规划目标还停在文字里时,大模型能帮规划师把一座城想清楚吗?
论文名片|Yu Zheng、Fengli Xu、Yuming Lin、Paolo Santi、Carlo Ratti、Qi R. Wang、Yong Li,Urban planning in the era of large language models,Nature Computational Science,2025,5:727–736,2025年9月8日在线发表。DOI:10.1038/s43588-025-00846-1。本文是观点文章(Perspective)。2025年10月6日的出版更正只恢复了图1标题,下文依据已包含该标题的正式版本。
设想一块待更新的用地。文本要求日常服务尽量落在步行或骑行15分钟之内,同时还要回应公平、环境韧性和居民意见。这些要求此时还是句子。规划师要把句子收成概念,再收成带位置的布局,并在动工前判断居民会不会真的这样使用。这个场面用来进入论文的问题,不是文中的真实项目。
这篇观点文章认为,大语言模型可以在这三步上做规划师的助手。模型被期待调动跨学科知识、把概念变成图,并用智能体提前演一遍日常活动。本文能够核对的证据短得多:Qwen2 里最大的700亿参数(70 billion parameters)模型,在规划概念难题上超过人类规划师中排名前10%的表现;智能体在纽约和芝加哥各一个社区模拟设施访问,常去地点接近真实移动数据里的热点,15分钟可达性也与真实情况一致。正确率、考生人数、社区名称和误差都没有写在这篇正文里。四张图说明工作流,其中的城市画面主要是示意和转引。
先说结论
- 作者提出的助手分三步:大语言模型写概念,视觉大模型出空间图,大模型智能体做事前评估。人负责改提示、纠正偏见,并和各方协商。
- 概念阶段的直接例证是规划师资格考试题。不同规模的 Qwen2 被拿来作答;700亿参数的最大模型,在规划概念难题上超过人类规划师里排名前10%的表现。题目数、考生人数和正确率不在本文。
- 评估例证是纽约、芝加哥各一个社区的设施访问。智能体常去的地点接近真实移动数据中的热点;按模拟计算的15分钟设施使用,也与两地真实情况一致。重合程度和误差不在本文。
- 出图一步停留在方法建议:用已有城市的底图、布局和说明文字微调视觉模型,并让底图约束生成。图3展示用地分区、建筑足迹和三维场景三类目标,本文没有报告生成误差。
- 作者把落地写成四道门槛:高质量设计图文稀缺,训练和全市人口模拟昂贵,人的活动从日常到多年都不稳定,训练数据还会把大城市和部分社会群体写得过重。
规划师手里的句子,为什么越来越难直接变成一张图?
城市规划一直在跟着城市变。作者从1890年代霍华德的田园城市说起:1940年代以前,城市规划主要被当成更大尺度的建筑设计,关注空间怎么排、看起来好不好。英国新城法和美国城市更新大体沿这条路走。这条路漏掉了城市生活里的社会维度,也解释不了高犯罪率和城市衰落。
第二次世界大战之后,规划转向把城市看成相互连接的子系统,并用模型处理其中的社会过程。重点从一张静止的总图,转到居民的日常活动。林德布洛姆的渐进式规划、法卢迪的规划理论和希利的沟通式规划,都属于这一路。15分钟城市也从这里长出来:用地更紧凑,日常服务处于步行或骑行距离内,生活更公平、更方便、也更包容。15分钟城市在本文里是被讨论的规划概念,作者同时引用既有研究,提醒这种布局可能带来隔离风险。隔离本身不是本文新测出来的。
作者认为这两条传统仍然不够。规划过程还是以规划师为中心,概念和规章很难让公众进入;评估又常常颗粒粗、依赖主观判断、以定性为主。当下的决策却想要更细、可量化、可比较的反馈。三件具体的事把这个缺口放大。第一,规划要同时理解社会公平、环境韧性和城市可持续,知识跨了很多学科。第二,新概念必须落到地理空间上,还要处理它可能带来的负面后果,这需要把抽象目标对齐到具体布局。第三,城市是大量主体和复杂相互作用组成的系统,方案好坏很难评。
已经有模型会画路网,缺的是哪一种通用?
城市地理数据变多之后,大模型出现之前的人工智能已经参与规划。作者综述的第一类能力,是从数据里找规律,再生成看起来像真实城市、统计上也接近真实城市的要素。生成对抗网络和变分自编码器被用来合成路网、功能分区和建筑足迹。第二类能力是按某个效率或生活质量指标做决策。强化学习被用于15分钟社区布局、道路规划和地铁网络扩展。这些都是本文引用的既有工作,不是作者在这篇文章里重新训练的模型。
作者指出这些小模型的共同限制:它们在较窄的任务数据上训练,往往只覆盖少数方面,换一种规划任务就难以沿用。大语言模型被期待补上的,是用自然语言把多个领域的知识放进同一种表示。论文把模型能力的来源写成三步:在多种数据上自监督预训练,用指令对做监督微调,再用强化学习做后训练。DeepSeek-R1 和 OpenAI 的 o 系列被当作更强推理的例子,用来说明这种能力已经出现在通用模型里,不是本文自己的规划实验结果。
作者希望大模型补上的,是哪三种能力?
第一种是跨学科知识。有效的规划要同时碰到地理、经济和社会。作者引用的基准显示,大语言模型在数学、医学、法律和金融里表现出较深的知识;还有缩放规律:参数和训练数据跨过某个门槛后,表现会明显高于随机猜测。由此他们推断,把模型做大,并在更多城市规划数据上预训练,就有可能同时照顾规划的多个方面。这是从其他领域的基准推到城市规划,本文没有给出一条城市规划任务上的缩放曲线。
第二种是按概念指令做更细的推理。抽象概念要变成令人满意的设计,本来就难。强化学习让模型把复杂任务拆成小步;视觉大模型则能理解卫星图像和街景,并按语言指令生成图像、三维场景甚至视频。作者认为这有助于让城市设计对齐不同的规划概念。这里给出的是能力迁移的理由,没有一份“概念对齐得分”。
第三种是预测性评估和公众参与。智能体可以带上居民和规划师的不同画像,模拟日常活动。作者列举已有研究在物理操作、社会模拟和网络讨论里用过智能体,据此认为城市模拟也有空间。公众参与这边,他们看重的是自然语言对话:居民和规划师可以多轮修改方案,而不必先学会一套专业界面。这也是设想中的界面,本文没有报告一场真实公众会议的参与人数或意见采纳率。
三步怎样接成一条还能改回去的流程?
作者把助手收成一个框架,对应图1。概念阶段,大语言模型读规划需求、要求和导则,标出需要更新的区域,并给出布局上的策略建议,输出描述城市形态和功能的文字。生成阶段,视觉大模型把规划师的提示变成布局和城市景象,并受使用者给出的草图约束。评估阶段,大模型智能体吃进方案、人口特征和其他条件,模拟包括人类移动在内的城市动态,再给出定量反馈。三步连起来,是为了让传统方法里“公众难进入”和“评估太粗、太晚”这两处一起被处理。
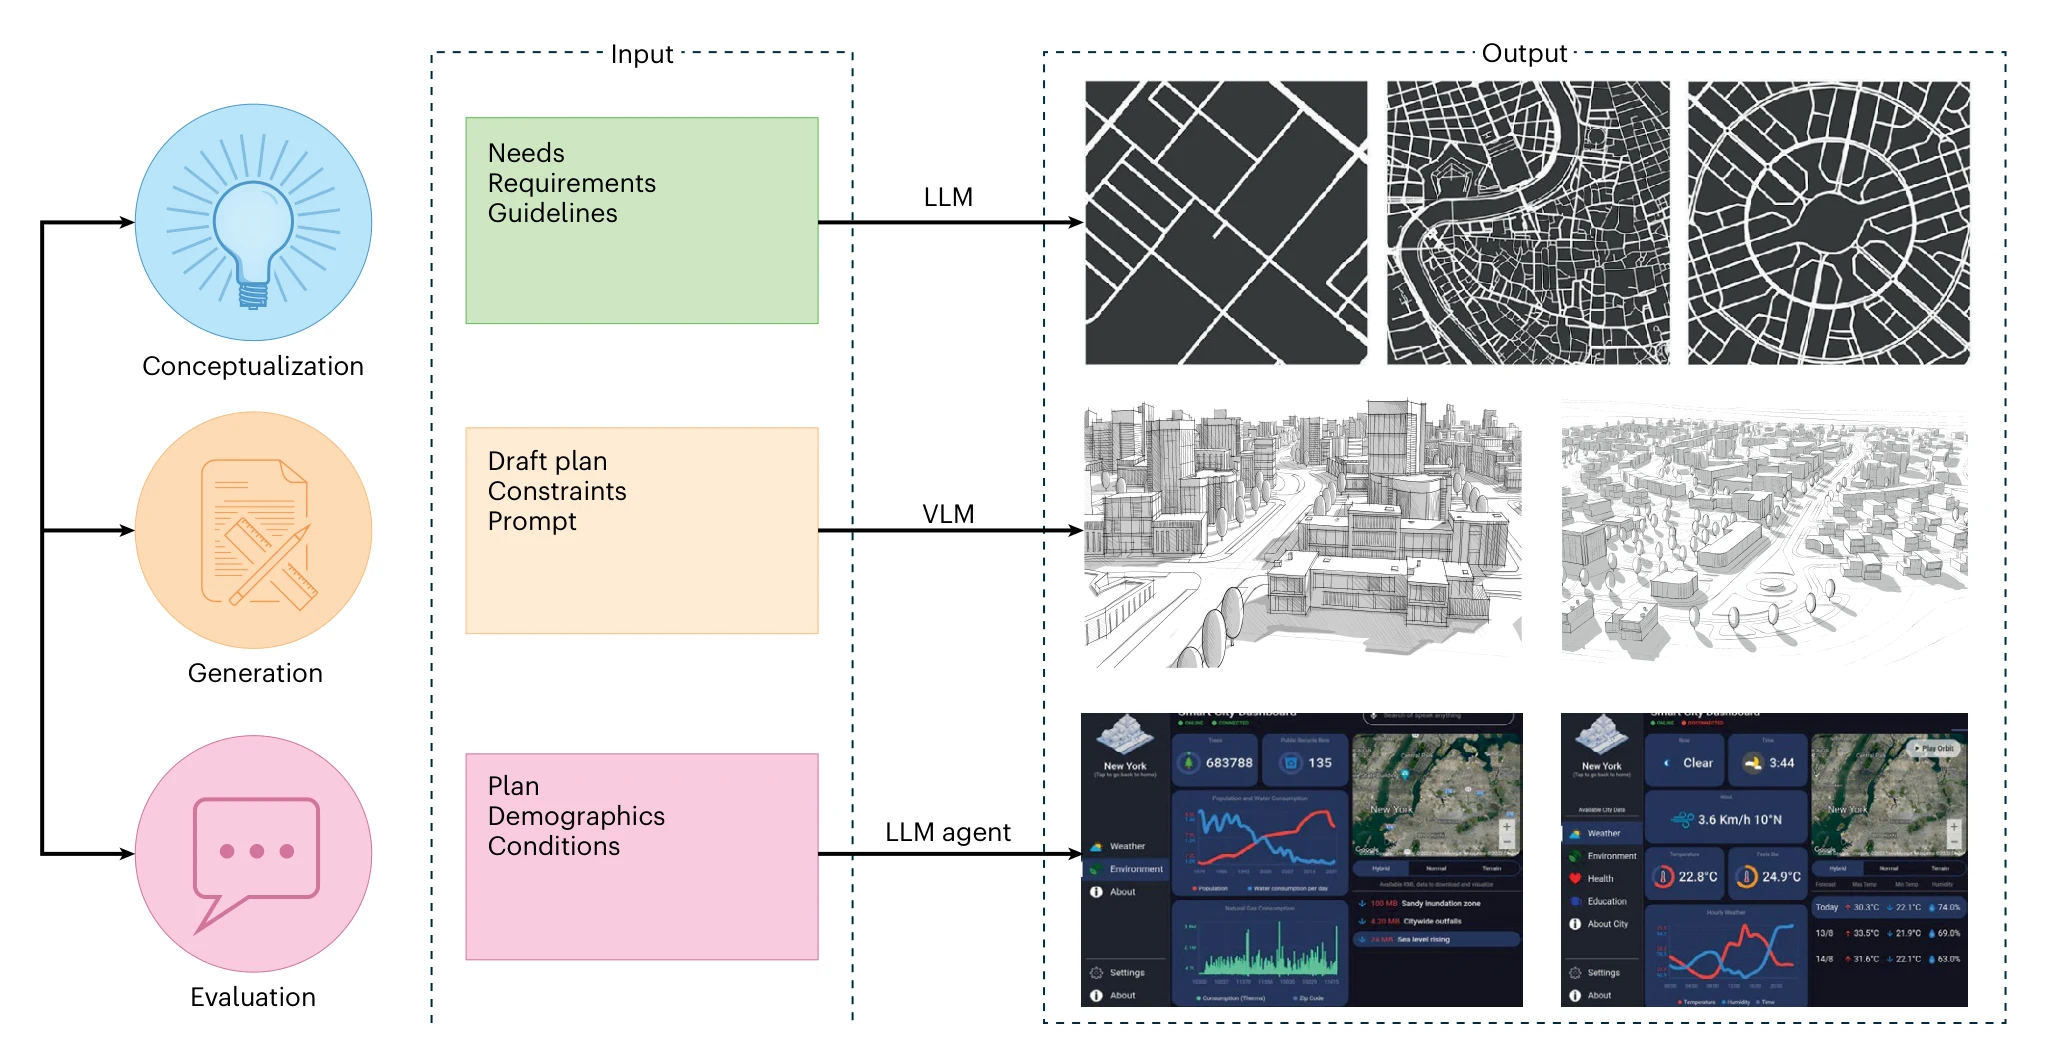
图 1|概念、出图和评估,各自吃进什么、交回什么?
无字母子图。左侧三条回路依次是概念构思、方案生成和效果评估。中间输入分别是需求、要求和导则;草图方案、约束和提示;方案、人口特征与条件。右侧输出用路网形态、城市空间草图和带地图的仪表盘示意三步可能交回的东西。路网图、空间草图和仪表盘由期刊分别注明来自既有城市形态研究、图库和开源城市仪表盘,用来表示输出类型。仪表盘上的天气和数字不是本文测量的规划指标。来源:原论文 Fig. 1。
图1因此支持的是分工:文字概念、视觉方案、活动模拟由不同模型承担,反馈还可以回到前面。它不支持“某一座城市已经按这个框架改完”。右侧画面也没有坐标轴或对照实验。
概念从哪来:多轮对话之外,考试题说明了什么?
概念阶段要先定下城市功能和形态的大方向,通常写成较短的文字,并点出走廊、中心这类要素。传统上,规划师和多方来回讨论、磋商,最后留下一套说明动机和逻辑的文本,很花时间。
图2把这一步画成对话。模型先在环境、社会、经济等规划相关文本上做大规模预训练。每一轮,规划师把需求、要求、导则和其他材料整理成提示;模型返回城市形态和功能上的建议,并利用它对现实世界时空知识的掌握,提出中心、走廊等要素怎么放。思维链、强化学习和图检索增强生成被作者列为加强推理的手段。规划师再改输入,进入下一轮。作者特别写明,训练数据若过度代表某些地区或领域,模型会带偏;人要识别并改正这些偏向,文字概念才适合继续画成草图。
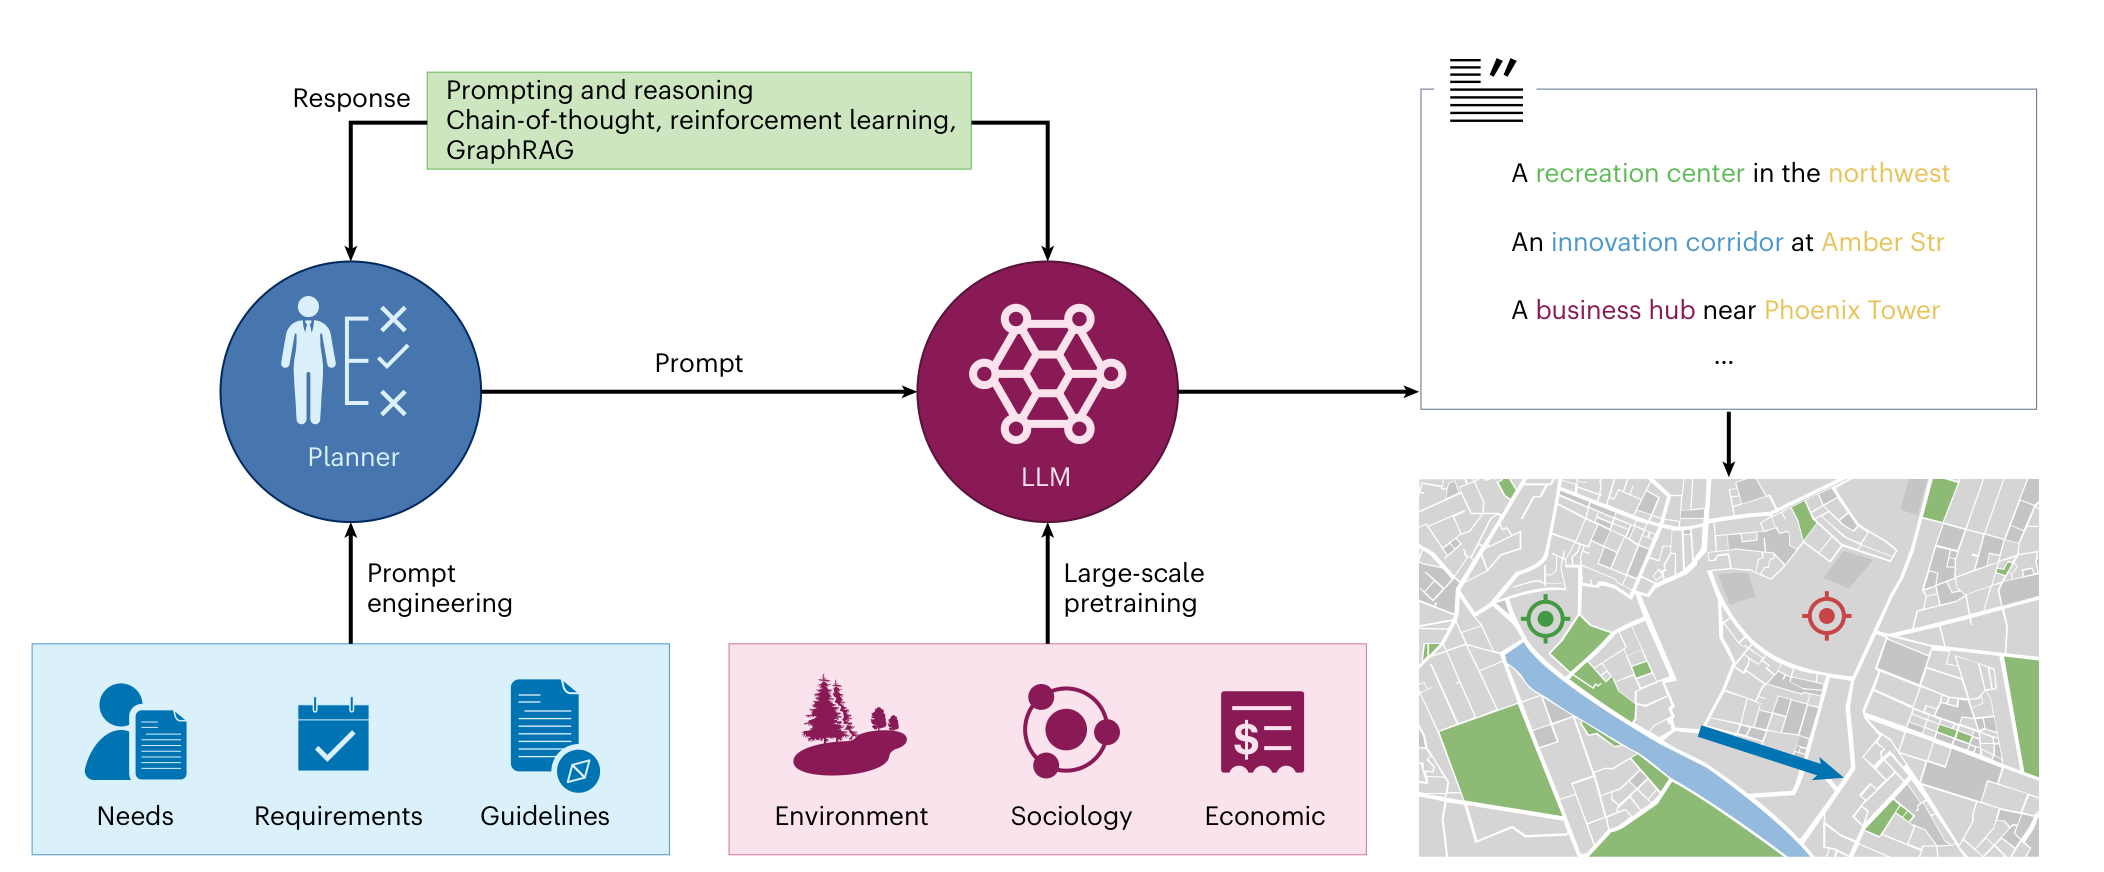
图 2|一次概念对话里,人和模型各交什么?
无字母子图。规划师从需求、要求和导则做提示工程,把提示交给经过大规模预训练的模型;模型一侧标出环境、社会和经济。上方回路写着思维链、强化学习和 GraphRAG。右侧是示意图里的概念短句,以及一张标了点位和箭头的地图。短句和地图是图中的例子,地图由期刊注明来自图库。这张图没有真实项目的用地红线和采纳记录。来源:原论文 Fig. 2。
作者用规划师职业资格考试题,给这种概念能力一个直观例子。题目覆盖交通、经济、地理、社会、生态与环境,考查基本理论和实务知识。他们比较了不同规模的 Qwen2。结果只报告了一句比较:700亿参数的最大模型,在与规划概念有关的难题上,超过人类规划师中排名前10%的表现。比较对象是参加这类考试题的人类规划师;前10%的分母,也就是考生人数,本文没有写出,正确率和题目数量也没有写出。作者把这句比较理解成:模型有潜力在规划开头参与概念综合。资格考试题上的相对名次,还没有扩展到一块具体用地的公平性或可实施性。
出图时,底图为什么必须留在条件里?
布局才决定土地、路网、设施和公共交通怎么放,也影响后面的活动。它要用图像或更精确的矢量表达位置,不能停在自然语言。而且布局不能任意生成,还要服从地理、社会动态和土地权属。作者要的是可控生成:最终布局同时贴住原有城市环境和这次的规划概念。
图3把做法写成两段。先建一个面向城市设计的条件图文数据集,包含已有城市的底图、布局和对应的规划说明。再用它微调视觉大模型,例如把 CLIP 这类模型接到生成模型上,并用低秩适配降低微调成本。规划师用文字描述要求和概念,微调后的模型在底图条件下生成设计。ControlNet 和 DreamBooth 被点名为让生成服从建成环境约束的技术。作者预期,视觉模型会像地理信息系统曾经那样,成为规划支持工具;仍有设计不能完全由计算生成。规划师根据出图改提示,并与决策者和其他相关方讨论,使方案对准更广的公共利益。
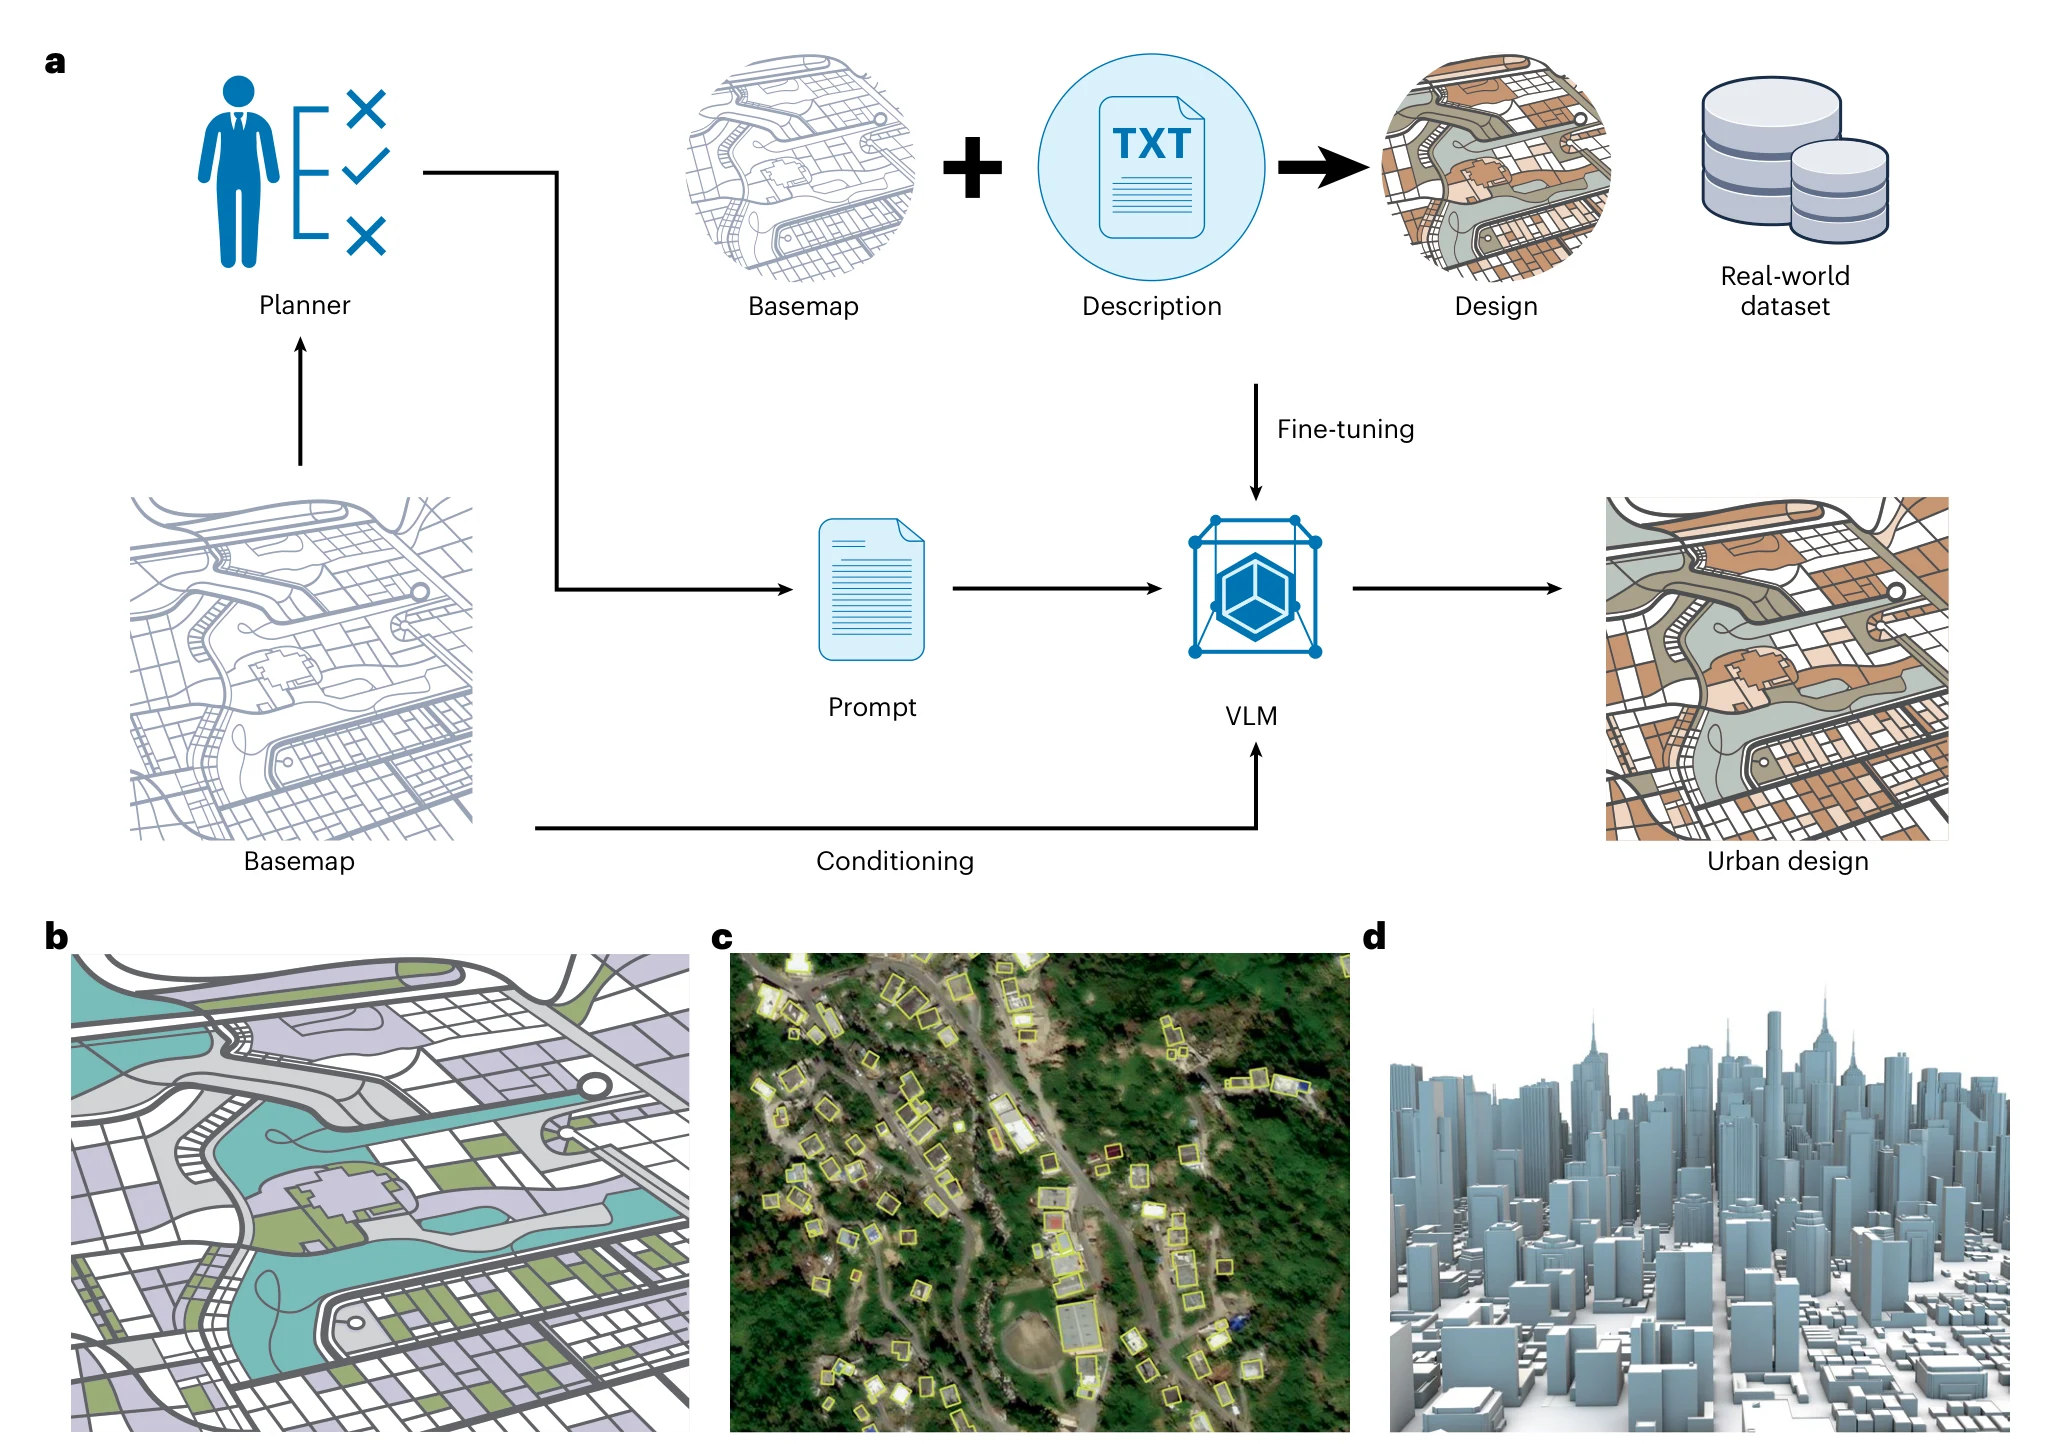
图 3|文字概念怎样被收成受底图约束的城市图?
(a)上方用已有城市的底图加文字说明得到设计,并进入真实世界数据集,再用来微调视觉模型。下方规划师依据底图写提示,视觉模型在底图条件约束下生成城市设计。底图和设计图由期刊注明含有图库图像。(b)一幅分色的用地分区图,示意土地用途布局。(c)卫星影像上用黄色框标出建筑,期刊注明这幅建筑足迹来自微软全球机器学习建筑足迹数据。(d)一片由体块组成的三维城市场景,期刊注明来自图库。图注把(b)(c)(d)写成不同场景下的生成结果;同一页的署名又把(b)(d)归于图库、把(c)归于上述建筑足迹数据。三幅图都没有比例尺、样本数或与真实方案的误差。来源:原论文 Fig. 3。
所以图3回答的是生成步骤打算约束什么:文字提供概念,底图卡住地理条件,输出至少要覆盖用地、建筑足迹和三维场景。它没有回答微调之后的图离合格方案还有多远。数据集的城市数量、图文对数量和微调是否已经完成,正文都没有给出。
两个社区的模拟,能提前说明居民会怎么用这座城吗?
评估要衡量方案的影响并指导修改。作者批评传统评估依赖专家意见和相关方访谈;经济指标、环境质量这类定量指标又往往范围窄,或只在特定情形使用,方案之间难比较。评估还常常发生在设计和建设之后,留下的修改空间很小。他们因此转向事前预测,也就是在城市数字孪生里做多方面模拟。难点在于,人的活动随人口特征变化,而且彼此牵连。
图4把智能体评估画成一个可反馈的循环。智能体带有性别、职业、年龄等画像,各自有不同的需求。城市环境里的工具包括导航和 Google Places 接口,用来决定地点之间的路线,并模拟移动。记忆保存过去的行为、观察和与其他智能体的互动,使模拟可以随时间调整。为了把模拟扩展到更大的城市,作者认为还需要提示优化,以减轻计算和通信负担。图中列出的反馈指标包括出行距离、设施使用、碳排放、多样性与公平。这些名称表示评估想交回的维度,图上没有数值。
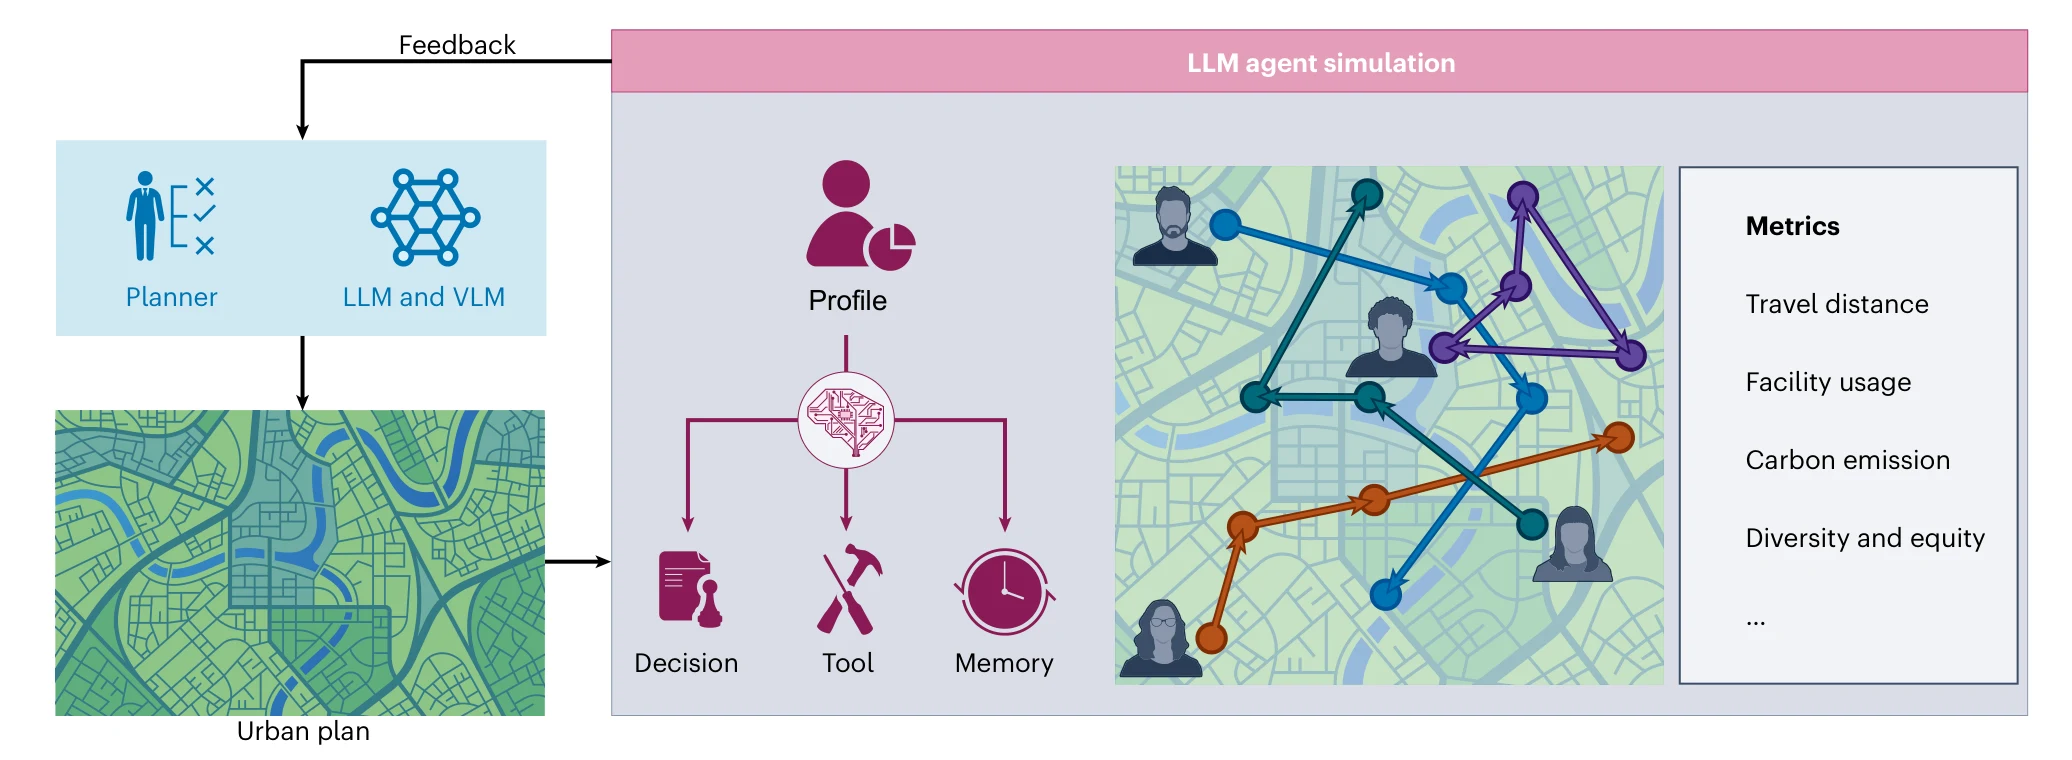
图 4|评估阶段模拟谁、调用什么、最后交回哪些指标?
无字母子图。左侧是城市方案,以及规划师与大语言模型、视觉模型;一条反馈箭头回到这一侧。中间智能体从个人画像分出决策、工具和记忆。右侧在地图上用不同颜色的连线示意居民之间的活动联系,指标栏列出出行距离、设施使用、碳排放、多样性与公平,并留有省略号。地图由期刊注明来自图库。这张图没有纽约或芝加哥的热点数量,也没有15分钟可达的比例。来源:原论文 Fig. 4。
作者用两个社区的设施访问,说明这条评估路径可能有效。地点分别在纽约和芝加哥,对照的是真实移动数据。智能体经常访问的位置,与经验数据里的热点接近;不同类别城市设施的15分钟使用,也与两个社区的真实情况一致。15分钟使用在这里的定义是:模拟中这些服务是否处于步行或骑行15分钟可达范围内。比较的社区数是两个,每城一个。本文没有写出每个社区的居民数、智能体数、设施类别名单、热点重合的比例,或15分钟使用的具体份额。因此这则例证支持的是方向:模拟访问可以贴近真实热点,15分钟可达性也可以与真实情况同向。它还没有给出误差,也不能单独推出碳排放或公平指标已经合格。
作者紧接着写下一条边界:人的行为本来不确定,确定性的智能体模拟无法完全抓住它。后续基准需要把不确定性和情境差异写进评估,也可以用随机模型表现行人移动和决策里的概率性。两个社区的例证尚未包含这套检验。
数据、算力和偏见,把蓝图挡在哪里?
作者把蓝图落到规划流程时的技术障碍写成四条。
第一条是数据。可靠的大语言模型往往需要百万乃至十亿级训练样本;缩放规律表明,涌现能力要等训练数据超过某个临界规模才出现。遥感和众包降低了获取土地利用、路网和兴趣点的门槛,但高质量城市设计数据仍然紧缺。作者指的是空间布局和对应的说明文字,它们通常在政府和设计机构手里,获取受限。他们鼓励规划界用开放、可协作的平台交换这类数据。本文没有报告他们已经建好的平台规模。
第二条是计算。训练大语言模型和视觉大模型通常要大量先进图形处理器,对多数规划研究者和实践者仍然太贵。作者因此主张做更小、专门面向城市规划的模型,因为专用模型需要的参数通常远少于通用模型。智能体若按个人模拟整座城市的人口,计算同样困难。他们建议对精心抽取的人口子集做模拟,再把结果统计外推到全体,并用较小的专用或蒸馏模型降低成本。子集多大、外推误差多少,本文没有给出。
第三条是人的活动本身难模拟。活动在日常节律和多年趋势上都有很大不确定性;时间拉长后,人口变化这类因素会改写城市动态,不确定性通常更大。这同时压在决策过程的建模上,也压在大规模、高保真模拟的计算上。
第四条是偏见。已有的城市专用模型被用于移动预测、交通信号控制和空间导航,预训练和微调依赖的城市数据本身偏差很大。大城市产生的数据更多,模型会偏向这些人口中心,用到数据较少的小城市时表现变差。作者引用的研究还表明,大语言模型存在地理偏见,社会经济条件较低的地点尤其如此;生成内容里也观察到与性别、种族有关的社会偏见。这些是被引研究的结论,不是本文新测的偏见幅度。作者提出的应对包括审慎挑选训练数据、用专门微调等算法公平性技术,以及让当地相关方参与设计。
作为收束,他们建议在大都市和代表性不足的小城市里做案例和消融,并给城市规划单独建立评测基准。最后一节把问题从技术再往外推:采用这种工具可能要改规划政策和规章;计算资源会限制小城市政府或技术条件有限的机构;规划师、设计者和公众还要建立信任。规划师可能怀疑人工智能方案的可解释性、透明性,以及是否还对准以人为中心的城市价值。作者主张人与模型协同,并研究人在回路中的方法,让生成过程可被指导和监管。
一句话总结
大模型可以被安排成写概念、出图和事前模拟的助手,但本文能核对的证据只到资格考试题上的相对名次,以及纽约、芝加哥两个社区设施访问的定性一致;拿去改一座具体的城之前,还要有开放的设计图文、付得起的计算,以及对偏见和居民行为不确定性的检验。
核心来源
- Nature Computational Science 正式页面,核对题目、作者、卷期页码与2025年9月8日在线发表信息。正文图1至图4均来自该文。
- 2025年10月6日出版更正,说明最初版本中图1标题曾出错,现已恢复为 The proposed LLM-driven urban planning framework。
- 清华大学新闻稿,2025年9月10日,核对第一作者与通讯作者身份,以及资格考试、纽约和芝加哥两则例证的公开转述。新闻稿没有补充本文缺失的正确率或误差。
- 两则例证在正文中分别引用 UrbanPlanBench 预印本(arXiv:2504.21027)和 Su 等关于城市设施选址的会议论文。这些文献的明细表不在本篇正文,本文没有转写其中的数值。
作者介绍
机构以论文署名为准。职务和研究方向只写能在论文贡献说明、清华大学新闻稿或清华大学建筑学院教师页上核对的内容。
- Yu Zheng(郑瑜):署名清华大学电子工程系与麻省理工学院 Senseable City Lab。论文贡献说明写明由他完成初稿。清华新闻稿称他为电子系2019级博士生、本文第一作者。
- Fengli Xu(徐丰力):署名清华大学电子工程系。全体作者参与审阅、修改和定稿。清华新闻稿称他为电子系助理教授。
- Yuming Lin(林雨铭):署名清华大学建筑学院城市规划系,以及自然资源部智慧人居环境与空间规划治理技术创新中心。通讯作者之一,参与关键反馈。建筑学院教师页列其为城市规划系助理教授,研究方向包括城市复杂系统、城市模拟与决策、生成式人工智能。
- Paolo Santi:署名麻省理工学院 Senseable City Lab,以及意大利国家研究委员会信息学与远程信息研究所(比萨)。参与关键反馈。清华新闻稿称他为 Senseable City Lab 研究员。
- Carlo Ratti:署名麻省理工学院 Senseable City Lab。全体作者参与审阅和定稿。清华新闻稿称他为该实验室教授。
- Qi R. Wang(王琦):署名美国东北大学土木与环境工程系。与 Yong Li 共同提出研究主题,并参与关键反馈;通讯作者之一。清华新闻稿称他为副教授。
- Yong Li(李勇):署名清华大学电子工程系。与 Qi R. Wang 共同提出研究主题,参与关键反馈;通讯作者之一。清华新闻稿称他为电子系教授。致谢写明他得到国家重点研发计划项目2024YFC3307603支持。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
资格考试比的是概念题上的相对名次。若下一步真要检验“助手能不能把一座城想清楚”,可以把同一块用地、同一份导则交给规划师和模型,看概念有没有点中这块地上真正绑住方案的条件,例如现状居民、土地权属或环境约束。模型若只交出流畅、像大城市模板的句子,名次再高也还停在考试分布里。这个检验直接接上作者自己对训练数据偏向大城市场景的提醒。
图4把多样性与公平列进指标栏,纽约和芝加哥的例证却只报告了总体热点和15分钟使用是否与真实情况一致。平均可达若看起来吻合,仍可能盖住某个年龄或职业群体到不了诊所、学校。把论文已经列出的画像拆开,分别报告各组里15分钟步行或骑行可达的比例,才能看出总体一致是不是由人数较多的群体贡献的。这是对现有例证口径的延伸,不是文中已经完成的分组结果。
人在回路里若只保留“看起来像熟悉的成功城区”的图,修改过程会把作者担心的地理偏见再写回去。每一轮除了新提示,还需要留下一条可核对的理由:改动对准的是哪条导则、哪一类居民,或哪一项底图约束。没有这条例由,多轮对话只是让句子和图变得更顺。