住在这里的人,和白天来到这里的人,是同一群人吗?
论文名片|Meicheng Xiong、Di Zhu、David Van Riper,A visitor-enriched census in the U.S. cities using large-scale mobile positioning data,Scientific Data 12, 1106(2025)。原论文 · 数据描述论文。
想象两个街区,常住居民的收入与教育结构十分相似。一个白天吸引全城上班族,另一个几乎只有附近居民活动。如果只看住在这里的人,两地可能相似;如果看谁来到这里,它们可能完全不同。
这篇论文给普查区增加了一层访客画像:先从手机记录推断居住区,再把访客居住区的普查属性带到目的地。它没有逐个询问访客收入和族群,而是在地区间出行联系的基础上,构建一份来源社区属性加权的访客普查。
先说结论
- 产品覆盖美国七个都市统计区的 2021 年 7 月,将居民统计与外来访客来源社区联系起来,空间单元为人口普查区组(Census Block Group,CBG)。
- 按访客人数与按访问次数加权,会得到不同画像:前者接近谁来过,后者更强调谁频繁来。
- 访客收入指标是访客来源区家庭收入中位数的加权平均,不是实测个人收入,也不是所有访客家庭收入的真实中位数。
- 居所识别经过夜间聚类、住宅建筑过滤和人口分布比较,但没有个人居所真值;相关与抽样比例不能证明个体识别准确或群体无偏。
一张居民表,怎样加上来访者的信息?
七个都市统计区分别是洛杉矶、休斯敦、亚特兰大、迈阿密、西雅图、丹佛和明尼阿波利斯—圣保罗双城。移动记录来自商业数据 PlaceIQ 的 Unattributed Visits Dataset,分析月份为 2021 年 7 月;社区属性来自 2017—2021 年 ACS 五年估计。
一个 CBG 的访客被定义为:被记录到访该区、推断居所又在别的 CBG 的设备使用者。住在目标 CBG 内的设备使用者会被排除出该区访客计算。同一个人因此可以是自己居住区的居民,又是其他区的访客。
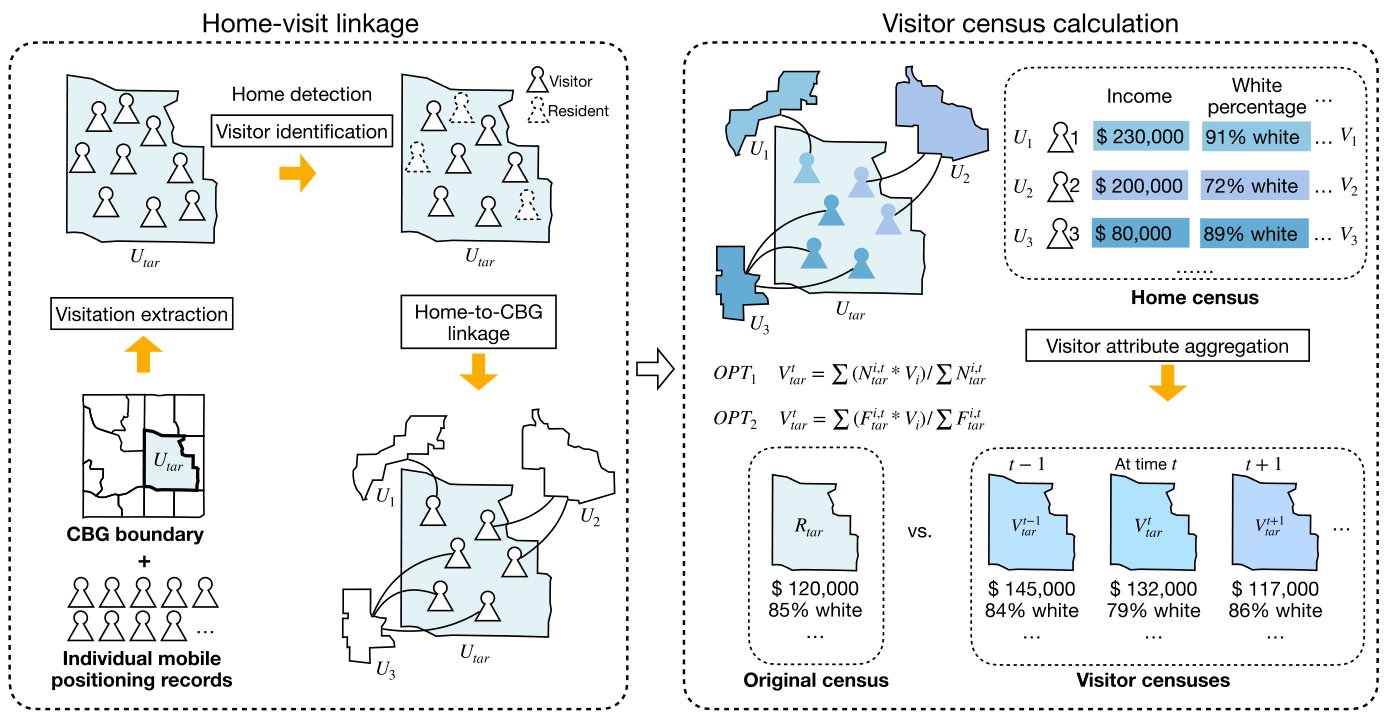
图 1|居住区的社会属性,怎样沿访问关系进入另一个地方?
本图没有字母子图。左半部分从移动记录提取访问、识别居所、排除目标区居民,再把居所匹配到来源 CBG;右半部分根据来源区普查属性与访问权重,生成不同时段的访客画像。右下的时间序列示意的是属性可随来访构成变化,而不是社区居民在短时间内改变身份。来源:原论文 Fig. 1。
同一目标地可以同时保留居民画像和访客画像,因而避免把地理区域看成彼此独立的静态容器。中间的居所—访问表类似起讫点(OD)联系表,但起点是推断居所,终点是访问地,不是相邻两次出行停留之间的所有真实行程。
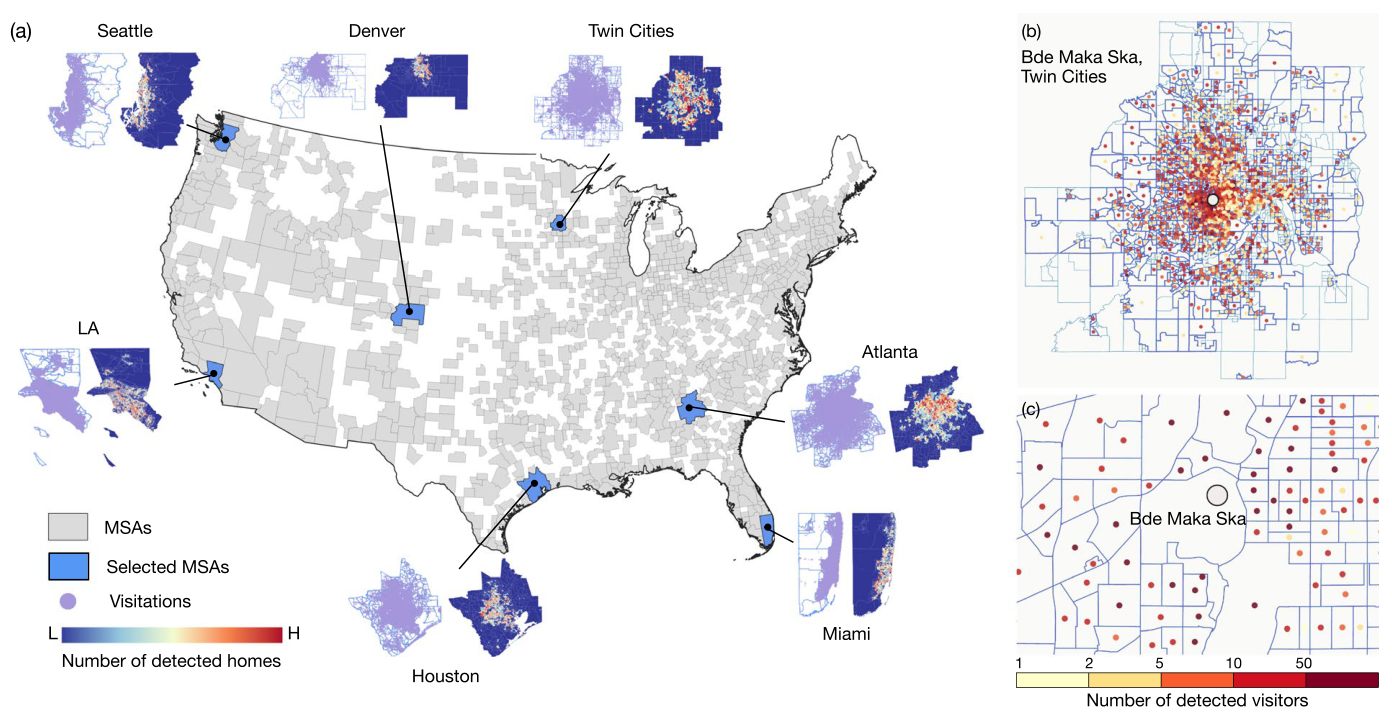
图 2|一处湖区的来访者,来自哪些社区?
(a)七个都市区位置及数据分布,每个城市左图示定位访问,右图示按 CBG 汇总的居所识别结果。
(b)以双城 Bde Maka Ska 所在目标 CBG 为例,点的颜色表示各来源社区被识别的访客数量,颜色较深表示更多;图中没有画出每一条 OD 连线。
(c)目标区附近的放大图。来源区与目标地形成的联系说明观察到谁来自哪里,不能直接代表没有手机记录的人也按同样比例到访。来源:原论文 Fig. 2。
手机夜里不动,就能认定那是家吗?
识别先取晚 8 点至次日凌晨 4 点的记录,只保留夜间记录超过 20 条的设备,约有一半设备因活跃度不足被筛除。之后用 HDBSCAN 空间聚类,每个簇至少含 5 条记录,从中选择平均停留时长最高的簇,以其中心作为候选居所。
这个假设对规律作息者较合理,但并不天然适合夜班工作者、短期旅行者或多居所人群。研究为简化而只取一个居所。随后把候选点与住宅建筑分类数据匹配,只保留位于住宅建筑 20 米缓冲范围内的结果。
住宅过滤可以减少把通宵工作场所当作家的情况,却仍不是逐户核查。建筑分类错漏、定位误差和缓冲阈值都会影响保留样本;落在住宅附近也不证明这个人真正长期住在那里。
两种加权,回答了两个不同问题
假设甲社区有 10 位居民到访,每人只来一次;乙社区有 2 位居民到访,每人来十次。按访客人数加权,甲的权重是 10/12;按访问次数加权,乙的权重是 20/30。这个例子只是解释方法,不是论文中的真实数据。
计算方式都是把每个来源 CBG 的属性乘以对应人数或次数,再除以全部人数或次数。论文展示四项属性:家庭收入中位数、白人比例、25 岁及以上人口中本科及以上学历比例,以及文中定义的 16 岁及以上人口失业比例。最后一项复用时应核对 ACS 原变量分母,不能未经检查就当作以劳动力为分母的标准失业率。
特别是收入:对多个社区的家庭收入中位数求加权平均,不会自动得到合并访客群体的中位数。同样,某位访客来自白人占比 80%的社区,并不等于已知此人的族群;模型带到目的地的是来源社区构成的代理。
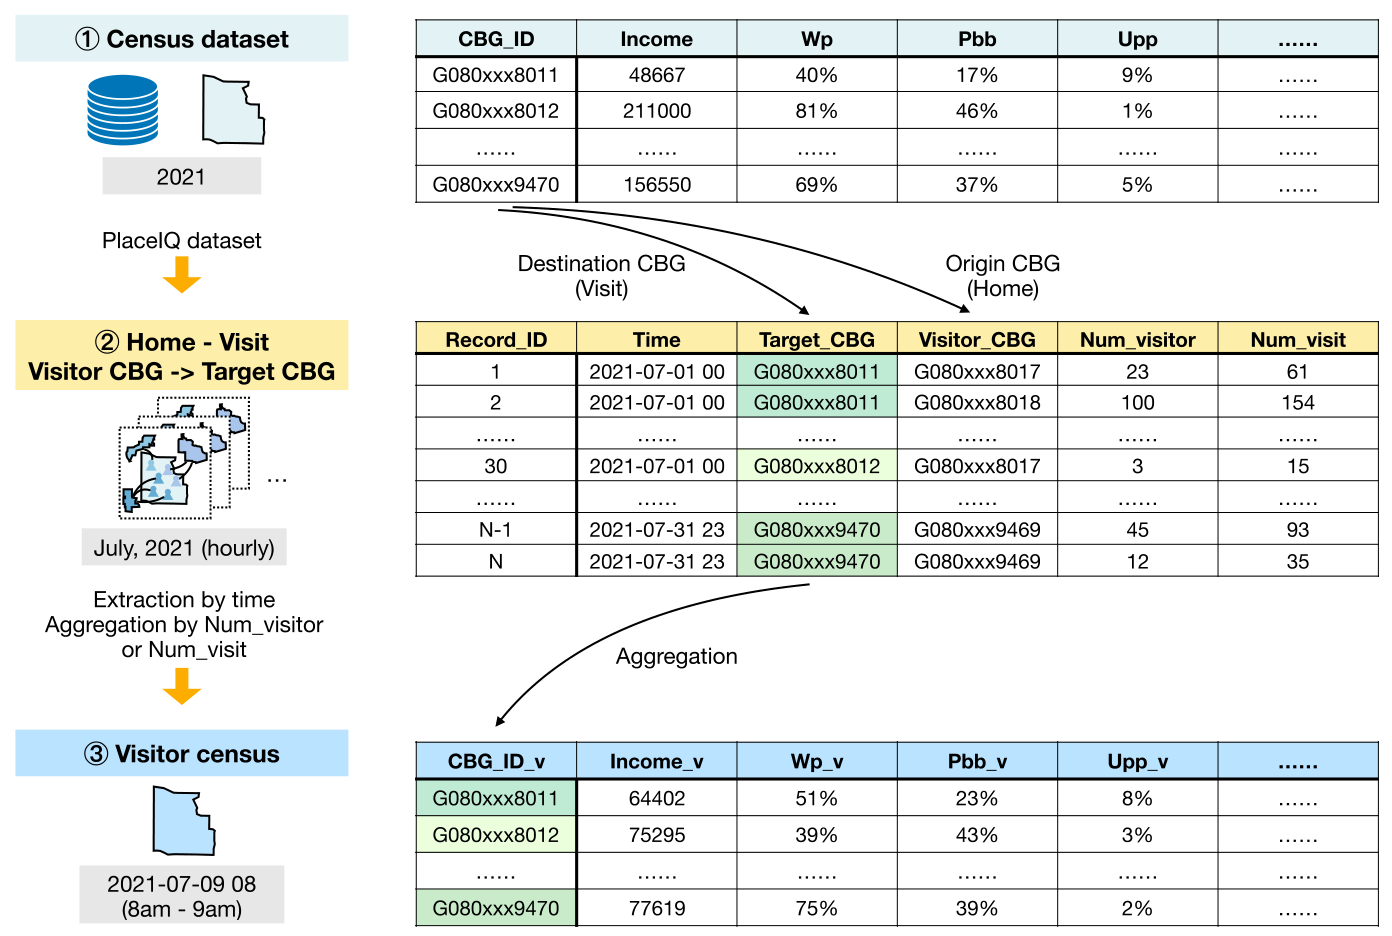
图 3|哪些字段是真的观察,哪些是加权推断?
本图没有字母子图。上表为 CBG 居民普查属性,中表按来源 CBG、目标 CBG 和小时记录访客人数 Num_visitor 与访问次数 Num_visit,下表为选定时段的访客属性。CBG 标识负责连接,属性值来自来源区统计与中表权重的组合,未新增访客个人调查。来源:原论文 Fig. 3。
归档为每个都市区提供两份 2021 年 7 月整月访客表,分别按人数、次数汇总;此外公开 7 月 19—25 日一周的逐小时居所—访问中间表。不能把这份一周中间表称为整月所有小时都已公开。没有识别到访客的 CBG,属性记为空值,也不能用零收入或零比例替换。
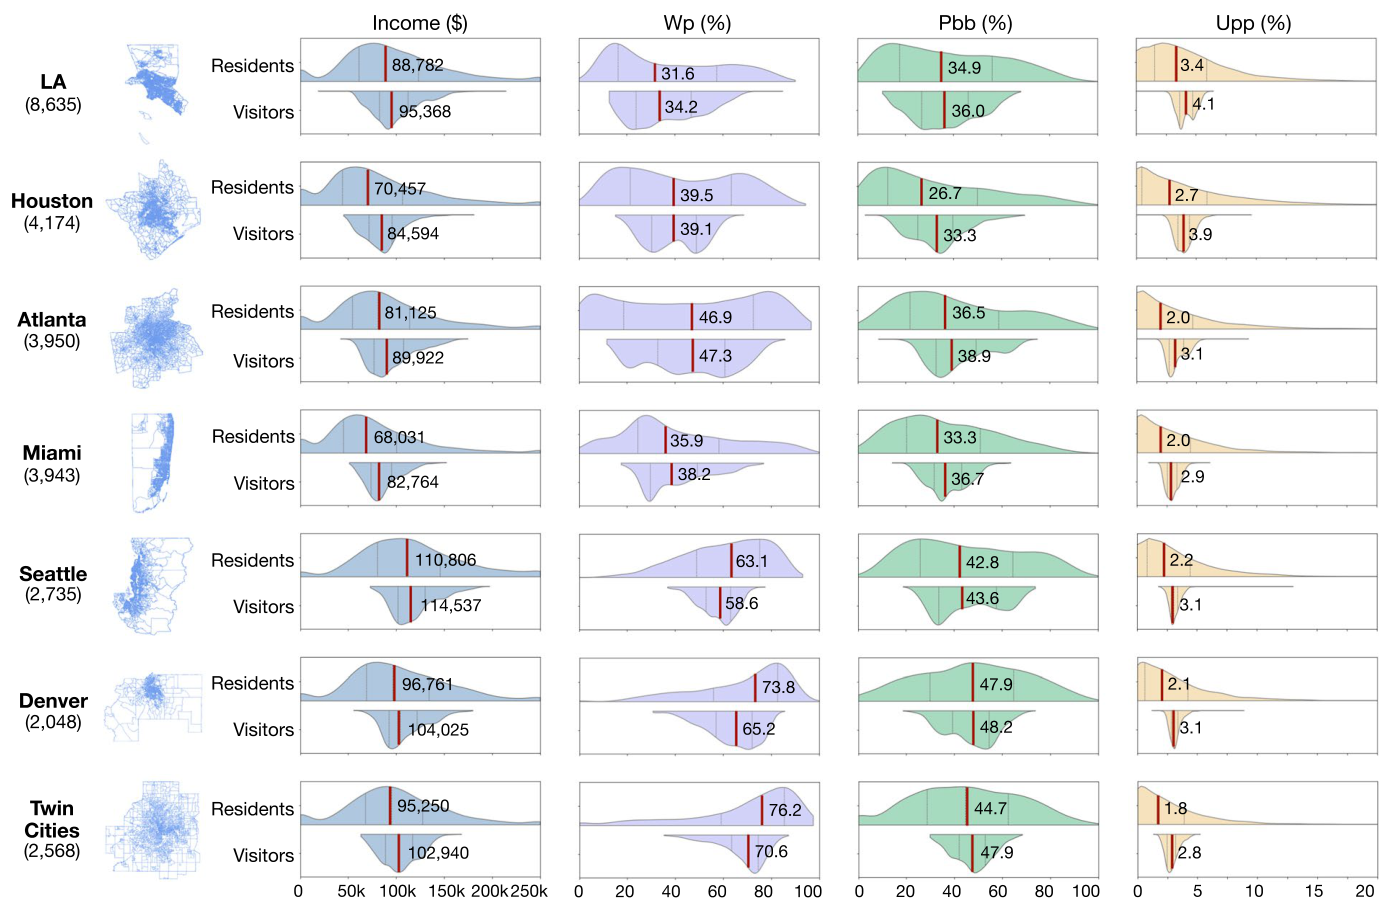
图 4|加入访客视角后,社区属性分布怎样变化?
本图没有字母子图。七行依次为洛杉矶、休斯敦、亚特兰大、迈阿密、西雅图、丹佛和双城;四列依次为收入、白人比例、本科及以上比例与失业比例。每格比较居民与按人数加权的访客属性分布,城市名下数字为 CBG 数。图中的差异反映目的地被哪些来源社区连接,不是同一批人前后的社会属性变化。来源:原论文 Fig. 4。
居所估计,有多少验证依据?
第一类证据看时间规律:七个都市区的平均停留时间夜间更长,白天约 4247 秒、夜间约 8638 秒,约合 71 与 144 分钟。它支持把夜间长期停留作为候选居所的总体动机,不能证明每个候选点都准确。
第二类证据把识别居所汇总到 CBG,与 ACS 人口比较。相关系数包括洛杉矶的 0.56、休斯敦的 0.58、西雅图的 0.40、丹佛的 0.63。图中这些值是 Pearson 相关系数,并非正确识别百分比。
洛杉矶住宅过滤后的抽样比例为 1.81%、迈阿密为 2.78%,其他都市区也有差别。抽到 1%以上人口说明规模可观,却不能保证低收入、老年或儿童等群体按比例出现。论文摘要报告潜在居所识别涉及约 358 万匿名用户;它与图 5 中经过筛选、用于验证的各城设备计数不是可以直接替换的同一个口径。
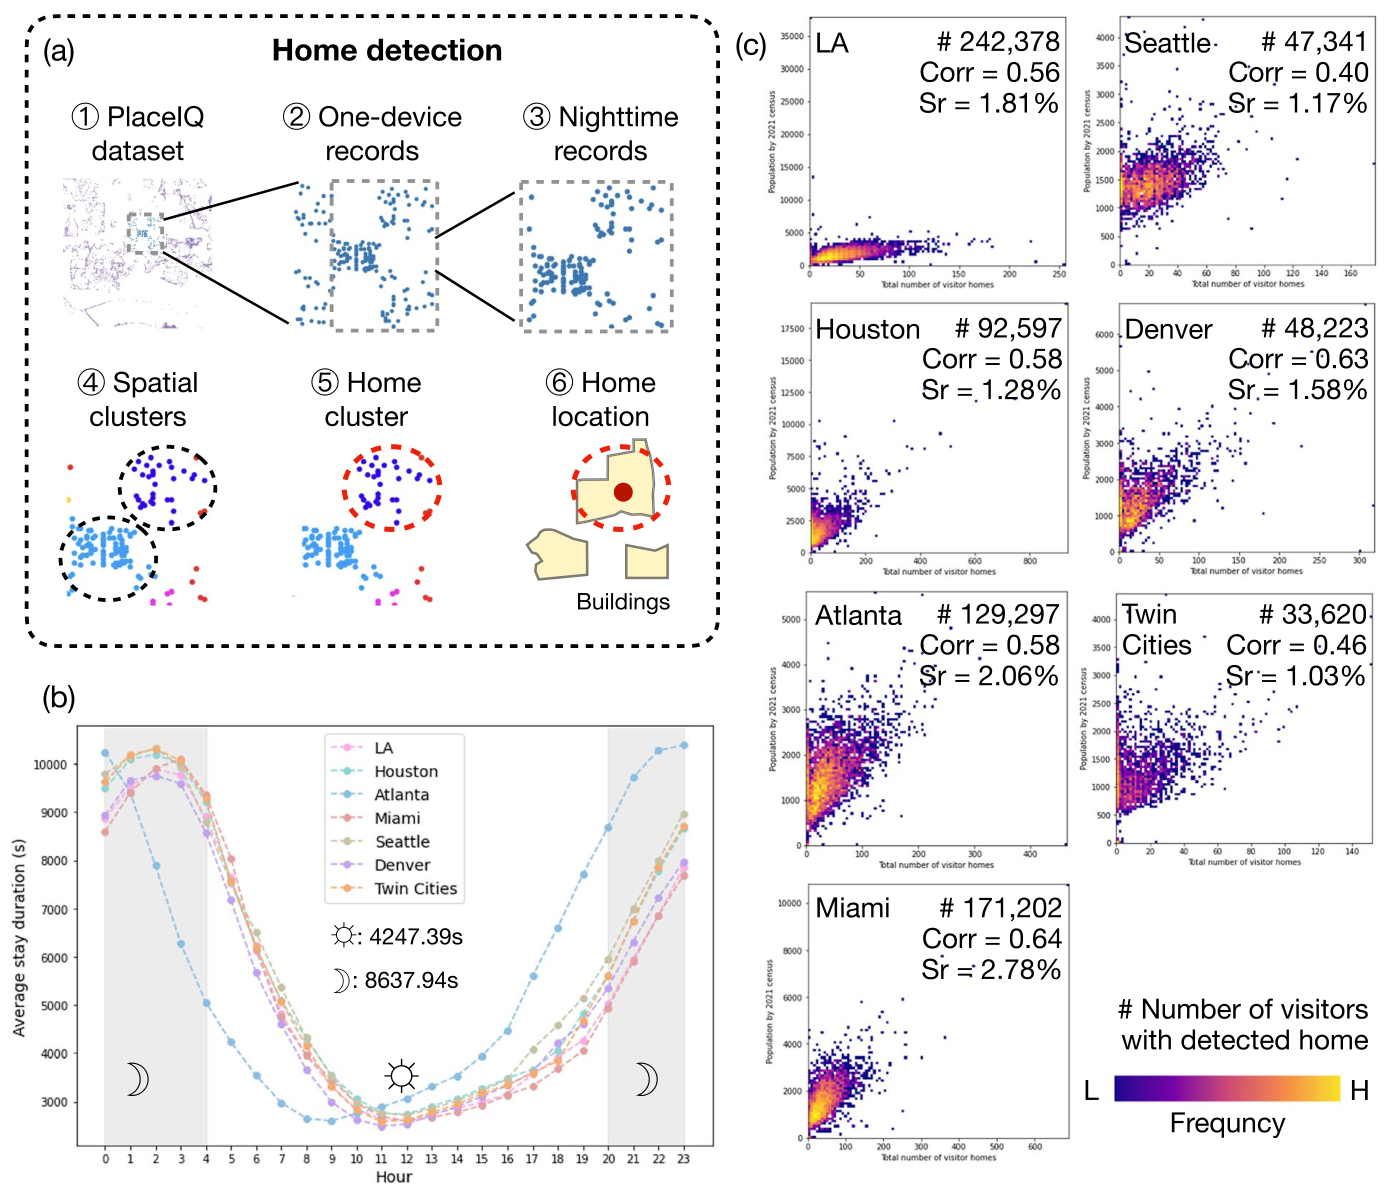
图 5|三种检查各自能说明什么?
(a)提取设备记录、筛选夜间数据、聚类并匹配住宅建筑的识别流程。
(b)横轴为小时、纵轴为平均停留秒数,不同线对应不同都市区;夜间较高说明总体时间规律与方法假设相容。
(c)各都市区内,横轴为住宅过滤后的识别居所设备数、纵轴为 CBG 统计人口;图中标出计数、相关系数 Corr 与抽样比例 Sr。聚合分布相关不能替代个人居所真值验证。来源:原论文 Fig. 5。
一天之内,一个地方的访客画像怎样变?
双城示例按人数权重计算访客来源社区的非白人比例代理,并比较夜间与白天。目标不是说一个社区的居民白天变成另一种族群,而是不同时间到访设备所连接的来源社区不同。
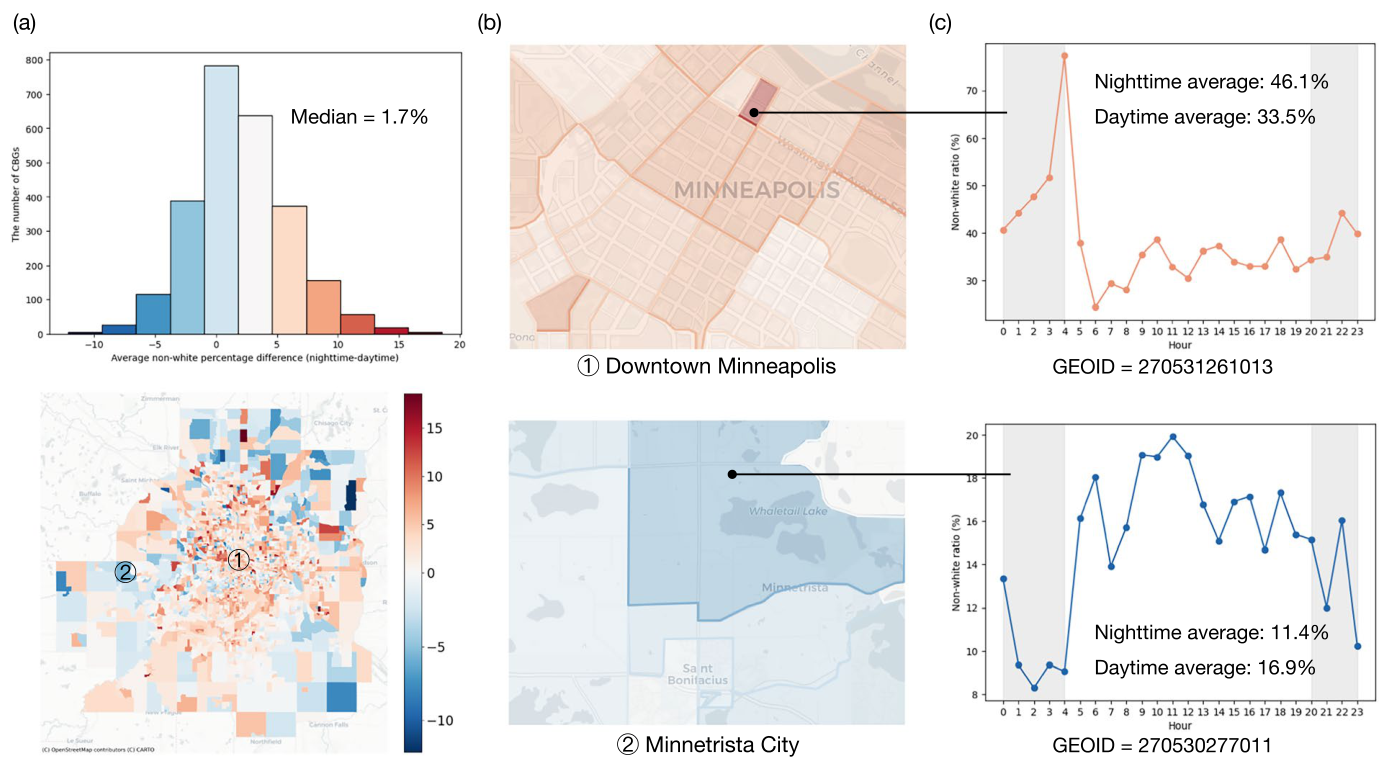
图 6|平均差异背后,是否有方向相反的地方?
(a)直方图和地图表示夜间平均减白天平均的非白人比例代理差,直方图中位数约为 1.7 个百分点;颜色展示正负方向。
(b)选取明尼阿波利斯市中心与 Minnetrista 两个局部示例,前者夜间较高,后者白天较高。
(c)两处示例 CBG 的逐小时曲线:市中心一例夜间与白天平均为 46.1%和 33.5%,Minnetrista 一例为 11.4%和 16.9%。这些是来源社区构成经访客权重形成的代理比例,不是直接观察到每位到访者的族群身份。来源:原论文 Fig. 6。
这种日夜差异可以帮助提出社会空间问题,但不能单凭两条曲线认定存在排斥或歧视。设施营业时间、出行目的、地理距离和样本结构都可能改变昼夜构成。论文提出与历史日落城资料结合的应用设想,也不等于已经验证某个当代地区强制非白人离开。
居民较富,不代表来访者也来自较富社区
另一组双城示例比较居民属性与访客来源属性。Fulton 示例居民家庭收入中位数为 250,000 美元,访客来源社区收入中位数加权平均为 122,831 美元;圣保罗市中心一例则反过来,为 21,311 对 89,870 美元。这些数值指向某些地点的居民与到访来源存在明显分离。
教育代理也类似。Uptown Minneapolis 示例中,居民本科及以上比例为 96.7%,访客来源加权比例为 58.7%;Brooklyn Center 的例子则为 5.2%对 39.6%。不能把同一地点的居民与访客视为同一个总体,也不能推断具体某位访客有何学历。
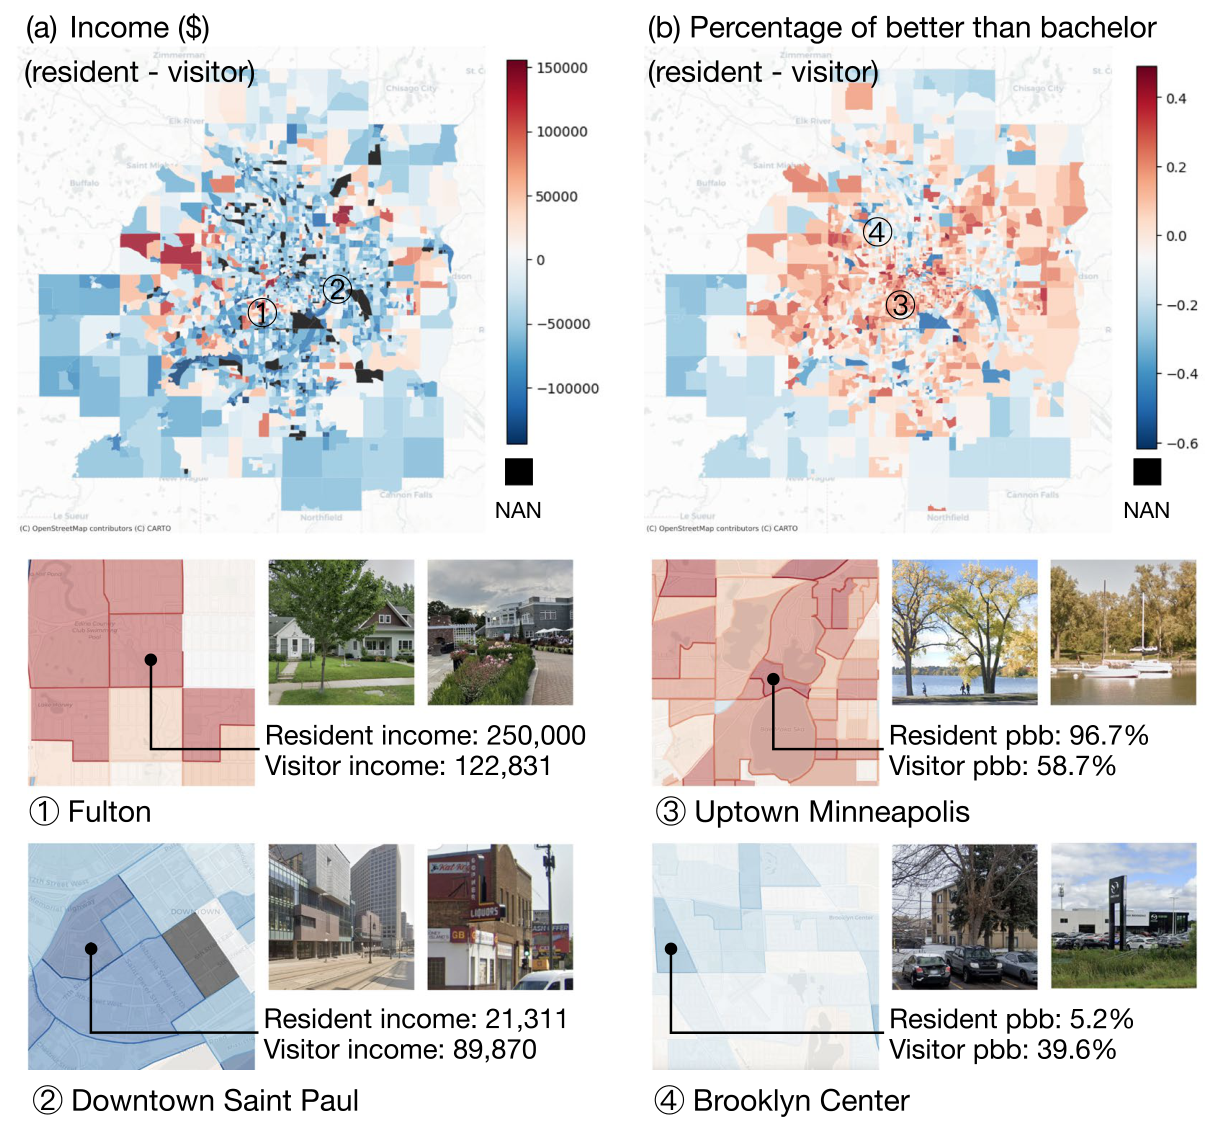
图 7|谁居住在这里,与谁来这里,有何空间差异?
(a)居民收入指标减访客来源收入代理的差值地图,并放大 Fulton 与圣保罗市中心两个方向相反的例子;颜色图例为美元差值。
(b)居民本科及以上比例减访客来源对应代理比例,展示 Uptown Minneapolis 与 Brooklyn Center 的对照;图例使用比例差,0.4 对应 40 个百分点。黑色为空值。照片帮助识别地方环境,不是个体属性的调查证据。来源:原论文 Fig. 7。
这份访客普查,不能越过哪些边界?
最核心的边界是生态谬误(ecological fallacy):地区平均不能直接代表地区里每一个人。若真实访客主要来自一个收入差异很大的社区中的某一小群体,用全社区属性代入就会偏离真实到访者。访客平均来自较富社区,也不能自动写成到访者本人更富。
其次,样本依赖手机与应用记录,活跃度筛选、住宅建筑过滤又进一步改变了保留群体。夜间工作者、多居所者、低设备使用者与边缘地区住户可能更容易被漏掉。人口分布相关只检查了一部分聚合一致性。
最后,研究只纳入居住在相应都市区内部的访客。外地游客、跨都市区通勤者等不在同一口径内。某地实际人流很多,而数据中的访客不多,既可能来自样本遗漏,也可能来自研究边界。
代码公开复现的是访客画像的计算,原始 PlaceIQ 记录为商业产品,不能仅凭公开代码恢复相同的个体轨迹。数据把传统统计与移动联系接到一起,价值在于提供可分析的地区互动层,而不是宣布已经测量了每个人的身份。
一句话总结
认识一个地方,既要看谁住在那里,也要看它连接哪些来访社区;这层联系能丰富普查,却仍是社区属性的加权代理,不能冒充个人调查。
核心来源
- Xiong, M., Zhu, D. & Van Riper, D.(2025)原论文及完整图表,Scientific Data 12, 1106。本文图 1—7 均源自原论文。
- 访客普查数据归档。
- 公开计算代码。
作者介绍
- Meicheng Xiong:署名明尼苏达大学双城分校地理、环境与社会系,参与研究设计、计算分析、数据处理、可视化与论文写作。
- Di Zhu:署名上述系及明尼苏达人口中心,为通讯作者;参与设计、数据获取、计算分析、写作与经费支持。
- David Van Riper:署名明尼苏达人口中心,参与经费支持、数据解释与稿件修改。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
对公共空间是否促进混合的判断,可以拆成三个层次:不同来源社区的人有没有到访、有没有在相同时段到访,以及到访后是否真正接触。访客来源更丰富,最多先支持第一层;逐小时数据可以帮助接近第二层,但 CBG 仍可能容纳彼此分离的多个场所,不能直接证明交流发生。
一种更严谨的研究路径,是先用访客普查筛出来源明显多样化的地点,再结合具体设施边界、停留时间与自愿参与的现场调查,检验共同在场是否转化为交往。这样能把这份数据用作提出可验证问题的入口,避免把来源社区的统计多样性直接写成现实中的社会融合。