人群的距离长尾,为什么不等于每个人的旅行规律?
论文名片|Xiao-Yong Yan、Xiao-Pu Han、Bing-Hong Wang、Tao Zhou,Diversity of individual mobility patterns and emergence of aggregated scaling laws,Scientific Reports,2013,3:2678。DOI。
每天去同一所学校的人,可能在十几公里附近留下一个很高的距离峰值;每天到另一座镇上班的人,峰值可能出现在三十多公里。把许多不同峰值叠在一起,整体却可能变成一条平滑的长尾。
这篇论文用有明确出行目的和起讫点的日记资料,检查个人分布与总体分布是否真的一样,再从时间、金钱和交通方式混合的角度解释总体规律。它最明确的提醒是:总体分布可以很整齐,组成总体的人却不必遵循同一条曲线。
先说结论
- 瑞士 230 名志愿者的六周日记中,202 人的位移分布在论文采用的检验下不支持幂律,占 87.8%;不能把剩下的人直接认定为已经证实遵循幂律。
- 学生的主导行程平均占比为 0.444,雇员组为 0.265,其他组为 0.164,显示日常活动组织方式差别明显。
- 合并 36,761 次行程后,总体分布可用带指数截断的幂律近似,个人不具备的外形可以在人群层面出现。
- 最大熵与出行成本假设提供一种可推导的解释,单一交通方式数据也表现出近似指数形态;这些支持没有排除所有其他机制,更没有证明所有人的成本函数相同。
为什么重新回到出行日记?
两次手机通信的位置差,可能只是一次行程的局部,也可能横跨几次活动。纸币和出租车轨迹还会把不同人的移动串接起来。若要讨论一个人的有目的出行,明确起点、终点和活动目的就很重要。
研究使用 2003 年 8—12 月在瑞士 Frauenfeld 及周边 Thurgau 地区开展的调查。99 户家庭的 230 名志愿者,在各自六周期间逐日填写纸笔问卷。清理异常、缺失和不明确地址后,保留 36,761 条行程。
位置由地址地理编码,研究报告约 60% 的行程起讫位置误差在 100 米内、90% 在 500 米内。行程长度用经纬度之间的球面距离计算,不是道路实际行驶距离。日记可以更明确地对应一次活动间移动,但仍有自报、定位和有限观察期的误差。
每个人的峰值,是否藏在那条总体曲线里?
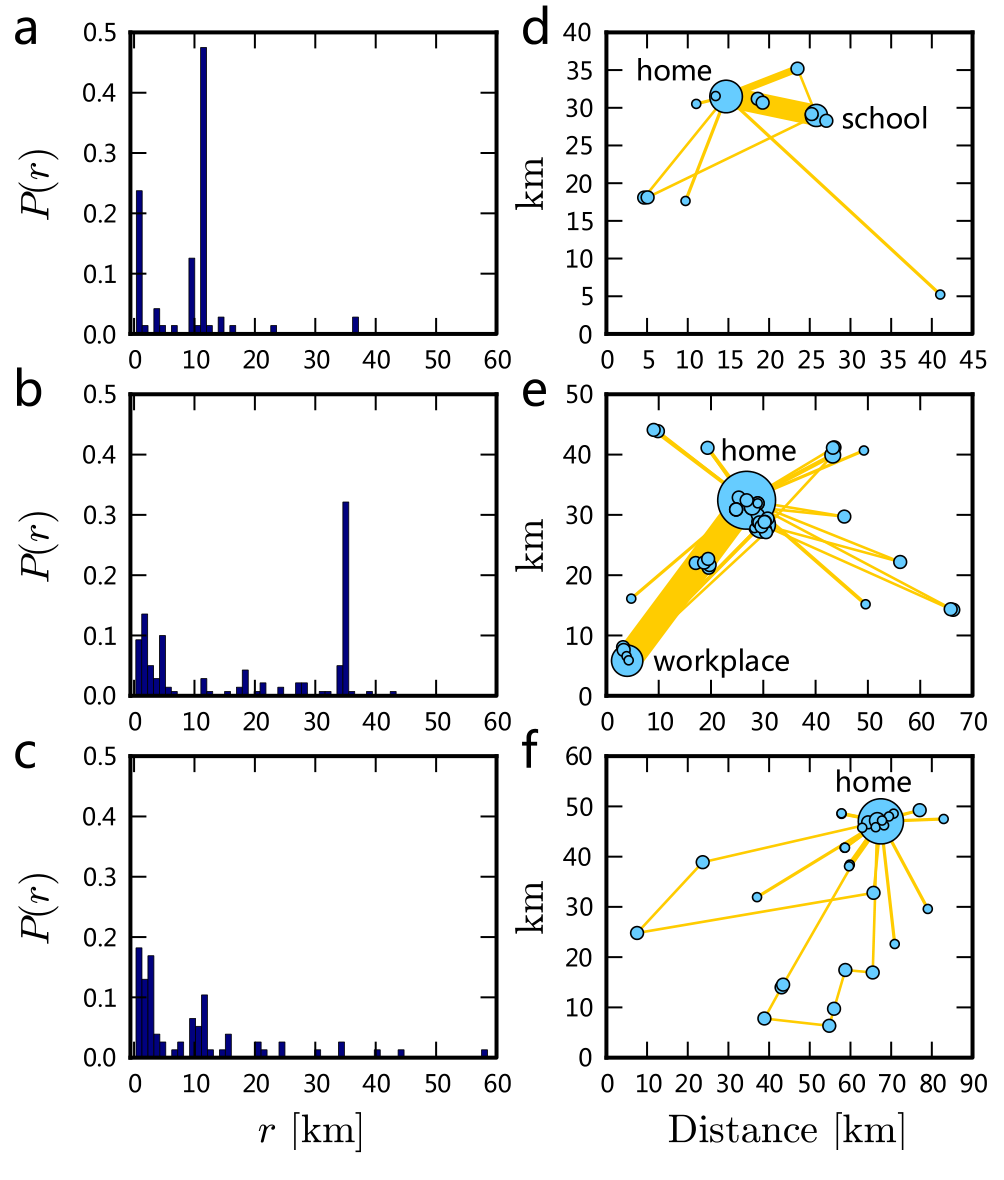
图 1|学生、雇员与退休者的出行分布怎样不同?
(a—c)分别为一位学生、一位雇员和一位退休者的距离分布,横轴为公里、纵轴为相应概率;前两者出现明显的特定距离峰值,退休者的记录较分散。(d—f)对应同三人的地点网络,节点面积按访问次数、连线宽度按行程次数变化;家与学校或工作地之间的粗连线解释了前两幅的峰值。网络线段表示起讫联系,不是真实道路路线。来源:原论文 Fig. 1。
补充表 S1 列出了全部 230 人的个人距离分布、地理网络和另一种圆形网络布局,避免只凭三个典型案例判断总体。圆形布局为了展示连接结构,将高频地点置于中心,位置和线长不再表示地理距离。
每个人访问的地点可构成一个移动网络,边的权重表示相应两地之间的行程次数。研究把权重最大的一条边对应的行程称为主导行程(dominant trip),以其权重除以全部边权重,得到主导占比 d。d 衡量一条重复联系有多突出,不是某人所有通勤行程之和,也不是在家停留时间占比。
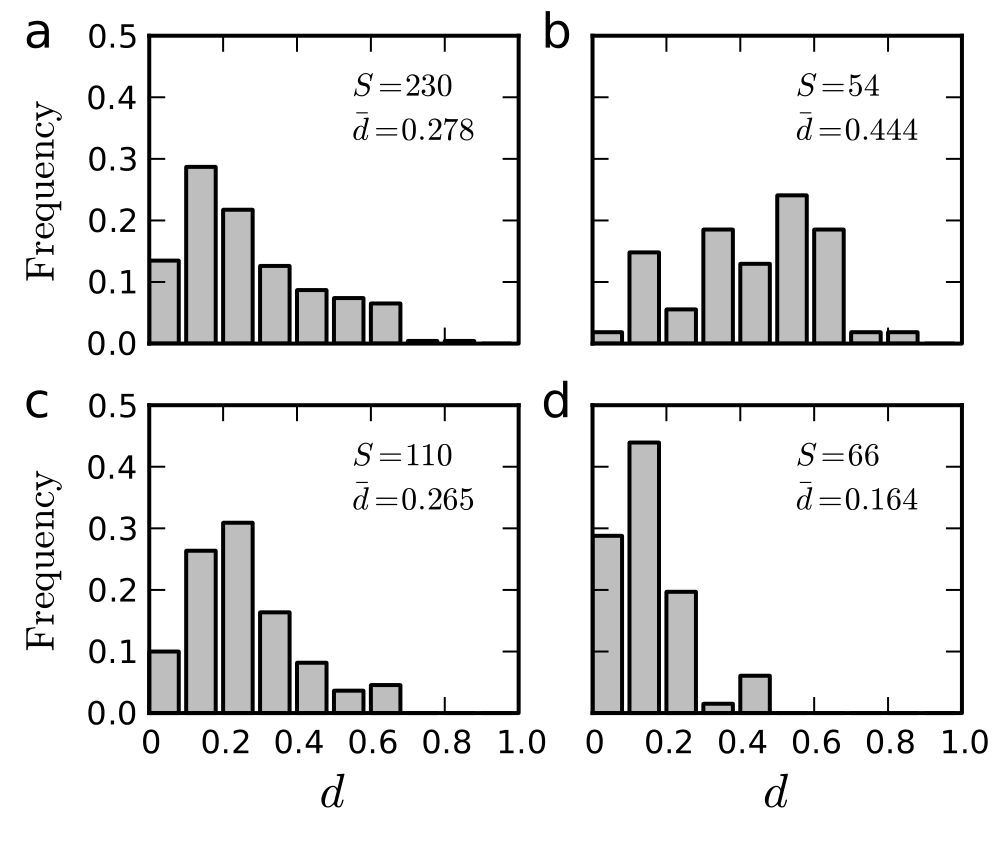
图 2|一条固定联系,在各类人的记录中占多少?
(a)全部 230 人,平均 d=0.278。(b)学生组 54 人,平均 0.444。(c)雇员组 110 人,平均 0.265。(d)其他组 66 人,平均 0.164。横轴为个人 d,纵轴为组内分布频率,S 为组人数。平均值不能解释为每个学生都恰好有 44.4% 的行程属于同一联系。来源:原论文 Fig. 2。
图中类别与补表原始身份标签的粒度不同:学生组人数对应学生与中小学生,雇员组人数还包括学徒;其他组并不只包含退休者,还包括家务劳动者、失业者与身份不详者。不能把这三组当作随机分配的职业实验,也不能据此认定职业本身造成了全部差异。
逐人检验更直接。补表 S2 列出每人的观测数 n、幂律起始下限 xmin、进入尾部的观测数 ntail、指数和检验结果。以 p<0.1 为排除条件,202/230 人未通过。逐人行程数从 53 到 322,不同人的尾部样本有时很少。因此证据支持多数个人分布不符合所检验的幂律形式,但未排除者并不等于已经证明拥有无尺度规律。
为什么合并以后,长尾又出现了?
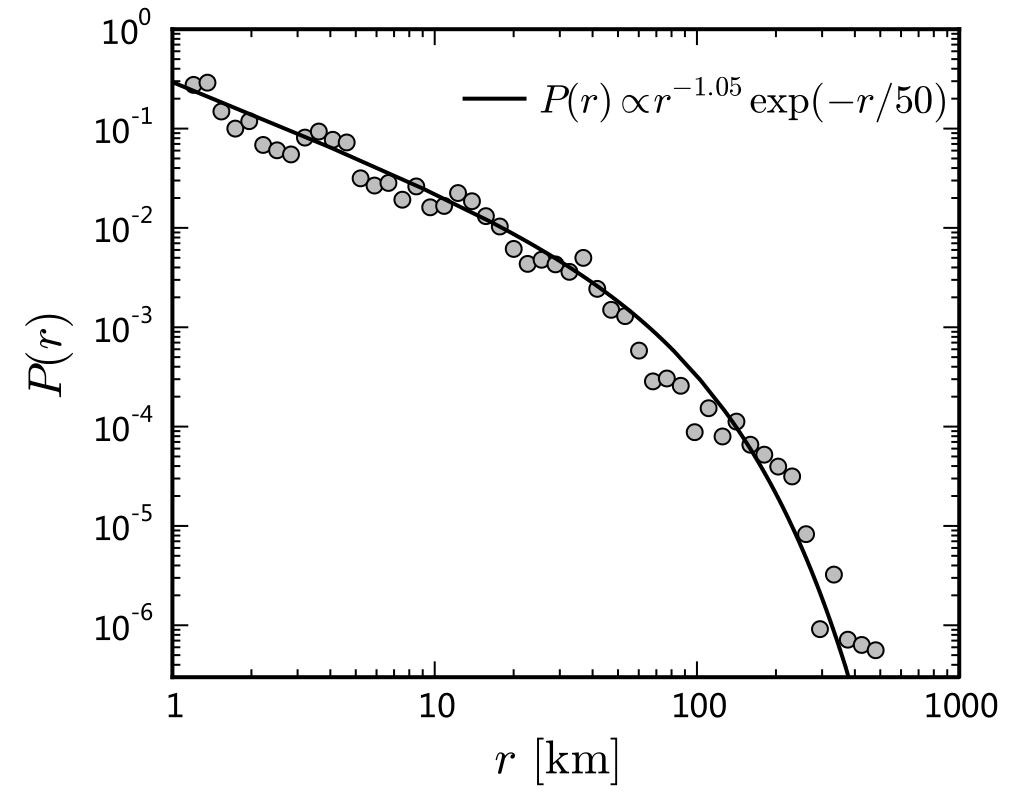
图 3|把不同人的行程放在一起,会出现什么外形?
原图无面板字母。横轴为球面位移距离 r,纵轴为合并行程的概率密度,双轴采用对数尺度;圆点为对数分箱后的数据,黑线近似为 P(r)∝r⁻¹·⁰⁵ exp(−r/50),r 用公里计。尾部最终更快衰减,不能解释成无限延伸的纯幂律。来源:原论文 Fig. 3。
总体分布按行程汇总,出行次数多的人贡献更多记录,不是先让每个人等权再平均。分箱时还要除以箱宽和总观测数,避免把宽箱中的更多记录误读为更高密度。
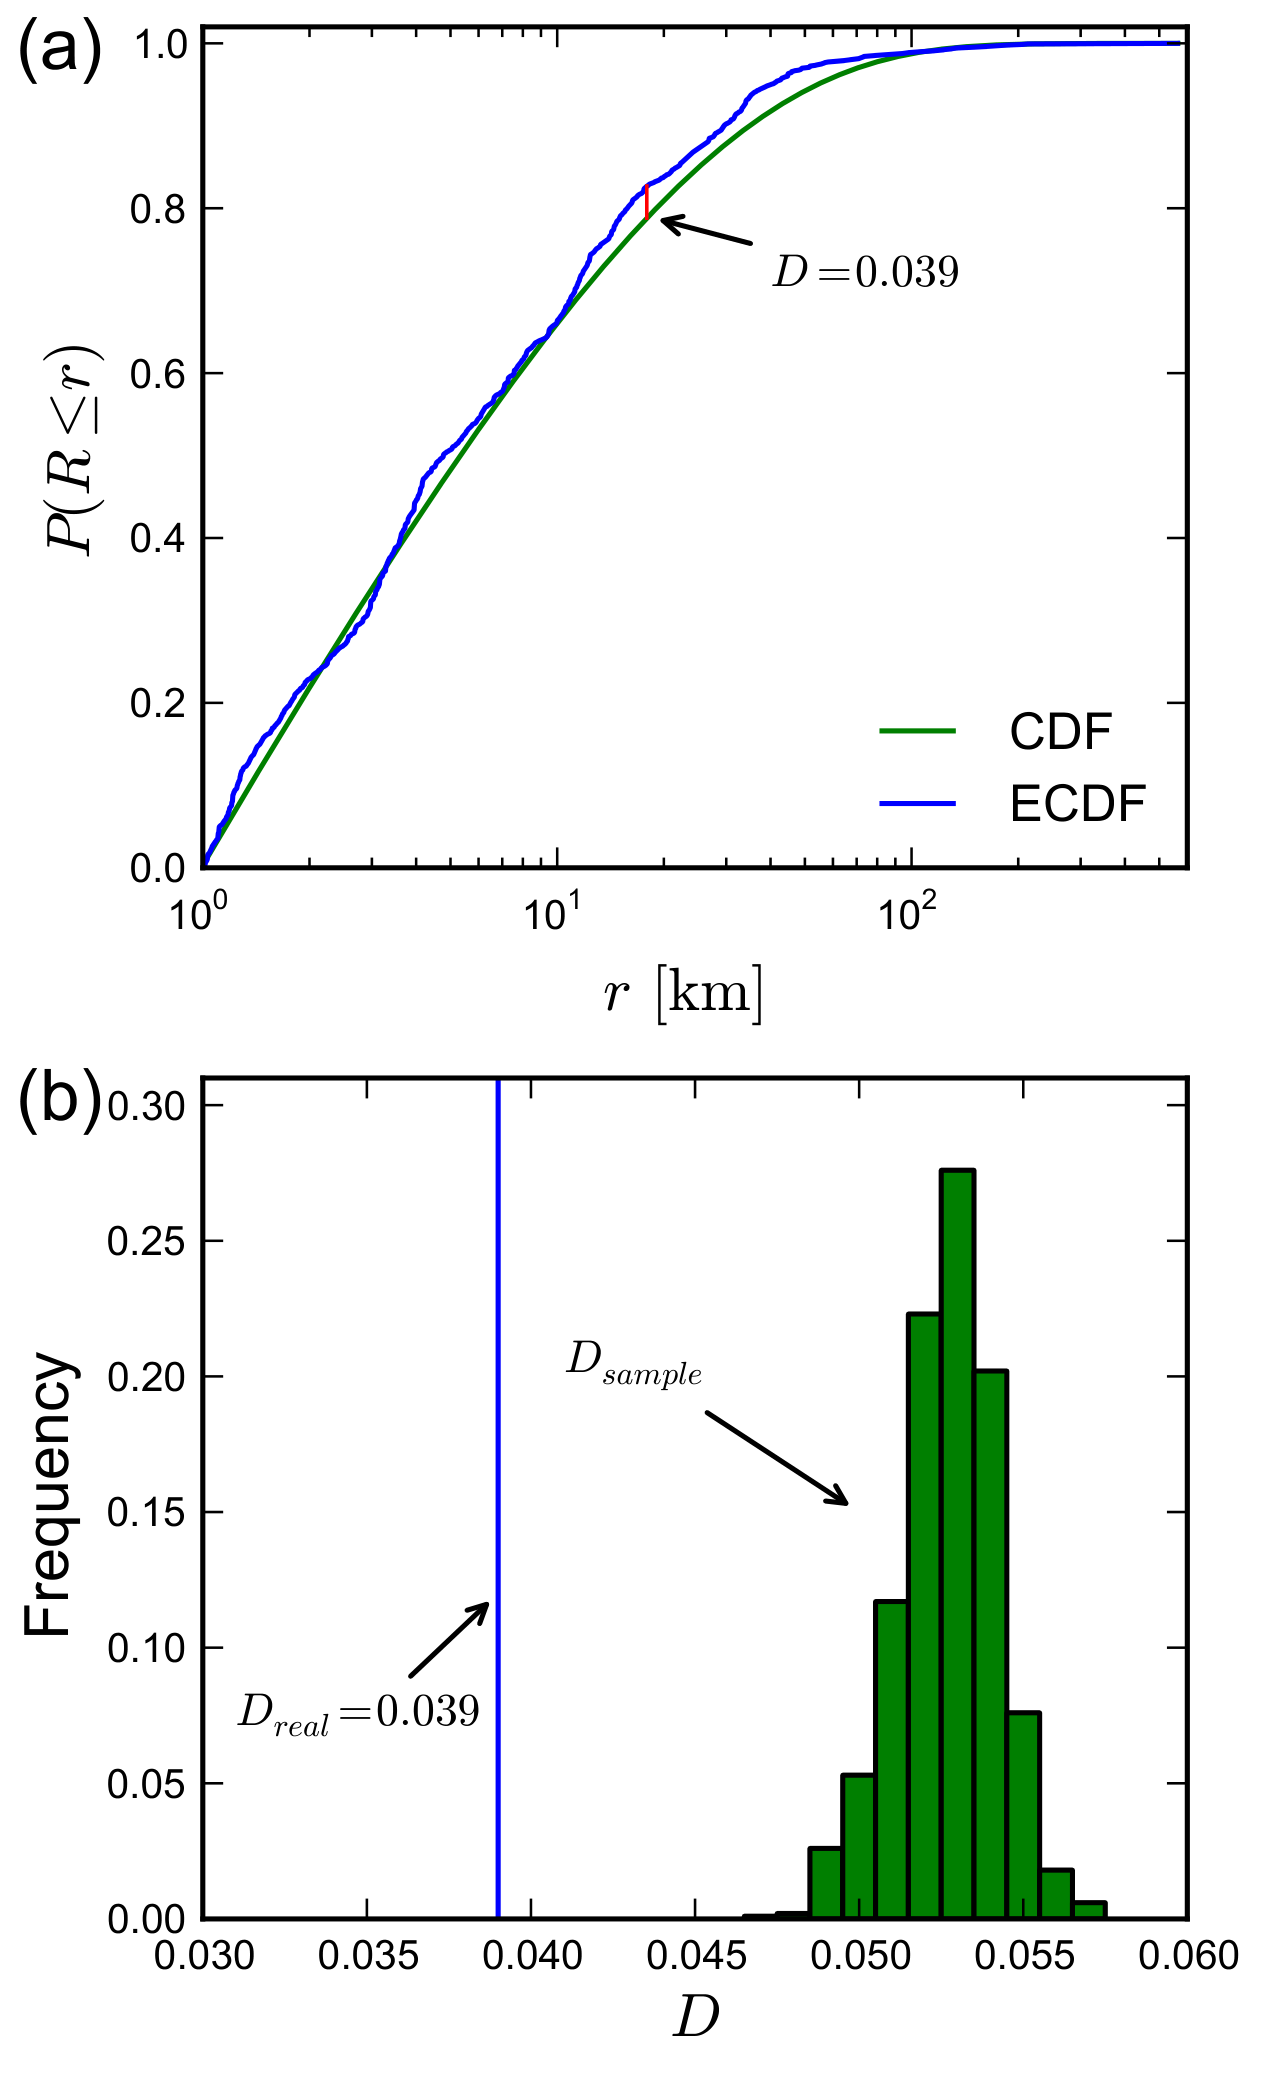
图 S1|拟合与总体数据的距离有多大?
(a)绿线为拟合累计分布,蓝线为经验累计分布,最大差异 D=0.039。(b)从拟合中独立生成 1,000 份合成样本,其 KS 差异分布以绿色柱表示,实际差异为蓝线;论文报告 p=1.000。它是在所用检验下没有排除拟合,不是拟合正确的概率为 100%,也没有排除其他候选分布。来源:补充材料 Fig. S1。
个人层面与总体层面的结论并不矛盾。个人有特定活动联系、交通方式和距离尺度,人群混合后可能变得平滑。真正需要解释的是这种混合为什么形成特定外形,而非默认每个人都拥有同一外形。
如果时间和金钱有限,距离分布能怎样推出来?
理论从固定总行程数 N 与总出行成本 C 出发。只保留这两个约束,用最大熵原则选择其余信息尽量少的成本分布,会得到 P(c)∝exp(−c/平均成本)。这是一种在给定约束下的统计推导,不是已经测量每个人的心理最优决策。
成本被近似写为时间与金钱的加权和。货币成本近似随距离线性增加;出行时间则采用对数项加线性项的经验形式。直觉是长距离往往改用更快的交通方式,不能把所有距离都按一种速度折算。
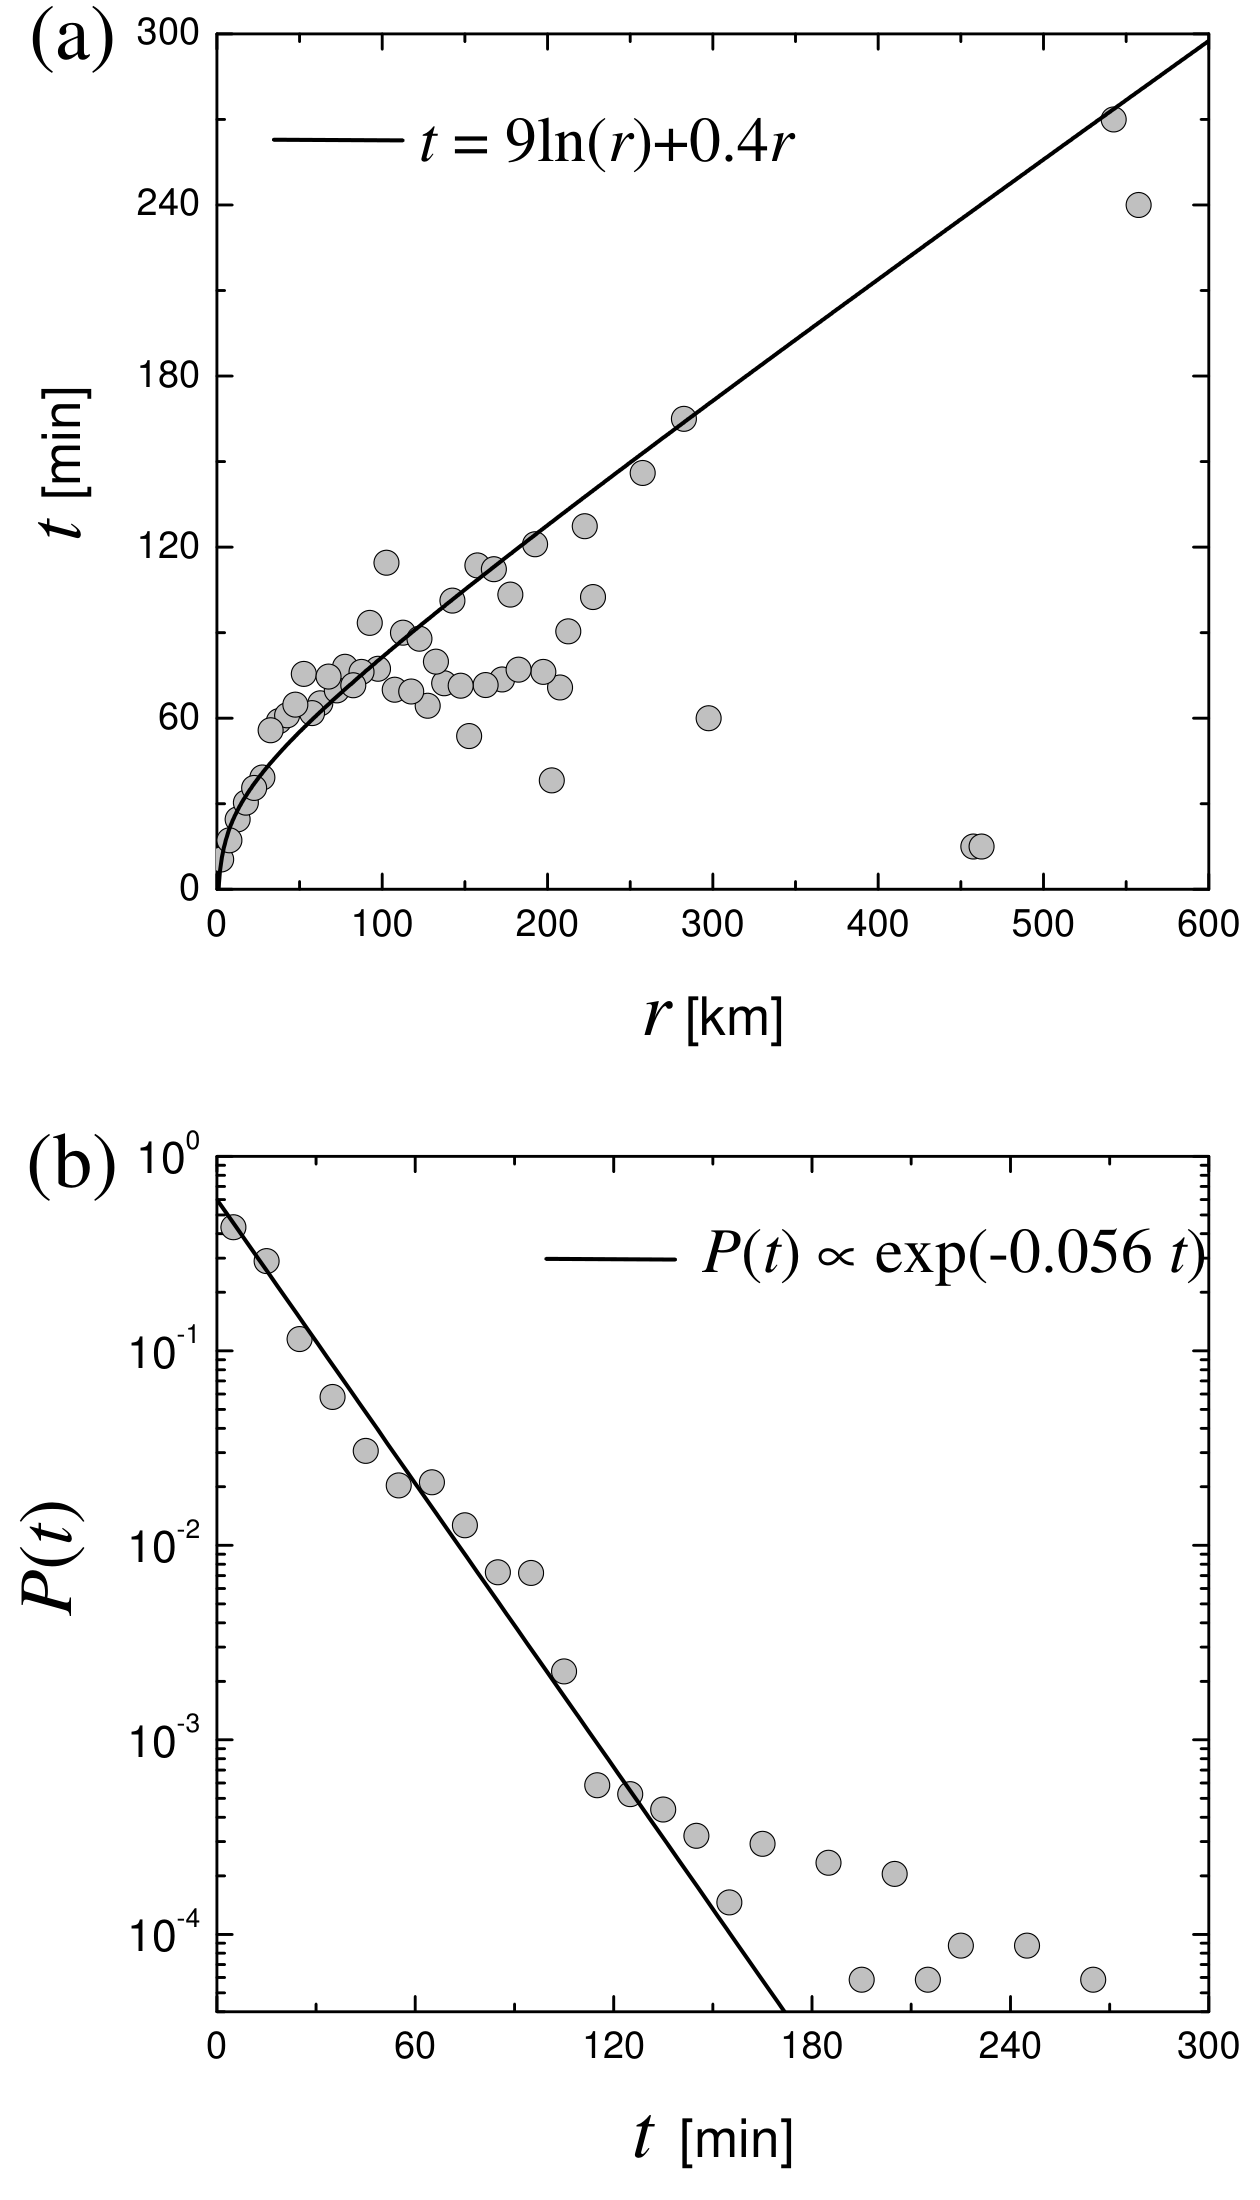
图 S2|时间与距离真的只有固定速度关系吗?
(a)横轴为公里,纵轴为分钟,拟合形式约为 t=9 ln(r)+0.4r,混合短距离和长距离的时间增长。(b)总体时间分布的前半部分近似指数下降,后段偏离。作者也明确承认噪声,例如超过 450 公里却只用约 15 分钟的点不可信;不能把所有散点都当作可靠交通速度观测。来源:补充材料 Fig. S2。
将成本分布变换为距离分布,除了把 c(r) 代入指数,还必须乘上成本对距离的变化率。模型最终得到:
P(r)∝(b/r+1/k) r⁻ᵇ exp(−r/k)。
b 与时间成本中的对数项相关,k 则取决于平均成本和线性成本系数。两者都是组合参数,不能直接读成某位用户的收入或可承受票价。
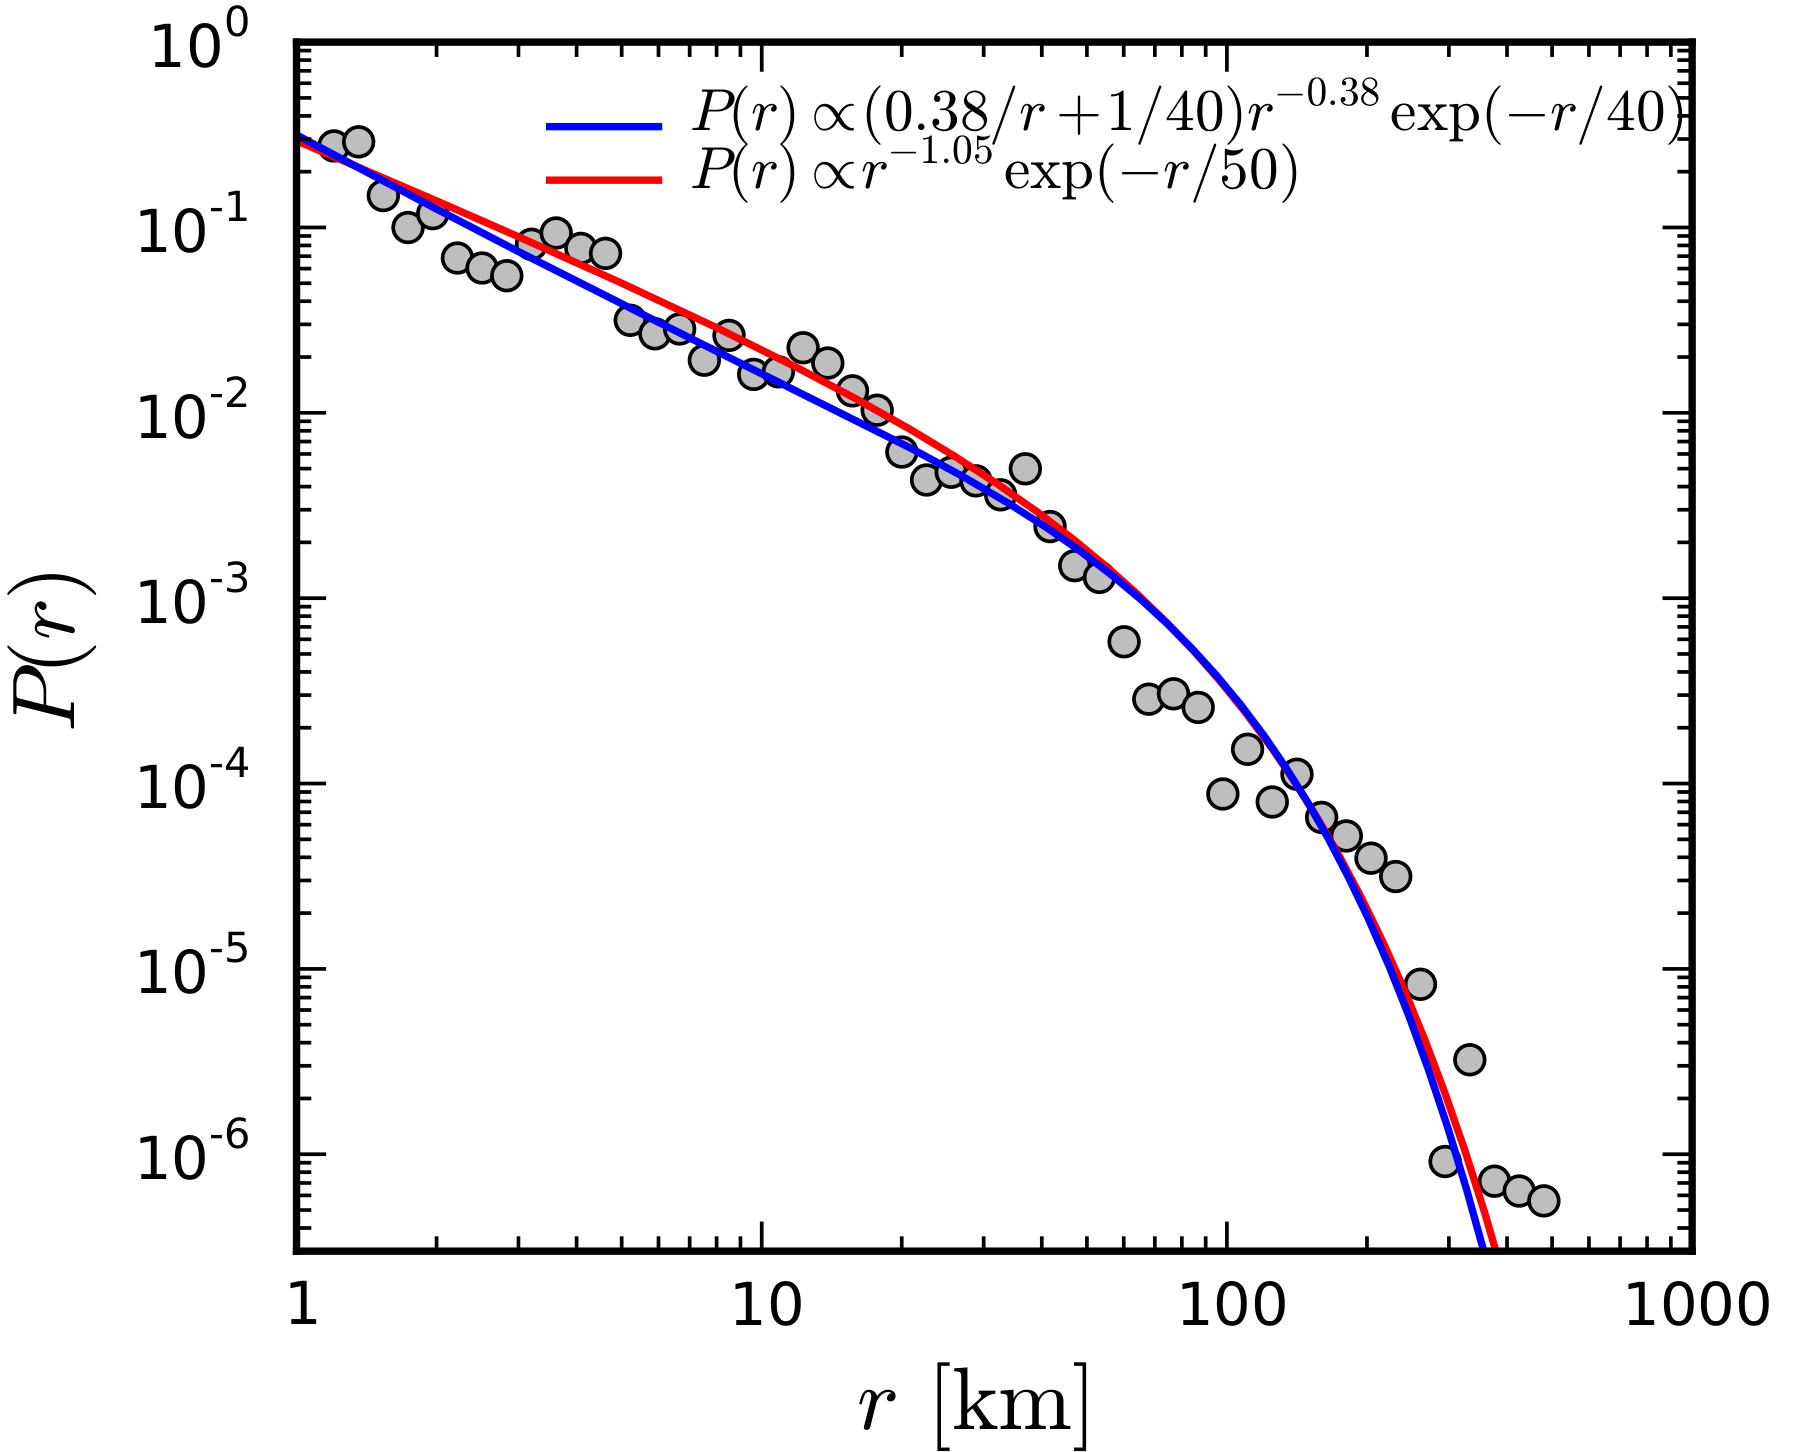
图 S3|理论表达式与简单经验曲线有多接近?
原图无字母。横轴为距离、纵轴为概率密度,蓝线使用 b=0.38、k=40 的完整理论形式,红线为图 3 的指数 1.05、截断尺度 50 公里的经验形式。两者在图上较接近,但参数和表达式不同,不应写成同一个精确解析结果。来源:补充材料 Fig. S3。
何时能把括号中的 1/k 忽略,需要单独检查:b/r 远大于 1/k 等价于 r 远小于 bk。按给出的参数,bk=15.2 公里。正文把这一近似宽泛地用于 100 公里以下,条件并不充分;在 100 公里处,b/r 反而比 1/k 更小。因此应保留完整函数,不能用近似的幂指数 1.38 宣称整个 100 公里范围都已精确推出。
只看一种交通方式,长尾会怎样变化?
如果某种交通方式的单位距离成本近似固定,便有 c∝r,成本指数分布会对应距离指数分布。论文用四组来自不同地区和系统的数据检查这种推论,并未在同一批日记参与者中随机更换交通方式。
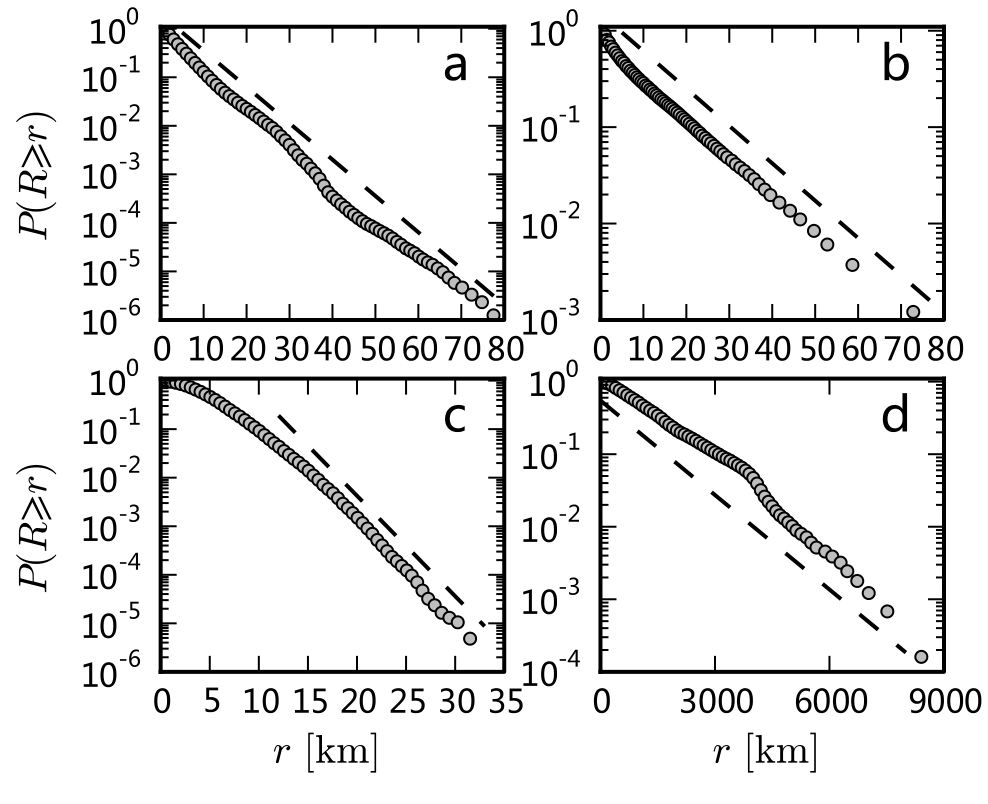
图 4|单一方式的距离是否更接近指数形式?
(a)北京 12,028,929 条出租车载客轨迹;(b)底特律 46,541 次汽车行程;(c)石家庄 783,210 次公交行程;(d)美国 205,534 条航空出行记录。横轴为公里,纵轴为超过给定距离的累计概率,半对数坐标下直线对应指数参照。圆点总体呈近似指数形态,但存在弯曲、局部差异和尾部偏离,不能写成所有区间都精确服从同一指数。来源:原论文 Fig. 4。
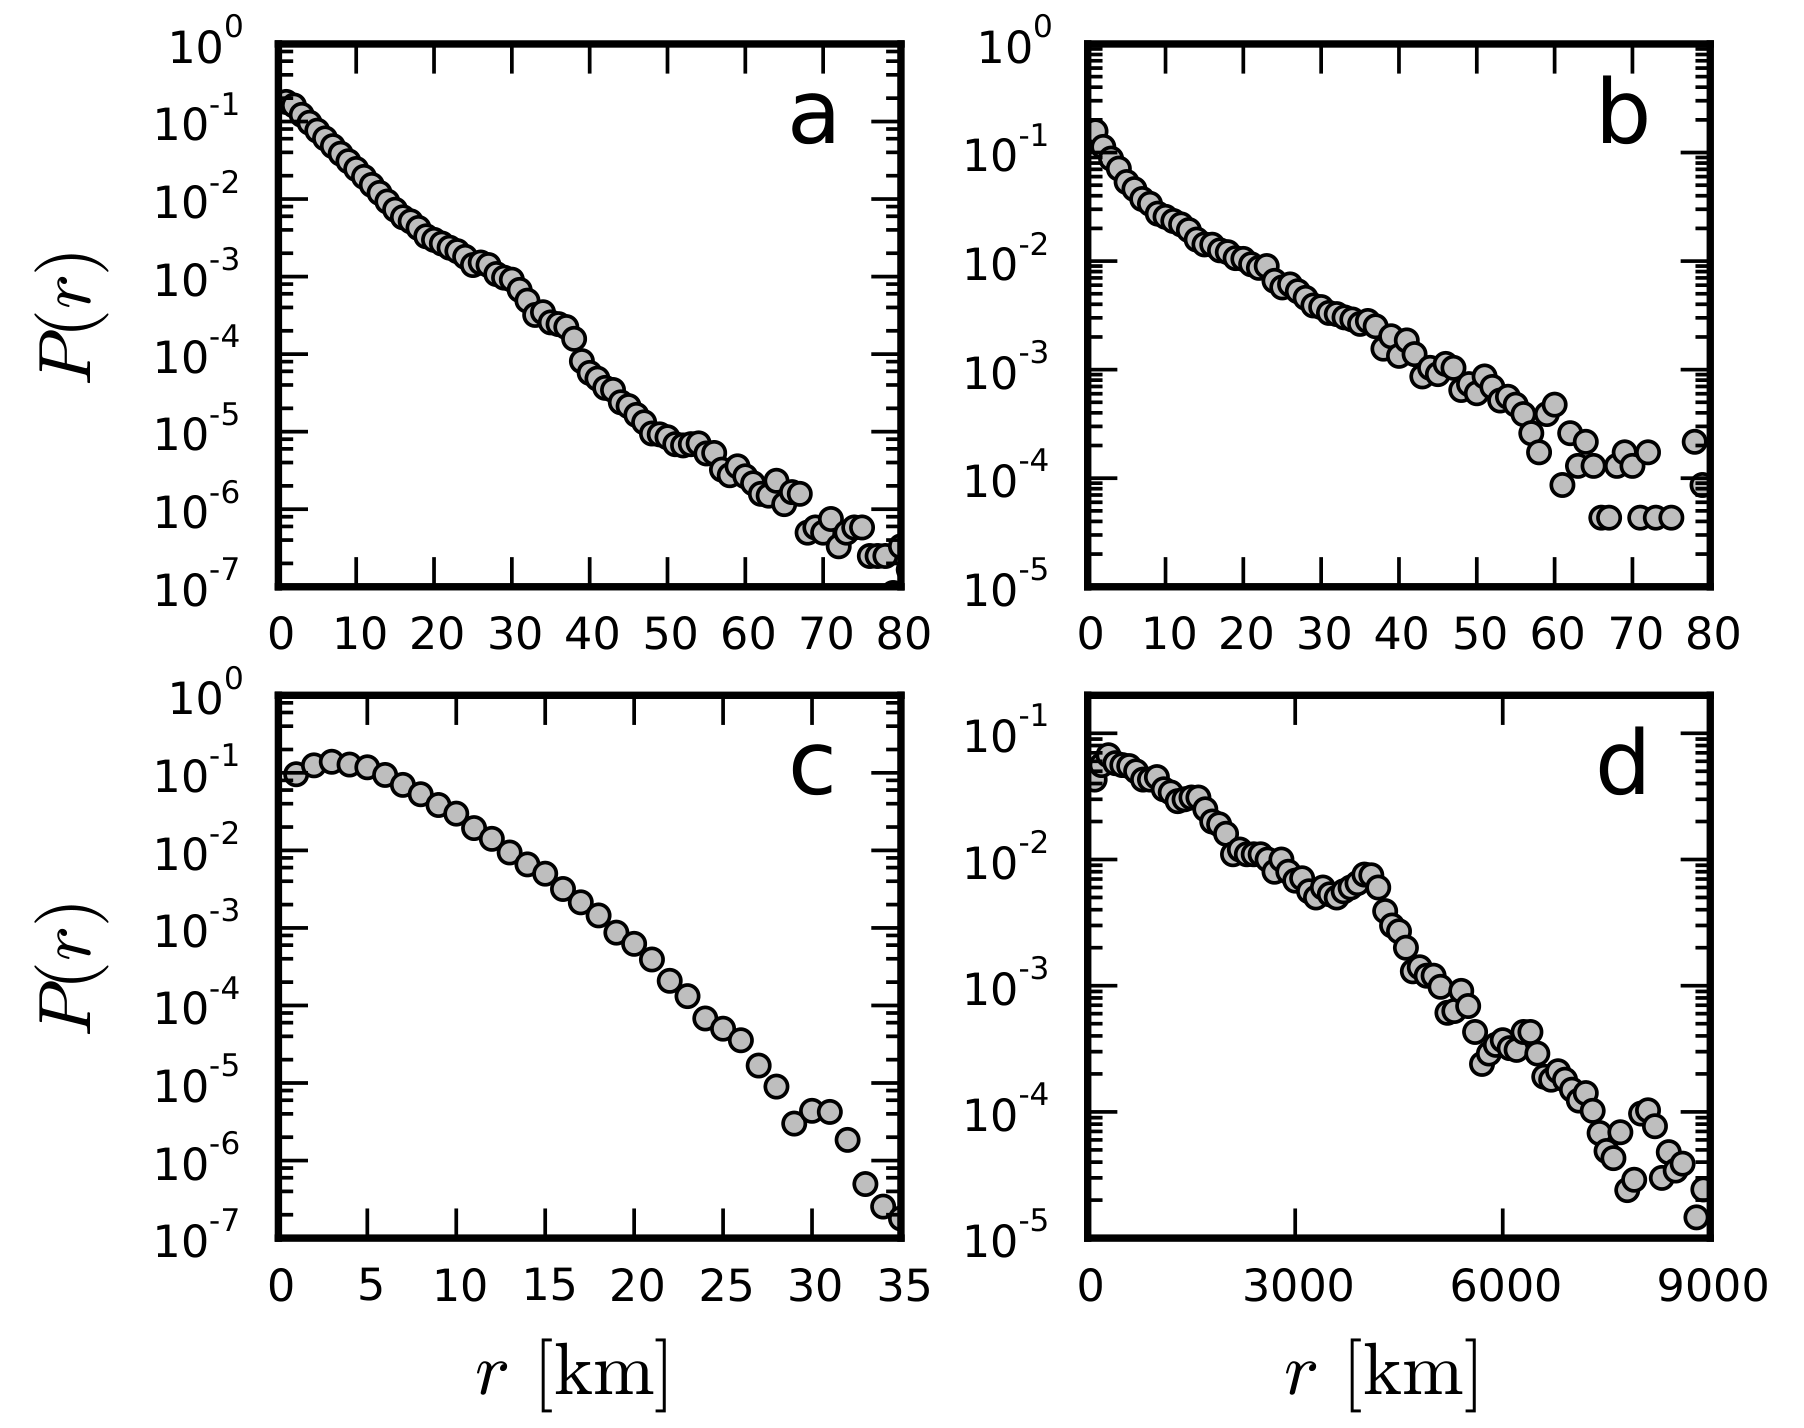
图 S4|不采用累计概率,原始密度还显示什么?
(a—d)顺序与图 4 相同,改用概率密度;出租车与汽车有长距离端噪声,公交在短距离处先出现峰值后下降,航空也不是一条完全笔直的线。四图提醒我们,“近似指数型”不等于所有点都没有特征尺度或局部结构。来源:补充材料 Fig. S4。
四套资料的地区、尺度、采样和出行单位不同,不能把它们当作只改变交通方式、其他条件不变的实验。单一方式近似指数支持成本解释的一部分推论,但没有独立识别时间与金钱的全部权重,也不意味着交通方式是所有总体长尾的唯一原因。
这是否否定了探索与优先返回模型?
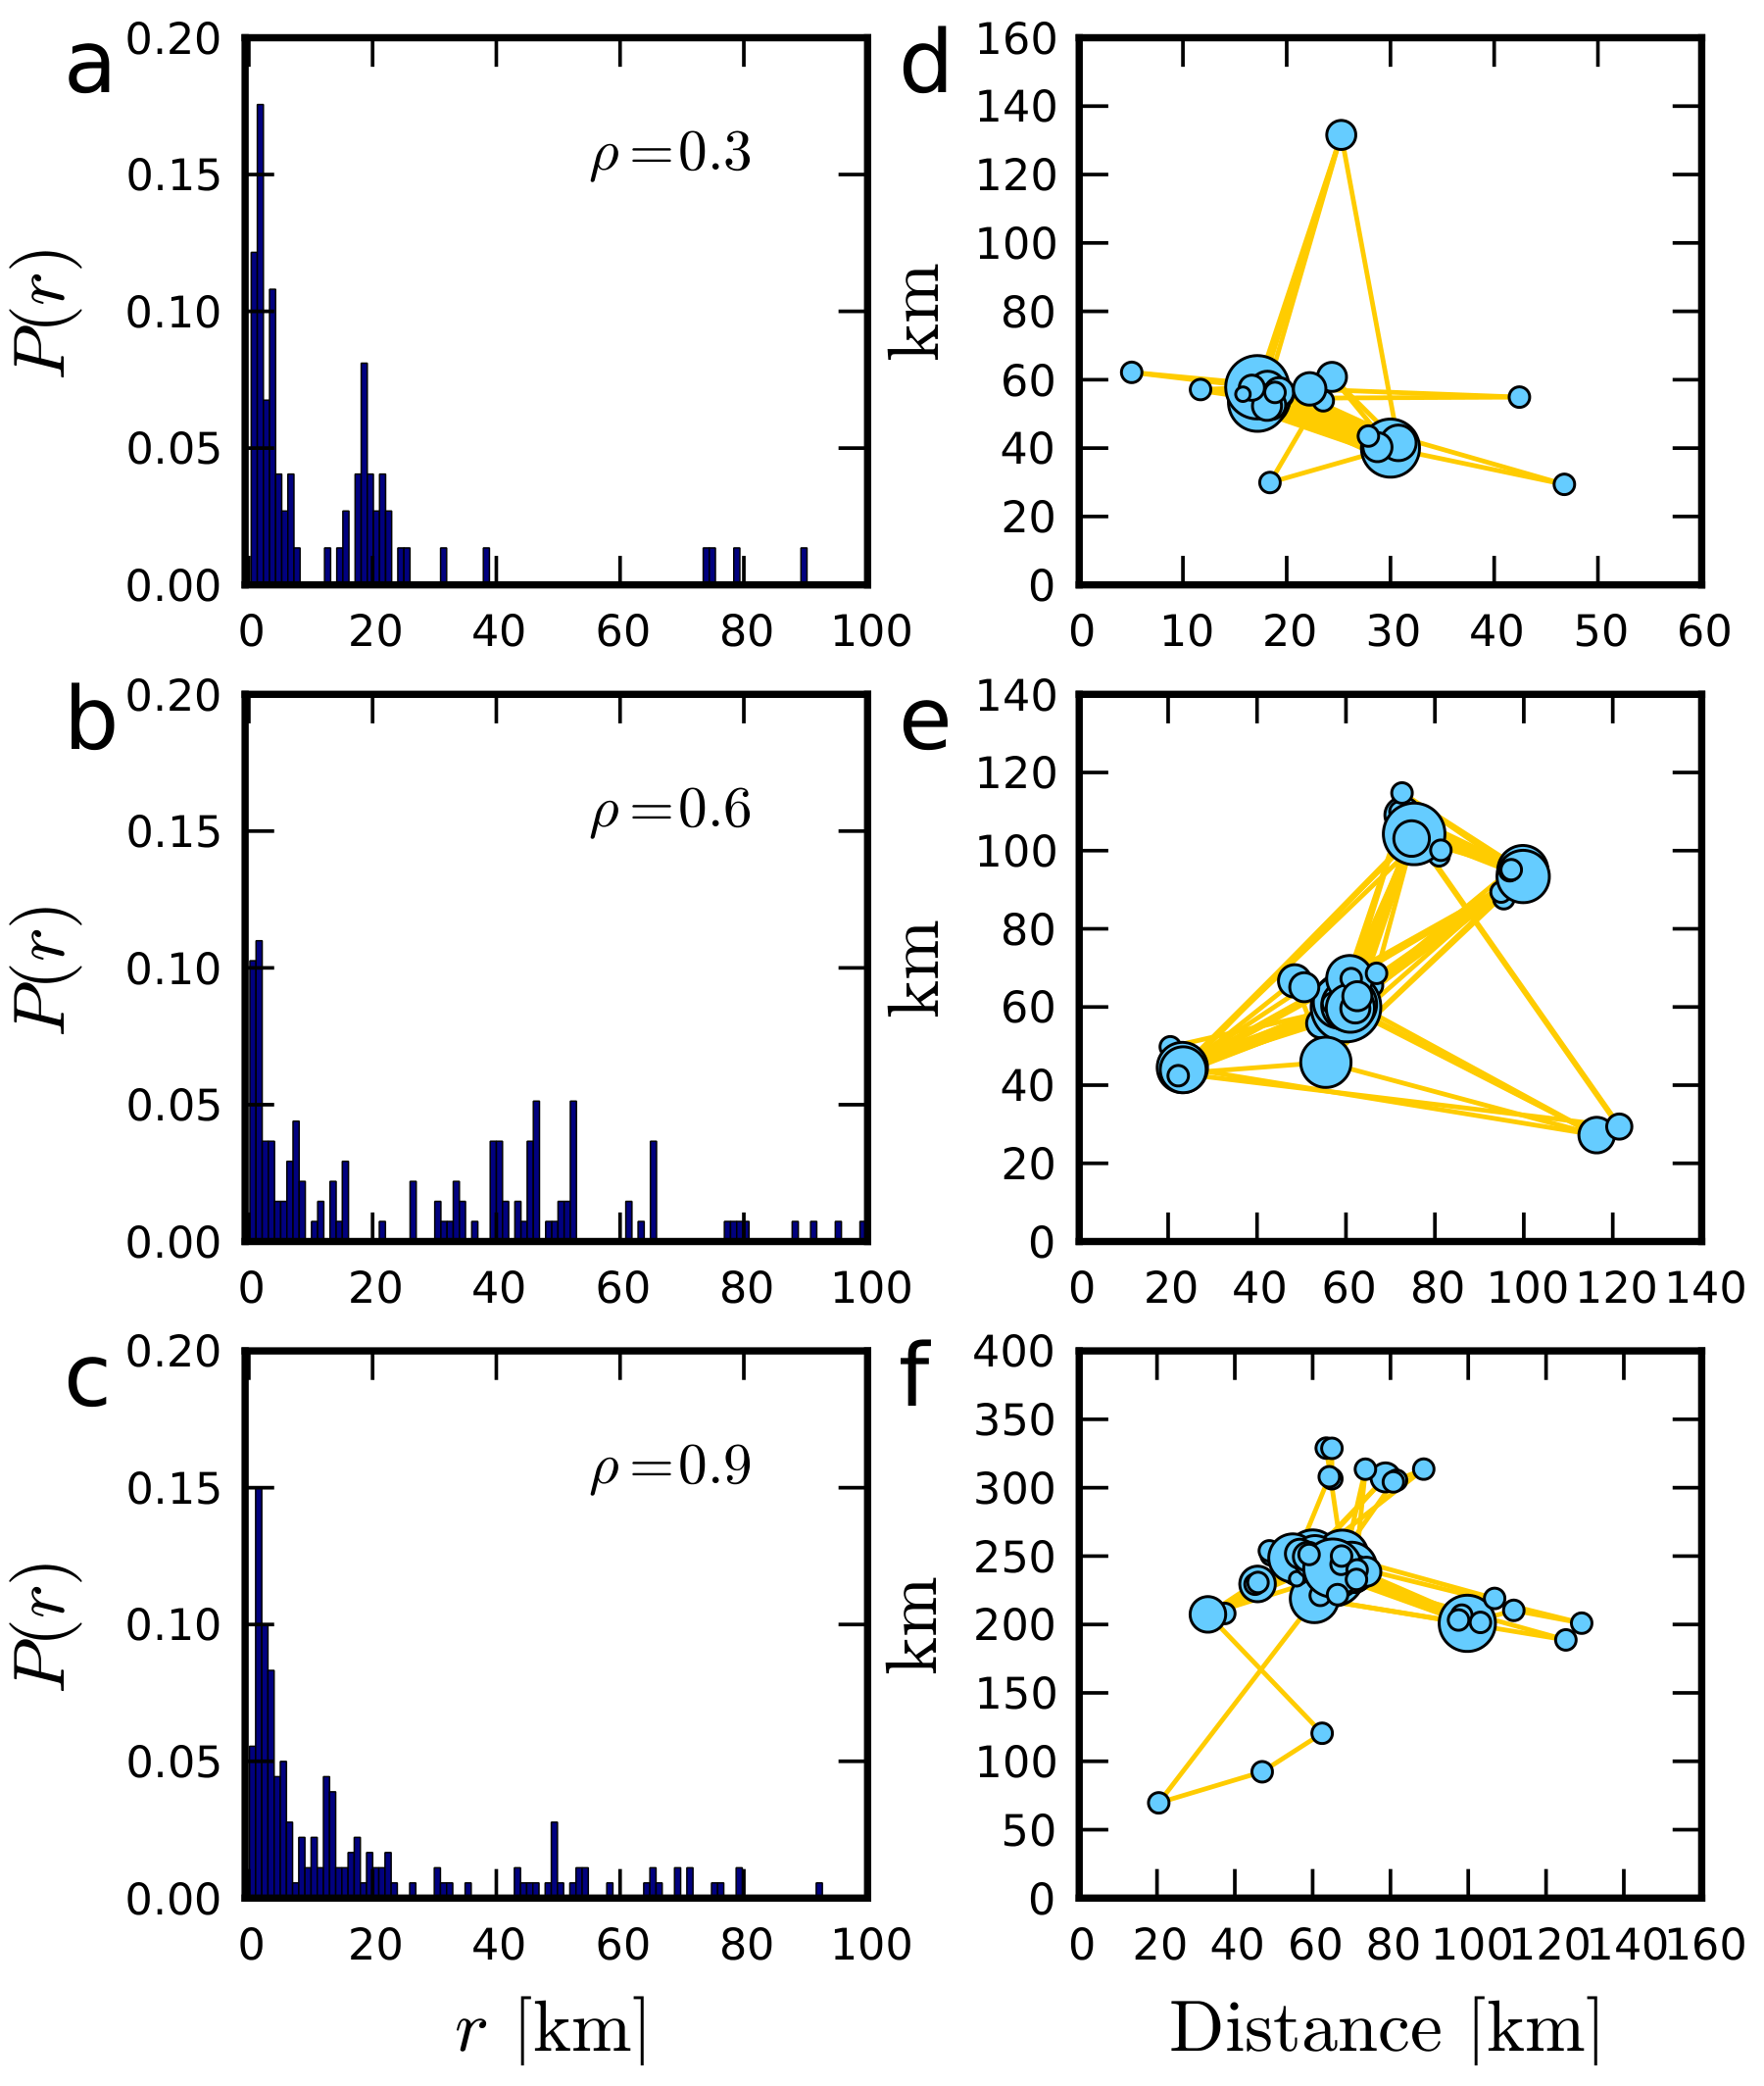
图 S5|已有移动模型能不能生成多样的个人轨迹?
(a—c)三位模拟个体的距离分布,探索参数 ρ 分别为 0.3、0.6、0.9;分布可以出现峰值与差异。(d—f)对应模拟网络,节点面积反映访问、边宽反映联系频次。它们是模型输出,不是调查参与者。来源:补充材料 Fig. S5。
作者实际运行了探索与优先返回模型,并承认它能够产生个人差异。争论不在于这个模型毫无用途,而在于它通常预先假设探索距离具有幂律性质,因而仍需要解释这种输入从何而来。成本理论提供另一条解释线索,没有通过一次拟合就排除探索、返回或交通系统层级等机制。
从这些证据,能够推到哪里?
六周日记比通信事件更接近有目的的行程,但样本只有一个瑞士地区的 99 户家庭。短期样本量、地理编码精度、季节和家庭抽样结构,都会影响逐人分布。没有观察到幂律,并不意味着这个人在其他时期、尺度或活动条件下永远不可能出现相似统计。
本文更可靠的结论,是分清个人与总体层级,并展示一个有明确假设的成本解释。它没有逐人验证完整成本函数,也没有证明某一政策改变票价或时间成本后,真实距离分布必然按理论参数变化。这样的预测仍需独立数据或干预设计。
一句话总结
总体距离分布的长尾可以由不同个人和交通方式混合而成,解释人怎样出行,必须先分清正在讨论一条个人行程规律,还是一群人叠加后的统计外形。
核心来源
Yan, X.-Y., Han, X.-P., Wang, B.-H. & Zhou, T. (2013). Diversity of individual mobility patterns and emergence of aggregated scaling laws. Scientific Reports 3, 2678。论文与补充材料。四张主图与五张补图均来自相应完整原图;逐人分布和检验依据 Supporting Information Tables S1—S2。
作者介绍
- Xiao-Yong Yan(闫小勇):论文署名为电子科技大学互联网科学中心、石家庄铁道大学交通运输工程系及北京师范大学系统科学系。
- Xiao-Pu Han(韩筱璞):论文署名为中国科学技术大学近代物理系,以及杭州师范大学信息经济研究所和阿里巴巴商学院。
- Bing-Hong Wang(汪秉宏):论文署名为中国科学技术大学近代物理系。
- Tao Zhou(周涛):论文署名为电子科技大学互联网科学中心和微软亚洲研究院,为通信作者。以上按论文发表时署名介绍。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
交通模型评估可以同时报告三种权重:按行程汇总、每个人等权,以及按家庭抽样结构加权。三种结果若差别明显,就说明一条看似稳定的曲线仍依赖“谁贡献了更多记录”。这比只比较不同函数拟合优度,更接近理解总体规律从何而来。
检验成本机制还可以设计一项更严格的比较:利用同一批人在票价或服务速度变化前后的资料,观察模型事先给出的距离变化预测是否成立,同时控制出行目的与可选地点。如果只能在已有曲线上调出相似形状,而无法预测变化方向与幅度,成本解释就还停留在相容机制阶段。