每个人都近似随机上线,为什么人群接触仍会时疏时密?
论文名片|Yi-Qing Zhang、Xiang Li、Di Liang、Jin Cui,Characterizing Bursts of Aggregate Pairs With Individual Poissonian Activity and Preferential Mobility,IEEE Communications Letters,2015,19(7):1225—1228。DOI。
一套校园 Wi-Fi 系统里,每个人上线、离线的时间可能没有明显记忆。但把所有用户之间的接触放在一起,仍可能看见大量很短的等待和少数很长的等待。这样的总体长尾,是否说明每个人都遵循同一种突发规律?
这篇论文从个人活动与地点偏好出发,构造一个自下而上的模型,说明个体简单、整体复杂可以同时发生。它也提醒我们区分个人活动、某一对人的接触和全部用户对的汇总,三者不是同一种统计对象。
先说结论
- 复旦校园 Wi-Fi 数据中,多数个人的接入持续时间和日等待间隔更适合指数候选,而汇总用户对的等待间隔更偏向长尾候选。
- 当个人活跃概率不同、又高度偏爱特定地点时,独立的个人活动可以混合出汇总接触间隔的长尾,不需要先假设每个人本身就有相同幂律。
- 模型在强地点偏好条件下,推导出等待间隔互补累积分布约按 ln(δ)/δ² 衰减;接触持续时间的理论尾部约按 Δ⁻³ 衰减。这些是累计尾部关系,不能直接当作概率密度指数。
- 模拟支持这种机制的可能性,但有限参数下的拟合指数仍偏离极限;Wi-Fi 共现也不等于已验证的面对面接触或实际无线传输。
校园记录里,一次接触究竟指什么?
实证部分使用 FudanWiFi09 中 685 名用户在六栋公共教学楼内的十周接入记录,构成包含 938 对用户、21,453 条交互记录的机会网络。论文前文也用约两个月概述时间,此处采用方法部分更具体的十周口径。
研究依据地理共现来生成交互:把接入点 AP 当作地点,依据用户在同一地点的活动重叠推定接触。因此,这些数据代表 Wi-Fi 系统能观察到的共现,不保证两人认识、实际面对面交谈,或设备之间已经成功交换数据。教学楼之外和未接入网络时的行为,也不在记录之中。
接触持续时间 Δ,是一次用户对连接延续多久;等待间隔 δ,从上一次接触结束算到下一次开始,不包含上一段接触本身。它们与个人一次接入多久、个人两次接入之间等多久,分别处于用户对和个人两个层级。
个体近似指数,汇总数据为什么还能长尾?
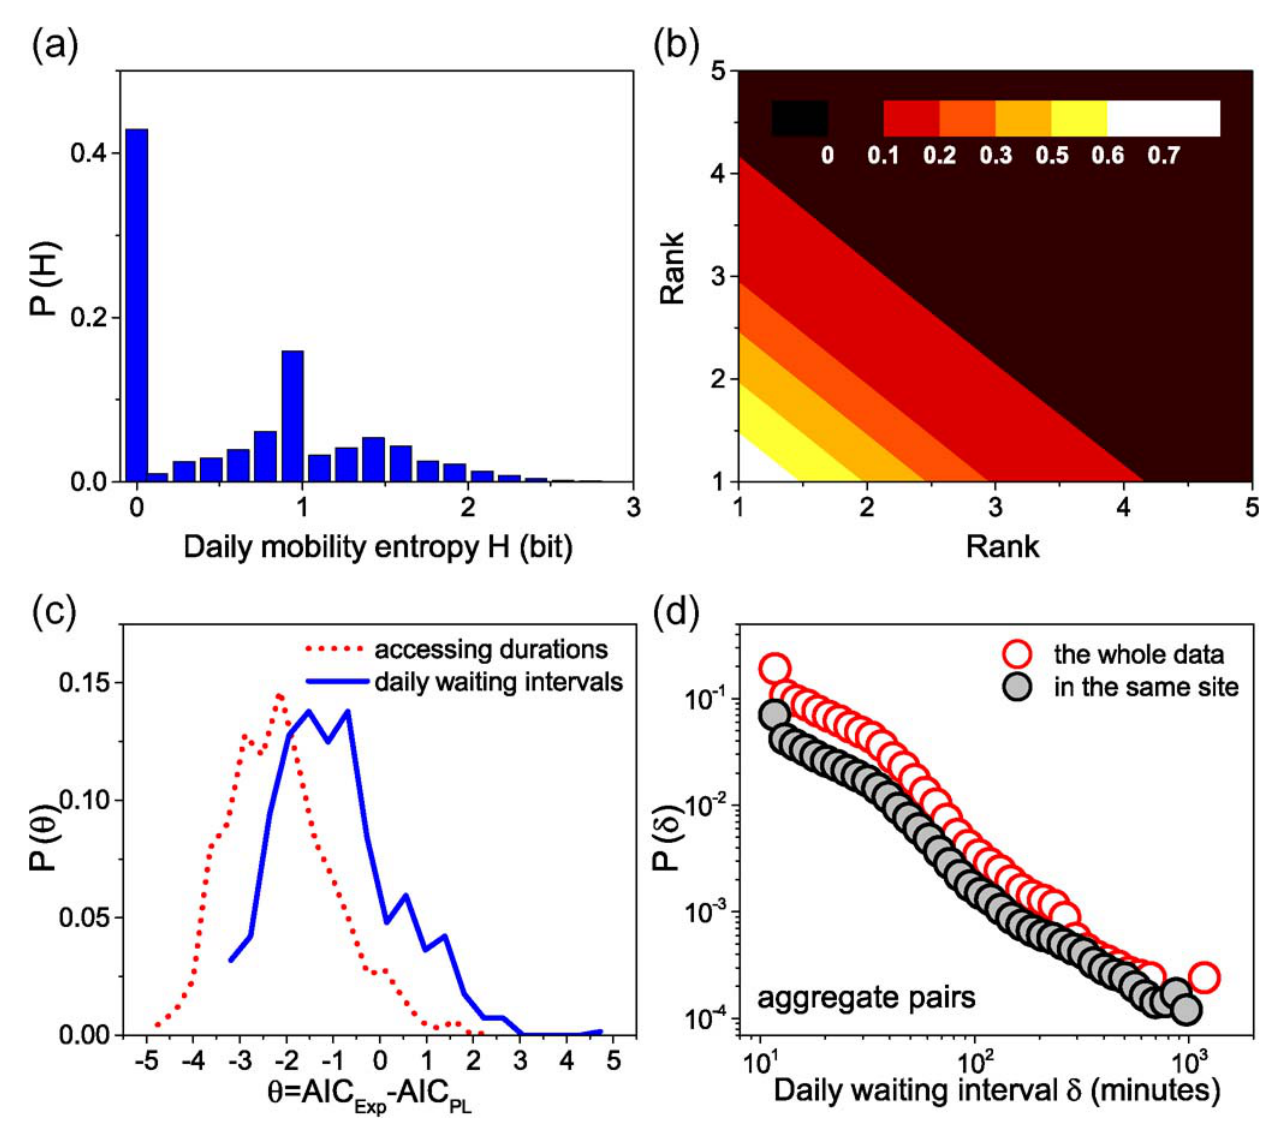
图 1|个人活动与全部用户对的统计是否一致?
(a)横轴为每日移动熵 H,纵轴为分布。超过 40% 的记录质量集中在 H=0,表示对应用户日的接入时长集中于一个 AP,不能解释成这些人在现实中完全不移动。(b)两名用户各自按当日接入时长排列地点,横纵轴为地点排名,颜色表示交互发生比例;高频地点之间的共现更突出。
(c)横轴为 θ=AIC指数−AIC幂律,纵轴为 θ 的分布;红虚线为个人接入持续时间,蓝线为个人日等待间隔。负值支持指数候选。(d)红空心圈为全部用户对、黑实心圈为在同一地点交互的汇总等待间隔分布;横轴为分钟,纵轴为分布,两者都有较长尾部。来源:原论文 Fig. 1。
移动熵(mobility entropy)由每天在各 AP 的接入时长占比计算。H=0 只意味着观测到一个地点;接入较少或覆盖较窄,也可能让人的真实移动在系统中不可见。
指数模型在 91% 的个人接入持续时间曲线、79% 的个人日等待间隔曲线中获得更低 AIC。AIC 比较的是两个候选模型的相对表现,不是“通过率等于拟合准确率”,也不能单独证明过程完全独立、平稳、无记忆。论文据此把大部分个体活动称为泊松型,证据应理解为与这种近似相容。
汇总等待间隔的指数与幂律 AIC 差约为 3.07;同一地点子集约为 3.09,均偏向幂律候选。数值支持个人与总体不必同形,没有排除截断分布、日程变化或其他混合机制。图 1d 展示的是实证分布,后面的定理才推导互补累积分布,不能把两者纵轴口径混用。
一个模型怎样把个人活动变成用户对接触?
模型名为个人泊松型活动与偏好移动模型(IPAPM)。网络节点表示地点,边权表示移动所需时间。每人预先分配一个偏好地点,初始位于那里,并分配一个固定活跃概率 α;不同人的 α 在 0 与 1 之间均匀分布。
每个离散时刻,个人依照自身 α 独立活动。两人需要同时活跃且处于同一地点,才产生一次接触;移动途中不能活跃。地点偏好参数 p 控制离开后选择偏好地点的倾向,越接近 1,个人越少离开熟悉据点。
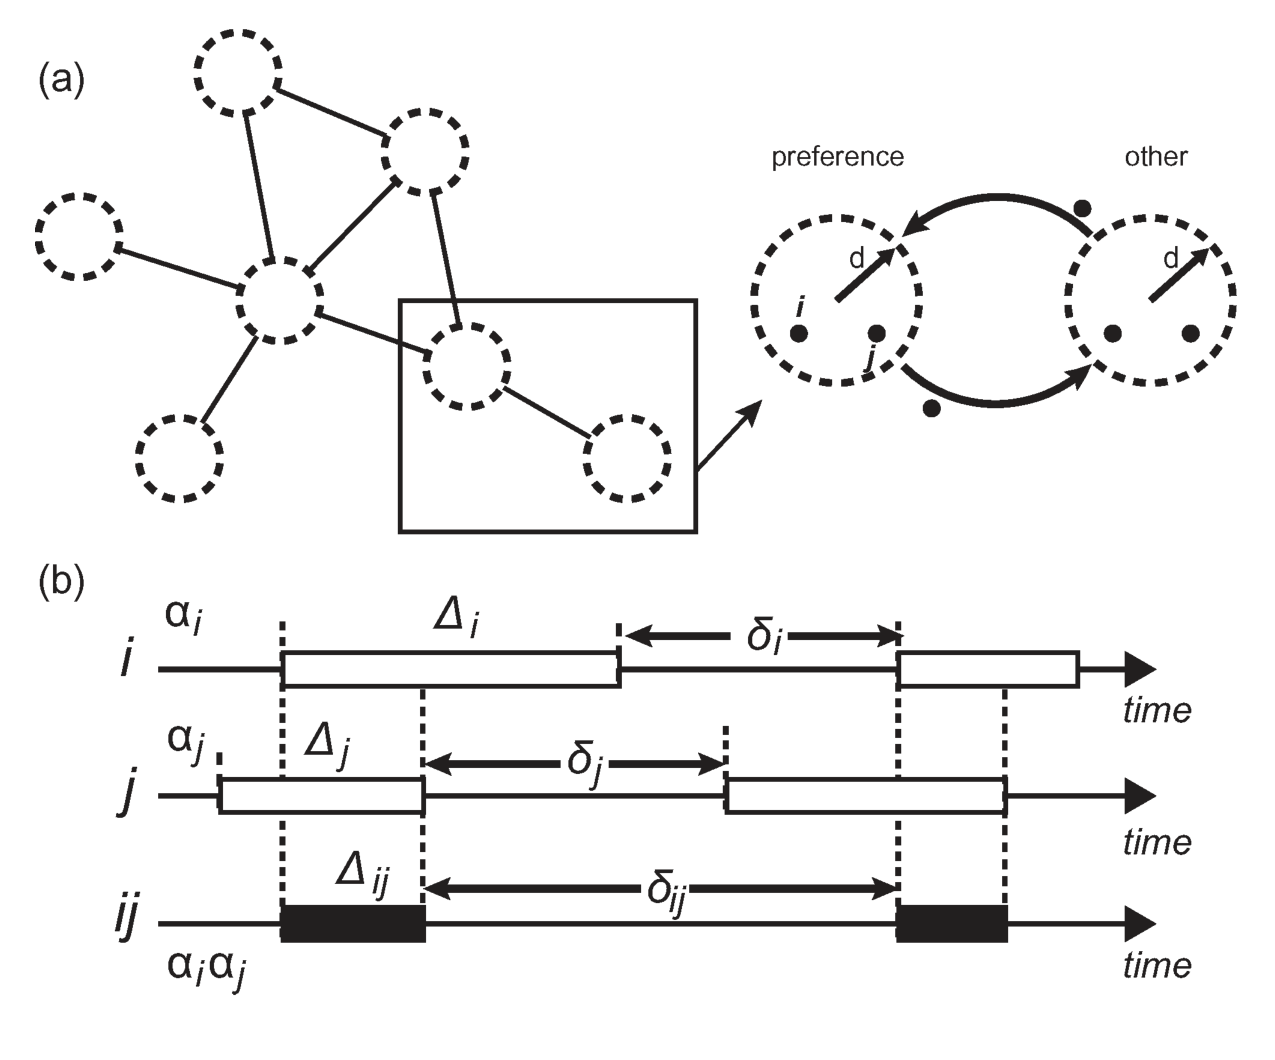
图 2|个人上线时间怎样拼成一段接触?
(a)左侧地点网络的边表示可移动联系,右侧放大偏好地点与其他地点,展示个人在地点之间选择。(b)前两条时间线为用户 i、j 的活跃区间,Δi、Δj 是个人持续时间,δi、δj 是个人等待;最下方黑色区间为两者同时活跃的重叠,形成接触 Δij,其间空白形成用户对等待 δij。来源:原论文 Fig. 2。
在两人基本停留于同一偏好地点的极限下,令 q=αiαj。单对用户每个时刻共同活跃的概率固定,连续接触长度与非接触长度分别遵循几何分布。它们都是离散时间的无记忆分布,是这里理解“个人泊松型”的更直接方式。
离散独立试验的事件计数本来是二项分布,仅仅把观察时间拉长,并不足以自动变成泊松分布;还需要适当的稀疏事件近似条件。因此不必把模型中所有 α 都当成严格连续时间泊松率,核心推论依赖的是独立、异质的活跃概率与由此形成的几何等待。
混合了什么,才会出现长尾?
对某一对用户,q 固定;对全部用户对,q 却随两人的 α 改变。大量不太活跃的组合与少数活跃组合叠加,会产生单个组合没有的总体外形。
汇总所有接触记录时,接触更多的用户对贡献更多事件,不能简单对每对用户等权平均。论文使用按事件率加权的混合公式,将单对的几何尾部与 αi、αj 的联合分布积分。
在 p≈1 的条件下,等待间隔的累计尾部得到 ln(δ)/δ² 型渐近关系。这里 G(δ) 表示等待至少达到相应时长的比例,δ≫1 指远大于模型时间步,而不是直接规定现实中某个分钟阈值。
接触持续时间的积分则得到 Δ⁻³ 型累计尾部。原文部分积分表达式省略了整体归一化常数,因此不能直接把未归一化式当作从最小时间起就精确成立的完整概率;常数不改变本文讨论的远尾幂次。理论讨论的是一组指定活跃度分布下可以产生什么,并未从校园数据中逐人估计和确认均匀分布的 α。
等待与持续时间对地点偏好的依赖不同:前者还包括两人何时重新在同地出现,强偏好让这个空间过程更容易简化;后者在同地同时活跃已经发生后,受两人活跃重叠控制。论文据此预测持续时间尾部对 p 更不敏感,但这不能扩大为整个经验分布对移动完全不敏感。
模拟离理论极限有多近?
模拟使用 700 个体、100 个地点的完全连接网络,所有移动边权相同为 10,观察窗口 T=1,020,个人 α 独立均匀取值。地点结构和速度高度简化,模拟时间步也不能直接换成现实分钟。
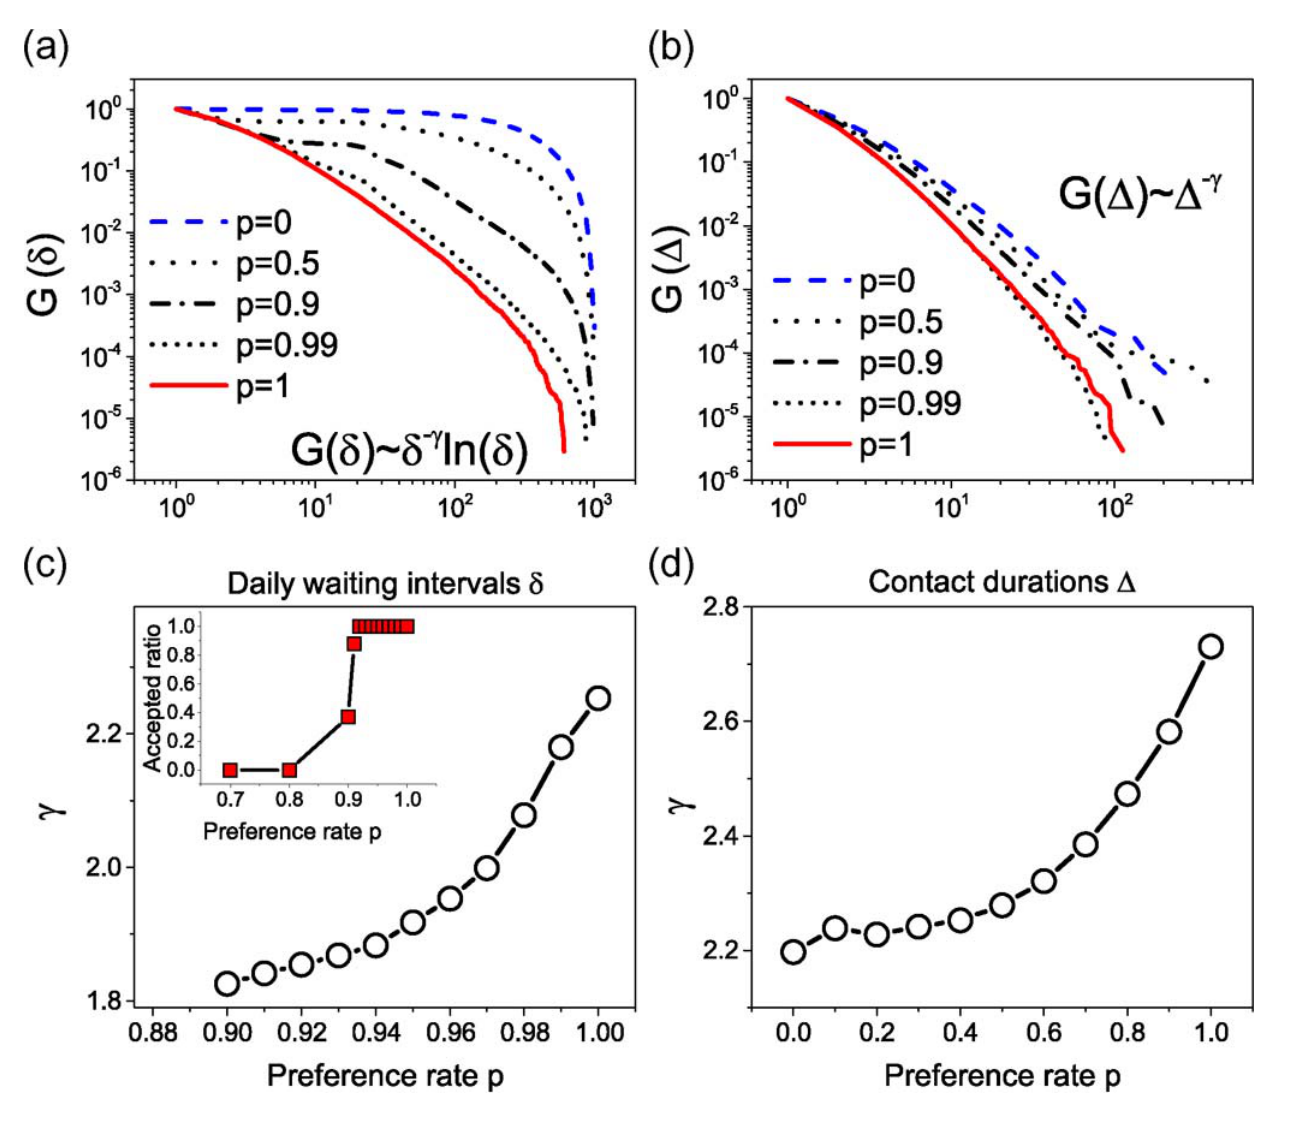
图 3|地点偏好改变后,哪些尾部仍保留?
(a)不同 p 下的汇总等待间隔 CCDF;p 越接近 1,越接近理论长尾形态。(b)相应接触持续时间 CCDF,各 p 都有较长尾部,但曲线并不完全重合。
(c)100 次模拟中,修改幂律形式 ln(δ)×δ⁻γ 获得较好 AIC 的情况下,拟合 γ 随 p 变化;插图为这种相对优选的比例,接近 1 时比例高。(d)持续时间尾部拟合 γ 也随 p 变化,图中约从 2.2 增至 2.7 多,不能写成所有 p 都已精确得到理论极限 3。横轴均为偏好参数,纵轴为 CCDF 拟合指数。来源:原论文 Fig. 3。
等待间隔的拟合在较强偏好下才稳定支持相应尾部形式;持续时间的幂律候选在超过 99% 的模拟比较中优于指数候选。不过图 3c 在 p 最接近 1 时也偏离指数 2,表明有限窗口与参数下的拟合指数仍有差异。趋势与候选比较支持机制可能性,并不等于所有有限条件下数值都达到定理极限。
还需要注意,实证图 1 的 AIC 差用“指数减幂律”,模拟部分改用“幂律减指数”,优选方向的符号随之反转。两处比例应按各自定义理解,不能只记住正数或负数就直接比较。
从通信机制解释到现实网络,边界在哪里?
这项工作的重要贡献,是提供一个反例:个体无记忆,并不迫使全部用户对汇总后仍然无记忆。不同人的活跃程度和地点偏好,足以创造复杂的总体时间结构。
实证来自一所大学教学楼的 Wi-Fi 覆盖,样本有限,交互由共现推断;模拟采用均匀活跃度、单个偏好地点和等权完全网络,没有纳入课程表、昼夜周期、设备接入差异或多种偏好地点。原文也明确承认这不是唯一解释。
因此,论文为机会网络建模提供了机制候选,没有实际比较一套新转发协议在真实网络中的传输量、延迟或成功率。由接触时间统计进一步走向系统性能改进,还需要通信实验与独立验证。
一句话总结
个人活动近似无记忆,与总体接触出现长尾并不矛盾;把不同活跃度和地点偏好的人混在一起,就能生成单个用户对没有的时间结构。
核心来源
Zhang, Y.-Q., Li, X., Liang, D. & Cui, J. (2015). Characterizing Bursts of Aggregate Pairs With Individual Poissonian Activity and Preferential Mobility. IEEE Communications Letters 19(7), 1225—1228。DOI。三张图均来自对应完整原图;数据口径、模型与积分依据论文正文 Eqs. (1)—(4)。
作者介绍
- Yi-Qing Zhang:论文署名为复旦大学电子工程系自适应网络与控制实验室,以及信息科学与工程学院智能网络与系统中心。
- Xiang Li:论文署名为上述复旦大学机构,为通信作者。
- Di Liang:论文署名为上述复旦大学机构。
- Jin Cui:论文署名为上述复旦大学机构。以上按论文署名介绍,未另行推断当前职务。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
网络评估可以同时保存三套等待统计:每个人、每一对人,以及按事件汇总的全部用户对。若算法只在最后一套分布上匹配得很好,却对低频用户或罕见联系预测很差,整体长尾拟合仍可能掩盖服务不均。
也可以分别打乱地点选择与个人活跃序列,构造机制对照。保持每人的活跃概率、只改变地点偏好,或保持地点占用、只改变活跃时间结构,有助于检验现实网络中的长等待究竟主要来自异质性、空间分离,还是日程约束,而不是只用一条汇总曲线作判断。