猜你下一小时在哪里,别人的日程能帮多少忙?
论文名片|Francesco Calabrese、Giusy Di Lorenzo、Carlo Ratti,Human Mobility Prediction based on Individual and Collective Geographical Preferences,IEEE ITSC 2010,312—317。DOI。
周五傍晚,你过去常去的地方并不只有一个:可能回家,也可能去商业区。个人历史提供候选,其他人在这个时段通常走多远、靠近什么类型的地点,能不能帮助进一步判断?
这篇 2010 年的论文把个人周期性与群体地理偏好放进同一个概率模型,在波士顿地区手机轨迹上预测下一小时的位置。它显示两类信息可以结合,但也需要分清:相对简单常去地点基线的改善很大,群体信息在个人周期模型之上的额外收益则小得多。
先说结论
- 原始数据约有 100 万台设备、8.29 亿条位置估计,覆盖四个月;实际模型实验选用其中每天至少 100 次网络连接的 2,000 个用户。
- 模型在 500 米网格、1 小时时间步上预测位置,个人历史按一周 168 小时的周期对齐;群体部分综合不移动概率、距离、土地利用和 POI。
- 混合权重 α=0.8 时平均误差约 1.34 公里,优于总猜个人最常去网格的 2.8 公里;图中的纯个人模型已约为 1.35 公里,新增群体收益需与这个更强对照一起看。
- 约 60% 的预测网格与观测网格一致,但这包括下一小时仍留在原地的情况,不能理解为 60% 的真实出行目的地被精确猜中。
从庞大定位库里,真正测试的是谁?
数据由 AirSage 提供,来自电话、短信及网络数据连接时产生的匿名位置估计,比只用通话详单包含更多事件。位置是网络侧估计,不是手机 GPS 的连续实测;论文引用的定位误差平均约 320 米、中位数约 220 米,还可能出现短时间跨越很远的异常点。
范围涵盖马萨诸塞州东部八个县,人口约 550 万。为了获得较密的个人轨迹,研究筛出每天至少 100 次网络连接的 2,000 个用户,其个人事件间隔在约 75% 的情况下低于一小时。该选择偏向高活动设备,不能把结果直接推广给整个约百万设备库。
预处理把空间上相近的连续测量融合为虚拟停留位置,以约 1 公里阈值缓和定位误差,再构造 1 小时采样的轨迹,并映射到 500 米×500 米网格。因而,500 米是分析网格宽度,不能当作原始定位精度。
预测问题是:已知当前网格,下一小时会在哪个网格?它没有先要求人必须出发,也不是预测某趟汽车行程的完整路线。
个人惯例与群体偏好,怎样放在一起?
个人部分统计过去每周同一时段,从当前网格前往各网格的历史频率。如果同一时段从未出现过当前网格,则退回到那个时段个人到访网格的频率。这个设计把个人的周周期作为基础,也意味着至少需要一个完整周期的历史才能开始预测。
群体部分回答两个问题:这个时段人们通常是否移动,以及若移动,更可能到怎样的地方。它使用同一批 2,000 个用户的历史,把目的地得分写成距离、POI 和土地利用三项的乘积,再归一化。
最终预测概率是:个人概率×(1−α)+群体概率×α,再选择概率最大的网格。α 是两个概率模型的混合权重,α=0.8 不能解读为人的行为有 80% 被群体决定。
不移动和短距离移动,先构成一个强约束
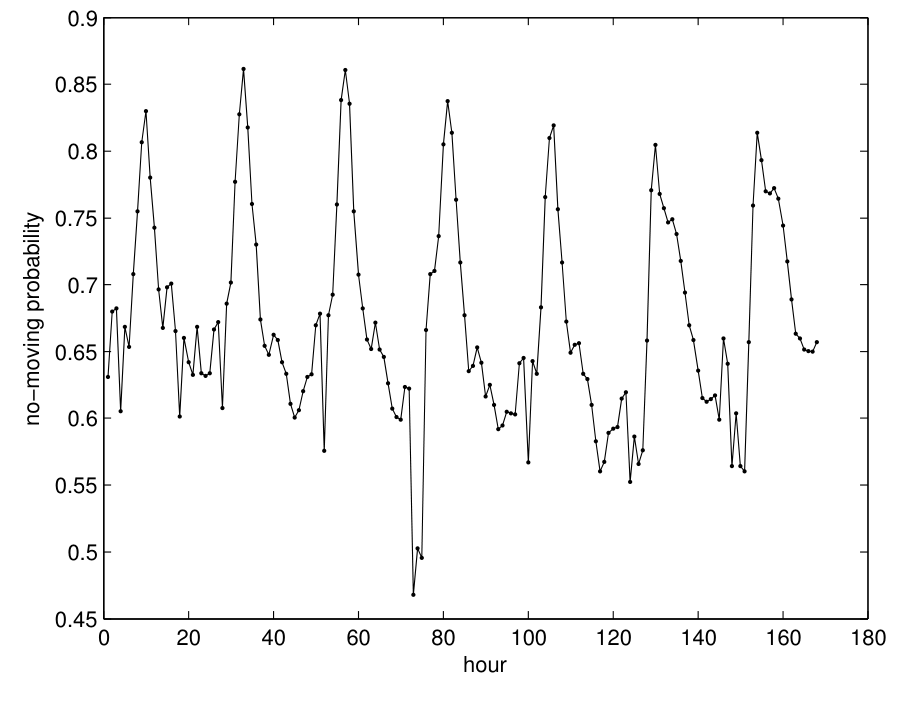
图 1|同一个人群在一周不同小时,有多大概率留在原网格?单幅图横轴从周一零点开始按小时排列,纵轴为下一时间步不改变位置的概率。曲线呈现重复的日内高低起伏,说明预测首先需要区分仍然停留与移动,而非每小时都选择新目的地。来源:原论文 Fig. 1。
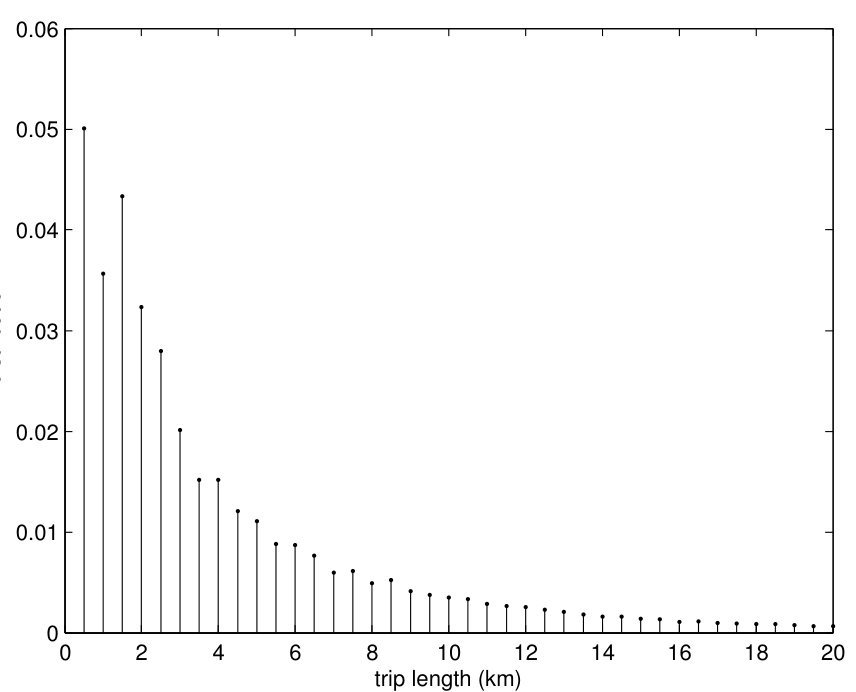
图 2|移动发生后,距离分布是什么样?单幅图横轴为行程长度(公里),纵轴为归一化频率;这里将不同时段的非零距离统计平均展示。短距离较多,长距离较少。模型中距离偏好可随周内时段变化,图中平均曲线本身不能展示全部时间差异。来源:原论文 Fig. 2。
这两个统计有不同作用:不移动概率为留在原地提供依据,距离分布限制其他候选网格的可达偏好。它们不要求预先指定所有人都遵循固定的距离平方反比,而是从群体历史估计。
目的地的功能,能提供怎样的额外线索?
土地利用数据来自 MassGIS,在网格内计算各类用地的面积比例,分为 33 类。展示地图时,每个网格只画面积最大的类别,模型计算则使用类别组成向量;不能把显示的主类当成网格内唯一功能。
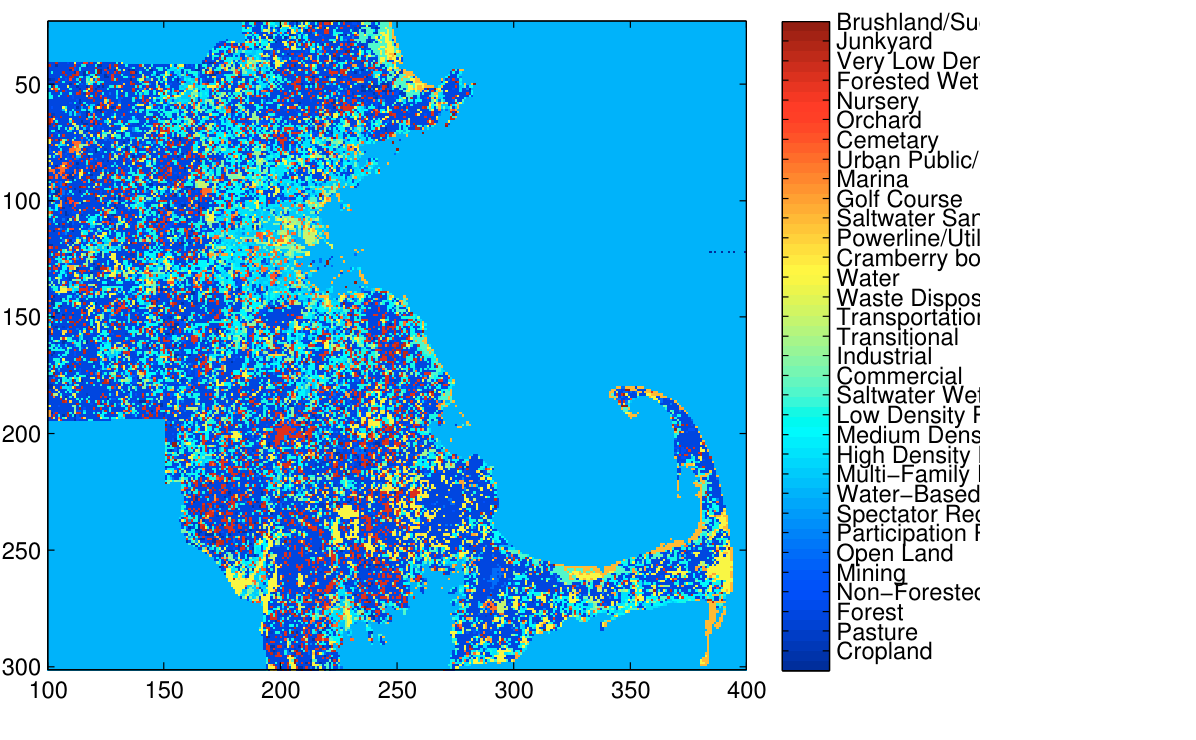
图 3|同一片区域有哪些土地利用差异?单幅网格地图按面积占优的土地利用类别着色,右侧图例保留所有原类别。坐标表示网格位置;颜色是类别编码,没有由浅到深的数值大小含义。来源:原论文 Fig. 3。
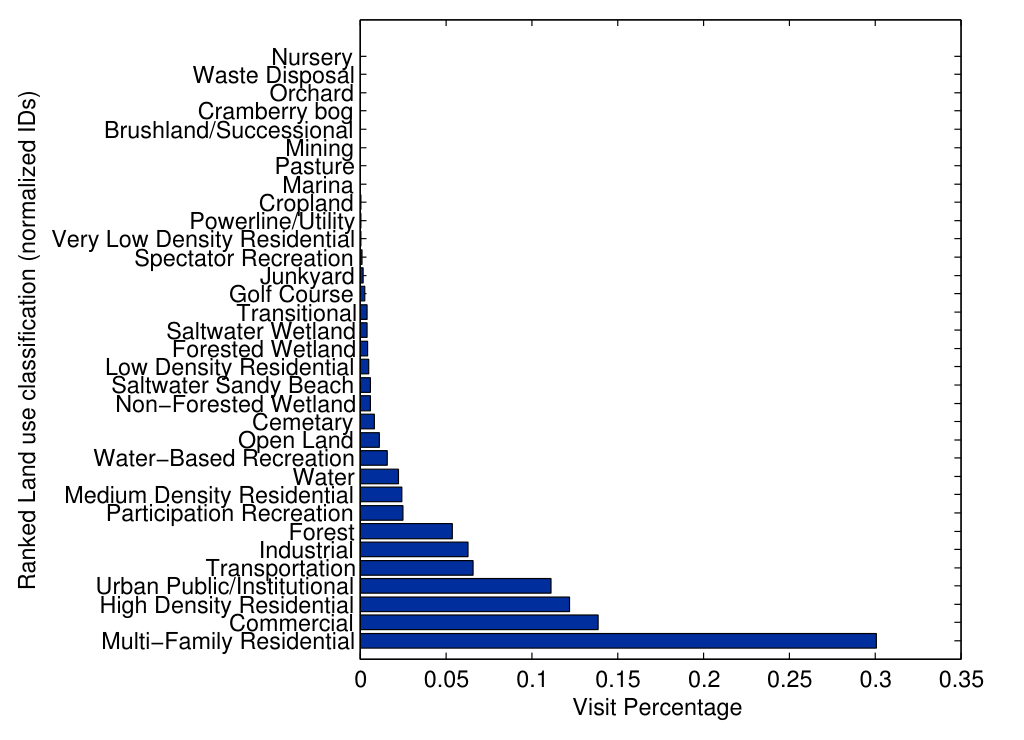
图 4|人群更常出现在怎样的土地利用组合附近?横轴为访问占比,纵轴为排序后的用地类别。多家庭住宅、商业和高密度住宅合计超过一半;这是用地组成与轨迹占据的统计联系,不是每个人真实活动目的的调查。来源:原论文 Fig. 4。
POI 来自 Yelp,同样汇总到网格。模型考虑人群各时段所在网格的类别构成,再给具有类似资源的候选网格较高得分。餐馆多的区域可能支持餐饮活动,但也可能有工作或其他活动;作者明确将地理资源作为活动代理。
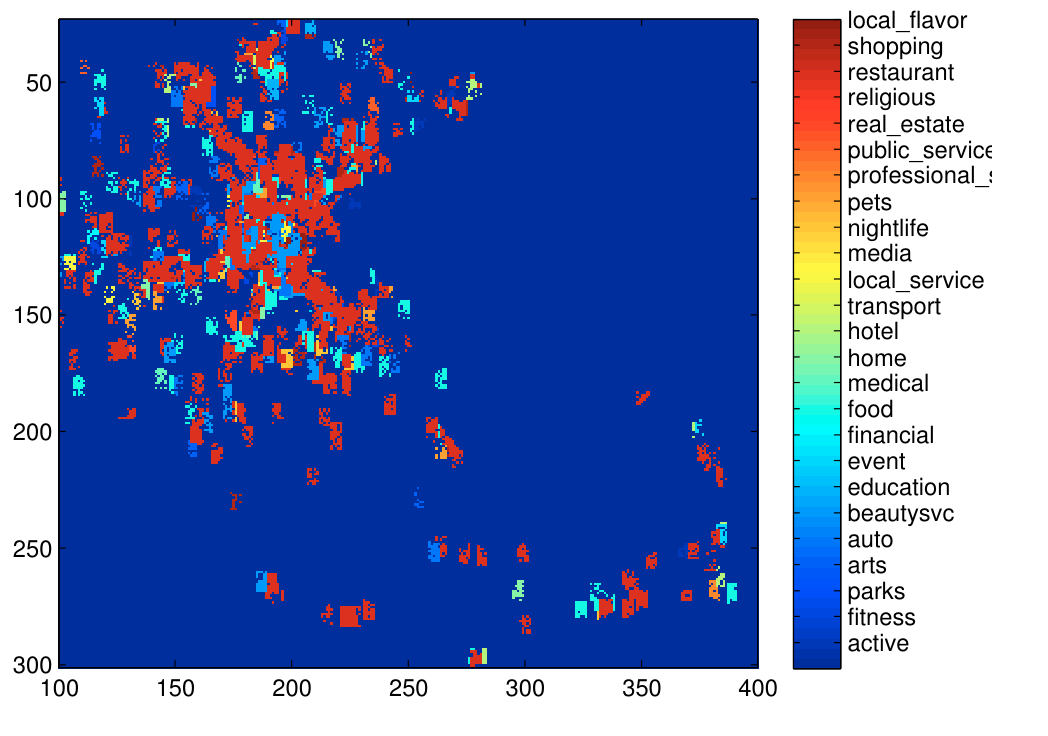
图 5|POI 类型怎样分布在空间上?单幅地图按每格数量最多的 POI 类别着色,深蓝色表示没有 POI 记录。没有记录不能自动等同于没有活动,地图的类别也不能直接当作居民收入或人流强度。来源:原论文 Fig. 5。
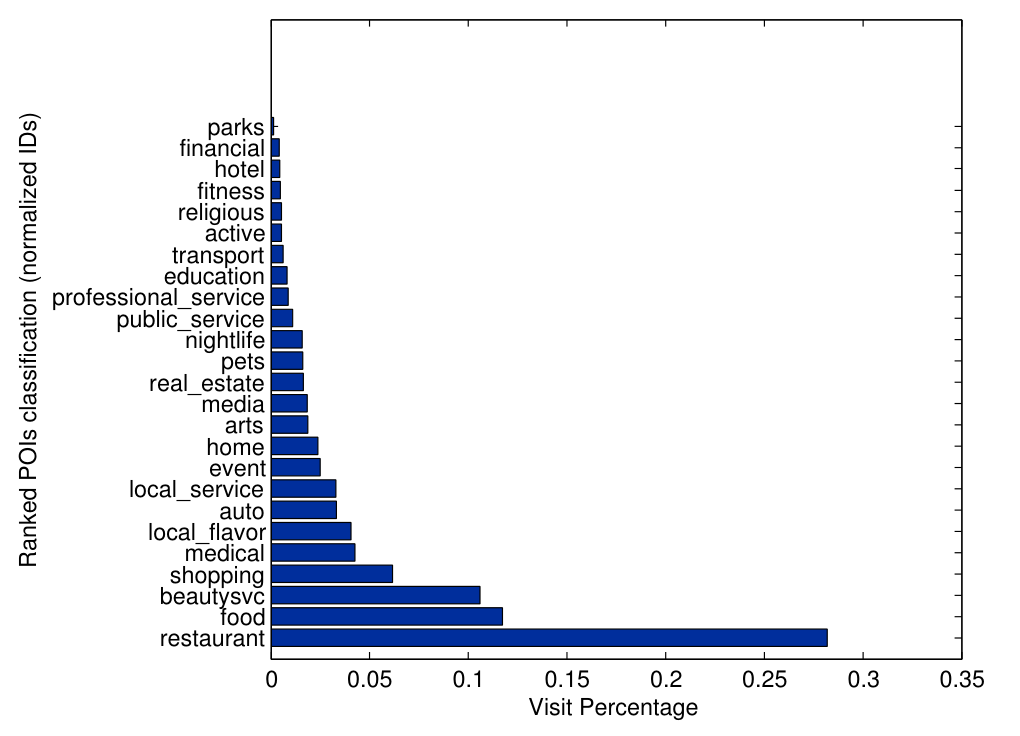
图 6|哪些 POI 类别在群体偏好中占比较高?横轴为访问占比,纵轴为排序类别。餐馆与食品类合计接近一半,随后为美容、购物和医疗等;结果依赖地点库和当前样本,不能解释为近半数出行都是为了吃饭。来源:原论文 Fig. 6。
土地利用与 POI 共同提供目的地功能线索,乘上距离项之后,模型才得到群体条件概率。它并未直接测量动机,也没有单独识别是哪一类地理资源导致人们前往。
最佳误差 1.34 公里,应该与谁比较?
研究逐步改变 α。α=0 是个人周期模型,α=1 只用群体概率;另一个对照把“群体”改成仅包含当前这个人,检查其他用户的信息是否有额外帮助。
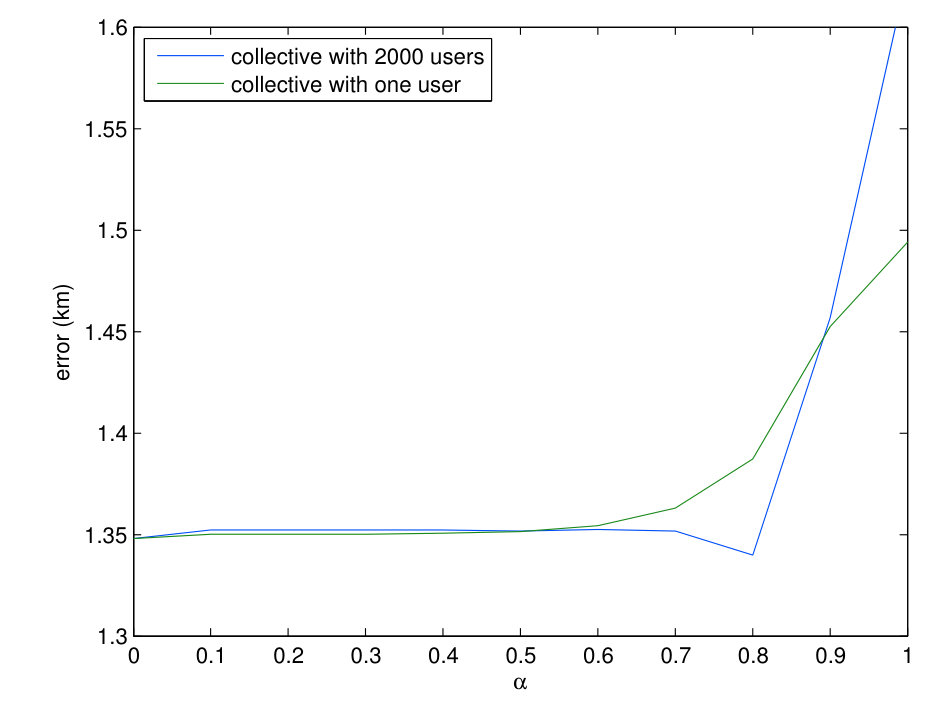
图 7|加入其他人的历史,在什么权重下有帮助?单幅图横轴为 α,纵轴为平均地理误差(公里);两条线分别使用 2,000 个用户与仅当前用户构造群体偏好。α≈0.8 时,前者取得约 1.34 公里的最低值;α 接近 1 时误差反而明显升高,不能概括为群体占比越高越好。来源:原论文 Fig. 7。
有两个不同的比较。对“永远猜个人最常去网格”的简单基线,1.34 公里比 2.8 公里低约 52%。但对已经利用周周期与当前状态的纯个人模型,图 7 中误差约为 1.35 公里,最佳混合只是再降低约 0.01 公里,属于图示近似值。
所以,本文最直接的证据是:个人周期已经很有用,在某些混合权重下群体地理偏好还能改善。它没有证明所有时段、所有用户或所有权重都同样获益;也没有给出误差条或独立显著性检验来判断这项小差距的稳定程度。
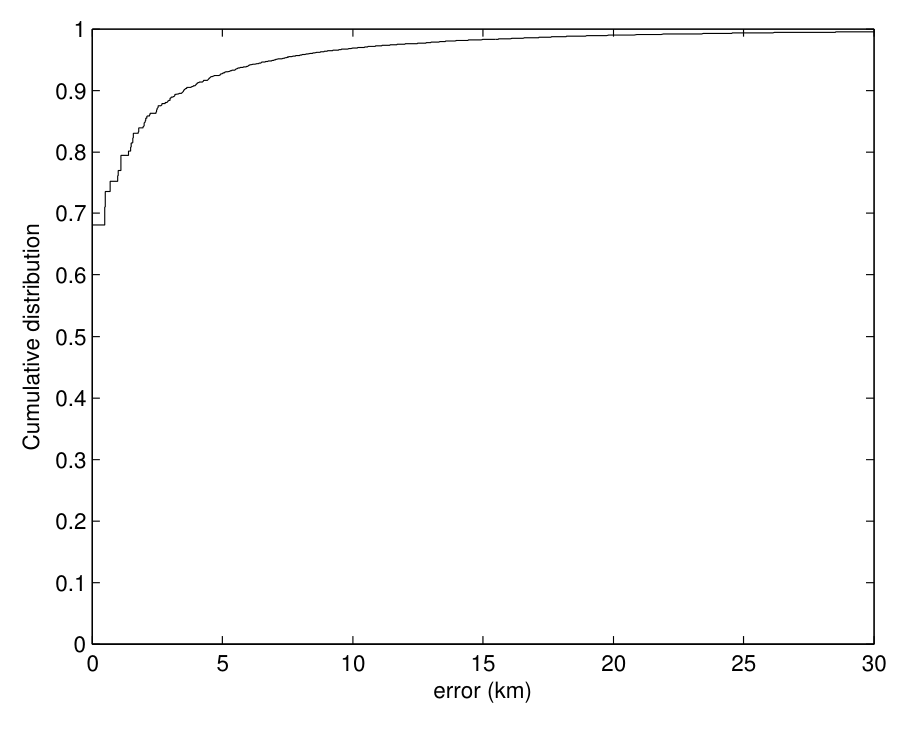
图 8|均值之外,误差分布怎样?单幅图横轴为地理误差(公里),纵轴为累积比例。论文在最佳权重下报告约 60% 的误差为零,剩余样本包含较长误差尾部。这里的零是网格位置一致,既非厘米级定位,也不意味着每次实际移动的目的地都被猜中。来源:原论文 Fig. 8。
留在原地的小时占有较大比例,精确网格命中率必须与这些小时一起理解。论文没有另列只在真实移动发生时的命中率,因而不能从约 60% 推出出发后的导航目的地成功率。
另外,模型公式使用历史周期,但文中没有充分说明独立测试时段、α 调参集与最终评估集的隔离。1.34 公里应视为本文实验设置下报告的最优结果,不能当成任何未来月份均已验证的保证。
给出三个候选地点,评价为何更容易改善?
推荐示例不再只取一个地点,而是给出前若干候选,以真实位置到候选集合最近地点的距离作误差。候选越多,这个最小距离在定义上就越不容易变大,因此需要同时考虑列表长度。
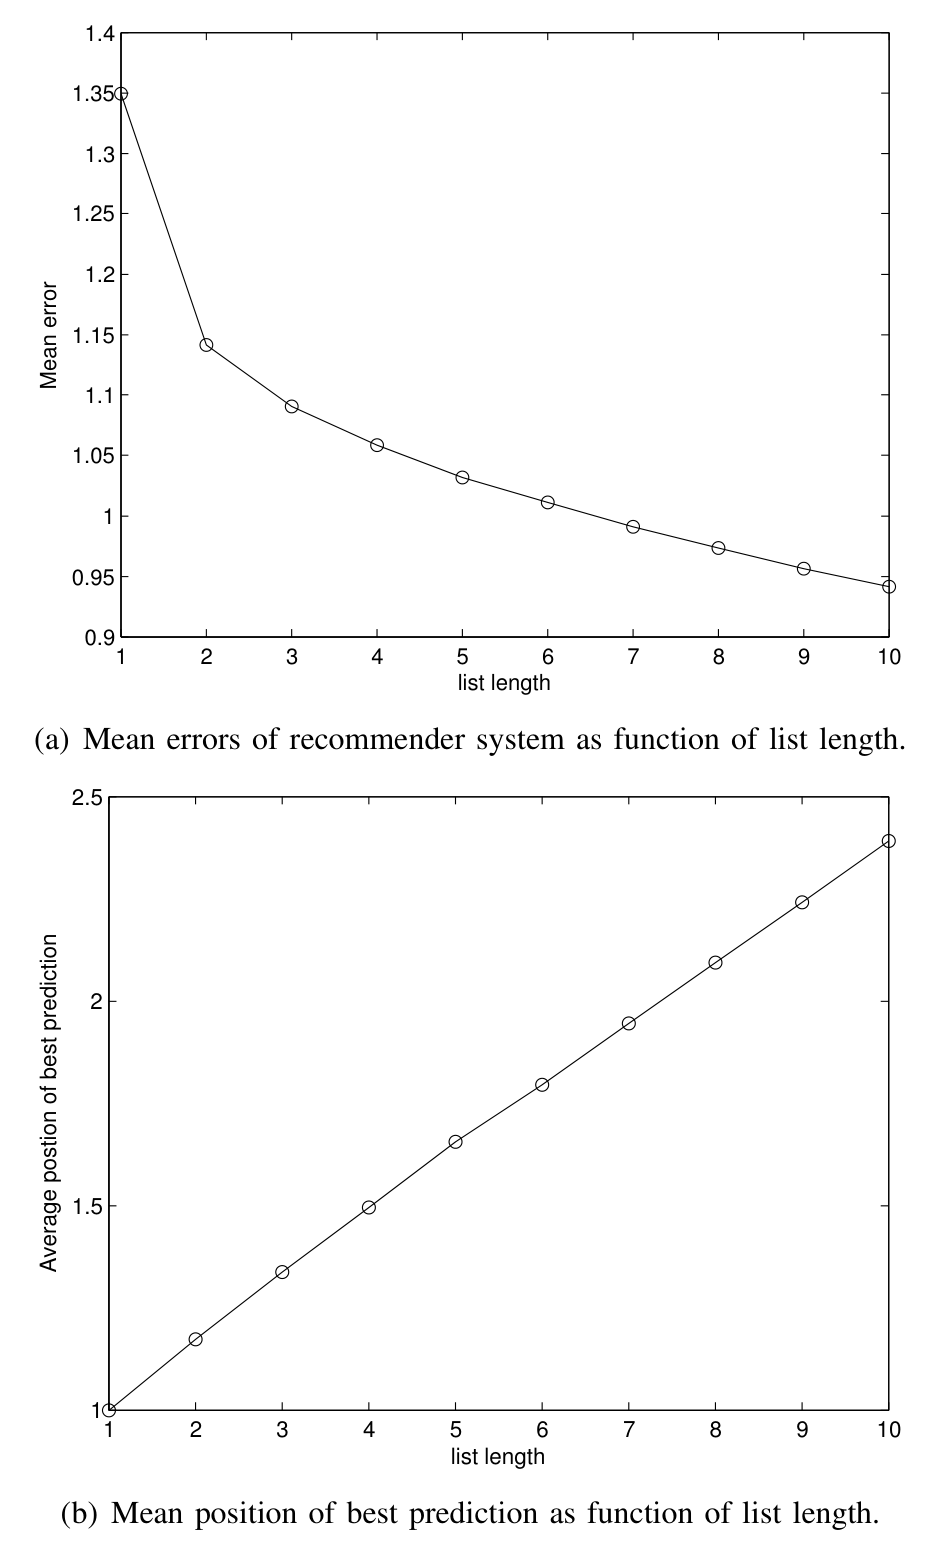
图 9|多给几个候选地点,能减少多少位置误差?(a)横轴为推荐列表长度,纵轴为平均最近距离误差;从 1 增到 3 后主要下降已经出现,继续增大仍有改善。(b)横轴仍为列表长度,纵轴为集合中最接近真实位置的候选的平均名次;即使列表到 10,平均名次仍不到 3。来源:原论文 Fig. 9。
列表长度为 3 时并未完全达到长度 10 的最低误差;“最好的候选通常较靠前”也不等于“三个候选已精确覆盖几乎全部目的地”。这项示例验证的是模型排序与地理距离表现,没有测试真实用户点击、满意度或交通规划收益。
一句话总结
个人周期是强预测基础,群体的距离与地理偏好能提供额外线索,但收益大小必须与强基线、停留小时及评价设置一起解读。
核心来源
Francesco Calabrese, Giusy Di Lorenzo, Carlo Ratti. Human Mobility Prediction based on Individual and Collective Geographical Preferences. 13th International IEEE Conference on Intelligent Transportation Systems, 2010, 312–317。DOI:10.1109/ITSC.2010.5625119,MIT 机构仓库。Fig. 1—9、方法及实验数值均来自原论文;约 52% 为根据 1.34 与 2.8 公里计算的相对误差降低。
作者介绍
- Francesco Calabrese:论文署名机构为麻省理工学院 Senseable City Laboratory。
- Giusy Di Lorenzo:论文署名机构为麻省理工学院 Senseable City Laboratory。
- Carlo Ratti:论文署名机构为麻省理工学院 Senseable City Laboratory。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果专门把“下一小时移动”与“不移动”分开报告,群体信息可能在少数移动小时中更有价值,也可能只是改善了停留判断。这两种机制会导向不同应用:前者有助于目的地候选排序,后者主要帮助判断是否需要预测新地点。
还可以比较同样数量的不同群体:所有用户、作息相似的用户,以及随机用户。保持个人模型与训练时长不变后,才能判断改善来自更多样本,还是来自选到了更相关的人群。原论文提出了按相似习惯定制群体的扩展,这类实验能够把这个设想转成可检验的预测增益。