停留点的定义一改,出行模型还在比同一件事吗?
论文名片|Takahiro Yabe、Massimiliano Luca、Kota Tsubouchi、Bruno Lepri、Marta C. Gonzalez、Esteban Moro,Enhancing human mobility research with open and standardized datasets,Nature Computational Science,2024,4(7):469–472,2024年7月2日在线发表。DOI:10.1038/s43588-024-00650-3。本文是 Comment,讨论数据与可复现性,不报告新的预测实验。
两支队伍拿到同一批手机定位,都要预测一个人接下来会去哪里。甲把停留定得更严:在一个中心附近待得更久,而且几乎不能再移动,才算停过。乙把时间放短,或把允许偏离中心的距离放宽。评论指出,预处理里只要改动停留地点的空间或时间定义,就可能得到完全不同的数据集。后面报出的准确率,回答的未必是同一个问题。甲和乙是为了看清这个机制,评论没有描述这样一次真实对决,也没有给出停留该设多少分钟、偏离中心不得超过多少米。
Yabe 等人主张,人类移动研究要提高有效性和可复现性,需要开放、处理口径可对照、并且依任务而设(fit-for-purpose)的基准数据。人类移动性(human mobility)在这里指人在空间中的移动,主要是设备被动记下的位置轨迹,不是搬家或户籍迁移。这些轨迹已经进入城市规划、交通工程、公共卫生、灾害管理和经济分析,但公开数据的规模、交通方式和地理范围经常受限,原始记录又多在企业手里。一个模型在某一套数据上更好,可能混进了那套数据的筛选方式。
先说结论
- GeoLife、T-Drive、纽约市出租车与豪华车委员会的行程数据、Gowalla 都被用于移动预测,评论同时认为领域仍缺都市尺度、长时间、个体层面的开放轨迹。
- 定位点变成研究数据时,通常要去噪并去掉 GPS 漂移、校正偏差、补充语义、满足隐私要求。停留检测要自定最短停留时间,以及相对停留中心允许的最大移动距离。本文没有给出这两个阈值。
- 作者认为,目前还没有一份能支撑数据密集型人类移动研究的标准开放基准。文本和图像可以从公开网络收集;移动轨迹多是专有数据,难以让所有算法共用同一训练集、测试集和预处理。
- 一条已有途径是生成保护隐私的合成轨迹。较早使用循环神经网络和长短期记忆网络,较新的扩散模型与注意力模型被引述为仿真更准确、更实用,本文没有写出提升幅度。另一条是与雅虎日本(现 LY Corporation)合作的 YJMob100K,尽量少做任意处理,面向下一地点预测。
- 文中点名的那些既有数据挑战,每一项都有 50 到 100 支队伍把数据用到不同问题上。HuMob Challenge 2023 使用 YJMob100K,吸引超过 85 支队伍,并聚集了超过 200 名研究者。这是参与规模,不是预测命中率。
已有的公开轨迹,卡在哪一种比较上?
大规模、被动采集的手机定位,让计算社会科学、复杂系统和行为研究有机会讨论个体与集体移动中反复出现的规律,也让计算机科学去做下一地点预测,以及受物理启发的人流预测与生成。评论引用的这些方向来自既有综述和论文,不是本文新测出的一条定律。
无论具体问题是什么,人类移动数据集都有明显限制。隐私顾虑使大规模开放轨迹难以出现,现有公开数据常常偏小、只覆盖特定交通方式,或局限在个别地区。评论举出的真实轨迹包括 GeoLife、T-Drive、纽约市出租车与豪华车委员会数据,以及 Gowalla。它们对移动预测的大规模实验有价值,却补不上都市尺度、可长期追踪的个体开放数据。没有开放数据,接触不到专有数据集的研究者会被挡在这个领域外面,评论把这看成科学里的公平问题。
即便研究者拿到的是已经处理过的公开数据,隐私限制仍然挡住原始记录。公开数据的处理步骤往往并不统一。停留地点的空间定义或时间定义稍作改动,就可能得到另一套数据,不同方法的成绩便难以公平对比。这里的分析单位是处理后的轨迹或由此算出的流量,不是“有多少人住在这座城市”。
同一次出行,会在哪一步被写成不同的数据?
研究用的人类移动数据,是从原始地理定位一步步处理出来的。这些步骤的细节,经常只有做分析的团队知道。图 1 把这条链路画成示意图:真实移动先被被动观测,带上偏差,成为原始定位;再经过预处理,才进入下一地点预测、人群流量预测等下游任务。
处理至少服务四件事:去掉噪声和 GPS 漂移,校正移动数据里的偏差,补充语义,以及满足隐私要求。定位常常本来是为营销和商业采集的,研究是后来的用途,因此会带上多种偏差。评论列举的例子包括人口结构偏差,如年龄、收入和种族;地理偏差,如城市与乡村、发达国家与发展中国家;行为偏差,即某些活动期间观测更密,例如在兴趣点(point of interest,POI,可理解为被标注的具体场所)签到时。这些是偏差的类型,本文没有报告每一类偏差占观测的百分之几。
为了让数据能回答后续问题,分析者还会做用户筛选、停留检测、隐私增强、给兴趣点和其他情境赋值,以及估计交通方式。每一步都要选多个参数。检测轨迹中的一次停留,就要规定在停留处至少待多少分钟,以及离开停留中心最多还能移动多远。评论把这些称作由分析者设定的超参数。每一步都有好几个这样的选择,改动一点,处理后的人类移动数据就可能差很多。本文没有推荐具体的分钟数或距离。
步骤一多,使用数据的研究者和业务分析人员就很难追完当初的每一个决定。原始数据和处理后的数据又常常是专有的,只公开处理方法,仍不足以掌握下游任务实际用的是什么数据。评论认为,这会同时伤害可复现性、可推广性,以及方法成绩的可比性。有人可以在特定数据集上宣称当前最优,结果却可能只贴合那一套处理和那一批轨迹,换到别处就减弱。
另一些工作用外部数据检查移动数据的准确性,评论举出 Unacast、Safegraph、Cuebiq,以及对照美国社区调查(American Community Survey)、体育场到访和工厂设施到访的论文。这类对照回答的是“这套定位和某种外部计数是否合得上”,仍然不是把同一训练集、测试集交给所有模型。
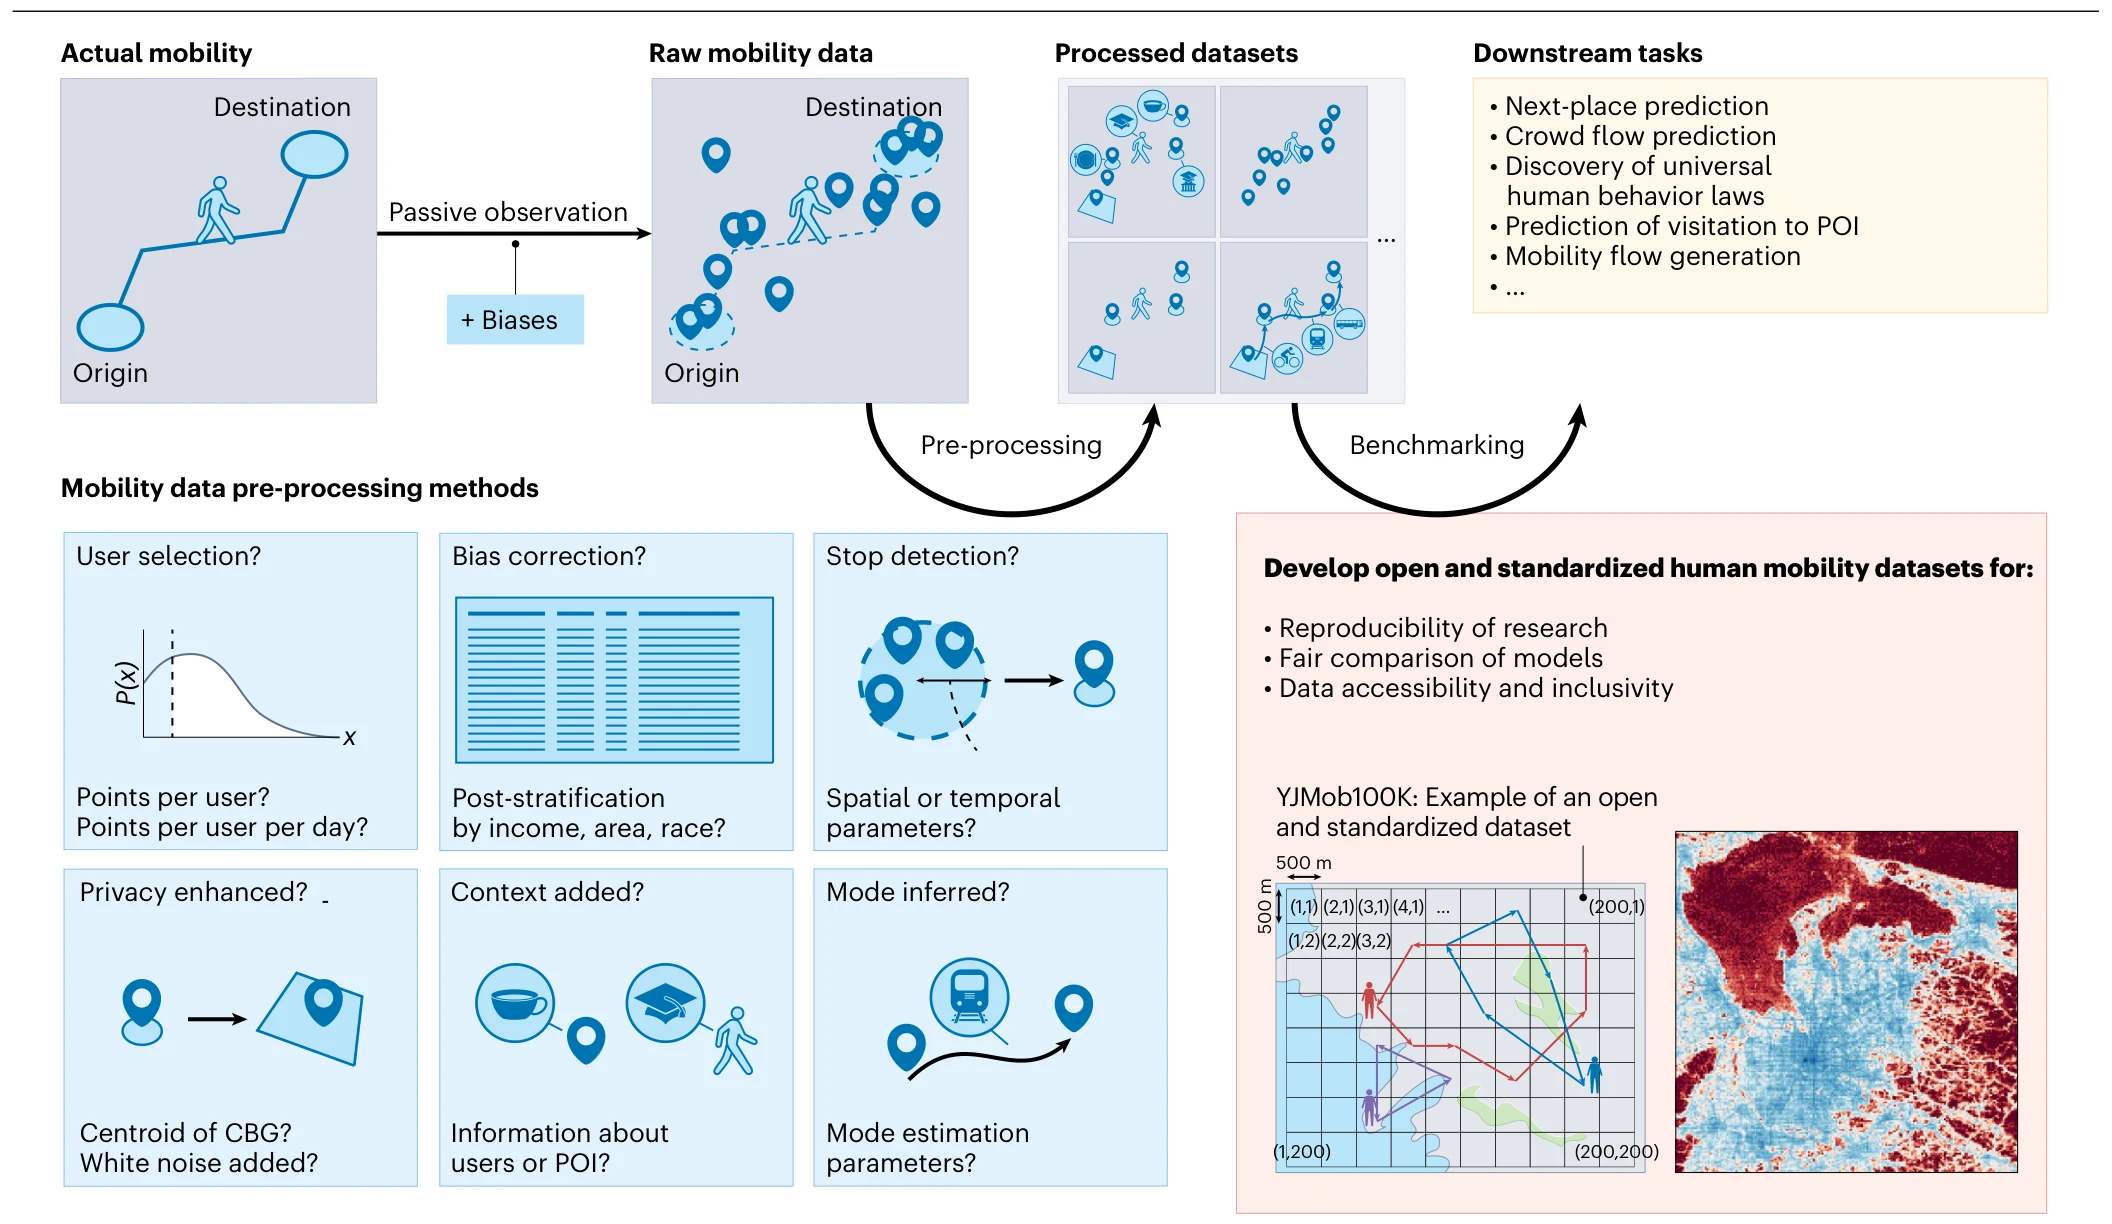
图 1|从真实移动到下游任务,哪些处理决定会改写后来被比较的数据?
原图没有(a)(b)等子图字母,按图中标注阅读。上排从左到右:真实移动是起点到终点的一条路径;被动观测加上偏差后,成为散布的原始定位;预处理把定位收成网格上的轨迹,省略号表示处理还可以继续;基准比较指向下游任务,列出下一地点预测、人群流量预测、发现普遍人类行为规律、兴趣点到访预测和移动流生成。中部六格都是待选择的处理问题,不是实测结果:用户筛选画了随横轴下降的 P(x) 和一条虚线,并追问每位用户有多少点、每天有多少点;偏差校正面向按收入、地区和种族做后分层;停留检测把一簇点收成一个点,并追问空间或时间参数;隐私增强追问是否改到人口普查街区组(census block group,CBG)的中心,或是否加入白噪声;情境补充追问是否写入用户或兴趣点信息;交通方式推断则追问估计方式的参数。右下写明开放且标准化的数据要服务于研究可复现、模型公平比较、数据可及与包容。YJMob100K 的示例把网格两边都标成 500 米,可见索引包括 (1,1)、(2,1)、(3,1)、(4,1) 直至 (200,1),第二行有 (1,2)、(2,2)、(3,2),角上为 (1,200) 与 (200,200)。红、蓝、紫折线是示意图上的个体轨迹。右侧色块图没有数值图例,也没有城市名。来源:原论文 Fig. 1。
图 1 里的曲线、表格、图标和 500 米网格都是示意。不能从图上读出某座城市有多少用户,也不能把 (200,200) 换成数据集的真实覆盖范围。评论正文只把这张图当作处理链路和基准数据目标的说明。
别的领域用同一张考卷,移动研究的考卷在哪里?
要设计更有效的方法,先得让不同技术在公平条件下比成绩。深度学习早期,ImageNet 用竞赛检验计算机视觉算法,并被广泛看作推动深度学习的数据集。近年还出现了大量面向特定领域或任务的基准,评论列举计算机视觉、自然语言处理、语音、图机器学习、分子机器学习、大气科学、城市三维点云和多模态学习。这些数据被许多研究者使用,算法由此面对同一套数据设定:相同的训练集、测试集和预处理。
评论接着写明,迄今还没有一份人类移动基准,能够支撑最前沿的数据密集型研究。文本和图像可以从公开网络抓取;人类移动数据的专有性质,是建成这类基准的主要障碍。ImageNet 在这里是其他领域的先例,不是作者新举办的一场移动竞赛,也不能推出“移动预测已经有了公认第一名”。
合成轨迹,和一份故意留着噪声的开放数据
既然还没有标准的开放基准,一条较新的路是训练机器学习模型,生成保护隐私的合成人类移动数据。较早的尝试用循环神经网络和长短期记忆网络刻画移动序列。较近的工作使用扩散模型和基于注意力的模型,评论称这些数据在仿真准确性和实用性上有明显进步,并预期大语言模型和基础模型还会带来进展。进步幅度写在被引用的论文里,本文没有给出百分比、误差或对照样本。预期也还不是已经完成的评测。
另一条路是与私人数据公司合作,做隐私上可发布、经过匿名的大规模移动数据。作者自己的例子,是与雅虎日本公司(现称 LY Corporation)合作,用手机定位做成开放、匿名的人类移动轨迹,面向下一地点预测,名为 YJMob100K。为了让它能够被广泛用来建立基准,他们尽量减少任意的预处理决定,让数据保持接近原始形态。研究者因此可以按自己的问题和应用,再选择处理步骤。
早期使用者的总体反馈是积极的,也有人担心数据又乱、噪声又大。不同用户之间,数据的数量和质量差很多,这是人类移动数据里常见的偏差。作者说,这是有意的设计:把处理的灵活性留给后续研究者,也希望 YJMob100K 让大家正视预处理本身的困难。评论没有给出反馈人数、积极反馈的比例,或每位用户的定位点数。数据集名称里的 100K,本文也没有解释成一个可核对的样本量。
数据挑战可以把研究社区和新数据集、以及可能用数据去处理的社会问题放到一起。人类移动领域此前已有多次与电信公司合作的挑战。评论点名的例子包括:Orange 提供手机数据、分别在科特迪瓦和塞内加尔举行的两次 Data for Development 挑战,Telecom Italia 的 Big Data Challenge,Foursquare 在 NetMob 2019 的 Future Cities Challenge,Orange 参与的 NetMob 2023 Data Challenge,以及 2018 年的 Data4Refugees。最后这项由 Türk Telekom、博阿齐奇大学和 Tübitak 共同组织,合作方包括布鲁诺·凯斯勒基金会、麻省理工学院媒体实验室、Data-Pop Alliance、联合国难民署、国际移民组织和联合国儿童基金会。在这些挑战的每一项中,都有 50 到 100 支队伍把数据用到不同问题上。分母是这里点名的各项挑战,不是全世界所有移动竞赛的总和;论文给的是每一项的范围,没有逐项列出精确队伍数。作者认为,这些早期努力已经推动了移动数据生产和获取方式的标准化。
为推广 YJMob100K,作者举办了人类移动预测数据挑战 HuMob Challenge 2023,工作坊与 ACM SIGSPATIAL 2023 同时举行。挑战吸引超过 85 支队伍参加,并聚集了超过 200 名人类移动研究者,来自学术界和世界银行等公共机构,专长从城市规划到计算机科学。85 支队伍和 200 名研究者是两个数:前者是参赛队伍,后者是挑战所聚集的社区,不能把 200 人当成 200 次独立预测,也不能把参赛人数当成准确率。作者希望 YJMob100K 在挑战之外,继续服务于公平、可复现、可获得的研究。它在 HuMob 中承担的是下一地点预测;评论明确说,下一步还要为其他任务和问题建立基准,那些任务需要不同的考虑。
早期挑战改善了数据的生产与获取,评论仍认为领域缺少一份标准开放基准。两句话指向的不是同一件事:前者是某次挑战里大家暂时用上同一批数据,后者是一套能长期、按相同训练与测试划分来比较方法的基准。
一份网格轨迹,为什么回答不了所有城市问题?
YJMob100K 是面向移动预测社区建立基准的一次尝试,作者同时列出还没解决的问题。首先,研究社区还需要共同定义什么样的数据才算依任务而设,包括数据规格,以及产业界可共用的预处理标准。图 1 中的步骤只是必须讨论的一部分。
其次,任务不同,数据也不同。YJMob100K 可以适合人类移动预测,但每个网格没有具体城市、也没有兴趣点,因此不太适合那些要研究移动情境的城市科学问题。人群流量预测不必使用个体数据,空间上和时间上的汇总可能就够用;这类任务更受益于空间情境和时间情境,例如真实的经纬度,以及真实的日期、钟点和事件信息。评论没有在这里比较某个流量模型的误差。
作者还主张,基准数据需要地理、社会、经济、时间和情境上的多样性。既有研究已经表明,模型和方法的表现会明显随情境变化,例如城市与乡村、高收入与低收入地区、平常时段与灾害期间。这是对参考文献中已有研究的转述,不是本评论新做的分组实验。因此,他们希望由各自的研究社区自下而上,形成一批依任务而设的基准,分别对准特定领域、社区和社会—空间—时间情境。
评论的收束是:多个学科会受益于开放、标准化的人类移动数据,用来补充专有数据。研究者和实践者可以共同建立面向不同需求的开放基准,并一起规定数据规格和预处理流程,使不同研究使用数据时更一致、更可靠。作者认为,这种集体工作能提高研究的有效性与可复现性,并让更多人用上高质量数据。这是行动呼吁。本文没有检验“一旦有了基准,预测误差会下降多少”。
这篇短评能够支持到哪里?
可以支持的是一条论证:预处理参数会改写数据,专有数据阻碍共同基准,因而公平比较和复现都会受影响;合成数据、YJMob100K 和数据挑战是已经走过的路;一份去掉城市和兴趣点的网格,服务不了所有下游任务。
不能支持的是新的预测冠军、某座城市的出行总量,或“开放数据必然提高准确率”。用户反馈只有“总体积极”和“有人觉得数据吵”这两种定性说法。50 到 100 支队伍、超过 85 支队伍、超过 200 名研究者,度量的都是参与范围。图 1 的 500 米是示例网格的标注。模型在城乡、收入或灾害情境中表现不同,依据的是评论引用的既有研究。
一句话总结
出行模型要公平比较,先得让它们面对按任务设计、处理过程说得清的同一套开放数据;YJMob100K 和数据挑战开了头,一份不带城市与兴趣点的网格轨迹还回答不了所有城市问题。
核心来源
- Nature Computational Science 正式页面,Comment,2024年7月2日在线发表,4(7):469–472。正文唯一主图是 Fig. 1。
- 评论把 YJMob100K 的数据说明指向 Yabe 等,Scientific Data 11,397(2024)。该数据论文中的用户规模和时间间隔没有写进本评论正文,这里不转述。
- HuMob Challenge 2023 的会议页面由评论给出:https://connection.mit.edu/humob-challenge-2023。
作者介绍
六位作者共同形成这篇评论的想法,共同审阅和修改;Yabe 撰写初稿。论文声明作者没有利益冲突。
- Takahiro Yabe:通讯作者。署名为纽约大学坦登工程学院城市科学与进步中心、技术管理与创新系,以及东京大学空间信息科学研究中心(千叶县柏市)。
- Massimiliano Luca:署名为布鲁诺·凯斯勒基金会移动与社会计算实验室,以及帕尔马的跨学科物理与复杂系统研究所 IFISC(CSIC-UIB)。本文参考文献 4 中,他与 Lepri 等综述了人类移动的预测方法。
- Kota Tsubouchi:署名为 LY Corporation 的 LY Research(东京千代田)。评论中的 YJMob100K 来自作者与雅虎日本(现 LY Corporation)的合作。
- Bruno Lepri:署名为布鲁诺·凯斯勒基金会移动与社会计算实验室,并与 Luca 同为参考文献 4 的作者。
- Marta C. Gonzalez:署名为加州大学伯克利分校土木与环境工程系、城市与区域规划系。她与 Yabe 等合作的参考文献 2 被本评论用来说明移动研究与灾害等城市问题的关联。
- Esteban Moro:署名为东北大学网络科学研究所与物理系,以及麻省理工学院媒体实验室。参考文献 12 是他与合作者用外部数据检验移动数据的论文,本评论把它当作已有的准确性报告。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果排行榜只公布下一地点的命中率,不公布停留至少多少分钟、离开中心最多多远,名次就可能跟着停留定义走。把这两项参数和训练、测试的划分一起公开,读者才能判断两个模型是不是在做同一种比较。反过来,若大家改用同一套更严的停留过滤之后名次趋于接近,原先的差距更可能来自谁更能忍受原始记录里的噪声。
城市部门若用同一份网格既做灾害时的下一地点预测,又做商场到访或大型活动的人流,评论给出的分工会挡住这种混用。网格可以让预测模型面对相近的原始形态;到访和人流还需要兴趣点、真实经纬度、日期和事件。HuMob 上的胜出,只说明模型在那次下一地点任务里相对其他参赛队伍表现如何。挑战结束后数据若不能按原划分继续下载,50 到 100 支队伍的那次共用来过,仍然不等于一份可以反复复核的基准。