家门口的快餐店少,就代表这个人少去快餐店吗?
论文名片|Bernardo García Bulle Bueno、Abigail L. Horn、Brooke M. Bell、Mohsen Bahrami、Burçin Bozkaya、Alex Pentland、Kayla de la Haye、Esteban Moro,Effect of mobile food environments on fast food visits,Nature Communications,2024,15:2291。2022年8月15日收稿,2024年2月26日接收,2024年3月14日发表。DOI:10.1038/s41467-024-46425-2。本文依据这一正式版及其补充材料解读。2022年预印本题为 You are where you eat: Effect of mobile food environments on fast food visits。观察数据加上作者所称的半因果设计,再加一套干预模拟;到访不是已核实的购买或摄入。
中午从工作地走出来,最近的几家店都是快餐;家附近反而有超市。若只统计居住普查区里有多少快餐店,这个人的午餐会被算成“住在食物环境较好的地方”。手机停留记录给出另一幅图:多数快餐到访根本不在自家普查区。
这项研究用2016年10月至2017年3月、美国11个都市区的匿名位置数据,把一个人白天经过的餐饮环境,和他随后走进快餐店还是其他餐饮店分开。方向性的结果是:住所周边的快餐占比,解释不了大部分快餐到访;午餐前最后一处停留周围的快餐占比升高,同一个人去快餐店的几率随之升高。把这一关联放进模拟后,按决策发生地和人群敏感度选点,减少的快餐到访大约是只改家门口或只改“快餐特别多的地方”的2到4倍。这是模型下的情景比较,不是已经实施并评估过的政策。
先说结论
- 11个都市区共186.2万用户、2.4505亿次停留到访。其中餐饮到访6204万次,占全部停留到访的25.32%;快餐到访1081万次,占餐饮到访的17.42%。按用户计算,快餐占该用户餐饮到访的中位数是13.3%。两个百分比分母不同。
- 快餐到访里,只有6.8%发生在用户自家普查区。快餐到访离住所的中位距离是6.74公里。
- 在午餐前的上下文同时有快餐和其他餐饮、且这个人两类店都去过至少一次时,上下文快餐占比升高0.10,去快餐的几率大约升高20%。对数几率系数是1.87(标准误0.033)。
- 午餐前常去的普查区从低快餐档换成高快餐档的人,快餐占午餐餐饮到访的比例从约16%升到约25%;反向切换则从约24%降到约15%。50天累计大约多或少4次,不是比例变成原来的4倍。
- 在“改动100家店”的模拟里,同时考虑决策数量和个人偏好的策略,避免的快餐到访约占全部快餐到访的0.56%;只按快餐密度、食物沙漠或餐饮热点选点,至多0.29%。按作者放大到总人口后,半年大约71.9万次对至多44.2万次。
人中午吃什么,为什么不能只看家里那一圈?
食物沙漠通常指健康食品难买到的地方,食物沼泽通常指快餐和便利店特别密的地方。以往很多研究只量住所、学校或工作地周围的店,而且常常是某一时点的截面。作者引用的综述里,这类关联有正有无,政策评估也常常看不到饮食或相关疾病的明确变化。一个直接的缺口是:人获取食物的地点,很多不在睡觉的地方。
本文的移动数据来自位置数据公司 Spectus,用户选择加入匿名共享。分析样本是11个核心统计区(CBSA)里的186.2万匿名用户,时间是2016年10月到2017年3月。这11处是波士顿、芝加哥、达拉斯、底特律、洛杉矶、迈阿密、纽约、费城、旧金山、西雅图和华盛顿。摘要里的62M,对应补充表S1的6204万次餐饮到访,不是6200万用户。
停留用 Hariharan 与 Toyama 的算法提取:连续定位点离质心不超过50米,并且至少停5分钟,才算一次停留。短于5分钟的路过或驾车窗口买饭不会进入数据。超过2小时的停留被拿掉,以免把工作地点算成餐饮停留;这一刀去掉5.83%的餐饮店到访。家用夜间22:00到次日6:00的停留做聚类,至少10个夜晚,再落到普查区块组。距家50米以内的停留也不再当作外出。一次停留归到200米内最近的 Foursquare 兴趣点。补充说明里,归到快餐店的停留中位距离是17.70米,远小于200米上限。
快餐店按店名匹配美国连锁名单,并用近似字符串比对拼写差异。餐饮店则按 Foursquare 分类,并纳入部分不在“Food”父类、但实际卖食物的地点。学校、药店和医疗机构里的点被排除。洛杉矶对照中,先前人工标注的快餐店有94%进入这套自动分类;自动分类有6964家,先前研究是4151家,差别包括 Chipotle、星巴克等是否算快餐。因此“快餐到访”依赖这份连锁名单,不是营养成分检测。
| 都市区 | 用户数 | 餐饮到访(占全部停留到访) | 快餐到访(占餐饮到访) |
|---|---|---|---|
| 波士顿 | 7.2万 | 208万(27.79%) | 30万(14.45%) |
| 芝加哥 | 30.0万 | 946万(24.14%) | 185万(19.59%) |
| 达拉斯 | 24.5万 | 813万(24.32%) | 189万(23.27%) |
| 底特律 | 12.7万 | 391万(24.58%) | 71万(18.16%) |
| 洛杉矶 | 24.3万 | 992万(25.85%) | 172万(17.38%) |
| 迈阿密 | 18.7万 | 629万(23.63%) | 93万(14.7%) |
| 纽约 | 24.8万 | 930万(26.26%) | 119万(12.85%) |
| 费城 | 12.3万 | 370万(27.08%) | 51万(13.84%) |
| 旧金山 | 8.6万 | 265万(27.64%) | 37万(13.98%) |
| 西雅图 | 7.3万 | 233万(27.16%) | 43万(18.44%) |
| 华盛顿 | 15.3万 | 426万(25.41%) | 90万(21.01%) |
| 合计 | 186.2万 | 6204万(25.32%) | 1081万(17.42%) |
各市用户数四舍五入到千人,简单相加与186.2万略有尾差,以补充表S1的合计为准。17.42%是全部快餐到访除以全部餐饮到访。后文13.3%是每个用户自己的快餐占比,再取用户中位数。到访多的人把总体比例拉高,所以总体高于典型用户。
普查区人口与数据中检测到的手机用户相关为0.59±0.01。作者用普查区手机用户相对真实人口的比例做了加权,主要系数的量级仍与未加权接近。样本覆盖城市人口的空间分布,并不等于每个收入、种族和年龄组都被等比例抽到。
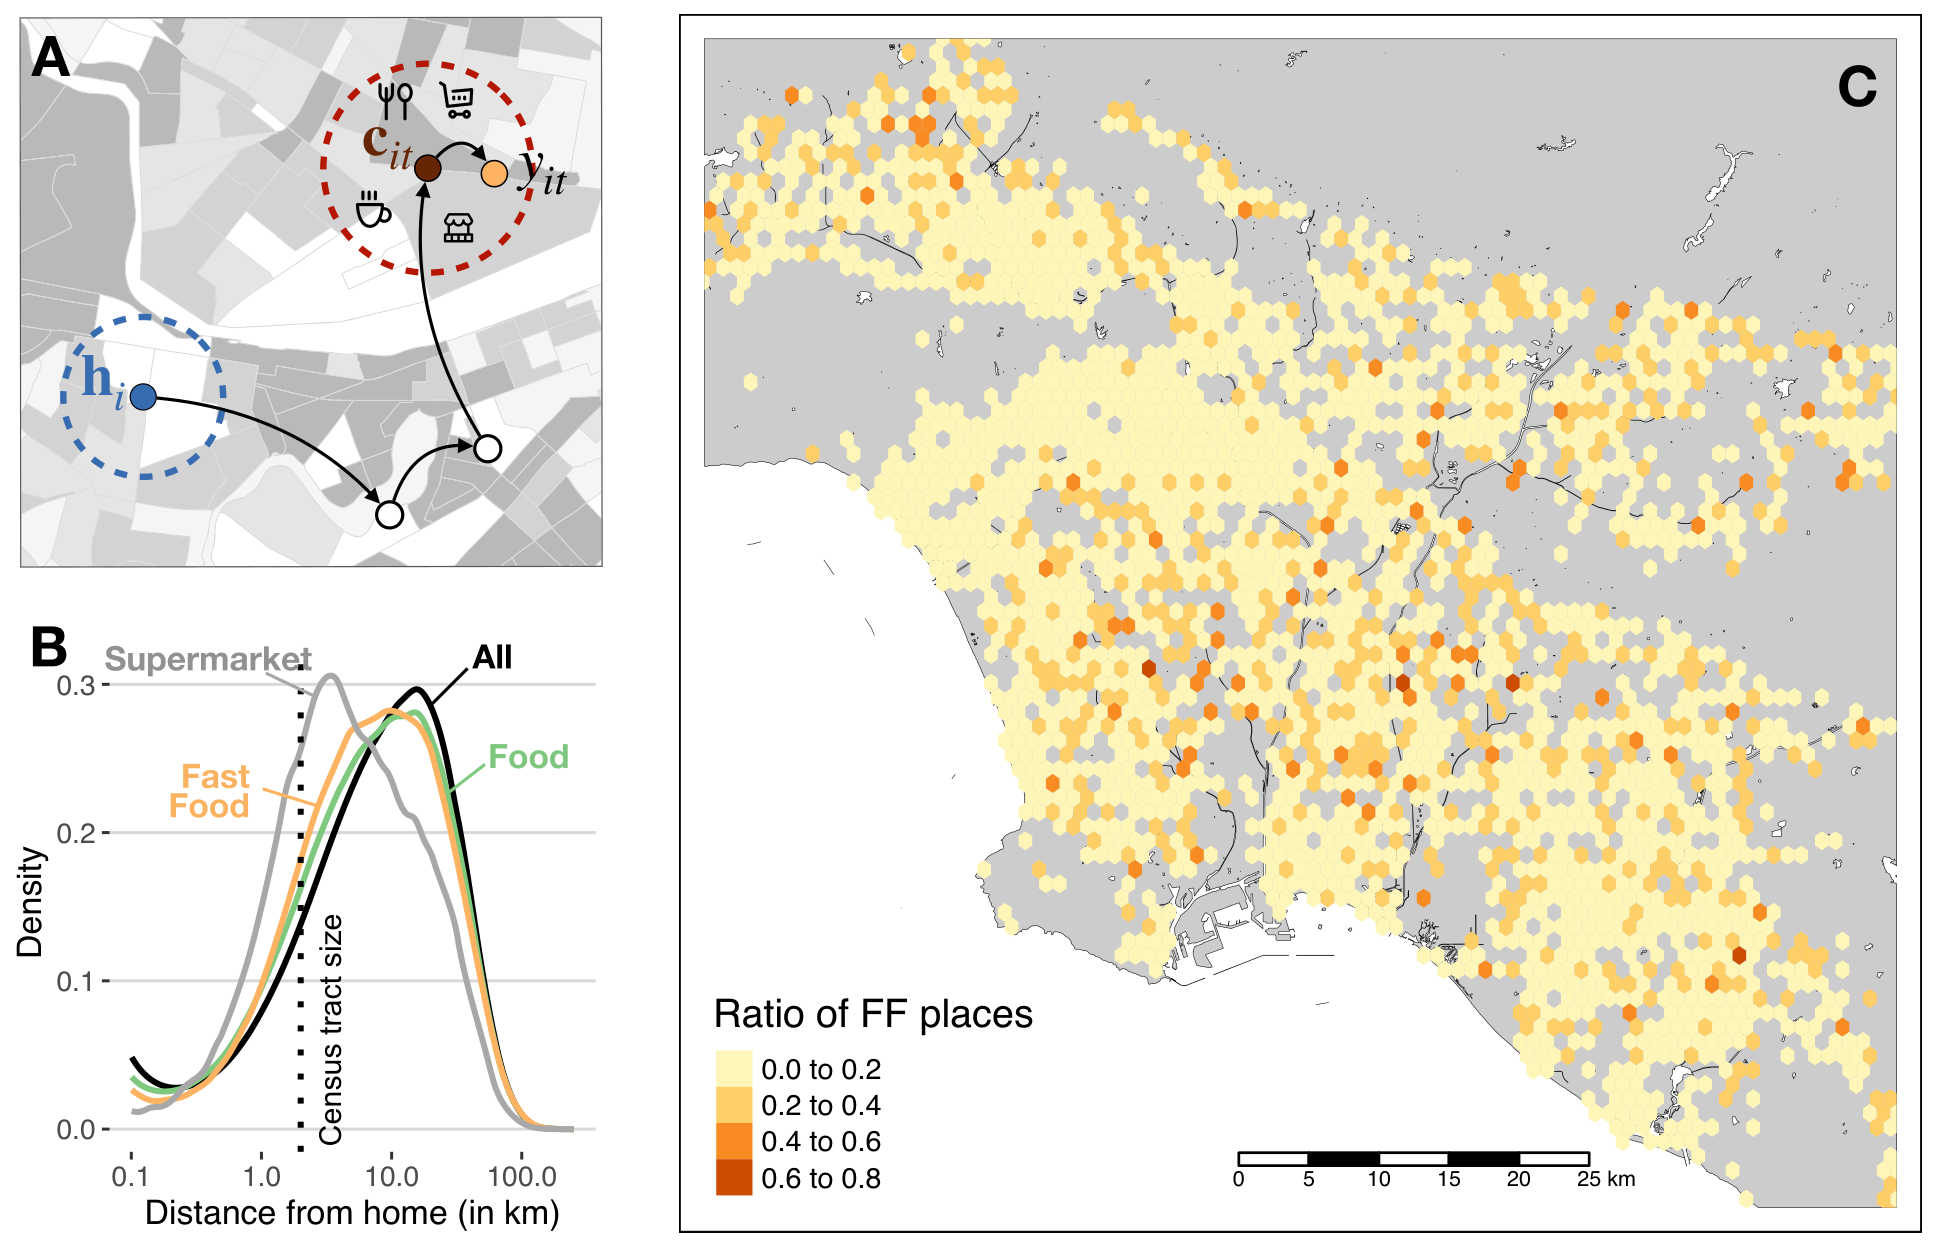
图 1|快餐到访离住所有多远,城市里的快餐占比如何分布?
(a)示意图:家 hᵢ、午餐前的上下文 cᵢₜ,以及随后的餐饮选择 yᵢₜ。虚线圆表示用来计算快餐占比的范围,不是某一次真实行程。(b)离住所距离的密度。横轴为公里、对数刻度,纵轴为密度。灰线是超市,黑线是全部到访,绿线是餐饮店,橙线是快餐店;竖虚线是普查区的典型尺度,图中没有标出具体公里数。(c)洛杉矶都市区约1平方公里六边形内的快餐店占餐饮店比例,颜色从浅黄到深橙对应0—0.2直到0.6—0.8。来源:原论文 Fig. 1。
任何到访离住所的中位距离是7.83公里(四分位距2.47—18.63公里)。任何餐饮店是6.94公里(2.30—17.23)。快餐店是6.74公里(2.50—16.62)。超市或食品杂货店是3.1公里(1.35—8.22),对应196万次到访。快餐与“全部到访”的中位数差得不多;秩双列相关系数只有0.02。超市则明显更近,同一系数是0.17。巨大样本量让很小的差别也能得到 p < 0.001,所以“统计上显著”不能读成快餐比一般到访近很多。真正拉开的对比是:超市靠近住所,快餐到访的距离分布更接近全部外出。
白天经过的快餐占比,和家门口是同一件事吗?
作者把地点 x 周围的食物环境定义成 ϕ(x):1公里半径内,快餐店数量除以餐饮店数量。家的环境 ϕʰᵢ 就是家这个点的 ϕ。移动环境 ϕᵐᵢ 把半年内每一次超过5分钟的停留都算进去,按停留时长加权,不管这次停留是不是去吃饭。它回答的是“这个人醒着停住的时间里,周围快餐占多大比例”,不是“他吃的饭里快餐占多大比例”。
移动环境的中位数是14.0%(四分位距9.7%—19.0%)。家的中位数是8.2%(0—17.5%)。二者相关 ρ = 0.213±0.001。按人口分组后,相关最高也不超过0.29。家门口快餐少的人,白天不一定停在快餐少的地方。
人口回归只保留停留超过50次的用户,补充表S3有1,001,733人,并放入都市区固定效应。解释变量来自家所在普查区块组,不是个人问卷:黑人居民比例、就业比例、大学及以上教育比例、低技能职业比例、通勤超过45分钟的比例、公共交通通勤比例,以及家庭收入中位数。低技能职业在文中包括农业、建筑、制造、批发、零售和运输。
在其他变量保持不变时,移动快餐暴露与公共交通通勤比例的系数是 −0.093,与长通勤比例是 0.050,与低技能职业是 0.040,与黑人居民比例是 0.022,与大学及以上教育是 −0.016,与收入中位数是 0.002。家的环境几乎相反:长通勤系数是 −0.073,教育是 +0.025,收入是 −0.019。这些系数的单位,论文没有写成“收入每增加1美元”或“比例每增加1个百分点”。收入若以美元原值进入,0.002会大到不可能,因此它们应是放上同一坐标后的可比系数。样本超过100万时,0.002也能 p < 0.001;相对公共交通和长通勤,收入的移动暴露系数很小。到访比例对收入的系数是 −0.0002,p = 0.722。
移动环境的 R² 是0.213,家是0.038,到访比例是0.052。随机森林略高一点:0.288、0.048和0.055。人口特征更能跟着人进入白天的食物环境,仍然解释不了一个人到底多常去快餐店。教育还有一个符号提醒:只放教育时,教育更高的普查区家里快餐更少;放进全部变量后,家的教育系数变成正的。这是变量彼此相关造成的条件系数,不能单独说成“学历高导致家门口快餐变多”。
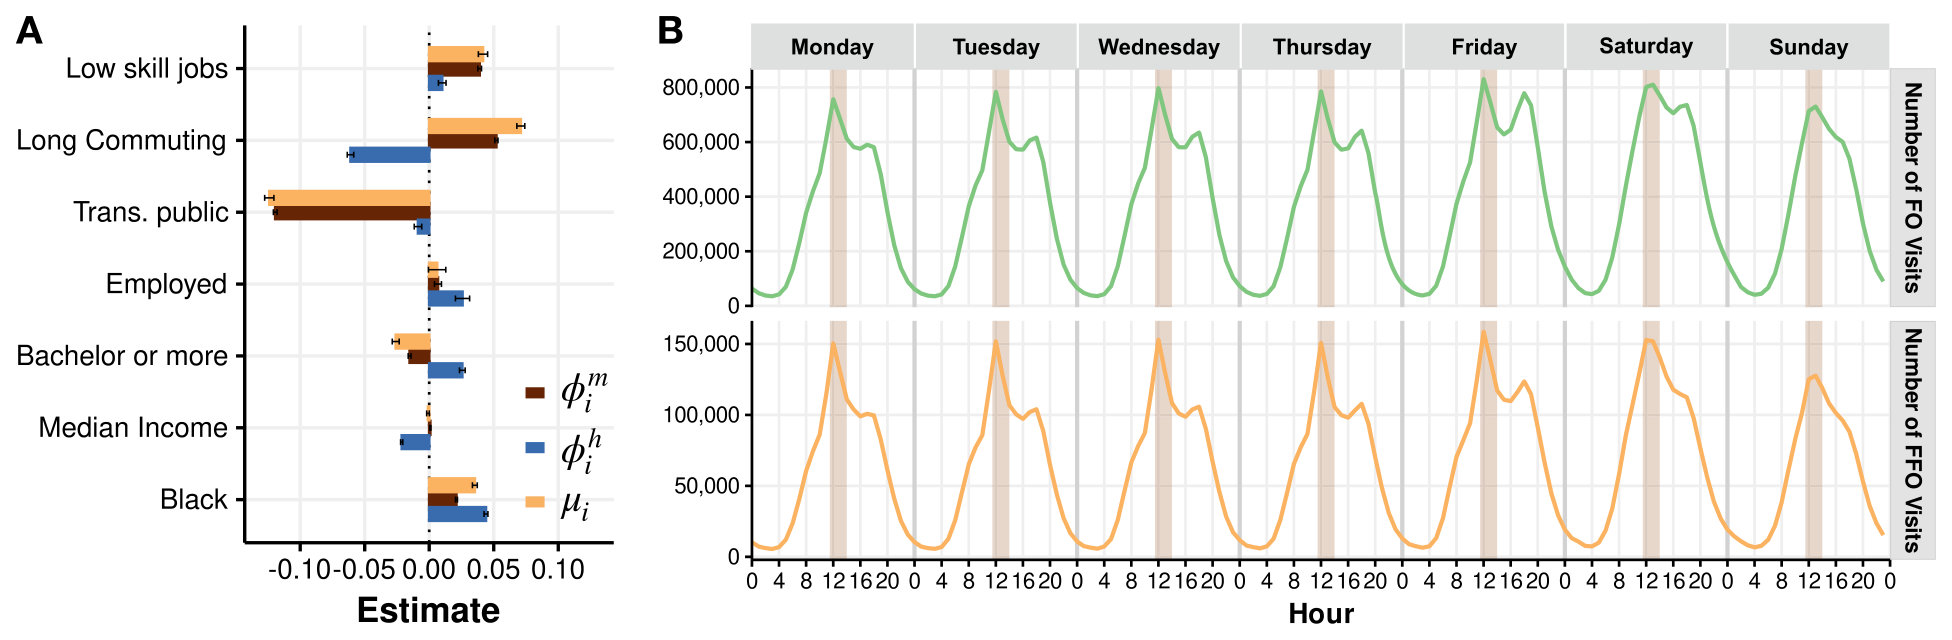
图 2|人口特征与快餐环境的关联有多大,一天中的到访何时最多?
(a)横轴是回归系数,纵轴是家所在普查区块组的特征。棕色是移动快餐占比 ϕᵐᵢ,蓝色是住所 ϕʰᵢ,橙色是用户快餐到访比例 μᵢ。误差线是系数的95%置信区间。公共交通和长通勤的条最长,收入的条接近零。(b)上为餐饮到访次数,下为快餐到访次数,横轴是周一到周日的小时。绿色和橙色曲线都在中午与傍晚升高;竖向色带是用来定义午餐选择的时段。来源:原论文 Fig. 2。
用户自己的快餐占比 μᵢ,中位数0.133,四分位距0.025—0.273。六个月里从未去过快餐店的用户占22.9%。到访比例与人口变量的 R² 只有0.052。系数可以显著,组间差别却不大:城市里很多不同背景的人都去快餐店。
午餐前最后停留的地方,怎样进入选择?
全天平均暴露和单次选择不是同一层。一个人可能长期停在快餐多的区域,也可能只是走到一家店之前,眼前的选项变了。作者把结果收窄到本地时间11:30—14:00的午餐,因为这段餐饮和快餐到访都多,而且上午的时间更紧。上下文 cᵢₜ 是11:30之前最后一次被观测到的停留。ϕ(cᵢₜ) 仍是该点1公里内快餐店除以餐饮店。只保留上下文里两类店都有的记录。补充材料在这些限制之后得到270万次午餐餐饮到访、75.5万用户。
选择写成 yᵢₜ:午餐去快餐店为1,去其他餐饮店为0。逻辑回归是
P(yᵢₜ = 1) = 1 / (1 + e^(−Xᵢₜ)),Xᵢₜ = β₀ + αᵢ + δₜ + β ϕ(cᵢₜ)。
αᵢ 是个人固定效应,把这个人半年里去快餐的平均倾向拿走。δₜ 是日期固定效应。于是 β 比较的是同一个人、不同日期、不同上下文,而不是“喜欢快餐的人”和“不喜欢的人”之间的差别。回归还要求这个人在观察期内午餐既去过快餐、也去过非快餐,所以从未去或每次都去的人不在这个系数里。全体模型有1,483,379次观测。
β = 1.872,标准误0.0335;正文写作1.87±0.033。ϕ 增加0.10时,几率变成原来的 e^(β×0.1) 倍,正文计算 (e^(β×0.1) − 1) × 100 ≃ 20%。这里的0.10是比例的绝对增量:快餐占周边餐饮店的份额升高10个百分点。它不是在原来14%上再相对增加10%(那只是1.4个百分点)。
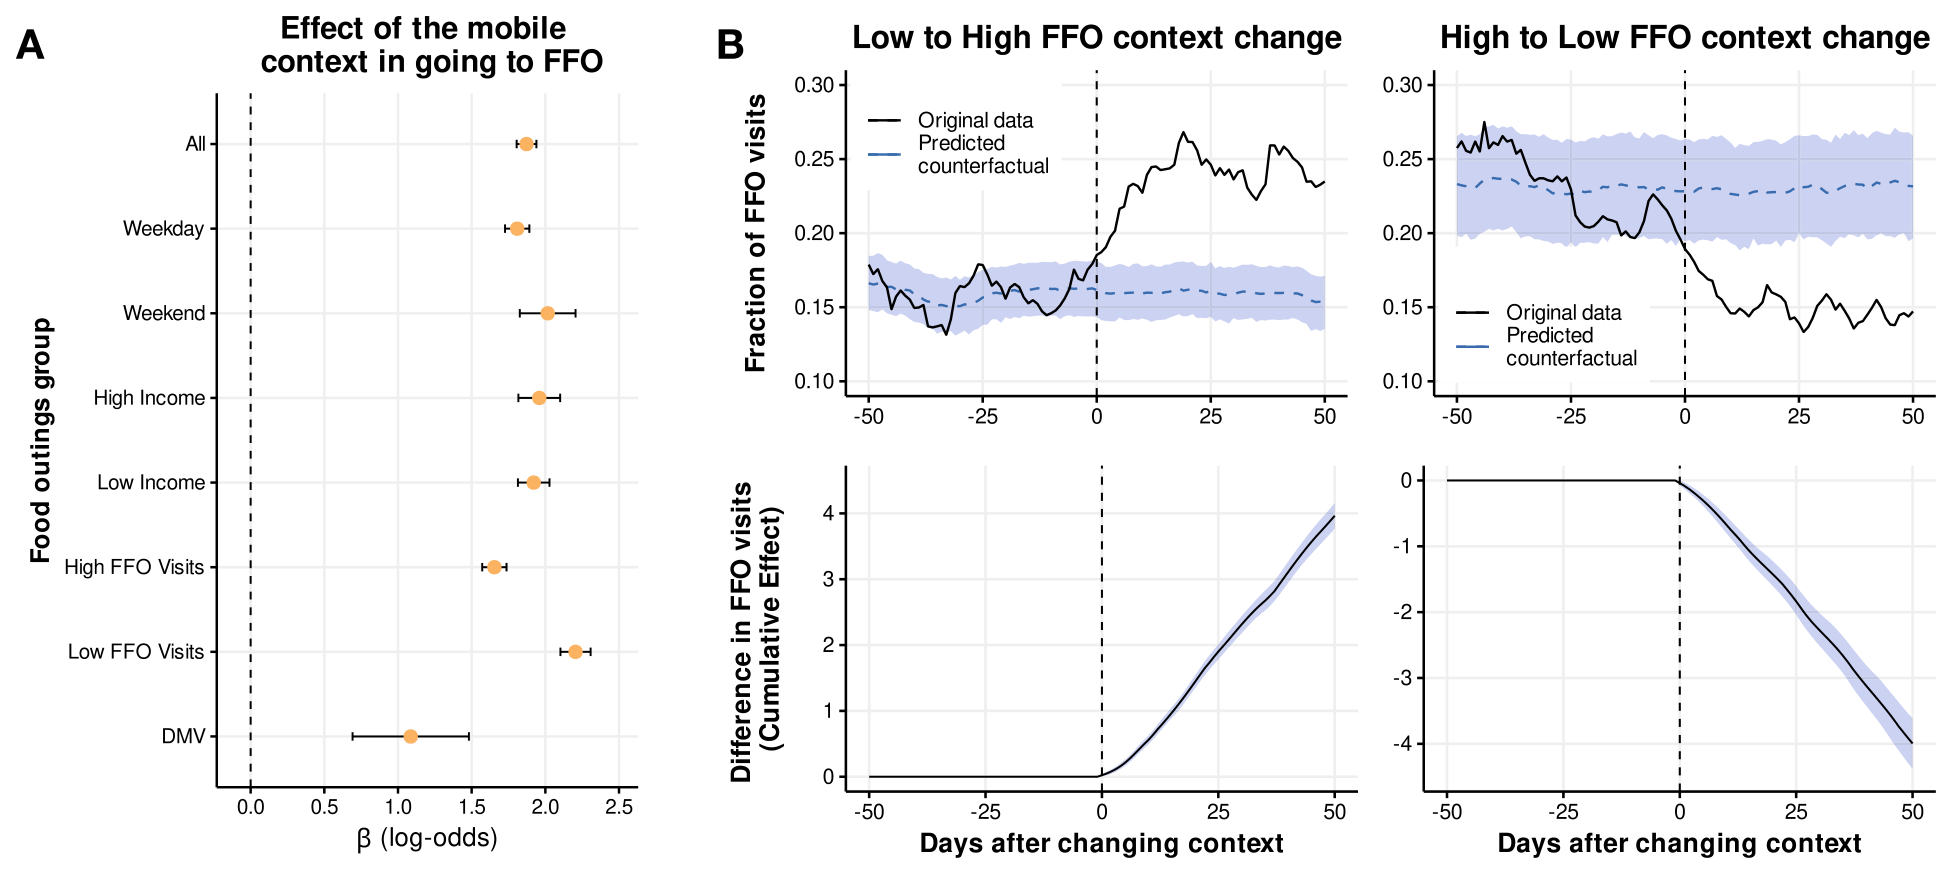
图 3|上下文的快餐占比升高后,去快餐的几率如何变化?
(a)纵轴是午餐分组,横轴是 β,即对数几率。误差线为95%置信区间。全体、工作日、周末、收入高低、快餐到访高低都明显大于0;车管所的点和区间更靠左,也仍大于0。(b)左为低快餐上下文换成高快餐,右为高换成低。上排是快餐占餐饮到访的比例,下排是相对预测对照的累计差。黑线为观测,蓝虚线为对照预测,色带为对照的95%置信区间。横轴是换上下文前后的天数。来源:原论文 Fig. 3。
分组系数仍在同一量级。工作日1.809(1,032,172次),周末2.016(182,487次)。收入两个分位是1.921(458,358次)和1.959(283,765次)。平时较少去快餐的人系数更高,2.205(789,554次);经常去的人是1.654(697,838次)。分组样本量不能加总成148万,因为每一组只保留在该组内两类店都至少出现过的记录。训练准确率在全体组是0.7546。这是同一批午餐数据上的拟合,不是独立城市的预测成绩。
移动暴露与到访比例的相关是0.268±0.001,住所环境与到访比例只有0.068±0.001。相关方向和回归一致,但相关没有拿掉个人偏好。
午餐餐饮点离住所的中位距离是9.78公里,离午餐前上下文只有1.60公里。ϕ 的空间自相关在1公里后明显衰减,所以上下文和真正吃饭的地点可以是两套店。把距离放进交互项后,上下文到午餐点超过约4.93公里时,上下文的有效对数几率可以变成负数。这样的远距离午餐只占该分析的15%。论文把这看成相关:专程走远吃饭的人,眼前这一圈店更说了不算。它没有证明走远会让快餐环境产生相反的因果作用。
同一个人换了上午常去的地方,午餐比例跟着变吗?
固定效应仍然可能漏掉“这个人为什么出现在那个上下文”。作者再找午餐前常驻普查区发生过切换的人。条件是至少两个普查区各自占到上下文的30%以上,且每个至少出现5次,再用变点检测看均值是否真的改道。结果段写这一小部分约占0.46%、约8500人。补充材料写出检出8524人。正文方法段写7913人。三处没有合成同一个整数,下文的分组比例采用补充说明:低到低、高到高各约35%,低到高、高到低各约15%。高低档的切分是 ϕ < 0.13 与 ϕ > 0.13。
对照不是“上下文地址完全没变的人”,而是地址变了、快餐档次仍停在同一侧的人。这样是为了少把“换不换地方”本身当成食物环境的效果。低到高的组,快餐占午餐餐饮到访的比例从约16%升到约25%;高到低从约24%降到约15%。对照曲线在切换后仍近乎平直。差别在50天后还在。累计曲线在第50天接近 +4 和 −4,对应正文那句50天里多(或少)4次。比例本身只变了大约9个百分点,不能读成变成原来的4倍。
这仍是观测到的行程变化。换普查区可能同时换了工作、学校或住处,食物环境只是一并改变的条件之一。作者把设计称作半因果的自然实验,并在讨论里写明还需要专门实验再检验。
去车管所时,周围的店还有作用吗?
车管所(DMV)被用来接近“人不是为了吃饭才来到这里”。选哪一处车管所,更常取决于预约和离家、离工作地的距离;周边有没有快餐,不太像选点的主要理由。数据里有5.3万次车管所到访,离家中位距离7.62公里(四分位距3.48—15.44公里),高于餐饮到访的中位距离。若餐饮到访发生在车管所停留后的2小时内,车管所就算这次午餐的上下文。进入回归的是18,733次,不是全部5.3万次。
因为多数人只有一次车管所记录,模型不再放个人和日期固定效应,而把这个人平时的快餐占比 μᵢ 放进偏好项。上下文系数是1.086,标准误0.1974;正文写作1.09±0.20。方向与午餐模型相同,数值更小,置信区间更宽。偏好项系数是5.065,说明这个人平时去不去快餐,仍然比车管所门口的店更强。车管所没有把选择变成随机试验:谁能在工作日去、住得离哪一处近,仍可能和收入、车辆和食物偏好有关。
全天版本把每一次餐饮到访往前找2小时内的非餐饮停留作为上下文。上下文变量的 t 统计量在中午最大。这个全天模型被用来估计后面的干预,系数约3.33,与午餐模型的1.87不是同一个数。个体留出测试的准确率是0.8016,地理留出是0.7766;训练分别是0.8045和0.8064。地理留出时,区域快餐到访次数的预测与观测相关 R = 0.95,到访比例的相关 R = 0.64。正文方法段概括成个体约80%、区域约90%。80%接近个体留出准确率;90%更接近次数相关,不是比例相关,也不是地理留出的77.66%准确率。
亚洲餐饮和拉丁美洲餐饮的上下文系数大于快餐,补充图没有在正文给出精确点估计,这里不补读数。它们的上下文平均占比更低:亚洲餐饮0.089,拉丁美洲餐饮0.081,快餐0.162。系数更大,部分因为基线占比更小。这只说明移动环境也影响其他品类的到访,不能推出这些品类比快餐更不健康或更健康。
若只能改100家店,改哪里减少的快餐到访更多?
前面的系数被放进一个反事实计算。若区域 Ω 的快餐占比因干预改变,快餐到访次数的变化近似为每个决策上的逻辑函数斜率,乘以占比的变化,再把区域内的决策加总。斜率在个人很偏好快餐、或者根本不吃快餐时都较小;决策次数少的区域,加总也小。所以快餐占比最高的地方,不一定是改动后到访变化最大的地方。
示意性的“同样努力”是让一个区域的快餐相对餐饮平衡移动大约一家店,占比变化约 −1/nΩ,nΩ 是该区域餐饮店数量。正文先写资源只够改100家餐饮店,后文把同一比较写成改变100家快餐店,占全部快餐店的0.22%。四种选点方式是:快餐占比最高的食物沼泽;既是高占比、又被美国农业部标成低收入且超市可达性低的区域;餐饮决策最多的热点;按上述公式算出的到访变化最大的行为—环境地点。每种都取排序最前的100个区域。
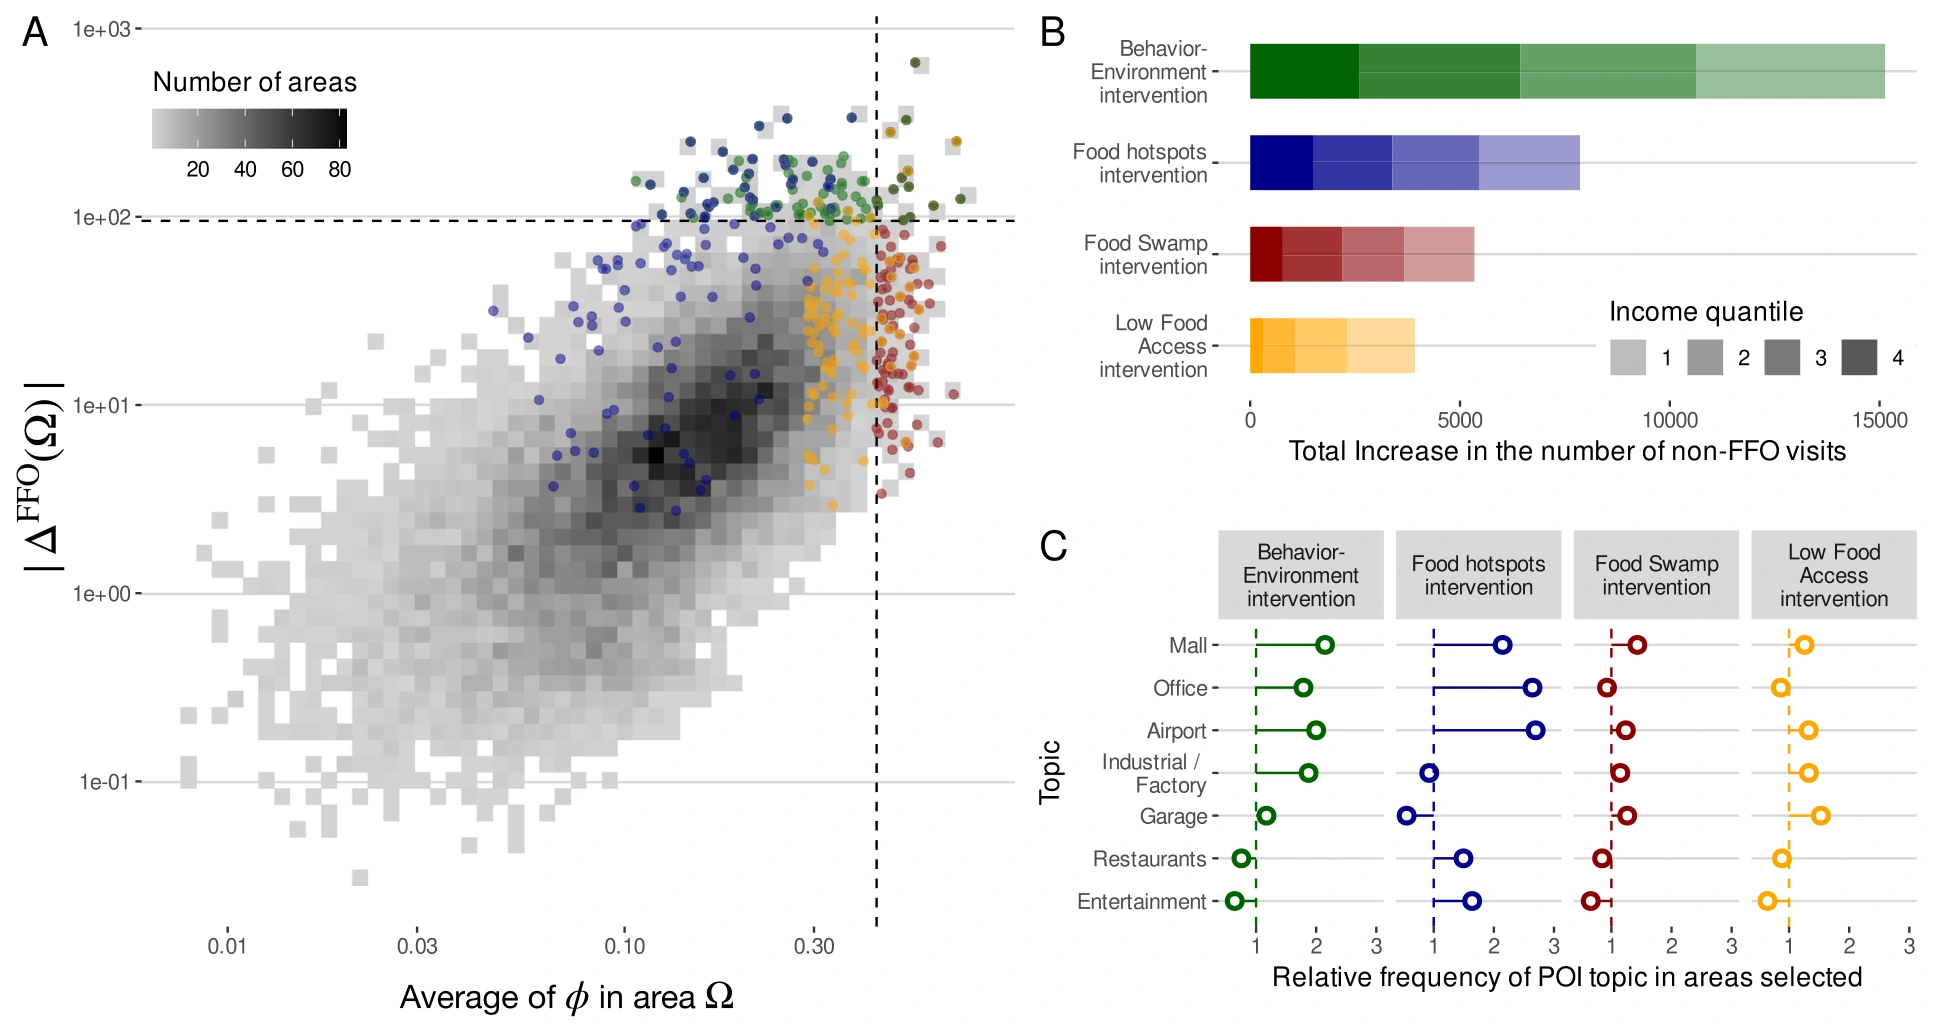
图 4|同样改动快餐占比,四种选点方式差多少?
(a)每个点是一个普查区。横轴是该区域平均快餐占比 ϕ,纵轴是干预带来的快餐到访变化绝对值,纵轴为对数刻度。颜色深浅表示落在该处的区域多少。竖虚线右侧的红点是按快餐占比选出的100个食物沼泽,横虚线以上的绿点是按到访变化选出的100个行为—环境区域;橙点是低食品可及,蓝点是餐饮热点。(b)四种策略带来的非快餐到访增加。横轴刻度到15000,颜色由浅到深是收入第1到第4分位。行为—环境的条最长。(c)被选区域里,兴趣点主题相对全部区域的出现频率,1为与全部区域相同。绿、蓝、红、橙分别对应四种策略。来源:原论文 Fig. 4。
同一平均 ϕ 下,到访变化可以差两个数量级。食物沼泽和低食品可及选中的区域,很多决策次数少,或人对环境不敏感。餐饮热点决策多,但那里的人较少被周边选项左右。正文给出的总效果是:行为—环境策略比只看决策发生地或住所周边的策略高1.93倍到3.85倍。摘要把这一范围写成2倍到4倍。改动这0.22%的快餐店,行为—环境策略大约避免0.56%的快餐到访,其他策略至多0.29%。按总人口放大后,半年约71.9万次,其他策略至多44.2万次。图4B横轴是样本内非快餐到访的增加,刻度到15000;71.9万是放大后的另一套分母,不能从横轴直接读出。
收入四个分位都有变化,没有集中在某一档。对高肥胖或高糖尿病患病率群体的决策,行为—环境策略仍比其余策略高2倍到2.5倍。这是普查区患病率分组下的模拟,不是诊断了个人疾病。城市之间也不完全一样。正文写费城、西雅图和洛杉矶里,行为策略相对静态策略的优势略小。补充材料写波士顿、芝加哥和华盛顿的优势更大;费城和西雅图仍高于餐饮热点,但小于前一组城市。
被选中的区域用兴趣点主题描述。潜在狄利克雷分配的文档—词矩阵是18898个普查区、614类兴趣点,取20个主题;正文方法段写的是18896个普查区。这一步只用兴趣点的空间分布,不用到访。商场、工厂、机场和办公室更常出现在行为—环境策略的区域。餐厅和娱乐场所更常出现在餐饮热点,而那些地方的干预模拟效率更低:决策很多,环境改变带来的转向更少。
模拟假定人仍按原来的逻辑回归做选择,也假定改动只改变 ϕ、不改变谁会来到这个区域。它没有估计店租、就业、价格和新店实际能否开成。英格兰东北部一项分区禁开新快餐店曾被别的研究估计为 ϕ(x) 下降15%,那是已实施政策的外部例子,不是这100家店的实测结果。
这些结果不能直接说成少买了多少快餐
到访超过5分钟,并不保证付款。作者认为它是潜在快餐摄入的代理,而且因为漏掉很短的驾车购买,更像下限。同一套数据上的另一项研究曾把快餐到访与自我报告摄入、肥胖和2型糖尿病联系起来;那是关联,不是本图里的每一家店都卖同一种食物。快餐店菜单里也有相对没那么能量密集的选项,本文没有逐店区分。
最近兴趣点规则在商场、多层建筑里容易归错,而快餐恰恰常开在这些建筑中。2016—2017年的行程也没有覆盖疫情后更多时间留在住所附近、以及外卖覆盖变广的情况。作者认为,在人仍被周围选项约束的场合,这套移动框架还适用;这句话是外推,不是新的疫情后样本。
一句话总结
家门口快餐少,说明不了一个人少去快餐店:多数快餐到访在自家普查区之外,而午餐前那一圈店的快餐占比升高0.10,会在本来两类店都去的人里,把去快餐的几率大约提高20%。
核心来源
- Nature Communications 正式页面,核对题目、作者、收稿日期与正文图1—4。
- 补充材料,表S1、S3—S7与补充说明1—13。正文图来自正式版,补图没有另贴。
- 可复现聚合数据与分析代码。Spectus 原始轨迹不公开。
作者介绍
- Bernardo García Bulle Bueno:论文署名为麻省理工学院数据、系统与社会研究所。参与设计、分析并与 Moro 合写初稿。该校课题组页面介绍他当时在该所攻读博士,并拥有墨西哥 ITAM 的经济学学士与计算机硕士。
- Abigail L. Horn:署名为南加州大学凯克医学院人口与公共卫生科学系,以及维特比工程学院工业与系统工程系;现地址为该校信息科学研究所。参与研究设计。本文引用的到访与自我报告摄入对照,也出自她参与的同一数据系列。
- Brooke M. Bell:署名为南加州大学人口与公共卫生科学系,以及耶鲁大学公共卫生学院慢性病流行病学系。参与结果讨论和改稿。
- Mohsen Bahrami:署名为麻省理工学院数据、系统与社会研究所。参与结果讨论和改稿。
- Burçin Bozkaya:署名为土耳其萨班哲大学萨班哲商学院。参与结果讨论和改稿。
- Alex Pentland:署名为麻省理工学院数据、系统与社会研究所。麻省理工学院媒体实验室的相关项目页将他列为媒体艺术与科学教授。参与结果讨论和改稿。
- Kayla de la Haye:署名为南加州大学经济与社会研究中心。参与研究设计、结果讨论和改稿。
- Esteban Moro:通讯作者。署名为麻省理工学院数据、系统与社会研究所,马德里卡洛斯三世大学数学系与跨学科复杂系统小组,以及东北大学网络科学研究所。参与设计、分析并与 García Bulle Bueno 合写初稿。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若把2024年以后的外卖列表也看成一种上下文,物理上的1公里圆会漏掉真正被看见的选项。可以沿用同一比较:列表里快餐占比升高0.10时,下单几率是否仍大约升高20%,以及这个增量是出现在所有用户,还是只出现在本来两类店都会点的人。论文的午餐系数不能直接当成这个答案。
按到访变化挑选前100个区域,商场、机场和工厂会靠前。这些地点的访客,不一定是糖尿病或肥胖负担最高、又最少有其他选择的人。论文已经按普查区患病率看过模拟倍数,但规划目标若是缩小群体差距,排序本身应改成“高负担群体被转向的决策数”,再和现在这条总到访最大的名单对照。两份名单会不会是同一批100个普查区,需要单独算。
还有一个边界可以直接变成反例。补充模型里,上下文离午餐点超过约4.93公里后,环境项的有效对数几率可以变负,而这只占约15%的午餐。专程去某一家店的人,不会因为上班地少了一家快餐店就改主意。因此任何按上下文改店的方案,上限首先取决于有多少决策仍发生在离上下文1.60公里这个中位数附近。