四种交通方式各自更像对数正态,合在一起为什么又像幂律?
论文名片|Kai Zhao、Mirco Musolesi、Pan Hui、Weixiong Rao、Sasu Tarkoma,Explaining the power-law distribution of human mobility through transportation modality decomposition,Scientific Reports,2015,5:9136。DOI:10.1038/srep09136。2014年10月29日收稿,2015年2月9日接收,2015年3月16日发表。
一个人从城区一侧出发,先坐出租车,下车走一小段,再进地铁;办完事,又坐出租车回到原点。短的几段多半是步行,长的几段多半是地铁或一开始那段出租车。若把许多人、许多方式的直线位移合在一起,短的很多、长的很少,长度分布会拖出一条重尾。以往用钞票、手机和 GPS 看到的人类移动性(human mobility,人在空间中的移动,这里指日常出行中的位移,不是人口迁移)常被说成莱维飞行(Lévy flight):跳跃长度服从幂律。这篇论文也使用莱维游走(Lévy walk)这个说法。它真正测量的是直飞段长度,再问这条幂律是不是由不同交通方式叠出来的。
直飞段(flight)是方向基本不变的最长直线位移。从起点到终点的一次行程可以含有好几段。定位精度写的是 3 米;他们先把约一分钟内的坐标取平均,并允许中间点偏离两端点连线不超过 10 米,从而把小曲折并进同一段。下面所有分布都建立在这个长度定义上。
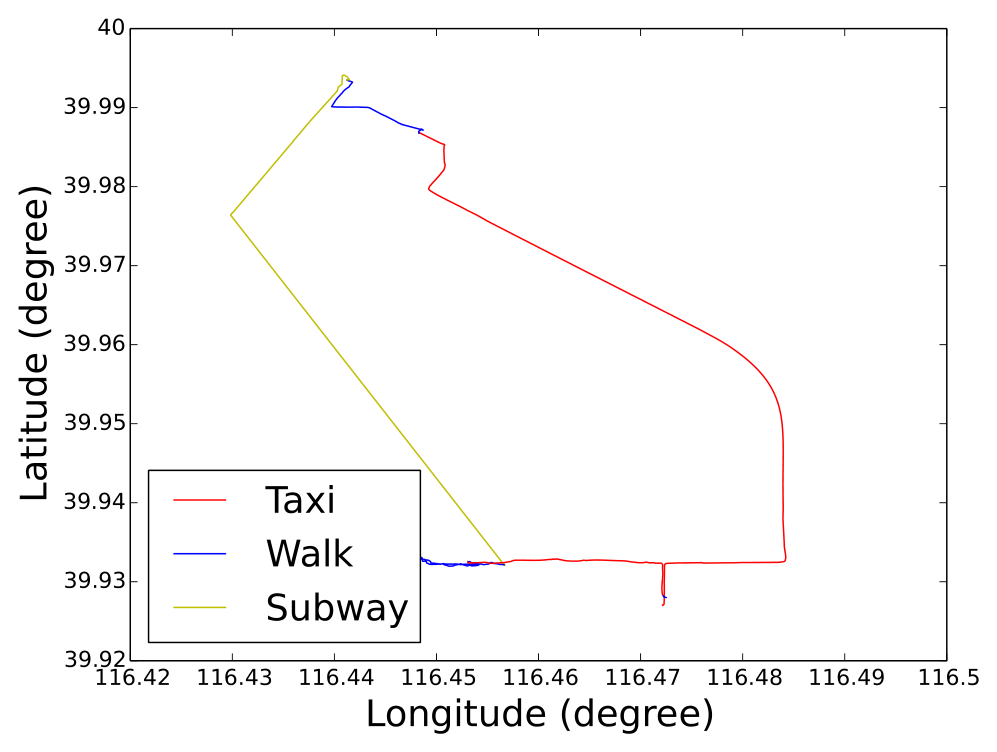
图 1|一天之内,出租车、步行和地铁的位移是不是同一种长短?
无字母子图。横轴经度、纵轴纬度,单位为度,大约覆盖东经 116.42–116.50、北纬 39.92–40.00,落在北京。红线是出租车,蓝线是步行,黄线是地铁。出租车占了右侧较长的一条弯曲线,地铁是一条斜穿的长线,步行只有短短几截。图注称这是一条合成的一日轨迹,用来展示三种方式的长度差得很明显。它本身只是示意,不能代替后面的分布拟合。来源:原论文 Fig. 1。
方向性结论:在两套带交通方式标签的 GPS 里,不分方式时,直飞段长度更接近带指数截断的幂律;步行/跑步、自行车、小汽车/公交/出租车、地铁/火车分开之后,各自更接近对数正态。作者用两件经验事实把二者接起来:同一方式内相邻两段长度正相关,各方式上的停留时间呈指数分布。若干对数正态再按指数时间混合,数学上可以给出幂律。代回参数后的指数,和直接拟合的指数很接近。混合分布能够复现总体形状。这组结果还不说明人们为了制造幂律而去选择交通工具。
先说结论
- 不分方式时,Geolife 的 202,702 段拟合为截断幂律,指数 α=1.57、截断参数 c=0.00025;Nokia MDC 的 224,723 段为 α=1.39、c=0.00016。相对对数正态的对数似然比分别为 1279.98 和 3279.82(p<0.01)。图上两条曲线仍然贴得很近。
- 四种方式各自更符合对数正态。对数长度的均值 μ 从步行到地铁上升。Geolife 里地铁 μ=7.27,路面机动车 μ=5.78;Nokia 里这两类几乎挨着,分别是 6.93 和 6.89。
- 同一方式内,相邻直飞段长度的皮尔逊相关系数落在 0.3640 到 0.6445(p<0.01)。变化率本身在相邻间隔之间只有 0.03 到 0.13 的相关(p<0.05)。
- 作者把各方式停留时间描述为指数分布。Geolife 里,连接其他方式的步行直飞段中,87.93% 的距离在 500 米以内,并且行程时间在 5 分钟以内。混合公式给出 α′=1.55 和 1.40,对应直接拟合的 1.57 和 1.39。
- 北京 433,391 条道路的长度分布指数为 3.4,大于两套直飞段的 1.57 和 1.39。路段更薄的尾巴解释不了直飞段里那些更长的位移。
统计的是带方式标签的直飞段
两套数据都是志愿者 GPS,带有交通方式。Geolife 主要在北京,也包含其他城市的游览和步行;Nokia MDC 的表 1 写日内瓦,正文写莱芒湖地区。方式分成四类:步行/跑步、自行车、小汽车/公交/出租车、地铁/火车。表 2 把第三类写成 Car/Bus/Taxi,正文常写成 Car/Taxi/Bus,指的是同一组,没有再拆开小汽车、公交和出租车。作者认为这四类覆盖最常用的情形;正文没有给出每类占全部直飞段的比例。
Geolife 的方式由参与者自己记录,论文把记录当作实际采用的方式。自我记录可能记错,正文没有报告核对比例。
| Geolife | Nokia MDC | |
|---|---|---|
| GPS 样本数 | 24,876,978 | 11,077,061 |
| 时段 | 2007年4月–2012年8月,约5年 | 2009年9月–2011年4月,约1.5年 |
| 采样间隔 | 1–5秒 | 10秒 |
| 标称精度 | 3米 | 3米 |
| 参与者 | 182人 | 200人 |
| 带方式标签的直飞段 | 202,702 | 224,723 |
摘要里的大约 2000 万和 1000 万,是对表中样本数的约数。Geolife 还给出全部轨迹合计 1,292,951 公里、50,176 小时。这是数据集总里程和总时长,论文没有把它说成那 202,702 段直飞段的长度之和。分析单位是段,同一名参与者可以贡献很多段;论文没有报告每人段数的分布,因此不能把段的分布读成“一个典型居民的一天”。
合在一起时,截断幂律比另外三条曲线更受支持
不分方式时,候选分布有四条:截断幂律、对数正态、不截断的幂律、指数分布。截断幂律写成 P(l) ∝ l−α e−cl。前面的幂让短段很多、长段变少,后面的指数项在更长的距离上把尾巴压下去。幂律的拟合下界用各候选起点的柯尔莫哥洛夫–斯米尔诺夫距离挑选,正文没有列出选中的下界。长尾用对数分箱减弱末端噪声。分布之间用赤池权重比较:它把赤池信息量的差距归一化到 0 和 1 之间,越大表示在这组候选里相对越受支持,不是分类正确率。
作者把截断幂律视为不分方式时的最佳拟合,并写相应幂律分布的赤池权重在两套数据里都是 1.0000,p 值小于 0.01。表 2 把总体和每种方式的 p 都印成 0.00。因为截断幂律和对数正态都是这个数,单靠这一列分不出谁更好。作者另外用对数似然比比较截断幂律和对数正态:比为正,表示数据更倾向截断幂律。Geolife 为 1279.98,Nokia MDC 为 3279.82,显著性都标为 p<0.01。似然比是整批直飞段累加的结果。段数分别是 202,702 和 224,723,所以图上很小的分离也可以累加成很大的比值。作者自己也写,图 2 里各曲线的差别并不醒目,截断幂律和对数正态尤其接近。
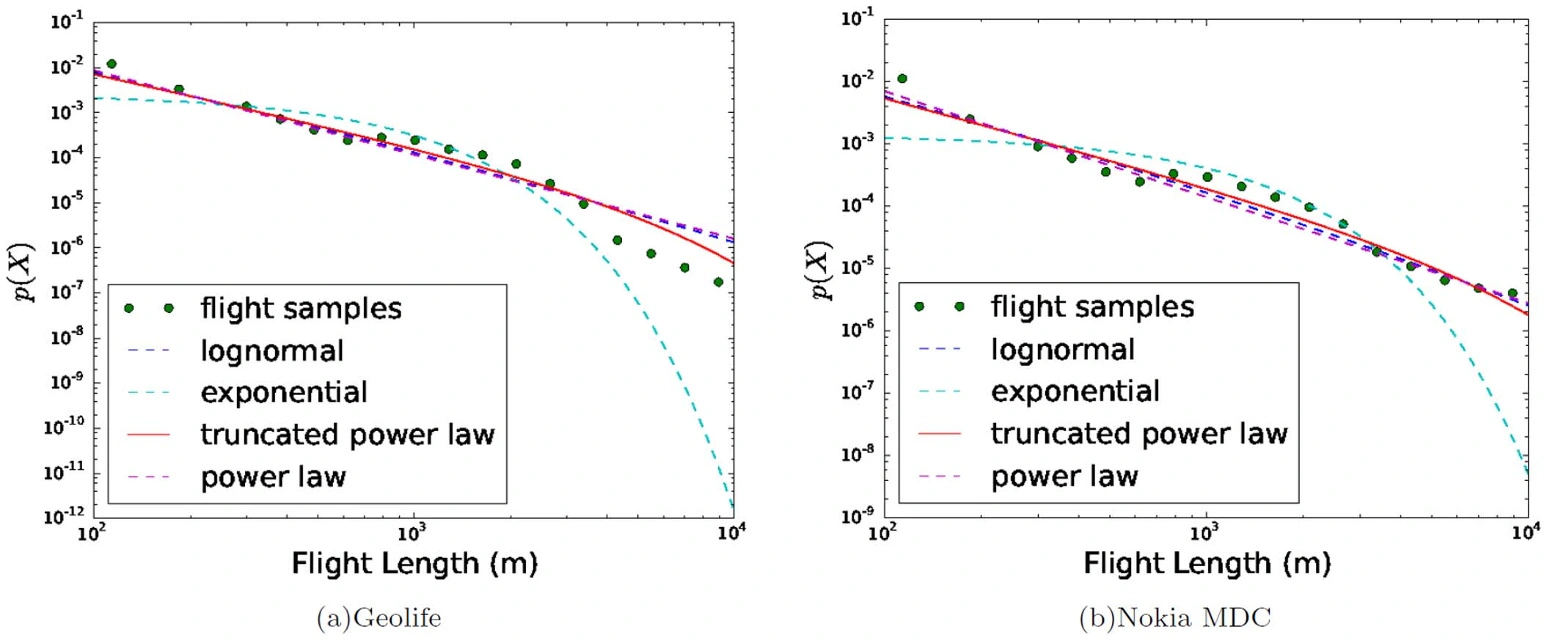
图 2|不分交通方式时,哪条曲线更贴直飞段长度?
(a)Geolife,(b)Nokia MDC。横轴是直飞段长度,单位米,对数坐标,大约从 102 米到 104 米;纵轴是概率密度 p(X),对数坐标。正文的长度符号是 l,图上写成 X。绿点是样本,红色实线是截断幂律,紫色虚线是对数正态,青色虚线是指数分布,品红色虚线是不截断的幂律。赤池权重选中的是红色实线。它和紫色虚线在中段几乎叠在一起;青色虚线到了长距离下降更快;品红色虚线更直,Geolife 最右侧的点落到它下方。来源:原论文 Fig. 2。
若长度以米计,c=0.00025 和 0.00016 对应的尺度 1/c 分别为 4000 米和 6250 米。这是按 e−cl 做的换算,论文没有把这两个长度写成结论。α=1.57 与 1.39 只说明在各自的拟合区间里,密度随长度下降的陡峭程度;作者认为它们接近先前研究,正文没有重列那些研究的指数。
拆开四种方式以后,样本弯成对数正态
同一批直飞段按方式分开后,幂律不再是更好的拟合。作者报告每一类都由对数正态描述得更好,参数随方式变化。对数正态密度是
P(l) = 1 / (l σ √(2π)) × exp( −(ln l − μ)2 / (2σ2) )。
这里 μ 和 σ 是 ln(l) 的均值和标准差,不是平均米数。μ 越大,分布中心在对数尺度上越靠右。
| 数据 | 方式 | 拟合分布 | 参数 |
|---|---|---|---|
| Geolife | 全部方式 | 截断幂律 | α=1.57,c=0.00025 |
| Geolife | 步行/跑步 | 对数正态 | μ=4.08,σ=0.76 |
| Geolife | 自行车 | 对数正态 | μ=5.03,σ=0.68 |
| Geolife | 小汽车/公交/出租车 | 对数正态 | μ=5.78,σ=1.04 |
| Geolife | 地铁/火车 | 对数正态 | μ=7.27,σ=0.51 |
| Nokia MDC | 全部方式 | 截断幂律 | α=1.39,c=0.00016 |
| Nokia MDC | 步行/跑步 | 对数正态 | μ=4.58,σ=1.09 |
| Nokia MDC | 自行车 | 对数正态 | μ=5.80,σ=1.08 |
| Nokia MDC | 小汽车/公交/出租车 | 对数正态 | μ=6.89,σ=0.91 |
| Nokia MDC | 地铁/火车 | 对数正态 | μ=6.93,σ=0.94 |
表中 p 一律印成 0.00,表注解释为小于 0.01。μ 的顺序在两套数据里都是步行、自行车、路面机动车、地铁/火车。Geolife 地铁与路面机动车相差 1.49;Nokia 只相差 0.04。因此“地铁把人送到更远的地方”在北京这套参数里很清楚,在莱芒湖这套参数里,地铁/火车和路面机动车的对数中心几乎相同。Geolife 地铁的 σ=0.51,是该数据集四种方式里最小的,分布更窄;更靠右主要来自更大的 μ。
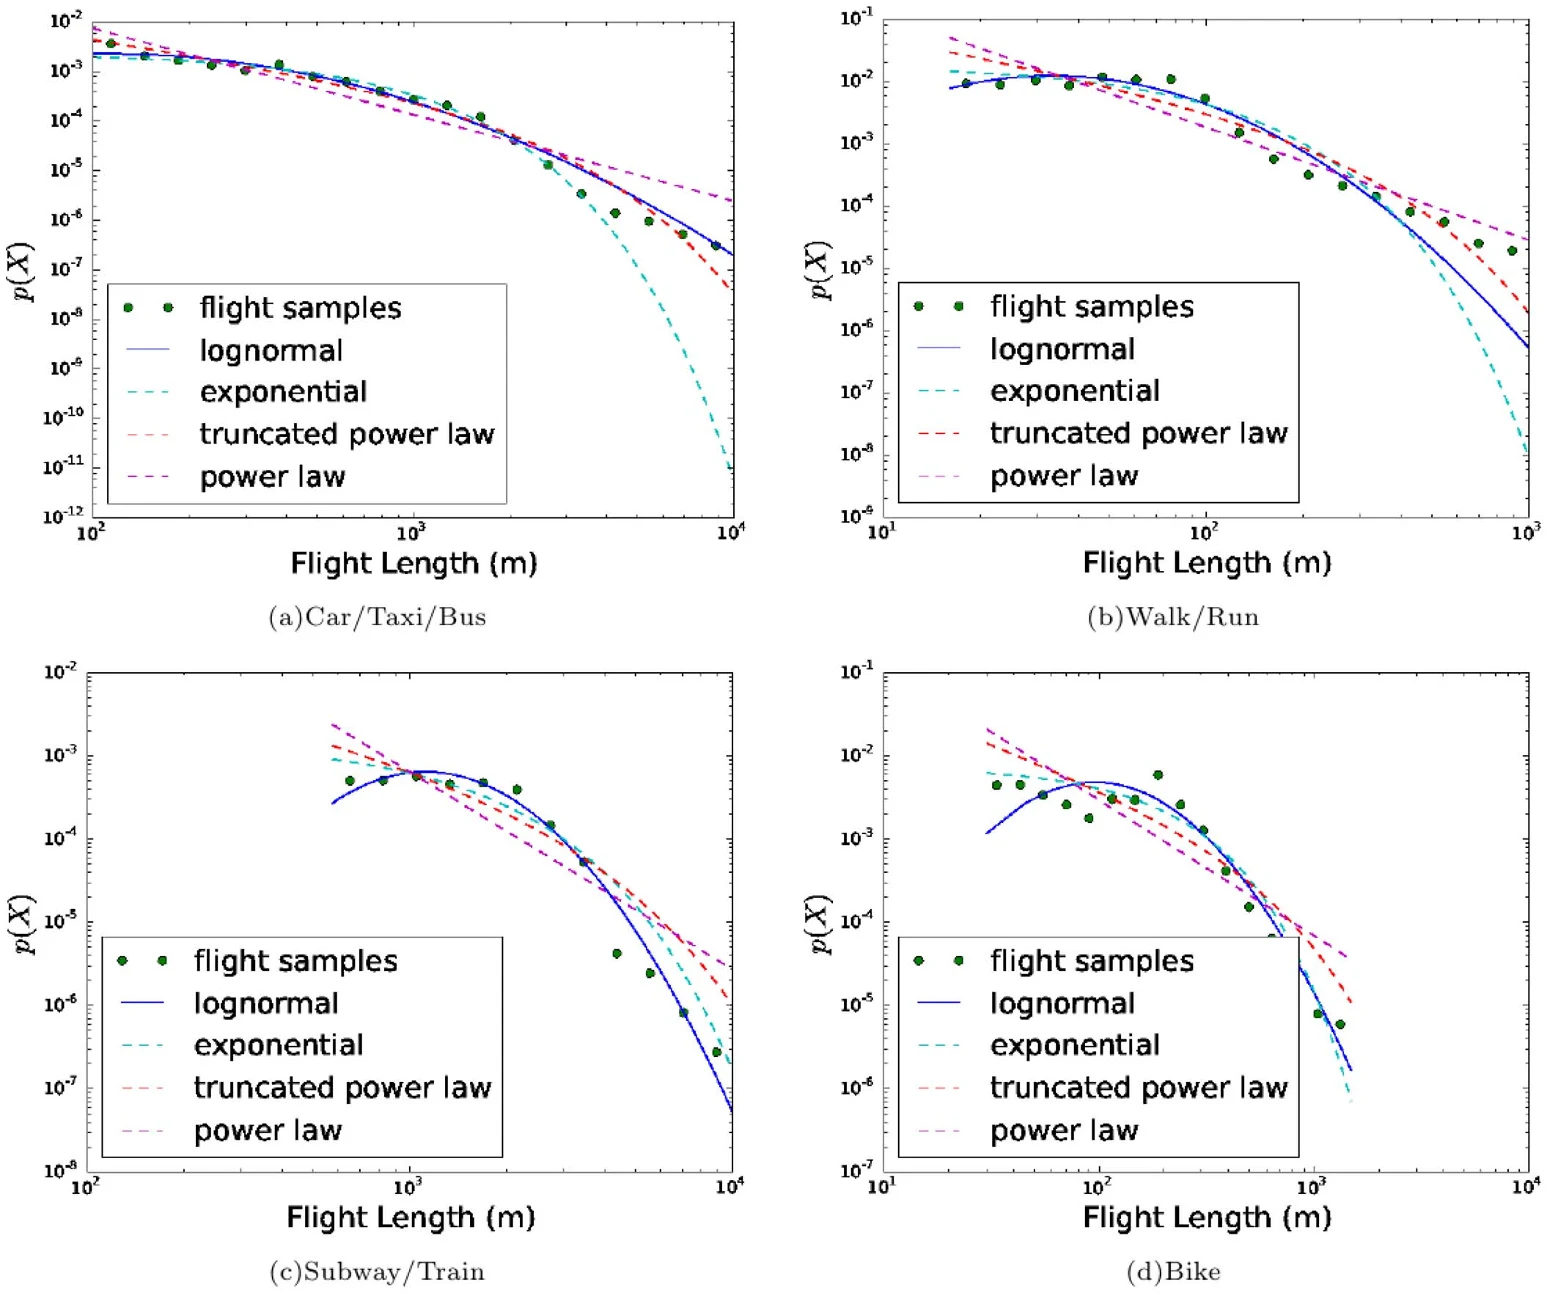
图 3|Geolife 里,每种方式单独看还像一条幂律吗?
(a)小汽车/出租车/公交,(b)步行/跑步,(c)地铁/火车,(d)自行车。绿点是该方式的直飞段,蓝色实线是对数正态,青色、红色、品红色虚线依次为指数、截断幂律和纯幂律。横轴仍是米、对数坐标:步行大约画到 103 米,路面机动车和地铁/火车大约画到 104 米。蓝色实线跟着样本先缓后弯;纯幂律太直,指数在长段掉得更陡。地铁的点主要落在更长的距离上。这张图只有 Geolife;Nokia 的单方式参数见表,曲线不在这张图里。来源:原论文 Fig. 3。
这组结果和只看出租车 GPS 的研究不同。那些研究发现出租车位移更接近指数衰减,下降更快。作者的解释是,很少有人愿意为很长的路程付出租车费,所以纯出租车样本的尾巴更薄;本文的路面机动车还包含小汽车和公交。本文没有把三类再分开拟合,这组对数正态因此沿用不到只含出租车的研究上。
相邻两段靠得近,对数正态从哪里来?
对数正态若要成为机制而不只是一条拟合曲线,需要说明长度为什么会变成对数之后的正态。作者看的是同一方式、同一段连续行程里的相邻直飞段。变化率 ct 定义为下一段相对上一段的增减:(lt+1 − lt) / lt。于是下一段长度等于上一段乘以(1+变化率)。把一段行程里的变化率加起来,近似等于末段与初段长度之比的自然对数。
若每次变化率都不大,相邻两段就会落在长度相近的位置。图 4 用点的密度看这件事。皮尔逊相关系数 r 衡量线性相关的强弱,1 为完全同向,0 为无线性相关。正文给出的 r 全部为正,范围是 0.3640 到 0.6445,p<0.01。0.36 表示中等程度的同向关系,0.64 更强,相邻段倾向于长度相近。正文没有按方式列出每一个系数。
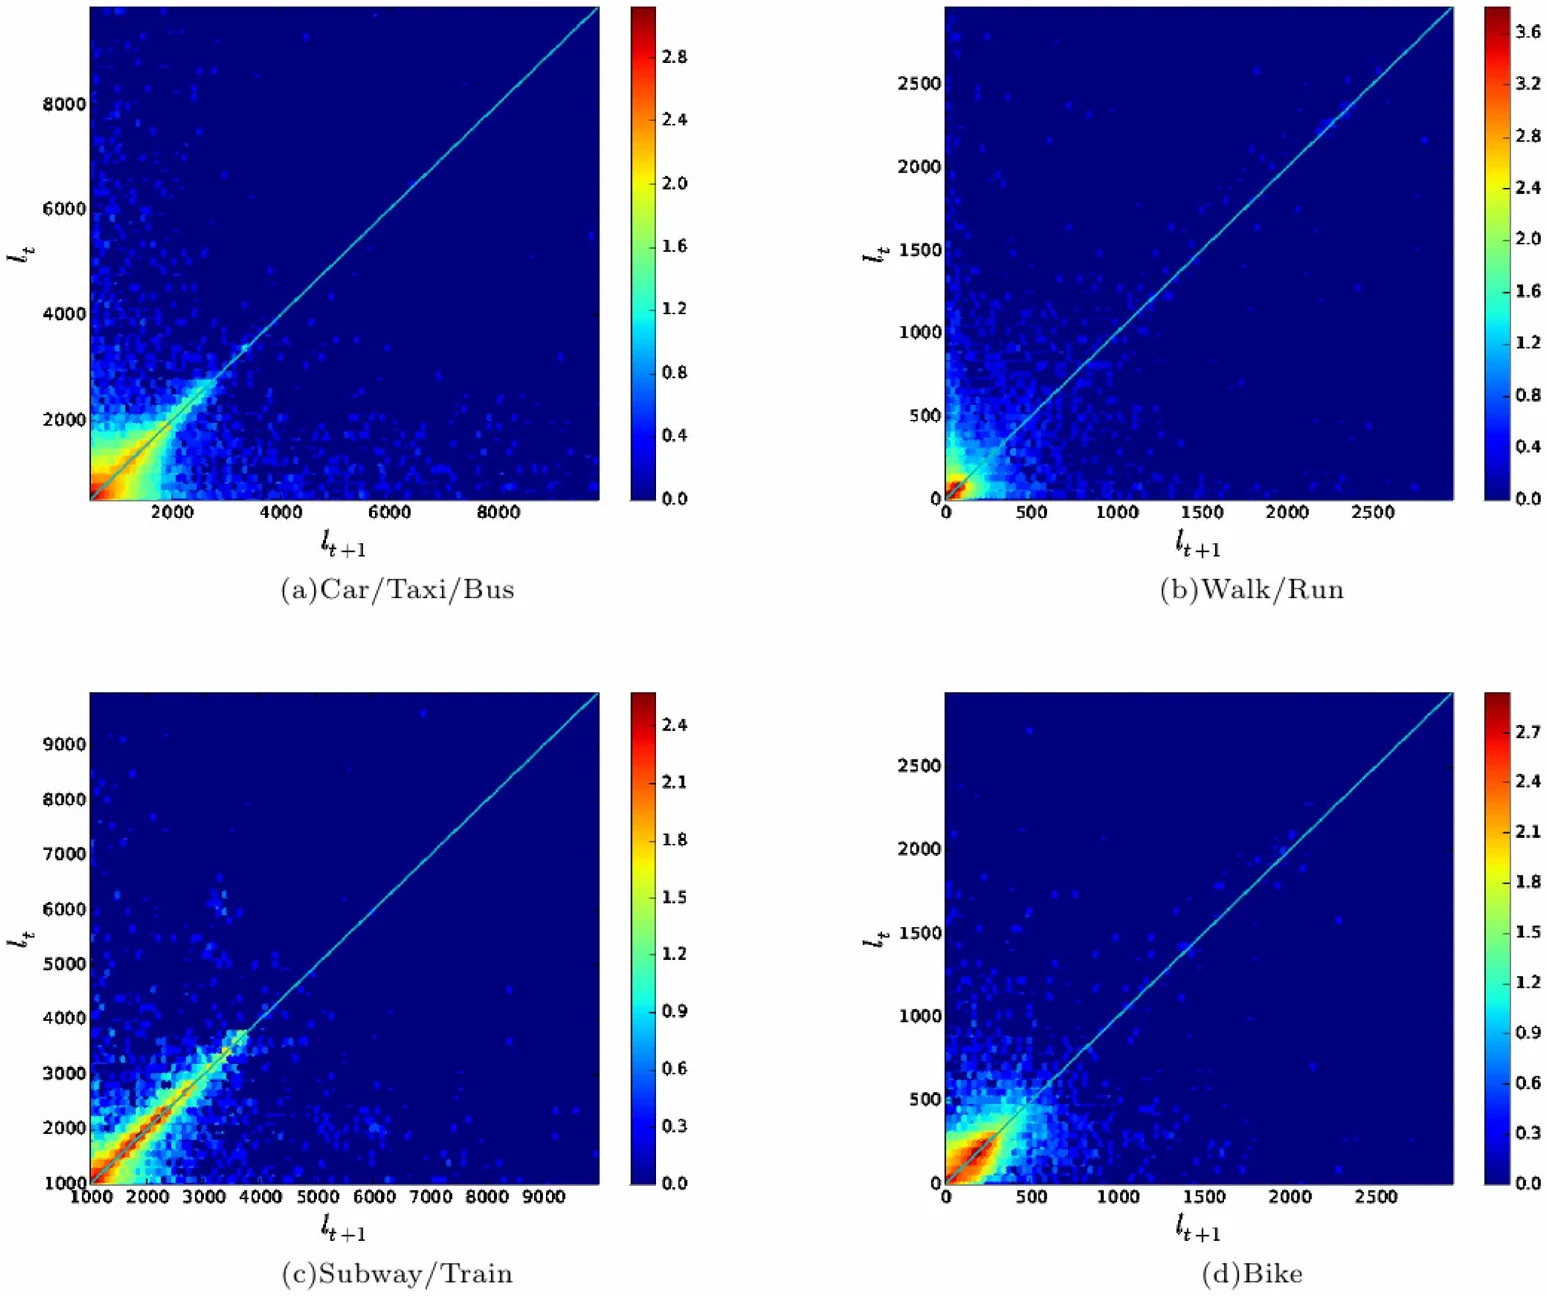
图 4|同一种方式里,下一段长度是否靠近上一段?
(a)小汽车/出租车/公交,(b)步行/跑步,(c)地铁/火车,(d)自行车,都来自 Geolife。横轴是下一段长度 lt+1,纵轴是上一段长度 lt,单位米。颜色从蓝到红表示密度升高;四个色标上限约为 2.8、3.6、2.4 和 2.7,图中没有写出色标单位。青色对角线表示两段一样长。高密度贴着对角线的较短一侧。(a)大约覆盖到 8000–9000 米,(b)和(d)大约覆盖到 2500 米以上一点,(c)大约从 1000 米覆盖到 9000 米。四个子图坐标范围不同,点云的视觉宽度要回到各自的米制刻度上读。地铁图窗从约 1000 米起,更短的段不在这个图窗里。来源:原论文 Fig. 4。
长度相关只说明相邻段差不多长。作者接着看变化率自己是否一波接一波。正文写,变化率在相邻时间间隔之间的皮尔逊相关为 0.03–0.13,p<0.05。样本很大时,这么小的系数也可以显著偏离 0,数值本身仍然很弱。作者把它理解为近乎互不相关的波动。按中心极限定理,一段时间内变化率之和近似正态,均值和方差与经过的时间成正比,于是 ln(l) 近似正态,l 成为对数正态。这一步是在相关很弱的前提下做的推导。图 3 的拟合是直接证据;图 4 支持“相邻段相近”,推导才把相近解释成对数正态的生成过程。
指数型的停留时间,怎样把几条对数正态拼成幂律?
停留时间在本文里指连续使用某一种交通方式的时长。图 1 那种出租车、步行、地铁、步行、出租车、步行的衔接,会留下六段停留。作者报告,这些停留时间在不同方式之间呈指数分布,并认为主要原因是步行常常只做接驳,时长远短于其他方式。正文给出的数量是:在 Geolife 里,连接其他交通方式的步行直飞段中,87.93% 的距离在 500 米以内,并且行程时间在 5 分钟以内。这个百分比的分母是接驳其他方式的步行直飞段;全部步行段和全部 202,702 段都不是这个分母。Nokia 没有给出对应百分比。
已有概率结果说明,若一个对数正态的均值和方差随时间成正比,再用指数分布去混合这段时间,总体可以变成幂律。本文把指数率记为 λ,混合后的指数写成
α′ = 1 − μ/σ2 + √(μ2 + 2λσ2) / σ2。
作者说,把表 2 的参数代入后,Geolife 得到 α′=1.55,直接拟合是 1.57;Nokia 得到 α′=1.40,直接拟合是 1.39。两边分别相差 0.02 和 0.01。核对的是幂律指数这一项。经验拟合还带 e−cl,混合后写出的解析式是不带这项的幂律;作者仍把混合结果称为截断幂律。截断参数 c 来自前面的直接拟合,不是这条解析式单独给出的。
表 2 有四套 μ、σ,公式只接受一套,λ 也不在表里。正文没有写出合成时用的那一组 μ、σ、λ。1.55 对 1.57、1.40 对 1.39 是作者报告的核对,读者无法只凭正文把四种方式重算一遍。它表明混合机制和观测指数相容,还不足以证明这是唯一能产生该指数的过程。
道路本身的长短,解释不了这条更重的尾巴
另一种常见解释是:人沿着路网走,路段长度已经是重尾,所以位移也是重尾。作者用北京路网检验这一点,共 433,391 条道路、171,504 个交叉口。道路长度分布的幂律指数为 3.4。幂律指数越大,长距离下降越快,所以路段的尾巴薄于 Geolife 直飞段的 α=1.57,也薄于 Nokia 的 α=1.39。
比较的是两类对象。路段是地图上的一段路,直飞段是人在方向改变之前的直线位移。人并不是到了每个交叉口都转弯;地铁和火车的长位移也不在道路长度里面。因此路网几何没有复现直飞段的重尾。这个比较用的是北京路网,没有对莱芒湖地区做同样的道路统计。它削弱了“只靠街道长短就得到这条幂律”的说法,并没有单独证明交通方式混合是唯一原因。
这条解释停在哪里
样本是 182 名和 200 名志愿者,时间、城市和记录方式都不同。Geolife 含有北京以外的活动,方式又靠自己填写。结论适合描述这两套带标签轨迹里的直飞段,不能直接换成一座城市全体居民的出行次数。
段与段不独立,总体分布是把所有段堆在一起。拟合更好表示在赤池权重和似然比下更受支持;二十万段的量级会把图上不大的差别放大。对数正态到幂律的那一步,还依赖变化率弱相关、停留时间为指数、以及一套没有在正文展开的参数合成。Nokia 的地铁和路面机动车 μ 几乎相同,但总体 α 更小、尾巴更重,所以“长尾巴主要来自地铁”不能从北京的 μ 差距直接搬到另一座城市。
小汽车、公交和出租车合成一类之后,类内仍可能混着不同的长度规律。与纯出租车指数衰减的差异,本文给出的是经济考虑这一解释,没有做分组检验。
一句话总结
步行、骑车、路面机动车和轨道交通各自的直飞段更像对数正态;按指数型停留时间混在一起之后,总体长度才接近一条截断幂律。幂律描述的是混合之后的段长分布;某一种交通工具自己的直飞段,在本文中更接近对数正态。
核心来源
- Scientific Reports 正式论文,Zhao、Musolesi、Hui、Rao、Tarkoma,2015,5:9136。题目、作者单位、DOI、图表和正文数值以此为准。
- 赫尔辛基大学计算机系对该文的报道,用于核对第一作者当时的身份和研究由谁带领:Researchers explain urban mobility by transportation mode decomposition。
- 赫尔辛基大学研究门户中 Sasu Tarkoma 的页面,用于核对教授身份与研究方向:Sasu Tarkoma。
作者介绍
- Kai Zhao:第一作者。论文署名为赫尔辛基大学计算机系和赫尔辛基信息技术研究所(HIIT)。系里的报道称他当时是博士生;作者贡献写明,最初的想法由他和 Tarkoma 提出,实验、统计和作图由他完成。
- Mirco Musolesi:署名为伯明翰大学计算机学院。参与研究设计,指导实验,并参与写作。
- Pan Hui:署名为香港科技大学计算机科学及工程学系。参与研究设计,指导实验,并参与写作。
- Weixiong Rao:署名为同济大学软件学院。参与研究设计,指导实验,并参与写作。
- Sasu Tarkoma:通讯作者之一,署名为赫尔辛基大学计算机系和 HIIT。系里的报道称这项研究由他带领;大学研究门户列他为计算机科学教授,研究方向包括互联网技术、分布式系统和移动计算。他与 Zhao 一起做统计分析并准备图。五位作者都参与了写作和审阅。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果幂律指数真由几种对数正态的混合决定,那么改变方式的数量份额,总体指数就会变,即使每种方式自己的 μ、σ 不变。本文没有报告四类各有多少段、占多少时间,所以还不能把 1.57 或 1.39 拆成“步行占几成、地铁占几成”。一个可检验的情形是:同一座城市、同一套 10 米直飞段定义下,新开一条地铁之后,原来由公交完成的几公里位移有多少被轨道上的更长直飞段替代。混合账户预测总体尾巴会变重;若只是把同样的位移从一种标签改到另一种标签,而直飞段长度分布不动,指数就不应明显变化。
另一处值得拆开的是路面机动车。出租车研究里的指数衰减只覆盖出租车,本文的对数正态把小汽车、公交和出租车合在一类。若分开之后出租车仍是指数、另外两类仍是对数正态,那么单一方式上的对数正态就还是一种混合,混合发生在这一个标签内部。Nokia 已经给出一个反例方向:地铁与路面机动车的 μ 只差 0.04,总体尾巴却比 Geolife 更重。长尾巴是否来自轨道,要用方式份额和各方式的段长一起算,不能只看哪一种方式的名字听起来更远。