城市内部的出行距离,为什么会变成一条指数曲线?
论文名片|Xiao Liang、Jichang Zhao、Li Dong、Ke Xu,Unraveling the origin of exponential law in intra-urban human mobility,Scientific Reports,2013,3:2983。2013年7月19日收稿,9月27日接收,10月18日发表。DOI:10.1038/srep02983。
设想一段市内行程再延长一截。跨县、跨城的研究里,行程距离常常有一条下降很慢的肥尾,很远的移动仍会反复出现。城市内部的集体记录却更接近指数:距离增加时,这样的行程很快变少。已有猜想认为,指数来自只观察一种交通工具,把各种工具合在一起才会得到幂律;另一类解释把市内出行主要归于兴趣点的地理位置。
这篇论文问的是集体层面的另一件事。城市内部人类移动(intra-urban human mobility)指的是同一座城市里的出行,不是居住地迁移。作者认为,集体出行距离的指数律,来自平均人口密度随到城市中心的距离指数下降,而且两者共用同一个衰减速率。这个判断建立在一个能同时再现区域间流量和距离分布的模型上;把人口的空间位置打乱之后,指数尾就不再是合适的描述。
先说结论
- 北京、伦敦、芝加哥、洛杉矶的集体出行距离呈指数尾。作者在模型里把来源归于平均人口密度的指数下降,并认为它与出行距离共用衰减速率。这里的人口是到达该区域的出行次数。
- 无参数的辐射模型在北京低估了距离大于1公里的出行概率。论文说另外三座城市也有同样现象,这三座城市的对照图没有放进正文。
- 距离函数取 f(d)=d^σ。北京、伦敦、芝加哥、洛杉矶的 σ 依次为 1.601、0.402、1.832、1.805。四座城市模拟距离分布的指数拟合依次为 0.1828±0.0001、0.181±0.0008、0.0903±0.0017、0.0696±0.0012。除洛杉矶最后一个分组外,各流量分组里 y=x 落在第9到第91百分位之间。
- 北京若改成均匀人口,模拟距离分布变成下降更慢、带指数截断的幂律,幂律指数为 −0.716(σ=1.6)和 −1.100(σ=2.0)。只打乱格子上的人口位置、保留人口数字的分布,曲线也更接近幂律。
- 图5中,北京、伦敦、芝加哥、洛杉矶按三个高密度中心画出的密度下降速率为 −0.239、−0.218、−0.096、−0.058。网格模拟里 σ 固定为 1.6,密度参数 λ 取 0.1、0.2、0.4 时,距离分布的指数斜率为 0.085、0.180、0.414。
大尺度上的肥尾,进了城为什么对不上?
县与县、城与城之间的移动,常被描述成列维游走(Lévy walk):步长分布的尾巴很重,很远的移动比指数分布所允许的更常见。美元钞票在美国的扩散、欧洲手机记录,都曾给出这种肥尾。城市内部的出租车、私家车、地铁,以及中国东北八座城市的手机通话记录,报告的却是出行距离的指数尾。不同城市的特征距离并不相同。
已有的两类解释,覆盖不了这些市内记录。第一类说,指数是单一交通工具造成的,把所有工具合在一起才出现幂律。可是手机通话和基于位置的服务并不限定交通方式,市内移动仍然有指数尾。第二类说,市内出行跟着兴趣点的地理分布走。兴趣点被访问的机会还取决于规模和受欢迎程度,地理位置本身解释不了访问量。大尺度幂律的若干机制,讨论的是个人移动;这篇论文明确改从集体出行入手,因为已有证据并没有表明个人行程与集体行程服从同一种分布。
因此需要先确认:城市内部,从一个区域到另一个区域的出行量,能不能用一个同时依赖人口布局和距离的模型再现。距离分布是这个模型的结果,不是事先写进公式的指数。
四座城市分别记下了哪种出行?
四套数据的分析单位都是区域之间的出行,不是可以对应到某一个人全天行程的轨迹。分区、时间和记录渠道不同,不能把四座城市读成同一种抽样。
| 城市 | 记录了什么 | 时间 | 分区与条数 |
|---|---|---|---|
| 北京 | 超过1万辆出租车的 GPS;论文按车辆位置和载客状态整理乘客出行 | 截至2010年12月31日的三个月 | 六环以内,经纬度各0.01度的格子;3450个小区之间11,776,743条轨迹 |
| 伦敦 | 地铁出行的大约5%样本,来自 Oyster 卡 | 2009年11月的一周 | 部分车站相距不到200米;论文合并了部分相邻车站,得到183个 Voronoi 小区、667,584次出行 |
| 芝加哥 | 芝加哥大都会规划机构的家庭出行追踪调查;只保留 Cook 县 | 2007年1月至2008年2月 | 1314个人口普查区之间43,881次出行 |
| 洛杉矶 | 南加州政府协会的区域家庭出行调查;大区有六个县,分析集中在洛杉矶县 | 2001年 | 2017个人口普查区之间46,000条轨迹 |
伦敦的667,584次是约5%样本、合并车站之后的出行,不是那一周地铁的全部客流。洛杉矶的46,000是论文给出的整数。北京的车辆数只写了超过1万辆,没有更精确的数字。
区域内的人口也不用户籍或普查常住人口。作者认为城市里人的活动变化太快,常住人口对不上日常出行;他们用到达一个区域的出行次数当作该区域的人口,并说这个量大约正比于日均活动人口。后面的模型因此是在各区域到达量已经给定时,解释出行如何分配到其他区域。它没有单独预测每个区域会到达多少人。
正文把指数律的直接展示放在补充材料第一节,并在图3给出四座城市的实际距离分布。实际分布的指数拟合写在表S1,正文没有印出那四个数字。
辐射模型为什么把更远的市内出行估少了?
引力模型(gravity model,也称重力模型)让两地流量随两端规模增大、随距离增大而减小,但按论文的写法,它无法区分同一对区域两个方向上流量为什么可以不同。作者因此没有用引力模型做这张对照,只检验了无参数的辐射模型(radiation model)。
辐射模型里,从 i 到 j 的期望流量是
⟨Tᵢⱼ⟩ = Tᵢ × (Pᵢ Pⱼ) / [(Pᵢ + Pᵢⱼ)(Pᵢ + Pⱼ + Pᵢⱼ)]。
Tᵢ 是从 i 出发的出行次数,Pᵢ、Pⱼ 是两端人口,Pᵢⱼ 是到 i 的距离不超过 dᵢⱼ、且不含 i 和 j 的那些位置的人口总和。它在县际、城际人口移动上曾经有效。市内是否仍然有效,要用同一套到达量人口来看。
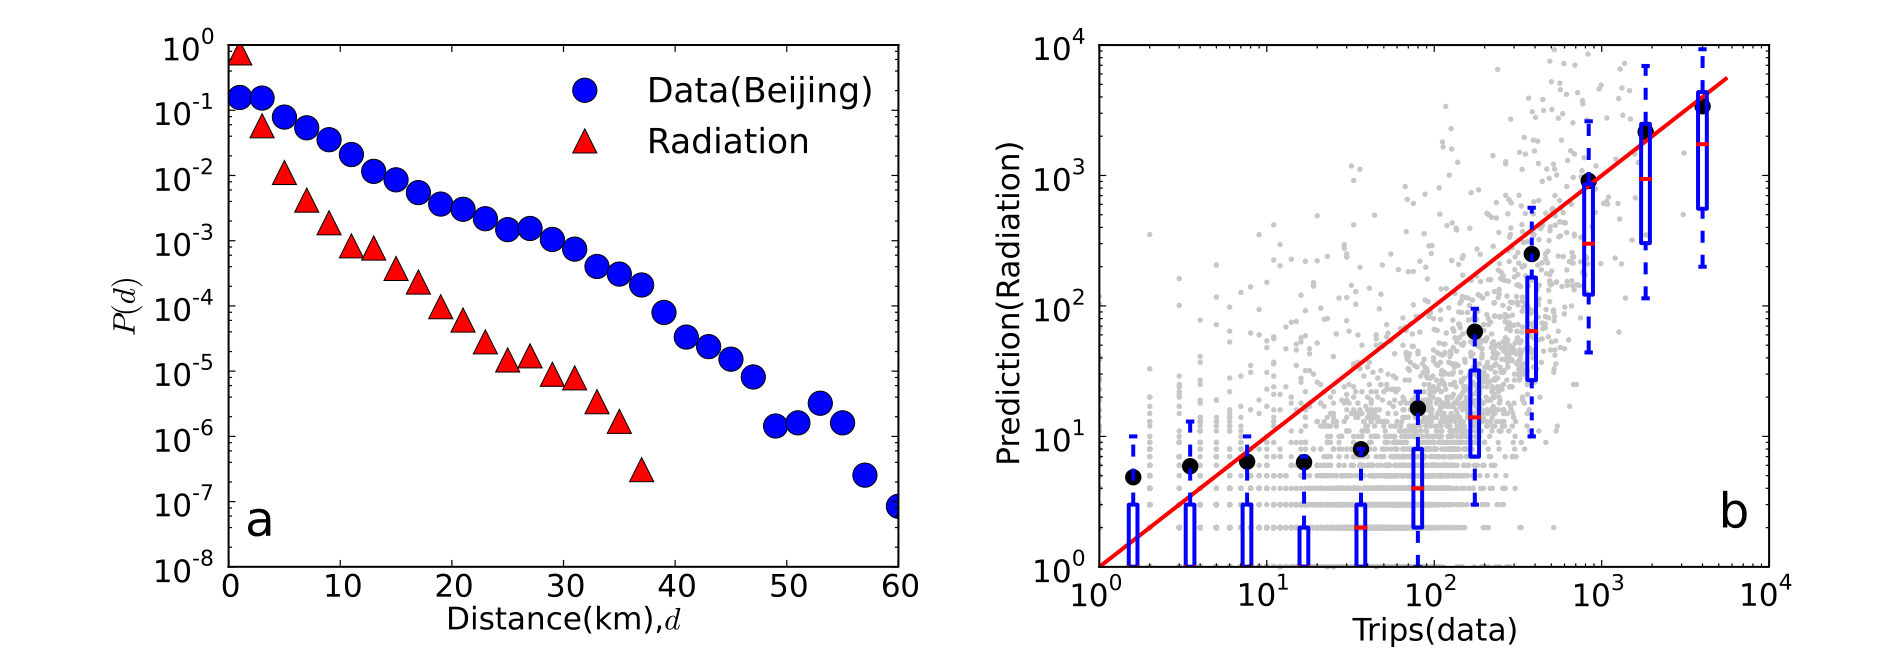
图 1|没有可调参数的辐射模型,能否对上北京的市内出行?
(a)纵轴是距离分布 P(d),对数刻度;横轴是距离,单位公里。蓝圆是北京数据,红三角是辐射模型。红三角下降更快。正文写明,模型低估了距离大于1公里的出行概率。(b)横轴是实际流量,纵轴是辐射模型的预测,均为对数。灰点是有方向的区域对,红线 y=x 表示预测等于实际,黑点是分组内预测的均值,须线两端是该分组的第9和第91百分位。点云明显离开红线。来源:原论文 Fig. 1。
这张图只画了北京。论文说伦敦、芝加哥、洛杉矶也出现同样的低估,但没有把那三张图放进正文。作者把偏差归因于不同空间尺度上的出行习惯不同,所以市内需要另一个模型。这个归因是解释,图1本身只说明辐射模型对不上北京的距离分布和区域间流量。
目的地更热闹、距离按幂次惩罚,流量能对上吗?
新模型仍保留引力模型的两个直觉:到达一个地点的概率随该地人口密度上升,随它与出发地的欧氏距离(Euclidean distance,地图上的直线距离)下降。欧氏距离不是沿路里程,也不是时间或费用。对区域来说,从 i 出发后到达 j 的概率正比于 P(j) / f(dᵢⱼ)。再乘上从 i 出发的概率,并在除 i 以外的所有目的地上归一,得到
P(i→j) = Pnorm(i) × [P(j) / f(dᵢⱼ)] / Σₖ≠ᵢ [P(k) / f(dᵢₖ)]。
Pnorm(i) 是归一化人口,表示一次出行从 i 出发的可能性。总出行数为 T 时,期望流量是 T 乘上这个概率。分母记为 M(i)。M(i) 取决于 i 周围的人口如何分布,M(i) 和 M(j) 通常不相等,所以 i 到 j 不必等于 j 到 i。这是它和论文所写的引力模型不同的地方。
f(d) 比较了幂函数和指数函数两种常见形式。幂函数 f(d)=d^σ 好得多。σ 用最大似然估计,并用 Nelder–Mead 单纯形算法数值求解;似然把各次出行当作相互独立。四座城市的 σ 依次是:北京 1.601,伦敦 0.402,芝加哥 1.832,洛杉矶 1.805。伦敦比另外三座城市小很多,距离惩罚弱得多。论文没有单独解释这个差别。伦敦数据只含地铁、大约5%样本,以及合并后的183个车站小区,和其他三座城市的分区方式不同;这是数据范围的差别,不能直接当成 σ 较小的原因。
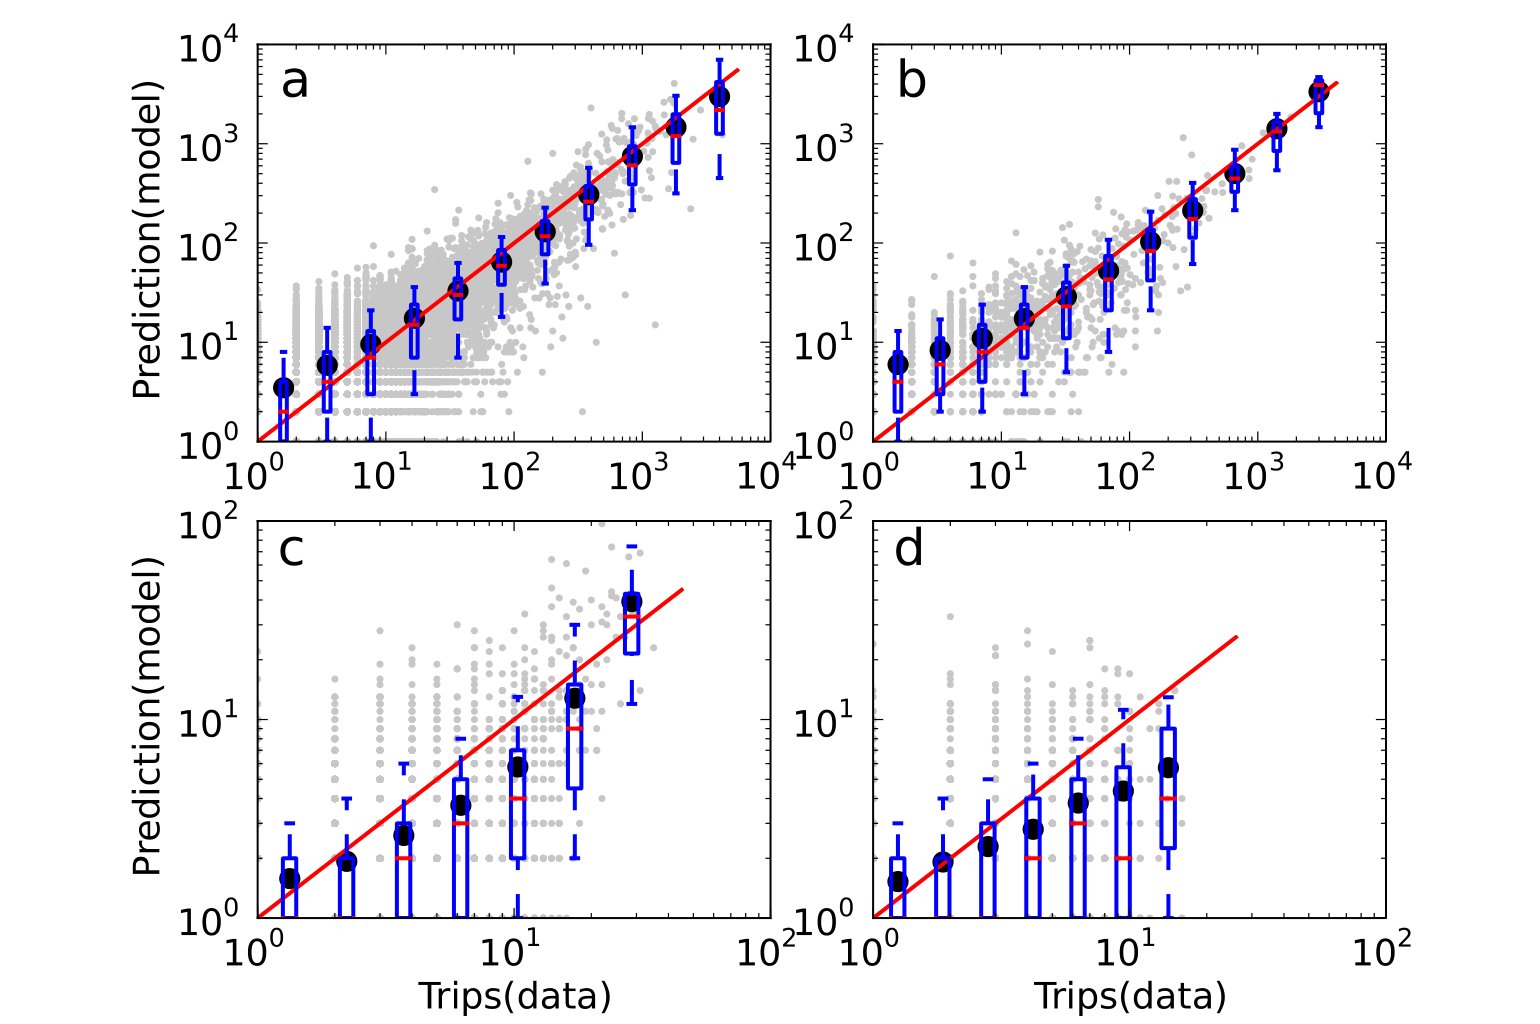
图 2|区域之间的出行次数,预测有没有落到实际附近?
(a)北京,(b)伦敦,(c)芝加哥,(d)洛杉矶。横轴是实际出行次数,纵轴是模型预测,对数坐标。灰点为有方向的区域对,红线为 y=x,黑点为分组均值,蓝色须线标出该分组内预测值的第9和第91百分位。正文用红线是否落在这两端之间来判断。四个面板里,只有洛杉矶最后一个分组不满足。来源:原论文 Fig. 2。
距离分布是同一套模拟的另一项结果。北京、伦敦、芝加哥、洛杉矶的模拟分布,指数拟合依次为 0.1828±0.0001、0.181±0.0008、0.0903±0.0017、0.0696±0.0012。论文没有说明 ± 是标准误还是别的不确定度,只给出这个写法,并说它们与表S1里实际距离分布的拟合非常接近。表S1的四个实际拟合值没有印在正文里。
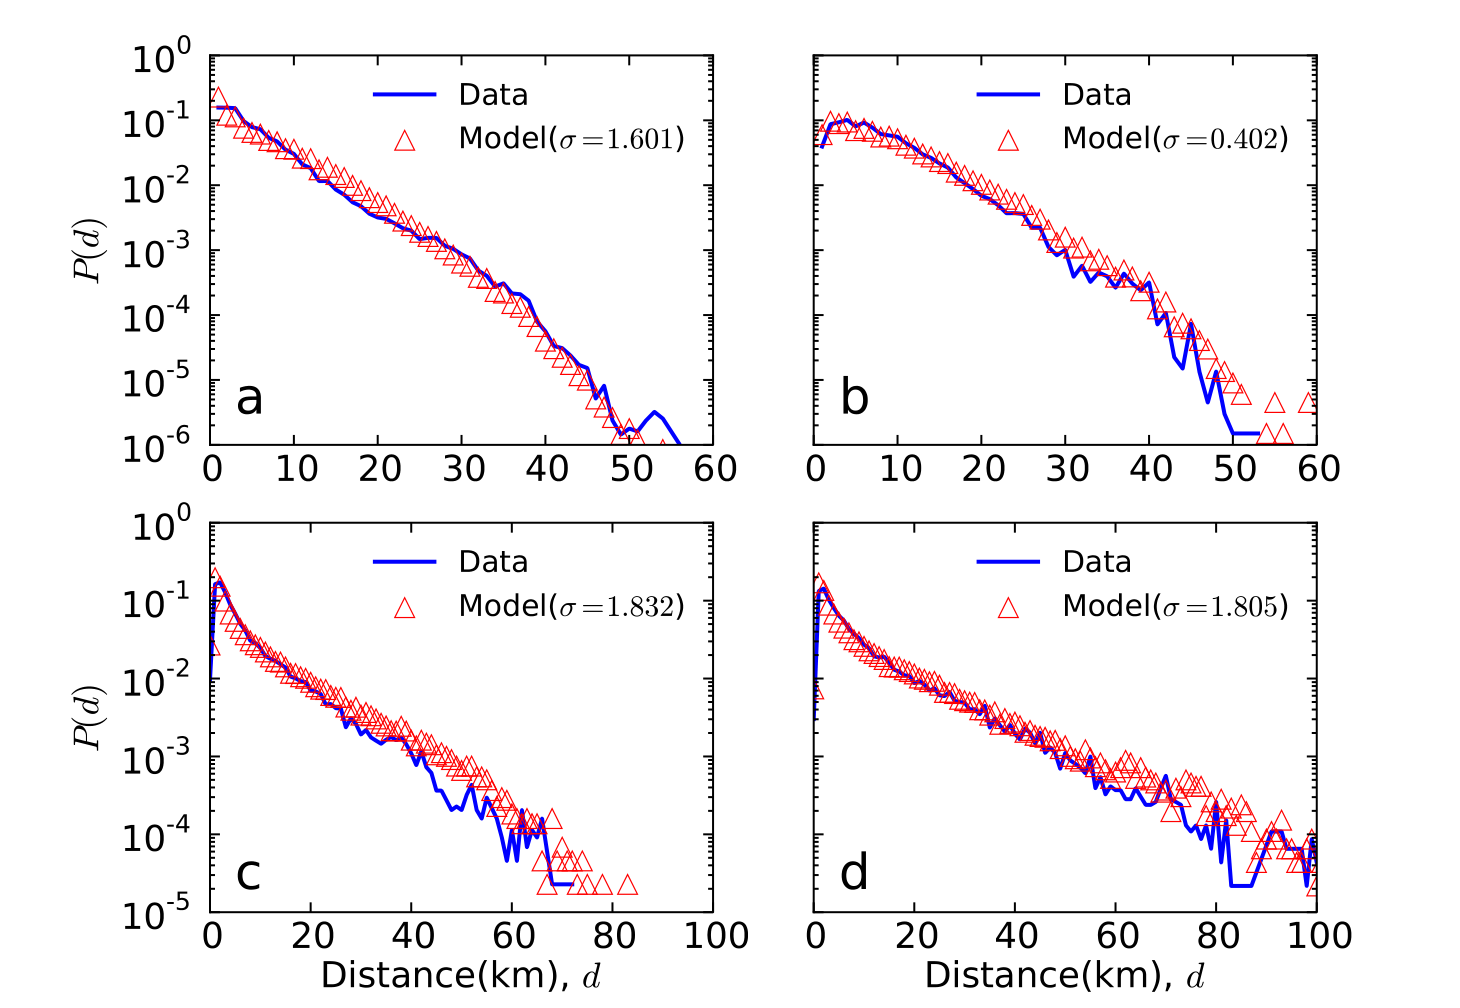
图 3|模拟出来的出行距离,是否跟着实际曲线一起下降?
(a)北京,模型 σ=1.601;(b)伦敦,σ=0.402;(c)芝加哥,σ=1.832;(d)洛杉矶,σ=1.805。蓝线是实际距离分布,红三角是模型。纵轴 P(d) 为对数,横轴为公里;北京和伦敦画到60公里,芝加哥和洛杉矶画到100公里。四座城市里两条曲线整体相随,远端次数变少后起伏变大。曲线相随说明该模型能再现集体距离分布,还不等于每个人的行程都服从同一条指数。来源:原论文 Fig. 3。
把人口的位置打乱,指数还剩什么?
模型里人口布局会影响距离分布。要分开两件事:各个格子的人口数字组成什么样,以及这些数字放在城市的哪些位置。
先把北京的人口改成均匀分布,再用不同的 σ 模拟。实际数据下降更快。均匀人口下的模拟符合带指数截断的幂律,幂律指数为 −0.716(σ=1.6,绿三角)和 −1.100(σ=2.0,红星)。论文给出的解析对照是 1−σ:1−1.6=−0.6,1−2=−1。模拟指数接近这两个值,但不是逐位相等。推导放在补充材料第二节。
再保持每个格子的人口数字不变,只把这些数字随机重新分配到格子上,做三次。σ 固定为北京的实际值 1.601。三次结果彼此相似,用幂律描述更合适。
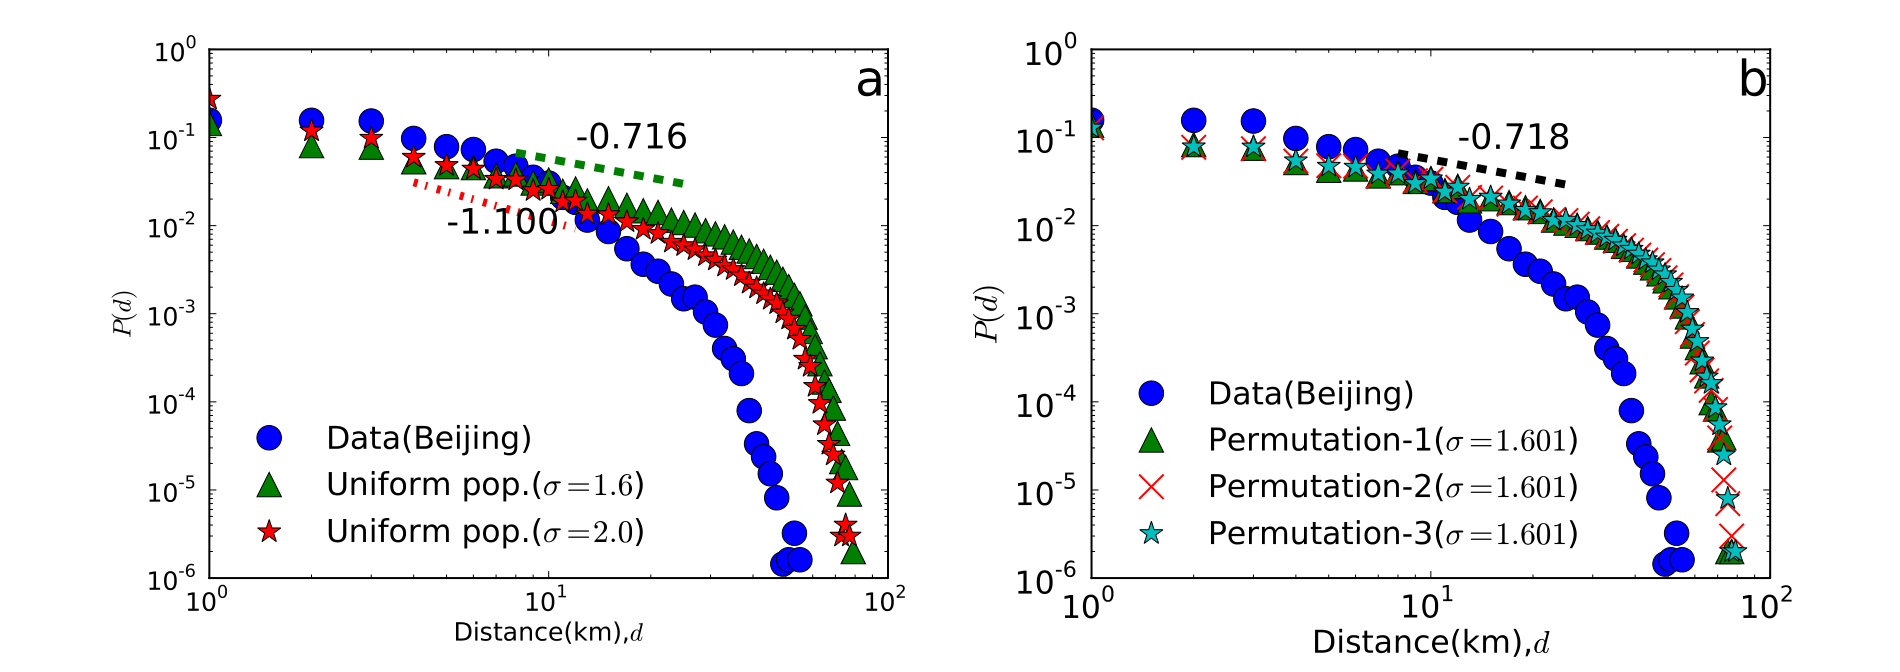
图 4|人口数字不变、只改空间布局时,北京的距离分布还是指数吗?
(a)蓝圆是北京实际数据;绿三角是均匀人口、σ=1.6,图上参考斜率为 −0.716;红星是均匀人口、σ=2.0,参考斜率为 −1.100。两条模拟曲线都比实际数据下降得慢,远端才明显下弯。(b)绿三角、红叉、青星是三次随机重排,σ 都是 1.601;图上参考斜率为 −0.718。三次重排几乎重叠,在较长距离上仍高于实际数据。横轴是公里、对数刻度,纵轴是 P(d)、对数刻度。来源:原论文 Fig. 4。
所以,单是人口数字有大有小,还产生不出实际的指数尾。这些数字在空间上怎么摆,会改变距离分布。这一步仍然是在作者的模型里改输入后重新模拟,不是把真实城市的人口搬迁一遍再观察出行。
离中心越远人越少,和出行距离是同一个衰减吗?
城市人口的空间分布,用平均密度随到城市中心的距离来描述。北京的格子大小接近,直接选高密度格子作为中心,再按距离平均。伦敦、芝加哥、洛杉矶的区域形状不规则,论文假定每个区域内部密度均匀,把城市划成 0.005度×0.005度的格子,格子密度取它所在区域的密度,再按距离平均。图5对每座城市取三个人口密度高的区域作为中心,纵轴是平均密度除以该序列的最大密度。
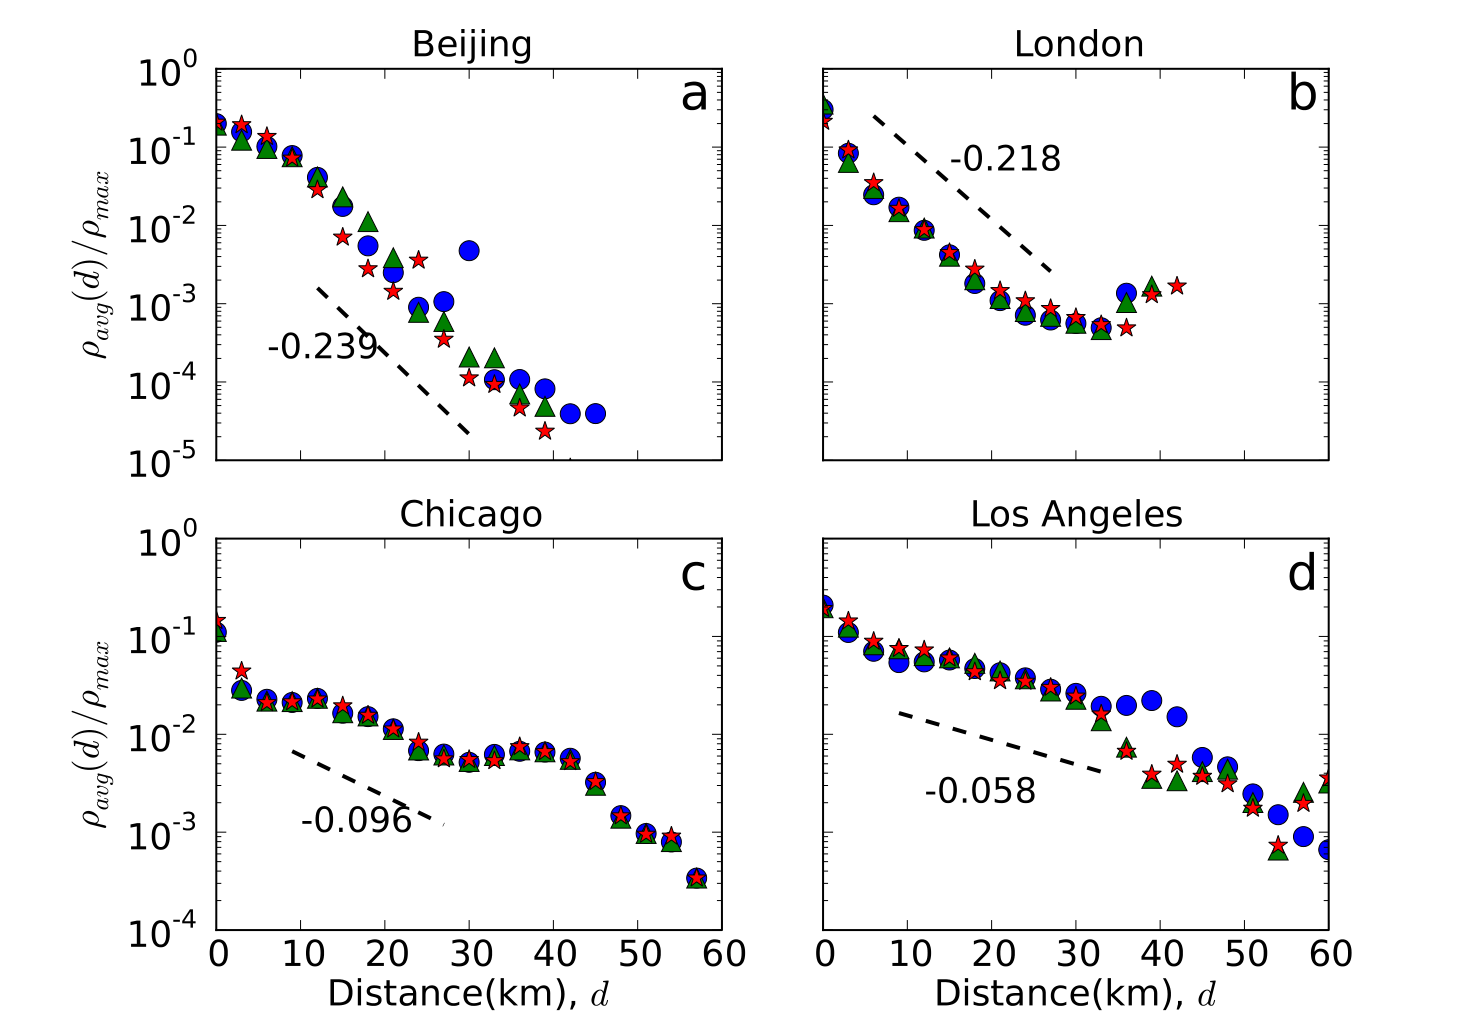
图 5|平均密度离开城市中心之后,下降有多快?
(a)北京,(b)伦敦,(c)芝加哥,(d)洛杉矶。蓝圆、绿三角、红星分别是三个高密度中心;纵轴为平均密度除以最大密度,横轴为到该中心的公里数。黑色虚线是密度下降速率,图上标为 −0.239、−0.218、−0.096、−0.058。同一城市的三个中心趋势相近。伦敦远端有少量回升,北京中段有个别偏高的点,虚线没有穿过每一个点。来源:原论文 Fig. 5。
论文说,这些下降速率与表S1里实际距离分布的指数相差不远。正文没有列出表S1。可以并排看到的,是图上速率的绝对值,以及前面模拟距离分布的拟合:北京 0.239 对 0.1828,伦敦 0.218 对 0.181,芝加哥 0.096 对 0.0903,洛杉矶 0.058 对 0.0696。芝加哥和洛杉矶更接近;北京和伦敦的密度速率更大。这组并排使用的是模拟拟合,论文自己的对照对象仍是表S1。
若密度只随到中心的距离 r 变化,并写成 ρ(r)=C e^{−λr},其中 λ>0,r 从 0 到城市半径 R,则距离分布被夹在两条曲线之间:
C₁ × d^(1−σ) × e^{−λd} ≤ P(d) ≤ C₂ × d^(1−σ) × e^{−λd}。
两条界线共用指数衰减 λ,也共用幂次 d^(1−σ)。当 d 大于 1/λ 时,指数部分占主导,P(d) 开始按指数下降。四座城市的 σ 都小于 2,所以幂次 1−σ 大于 −1,这段幂律下降得很慢,不像大尺度集体移动里的列维游走。市内密度下降通常较快,λ 较大,幂律段因此很短,整条分布看起来就更像指数。
这个不等式是模型在负指数密度下的结果,证明在补充材料第二节。作者再用同一模型在 80×80 的网格上模拟;论文没有给出这些格子的公里边长。
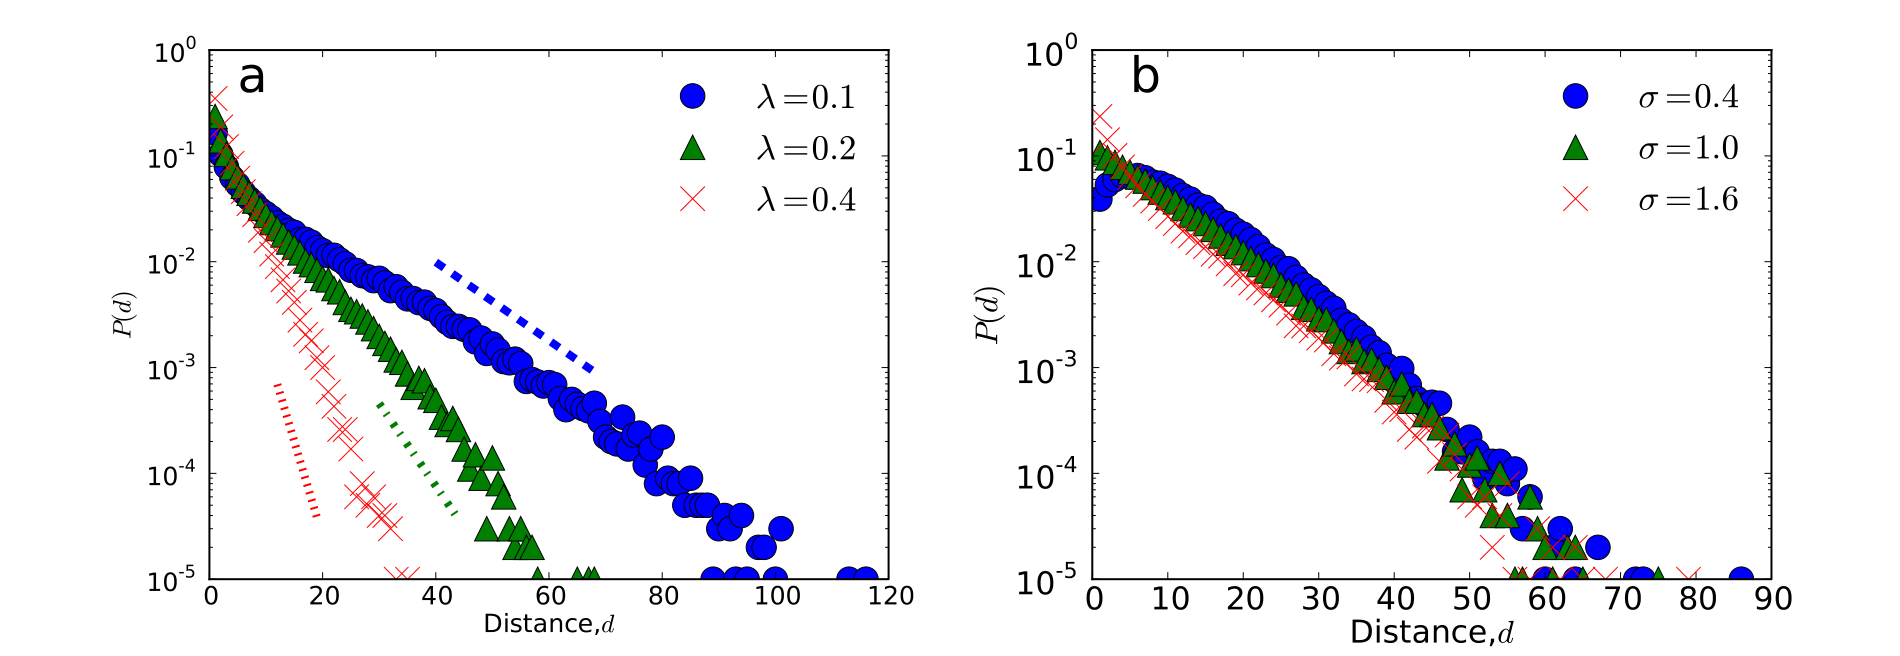
图 6|只改密度的衰减或只改距离的幂次,指数尾跟谁走?
(a)σ 固定为 1.6。蓝圆、绿三角、红叉对应 λ=0.1、0.2、0.4。正文给出的指数斜率分别是 0.085、0.180、0.414,对应蓝虚线、绿点划线和红点线。0.085 比 0.1 低 0.015,0.180 比 0.2 低 0.020,0.414 比 0.4 高 0.014,斜率接近 λ,但不是相等。(b)λ 固定为 0.2。蓝圆、绿三角、红叉对应 σ=0.4、1.0、1.6。三条曲线的指数尾接近,短距离一端仍有差别。横轴是距离,纵轴是 P(d)、对数刻度。来源:原论文 Fig. 6。
固定 λ 时,σ 对指数尾影响很小;固定 σ 时,尾部斜率跟着 λ 走。这与夹逼不等式一致,也说明距离函数的幂次主要影响指数段之前的那一部分。图6是规定了密度形状之后的模拟,不是四座城市的再次实测。
四座城市的密度曲线与克拉克模型(Clark’s model)一致:城市人口密度用到中心距离的负指数来描述。斯米德(Smeed)曾用反比幂函数。帕尔(Parr)认为,城区更适合负指数,城市边缘和腹地更适合反比幂函数。作者据此推测,人口密度函数随空间尺度改变,或许对应集体移动在不同尺度上分别呈现幂律和指数。这是讨论中的尺度猜想,本文没有用同一套数据去拟合城际密度和城际行程。
指数律可以解释到哪一层?
可以稳定说的是:在这四套市内数据上,集体出行距离呈指数尾;辐射模型对不上北京图中的距离和流量;到达量加幂函数距离的模型能再现区域间流量和距离分布;均匀人口和随机重排都不再保持实际数据那种指数尾;负指数密度会在模型里让距离分布的指数尾靠近密度的衰减速率。
说到机制时,有几层边界。人口是到达次数,不是独立的人口普查。模型解释的是到达量给定之后的分配和由此产生的距离分布。估计 σ 时把各次出行当作相互独立,论文没有再检验这个假定。距离是直线距离。伦敦的 σ=0.402,北京、芝加哥、洛杉矶分别为 1.601、1.832、1.805,论文没有给出专门解释。
集体指数也不能推出个人行程服从幂律或指数。论文引用的一项研究表明,每个人的移动长度若是不同的指数分布,合在一起仍可能得到无标度分布;通话间隔在总体层面像幂律,多数人自己却像韦伯分布(Weibull distribution)。动物移动是否为列维式,文献里也仍有争论。作者因此把个人移动留作需要更完整出行记录的问题。
图6的斜率接近 λ 而不等于 λ。图5的虚线是总体下降速率,三个中心的点还有波动。表S1的实际拟合没有印在正文,正文只用“非常接近”“相差不远”来比较。另外三座城市的辐射模型对照没有附图。这些都限制了“完全同一个速率”这句话能有多硬。
一句话总结
城市内部的集体出行距离呈指数下降,是因为在这个模型里,平均人口密度本身就随到城市中心的距离指数下降,两者共用衰减速率;人口位置一旦被打乱,指数就不再是合适的描述。
核心来源
- Liang, X., Zhao, J. C., Dong, L. & Xu, K. Unraveling the origin of exponential law in intra-urban human mobility. Scientific Reports 3, 2983(2013)。正式版本,DOI:10.1038/srep02983。正文图1–6及上述数值均来自这一版。
- 指数律的展示在补充材料第一节,距离分布的实际拟合在表S1,夹逼不等式的证明在补充材料第二节。正文写明补充材料随文提供,但这份正文没有印出表S1的拟合值,也没有印出证明步骤。
- 数据由论文方法部分说明:北京出租车 GPS;伦敦交通局 Oyster 卡地铁样本;芝加哥大都会规划机构2007–2008年家庭出行调查;南加州政府协会2001年区域家庭出行调查。
作者介绍
四位作者均署名北京航空航天大学软件开发环境国家重点实验室(北京 100191)。以下只采用论文所载身份、贡献和致谢。
- Xiao Liang:与 Jichang Zhao、Ke Xu 共同设计研究并撰写论文;与 Li Dong 完成实验、分析数据并制图。致谢写明,Liang 与 Zhao 感谢北航博士研究生创新基金。
- Jichang Zhao:参与研究设计与论文撰写,并与 Liang 同列于上述博士研究生创新基金致谢。
- Li Dong:参与实验、数据分析与制图。
- Ke Xu:通讯作者,参与研究设计与论文撰写。论文给出的通信邮箱是 kexu@nlsde.buaa.edu.cn。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果一座城市把人口从中心摊向边缘,使密度的 λ 变小,这个模型预期集体出行的指数尾会变缓,中等距离的行程占比上升。图4已经给出一个极端对照:人口完全均匀时,距离分布更像下降较慢的幂律。反过来,新建一个远离原中心的高密度节点,可能会在图5那种曲线的相应距离上抬起一个峰,而不一定立刻改写整条指数。四座城市各选三个中心时趋势仍然相近,说明多中心本身并不自动取消指数;要检验的是新节点有没有改变密度随距离下降的速率。
另一项可以直接核对的分工是,把“区域有多热闹”从出行记录里分开。本文的人口就是到达次数,所以模型回答的是到达量已知后行程如何分配。若改用普查人口、就业岗位或建筑面积作为 P(j),再看距离分布的指数是否仍接近密度的 λ,就能区分两件事:指数来自人们白天真正聚集的位置,还是来自出行数据自己生成的到达量。集体曲线仍然不能当作每一个人的行程衰减。