人走得更远,还是出行更分散,更能对上这座市镇的经济发展?
论文名片|Luca Pappalardo、Dino Pedreschi、Zbigniew Smoreda、Fosca Giannotti,Using Big Data to study the link between human mobility and socio-economic development,2015 IEEE International Conference on Big Data (Big Data),2015,第871–878页。观察性研究:把个人手机移动汇总到法国市镇,再与官方社会经济指标做相关。
一个人可以长期只在家和远处的工作地之间往返。基站拉得很开,典型距离很大,但来回的路线种类很少。另一个人可以在住处附近的市场、学校、诊所和亲友之间换着走。地图上的跨度未必更大,起讫组合却多得多。前一种是走得远,后一种是走得散。把这种差别汇总到一座市镇之后,哪一种更能对上收入、教育、失业和剥夺?
这篇论文的方向性结果是:在法国市镇尺度上,对得上的主要是走得散。居民移动熵的均值与人均收入正相关,与剥夺指数、仅初等教育比例负相关;回转半径往往落在相反的一侧,而且除个别汇总方式外关系更弱。两个移动指标彼此也是负相关。证据是5,100座市镇上的线性相关。个人收入没有被观测,经济发展与出行谁先发生也没有被分开。
先说结论
- 分析用的是2007年9月1日至10月15日、共45天的法国Orange通话详单。原始记录包括2,000万名匿名用户、2亿次通话;保留平均每天通话多于0.5次的用户后,剩下600万名,占原始用户数的30%。相关分析的单位随后变成市镇,共5,100座。
- 移动多样性用行程起讫对的移动熵表示。市镇均值与人均收入的皮尔逊相关系数为0.49,与剥夺指数为−0.43,与仅初等教育比例为−0.49,与失业率为−0.17。分母都是这5,100座市镇。
- 移动规模用回转半径表示,即活动基站相对质心的典型直线距离。中位数与仅初等教育比例的相关达到0.47,与人均收入为−0.21,与剥夺指数为0.16,与失业率为−0.1。均值回转半径与剥夺指数、仅初等教育比例只有0.01。
- 市镇的均值移动熵与中位数回转半径相关为−0.38。走得更散的市镇,居民的典型距离往往更短。
- 把用户随机重新分到市镇、并重复100次之后,多样性汇总与四个社会经济指标的相关变为零。这只说明观察到的相关依赖于用户实际落在哪座市镇。
留下来的是经常打电话的人
人类移动性(human mobility)在这里指人在空间中的地点移动,分析的是日常通话所露出的位置,不是搬家或户籍迁移。数据来自Orange的通话详单(Call Detail Records,CDR)。用户每次通话或发送短信,运营商记下时间,以及当时为这支手机服务的基站。基站另有经纬度。个人轨迹因此是一串基站,不是连续的GPS,也不是沿路里程。
为了让个人统计稳定一些,论文保留通话频率 f = N/45 > 0.5 的用户。N是该用户的通话次数,45是观察天数。这个阈值相当于平均每天多于0.5次通话,也就是45天里多于22.5次。作者的说法是删去平均每两天还不到一次通话的用户。筛选句写的是通话次数;短信会出现在原始记录里,论文没有说明短信是否计入N。筛完得到600万名活跃用户。
外部指标来自法国国家统计与经济研究所(INSEE)的2007年数据,对象是官方居民超过1,000人的市镇。移动指标与这些指标对齐之后,论文得到5,100座市镇。5,100是进入相关分析的市镇数,论文没有另外给出法国市镇总数,也没有给出每座市镇分到多少手机用户。日历年同为2007年,但手机只覆盖秋初的45天,社会经济指标则是这一年的市镇统计。
用户要先有一个家所在基站,才能归入市镇。汇总规则是:夜间22:00至次日7:00通话次数最多的基站,再用常规地理信息系统划入对应市镇。图2的图注同样把红色基站标成夜间通话最多的位置。正文在解释图中两位示意用户时,又写成整个观察期内通话最多的基站。两句口径不完全相同。后面的市镇相关使用的是夜间规则。
走多远,和路线有多散,是两件不同的事
移动规模(mobility volume)用回转半径(radius of gyration)rg衡量。它问的是:这个人打过电话的基站,围绕自己的活动质心散开了多远。质心是这些基站坐标按到访次数加权后的平均位置。公式把每次到访到质心的直线距离平方,再按次数平均,最后开方:
rg(u) = √[ (1/N) × Σᵢ∈L nᵢ (rᵢ − r_cm)² ]
L是此人到过的基站,nᵢ是基站i的到访次数,N是这些次数之和,rᵢ和r_cm是坐标。筛用户时的N是45天内的通话次数,回转半径里的N是各基站到访次数之和。距离来自基站坐标的直线距离,对应的是基站在地图上散开的程度;它不把每次出行的道路里程累加起来。一个人若只在两个相距很远的基站之间来回,回转半径可以很大;一个人若在家附近许多基站之间换着走,总路程可以不短,回转半径仍然可以很小。
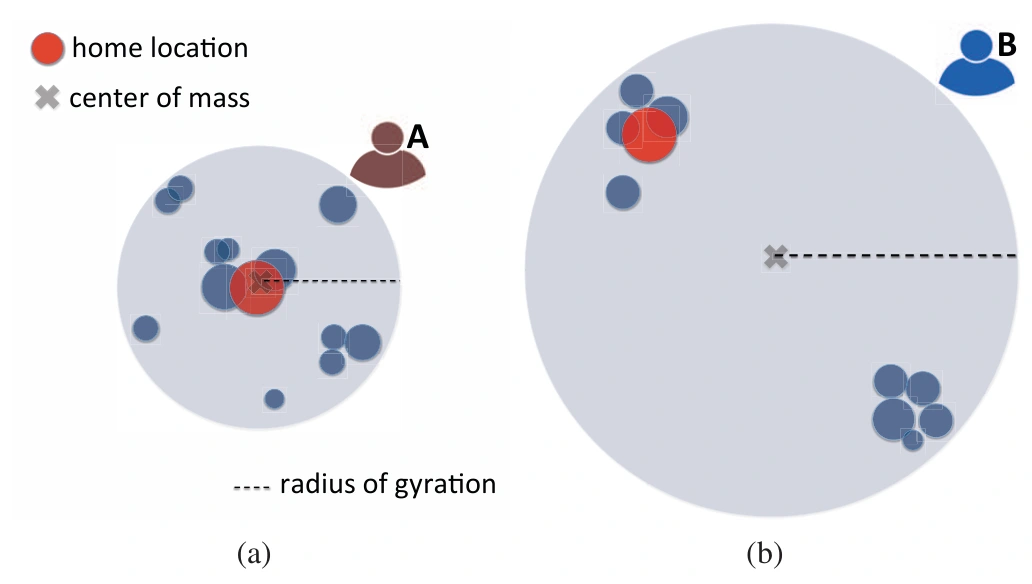
图 2|同样是活动基站,怎样看出一个人走得远还是走得近?
(a)用户A的基站彼此接近,红色家的位置靠近灰色质心,黑色虚线表示的回转半径短。(b)用户B的基站分在相距更远的几处,质心落在中间空处,虚线更长。圆的大小表示到访次数,红色表示最常在夜间通话的基站。这是两位用户的示意图,论文没有给出他们的公里数。来源:原论文 Fig. 2。
全体用户的回转半径差异很大。分布呈重尾:很多人的典型距离不大,少数人拉出很长的尾巴。论文以此呼应此前在手机和汽车GPS上看到的个体差异,但没有在本文拟合一个幂律指数。
移动多样性(mobility diversity)用移动熵S衡量。它不看公里,而看行程怎样分摊到不同的起讫对上。一次行程e是一对起点基站和终点基站,E是观察到的全部起讫对,p(e)是这种移动出现的概率。论文使用的是除以轨迹总数对数之后的香农熵:
S(u) = − Σₑ∈E p(e) log p(e) / log N
分母里的N是这个人的轨迹总数,又与回转半径公式里的N不同。分子分母用同一个log,底数会在比值中抵消;论文没有另行指定底数。行程反复集中在少数几条起讫对上时,S接近0;行程摊到许多不同起讫对上时,S升高,最高到1。因此熵高表示路线种类多,不表示这个人一定走得更远。
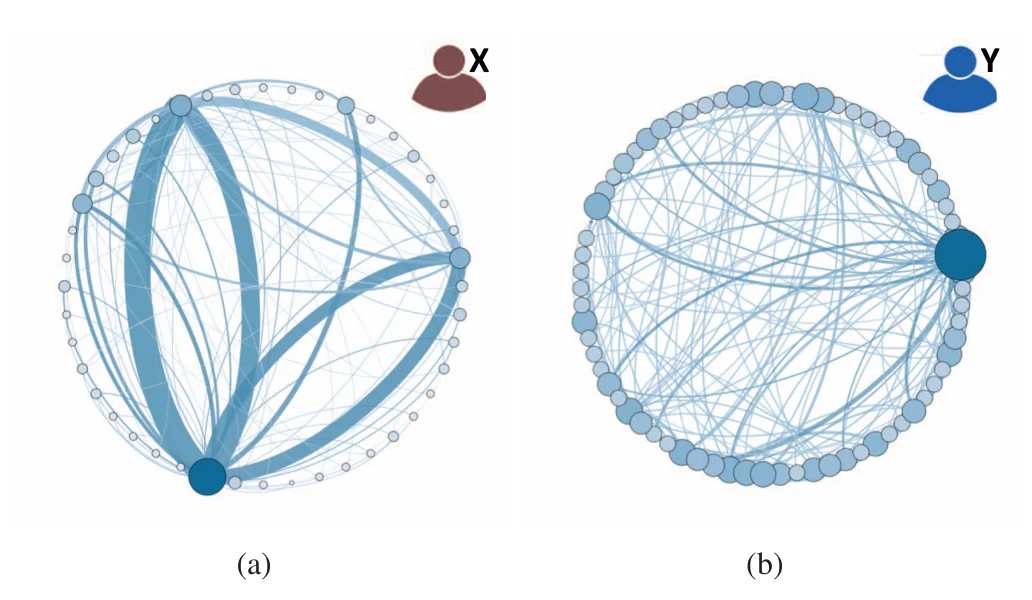
图 4|路线集中在少数几条上,和摊到许多条上,熵有什么差别?
(a)用户X的行程堆在少数几条粗边上,移动熵低;论文把这种反复出现的模式理解为未来位置相对可预期。(b)用户Y的行程分散在许多粗细更接近的边上,移动熵高,更难以既有模式判断下一次移动。点的大小表示该基站经手的通话次数,边的粗细表示这条起讫对上的行程次数。图中没有给出两人的熵的具体数值。来源:原论文 Fig. 4。
论文把低熵理解为行程反复集中、因而更可预期,把高熵理解为更难只凭既有行程判断下一次移动。正文没有报告预测准确率。
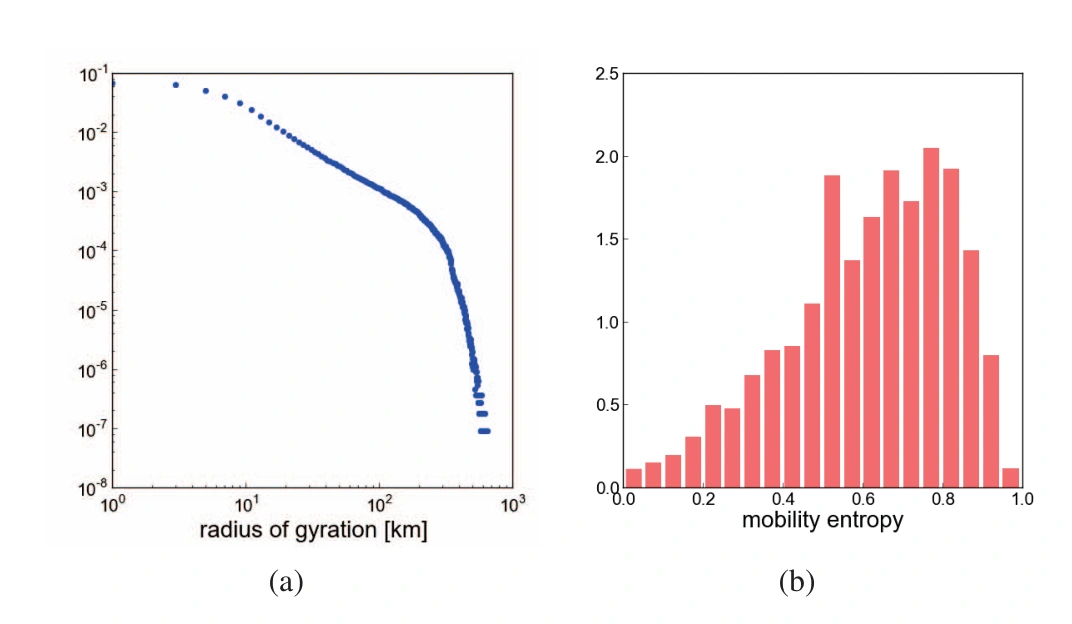
图 3|600万名用户的典型距离和移动熵,各自散成什么样?
(a)横轴是回转半径的公里数,纵轴是概率,两轴都取对数。曲线拖着长尾,说明少数人的典型距离远高于多数人。(b)横轴是移动熵,范围从0到1。分布先升后降,极低和接近1的人数都少。图注写这表示人类移动的平均不可预测程度高;同页正文却写平均可预测程度高,并引用Song等。两句用词相反。后文讨论采用的说法是:熵更高,移动更不可预测。来源:原论文 Fig. 3。
四个市镇指标,高低分别代表什么?
相关能否读懂,取决于指标的方向。INSEE资料覆盖四项,年份都是2007年。
人均收入是市镇平均收入。相关图使用常用对数log10。论文没有在正文标明货币单位。
教育率(education rate)是居民中只有初等教育的人所占比例。数值越高,停在初等教育的人越多。它不是高等教育比例,也不是平均受教育年限。
失业率是失业人数除以该市镇全体居民。后文每一个失业率相关系数,分母都是全体居民。以劳动力为分母的失业率是另一种指标。
剥夺指数(deprivation index)把若干生活状况合成一个分数,系数来自论文采用的法国版做法:
剥夺指数 = 0.11×过度拥挤 + 0.34×无电暖气 + 0.55×非自有住房 + 0.47×失业 + 0.23×外国国籍 + 0.52×无汽车 + 0.37×非技术或农场工人 + 0.45×6人及以上家庭 + 0.19×低教育 + 0.41×单亲家庭。
这些系数是线性组合里的既定权重,十个系数之和为3.64。指数越高,剥夺程度越高。论文转述,这一指数与法国市镇的收入、教育有较高关联,因而在一定程度上能够表示社会经济地位;那个关联本身的数值不在本文里。指数中的失业、低教育,和上面单独使用的失业率、仅初等教育比例是相关的构造,论文仍把它们当作各自的指标。
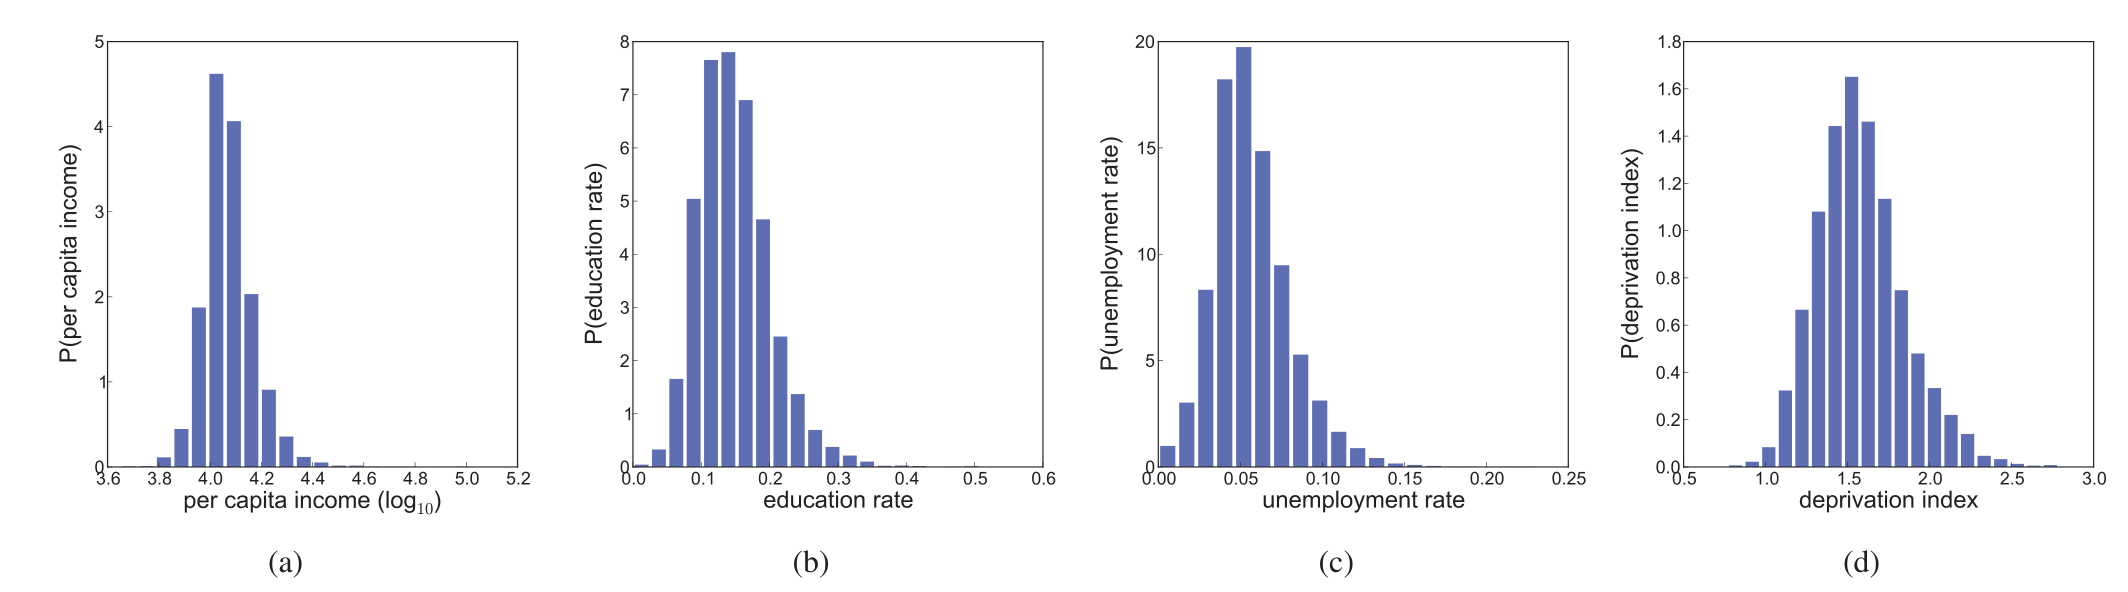
图 1|法国市镇的四项社会经济指标,是不是各有一个常见水平?
(a)人均收入的常用对数。(b)仅初等教育比例。(c)失业率,分母为全体居民。(d)剥夺指数。纵轴都记为P,表示该取值出现的概率。四个分布都有明显的峰,说明市镇之间虽有差别,各自仍有比较常见的水平。论文没有给出峰所在的精确坐标。来源:原论文 Fig. 1。
汇总到市镇后,多样性比规模更对得上
每位用户先有自己的rg和S,再按夜间家所在基站进入市镇。市镇指标是这些用户的均值、中位数和标准差。相关是市镇与市镇之间的皮尔逊相关,一组数的分母是5,100座市镇。一个人的熵不会直接出现在相关系数里。
表2把六种汇总与四个指标并排列出。S是移动熵,rg是回转半径。DI、PCI、PER、UR依次是剥夺指数、人均收入、仅初等教育比例、失业率。
| 汇总 | 剥夺指数 | 人均收入 | 仅初等教育比例 | 失业率 |
|---|---|---|---|---|
| 均值 S | −0.43 | 0.49 | −0.49 | −0.17 |
| 均值 rg | 0.01 | −0.25 | 0.01 | −0.04 |
| 中位数 S | −0.43 | 0.48 | −0.47 | −0.17 |
| 中位数 rg | 0.16 | −0.21 | 0.47 | −0.1 |
| 标准差 S | 0.20 | −0.26 | 0.27 | 0.11 |
| 标准差 rg | 0.01 | 0.28 | −0.21 | 0.13 |
均值和中位数的移动熵几乎一样:收入更高的市镇,居民行程更分散;剥夺更高、仅初等教育比例更高、失业率更高的市镇,行程更集中。收入和仅初等教育比例上的绝对值接近0.5,失业率只有0.17。论文概括说,收入、仅初等教育和剥夺与移动的关系强于失业。按表中的定义,仅初等教育比例更低会被说成教育程度更高的地区;这个说法依赖的是“只有初等教育的人更少”,不是直接测到了高等教育。
回转半径的方向大体相反,强度则看用哪一种汇总。均值rg与剥夺指数、仅初等教育比例都是0.01,线性关系非常弱;与人均收入为−0.25,与失业率为−0.04。中位数rg与仅初等教育比例达到0.47,绝对值和中位数移动熵的−0.47相当。因此,“多样性在任何汇总方式下都强得多”能概括大部分格子,盖不住这一个格子。失业率一列里,熵和回转半径同为负号,也不符合“一边为正、另一边必为负”的完整说法。
标准差描述的是市镇内部个人之间的差别,不是市镇指标本身的高低。收入更高的市镇,个人移动熵的标准差更低(−0.26),个人回转半径的标准差更高(0.28)。市镇更富,并不意味着居民的出行彼此更相像;相像的是熵,半径反而更不齐。第六节写每座市镇带有两个汇总指标,表2实际给出的是两种移动各三种汇总。结论里有一处把标准差说成方差,表中列出的是std。
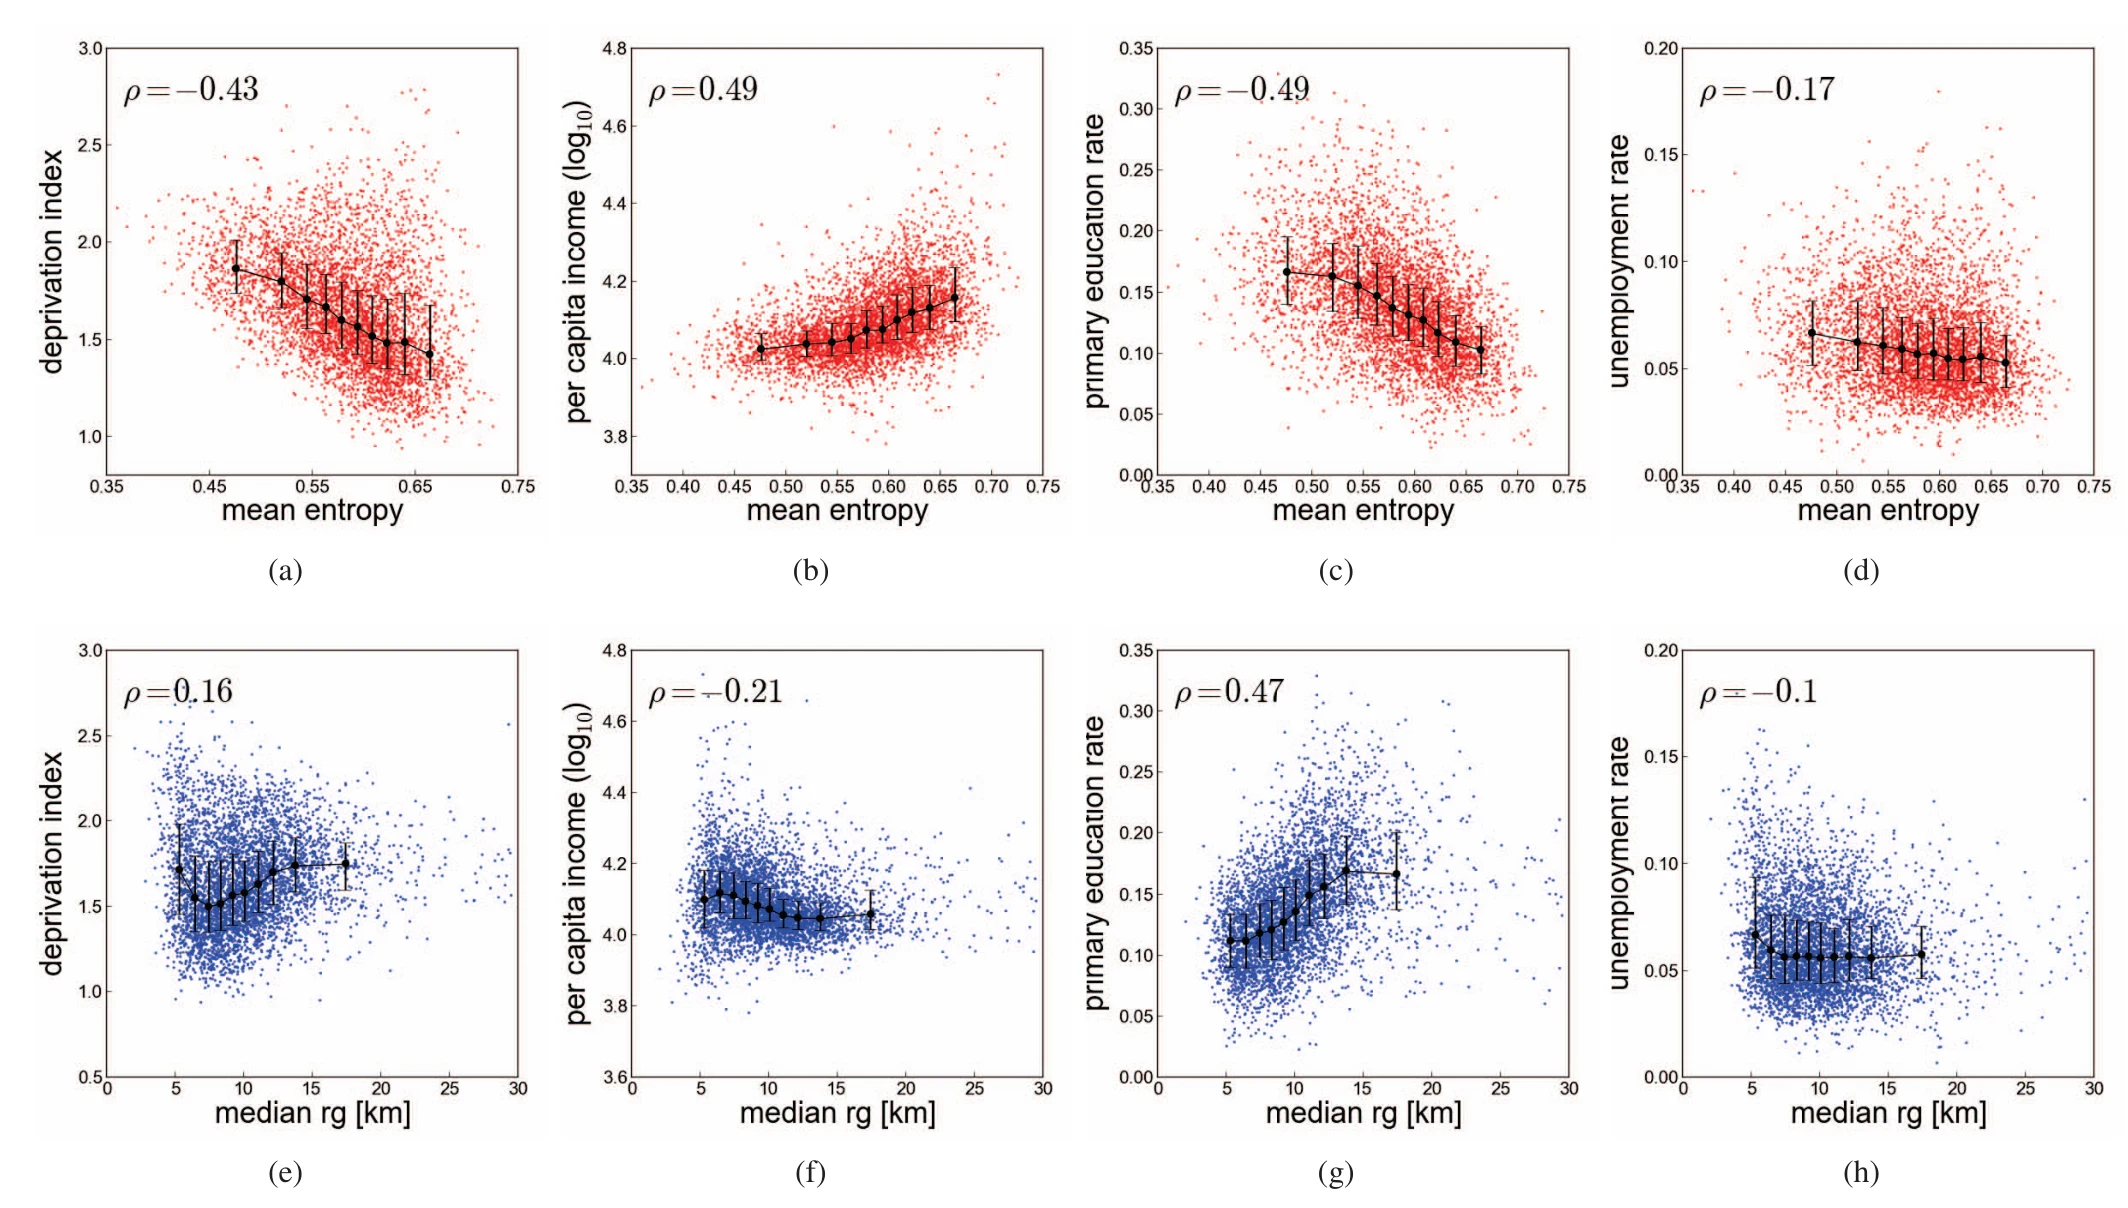
图 5|市镇的移动熵、回转半径,与四项指标各呈什么方向?
上排红点的横轴是均值移动熵,下排蓝点的横轴是中位数回转半径,单位为公里。纵轴依次为剥夺指数、人均收入的常用对数、仅初等教育比例、失业率。市镇先按横轴分成十个样本量相等的组;黑色误差线给出该组纵轴的均值,线的长度是组内标准差。图上的ρ与表2对应格子一致,计算用的是全部市镇。(a)均值熵与剥夺指数,ρ = −0.43。(b)均值熵与人均收入,ρ = 0.49。(c)均值熵与仅初等教育比例,ρ = −0.49。(d)均值熵与失业率,ρ = −0.17。(e)中位数回转半径与剥夺指数,ρ = 0.16。(f)中位数回转半径与人均收入,ρ = −0.21。(g)中位数回转半径与仅初等教育比例,ρ = 0.47。(h)中位数回转半径与失业率,ρ = −0.1。八个面板的p值都小于0.001。在5,100座市镇上,0.17这样的相关也可以越过这个阈值;统计上不像纯随机,仍然可以是较弱的线性关系。散点很宽,黑线只是每组平均值的走势。来源:原论文 Fig. 5。
图5没有画出均值回转半径。表2里那两个0.01因此不能借用图注的p值。作者在这一节把移动熵称为更好的预测指标。第八节又把回归和分类列为后续计划。正文没有训练模型,没有训练组与测试组,也没有报告预测误差。0.49表示线性相关的强弱,论文没有给出它的平方,不能把它写成已经解释了某一比例的收入差异。
剥夺更高的一组市镇,移动熵分布如何挪动?
表2把每座市镇压成一个数。图6改看整组分布:5,100座市镇按剥夺指数分成十个样本量相等的组,每组再画市镇移动熵的分布。
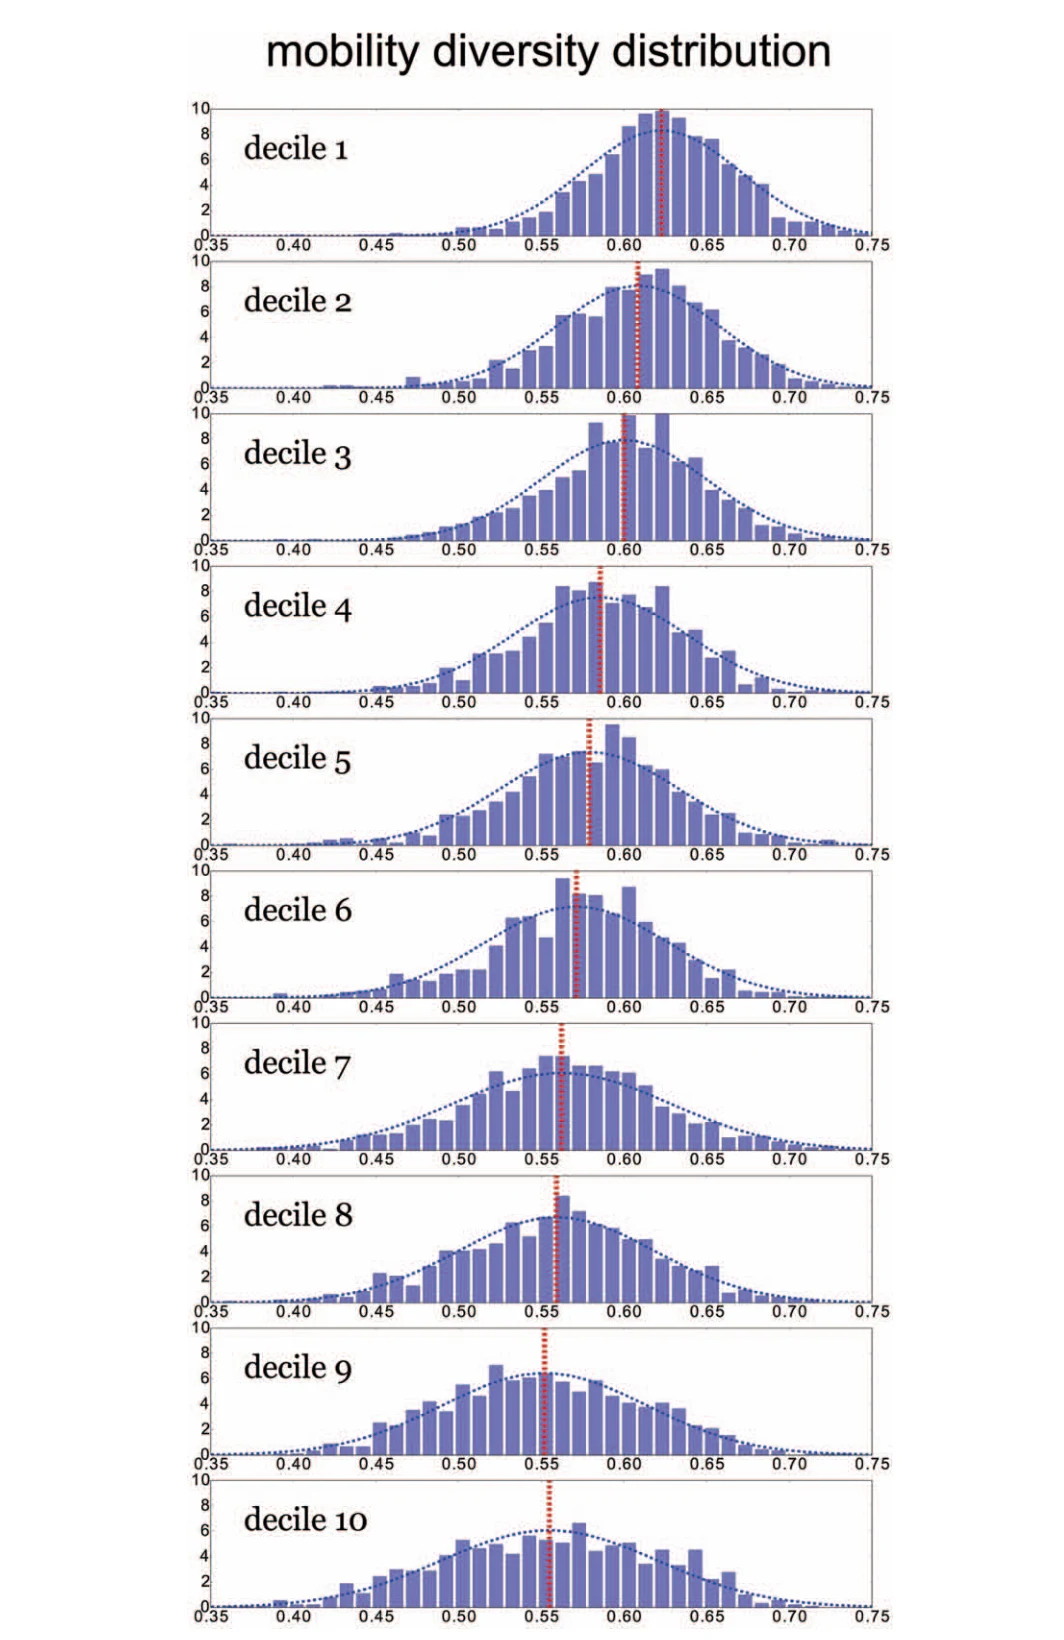
图 6|剥夺指数从低到高,市镇移动熵的整组分布是否只是整体平移?
无字母子图。十行都是市镇层面的移动熵分布,自上而下为第1到第10个等量组。横轴刻度约为0.35至0.75,与图5、图7中均值熵的坐标范围一致;图题没有印出mean或median。红色虚线是该行的均值,蓝色虚线是分布的拟合,纵轴用于比较形状。论文写明均值和方差都随分位发生系统性变化,并与图5(a)一致。图5(a)的相关为−0.43,因此更高的剥夺对应更低的市镇移动熵;图中红色均值线也从第1行到第10行向左移动。论文没有列出十个均值的具体数字。来源:原论文 Fig. 6。
这张图的方差,是同一剥夺分位内部、市镇与市镇之间的离散程度。它不同于表2的标准差S。后者是一座市镇内部、用户与用户之间的移动熵差别。两件散开不能合成一个“不平等”结论。
论文把这种分位差异,拿去对照Song等关于移动可预测性的结果。Song等认为,按性别或年龄划分的子群体,移动熵很稳定。本文则看到,按市镇社会经济状况划分之后,熵的分布会移动。作者由此认为,城市尺度的社会经济状况与个人移动的关系,强于个人人口学特征与移动的关系。本文数据没有报告性别或年龄,这个对照使用的是Song等已经发表的结论,不是同一批用户里重新做的比较。
讨论同时给出一句方向:发展程度更高、更富裕的市镇,居民移动熵更高,因而移动更不可预测。这句里的“更不可预测”沿用的是熵的高低,不是图3图注和正文互相冲突的那两个词。
走得散的市镇,典型距离往往更短
如果多样性已经对上了较高的收入和较低的剥夺,规模又常常对上相反的一侧,那么两个移动指标自己应该是负相关。论文计算的结果是ρ = −0.38,p值小于0.001。图7把这个相关画成均值移动熵对中位数回转半径。
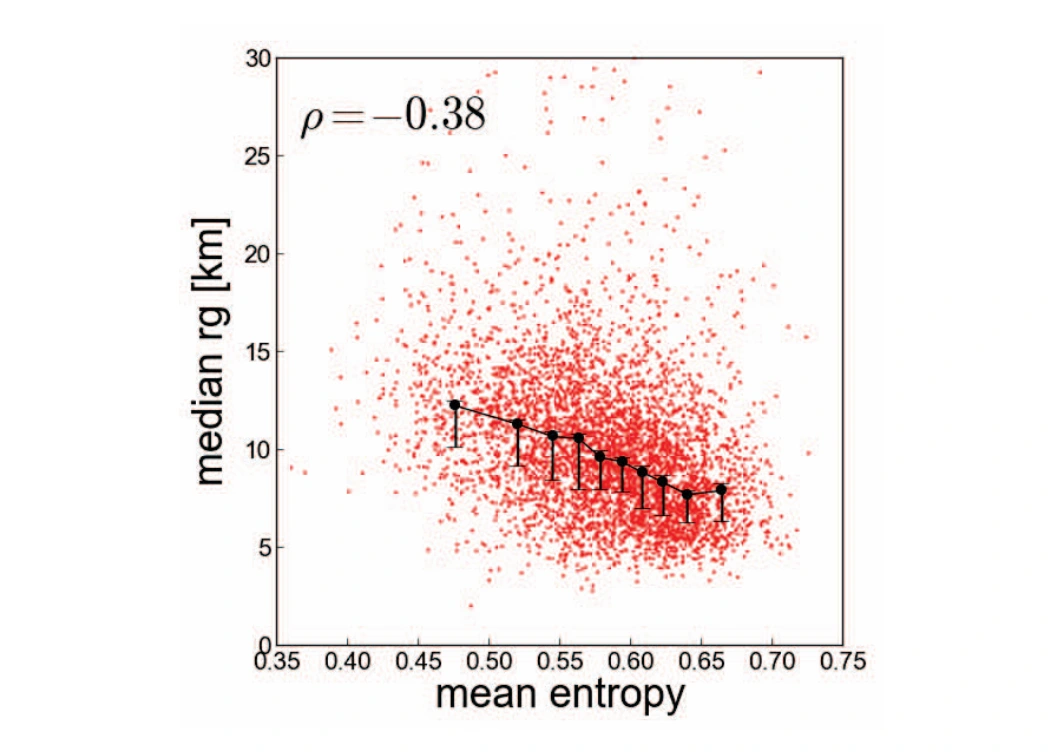
图 7|市镇的行程更分散时,居民的典型距离会更短吗?
无字母子图。横轴是均值移动熵,纵轴是中位数回转半径,单位为公里。每个点是一座市镇。市镇按横轴分成十个样本量相等的组,黑线是组内纵轴均值,误差线是组内标准差。ρ = −0.38,p值小于0.001。黑线下行,纵轴刻度到30公里,点云比黑线宽得多。负相关描述的是5,100座市镇的总体倾向。来源:原论文 Fig. 7。
作者提出一种可能的机制:发展程度较高的市镇,附近就有多种活动,居民的起讫对更多,回转半径不必很大;发展程度较低的市镇,例如乡村市镇,居民要到本镇以外寻找本镇没有的活动,典型距离因此更大。ρ = −0.38支持“高熵与低半径连在一起”。活动种类、公共交通和乡村身份都没有被直接测量,所以这仍是待检验的解释。论文也写明,多样性与社会经济状况的关系是双向的:富裕和设施可能带来更多样的出行,更多样的出行也可能反过来滋养经济联系。经验相关本身分不出这两条路。
随机打乱居民之后,相关还在吗?
市镇人数不同,只做汇总也可能生出虚假相关。论文用一个零模型检查多样性结果:从全体用户中随机抽取N人,分给原来拥有N名用户的市镇,从而保持每座市镇的用户人数。再把同一市镇内用户的多样性指标汇总。整个过程重复100次,每座市镇取100次结果的平均。论文报告,这样得到的结果与四个社会经济指标的相关都是零,因此观察到的相关不太可能只是随机分组的产物。
这段文字明确汇总的是多样性。它没有报告回转半径也做过同样的100次打乱。零模型保住的是手机用户人数N,不是官方人口,也没有补上从未出现在Orange数据里的居民。它回答的是:若这些已观测用户不按真实市镇聚集,多样性与社会经济指标的线性相关是否还在。答案是不在。它没有回答收入为什么与移动熵同向。
这些相关可以支持到哪一步?
可以支持的是一条市镇尺度的描述。在2007年法国、官方居民超过1,000人、并进入本文汇总的5,100座市镇里,居民行程在起讫对上更分散,线性地对上更高的平均收入、更低的剥夺指数和更低的仅初等教育比例。回转半径的中位数往往对上相反方向。两者之间的相关为−0.38。随机打乱用户所在市镇后,多样性这边的相关消失。
再向外推,就超出了现有证据。个人收入不在数据里,0.49停在市镇。数据来自一家运营商、一个45天的秋初窗口,基站只在通话或短信时出现,回转半径是这些基站的直线散度。均值移动熵与失业率的相关是−0.17,分母仍是全体居民。均值回转半径与剥夺指数、仅初等教育比例的相关都是0.01,所以“规模”是否与多样性反向,还要看使用均值还是中位数。作者把预测和现况推算写成大数据的潜力;正文停在相关,回归和分类仍在计划里。
一句话总结
法国市镇里,居民行程在起讫对上更分散,比典型距离更大,更能线性对上较高收入和较低剥夺;两个指标方向相反。证据等级是5,100座市镇上的皮尔逊相关。
核心来源
Pappalardo、Pedreschi、Smoreda、Giannotti,Using Big Data to study the link between human mobility and socio-economic development,2015 IEEE International Conference on Big Data (Big Data),第871–878页。首页会议信息为2015 IEEE International Conference on Big Data (Big Data),并印有978-1-4799-9926-2/15/$31.00 ©2015 IEEE。剥夺指数的线性组合按正文抄录,方法指向参考文献[31]:Pornet等,2012,Journal of Epidemiol Community Health,66(11):982–9。移动熵与性别、年龄分组的对照,指向参考文献[36]:Song、Qu、Blumm、Barabási,2010,Science,327(5968):1018–1021。本文只转述这篇论文对Song等的概括,没有重算该文的数值。
作者介绍
- Luca Pappalardo:署名为意大利比萨大学计算机科学系。本文由他与合作者完成。参考文献中,他还参与了汽车出行空间模式,以及人类移动里回返者与探索者划分的研究。
- Dino Pedreschi:署名为意大利比萨大学计算机科学系。参考文献中,他与Giannotti等讨论用大规模数字痕迹做社会挖掘。
- Zbigniew Smoreda:署名为法国Orange Lab的SENSE。致谢写明,通话详单由Orange提供。
- Fosca Giannotti:署名为意大利国家研究委员会信息科学与技术研究所。参考文献中的社会挖掘和移动数据分析,与这一署名单位上的工作相连。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果一个统计指标把移动熵和回转半径合成一个“总移动”分数,图7的负相关会让两种市镇互相抵消。高熵、低半径的市镇,和低熵、高半径的市镇,合成之后可能接近,收入和剥夺却落在表2的两端。更稳妥的做法是两个数分开报,并先检查它们在新的年份、新的运营商里是否仍然保持−0.38这种反向关系。这是一项尚未做的指标设计,不是论文已经比较过的方案。
另一个需要单独检验的问题出在汇总层次。5,100座市镇上的0.49,不能直接变成“出行更散的人收入更高”。高收入市镇内部,完全可以有人长期只在两个基站之间往返;表2里收入与移动熵标准差的相关是−0.26,说明市镇之间的整齐程度也有限。若在同一年、同一运营商把个人移动熵与个人收入配对,符号仍与0.49相同,市镇结果才更接近个人状况;若符号反过来,市镇相关就不能被讲成个人规律。本文没有这组成对数据。