把一天待在哪里对上之后,手机记录漏掉了谁?
论文名片|Ayumi Arai、Zipei Fan、Dunstan Matekenya、Ryosuke Shibasaki,Comparative Perspective of Human Behavior Patterns to Uncover Ownership Bias among Mobile Phone Users,ISPRS International Journal of Geo-Information,2016,5,85,2016年6月6日发表。DOI:10.3390/ijgi5060085。观察研究:比较手机用户和全体居民的日常,从而看出通话记录的持有偏差。
用达卡的手机通话记录看一座城市白天谁在移动,材料本身很省事。运营商为计费记下通话时间、基站位置和通话时长。图上反复出现早上离开、晚上回来,很容易被当成这座城市的普通一天。
持有偏差(ownership bias)指的是:记录里只有使用该运营商手机的人,这一群人的构成可以和全体居民不同。达卡这里的比较单位是一天里人待在关键地点的时间。手机用户的日记、通话记录里抽出的时间模式、以及全体居民的出行日记,被放到同一组地点上。对得上的是两类日常:白天在家以外的固定地点从事创收活动的男性,以及大部分时间在家做家务的女性。全体居民里以受教育为主要活动的人约占三分之一;在这家运营商的用户里,学生比例只给出一个很小的下限。
先说结论
- 2009年达卡大区75000人的居民出行样本中,主要活动为创收、家务、教育的受访者分别占38%、25%、32%,其余5%为其他。样本里男性占54%,女性占46%。
- 2013年11月至2014年1月的922名用户中,创收活动占男性用户的89%,家务占女性用户的77%;教育在男性用户和女性用户中都只占4%。
- 这些男性工作者的主要活动地点中,72%是家以外的一个固定地点,由特定建筑62%和街头固定地点10%相加。被归为家庭主妇的用户里,94%的主要活动在家。
- 2013年8月5000个通话用户抽出三种时间模式。其中两种在形状上对得上“白天在外、回得最晚”和“长时间与家有关”;早上约8点、晚上约7点的双峰,对不上学生日记里更窄的上午和傍晚峰值。
- 缺少收入组人口权重时,手机用户中男性工作者、主妇、学生的比例下限为46%+、26%+、4%+。学生在出行样本中占32%,在手机用户中的下限只有4%,这是构成上的大缺口。
三套记录看见的不是同一群人
通话记录(call detail records,CDR)只在手机被使用时更新,所以它在空间和时间上都是稀疏的,看到的是真实轨迹的一部分。这篇论文要补上的,是这些点属于哪一类人的一天。
三套数据的年份和抽样框并不相同。
居民出行调查(Person Trip,后文称PT)由日本国际协力机构于2009年在达卡大区入户完成,访问75000名居民,设计目标是代表一般人口。记录包括一个“典型日”的出行时刻、起讫点、交通方式和目的,以及年龄、性别和职业。男性占该样本的54%,女性占46%。
手机用户日记来自实地调查SPACE,全称是达卡手机用户活动模式综合调查。时间是2013年11月至2014年1月,对象是使用这家运营商的人。一天的日记记下各项活动的时长,并带有当天的通话记录;另一部分记下年龄、性别、职业和主要日常活动。达卡大区在通话记录覆盖范围内被分成161个行政区,再按主导土地利用分为居住、商业、工业。从中按人口份额抽取15个地区:10个居住、2个商业、3个工业。每个地区的高、中、低收入组各抽18户,户内至少有一名该运营商用户。某地区贫民窟人口超过25%时,这部分被放进低收入组抽样。15个地区、3个收入组、每组18户,合计810户,实际访问922名用户,所以有的家庭不止一名用户。作者写明,SPACE对应的是各个收入组里的该运营商用户,不代表这家运营商的全部用户。访问安排在工作日和周末,并分早晨、下午和晚间入户,以便碰到白天外出工作的人。
通话记录是同一家运营商2013年8月、达卡大区全部基站上的呼叫。字段包括时间、基站位置和通话时长。作者从中随机抽取5000个不重复用户编号,并让样本在研究区内地理分布均匀。他们没有使用全量,理由是5000人足以提取典型日常。这5000人没有性别和职业字段。后面把某种通话模式叫成男性工作者或主妇,靠的是曲线像不像日记,不是这5000人自己填过问卷。
三套数据因此不能当成同一批人的前后对照。PT早四年,SPACE和通话记录相差约一个季度,而且SPACE的家庭必须已经有这家运营商的手机。
用户里反复出现的,是两类家庭角色
922名用户先按收入组看性别和婚姻。高、中、低、贫民窟四档中,男性用户分别占62%、52%、63%、68%,每一档都多于女性。已婚用户分别占85%、86%、87%、86%。论文据此概括为已婚者超过85%;表里高收入一档写的是85%。作者没有给出各档人数,所以这里不能加权成一个总的男性比例。
论文用孟加拉国城市劳动力参与率给这种性别分工提供背景:城市女性35%,男性80%。在性别比接近1的假设下,他们粗估从事有收入工作的男性大约占人口40%,相应的女性不到20%。这是外部劳动力统计加上假设后的粗算,不是PT的75000人,也不是SPACE的922人。
主要活动被分成能获得货币收入的创收活动,以及家务、教育和其他。受薪、兼职和自雇都算创收。
| 主要活动 | 男性用户 | 女性用户 |
|---|---|---|
| 创收 | 89% | 18% |
| 家务 | 1% | 77% |
| 教育 | 4% | 4% |
| 其他 | 5% | 1% |
分母是该性别的SPACE用户。男性四项因四舍五入合计99%,女性四项合计100%。论文没有公布进入这张表的男女人数,所以不能把89%和18%合成922人的一个百分比。
同一模式在四个收入组里都在。从事创收活动的男性,在高、中、低、贫民窟分别占86%、87%、93%、95%;括号里论文称为已婚用户比例,依次是78%、81%、86%、88%。做家务的女性分别是75%(78%)、79%(87%)、85%(95%)、71%(78%)。论文没有再写明括号的分母是该收入组的全部用户,还是正在从事这项活动的人。他们由此把两类典型用户称为男性工作者(working males)和家庭主妇(housewives):前者是从事创收活动的已婚男性,后者是主要做家务的已婚女性。学生是第三大组,绝对比例远小于前两组,而且这些学生大多是大学生。
运营商资费被写成比孟加拉国其他公司相对更贵,并被视为用户构成的一个因素。正文没有给出资费金额。
家和工作地,先把日记里的三组人分开
通话记录只能看到基站,看不到问卷里的“上班”或“做家务”。日记因此先把活动收成地点。自报的家标为Home。自报的工作地标为Work。没有工作地的人,用家以外出现最多的地点充当Work。主妇和学生的家以外主要地点也标成Work,学生受教育的时间算进Work。所以图里的工作地,在三组人里不是同一种活动。每个人都被标上家和工作地,另外还有Other;下面两张小时图只画了前两类。工作日和周末没有分开,因为用来对照的PT只指定了一个典型日。
男性工作者的主要活动地点里,家占7%,家以外的特定建筑占62%,街头的一个固定地点占10%,多栋建筑占3%,在多个地点之间移动占18%。62%与10%相加,就是论文所说的72%:主要活动发生在家以外的一个固定地点。分母是这些男性工作者的主要活动地点。主妇一侧,家占94%,特定建筑4%,街头固定地点1%,多栋建筑1%,多地点移动0%。
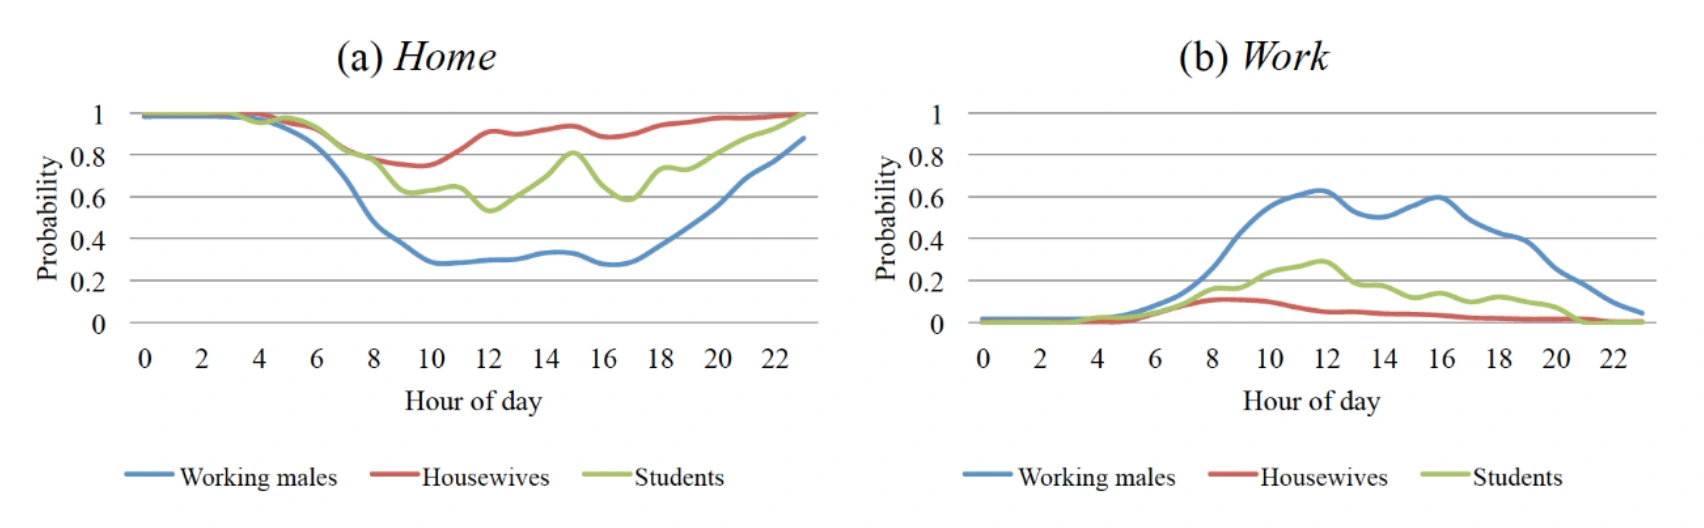
图 1|这家运营商的三类用户,一天里在家和工作地的概率怎样分开?
(a)纵轴是该小时人在家的概率,横轴是0到22时,三条线分别是男性工作者、主妇和学生。夜间三条线都接近1。男性工作者从早晨下降,大约10时到16时落在0.3附近,入夜后再上升。主妇全天最高;论文概括为几乎全天接近1,图上白天最低处在0.8上下,没有落到另外两组的位置。学生白天降到0.6附近,午后有一次回升,再降,晚上回到高位。(b)纵轴换成在工作地的概率。男性工作者约6时后上升,11时到12时略高于0.6,午后仍维持在0.5以上,16时附近再次接近0.6,然后下降。学生的形状也是白天升高,峰值大约0.3,下午还有一处更低的起伏。主妇只有上午约0.1的小鼓包,其余时间接近0。论文把男性明显高于学生这一点,联系到办公室时间(举例为9时到17时)和达卡上学时间的差别;图上没有标出上课时刻。来源:原论文 Fig. 1。
图1的概率是组内份额,不是922人混在一起的平均值。论文没有给出进入每条曲线的人数,也没有误差线。学生曲线来自用户中很小的一组,读起伏时要比前两组更谨慎。
通话只在打电话时出现,主题模型补的是共同的时间形状
5000人的记录不能直接画成图1。没有电话的小时是空的。论文把主题模型用在这个缺口上:一个用户的全部通话像一篇文档,每条记录的时间和地点像词,一种反复出现的日常像一个主题。模型是潜在狄利克雷分配(latent Dirichlet allocation,LDA)的扩展,用吉布斯采样估计未观测的主题。论文没有给出先验的具体数值,也没有报告把主题个数换成别的数之后,三类模式是否还在。
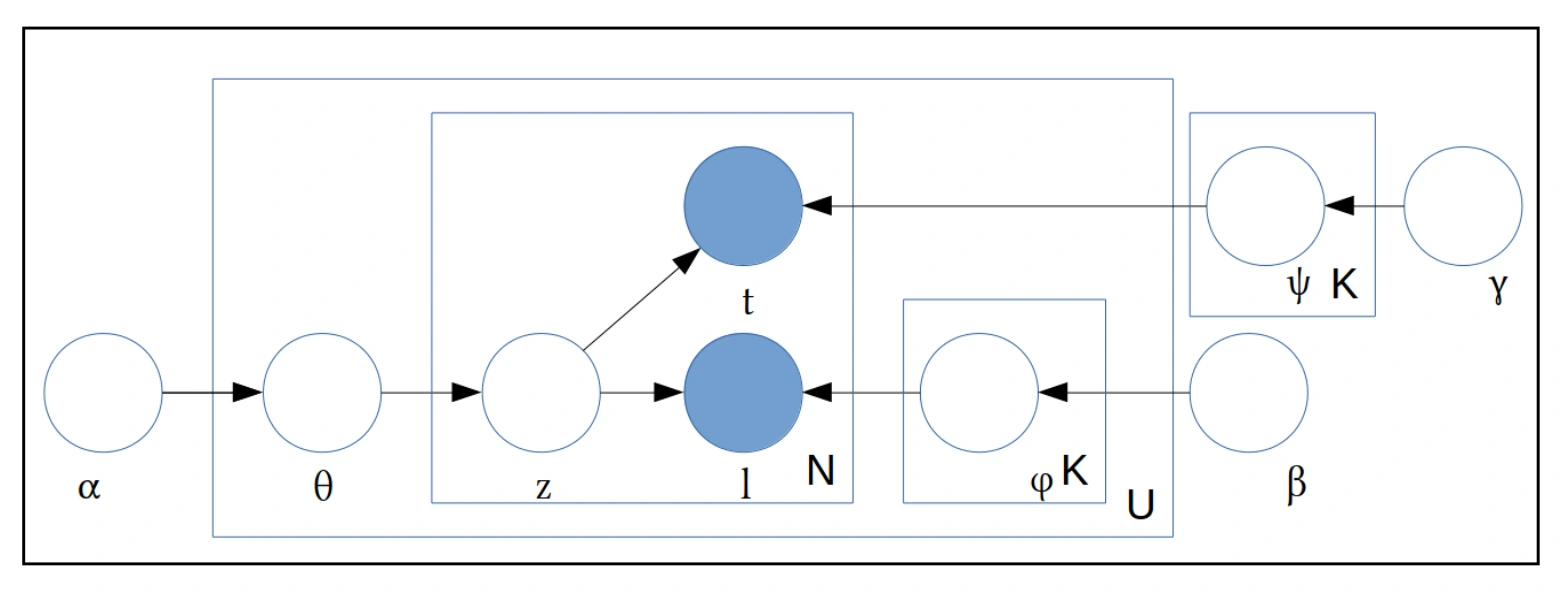
图 2|为什么不同的人可以共享一种作息,却不必共享同一座房子?
深蓝节点是观测到的时间t和地点l,空心节点是未观测变量。α通向每个用户的主题分布θ,z是一条记录被分到的主题。地点分布φ画在用户框U里面,并由β约束,所以同一主题下每个人有自己的地点。时间分布ψ画在用户地点框之外,并由γ约束,所以一天中的时间形状是用户之间共用的。N是该用户的记录数,K是主题数。这张图要解决的比较是:把“什么钟点活动”和“在哪一个基站”拆开。性别、职业和受访者姓名都不在这些节点里。来源:原论文 Fig. 2。
地点含义靠一条假设接回日记:午夜之后概率最高的地点被当作家。论文给出的理由是,达卡的办公室、商店和娱乐场所夜间大多关闭,多数人夜里更可能在家或家附近。这是假设,不是这5000人填写的家庭地址。后面说某一主题的人长时间在家,依赖的就是这一步。
三种通话时间,只稳稳对上两类人
模型抽出三个主要主题。图3的纵轴没有文字标题,刻度从0画到1.2;论文称这些曲线为每个小时的主题占比。它画的是通话在时间上的权重,不是图1那种由日记直接数出来的在家概率。横轴是1时到24时。论文没有给出每个主题包含多少用户。
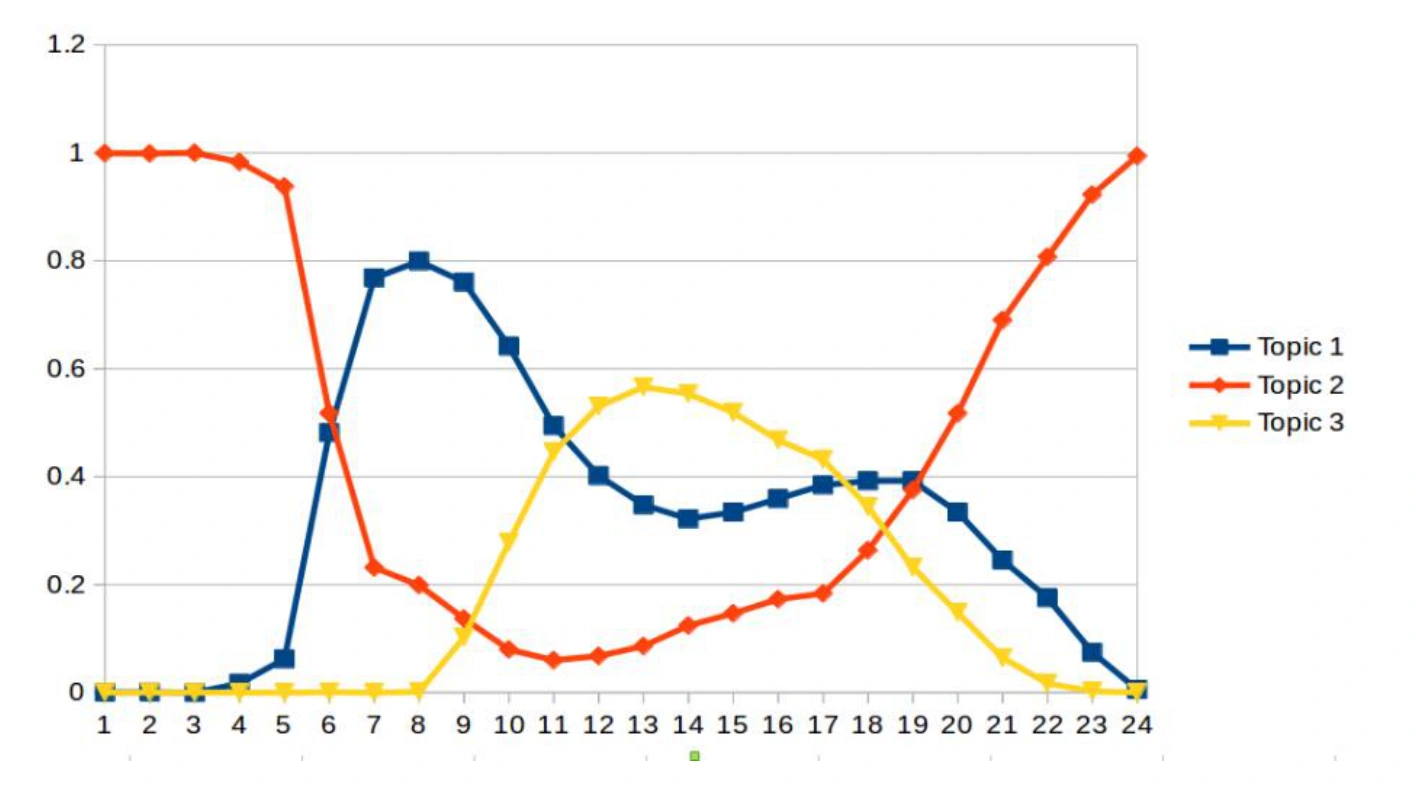
图 3|三种通话时间,哪一种像白天出门,哪一种像白天仍与家有关?
蓝方块是主题1。它在凌晨接近0,约5时后陡升,8时前后达到大约0.8,午后降到略高于0.3,18时到19时停在大约0.4,24时回到0。论文把两个峰写在大约8时和19时;图上早峰明显高于晚间这一处。红菱形是主题2。1时到4时贴着1,6时前后落到0.5,白天降到接近0,17时以后上升,24时回到1。论文称这种通话更集中在夜间。黄三角是主题3。它在8时以前接近0,13时前后升到略高于0.5,然后下降,23时以后回到0。论文称它在白天占优。来源:原论文 Fig. 3。
作者再把这些主题和日记对照。主题2的人,夜间和白天待在被假定为家的地点上差别明显,在外时间长,回家时刻是几种模式里最晚的,因而最像男性工作者。主题3从午夜以后到中午以前,处于该地点的时间最长,因而最像主妇。主题1和主题2都被描述为有大量时间在家以外。主题1的双峰和学生日记并不很像:学生在图1里的工作地峰值更窄,落在10时到12时,以及17时前后。论文认为主题1里既有学生,也有分不进主题2和主题3的其他人。
因此,通话记录这边能够稳妥分开的是两类人。学生没有形成一条干净的第三条曲线。而且5000个编号和922名日记受访者没有被写成同一批人,对得上的是模式,不是逐人核对。
全体居民的曲线大体还在,学生和男性工作者靠得更近
PT把一般人口里的主要群体收成男性工作者、主妇和学生,其余记为其他。图4仍只用家和工作地,分组定义与图1对应,但样本换成2009年的75000人。
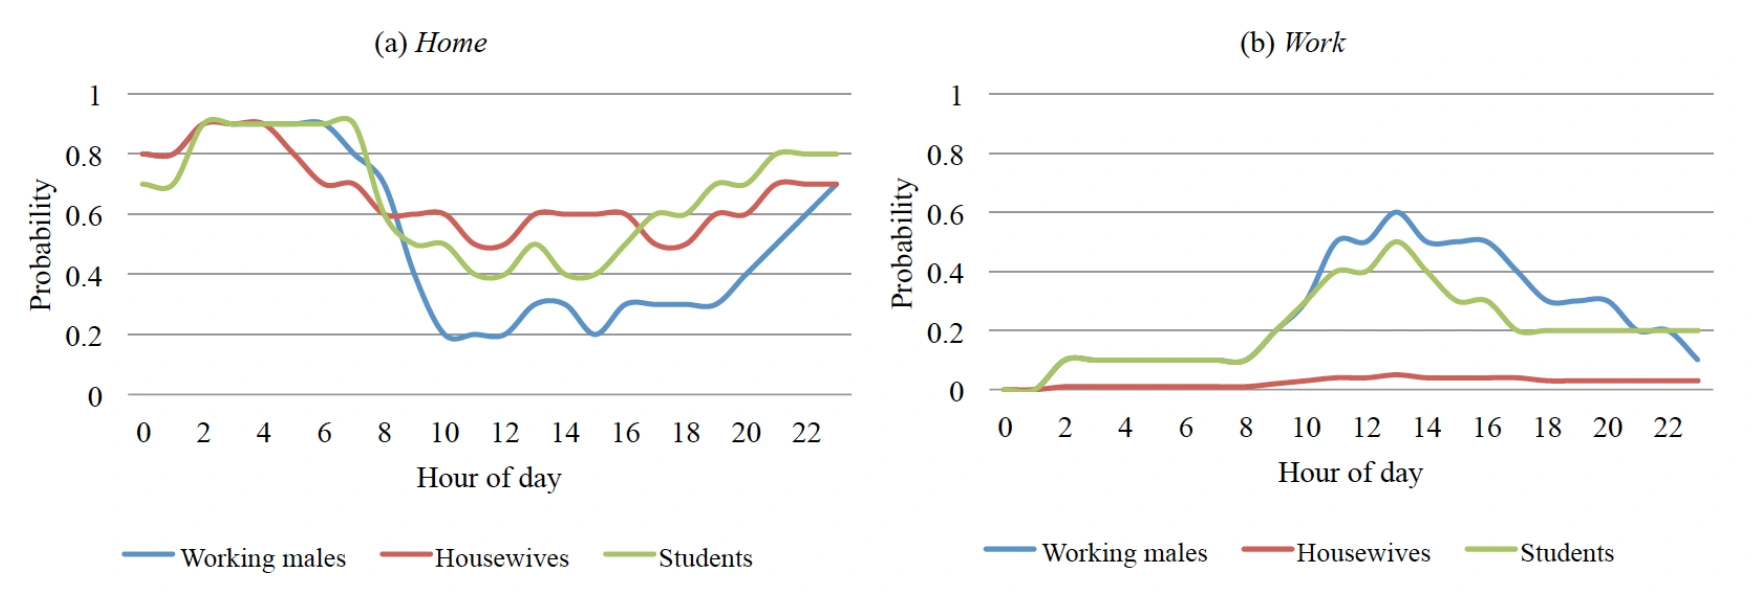
图 4|全体居民的三条曲线,和手机用户像在哪里?
(a)在家的概率。男性工作者白天大约落到0.2,低于图1里手机用户的大约0.3,晚上回到0.7附近。主妇白天在0.5到0.6之间起伏,夜间大约0.7到0.9;这和手机用户主妇全天贴着高位不同。学生中午前后大约0.4,晚上回到0.8附近。(b)在工作地的概率。男性工作者和学生都在8时以后上升。13时前后男性大约0.6,学生大约0.5,两条线比图1靠近。主妇全天接近0。学生从17时到22时停在大约0.2,没有像图1那样回到0。论文没有单独解释这段平台。来源:原论文 Fig. 4。
论文的判断是:主妇在家的概率仍是三组中最高的;一般人口里,男性工作者和学生的工作地曲线比手机用户更相似;尽管有这些差别,两个来源的行为模式大体相似。这里没有置信区间或显著性检验。2009年和2013年也没有被放进同一个变化模型。能够说的是形状仍能认出这三类日子,不能说四年之间达卡人的日常没有改变。
行为对得上的地方,人数对不上
PT的活动构成是表1的行百分比,每一行合计100%。全体受访者中,创收38%、家务25%、教育32%、其他5%。男性受访者内部是创收61%、家务1%、教育32%、其他6%。女性受访者内部是创收10%、家务53%、教育33%、其他4%。教育在男性和女性内部都约占三分之一,所以这不是某一性别独有的活动。
论文接着把分析集中到男性工作者、主妇和学生。比较表把一般人口写成38%、25%、32%,与表1全体受访者的创收、家务、教育三项相同,并把第一列称为男性工作者。表1同时写出,创收活动在男性受访者中占61%、在女性受访者中占10%。38%因此是全体受访者的创收活动比例;论文在比较表里把它放在男性工作者一栏。
手机用户一侧不能做同样的加权。SPACE每个收入组抽取的户数相同,又没有各收入组在用户总体中的份额。论文于是对每个收入组各算一次比例,再取下限,表中用加号表示。主妇在高、中、低、贫民窟四档分别占手机用户的30%、29%、27%、26%,所以总体至少是26%。男性工作者和学生只公布了下限,没有公布四档各自的数字。
| 分组 | 一般人口,占PT受访者 | 手机用户,各收入组下限 |
|---|---|---|
| 男性工作者 | 38% | 46%+ |
| 家庭主妇 | 25% | 26%+ |
| 学生 | 32% | 4%+ |
一般人口三列合计95%,其余5%在表1记为其他。手机用户三列都是下限,不能把46、26、4相加后当成完整构成。主妇下限26%和一般人口的25%接近,论文没有据此说主妇被严重放大。男性工作者下限46%高于38%,方向是手机用户里这一类至少已经多于出行样本中的创收活动份额,高出的准确幅度没有点估计。学生从32%到4%+,是论文强调的缺口。
论文还提到孟加拉国人口金字塔底部较宽,而学生多属于较年轻的人群,因此认为通话记录有偏差:它很少包含在达卡一般人口中占显著比例的学生。金字塔这句话没有附带年龄组百分比。
这个偏差能用到哪一步
比较支持的结论是代表性,不是“没有手机导致人不去上学”,也不是“学生的一天在达卡不存在”。日记里学生有自己的在家和工作地曲线。他们在这家运营商的用户中很少,通话主题又没有分出一条与之对应的干净模式,所以用这批通话去描述年轻人和受教育活动时,会缺少这一组。
还有几道边界要留在结论旁边。第一,只有一家未点名的运营商,资费只被定性为相对更贵。SPACE要求户内已有该运营商用户,而且各收入组户数相同,不能直接放大成全部手机用户。第二,5000个编号是否足够,论文只给出判断,没有报告换样本量后的结果。第三,通话时长出现在原始字段里,日常对比使用的是时间和地点;没有电话的小时靠主题模型补成时间形状,模型输出不是逐小时观测到的位置。第四,午夜地点被当成家,是根据达卡夜间多数场所关闭所作的假设。第五,工作地标签在学生那里包含受教育时间,在没有固定工作地的人那里是家以外最常去的地点。第六,作者自己写到,这里的日常相对不复杂,因为强的社会规范把男女的时间拉开了;换到别的城市,还要重新检查人群特征和日常之间的对应。大规模实地调查昂贵,他们提出下一步使用人口普查,因为手机持有被建议列入人口与住房普查的核心题目。那是后续打算,不是本文已经做成的对照。
一句话总结
这家运营商的通话记录,重复的是白天在固定地点从事创收活动的男性和长时间在家做家务的女性;2009年达卡大区出行样本里主要活动为教育的人占32%,手机用户中学生的下限只有4%。
核心来源
Ayumi Arai、Zipei Fan、Dunstan Matekenya、Ryosuke Shibasaki,Comparative Perspective of Human Behavior Patterns to Uncover Ownership Bias among Mobile Phone Users,ISPRS International Journal of Geo-Information,2016,5,85,2016年6月6日发表。DOI:10.3390/ijgi5060085。
Ayumi Arai,东京大学地球观测数据集成与融合研究计划(Earth Observation Data Integration and Fusion Research Initiative)。论文写明她设计并实施实地调查,分析手机用户的日记数据,是通讯作者。前三位作者标注为同等贡献。
Zipei Fan,东京大学工学系研究科(Graduate School of Engineering)。他设计了从通话记录中划分人群行为模式的算法。
Dunstan Matekenya,东京大学新领域创成科学研究科(Graduate School of Frontier Sciences)。他分析一般人口的日记调查。
Ryosuke Shibasaki,东京大学空间信息科学研究中心(Center for Spatial Information Science)。他负责实地调查的管理,以及通话记录的获取。四位作者共同讨论了结果及其含义。论文声明不存在利益冲突。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果用这批通话估计上学途中的人流,缺掉的恰好是主要活动为教育的那一组:出行样本里占32%,用户下限只有4%。男性工作者白天那条整齐的外出曲线,填不上这条缺口。模型可以很好复现它真正看见的电话,同时仍然看不见学校相关的移动。
加号也限制了能说的话。主妇四档是30%、29%、27%和26%,论文采用其中的26%作为下限。这四档都靠近一般人口的25%,和学生一侧32%对4%下限的差距不在一个量级。男性工作者只公布了46%+,没有四档数字,所以只能说这一类至少已经高于38%,不能报出一个超额的精确百分点。
主题1提醒另一件容易做错的事。它有早、晚两个峰,论文明确说它不像学生,而且里面混有分不进另外两类的人。若把每条解释不了的曲线都命名为学生,就会把一个混合组错当成缺失组。
最后,32%来自2009年,4%来自2013至2014年的用户调查。四年里入学、资费和持有率若有变化,这两个数字里会同时含有年代差异和持有差异。论文没有把二者分开。把这对数字当成达卡永远不变的人口结构,会把一次时点上的代表性问题说得过满。