手机只在使用时留下坐标,这些点能代替出行调查吗?
论文名片|Shan Jiang、Gaston A. Fiore、Yingxiang Yang、Joseph Ferreira, Jr.、Emilio Frazzoli、Marta C. González,A Review of Urban Computing for Mobile Phone Traces: Current Methods, Challenges and Opportunities,UrbComp’13,2013年8月11–14日,芝加哥。ACM 978-1-4503-2331-4/13/08。DOI:10.1145/2505821.2505828。这是一篇城市计算方法综述,并用2010年波士顿都市区的三角定位手机记录做演示。
出行调查让人自己写下上班、买菜、接孩子。手机留下的是另一套东西:发短信、打电话、上网,或者手机与蜂窝网络通信时,才多出一个带时间的坐标。坐标由信号强度估算,论文写明误差大约200到300米,记录里没有基站编号。规划师如果只盯着这些点,很难分清人是停下来办事,还是乘车经过。
这篇论文把城市计算里的手机轨迹收成三步:先把坐标收成停留,检验个人移动里已经见过的规律和一天的行程形状;再用目的地周围的土地利用讨论活动类型;最后把点放进道路网;此前许多分析只使用直线距离。停留区上的规律和17种日常模体能够重新看到,并与马萨诸塞出行调查的模体分布接近。活动类型和道路使用在本文仍是方法、条件概率表和一名匿名用户的演示。
先说结论
- 2010年波士顿都市区、来自多家运营商的约100万匿名用户,两个月里有834,690,725条三角定位记录,约占该都市区人口的19.35%。后文把这一覆盖写成约20%。
- 用300米漫游距离和超过10分钟的停留抽出停留区后,一周里各小时的位置规律性平均为64%。这个64%是停留区尺度上的平均值。先前基站尺度研究里的对应数字是70%,两套数字来自不同空间单元。
- 全体用户的不同地点数随时间大约按0.59次方增长,与基站数据上的0.6±0.02接近。第k常去地点的访问频率大约按k的−1.04次方下降。回到旧地点时,去某个地点的概率随该地点以往的访问频率上升。
- 在筛选后的日常移动网络里,17种模体覆盖所测量日常出行的90%以上。手机用户与2010/2011年马萨诸塞出行调查的37,023人,模体分布相近,也与芝加哥、巴黎的既有结果一致。筛选后还剩多少用户、多少人日,本文没有给出。
- 给定土地利用后的活动概率来自调查,不来自手机。居住用地上居家活动占0.70;商业用地上工作占0.23,购物占0.22。用时刻、用地和当天模体一起推断活动的多元logit,论文写明留待后续检验。路网部分给出开源数据库架构,以及同一个人三天的路径预览。
八亿多条记录,先要分开停下和路过
人类移动性(human mobility)在这里指人在城市里反复出现的空间移动,不是搬家或户籍迁移。数据是计费用途的匿名手机记录:用户编号、经度、纬度和时间。定位用标准三角定位算法估计,精度大约200到300米,比用基站代表位置更细,所以作者借用了原先用于GPS轨迹的停留识别。
原始材料的分母要分开看。834,690,725是记录条数。约100万是用户数。19.35%的分母是波士顿都市区人口,分子是这100万用户,来自多家运营商的合计。两个月位于2010年,论文没有写明是哪两个月。一次记录对应一次手机活动,时间上留有空洞。
预处理的第一套规则出现在规律和模体之前。一次停留(stay)要同时满足两件事:连续记录落在300米的漫游距离内,而且第一条到最后一条的时间差超过10分钟。300米对应定位误差的量级。停留点(stay point)取这些记录的质心。同一个人在不同日子回到同一地点时,质心不会正好重合,于是再用网格把停留点收成停留区(stay region)。停留区的最大尺度d设为300米,用来近似一项城市活动里可能步行经过的范围。整个区域先切成边长d/3的矩形格子,d为300米,格子边长就是100米。算法把停留点最多的未标记格子和它的未标记邻居并成一个停留区。作者认为网格能限制簇的大小,这一点比k均值和基于密度的OPTICS更适合已知定位误差的场景。具体合并步骤指向Zheng等人2010年的工作,本文没有把逐步算法重印出来。
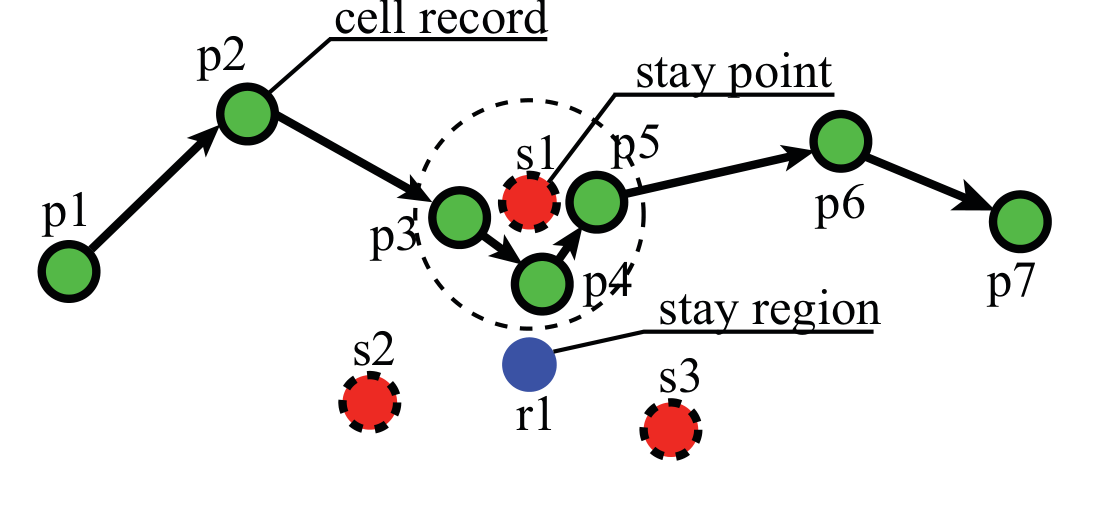
图 1|一次停留怎样从一串坐标里分离出来?
绿色圆点是原始三角定位记录,按时间连成p1到p7。红色是识别出的停留点:s1是p3、p4、p5的质心,虚线圆圈出s1附近被当成同一次停留的记录。s2、s3是另外的停留点。蓝色r1是停留区,文中写明图上的停留点被聚到这一个停留区。来源:原论文 Fig. 2.1。
这张图是规则示意。它说明后面的统计单元已经从单条记录换成了停留区。后面还有第二套规则,用中位点和不超过500米的簇去追踪活动和路径。作者写明,两套过滤的比较不在本文范围内。
格子变小以后,熟悉的规律还在吗?
基站尺度上已经有过一批规律:人们既探索新地点,也优先返回旧地点。地点越多,下一次去新地点的可能性越低;若回到旧地点,去其中某一个的概率与它以往被访问的频率成比例。更细的停留区会把一个基站覆盖范围拆开,这些关系可能改变。本节用上一节抽出的停留位置做检验。这里的“全体用户”是停留提取之后的用户,论文没有再报告一个更小的样本量。
位置规律性R(t)是:在一周的每个小时,用户出现在自己最常访问地点的概率。先前研究在基站尺度上得到,平均约70%的时间,最常访问地点与当时的实际地点一致。本文在停留区上把这条周曲线的平均值算成64%。夜间高于白天,周末也更高。全体用户在每个小时的平均到访地点数,走势与R(t)相反。64%是这条周曲线的平均值:该小时的位置落在此人最常访问地点上的概率,再对用户和小时汇总。70%来自先前的基站研究。两个百分比使用不同的空间单元。
不同地点数S(t)随观测时间t增长,形式是S(t) ∼ t的μ次方。基站数据上μ为0.6±0.02,这个波动范围来自被引用的研究,不是本文给波士顿停留区重新计算的置信区间。本文对全体用户得到μ = 0.59。图上还按两个月内的不同地点数分成四组,并画出四条引导线:80–100个地点的一组为0.66,60–80为0.59,40–60为0.52,20–40为0.41。正文点名的是两端,0.66和0.41。全体用户的0.59与60–80这一组的引导线数值相同,但是对全体另算的结果。作者也写了,两个月里去过更多地点的人斜率更高,这是可以料到的:分组本身用的就是两个月的地点总数。
第k常去地点的访问频率f_k大约按k的−1.04次方下降,略小于先前报告的1.2。作者认为多尺度效应还需要细究,指数可能对停留区的大小敏感。若用户回到一个曾经去过的地点,选中该地点的概率Π与该地点以往的访问频率f成比例。这支持探索与优先返回这一机制。Π的条件是人已经回到某个旧地点,再按以往访问频率在这些地点之间分配。
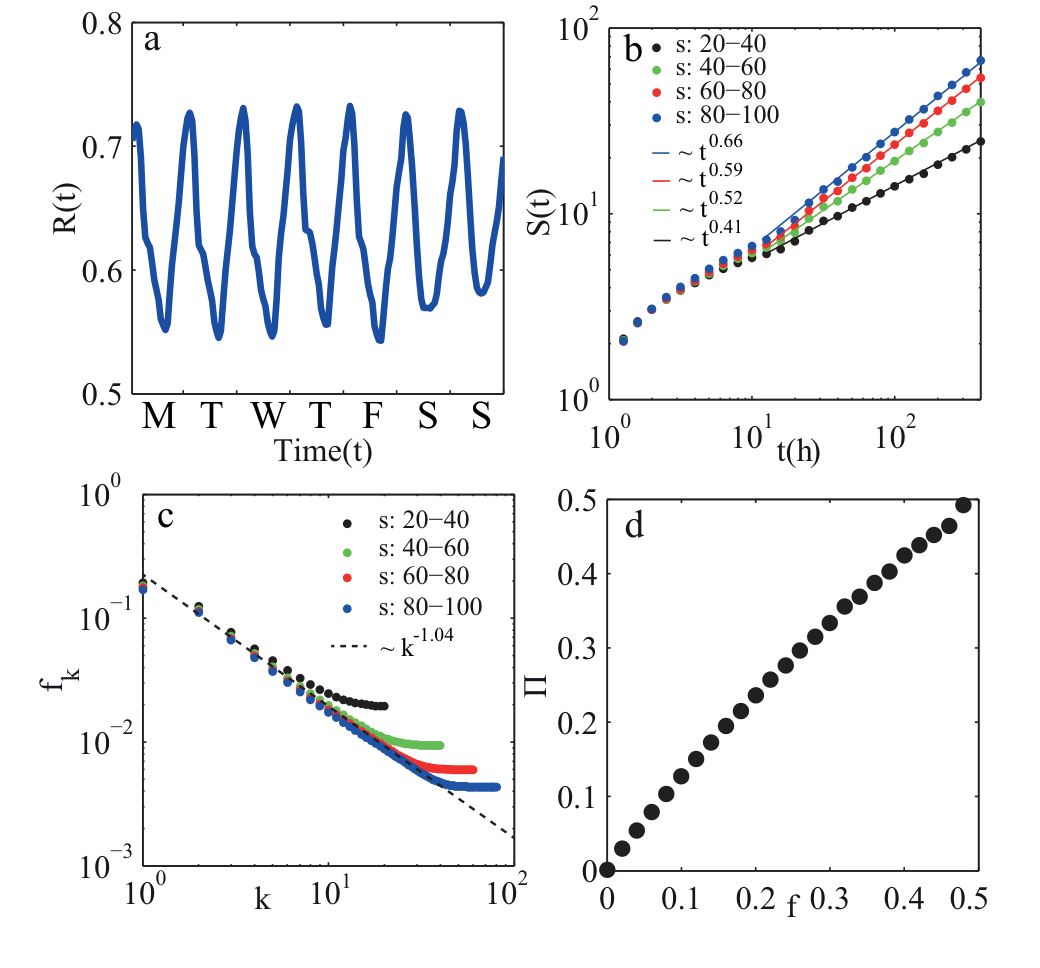
图 2|更细的停留区上,四条熟悉的规律各自变成什么形状?
(a)纵轴R(t)从0.5到0.8,横轴是周一到周日。曲线在工作日白天下降、夜间回升,周末的低谷较浅。64%是这条曲线的平均值,图上没有另画一条64%的横线。(b)双对数坐标。横轴是小时,纵轴是不同地点数S(t)。黑、绿、红、蓝依次是两个月内访问20–40、40–60、60–80、80–100个地点的用户组,引导线依次为t的0.41、0.52、0.59、0.66次方。地点越多的组,后期升得越陡。(c)横轴是地点排名k,纵轴是访问频率f_k。四组在排名靠前时靠近虚线k的−1.04次方;排名变大后,地点较少的组先抬平。抬平与分组有关:两个月只去过20–40个地点的人,排名延续不到很大的k。(d)横轴是以往访问频率f,纵轴是返回该地点的概率Π。散点从原点附近升到f和Π都接近0.5。论文把它读成Π与f成比例,没有另给回归斜率。来源:原论文 Fig. 3.1。
一天的行程,为什么大多落进少数几种网络?
单日行程通常写成活动链:每个活动的开始、结束和地点。调查能写下这些目的,但抽样稀、时段短。论文对调查类数据的一般说明是,都市区里大约1%的家庭会被抽到,而且常常每户只记一天。大约1%是论文对调查类数据的一般说明。本文实际对照的2010/2011年马萨诸塞出行调查,规模是37,023人,每人一条一天的出行日记,按滚动方式采集。手机的特点相反:一天里的停留未必都被记录,但观察期有两个月,用户覆盖写出约20%的波士顿人口。问题于是变成:更长的时间和更大的覆盖,能不能补上定位较粗、记录有空洞这些缺点。作者的答案是,筛选得当就可以。
筛选用在构造模体之前,五条规则都有明确作用,其中两条没有给出人数。第一,只保留记录足够多的频繁用户;“足够”没有数值门槛。第二,去掉只在路上出现的顺路点。第三,去掉相邻地点之间的信号跳动。第四,一天分成48个半小时槽,只有至少7个槽能辨认位置的日子才用来检测行程。第五,夜间通话少,所以把单个用户在全部夜晚凌晨0点到6点最常出现的地点指定为家。更细的筛选过程指向作者此前的模体研究,本文没有重印,也没有给出筛完后的用户数或人日数。
每个被保留的人日做成一个有向网络:点是停留区,边是停留区之间的出行。这里的地点只按停留区坐标区分,不按家、工作地或商店区分。作者采用网络科学里的模体(motif)一词,指那些频繁到难以看成随机碰巧的网络形状。它和调查里的活动链相近,差别是活动链通常带着目的,模体在这一步只带着几何位置。
既有模体研究给出的机制是:一个人一天去的地点通常不超过5个;在超过100万种可能的网络构型里,实际常用的只有17种。生成机制被写成昼夜节律,加上一个隐马尔可夫模型里的扰动:当天一旦已经有一项至少30分钟的灵活活动,再进行另一项灵活活动的可能性,约为尚未离开家或工作地这类固定活动的人的10倍。这里的30分钟是灵活活动的时长。识别停留时使用的是另一条规则:超过10分钟。10倍、5个地点和100万种构型是这套机制里的既有陈述。本文没有在波士顿三角定位样本上重新估计这个10倍。
本文做的检验,是把17种模体同时从手机数据和马萨诸塞调查里抽出来,再与芝加哥、巴黎的既有分布对照。
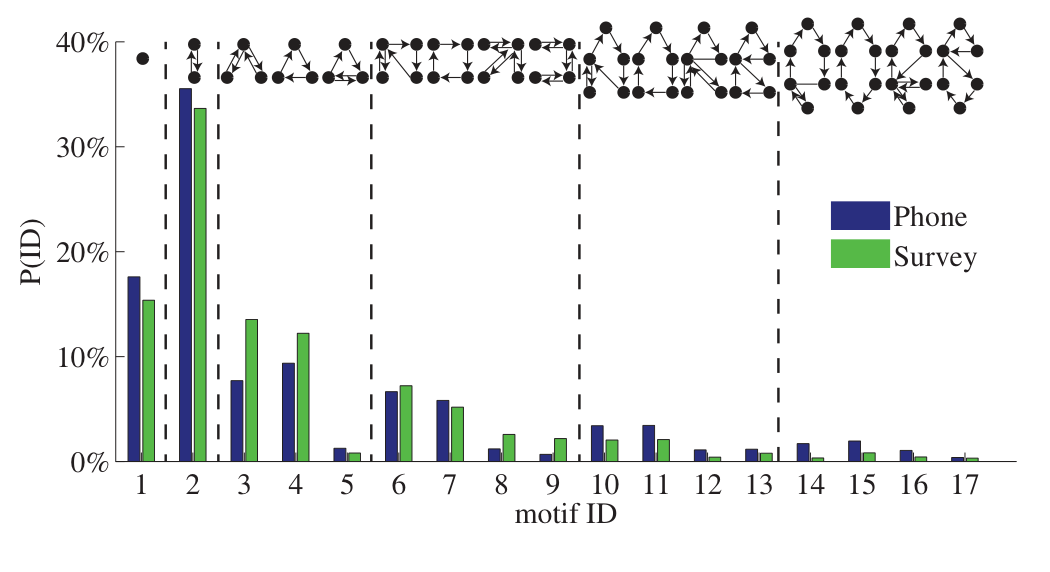
图 3|17种日常行程网络在手机和调查里是否同形?
横轴是模体编号1到17,纵轴P(ID)以10%为刻度,直到40%以上。深蓝是手机,绿色是调查。每根柱顶的小网络用点表示地点、用箭头表示地点之间的出行;论文没有为17种形状逐一写下文字定义。第2种最高,手机和调查都落在30%与40%刻度之间,手机略高。第1种低于20%刻度。第3种上,调查高于10%刻度,手机低于10%刻度;第4种调查也高于手机。第5种以后多数低于10%刻度。图注写明,这17种覆盖所测量日常出行的90%以上。来源:原论文 Fig. 3.2。
因此,相近指的是整体分布,尤其是少数几种网络占去大部分人日。它不表示每一种模体的百分比相同。90%的分母是筛选之后测到的日常出行或日常移动网络。它不覆盖100万用户的每一个日历日,也不按每一条单独的行程段计数。调查的37,023人每人只有一天;手机的人日数没有印出。两套分布可以对照形状,不能折算成同一批人的两天。
知道去过一块地,就知道在做什么吗?
模体回答的是去了哪些坐标、按什么顺序连接。土地利用和交通规划还要问人在那里做什么。调查里的目的由受访者填写。计费手机数据里,目的是隐藏的。手机记录还有两个与GPS不同的困难:时空上有不定长度的空洞,定位也比GPS粗。
这一节换用第二套提取,以便尽量利用200到300米精度。它不再把点收进固定网格。它受Hariharan和Toyama的停留解析启发,步骤分三层。第一层先按时间顺序,把落在300米内的后续记录视为同一次出现,位置改成这些点的中位点,用来压低三角定位的跳动;再忽略时间顺序,把空间上接近的点做凝聚聚类,簇的直径不超过500米,位置再次改成簇的中位点。第二层把持续时间超过10分钟的位置定为观察到的停留,其余点称为顺路点(pass-by)。第三层把已经确认的停留当作这个人的目的地;若顺路点与任一历史目的地重合,就改标为潜在停留(potential stay)。潜在停留承认一种可能:人其实停过,但这次手机记录没有留下足够长的停留。
演示对象是一名匿名用户的两个月,不是100万用户的汇总。从1,776条手机记录中抽出31个不同的停留位置。1,776和31的分母都是这一个用户。
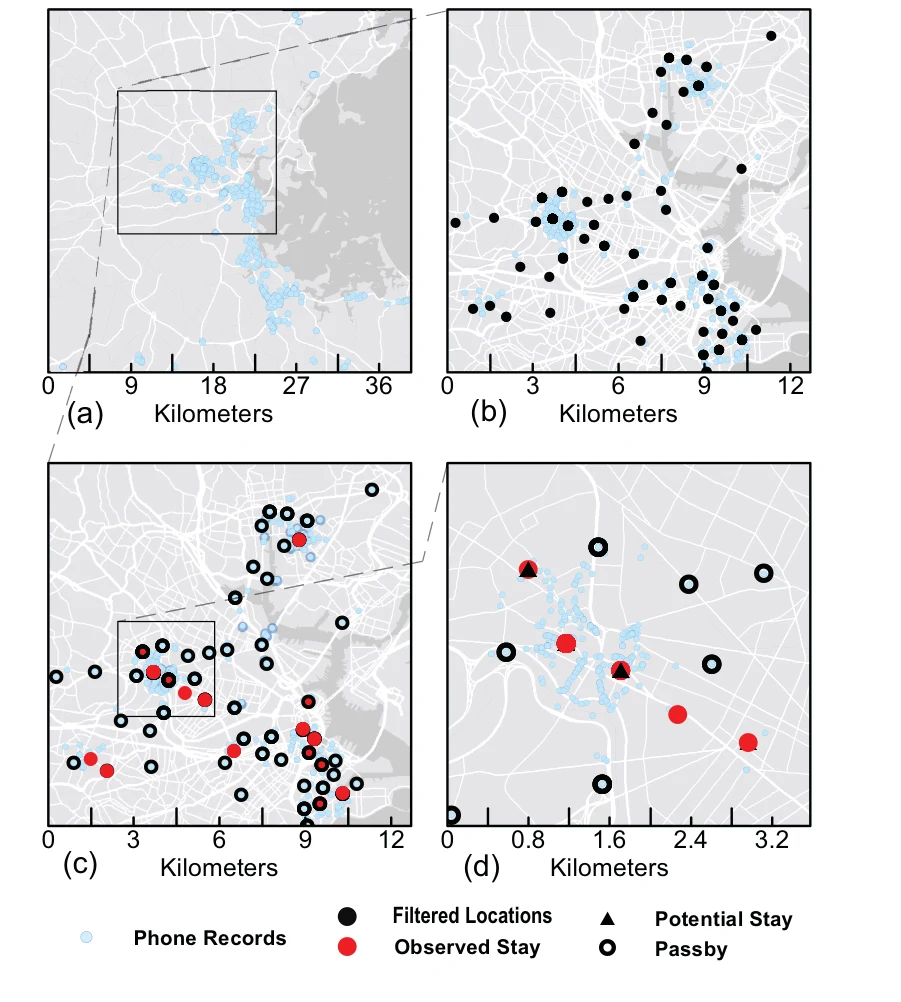
图 4|同一个人的两个月记录,怎样逐层收成停留和潜在停留?
(a)浅蓝色为原始手机记录,比例尺0到36公里,方框标出后面放大的范围。(b)黑点是过滤后的位置,比例尺收到0到12公里,仍能看到一部分原始记录。(c)在同样的0到12公里范围内区分红点所示的观察到的停留,以及空心点所示的顺路点。(d)再放大到0到3.2公里。三角是潜在停留,红点是观察到的停留,空心点是顺路点,浅蓝色仍是原始记录。来源:原论文 Fig. 4.1。
把这些点放回同一天,路径会随纳入的点而改变。作者认为加入顺路点之后,行程推断更接近连续路径。这句话依据的是这一名用户的图示,论文没有给出与GPS或调查路线对比的重合率。加入潜在停留还可能改变当天的模体,因为一些耗时较短的活动会被算进来。所以图3的模体统计不能直接改用这一套潜在停留规则重读。
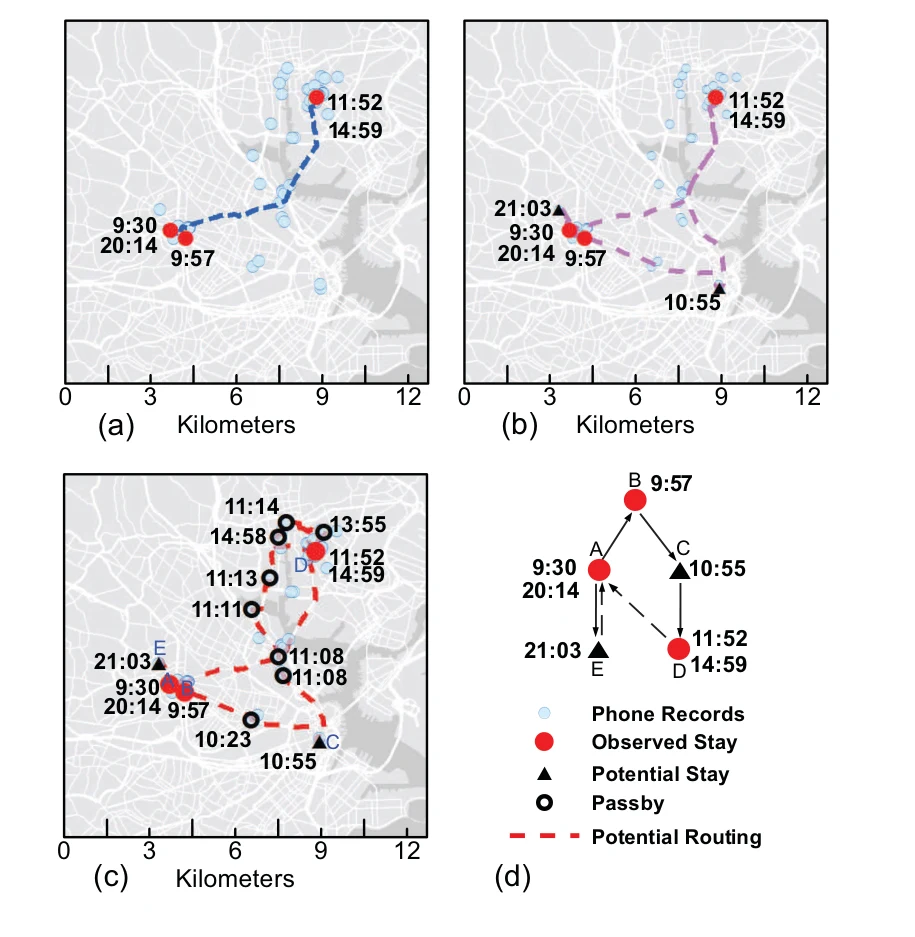
图 5|只保留长停留时,一天的路径会漏掉什么?
图中是图4同一用户的一天,比例尺均为0到12公里。(a)只有红点表示的观察到的停留,时刻包括9:30、9:57、20:14,以及东北侧的11:52和14:59,蓝色虚线把它们连起来。(b)加入三角表示的潜在停留,可见10:55和21:03,连接改成紫色虚线。(c)再加入空心的顺路点,时刻细到11:08、11:11、11:13、11:14、13:55、14:58等,红色虚线是潜在路径,并标出A到E。(d)把这一天收成模体:红点是观察到的停留,三角是潜在停留,虚线是潜在路径。来源:原论文 Fig. 4.2。
活动推断被写成一个条件概率:在时刻t、目的地信息d和当天模体m之下,这个人做活动a的概率。d可以包括位置、土地利用和人口密度。概率可用调查估计,论文举例为多元logit。同一段写明,这一框架将在后续研究中检验。本文没有报告分类准确率、混淆矩阵或手机样本上的命中比例。
表1来自2010/2011年马萨诸塞出行调查与麻省地理信息系统土地利用数据。它给出的是条件概率:在某种用地上,调查所记活动属于某一类的份额。每一列在四舍五入后接近1。论文没有印出每一格的行程条数,所以不能把0.70读成70万手机用户,也不能把37,023人平分进100个格子。
活动的归并是:a居家,含有偿在家工作和其余居家活动;b工作,含工作地的其他活动、志愿活动和公务;c上学;d换乘、接送、处理私人车辆和环行;e日常购物和大件购物;f家政办事、个人事务和就医;g外出就餐;h公民或宗教活动;i室内外娱乐;j访友探亲。用地是:1农地、牧场、森林、湿地和空地等;2多层住宅以及高、中、低、极低密度居住;3商业;4采矿、工业和电力管线等公用设施;5过渡用地;6交通;7废弃物与废品场;8城市公共与机构;9墓地;10参与性、观赏性或水上游憩、高尔夫球场和码头。
| 活动 | 1农旷 | 2居住 | 3商业 | 4工矿 | 5过渡 | 6交通 | 7废弃 | 8机构 | 9墓地 | 10游憩 |
|---|---|---|---|---|---|---|---|---|---|---|
| a 居家 | 0.55 | 0.70 | 0.15 | 0.19 | 0.42 | 0.17 | 0.31 | 0.19 | 0.32 | 0.29 |
| b 工作 | 0.10 | 0.05 | 0.23 | 0.34 | 0.13 | 0.24 | 0.21 | 0.25 | 0.13 | 0.12 |
| c 上学 | 0.05 | 0.03 | 0.02 | 0.02 | 0.03 | 0.02 | 0.03 | 0.14 | 0.05 | 0.13 |
| d 换乘接送 | 0.08 | 0.06 | 0.07 | 0.07 | 0.07 | 0.16 | 0.11 | 0.12 | 0.13 | 0.14 |
| e 购物 | 0.06 | 0.03 | 0.22 | 0.17 | 0.15 | 0.15 | 0.06 | 0.04 | 0.07 | 0.05 |
| f 办事就医 | 0.05 | 0.04 | 0.14 | 0.08 | 0.04 | 0.09 | 0.13 | 0.12 | 0.10 | 0.06 |
| g 外出就餐 | 0.03 | 0.02 | 0.10 | 0.05 | 0.06 | 0.07 | 0.04 | 0.03 | 0.04 | 0.03 |
| h 公民宗教 | 0.01 | 0.01 | 0.01 | 0.00 | 0.00 | 0.00 | 0.00 | 0.02 | 0.03 | 0.01 |
| i 娱乐游憩 | 0.05 | 0.03 | 0.06 | 0.07 | 0.06 | 0.06 | 0.09 | 0.08 | 0.08 | 0.15 |
| j 访友探亲 | 0.03 | 0.03 | 0.02 | 0.02 | 0.03 | 0.02 | 0.02 | 0.02 | 0.05 | 0.02 |
居住用地上,居家占0.70,工作只有0.05,这是十类用地里最像“一种活动占多数”的一列。商业用地上,工作0.23,购物0.22,办事就医0.14,外出就餐0.10,最高的一类也只是略多于两成。工矿公用设施上工作最高,为0.34,居家仍有0.19。游憩用地上,居家0.29,娱乐游憩本身是0.15,上学还有0.13。表上的0.00是印出的四舍五入结果。只看用地类型,多数地块给不出一个占优的活动。
调查目的地通常是行政区质心。马萨诸塞调查用普查区质心,普查区面积从几平方米到约10平方公里。同一区内用地可以混合。手机定位即使细到200到300米,落到的仍是一块区域。作者把“把语义化的用地和兴趣点(points of interest, POI)与到访区域连起来”写成尚未解决的挑战。在线POI的商业类别可以补充用地,本文只说明这种补充可行,没有给出合并后的新表。
周六的例子把这种含糊画在同一个人身上。作者的用词是“推测”“可能”。多元logit尚未在这篇文章里运行。
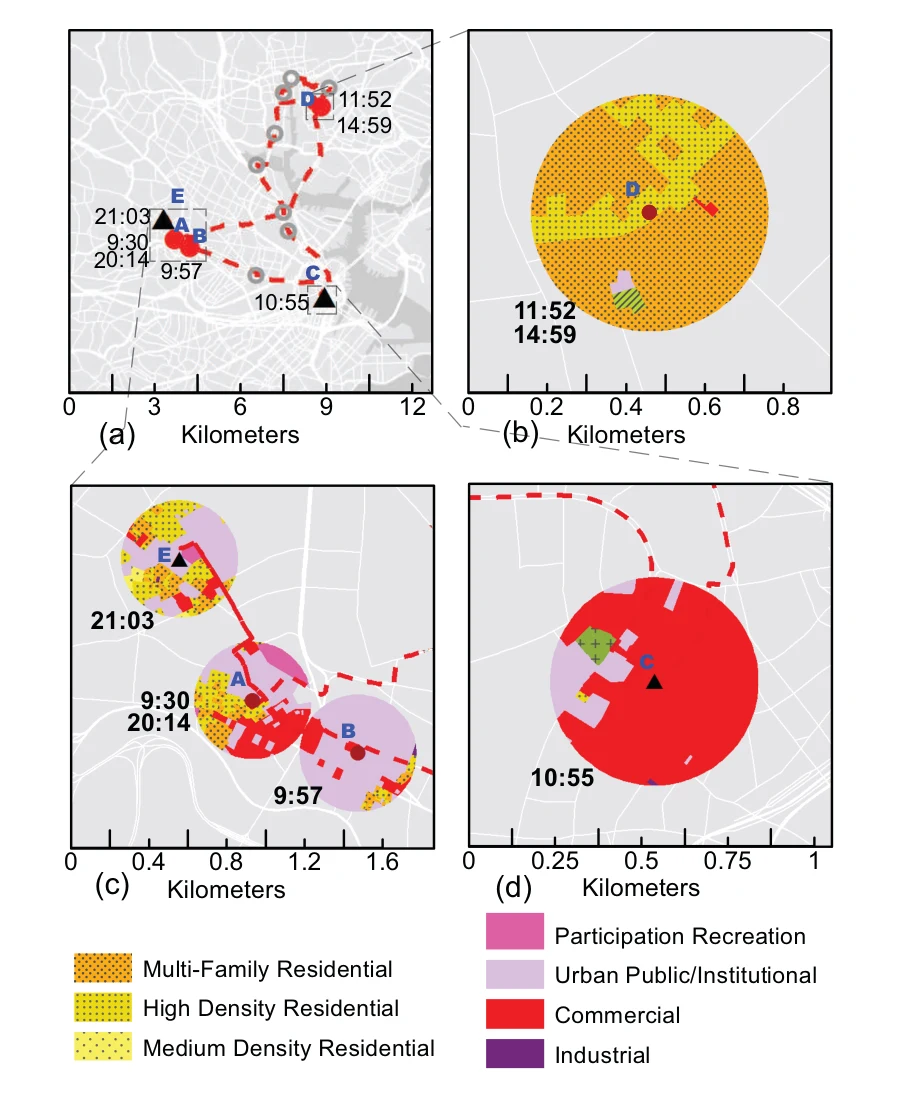
图 6|同一个周六的五个地点,周围用地能不能单独决定活动?
(a)这一天的停留、顺路和潜在停留,比例尺0到12公里,A到E与图5对应。(b)放大D,比例尺0到0.8公里,时刻为11:52和14:59,图面以多层住宅和高密度居住为主。(c)放大A、B、E,比例尺0到1.6公里,居住、商业、公共机构和游憩叠在一起。(d)放大C,比例尺0到1公里,10:55的位置落在大片商业用地旁,并邻接公共机构。橙色点、黄色点和浅黄点依次是多层住宅、高密度居住、中密度居住;粉色是参与性游憩,浅紫是城市公共或机构,红色是商业,深紫是工业。来源:原论文 Fig. 4.3。
按正文对这一天的阅读:A从9:30起检测到22分钟手机使用,9:52之后离开,周围兼有居住、商业和公共机构,作者推测为家。B在9:57左右停留13分钟,用地为公共机构和商业,作者认为可能是短暂购物或办事。C在10:55出现,手机使用很短,但C属于历史目的地,因此可以是潜在停留,周围以商业和公共机构为主。D从11:52起停留116分钟,14:59再次出现并再停留30分钟,周围以居住为主,作者推测为访友或探亲。20:14再次出现在A。21:03在E短暂出现,E也是历史目的地,用地以机构和居住为主;因为没有观察到停留,作者假定夜里回到了A。这些分钟数都是这一名用户这一天的记录间隔。
点落到了路上,车流来源就算出来了吗?
前面的规律大多放在欧氏空间里,距离是地图上的直线距离。道路、轨道和时刻表会限制人实际能怎么走。要讨论方式选择、拥堵和道路使用,手机点需要进入空间网络(spatial network),尤其是费用会随时间变化的网络。
作者引用的一项道路使用研究用基站尺度的手机数据发现,波士顿和旧金山湾区拥堵道路上的主要车流,由很少的驾车来源产生。本文没有重印该项研究的来源个数或比例,也没有在三角定位数据上重新估计。该项研究使用了交通规划软件TransCAD。本文改用可以公开获得的组件:PostgreSQL存放手机数据和路网,PostGIS处理地理对象,pgRouting在数据库内做路径计算,Python通过PyGreSQL实现前面的轨迹处理。
他们列出的软件规格包括:数据库最大容量不限,单表最大32TB。这是软件上限。论文没有把波士顿这批数据的实际体积写成32TB。路径功能包括Dijkstra最短路、A*、考虑转向限制的Shooting-Star、旅行商问题和行驶距离。费用可以由SQL按多个字段现算,数据一改,路径计算就使用新值。这个设计是为了以后加入随时间变化的费用和多种交通方式。本文的图还不是一张拥堵或方式划分的结果。
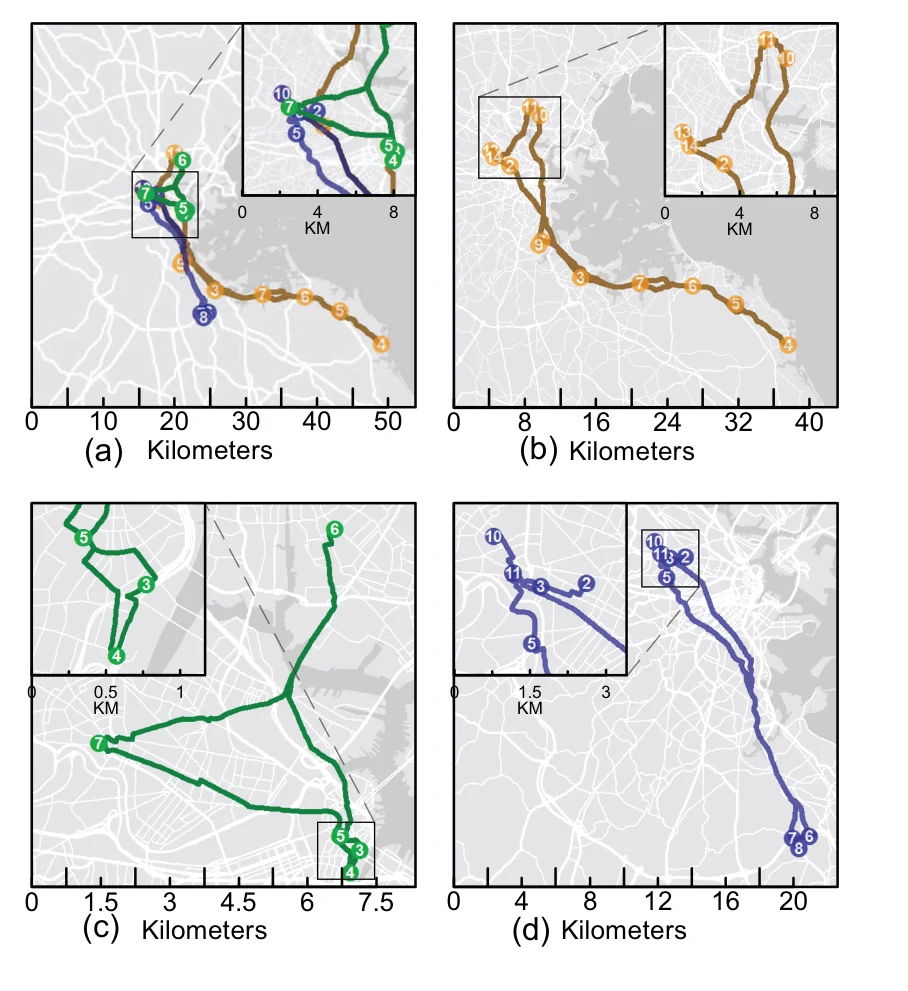
图 7|把同一个人的点按道路连起来,三天里重复的是哪一类位置?
路径经过停留、潜在停留和顺路点,三种颜色代表三天。点上的数字是手机记录里的先后顺序。(a)三天叠在一起,比例尺0到50公里,小图为0到8公里。(b)单独的一天,比例尺0到40公里,小图0到8公里。(c)另一天,比例尺0到7.5公里,小图0到1公里。(d)第三天,比例尺0到20公里,小图0到3公里。三天都回到住处及附近位置。来源:原论文 Fig. 5.1。
这张图的对象仍是图4的那一名用户。路径是在道路约束下把离散点连起来的近似路线。三天重复出现的是住处附近,这个观察停在一个人。拥堵路段上的车辆来自哪些居住地,属于被引用研究的结论,具体人数和比例没有印在本文。
这些结果能用到哪一步
停留区上的64%、0.59次方、−1.04次方和返回概率,说明200到300米的三角定位经过300米、10分钟的停留提取后,仍能看到基站尺度上那类统计规律。比较时要带着各自的分母:64%对的是先前研究的70%,0.59对的是0.6±0.02,−1.04对的是1.2。它们来自不同研究和不同空间单元,不能相减成同一批波士顿用户的前后变化。
17种模体覆盖90%以上所测量的日常出行,手机与37,023人的调查分布相近。这个90%位于频繁用户、去掉顺路和信号跳动、并且一天至少有7个半小时槽可辨认之后。10倍的灵活活动效应没有在本文重新估计。
活动类型有一张来自调查的条件概率表,还有一名用户的周六阅读。商业用地上最高的两类只差0.01,分别是工作0.23和购物0.22。多元logit尚未检验。道路使用有一套开源数据库方案和三天路径预览。两种停留提取谁更接近真实目的地,作者明确放到了别的研究里。
样本本身是2010年波士顿都市区、多家运营商合计约100万用户、两个月的计费记录。没有连续轨迹的人、记录不足的日子,以及调查里没有被抽到的家庭,都不自动进入相应的图。
一句话总结
三角定位手机数据可以把停留区上的探索、返回和高度集中的日常模体收回来,并与波士顿出行调查的模体分布对齐;混合用地上的活动目的,以及道路上的车流来源,在这篇文章里还没有被算成已经检验的结果。
核心来源
Shan Jiang、Gaston A. Fiore、Yingxiang Yang、Joseph Ferreira, Jr.、Emilio Frazzoli、Marta C. González,A Review of Urban Computing for Mobile Phone Traces: Current Methods, Challenges and Opportunities,UrbComp’13,2013年8月11–14日,芝加哥,ACM 978-1-4503-2331-4/13/08,10.1145/2505821.2505828。
手机记录为2010年波士顿都市区多家运营商的匿名三角定位。出行对照为2010/2011年马萨诸塞出行调查,土地利用为麻省地理信息系统数据。网格聚类的逐步算法、模体筛选的逐步过程、基站尺度的规律、17种模体的生成机制,以及拥堵道路的车流来源,分别指向文中引用的既有研究。致谢写明,研究得到BMW集团、奥地利技术研究所、麻省理工学院工程学院、麻省理工学院城市研究与规划系,以及新加坡国家研究基金会经由新加坡—麻省理工科研中心未来移动项目的部分资助。
Shan Jiang的署名单位是麻省理工学院城市研究与规划系。本文参考文献中的两篇2012年论文讨论城市日常活动聚类,以及从活动模式识别城市时空结构,合作者包括Joseph Ferreira与Marta C. González。
Gaston A. Fiore的署名单位是麻省理工学院航空航天系。
Yingxiang Yang的署名单位是麻省理工学院土木与环境工程系。
Joseph Ferreira, Jr.的署名单位是麻省理工学院城市研究与规划系,并与Jiang、González共同出现在上述2012年城市活动研究的署名中。
Emilio Frazzoli的署名单位是麻省理工学院航空航天系。
Marta C. González的署名单位是麻省理工学院土木与环境工程系。本文引用的个人移动规律、日常模体和道路使用研究中,有多篇署有她的名字。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果一个系统只按表1每一列里概率最高的活动给停留贴标签,居住用地会把0.70的调查活动标成居家,商业用地却只能把0.23标成工作,而且购物还有0.22。列最大值是“只用用地、总选最大类”时、在这张调查表内部的命中份额,不是论文训练过的模型准确率。它说明商业地块上的活动推断不能停在用地众数。论文把时刻和当天模体写进条件概率,正好对应这0.01的差距:工作和购物在商业用地上几乎打平,离开钟点和行程位置就无法分开。
模体分布还带着一个沉默的人。一天要有至少7个半小时槽能辨认位置,记录不够的日子进不了那90%。家又是用凌晨0点到6点最常出现的地点补上的,因为夜间通话少。把17种模体铺成全市全天的活动日程,会更像频繁使用手机的人日。很少打电话、但仍在通勤的人,不会因为都市区有19.35%的用户被记录过,就自动出现在模体图里。
64%和70%之间的差距也不适合直接写成“人们变得更不规律”。一个数是停留区上的周平均,另一个数来自基站尺度的先前研究。仪表盘若从基站论文改用300米停留区,百分比会动,即使出门习惯没有变。道路图也一样:三天都回到住处附近,只说明这一名用户的停留在重复。拥堵路段上的车来自哪些居住地,仍要单独计算来源份额,本文没有给出那个分母。