常住人口解释不了街区有多热闹,城市的标度从哪来?
论文名片|李睿琪、刘晨馨、尚璠、狄增如,系统科学视角下的城市建模与城市计算研究进展,电子科技大学学报,2022,51(5):786–799。DOI:10.12178/1001-0548.2022048。英文题为 Advances on Urban Modeling and Urban Computation: From a Perspective of Systems Science。综述,2022年9月出版;收稿日期2022年2月18日,修回日期2022年3月25日。
时代广场附近夜里留下的居民并不多。不同时段仍不断有人到来,这里仍是北美最活跃的地区之一。一张只登记常住人口的表,会把这种街区看成空地。霍华德的田园城市想用更简单、更静态的功能单元替换伦敦式的大城市,后面的城市规划受过这套构想影响。人聚在一起之后产生的动态和交互,没有进入那个替换方案。
这篇综述沿系统科学把已有证据串起来:城市要解释的是特定空间里的聚集和交互。活跃人口比居住人口、工作人口更接近交互强度。中心区活跃人口密度的幂律,被用来同时连接城市内部的空间分布,以及城市与城市之间的面积、产出标度。四条规则画出的曲线能贴上伦敦和北京的密度与累积量。这两张拟合图来自所引研究,综述没有另报样本量。曲线吻合仍留有边界:它还不是行政规划和个体出行已被证明的机制。
先说结论
- 建成区的分形指数落在 1 和 2 之间,城市生长没有把平面一次铺满。面积对人口的幂,已有实证大约从 0.56 排到 1.04;1971 年文献里的 2/3 只是其中一种结果。人口密度若随半径指数衰减,积分后的总人口仍随半径指数变化,得不出面积与人口的幂律。
- 城市越大,地区生产总值、专利、犯罪这类与人交互有关的总量,增长快于人口;户均水电、住房供给大体与人口同步;道路、光纤、下水管道的长度和加油站数量增长更慢。银行、餐馆、医院的标度指数约等于 1,按社会机会成本配置的公共设施约等于 2/3。综述把生产总值对人口的幂写成 1.15 左右,并转述另一项分解:非线性交互大约解释超线性标度的 60%,其余与受教育程度和专业技能的差别有关。
- 活跃人口是一整天在这块地上活动过的人的总和。大伦敦中心区被写成密度正比于距离的 −0.3 次方。图 3 的拟合更细:伦敦 β=0.296(sd. 0.011),北京插图 β=0.890(sd. 0.011)。
- 从中心向外累积时,大伦敦的活跃人口斜率标为 1.70(sd. 0.01),道路参照线 1.85,社会经济交互参照线 1.55。北京依次是 1.91(sd. 0.02)、1.95、1.85。中段贴近直线,靠近外缘会离开直线。
- 空间吸引、匹配增长、用泰森多边形近似路网、产出正比于人口密度与道路密度之积,这四条规则给出同一密度公式。把积分上限从某个距离换成城市半径,城内曲线和城际总量标度可以放进一个框架。吻合的是所引研究里的伦敦和北京,综述没有新的样本表。
城市要抓住的是谁在这里相遇
城市同时有自上而下的规划和自下而上的自组织。有的城从村落长出来,有的城按总图建造。城墙和护城河的防御作用减弱以后,通信、电力、公交和地铁这些网络仍在长,为的是让人更容易相遇。邻近城市在经济和人流上连成更大的整体之后,按一座城画边界也会越来越不够用。
综述转述两项已有估计:全球超过 80% 的财富、超过 90% 的创新成果源于城市。分母是这两份报告里的全球财富和创新成果,出处分别是麦肯锡 2011 和布鲁金斯 2013,不是本文重新加总。快速城市化也伴随着犯罪、流行病、拥堵和环境破坏。一百多年前的大城市病已经存在。简·雅各布斯在二十世纪六十年代强调城市的动态、多样性和人类交互的物理约束;同一时期的阿隆索—米尔斯—穆特地租模型则解释地租和空间形态。两边都在看城市,系统科学要补上的是结构和功能怎样互相推动。
分形和指数密度,为什么对不上城市有多大
建成区有分形结构,分形指数介于 1 和 2。指数随人口规模增大,垂直方向的生长也被写成具有分形特征。一种过程解释是集聚和扩散一起作用:城市先沿道路或资源廊道长,再把廊道之间的空隙填上,分形指数因而变大。扩散限制凝聚可以生成分形聚集体,但通常只得到一个大连通体,现实中的多片城区它解释不了。关联渗流加上指数型人口分布,能得到更接近现实的形态、分形,以及社区密度随到中心距离指数衰减。道路模型则让未建成道路沿最近两个建成区的合力方向生长,两边相反时分叉。这些模型把指数或幂律人口密度当作输入。密度本身如何分布,仍然是另一场争论。
克拉克 1951 年的大量实证把居住人口密度写成从中心到边缘的指数衰减。芝加哥、克利夫兰、利物浦、墨尔本并不完美:中心密度低于指数曲线的预测,形态像一个倒勾。后来的研究指出,把离中心更远的区域放进分析后,幂律拟合更好;也有理论认为,只有幂律密度才能同时保住分形和面积—人口的亚线性异速关系。面积与人口的幂律早在 1971 年被写成面积正比于人口的 2/3 次方。若密度随半径指数下降,积分得到的总人口仍是半径的指数函数。面积大约随半径的平方增长,于是人口与面积之间得不出幂律。关联渗流能重现分形,却仍解释不了这条异速关系。后续实证里,面积对人口的指数也不总是 2/3,已有结果大约落在 0.56 到 1.04,其中有接近线性的案例。区间来自多篇文献的汇总,不是这篇综述新做的一次回归。争论落到城市边界怎样划定。
排序、引力和三类标度,各管哪一种比较
单个城市内部的形态之外,城市系统还有跨城规律。把美国城市按人口排序,双对数坐标上接近幂律,幂指数接近 −1:最大城市大约是第二大的两倍、第三大的三倍。全球自然城市的研究被用来继续检验这种齐普夫律。词频里的齐普夫分布更常被提起;城市和文献不是同一个系统,排序形式却可以同样稳定。
城市内部也有一条按小时看的齐普夫律。工作时段人堆在商业区和办公地点,休闲时段堆在商场和娱乐场所,夜间堆在居住区,最热的地点一直在换。每个时段把地点按人口排序,头部仍遵循齐普夫律,不同时段的曲线还很一致。地点在换,排序曲线的形状保持。这篇综述没有给出城市内部这条曲线的具体幂指数。
地点之间的交通流量也被写成引力模型:流量正比于两地人口的幂,并反比于距离的幂或距离的指数函数。数百米到数千米的尺度上都适用,人口相关的幂指数和距离相关的幂指数随尺度有相近的变化。城际、国际的流量同样常服从引力模型。综述把这种简洁形式读成统一机制存在的迹象。形式相似还没有证明各尺度共用同一个机制。
跨城市的宏观标度把变量分成三类。地区生产总值、工资总收入、专利、犯罪,以及风险投资的项目数和资金量,相对人口超线性增长,标度指数 γ 大于 1,现象越复杂指数往往越大。户均水电、住房供给这类按人摊的需求,γ 大约等于 1。道路、光纤、下水管道总长度和加油站数量,γ 小于 1。商业设施和公共设施还要再分开:银行、餐馆、医院接近线性,γ 约等于 1;公共设施约等于 2/3。转述的机制是,利润设施把覆盖人口铺得更匀,以减少同类竞争;公共设施则把个人到设施的出行距离压小。这是选址目标的解释,这篇综述没有重新识别因果。
人有 N 个时,两两不同的交互在理论上最多有 N² 种。技术条件和每个人有限的处理能力使这个上限到不了。综述用这个上限定性地理解,为什么生产总值对人口的幂次是 1.15 左右,而不是 2。1.15 是在这一框架下被解释的已有幂次,正文没有附上新的回归。按消耗和收益,同一框架还能讨论城市规模是否相对优化。它依赖层级化分形网络、人口均匀混合、网络增量增长、人类努力有界、产出正比于交互数量等假设,参数多,而且是某一个时点上的静态模型。均匀混合与真实的空间分布差得远,技术一变,下一时段的最优也不再是上一时段的最优。
另一路解释从经济复杂性和文化演化出发:越复杂的现象,流行程度越低,标度指数越大,方差也越大,因为构成要素更多,大城市更容易同时满足。还有一项研究把超线性标度拆开:过去文献所说的非线性交互大约解释其中 60%,其余对应不同规模城市里受教育程度和专业技能的差别,大城市聚集了更多受教育程度和认知能力较高的居民。60% 的分母是超线性标度里被归因的部分,不是城市个数。这些仍是宏观模型,重现不了要素在城市内部的空间分布。扩散限制凝聚和关联渗流则是二维表面生长,能模拟形态,给不出人口密度和其他要素的具体分布。
活跃人口沿半径怎样分布,和夜光比差在哪里
手机信令、兴趣点、公交地铁刷卡、出租汽车卫星定位、人口统计、夜光、开放街道图、共享单车、媒体、手机应用、信用卡和简历,都在被用来感知城市。手机记录常被看成质量较高的一类:即使在发展中国家,普及率也高于许多社交媒体,使用人群的偏向较小,而且是被动采集。一条记录通常只是匿名标识、基站位置和时间。许多人、许多周的记录叠在一起,可以估计居住与工作的分布、通勤需求、交互模式和城市节律。基站流量平衡会把静止的人记到更远的空闲基站上,轨迹里出现假跳跃;人不使用服务时的移动会漏掉;原始记录不标明家里、工作地还是消费场所。这些限制说明感知并不完整。
居住人口和工作人口各自只覆盖一天里的一段。动态活跃人口把特定空间上、全天在此活跃的人都加进去。普查数据可得时,可以把居住人口和工作人口按各自在该地的大致活跃时间加权,作为近似。综述没有给出居住和工作各占多少小时。时代广场被用来说明这个差别:估计这里的人类交互时,居住人口会偏低,活跃人口更合适。雅各布斯的判断也被接上来:活跃人口还可以被当作安全、经济前景和街区吸引力的参照。那是概念上的延伸,图 1 直接画出的是大伦敦的密度。
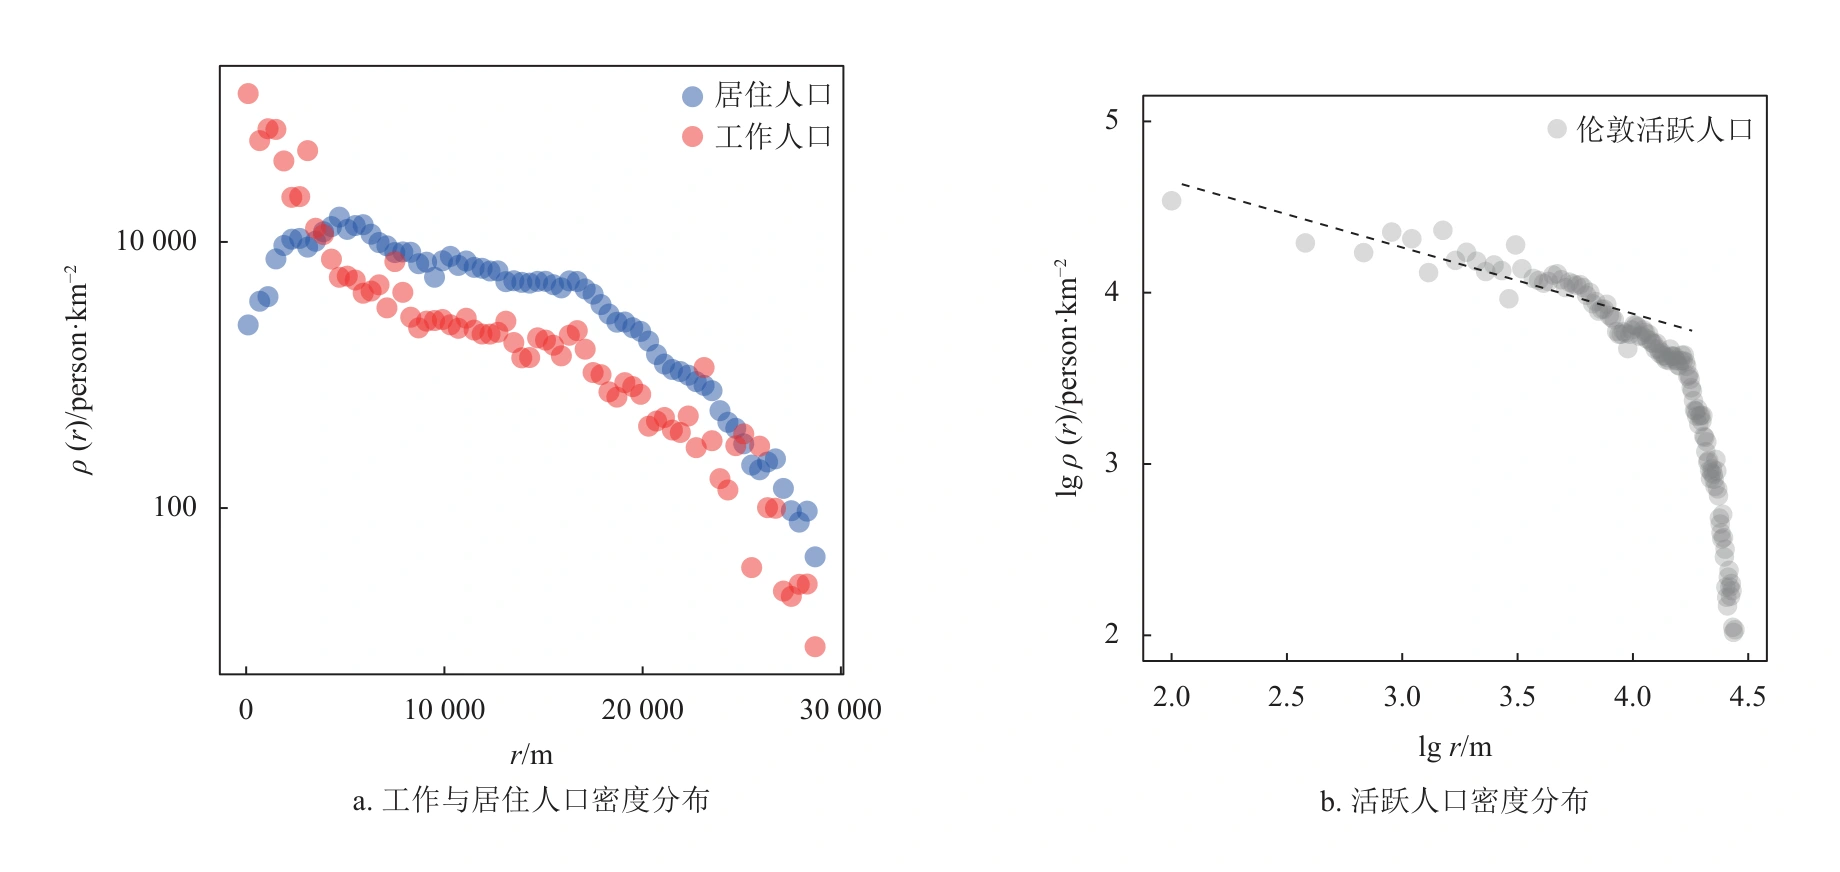
图 1|离开中心以后,居住、工作和活跃人口的密度各走哪条曲线?
(a)大伦敦的居住人口为蓝色,工作人口为红色。横轴是到中心的距离,标到 30 000 米;纵轴是人口密度,标出 100 和 10 000 人每平方千米,刻度按数量级拉开。中心处工作人口高于 10 000 这条刻度,居住人口低于它;向外居住人口先升到这条刻度附近,工作人口则降到它下面,更远处两者都降向百人量级。(b)灰色点是伦敦活跃人口密度的常用对数,横轴是距离的常用对数,从 2.0 到 4.5,即约 100 米到 3.2 万米。虚线贴着中心一段下降,正文把这段写成正比于距离的 −0.3 次方;大约在横轴 4 之后,点离开虚线并迅速下落。这一幅没有印出拟合标准差。来源:原论文图 1。
−0.3 次方若能代表中心区,指数密度和面积—人口幂律之间的冲突就有一条出路:中心段用幂律密度,对半径积分可以接上面积与人口的幂,而纯粹的指数密度做不到。图 1 的外缘下跌也说明,一条幂律不能铺到城市最边上。更细的 β 留在图 3。
夜光与区域经济的相关,在国家和州的大尺度上被反复看到。活跃人口被用来在更细的格子上估计社会经济强度。按文献中的交互框架,交互数量由活跃人口估计,图上横轴是活跃人口的 1.5 次方再取对数,纵轴是夜光的对数。用地类型仍会影响估计。活跃人口规模较大时,交互强度通常更高。
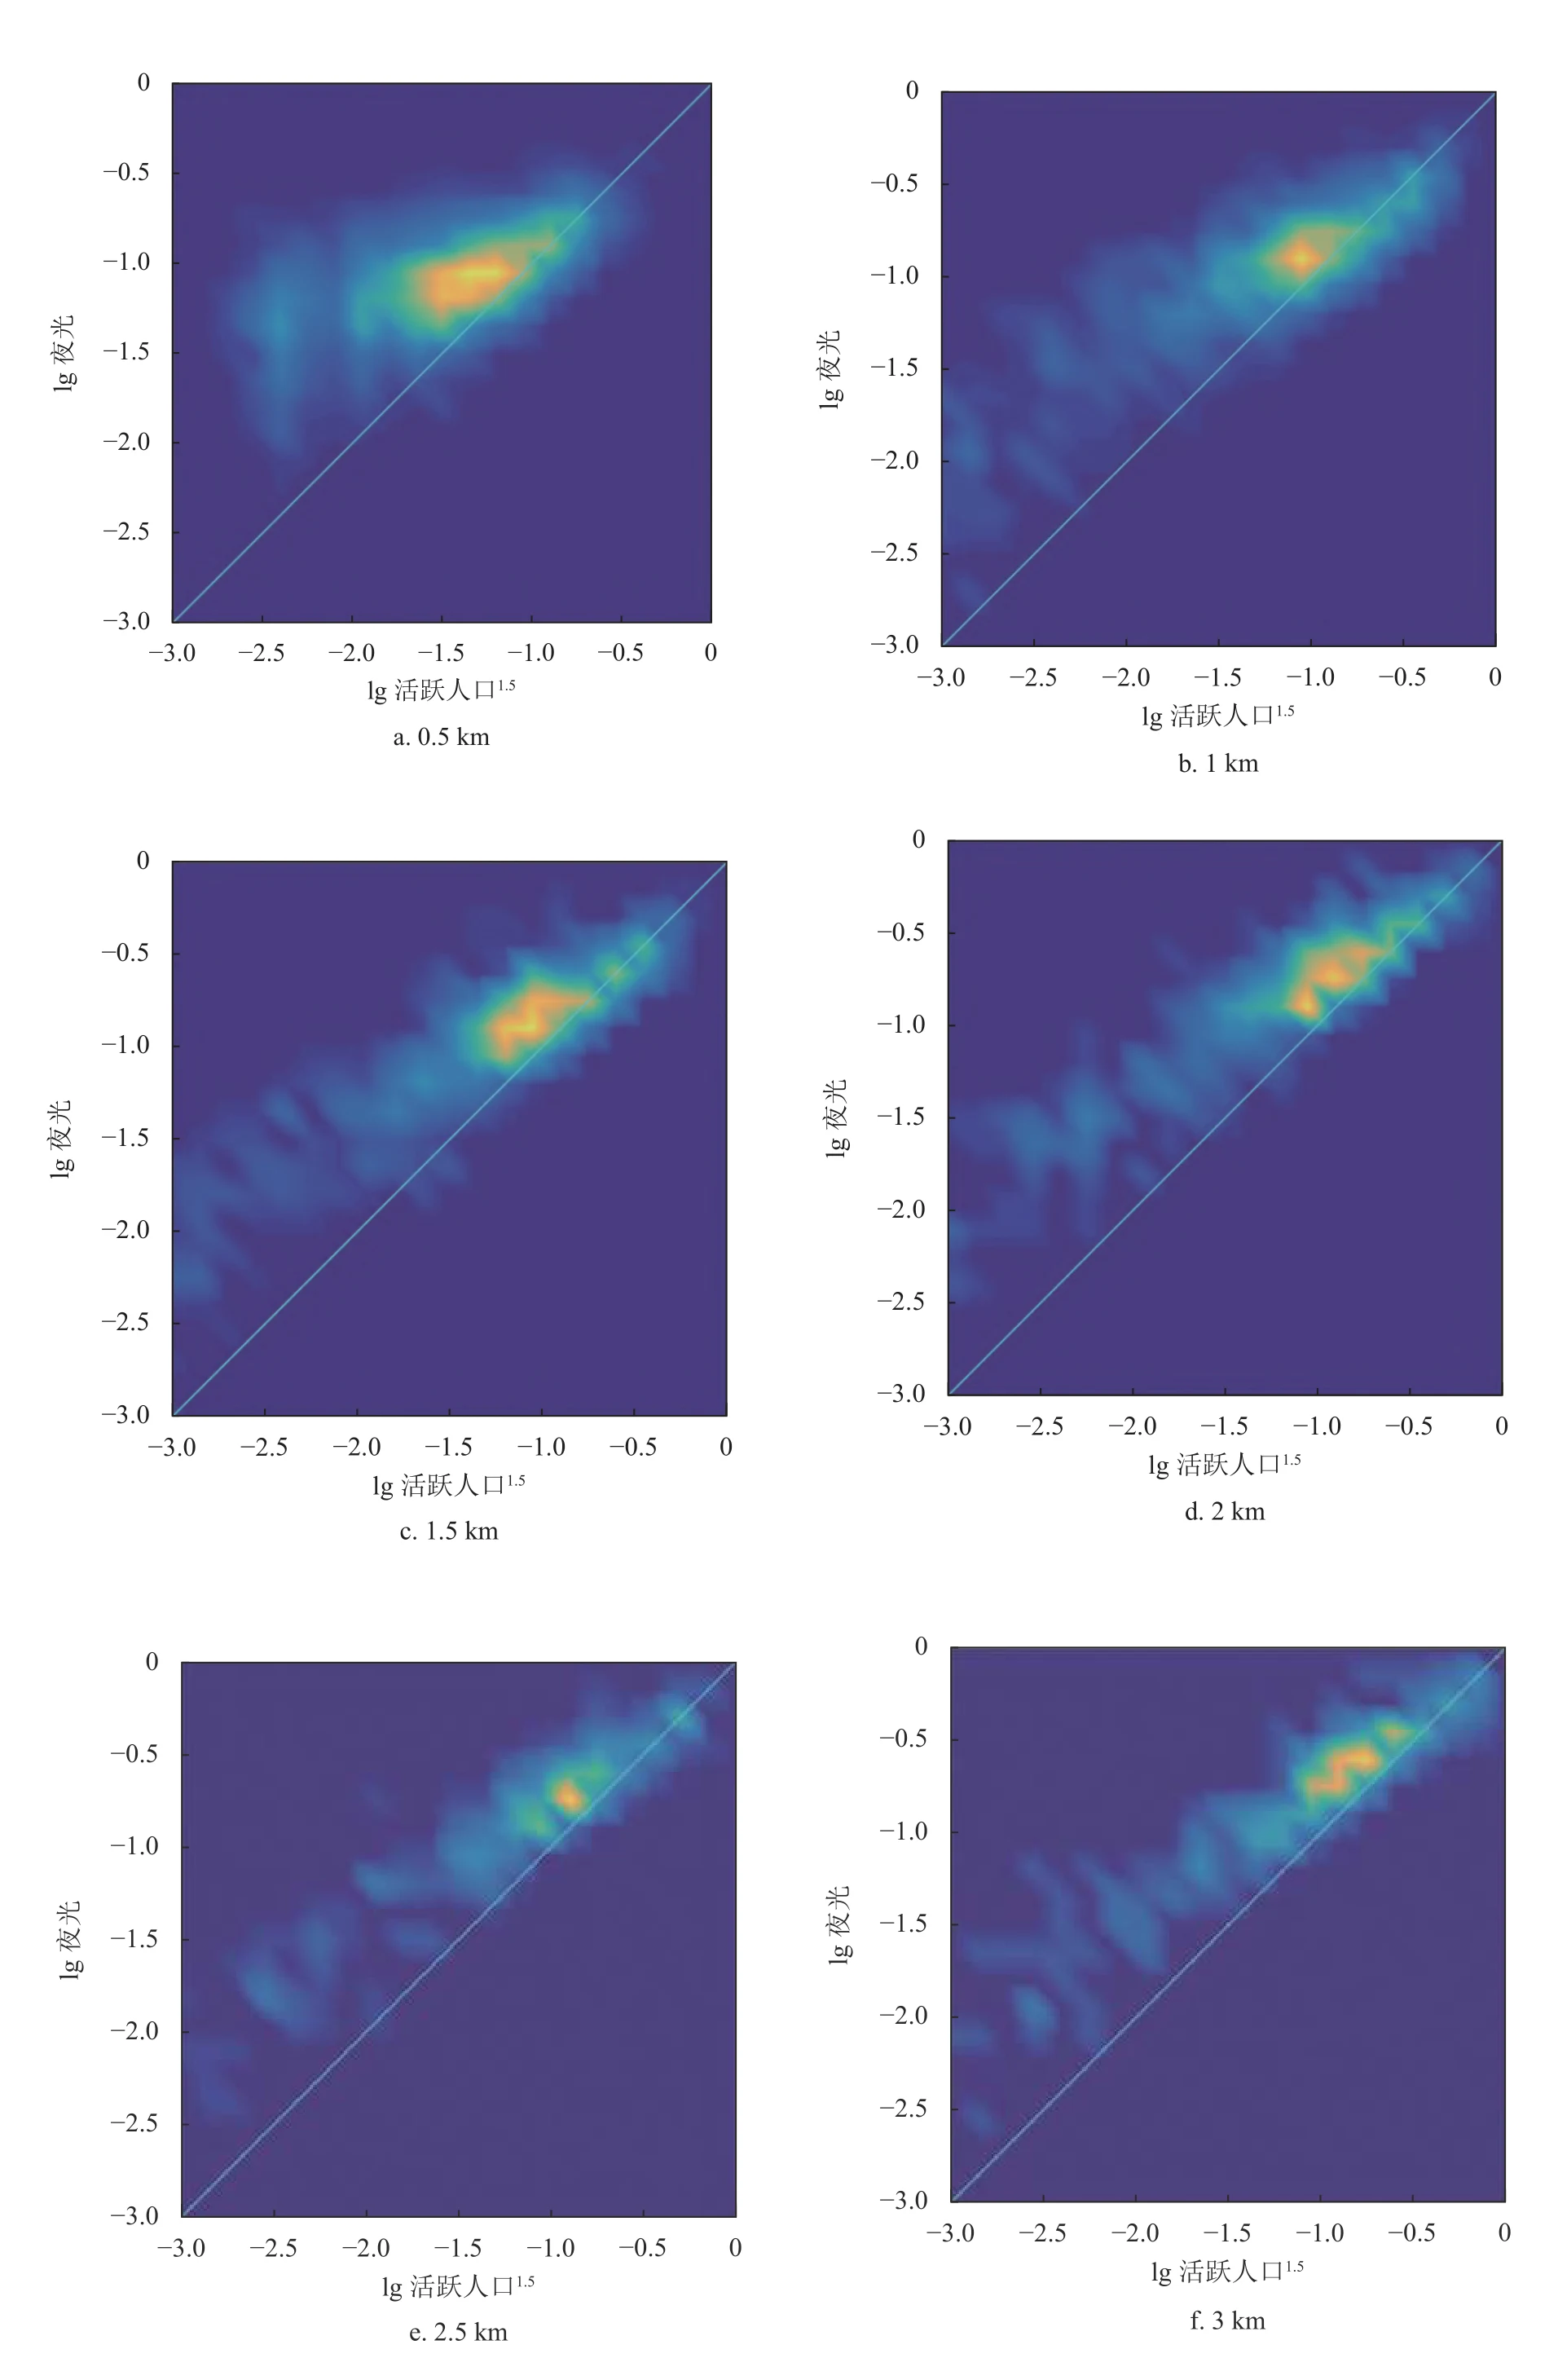
图 2|格子放大以后,活跃人口估计的交互和夜光还贴得多紧?
六幅的横轴都是活跃人口 1.5 次方的常用对数,从 −3 到 0;纵轴都是夜光的常用对数,从 −3 到 0。浅色对角线是参照。黄绿色表示地块更集中,蓝色更稀,图旁没有色标计数。(a)0.5 千米,云团最散,横轴偏左、活跃人口较低的一侧离开对角线更明显。(b)1 千米。(c)1.5 千米。(d)2 千米。(e)2.5 千米。(f)3 千米。从(a)到(f),高值核心总体更靠近对角线,低值一侧的拖尾一直还在。正文把低密度处的偏离归到郊外道路:人很少,路和灯不一定少。尺度变大后差异缩小。1 平方千米被写成还保得住空间精度、偏差又已经缩小的一档。图上没有相关系数或误差表,不能把“很高的相关性”读成一个具体的决定系数。来源:原论文图 2。
微博在线人数、城市间关注和简历推断的人才流动,可以写得更细。机制模型要压缩变量时,人口仍被当作第一驱动力。夜光因此是交互的替代量,低密度处尤其不能单独当成经济强度。
四条规则怎样同时画出城内和城际
在活跃人口之上,文献 [24] 用四条规则建立个体交互的生长模型,目标是同时重现跨城市宏观标度、城市内部空间标度、人口分布,以及人口、道路、夜光之间的关系。
新来的人选择地块时,吸引力正比于当地社会吸引与自然禀赋之和。社会吸引用活跃人口密度表示,自然禀赋用参数 C 表示。城市还受空间和稀缺资源限制:新点离已有城区太远,连接成本高,古代场景下也不安全。没能和现有城市匹配上的点被移除。路网用泰森多边形作粗略近似,许多关键统计量与真实路网贴合,几何细节并不逐条重现。社会经济产出正比于交互数量;模型假定交互发生在沿街空间,因为商场和写字楼多沿街建造,于是当地产出 g 正比于人口密度 ρ 与道路密度 l 的乘积。在这个比较里,活跃人口比居住人口或工作人口更接近当地交互数量。沿街假定是模型设定,不能读成人们只在路上发生交互。
按动态生长写下去,距离中心 r 处、时间步 t 的环形密度是
ρ(r, t) 正比于 r 的 −β 次方,再乘以(当时城市半径 R 的 1+β 次方,减去 r 的 1+β 次方)。
r 远小于半径时,括号里的差变化较慢,密度近似正比于 r 的 −β 次方。r 接近半径时,这个差趋向于 0,密度会更快下降。
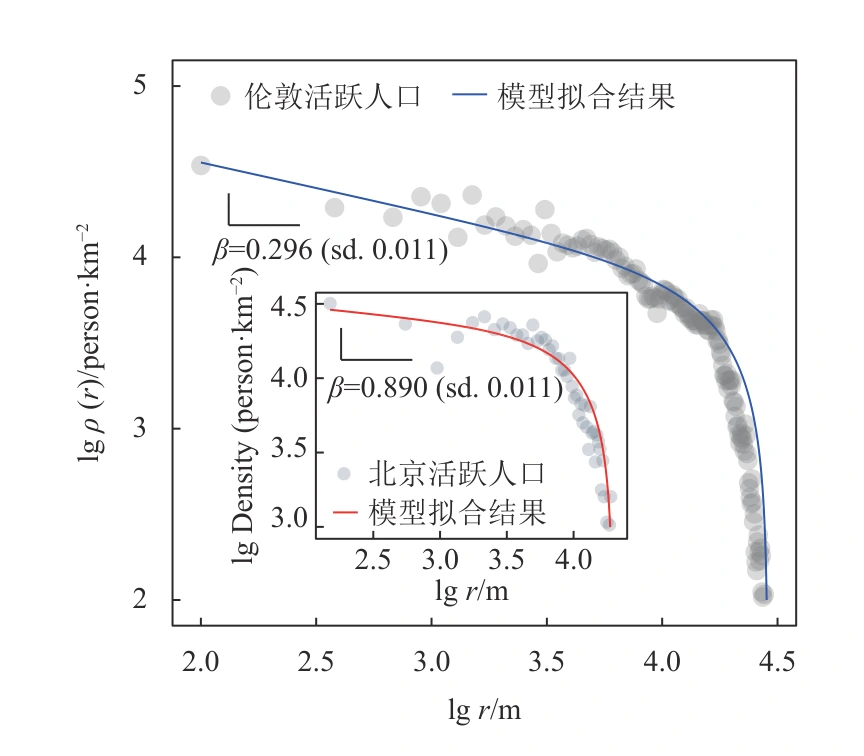
图 3|同一套密度公式,伦敦和北京衰减得一样陡吗?
主图是伦敦,灰色点为活跃人口密度,蓝色曲线为模型拟合,β=0.296(sd. 0.011)。纵轴是密度的常用对数,单位人每平方千米;横轴是距离的常用对数,标到 4.5。插图是北京,红色曲线,β=0.890(sd. 0.011),横轴大约从 2.5 标到 4.0,纵轴写成密度的对数。两城都是中段缓慢下降、靠近右端骤降。0.890 约为 0.296 的 3.0 倍,这是两个印刷数值相除,图上没有单独标出倍数,综述也没有做两城差异的假设检验。sd. 是拟合给出的标准差,正文没有写环带数、距离范围或决定系数。来源:原论文图 3,图注标明引自文献 [24]。
正文另把大伦敦中心区写成 −0.3 次方。0.296 是图 3 上更细的拟合,−0.3 是文字里的约数。外缘骤降对应完整公式里半径那一项,不能把中心段的幂律外推到城市边界之外。
对活跃人口做积分,得到道路、人口和交互这些要素随距离累积的空间标度指数。图中实线是理论预测,散点是观测值。
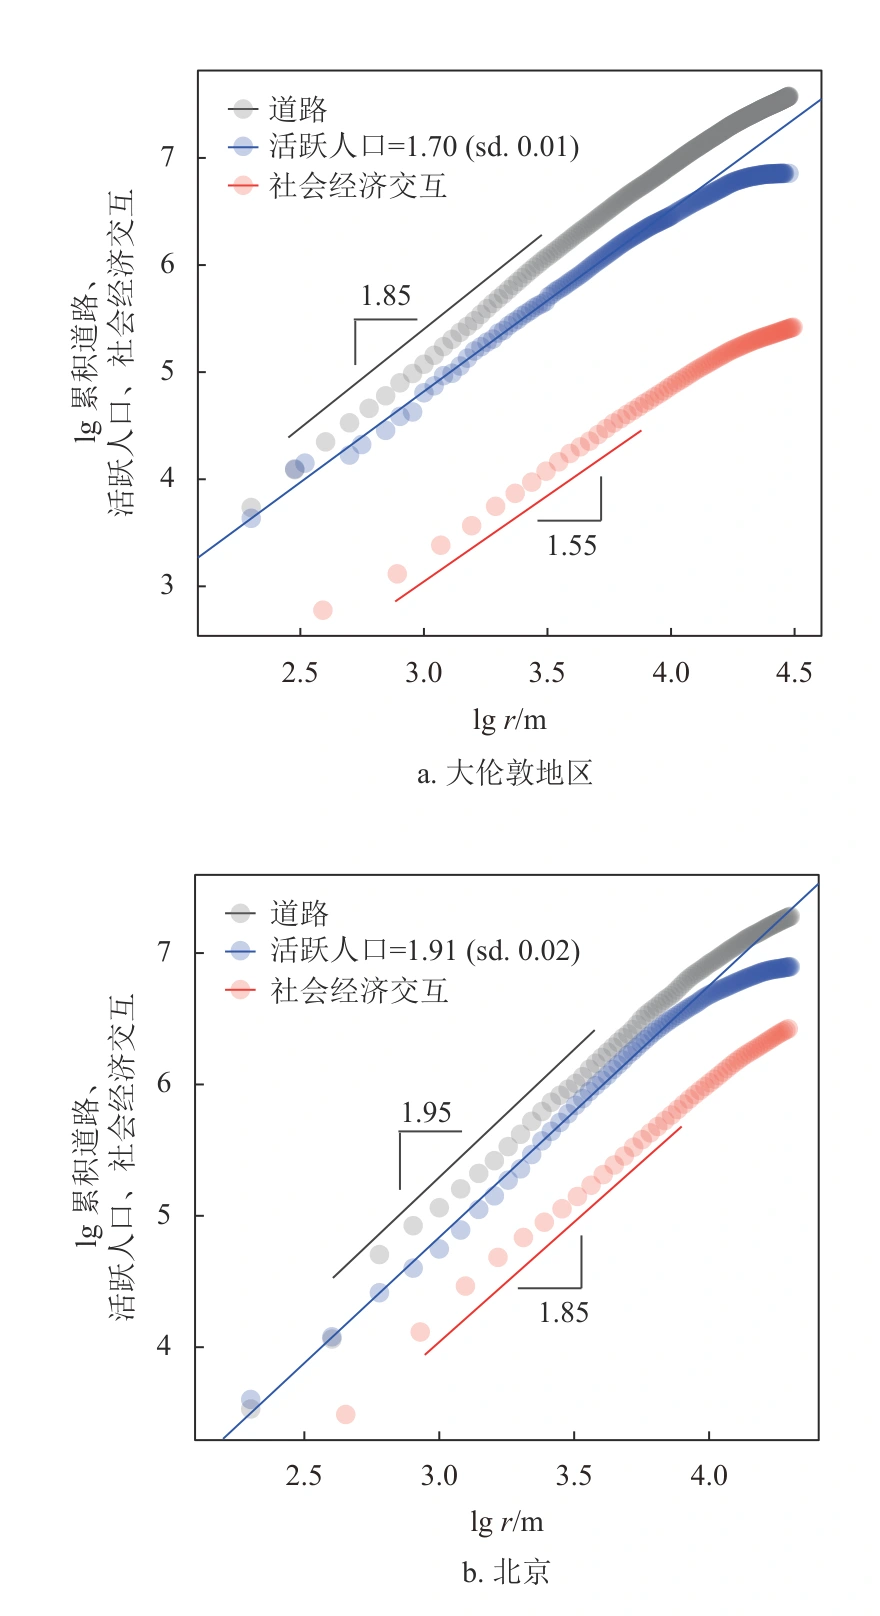
图 4|累积到某个半径时,路、人和交互的斜率是否相同?
纵轴是累积道路、累积活跃人口和累积社会经济交互的常用对数,横轴是距离的常用对数。灰色为道路,蓝色为活跃人口,红色为社会经济交互。直线是中段参照,圆点在更远处逐渐离开直线。(a)大伦敦:活跃人口标为 1.70(sd. 0.01),道路参照线 1.85,社会经济交互参照线 1.55。相对活跃人口这条 1.70,道路高 0.15,交互低 0.15。(b)北京:活跃人口标为 1.91(sd. 0.02),道路 1.95,交互 1.85。三者只差 0.04 和 0.06。道路和交互的数字没有标准差,北京这三条不能据此宣布统计上彼此不同。两座城市都是道路斜率高于活跃人口、交互斜率低于活跃人口。来源:原论文图 4,图注标明引自文献 [24]。
把积分上限从某个距离换成整个城市半径,得到要素总量,再把人口关系代入,就得到要素与人口之间的标度。生长过程因此同时对着两张表:城内的累积曲线,城与城之间的总量幂律。模型简单,综述说它还能讨论房价分布和平均地租的宏观标度。那些指数没有印在这篇正文里。解析依据的是生长,不是静态的全局平均场和均衡态。
动态活跃人口还被联系到照明与能耗、充电桩排布、异常聚集和疏散。这些是应用前景:全天人流估计得更准时,能源需求和应急才有更合适的参照。这篇综述没有给出照明节能量或充电桩数量。
人口权重效率把出行需求分布和道路网络放在一起。综述说,用它估计平均通勤时长,拟合优于交通里常用的过剩通勤,还能标出低效道路,并可用于城际路网。共享单车的流量、绕行指数和标度关系,被用来预测路径上的机动车拥堵。两处都只有方向,没有印出拟合优度或预测误差。
同一时间出现在同一地点的人,可以连成一张随时间变化的交互网络。把相邻时段叠加,再用社团划分去看内部连接更密的一群人,城市会在活跃与睡眠之间切换:活跃时人聚进少数大社团,睡眠时散在更多小社团。城市越大,睡眠越短,活跃越长。这与标度研究里大城市生活节奏更快的结论互补,不是同一次测量。大城市里个体交互更容易到达其他角落,小城市里更多停在居住地附近。综述没有给出社团人数或睡眠小时数。
人均交互还会随城市规模超线性变强,密度和聚集程度会改变个体相遇的频繁程度。流行病如何展开,因此不只有城际流动这一层。正文没有进入具体传播模型。
个体移动和规划,还留在这四条规则外面
上面的生长模型没有把个体移动明确写进去。移动本身分市内、城际和国际。多数研究只做一个尺度。目的地选择博弈把个体交互,以及拥挤对目的地收益的影响放进选择:三种尺度上的移动都能被这套比较讨论;若忽略拥挤,它又能为引力模型提供一种解释。另一项工作用移动轨迹的层级和移动能级解释跨尺度移动,并处理无标度距离分布与楼宇、街区、街道这些有意义尺度之间的矛盾。较强的社会交互,加上个体移动的长程记忆,被写成城市分形形态和城市生长的两个机制。这些是所引模型的结论,不是四条规则已经含有的项,也没有在本文里重新拟合。
地理距离也会漏掉联系。人才流动构成的网络上,高新技术产业的空间溢出可以比直线距离、边界接壤长度更清楚。北京和上海相隔数千里,高铁和航空使两城交互远强于北京和张家口某个小山村;后者的空间距离只有百余公里。短的直线距离并不对应更强的交互。
许多数据驱动模型强调自组织。行政力量的周期和影响不同,综述举了拿破仑时代奥斯曼对巴黎的改造,以及亚历山大城的建立,并说明这一层还有待研究。不少模型把人口增长写成从外部给定。放在更大的系统里,连跨国迁移也仍是系统内部的移动。单座城市的生长轨迹会偏离标度律的预测,一种可能是多个城市互相耦合。把出生、死亡和城际迁移放进多城市共演化,是综述提出的下一步,不是已经完成的估计。城市生长也不只是用地扩张。供水、食品和物流这些网络同样在长。设计若不符合人类活动的约束,就会停留在构想。自动驾驶普及之后停车空间可以改作居住和交互,是文末对未来形态的设想,不是文中的观测。
能够站住的范围因此比较窄。活跃人口比常住名册更接近交互;伦敦和北京的密度与累积曲线,可以用同一套带边界项的幂律和四条规则一起描述。分形指数、0.56 到 1.04 的面积指数、1.15 左右的生产总值幂次、60% 的交互分解,都是转述。图 3 和图 4 的吻合来自文献 [24],没有新的样本量,也没有决定系数。泰森多边形不是真实路网,沿街交互不是调查结论,均匀混合的静态标度模型给不出这里的空间曲线。单城轨迹、规划周期和城际人口流动,仍在这套规则之外。
一句话总结
街区有多热闹,要看全天在这里活动并相遇的人;把活跃人口密度写成随距离变化的幂律再按半径积分,城内的累积曲线和城际的总量标度可以接到一起,边界划分、规划力量和城市之间的人口流动还没有被一起解释。
核心来源
- 李睿琪、刘晨馨、尚璠、狄增如,系统科学视角下的城市建模与城市计算研究进展,电子科技大学学报,2022,51(5):786–799。DOI:10.12178/1001-0548.2022048。
- 图 3、图 4 的图注标明引自 LI R、DONG L、ZHANG J 等,Simple spatial scaling rules behind complex cities,Nature Communications,2017,8:1841。图 1 的 −0.3 次方在正文中同样归到这项研究及另一篇会议论文。图 2 印在本篇正文中,没有单独的图注出处。
- 生产总值幂次 1.15 左右,出现在综述讨论文献 [21] 的段落中:Bettencourt,The origins of scaling in cities,Science,2013,340(6139):1438–1441。超线性标度的 60% 转述自文献 [23]:Keuschnigg、Mutgan、Hedström,Urban scaling and the regional divide,Science Advances,2019,5:eaav0042。面积指数 0.56~1.04 由综述综合文献 [21, 42–44] 给出。这三组都不是本文新回归。
作者介绍
四位作者的身份以论文署名为准。只有李睿琪在作者简介中有进一步说明。
- 李睿琪:北京化工大学信息科学与技术学院。作者简介写明,1992 年生,博士、副教授,从事城市建模与分析、复杂网络和计算社会科学研究。
- 刘晨馨:署名北京化工大学信息科学与技术学院。论文没有另附个人简介。
- 尚璠:署名北京化工大学信息科学与技术学院。论文没有另附个人简介。
- 狄增如:通信作者,署名北京师范大学系统科学学院,以及北京师范大学珠海校区复杂系统国际科学中心。论文给出的邮箱是 zdi@bnu.edu.cn,没有另附头衔或履历。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若商店和公交仍按夜间居住人口配给,白天极密、夜里很空的街区会被系统性低估。可以在同一套格网上比较两种人口对夜光或零售额的误差。图 2 只展示了活跃人口 1.5 次方和夜光是否靠近对角线,没有给出居住人口在同样格子上的误差比。少了这个对照,就还不知道活跃人口到底修正了多少配给偏差。
匹配增长会删掉离现有城区太远的新点。先通轨道、后才有密度的新城,正好落在这条规则要删除的位置。如果这类新城后来留下,并长出自己的密度曲线,缺的就不是另一个 β,而是一条允许外部连接先于本地密度的规则。伦敦 0.296 和北京 0.890 也提醒同一件事:函数同为幂律时,衰减仍可以差到大约三倍。把一座城中心段大约 −0.3 的斜率直接画到另一座城的服务圈上,高密度核心的半径会对错一截。跨城使用这条曲线之前,至少要先看 β 是否接近。