发信、上网和出门,为什么都是一阵密集,然后长时间空白?
论文名片|樊超、郭进利、韩筱璞、汪秉宏,《人类行为动力学研究综述》,复杂系统与复杂性科学,2011,8(2):1–17,2011年6月出版。英文题名 A Review of Research on Human Dynamics。文章编号 1672-3813(2011)02-0001-17,收稿日期 2010-07-27。这是一篇综述,归纳已有实证和模型。
一个人可以在二十分钟里回完一批消息,然后两天不再打开对话框。若做事像泊松过程那样均匀落下,这种又密又空的节奏应当少见。通信、网页和工作记录却反复出现长长的空白,空白之间夹着一阵密集活动。这篇综述要看的是:这种节奏在书信、上网、工作、身体动作和出门移动里是否站得住,幂指数是不是同一个数,以及排队、兴趣和作息能否各自把重尾造出来。
方向先说清楚。重尾在很多行为里都出现了,指数却散在一个区间中。一个人身上的幂律,叠到成百上千个对象之后会弯掉。同一条拖长的尾巴,至少有优先权队列、兴趣衰减和带周期的级联泊松过程三套机制能够产生,所以只看到重尾,还指认不了原因。
先说结论
- 通信、网页、工作和生理活动的间隔时间常常偏离泊松过程,综述把已有研究里的幂指数归纳在 1 到 3。这是多篇研究合在一起的范围,分母不是同一次抽样。
- 书信记录中,达尔文、爱因斯坦、弗洛伊德、鲁迅 4 人的幂指数为 1.5,钱学森为 2.1,分母是这 5 位通信者。电子邮件的发送间隔和回复时间指数为 1。短信在个体层面为 1 到 3。在线电影点播的间隔指数为 2.08;用户按活跃性分成 20 组后,组内指数随平均活跃性升高,图上大约从 1.5 升到 2.7。
- 电子支票的移动距离按指数 1.6 的幂律衰减,支票本身会在不同人之间传递。手机用户的移动距离和活动半径服从带指数截断的幂律;回到某地的概率在 24 小时、48 小时、72 小时出现峰值。综述转述的位置预测准确率高达 93%,活动半径超过 10 公里后这一概率趋于平稳。
- 对一家供应商下单时,间隔可以是幂律;把数千家供应商的订单合在一起,分布变成指数项和幂律项的混合。物流各环节的幂指数落在 1.2 到 2.6,其中一张图的引导线标为 −2.50。
- 优先权队列在队长固定时给出等待时间指数 1,队长可变时给出 1.5。兴趣模型可以给出 1,也可以给出随参数连续变化的指数。带昼夜周期的级联泊松过程同样可以造出重尾。分布形状本身不等于机制已经确定。
均匀落下的钟,为什么盖不住这些空白?
过去估算电话占线、车流或零售补货时,常用齐次泊松过程:间隔服从负指数,一段时间内的事件数服从泊松分布。很长的静默和很短的爆发都被当成可以忽略的起伏。
巴拉巴西(Barabási)对电子邮件和传统信件的分析把这个简化打开了。阵发(burst)指一件事在短时间里反复出现,随后又长时间消失。重尾(heavy tail)在这篇综述里用得很宽:明显偏离泊松、尾巴拖得很长的分布都算进去,包括纯粹的幂律,也包括幂律再接一段指数的混合形状。严格的重尾要求分布没有指数阶矩;混合形状不一定满足这一条。读后文的“重尾”时,要按综述自己的宽口径理解。
幂律密度写成 f(x) = C x^{−α},α 是幂指数。它没有一个代表性的尺度:把 x 的单位乘上常数 b,分布形状只差一个与 x 无关的倍数。双对数坐标上,它接近一条斜率为 −α 的直线。真实数据很少在整个范围里都是幂律,小端会在某个 xmin 以下偏离。综述因此常说“尾巴服从幂律”。
用双对数最小二乘去拟合这条直线,得到的指数可能和真实值差一截。综述推荐的极大似然估计是
α̂ = 1 + n × (Σᵢ ln(xᵢ / xₘᵢₙ))⁻¹,
标准差 σ = (α̂ − 1) / √n,
再配合 Kolmogorov–Smirnov 检验。这里的 n 是纳入拟合、且不小于 xmin 的观测个数。数据很少时,尾部会乱跳。若密度是幂律,累积分布 P(X ≥ x) 也是幂律,指数比密度的 α 小 1。累积分布用上全部数据点,也不必先选定装箱宽度。后文有的图是密度,有的图是累积,两类指数不能直接并排比较。
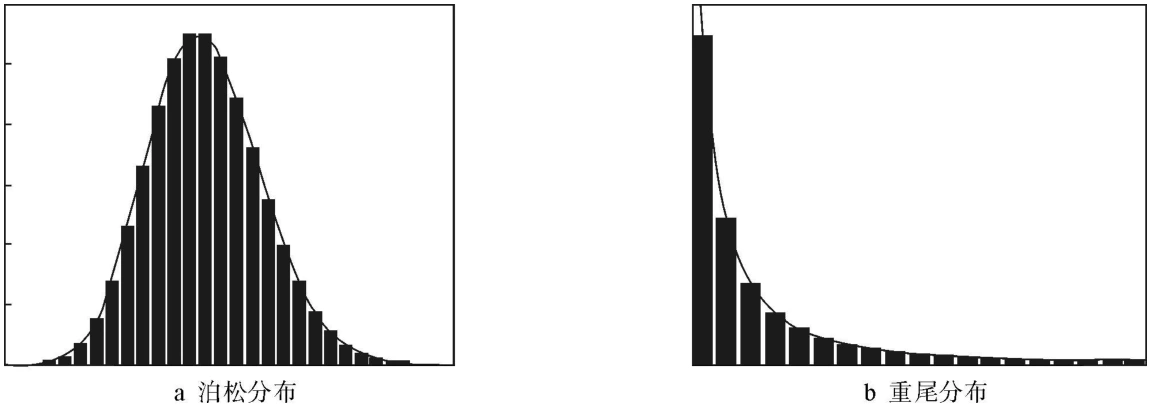
图 1|同样叫“分布”,均匀的钟和拖尾的钟长什么样?
(a)泊松分布,中间高、两侧很快落下。(b)重尾分布,概率堆在很小的取值上,右侧留着一条下降很慢的尾巴。两幅都是形状示意,没有样本量和坐标单位。来源:原论文图1。
图 2 把这个差别放进一串事件。两套序列都是 1 000 个连续事件,重尾那一套的平均间隔被画成与泊松那一套相同。均值一样,节奏完全不同。
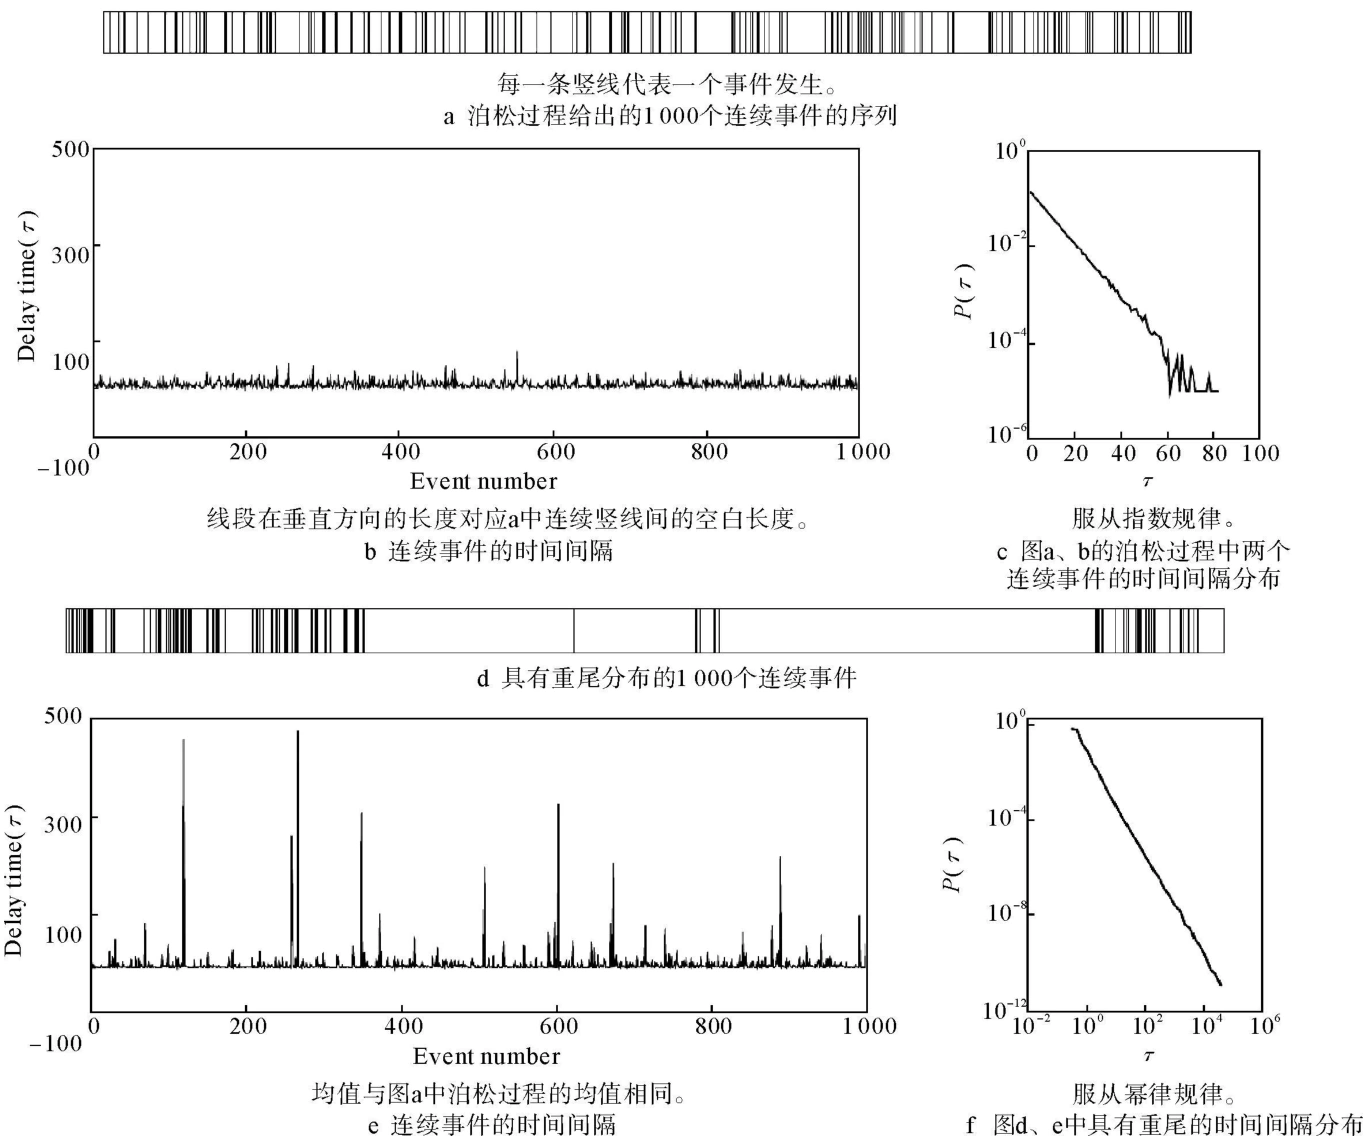
图 2|平均间隔相同的两串事件,为什么一个均匀、一个阵发?
(a)泊松过程的 1 000 个事件,竖线较匀地排开。(b)这些事件的间隔,纵轴是等待下一次的时间,横轴是事件序号 0 到 1 000;间隔在一条水平带附近小幅跳动。竖线长度对应(a)里两道竖线之间的空白。(c)(a)(b)的间隔分布,图中写明服从指数规律,半对数上很快掉下去。(d)重尾的 1 000 个事件,竖线成簇,中间留下长空白。(e)对应的间隔,出现冲得很高的尖峰;图中写明均值与(a)的泊松过程相同。(f)(d)(e)的间隔分布,图中写明服从幂律,双对数上接近直线。来源:原论文图2。
这张图说明的是:只比较平均间隔,会把两种节奏看成同一件事。它是机制示意,用来对照后文的实证,本身不是某一个人的通信记录。
五个人的书信,共用一个指数吗?
间隔时间是连续两次行为之间的时间差,例如两封信、两次借书之间隔了多久。等待时间是任务到达之后、开始被处理之前的时间,回信情景里也叫回复时间。间隔在记录里较好界定。回复时间会含糊:看不到正文时,分不清这封信是在回复上一封,还是一封新信。有的研究把回复改成“从对方发出到自己第一次打开”,而邮件服务器通常并不记录打开时刻。
书信研究看过达尔文、爱因斯坦、弗洛伊德、钱学森和鲁迅。5 人里,除钱学森的幂指数为 2.1 外,其余 4 人都是 1.5。图 3 只画达尔文和爱因斯坦。电子邮件的发送间隔和回复时间都被综述概括为指数 1 的幂律。短信在个体层面是 1 到 3;按联系人拆开后,分布变成几段,每一段仍接近幂律。综述由此猜想,通信方式虽多,底下可能有一套不随时代更换的模式。这是猜想。2.1 和 1.5 已经说明,五个人也没有合成一个指数。
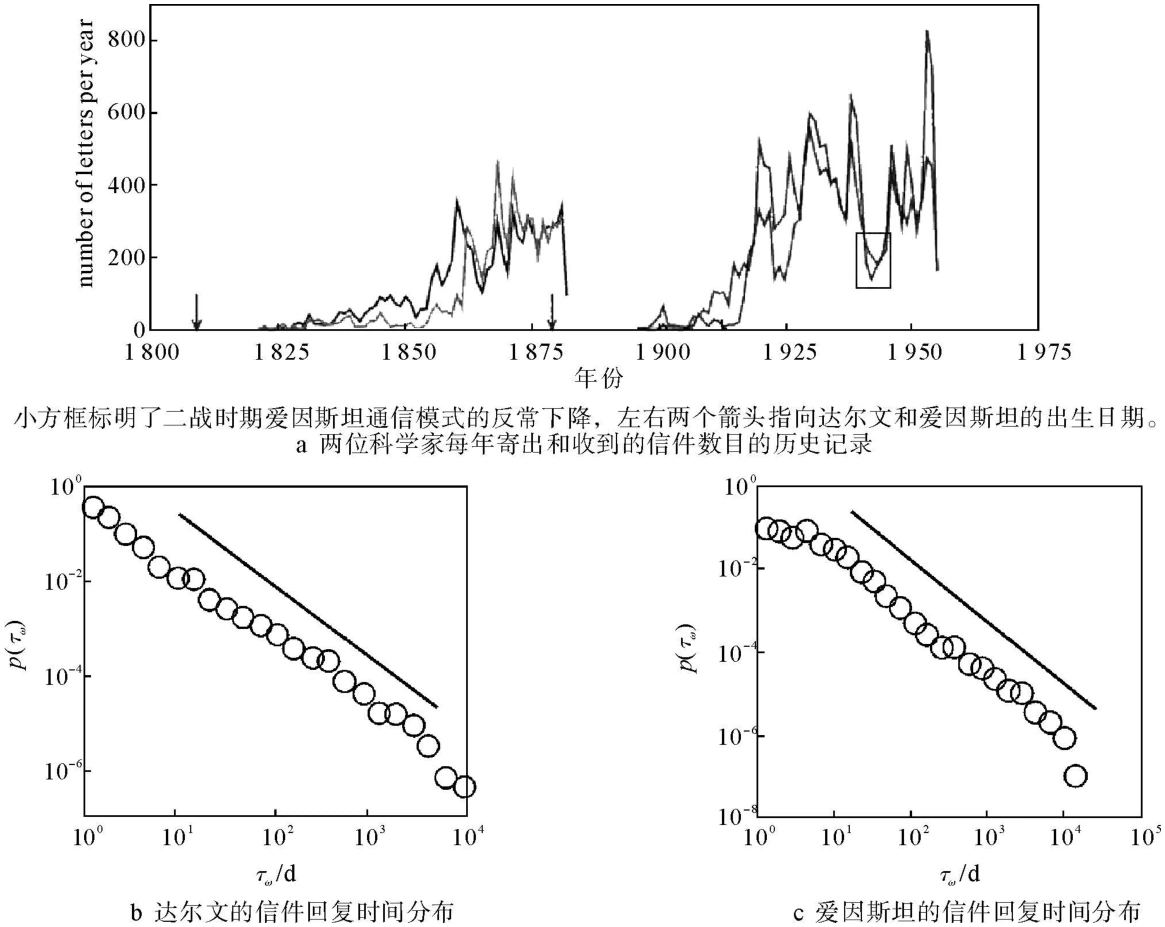
图 3|两位科学家的通信,密集和空白怎样交替?
(a)每年寄出和收到的信件数,横轴约从 1800 年到 1975 年,纵轴是每年信件数。图中写明,左右箭头指向达尔文和爱因斯坦的出生年份,小方框标出二战期间爱因斯坦通信的反常下降。(b)达尔文信件回复时间的分布,双对数,横轴以天计,沿一条直线下降。(c)爱因斯坦的回复时间,同样在双对数上沿直线下降,最右侧有一个落得更低的点。正文把这两人的幂指数放在 1.5,图上没有另印斜率数字。来源:原论文图3。
短信图换了一个问题:过去的发送是否影响后来。Rybski 等人看发送数量怎样增长,并计算 Hurst 指数。综述给出 H > 0.5,因此把增长过程称为具有长期相关,过去的行为对将来仍有影响。图上没有印出 H 的数值,也没有给出这是多少位用户里的哪一位。
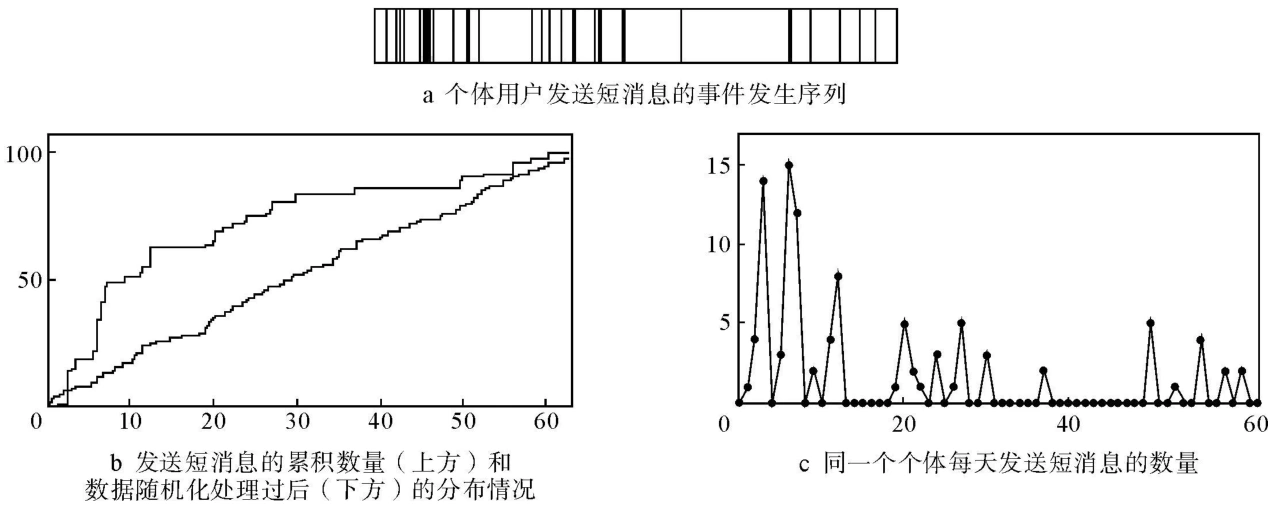
图 4|同一个人的短信,是平稳增长还是一阵一阵?
(a)一位用户发送短信的事件序列,竖线集中成几段。(b)累积发送量,横轴标到 60,纵轴标到 100;上方是实际累积,下方是打乱之后的累积。打乱保留了总件数,所以两条线到达同一终点,实际曲线更呈台阶。(c)同一个体每天发送的条数,多数日子接近 0,少数日子冲到图上约 15 的高度。来源:原论文图4。
H > 0.5 说明序列有记忆,并不给出“明天会发几条”的误差。综述提到可以用活跃程度去估计未来某时发送一定数量短信的概率,正文没有附上这套概率的数值。
越常点开的人,空白越短吗?
网页访问被概括为:新闻页面的访问量随时间按幂律衰减,访问间隔的指数为 1。在线游戏里,玩家的累积在线时间和“寿命”也服从幂律。综述用后者说明,多数人对一项活动浅尝辄止,少数人会留得很久。这里没有给出玩家人数。
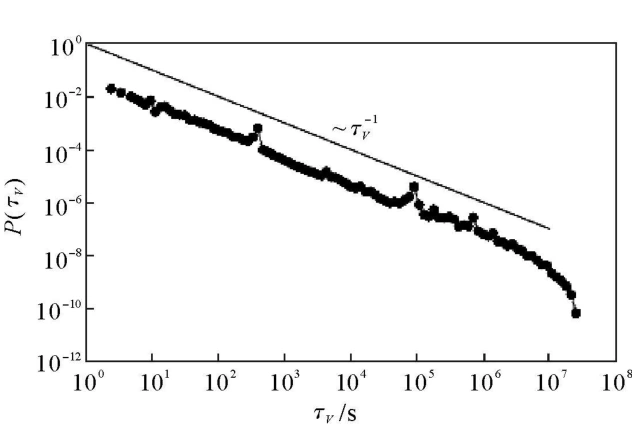
图 5|同一个人反复访问同一网站,间隔如何变稀?
无字母子图。纵轴是间隔概率 P(τᵥ),横轴是间隔秒数,都取对数。图中画有一条标成 ∼ τᵥ^{−1} 的引导线,与正文“指数为 1”相应。经验点整体沿这条线下降,到很大的间隔时掉到引导线下方。因此“指数为 1”描述的是主体趋势,最远的尾巴比这条引导线更瘦。来源:原论文图5。
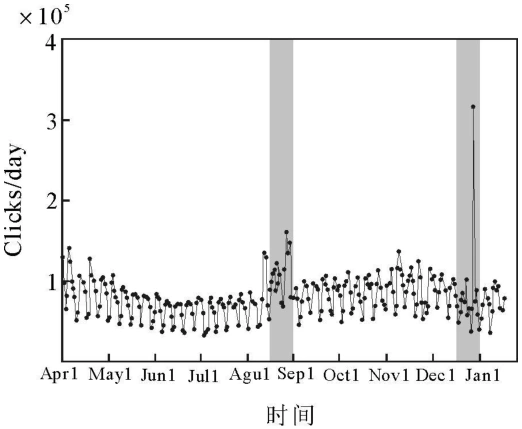
图 6|整个观测期里,每天的网页点击稳不稳定?
无字母子图。横轴从 April 1 到 Jan 1,纵轴是每天点击数,刻度乘以 10⁵,也就是每一格 10 万次。多数日子在约 1×10⁵ 次上下起伏,右端有一次明显更高的尖峰。图中有两段灰色竖带,正文没有说明它们对应哪几天。来源:原论文图6。
电影点播把“谁更活跃”写成一个可算的量。活跃性是某用户点播电影的总数,除以这些点播所跨越的时间。全体用户的点播间隔服从指数 2.08 的幂律。再按活跃性从高到低排好,分成 20 组。每一组的间隔仍是幂律,组内幂指数与该组平均活跃性呈非线性的正相关:活跃性越高,指数越大,平均间隔越短。20 是组数,不是 20 个人。2.08 是全体用户间隔分布的指数,不是这 20 个组指数的平均数。
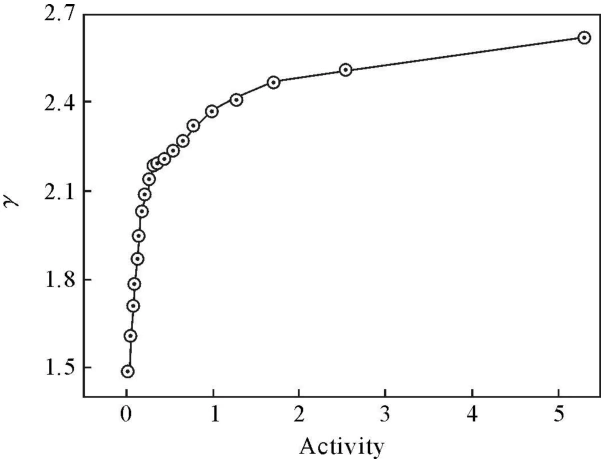
图 7|分组之后,幂指数怎样跟着活跃性走?
无字母子图。横轴是组内平均活跃性,从接近 0 到 5 以上;纵轴是间隔分布的幂指数 γ。曲线从约 1.5 陡然上升,随后变缓,右端接近 2.7。每个点是一个活跃性组,不是一位用户。来源:原论文图7。
综述的解释是:双对数上指数越大,线越陡,间隔更集中在短的一侧,观测到的平均间隔就越短。图书借阅和音乐点播被说成有类似关系,正文没有再给出那两项的指数。活跃性用的是单位时间里的访问量,它和平均间隔在定义上就缠在一起;图 7 显示的是二者怎样一起变化,还不是一套独立原因。
把很多人加在一起,幂律还在吗?
综述用“工作时间要占到日常生活的三分之一以上”说明工作记录值得单独看。这里的三分之一是对日常生活的一个比例说法,正文没有给出工时调查的样本。
股票价格变化的间隔被写成幂律,交易量有长期相关:某一刻很活跃,后面相当长一段仍可能活跃。打印机任务、订单的间隔和等待时间也被归入偏离泊松的重尾。这些句子没有再附指数。
物流企业的进境流程给出了更具体的形状。各环节以及供应链三方的间隔和等待时间都呈单峰:左侧有一个较小的峰,右侧是重尾,可用幂律近似,幂指数在 1.2 到 2.6。分母是这些流程的分布,不是其中一张图的一条线。综述的解释是,任务到达率还在人的处理能力之内时,长时间等待很少;一旦超负荷,一部分任务会被搁很久。医院就诊记录被说成同一形态:间隔低于某个临界值时接近泊松,高于该值后接近幂律。这个临界值的数字,正文没有写。
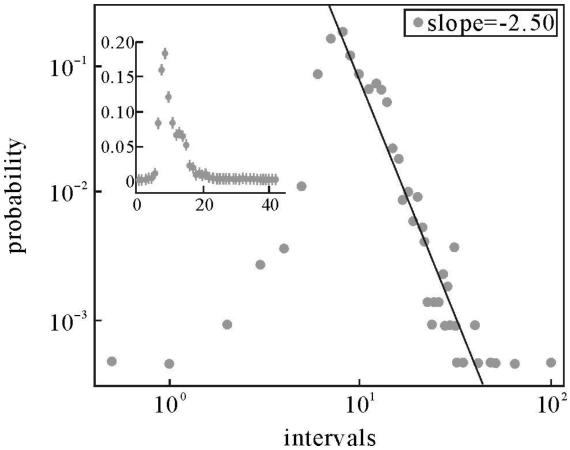
图 8|一整段物流运作的间隔,峰和尾巴各在哪里?
无字母子图。主图双对数,横轴是间隔,纵轴是概率;点在短间隔处抬起,向右下降。图例中的引导线写着 slope = −2.50,即这一条分布的幂指数取 2.50,落在正文 1.2 到 2.6 的范围里,并不表示每个环节都是 2.50。左上角插图把短间隔放大,能看到一个峰,然后落到较低的平台。来源:原论文图8。
采购订单把个人和群体拆开。某国际 500 强企业对一家供应商下单时,间隔服从幂律。把数千家供应商的全部订单放在一起,密度变成
P(x) = a e^{−bx} ( c(x+m)^{−α} + d(x+n)^{−β} )。
前一段是指数衰减,括号里是两段幂律。a、b、c、d、m、n、α、β 都没有在正文给出拟合值。数千家是数量级,不是一张精确的供应商名册。
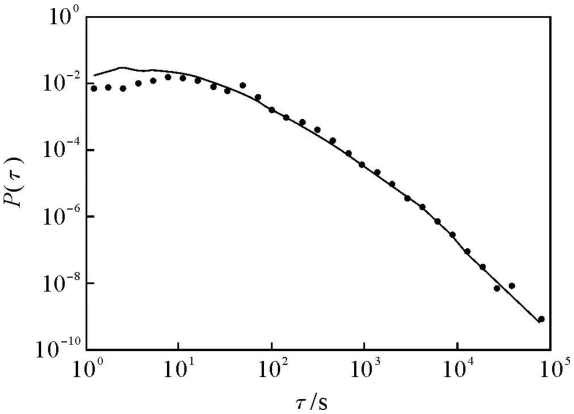
图 9|不区分供应商时,订单间隔还是一条直线吗?
无字母子图。横轴是间隔秒数,纵轴是概率,都取对数。散点与一条先平、再向下弯的曲线贴在一起,右端接近 10⁵ 秒。双对数上的弯曲对应正文那个指数与幂律混合的密度,不能再读成单一幂指数。来源:原论文图9。
这一对比是综述里最值得记住的尺度问题。个体层面小到可以忽略的偏差,叠到群体上会离开幂律。组织或群体层面的规律因此常常是混合的、分段的,一种模式盖不住。
身体自己的休息和动作,也拖着长尾吗?
Nakamura 等人给 14 名抑郁症患者装上传感器,记录身体的微小动作,并与 11 名健康人对比。分母是这项研究里的 25 人。休息期和活跃期都有重尾:休息期的累积时间接近幂律,活跃期接近广延指数分布。健康人的幂指数大于患者。综述据此说,患病时生理活动更平稳,长时间休息更多。两种健康状态都出现重尾,被用来暗示行为的组织方式有共通之处。
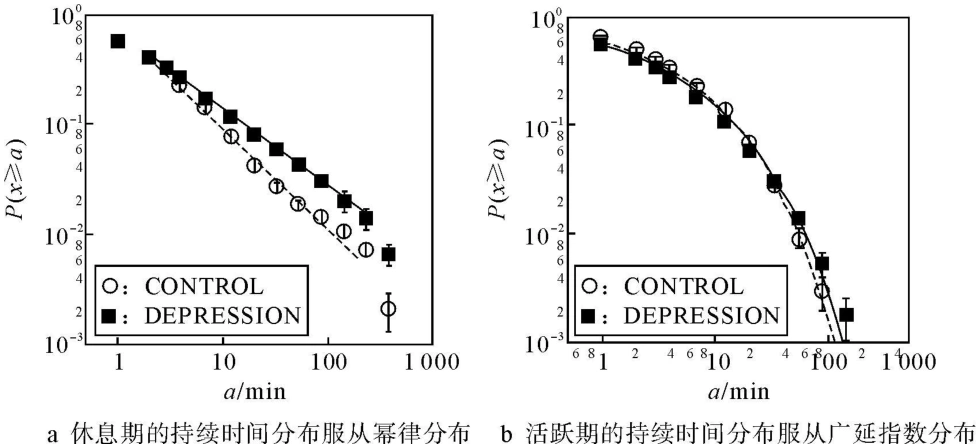
图 10|休息和活动的持续时间,健康人与患者差在哪?
(a)休息期累积分布,横轴是持续时间(分钟),纵轴是 P(x ≥ a)。空心圆是健康对照,实心方块是抑郁症患者,双对数上两组都接近直线,患者的尾巴更厚。(b)活跃期累积分布,两组都向下弯曲,图中写明服从广延指数。因为画的是累积分布,它的斜率比同一批数据的密度指数小 1,不能拿来和图 7 的 1.5 到 2.7 直接比大小。来源:原论文图10。
另一项研究记录躺、坐、站、走四种姿势怎样切换,并用非线性分析提出区分健康与患病的量化指标。综述没有写出这个指标的公式,也没有给出区分的正确率。图 11 是一段姿势如何切换的例子。
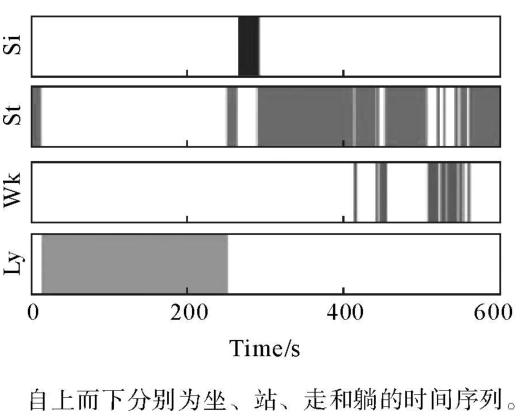
图 11|几分钟里,坐、站、走、躺怎样来回切换?
无字母子图。横轴 0 到 600 秒。图中写明,自上而下四行是坐(Si)、站(St)、走(Wk)和躺(Ly)。色块的长短是每种姿势持续的时间。这是一段示例序列,上面没有健康组和患者组的对比,也没有那个量化指标的得分。来源:原论文图11。
综述把宏观行为的不均匀,接到微观生理活动同样具有重尾这件事上。传感器记录支持“身体的动静也有长尾”,还没有单独证明宏观通信或出行的重尾就是由这四种姿势决定的。
把时间部分收成几条可以同时成立的特征:间隔分布常见重尾,指数多在 1 到 3,资源访问量也会随时间按幂律下降;行为往往要么不发生、一发生就是一串;活跃时段常卡在一周里的某天或一天里的某个钟点;单位时间里的次数仍然难测,并受节假日等环境影响;许多行为靠兴趣维持,兴趣本身长短不一;通信流量、交易和生理记录里还能看到自相似和长期相关。这些特征彼此牵着,共同组成阵发和重尾。它们是综述的归纳,每一条的证据强度并不相同。
出门的距离,能不能也收成一条线?
人在空间中的位置变化,被综述称为多种时空现象的驱动力。旧看法把迁移当成无序随机游走,长距离很少发生。信天翁的飞行时间接近幂律之后,这个看法被追问。后续动物研究里,海洋生物的行程分布服从指数在 1.7 到 2.4 的幂律:多数位移很短,长位移仍然不能丢掉。这是动物搜索的范围,不是人的出行样本。
对人,Brockmann 等人用电子支票追踪迁移,移动距离按指数 1.6 的幂律衰减,并用连续时间随机游走来解释。支票在不同持有人之间传递,所以 1.6 描述的是票据位置的跳跃,不是同一个人的行程。后来的研究改用手机:手机跟着同一位用户,通信塔能给出发生通信时的位置。局限也写在正文里:没有通信,就没有这个位置点。
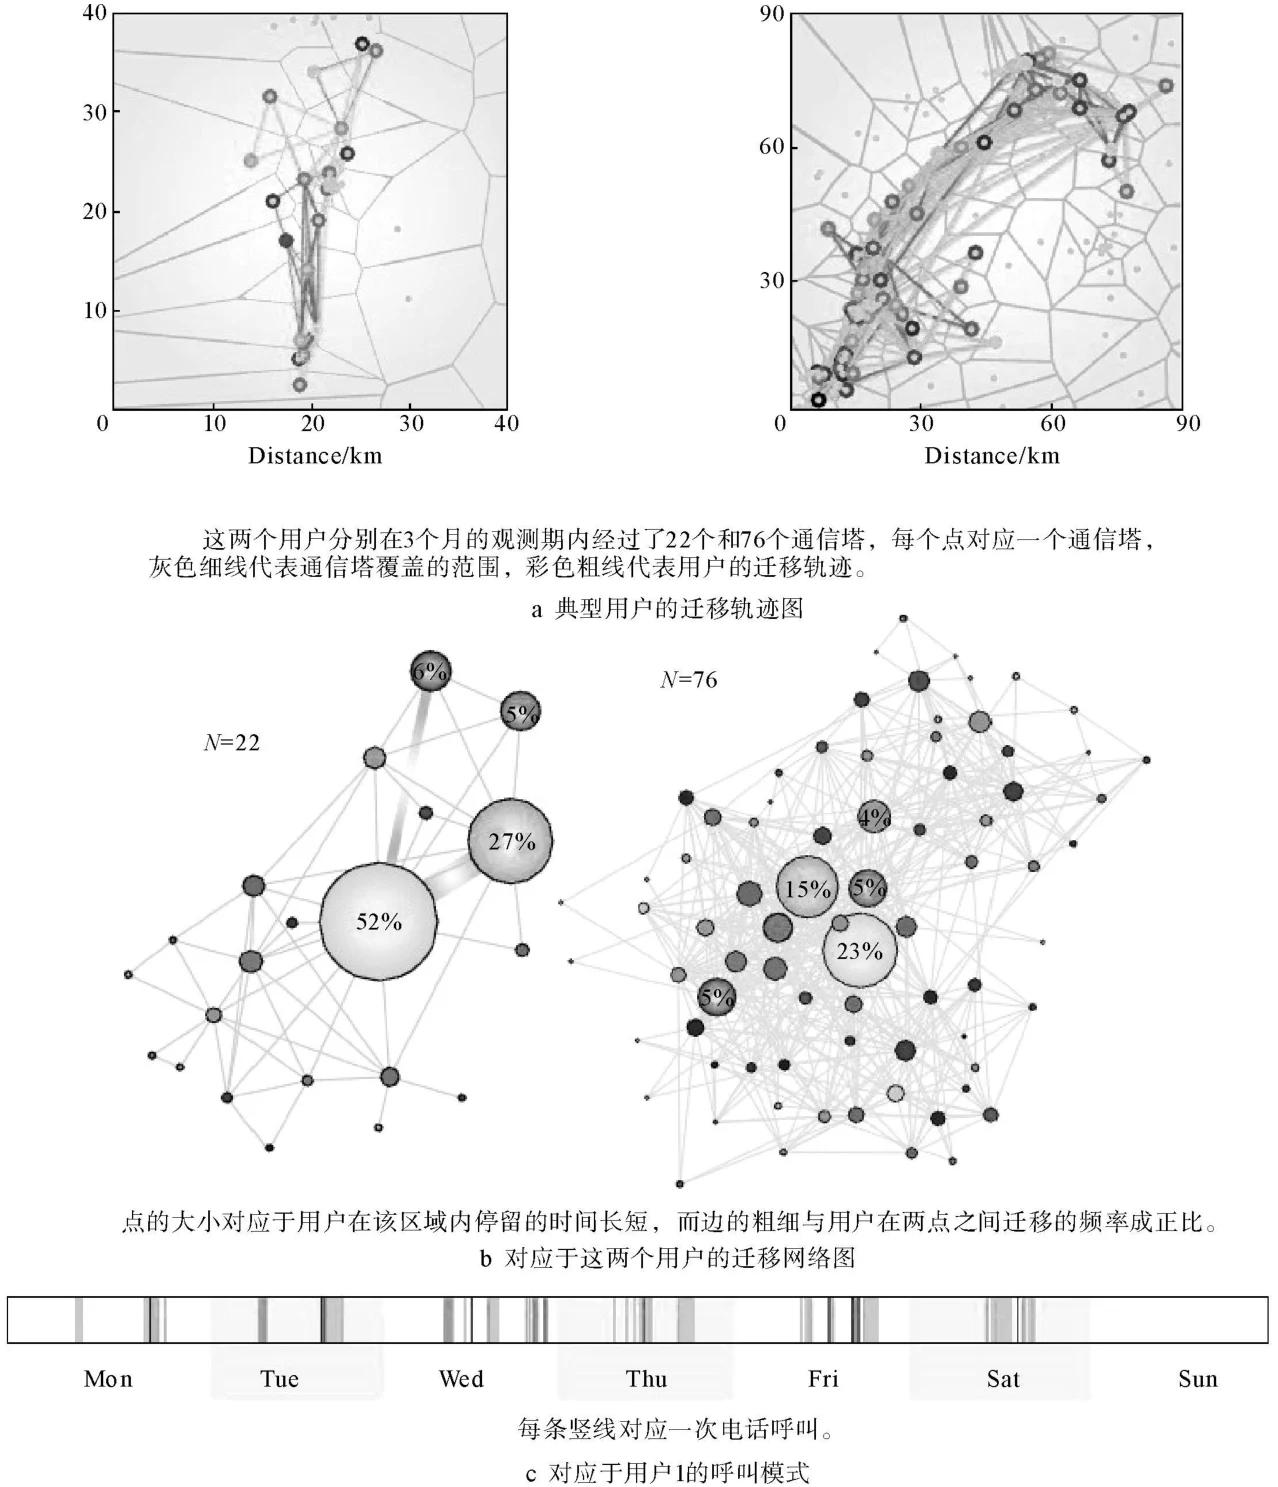
图 12|两个匿名手机用户,三个月里怎么在通信塔之间移动?
(a)迁移轨迹。左图距离轴约 0 到 40 公里,右图约 0 到 90 公里。图中写明,两人在 3 个月里分别经过 22 个和 76 个通信塔;每个点是一座塔,灰线是塔的覆盖,彩色粗线是用户轨迹。(b)对应的迁移网络。左为 N = 22,右为 N = 76。点的大小表示在该区域停留的时间长短,边的粗细表示两点之间移动的频繁程度。N = 22 的网络上标出 52% 和 27% 两处较大停留份额,N = 76 上标出 23% 和 15%;其余节点还有更小的份额。百分比的分母是该用户自己在这些塔上的停留,不是全部手机用户。(c)用户 1 一周的呼叫,横轴从周一到周日,每条竖线是一次呼叫,呼叫聚成几段。来源:原论文图12。
综述据此概括四条空间特征。
移动距离(两次停留之间的位移)和活动半径(日常生活覆盖的典型范围,图中记为 r_g)都服从带指数截断的幂律。多数移动很短,少数移动很长。
人们大部分时间待在较小的范围里。活动半径随观测时间的增长,用对数比用幂律更合适:观测越久,越可能出现一个没去过的地方,只是这个增长比幂律慢。正文没有给出对数增长的系数。
移动带有记忆。一系列行程之后,人会回到家或单位。返回概率在 24 小时、48 小时、72 小时周期性达到峰值。返回次数的排名服从齐夫定律(Zipf’s law,名次和频次之间的幂律),而且与这个人去过多少个地方无关。活动半径大的人,规律性反而高于活动范围只在家或单位附近的人。
位置可以被预测。综述写,模型和算法预测个体去向的准确性高达 93%。这个概率与性别、年龄、生活环境、节假日无关,随活动半径增大而提高,活动半径超过 10 公里后趋于稳定:半径再大,预测概率也不再变化。93% 是综述所写的上限式说法,这一段没有印出被预测的人数。它预测的是人会出现在何处。单位时间里行为发生多少次,时间部分仍然称为难以预测。两句说的不是同一个预测任务。
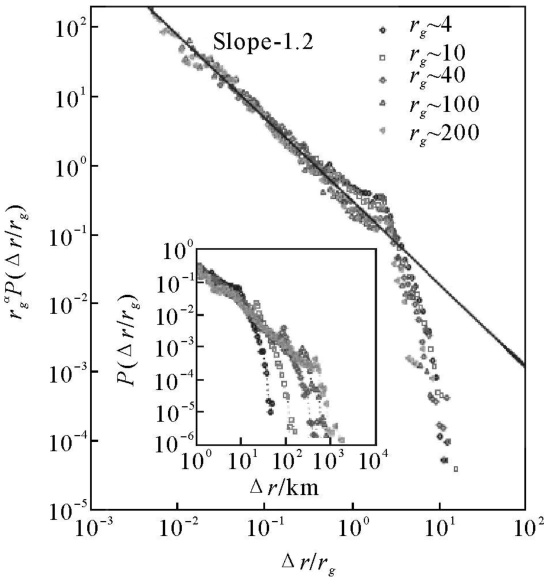
图 13|活动半径差很多的人,移动距离能否叠到同一条线上?
无字母子图。主图横轴是移动距离除以活动半径 Δr/r_g,纵轴是用 r_g 的幂次重新标度后的概率。图例把人分成 r_g 约 4、10、40、100、200 五档,五组点沿同一条下降线聚集,引导线标为 Slope −1.2。插图横轴是未经标度的距离,单位是公里,五组曲线彼此分开。93% 和 10 公里写在正文的可预测性条目里,不在这张图的坐标上。来源:原论文图13。
重标度之后的重合,说明不同活动半径共享一种空间标度。插图同时表明,不除以 r_g 时,各组的原始距离分布并不相同。传统随机游走和莱维飞行(Lévy flight)被综述认为还不能完整解释人的流动。文中提到的后续模型包括:资源越匮乏、多种生物共享领地的比例越大,长程移动的概率越大;具有等级结构的交通网络上,行程分布也可以出现幂律。这些是模型结果,综述没有在这里给出新的人类行程样本。
重尾可以来自排队,也可以来自兴趣和作息
实证给出重尾之后,综述转去问尾巴从哪来。优先权、兴趣、记忆、截止时间、人与人的影响、任务类型和排队规则都被试过。下面几套模型都能造出宽尾巴,它们要求的行为并不相同。
优先权模型把一天的事情看成一份长度为 L 的任务列表。每项任务有一个优先权 xᵢ,由分布 ρ(x) 生成。每个时间步,人以概率 p 执行优先权最高的任务,以概率 1 − p 随机执行一项;做完就删掉,并补上一项新任务。p 接近 1 时,几乎总是先做最紧急的事;p 接近 0 时,接近随机挑选。综述接着写,p → 1 相当于确定型的先进先出,p → 0 相当于随机选择。前一句和“以概率 p 选择最高优先权”并不吻合,阅读时应以选择规则为准。
解析和模拟给出:队长固定或可变时,等待时间都是幂律,指数分别为 1 和 1.5,并且与 ρ(x) 的具体形状无关。优先权一旦分配就不再改,较小的优先权会在列表里停留很久,于是等待时间出现重尾。到达率 λ 与服务率 μ 相等时,队长保持常数,指数为 1。队长可变时,λ ≥ μ 给出 P(τ) ∼ τ^{−3/2};λ < μ 给出 P(τ) ∼ τ^{−5/2} e^{−τ/τ₀},τ₀ 是一个特征时间。服务强度 λ/μ = 1 的两侧,标度不同。这是队列模型的解,不是从某一批邮件直接拟合出来的指数。
真实任务往往有截止时间,优先权再低也不能无限等。一种改法是让优先权随等待时间上升,低优先权的任务等久了会变得紧急。另一项模拟在每个时间步先处理快到截止时间的任务,再用概率 p 处理最高优先权,或用 1 − p 随机选一项。截止时间固定时,任务越多,幂律尾越明显;任务数固定时,截止时间越短,尾越明显。综述写明,这个模型的解析解可能很难求。会议注册给出一个能写成公式的例子。设截止日期为 T*,注册人数
N(t) = C ln( T / (T − t + 1) )。
越靠近截止日期,完成注册或支付的概率越大。支付人数用另一个含截止日期的积分描述。综述说,模拟和会议数据对得上,正文没有给出误差或会议场数。
上网、看电影、发短信很难都当成带优先权的任务。兴趣模型改用一条自我调节:做事的频率跟着兴趣走。很久没玩游戏,偶然一次会把兴趣拉高,随后玩得很密;密到影响生活,人又会把频率降下来。
韩筱璞等人的自适应兴趣模型用 r(t) 表示离散时刻 t 发出行为的概率,每次行为之后按 r(t+1) = a(t) r(t) 更新。间隔短于阈值 T₁,兴趣下降;长于阈值 T₂,兴趣上升。两个阈值相差 3 个以上数量级时,模拟产生指数为 1 的间隔分布。综述把“只能得到指数 1”看成这个模型的主要限制。
戴双星、尚明生等人把指数做成可调的。兴趣 x(t) 取 0 到 1,一开始最高,然后按 1 / (1 + α t) 衰减,α > 0。距上一次行为的时间为 t − t′ 时,
x(t) = 1 / (1 + α (t − t′))。
若 t 时刻发生了事件,t + 1 再次发生的概率是 1 / (1 + α)。解析得到的间隔指数是 1 + 1/(1+α)。当 α < 1,平均间隔大约是 1 / (1 − α):α 越大,平均间隔越长,活跃性越低。α 又与幂指数反向,于是活跃性与幂指数同向。这和电影点播里“越活跃、指数越大”的方向一致。两边的活跃性来自不同数据和不同定义,方向一致还不是同一次测量的重复。
上面两个兴趣模型把时间分成离散步。连续时间的情形用非齐次泊松过程:发生率 λ(t) 可以随时间改变。一个兴趣逐渐消失的模型取 λ(t) = b / (a t + 1),a、b > 0。间隔仍是幂律,指数为 b/a + 1,可以落在 (1, ∞)。λ(t) 和前面的 x(t) 形式相近,综述强调发生率与“这一步发生的概率”不是同一个量。
Malmgren 等人从电子邮件的日常用法出发,认为幂律间隔来自行为的周期性。模型内外嵌套:外层是发生率随时间周期变化的非齐次泊松过程;外层每个事件启动一串内层过程,内层是发生率恒定的齐次泊松过程。内层做完,人回到外层的钟。和邮件数据对比后,重尾可以来自周期、重复和需求量的变化,而不必来自优先权排序。综述认为它更贴近日常,同时写明它目前解释的是单一行为的间隔,多种任务混在一起是否仍然适用,还要再看。
记忆被放在这些模型旁边。刚发生过的事很快再来的概率大,很久没做的事再做的概率小。综述认为记忆可以产生阵发;相对许多自然现象,这种作用并不特别强。正文没有给出一个记忆系数的拟合值。
这些规律停在什么地方
个体分布和群体分布可以不同,综述把这一点做成了订单的实证。个体怎样汇成群体、群体又怎样影响社会层面的动态,仍然是未解的。团体内部的组织行为,数据更少。
队列、截止时间和兴趣已经放进模型。生理、心理、认知、情感,以及家庭、单位、制度和民族,怎样量化进同一个模型,综述列为开放问题。模型能生成重尾,只说明这条路走得通,不说明人就是按这个规则生活。
测量本身还有缺口。回复时间在邮件和网络评论里都难界定。手机位置只在通信发生时出现。公司或政府的组织行为记录往往涉及机密。综述把精确、完整的数据当成继续发现规律的基础。
自相似和长期相关在网络流量、通信流量、计算机指令、短信和股票交易里被报告过。短信和股票里的分形,是个别现象还是普遍规律,综述没有下结论,只提到自己对图书借阅做过考察,并说还要继续验证。那项考察的数值没有写在这篇综述里。
幂指数的差别,曾被想成行为类别的尺子。Vazquez 等人把指数分成 1 和 1.5 两类,分别对应队长固定和队长可变。越来越多的实证落在这两类之外,电影点播的 2.08、物流的 1.2 到 2.6 都是例子。综述把“是否还有别的普适类,或者根本没有普适类”留成问题。因此,1 和 1.5 是队列模型的两个解,不是全部人类行为的分类表。
一句话总结
人的许多行为确实是一阵密集、然后长时间空白,重尾反复出现;指数却不是一个数,个人规律加总后会变形,一条重尾也还不能指认它来自排队、兴趣还是作息。
核心来源
樊超,郭进利,韩筱璞,汪秉宏. 人类行为动力学研究综述. 复杂系统与复杂性科学, 2011, 8(2): 1–17. 英文题名 A Review of Research on Human Dynamics. 文章编号 1672-3813(2011)02-0001-17.
文中的数字都来自这篇综述的正文和图。图注方括号和参考文献表在前半部分对得上:图2 对应 [4] Barabási, Nature, 2005, 435: 207–211;图3 对应 [14] Oliveira 与 Barabási, Nature, 2005, 437: 1251–1253;图7 对应 [11] Zhou 等人, Europhysics Letters, 2008, 82: 28002;图8 对应 [18] Wang 与 Guo, Physica A, 2010, 389: 2127–2133。
后半部分的编号有错位,核对时要看作者和题目。图4 的正文和图注写 Rybski 等人 [38],表中 Rybski 等人的 PNAS 2009, 106(31): 12640–12645 印在 [37],[38] 是 Johansen 与 Sornette 2000。图5、图6 的图注为 [43],表中 Gonçalves 与 Ramasco 的网页分析, Physical Review E, 2008, 78: 026123 印在 [42],[43] 是 Grabowski 等人的人工社会模型。图9 讲采购订单、图注为 [21],表中 [21] 是郭进利关于博客评论的论文,[20] 是 Gao、郭进利、樊超等人的采购订单预印本。图10 的正文称 Nakamura 等人并标 [52],表中 Nakamura 等人 2007, 99(13): 138103 印在 [51],期刊栏写的是 Physical Review E;[52] 是 Paraschiv-Ionescu 等人, Physical Review E, 2008, 77: 021913。图11 的姿势序列图注为 [53],表中 [53] 是 Viswanathan 等人的动物搜索, Nature, 1999。图12 图注 [61] 与汪秉宏、韩筱璞, 物理, 2010, 39(1): 28–37 一致;正文的手机研究写在 [59]–[61],其中 [59] 是 Gonzalez、Hidalgo 与 Barabási, Nature, 2008, 453: 779–782。图13 图注 [60] 与 Song 等人, Science, 2010, 327: 1018–1021 一致。钞票迁移在表中是 [57] Brockmann、Hufnagel 与 Geisel, Nature, 2006, 439: 462–465,正文写成 [58]。
作者介绍
四位作者的单位以论文署名和作者简介为准。
- 樊超:1984 年生,山西太谷人。署名上海理工大学管理学院、山西农业大学文理学院数学系。作者简介写明他当时是助教、硕士,方向是复杂网络与人类动力学的实证和建模。参考文献里有他参与的图书借阅标度律分析。
- 郭进利:署名上海理工大学管理学院。参考文献中有他关于博客评论、兴趣衰减的非齐次泊松模型、记忆效应和物流运作标度的工作。论文没有另写职衔。
- 韩筱璞:署名中国科学技术大学近代物理系理论物理研究所及非线性科学中心,英文名 HAN Xiao-pu。参考文献中的自适应兴趣模型、交通层次与移动标度,以及与汪秉宏合写的评述,使用这一姓名。论文没有另写职衔。
- 汪秉宏:署名上海理工大学复杂系统科学中心,以及中国科学技术大学近代物理系理论物理研究所及非线性科学中心。参考文献中有他与韩筱璞合写的《人类行为的动力学与统计力学研究》。论文没有另写职衔。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
订单那一对比可以再往下做一步。一家供应商是幂律,数千家合在一起就弯了。若每个供应商各有自己的指数,混合分布会在什么规模开始离开直线?综述只给了两端。一个采购或客服系统若只拟合公司级的一条间隔分布,会把“很多人各自的阵发”看成“公司有另一种机制”。更有信息的做法,是先在每个对象内部估计指数,再看对象个数从几个增加到几千时,混合尾巴从哪一段开始变弯。
93% 和“单位时间里的次数难以预测”也可以放在同一次汇报里,避免听成同一句话。前者说的是手机用户下一次更可能出现在何处,而且活动半径超过 10 公里后,这个位置概率不再跟着半径变。后者说的是下一小时会有多少次点击、多少张订单,还会被节假日推动。交通或门店若把 93% 挪去承诺小时客流,预测对象已经换了。值得单独检验的是:同一个人,位置的可预测程度高,他的小时出行次数是不是仍然接近综述所说的难测。
指数也不适合先被收成 1 和 1.5 两格。电影点播的全体指数是 2.08,20 个活跃性组又大约从 1.5 铺到 2.7;兴趣模型里的指数可以随 α 连续变化。一个产品若只问“用户属于 1 还是 1.5”,这组点播数据没有格子可放。记录行为时不妨同时记下三件事:有没有硬性截止日期,兴趣会不会随重复而下降,以及这件事是否被一天或一周的作息卡住。同样的重尾,在这三列里的位置不同,后面该用队列、兴趣还是周期泊松,才有依据可分。