去过的地方越来越多,为什么生活范围没有一直散开?
论文名片|Chaoming Song、Tal Koren、Pu Wang、Albert-László Barabási,Modelling the scaling properties of human mobility,Nature Physics,2010,6:818–823,2010 年 9 月 12 日在线发表。DOI · 官方补充材料。
你偶尔会去一家新餐馆、换一条散步路线,甚至去一座新城市。但几个月后回看,大部分活动仍围绕少数常去地点展开。不断发现新地方,与生活反复回到熟悉地点,两件事同时发生。
如果把人当成不断随机跳跃的粒子,长距离移动与长时间停留可以被描述,却不一定解释这种反复回归。这篇论文的关键,是给随机移动补上两个带记忆的选择:探索概率逐渐降低,返回时偏向过去常去的地方。
四点主要发现:
- 仅知道步长和等待时间都是重尾分布,还不足以描述人的移动;不同地点增长、访问排序和扩散速度提供了额外检验。
- 新地点数的增长指数约 0.6,慢于简单连续时间随机游走的预期;常去地点的访问频率明显不均。
- 探索衰减与优先返回模型,不只拟合一条曲线,还把多个统计指数连接起来。
- 它解释长期统计形态,尚不能直接重现准确的逐日日程、路线顺序或个人下一站;预测的长期饱和也未在一年数据中观察到。
三百万人的大数据,为什么还需要一千人的小时记录?
研究使用欧洲移动运营商的两套匿名数据。D1 覆盖 2008 年约三百万用户一年的通信定位;正文主要说通话,补充材料说明还包括短信收发。每次通信记录路由基站,空间精度随基站覆盖变化,城市可为数百米,乡村可达数公里。
D2 是自愿加入位置服务的一千名用户,两周内每小时记录一次最近基站位置,独立于是否打电话。它的作用不只是增加样本,而是帮助处理 D1 的观察偏差:一个人几个小时没有电话,不能据此认定他几个小时都没移动。
补充材料 S2 在 D1 中只比较间隔接近一小时的定位,并检查不同通话频率和一、两小时尺度;等待时间则通过采样概率校正,并与 D2 对照。校正依赖通信活动与停留相关较弱等假设,D2 也只有小时分辨率,二者都不是连续 GPS 真值。
研究得到的位移分布尾部近似为 P(Δr) ∝ Δr⁻⁽¹⁺α⁾,α = 0.55 ± 0.05,约 100 公里附近截断;等待时间近似 P(Δt) ∝ Δt⁻⁽¹⁺β⁾,β = 0.8 ± 0.1,约 17 小时截断。这里的 Δr 是固定观察间隔下的位置变化,Δt 是在同一定位地点的等待;都不能直接等同于完整行程距离与活动持续时间。
连续时间随机游走(continuous-time random walk,CTRW)可以把随机步长与随机等待时间组合起来。重尾符合它的出发点,但能否解释人,还得看其他不被输入分布直接保证的统计量。
哪三种现象,让无记忆随机游走遇到困难?
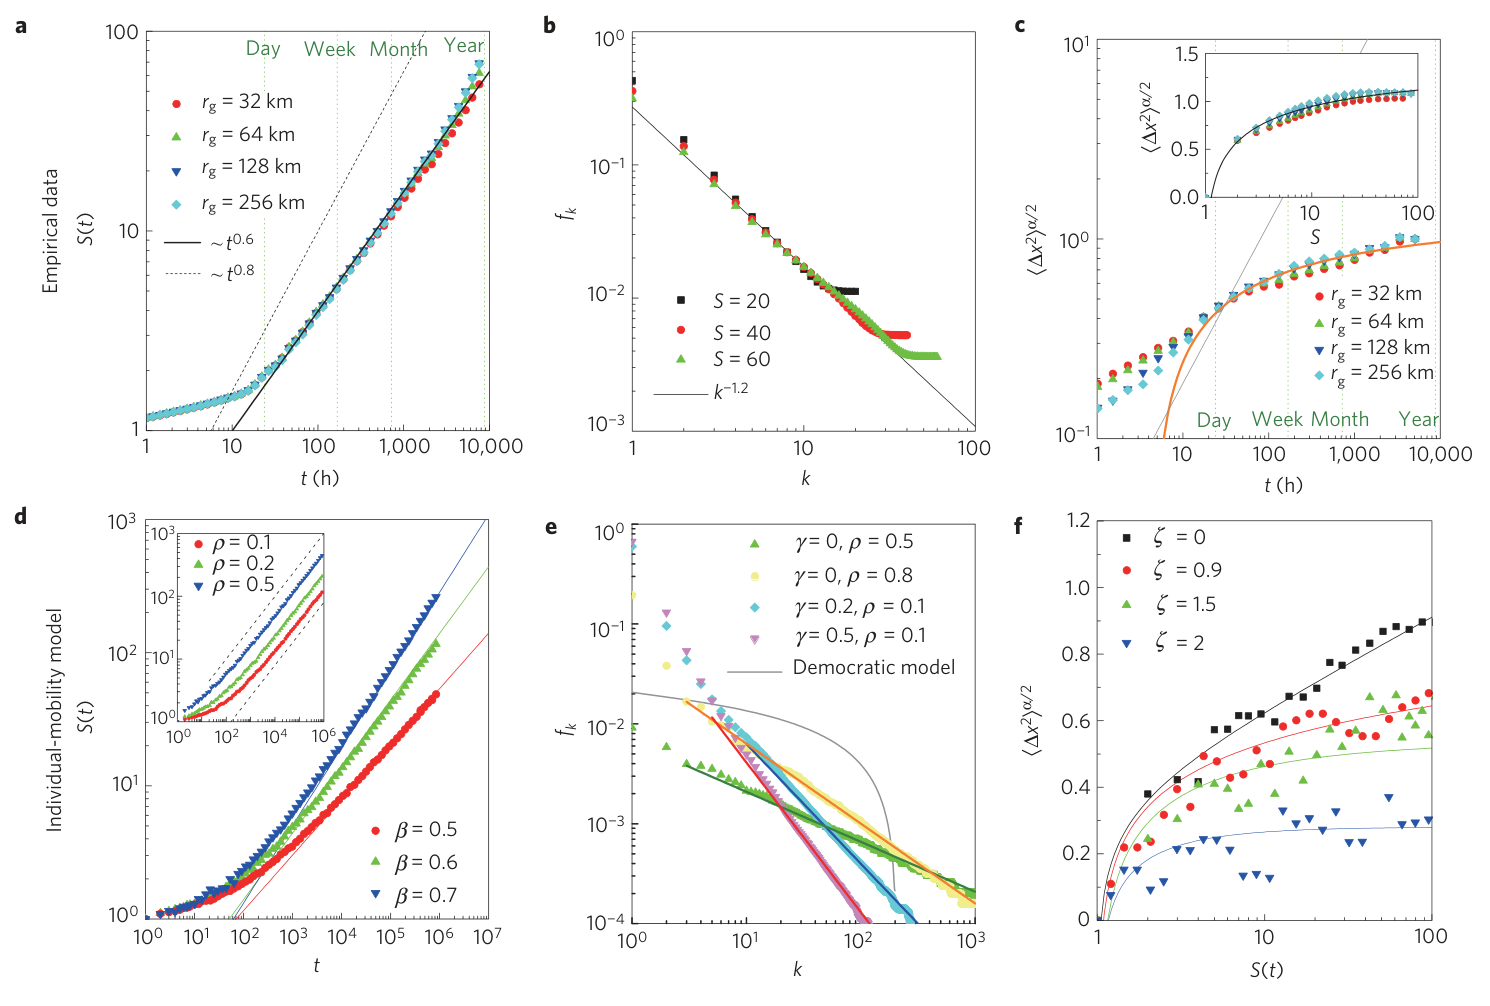
图 1|除了长步长与长等待,模型还必须同时解释什么?
(a)不同回转半径组的新地点数 S 随时间 t 增长,横轴小时、双对数,观测约为 t 的 0.6 次方,慢于虚线所示 CTRW 的约 0.8 次方。
(b)按每人访问频率排序的位置,横轴为排名 k,纵轴 fk 为访问频率;不同已访问地点总数的曲线接近 k 的 −1.2 次方。
(c)按回转半径分组并归一化后的均方位移变换量,随时间增长很慢,灰线是 CTRW 对照、橙线是本文理论;插图以新地点数 S 为横轴对照理论。
(d)模型在不同等待指数 β 下的新地点增长,线为解析预期,插图改变探索参数 ρ。
(e)模型的访问排名分布随 γ、ρ 改变;灰色曲线为旧地点等概率返回的对照,失去明显的 Zipf 形态。
(f)模型的均方位移变换量随 S 变化,不同访问排名指数 ζ 对应不同增长形态。来源:原论文 Fig. 1。
第一个异常是探索减慢。S(t) 表示截至 t 去过的不同地点数,而非全部到访次数;一再回家不会增加 S。观测指数 μ = 0.6 ± 0.02,比基于 β 的简单 CTRW 预期更低,说明新地点发现速度不能只由等待时间解释。
第二个异常是访问集中。把一个人的地点按访问次数排队,fk 约按 k⁻ζ 下降,ζ = 1.2 ± 0.1,即 Zipf 定律。它描述排名与频率,不是位移距离的幂律指数,也不是说所有人都有相同的一号地点。
第三个异常是超慢扩散。普通随机游走会不断偏离起点,但人的移动受经常返回少数地点的行为限制。这里的均方位移(mean square displacement,MSD)还经过特定测量:按回转半径分组,从离开最常去地点时对齐起点,且为直接比较理论,只在探索新地点时计入位移。图中纵轴另作 α/2 次幂变换,不能直接当作每小时实际走了多少公里。
三种现象共同约束模型,比只匹配步长分布更严格。但这些仍是群体分组后的统计规律,不能据此判定每个个体的行为完全相同。
两条规则,怎样把新鲜感与熟悉感放进同一个模型?
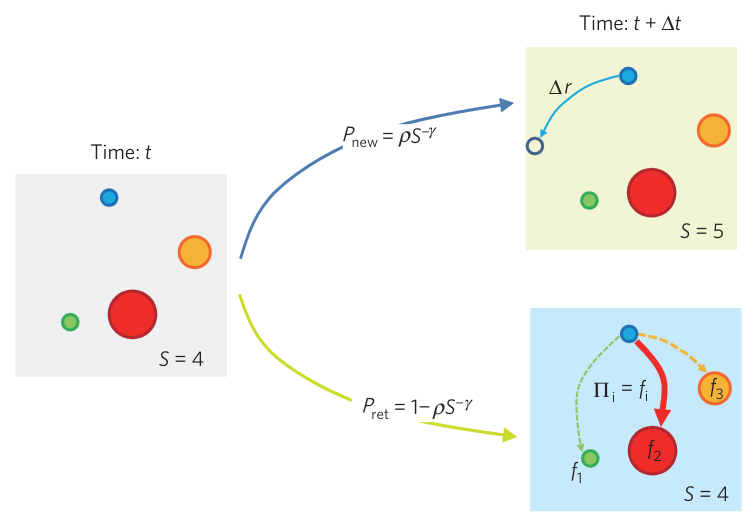
图 2|下一步是去新地点,还是回到旧地点?
左侧已有四个地点,圆的大小表示访问频率;右上以 Pnew = ρS⁻γ 探索新地点,S 从 4 变 5,探索距离服从输入的重尾分布;右下以互补概率返回旧地点,并按各地点已有访问频率 fi 选择目标。原图无子图字母。来源:原论文 Fig. 2。
第一条是探索(exploration)。已去地点越多,若 γ > 0,下一步发现新地点的概率越低。ρ 控制探索倾向的水平,γ 控制探索随累积经验衰减的程度。新地点距离从已有的重尾步长分布抽样,方向随机。
第二条是优先返回(preferential return)。决定回旧地点后,选择地点 i 的概率与过去访问它的次数成比例。它不是单纯选最近地点,也没有按真实的家、单位、商场类别分别设规则;历史频率本身就在增强常去地点。
模型因此具有记忆:新地点一旦加入访问史,就可能在以后被重复强化。一个人形成的活动范围可以相对稳定,即使整个群体的活动尺度仍差异很大。
这两条规则,数据真的支持吗?
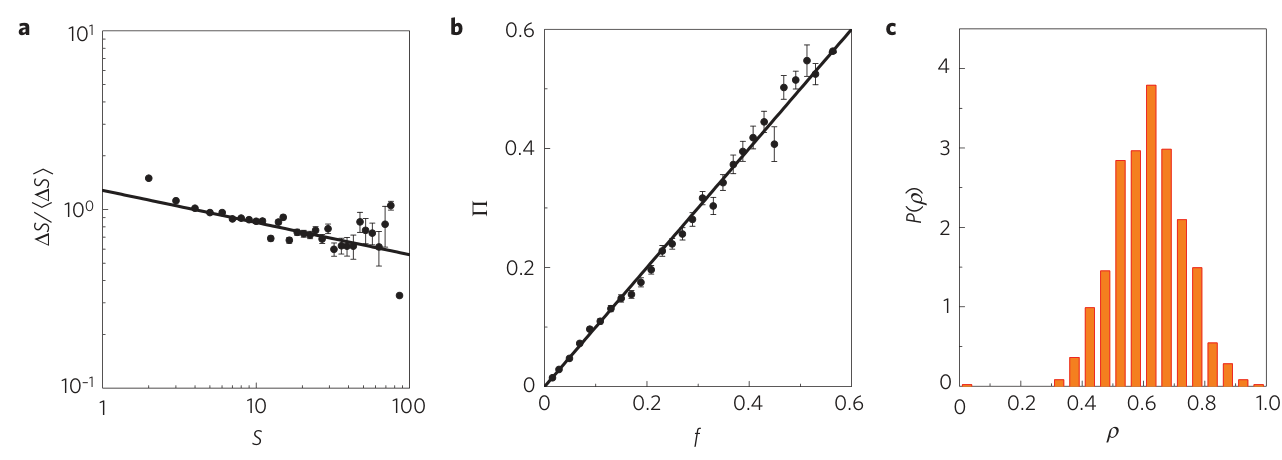
图 3|两条机制是否只是为曲线量身定做?
(a)横轴为已经去过的地点数 S,纵轴为标准化新地点增量,双对数下缓慢下降,对应 γ = 0.21 ± 0.02;误差棒为均值标准误。
(b)横轴为过去访问频率 f,纵轴为返回概率 Π,数据接近 Π = f;误差棒同为均值标准误。
(c)用户探索参数 ρ 的概率密度,近似钟形,均值约 0.6。来源:原论文 Fig. 3。
这些检验使用 D2,减少按是否通信决定记录的偏差。结果支持把探索衰减和历史频率强化作为统计建模规则,但并不直接测量人的主观动机,也未排除固定日程、地点功能、家庭工作约束产生相似规律的可能。
补充图 S6 进一步显示,白天与夜间、工作日与周末的返回倾向并不完全相同。把时间汇总后,优先返回是有用的长期近似;如果任务改为预测明天几点去哪里,就需要显式加入节律与顺序。
为什么这不是给每条曲线单独拟合一个指数?
模型把探索次数 n 与新地点数连接起来:每多走一步,新地点增加的平均概率约为 S⁻γ,因此 S ∝ n¹⁄⁽¹⁺γ⁾。再结合重尾等待下的 n ∝ tᵝ,得到 μ = β/(1 + γ)。
对于 γ > 0,优先返回又给出 ζ = 1 + γ,所以得到 β = μζ。这意味着三个经验指数之间不是任意搭配:改变探索衰减,既改变发现地点的速度,也改变常去地点的频率排序。
以独立估计的 β = 0.8 ± 0.1、γ = 0.21 ± 0.02 为输入,论文预测 μ = 0.67 ± 0.07,与经验 0.6 ± 0.02 在所报不确定性范围内相容;预测 ζ = 1.21 ± 0.02,与经验 1.2 ± 0.1 相近。这里是模型和观测的统计一致性,不是没有误差的恒等式。
图 1e 的等概率返回对照尤其重要:即使保留探索,若旧地点都同样可能被选中,Zipf 排序会消失。这把访问不均衡具体连接到优先返回,而不是只说模型“看起来像人”。
模型的 γ = 0 是另一个参数区域,其 ζ = 1 − ρ,不能把 ζ = 1 + γ 无条件套到所有设置。真实数据对应 γ > 0 的区域,ρ 的具体取值会改变探索水平,却不改变该区域主要渐近指数。
不同人的活动范围,为什么仍然相差很大?
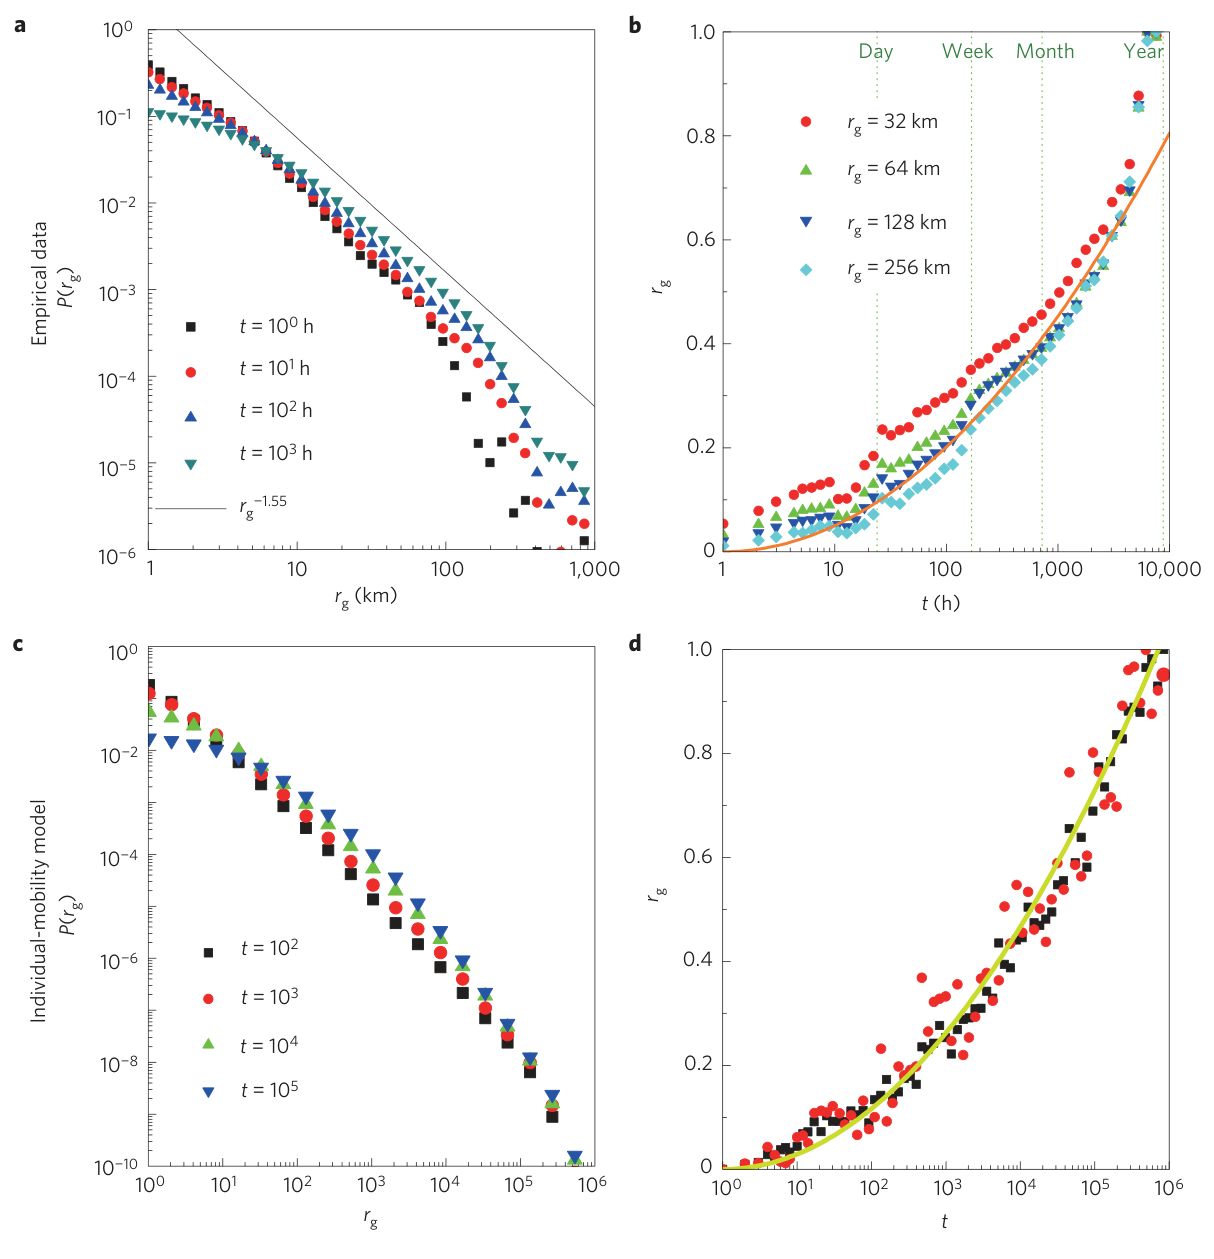
图 4|同一生成机制能否产生很不一样的活动尺度?
(a)不同观察时刻的经验回转半径 rg 分布,横轴公里、双对数,尾部参照斜率约 −1.55。
(b)不同 rg 分组的回转半径随时间变化,用一年末的值归一化;橙线为缓慢增长的视觉参照。
(c)模型产生的 rg 分布,使用 α = 0.75、β = 0.6、γ = 0.2、ρ = 0.1 的示例设置。
(d)同一设置下模型回转半径的时间增长,用模拟终点归一化,绿线为视觉参照。来源:原论文 Fig. 4。
回转半径是位置相对个人活动中心的均方根距离,不是某一次最远出行,也不是轨迹总长。不同人经常移动的范围不同,使全体直接混合平均可能掩盖尺度差异,所以前面的分析按 rg 分组。
模型无需给每人预设一种固定活动半径,也能产生重尾的人群尺度分布。补充材料 S5 将 rg 尾部与输入探索步长尾部的指数联系起来。这说明随机探索和返回历史共同形成异质性,但不意味着现实收入、职业或交通条件无关。
图 4 的模型参数与正文全部经验估计并不逐一相同,它展示的是机制可产生同类形态,不是对每名真实用户进行个体拟合或路线复现。
扩散会饱和吗?一年数据还不能证明
理论区分三种长期区域:ζ < 1 时位移按对数形式极慢增长,ζ = 1 时进一步变成双对数形式;ζ > 1 时模型预期 MSD 最终饱和,频繁返回会限制典型偏离尺度。
经验 ζ 约 1.2 落在预期饱和区域,但研究一年内没有观测到真正饱和。论文外推约 5 年后才可能接近相关尺度,这是一项模型预测,不是五年纵向验证。不能把它翻译成“人类活动范围五年后固定不变”。
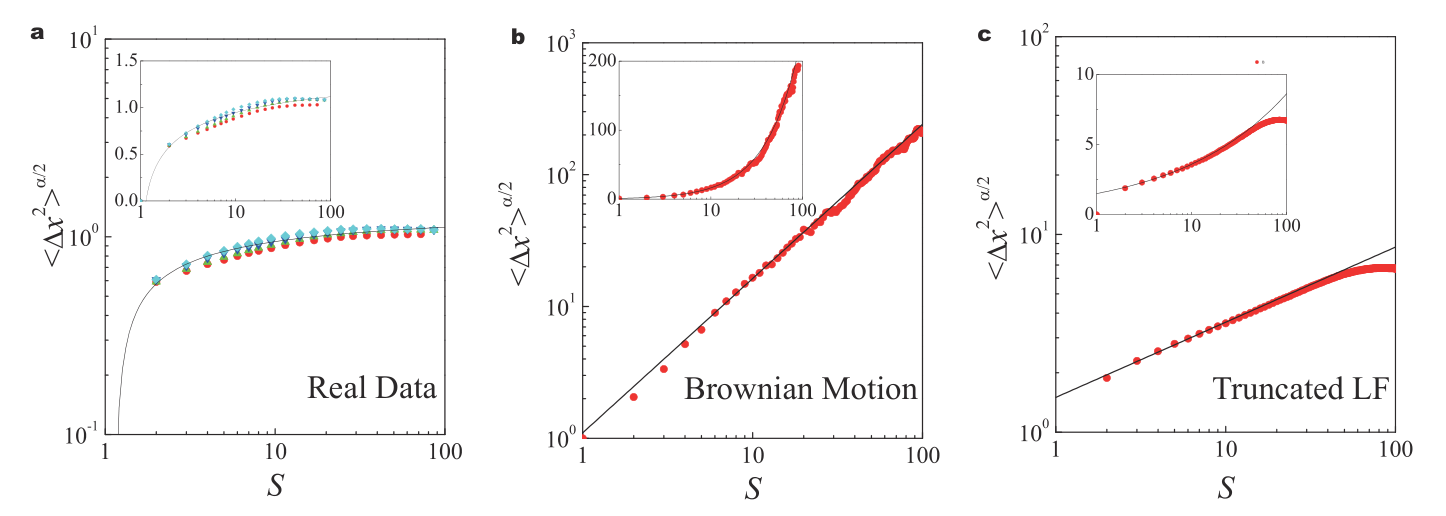
图 S5|超慢增长会不会只是因为地图本来就有限?
(a)经验数据的 MSD 变换量随新地点数 S 变化,曲线为本文模型预测。
(b)限制在 100 × 100 格网内的布朗运动。
(c)同一有限格网内的截断 Lévy 飞行,探索步长有截断;插图展示趋向饱和的过程。三面板保留原组合。来源:原论文补充 Fig. S5。
有限地图确实能让某些随机模型饱和。关键不只是有没有饱和,而是怎样接近:这里两个有限空间对照在饱和前呈不同于经验的幂律关系,本文模型更接近观测到的极慢变缓。补充材料也承认,把有限区域加入本模型可能加快饱和,一年数据不足以完全分离这些长期作用。
因此模型提供的是一组相互一致的机制解释,而非唯一机制的证明。重尾输入存在实际截断,渐近解析关系与有限观测期也要分开理解。
这套模型的边界,决定了它最适合怎样使用
它最适合生成与比较长期活动统计:新地点数怎样增长、常去地点如何排序、活动尺度分布如何形成。若想模拟准确的日程、早晚高峰、路线先后、交通方式或政策后的改变,还要加入更多结构。
作者明确指出现有模型不再现短期时间顺序与相关性:例如 B 位于 A、C 之间时,人可能更倾向 A→B→C,而不是任意排列;24 小时与 7 天节律也未在基本规则里显式编码。
观测地点又是基站而非真实设施,小时级记录会漏掉短活动。模型匹配统计规律不能视为预测到某一个人的精确下一站,也不能把优先返回直接解释成对家庭或工作的心理偏好。
一句话总结
人的移动既探索又反复返回,降低的新地点发现率与按历史频率强化的返回,共同解释了几种长期标度规律;它们还不足以还原具体日程,更没有在一年数据中证明长期活动范围已经饱和。
核心来源
- Nature Physics 正文:图 1–4、模型方程、参数检验、方法与使用边界;本文四张主图均保留完整原组合。
- 官方 Supplementary Information:S1–S7,通信采样校正、解析推导、有限空间对照和日内/周内节律。本文另呈现完整补图 S5。
作者介绍
按论文发表时的署名机构及贡献声明介绍。
- Chaoming Song:美国东北大学复杂网络研究中心、Dana-Farber Cancer Institute 癌症系统生物学中心;共同第一作者,参与设计执行、数值模拟和经验数据分析。
- Tal Koren:同属上述两个中心;共同第一作者,参与设计执行、数值模拟和经验数据分析。
- Pu Wang:同属上述两个中心;共同第一作者,参与经验数据分析。
- Albert-László Barabási:上述两个中心及哈佛医学院 Brigham and Women’s Hospital 医学系;通讯作者,参与研究设计与执行。
延伸思考:相同的统计规律,能否来自不同的日常生活?
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
两个人可能具有相似的访问频率排序:一个每天按固定时间往返家与单位,另一个时刻不规律,但也总回到少数地点。若只看 Zipf 曲线,二者可能相近;若研究拥堵、碰面或暴露机会,差异就很大。
可以让两种生成器匹配同样的 S(t)、fk 和回转半径,再比较日内到访时刻、地点转移顺序与共同在场。若宏观标度相同而后面这些结果不同,就说明标度一致只是模型的一层约束。给模型增加真实行为结构时,应检查增加的结构是否改善任务所需的预测,而不只是让故事更像生活。