城市越大,平均每人的电话联系和位移会不会变多?
论文名片|Ricardo de S. Alencar、Fabiano L. Ribeiro、Horacio Samaniego、Ronaldo Menezes、Alexandre G. Evsukoff,Validating urban scaling laws through mobile phone data: analysis of Brazil’s largest cities,Computational Urban Science,2026,6:21。2025年11月14日收稿,2026年2月13日修回,2026年3月10日接受。DOI:10.1007/s43762-026-00252-x。
工作日晚上,一个人在自己最常打电话的那座基站附近又拨出一通电话。记录里有基站坐标、通话时长和两端的匿名编号,没有他实际走过的街道。把巴西人口最多的一批城市放在一起,居民数可以相差几十倍。若平均每人的联系对象和位移次数不随城市大小变化,总联系、总位移就该大致跟着人口走。城市标度律的预期更强:大城市里平均每人维持的互动更多,总互动会比人口涨得更快。巴西的地区差距很大,这个更快不一定还在。
这项研究用2013年大约一个月、31亿条主叫语音记录,在100座人口最多的城市里做了检验。更大的城市中,样本里的人均电话联系和按连续通话定义的位移,仍然比人口涨得更快。基站数量相对普查人口是超线性的,相对实际出现的电话身份则是次线性的。市政产值也更陡,但这是同一时点上的伴随关系。
先说结论
- 已推断出居住地的电话身份数,随2010年普查人口的标度指数为1.29±0.03(100座城市,对数坐标上的未加权普通最小二乘)。按这条指数,人口翻倍时电话身份的拟合水平约为2.45倍。
- 基站数相对普查人口的指数是1.11±0.06,相对这些电话身份是0.84±0.04。同一个基础设施,换掉横轴,读数从高于1变成低于1。
- 样本内累计联系次数对人口的斜率是1.49±0.03,累计位移次数是1.56±0.05。按抽样比例外推到全体居民后,总联系为1.19±0.02,总位移为1.25±0.05。外推后仍高于1,斜率比样本总和平缓。
- 2010年市政生产总值对人口的指数是1.12±0.08。方向与互动一致,标准误更大。论文没有检验联系人数是否带来产值。
差距这么大,旧的标度律还测得动吗?
城市标度律(urban scaling laws)描述一项城市指标怎样随人口变化:指标大致与人口的β次方成正比。β大于1称为超线性(superlinear),平均每人分到的量随城市变大而增加;β小于1称为次线性(sublinear),常用来描述道路、加油站一类设施的规模经济。Bettencourt等人在数据更完整的国家里看到,专利、工资等社会经济指标偏超线性,基础设施偏次线性。
本文采用的理论写法是:若一次相遇带来的产出不随城市规模改变,城市总产出就正比于人口乘以平均每人的联系数。平均联系数若也随人口上升,总产出就会超线性。葡萄牙、英国和智利的手机研究支持过“大城市里人均联系更多”,但那些国家更小,或不平等和基础设施缺口没有巴西这么极端。
巴西有5570个市镇。引言用2020年的统计做对照:圣保罗超过1200万人,约占全国生产总值的32%,约5000亿美元;人口第七的马瑙斯约220万人,产值约130亿美元。同一段把人均差距写成大约两倍。用这一段自己的数字相除,5000亿美元除以1200万人约4.2万美元,130亿美元除以220万人约0.59万美元,倍数约为七倍。后面的回归不用这组2020年美元,也不采用两倍这个说法。
回归用的城市是人口最多的100个市镇,城市就是市镇行政边界。作者的理由是:巴西不少密集建成区并没有统一的都会区边界,小市镇的行政范围又常常大于建成区,5570个市镇全放进回归会把估计冲稀。因此结果只覆盖大城市。市镇行政边界和人们每天活动连成的功能城市,是两套范围。
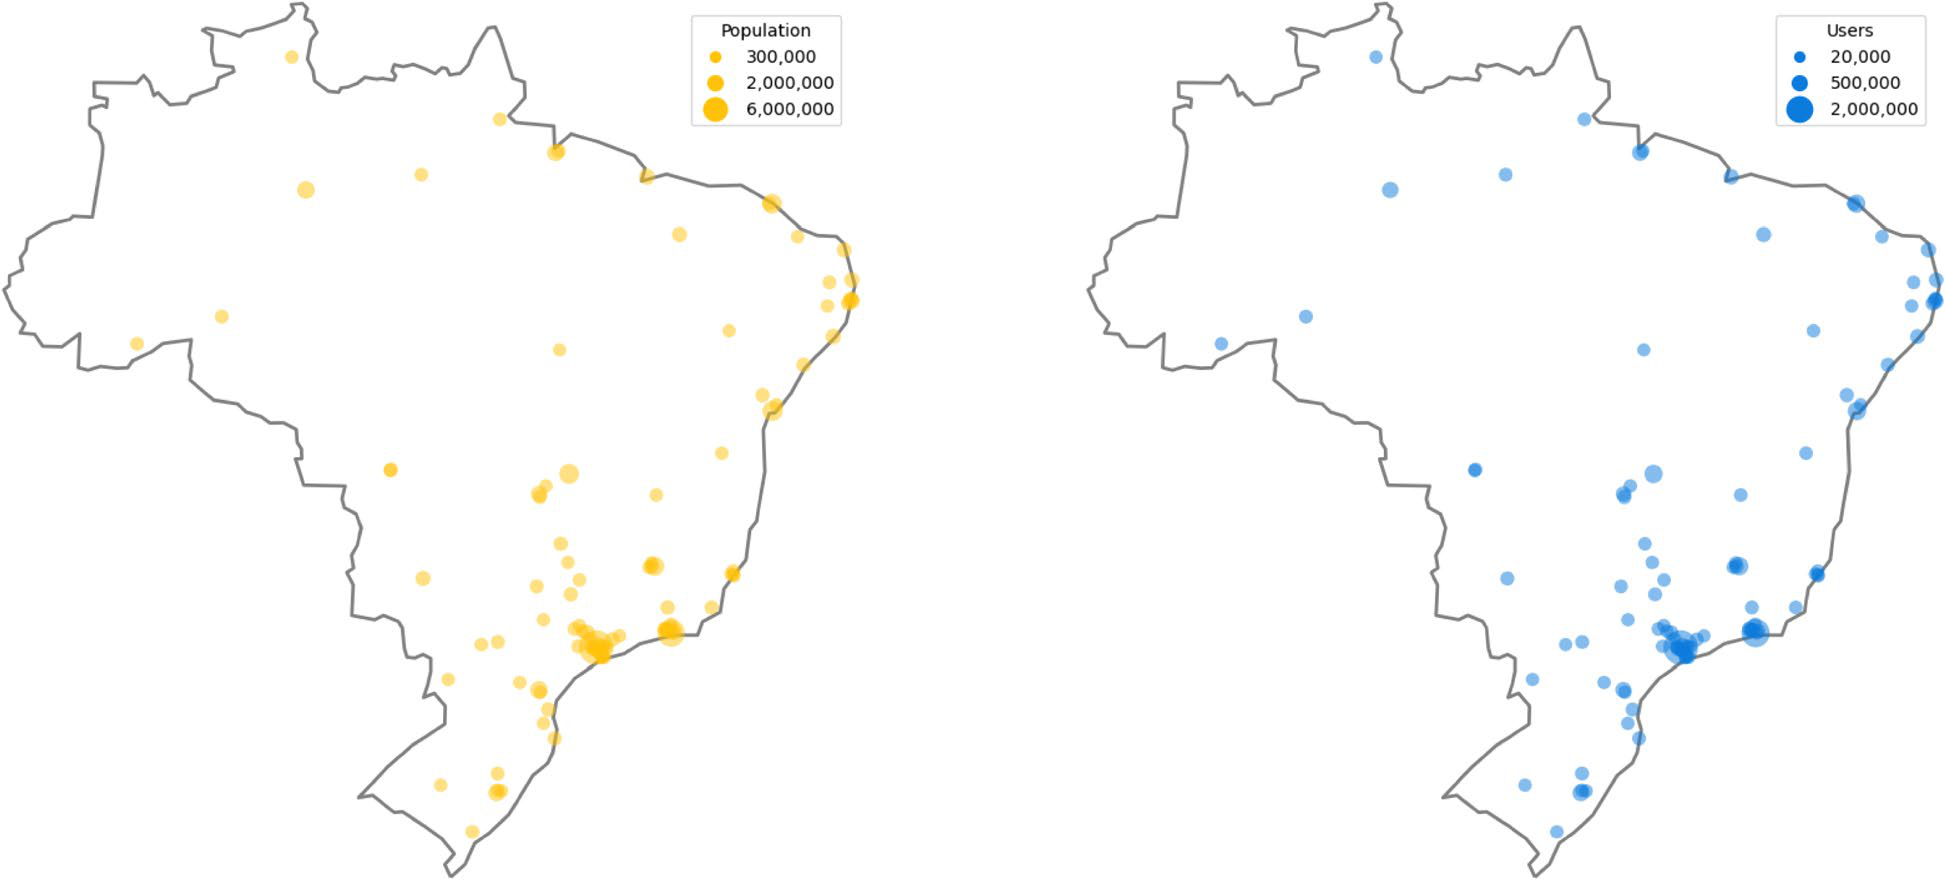
图 4|这一百座城市在国土上怎么分布?
(A)黄点大小表示2010年人口,图例三档为30万、200万、600万。(B)蓝点大小表示电话用户数,图例三档为2万、50万、200万。两张图都是东南沿海密、北部疏。随文城市表的100座城市中,东南49座、东北21座、南部14座、北部9座、中西部7座。来源:原论文 Fig. 4。
一条主叫记录,怎样变成联系或一次位移?
数据来自一家全国性运营商,合同不允许点名,也不允许公布各城市的市场份额。正文写的时段是2013年3月13日至4月13日;附录A写的是2013年3月21日至4月19日、共30天。两处对应的都是31亿条记录。记录只有该运营商用户打出的语音,没有被叫位置、短信和上网流量。作者说明,2013年语音仍是主要沟通方式,网络电话尚未普及;当时85%的巴西城市人口使用手机。样本里大约85%是预付费卡,这是另一个85%。运营商各城市平均市场份额约20%。作者写道份额与城市大小没有系统性关系,正文没有附上这张关系图。
居住地取工作日19时至次日6时、以及周末全天通话最多的基站,并且这些时段里至少一半通话来自该基站。达不到的用户不进入后文分析。作者指出,大城市若打电话更勤,就更容易跨过一半这道门槛,用户数对人口的超线性里可能有这一部分。
联系按有向的主叫来数:观察期内i至少给j打过一次,j才算i的联系人。标度用的度数只统计同一市镇、且双方都出现在这份样本里的联系人。图1里的6个联系人是示意图。没给这家运营商打过电话的人,不会进入这个度数。
位移更窄。同一个人连续两次通话若换了基站,两座基站的直线距离大于2公里,时间间隔在30分钟到4小时之间,就记一次。距离是铁塔之间的直线,不是沿路里程。短距离步行会被漏掉。这组阈值此前在里约热内卢都会区对照过家庭出行调查;本文没有对100座城市再做一遍。只有推断出居住地的用户才计入位移。
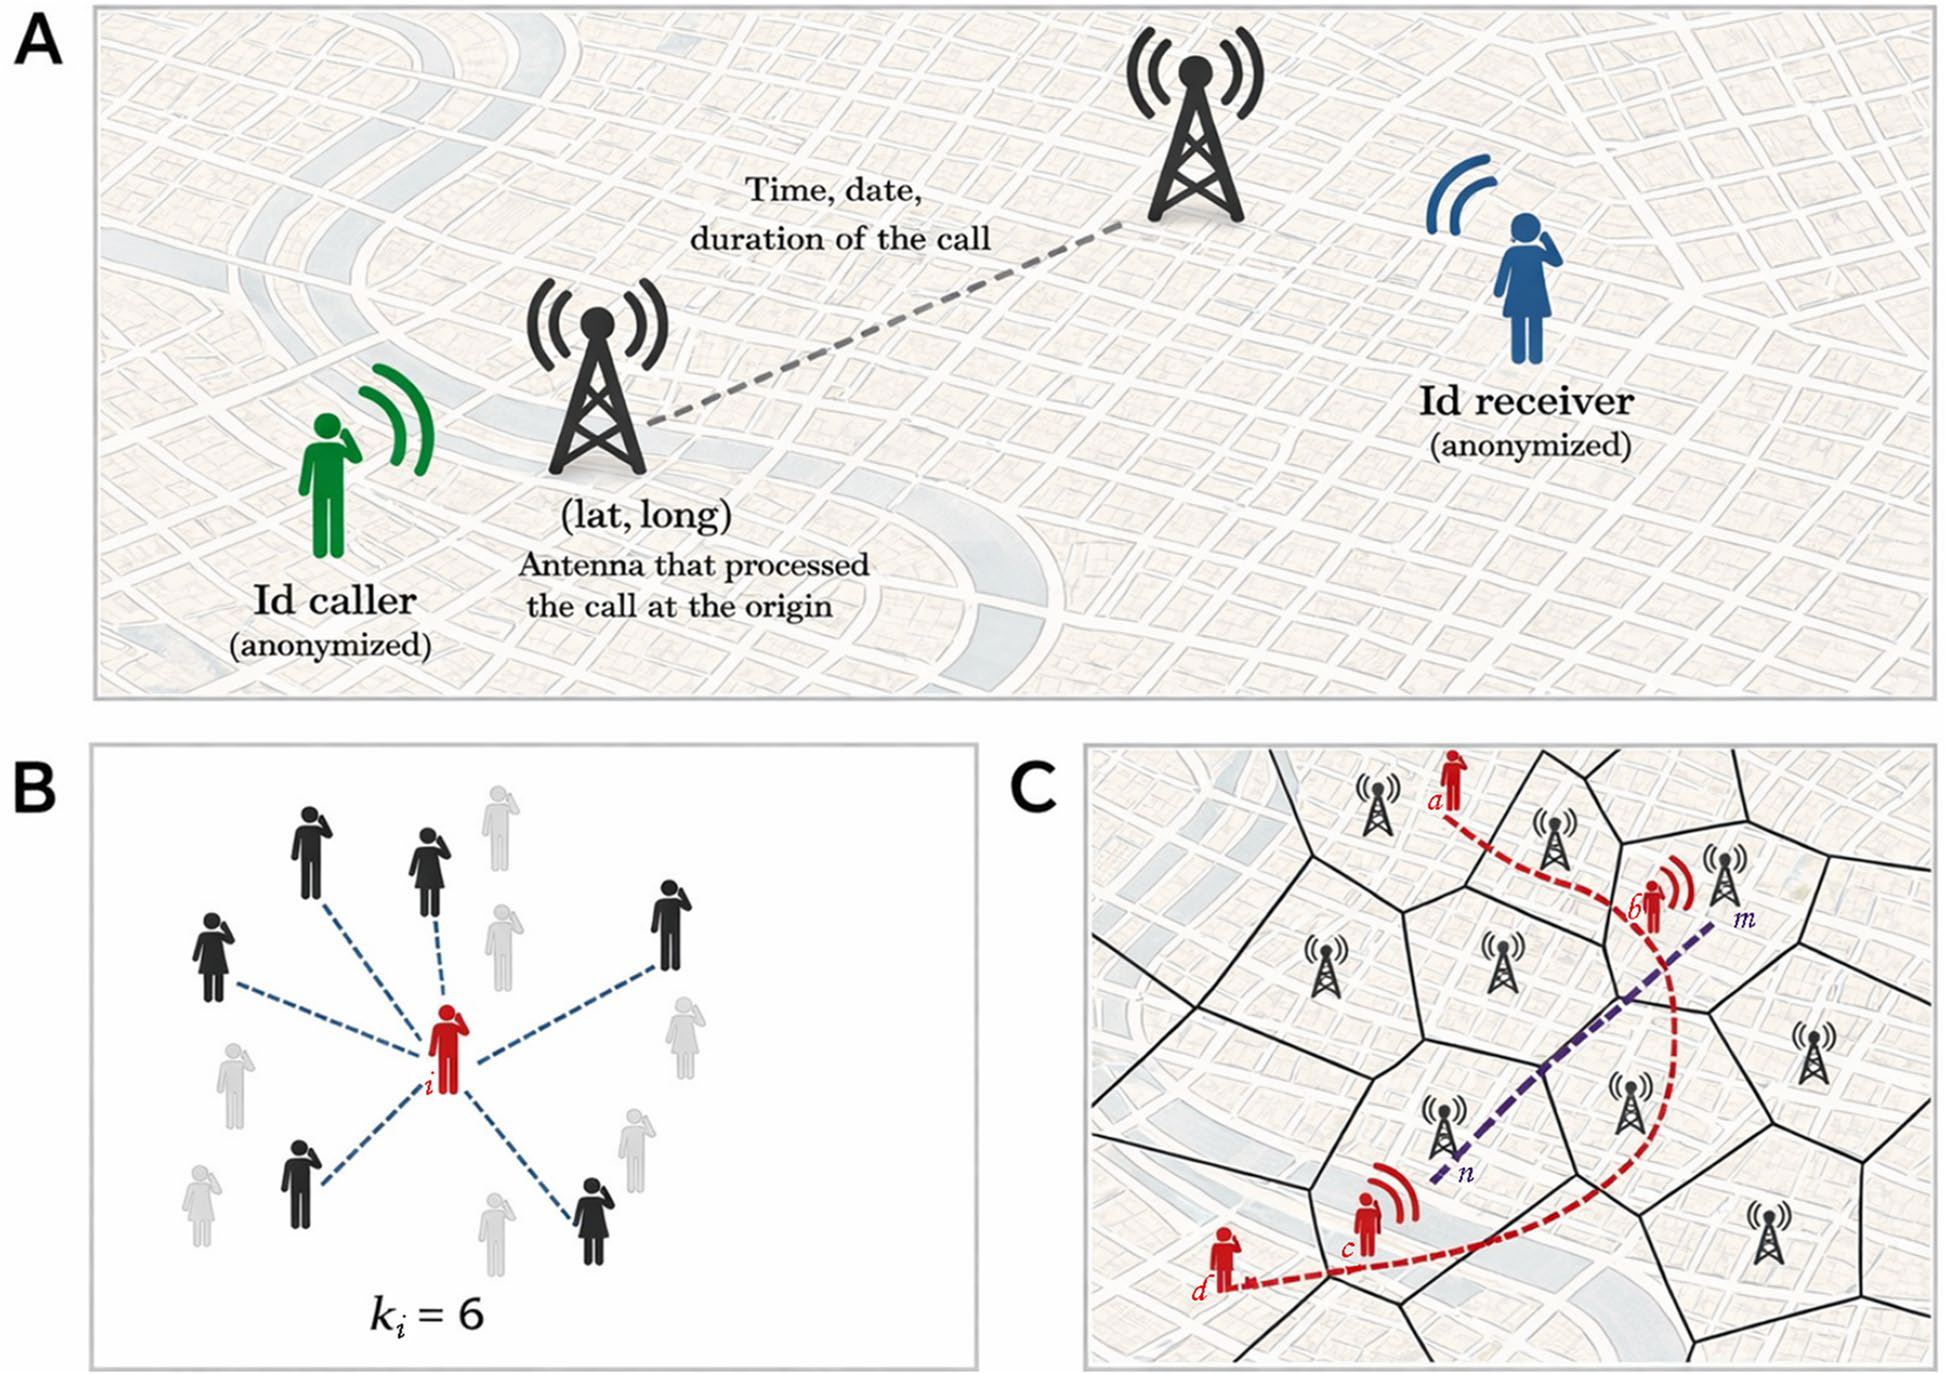
图 1|记录里实际有什么,联系和位移各按什么规则数?
(A)一次主叫留下匿名的主叫与被叫编号、时长、时间,以及处理这次通话的起点基站坐标。(B)度数是至少主叫过一次的不同人数;图中6只是示意。(C)红虚线是人真实走过、数据里看不到的路径;紫虚线是两次通话所在基站之间的直线。直线长于2公里、两次通话相隔30分钟到4小时,才记为一次位移。多边形是按基站划分的覆盖示意。来源:原论文 Fig. 1。
普查人口、电话身份和基站,各自给出哪条线?
后文的用户数U是这家运营商的电话身份,也就是SIM卡编号,不是人数。一个人可以持有多张卡。随文城市表把“在该市镇至少打过一次电话的身份”和“推断出居住地的身份”分开。与正文指数吻合的是后者。
100座城市里,2010年人口从帕尔马斯的228,332人到圣保罗的11,253,503人。推断出居住地的电话身份,从苏马雷的19,966个到圣保罗的3,125,127个。圣保罗是3,125,127除以11,253,503,约0.278。100座城市中这个比值最低的是瓦尔泽亚格兰德,20,145除以252,596,约0.080;最高的是里约热内卢,1,927,071除以6,320,446,约0.305。中位数约0.118。分母都是2010年普查人口,分子只是这一家运营商里居住地可判定的电话身份。
对数坐标上,居住地电话身份对人口的斜率是1.29±0.03,电话身份占人口的比例因而随人口的0.29±0.03次方上升。人口翻倍时,电话身份的拟合倍数是2的1.29次方,约2.45倍。这里的翻倍是同一条拟合线的比较,不是某两座城市的实测差。
基站相对人口的斜率是1.11±0.06,高于1。只看普查人口时,它和“基础设施应当次线性”的旧结果不一致。改用电话身份做横轴,斜率是0.84±0.04。表1另给两个指数之比0.86±0.05,和直接拟合的0.84接近。电话身份翻倍时,基站的拟合倍数是2的0.84次方,约1.79倍,低于按比例增加的2倍。作者提到两种可能:大城市活动更复杂,需要更多基站保证覆盖;运营商也更愿意把投资放在回报高的大城市。相对用户的次线性,则被理解成更多人共享同一座基站。这些是对读数的解释,文中没有再设对照去分开它们。
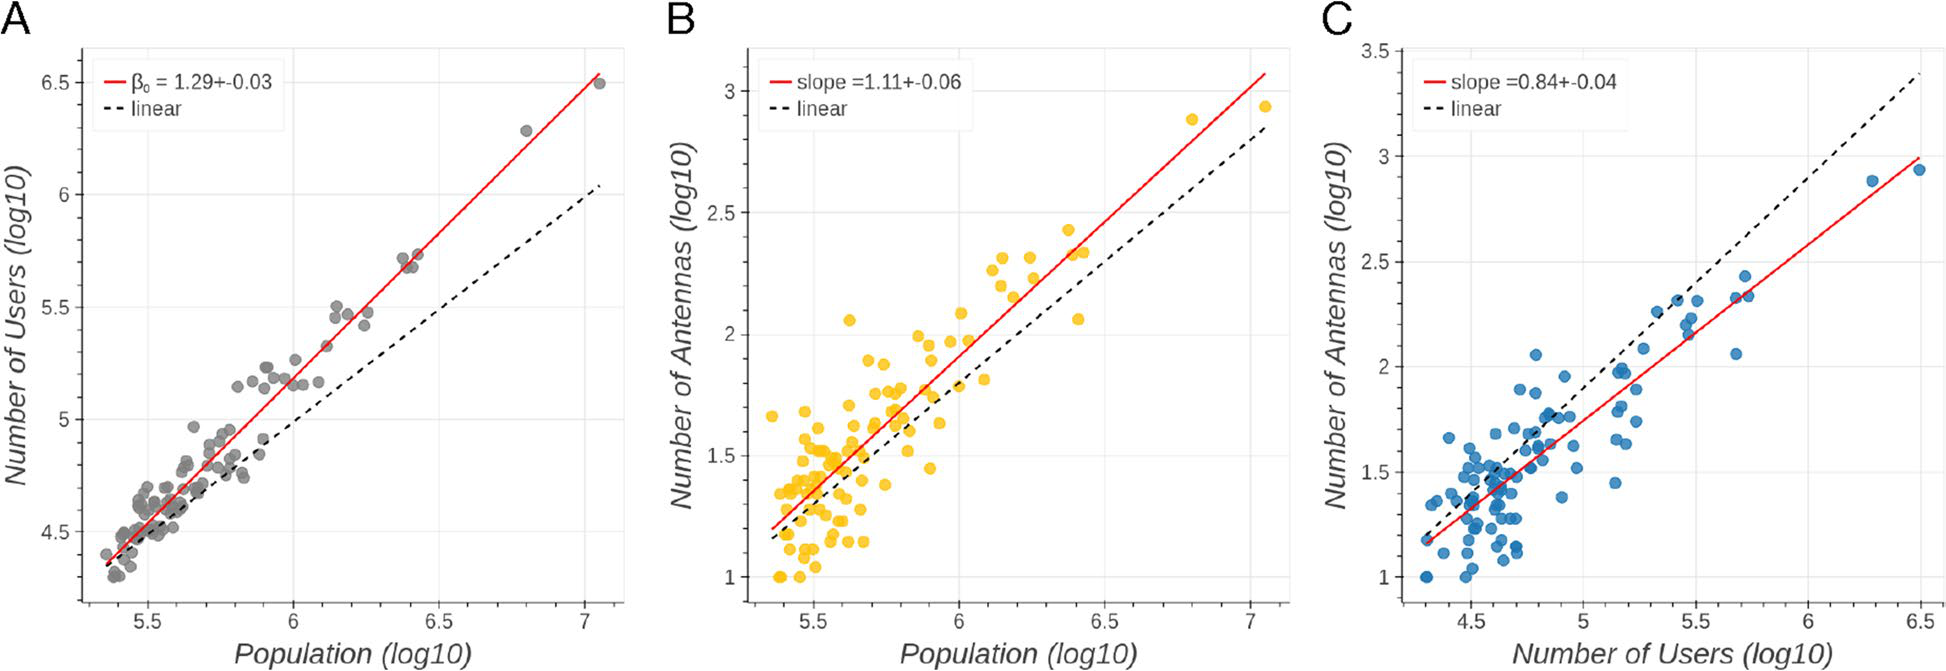
图 2|换掉横轴之后,基站的斜率为什么变了?
横轴、纵轴都是以10为底的对数。红线为拟合,黑虚线为斜率等于1的参照。(A)灰点是居住地电话身份对人口,斜率1.29±0.03。(B)黄点是基站数对人口,斜率1.11±0.06。(C)蓝点是基站数对电话身份,斜率0.84±0.04。100座城市的人口约从22.8万到1125万,居住地电话身份约从2.0万到313万。来源:原论文 Fig. 2。
作者把电话身份叫做通信意义上的有效人口:它量的是连上这家网络的身份有多少,不是名册上的居民有多少。用居民数做横轴,基站高于线性;用电话身份做横轴,基站低于线性,和基础设施的规模经济同向。他们同时写明,只有一家运营商时,1.29未必在所有运营商合并之后仍然存在。保留这一结果的依据,是市场份额据说不随城市大小系统性变化。
产值也更陡,但离线性更近
2010年市政生产总值对2010年人口的斜率是1.12±0.08。数据说明只写这是2010年IBGE的市政生产总值,图上没有印货币单位。点的纵向散布比电话身份那张图宽。1.12减去两倍标准误约到0.96,所以“产值超线性”比“电话身份超线性”弱:后者1.29±0.03,减去两倍标准误仍约为1.23。这张图与互动增多同向,不能单独说明产值高是因为电话打得多。论文没有把生产总值对联系人数做回归。理论公式里,每次相遇的产出被设成不随规模变化,这个假设也没有单独检验。
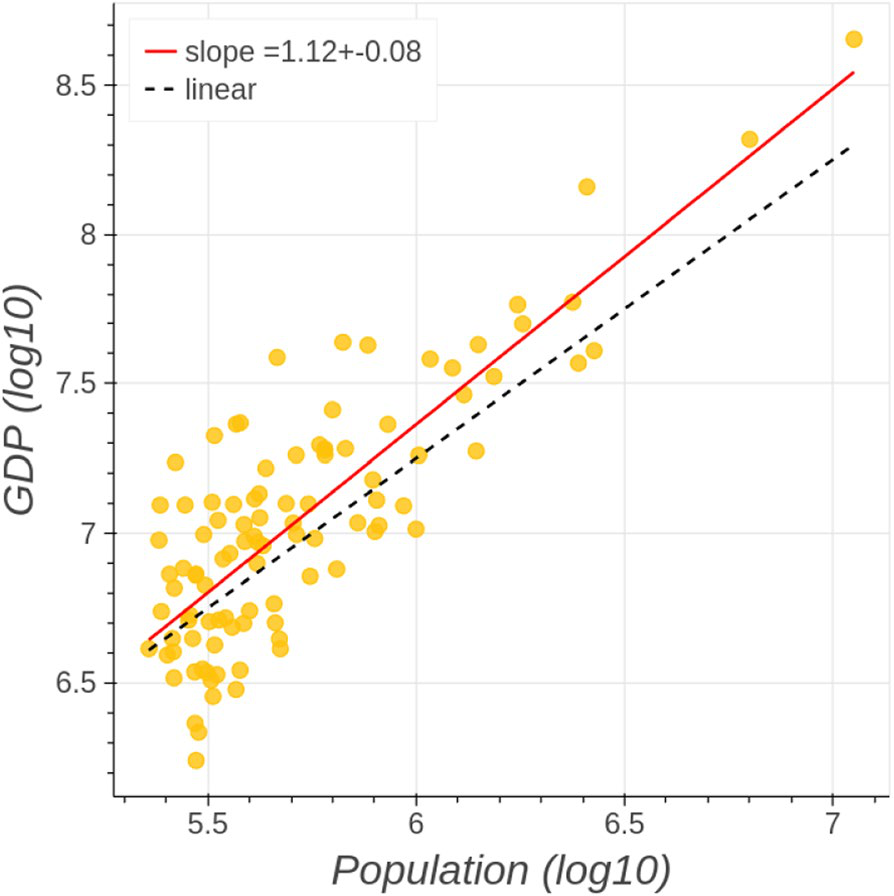
图 5|产值随人口上升的陡度有多大?
黄点是100座城市的2010年市政生产总值对2010年人口,两轴都是以10为底的对数。红线斜率1.12±0.08,黑虚线斜率为1。纵轴没有印出货币单位。来源:原论文 Fig. 5。
样本总和很陡,外推到全体居民之后还剩多少?
图3画的是样本内部的总和,不是外推后的全市总量。累计联系次数对人口的斜率是1.49±0.03,对电话身份是1.15±0.01。累计位移次数对人口是1.56±0.05,对电话身份是1.19±0.04。样本总和更陡,有一个直接的算术原因:大城市贡献的电话身份占比本身更高。把样本总和当成全市互动,会把“样本变大”和“每个人联络更多”叠在一起。
外推假定一个人的平均联系数、平均位移次数,不因有没有被这家运营商抽中而明显改变。全市累计联系就约等于人口除以样本人数、再乘样本累计联系。代入电话身份随人口的1.29次方、样本平均联系数随电话身份的0.15次方,指数变成1加1.29乘0.15,约1.19。表1记为1.19±0.02,并写明这个全市总量不能在数据里直接点出来。位移同样处理:样本人均位移对电话身份的指数是0.19±0.04,外推后全市总位移对人口的指数是1.25±0.05。样本联系总和的1.49,减去电话身份比人口多涨出来的大约0.29,就回到1.2附近。外推把斜率拉低了,没有拉到1以下。
图3(D)上的1.19,是样本位移总次数对电话身份的斜率。表1里的另一个1.19,是外推后全市联系总次数对人口的指数。两个1.19各有自己的定义。
正文用圣保罗和贝伦做直观对照:圣保罗的人口量级是一千万,平均大约10个电话联系;贝伦约130万人,大约7个。城市表中的对应数字是:圣保罗2010年人口11,253,503,平均联系9.60;贝伦1,393,399人,平均联系6.92。9.60除以6.92约1.39,人口之比约8.08。分母是该市样本里已推断居住地的电话身份,不是全体居民的通讯录。
讨论里另有一个十倍人口的换算:1000万人口的城市相对100万人口的城市,人均联系大约多50%到55%,人均位移大约多70%到80%。所用的人均指数是0.19和0.25,即1.19减1、1.25减1。10的0.19次方约1.55,10的0.25次方约1.78。这是指数换算,不是两座实测城市的差。直接把样本平均联系数对人口拟合,斜率是0.20±0.01,与0.19相差在一个标准误量级。
位移的绝对量也要连着定义读。圣保罗样本共713,447,056次,除以3,125,127个居住地身份,约228次;贝伦33,095,486除以284,771,约116次。观察窗大约30天时,圣保罗大约是每个电话身份每天数次,不是家庭调查里一天几次通勤。一次计数是两次通话之间的铁塔跳动。
作者认为联系指数1.19±0.02和位移指数1.25±0.05在各自标准误下难以分开;文中没有另给检验统计量。位移的标准误是0.05,1.25减去大约两个标准误可以落到1.15附近。
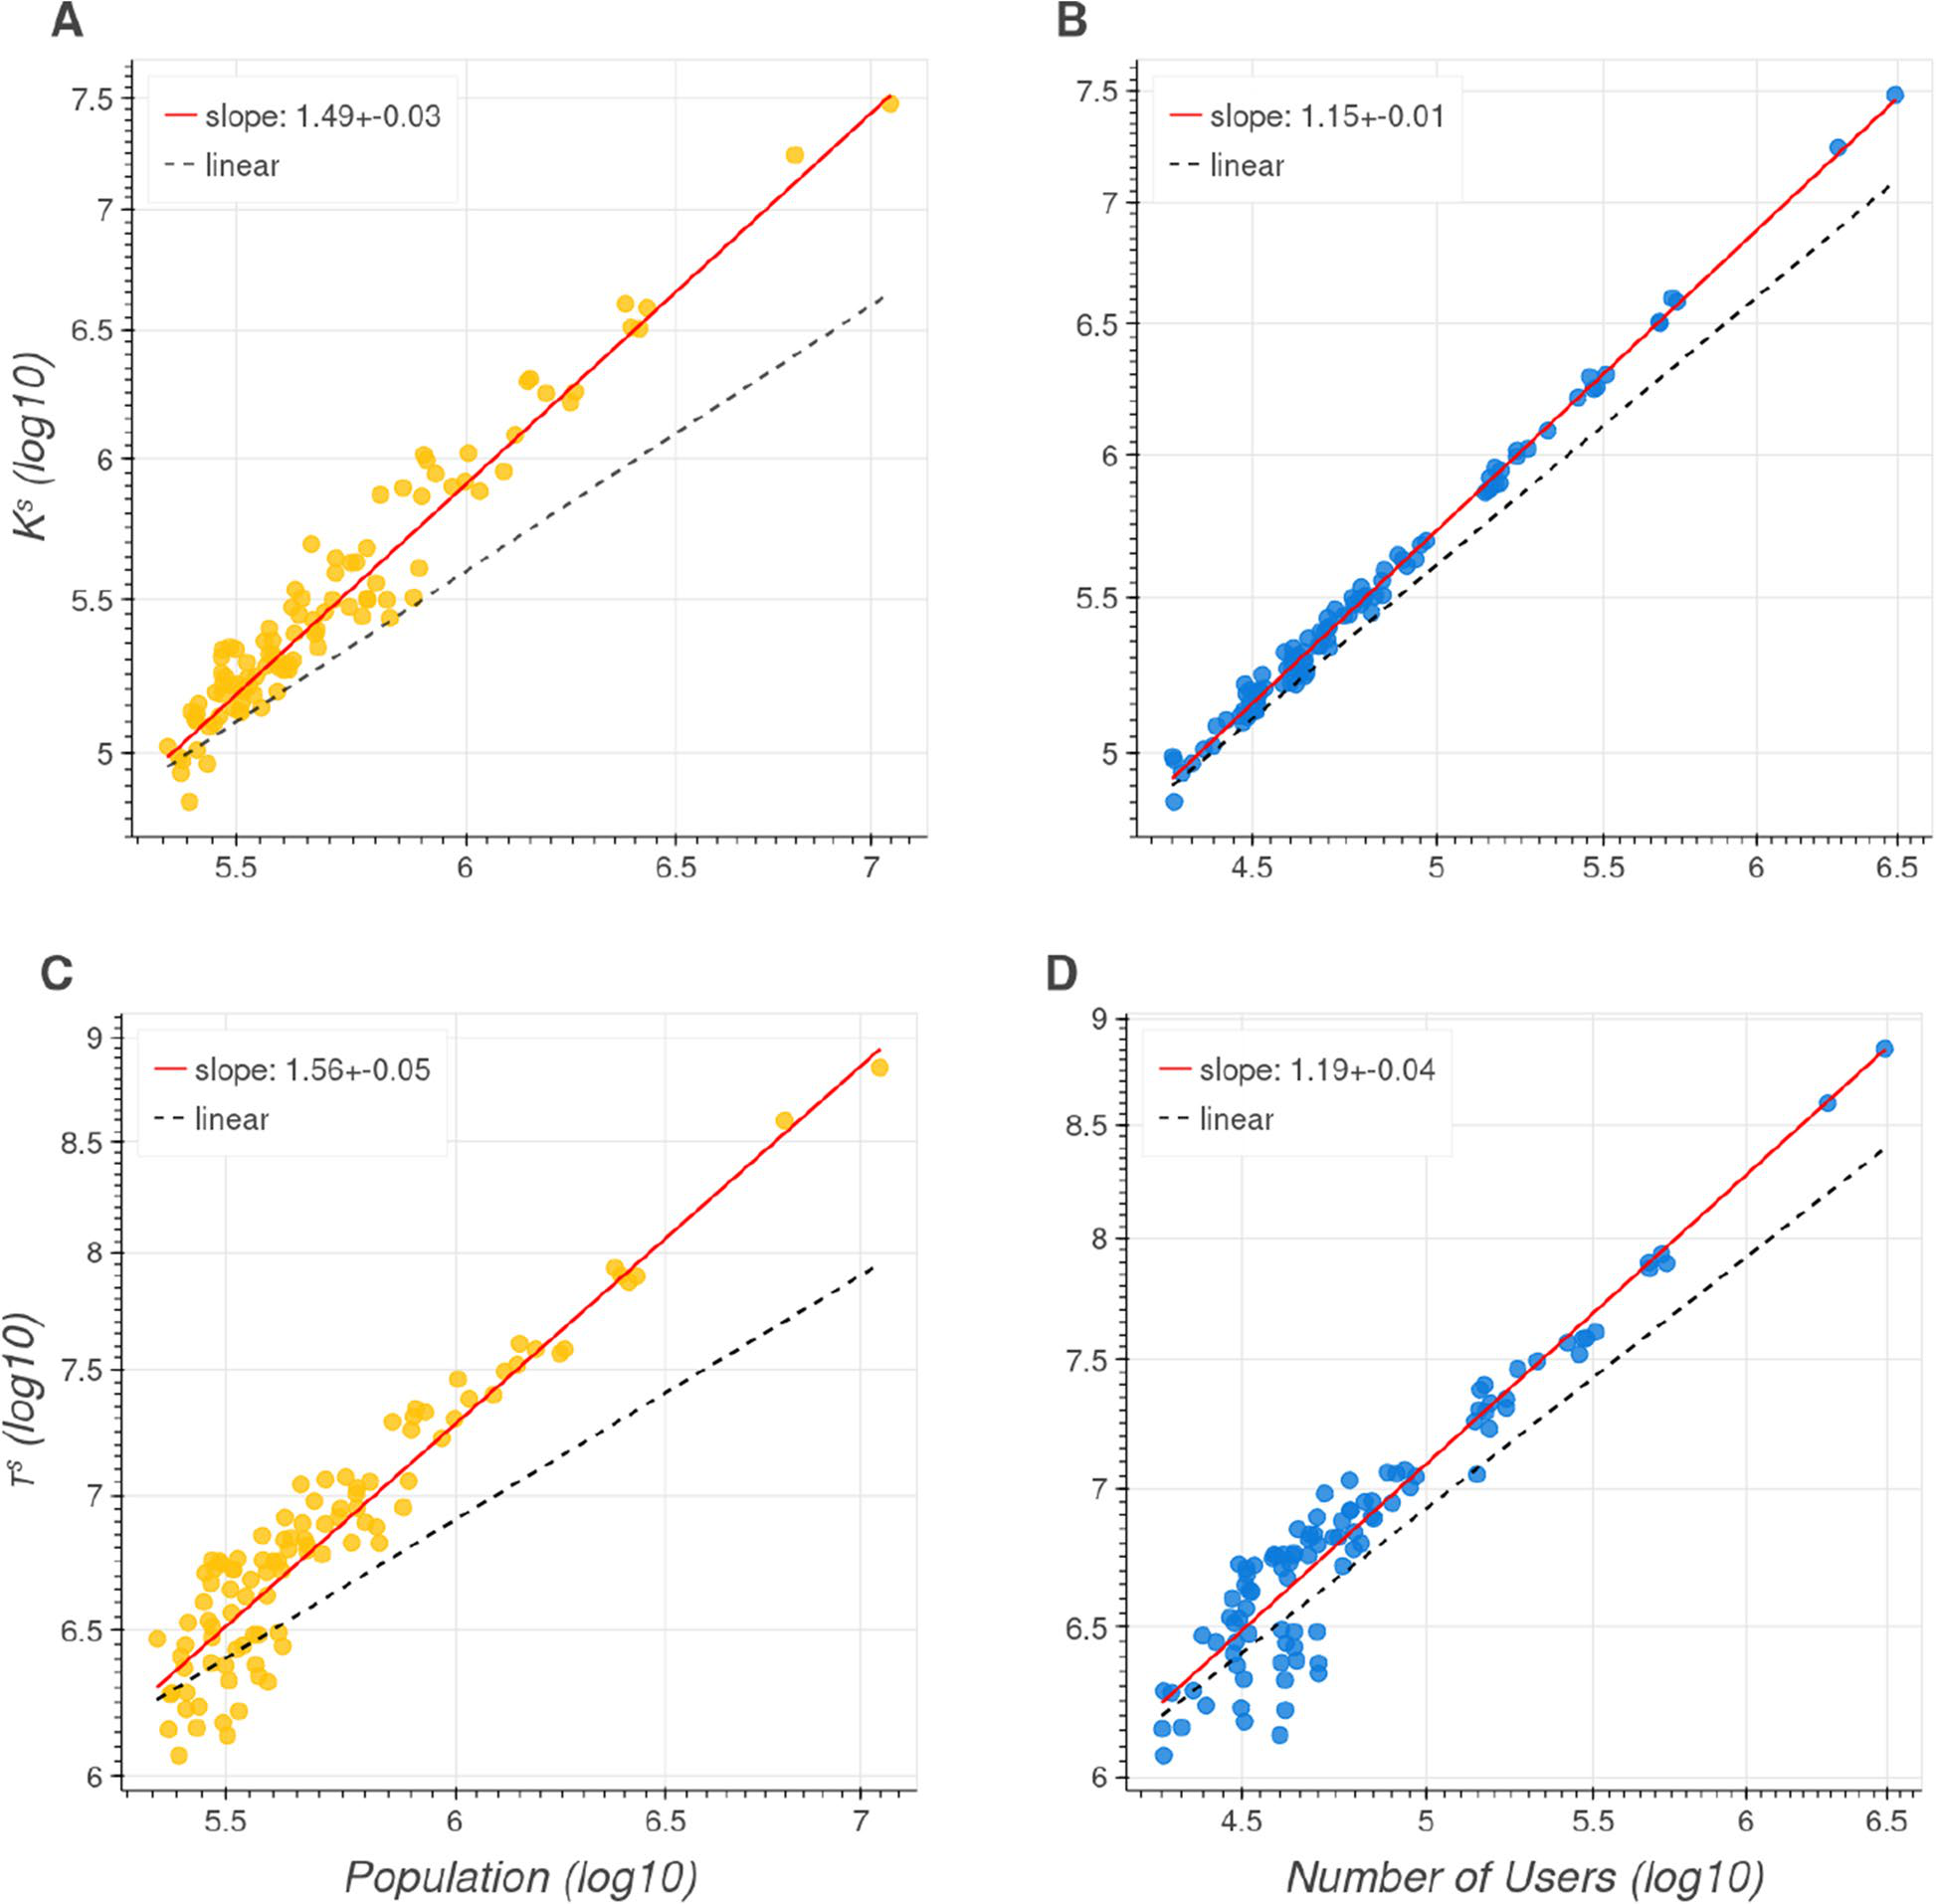
图 3|样本里的总联系、总位移,对人口和对电话身份各有多陡?
两轴都是以10为底的对数。红线为拟合,黑虚线斜率为1。黄点的横轴是人口,蓝点的横轴是电话身份。(A)样本累计联系次数对人口,斜率1.49±0.03。(B)同量对电话身份,斜率1.15±0.01。(C)样本累计位移次数对人口,斜率1.56±0.05。(D)同量对电话身份,斜率1.19±0.04。这四条都是样本内部的总和,全市外推指数1.19和1.25不在这张图的标注里。来源:原论文 Fig. 3。
平均每人多出来的联系,是不是样本太小凑出来的?
平均联系数对人口的斜率是0.20±0.01,对电话身份是0.15±0.01。1.29乘0.15约0.19,和讨论里写的人均联系随人口的0.19次方一致,也和直接拟合的0.20±0.01同向。圣保罗全样本平均联系数是9.60,图上的曲线在子样本变大后停在10附近。
同一张收敛图还画了萨尔瓦多、圣路易斯、里贝朗普雷图和帕尔马斯。城市表里的全样本平均联系数依次是7.15、5.70、5.15和4.16。帕尔马斯是这100座城市中2010年人口最少的一座,曲线仍然随子样本增大而变平。作者据此认为,在这些大城市里,样本平均度数可以代替全体居民的平均度数。他们也写明,很小的城市未必抽得到足够的人让曲线变平,所以分析从一开始就限定在这100座大城市。
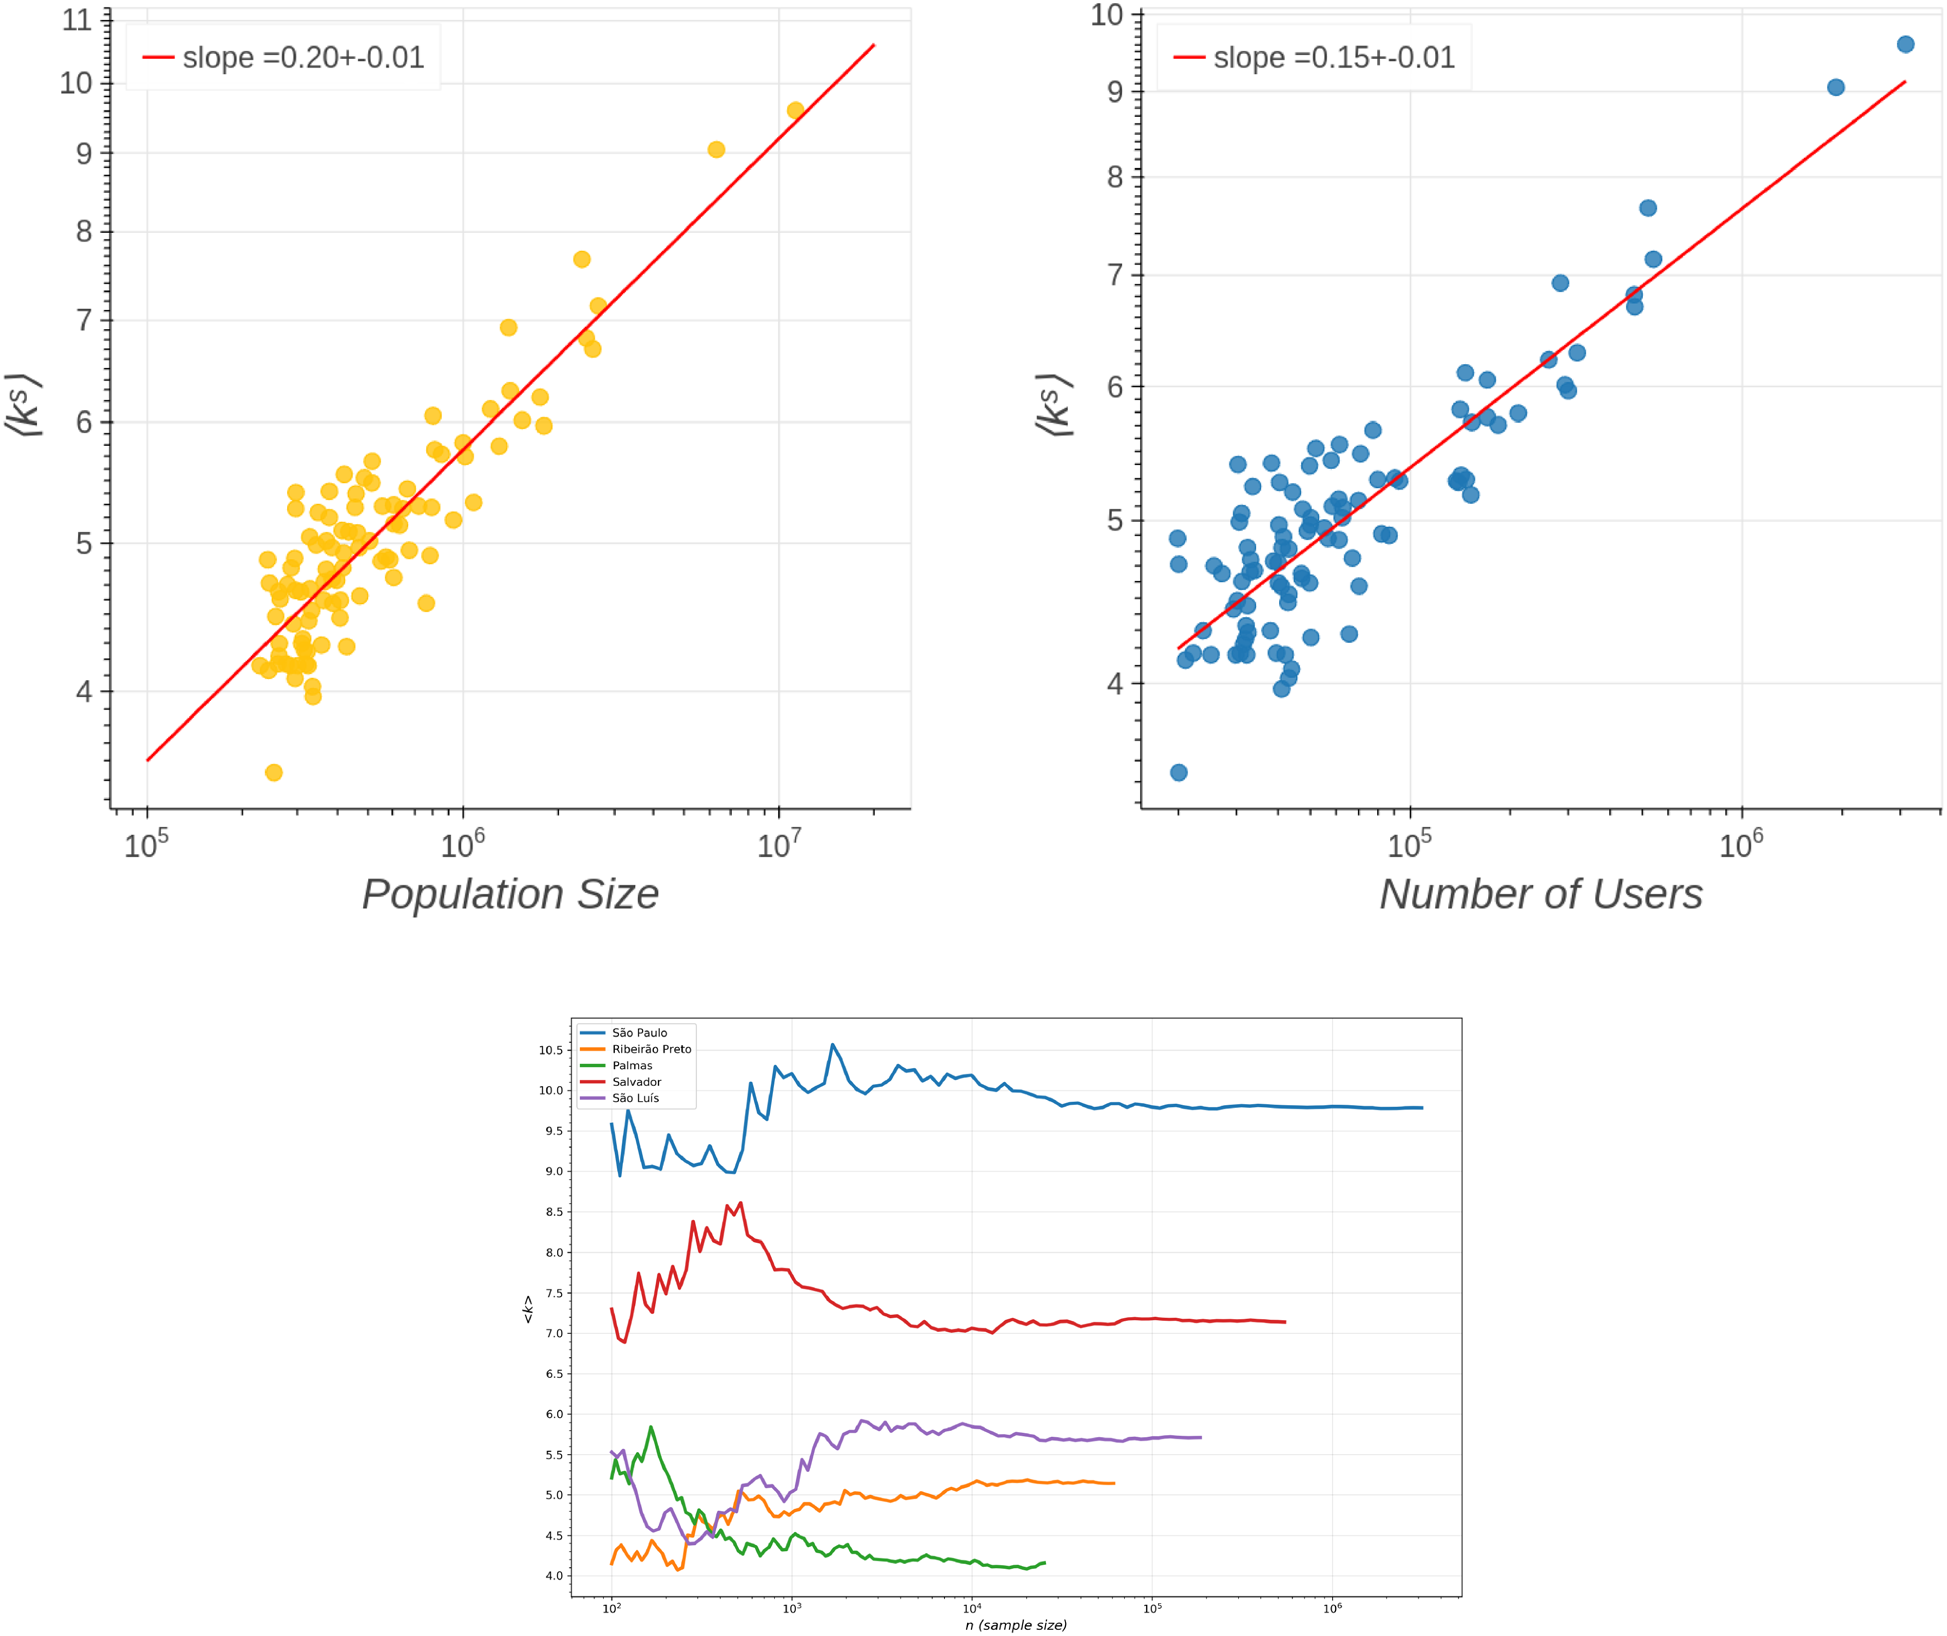
图 6|人均联系数怎样随城市变大,子样本加大后稳不稳?
(A)样本平均联系数对人口,斜率0.20±0.01。(B)同量对电话身份,斜率0.15±0.01。(C)横轴是从该市用户中抽取的子样本人数,纵轴是这个子样本的平均联系数。圣保罗、里贝朗普雷图、帕尔马斯、萨尔瓦多、圣路易斯五条线都在子样本变大后趋于平稳,圣保罗最高,帕尔马斯最低。来源:原论文 Fig. 6。
子样本变平,说明的是继续多抽这家运营商的用户,平均数不再乱跳。它没有观测到其他运营商的用户,也没有观测到很少打电话、因而进不了居住地门槛的人。
铁塔格子量的是覆盖范围
每通电话落在处理它的基站上。覆盖范围用维诺多边形近似:地面上一点划给离它最近的基站。图7选了四座人口差一个数量级以上的城市。图注给出的人口约为苏马雷24.1万、若昂佩索阿72.3万、戈亚尼亚130万、里约热内卢630万;城市表中的2010年人数是241,311、723,515、1,302,001和6,320,446。基站密的地方格子小,疏的地方一格可以很大,位置就更粗。位移距离用的是两座铁塔的直线,格子一大,同一次移动更容易被算长或算丢。被叫方在哪里,这套主叫记录给不出来。
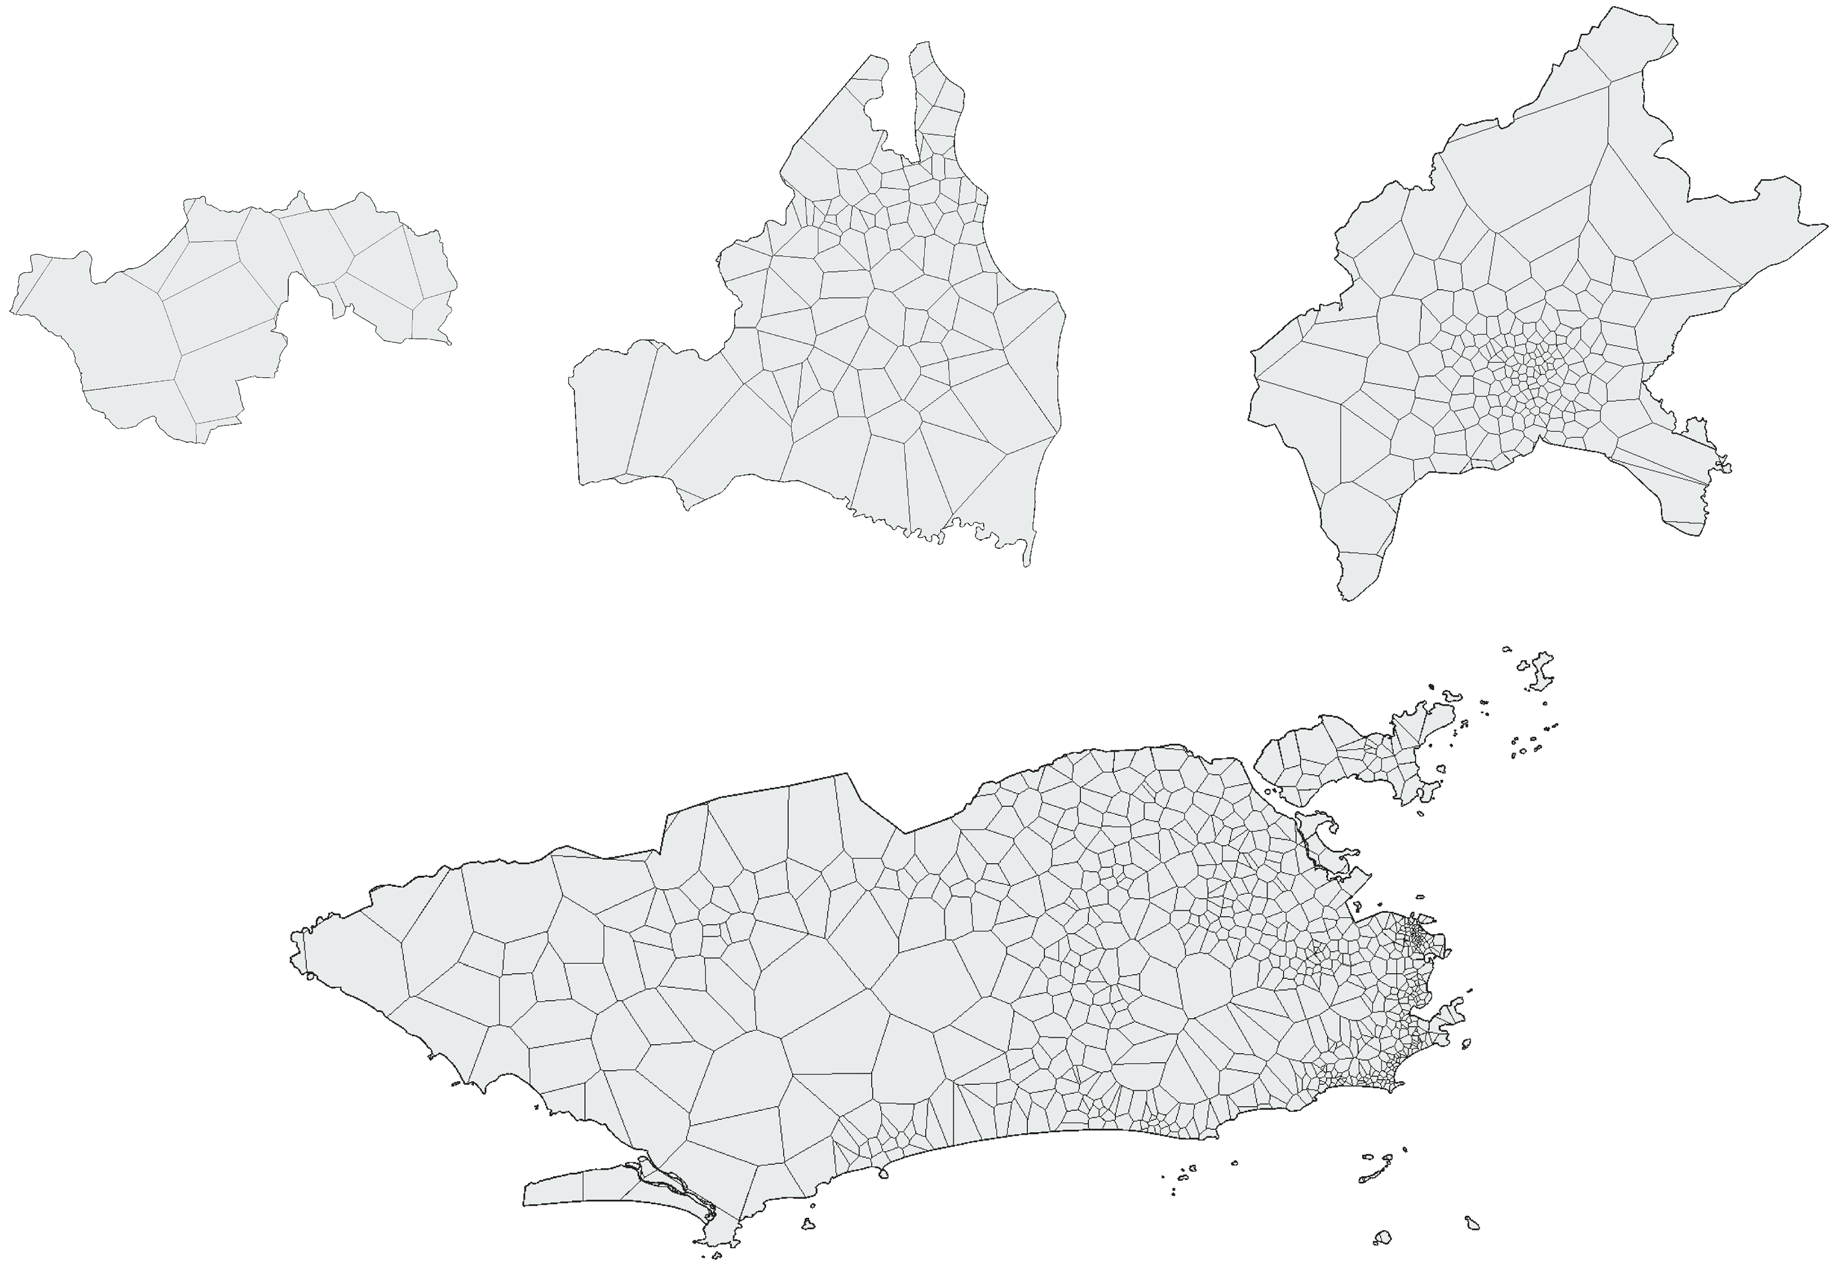
图 7|基站覆盖的粗细,在大小城市里差多少?
图内没有印面板字母。按原图说明,上排从左到右是(A)苏马雷、(B)若昂佩索阿、(C)戈亚尼亚,下排大图是(D)里约热内卢。每格是离某一基站最近的地面范围。人口更大的城市里,局部格子明显更碎,城市边缘和大片低密度区域仍然很粗。来源:原论文 Fig. 7。
这些指数停在哪一步
100座大城市的横截面上,电话联系和这种位移定义都高于线性,基站相对电话身份低于线性。读数到此为止。数据是同一时期的城市对比,分不出是互动多了才有更高产值,还是更有钱的城市打更多电话、也更常移动。
还有几道会碰到指数本身的口子。居住地规则偏向通话频繁的人,可能推高用户数对人口的斜率。外推把样本均值当成全体居民的均值;预付费卡约占样本的85%,若预付费与后付费的比例或通话习惯随城市大小变化,指数会跟着动。城市级市场份额没有公布。行程阈值漏掉短途,铁塔直线也不是路网距离,里约都会区的调查对照没有在这100座城市重复。市镇边界若改成按通勤连成的功能城市,人口和联系会重新归组,指数可能移动,本文没有做这组对照。回归是100个点的未加权对数最小二乘,正文没有报告拟合优度。生产总值那条1.12±0.08,比电话身份和联系的指数更接近线性。
一句话总结
在巴西这100座人口最多的城市里,2010年人口更大的地方,这家运营商样本中的人均电话联系、以及按连续通话定义的位移,仍然比人口涨得更快;基站改按电话身份来数,则低于线性。这是同一年份城市之间的标度关系。
核心来源
- Alencar, R. de S., Ribeiro, F. L., Samaniego, H., Menezes, R., & Evsukoff, A. G. (2026). Validating urban scaling laws through mobile phone data: analysis of Brazil’s largest cities. Computational Urban Science, 6:21. https://doi.org/10.1007/s43762-026-00252-x
- 100座城市的人口、电话身份、位移、平均联系数、基站和2010年市政生产总值:https://doi.org/10.5281/zenodo.15359949
- 标度框架与人均联系:Bettencourt, L. M. A. (2013). The origins of scaling in cities. Science, 340(6139), 1438–1441;Ribeiro, F. L., & Rybski, D. (2023). Mathematical models to explain the origin of urban scaling laws. Physics Reports, 1012, 1–39.
- 手机联系随城市变大:Schläpfer, M., et al. (2014). The scaling of human interactions with city size. Journal of the Royal Society Interface, 11(98), 20130789;Samaniego, H., Franco-Cisterna, M., & Sotomayor-Gómez, B. (2020). The topology of communicating across cities of increasing sizes.
- 2公里、30分钟至4小时这组阈值的里约对照:Barboza, M. H. C., et al. (2021). Identifying human mobility patterns in the Rio de Janeiro metropolitan area using call detail records. Transportation Research Record, 2675(4), 213–221.
- 人口为IBGE 2010年人口普查。图4底图为Natural Earth,图7市镇边界为IBGE公开边界。
文中图1至图7均来自上述论文。
作者介绍
Ricardo de S. Alencar,里约热内卢联邦大学COPPE。本文第一作者,参与数据整理。论文引用的里约热内卢都会区通话记录位移识别(Barboza et al., 2021)署名中有他和Evsukoff。
Fabiano L. Ribeiro,拉夫拉斯联邦大学物理系。论文标注他与Samaniego、Menezes、Evsukoff同等贡献。本文的产出—联系公式,引用的是他与Rybski关于城市标度律数学模型的综述。
Horacio Samaniego,智利南方大学保护、生物多样性与领土研究所生态信息学实验室,以及瓦尔帕莱索复杂系统研究所。同等贡献,并参与数据整理。本文用他此前关于城市规模与通信拓扑的研究作为对照。
Ronaldo Menezes,埃克塞特大学计算机系,通讯作者,同等贡献。本文引用他参与的人类移动性综述,以及他与Prieto-Curiel关于非洲城市暴力、城市规模和地理隔离的研究。
Alexandre G. Evsukoff,里约热内卢联邦大学COPPE,同等贡献,参与数据整理。里约都会区那项位移阈值对照也有他的署名。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若按普查人口给每座城市配同一套人均通信容量,大城市会被低估。这100座城市里,居住地电话身份除以2010年人口,低的约0.080(瓦尔泽亚格兰德,20,145/252,596),高的约0.305(里约热内卢,1,927,071/6,320,446)。把里约的比例套到瓦尔泽亚格兰德,会把电话身份数估到实际值的约3.8倍(0.305/0.080)。指数1.29描述的是拟合线,各城点在图2里仍有可见的离散。
基站监管若只除以居民数,大城市看起来基站偏多;若除以实际电话身份,同样的基站数变成低于线性,读成规模经济。一份评估报告选错分母,结论会从“超配”变成“共享得更充分”。论文没有说哪一个分母才是投资决策该用的那个。
1.25也不宜直接当成通勤需求的增长率。圣保罗样本是713,447,056次位移除以3,125,127个身份,约228次,观察窗大约一个月。一次公交车上相隔40分钟、基站直线距离超过2公里的两通电话,就会记一次;很少打电话的人则整月都不会出现。把这个指数写成“大城市通勤超比例增长”,跨过了定义。
还有一个论文点名、但没有测量的反例。圣保罗的功能城市若把周边、本身也在这100座里的市镇并进去,人口、电话身份和联系会重新加总,100个点变成更少的点,指数可以移动。在并市计算做出来之前,行政边界上的1.19只属于这100个市镇。
另一项尚未做的检验是:把其他运营商和没有手机的人补进分母之后,人均联系还会不会随人口上升。眼下的超线性,量的是2013年这一家、以预付费为主的网络里,能够判定居住地的电话身份。