一个人有多容易被预测,答案会随星期几和去哪里而改变吗?
论文名片|Bibandhan Poudyal、Diogo Pacheco、Marcos Oliveira、Zexun Chen、Hugo S. Barbosa、Ronaldo Menezes、Gourab Ghoshal,Dynamic predictability and activity-location contexts in human mobility,Royal Society Open Science,2024,11:240115。DOI。
星期二凌晨,一个人可能反复待在同一处;周末下午,他也许在不同餐馆、公园和朋友家之间选择。如果只给这个人一个全年平均的可预测性分数,就会把两种很不同的情境揉在一起。
这篇论文的核心主张是,把移动可预测性理解为随时间、活动强度与地点类型变化的状态。它通过三个位置签到平台发现反复出现的日周期,并用地点类型的组成估计用户之间的规律性差别。这里的可预测性来自信息熵推算的上限,仍需与已经实现的预测成绩分开。
先说结论
- 加入位置出现顺序后,整体序列的不确定性下降,可预测性上限提高;但同一个人不同星期时段的分数仍可以明显变化。
- 地点数量、回转半径和月签到频率越高的组,通常具有更低、波动更明显的时段可预测性。这是分组关联,不能当作增加一次出行的因果效果。
- 24小时是最强的总体周期,12小时有次级成分;6小时总体峰不显著,不能据此宣布发现新的独立生物节律。
- 地点类别访问组成能够解释部分可预测性差异,线性回归报告R²=0.419;它没有证明能以41.9%的准确率预测下一站,也没有用专门缺失实验验证任意缺测条件下都可靠。
平台记录和最终分析数据,有哪些差别?
研究使用Brightkite、Gowalla和Weeplaces。前两者是位置社交网络;Weeplaces允许用户上传其他平台的签到,并提供地点类别。分析单位是带用户、时间和地点标识的签到序列,不是连续GPS轨迹。某一小时没有签到,不能理解成那一小时没有活动。
正文表1给出原始库规模;补表S1另列清理后数据。两者不能混作同一个样本分母:
| 平台 | 正文原始用户数 | 正文原始签到数 | 补材处理后用户数 | 补材处理后签到数 |
|---|---|---|---|---|
| Brightkite | 58,228 | 4,491,143 | 4,401 | 2,279,147 |
| Gowalla | 107,002 | 6,405,492 | 15,874 | 4,061,522 |
| Weeplaces | 15,799 | 7,658,368 | 10,388 | 5,589,296 |
正文原库时间范围分别为2008年4月—2010年10月、2009年2月—2010年10月、2003年11月—2011年6月;补表对处理后数据另报告30、12、24个月观测期,并没有逐一给出对应起止日,不能把二者直接视为相同窗口。
补充材料说明排除缺失坐标、零点坐标及明显不合理位置,按地点ID识别地点。它没有将所有筛选步骤导致的人数变化逐级列出;尤其熵收敛部分记作S≥60门槛,正文又展示较低地点数量组,故不能把一个门槛强行解释为适用于所有图的统一分组规则。各时段实际参与估计的有效记录数,也影响稀疏时段的可靠性。
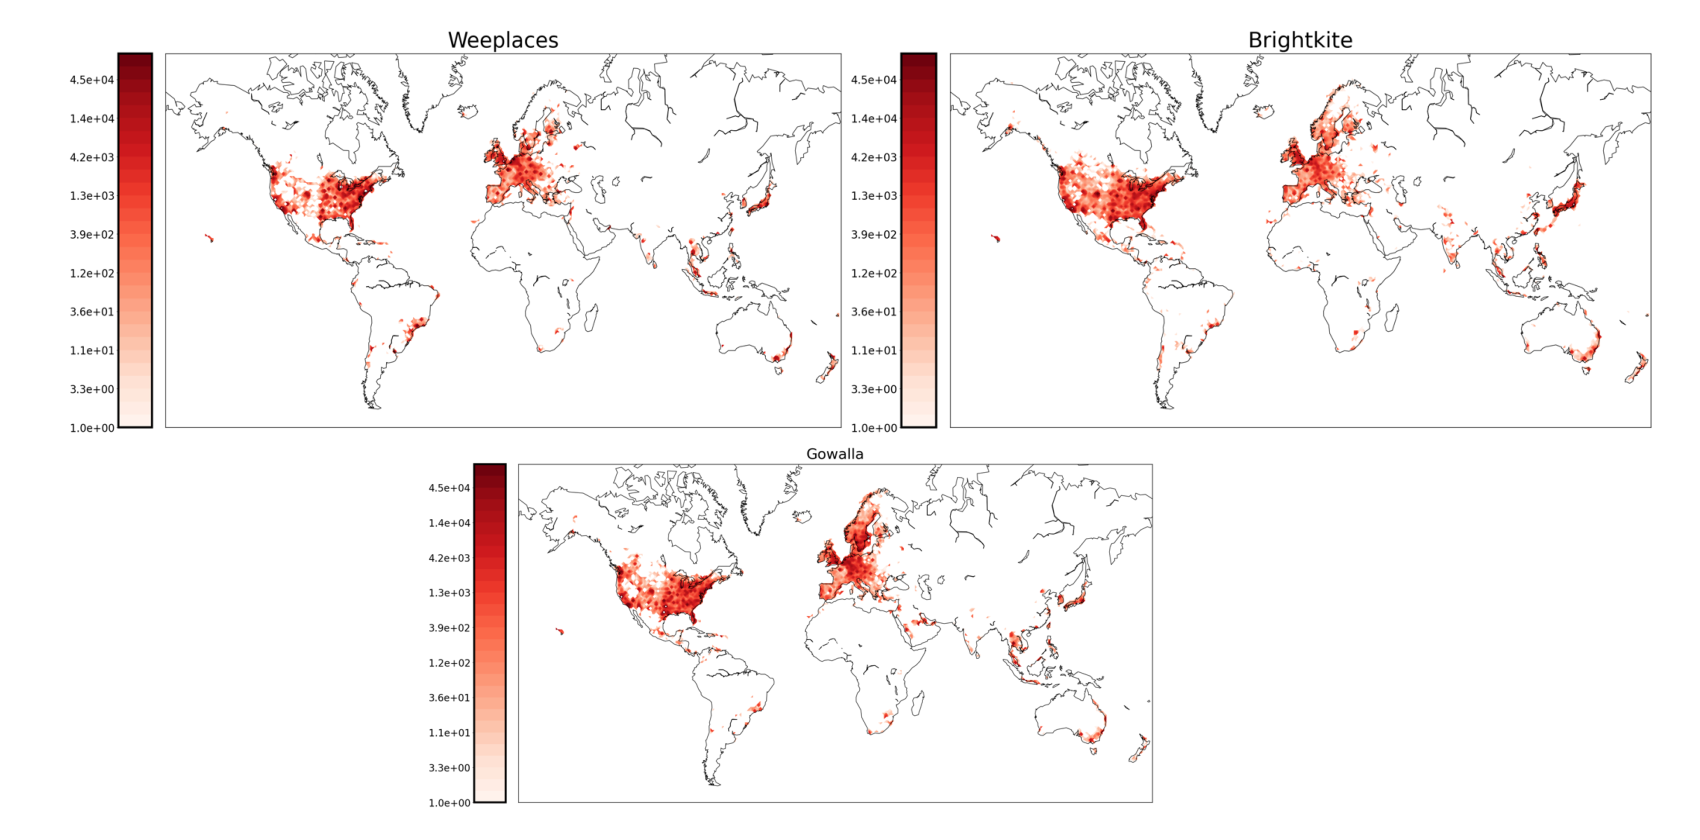
补图S2|签到数据在全球分布均匀吗?
左上Weeplaces、右上Brightkite、下方Gowalla;颜色表示50公里邻域内的签到密度。北美、西欧等区域更密集,三平台具有共同的覆盖偏差,不能因为结果跨平台相似就代表全体世界人口。来源:原论文补充 Fig.S2。
信息熵告诉我们的,是已经猜对多少次吗?
不考虑顺序的熵H_u,只根据每个地点在序列中出现的频率衡量不确定性。另一个熵率H_c利用Lempel–Ziv重复片段估计,考虑位置序列中的规律。例如反复出现A、B、A、B,比同样各占一半但顺序随机的序列更有可利用结构。
三个平台中,典型熵值从约6比特降到约5比特。这可以理解为等概率等效选择数大约由64降至32,不能照字面说用户实际上只可能去32个地点,也不能当作已经知道下一站。
论文用Fano关系把熵与不同地点数转换成理想预测器的可预测性上限Π。整体序列中,不考虑顺序的结果约20%,考虑顺序后约40%,这是分布的典型水平,不是所有人的统一分数,更不是论文训练某个算法达到的测试准确率。
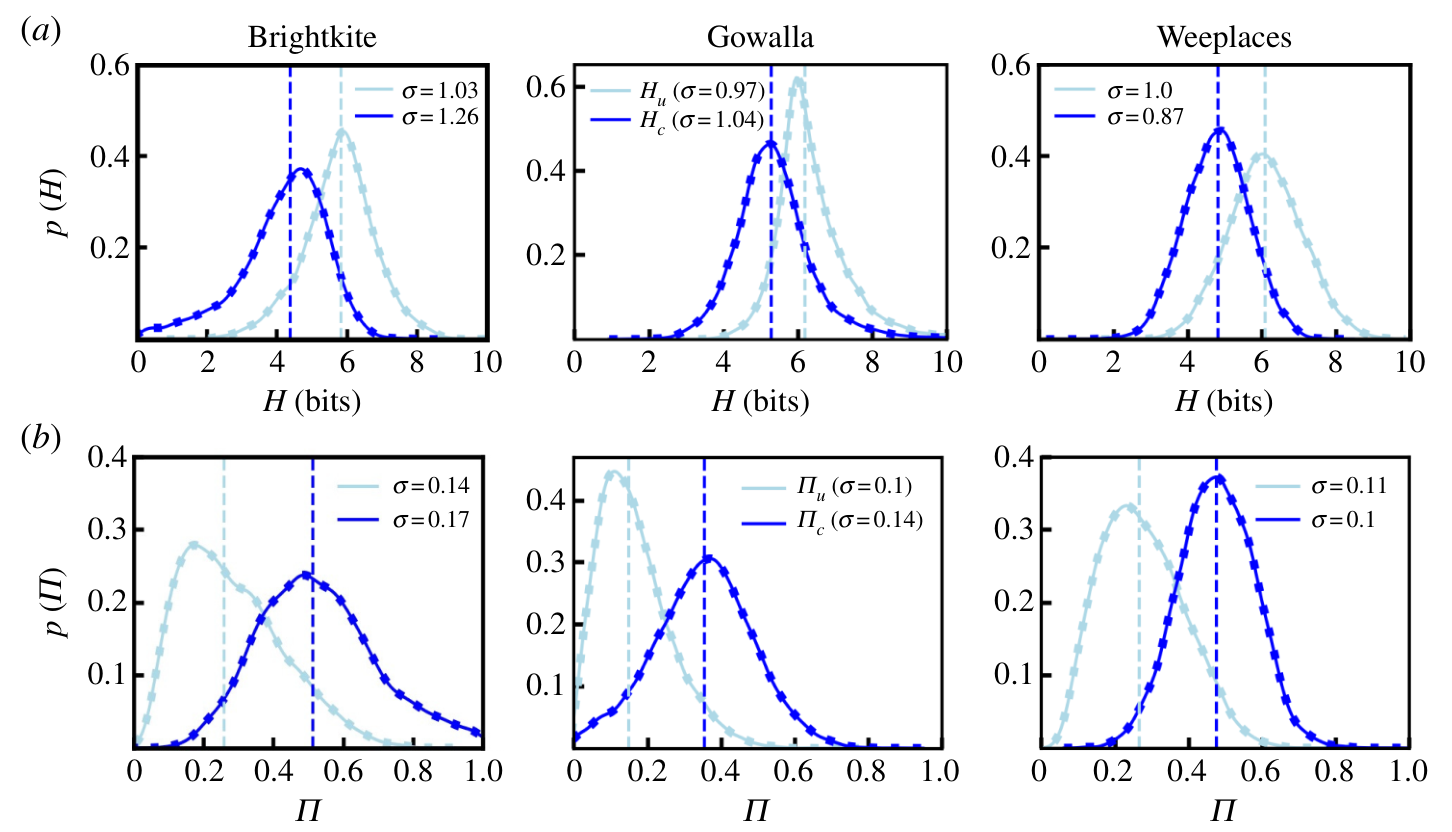
图1|知道地点的先后顺序,比只知道频率多提供多少信息?
(a)三列依次为Brightkite、Gowalla、Weeplaces,横轴为熵比特数,浅色只看频率、深色加入序列结构,纵轴为分布。(b)相同三组的可预测性上限分布,考虑顺序后整体右移。竖虚线为中位数,图例σ是用户间分布标准差,不是预测器准确率的置信区间。来源:原论文 Fig.1。
星期一傍晚的一个小时,究竟怎样拼成一条轨迹?
研究不是拿某一天只有几条签到的连续一小时,就声称精确测出这个人的规律性。它按星期与小时将记录分入168个时槽,把多周中同为星期一18—19点的签到按顺序拼起来;同一用户也会有星期二相同时段等其他时槽。补图S6对比这种拼接与整天记录的拼接。
先对每个人、每个时槽计算分数,再对相同槽的用户取平均,就得到人口层面的周内曲线。若要研究窗口长度,则进一步把每个人在各槽的分数平均成一个用户值,再比较1小时、3小时、24小时等不同分箱方案。因此时段曲线的一个点,与某种窗口下全体用户分数分布,是不同的汇总对象。
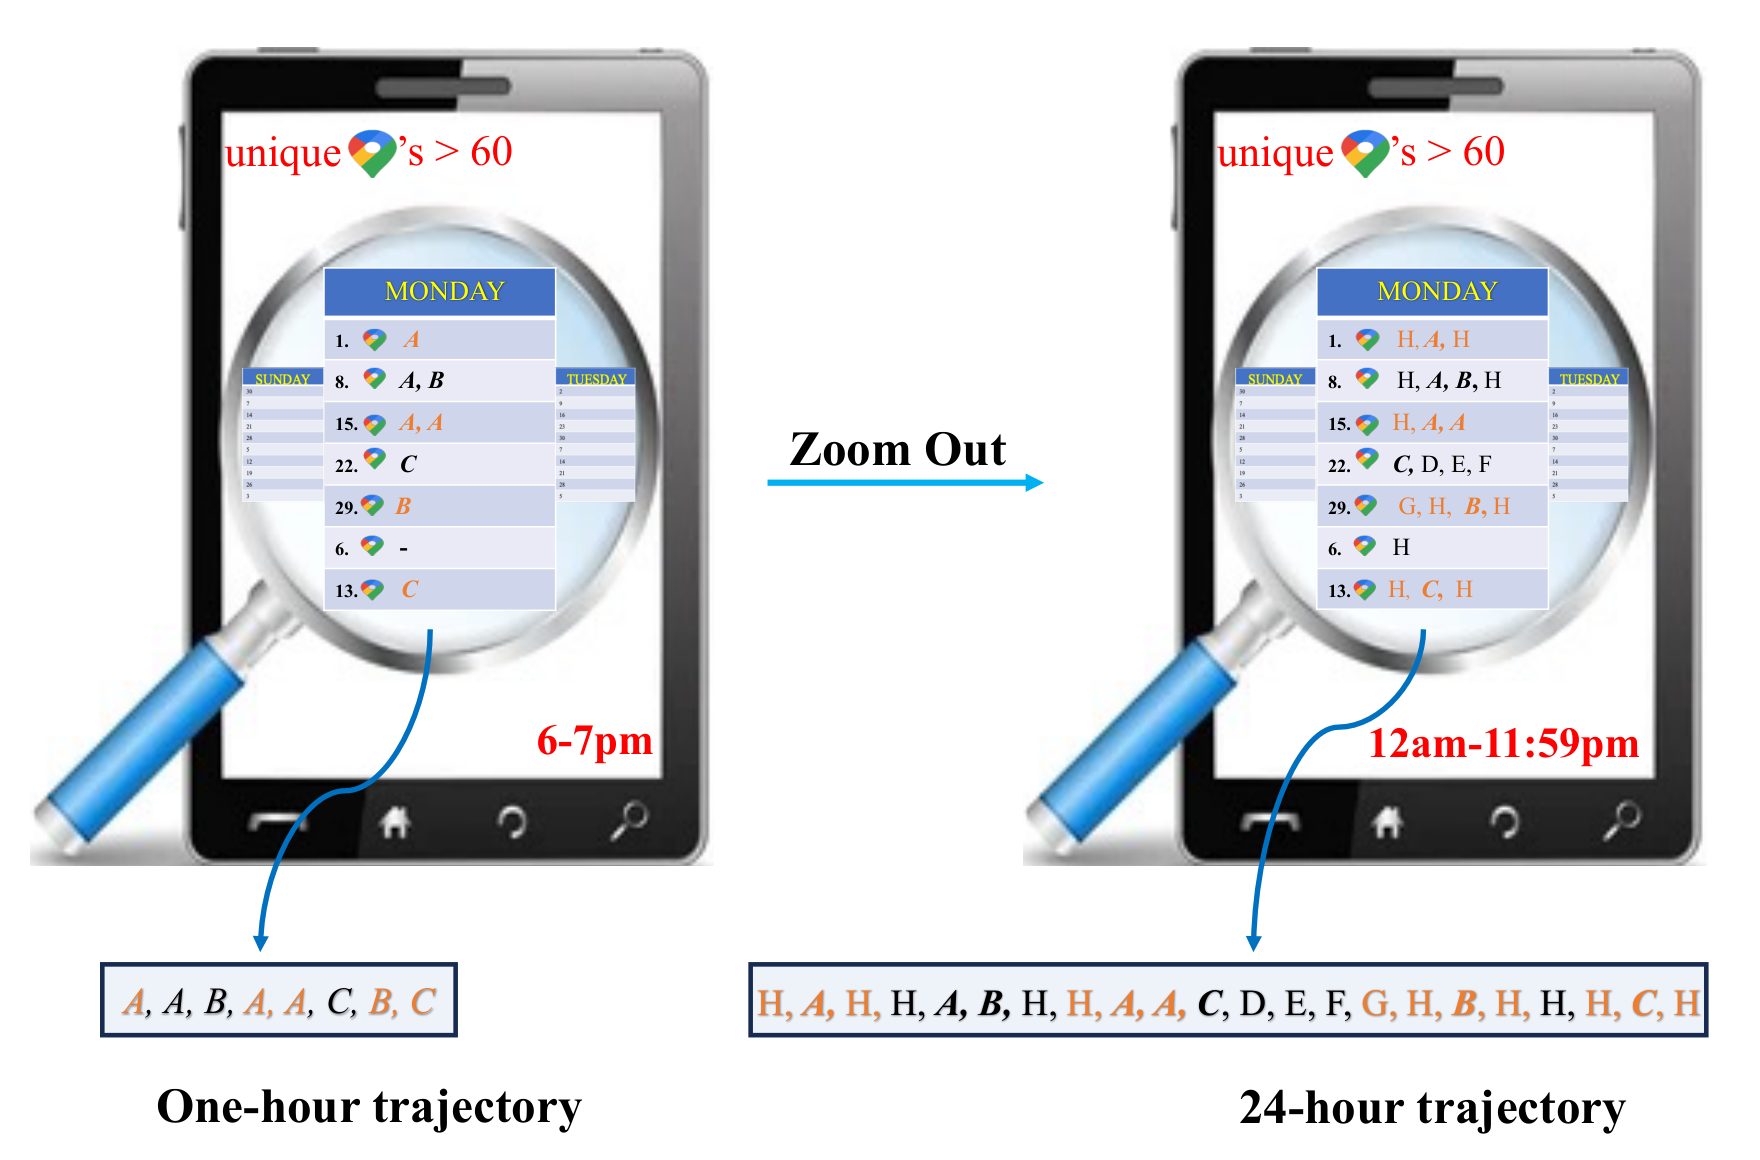
补图S6|一小时窗口与一天窗口,对应的记录有什么不同?
左侧将多个星期一18—19点的签到抽出,拼成只属于该时段的序列;右侧将多个星期一整天的签到拼起来。字母代表地点,放大强调小时序列是全天记录的子集,不是持续观测了每一分钟。原图保留左右两种构造及全部说明。来源:原论文补充 Fig.S6。
小时槽较短、序列更稀疏,正文主要使用不考虑顺序的Π_u。Weeplaces的平均曲线通常夜间较高,约4—5点附近有峰,白天较低,周末与工作日也不完全一致。许多时段的平均值约在0.5—0.85之间,不能把阴影解释为每个人都在这一区间,也不能将夜间签到规律性直接等同于已验证在家睡觉。
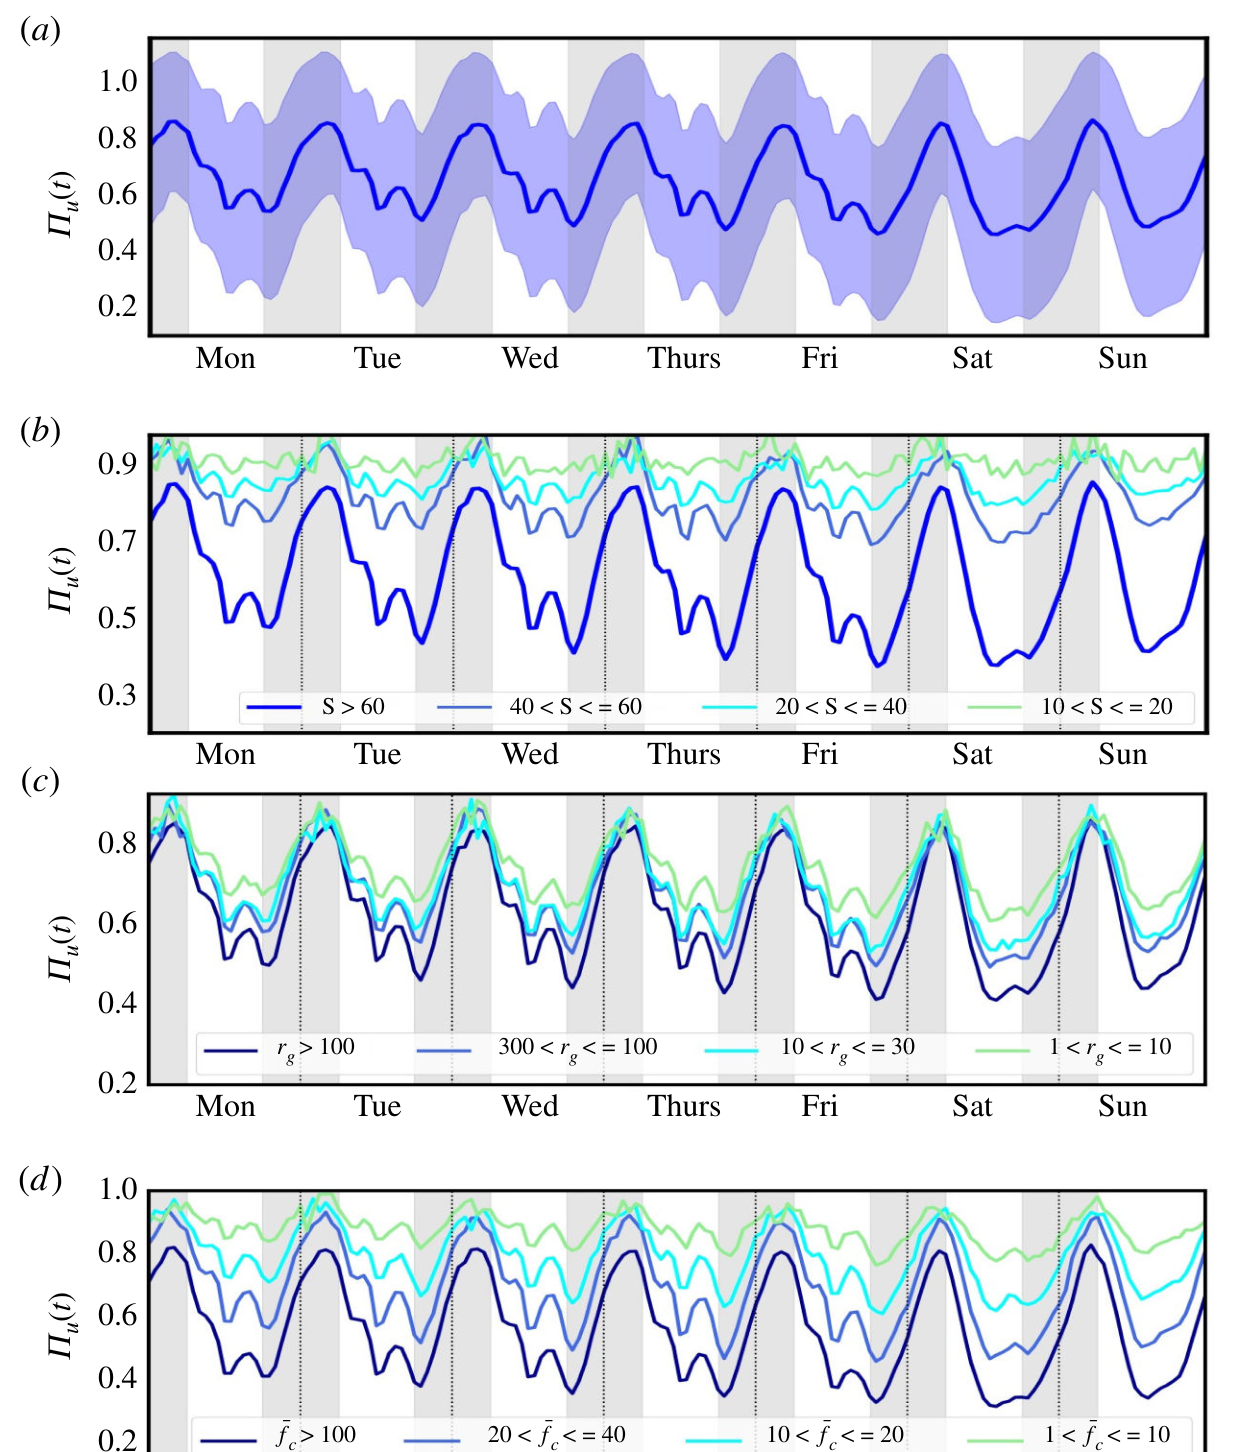
图2|可预测性会随时间与活动强度怎样变化?
(a)Weeplaces各星期小时槽的平均Π_u,阴影为用户间±一个标准差。(b)按不同地点数量S分组,地点较多者曲线通常较低、起伏更强。(c)按回转半径公里数分组,范围较大者通常较低;回转半径是到个人位置中心的离散尺度,不是离住宅最远距离。(d)按每月平均签到频率分组,记录更频繁者通常更低。各面板显示的是选定分组,不应把未绘制的区间当作无人存在。来源:原论文 Fig.2。
回转半径、地点数量与记录数量彼此相关。更积极签到的人会被观察到更多地点,因此既可能存在更丰富的真实活动,也可能有更密的报告行为。分组图没有独立改变其中一个因素来估计因果作用。
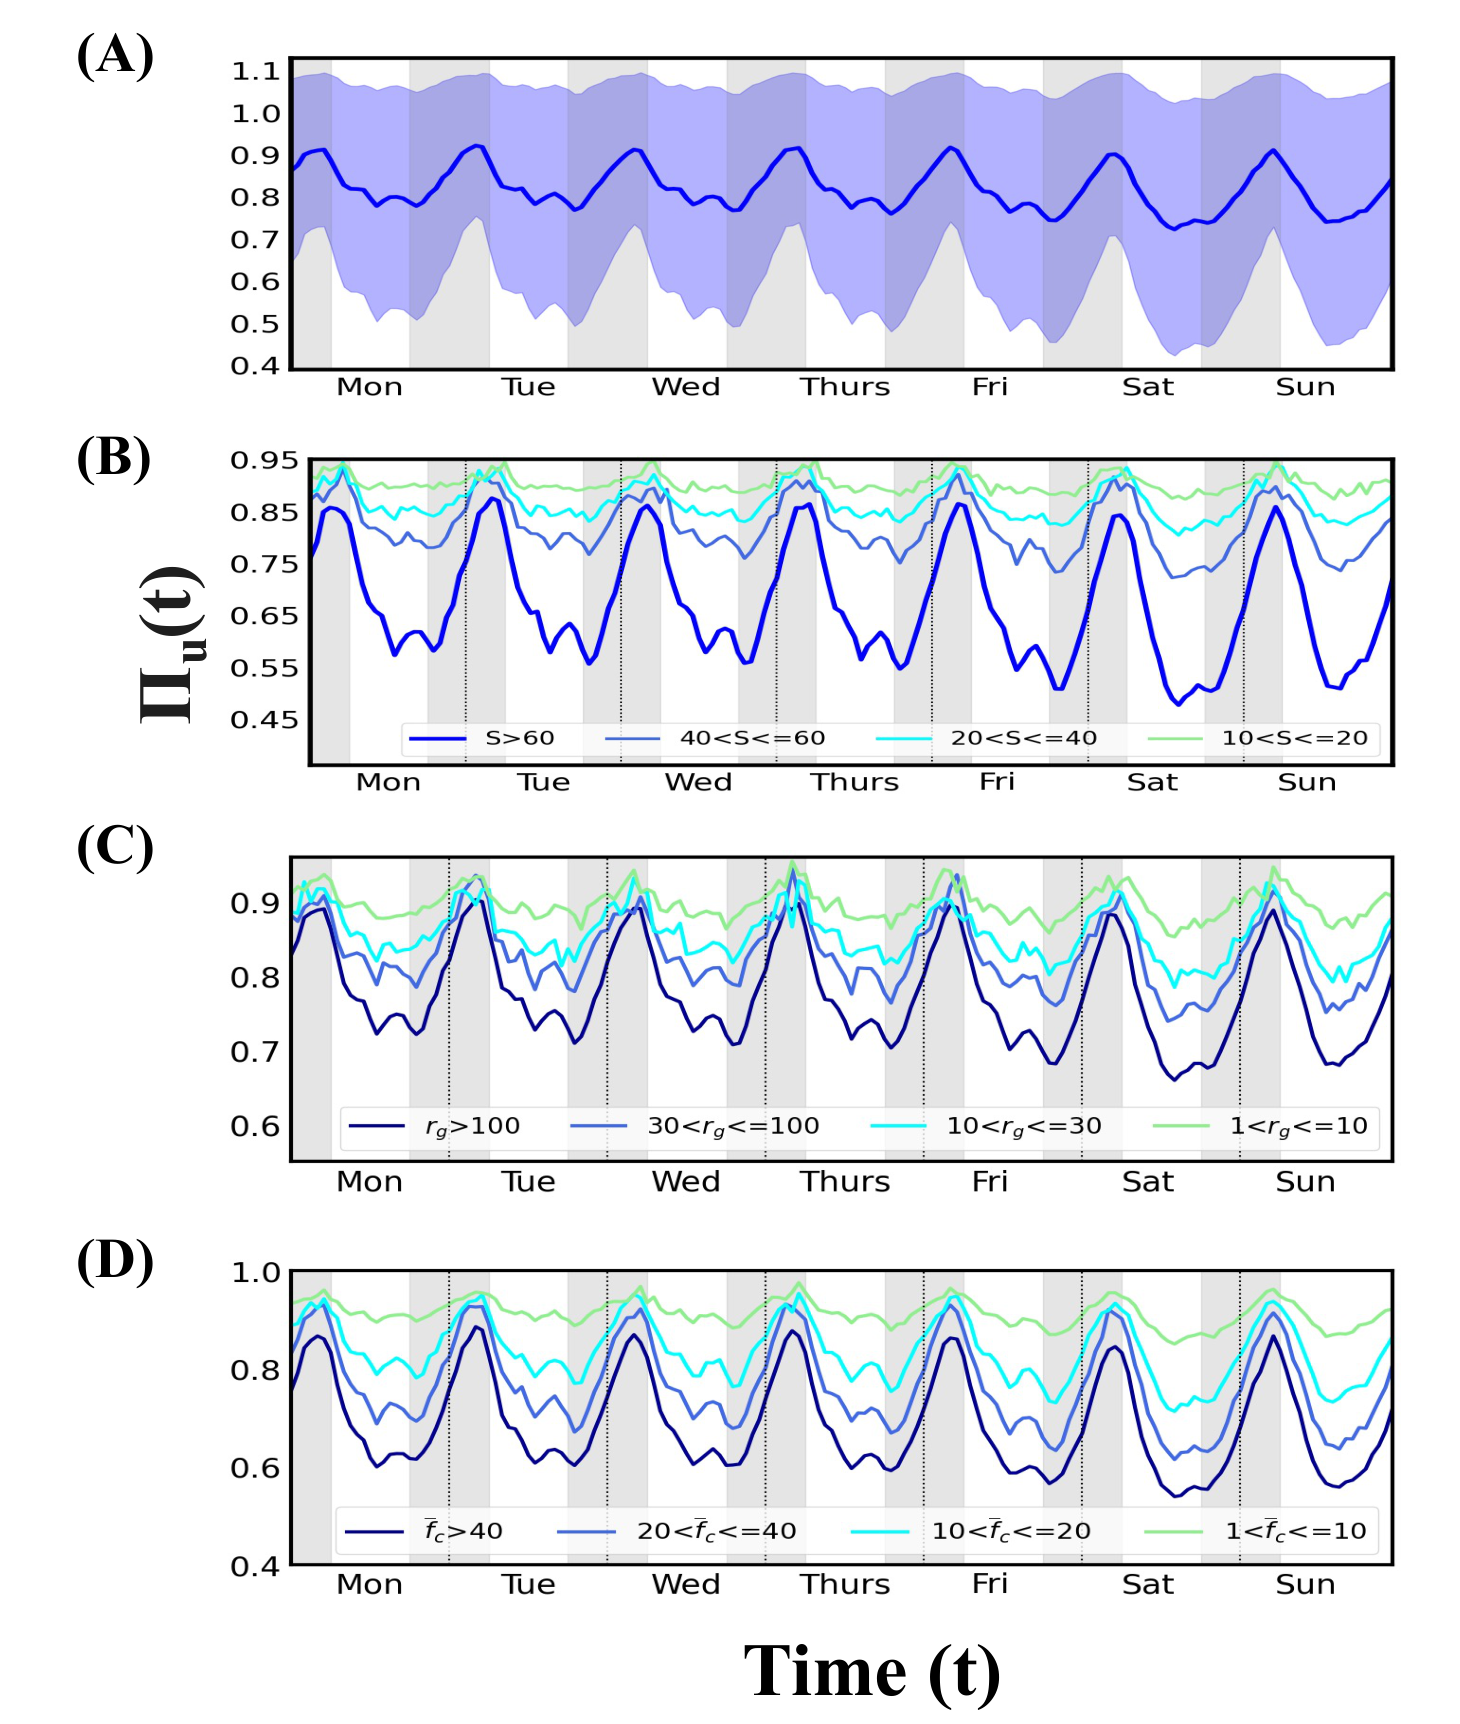
补图S8|类似模式是否只出现在Weeplaces?
(A)Brightkite的小时槽曲线及标准差阴影;(B)按不同地点数量;(C)按回转半径;(D)按月签到频率。夜间峰与高活动组更低的方向大体保留,数值水平仍与其他平台不同。来源:原论文补充 Fig.S8。
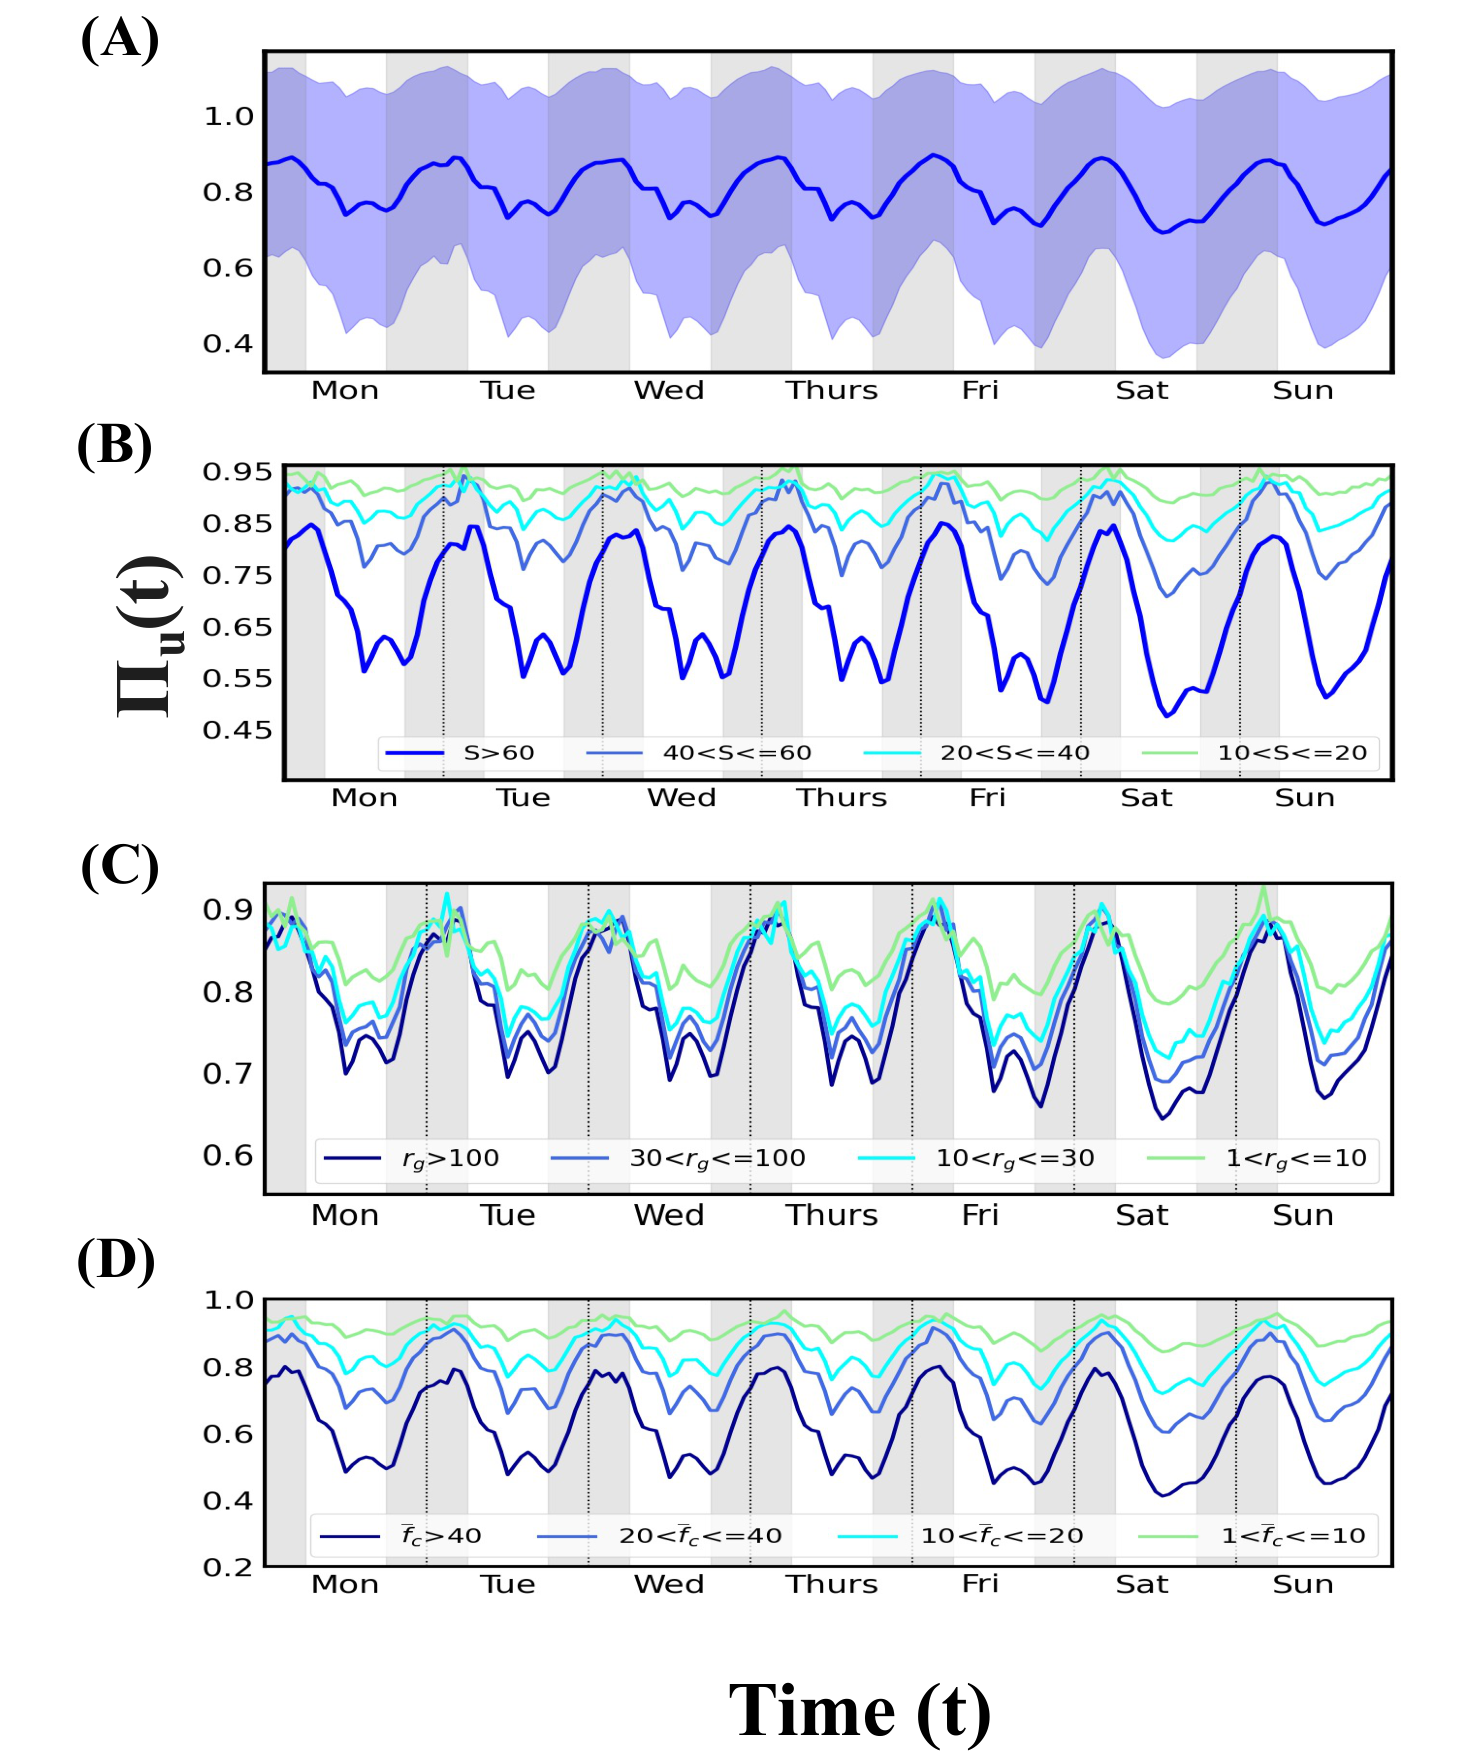
补图S9|Gowalla中的周期与分组差别怎样?
(A)平均时段曲线;(B)地点数量分组;(C)回转半径分组;(D)月签到频率分组。所有字母对应与补图S8相同分析,支持跨三个签到平台的描述性一致性,不构成同一批人的独立复现实验。来源:原论文补充 Fig.S9。
缩小观察窗口,为什么分数会变高?
只保留固定星期小时的记录,比保留整天或整周,通常会减少地点的多样性。随着分箱由72小时缩到1小时,不考虑顺序的可预测性分布向高处移动。因此1小时组分数高,不能直接解释为预测算法因为获得了更高频GPS而变好;这里改变的是所分析的条件子序列。
正文概括24小时附近出现趋缓,但图3仍显示平台差异,尤其Gowalla从24小时到48小时还会下降。可以说继续扩大窗口后的下降趋缓,不能把24小时当作对所有人都完全饱和的物理常数。
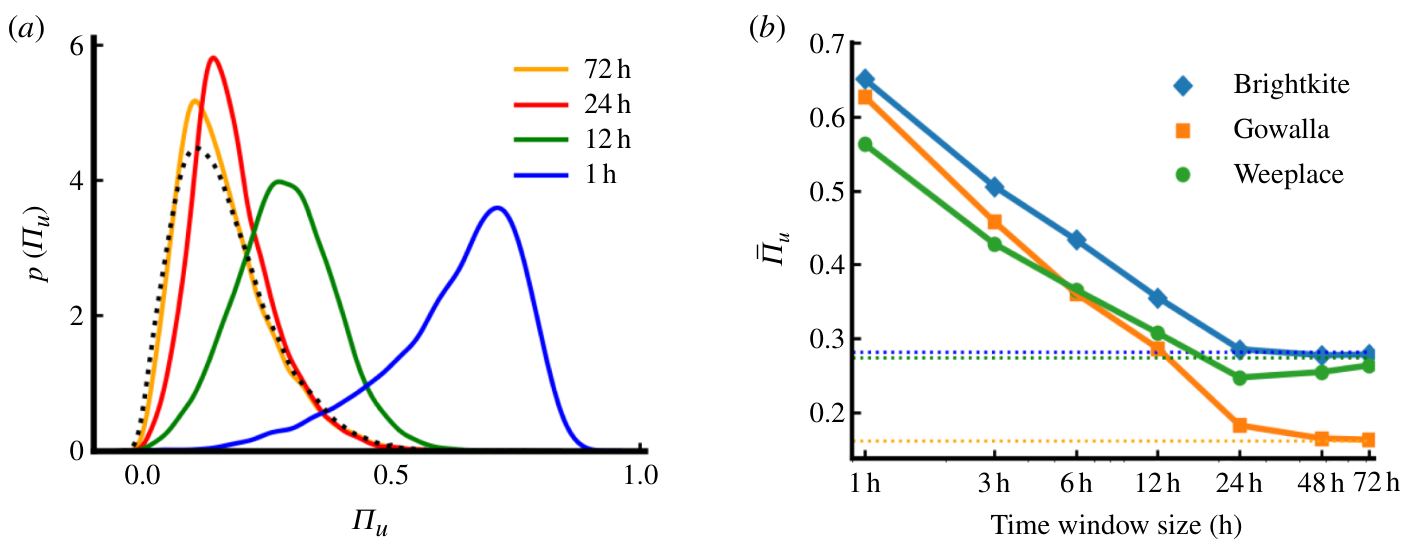
图3|同一批签到,换一种分箱会改变多少可预测性?
(a)Gowalla在1、12、24、72小时窗口下的Π_u分布,黑色虚线是完整序列基线。(b)三平台分布众数随窗口尺度变化,横向虚线标出参考水平。纵轴比较的是同一统计量在不同条件下的值,不是不同算法的成绩。来源:原论文 Fig.3。
12小时与6小时的峰,能证明人体有几个独立时钟吗?
连续小波分析可以把周内曲线拆成不同周期的成分。24小时成分最强,12小时次之,约6小时也有较弱的局部峰。图4的显著性基线表明,6小时峰在总体层面没有达到显著性标准。个体最强周期约73%—81%落在24小时、12%—18%落在12小时,6小时只占较小部分。
作者把这些结构与昼夜节律及其次级谐波联系起来。但有周期不等于找到了独立的生物机制:一天中多次出行安排、非正弦形的日周期、平台签到习惯与地区时间分布,都可能影响频谱。研究没有同步测量生理指标,也没有实验区分工作安排与生物驱动,因此12小时成分可以作为进一步解释的线索,不能直接证明人体内部时钟导致了这组签到规律。
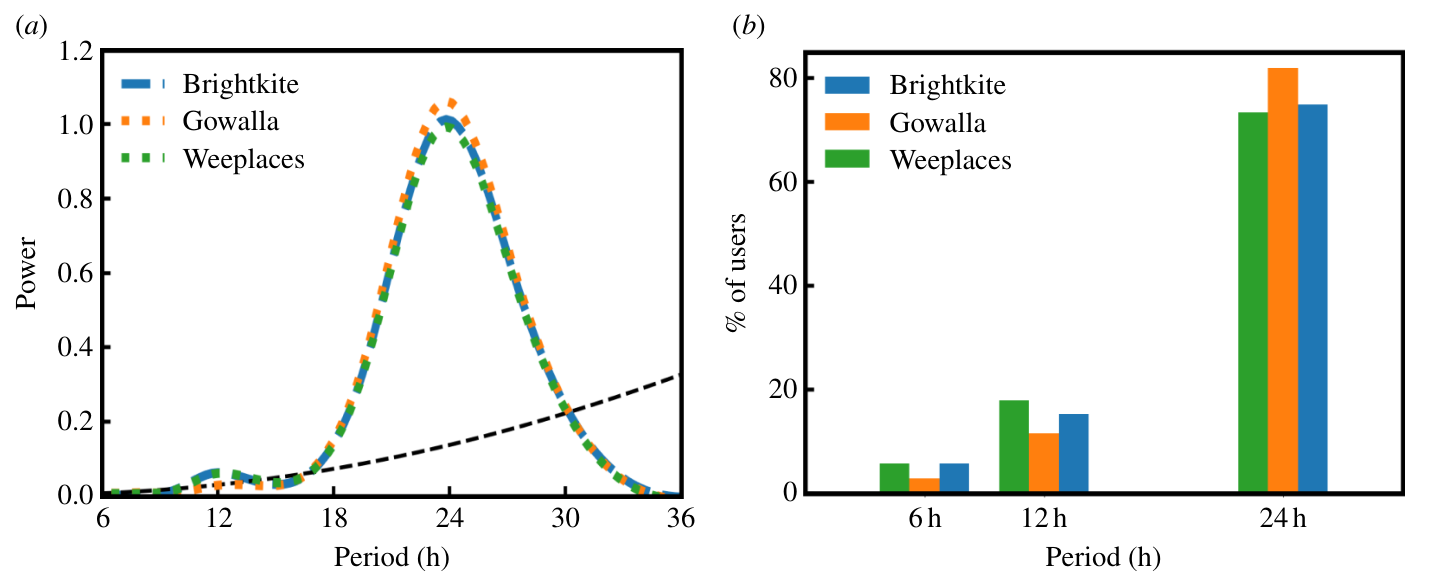
图4|在24小时之外,还有哪些重复尺度?
(a)三平台总体小波功率随周期小时数变化,黑虚线为文中采用的显著性参照;24小时主峰突出,6小时小峰未越过阈值。(b)三平台在6、12、24小时分别为最强成分的用户比例,颜色代表平台,柱高不是波谱强度。来源:原论文 Fig.4。
去工作地点和去餐馆,规律性为何不同?
Weeplaces有八类标签:Home/Work、Education、Entertainment、Food、Travel、Shops、Outdoors、Nightlife。标签描述地点类别,不保证一次实际活动的目的;一个人在工作地点吃饭,未必变成Food地点签到。
论文从完整序列里只抽出某一类地点,重新计算熵和Π。这样得到的是已知下一条属于这类地点时,对类内具体地点的可预测性,而不是预测一个人接下来会不会去餐馆。抽取还会改变序列长度、地点数量与观察间隔,不能把类别差别全归结于活动的心理性质。
总体上,Home/Work、Travel与Shops较整体基线更容易预测,Education和Outdoors更接近基线,Food、Entertainment与Nightlife较低。论文没有将所有地点都按精确到访目的重新标注,这些是签到标签下的统计关系。
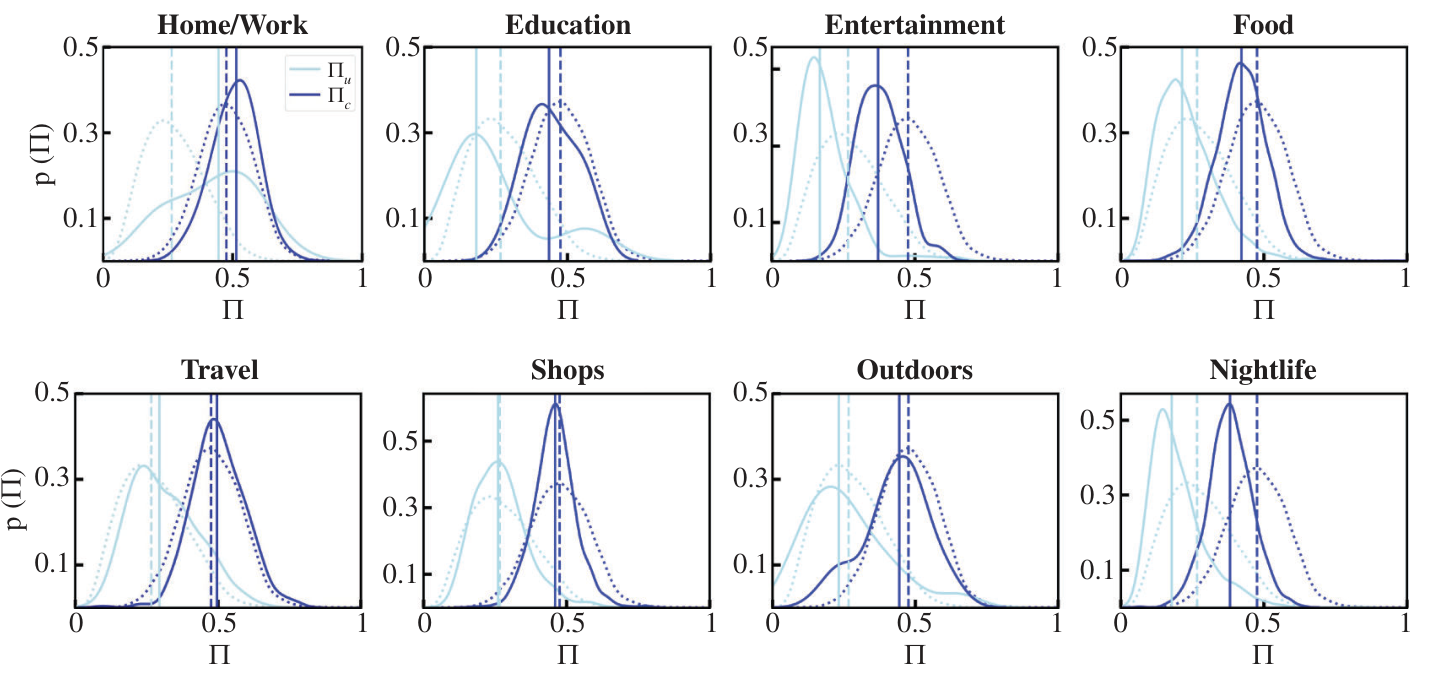
图5|只看同一类地点,具体地点选择有多规律?
上排依次为Home/Work、Education、Entertainment、Food,下排为Travel、Shops、Outdoors、Nightlife。浅色和深色分别为Π_u与Π_c,实线为该类别子序列,点线为完整轨迹基线,竖虚线为中位数。横轴始终为可预测性上限,不能读成去这一类地点的概率。来源:原论文 Fig.5。
只知道地点类型的比例,可以替代完整轨迹吗?
研究进一步用八类地点的访问比例,线性拟合由完整序列计算出的Π_c。输入是某人有多少签到属于Home/Work、Food等类型,输出是该用户的整体可预测性分数。正文有一句把因变量与自变量反写;图6、方法叙述与补表S2共同对应这里的输入输出关系。
拟合报告R²=0.419,说明这组粗粒度特征解释了约41.9%的分数变异,仍有相当多差异未解释。高分用户被低估、低分用户被高估的压缩也能从散点看出。正文没有报告独立测试集或跨平台外推,故不能把它作为已经证实的样本外性能。
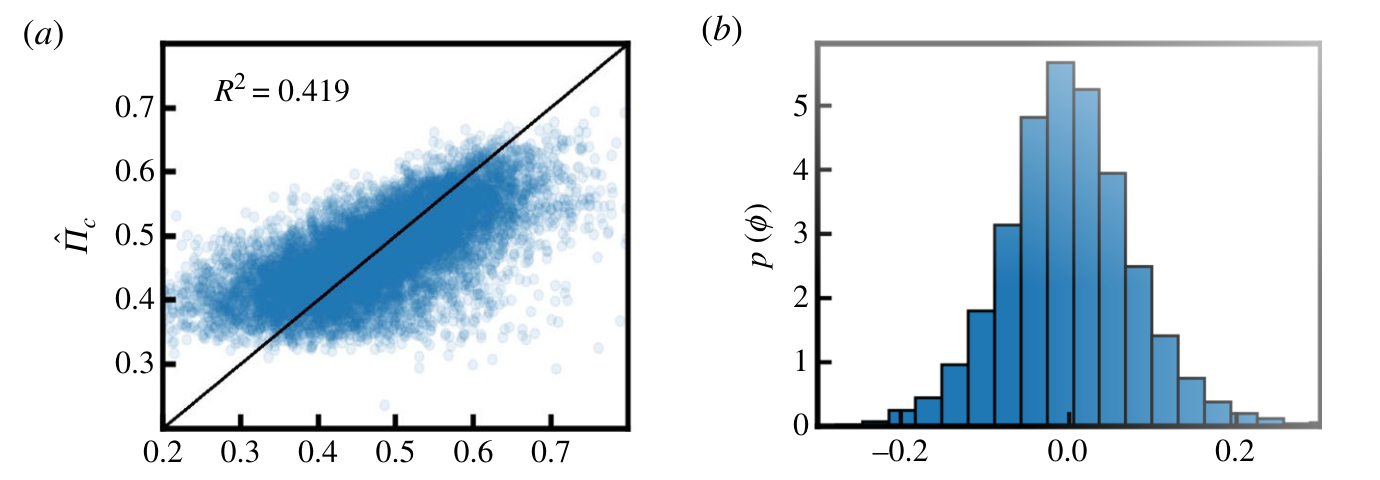
图6|粗粒度地点组成,可以恢复多少细轨迹信息?
(a)横轴为完整序列算出的Π_c,纵轴为类别比例线性模型的估计值,黑线是理想相等参照,R²=0.419。(b)残差分布主要集中于零附近;外形近似钟形,不等于已经排除所有系统误差或完成正式正态性证明。来源:原论文 Fig.6。
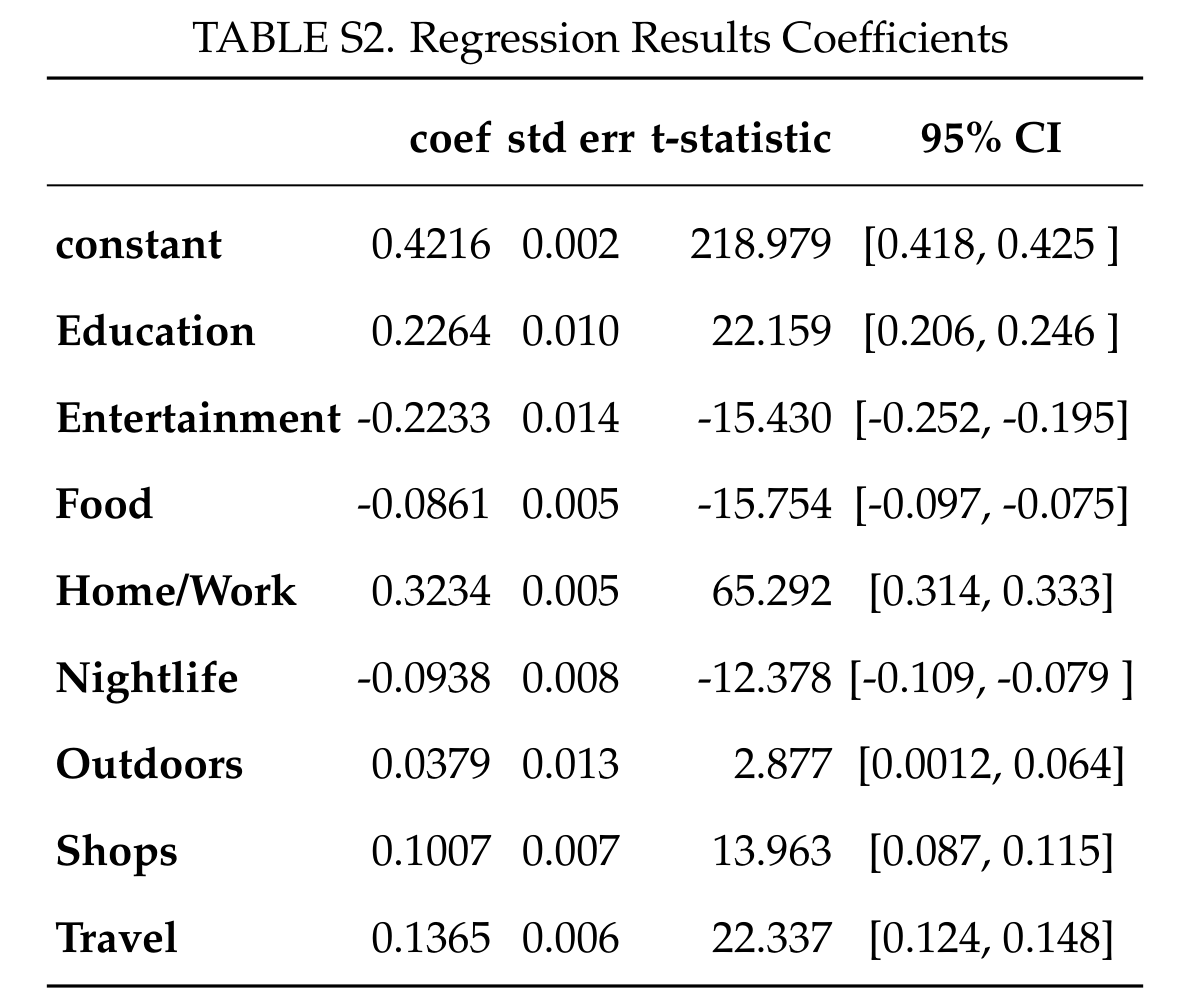
补表S2|回归中的地点类型分别对应哪些参数?
表中保留截距、八类地点的系数、标准误、t统计和95%区间。输入是总和受约束的比例,若全部八类之和为1又同时加入截距,参数之间会存在依赖,因此不宜把每个系数当成相互独立的因果贡献。模型可以用于描述组合与分数的关系,但不能据Home/Work正号就宣称增加居家会产生对应大小的可预测性提升。来源:原论文补充 Table S2。
地点比例比完整轨迹更容易收集,这是方法的潜在实用性。但本研究没有针对不同缺测比例与非随机缺测机制逐一测试。若缺失主要发生在夜间、夜生活场所或跨地区出行,类别组成也会被改变。拟合已有数据,不等于已证明任意低分辨率或缺失情境都能保留同样结论。
还有哪些记录偏差需要放在结论旁边?
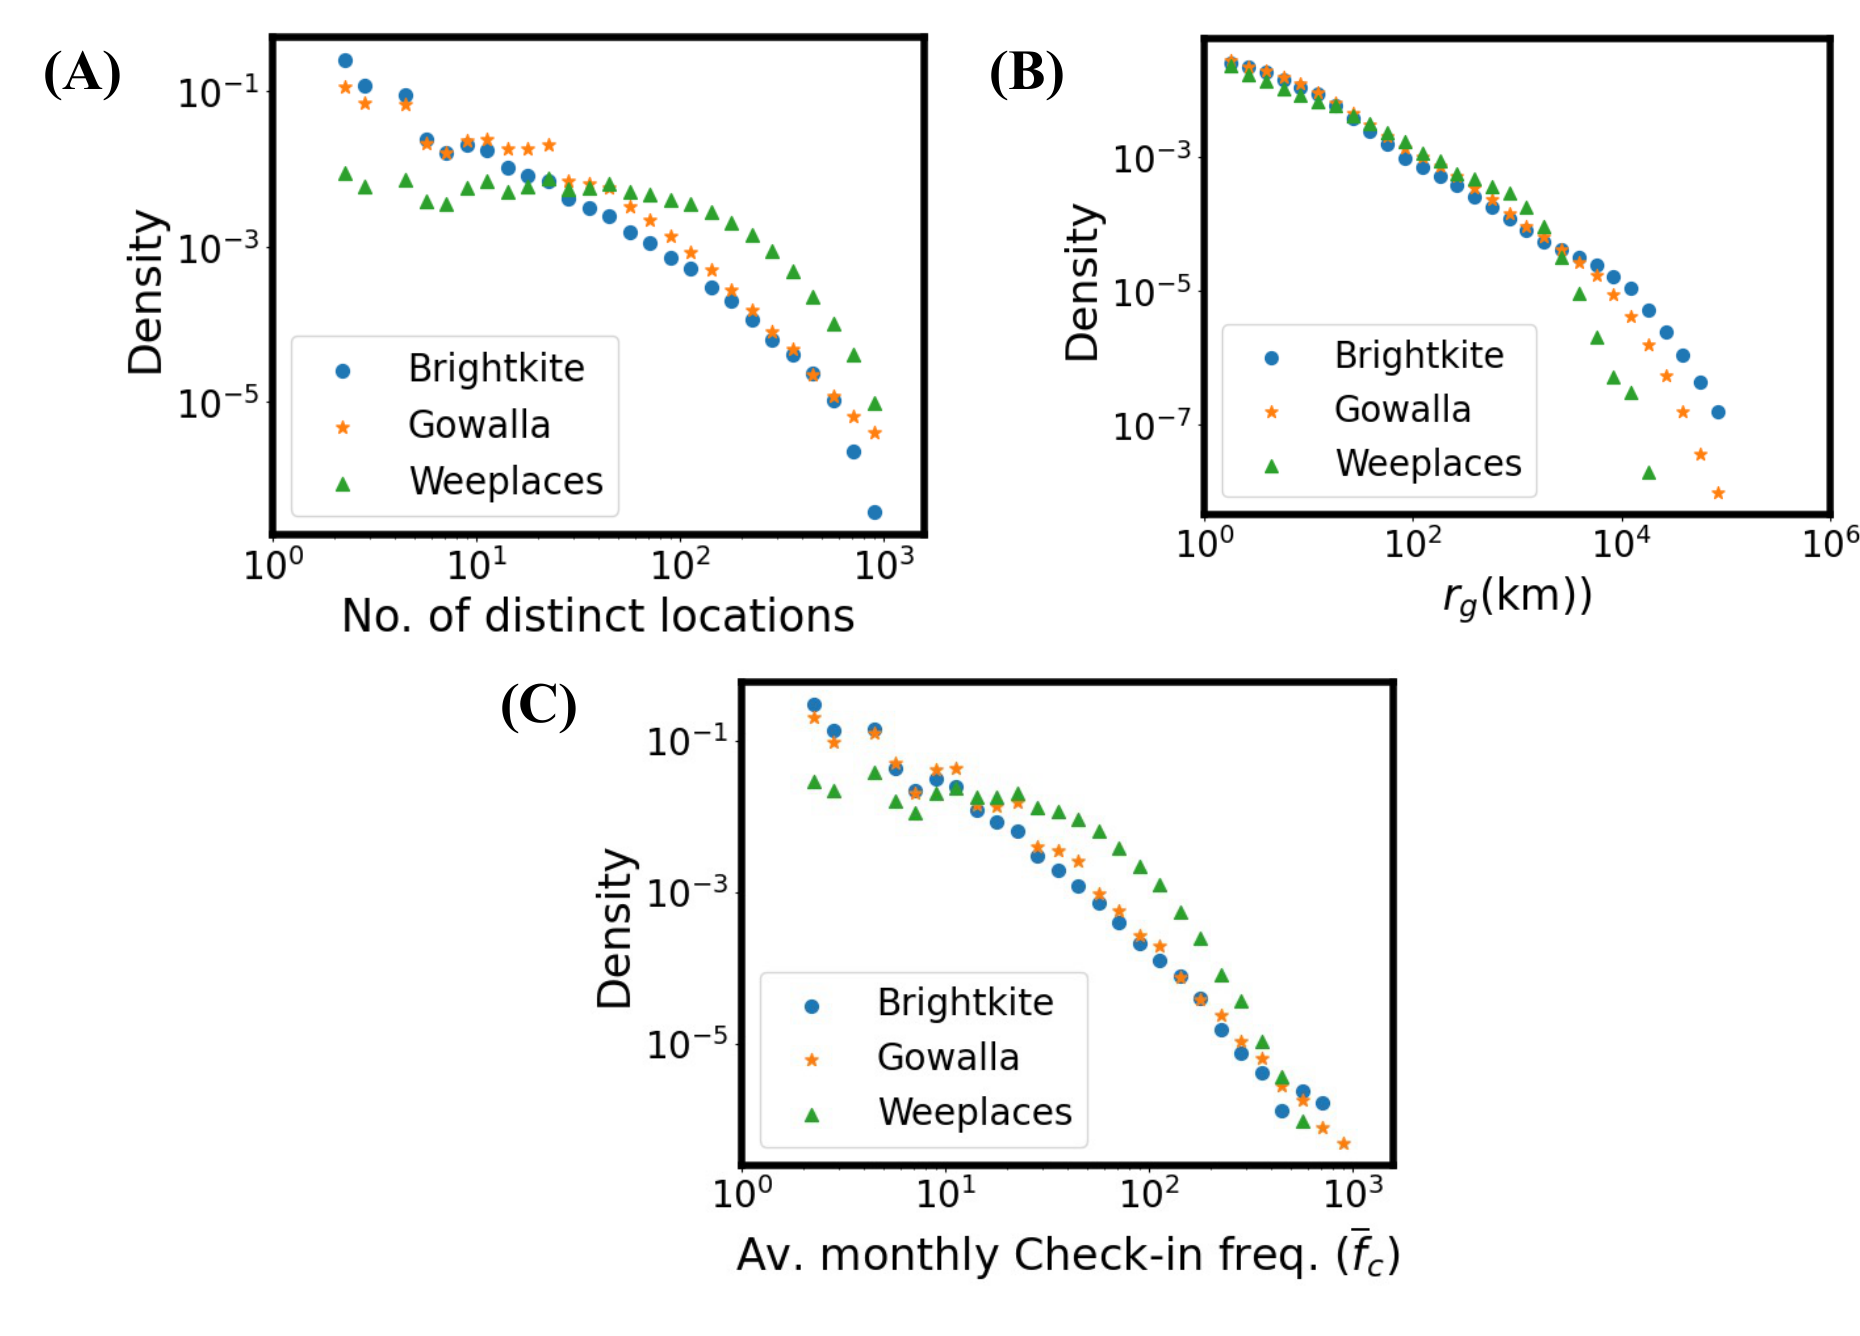
补图S1|用户之间的活动与记录强度差异有多大?
(A)不同地点数分布;(B)回转半径分布,单位公里;(C)每月平均签到频率分布。三者均右偏,少数用户贡献很高的记录或空间范围,Weeplaces部分尾部更重。重尾外形不是所有用户遵循同一种机制的证据。来源:原论文补充 Fig.S1。
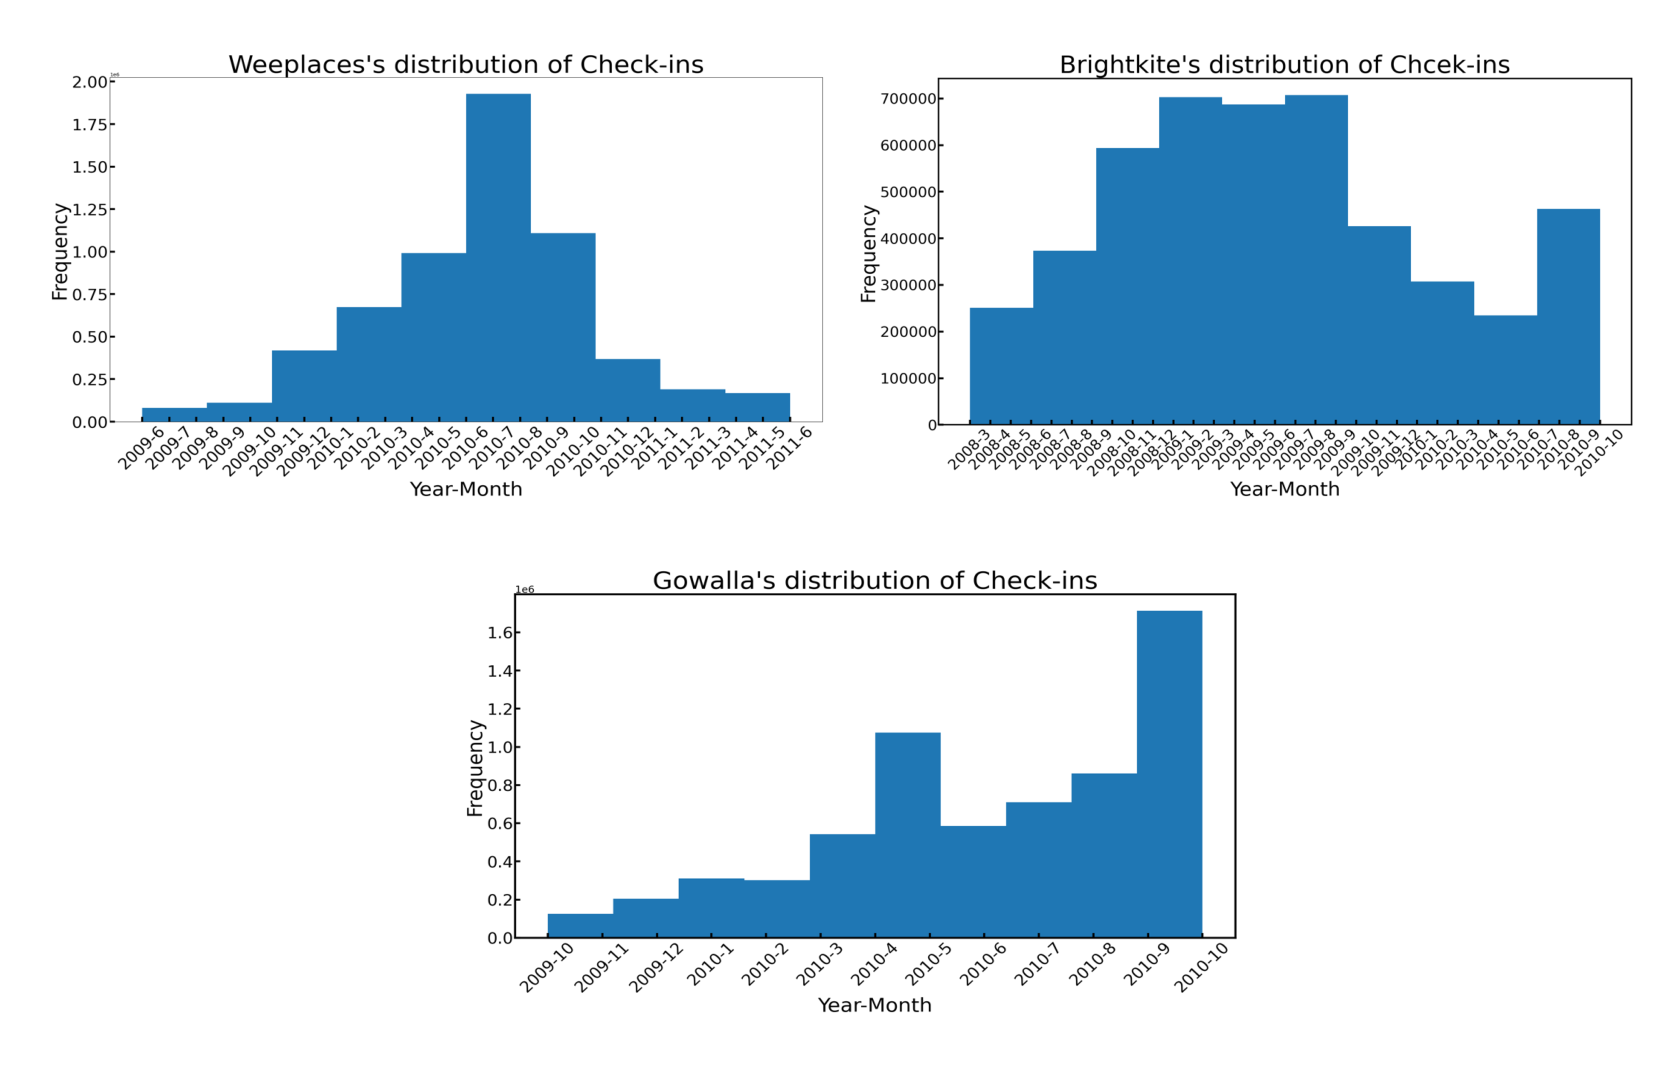
补图S3|每个月都留下相同数量的签到吗?
左上Weeplaces、右上Brightkite、下方Gowalla,横轴为年月,纵轴为签到数量。不同月份记录差别明显;将多个时期合并成典型一周,会压缩长期平台变化和用户习惯变化。来源:原论文补充 Fig.S3。
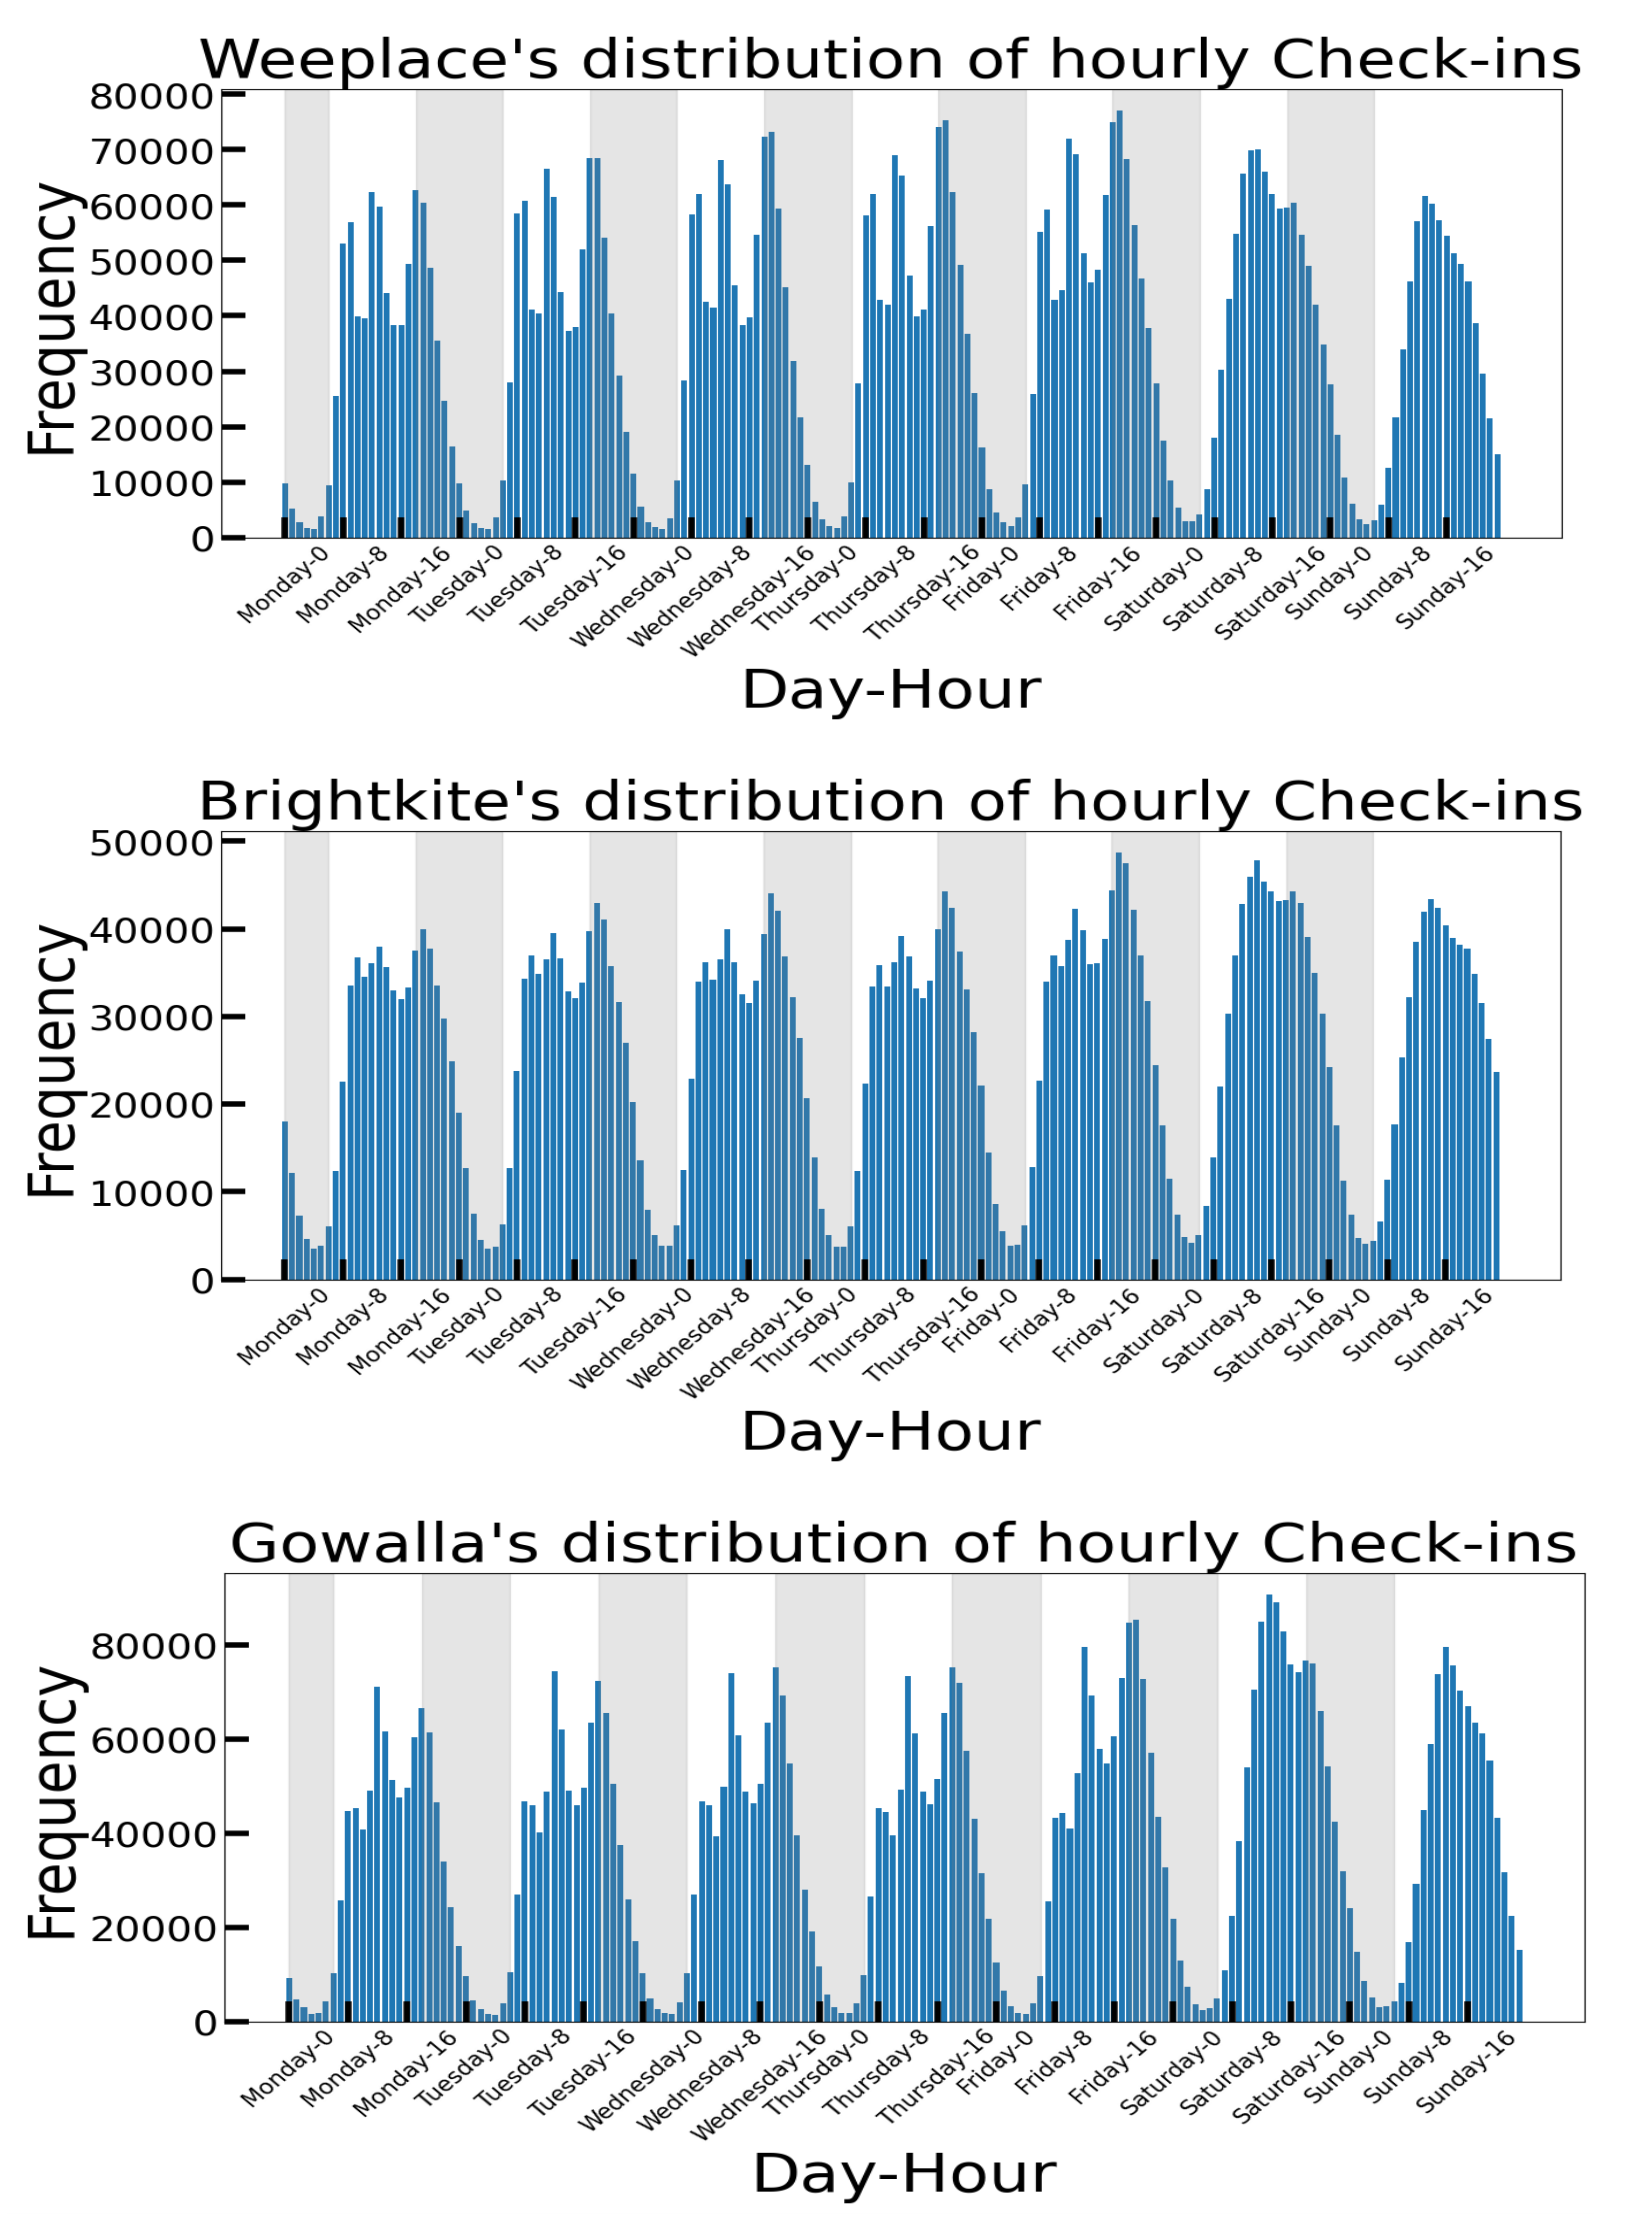
补图S4|可预测性波动,会不会同时遇到记录数量变化?
上、中、下依次为Weeplaces、Brightkite、Gowalla,展示一周各小时的签到数。昼夜间的采样数量本来就不均匀,所以夜间上限高不能自动代表连续跟踪夜间所有人的活动。来源:原论文补充 Fig.S4。
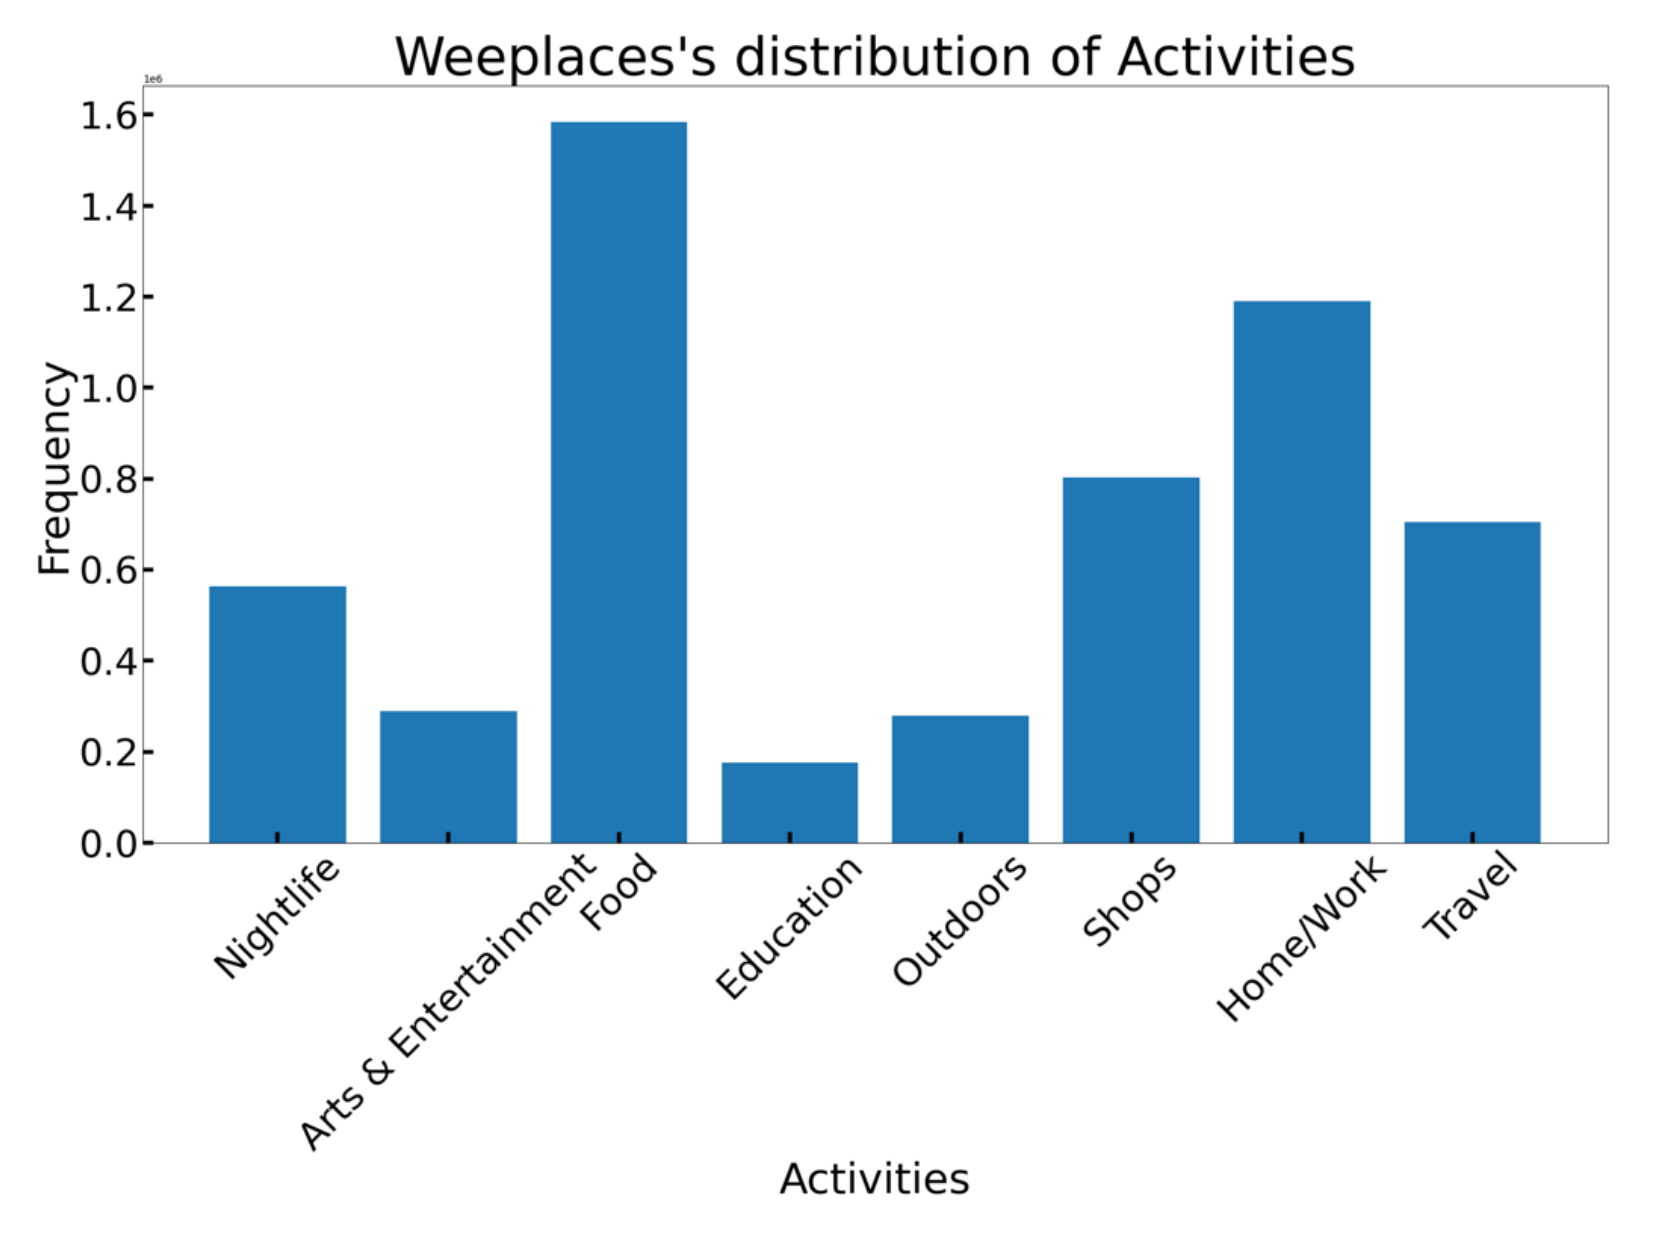
补图S5|各地点类型的数据量一样多吗?
横轴为Weeplaces类别,纵轴为签到数量;Food与Home/Work记录较多,不同标签的数据支持不均衡。类别标签和实际活动目的也不是一一对应关系。来源:原论文补充 Fig.S5。
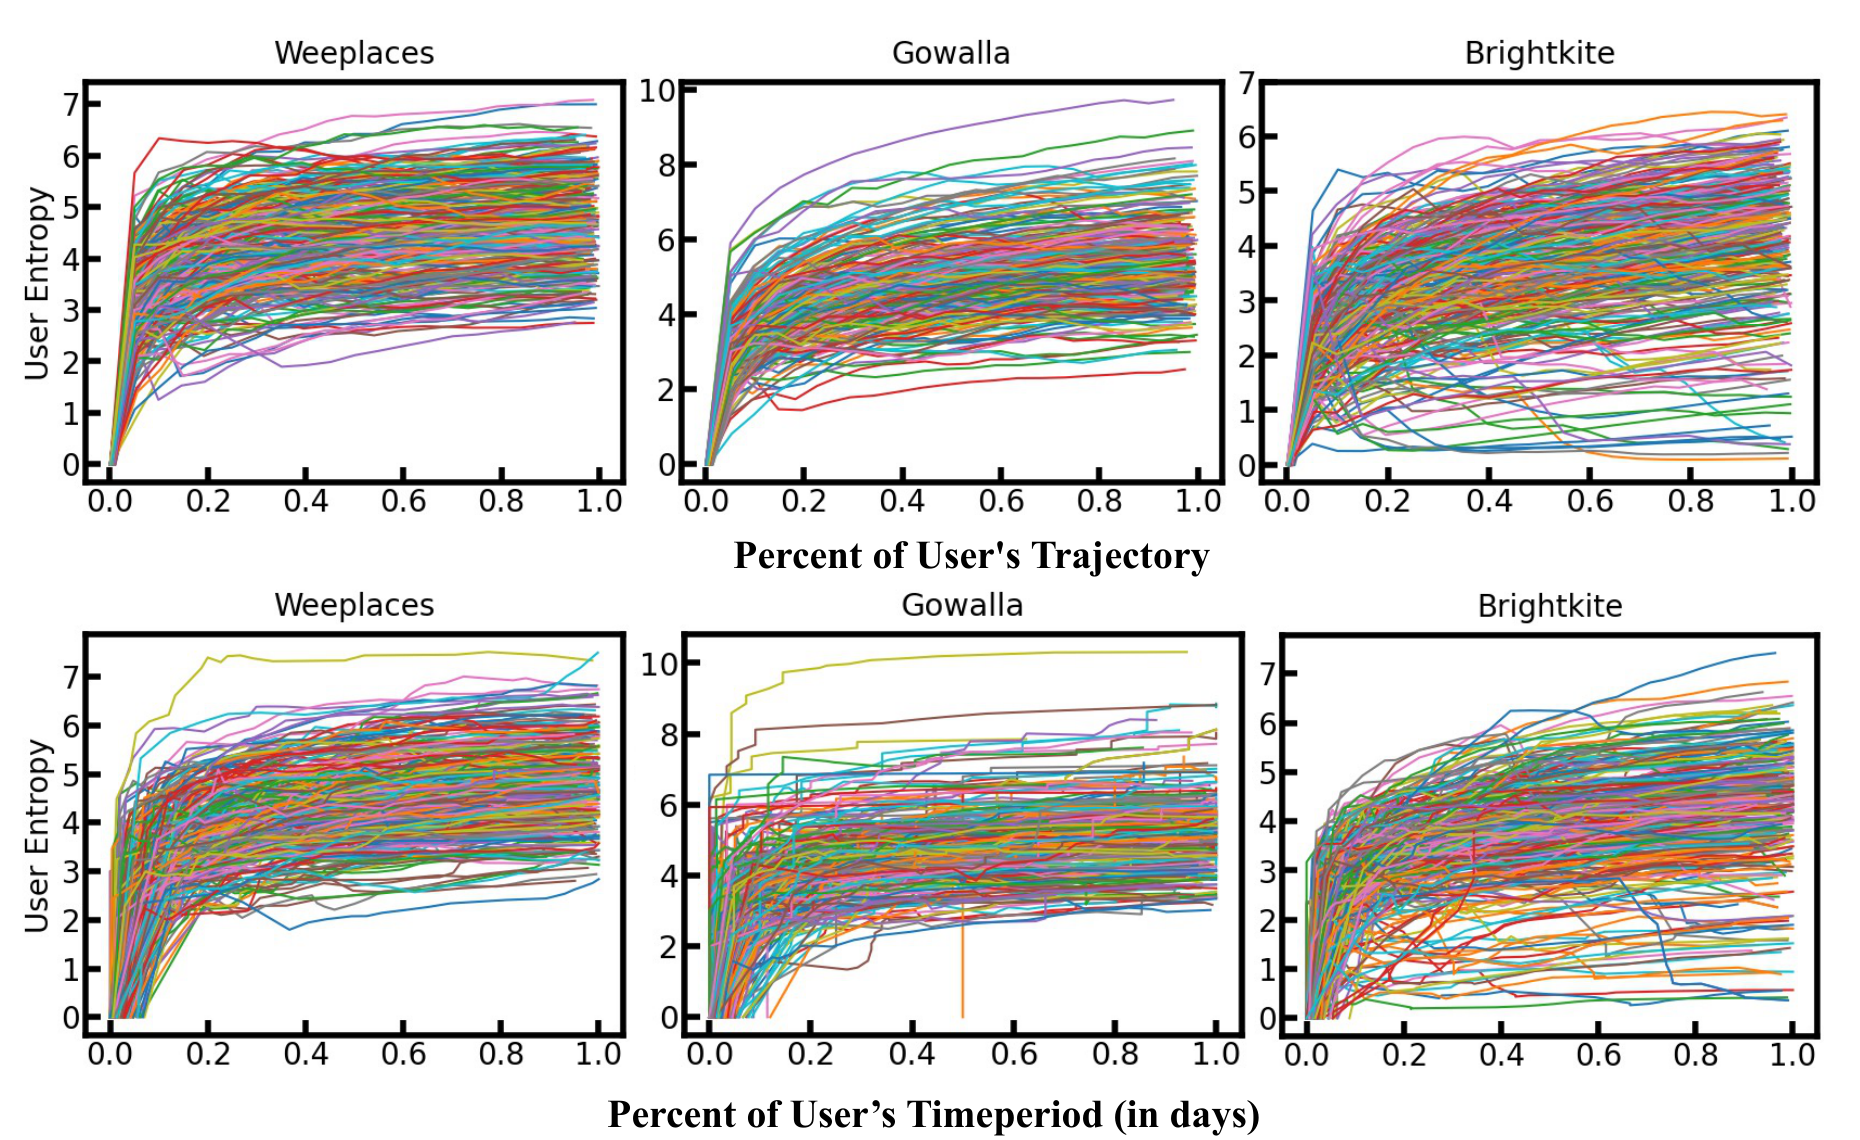
补图S7|多取一些记录后,熵估计会稳定到什么程度?
三列分别为Weeplaces、Gowalla、Brightkite。上排横轴为保留的轨迹比例,下排为保留的观测时间比例,纵轴均为用户熵;多条线代表不同用户。许多曲线早期增幅大、随后变缓,也有继续变化的个体,不能把约10%之后的总体趋缓解释成每名用户都已无误差。来源:原论文补充 Fig.S7。
这些检查支持论文将可预测性放回情境中理解,同时也限制了结论的应用范围。三个平台均来自较早期的自愿签到,不能直接代表今天全体居民。高分不保证容易预测真实下一次出行,低分也不表示个人生活无规律;不同任务、分辨率与报告机制,会共同改变可见的结构。
一句话总结
人类移动的规律性不是一个永远固定的个人分数;在这些签到数据中,星期时段、活动强度与地点类型共同改变可预测性上限,而实现可靠预测仍需要独立验证。
核心来源
- Poudyal B. et al. (2024). Dynamic predictability and activity-location contexts in human mobility,Royal Society Open Science 11:240115。正文、6张主图及表1为主要依据。
- 官方补充材料,含数据处理、全部补图S1—S9、小波方法与回归系数。文中保留所有图的完整原始组合。
作者介绍
Bibandhan Poudyal 署名为美国罗切斯特大学物理与天文学系作者,参与数据整理、分析与研究执行。Gourab Ghoshal 同属该系,是通讯作者之一,参与研究构思、方法与指导等工作。
Diogo Pacheco 署名为英国埃克塞特大学计算机科学系作者;Marcos Oliveira 同时署名该系与德国GESIS莱布尼茨社会科学研究所;两人参与分析和写作等工作。
Zexun Chen 署名为英国爱丁堡大学商学院作者,参与分析与方法。Hugo S. Barbosa 署名为埃克塞特大学计算机科学系作者,参与数据、方法与分析等工作。
Ronaldo Menezes 同时署名埃克塞特大学与巴西塞阿拉联邦大学计算机科学系,是另一位通讯作者,参与构思、资源与指导等工作。以上按原文署名及贡献声明介绍。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果目标是改善公交服务,值得追问的并不只是哪个时段更容易预测,而是预测错一次会造成多大代价。凌晨总体规律较强,却可能有少量必须出行的夜班人群;白天多样性更高,也不意味着公共服务只能放弃规划。统计规律与公共需求之间,需要加入出行必要性、服务覆盖和误差分布。
一个更严格的检验可以把早期签到用于确定时段与类别结构,完全留出后续月份,分别预测下一次签到、固定时间后的真实位置以及实际活动类别。若类别比例只能恢复用户的平均分数,却不能改善这些任务,就应该把它定位为描述性摘要,而不是已经可用的预测工具。
还应设计非随机缺测实验:按夜间、周末或某类地点删除记录,再检查可预测性和回归是否失真。平均随机删去20%记录,与恰好缺少所有夜间活动,可能产生完全不同的结果。把缺失机制放进验证,才能判断情境摘要真正节省了多少数据需求。
