模型猜中了热门车站,为什么还会错过早晚高峰?
论文名片|Samiul Hasan、Christian M. Schneider、Satish V. Ukkusuri、Marta C. González,Spatiotemporal Patterns of Urban Human Mobility,Journal of Statistical Physics,2013,151:304–318,2012年12月7日在线发表。DOI:10.1007/s10955-012-0645-0。研究以伦敦Oyster刷卡记录分析城市移动,并建立目的地选择与停留时长模型。
很多人工作日反复经过两座熟悉的车站,偶尔去餐厅、商场或朋友家。若让模拟乘客也保留两个固定地点,剩余时间偏向大家常去的热门地点,能否生成真实城市的出行?
这篇论文的回答是:可以生成若干总体规律,但仍会在关键地方失败。模型能形成不均匀的站间流量、缓慢增长的新地点数量和逐级降低的访问频率,却无法重现真实乘客的昼夜节奏,也低估了用户之间活动多样性的差异。拟合总体分布,与还原一个人的日程,要求并不相同。
先说结论:
- 两个最常访问的车站,与其他车站具有不同的停留时间特征,不能给所有地点套同一个等待时间分布。
- 其他地点的访问频率随排名降低,但前两名明显偏离这一尾部规律。
- 使用全体乘客共同累积的地点访问量,模型不必直接指定新地点探索概率,也能生成新地点数的次线性增长。
- 成功主要是统计形状的复现;没有昼夜约束和个体差异时,模型仍无法解释真实的日内节奏与高度规律乘客。
626位乘客,能代表伦敦所有出行吗?
研究最初取得1000位匿名公共交通用户三个月的交易记录,再保留至少70%的已记录行程由地铁完成的626位用户。这样筛选是因为地铁进出站记录能提供较完整的起终点,而部分公交或铁路行程只有上车信息。
70%针对记录到的公共交通行程,不代表这些人所有步行、驾车或骑行中的70%都是地铁。论文也没有给出这三个月的具体起止日期或总行程数,因此不能把当时Oyster系统的数百万用户背景规模当成本文分析样本。
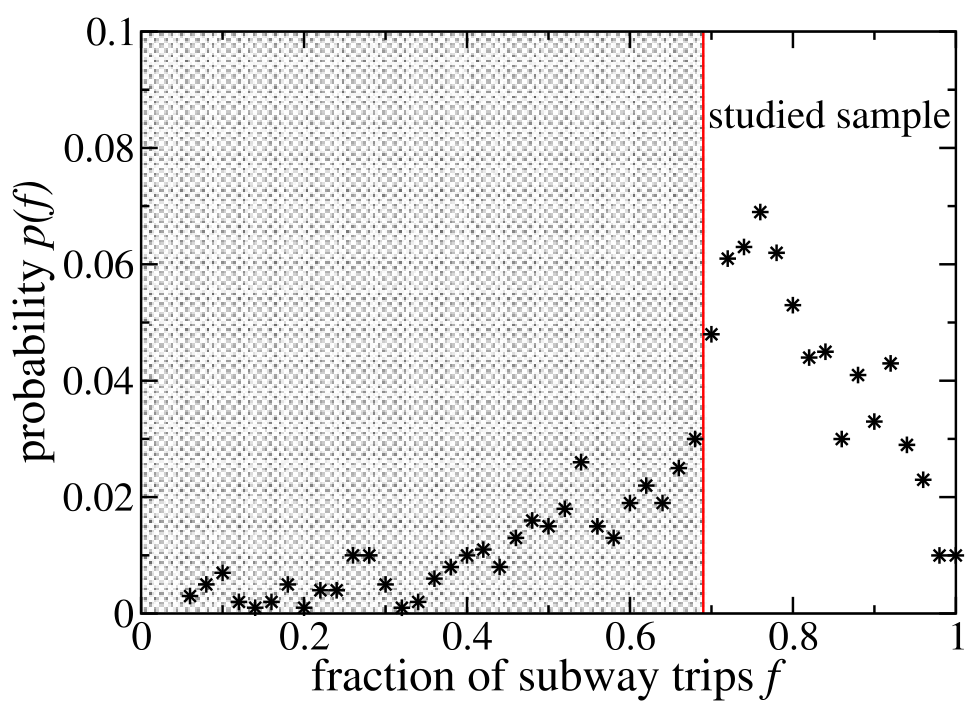
图 1|为获得较完整的地铁行程,样本经过了怎样的选择?
该图无字母子图。横轴f是用户已记录行程中的地铁比例,纵轴为该比例的分布;红线标出约0.7阈值,左侧阴影为未纳入区域,右侧为研究样本。这提高了行程完整性,同时将结论限定在偏常用地铁的人群。来源:原论文 Fig. 1。
常去的两个站,和其余地点有何不同?
对每个人,研究按三个月内的访问次数给车站排序。最常访问站在城市中较分散,第二常访站更集中于中心及一处东部办公区域,其余常访站的热点也集中于中心。这个格局与居住、工作及休闲分工相容,但刷卡记录没有直接提供活动目的。
因此,把前两名简称为家与工作地,是模型解释,不是每位乘客都经过核实的身份标签。车站也只是周边活动区域的入口,不能等同于某栋房屋或办公楼。
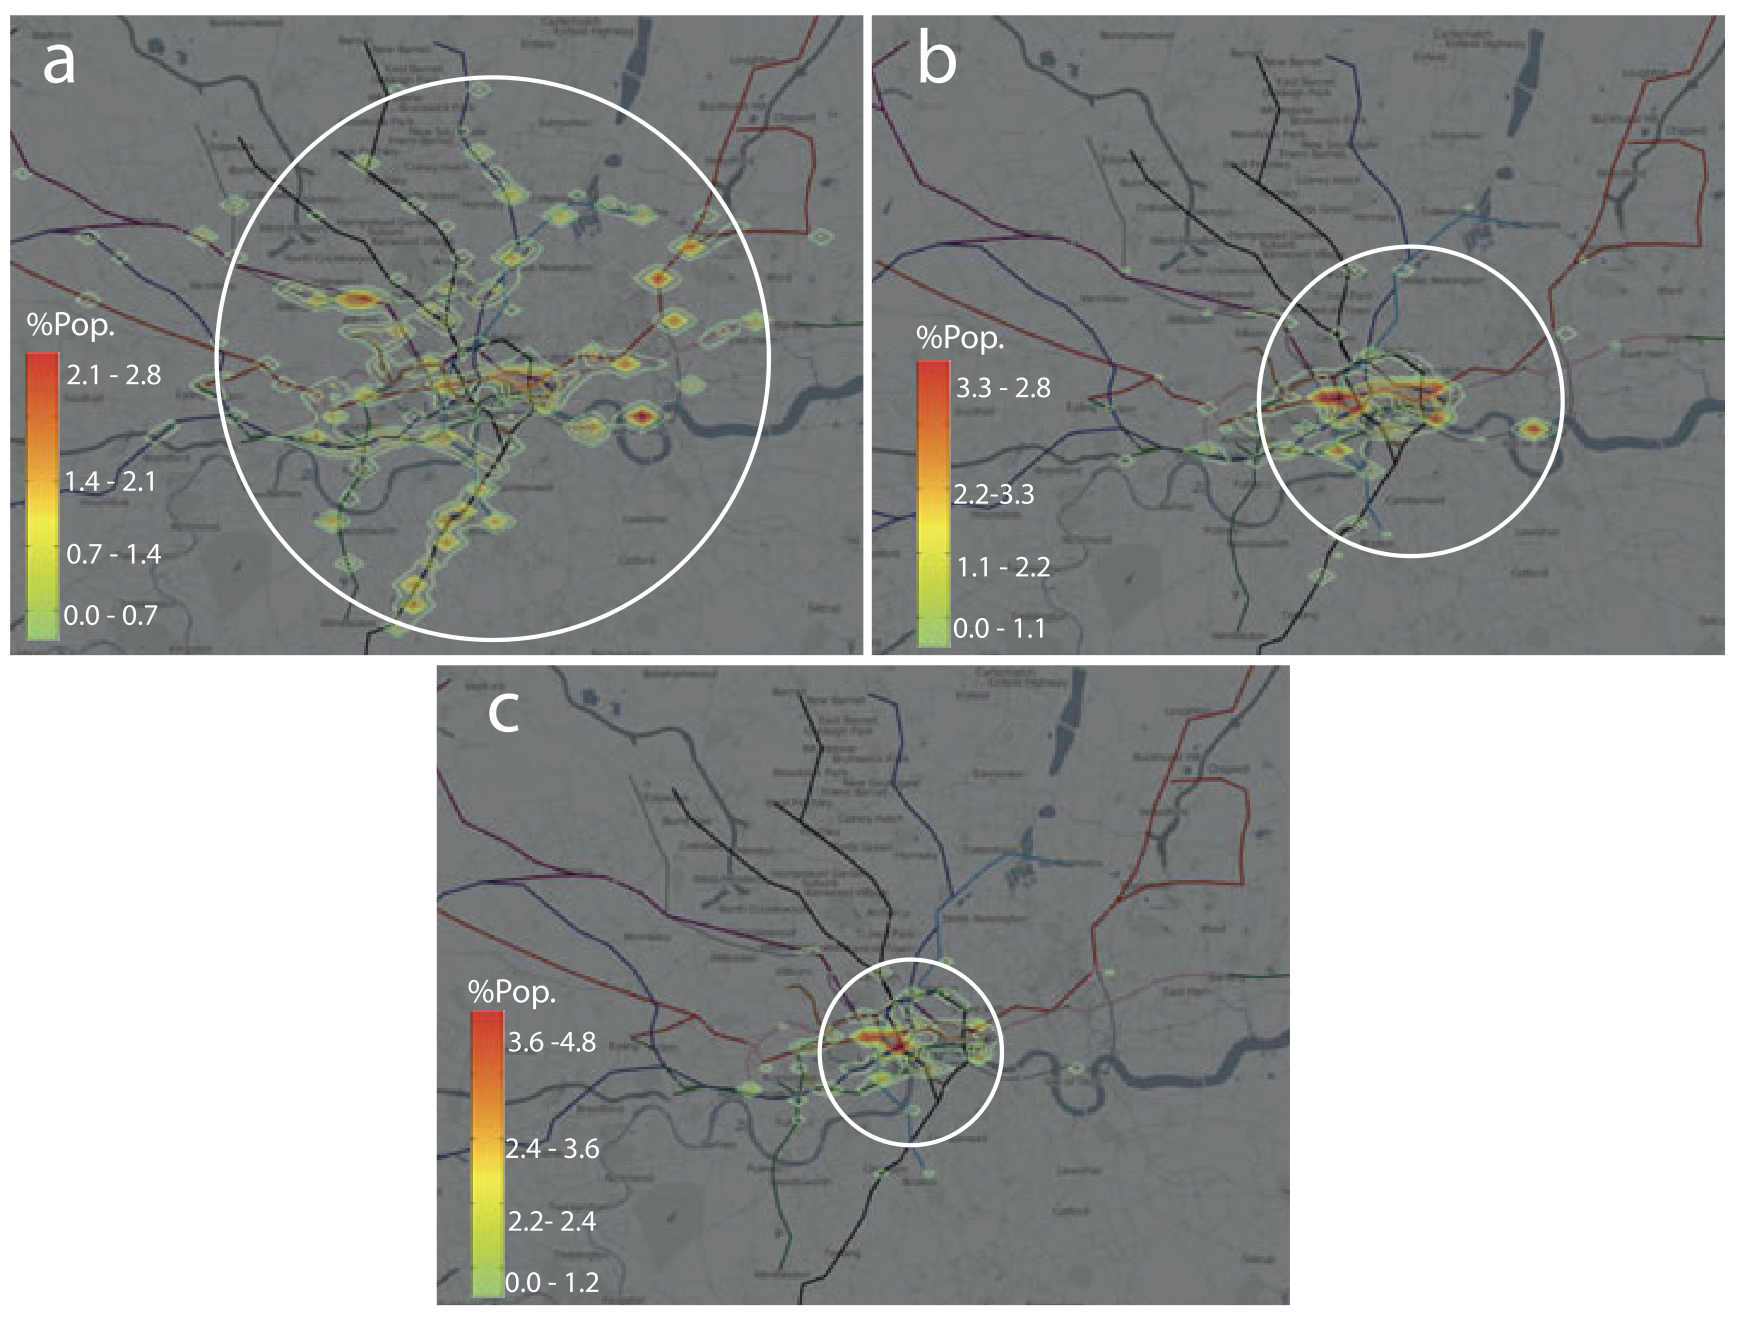
图 2|不同访问排名的热点,是否落在相同区域?
(a)最常访问站的空间分布较广。(b)第二常访问站的高值更多集中于中心附近。(c)其他访问站的热点更集中在中心。颜色表示车站在样本中被归入相应访问类别的比例,白圈强调集中区域;三个面板色标不同,不宜直接比较同一种颜色的绝对数值。来源:原论文 Fig. 2。
两站之间的时间,为什么不能和离站后的时间混在一起?
本文将trip length以分钟计,表示一次地铁旅行所花的时间,而非公里距离。典型旅行时间约25分钟,前两名常访站之间的平均旅行时间短约15%。这些时间分布具有中心位置,没有直接重现大地理尺度文献中的距离幂律;时间与空间量纲、单一交通方式和网络边界都不同,不能据此宣布所有出行距离都没有重尾。
停留时间则是到达一处之后、再次离开之前的间隔,研究只使用能确定开始与结束的记录。最常访地点约有9小时和14小时两个峰,第二常访地点主要在约9小时出现峰,符合某些日常活动时长。
其他地点的时长分布更宽,论文描述其尾部具有幂律式特征,但未给出可作为普遍定律的拟合指数。完整图中仍可见约9小时、14小时附近的小结构,不能把“更宽”写成完全没有任何时间特征。长间隔还可能包含未观测到的其他交通或活动,不能全部解释为在同一个目的地连续待了几天。
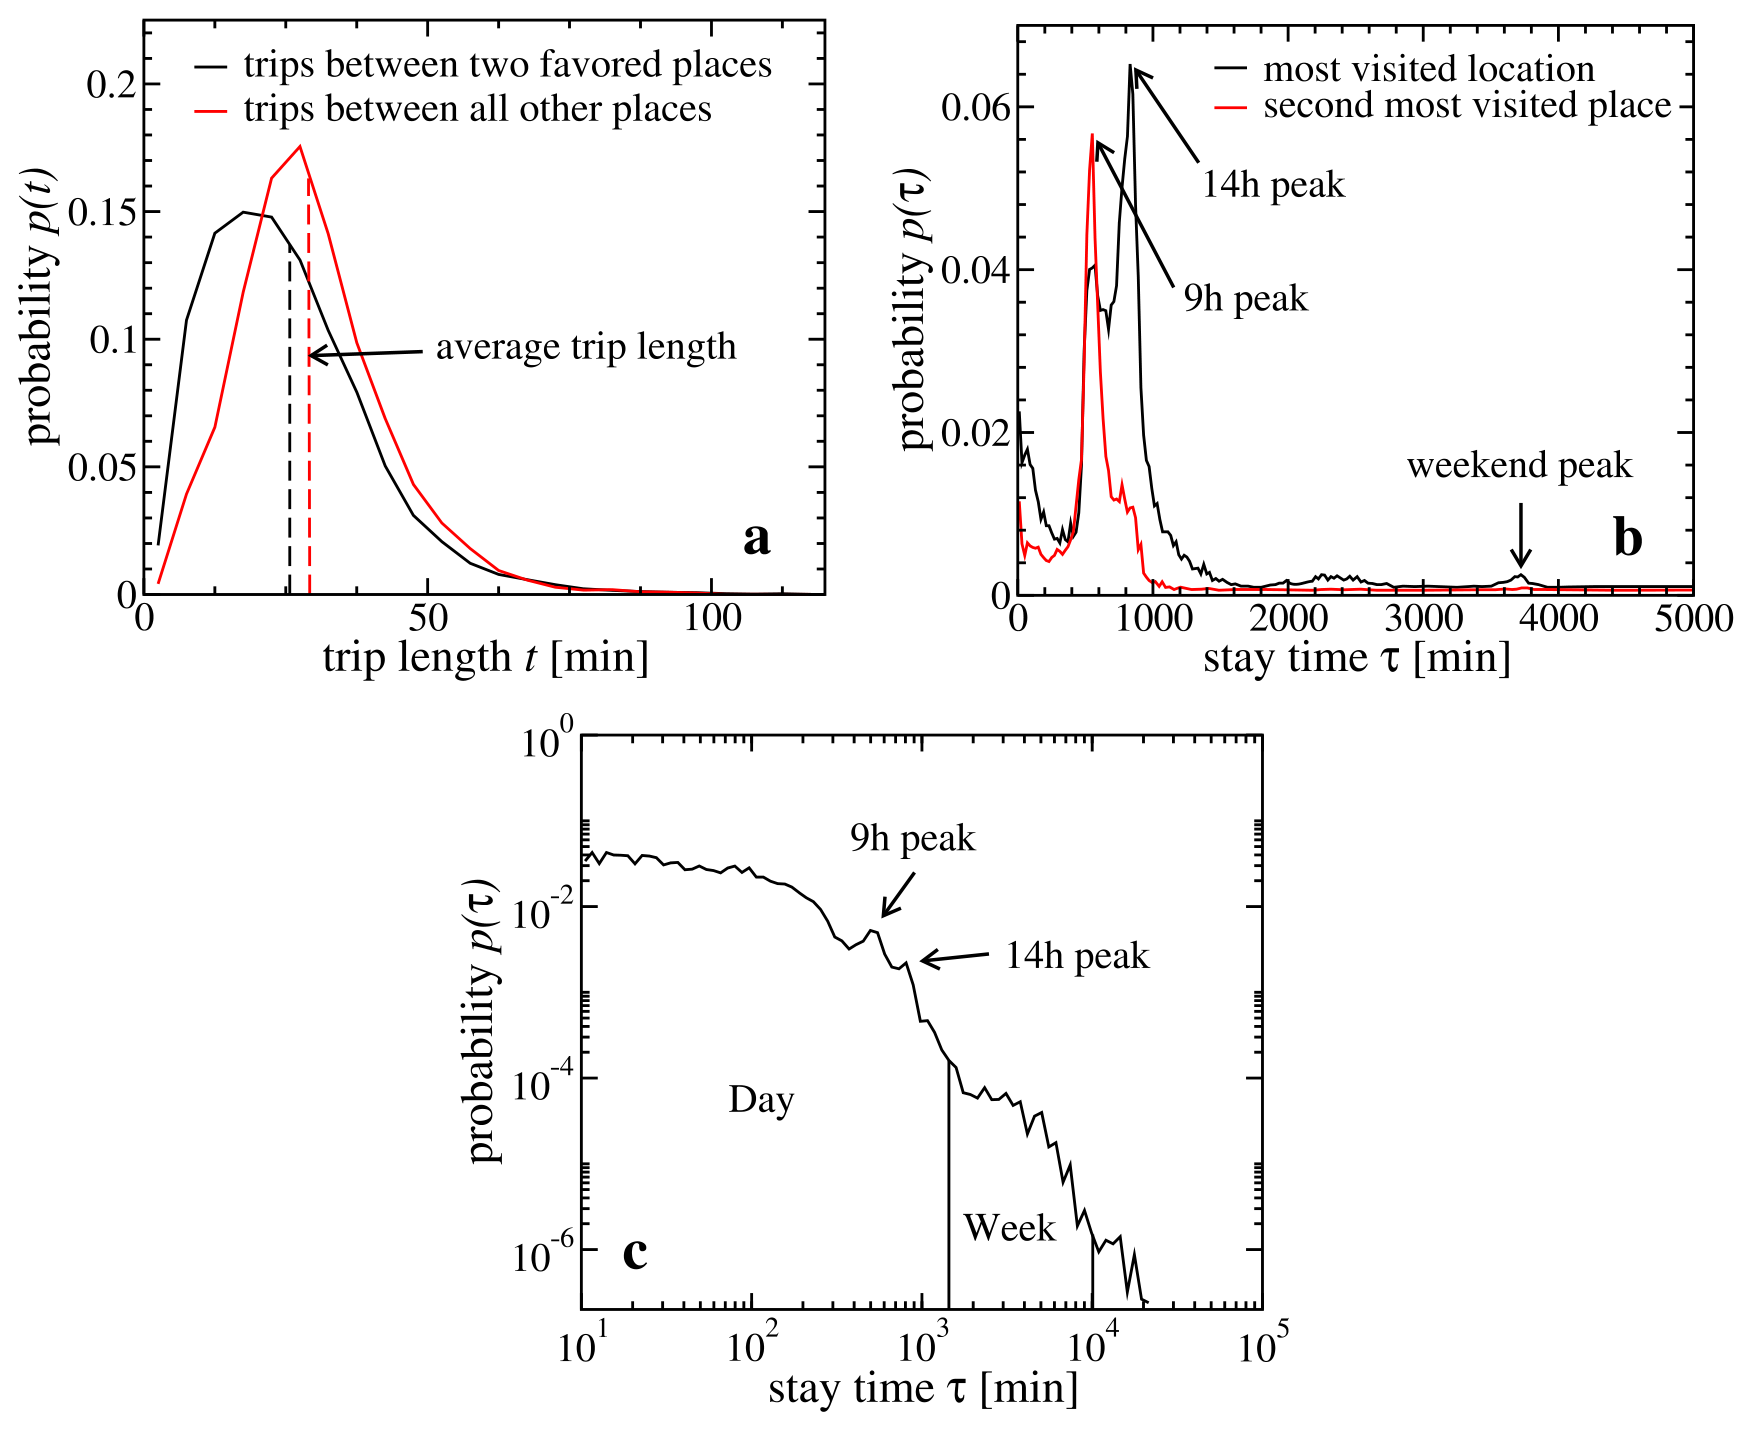
图 3|相同的等待时间模型,适合所有类型的地点吗?
(a)横轴为旅行分钟数,黑线对应前两常访地点之间,红线对应其他行程,虚线标出各自均值;两类分布有清楚的中心范围。
(b)横轴为停留分钟数,黑线为最常访地点,红线为第二常访地点;9小时、14小时和周末附近标记展示固定活动节奏。
(c)其他地点的停留分布使用双对数坐标,覆盖较长时间范围;图中保留日、周尺度和9小时、14小时标记。它与前两类地点形状不同,支持分类型处理。来源:原论文 Fig. 3。
访问排名的规律,能从第三名开始算吗?
访问频率p(L)表示访问排名L的地点占个人访问次数的比例。少数地点贡献了大部分访问:访问过10处的人,前两名合计约占82%;访问过40处的人,前两名合计约占53%。这是访问次数份额,不是全天时间份额。
排名大于2的部分近似呈Zipf式衰减,即排名越低,访问频率越小;衰减参数又随总地点数N变化,约满足η∝N⁻⁰·⁶³。将不同N组的曲线按相应参数调整后,可以大致重合。前两名位于该尾部规律之外,正好说明只用一条排名律会遗漏固定往返。
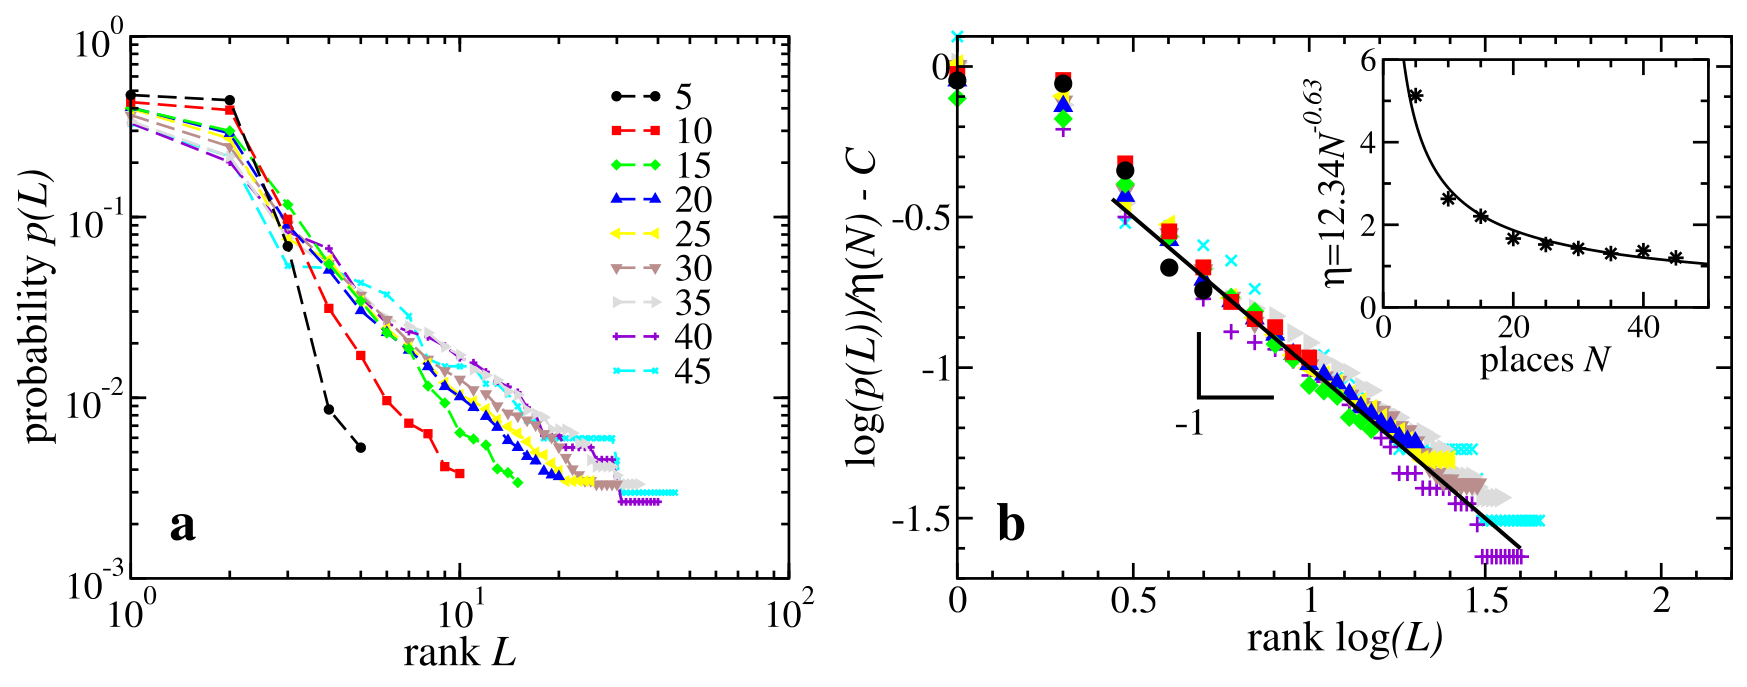
图 4|固定地点与偶尔访问地点,是否遵循同一条排名曲线?
(a)横轴为访问排名L,纵轴为访问频率,颜色区分总访问地点数N=5—45的用户组;前两名频率接近,之后明显下降。(b)按η与归一化常数调整后,较低排名部分接近共同趋势;插图标出η≈12.34N⁻⁰·⁶³的经验关系。曲线重合是描述性规律,不直接识别个人为什么选择某个地点。来源:原论文 Fig. 4。
模型怎样把固定往返与热门地点放在一起?
每个主体先获得两个不同的固定站,作为排名1与2的地点,在站点集合中随机均匀指定;模型示例使用100个站,模拟三个月。站点是抽象标签,未直接指定真实地理距离,因此这不是对伦敦每一条实际路线的精确预测器。
转移规则取决于当前位置。离开地点1后,以β=0.3转去地点2,其余概率转去其他地点;离开地点2后,以α=0.4转去地点1;在其他地点时,以α、β分别选地点1、2,其余概率选其他地点。α和β是规则参数,不能不加区分地称为每个用户最终恰好40%、30%的时间在两处。
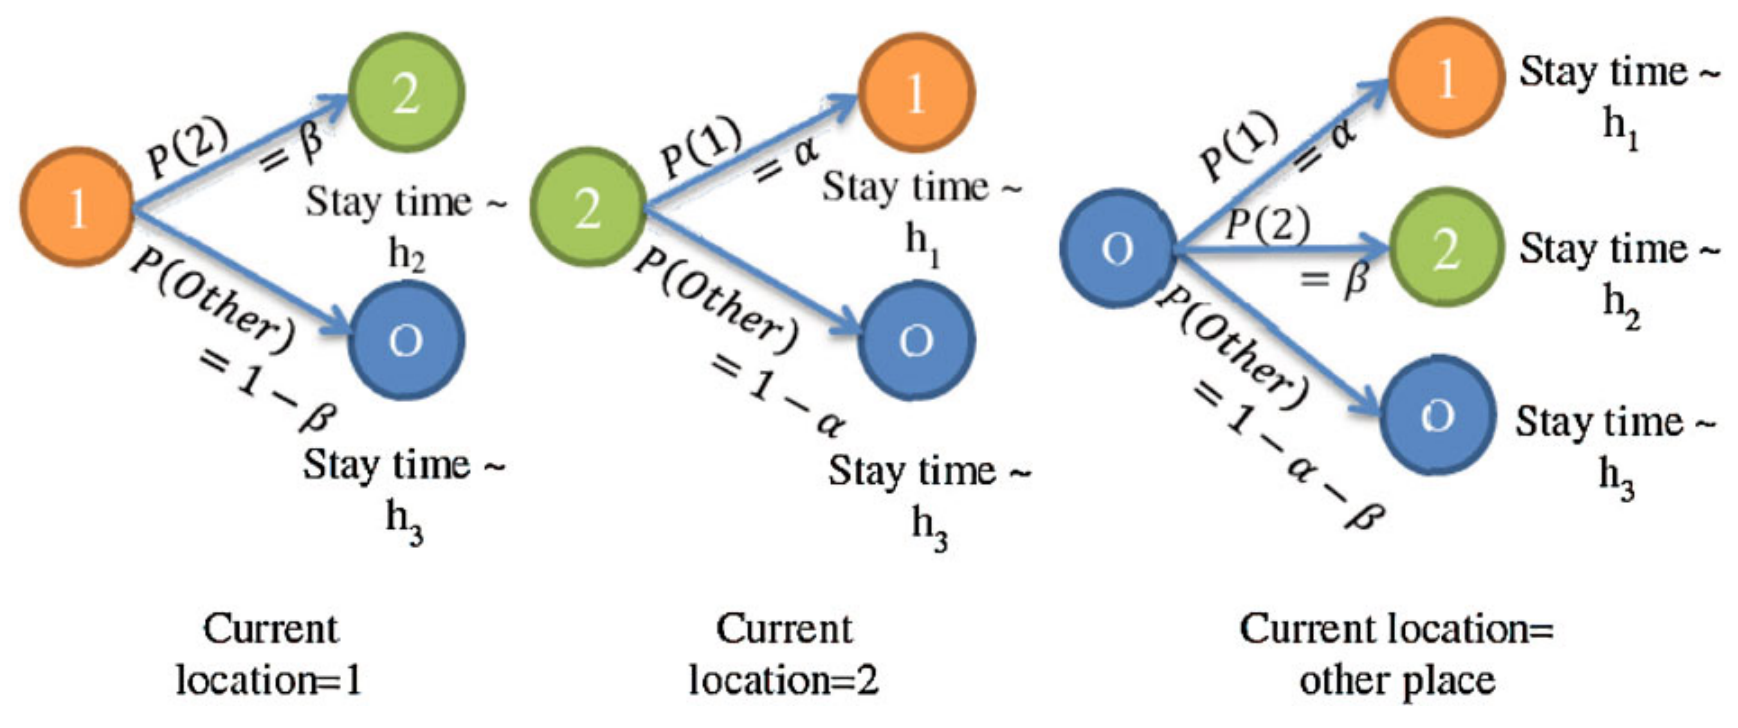
图 5|当前位置不同,下一站的候选概率是否相同?
该图无字母子图。左、中、右三组分别以地点1、地点2、其他地点为当前状态,橙、绿、蓝代表三类目的地,箭头给出α、β及剩余概率。h₁、h₂、h₃对应三类地点的持续时间处理,不能把箭头概率与停留时长混作同一个量。来源:原论文 Fig. 5。
停留采用风险率(hazard rate)h(t)=f(t)/(1−F(t)):已经停留到t时,接下来很短时间内结束这次停留的速率。三类地点分别从实测时长分布估计。风险率乘以很小的时间间隔才近似为离开概率,风险率本身不是“继续留下的概率”。
真正连接不同主体的是其他地点的选择。地点i被选的概率与vi成正比,vi统计所有主体已对该地点贡献的访问量;选中后继续增加访问量。这是总体热门程度的累积反馈,不同于只按个人过去去过几次来返回,也不是观测到朋友之间的直接社会影响。
初始权重设为vi=i,本身已经给不同站点不同的起始权重。因而模型展示的是在既定不均匀起点和反馈机制下的结果,不能把全部地点差异都归功于从完全平等状态自发产生的热门效应。
不直接规定探索衰减,能出现缓慢发现新地点吗?
模型没有另设“随着个人已去地点增多,新地点探索概率必然下降”的函数。只要主体不断偏向热门站,不常去的地方就较难被选中,个人累计发现新地点的速度也会变慢,而且最终受100站总量限制。
模拟与数据在三项统计上近似一致:站间流量的宽分布、累计不同地点数S(t)约随t⁰·⁶增长,以及访问较多地点用户的排名频率。图中的−1.9、0.6、−1.2线均是读图参照,原图注明幂律线仅作为视觉引导,不能写成严格证明的统一指数。
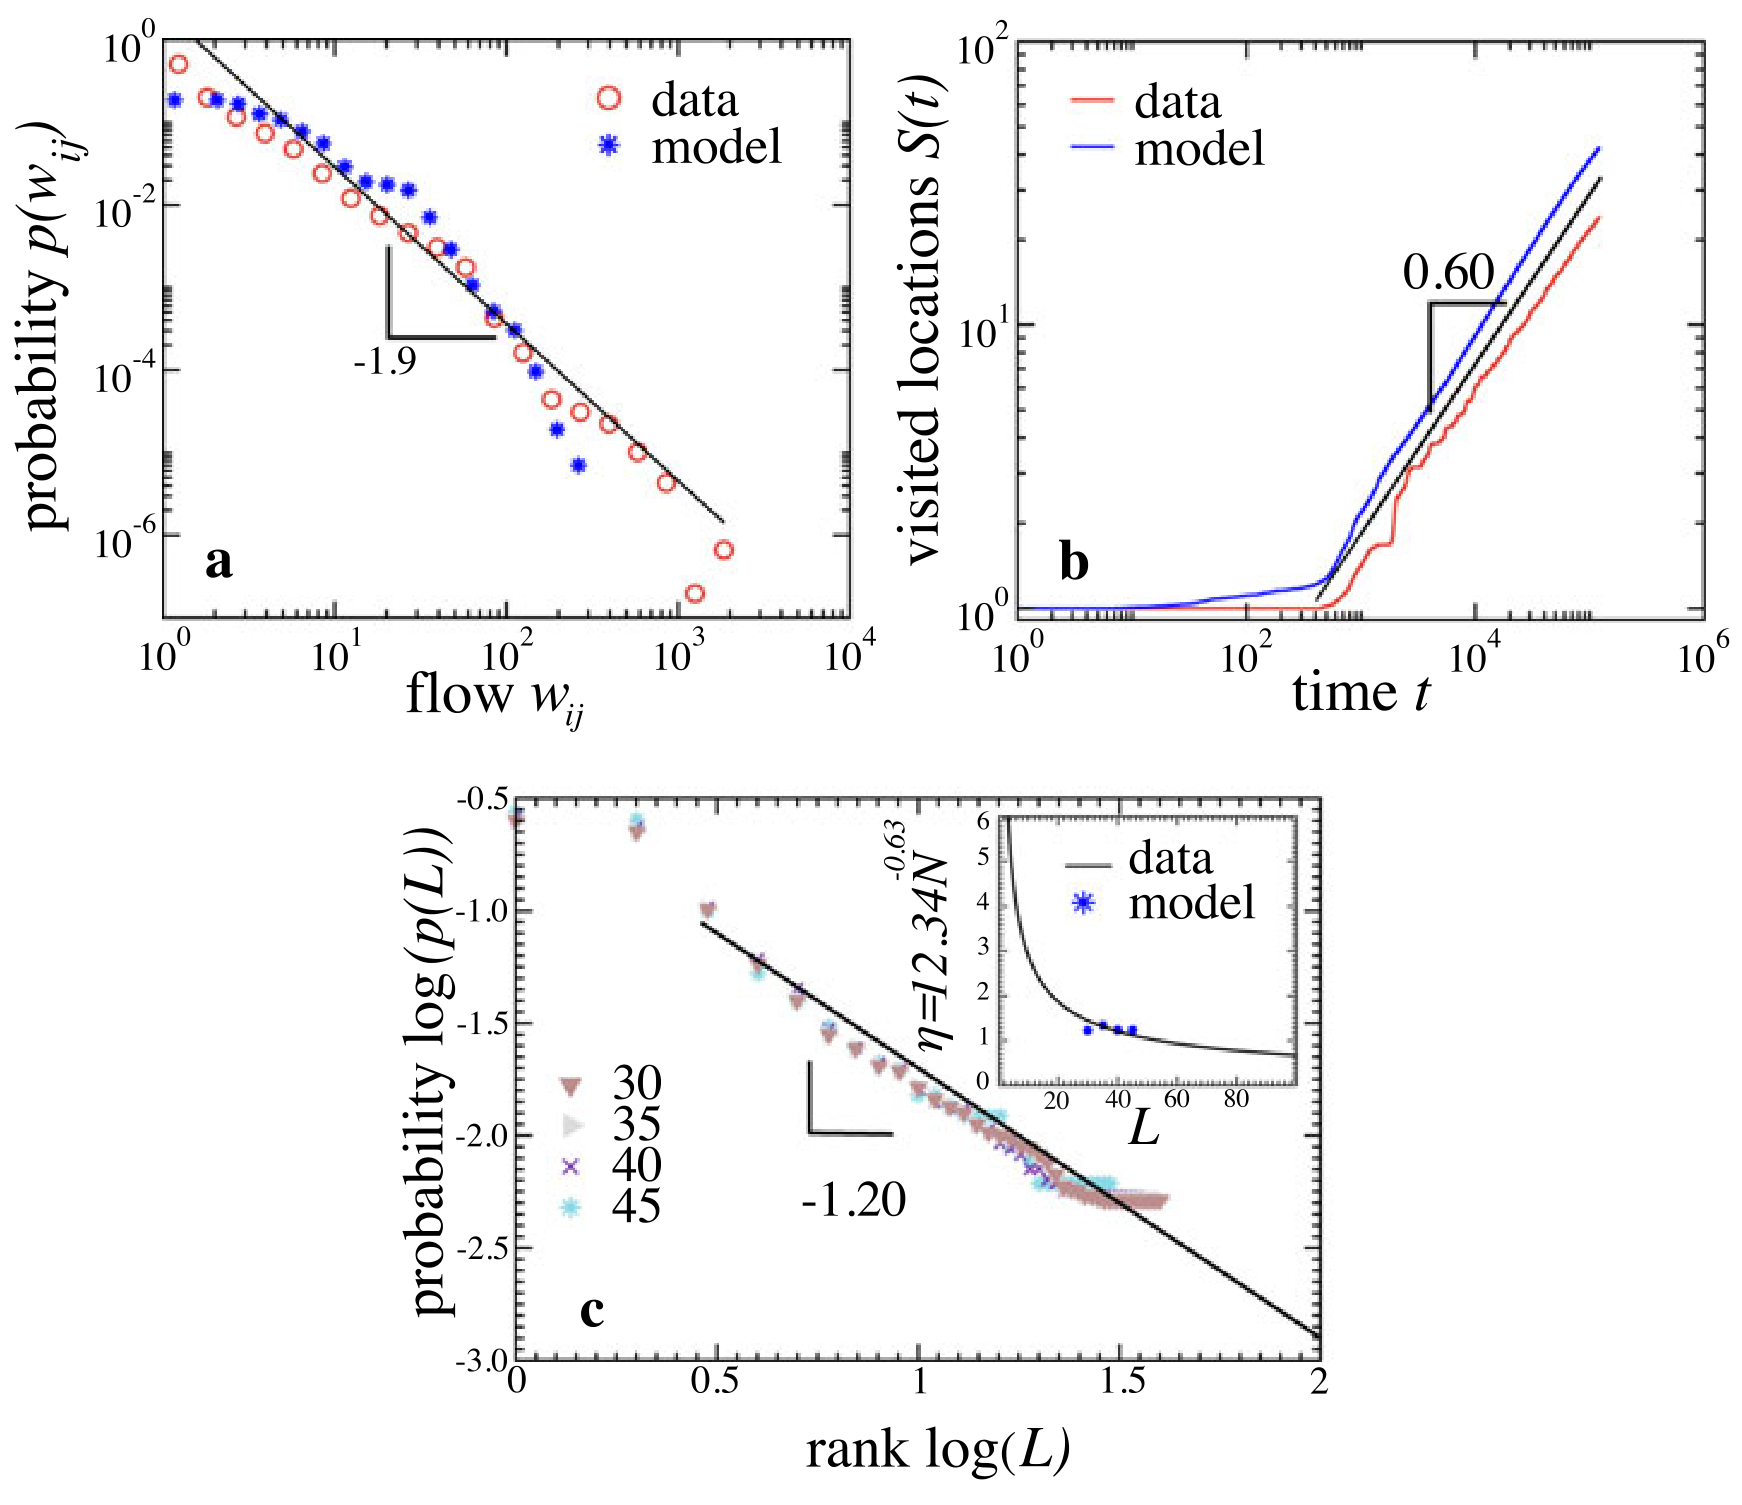
图 6|简单热门选择,能同时复现哪些统计特征?
(a)横轴wij为一对站之间的旅行数量,纵轴为此类流量的分布,红圈是实测,蓝点是模型;它比较流量分布形状,没有逐条验证具体OD连接。
(b)横轴为观察时间,纵轴为累计访问地点数S(t),数据与模型均呈次线性增长,0.60斜率作为参照;两条曲线的高度和起始过渡并非完全相同。
(c)横轴为访问排名对数,纵轴为访问频率对数,展示访问30—45处的主体组,参照斜率约−1.20;插图将模型参数与经验η关系比较。来源:原论文 Fig. 6。
哪些失败,暴露了模型缺少的东西?
所有主体使用同一组α、β,使模拟地点数过于集中。图7中模型的高斯参照均值约42.36、标准差5.82,数据参照约23.4、11.5:模型不仅分布较窄,中心位置也偏高。能让某些高活动用户的排名曲线相似,不等于覆盖了全体用户的活动差异。
更明显的缺口来自钟表。模型处理了“已经停留多久”,却没有让选择规则依赖“现在是星期几、几点”。前者可以产生9小时停留,仍不足以让许多人同时在早晨到达某处。真实第一、第二常访地点的占用概率有强烈昼夜变化,模拟曲线却接近水平。
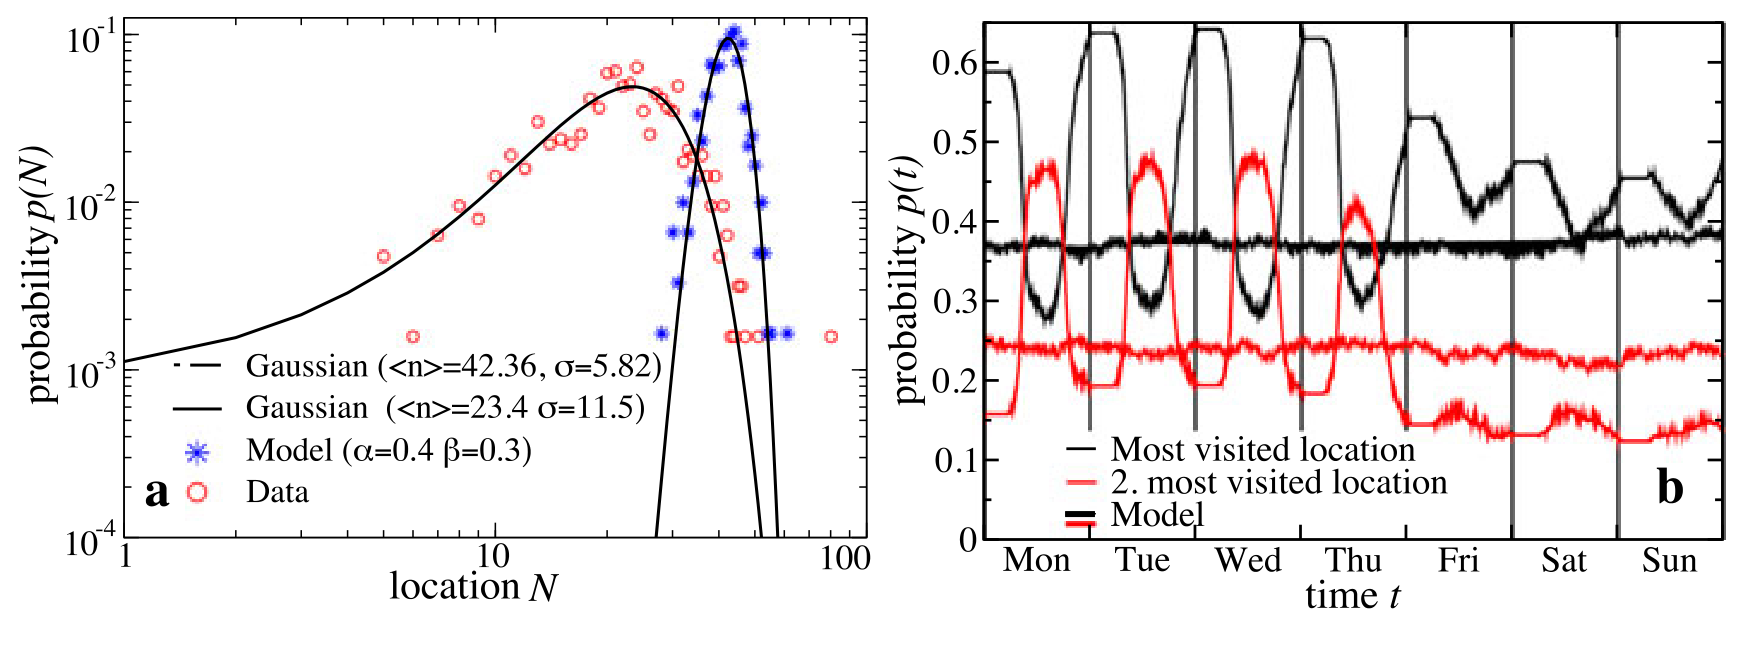
图 7|复现了总体流量,为什么仍没有生成真实日程?
(a)横轴为总访问地点数N,红圈为数据,蓝点为模型,两条黑色高斯线显示分布中心与宽度差异。(b)横轴为一周时间,黑、红分别对应第一、第二常访地点;真实曲线有明显工作日和周末节奏,模型同色曲线主要围绕平均值小幅变化。来源:原论文 Fig. 7。
最后三幅个体记录把这个差别具体呈现出来。它们的纵轴都是按个人访问频率排序后的地点编号,数字大不代表地理距离远。示例只能帮助读图,不是额外的统计显著性检验。
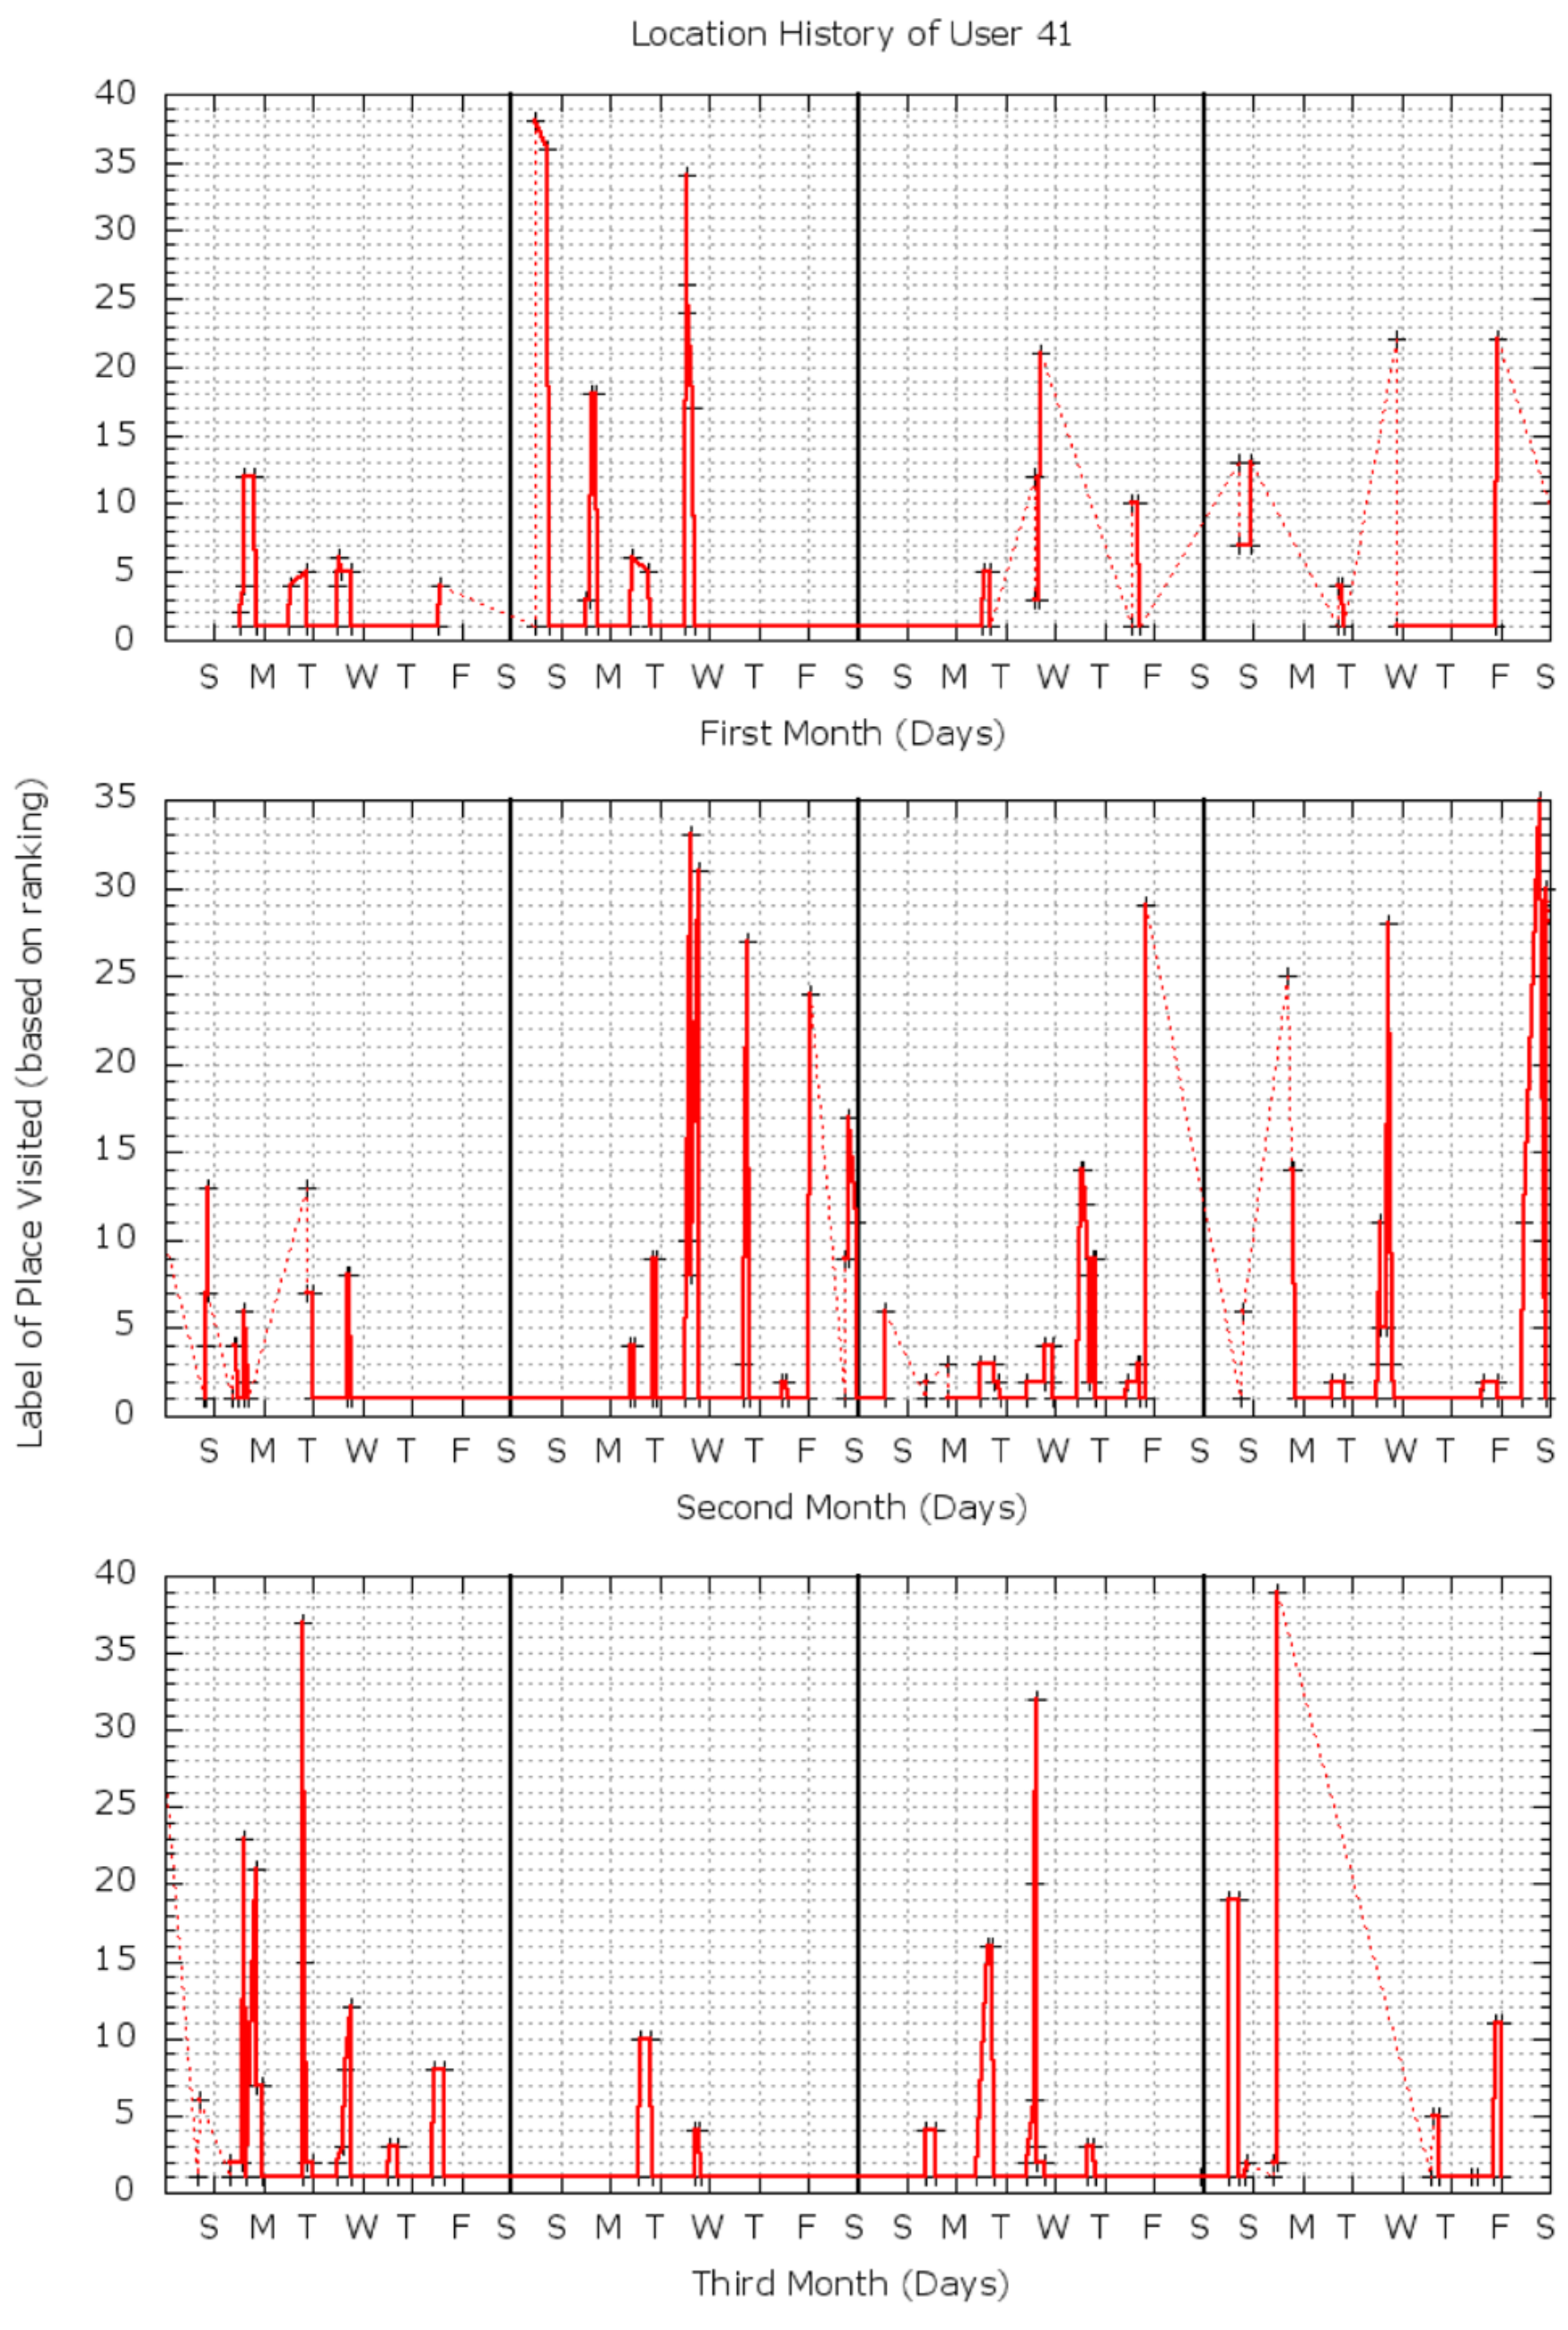
图 8|真实高活动用户,怎样在固定地点与较少访问地点之间切换?
原图无字母标号,上、中、下依次为第一、第二、第三个月。横轴为天及周内顺序,红线记录访问排名编号;这位真实用户共访问39处,常见地点之间夹杂较低频地点,并保留日程限制。来源:原论文 Fig. 8。
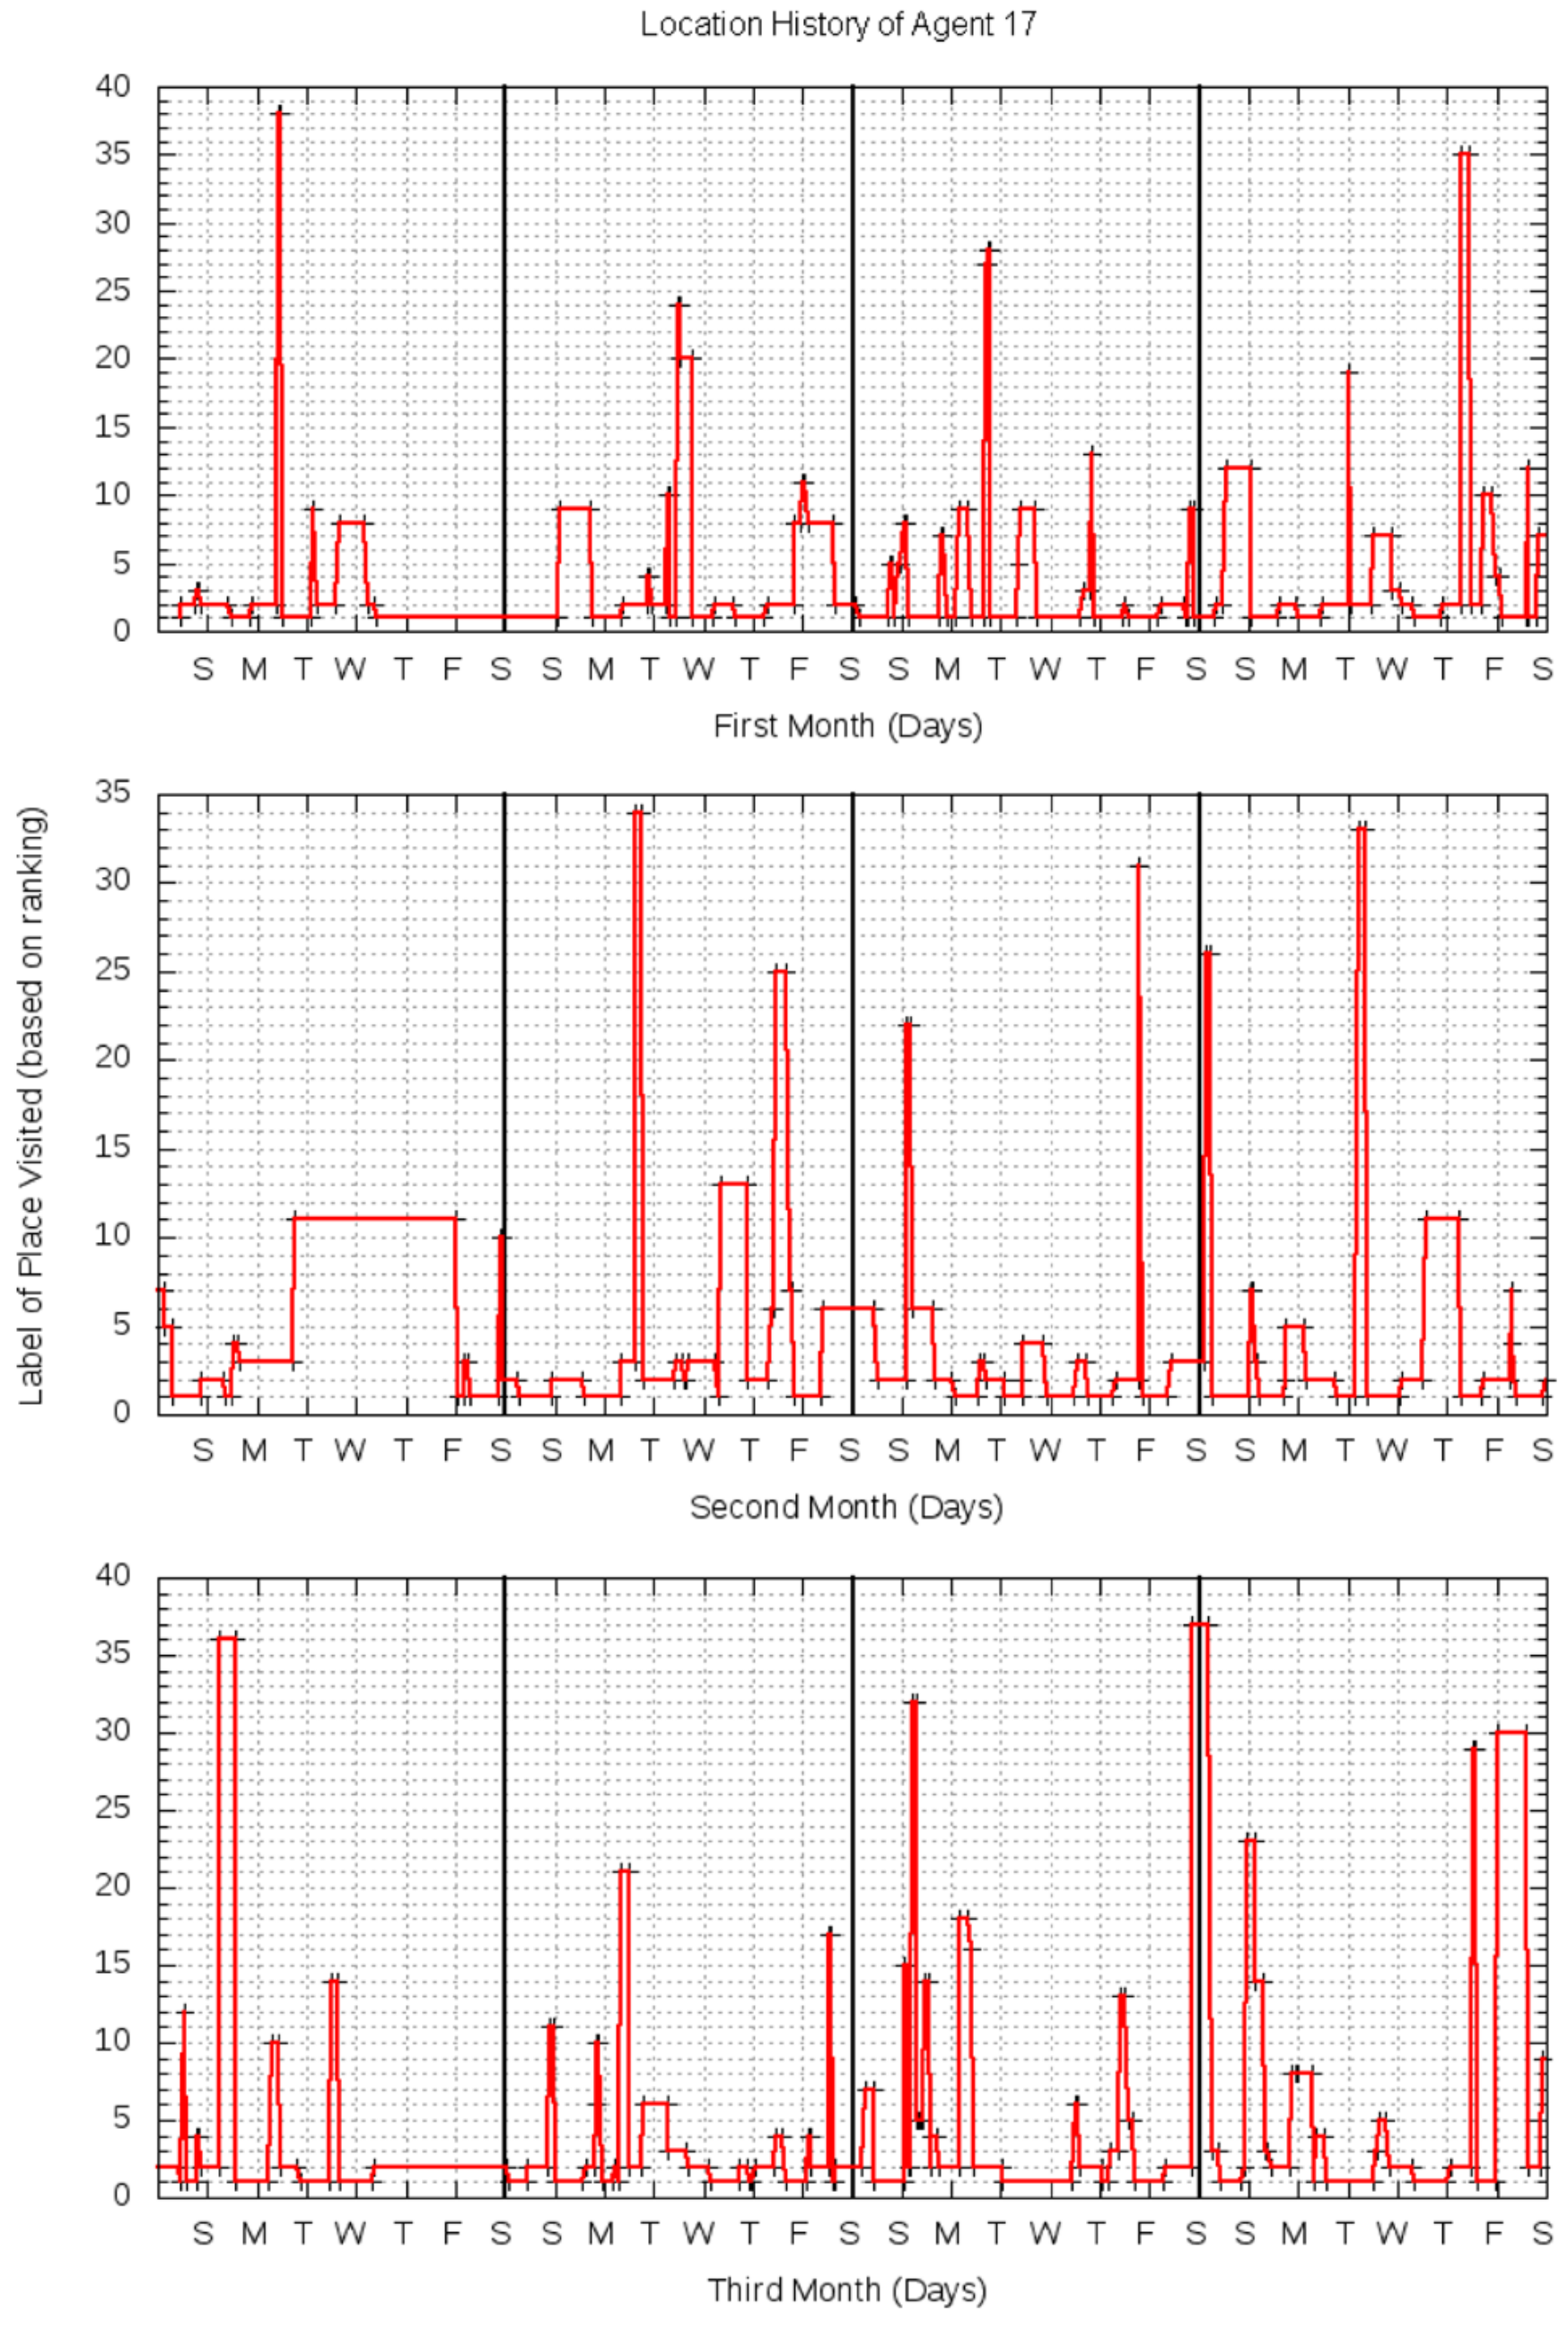
图 9|地点数接近真实用户,是否就意味着时间安排也接近?
上、中、下为模拟主体的三个月记录,轴含义与图8一致。这位主体访问38处,总地点数接近图8,但选择时间缺少真实昼夜限制,仍会出现不符合共同作息的访问序列。来源:原论文 Fig. 9。
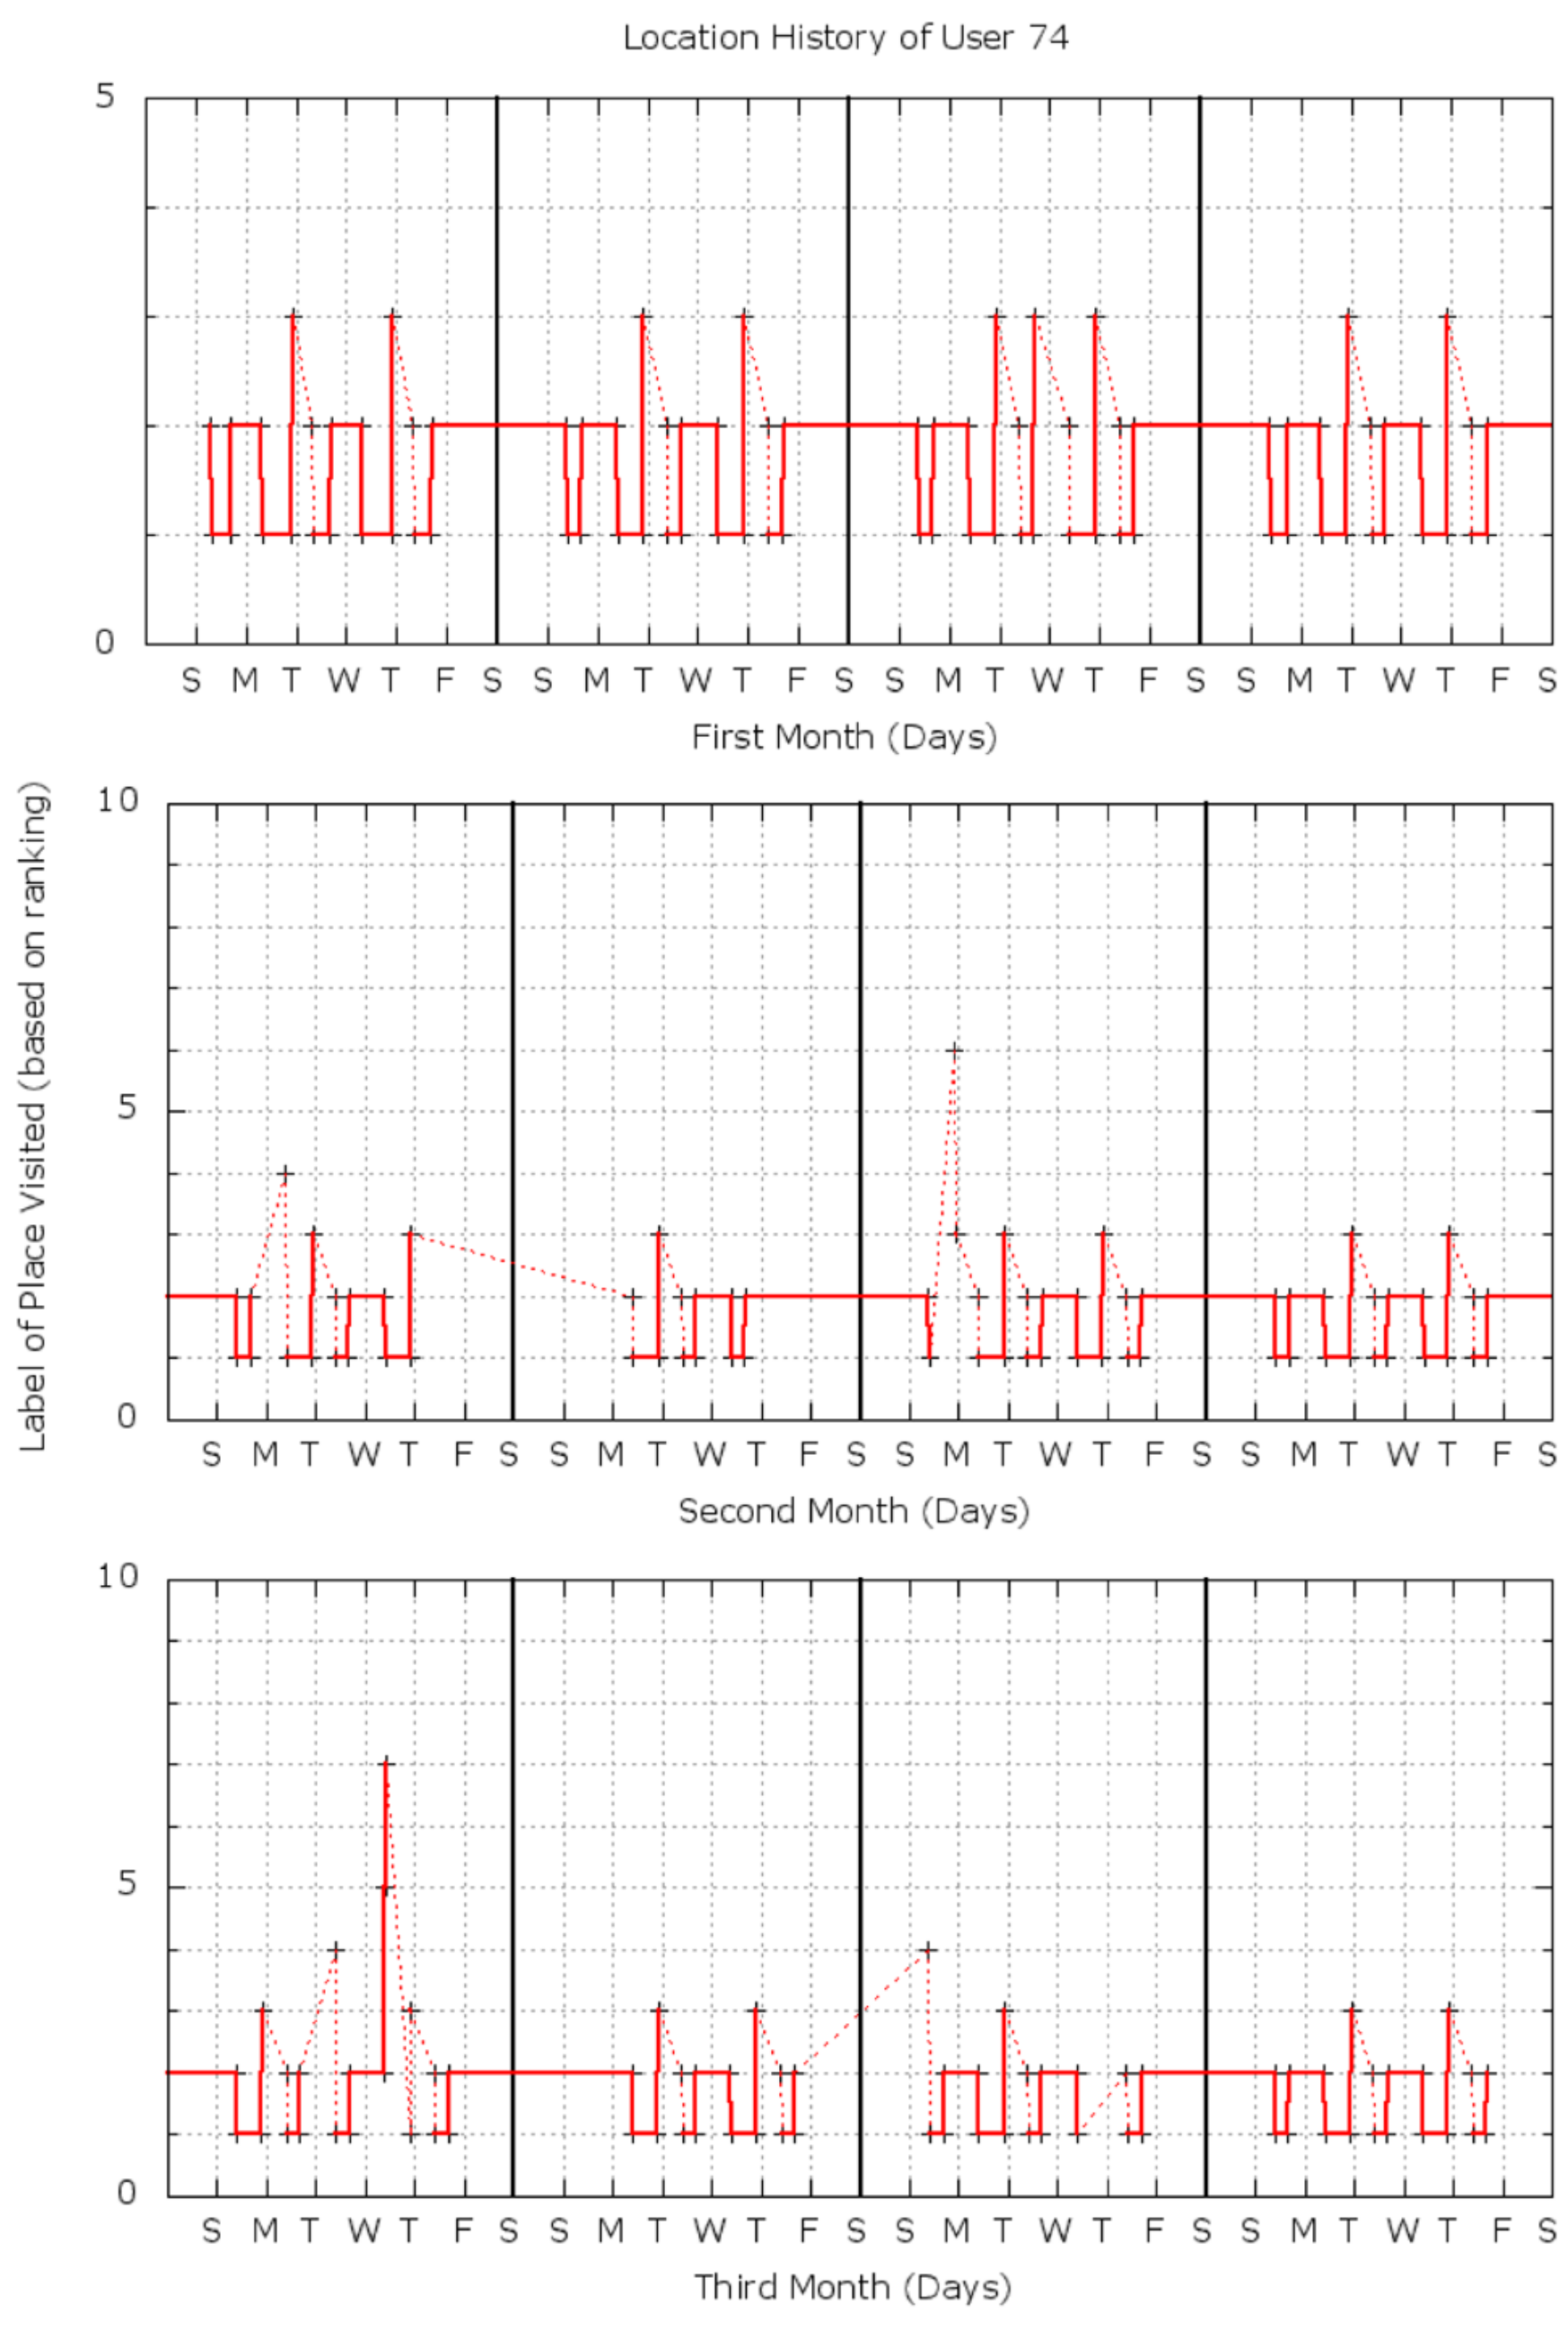
图 10|高度规律、只访问少数地点的人,模型同样解释了吗?
上、中、下为另一位真实用户的三个月记录,共访问7处。前两名之间的重复往返非常突出;注意三个月面板纵轴范围不同。统一参数模型较难同时生成这种低活动用户和前面高活动用户。来源:原论文 Fig. 10。
这是一种什么程度的解释?
论文的重要贡献,是显示全体访问量驱动的热门反馈,足以在一个简单模型中生成若干个体与总体统计形状。但模型直接使用实测停留分布,不能把时长分布的相似当作完全独立预测;随机指定固定站与抽象站点标签,也没有验证实际城市几何与真实OD的逐项准确性。
与此同时,记录只覆盖地铁使用,站点附近的真实活动和未记录交通仍有缺失。将全体访问量解释成主体之间的“相互作用”是一种建模方式,不证明乘客实际观察了别人的选择。要把它用于具体出行预测,还需要地理约束、个人差异、日内节奏,以及独立未来时段的验证。
一句话总结
热门地点的累积反馈可以生成不均匀流量和缓慢探索,但要还原真实乘客的一天,还必须解释人群差异与共同作息。
核心来源
- 原论文及出版信息:全文304—318页、Figs. 1—10、模型方程与局限讨论。各图均来自原论文同编号完整图。
- 数据由伦敦交通局为运营目的收集并匿名化,研究通过MIT Transit Research Group取得使用许可;本文样本为所述626位用户。
作者介绍
Samiul Hasan:论文署名为美国普渡大学土木工程学院。
Christian M. Schneider:论文署名为麻省理工学院土木与环境工程系。
Satish V. Ukkusuri:论文署名为普渡大学土木工程学院。
Marta C. González:论文通信作者,署名为麻省理工学院土木与环境工程系。以上均为原论文发表时机构信息。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
衡量一座车站总共多热门,与判断它在几点会拥挤,是两个不同目标。即使日客流总量一样,把所有乘客的出发时刻随机打乱,也会改变瞬时拥挤、换乘压力和等待时间。
因此,若用这类模型评估交通服务,可以先保持每日OD总量不变,只替换时间安排:一组使用独立停留与转移,另一组加入经验工作日、周末的共同作息。两者的高峰流量与拥挤持续时间之差,才能具体显示“时间同步”在基础设施需求中贡献了多少。
