路过的人变多时,财产类警情会不会增加得更快?
论文名片|Carlos Caminha、Vasco Furtado、Tarcisio H. C. Pequeno、Caio Ponte、Hygor P. M. Melo、Erneson A. Oliveira、José S. Andrade Jr.,Human mobility in large cities as a proxy for crime,PLOS ONE,2017,12(2):e0171609,2017年2月3日发表。DOI:10.1371/journal.pone.0171609。正式发表版的观察研究,比较巴西福塔莱萨市内各集群的居民人口、公交经过人数和两类报警次数。
福塔莱萨的密度图在市中心画了一个黑圈。圈里居民少,扰乱治安的报警也少;经过的人流和财产类报警却密。两种人数需要分开:住在普查区里的居民,以及一天里乘公交经过该普查区的人。
这篇论文问的是,集群变大以后,报警次数是跟着人数等比增加,还是增加得更快。结果取决于和哪一种人数配对。财产类报警次数随公交经过人数超线性增加,扰乱治安报警次数随居民人数超线性增加;交叉配对更接近等比,拟合也更弱。三套数据分别来自 2005–2007 年、2010 年和 2015 年,所以这是同一座城市里、按地点叠在一起的横截面关联。
先说结论
- 在 3,043 个普查区上,居民人口、流动人口与两类报警的四张散点,判定系数都低于 0.15。这里的分母是普查区。
- 把普查区收成集群并选定边界后,财产类报警次数对流动人口的标度指数为 1.15±0.04,判定系数 R²=0.84;扰乱治安报警次数对居民人口的指数为 1.18±0.04,R²=0.86。每个点是一个集群。
- 交叉组合更接近等比:流动人口与扰乱治安为 0.93±0.10,R²=0.65;居民人口与财产类报警为 1.01±0.06,R²=0.76。0.93 加上所给的 0.10 会跨过 1,正文要求谨慎解释。
- 参数窗口里还有一组平均指数。居民人口与扰乱治安在约 180–300 米为 1.17±0.06。320–510 米这一段正文印出 1.14±0.04;图 4(b) 把该段画成流动人口与财产类警情,同一句正文写成流动人口与扰乱治安。1.14±0.04 也不同于选定参数后的 1.15±0.04。
- 三套全市总数来自三个年份:2010 年约 2,400,000 名居民、314 平方公里;2015 年公交系统 2,034 辆车、359 条线路、每日约 700,000 名乘客;2005 年 8 月至 2007 年 7 月,财产类报警 81,911 次,扰乱治安报警 53,849 次。
市中心的两张密度图,为什么不像同一件事?
研究对象是福塔莱萨这一座城市。居民人口(resident population,POP)来自巴西地理统计局 2010 年人口,按普查区统计居民人数。全市 3,043 个普查区、约 2,400,000 名居民、314 平方公里。流动人口(floating population,FLO)用 2015 年市政公交数据推算,正文把它定义为一天内经过某个普查区的人数。当时有 2,034 辆公交车、359 条线路,每日大约 700,000 名乘客。700,000 是全市公交日客流。正文没有给出各普查区经过人数相加后的总和,也没有写同一个人经过多个普查区时记几次。
报警来自公共安全行动综合协调处的 190 紧急电话。2005 年 8 月至 2007 年 7 月,财产类警情(property crimes,PC)81,911 次,扰乱治安(disturbing the peace,DP)53,849 次。进入后文回归的纵轴,是集群在 2005 年 8 月至 2007 年 7 月的报警次数;这段首尾相距 24 个月。作者假定这 5 到 8 年里城市没有发生足以推翻地点对应的大规模断裂,并举出灾害、禁运和战争作为该假定不再适用的情形。
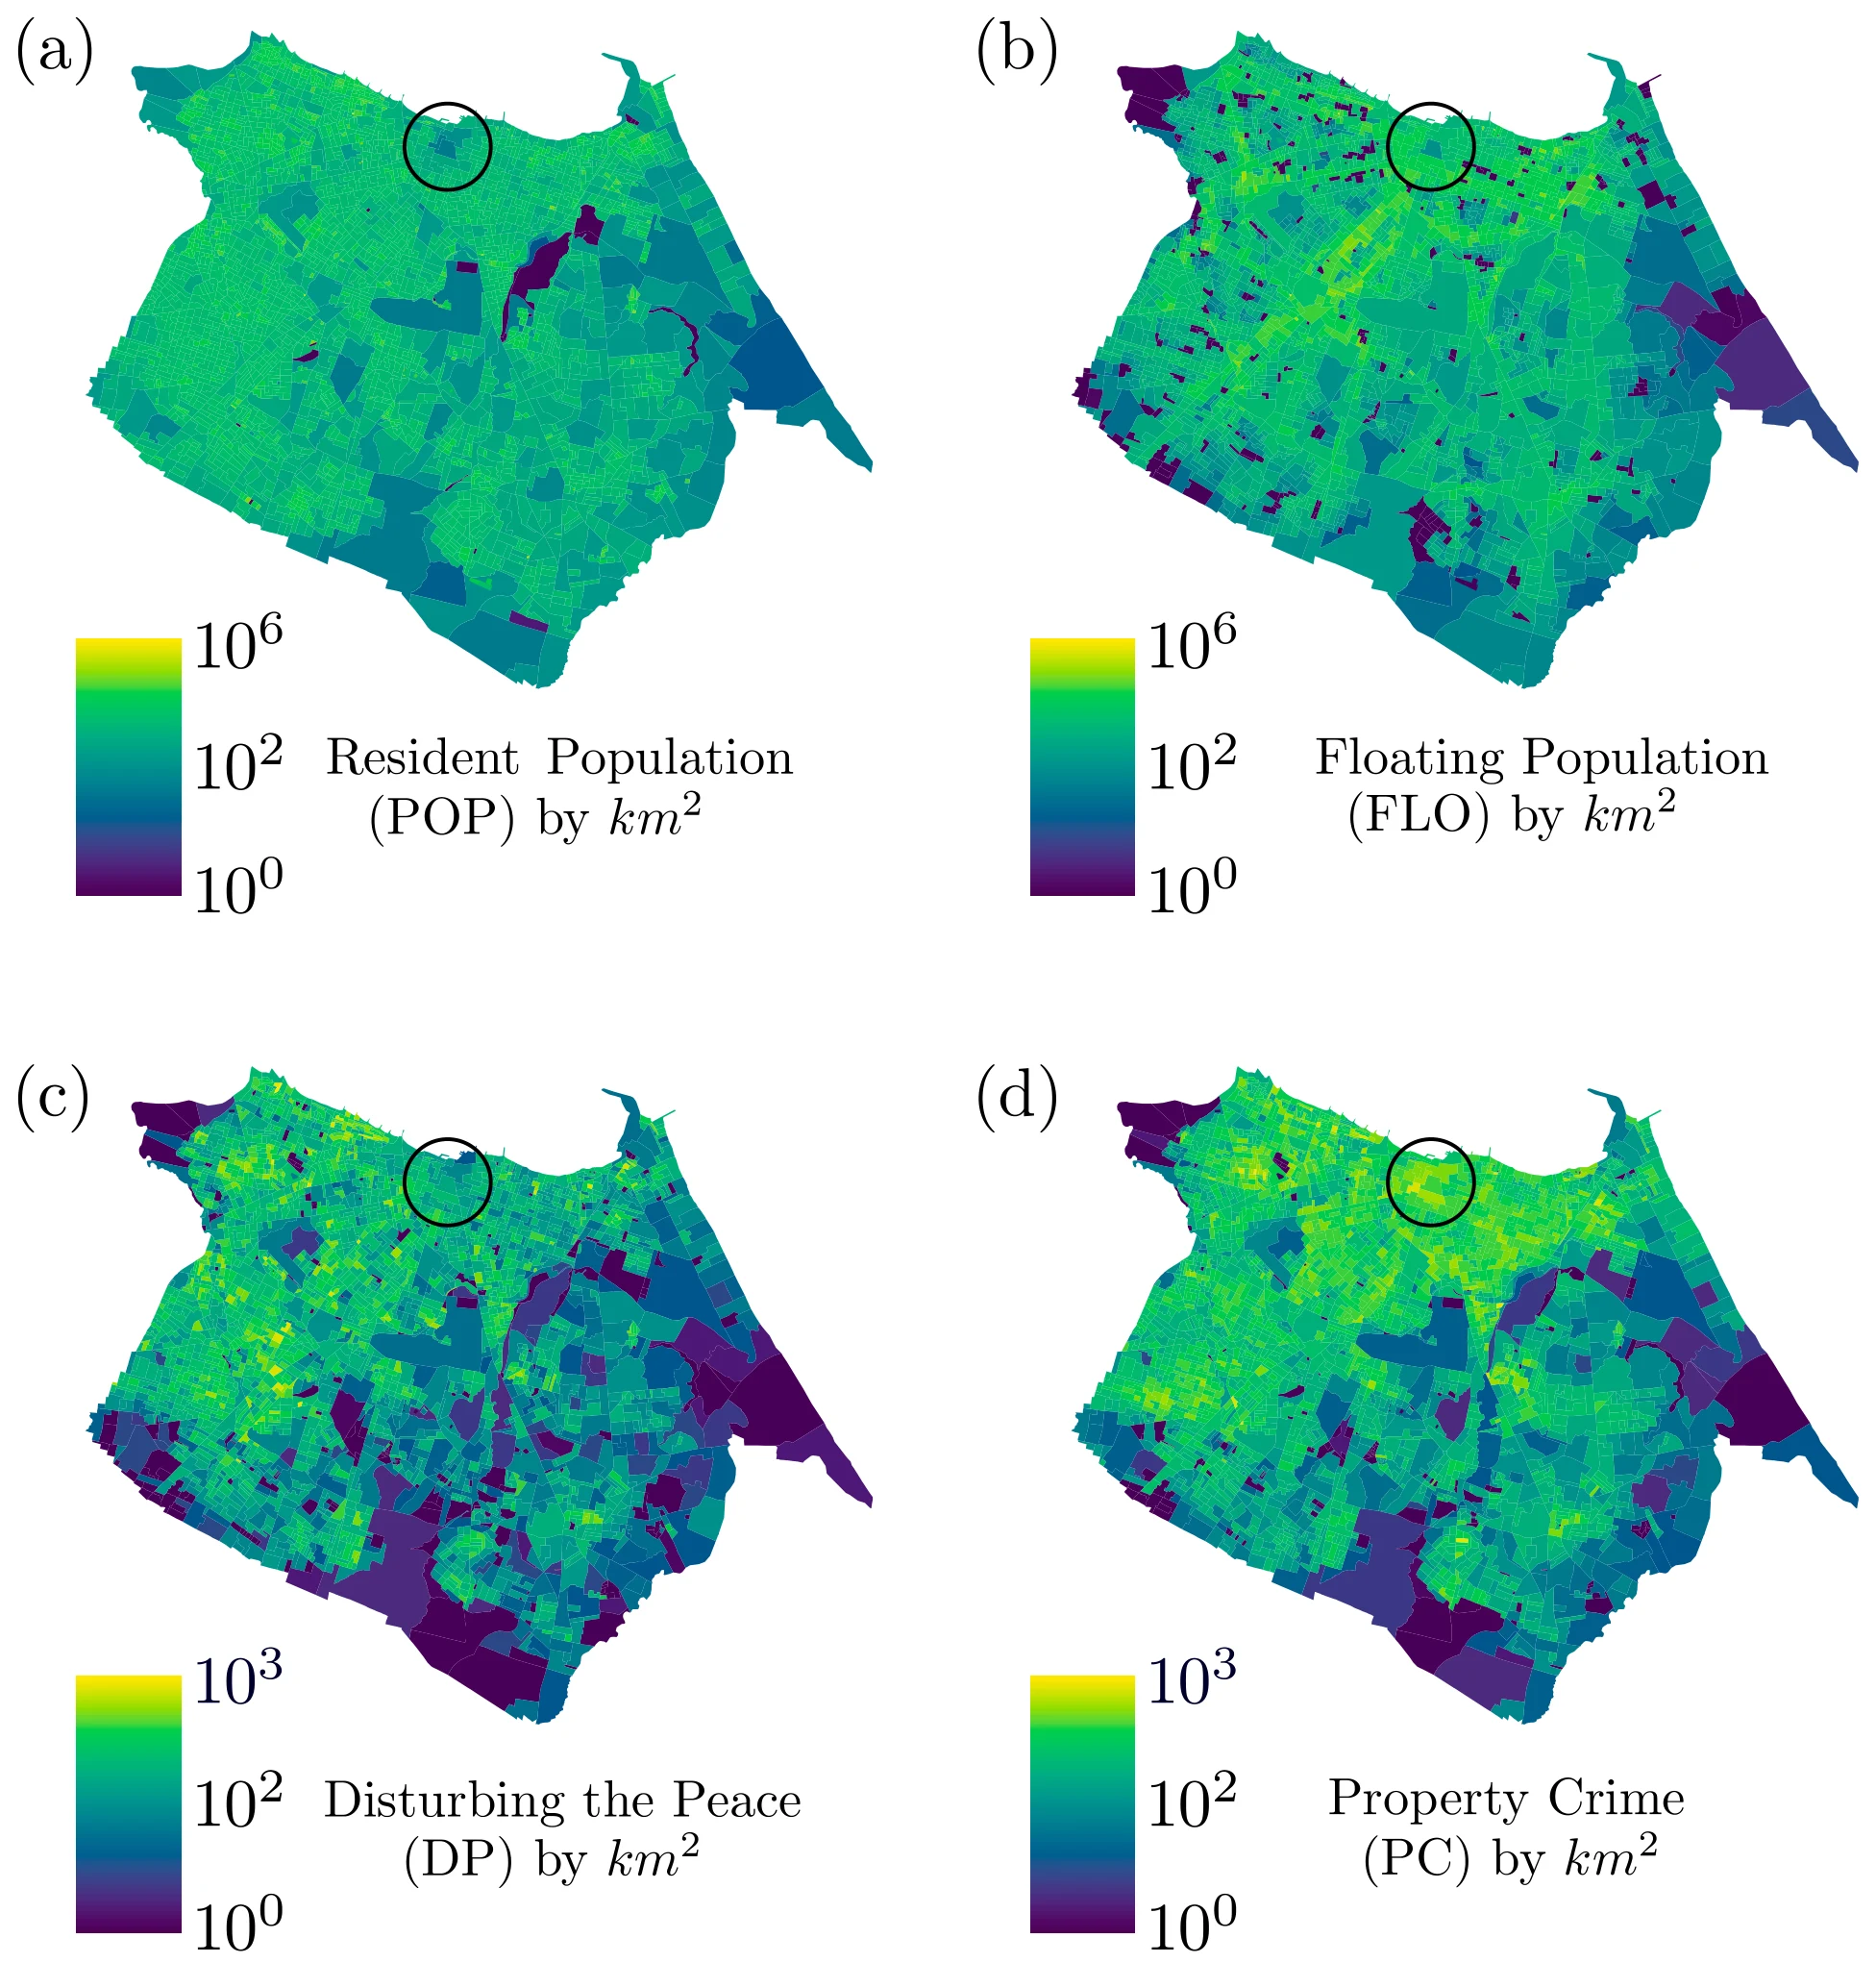
图 1|市中心的居民密度和人流密度,是否指向同一类报警?
(a)居民人口密度,对数色标从每平方公里 10⁰ 到 10⁶。(b)流动人口密度,色标同样到每平方公里 10⁶;人数定义是一天内的经过人数。(c)扰乱治安报警密度,色标到每平方公里 10³。(d)财产类报警密度,色标同样到 10³。黑圈标出市中心:居民和扰乱治安偏冷,人流和财产类报警偏热。四张图都是每平方公里密度,后面的回归用的是集群内人数和报警次数。来源:原论文 Fig. 1。
逐个普查区看,为什么四张图都散开?
密度图给出的是空间上的冷热。把每个普查区画成一个点之后,居民人数、经过人数和两类报警次数都对不齐。说明文字给出,四张散点的判定系数都低于 0.15。
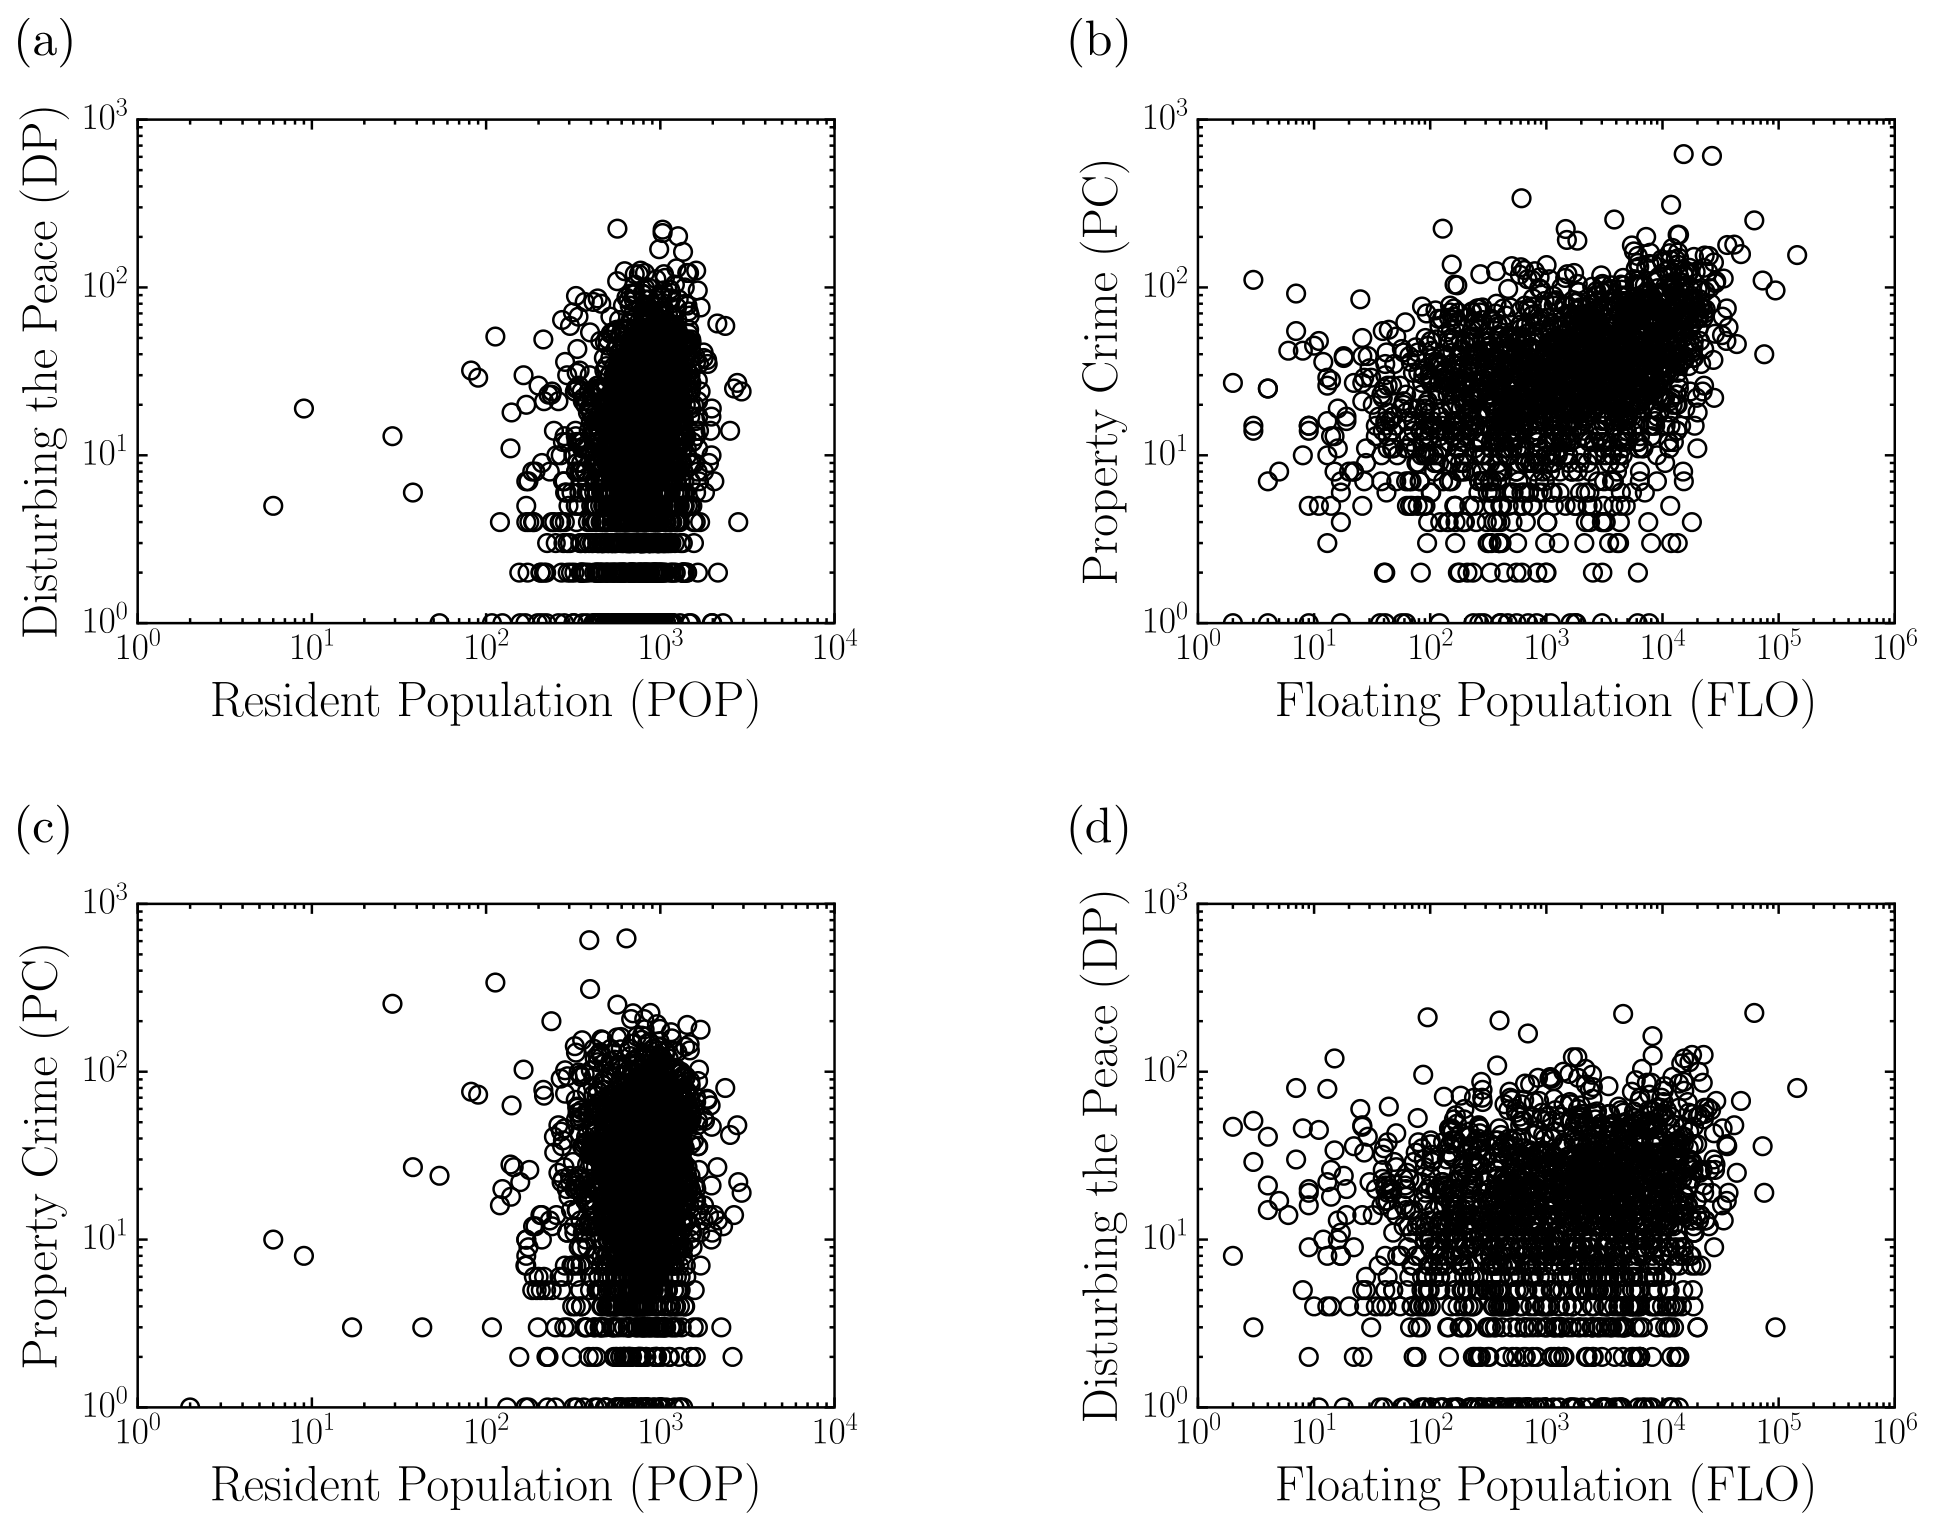
图 2|不合并普查区时,人数和报警次数有没有对齐?
(a)居民人口与扰乱治安。(b)流动人口与财产类警情。(c)居民人口与财产类警情。(d)流动人口与扰乱治安。横轴、纵轴都是对数坐标,每个点是一个普查区。四张图的判定系数都低于 0.15。居民人数的密集团块主要落在 10² 到 10³;流动人数的横轴标到 10⁶,点分布到 10⁴–10⁵ 这一量级。来源:原论文 Fig. 2。
多数普查区面积很小,有的只有一个街区;居民人数在各区之间又比较接近,点就会挤在一起。流动人口的横轴更散,四张图的判定系数仍都低于 0.15。普查区这个尺度上,两类人数和两类报警都还没有对齐。
街区合成集群之后,指数从哪一段开始稳住?
下一步是把相邻普查区收成更大的集群。集群边缘由人口密度和中心之间的距离决定。城市聚类算法(City Clustering Algorithm,CCA)用两个参数。密度阈值 D 决定一个普查区算不算“有人”:密度 Di 高于 D 才进入候选,Di 取在普查区的几何中心。距离阈值 ℓ 是中心之间的截止距离,小于 ℓ 的相邻普查区并入同一集群。从哪一个普查区开始搜索,结果不变。
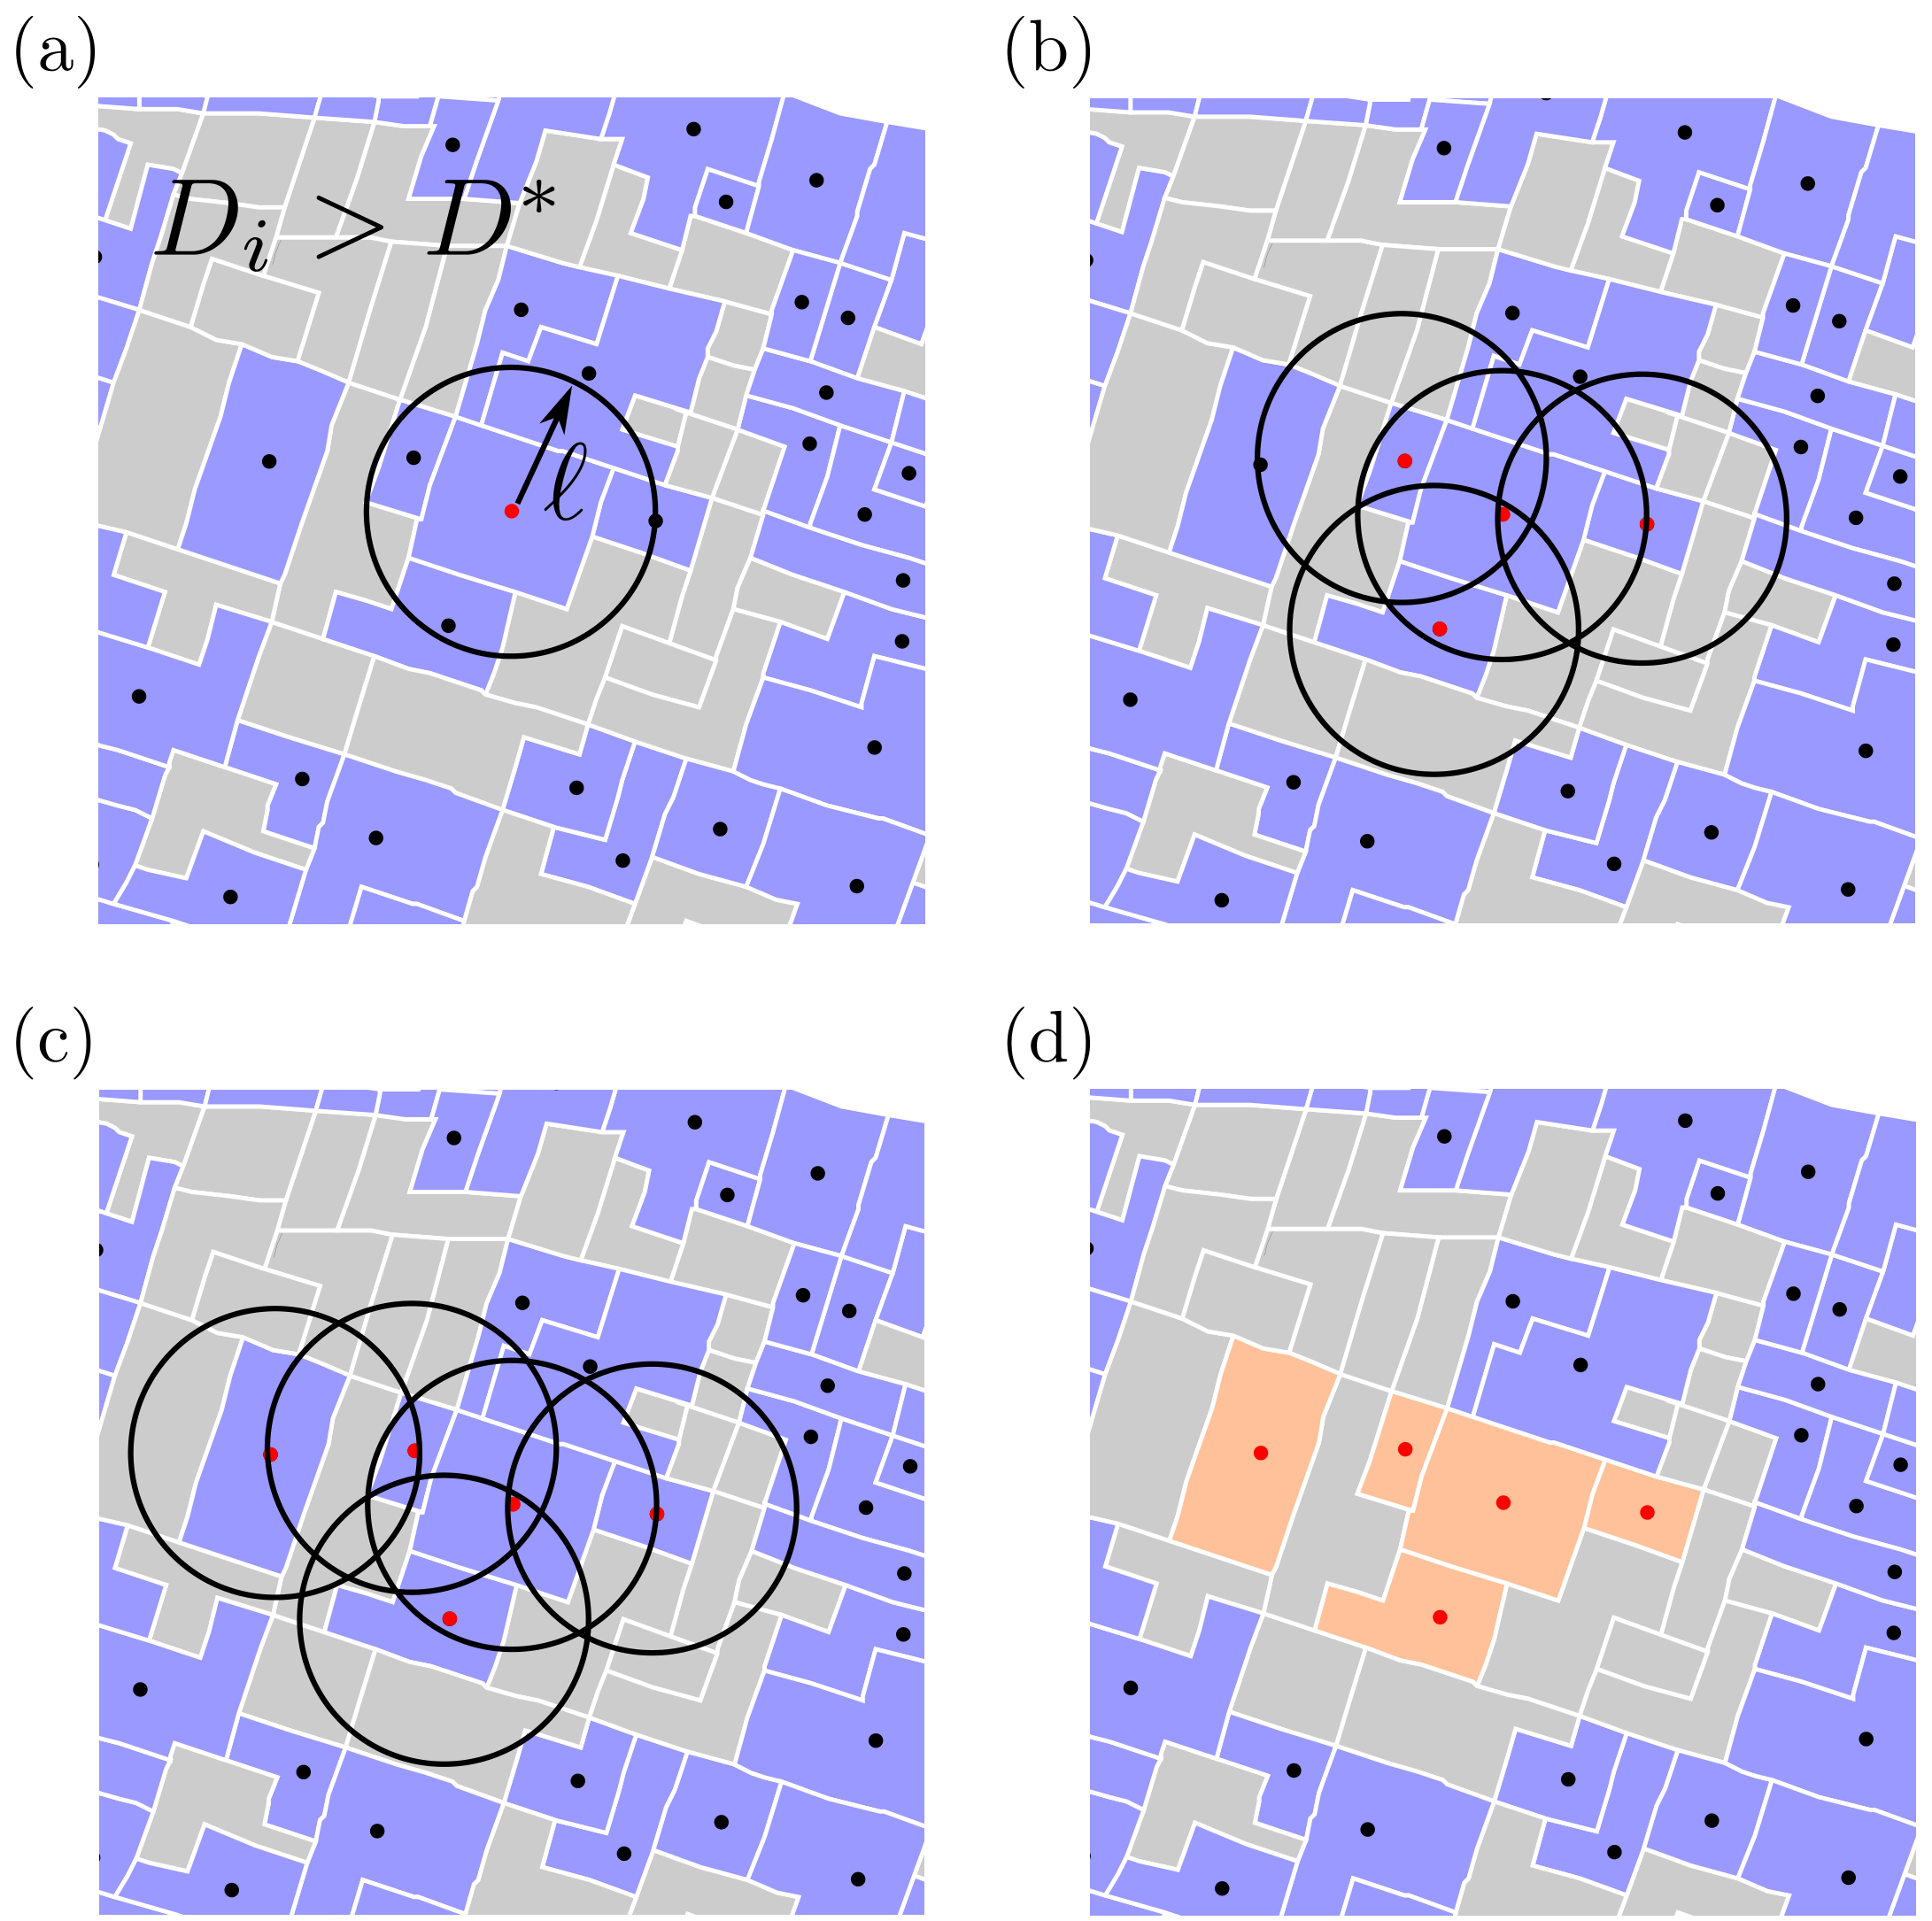
图 3|城市聚类怎样把相邻普查区收成一个集群?
这是算法步骤示意图,面板中的多边形不代表福塔莱萨的回归样本。(a)浅蓝色表示 Di>D*,灰色表示不高于阈值;红点是几何中心,圆半径为 ℓ。(b、c)对其余中心重复搜索,直到半径内不再出现新的邻居。(d)橙色区域是搜索结束后的一个集群。来源:原论文 Fig. 3。
集群尺度上的关系写成幂律 Y=aX^β。Y 是集群内的报警次数,X 是该集群的居民人数或流动人数,a 是常数,β 是标度指数。β=1 时,人数变为原来的 2 倍,幂律预测的次数也变为 2 倍,正文称为等比例(isometric)。β>1 称为超线性:次数增加得比人数更快。由印出的指数计算,2^1.15≈2.22,2^1.18≈2.27;论文没有另行报告这两个倍数。
ℓ 从 0 扫到 800 米,800 米时最大集群几乎吞进全城。D* 从每平方公里 1,000 人扫到 8,000 人;再高的话,许多普查区会被丢掉,集群也组不起来。两条红色竖虚线之间,β 对参数不那么敏感。正文把这两段印成 180≥ℓ≥300 和 320≥ℓ≥510。不等号若按字面读,区间是空的;图中虚线夹在这些端点之间,下文按虚线之间的区间理解。
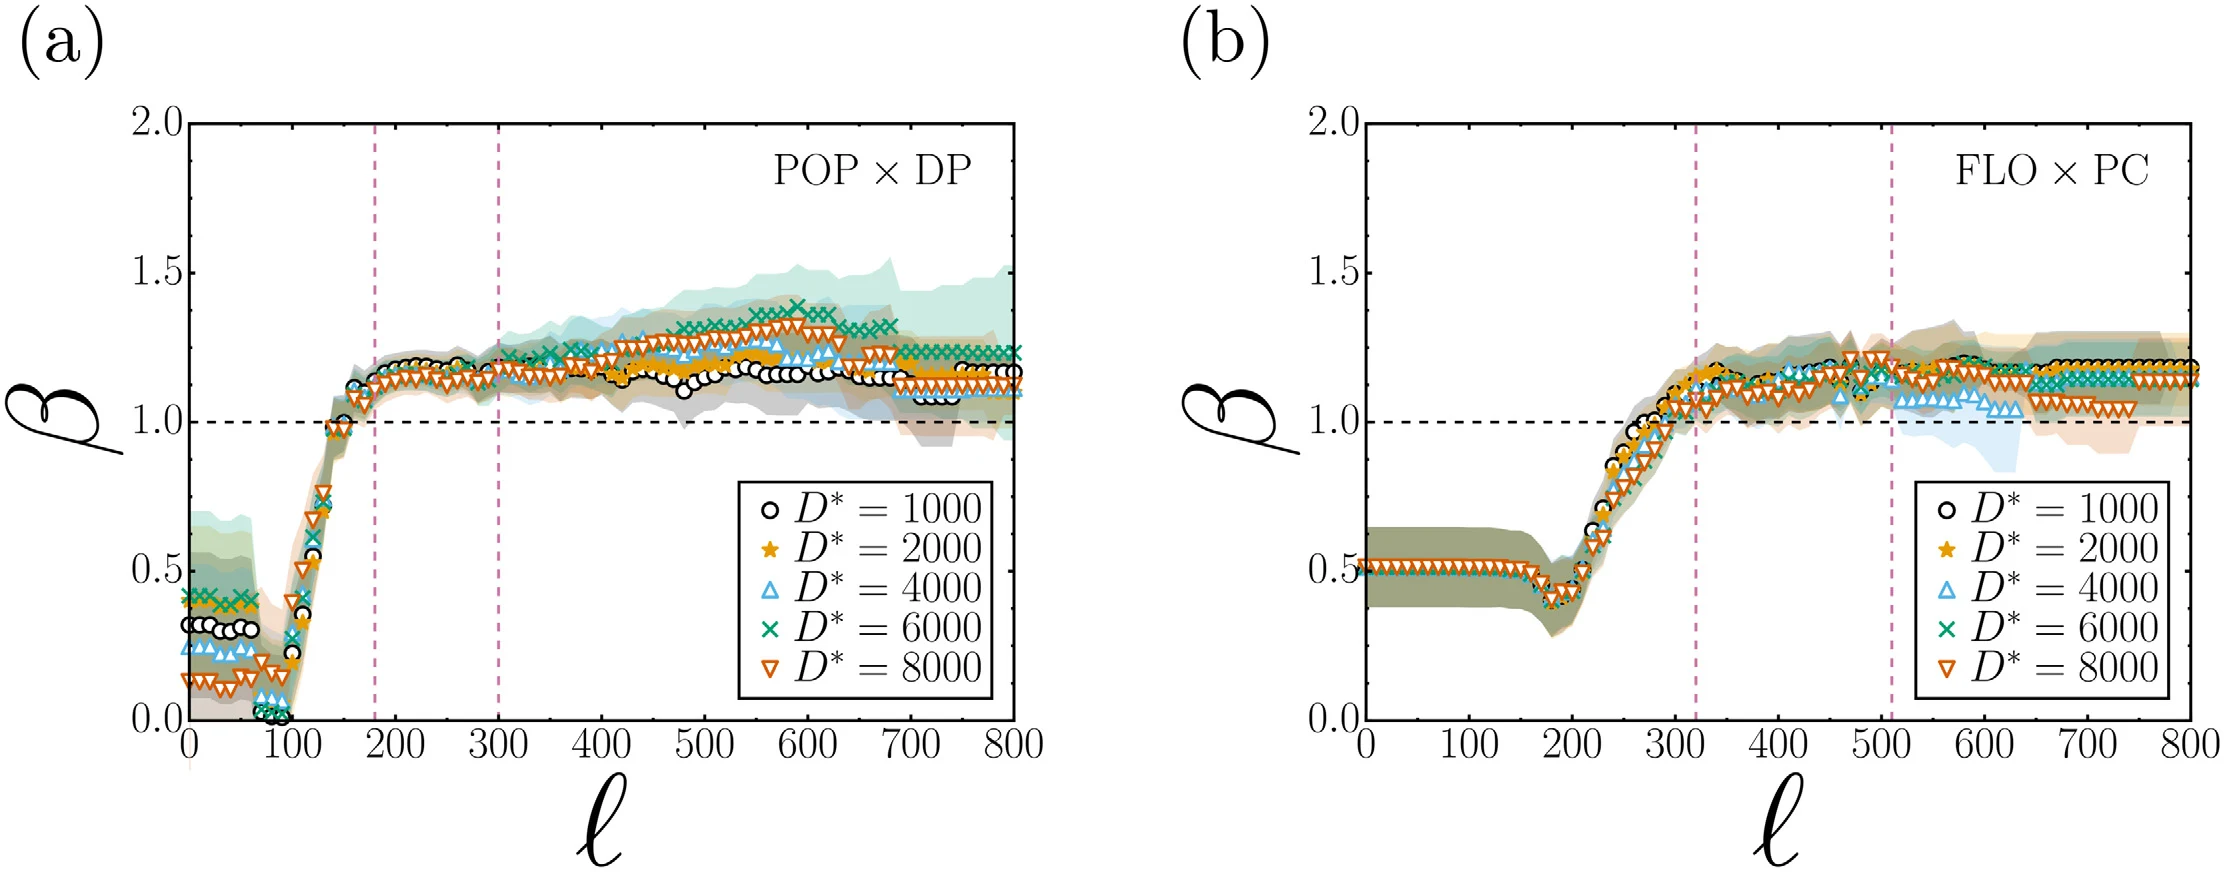
图 4|距离阈值改变时,标度指数会不会跟着大变?
(a)图内标题为居民人口与扰乱治安。横轴 ℓ 为 0–800 米,纵轴为 β,黑色点线是 β=1。颜色是居民人口密度阈值,从每平方公里 1,000 到 8,000 人;阴影是系数 β 的标准误。红色竖虚线大约标在 180 米和 300 米,这一段曲线位于 1 以上。(b)图内标题为流动人口与财产类警情,颜色改按流动人口密度;红色竖虚线大约在 320 米和 510 米,其后曲线位于 1 以上。较短的 ℓ 上,两边的指数都更低,也更晃。来源:原论文 Fig. 4。
居民人口与扰乱治安在前一段的平均指数为 1.17±0.06。后一段正文印出平均指数 1.14±0.04,句子却写成流动人口与扰乱治安。图 4(b) 的标题和说明都是流动人口与财产类警情,并指出另外两对的参数扫描放在附录。后文选定参数后,流动人口与扰乱治安的指数是 0.93±0.10,和 1.14 对不上。因此 1.14±0.04 按图来读,是流动人口与财产类警情在长距离窗口的平均,而且不同于选定参数后的 1.15±0.04。
窗口之内还要选一组具体的 ℓ 和 D*。作者的标准是:集群面积和人数尽量接近成正比,也就是面积=a×人数^α 中的 α 尽量接近 1。这样,大集群之所以大,更接近于面积也大,平均密度不至于和很小的集群差得很远。
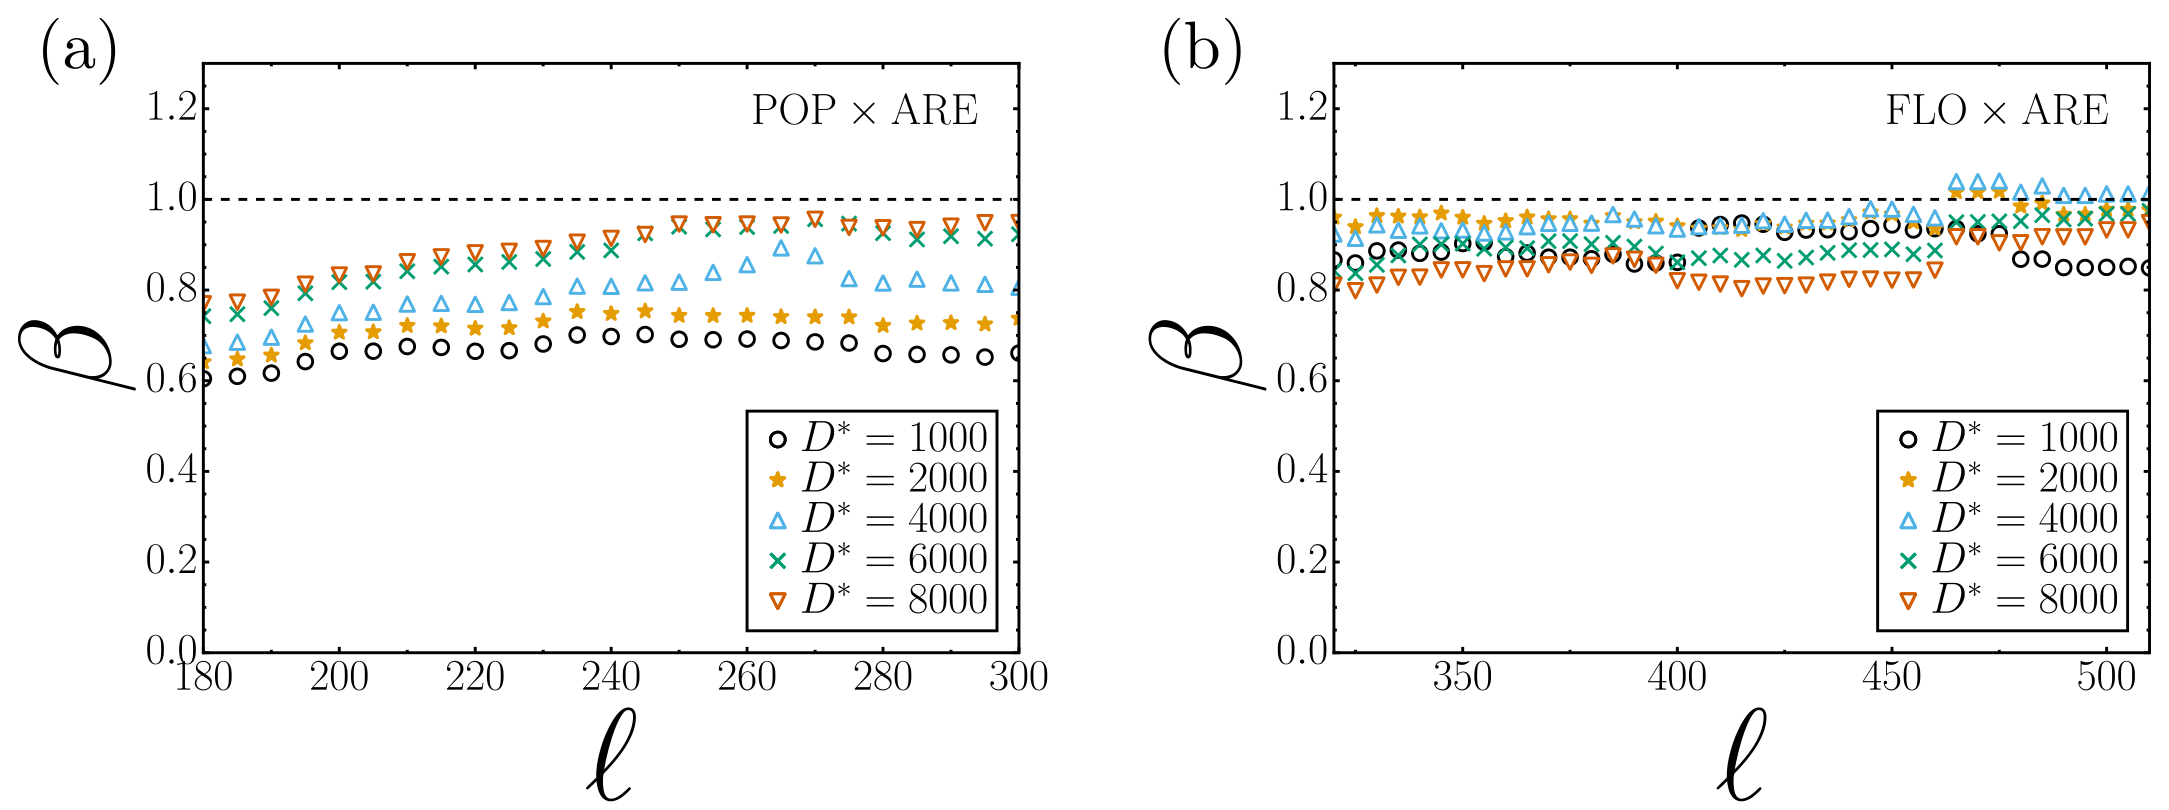
图 5|哪一组阈值让集群面积和人数最接近成正比?
(a)居民人口与集群面积,横轴为 180–300 米,纵轴为 α,虚线是 α=1。密度阈值越高,曲线越靠近 1。(b)流动人口与面积,曲线贴在 1 附近,图中横轴刻度标到 500 米。正文没有印出选中点的 α,只给出最接近等比例的组合:居民人口为 ℓ=270 米、D=6000 名居民/平方公里;流动人口为 ℓ=320 米、D=2000 名流动人口/平方公里/天。前一个 D* 是居民密度,后一个是每天的流动人口密度。来源:原论文 Fig. 5。
选定两套边界后,四对关系分别有多陡?
居民人口使用 ℓ=270 米、D=6000 名居民/平方公里。流动人口使用 ℓ=320 米、D=2000 名流动人口/平方公里/天。两张分区图各用各的边界。
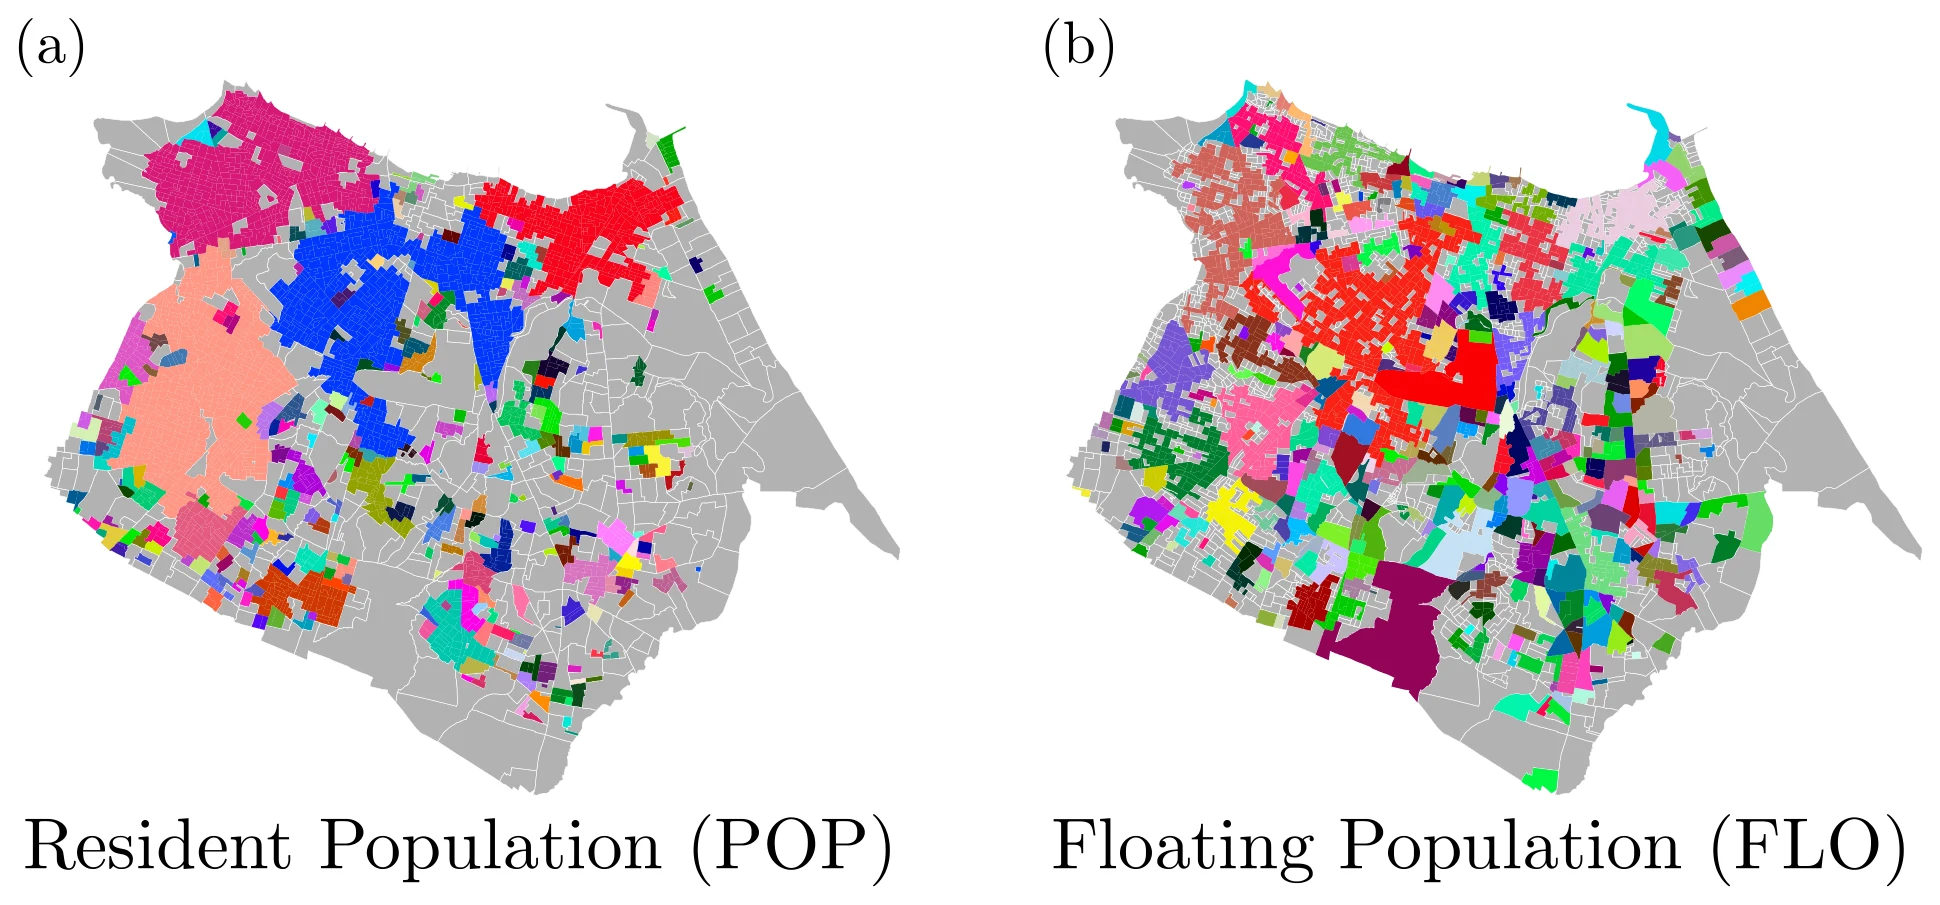
图 6|两套阈值把福塔莱萨切成了怎样的分区?
(a)按居民人口聚类。颜色区分集群,浅灰色是 Di 低于阈值、没有被编入的普查区。(b)按流动人口聚类,参数为 ℓ=320 米、D*=2000 名流动人口/平方公里/天。居民图上的灰色空档更大,正文将其归因于商业区居民少;流动图同时盖住商业区和居住区。浅灰色是密度低于阈值、留在这套聚类之外的普查区。颜色不表示报警高低,正文也没有给出集群个数,以及这些灰色普查区占全市居民、经过人数或报警次数的比例。来源:原论文 Fig. 6。
在这两组边界上,四对关系重新估计。红线是幂律的简单线性回归,画在对数坐标上,所以看起来是直线。蓝线是 Nadaraya–Watson 平滑,用来看关系是否只靠一条直线撑住;蓝色虚线是这条平滑曲线的 95% 自助法置信区间。图 4 把参数曲线的阴影标成系数 β 的标准误。图 7 在 β 后面沿用 ±,没有再次定义。
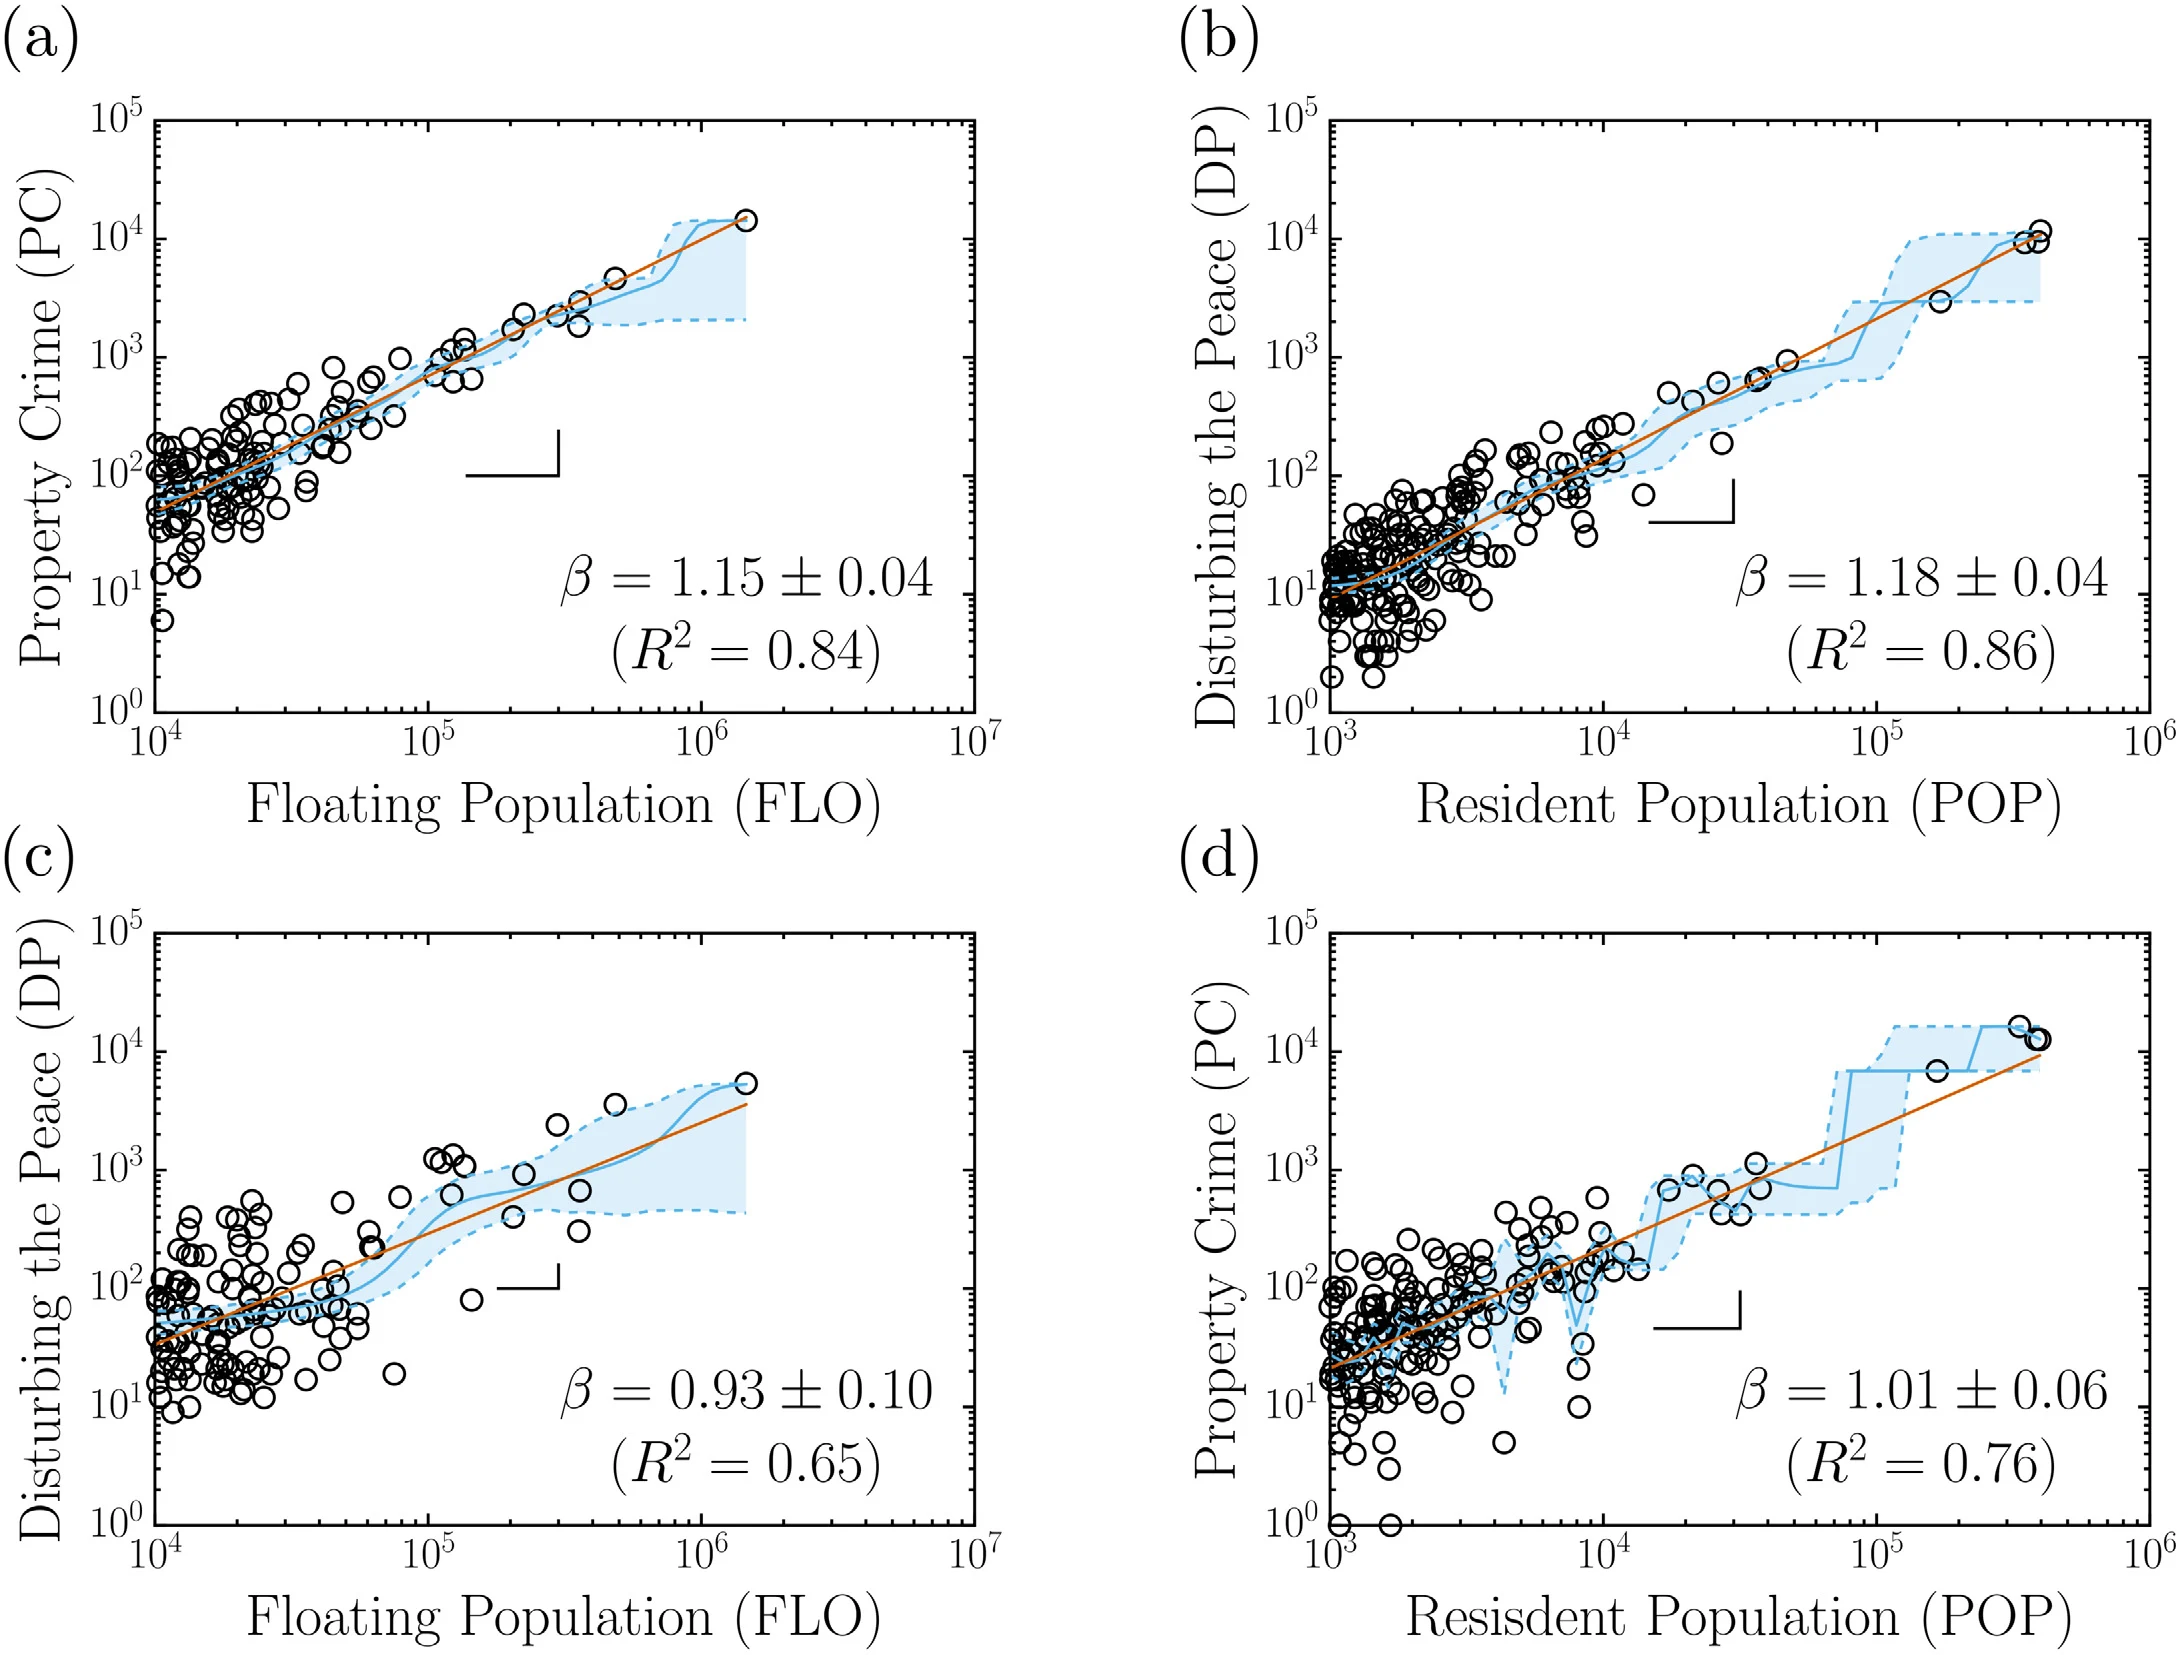
图 7|集群尺度上,四对关系的斜率和拟合差多少?
(a)流动人口与财产类警情,β=1.15±0.04,R²=0.84。(b)居民人口与扰乱治安,β=1.18±0.04,R²=0.86。(c)流动人口与扰乱治安,β=0.93±0.10,R²=0.65。(d)居民人口与财产类警情,β=1.01±0.06,R²=0.76。每个点是一个集群。右端置信带变宽,最大的几个集群对平滑曲线的约束更弱。来源:原论文 Fig. 7。
按图上印出的不确定性,1.15−0.04=1.11,1.18−0.04=1.14,两者仍高于 1。0.93 加上 0.10 得到 1.03,1.01±0.06 也盖住 1。R² 写在同一张对数散点图上:0.84 和 0.86 高于 0.65 和 0.76。0.84 的分母是这张图上的拟合,全市 81,911 次财产类报警和 53,849 次扰乱治安报警是另一套总数。摘要把财产类警情的有效异速关系放在流动人口上,把扰乱治安的超线性放在居民人口上;四张图同时给出交叉组合的同向关系,只是更接近等比、判定系数更低。
作者把财产类报警与流动人口的超线性,看作对“日常活动在空间上汇合”这一既有说法的数量支持。数据提供的是集群上的人数和报警次数。城市之间已有研究曾看到严重犯罪次数随居民人口超线性增加;作者提出,那种城市间图形有可能是因为市内真正同这类次数一起变化的是流动人口。本文没有在多座城市上检验这个解释,也没有给出全市流动人口相对居民人口的倍数。
这些指数比较的是哪些人、哪些年份?
三个横轴或纵轴用的是三种不同的量:一天内的公交经过人数、2005 年 8 月至 2007 年 7 月累计的报警次数,以及 2010 年普查时点上的居民人数。
正文写明,福塔莱萨当时仍以公交为主要公共交通,流动人口由公交客流网络推算。定义停在“一天内经过某个普查区的人数”。步行、小汽车和其他方式是否计入,以及同一个人经过多个普查区时记几次,正文都没有写出。
回归使用的是被编入集群的普查区。1.15 和 1.18 描述的是密度达到阈值的那些集群。浅灰色区域留在图 6 里,正文没有报告它们占全市居民、经过人数或报警次数的份额。
参数窗口本身是在同一批数据上观察 β 之后圈出来的,面积是否接近等比例也在这批数据上挑选。图 4 说明,ℓ 较短时指数可以明显低于后来的平台。超线性出现在文中那个距离窗口里的集群尺度上。图 2 已经表明,回到单个普查区时四对关系的判定系数都低于 0.15。
比较发生在集群之间。一个集群的流动人数高、财产类报警也多,图上对应的是这一组汇总数字。判定系数较高,表示幂律贴住了对数坐标上的点。论文没有做改变人流后再观察报警次数的实验,指数停留在不同年份叠合后的横截面关联。
一句话总结
在福塔莱萨的集群之间,财产类报警次数随一天里的公交经过人数增加得比等比更快,扰乱治安报警次数则随居民人数增加得比等比更快;交叉组合更接近等比,而整组关系叠着三个年份。
核心来源
- PLOS ONE 正式发表页,核对题目、作者、2017 年 2 月 3 日发表日期与 DOI:10.1371/journal.pone.0171609。收稿日期为 2016 年 10 月 21 日,接受日期为 2017 年 1 月 23 日。
- 居民人口见巴西地理统计局,IBGE;公交数据链接印为 2015 年 3 月 11 日的福塔莱萨开放数据;190 报警记录的下载地址印在参考文献 43。
- 附录 S1 的题目列出公交流动数据的处理、POP 与 PC 以及 FLO 与 DP、ℓ 与 D* 的补充说明和数据汇总。图 4 的说明把另外两对的参数扫描指到该附录;图 7 给出的是选定参数下的四对散点。
作者介绍
七人的单位和分工以论文署名、作者贡献声明,以及本文引用、且姓名能对上的先前论文为准。
- Carlos Caminha:通讯作者,福塔莱萨大学应用信息学研究生项目,邮箱印为 caminha@unifor.br。参与数据整理、软件,以及共同的研究设计、分析与写作。
- Vasco Furtado:同一研究生项目。承担经费、项目管理、监督和资源,并参与设计、分析与写作。
- Tarcisio H. C. Pequeno:同一项目,在经费、项目管理、监督和资源上与 Furtado、Andrade Jr. 并列。
- Caio Ponte:同一项目。参与数据整理、软件,以及共同的分析、作图和写作。
- Hygor P. M. Melo:塞阿拉联邦教育、科学与技术学院克拉特乌斯校区教学系,同时署名塞阿拉联邦大学物理系。参与数据整理与软件。本文引用的 2014 年城市间自杀与居民人口标度论文列有他和 Andrade Jr.。
- Erneson A. Oliveira:福塔莱萨大学应用信息学研究生项目,同时署名塞阿拉联邦大学物理系。参与数据整理与软件。本文引用的 2014 年大城市排放与居民人口论文列有他和 Andrade Jr.。
- José S. Andrade Jr.:塞阿拉联邦大学物理系。承担经费、项目管理、监督和资源,并参与设计、分析与写作。上面两篇被引论文也列有他。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一座城市对外只发布居民人口,商业区在财产类报警上会被排到偏低的一档,因为图 1 的市中心正是居民少、公交经过人数高的区域。值得另做的检验是:仍按普查区汇总,但改用同一年、包含多种交通方式的到场人数,替换 2015 年的公交经过人数,再看指数是否还停在 1.15 附近。若换口径之后指数回到 1 附近,现在的超线性就更紧地绑在“公交、一天经过人数”这个定义上。
年份是另一条可以拆开的线。报警停在 2007 年 7 月,公交是 2015 年。若新线路穿过早期报警并不集中的普查区,横轴变大,纵轴仍是旧的累计次数,幂律会把线路变化算进“经过的人越多,报警增加越快”。把人口、客流和报警对齐到同一年之后再估计 β,才能看出 1.15 里面有多少来自这种错位。
图 7 的交叉组合仍有 R²=0.65 和 0.76。只保留两条超线性关系,会留下仍同向变化的另一部分。后续做分区比较时,四条指数和四个判定系数放在一起,才能看出匹配的一对陡在哪里,交叉的一对又还剩下多少。