家和单位直线很近,开车却要绕:路网效率该按谁加权?
论文名片|Lei Dong、Ruiqi Li、Jiang Zhang、Zengru Di,Population-weighted efficiency in transportation networks,Scientific Reports,2016,6:26377,2016年5月27日发表。DOI:10.1038/srep26377。本文依据这份正式版本解读。它用通话记录估计家到工作地的人数,再按人数给“直线距离除以驾车路径”加权,用来比较路网有多直。
可以把达喀尔半岛上的通勤想成这样:人住在北面,单位在南面,地图上的直线不算长,可东西向公路和机场把南北向隔开,开车就要绕。这个画面只是帮助理解论文后来标出的方向,不是某一次被记录下来的个人行程。
若把每一对地点的绕路程度直接平均,几乎没人走的弯路会和每天有很多人通勤的弯路占同样分量。这项研究把权重改成通勤人数占比。十座城市里,达喀尔加权后最低,为 0.683;论文把其余多数城市概括在大约 0.73 到 0.78。一个所有人都去市中心、道路呈方格的简化城市,模拟结果约为 0.77。达喀尔低下来,对应的是南北向联系更绕,以及白天和夜里活动地点分得更开;它的平均通勤千米数并不是十座城市里最长的。
先说结论
- 人口加权效率是每对家—工作联系的直线距离除以驾车路径距离,再乘以这条联系的人数占全部通勤人数的比例,最后加总。1 表示每对联系都和直线一样短。表 1 里达喀尔为 0.683,蒂瓦瓦内和济金绍尔并列最高,均为 0.777。
- 达喀尔被标出的低效联系大多呈南北向,分成东、西和跨越机场三组。城际联系里,达喀尔、捷斯、姆布尔之间有若干对效率最低。这与当时在建的达喀尔—迪亚姆尼亚迪奥公路只是部分吻合,论文没有比较这条路通车前后的效率。
- 十座城市各一个点,人口加权效率与驾车平均通勤时间的调整后 R² 为 0.87,斜率为 −1816(244),p 值为 0.0001。正文给出的超额通勤拟合 R² 为 0.24(按直线距离)和 0.42(按驾车路径)。超额通勤使用全市重新分配后的理论最短距离,标不出某一对局部联系。
- 方格路、人人前往市中心的模拟中,居住均匀时为 0.77(0.001),正态衰减为 0.79(0.001),指数衰减为 0.80(0.001),各重复 10 次。市中心更集聚时,这个模板里的效率更高。达喀尔是狭长半岛,论文认为它不能套进单中心方格城。
直线距离除以驾车路径,为什么还要乘上人数占比?
既有做法大致分三路。一种看网络上节点之间距离的倒数,关心的是抽象网络里信息或出行有多容易到达。一种叫路径因子(route factor):把沿路距离除以直线距离,再对地点对取平均,数值越大表示越绕。还有一种看职住平衡和超额通勤,比较实际平均通勤距离与一套理论最短平均距离。前两种对每条联系一视同仁,人口堆在哪里不影响分数。第三种的基准是把全市居住地和就业地重新配对后的最短平均距离,这样的配对在现实中很难发生,而且它只给整个城市一个数,指不出哪一对地点特别绕。这些算法还依赖道路测绘或出行调查;论文关注的是调查稀缺、路网资料也不完整的城市。
这里改用两个容易拿到的代理。家到工作地的人数来自手机通话详单,驾车路径距离来自 Google 地图接口。直线距离由两端经纬度计算。某一对地点 i、j 的人口加权效率是:
ηᵢⱼ = (Pᵢⱼ / Ptot) × (deᵢⱼ / drᵢⱼ)
Pᵢⱼ 是从 i 到 j 通勤的人数,Ptot 是所有起讫对人数之和,所以 Pᵢⱼ / Ptot 是人数占比,各对比重加总为 1。de 是直线距离,dr 是驾车路径距离。全市效率 η 等于所有 ηᵢⱼ 之和。因为权重已经加总为 1,η 就是 de/dr 按通勤人数加权后的平均数。
η 为 1,表示每条被计入的通勤都有一条与直线等长的路径。η 越小,按人流量加权之后越绕。它和路径因子使用同一个几何关系,只是把比值倒过来:路径因子把沿路距离放在分子,越大越绕;这里把直线距离放在分子,越大越直。权重是这批家—工作联系里的人数占比。道路上的车流计数和居住人口各自是另一套量。
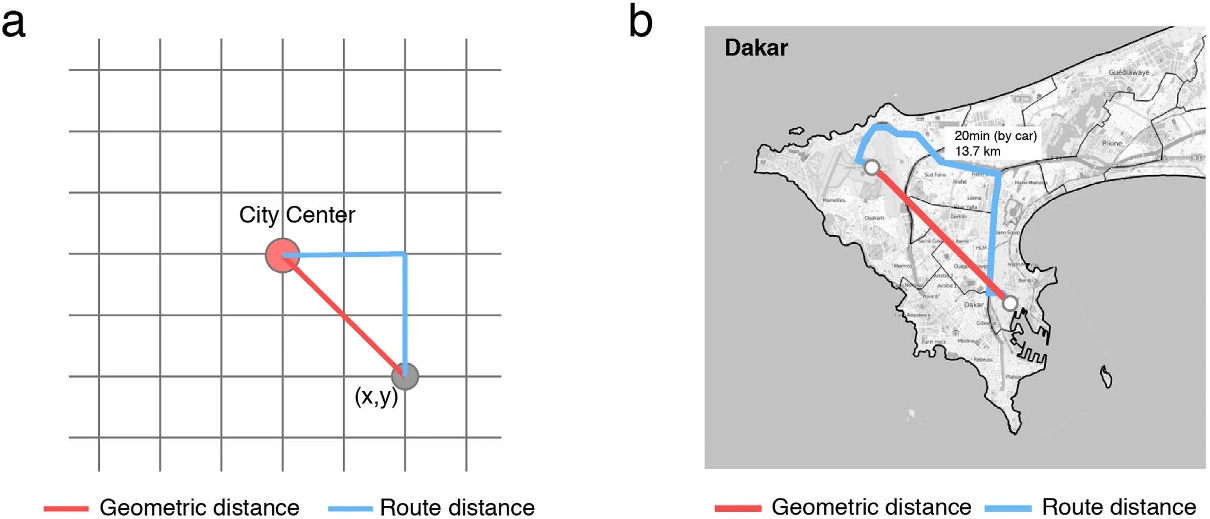
图 2|直线距离和驾车路径差在哪里,一个方格城又该怎么算?
(a)单中心方格城示意:红线是从 (x, y) 到市中心的直线,蓝线沿方格走,长度为横坐标与纵坐标的绝对值之和。后文的零模型就用这个几何关系。(b)达喀尔地图上的一对示例点:红线为直线,蓝线为驾车路径,图上标注这对点驾车约 20 分钟、路径 13.7 千米。这是画出来帮助对照的一对地点,不是全市平均,也不是电话数据里的一条通勤记录。来源:原论文 Fig. 2。
十座城市的范围,是基站、人口密度和建成区一起圈出来的
数据来自塞内加尔 Orange/Sonatel 2013 年 1 月 1 日至 12 月 31 日的匿名通话详单,空间精度到基站。论文写这套记录涉及超过 900 万用户,并分成两类:一类是基站之间逐小时的语音和短信往来;另一类是每两周随机抽取的大约 30 万用户、仍在基站尺度上的个体移动。家—工作矩阵使用的是后一类记录汇总后的人数。
城市范围按三步划定:先用基站坐标作泰森多边形,再用 WorldPop 保留人口密度超过每平方千米 100 人的多边形,最后对照 Google Earth 遥感影像,人工去掉非建成区。表 1 的人口和密度都来自这套 WorldPop 估计,人口单位是万人,对应的是这样圈出来的范围。
全国基站 1666 座,其中 492 座在达喀尔。每两周的抽样里,达喀尔区域内超过 17 万用户,论文写这约占 30 万抽样用户的 60%。17 万的分母是抽样用户;表 1 里达喀尔 333 万的分母是 WorldPop 对研究范围的居民估计。
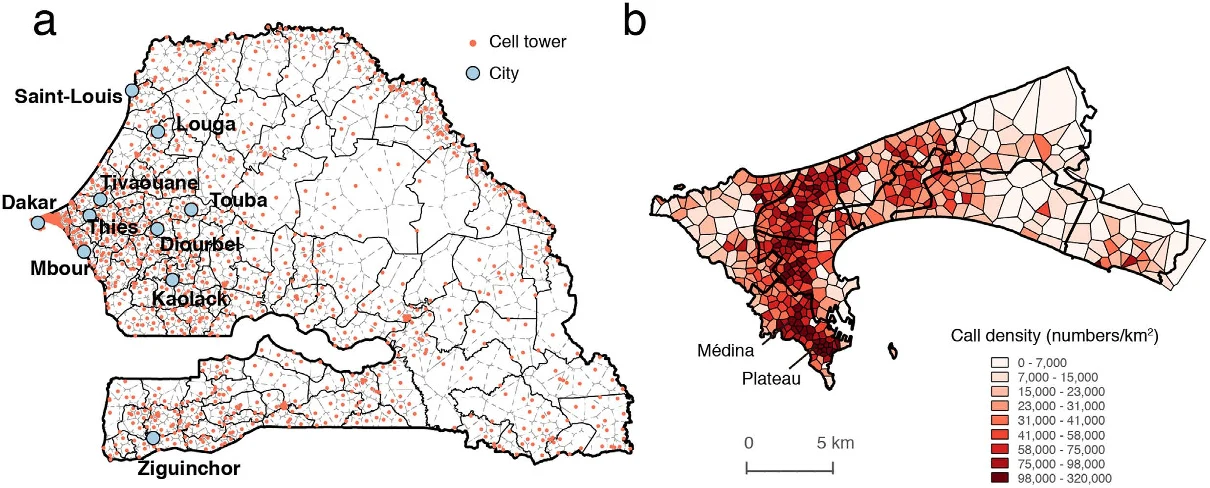
图 1|十座城市和达喀尔的通话落在哪里?
(a)橙点是基站,蓝点是十座城市:达喀尔、圣路易、卢加、蒂瓦瓦内、图巴、捷斯、久尔贝勒、姆布尔、考拉克、济金绍尔。灰线是按基站作出的泰森多边形。基站明显密于达喀尔一带。(b)达喀尔日均通话密度,颜色越深密度越高,单位是每平方千米的通话次数,最深一档图例为 98,000–320,000;梅迪纳和高原区标在半岛南端的深色区域。来源:原论文 Fig. 1。
家和单位的时段,从通话节奏里读出来
家和工作地若靠经验规定上下班时间,换一个国家就可能偏。论文改从全体用户的通话节奏里找转折。工作日和周末都有两个通话高峰,一个在中午 12:00 左右,另一个在 21:00–22:00;论文认为后一个高峰比西班牙多数城市更晚。白天平均通话时长大约 60 秒。23:00 左右短信达到一个很突出的高峰,总通话时长也在夜间升高。很晚仍打电话的人变少,但这些人的单次通话更长。
据此,工作时段取 10:00–19:00,因为这一段前后平均通话时长变化很快。在家时段取 21:00 至次日 06:00,因为夜间的长通话和短信高峰被看成休闲、在家的活动。每个用户在对应时段里出现最多的基站,作为工作地或居住地的代理,再把家到工作地的人数汇总成起讫矩阵。空间单位仍是基站。主文说明,居住地和工作地都未知的用户没有出现;只有一端未知的用户仍会计入后面的昼夜人数图,达喀尔的非本地用户更容易缺少居住地。下文只用这套汇总后的人数。
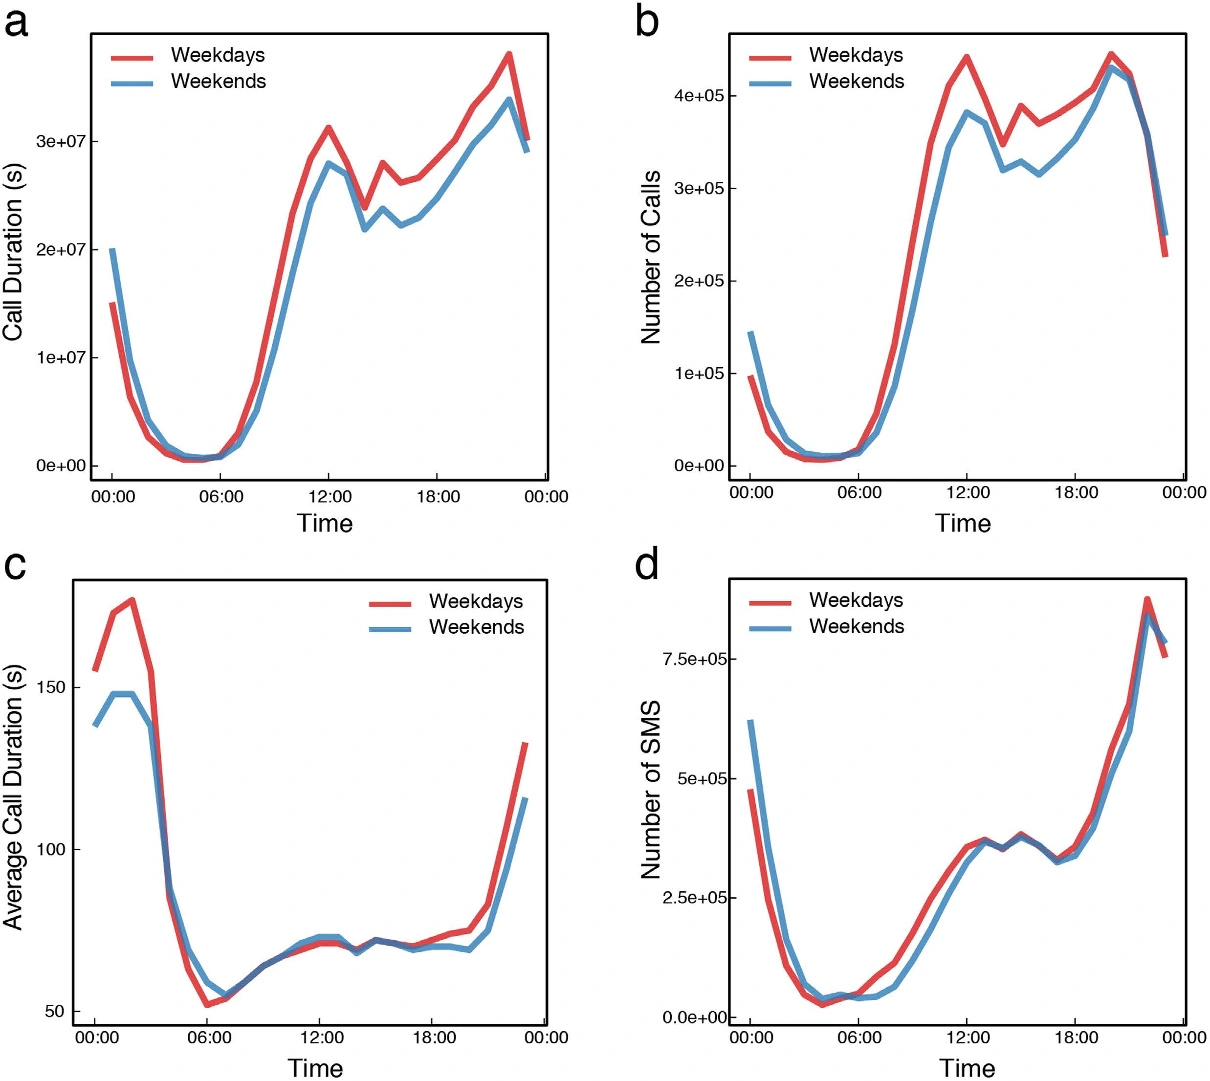
图 3|哪一段时间更像上班,哪一段时间更像在家?
(a)全体用户的总通话时长,单位秒。(b)通话次数。(c)平均通话时长,单位秒。(d)短信条数。红线是工作日,蓝线是周末,横轴是一天中的时刻。总时长和通话次数都在中午与晚间形成两峰;白天平均时长停留在较低水平,正文概括为大约 60 秒;短信在 23:00 前后最高。来源:原论文 Fig. 3。
达喀尔的通勤偏东西,捷斯从中心指向外围
把每个用户的家和工作地连起来,达喀尔有大量人从西往东通勤,捷斯则从中心指向外围。图上的线是两端基站之间的几何连线。论文写明,汽车实际路线是另一套由地图接口返回的路径。节点大小表示该点的起讫量。
把同一对地点的驾车路径距离对上直线距离,就可以看见绕行。灰线斜率为 1:点落在线的上方,驾车路径长于直线。达喀尔散点左上方的蓝点离开这条灰线最远;蓝框标在更靠近原点、但仍位于灰线上方的一组点。图注把蓝点和蓝框都标成路径偏长、直线偏短、因而更值得检查的联系。捷斯的纵轴画到 12 千米,同样是线上方表示绕行。点的大小对应通勤人数,图例给出 5、20、40 人三档。一个人的通勤在这个图上只是一个点的来源,城市效率要等这些点按人数加权之后才出现。
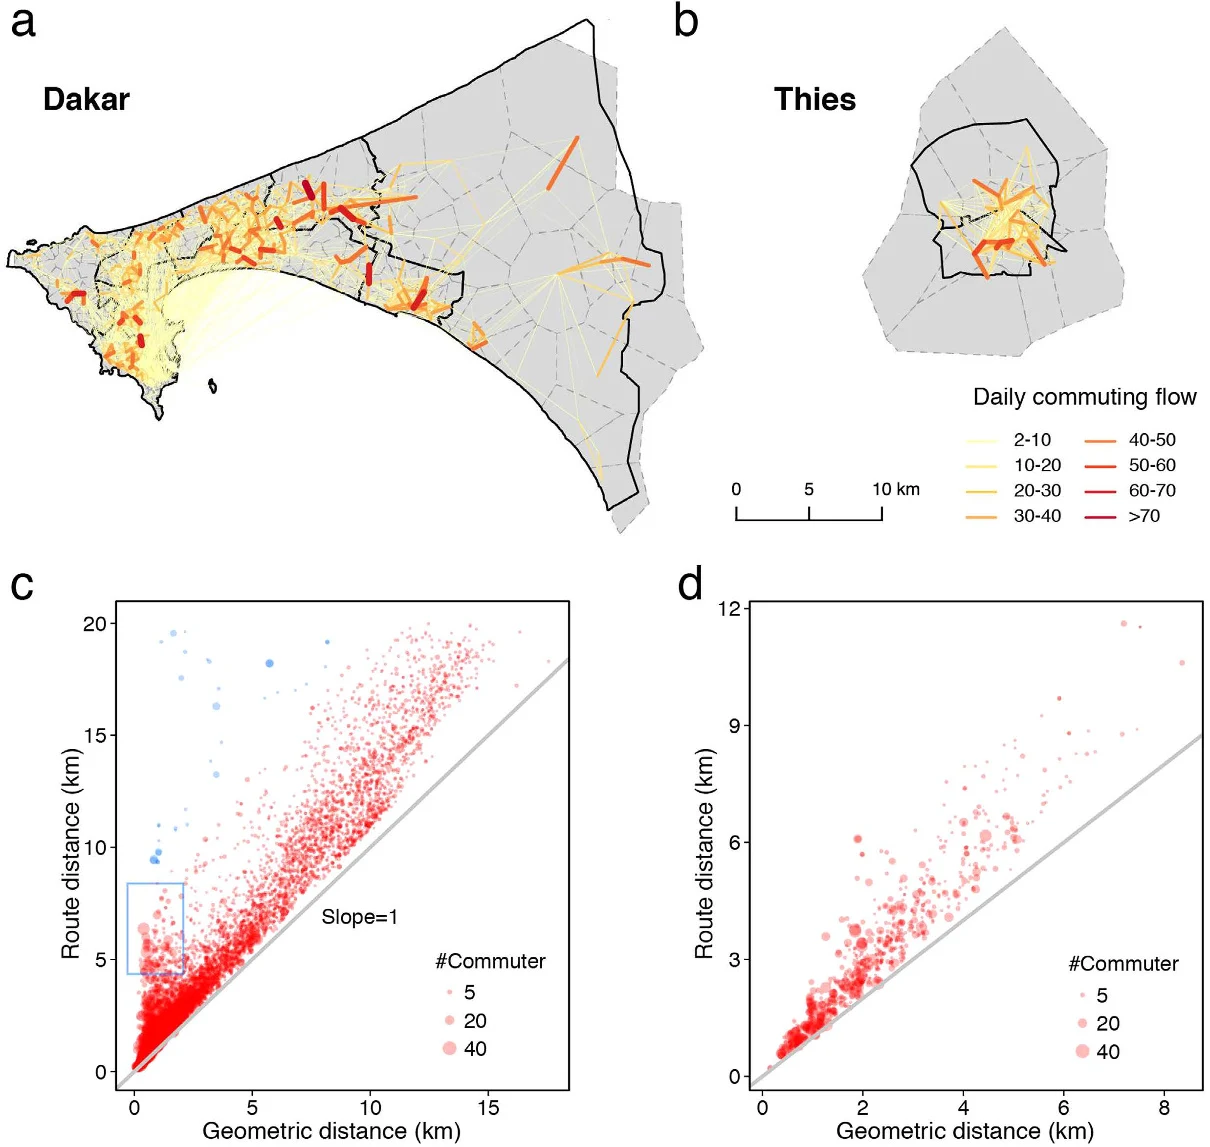
图 4|家到单位的方向,以及哪些点明显绕开了直线?
(a)达喀尔每日家—工作联系,线条颜色表示日通勤流量,图例从浅到深分档。(b)捷斯的联系从中心向外围散开,颜色图例与(a)相同,比例尺 0–10 千米。(c)达喀尔:横轴直线距离,纵轴驾车路径距离,单位都是千米;灰线斜率为 1,蓝点和蓝框标出路径相对直线偏长的联系。(d)捷斯的同样散点,点的大小仍是通勤人数。来源:原论文 Fig. 4。
被标出来的低效联系,几乎都是南北向
有了人数和距离比,就可以把 ηᵢⱼ 低、同时人数又不小的联系挑出来。达喀尔市内,论文写出几十对最需要注意的联系,并按方向分成三组。红组在东侧,可能主要是因为一条东西向公路把南北分开,人从家到单位要绕开它。蓝组在西侧,低效率同时来自绕行和很高的人数占比 Pᵢⱼ / Ptot。绿组穿过一块封闭空地,论文指认那是达喀尔机场。三组几乎都是南北向。这个图案支持的判断是:若只看这套家—工作联系,南北向的快速通道会碰到当前权重最高的绕行。它还不能证明某一条具体新路的投资收益,因为图上的彩色线表示被选中的起讫对,线上虽印有数字,主文并没有逐条定义这些数字,前十对的数值放在补充表 S1。
把一座城市里的全部基站合成一个点,同一套算法可以用于城际。十座城市之间,通勤集中在达喀尔和周边,尤其是捷斯、姆布尔和图巴。论文由此认为,这批城市的人口集聚在达喀尔附近。表 1 可以作一个人数核对:达喀尔 333 万,其余九城相加为 289 万,十城合计 622 万,达喀尔占 333/622,约 53.5%。这个比例的分母只是表中十座城市,不是塞内加尔全国人口。
城际效率里,连接达喀尔、捷斯和姆布尔的若干条联系最低。插图画出当时在建的达喀尔—迪亚姆尼亚迪奥公路,图例为黄线;同图还有蓝色的国家公路和红色的 RN2。正文图注把这条在建公路称为橙线,并认为它会加快达喀尔、捷斯、姆布尔之间的通行。论文的用词是部分印证。数据年是 2013 年,公路资料的访问时间写的是 2015 年 10 月,文中没有这条路通车前后的 η,也没有把公路投资写成由这个指标决定。
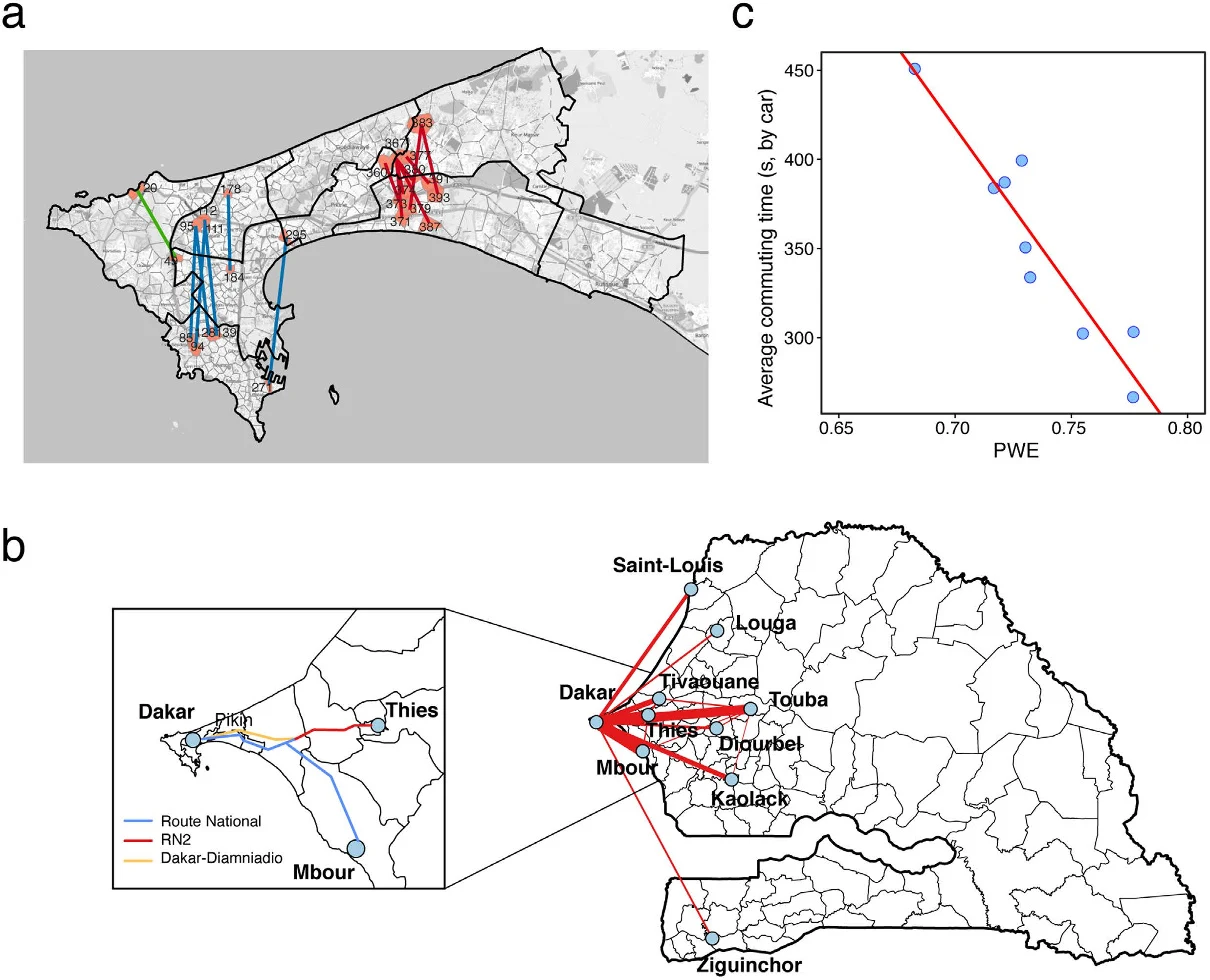
图 5|市内哪几组成南北向绕行,城际效率又是否跟着驾车时间走?
(a)达喀尔被标出的低效起讫对,红、蓝、绿三组大多为南北向;线上数字的逐条定义不在主文。(b)十座城市之间的通勤流,线集中在达喀尔与捷斯、姆布尔、图巴;插图图例分别是国家公路、RN2 和 Dakar–Diamniadio。(c)横轴是人口加权效率,纵轴是驾车平均通勤时间,单位为秒;红线为普通最小二乘拟合。图注给出斜率 −1816(244)、调整后 R² 0.87、p 值 0.0001。来源:原论文 Fig. 5。
平均距离更长的城市,加权效率就更低吗?
十座城市的全市 η 列在表 1 第四列。达喀尔 0.683 最低。论文概括多数城市大约在 0.73–0.78;表中捷斯 0.716、考拉克 0.721、姆布尔 0.725、图巴 0.729 落在这一说法的下沿附近,圣路易 0.730、久尔贝勒 0.732 刚刚进入,卢加 0.755,蒂瓦瓦内和济金绍尔都是 0.777。
因为 η 是 de/dr 的加权平均,可以对表中的数取倒数,看成加权后的驾车路径相当于直线的多少倍。达喀尔 1/0.683 约 1.46 倍,0.777 的倒数约 1.29 倍。这个倒数是便于阅读的换算,论文报告和比较的仍是 0 到 1 的 η。
| 城市 | 人口(万人) | 密度(人/平方千米) | PWE | Cmin(千米) | Cact1 直线(千米) | Cact2 路径(千米) | Cex1 | Cex2 |
|---|---|---|---|---|---|---|---|---|
| 达喀尔 Dakar | 333 | 5447 | 0.683 | 1.28 | 2.20 | 3.31 | 41.8 | 61.3 |
| 久尔贝勒 Diourbel | 22 | 292 | 0.732 | 1.36 | 1.88 | 2.57 | 27.7 | 47.1 |
| 考拉克 Kaolack | 23 | 1036 | 0.721 | 1.64 | 2.45 | 3.44 | 33.1 | 52.3 |
| 卢加 Louga | 20 | 181 | 0.755 | 1.44 | 1.76 | 2.46 | 18.2 | 41.5 |
| 姆布尔 Mbour | 42 | 680 | 0.725 | 1.73 | 3.03 | 4.34 | 42.9 | 60.1 |
| 圣路易 Saint-Louis | 26 | 735 | 0.730 | 1.31 | 2.44 | 3.32 | 46.3 | 60.5 |
| 捷斯 Thies | 36 | 1333 | 0.716 | 1.09 | 2.00 | 2.85 | 45.5 | 61.8 |
| 蒂瓦瓦内 Tivaouance | 12 | 323 | 0.777 | 1.32 | 1.91 | 2.50 | 30.9 | 47.2 |
| 图巴 Touba | 88 | 980 | 0.729 | 1.46 | 2.37 | 3.30 | 38.4 | 55.8 |
| 济金绍尔 Ziguinchor | 20 | 962 | 0.777 | 1.09 | 1.85 | 2.52 | 41.1 | 56.7 |
人口单位是表头的 10⁴,密度单位是人/平方千米。蒂瓦瓦内沿用表中拼写 Tivaouance。Cact1 低于同城的 Cact2,因为直线短于驾车路径。
超额通勤拿实际平均距离和理论最短平均距离作比较:
Cex = (Cact − Cmin) / Cact × 100
Cmin 是在每个地区的居住人数、工作人数和总流量都保持不变时,把人重新分配到更近的工作地之后,全市平均通勤距离的最小值。Cact 是实际平均距离。公式的分母是 Cact,所以 Cex 表示实际平均距离里有百分之多少高出这个理论最小值。达喀尔的直线版本是 (2.20 − 1.28) / 2.20 × 100 = 41.8,路径版本是 (3.31 − 1.28) / 3.31 × 100 = 61.3,与表中 Cex1、Cex2 一致。Cex1 的分母是该城直线实际平均距离,Cex2 的分母是驾车路径实际平均距离。表里的 Cmin 只有一列,两套指数都用它作被减数。主文写优化时的距离可以是距离或时间,但没有写明这一列 Cmin 用的是直线还是路径;补充图 S2 讨论了实际距离的两种定义。
把千米数和直不直分开,表里的对照就清楚了。姆布尔的实际路径平均 4.34 千米,是十城最长;达喀尔是 3.31 千米。可姆布尔的 η 为 0.725,达喀尔为 0.683。人通勤得更远,和路相对于直线更绕,是两件不同的事。卢加的 Cex1 只有 18.2,因为直线实际平均 1.76 千米,理论最短 1.44 千米,多出来的部分只占 1.76 千米的 18.2%。圣路易的 Cex1 为 46.3,是直线版本里最高的;捷斯的 Cex2 为 61.8,是路径版本里最高的,达喀尔的 61.3 与之接近。
论文用各城市的驾车平均通勤时间做第三个参照,时间来自 Google 接口返回的驾车秒数。人口加权效率和两套超额通勤都与这个时间有关,但前者拟合更好:图 5c 的图注写调整后 R² 为 0.87;正文比较三者时把人口加权效率的 R² 写成 0.87,Cex1 写成 0.24,Cex2 写成 0.42。斜率 −1816 的括号里是 244,图注没有给 244 命名。纵轴单位是秒,所以斜率表示:在这十个点的拟合线上,η 每升高 1,平均驾车时间变化 −1816 秒;η 每升高 0.01,拟合时间大约少 18 秒。从达喀尔的 0.683 到最高的 0.777,相差 0.094,沿拟合线大约是 171 秒。各城真实的平均秒数没有在正文逐城列出,171 秒是斜率乘以表中 η 的极差,不是两座城市实测时间的差。样本是十座城市各一个点。p 值为 0.0001,说明在这十个点上负相关很明显;它不表示换一批城市还会得到同一条斜率。
超额通勤适合讨论职住在全市尺度上离理论最短有多远。它的最短流量是全局最优解,小区内部特别绕的联系会进到全市平均里。人口加权效率保留每一对 ηᵢⱼ,才能回到图 5a 的局部分组。在这十座城市上,它更贴近 Google 驾车时间。这个时间是接口给出的驾车估计。通话记录提供用户出现在基站的时刻,主文用它划分昼夜并汇总家—工作人数;乘车分钟来自另一套驾车时间估计。
方格城里的 0.77,套不到达喀尔半岛
多数城市落在 0.73 到 0.78 附近,论文用一个零模型解释这个区间。假设所有人都在市中心工作,住在周围,道路是方格。直线距离是坐标平方和的平方根,路径距离是两段直角边之和,也就是图 2a。模拟把 L×L 的区域分成方格,在交叉口上均匀放 100,000 个点,再计算到中心的两种距离。均匀居住得到 0.77(0.001)。再改成从市中心向外的正态衰减和指数衰减,得到 0.79(0.001)和 0.80(0.001)。每种分布做 10 次。括号里的 0.001 没有标明是标准差还是标准误。市中心越集聚,这个模板里的 η 越高,因为更多人的行程更接近那些相对更直的短半径。
塞内加尔那些可以看成单中心的城市,经验值与这个区间接近。达喀尔除外。论文给出的形态原因是:达喀尔是不规则的狭长条带,不能当成单中心方格城。模型还说明,η 同时受路网形状和人口分布影响。高流量的起讫对之间有更直的路,η 会更高;提高职住平衡可能缩短总通勤距离并提高效率。这里的“可能”来自模型和达喀尔个案的推论,文中没有做一个把岗位搬近住所的前后对照。
昼夜分布被用来解释达喀尔为什么职住分得开。白天,用户主要分布在达喀尔高原、大达喀尔、梅迪纳和帕尔塞勒-阿萨尼;夜里则主要在帕尔塞勒-阿萨尼。图 6 的密度是电话用户密度,论文把它当作人口分布的一种估计,图例单位是人/平方千米。它和表 1 的 WorldPop 居民密度分开读。白天减夜里,红色表示白天更密,蓝色表示夜里更密。
图 6d 的每个点是一个省(Department),颜色是所属大区(Region);论文写每个大区包含 3 到 5 个省。横轴是白天人数的常用对数,纵轴是白天人数除以夜间人数,1 表示这一省的昼夜人数相同。正文比较的是各大区的分离程度,认为达喀尔和考拉克最高,算法放在补充表 S2。主文没有印出这个分离程度的具体数值,所以不能把图上最高的一个点直接读成那张表里的指标。
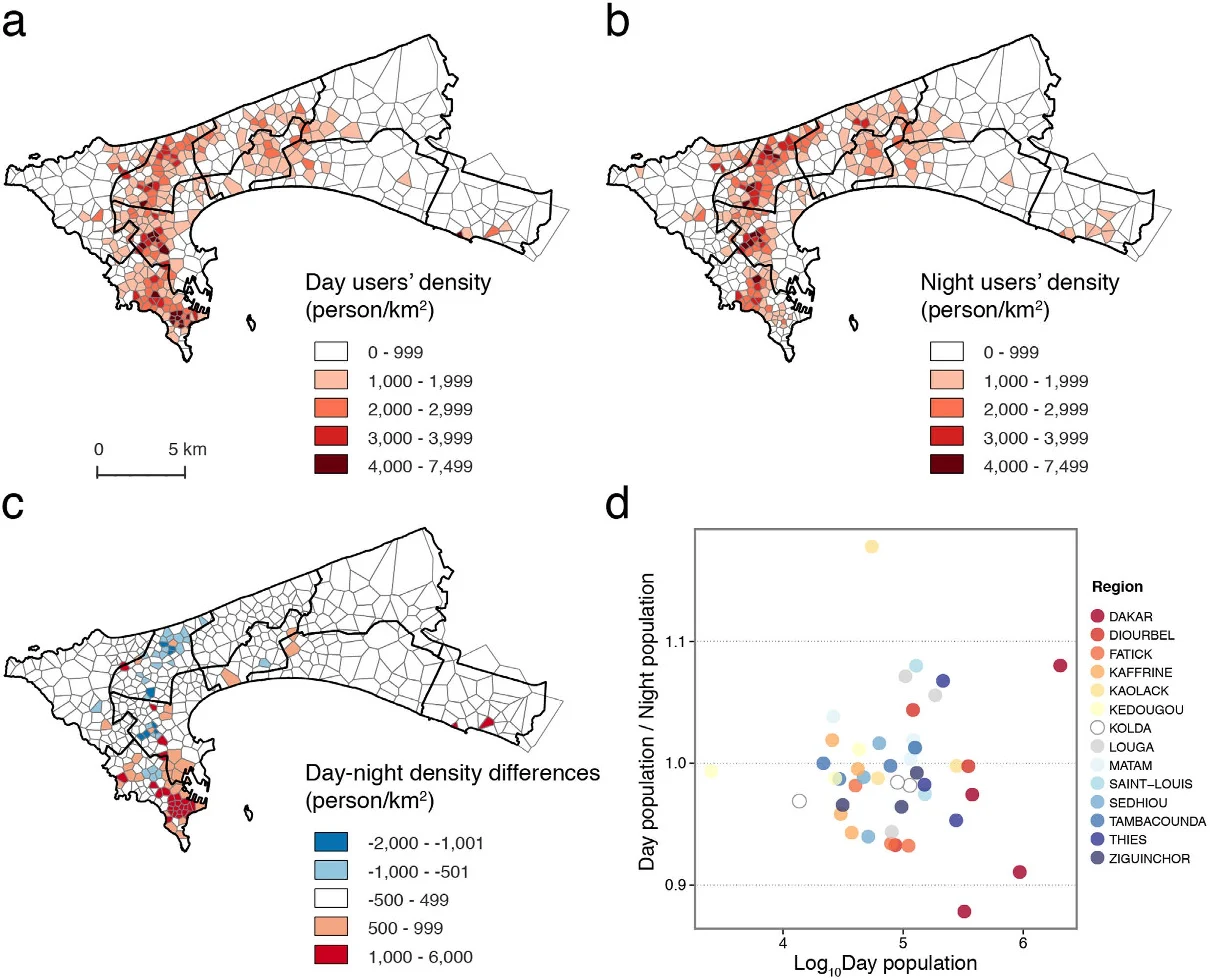
图 6|达喀尔的白天和夜里,用户堆在同一批地方吗?
(a)白天用户密度,颜色越深越高。(b)夜间用户密度,图例单位同样是人/平方千米。(c)白天密度减去夜间密度;红表示白天更高,蓝表示夜间更高。(d)每个点是一个省,颜色是大区;纵轴为白天人数除以夜间人数。分离程度的具体数值在补充表,不在这张主图的坐标读数里。来源:原论文 Fig. 6。
这些比较各自停在哪里
η 描述的是家到工作地这一种联系有多直,而且“直”是指直线距离占驾车路径的比例。商场、就医、货运和夜间出行没有进入权重。Google 路径是驾车距离,步行和公交若绕开同一条公路,排序可以不同。
电话用户只覆盖有通话记录的人和被抽中的两周。超过 900 万是运营商数据覆盖的用户规模,30 万是每两周的抽样,17 万是其中落在达喀尔区域的人数。基站多边形会把一小块里的不同社区合成一个点,短距离通勤的绕行因此被抹平。
十座城市的回归只有十个点。调整后 R² 0.87 描述的是这张散点,拿掉达喀尔这个最左端的点,斜率和 R² 都可能明显变化,论文没有做这个剔除。与在建公路的吻合是方向上的部分一致,不是道路效果评估。
零模型把所有工作岗位放在一个中心,道路没有河流、机场和半岛。它解释的是为什么一批单中心城市会挤在 0.77 附近,解释不了达喀尔的 0.683。0.73–0.78 也不是论文声称的世界城市常数。
一句话总结
按通勤人数加权之后,达喀尔的家—工作驾车路径在十座城市里最不直;这个 0.683 说的是直线距离占驾车路径的加权比例,还不是人们在各种出行方式上实际损失的全部门分钟。
核心来源
- Dong L., Li R., Zhang J., Di Z. Population-weighted efficiency in transportation networks. Scientific Reports, 2016, 6: 26377. 正式版本 2016 年 5 月 27 日发表,收稿日期为 2016 年 1 月 14 日,接收日为 2016 年 4 月 29 日。DOI 10.1038/srep26377 印在论文页眉和文末引用格式中。
- 正文图 1–6 与表 1 的数值均来自该正式版本。人口为 WorldPop,驾车路径与驾车时间来自 Google 地图接口,通话数据为 Orange/Sonatel 在 D4D 挑战中提供的 2013 年塞内加尔记录。上述数据来源以论文的报告为准。
作者介绍
四位作者的单位和分工以论文署名、通讯邮箱和作者贡献说明为准。
- Lei Dong:署名为清华大学建筑学院。与 Ruiqi Li 共同设计并完成研究,参与写作。
- Ruiqi Li:署名为北京师范大学系统科学学院,通讯作者之一,论文所留邮箱为 liruiqi@mail.bnu.edu.cn。与 Lei Dong 共同设计并完成研究,参与写作。
- Jiang Zhang:署名为北京师范大学系统科学学院,通讯作者之一,论文所留邮箱为 zhangjiang@bnu.edu.cn。参与写作。
- Zengru Di:署名为北京师范大学系统科学学院。参与写作。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
权重里只有家到工作地的驾车路径。若把同一批基站换成傍晚的休闲联系,或者换成没有小汽车时实际能走的路线,图 5a 的三组不一定还是南北向最靠前。达喀尔—迪亚姆尼亚迪奥公路若主要缩短小汽车时间,驾车版的 η 会上升,而公交或步行仍要绕开机场和东西向屏障时,按人数加权的结果可以几乎不动。要判断“该先修哪一条”,至少要把同一些起讫对各算一次驾车 de/dr 和一次公交 de/dr,再看红、蓝、绿三组的名次是否交换。
另一个容易误用的结果是:零模型里,岗位从均匀分布改到指数衰减,η 从 0.77 升到 0.80。达喀尔的低分对应半岛和东西向阻隔。若新增岗位继续堆在半岛南端的高原区,南北向高流量联系仍要跨过这些障碍,平均千米数变短和 de/dr 变大可以不同时出现。把方格城里的集聚结果用到有屏障的城市之前,需要先固定路网,只移动岗位,再看 ηᵢⱼ 最低的那一组人数占比如何变化。