地铁网越铺越大,乘客实际要做的选择为什么没有一起变难?
论文名片|Zhuojun Jiang、Lei Dong、Lun Wu、Yu Liu,Quantifying navigation complexity in transportation networks,PNAS Nexus,2022,1(3):pgac126,2022年7月22日在线发表。DOI:10.1093/pnasnexus/pgac126。这是一项把地铁刷卡记录匹配到路线、再在历史路网上模拟路线选择的研究。2024年1月的勘误只补入问卷与公交卡数据的匿名和知情同意说明,发表于 PNAS Nexus,3(1):pgad465。
站在一座换乘站,墙上的线网图常常同时画出十几条线。若每换一次车,都要把整张图里相连的线路重新挑一遍,线网越大,这一步就越贵。日常出行却常常反复走少数几条路线。这篇论文比较的就是这两种范围:乘客实际用到的路线所组成的小网,以及把全部线路都当成选项的整张网。比较的尺子是搜索信息,单位是比特,可以理解成指定下一条线路最少要回答多少道是否题。
方向很清楚。三座城市的乘客把大量站点对上的出行收在很少几条路线里,小网上的决策信息因此低于整张网的理论值。路网继续长大时,理论值上升得更明显;只看一类两次换乘的最快最简路径,经验最大值大约跟着理论最大值按四分之三的斜率上升。
先说结论
- 北京和上海各有95%的站点对、深圳有99%的站点对,乘客使用的路线不超过4条。正文另报告,超过90%的人走换乘最少的路线。前一句的分母是站点对,后一句的分母是人。
- 北京全部站点对的经验搜索信息均值约0.7比特,理论搜索信息均值约4.0比特。理论值更高的站点对占北京90%、上海87%、深圳81%;经验值更高的占三座城市各约1%。
- 经验值更高的时候,乘客常常用更多换乘换更短时间。中关村到来广营:匹配路线平均换乘4.0次、用时61.6分钟;全网换乘最少的路径是1次换乘、89.7分钟。
- 在没有逐年刷卡路径的历史路网上,路线由选择模型决定。北京超过70%的跨线出行,理论搜索信息随路网增长而上升;2017年起,北京和上海每年都有超过一半的跨线出行,经验搜索信息不变或下降。
- 只统计信息网络里有2条连接的最快最简路径时,上海的理论最大值达到此前纽约研究中的8比特上限,三城经验最大值约到6比特。逐年最大值的拟合斜率是北京0.75、上海0.71、深圳0.73。
刷卡只记录进出站,中间走了哪条线?
2.25亿是刷卡记录的条数。用户数另计:北京2019年5月1080万,上海2015年4月1030万,深圳2017年10月270万。三个月份分属不同年份。每条记录有卡标识、进出站时刻,以及进出站和所在线路的名称。进出站时刻之差是这次出行的行程时间。卡上没有中间换乘站,所以路线是估计出来的。
路网另有一套快照:北京2003–2020年15张,上海2000–2020年18张,深圳2004–2020年8张。车站和线路来自官方在线地铁图,坐标和站间时间来自百度地图。作者假定2000–2020年间,同一对相邻车站的车内时间都等于2020年的数值,列车提速不进入后面的历史比较。
问卷收集了三座城市共272条已知路线和时长的地铁出行,用来校准选择模型,并检查时间估计。调查在线进行,数据匿名,取得知情同意;刷卡数据也做了匿名处理。
匹配分四步。对每一对车站,按行程时间分布去掉最快的10%和最慢的10%,留下该站点对中间80%的记录。一条网络路径若与这条记录的行程时间相差不超过10分钟,就进入候选集。多项logit模型再按行程时间、距离和换乘次数给出概率,记录匹配到概率最大的那条路径。
路径时间拆成三部分:车内时间、换乘延误、进出站延误。车内时间是各边相加。换乘延误写成换乘次数乘以平均换乘延误,进出站延误写成常数。这两个常数用回归估计。回归所依据的行程,是k=3条最短路径里换乘最少的那条,作者把它当作帕累托最优、时间也最短的行程;站点对上这类行程的平均刷卡时间,用来拟合两个常数。在272条问卷路线上,估计时间与实际时间之差集中在0附近,约95.2%的行程落在相差不超过10分钟的范围内。
选择概率是候选路径效用的指数,再除以该站点对全部候选路径的指数和。效用是两项的线性组合:估计行程时间,以及累计换乘惩罚指数。惩罚指数写成 (1 − e的−C次方) / 直线距离,C是换乘次数,直线距离是起终点的欧氏距离。换乘越多,分子越接近1;同样的换乘次数,距离越短,指数越大。
用问卷做极大似然估计后,北京的时间系数和惩罚系数是−0.0063、−30.99,上海是−0.0023、−127.7,深圳是−0.0031、−113.2。两个系数都为负:时间更长、惩罚指数更高的路线,被选中的概率更低。距离单位没有在正文单独写出,所以不能把−127.7和−30.99直接相除,说成上海乘客比北京乘客更厌恶换乘多少倍。
问卷上按最高概率匹配,三座城市合计的正确率是92.1%,城市之间差别不大。另一个检查把匹配客流按线路加总,再和北京同期官方公布的16条线路客流比较。两边都除以各自的合计,纵轴和横轴都是百分比。图上的回归是 y = 0.01 + 0.998x,R² = 0.99。这说的是线路份额接近,一条线路的总客流对得上,仍可能掩盖方向相反的路径误差。
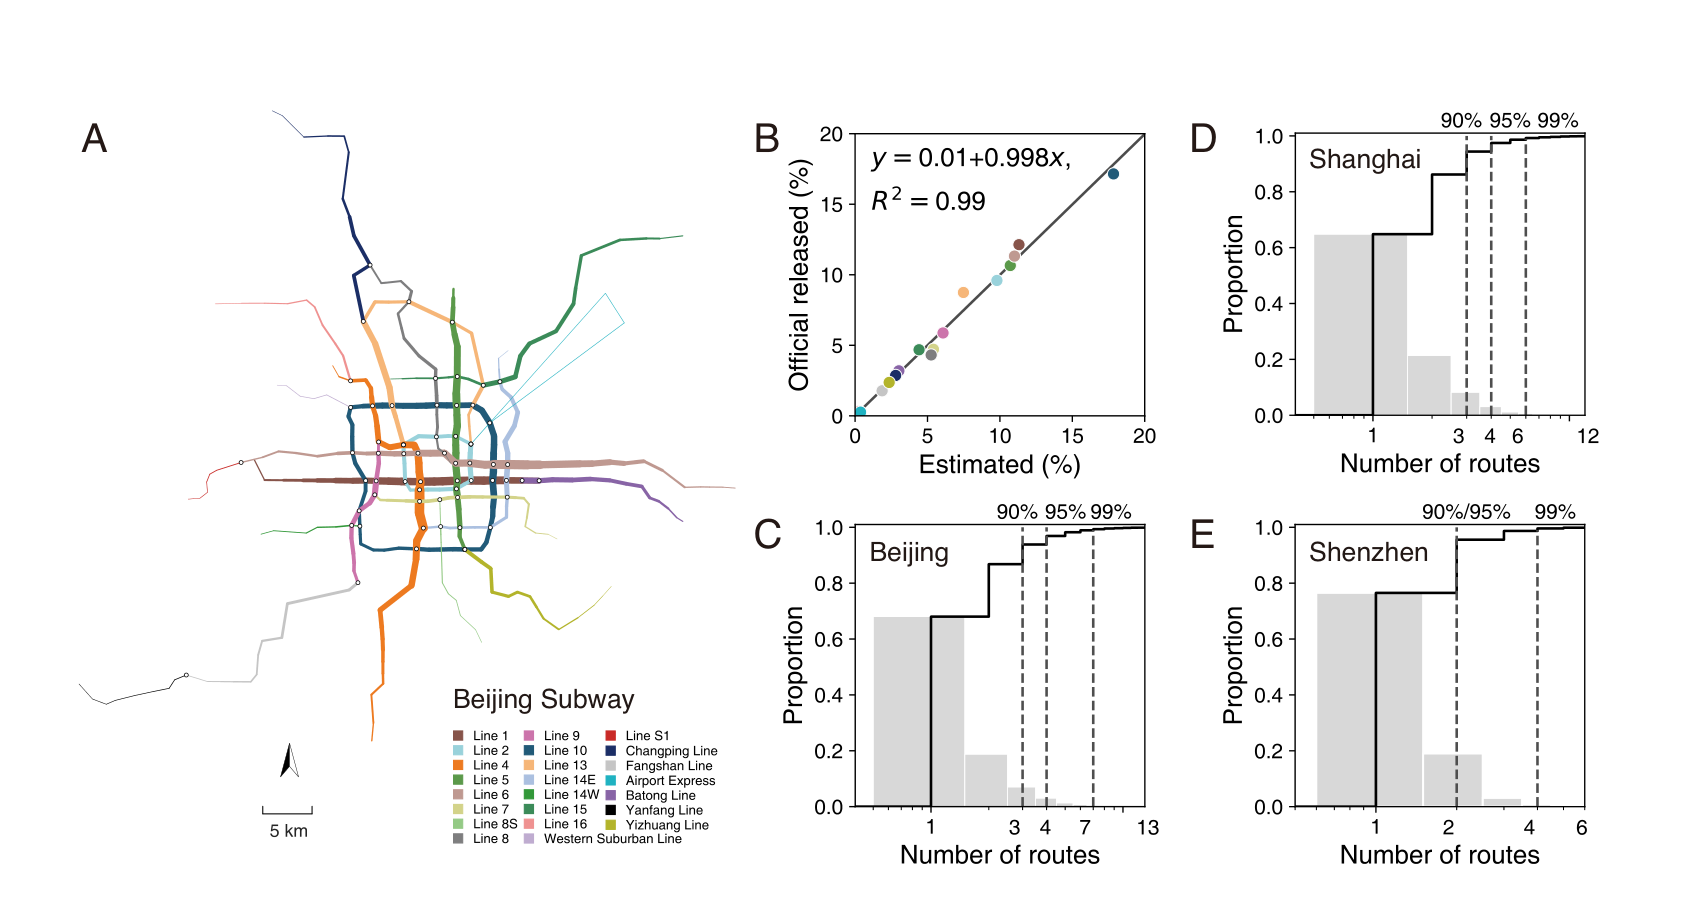
图 2|估计出来的路线有多集中,线路总客流对得上官方数字吗?
(A)北京地铁的估计客流图,颜色区分线路,比例尺为5公里。(B)16条北京地铁线路,每点一条线;官方份额对估计份额,两者都是占合计的百分比,回归式为 y = 0.01 + 0.998x,R² = 0.99。(C、D、E)北京、上海、深圳。灰色柱是使用某一路线条数的站点对比例,黑线是累计比例;虚线标出90%、95%、99%的站点对。横轴右端分别到13、12和6条路线。来源:原论文 Fig. 2。
尽管一对车站之间可以有很多路径,大多数站点对只出现很少几条被使用的路线。北京和上海95%的站点对不超过4条,深圳99%的站点对不超过4条。正文还报告,超过90%的人跟随最简单路线,也就是换乘最少的路线。换乘通常要步行和等待,最少换乘因而倾向于主导选择。90%的分母是人,4条路线的分母是站点对。
搜索信息在数哪一种选择?
作者能观察到的是已经走出来的路线,于是假定决策就发生在这些路线围成的子网里。他们把地铁网映射成信息网络:节点是线路,边是换乘站。这样计的是下一步换到哪条线。同一条线路在子网里的度数,可以小于它在全网里的度数,因为子网只保留实际考虑过的换乘。
定位一条从线路s上的车站i到线路t上的车站j的路径,所需信息是
S = log₂(kₛ) + 沿路径中间节点求和 log₂(kₙ − 1)。
kₛ是起点线路的度数,表示第一步有多少条线可选。以后每到一个节点,来时的那条线被排除,所以选项数是kₙ − 1。S越低,表示在这张网里指定这条路径越容易。S是给定网络上的信息量,单位是比特。
一对车站若匹配出多条路径,站点层面的经验搜索信息是这些路径信息量的客流加权平均,权重是各路径客流占该站点对匹配客流的比例。理论搜索信息使用同一公式,但度数来自整张信息网络,路径则取节点最少的最简路径;若最简路径不止一条,再取其中最快的一条。因此理论值在每个站点对上只有一条路径。
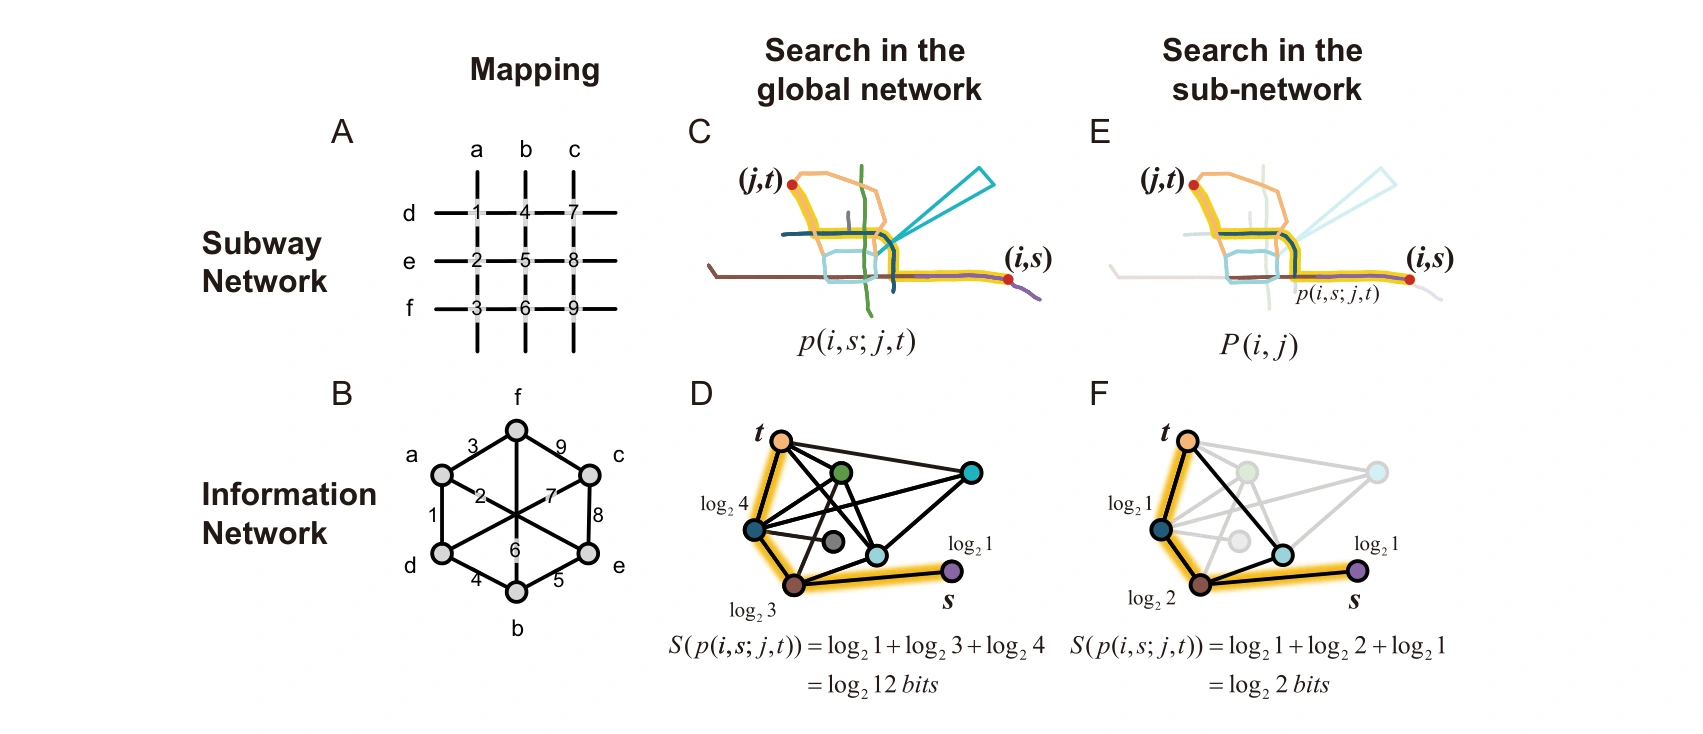
图 1|把线路当成节点以后,全网搜索和实际子网搜索差在哪里?
(A)简化地铁网,a–f是线路,1–9是换乘站。(B)对应的信息网络,节点是线路,边是换乘站。(C)从线路s上的i到线路t上的j,黄色标出一条路径。(D)在全网信息网络里搜索;图上把沿途信息量加总为 log₂12 比特,正文写成约3.6比特。(E)实际出行的子网只保留站点对路径集里的车站和线路,未考虑的线路被淡化。(F)由(E)映射出的信息网络;同一条路径的信息量变成 log₂2 比特,也就是在深蓝与浅蓝两条线之间做一次选择。来源:原论文 Fig. 1。
这3.6比特和1比特是示意图上的计算结果,用来说明定义。
北京全部站点对上,经验值均值约0.7比特,理论值均值约4.0比特。图3A右侧把“理论值更高、两者相等、经验值更高”标成:北京90%、9%、1%,上海87%、12%、1%,深圳81%、18%、1%。三组都加总为100%的站点对。超过81%这个说法,对应的是三座城市里最低的那一档。相等的站点对大多在同一条线上、无须换乘,两种决策成本都是0。
仍有约1%的站点对经验值高于理论值。原因是有人用更高的换乘次数换更短的时间。信息量沿每一次换乘累加,换乘比最简路径更多时,经验值就更容易超过理论值。
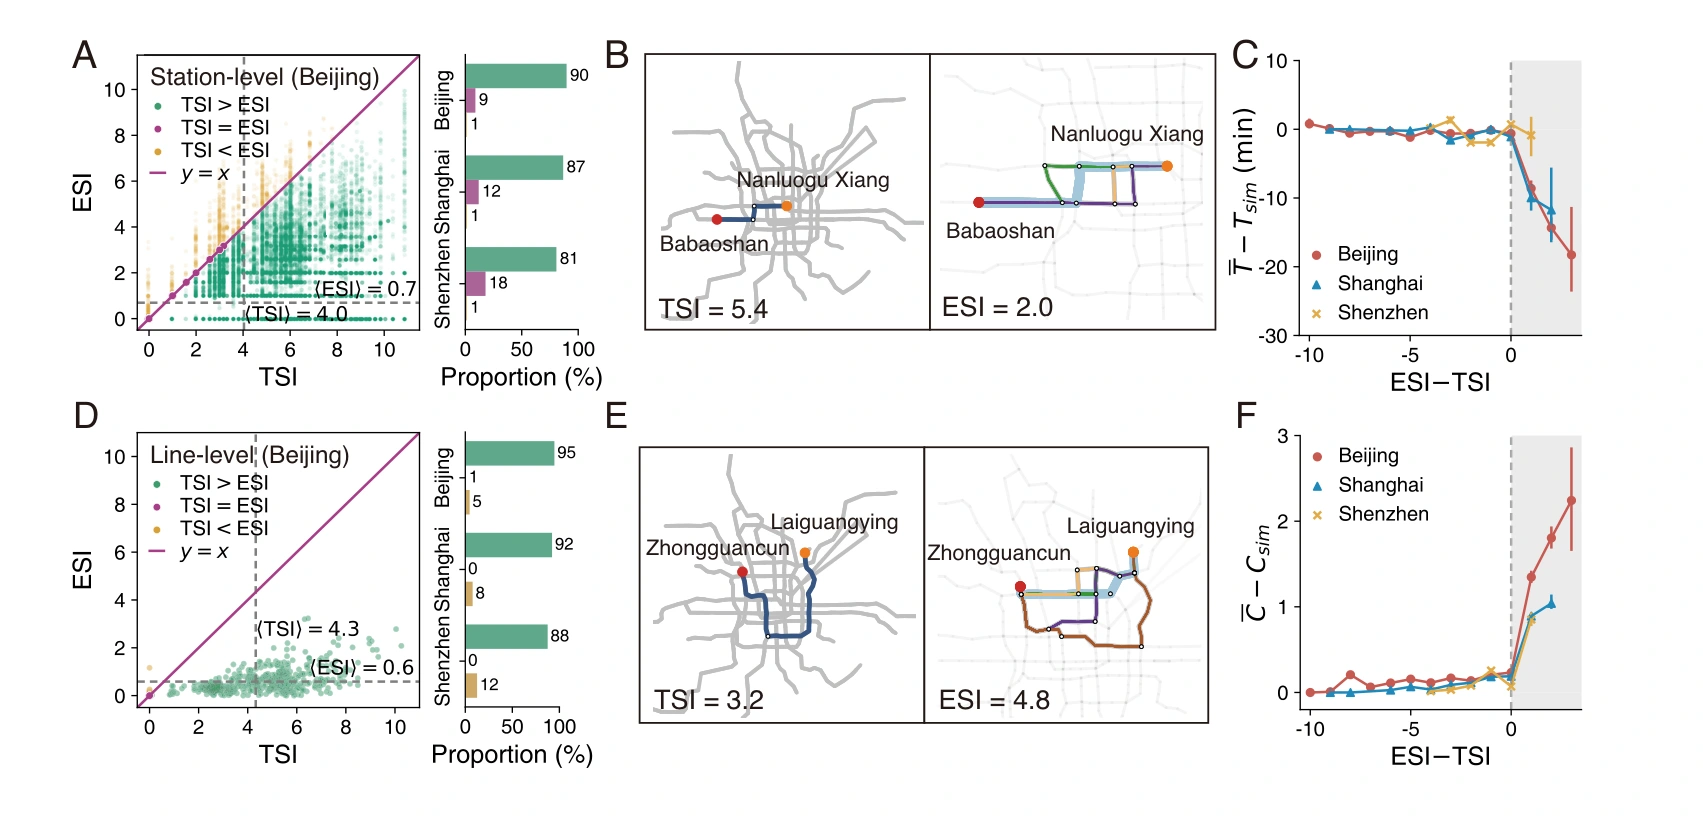
图 3|实际子网的搜索信息,在哪些站点对和线路对上低于整张网?
(A)左为北京站点对,每点一对车站,紫线是经验值等于理论值;图上标出均值约0.7比特和4.0比特。右为三座城市的站点对百分比:理论值更高为90%、87%、81%,相等为9%、12%、18%,经验值更高各约1%。(B)南锣鼓巷与八宝山。左是全网,理论值5.4比特;右是四条匹配路线组成的子网,经验值2.0比特。(C)横轴是经验值减理论值,纵轴是匹配路线的客流加权时间减去最简路径时间,单位分钟;竖线为95%置信区间。经验值更高的一侧,时间差落到0以下。(D)北京线路对。散点均值标为理论值约4.3比特、经验值约0.6比特。右侧长条为理论值更高的线路对:北京95%、上海92%、深圳88%;其余5、8、12个百分点分布在相等或经验值更高的类别中。(E)中关村到来广营。全网最简路径的理论值3.2比特;实际子网的经验值4.8比特。(F)横轴仍是信息差,纵轴是实际换乘次数减最简路径换乘次数,竖线为95%置信区间。信息差转为正时,换乘差上升。来源:原论文 Fig. 3。
中关村到来广营把这个例外写进了具体时间。子网路径的平均换乘次数C = 4.0,平均时间T = 61.6分钟;全网最简路径Csim = 1,Tsim = 89.7分钟。用这两个时间相减,多换乘的路径少用28.1分钟,搜索信息则从3.2比特升到4.8比特。4.0次是这对车站上匹配路径的平均换乘,1次是这对车站上最简路径的换乘。
线路层面把从线路s出发、到线路t结束的路线再做平均。经验值按匹配客流加权,理论值则汇总这些车站之间的最快最简路径。正文报告,超过87%的线路对经验值更低。图3D把北京线路对的均值标成约0.6比特对4.3比特,分母是线路对。站点对上的0.7比特对4.0比特,分母是北京的站点对。
路网长大以后,变难的是整张图,还是乘客在用的那张小网?
历史年份没有逐年的刷卡路径。作者用两步模型代替:先用重复最短路算法生成m条候选路径,再用匹配刷卡时的同一套离散选择模型,取概率最高的一条,当作实际路线,并计算它的搜索信息。选择集大小按图2的路线条数分布取为北京13、上海12、深圳6。正文说更换m后趋势相近。
因此,图4和图5里随年份变化的经验搜索信息,是模型在当年路网上选出的那一条路径的信息量。它和2019、2015、2017三个刷卡月份里按客流加权的经验值,回答的是两件不同的事。理论值则始终是全网最快最简路径的信息量。车内时间又固定在2020年,历史曲线反映的是线路和换乘结构加上这套选择规则,不包含列车加速。
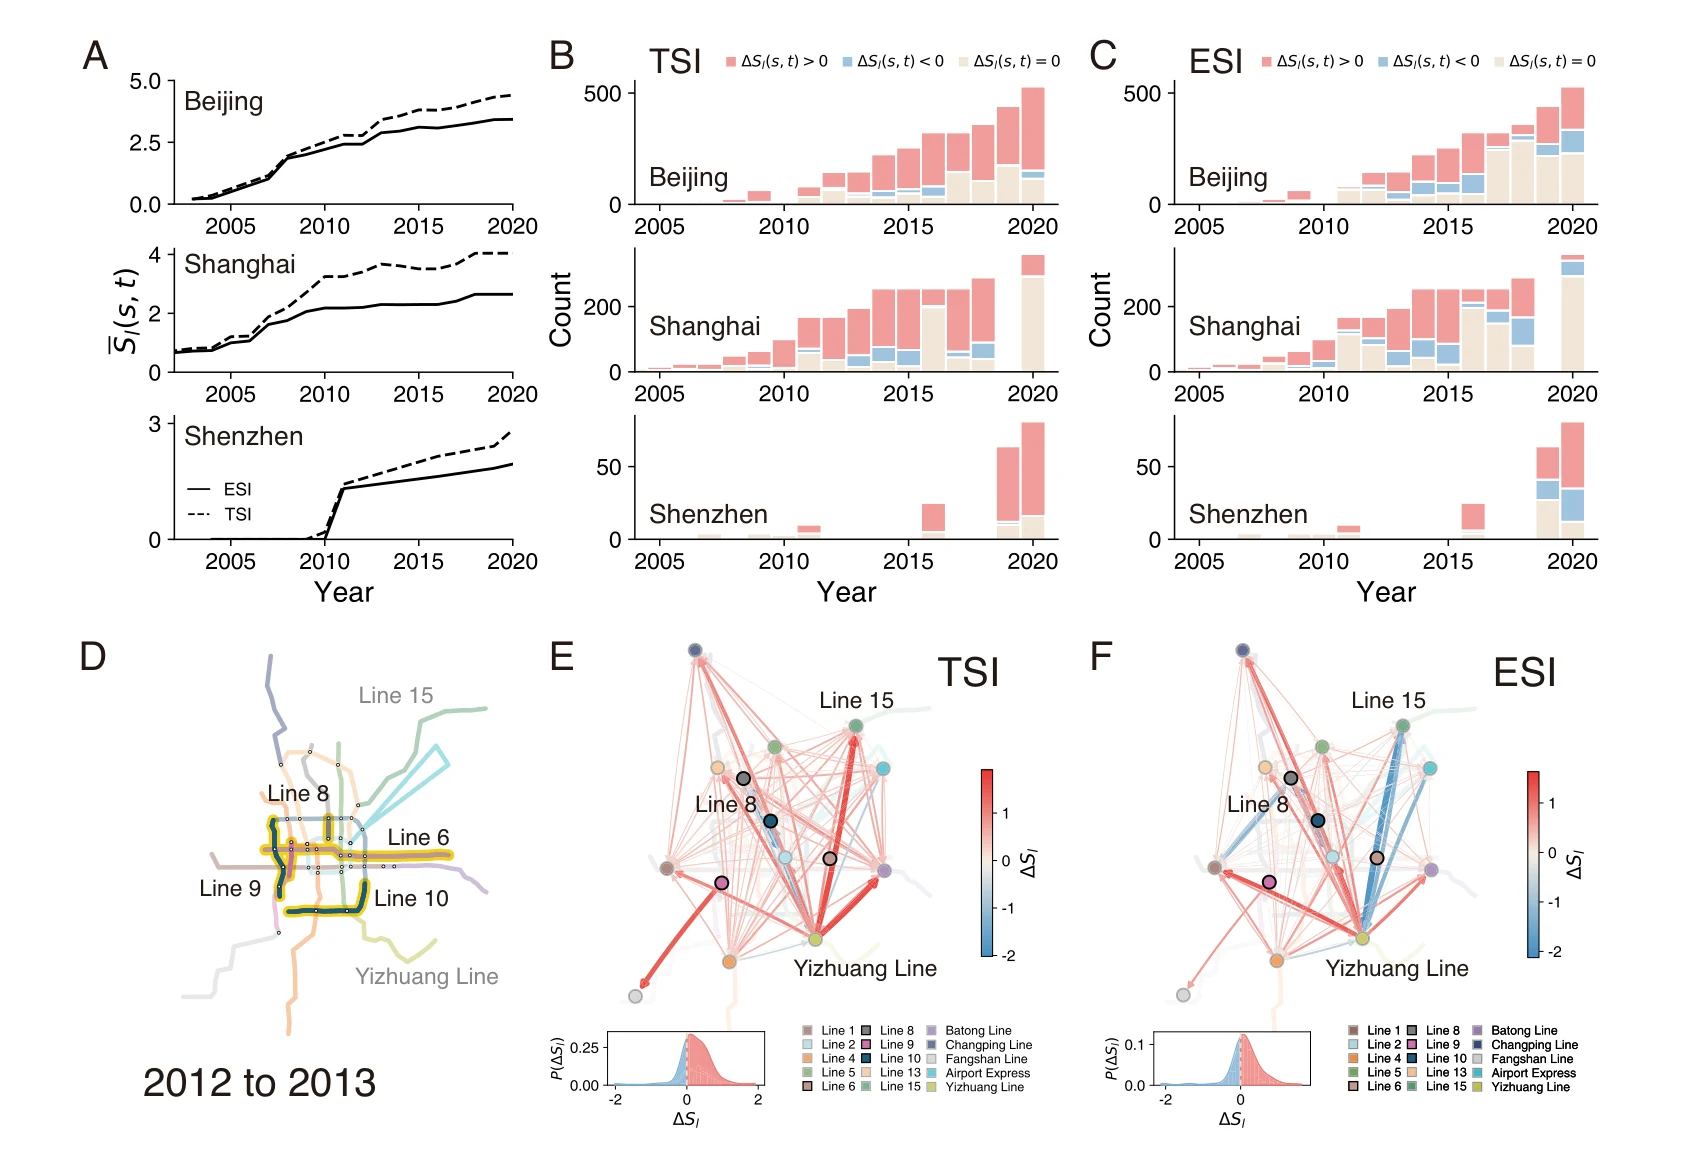
图 4|线网逐年变大时,线路对的理论值和经验值怎样分开?
(A)三座城市的线路对平均搜索信息。实线为经验值,虚线为理论值,两条都上升,经验值更低、升得更慢。(B)理论值按线路对计数。红色为当年上升,蓝色为下降,浅色为不变。柱高是线路对个数。(C)经验值的同样分解。2017年以后,北京和上海的浅色与蓝色占到柱子的大半。(D)北京地铁2012到2013年的变化,黄色是新开通的线段或线路。(E、F)线路对画成从起始线路指向终到线路的弧,颜色是2013年相对2012年的搜索信息差;小图是这个差值的分布。(E)多数理论值上升。(F)10号线接到亦庄线之后,从亦庄线到15号线、8号线等北向线路的经验寻路变容易。来源:原论文 Fig. 4。
平均值都在上升,经验值的升速更低。拆开看,全网理论值对绝大多数跨线出行是增加的。北京的例子是,超过70%的跨线出行理论值上升。图4B的柱子数的是线路对。子网里的经验值则有大量线路对不变,甚至下降。2017年起,北京和上海每年都有超过一半的跨线出行,经验值不变或降低。
2012到2013年的北京把这种分叉画在具体线路上。新开通部分以黄色标出。10号线延伸并接上亦庄线之后,从亦庄线前往15号线、8号线等北向线路的实际寻路变容易,而大多数出行的全网理论寻路变难。新增一条线可以同时提高整张图的理论复杂度,并降低某些实际使用的线路对的决策信息。
8比特和6比特分别卡在哪一类行程上?
最大值决定一张交通网最难的那一步,所以作者再看每年的最大搜索信息。图5只统计一类路径:信息网络中有2条连接的最快最简路径。正文后文把这一设定说成只考虑两次换乘的路线。上海的理论最大值达到Gallotti、Porter和Barthelemy在纽约找到的8比特上限。按正文所说的四分之三关系,8比特对应的经验上限约为6比特,三座城市的经验最大值也停在这一带。
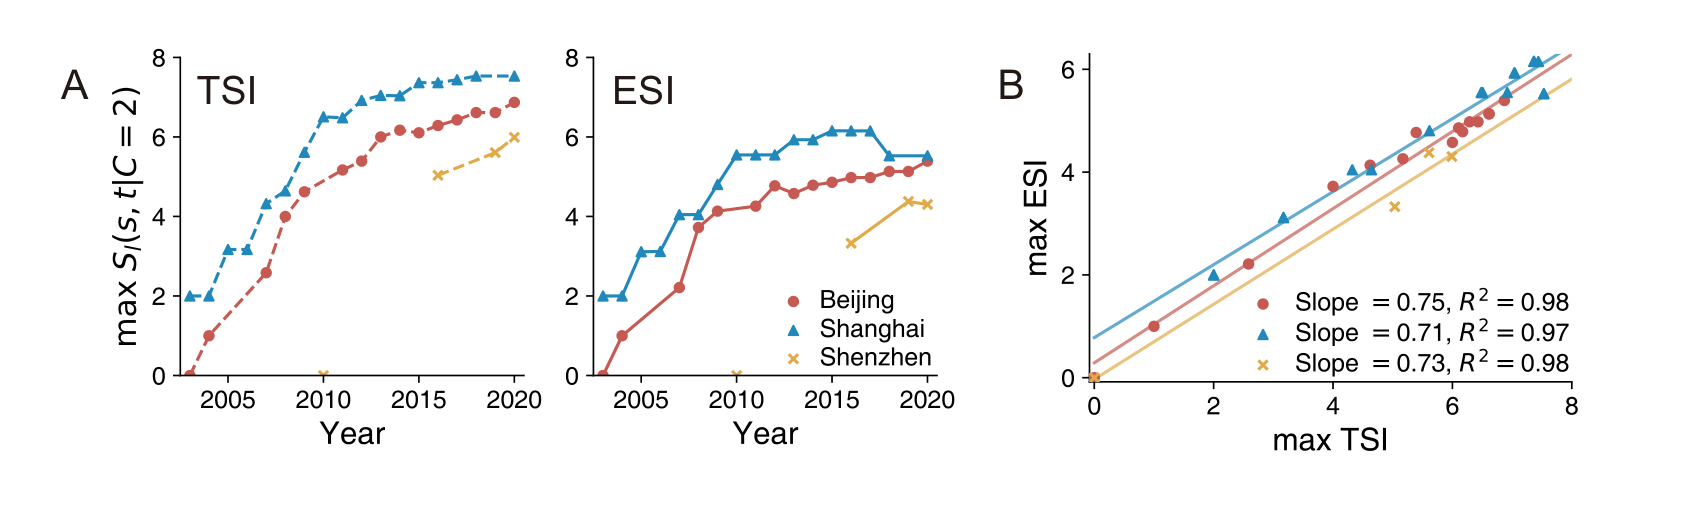
图 5|两次连接的最快最简路径,最大值之间有多紧的关系?
(A)纵轴是线路对搜索信息的当年最大值,只包含C = 2的最快最简路径。左为理论值,右为经验值;红圆为北京,蓝三角为上海,黄叉为深圳。上海的理论最大值接近8比特,三城经验最大值约到6比特附近。(B)每个点是(A)里某一年的一对最大值。拟合斜率与R²为:北京0.75、0.98,上海0.71、0.97,深圳0.73、0.98。来源:原论文 Fig. 5。
图5B的每个点是一座城市某一年的最大值。三条线的斜率都接近正文概括的3/4。斜率0.75的含义是:在这些年最大值上,理论最大值每高出4比特,拟合的经验最大值高出约3比特。R²描述的是这些年最大值排得有多齐。
作者进一步把6比特和信息网络的连接数联系起来。对两次连接的路径,若地铁网接近规则网格,线路对平均搜索信息近似等于 log₂(Kᵤ)。Kᵤ是信息网络的边数,也就是地铁网里的换乘连接数。6比特对应2⁶ = 64条连接:在这个近似下,上述最复杂的两次换乘搜索,相当于在子网里受到64条连接的干扰。
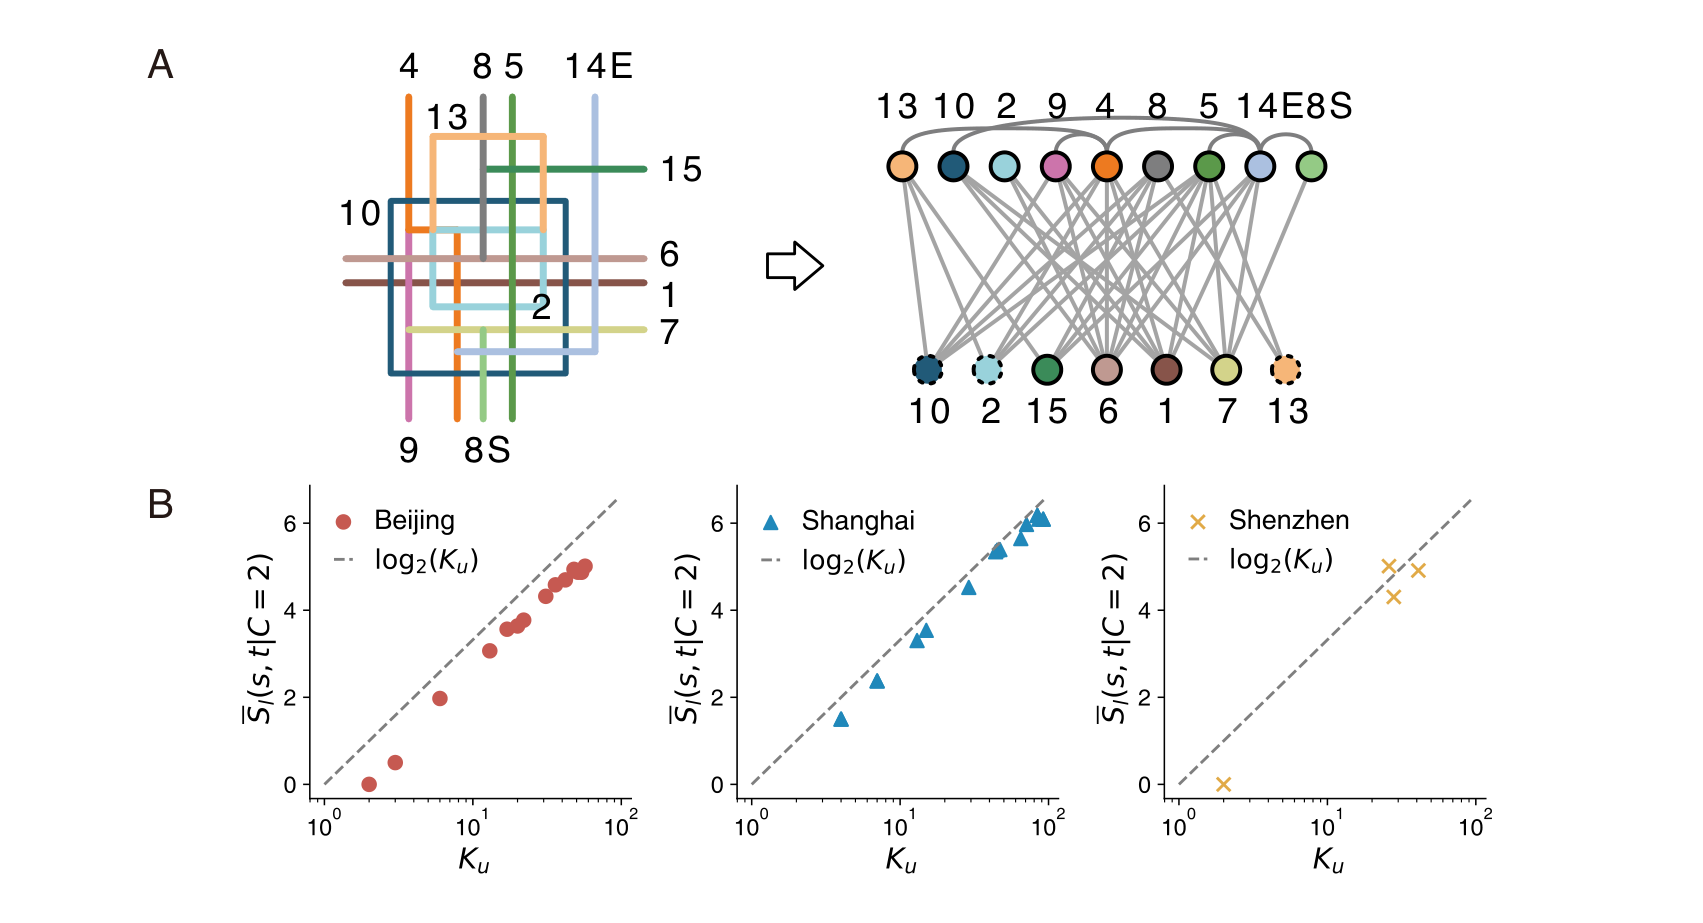
图 6|两次换乘的平均搜索信息,是否接近连接数的对数?
(A)左为北京地铁的网格状线路。2号线、10号线、13号线这样的环线同时充当横向和纵向,所以在右侧信息网络里画成同色的实心点与空心点。箭头表示从线路图映射到信息网络。(B)纵轴是C = 2时的线路对平均搜索信息,横轴是连接数Kᵤ,虚线是 log₂(Kᵤ)。北京、上海、深圳的历年网络分别与这条虚线对照。来源:原论文 Fig. 6。
北京的网格使这个近似有一个可看的几何对象,但作者同时写出边界:6比特和先前的8比特都只在两次换乘的路线上得到。许多行程要超过两次换乘,有的甚至要五次。从两次换乘总结出的上限,不能代表不同换乘次数下的全部网络复杂度。
讨论里还把6比特与认知科学中工作记忆约2–6个项目的范围并置。这项研究没有测量乘客的记忆容量,这一并列是两个数值的对照。
这些比较能说到哪一步
刷卡匹配的路径是模型输出。272条已知路线的问卷给出92.1%的总体正确率,北京16条线路的份额回归给出R² = 0.99。线路份额对齐,不能推出每一名乘客的换乘站都被认对。
子网只包含数据里出现过的路线。作者指出,人们可能还想过一些从未被观察到的备选路线;那些路线会使搜索信息高于本文的经验值,并仍然低于全网理论值。后半句是对未出行路线的判断,数据里没有这些路线的客流。
0.7比特和4.0比特是北京站点对的平均值。一对车站内部,经验值按路径客流加权;跨站点对再取平均时,正文写的是对全部站点对平均。客流很大的站点对,不会因此在这个0.7里占更大权重。线路对上的0.6比特和4.3比特又是另一个平均。
历史曲线使用固定的2020年车内时间,以及每组候选里概率最高的一条路径。它适合比较路网结构变化下的模型决策成本,不能当成2003年以来每年真实刷卡路径的信息量。三座城市的刷卡月份相差数年,城市之间的百分比也不宜读成同一年的城市排名。
搜索信息衡量的是在一张给定网络里指定路径的信息量。它没有直接观察乘客是否迷路、是否感到困难,也没有覆盖公交、步行和多种方式接续的出行。两次换乘上的6比特上限,留下了五次换乘那些行程仍需单独计算的空间。
一句话总结
乘客反复使用很少几条路线,所以在这些路线组成的小网上指定下一步,所需信息低于把整张地铁网都当成选项时的理论值;线网变大以后,实际使用的小网也没有以同样的幅度变难。
核心来源
- PNAS Nexus正式发表页面,2022年7月22日在线发表,卷1第3期,文章编号pgac126。正文图1–6及正文中的样本量、系数和比特数均按该版核对。
- 2024年勘误,只补充人类参与者政策所需的匿名与知情同意声明。
- 复现数据与代码,Zenodo记录号10.5281/zenodo.6828403。
作者介绍
四位作者在论文中的署名单位都是北京大学地球与空间科学学院遥感与地理信息系统研究所。董磊与刘瑜为通讯作者。
- 姜卓君(Zhuojun Jiang):第一作者,参与研究设计,并负责处理、分析数据和写作。北京大学教师主页记录其2015–2019年在武汉大学完成本科,专业为遥感科学与技术,2019年起在北京大学攻读地图学与地理信息系统;主页邮箱为 zhuojun.jiang@pku.edu.cn。
- 董磊(Lei Dong):通讯作者,参与研究设计与写作。学院教师主页列其为该所助理教授、博士生导师,研究领域为城市科学与时空大数据分析。
- 邬伦(Lun Wu):与刘瑜共同协调研究。研究所主页列其为教授、博士生导师,研究领域为地理信息方法、时空大数据与智慧城市。
- 刘瑜(Yu Liu):通讯作者,参与研究设计、写作并协调研究。学院教师主页列其为博雅特聘教授,研究方向为地理信息科学、时空大数据与社会感知;主页邮箱 liuyu@urban.pku.edu.cn 与论文通讯邮箱一致。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
2012到2013年的北京已经给出一个规划上会碰到的分叉:10号线接到亦庄线之后,全网理论寻路对大多数出行变难,从亦庄线到15号线、8号线的经验寻路却变容易。若评审一张新线方案时只跟踪理论最大值,这次接通会被记成纯粹的损失。更贴近本文机制的检查,是在开通前后用同一套选择模型,列出客流所在的线路对,分别报告经验搜索信息上升和下降的线路对各有多少。分母用线路对,并另报这些线路对上的客流,读者才能看见“大多数线路对”和“大多数乘客”是否同一件事。
中关村到来广营则说明,搜索信息最低的路径不一定是乘客选中的路径。1次换乘、89.7分钟的最简路径,理论值是3.2比特;平均4.0次换乘、61.6分钟的路径,经验值是4.8比特。用两个时间相减,多出来的换乘换回28.1分钟。一个只奖励低比特的导航评分,会把更慢的那条排到前面。若要把这篇论文用到线路方案比较里,需要事先写明目标是减少线路选择,还是减少行程时间;两个目标在这对车站上方向相反。
6比特上限卡在两次换乘的最快最简路径上,而正文明确说有的行程要换乘五次,信息量又是沿换乘累加的。一张网可以在两次换乘这一个切片上低于6比特,同时让五次换乘的站点对很贵。下一步可以把站点对按换乘次数分组,在每一组里重新比较经验值与理论值,并写出该组有多少站点对。北京那个0.7比特还是站点对的简单平均。若再按站点对的匹配客流加权,零换乘的大客流会把平均值拉低,多次换乘的大客流会把它抬高。这个加权平均本文没有给出,它和0.7比特回答的是不同的问题。