到北京的距离,为什么对通勤、休闲和商务在不同公里数掉头?
论文名片|Zile Liu、Xiaobing Liu、Xuedong Yan、Fengxiao Li、Hua Zhong、Yun Wang,Influences of built environment on intercity travel demand of urban agglomerations: The discrepancies across inferred trip purposes,Cities,2026,168:106404。2025年8月21日录用,2025年9月2日在线发表。期刊页眉写作 Cities 168 (2026) 106404。DOI:10.1016/j.cities.2025.106404。观察性建模研究,属于专题 Spatial Governance of Urban Agglomeration。
周一清晨从廊坊去北京上班,和周末从同一片地方去景区,走的可能是同一条高速公路。若规划只问这块地方离北京多远,两条出行会被收成同一个距离。下面这个场面只用来看清比较的对象,不是论文记录的某一次真实行程。
这篇论文用2021年京津冀城市群的手机信令,先按规则把人分成通勤、休闲和商务,再在3公里格上用地理加权神经网络(geographically weighted neural network,GWNN)拟合建成环境与对数出行量的关系,并用沙普利加性解释(SHAP)读每个变量把预测值往哪边推。到北京中心的距离对通勤大体是近处高、远处低;对休闲和商务则是先升后降。正向区间的终点,摘要写的是通勤120公里、休闲160公里、商务175公里。这是模型在格子上的偏依赖,不是问卷里的出行目的,也不是把公司搬近就会增加通勤的实验。
先说结论
- 2021年8月2日至10月24日,中国移动在京津冀的城际信令超过2.4752亿条,涉及1647万用户。规则最终留下的三类出行合计4690.0万次;其中商务4206.1万次,占这4690.0万次的89.68%。
- 通勤出行者只有33330人,但12周里人均79.51次,平均68.624公里、72.467分钟。休闲254680人,人均8.60次,平均118.642公里。商务2135037人,人均19.70次,平均98.192公里。
- 目的标签的“准确率”是同一人前后两段出行是否得到同一标签。三类明确目的的算术平均IAI为0.512;通勤这一类为69.3%。对照是100组均匀参数里最好的IAI 0.391。
- 5折交叉验证里,GWNN的R²为通勤0.576、休闲0.595、商务0.580、未分类全部数据0.523。每一行的次优模型都是地理加权随机森林。误差算在出行次数的自然对数上。
- 依赖图给出的正向终点是通勤120公里、休闲160公里、商务175公里。休闲在约75公里处最高,商务在约95公里处最高;通勤是在0至120公里内下降,120公里后为负。表1里网格到北京中心的平均距离是196.808公里。
这2.4752亿条记录,记的是跨城行程,不是一个人的全天
京津冀城市群在文中写作BTH-UA,约21.6万平方公里,占全国陆地的2.3%,含北京、天津和河北11个地级市,一共14个城市。论文给出的2023年口径是:地区生产总值10.4万亿元,占全国8.2%;人口1.09亿,占全国常住城镇人口的7.5%。出行数据是2021年的,和这组2023年经济社会数字不是同一年。
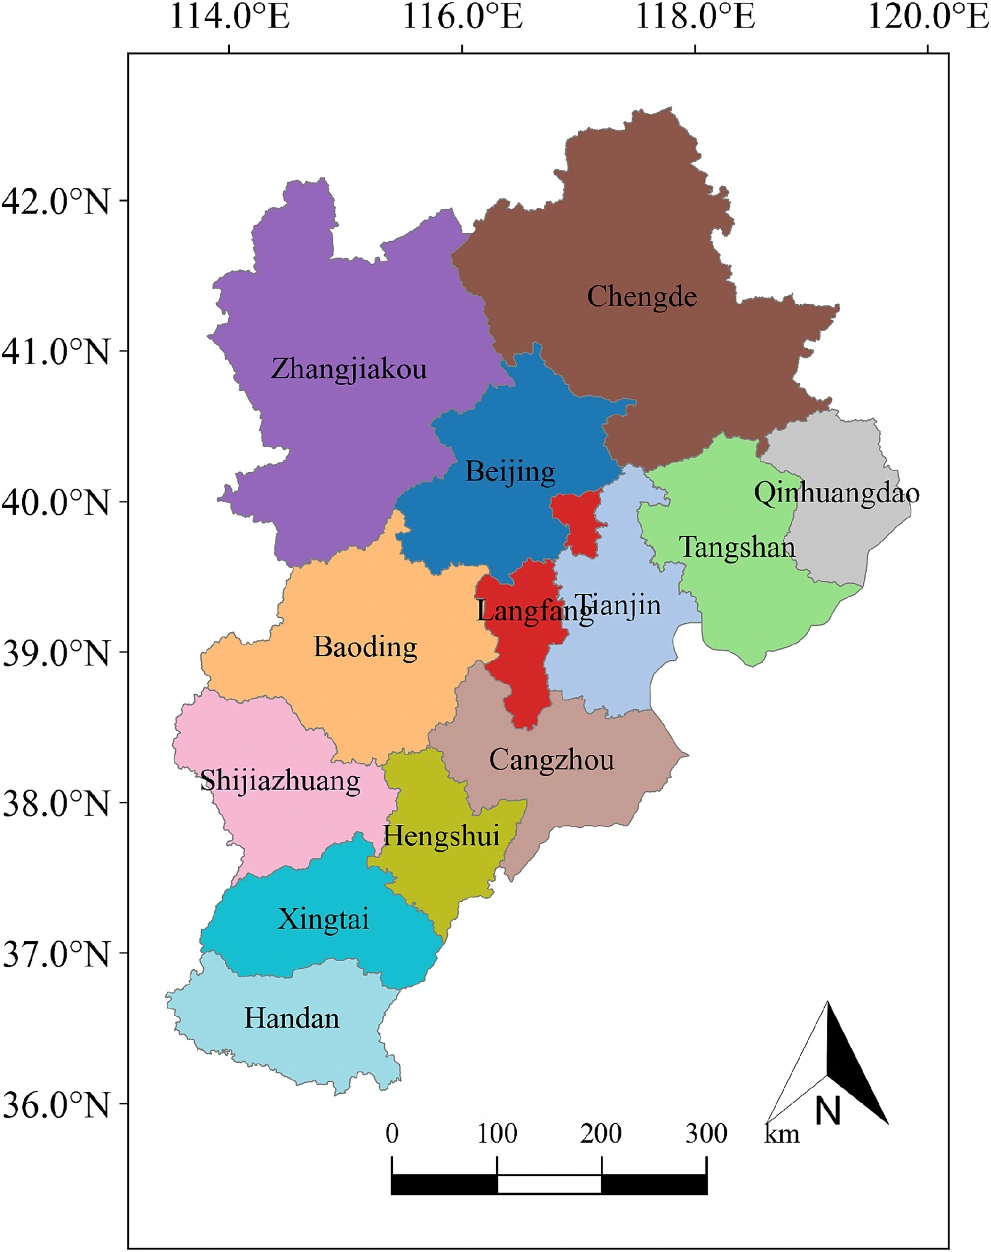
图 1|研究区覆盖哪14个城市?
地图画出北京、天津,以及石家庄、保定、唐山、廊坊、秦皇岛、邯郸、邢台、张家口、承德、沧州、衡水。来源:原论文 Fig. 1。
信令由中国移动提供,匿名,含起终点经纬度、时间、行政区与起讫距离。运营商规模是超过220万座基站、超过8亿客户;这是公司体量,不是分析样本。样本是城市群内超过2.4752亿条城际记录、1647万用户、连续12周。按8月2日到10月24日逐日计算,窗口正好84天。中秋(9月19日至21日)和国庆(10月1日至7日)都在窗口内。
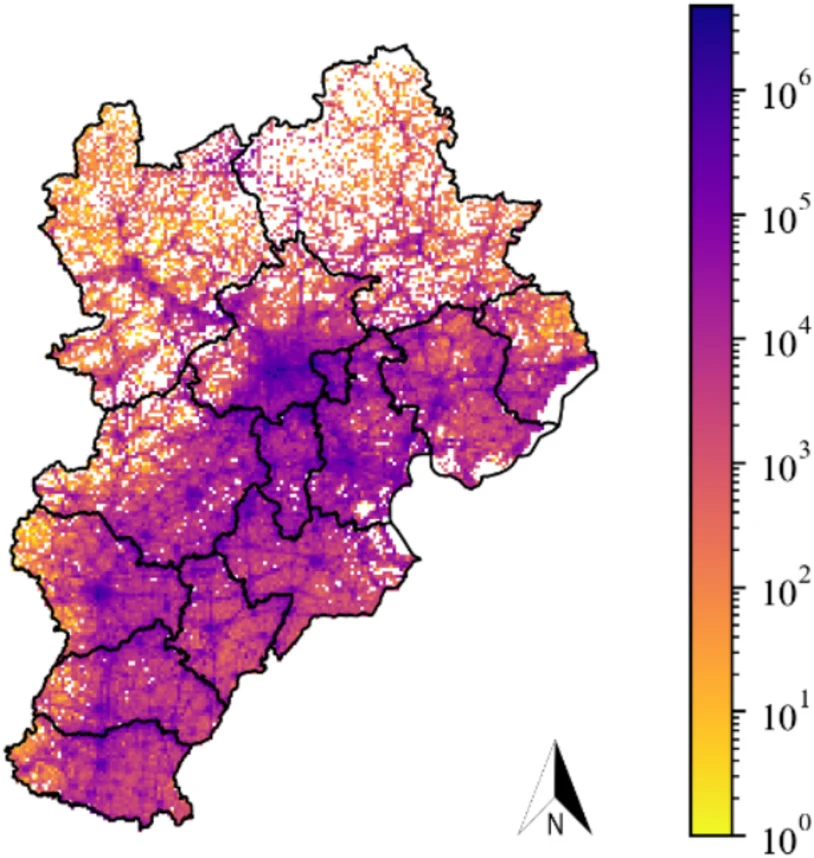
图 2|未分目的之前,出行堆在哪些格子?
颜色是出行量,色标按10的幂从个位数画到百万级。高值集中在北京、天津、廊坊一带,西北和北部稀疏,分布是长尾。来源:原论文 Fig. 2。
因为长尾,模型的因变量是城际出行次数的自然对数。分析单位是3公里×3公里的格子。论文把这个量也称为格子上的对数OD出行量,但没有写明一次行程记在起点格、终点格,还是两端都记。正文也没有报告进入模型的格子数。区域面积除以9平方公里,理论上限约2.4万格;那只是面积参照,不是样本量。
建成环境被收成四类,全部落到同一套格子上。社会经济:2021年VIIRS夜光、WorldPop 2021年100米人口、2021年统计年鉴里的GDP。土地利用:2021年百度地图兴趣点,12类功能,并计算兴趣点总数和香农熵。香农熵在这里表示一个格子里各类兴趣点的比例有多散,数值越高,功能种类越不集中。交通:OpenStreetMap的道路长度、铁路长度、城际交通设施数和市内交通设施数。距离有两个:到最近城市核心的距离,以及到北京这个城市群核心的距离。城市核心被定义成公司类兴趣点最多的那一格。
人口在表1里的单位是每平方公里百人,均值4.936,相当于每平方公里493.6人。1.09亿人除以21.6万平方公里约为每平方公里505人。前者是2021年格网人口的格平均,后者是2023年人口除以区域面积,只能说明量级接近。夜光均值16.153,正文没有给出物理单位。格网GDP均值484.3万元,标准差2334.6万元;年鉴上的城市总量如何分到3公里格,正文没有写。
表1同时说明,这些变量挤在一起,而且在空间上成片。购物兴趣点的方差膨胀因子是153.142,生活服务93.369,土地利用总量1381.802。到北京中心距离的莫兰指数是0.999,到最近市中心是0.993。距离场几乎必然空间相关。作者因此不用普通线性回归当最终模型。高共线性还留在后面:SHAP把功劳分给高度相关的兴趣点时,单项名次会不稳。
目的标签从行程堆在何时、何地推出来
正式分类之前,论文从出行超过10次的人里随机抽了3个人,看规则想抓住的形态。这3个人是例子,不是准确率的分母。
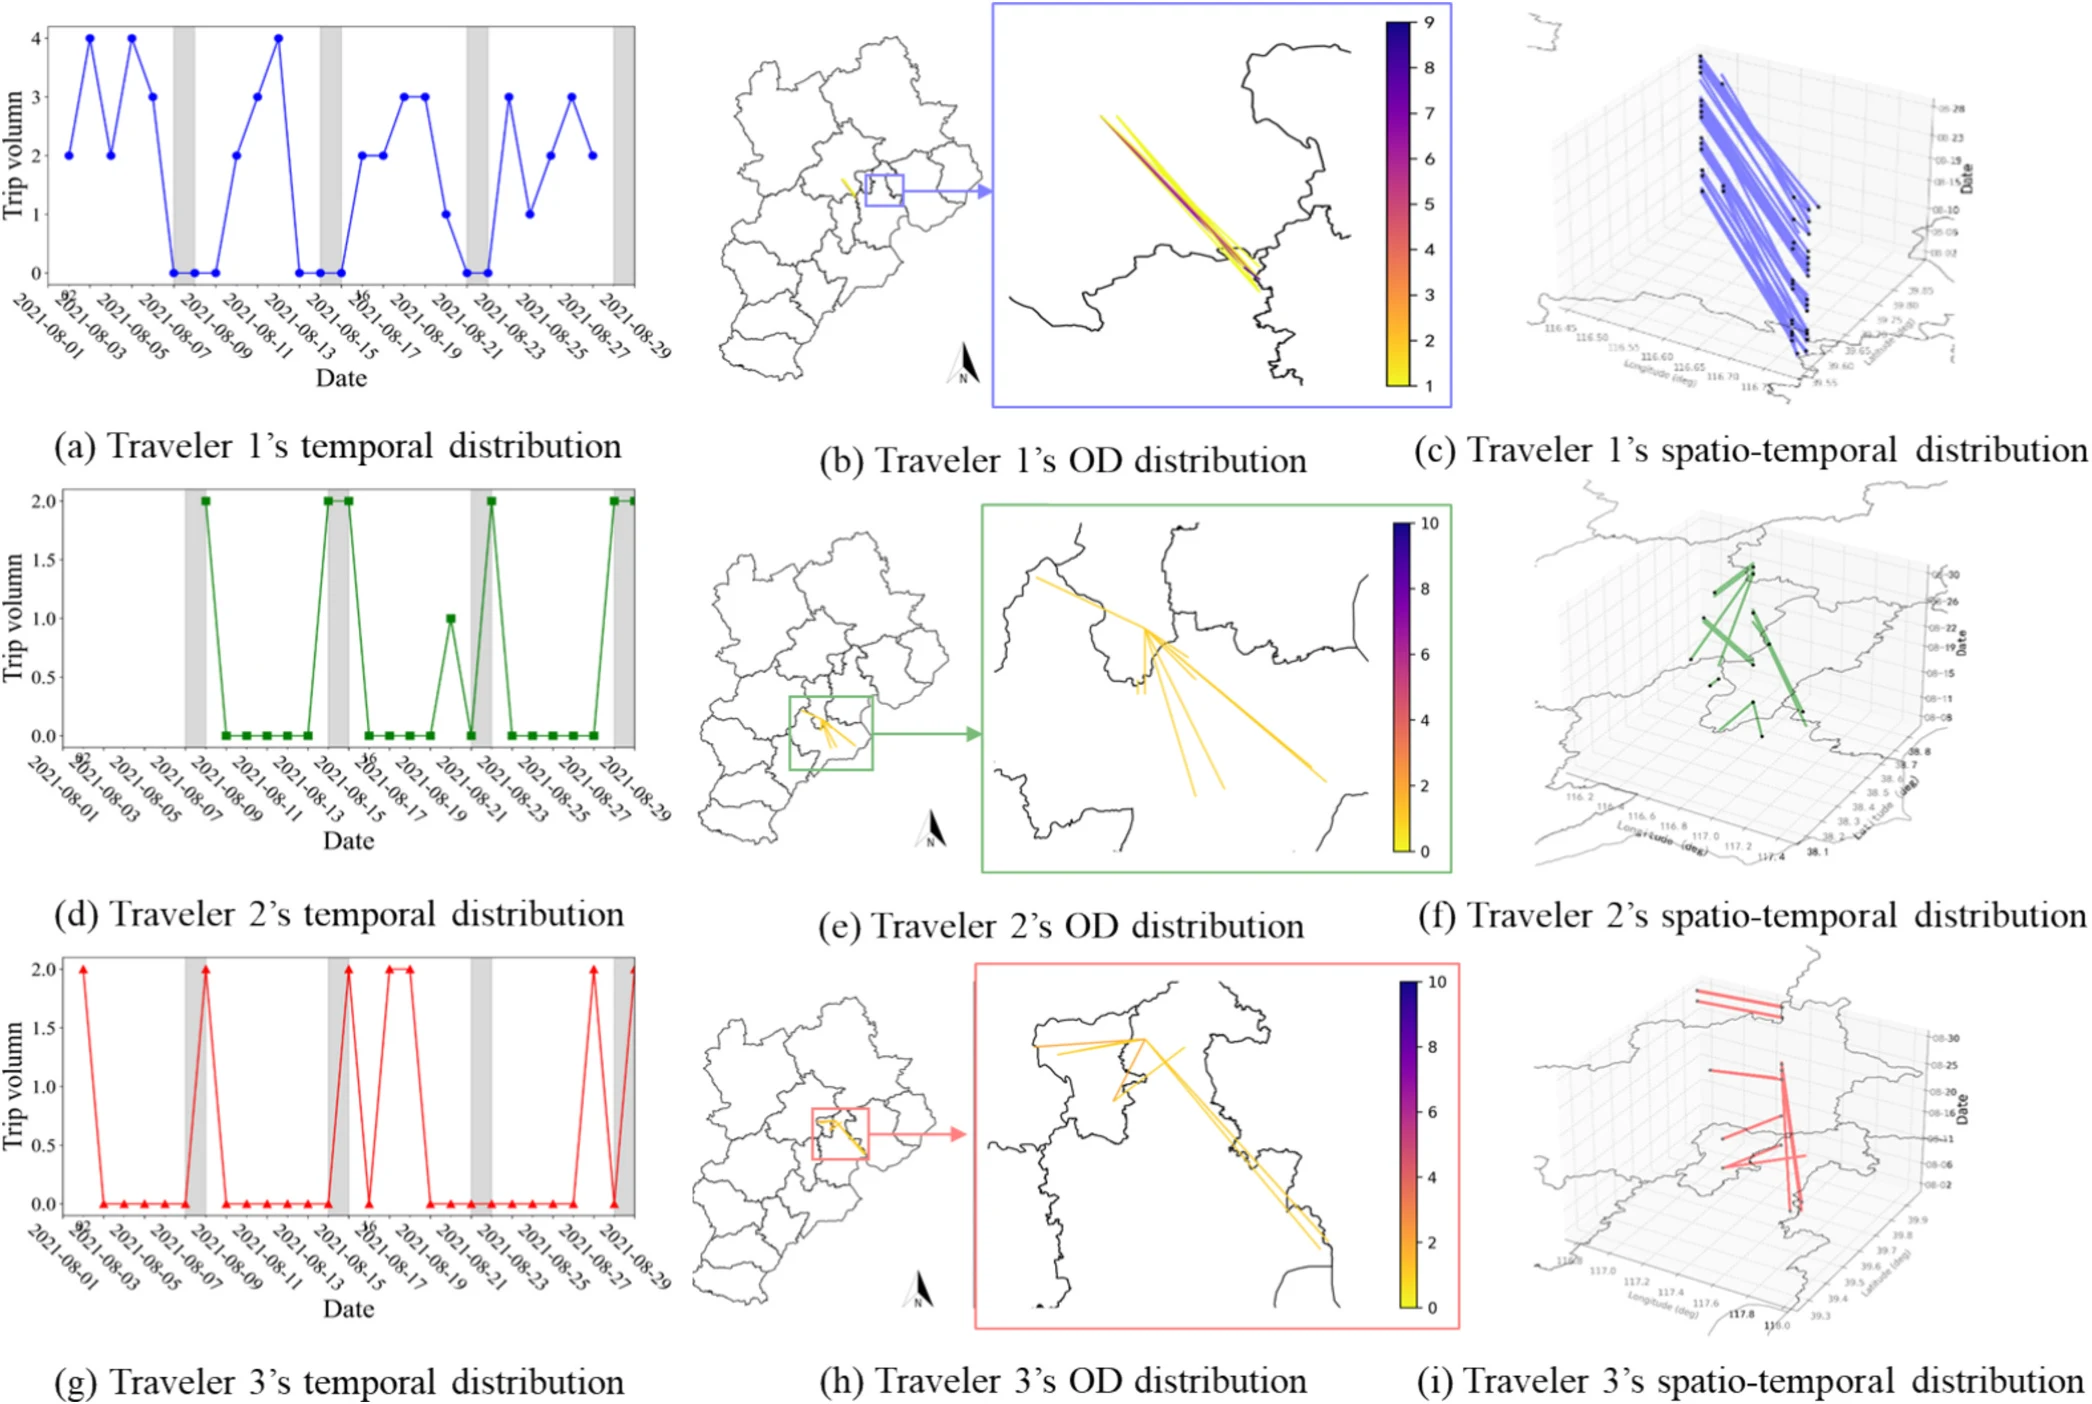
图 3|规则想分开的三种形态长什么样?
(a、d、g)纵轴是出行量,横轴是2021年8月2日至10月24日。出行者1集中在工作日,出行者2集中在周末,出行者3没有稳定的星期模式。(b、e、h)是这三人的起讫分布:1和3的起讫较集中,2从一个固定起点散向多个终点。(c、f、i)把时间和空间叠在一起。来源:原论文 Fig. 3。
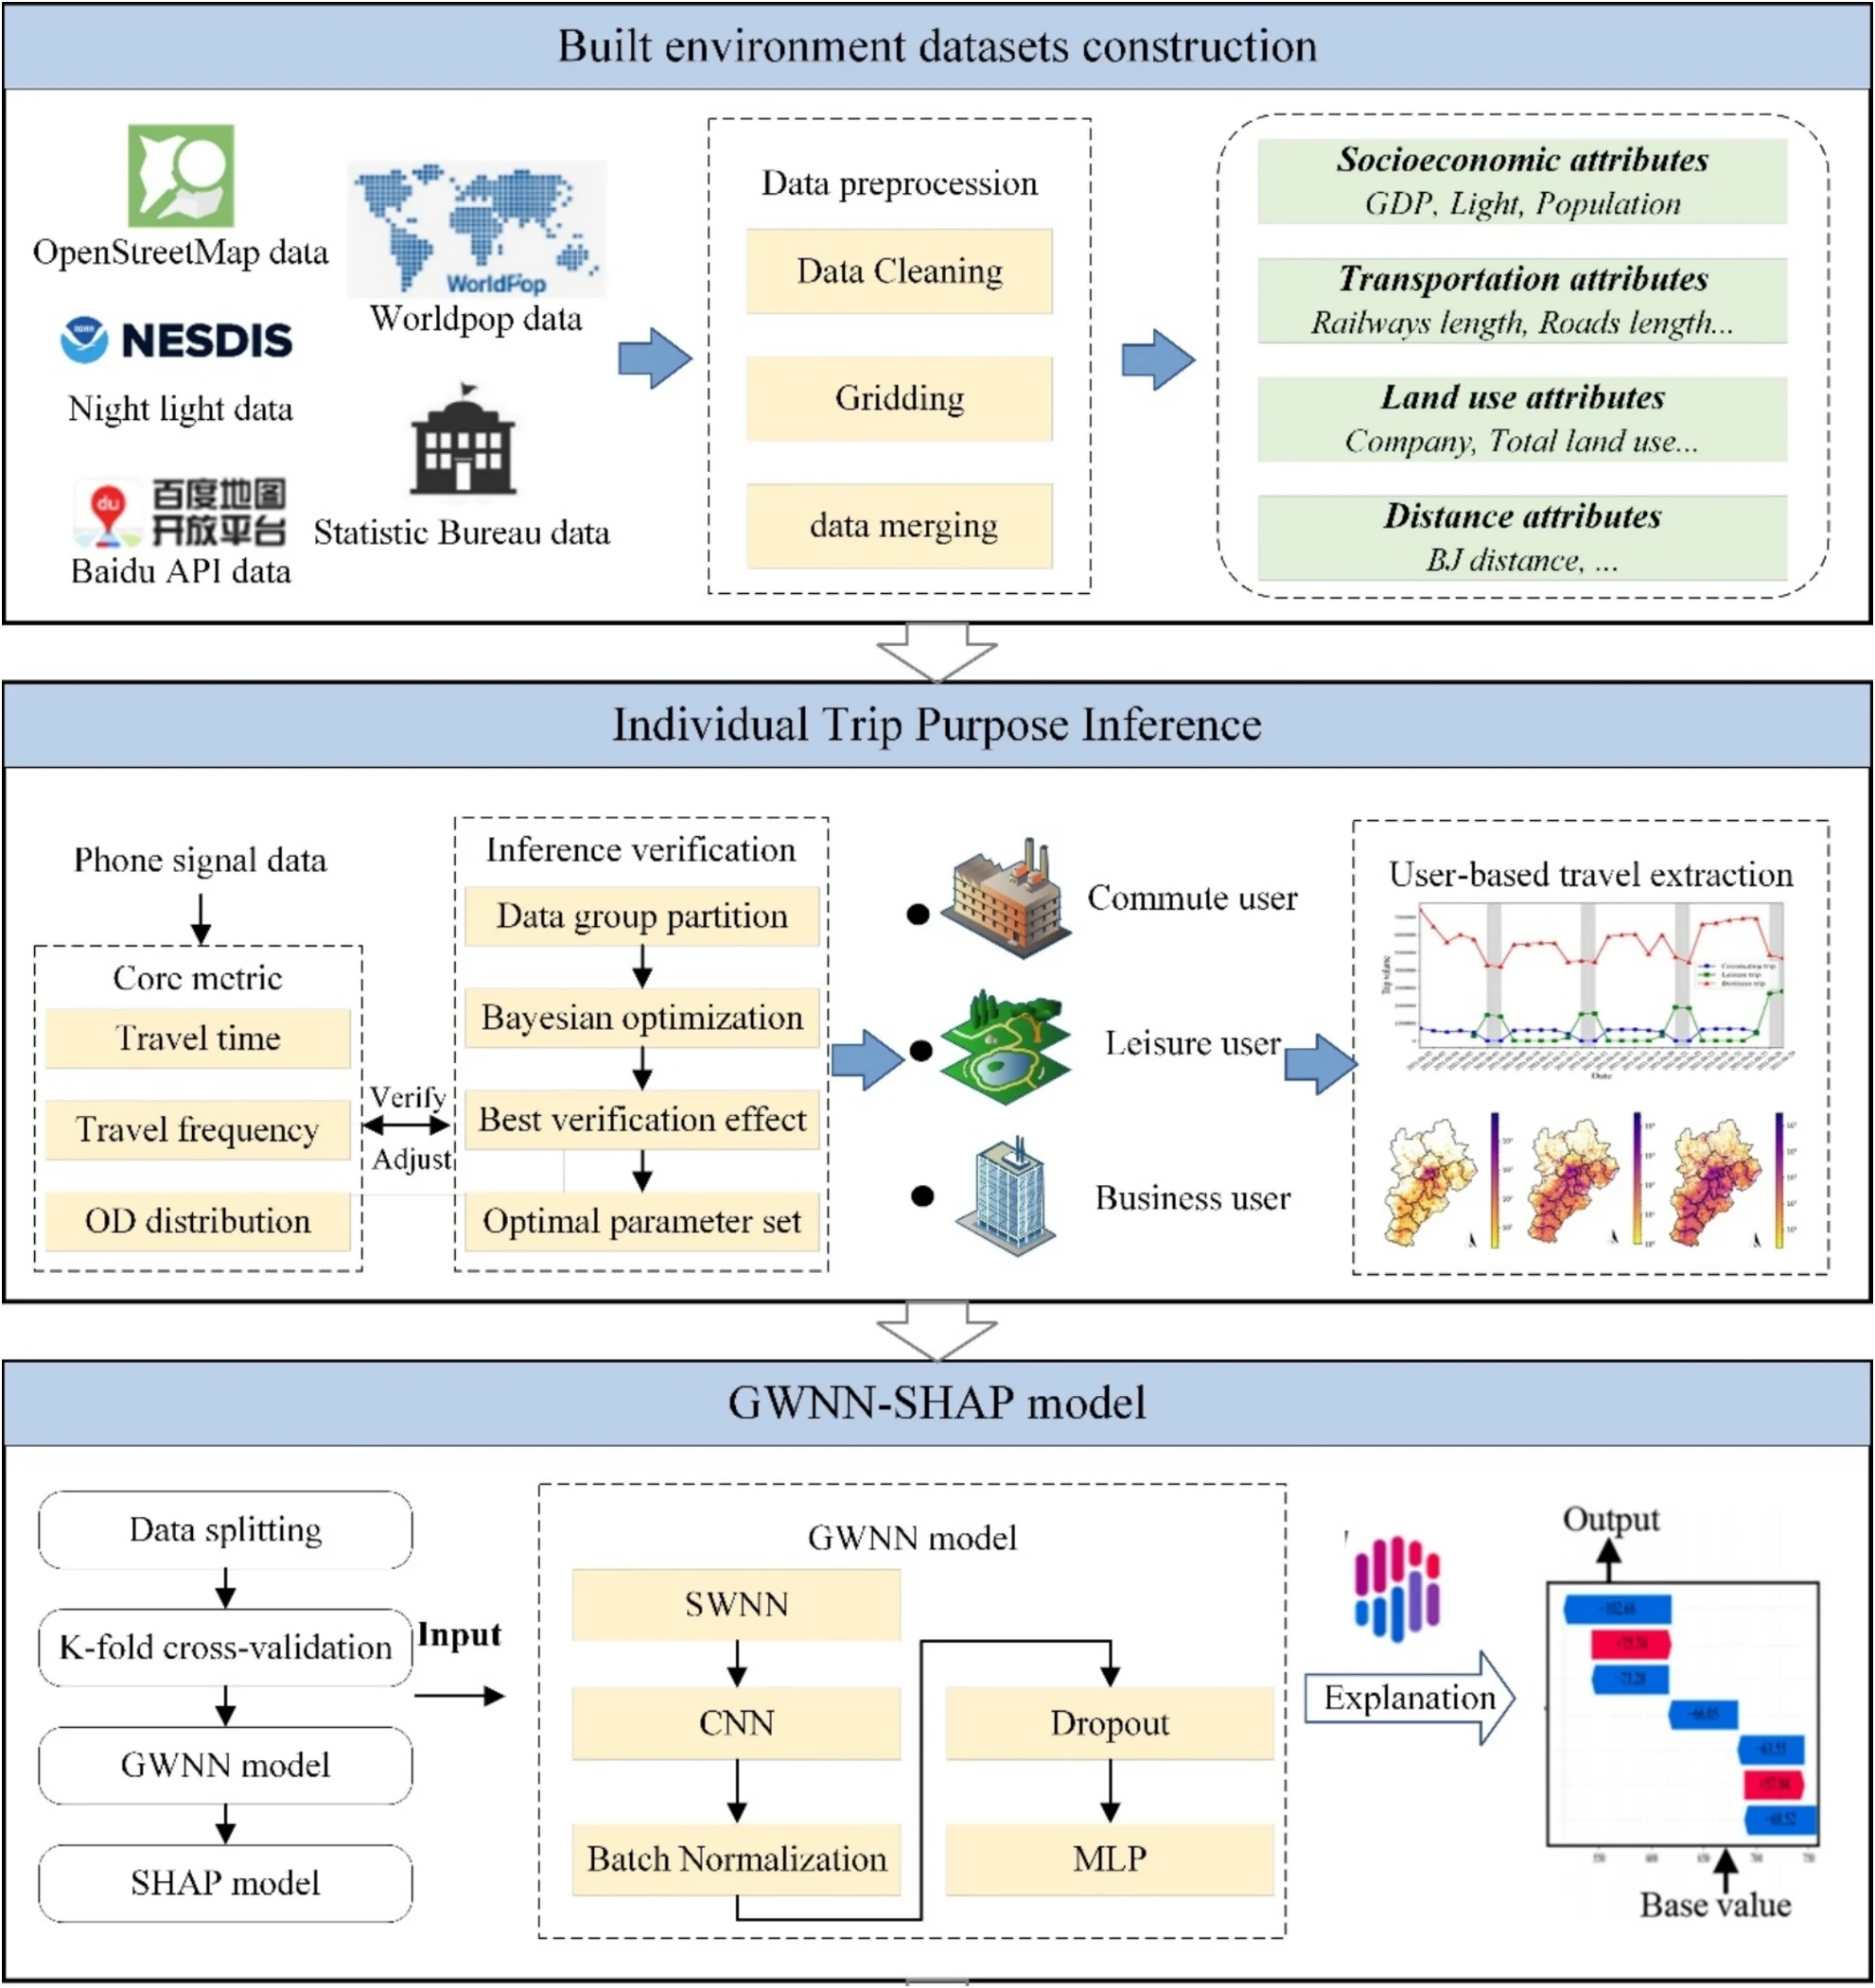
图 4|从多源地图到三类出行,中间经过哪三步?
上段用夜光、WorldPop、统计年鉴、百度和OpenStreetMap做成格子上的建成环境。中段用出行时间、频率和起讫分布做规则,并用贝叶斯优化选阈值,分出通勤、休闲、商务。下段把数据切成折,用GWNN预测,再用SHAP解释。来源:原论文 Fig. 4。
通勤时段被定得比市内通勤宽:工作日05:00–09:00和17:00–21:00。论文引用的依据是北京长距离通勤有不少人凌晨出发,平均出发时间可早到约5点,晚高峰还包含加班。休闲时段是周末和法定假日的全天。通勤行程只取每人每天早高峰或晚高峰的第一次行程。
一个人是否算“有固定起讫”,看两件事:出行量最大的两个格子各自占这个人总出行的比例要够高,而且这两个格子之间的往来要占它们所涉出行的一半以上。固定单点则是最大格子很高、第二大格子不高。通勤还有一套只在通勤时段里重算的版本。低频的人先被划进混合类。参数共8个,贝叶斯优化做了1000次,并要求前三个比例阈值递减、通勤用的两个比例阈值也递减。
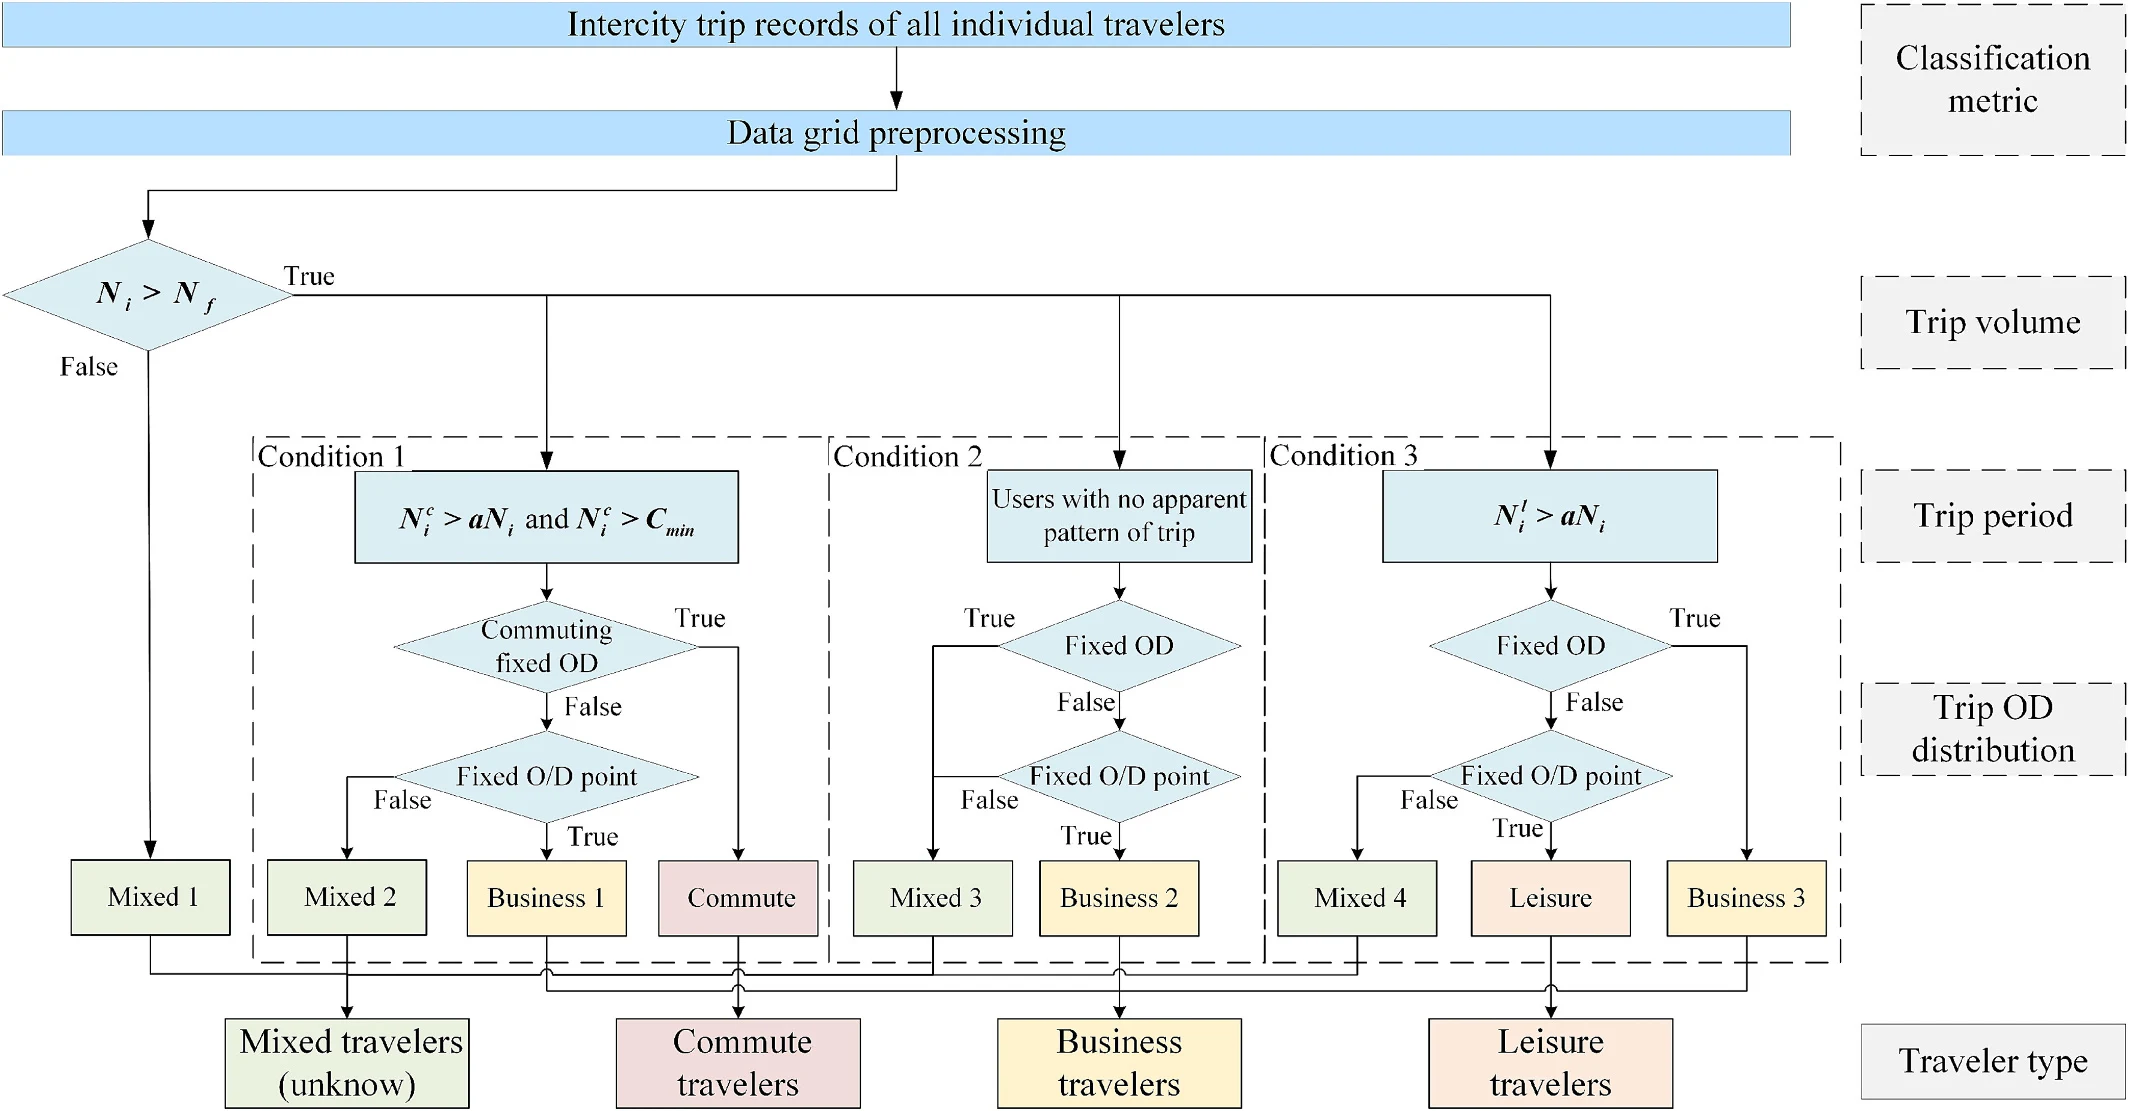
图 5|一个人怎样被分进通勤、休闲、商务或混合?
出行次数不超过Nf的人直接进入混合。其余按出行是否集中在某一时段分成三支。集中在通勤时段、次数超过Cmin、并且通勤起讫固定的人,标为通勤;这一支里只有固定单点、没有固定起讫对的人,标为商务。看不出时段规律时,有固定起讫对标为商务,否则混合。集中在休闲时段时,有固定起讫对仍标为商务,只有固定单点才标为休闲,其余混合。商务可以从三个时段分支里产生,休闲只从假日分支里产生。来源:原论文 Fig. 5。
最优阈值是:Nf = 4,Cmin = 27,时段集中系数 a = 0.6,五个比例阈值为0.569、0.394、0.255、0.627、0.519。论文把Nf说成“每月出行较少”的门槛,又在流程图里用它和总出行次数Ni比较;按月还是按这12周,没有再换算一次。Cmin = 27是进入通勤判定的最低通勤时段出行次数。a = 0.6表示相关时段的出行要超过这个人出行的六成。
校验不是拿问卷核对。每个人的行程按时间切成两段,两段分别跑同一套规则。某一类的一致率,是两段都被标成该类的人数,除以至少有一段被标成该类的人数。推断准确率指数IAI是通勤、休闲、商务三个一致率的算术平均,混合类不进这个平均。最优参数的IAI是0.512,100组均匀抽参数里最好的是0.391。通勤一致率69.3%。因为0.512 × 3 − 0.693 = 0.843,休闲与商务的一致率之和是0.843;正文没有分别列出这两个数。论文用了“显著高于”,但没有给出检验或区间。能核对的就是0.512对0.391,以及通勤69.3%这个一致率。
这套一致率衡量规则稳不稳定。一段被标成通勤、另一段也是通勤,会计入分子。它不衡量这个人是否真的在上班。混合类和未能归入三类的行程有多少,正文没有给。
分完类以后,三类出行不是同一种长尾
表4是规则输出的直接计数。次数和人数的单位不同,人均次数是用表4的两个数相除,分母是该类出行者人数,时间范围是这12周。
| 类型 | 出行次数 | 出行者人数 | 人均次数 | 平均距离 | 平均时长 |
|---|---|---|---|---|---|
| 通勤 | 265.0万 | 33330 | 79.51 | 68.624公里 | 72.467分钟 |
| 休闲 | 218.9万 | 254680 | 8.60 | 118.642公里 | 86.297分钟 |
| 商务 | 4206.1万 | 2135037 | 19.70 | 98.192公里 | 77.717分钟 |
三类人数合计2423047,其中商务占88.11%。三类次数合计4690.0万,商务占89.68%,通勤占5.65%,休闲占4.67%。原始记录超过2.4752亿条。4690.0万并不是从2.4752亿里做完所有筛选后的官方剩余比例,因为混合类人数没有公布,一次信令记录和一次被归类的行程也不保证一一对应。能说的是:在已经归入明确目的的行程里,商务约占九成。
若把表4的次数摊到84天,商务平均每天约50.07万次,通勤约3.15万次,休闲约2.61万次。休闲集中在周末和假日,所以这个日均会把工作日拉低、把周末抬高。
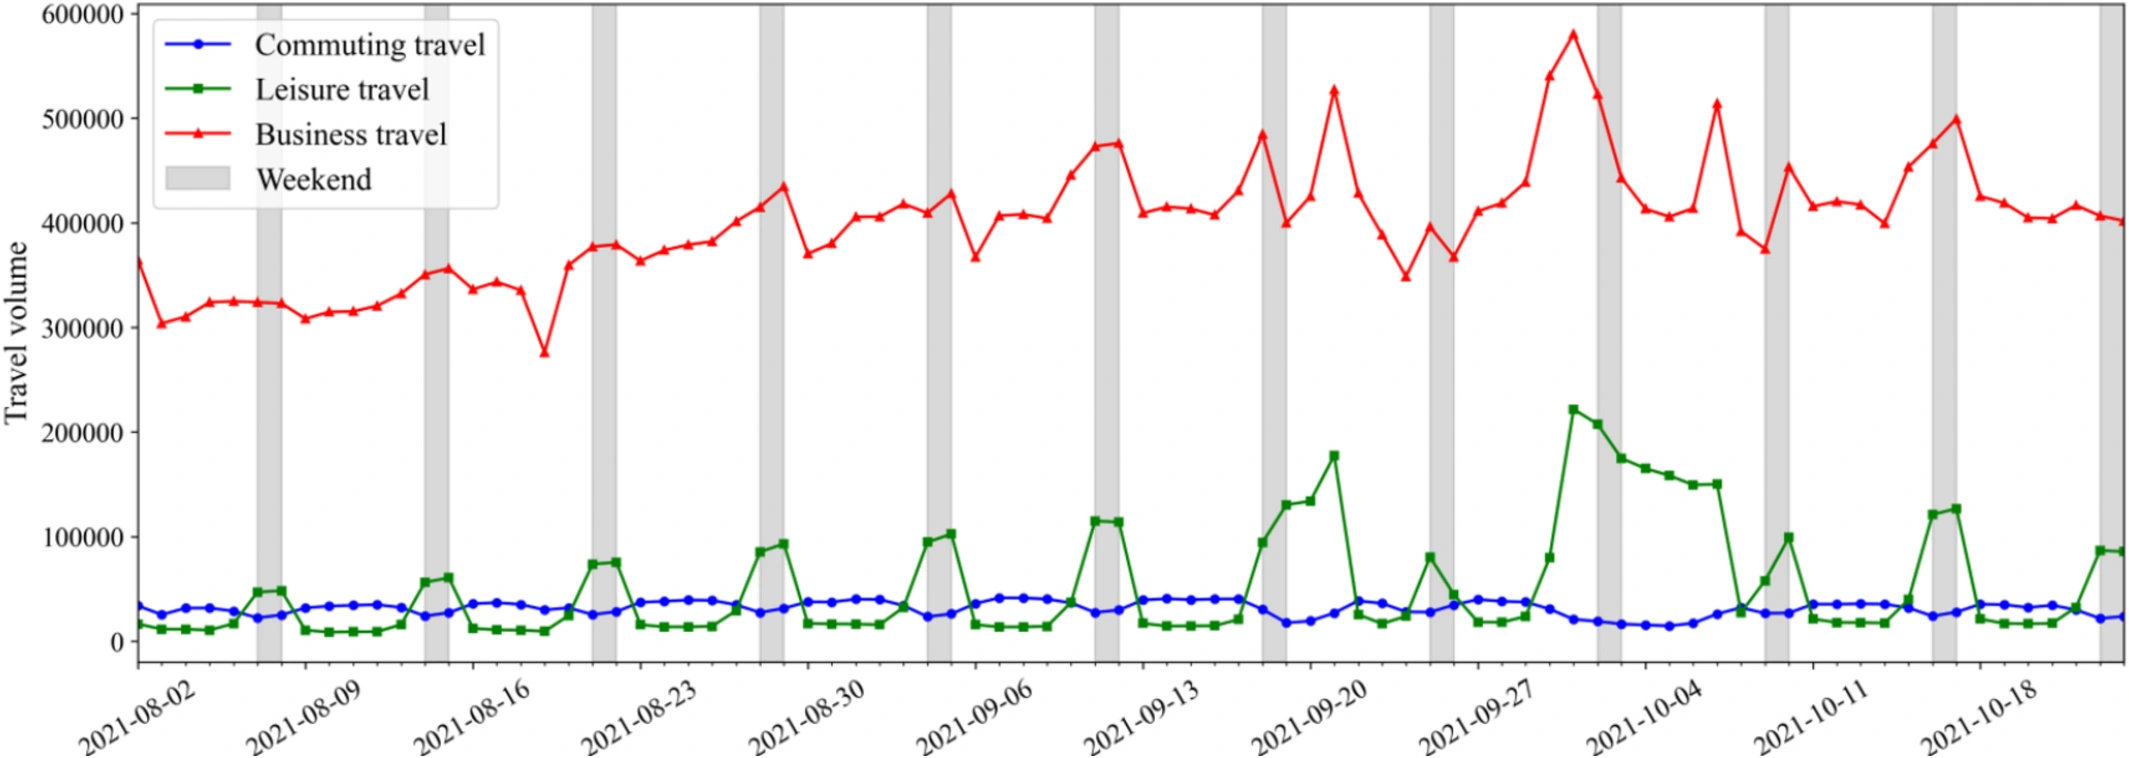
图 7|三类出行的距离和时长各自堆在哪里?
(a)横轴是距离,纵轴是概率密度。通勤主要堆在0至110公里,商务主要堆在0至50公里,休闲下降更慢,有相当一部分超过200公里。(b)横轴是时长。商务大部分短于60分钟,通勤和休闲的尾巴更长。三条曲线都是长尾,和市内出行的常见距离分布不同。来源:原论文 Fig. 7。
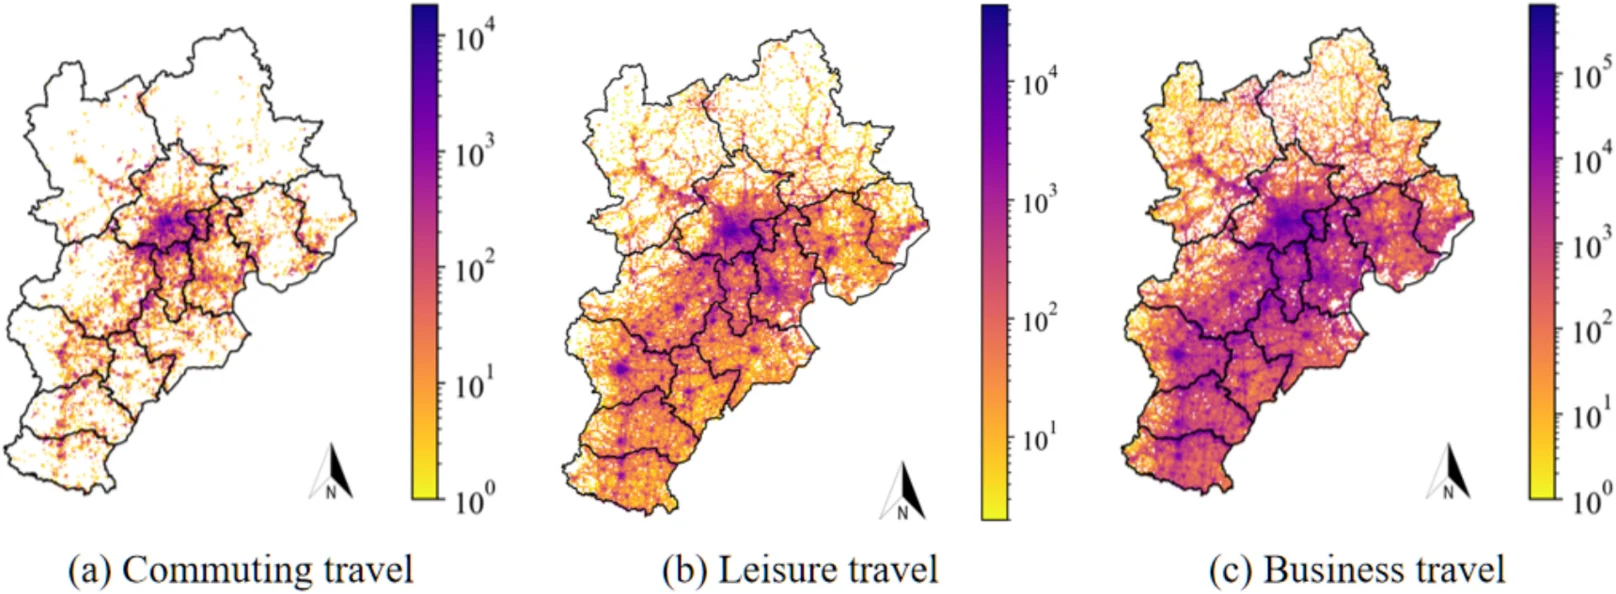
图 8|12周里,哪一类会在周末抬起来?
横轴是2021年8月2日至10月中下旬,灰色竖带是周末。蓝线通勤在工作日相对平稳,绿线休闲在周末上升,红线商务全程更高。正文没有逐日读数,某一天的尖峰不宜写成精确次数。来源:原论文 Fig. 8。
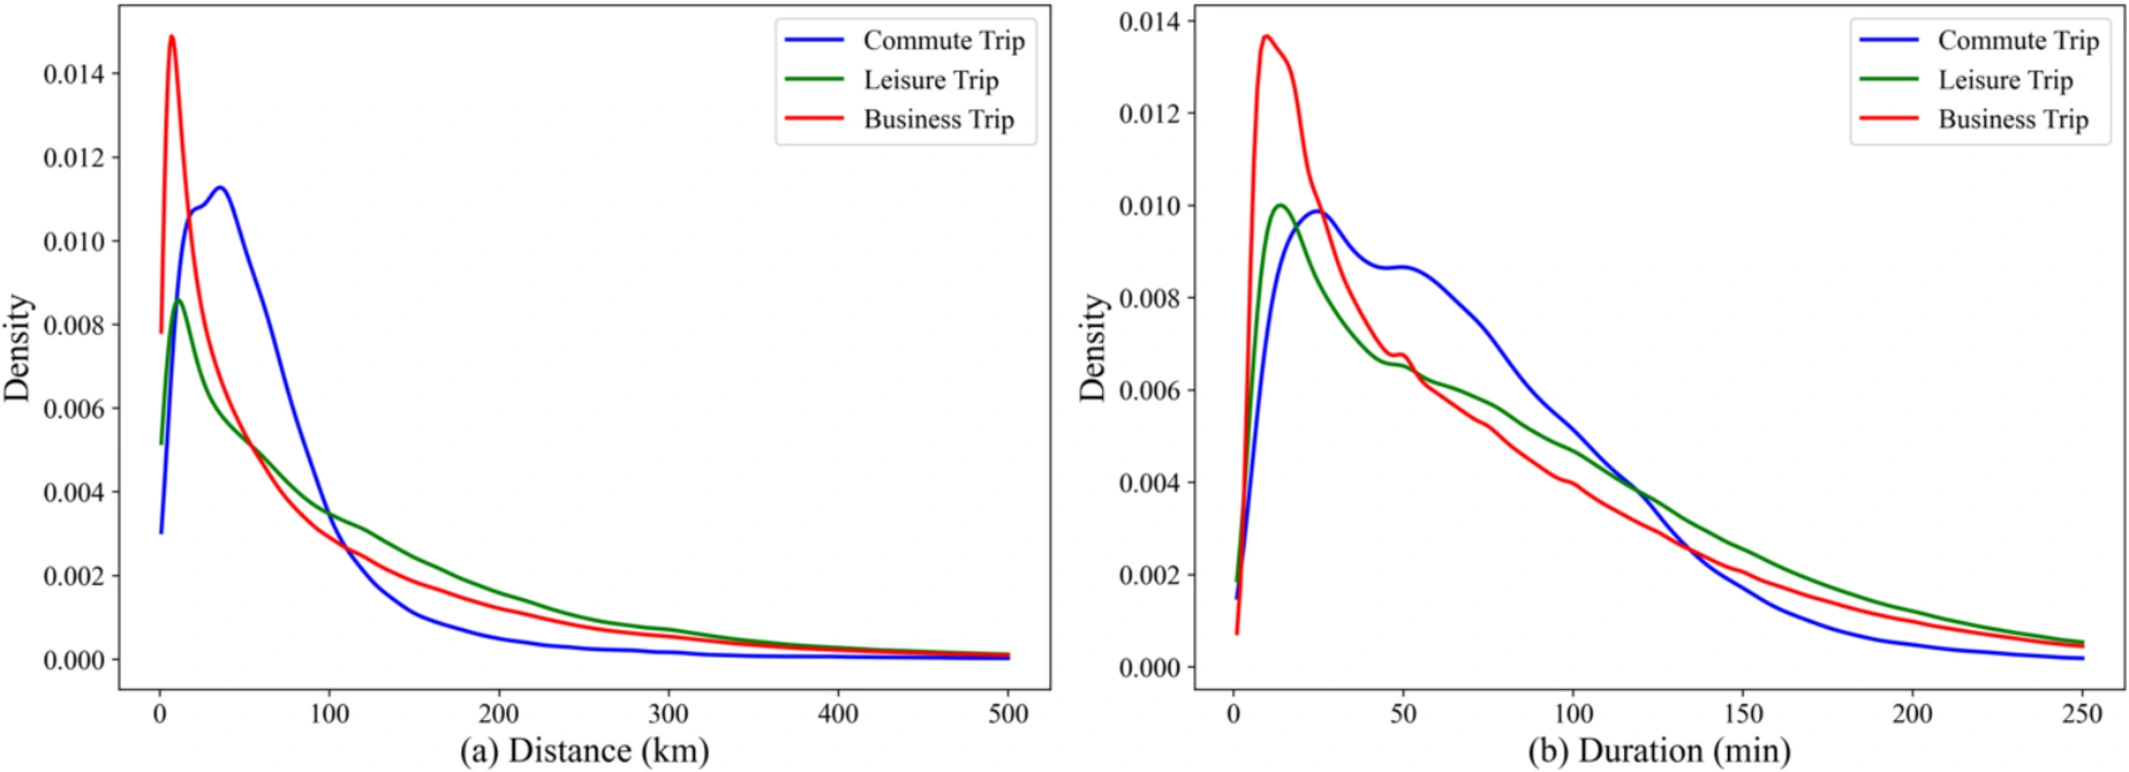
图 9|三类出行在城市群里落在哪些地方?
(a)通勤主要集中在北京附近。(b)休闲铺得更开。(c)商务在东部和南部连成片,西部和北部都较少。三张图各自有色标,颜色深浅不能跨图直接比大小。来源:原论文 Fig. 9。
人均次数最高的是通勤,其次商务,再次休闲。这和总次数的排序相反。原因就在规则:通勤要跨过27次,还要六成行程落在高峰,并有固定起讫。能留下的人少,但每个人的次数多。商务的入口宽得多,所以总次数大。
拟合的是对数出行量,而且土地利用变量彼此很像
GWNN把地理加权回归里的固定核,换成一个用距离学习权重的神经网络。对每个格子,网络看它到各个训练格子的距离,输出一组空间权重,再与建成环境变量逐项相乘。乘完的变量进入卷积层和全连接层,输出这个格子的预测对数出行量。选定的超参数是卷积输出32、批大小64、学习率0.02。评价用5折交叉验证的R²、均方根误差和平均绝对误差。R²的分母是观测对数出行量相对其均值的离差平方和。
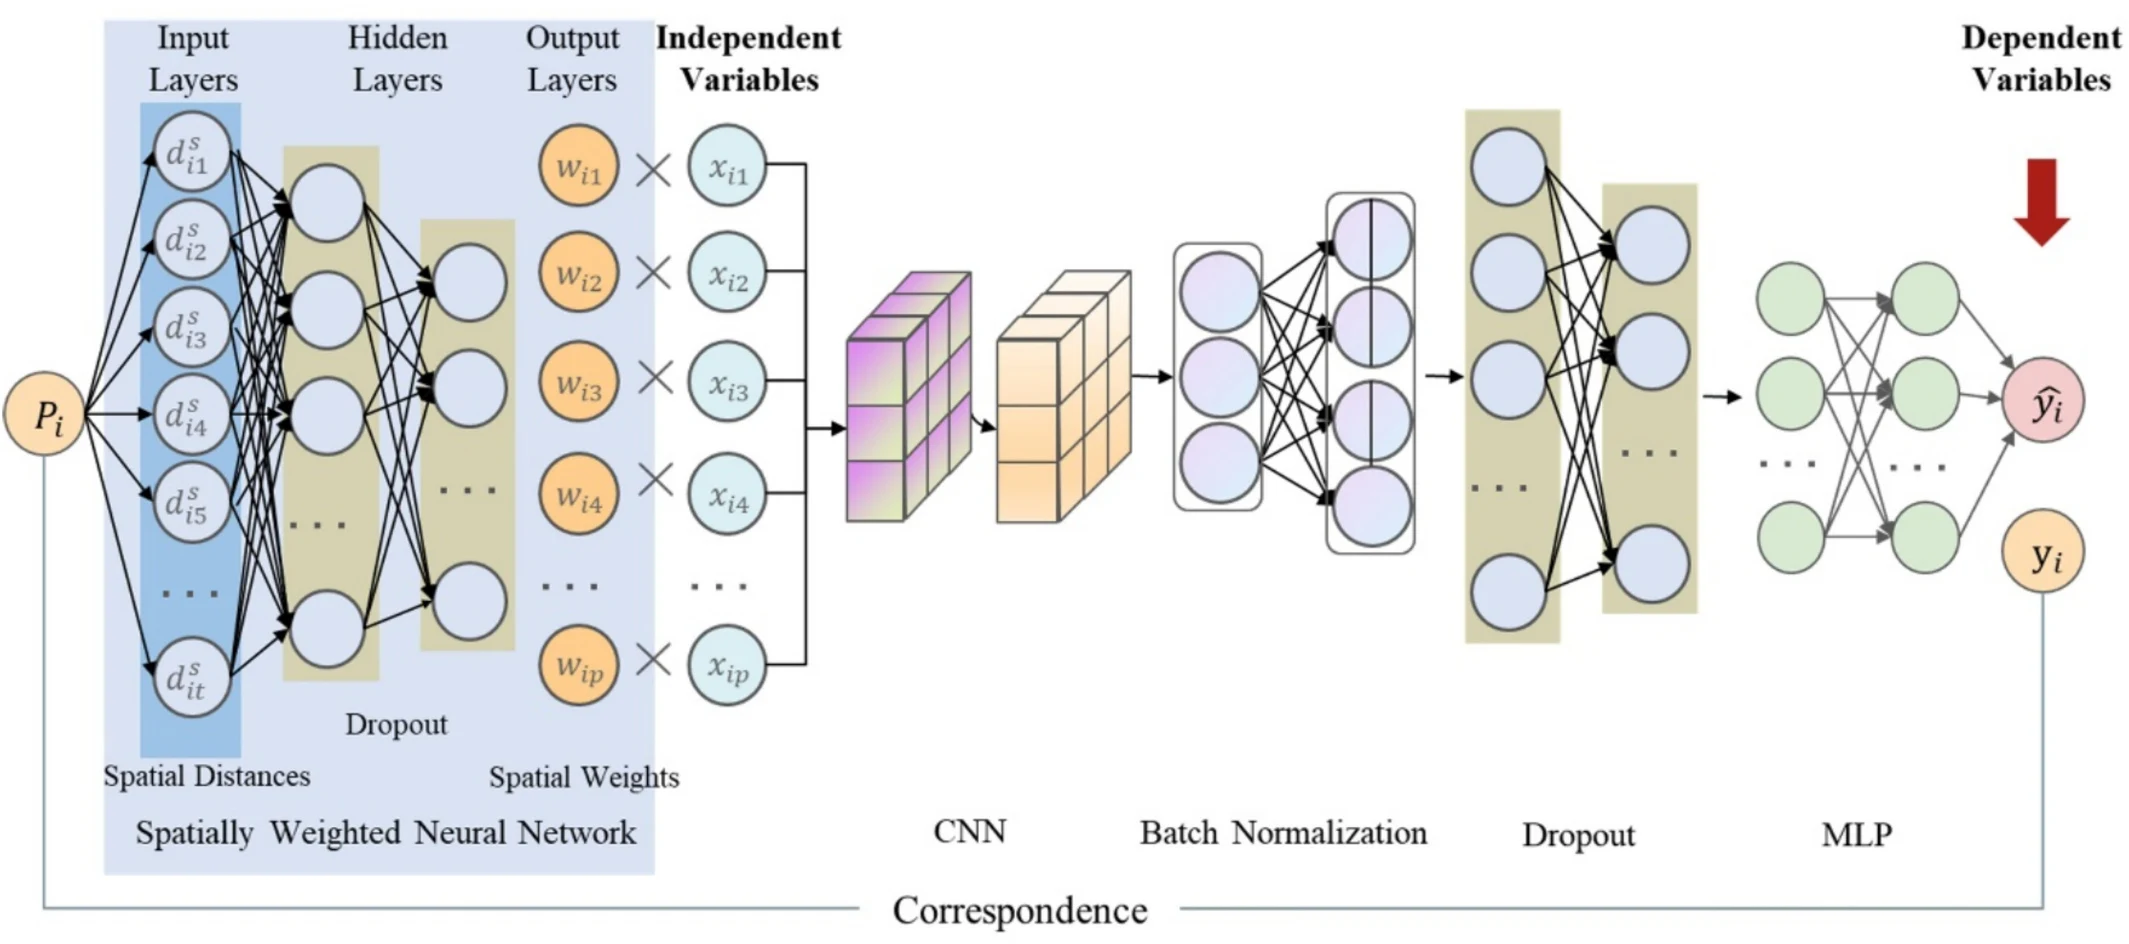
图 6|空间权重和非线性预测怎样接在一起?
左侧用格子之间的距离学习空间权重,中间与自变量相乘,再经过卷积、批标准化和随机丢弃,由全连接层给出预测值。右侧箭头指向的因变量是格子上的对数出行量。来源:原论文 Fig. 6。
正文写损失函数用的是二元交叉熵。二元交叉熵通常配0到1之间的分类概率,而这里的预测目标是连续的对数出行量。论文没有说明这个对数怎样进入该损失。表5的R²和误差仍然可以比较,因为它们直接拿预测值和观测对数出行量计算。
| 数据 | 最优模型 R² | 次优 GW-RF 的 R² | 相对提高 | GWNN的RMSE | GWNN的MAE |
|---|---|---|---|---|---|
| 通勤 | 0.576 | 0.555 | 3.8% | 1.244 | 1.058 |
| 休闲 | 0.595 | 0.579 | 2.8% | 1.322 | 1.053 |
| 商务 | 0.580 | 0.563 | 3.0% | 1.895 | 1.397 |
| 未分类全部数据 | 0.523 | 0.514 | 1.8% | 2.337 | 1.650 |
相对提高的分母是同一行GW-RF的R²。例如通勤是 (0.576 − 0.555) / 0.555。论文概括为比当时较优模型高2%至4%。这句覆盖前三行;未分类这一行是1.8%。未分类数据的R²比三个分类模型低9.2%、12.1%和9.8%,分母分别是0.576、0.595和0.580。这是四套样本上的拟合比较,不是同一批格子去掉标签后的对照实验。
同一张表里,普通最小二乘的通勤R²只有0.352,RMSE 1.598,MAE 1.649。按正文给出的定义,均方根误差不应低于平均绝对误差。这一格印出来的MAE更高,其余方法的通勤、休闲、商务和未分类各行都是RMSE不低于MAE。RMSE为1.244表示对数出行量上的误差,不是1.244次出行。
空间模型(地理加权回归、地理加权随机森林)和非线性模型(随机森林、XGBoost)都高于全局线性回归。GWNN在每一行都是R²最高、误差最低。这支持“空间不均匀加上非线性”比一条全局直线更贴合这批格子。它不证明建成环境导致了出行,也不证明这一种网络结构是唯一合适的结构。
合计份额和单项名次,讲的不是同一件事
SHAP把模型输出的变化分给各个输入。这里的输出是预测的对数出行量。一个正的SHAP,表示该变量把预测对数从基准往上推;它不是多出来的出行次数,也不是因果效应。图10至图12的蜂群图里,红点是该变量取值高,蓝点是取值低。右侧环形图的图例在三张图里一致:黄是社会经济,紫是交通,红是土地利用,青是距离。环上的百分比是一类变量的合计份额。
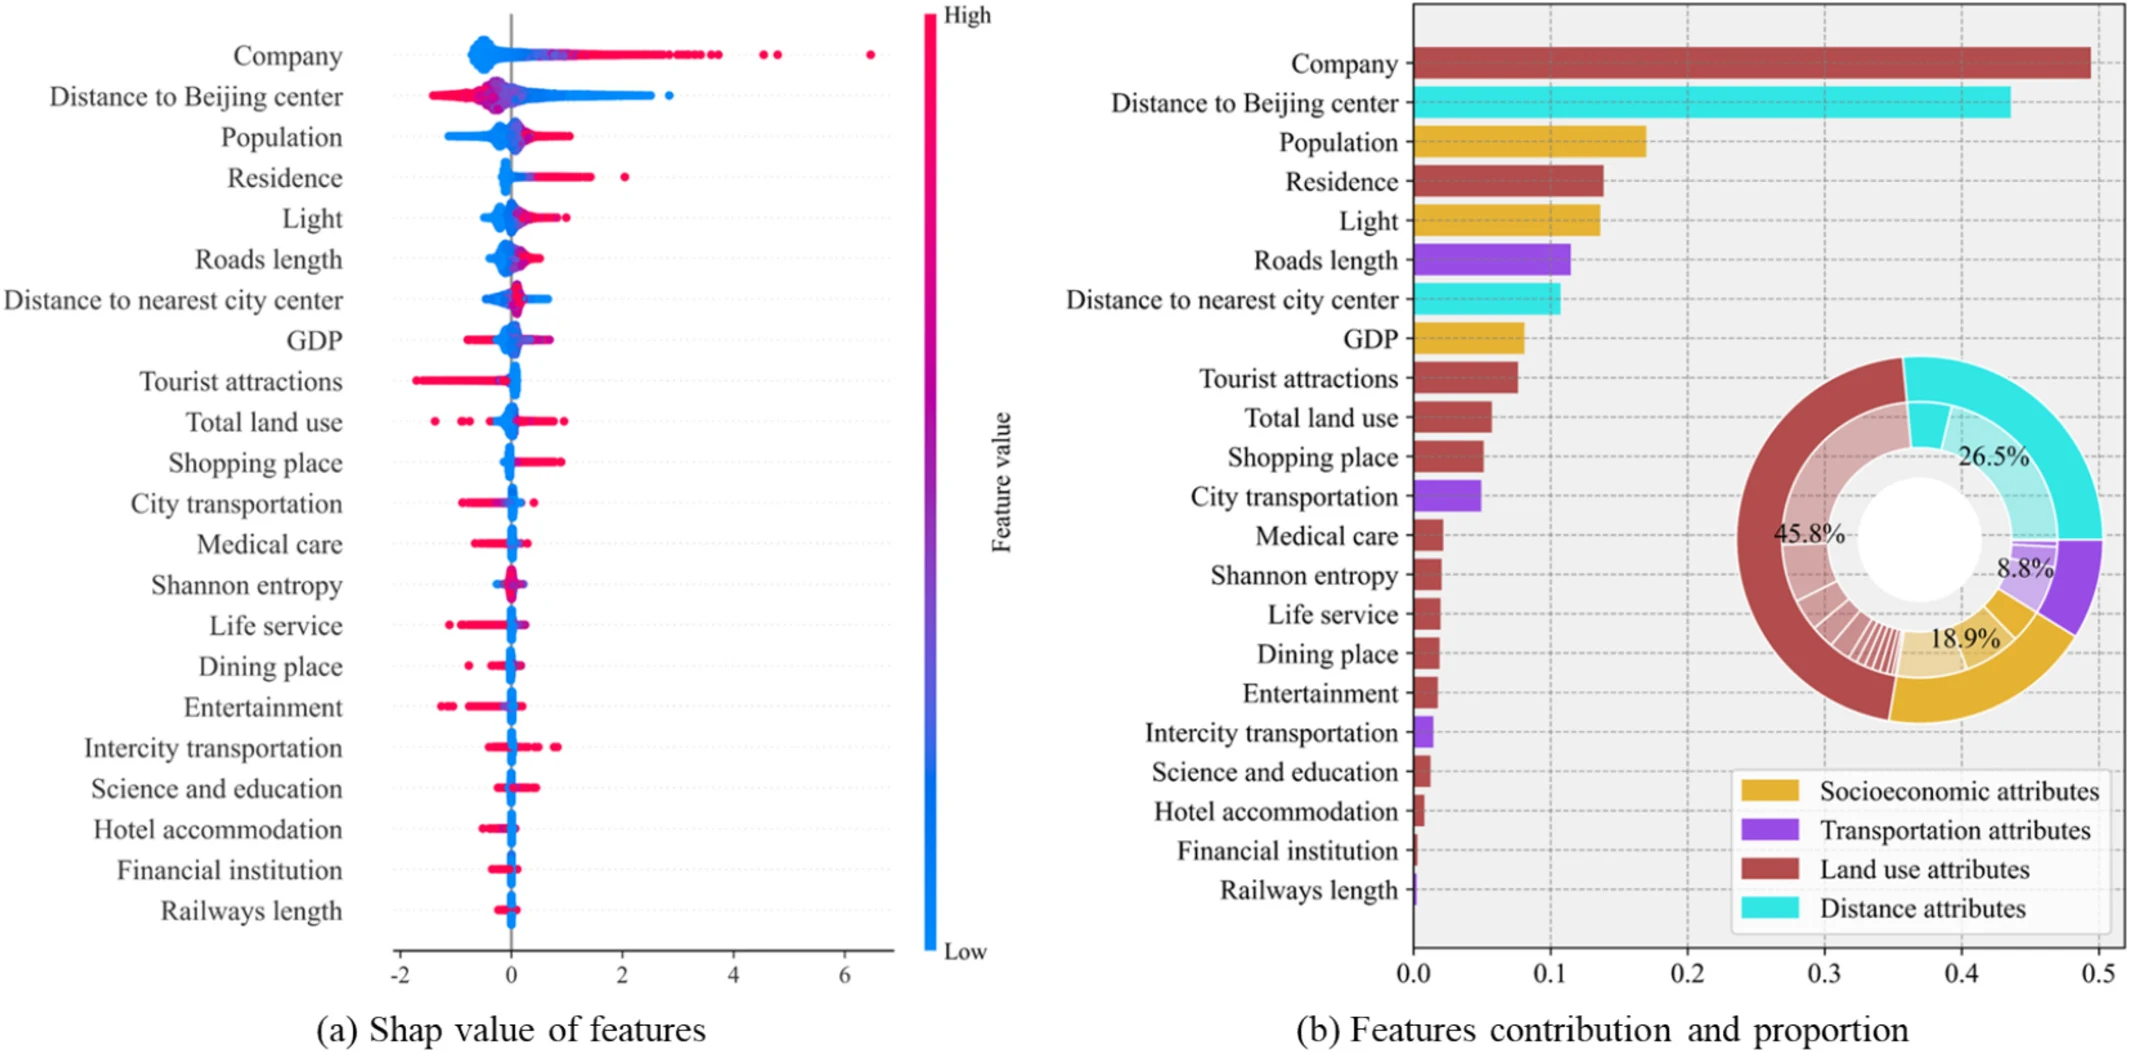
图 10|通勤模型里,哪些变量把预测对数推得最远?
(a)条形顺序的前五位是公司、到北京中心的距离、人口、居住和夜光。到北京距离取值低的点伸向正的SHAP,取值高的点靠近零或为负。公司、人口、居住和夜光取值高时偏向正的SHAP;景点取值高时偏向负的SHAP。(b)公司的条最长,其次是到北京的距离。环形图合计为土地利用45.8%、距离26.5%、社会经济18.9%、交通8.8%。来源:原论文 Fig. 10。
摘要写距离、交通和社会经济的平均贡献大于土地利用。通勤这张环形图量的是合计:土地利用45.8%是最大的一块,交通8.8%是最小的一块。土地利用变量在表1里有13个,距离变量只有2个。论文没有给出“平均贡献”的计算公式,所以合计百分比不能直接改写成摘要那句平均。正文另外写,居住兴趣点的SHAP从通勤的0.13、第7位,降到休闲的0.03、第15位。通勤条形图上,居住排在公司、到北京距离和人口之后,视觉上更靠前。0.13和0.03是正文给出的数,名次没有另附排序表。
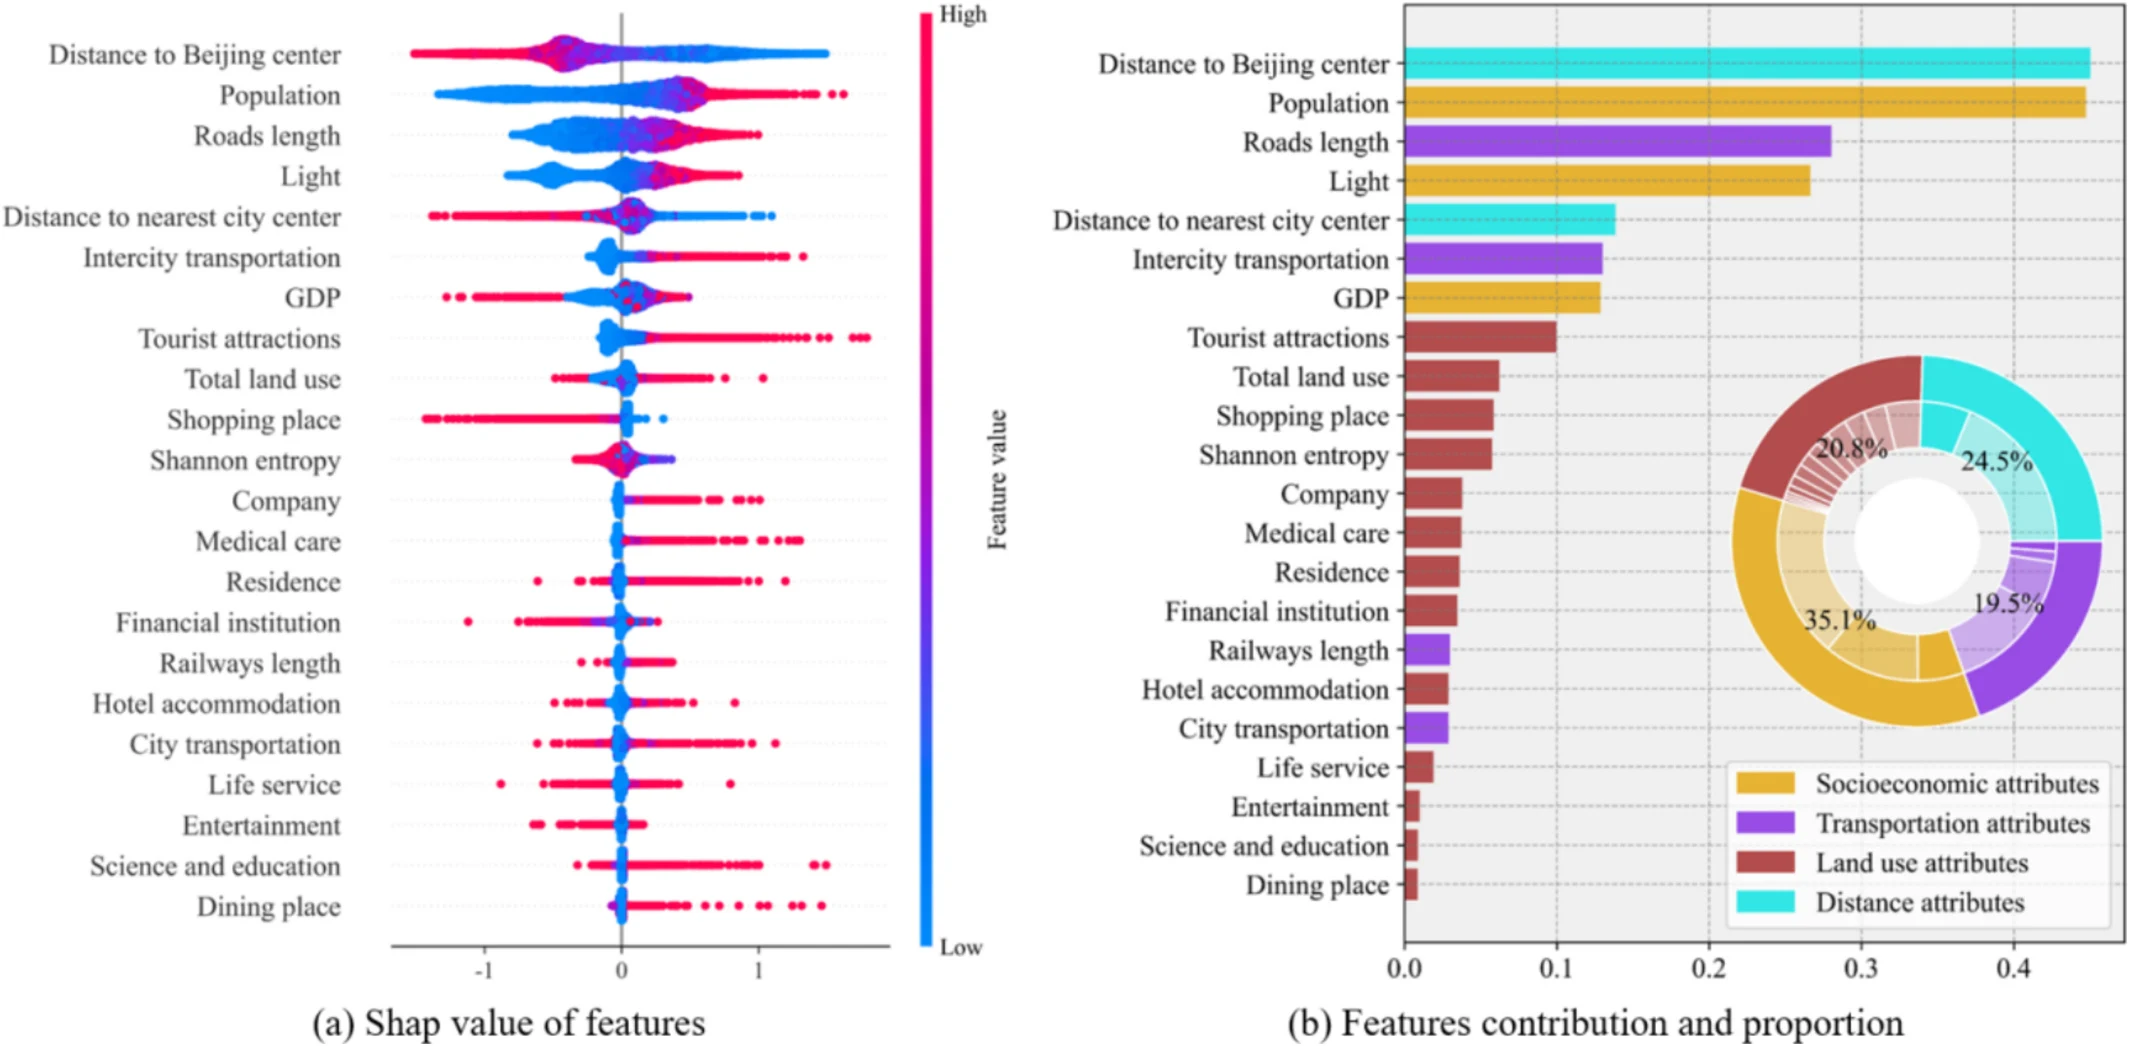
图 11|休闲模型的前几名为什么换成距离、人口和道路?
(a、b)单项前五是到北京中心的距离、人口、道路长度、夜光、到最近市中心的距离。城际交通设施和GDP大约排在其后,公司类兴趣点更靠后。景点的条形高于多数其他兴趣点。环形图合计为社会经济35.1%、距离24.5%、土地利用20.8%、交通19.5%。来源:原论文 Fig. 11。
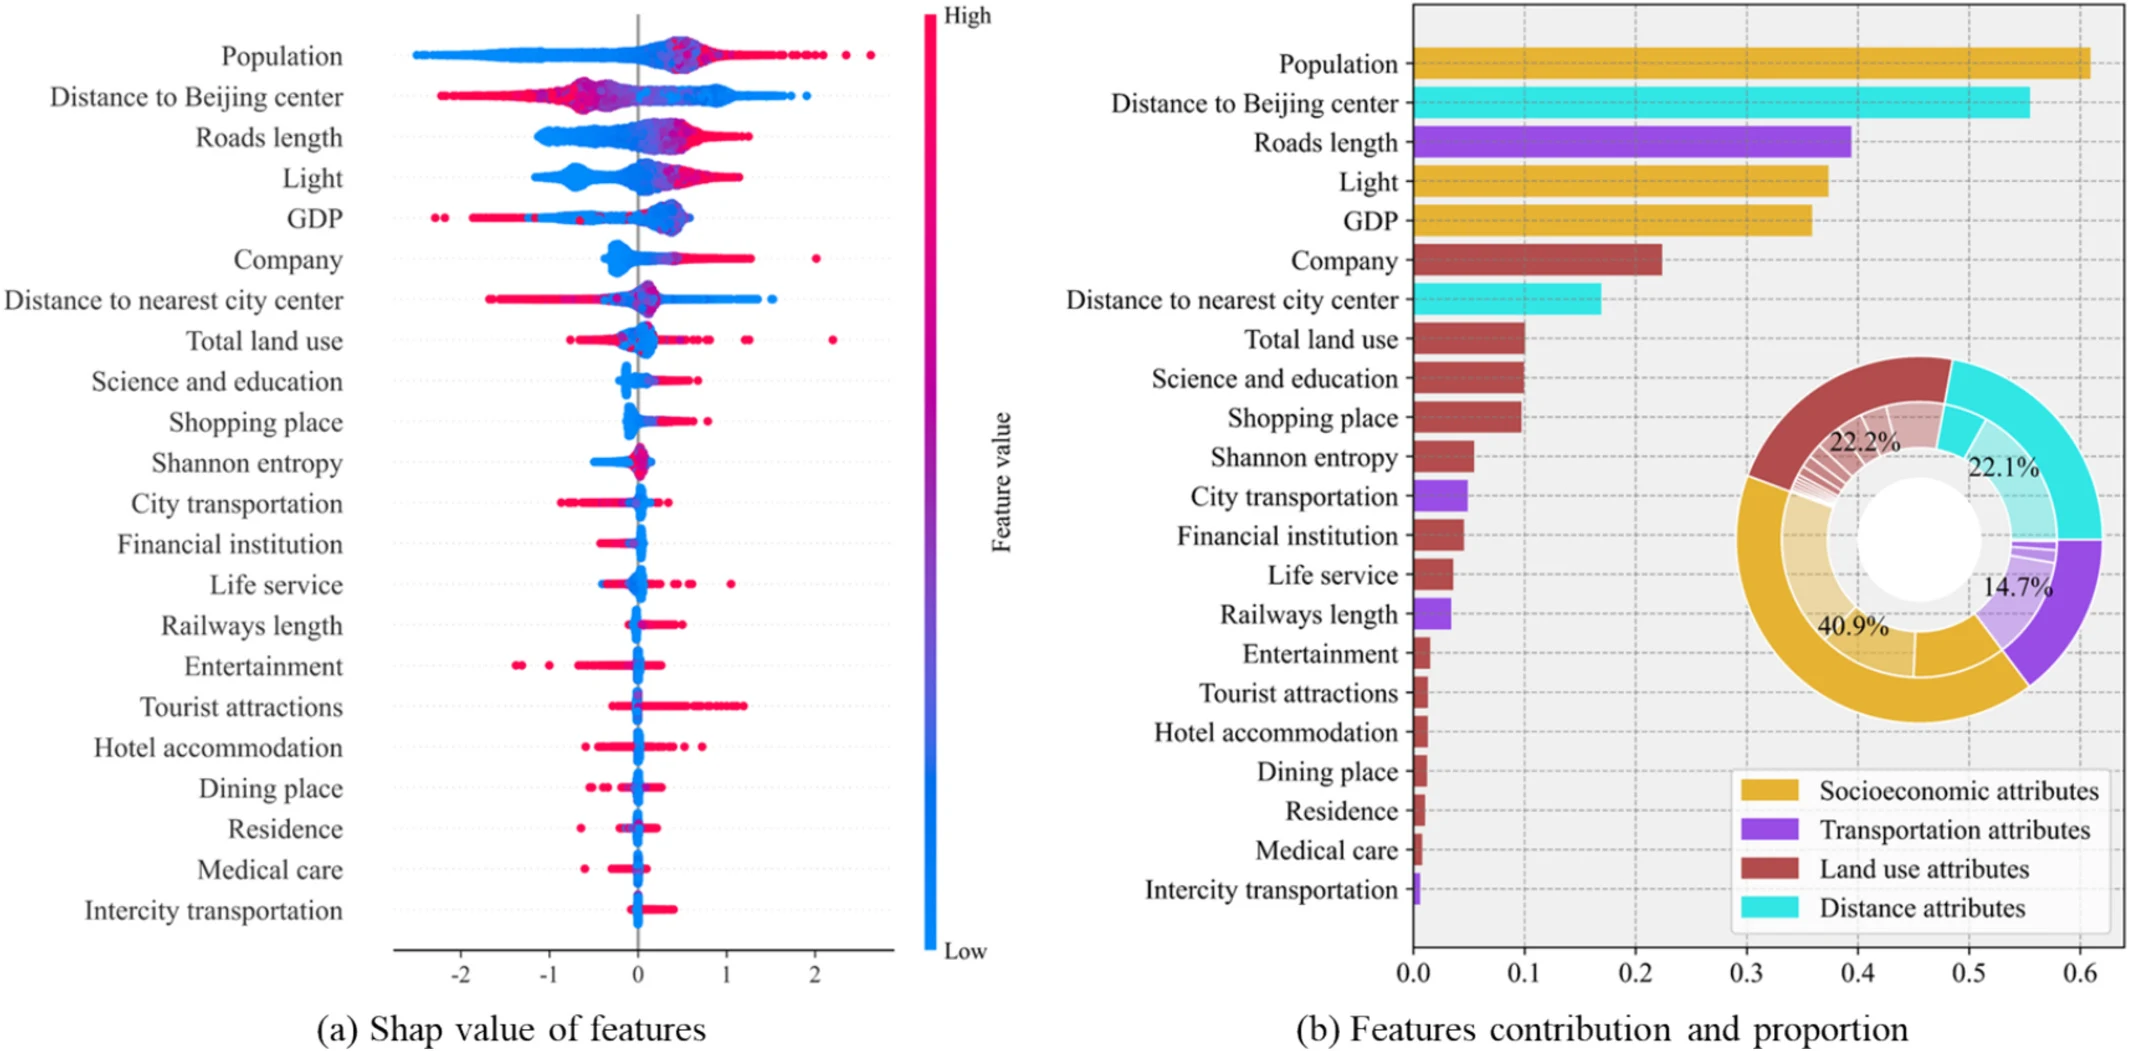
图 12|商务模型为什么更靠人口、夜光和GDP?
(a、b)前五是人口、到北京中心的距离、道路长度、夜光、GDP。公司排在GDP之后,科教和土地利用总量高于大多数单个兴趣点,居住和城际交通设施靠近底部。环形图合计为社会经济40.9%、土地利用22.2%、距离22.1%、交通14.7%。来源:原论文 Fig. 12。
三张环形图加起来都接近100%。商务的社会经济合计40.9%,和“经济因素更突出”同向。GDP是第5,不是第1;排在它前面的还有人口和夜光。交通设施在休闲里的名次高于它在通勤和商务里的名次,但休闲环形图里交通合计仍是19.5%,略低于土地利用的20.8%。
距离曲线的形状,三类并不相同
依赖图的横轴是变量取值,纵轴仍是SHAP。读的时候要连着表1的均值:门槛落在均值附近,和门槛远在均值之外,规划含义不同。
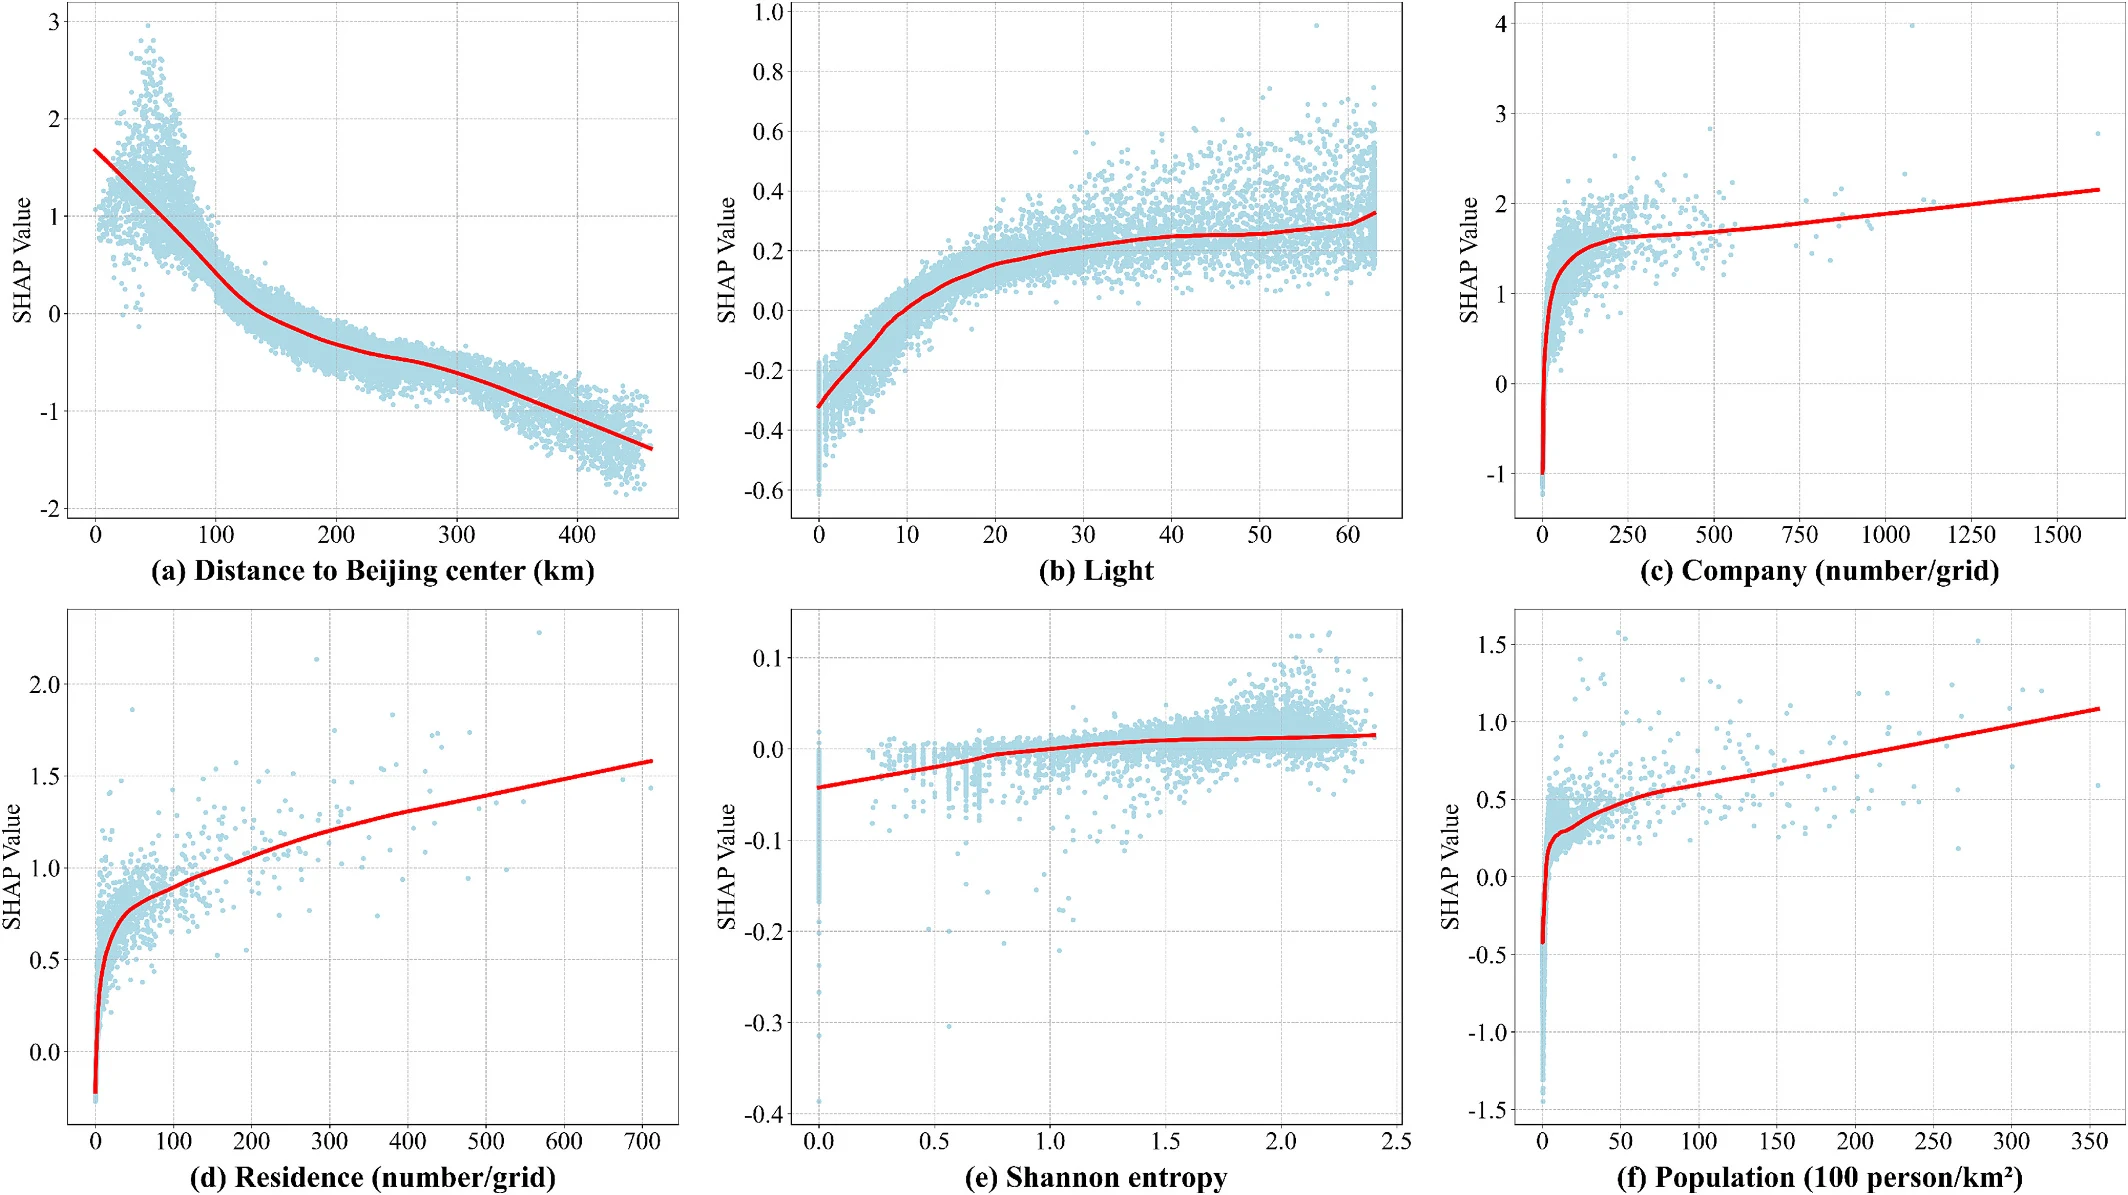
图 13|通勤的距离效应从哪里开始为负,其他变量在哪里变缓?
(a)到北京中心的距离:0至120公里内SHAP快速下降,120公里后为负,280公里后抑制更强。纵轴大约从−2到3。(b)夜光在约10处由负转正,40附近趋于平缓。(c)公司兴趣点在大约15个以前贡献很小,之后很快变强。(d)居住兴趣点在0至50个上升较快,100个以后增幅变小。(e)香农熵的正向效应在约0.8附近到顶,1.6以后缓降;纵轴大约只在−0.4到0.1。(f)人口横轴单位是每平方公里百人。正文写SHAP从每平方公里500人开始为正,约5000人后趋于平稳,对应横轴上的5和50。来源:原论文 Fig. 13。
表1的对照是:到北京距离均值196.808公里,已经高于120公里;夜光均值16.153,位于转正之后、40这个平台之前;公司均值17.987个,刚过约15个的拐点;居住均值5.372个,还在0至50的陡段;香农熵均值1.340,位于0.8的峰值和1.6的缓降之间;人口均值4.936个百人,即每平方公里493.6人,紧挨着正文所说的500人。
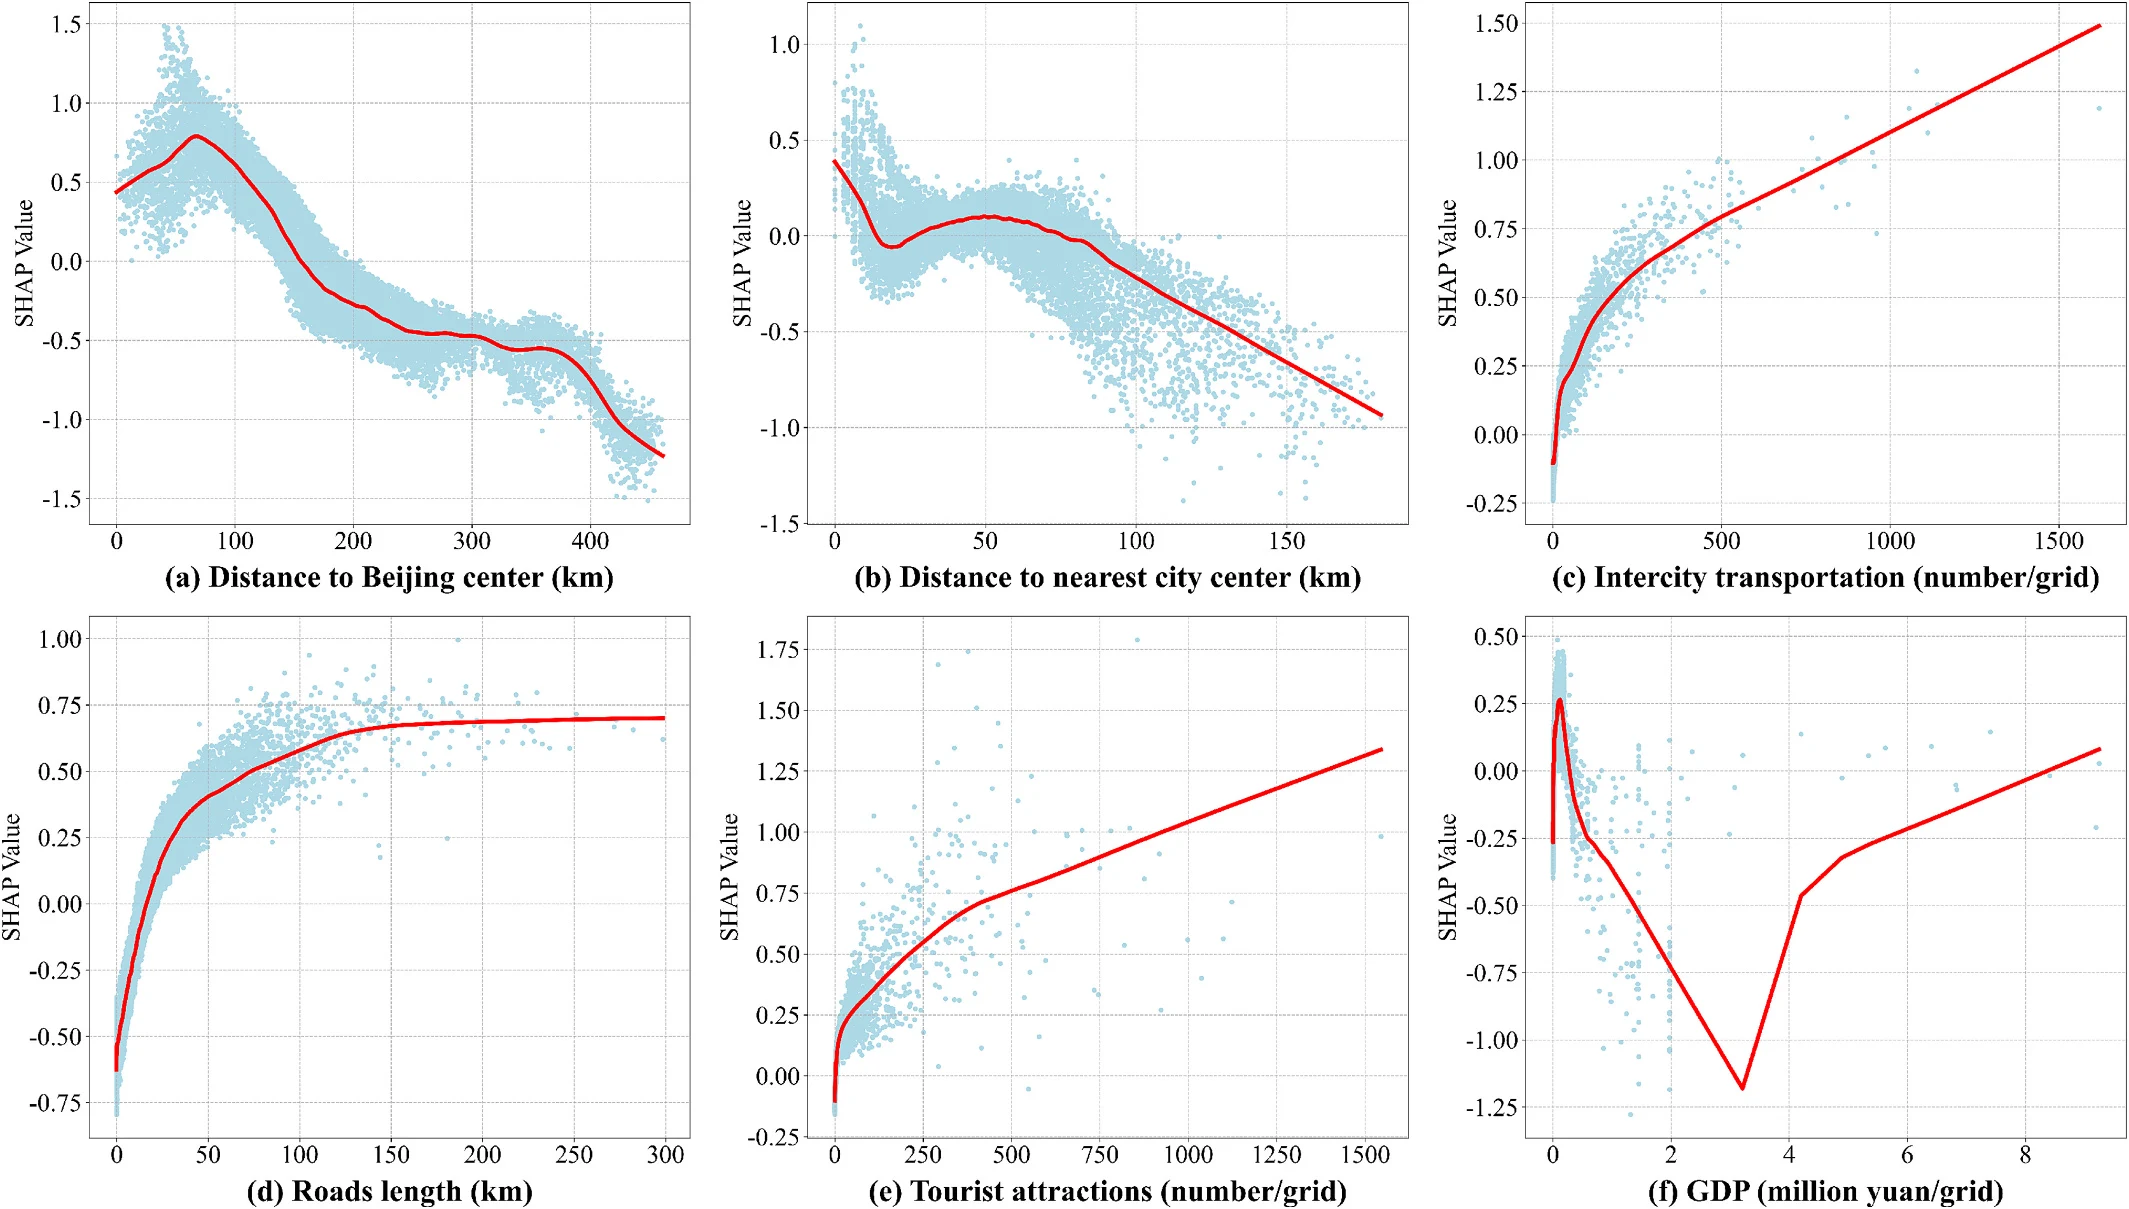
图 14|休闲为什么不是离北京越近越高?
(a)到北京的距离在0至160公里为正,约75公里最高,160公里后为负,330公里后抑制更强。(b)到最近市中心的距离:10公里内急剧下降,10至20公里维持抑制,20公里后上升,80公里后再次衰减。(c)城际交通设施数量与SHAP同向增加。(d)格内道路长度在约20公里以前减轻抑制,其后转为促进,150公里附近到达平台。(e)景点数量与SHAP同向增加。(f)GDP单位是每格百万元:0至0.2促进,中间水平抑制,超过8又促进。来源:原论文 Fig. 14。
格网GDP均值是484.3万元,也就是4.843个百万,落在正文所说的中间抑制区间里。道路长度均值21.757公里,接近休闲曲线由抑制转为促进的大约20公里。到北京距离的均值196.808公里,已经超过休闲的160公里正向终点。
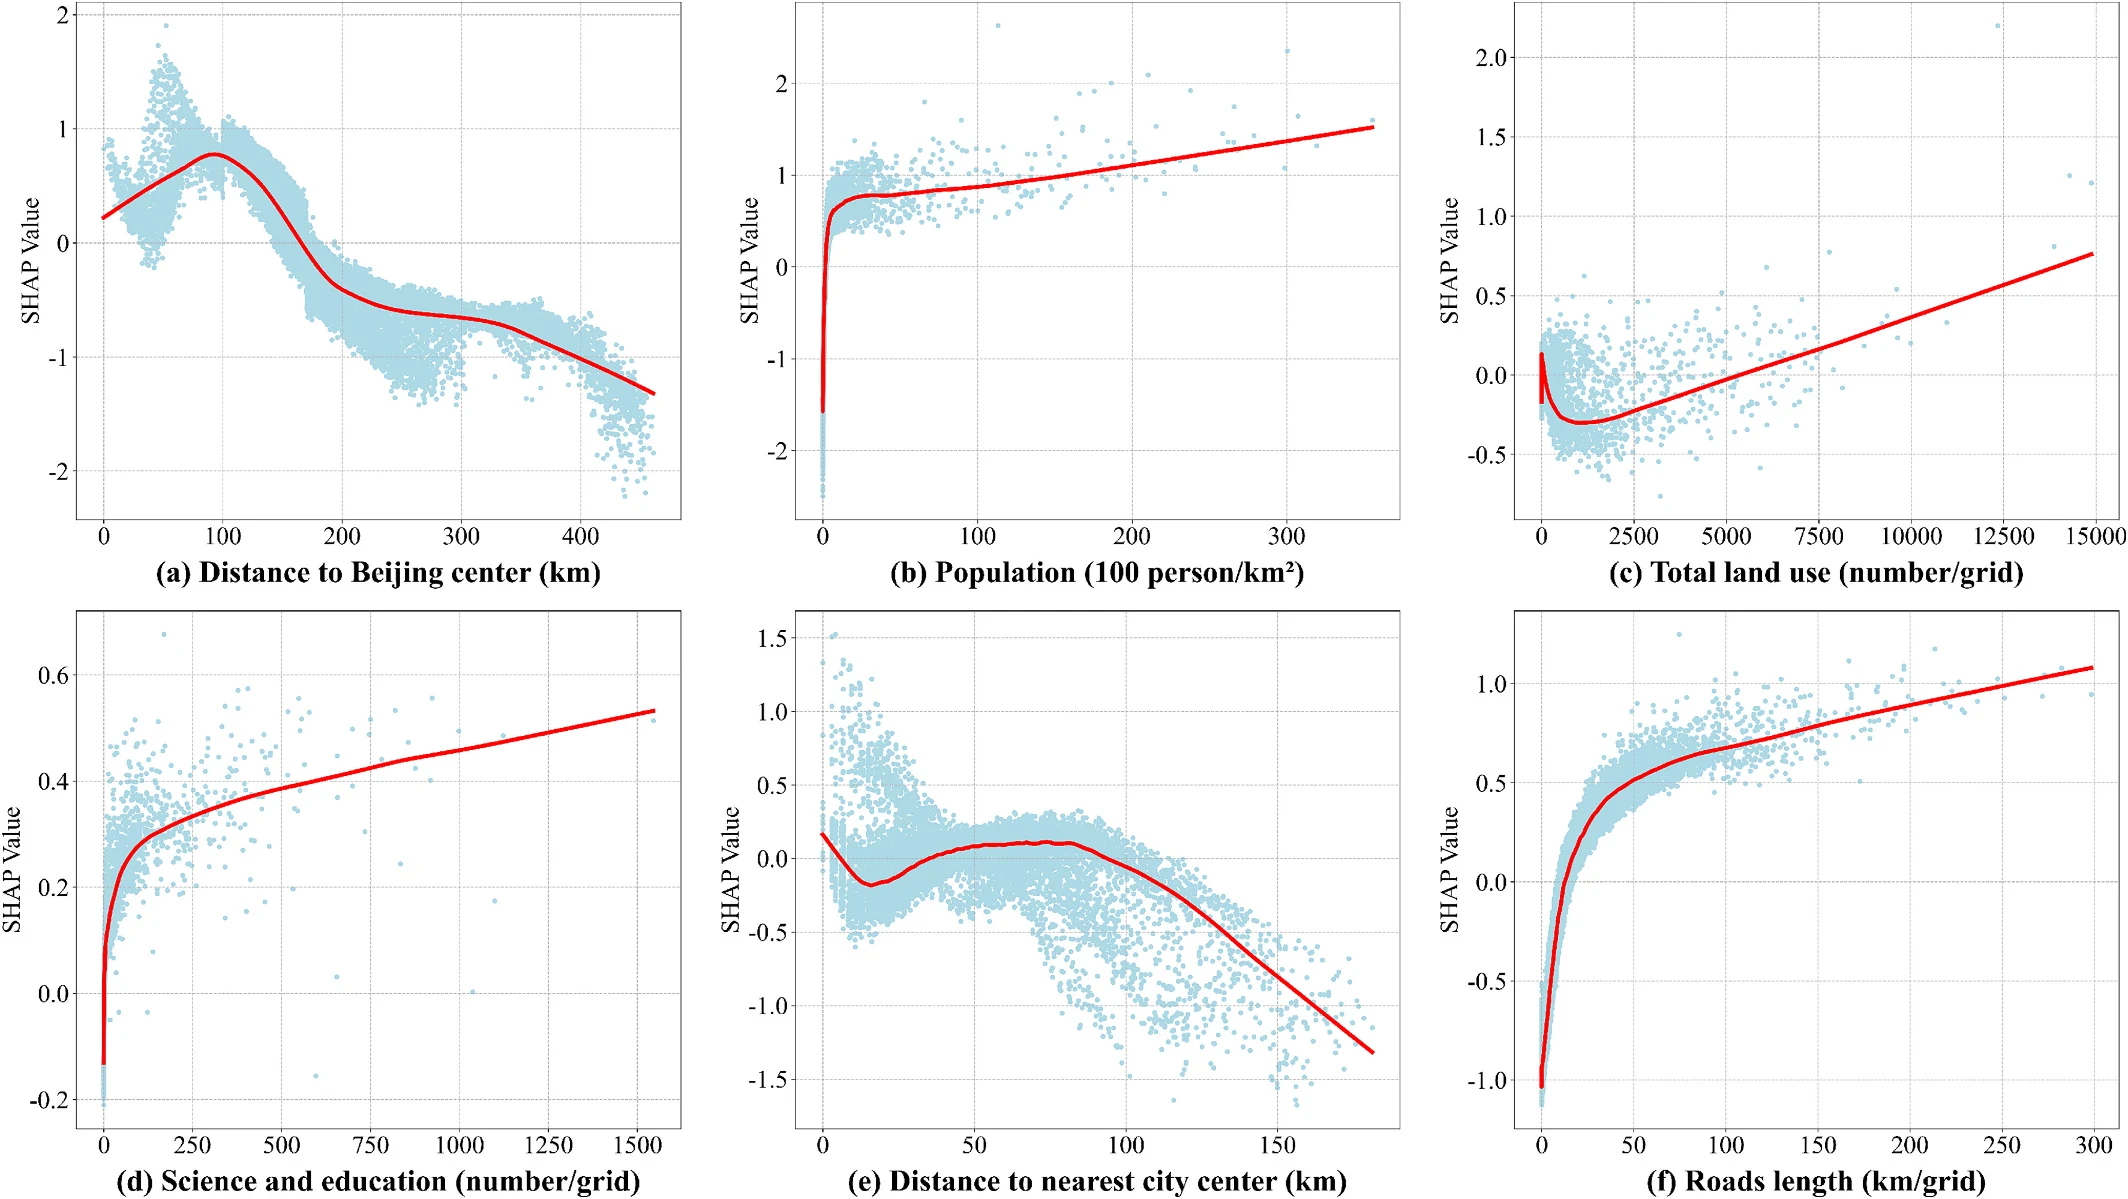
图 15|商务的正向距离能延伸到多远,土地利用要多密才转向?
(a)到北京的距离在0至175公里为正,约95公里最高,300公里后明显下降。(b)人口横轴仍是每平方公里百人。正文写SHAP在每平方公里1000人以前陡升,1000至5000人之间较稳,更高密度再次促进。(c)兴趣点总量低于5000个时为负,高于7500个时为正。(d)科教兴趣点大约超过50个以后促进更明显。(e)到最近市中心的距离呈倒U形,正文给出的转折约在37公里和125公里。(f)道路长度先陡后缓,正文只说存在饱和,没有在结果节写出饱和公里数。来源:原论文 Fig. 15。
兴趣点总量的均值只有176.278个,标准差661.751。(5000 − 176.278) / 661.751 = 7.29,5000个大约在均值以上7.3个标准差;(7500 − 176.278) / 661.751 = 11.1。多数格子到不了这条U形曲线的转向处。科教兴趣点均值10.603个,50个高于均值,但没有远到同样的程度。到最近市中心的均值是53.076公里,落在正文给出的37公里和125公里之间。
讨论部分把商务出行175公里内仍为正的范围,称为北京产业圈,并引用2022年的北京市发展改革委文件。同一节写道路长度在每格50公里时对商务的促进作用尤其明显;这个50公里出现在政策讨论,不在图15的结果叙述里。休闲政策写郊区出行主要在距市中心30至80公里,对应的是图14(b)后半段上升、80公里后衰减这一读法。通勤政策写平均城际通勤超过70分钟,表4的72.467分钟与之相符,并建议控制通州、亦庄、丰台的公司扩张、鼓励公司落在距北京中心120公里以内,以及把土地利用混合度提高到1.5以上。讨论没有给出这三个区的出行次数。混合度1.5和图13(e)也不在同一侧:依赖图写峰值约在0.8,1.6以后缓降,而且这张图的SHAP纵轴远窄于距离图。
附录里的系数地图,不能当成最终效应
附录用训练过程中的空间权重系数画了三组地图。论文写明,这些系数后面还要经过非线性网络,不能直接当作最终结果,只用来说明模型能够画出空间差异。
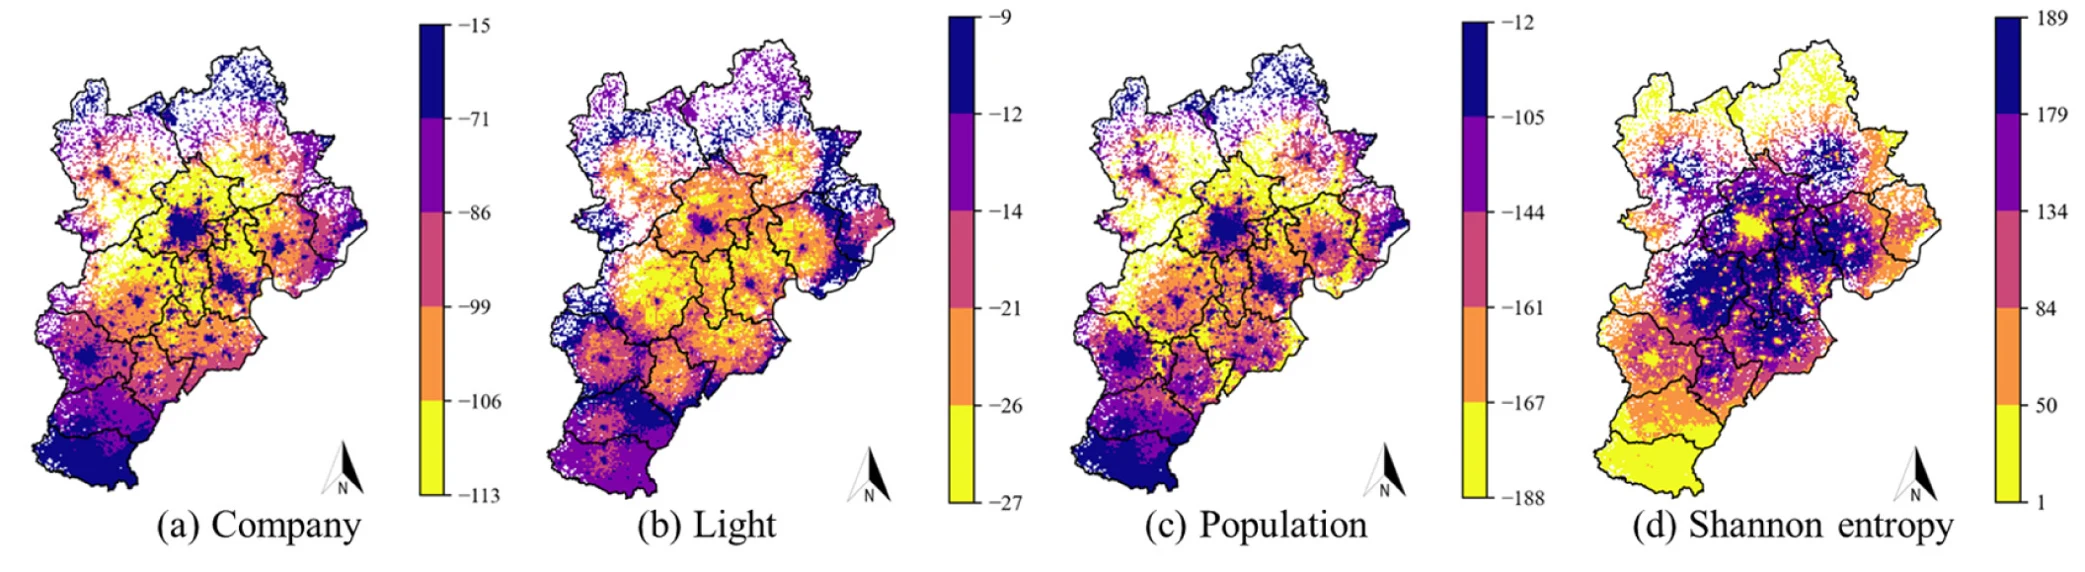
图 16|通勤模型的空间系数在地图上是否均匀?
(a)公司,(b)夜光,(c)人口,(d)香农熵。四张色标的数值范围不同,有的以负值为主,香农熵的色标则为正。颜色不能在面板之间比大小。来源:原论文 Fig. A1。
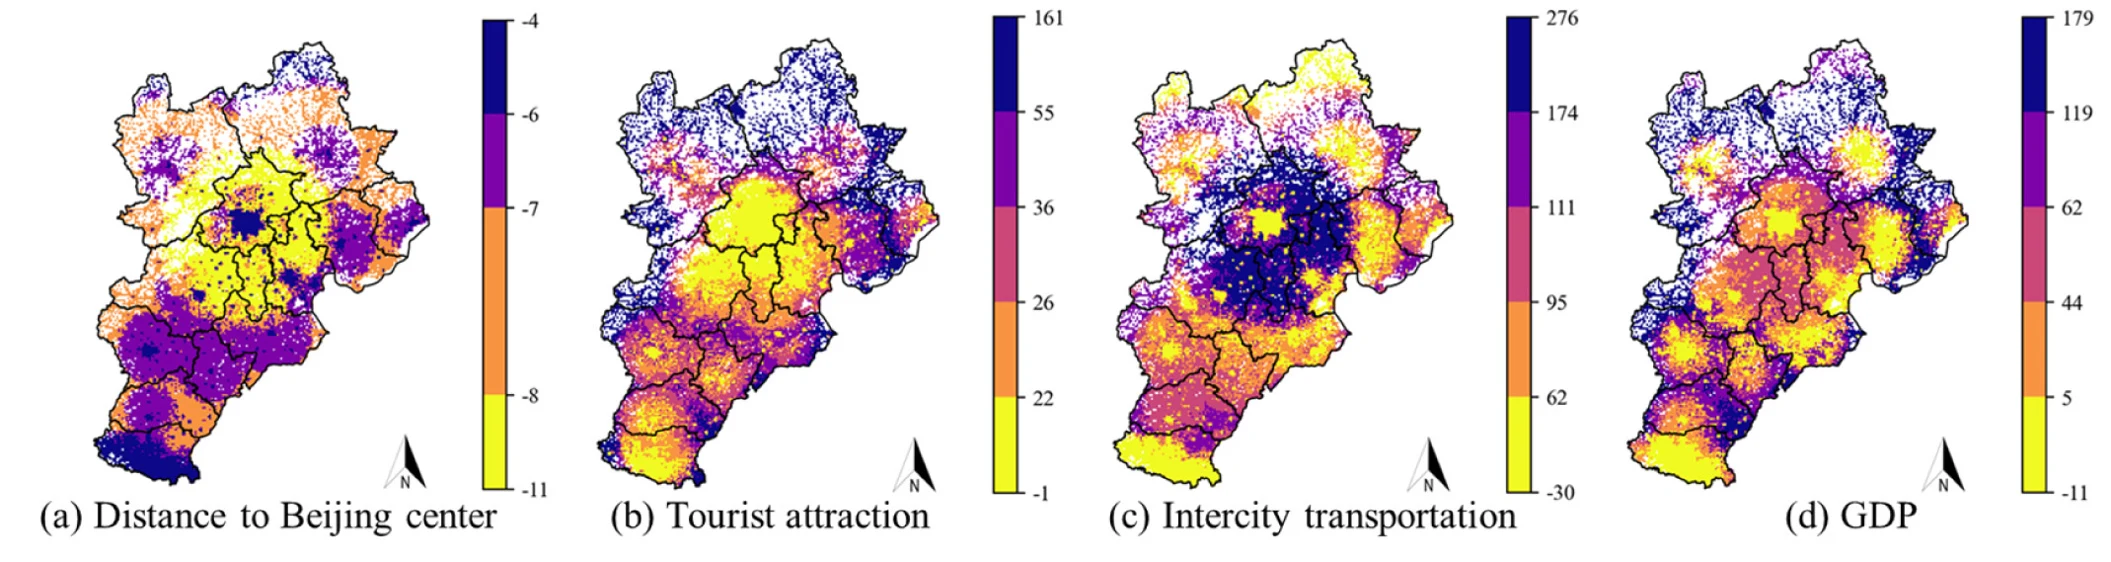
图 17|休闲模型挑出的四个变量,系数是否成片?
(a)到北京中心的距离,(b)景点,(c)城际交通设施,(d)GDP。北京附近与外围的颜色不同,各面板色标也不相同。来源:原论文 Fig. A2。
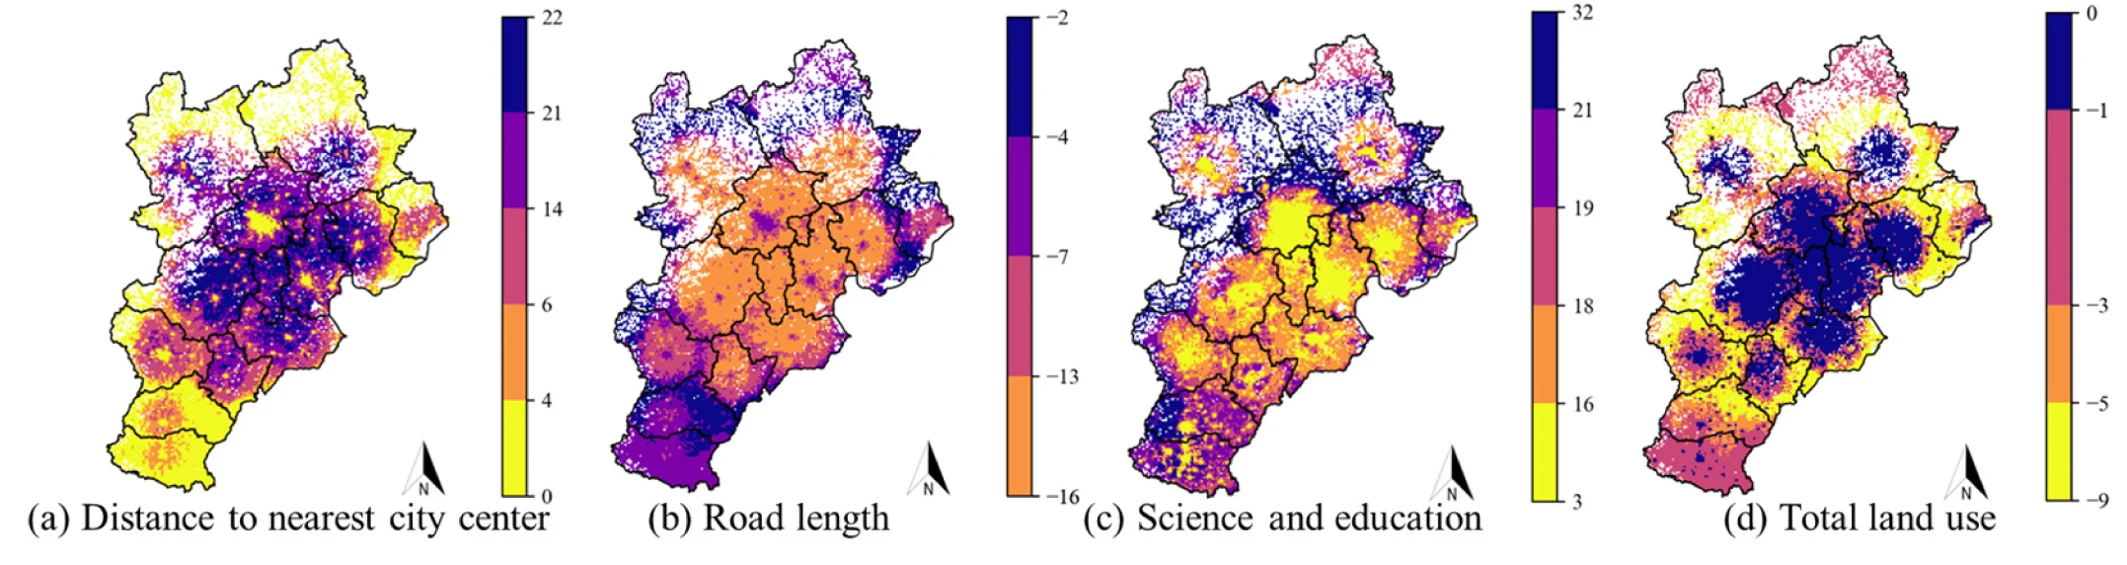
图 18|商务模型的空间系数集中在核心还是外围?
(a)到最近市中心的距离,(b)道路长度,(c)科教,(d)土地利用总量。城市核心附近与边缘的颜色成片变化,同样不能把色标读成SHAP。来源:原论文 Fig. A3。
这些公里数可以用到哪一步
模型比较说明,分目的之后的对数出行量更容易被这套变量拟合。它留下的边界也很具体。
标签来自规则,不是出行者自报。69.3%和0.512衡量的是同一个人两段时间的标签是否一致。国庆和中秋被整段计入休闲时段,会把假期出行推进休闲。商务能从三个时段分支进入,通勤必须同时满足高峰、27次和固定起讫,所以两类的规模差异里有规则宽严的成分。
SHAP和依赖图解释的是已经训练好的预测。到北京的距离、人口和兴趣点在空间上连在一起,购物和生活服务的方差膨胀因子已经到93至153,土地利用总量到1381.802。高度相关的变量会互相分走功劳。兴趣点总量要到5000至7500个才在商务依赖图上转向,而格子均值只有176.278个,这条曲线描述的是尾部。
3公里格会带来可更改面元问题:换一个格子大小,门槛的公里数可能移动。房价和出行者个人属性没有进入变量。数据不能公开。结论第(3)点把到北京的距离写成超过120、160和约175公里之后仍为正;摘要和第5.5节写的是在这些距离之内为正、超过之后为负,依赖图的文字与摘要一致。
论文认为方法和单中心城市群的经验可以供首尔—京畿、巴黎都会区参考。这是外推建议。本文的样本是一个运营商、一个秋季、一个含长假的12周,以及京津冀这一套城市等级。
一句话总结
在这12周、已经被规则标成明确目的的4690.0万次城际行程里,商务占89.68%;到北京中心的距离对通勤在120公里后转为负,对休闲和商务则先升后降,正向区间分别延伸到160公里和175公里,而格子的平均距离已经是196.808公里。
核心来源
Liu, Z., Liu, X., Yan, X., Li, F., Zhong, H., & Wang, Y. (2026). Influences of built environment on intercity travel demand of urban agglomerations: The discrepancies across inferred trip purposes. Cities, 168, 106404. https://doi.org/10.1016/j.cities.2025.106404
经费说明来自论文致谢:中央高校基本科研业务费2024YJS177、2024JBZX013,国家自然科学基金72304030。数据可用性声明写明,作者无权共享数据。
刘子乐是第一作者,贡献为软件、方法、形式化分析和概念。北京交通大学研究生院2026年5月20日公布的答辩安排写明,刘子乐申请交通运输规划与管理博士学位,导师闫学东,论文题目是基于手机信令数据的城市群出行特征挖掘与OD分布预测方法。公告是答辩安排,不是学位已经授予的证明。
刘晓冰是通讯作者,论文署有交通运输学院和系统科学学院两个单位,贡献为指导和研究方法。北京交通大学教师名录的邮箱与论文一致,现为系统科学学院副教授、博士生导师,研究方向包括大数据与人工智能、共享出行和智慧交通安全。其主页的成果列表收录了本文。
闫学东的论文贡献是指导、获取经费和形式化分析。北京交通大学教师名录与学校领导页写明,他是交通运输学院教授、博士生导师,并担任北京交通大学副校长;研究涵盖交通运输规划与管理、交通安全和综合交通大数据。邮箱与论文一致。
李奉孝在本文中负责可视化和数据整理。北京交通大学研究生院2026年9月4日公布的答辩安排写明,李奉孝申请交通运输规划与管理博士学位,导师马路,论文做都市圈长距离通勤的特征与公平性。
Hua Zhong在本文中负责可视化,署名为北京交通大学交通运输学院。同一实验室教师主页列出的2025年论文里,Zhong为第一作者,主题是通勤方式选择。公开页面没有给出可核对的中文姓名和职务,这里不补写。
王云在本文中负责指导。北京交通大学教师名录的邮箱与论文一致,职务是交通运输学院副教授、博士生导师,研究城轨与公交规划、交通韧性和出行行为的大数据分析。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一条规划环线同时服务上班、度周末和商务拜访,只画一个距北京120公里的圈会把后两类的峰值留在圈外。休闲依赖图的高点约在75公里,商务约在95公里,而且这两条曲线在更近处并不是最高。通勤曲线则是越近越高、120公里后转负。三种设施对应的是三条曲线的不同段落:高峰时段的就业与居住、75公里附近的休闲可达性、95公里附近的商务联系。用通勤的终点去裁休闲设施,或者用商务的175公里去论证通勤仍然该被鼓励,都越过了各自那张依赖图。
另一件容易被总次数掩盖的事,是谁在样本里占多数。明确目的的行程里,商务占89.68%。未分类模型的R²只有0.523,低于三类各自的0.576、0.595和0.580。把所有行程放进一个模型,拟合结果会更靠近数量最大的那一类。一个春季、不含国庆周的窗口,休闲的75公里高点是否还在,本文没有第二套数据可以回答。
公司兴趣点的通勤拐点约在15个,格子均值是17.987个。均值附近再增加一家公司,和空格子上出现第一家公司,落在曲线的不同坡度上。兴趣点总量对商务的转向要到5000至7500个,距离均值7个标准差以上。把后一个门槛写成“每个格子都应达到的土地利用强度”,依据的是尾部格子,不是表1里的典型格子。