在广州通勤,跨一道边界相当于多远?
Zhao, J., Zhang, Z., Wen, X., Xin, M., Gong, Y., & Liu, Y. (2027). A representation-explanation framework for flow-based border effects on intra-urban commuting using geographically weighted additive gravity model and machine learning. Computers, Environment and Urban Systems, 131, 102516. 论文 DOI
想象两处就业地,离家都差不多远,吸纳通勤者的规模也相近。去一处留在本区,去另一处要跨区。两处的通勤联系还会一样强吗?如果跨区的那一处来往更少,它在通勤意义上相当于远了多少?
广州的街道间通勤数据显示,跨区的阻力可以用公里来表达,而且同样一道区界,在中心城区和外围并不一样厚。要得到这个结果,研究首先得从通勤人数里区分距离、两端的规模和越界各自对应的变化。
怎样识别跨界与通勤流量的关系?
研究用中国移动在广州采集的 2023 年 6 月工作日的脱敏手机信令,识别 18–65 岁用户的居住地和工作地。夜间与白天最常停留的位置分别用来推断住处和工作地点。数据处理剔除了用于设备联网的 SIM 卡,也校正了定位漂移和基站反复切换造成的假移动。例如,手机停在原地,连接的基站也可能来回变动。
通勤人数按方向汇总到街道对,例如从居住街道 A 到工作街道 B。研究保留了约 1.87 万个流量超过 3 人的街道对用于估计。图 1b 的暖色连线集中在中心城区。这里既有更短的街道间距离,也有更密集的通勤联系,单看哪条线上的人数少,无法判断边界的作用。
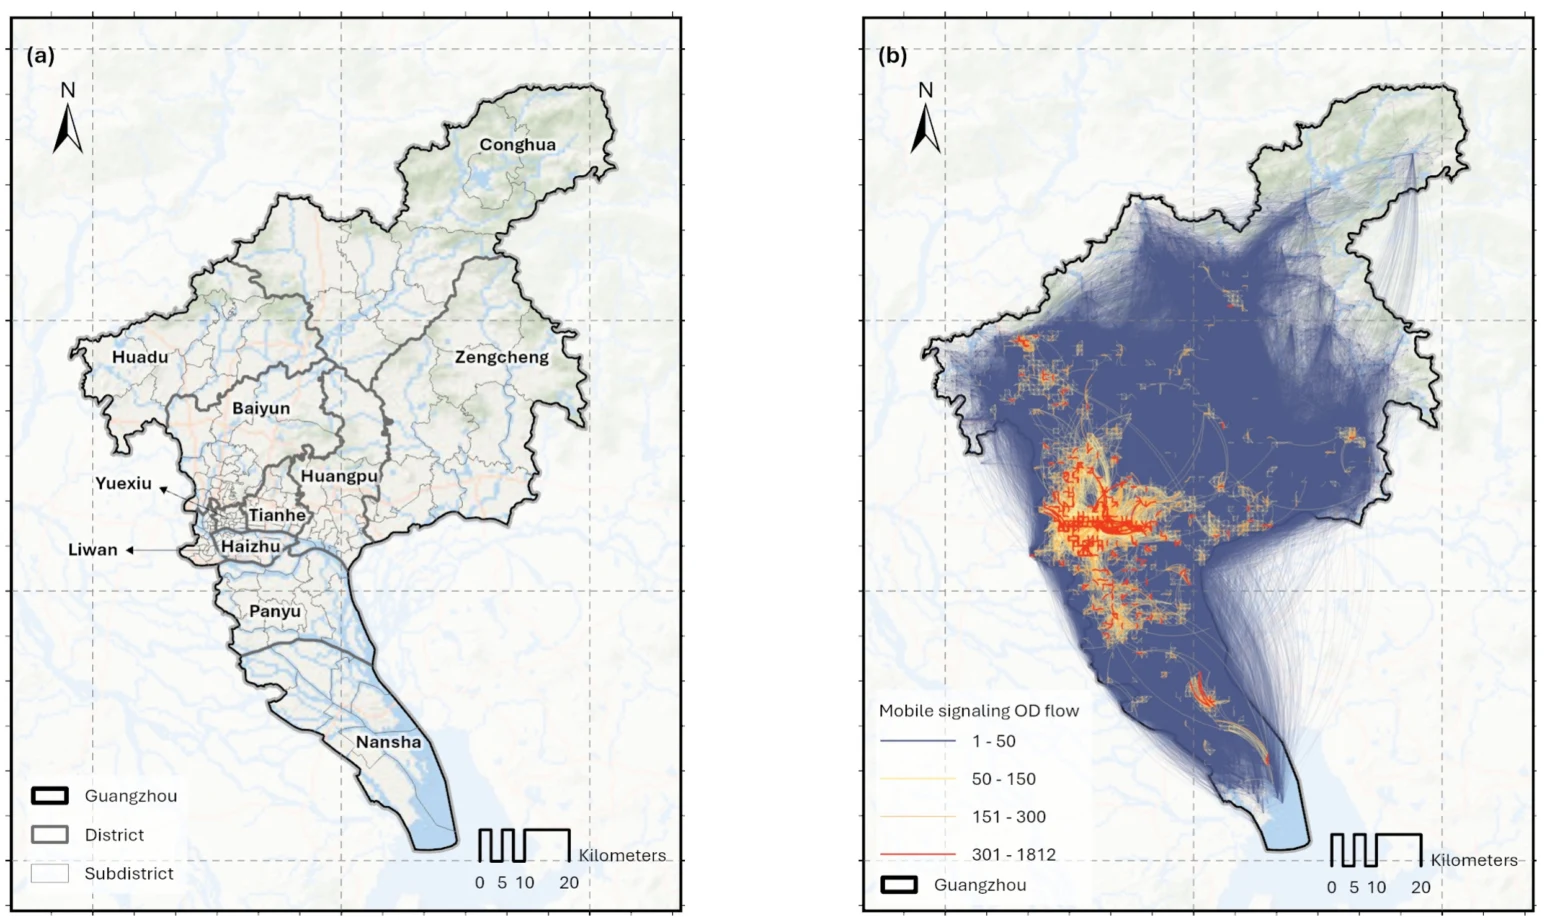
图 1|左图是广州的区和街道,右图每条线连接两个街道,颜色表示通勤人数。
研究将区界列为行政边界,将划定的山体和水体列为自然边界。对每对起讫街道,模型沿两端的直线分别计算跨过了几道区界、几道自然边界。这个口径衡量的是地图上的越界关系,实际通勤者可能选择不同路径。
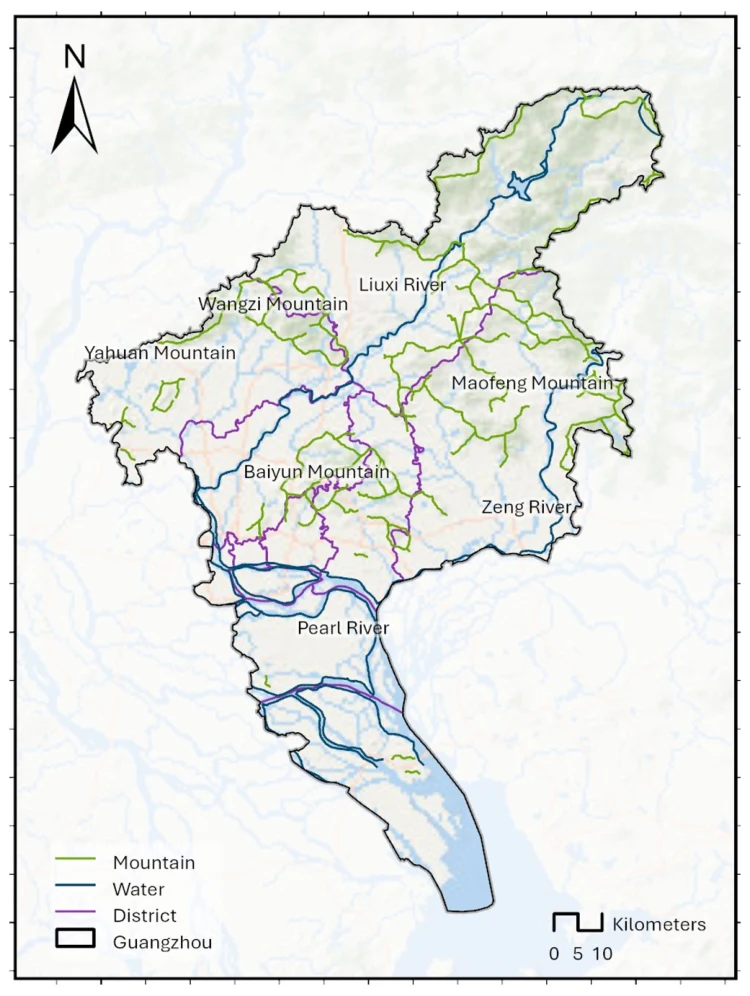
图 2|紫线标出区界,绿线和蓝线分别标出山体与水体边界。
为什么一个模型乘人数,另一个模型加公里?
引力模型(gravity model)描述两地之间可能有多少人通勤。以街道 A 到街道 B 为例,起点规模用从 A 出发的通勤总人数表示,终点规模用前往 B 的通勤总人数表示。通常,两端规模越大,预计流量越高。距离越长,预计流量越低,这就是距离衰减(distance decay)。
全局乘性模型(global multiplicative model)先用全市街道对估计一套共同参数。若 A 到 B 跨一道区界,模型就在原本预计的通勤人数上再乘一个区界系数。一个假设的例子是预计 100 人,跨界系数为 0.8,估计就变为 80 人。这样的系数表示流量按什么比例变化,也为下一步拟合提供规模和距离衰减等参数的初值。
要把阻力讲成公里,局部可加模型(local additive model)改在距离上做加法。假设 A 到 B 的直线距离为 8 公里,跨一道区界的估计阻力为 3 公里,引力模型就用 11 公里计算预期流量。若还跨了一道自然边界,再加上对应的公里数。每跨一次所增加的等效直线距离,论文称为边界厚度(border thickness)。
为什么要做局部估计?市中心的区界和外围的区界可能对应不同的通勤条件。估计 A 到 B 的边界厚度时,模型参考其他起点靠近 A、终点也靠近 B 的街道对,并给位置更接近的组合更大权重。用这些通勤人数拟合,模型可以得到随起讫地点变化的两类边界厚度。
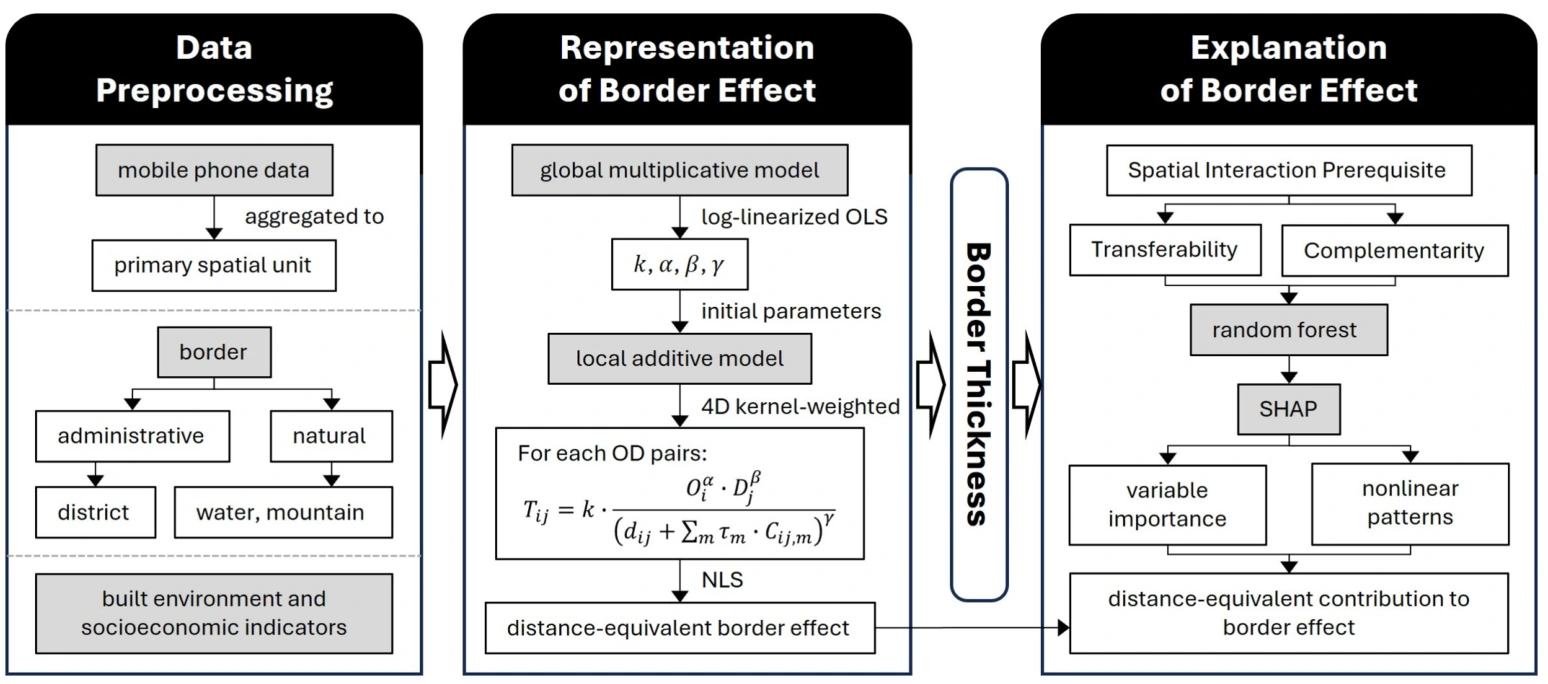
图 3|左栏整理通勤流量和边界,中栏把越界阻力折算成公里,右栏用交通和城市环境指标解释估计厚度的差异。
每次拟合参考的街道对太少,估计容易受个别联系影响。范围太大,又会淡化局部差异。论文比较不同邻居数量后挑选相对稳定的取值。把一部分街道所在的区域留作测试时,局部可加模型在衡量较大预测误差的指标上表现较好,为采用随地点变化的估计提供了依据。
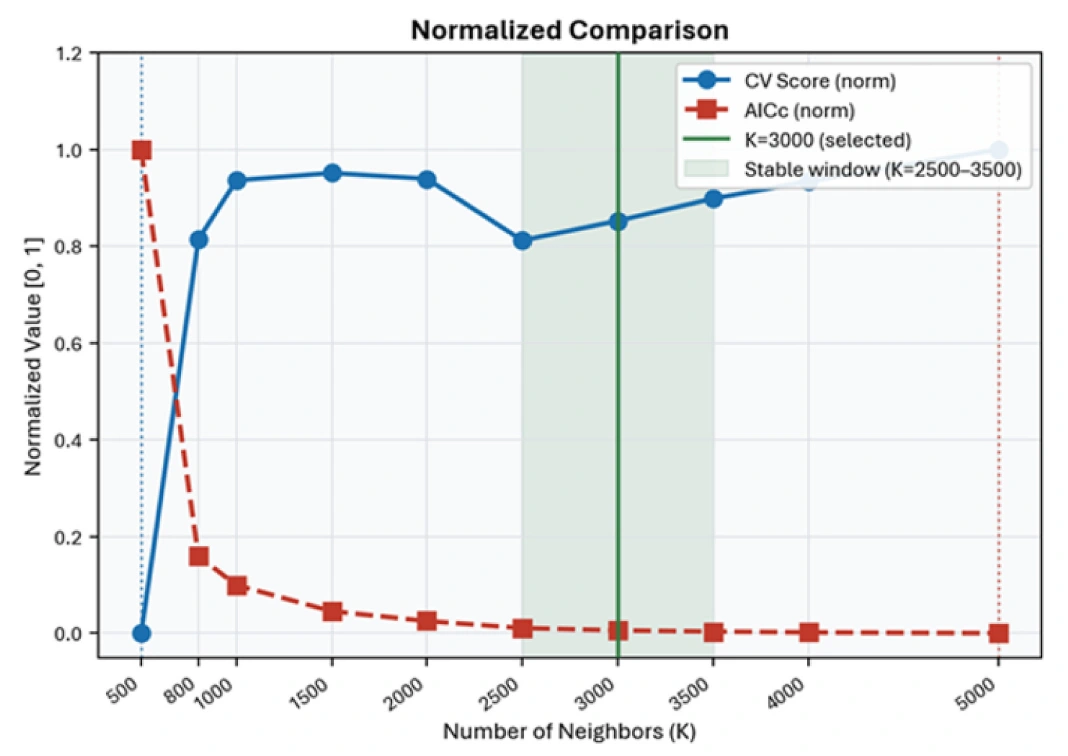
图 4|横轴是参与局部拟合的邻近街道对数量,纵轴是标准化后的交叉验证评分(蓝线)和模型复杂度校正指标 AICc(红线)。绿线标出论文选用的数量。
同一道区界,在市中心和外围一样厚吗?
在纳入分析的街道对中,跨一道行政边界的平均阻力相当于增加约 5.9 公里的直线距离,跨一道自然边界约为 3.0 公里。两类厚度都由通勤流量拟合得到。少数高值拉高了均值,两类边界的中位数分别约为 2 公里和 1 公里。论文放宽厚度估计的上限后,均值进一步升高,中位数保持稳定。
为了看清这些差别出现在哪里,研究将穿过同一边界段的街道对的估计厚度取平均。图 5a 上,天河、越秀、海珠和荔湾之间的区界偏薄,从化与相邻区之间则有较厚的区界。图 5b 的高值多出现在广州北部山地。区界的行政级别相同,实际联系强弱却有明显的空间差别。
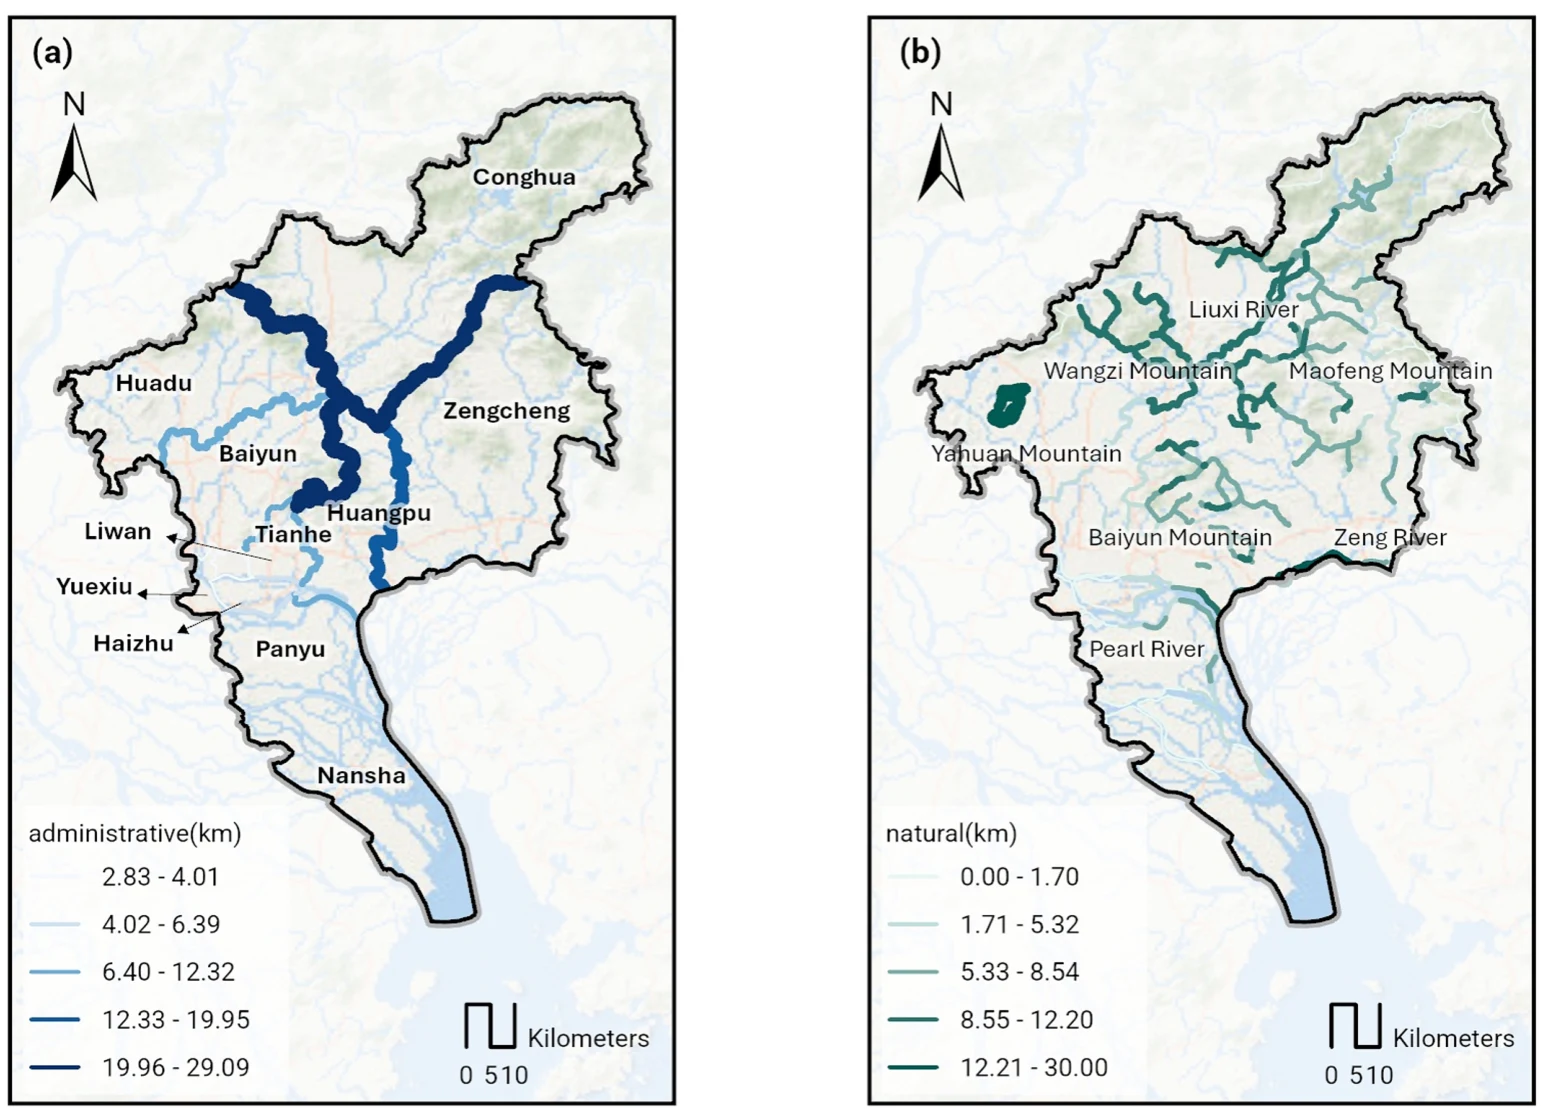
图 5|(a)为行政边界,(b)为山体和水体边界。颜色越深,该段对应的平均等效距离越大,单位为公里,两图采用各自的分档。
哪些地方更容易形成跨界联系?
厚度地图告诉我们哪里阻力大,接下来才能问这些街道对有什么共同特点。研究用随机森林(random forest),让多棵决策树根据公交、道路、职住和地形等指标去预测前面估出的边界厚度。每个街道对有一个估计厚度,分析比较的是哪些条件与这个估计值的高低相伴。
研究再用 SHAP 解释模型预测,衡量某项条件把预测厚度拉高或压低了多少公里。居住端和就业端的公交线路密度乘积,在两类边界的模型中贡献都排第一。公交较稀疏的街道对常有较高的预测厚度。自然边界的厚度差异还与沿途的地形和水体条件有关。这些关联可以帮助选出值得实地查看的路段。要估计增设交通设施会带来多少通勤变化,还需要观察真实的设施开通。
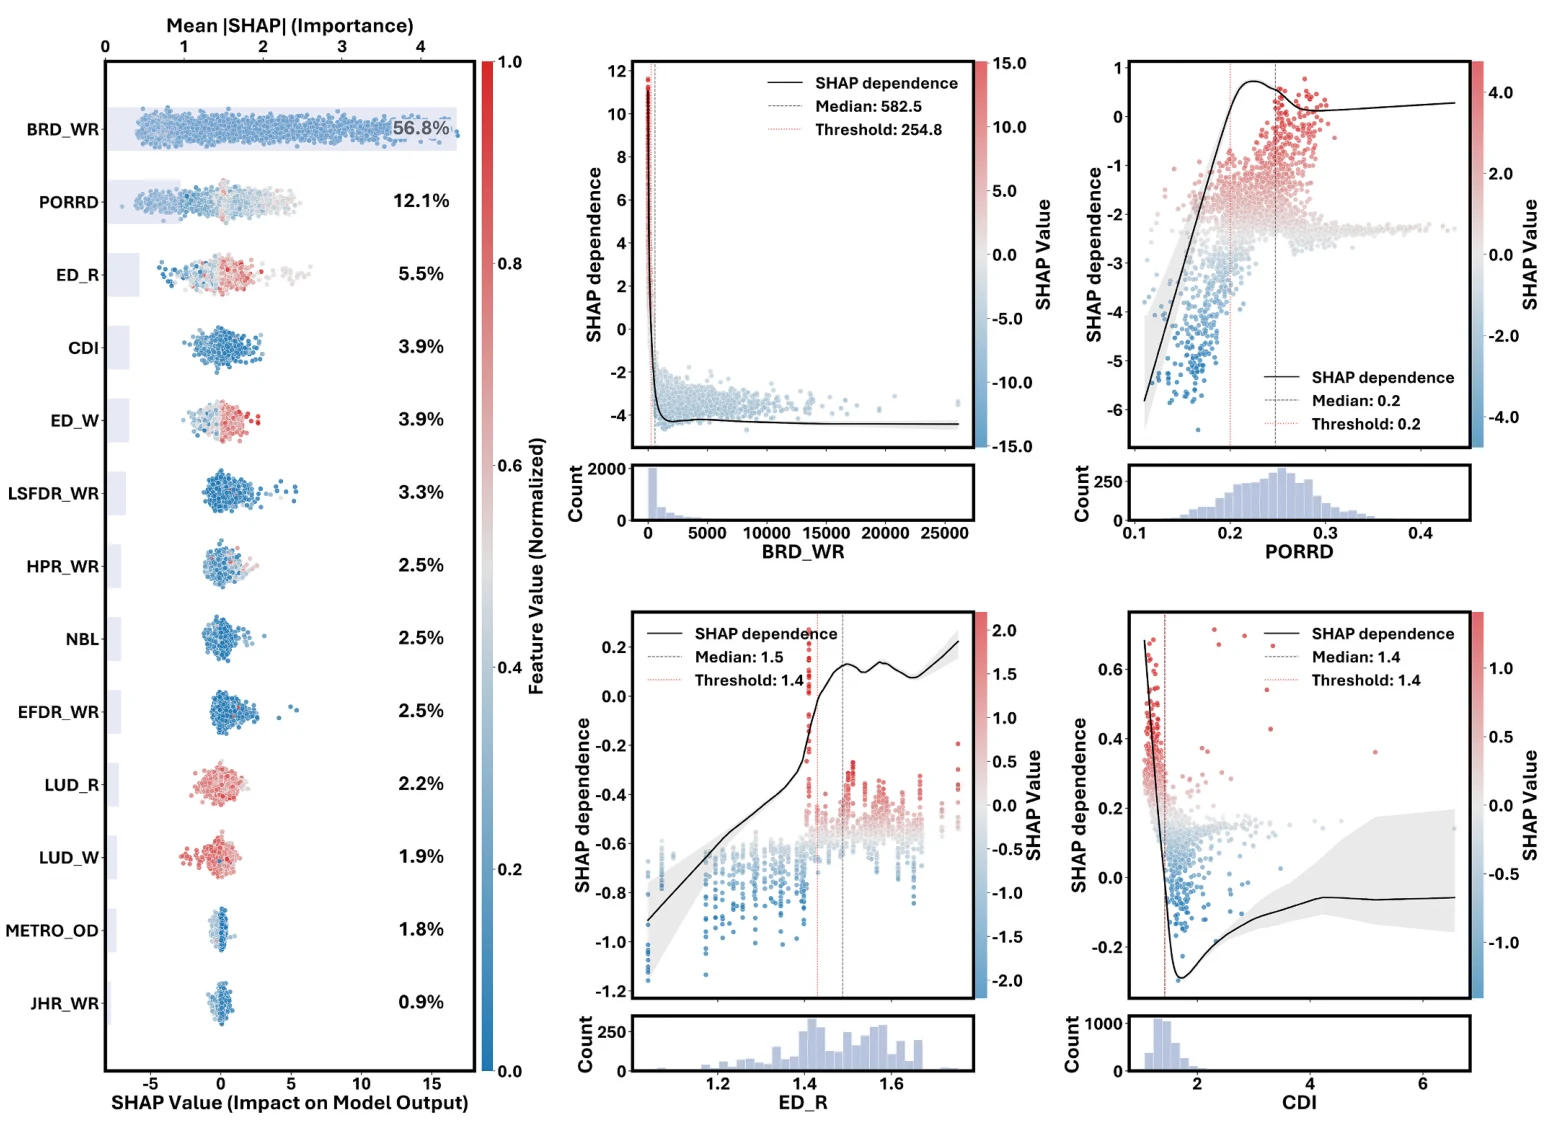
图 6|行政边界。左图每行对应一个变量,横轴是它对单个街道对的预测厚度贡献(公里),颜色表示变量取值。右侧各图横轴是对应变量取值,纵轴仍是厚度贡献。可先看右侧左上图的两端公交线路密度乘积(BRD_WR)。
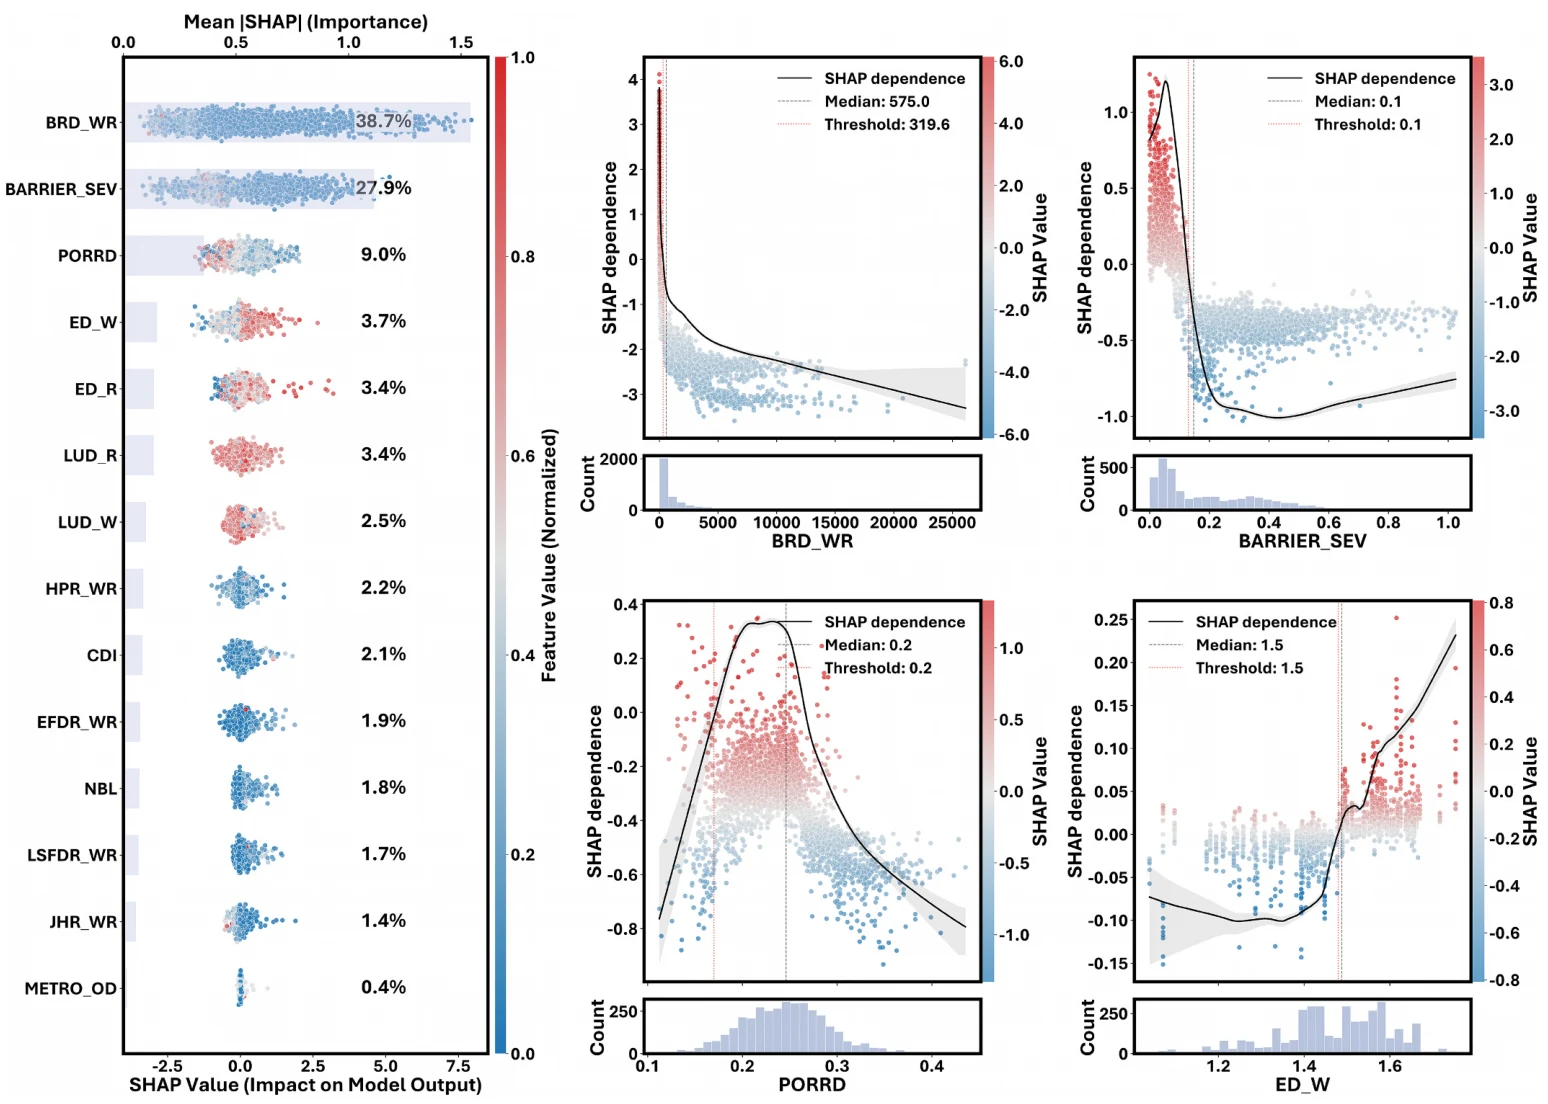
图 7|自然边界。坐标读法同图 6。最右上方的图以综合坡度和水面宽度的障碍强度指标为横轴,纵轴为它对预测厚度的贡献(公里)。
从化的流溪河与中心城区的珠江提供了一个直观对照。论文选取的流溪河河段跨越设施较少,估计厚度偏高。中心城区珠江的示例河段有多处桥梁与地铁通道,估计厚度偏低。对规划而言,厚度地图的用途是先找出通勤联系偏弱的地方,再调查人能从哪里过河、过河后能到哪些就业地。
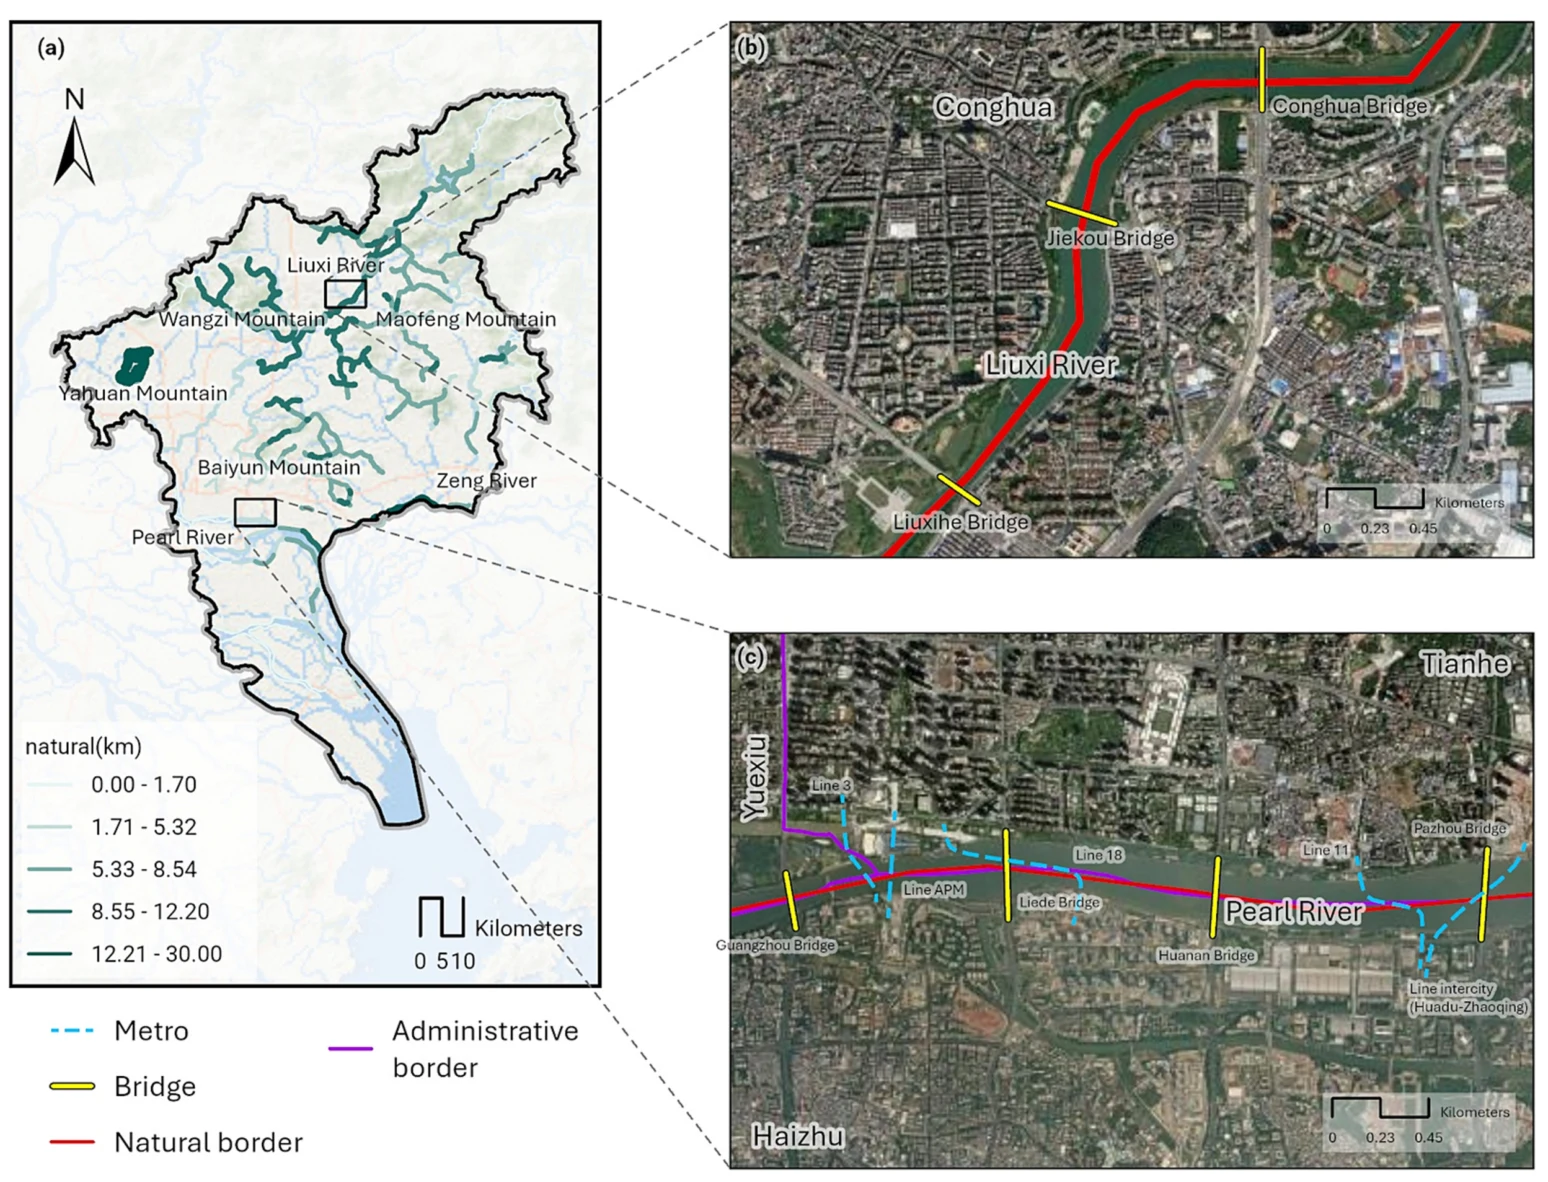
图 8|(a)定位两个河段,(b)是从化流溪河,(c)是中心城区珠江。黄线标桥梁,蓝色虚线标地铁。
一句话总结
根据广州工作日的街道间通勤流量,模型估计跨一道区界的平均阻力约合 5.9 公里直线距离,跨一道自然边界约合 3.0 公里,具体厚度随起讫地点而变。
核心来源
作者介绍
- Junyang Zhao 署名于哈尔滨工业大学(深圳)建筑学院、哈尔滨工业大学建筑与设计学院及空间治理数字技术中心,负责初稿与可视化。
- Zhaodong Zhang、Xixiang Wen、Mengwei Xin 和通讯作者 Yongxi Gong 均署名于哈尔滨工业大学(深圳)建筑学院、空间治理数字技术中心和深圳市城市规划与决策重点实验室。Zhang 参与方法和数据整理,Wen 参与软件和数据整理,Xin 参与方法和分析,Gong 参与研究设计与监督。
- Yu Liu 署名于北京大学地球与空间科学学院遥感与地理信息系统研究所,参与研究构思与监督。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
假如流溪河某一段新开了一条公交线路,可以用开通前后的通勤数据检验地图的判断。选择原来通勤规模和走势相近、同期交通条件稳定的另一段河岸作对照,再看新增线路两端的街道是否增加了跨河通勤。如果变化集中在能直达的街道,下一轮调查就可以把线路通向哪些就业地纳入分析。