起点流出已经知道了,远城之间的重卡为什么还是估不准?
论文名片|Yitao Yang、Bin Jia、Xiao-Yong Yan、Yan Chen、Dongdong Song、Danyue Zhi、Yiyun Wang、Ziyou Gao,Estimating intercity heavy truck mobility flows using the deep gravity framework,Transportation Research Part E: Logistics and Transportation Review,2023,179:103320,2023年10月10日在线发表,期刊期次为2023年11月。DOI:10.1016/j.tre.2023.103320。本文依据这一正式发表版解读。
一辆最大载重超过 12.5 吨的货车从北京出发,既可能开往邻近城市,也可能开往直线距离一千八百多公里外的广州。单约束重力模型把这件事写成一条规则:起点发出的总车次已知,目的地进来的车次越多、两城越近,分到这条线路上的概率越高。规则透明,也因此会把低流量城市和相距较远的城市估偏;同一距离上,北京到广州与广州到北京也不会被分开。
这项研究把 Simini 等人 2021 年的深度重力模型(Deep Gravity)扩到中国地级市之间的重型货车。网络仍先给出从起点到每个目的地的概率,再乘上已经观测到的起点总流出。加入货运场所、道路、用地和两端货运需求后,它对 2018 年 5 月 18 日至 31 日这 14 天流量的重叠程度高于单约束重力模型。解释结果里,距离和货运需求仍然最重要,但长短距离上距离的贡献方向相反。这是同一时期流量如何分配的拟合,不是未来一周的预测,也不是修路或建市场导致车流变化的因果证明。
先说结论
- 分析单位是 368 个地级市之间的重型货车行程。标签来自 270 万辆、最大载重超过 12.5 吨的货车,采样间隔 30 秒,记录数超过 410 亿条;时间只覆盖 2018 年 5 月 18 日至 31 日。
- 每座城市 26 个特征,一对城市加上欧氏距离后是 53 维。模型输出概率后乘以起点总流出,所以比较的是已知流出如何分到各目的地,不是从零预测一座城市发出多少车。
- 深度重力模型的流量重叠指数 CPC 为 0.7854,单约束重力模型为 0.6723;均方根误差 RMSE 分别为 760.79 和 901.17。相对重力模型,CPC 高 0.1131,相当于基线的 16.8%;RMSE 低 140.38,相当于基线的 15.6%。论文没有报告另一时段或留出城市对上的误差。
- 在全部城市对上,距离的平均绝对贡献最大,其后是起点和目的地的货运需求。北京—广州的距离贡献为负,厦门—福州的距离贡献为正;目的地综合市场、工业用地、交通枢纽和高速公路与距离的交互,在短距离和长距离上符号不同。
只靠距离和两端规模,货车流会漏掉什么?
城际重型货车流量,在交通规划里常称为出行分布或起讫点合成:估计城市对之间有多少趟货运行程,结果写成一张起讫矩阵。传统空间交互模型,尤其是重力模型,假设两地交互随规模增大、随距离增加而减弱。它容易解释,数据不全时也能算,但通常只用距离和经济活动。路网是否连通、用地是不是工业、城市里有多少市场和枢纽,都不进入公式。线性形式也难表示这些因素彼此改写的情况。
既有深度学习较多用于客运或一般交通量。深度重力模型原本用深度网络学习地区之间的人员流动概率。货车缺少可公开的城际大样本,把同一框架用于重型货车的研究当时仍少。本文要补的是:在起点流出已知时,货运场所、道路和用地能否让城市对流量更接近观测,以及这些特征在模型里怎样改写距离的作用。
这 14 天的行程,是怎样变成城市对标签的?
货车 GPS 来自全国道路货运车辆公共监管与服务平台。研究收集 2018 年 5 月 18 日至 31 日、最大载重超过 12.5 吨的 270 万辆重型货车轨迹,坐标为 WGS-84,采样间隔 30 秒,记录数超过 410 亿条。行程起讫沿用 Yang 等人 2022 年的识别方法:先在漂移影响下找出停车,再用活动时间、货运兴趣点和公路网,把休息、加油、拥堵等临时停车与装卸货停车分开。城市对之间的行程数,就是模型要拟合的标签。
这里的一趟,是识别出来的一次城际货运行程,不是一辆车,也不是货物吨数。一辆货车在 14 天里可以跑多趟。270 万是车辆数,410 亿是定位记录数,二者都不能当作城市对流量的分母。
城市特征来自另外两套数据,覆盖同样的 368 个地级市。高德地图兴趣点分成三类、共 18 项:货运企业 10 类,包括冶金、医药、电信、建筑、网络、贸易、装饰、机械、矿物和工厂;货运市场 6 类,包括超市、建材市场、家电市场、综合市场、产业园和农业基地;货运设施 2 类,即交通枢纽和物流节点。OpenStreetMap 提供主干路、次干路和高速公路的总长度,单位是公里,以及零售、居住、商业、工业四类用地面积,单位是平方公里。第 26 项是货运需求,定义为一座城市重型货车流出与流入之和。兴趣点和路网的采集日期,论文没有单独给出。
地级市面积差别很大。作者说明常见约 5,000 到 10,000 平方公里,也有约 2,000 或超过 20,000 平方公里的市。同一个“城市对”,地理尺度并不整齐,结果不能直接读成街道或区县之间的货车流。
网络先给概率,再乘上已经数到的起点流出
对起点城市 i 和目的地 j,模型把 i 的 26 维特征、j 的 26 维特征和两城欧氏距离拼成 53 维样本。同一起点的各个目的地并行进入前馈网络。网络有 6 个 256 维隐藏层和 9 个 128 维隐藏层,激活函数是 LeakyReLU,每个城市对先输出一个分数 sᵢⱼ。分数越高,表示从 i 到 j 出现行程的倾向越高。Softmax 把同一起点的分数变成概率,全目的地概率之和为 1:
pᵢⱼ = exp(sᵢⱼ) / Σₖ exp(sᵢₖ)。
预测流量再写成 Tᵢⱼ = pᵢⱼ × Oᵢ。这里的 Oᵢ 是起点重型货车总流出,不是原深度重力模型里的人口。因此,即使每个目的地的概率都估错,把它们乘回 Oᵢ 后,起点流出的合计仍与观测流出一致。模型回答的是分配,不是一座城市总共发出多少趟。
训练损失是观测份额与模型概率的交叉熵:H = − Σᵢ Σⱼ (Tobsᵢⱼ / Oᵢ) ln(pᵢⱼ)。Tobsᵢⱼ / Oᵢ 是起点 i 的流出中前往 j 的比例。优化用 RMSprop,动量 0.9,学习率 5×10⁻⁶,训练 30 个 epoch。论文没有报告批量大小、独立测试集或交叉验证。GPS 不直接作为网络输入,只用来生成城市对标签,以及每座城市的流出、流入和二者之和。
对照模型是单约束重力模型。它也把起点流出 Oᵢ 分出去,但概率只由目的地总流入 Dⱼ 和距离决定:
Tᵢⱼ = Oᵢ × [Dⱼᵝ × exp(−dᵢⱼ / γ)] / Σₖ [Dₖᵝ × exp(−dᵢₖ / γ)]。
β 和 γ 用最大似然估计,论文没有公布拟合后的数值。重力模型看见的是目的地流入;深度重力模型的货运需求特征则是流出加流入,两端都进入 53 维输入。两边都使用了这 14 天流量算出的边际量,不能理解成只凭地图就能预测车流。
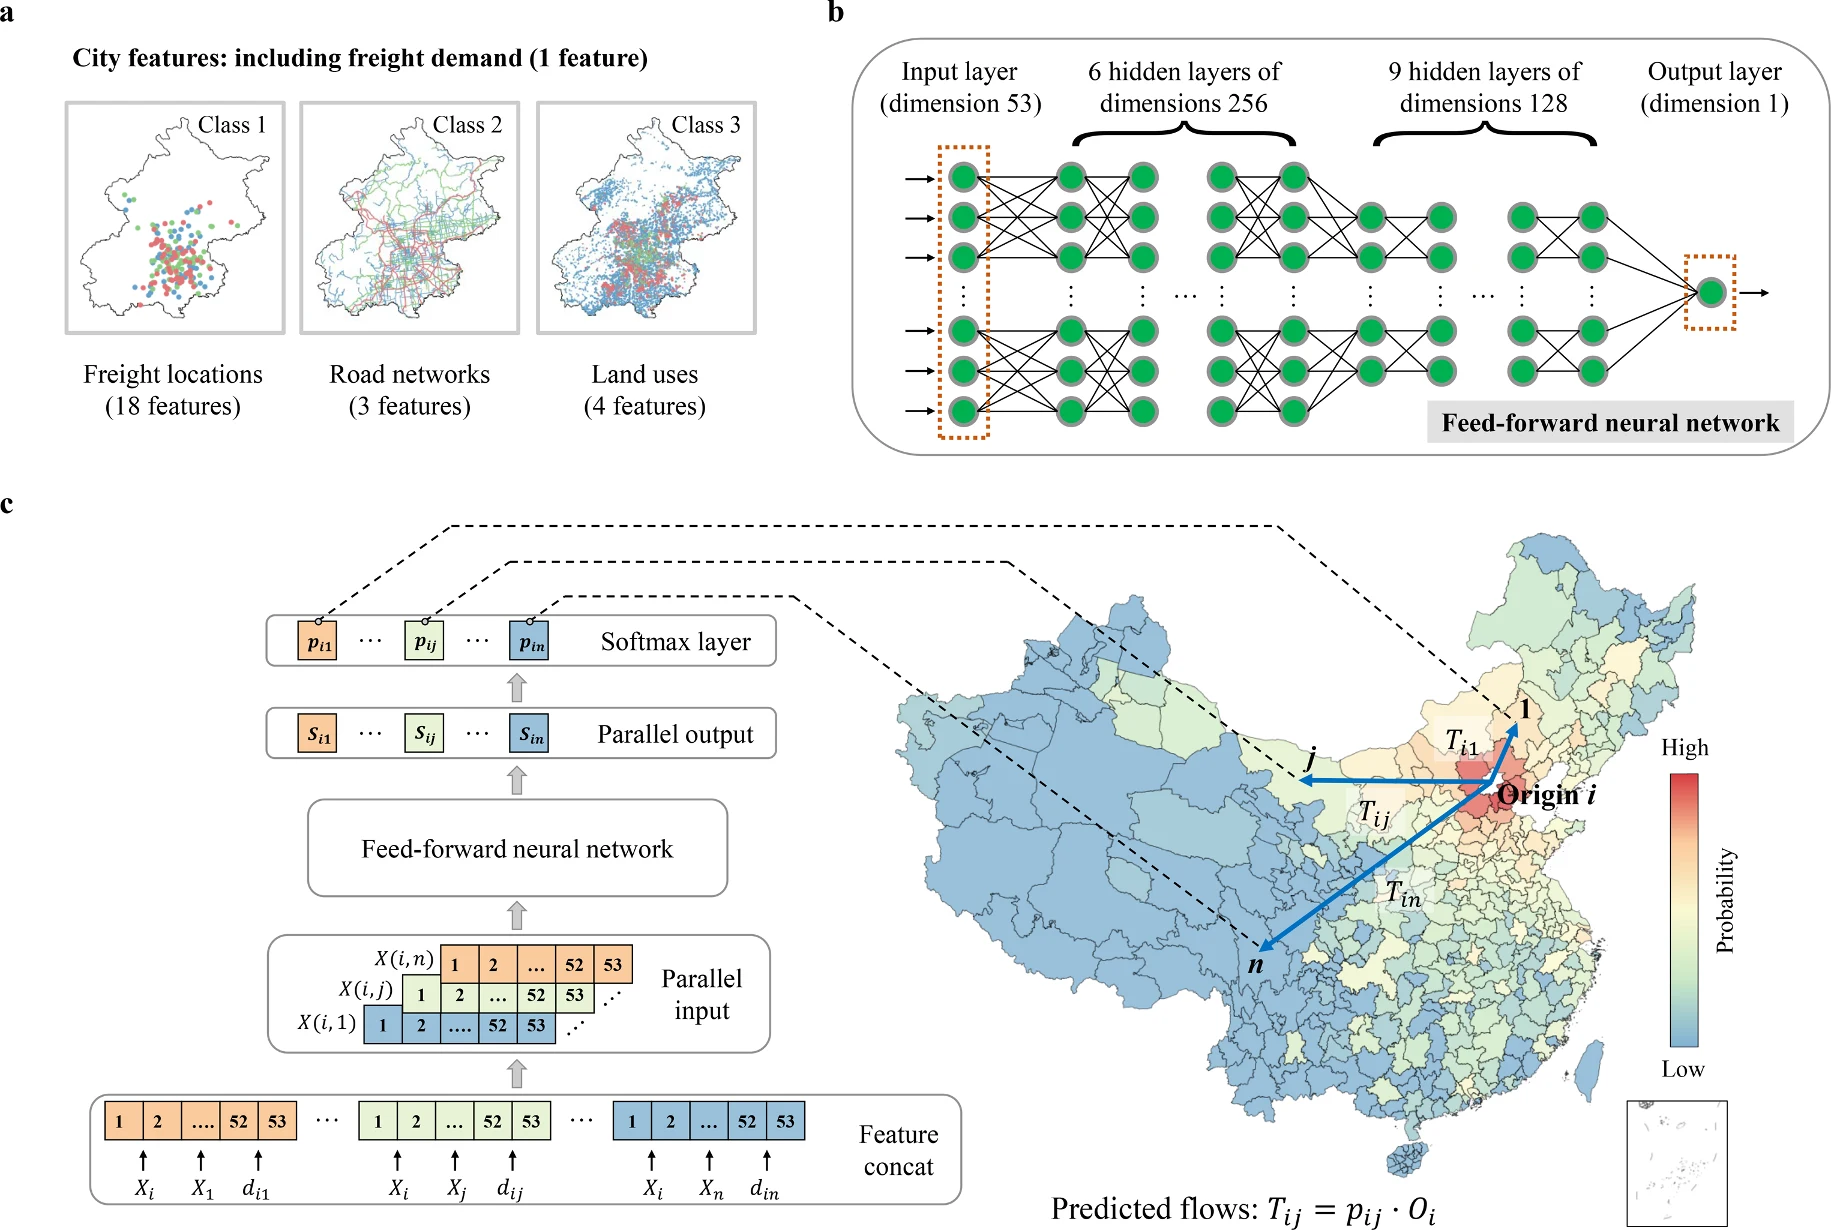
图 1|从城市特征到一条起点的流量分配,中间经过哪些步骤?
(a)一座城市的输入由货运场所 18 项、道路长度 3 项、用地面积 4 项,以及未画进三个小地图的货运需求 1 项组成,合计 26 项。颜色区分场所、道路和用地类型,地图是示意。(b)53 维样本进入前馈网络:6 个 256 维隐藏层、9 个 128 维隐藏层,输出 1 维分数。(c)同一起点的样本并行计算,Softmax 得到概率 pᵢⱼ,预测流量等于概率乘以起点总流出 Oᵢ。地图颜色是单位流量分到各目的地的概率,不是行程数;灰线隔开的是地级市。来源:原论文 Fig. 1。
多出来的特征,把重叠提高了多少?
评价用两个指标,都在这 14 天的城市对上比较观测流量和生成流量。CPC 是两倍的逐对较小值之和,除以观测总量与模型总量之和,范围在 0 到 1,1 表示完全重叠。它沿用通勤研究里 Common Part of Commuters 的名字,这里的分子分母都是货车行程。RMSE 是城市对误差平方的平均再开方,公式写明只对 i 不等于 j 的城市对求和,分母是城市对数量 Npair。论文没有给出 Npair,因此 760.79 不能换算成全国总车次误差。
图 3 印出的结果是:深度重力模型 CPC = 0.7854、RMSE = 760.79;单约束重力模型 CPC = 0.6723、RMSE = 901.17。CPC 高出 0.1131,除以重力模型的 0.6723 等于 16.8%。RMSE 降低 140.38,除以重力模型的 901.17 等于 15.6%。正文称深度重力模型显著更好,但没有报告统计检验。两个指标也不保证每一条低流量城市对都更准:CPC 看重叠,RMSE 更在意大误差。
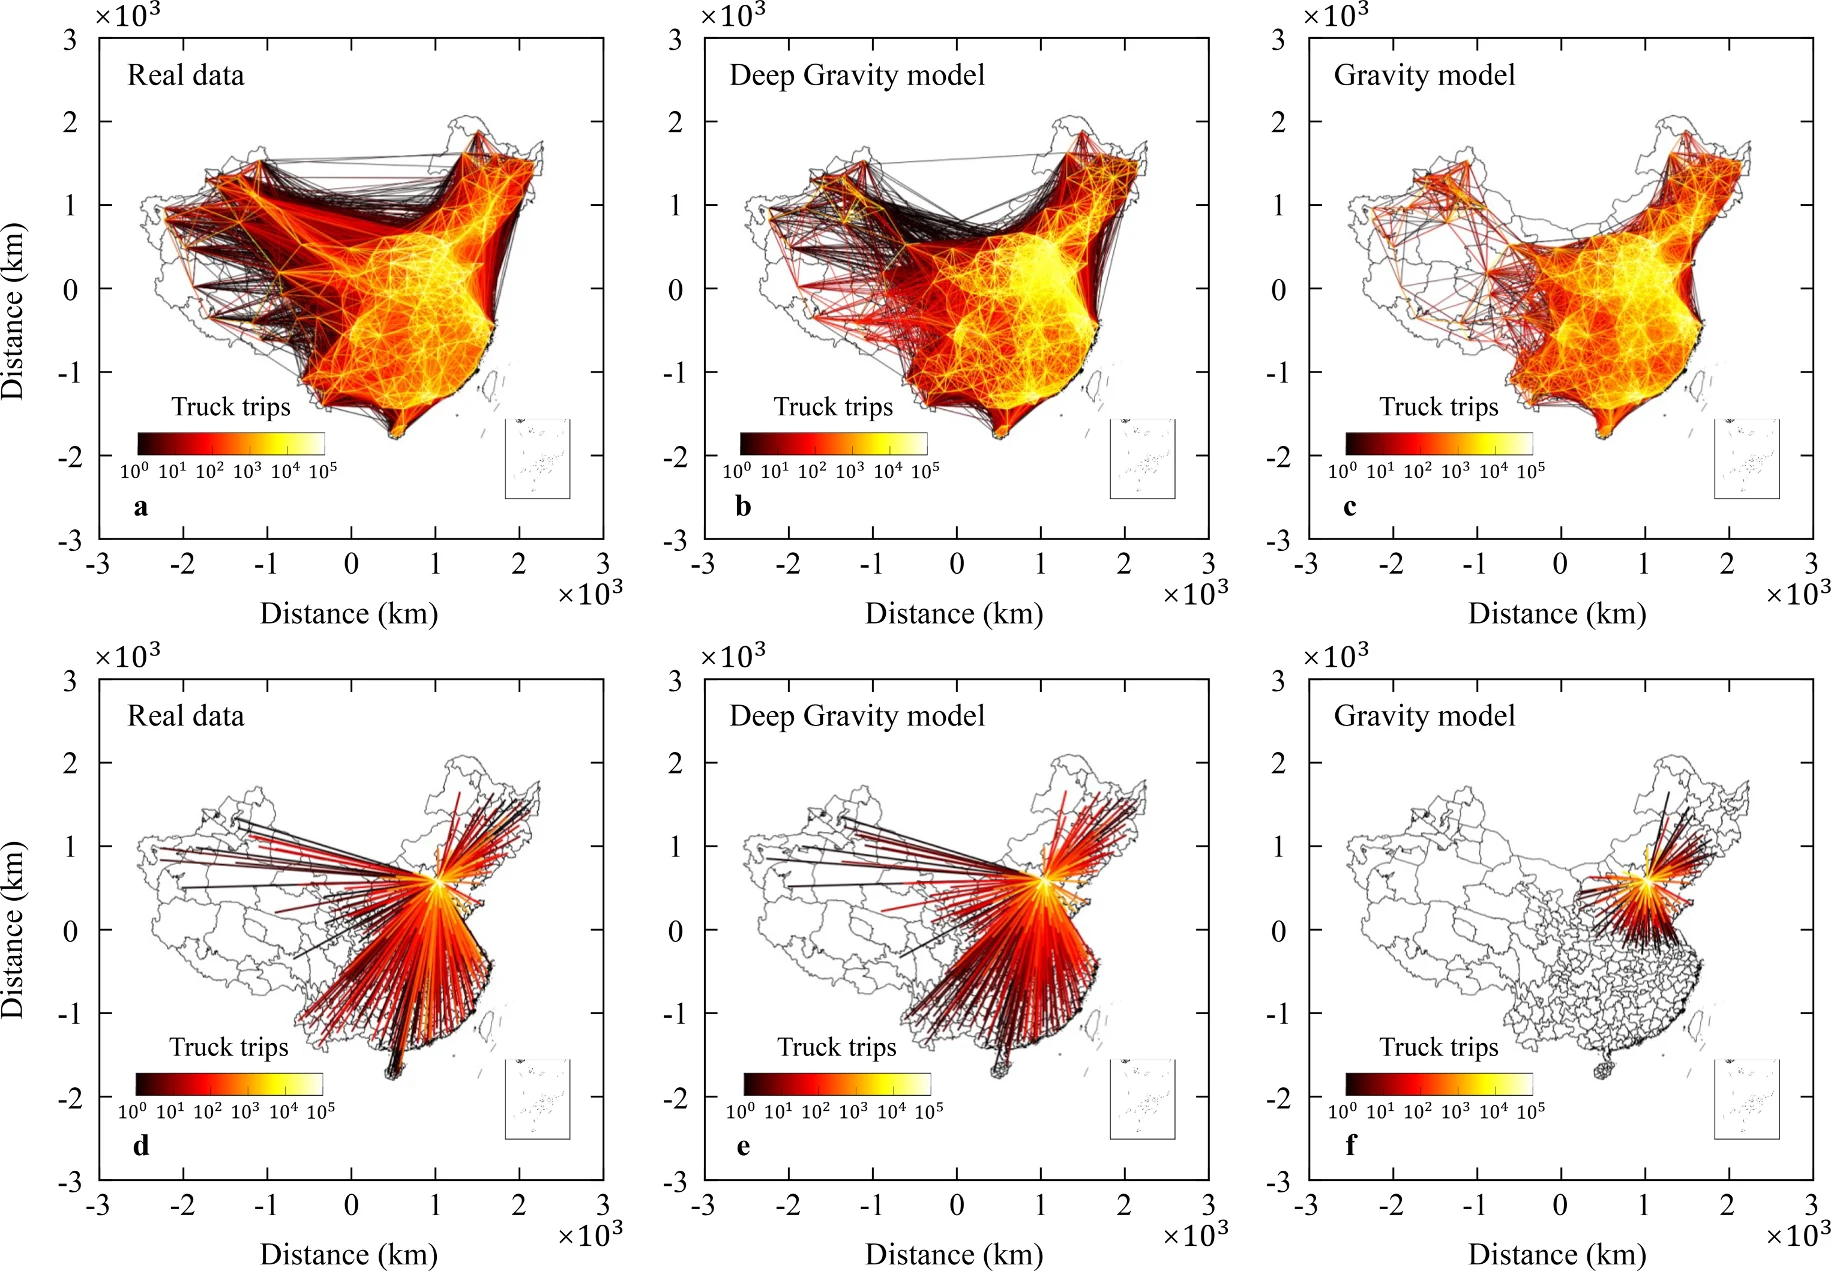
图 2|全国骨架和从北京出发的线路,两个模型各保留了多少?
(a、d)观测流量。(b、e)深度重力模型。(c、f)单约束重力模型。(a–c)为全部城市对,(d–f)为从北京到其他城市。横纵轴是投影后的平面坐标,单位公里,刻度乘以 10³,不是行程长度分布。颜色表示城市间货车行程数,色标从 10⁰ 到 10⁵。深度重力模型保留了更密的东部网络和北京向外的远距离线路;重力模型在西部和北京的远城方向更稀。图像相似不等于每条城市对误差都更小。来源:原论文 Fig. 2。
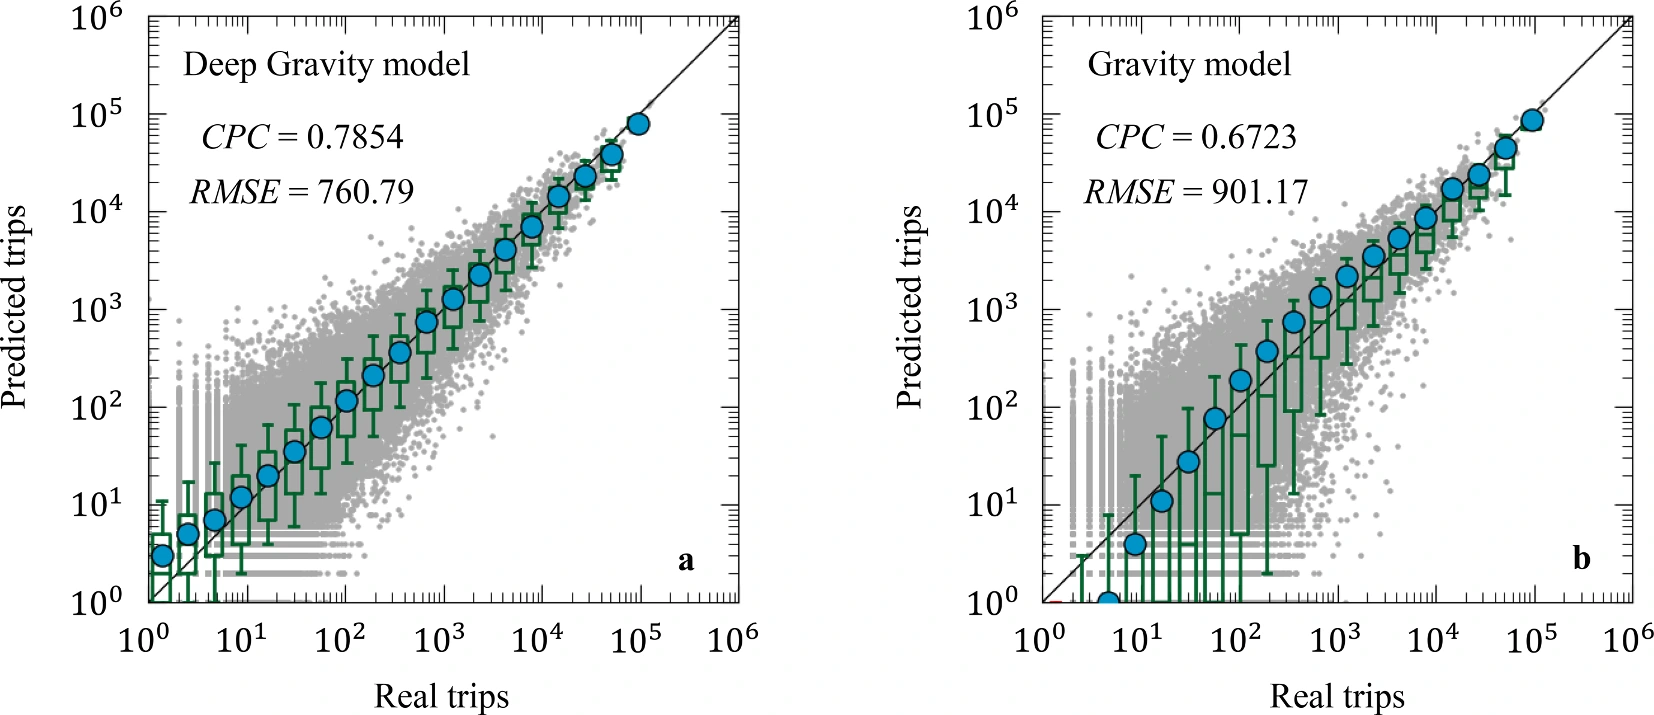
图 3|相对重力模型,逐城市对的误差降了多少?
(a)深度重力模型,CPC = 0.7854,RMSE = 760.79。(b)单约束重力模型,CPC = 0.6723,RMSE = 901.17。横轴是观测行程,纵轴是预测行程,均为对数坐标。灰点是城市对,蓝点是分箱后的预测均值,箱线是箱内预测值分布。按图注,若对角线 y = x 落在该箱预测分布的 10% 与 91% 之间,箱子标绿。高流量端两边都贴近对角线;低流量端散点更宽,重力模型最左侧分箱均值落到对角线下方。绿箱不是每条城市对都估准。来源:原论文 Fig. 3。
重力模型偏弱,作者归因于它只假定流量随货运需求增加、随距离衰减。需求低的城市对上,需求的拉动更弱;距离长的城市对上,空间衰减更强。图 2 的北京面板与这句话同向:重力模型把远城方向收得更短。深度重力模型同时使用场所、道路和用地,所以结构更接近观测。由于货运需求本身来自同一张起讫表,而且没有留出时段,这个“更接近”首先是当期拟合,不能直接承诺下一月仍低 15.6% 的 RMSE。
把 53 个特征放在一起,谁还站在距离前面?
模型输出用 SHAP 解释。SHAP 把每个特征对某一次预测的贡献分摊出来,正值表示把模型输出往高推,负值往低推。它解释的是已经拟合的网络,不是修一条路之后车流会增加多少。
全部样本有 53 个特征。图 4 只逐项画出平均绝对 SHAP 最高的 15 项,其余 38 项合并成一行。距离排第一,平均绝对贡献超过横轴 160 的刻度。起点货运需求排第二,条形落在 40 与 60 之间。其后是目的地货运需求、目的地综合市场、目的地工业用地、目的地建材市场、目的地交通枢纽、目的地装饰企业、目的地高速公路、起点工厂、起点工业用地、目的地机械企业、目的地工厂、目的地产业园和起点高速公路。论文没有在正文里列出这 15 项的精确平均绝对值。
方向与重力模型的直觉一致:距离较长时 SHAP 为负,较短时为正,短距离一侧可以超过 2000;两端货运需求较高时,贡献主要在正侧。目的地的综合市场、交通枢纽、装饰企业和工厂较多时,论文认为流量概率上升。图上并不每行都如此干净,建材市场、机械企业和产业园在负侧也有较长尾巴,不能写成任何一类地点越多、货车就越多。高速公路总长度和工业用地面积进入前列,表示模型使用了连通性和生产空间;这仍是同期相关,不是投资效应。
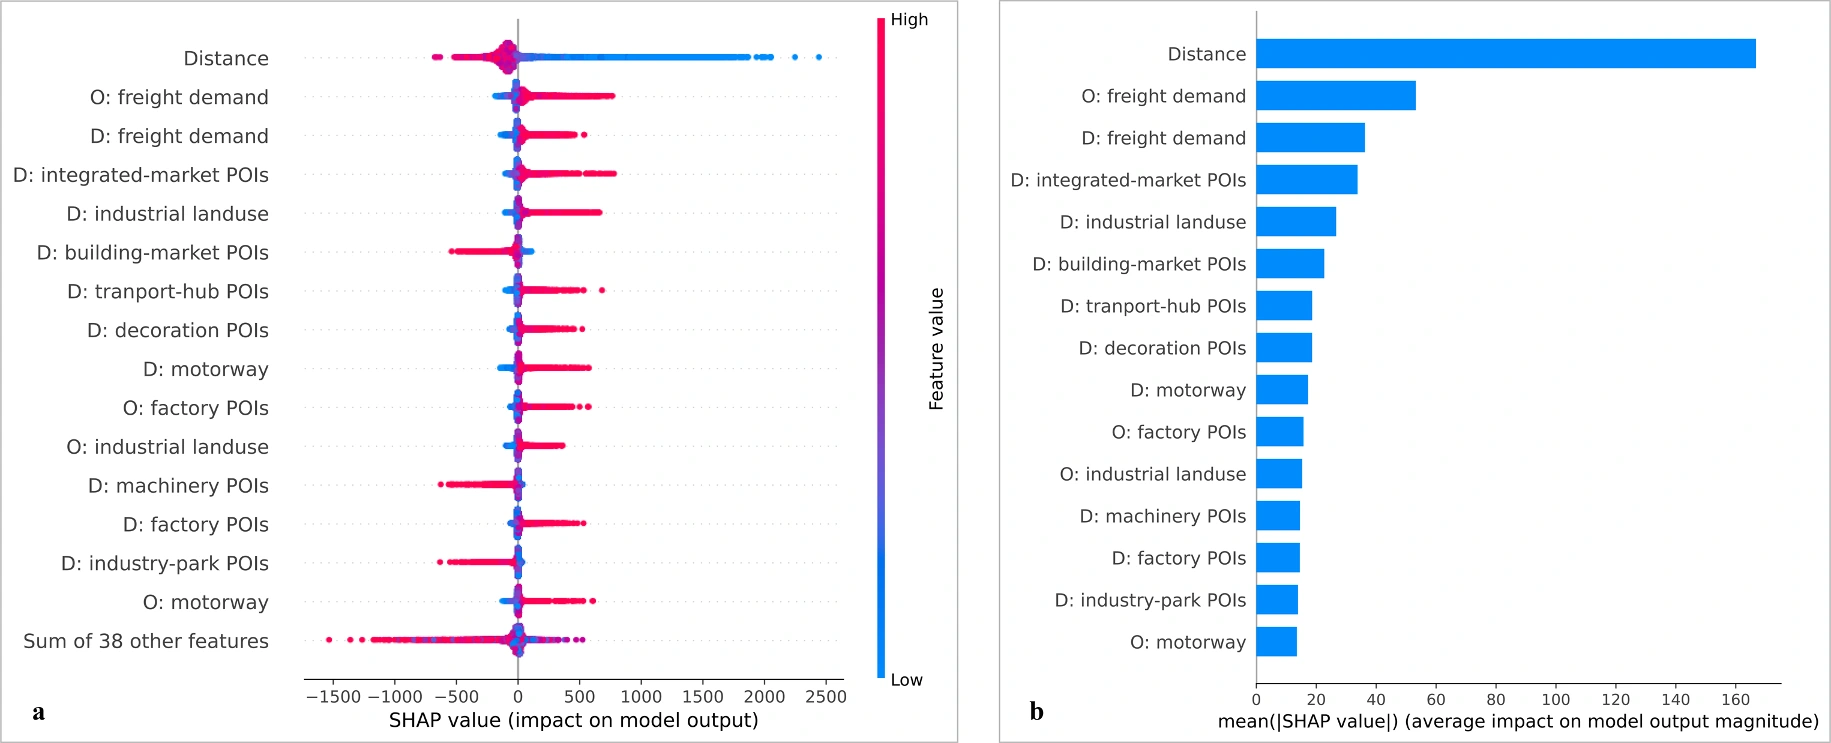
图 4|53 个特征里,哪些对模型输出的影响最大?
(a)每个点是一个城市对。纵轴按重要性从高到低排列,O 表示起点特征,D 表示目的地特征;颜色表示该特征取值高低。横轴是该特征对模型输出的 SHAP 值。(b)前 15 项的平均绝对 SHAP,距离最长,起点货运需求次之。(a)的最后一行是其余 38 项合计,不是第 16 个独立特征;(b)没有把这 38 项再画成一条。平均绝对贡献大,不等于该特征在每一对城市上都同向起作用。来源:原论文 Fig. 4。
距离相同,去和回为什么不是同一个数?
全局排序看不出一对城市内部的差别。作者选了长距离的北京—广州,以及短距离的厦门—福州,并比较每个方向。选择理由是两端货运需求相近,重力模型又只看距离和目的地流入,于是两个方向会被估成几乎一样。图 5 印出的货运需求,也就是流出加流入,北京为 394,489,广州为 477,957,福州为 52,799,厦门为 48,859。北京与广州同属一个数量级,但并不是相等;“相近”是作者的描述。
欧氏距离特征值为:北京—广州 1,883.971,厦门—福州 193.101。四个瀑布图使用同一个基线 E[f(X)] = 288.121。基线和最终输出 f(x) 都远大于 1,所以图上的数字是 SHAP 所解释的模型输出,不是已经落在 0 到 1 之间的概率,更不是行程数。
北京到广州的 f(x) = 1,864.177。距离贡献 −688.09,起点货运需求 +574.97,目的地货运需求 +508.9。广州到北京的 f(x) = 1,728.602。此时广州成为起点,货运需求贡献 +776.71,同一距离贡献 −685.01,北京作为目的地的货运需求只贡献 +242.89。距离相同,两个方向的输出仍差 135.575。
福州到厦门的 f(x) = 1,532.143,距离贡献 +1,320.76,两端货运需求分别为 −161.93 和 −79.77。厦门到福州的 f(x) = 1,163.713,距离贡献 +1,125.62,两端货运需求分别为 −202.69 和 −59.21。短距离城市对上,距离把输出大幅推高,货运需求的贡献转为负。这与北京—广州的符号相反,也是正文所说的空间效应异质性。每个瀑布图还列出市场、产业园、枢纽或高速公路,以及合并后的 43 个其他特征;方向不同,进入前列的特征也不同。这些数值说明模型没有把两个方向当成同一条重力公式,但不能据此说广州比北京更需要货车,或短途货运需求抑制了发车。
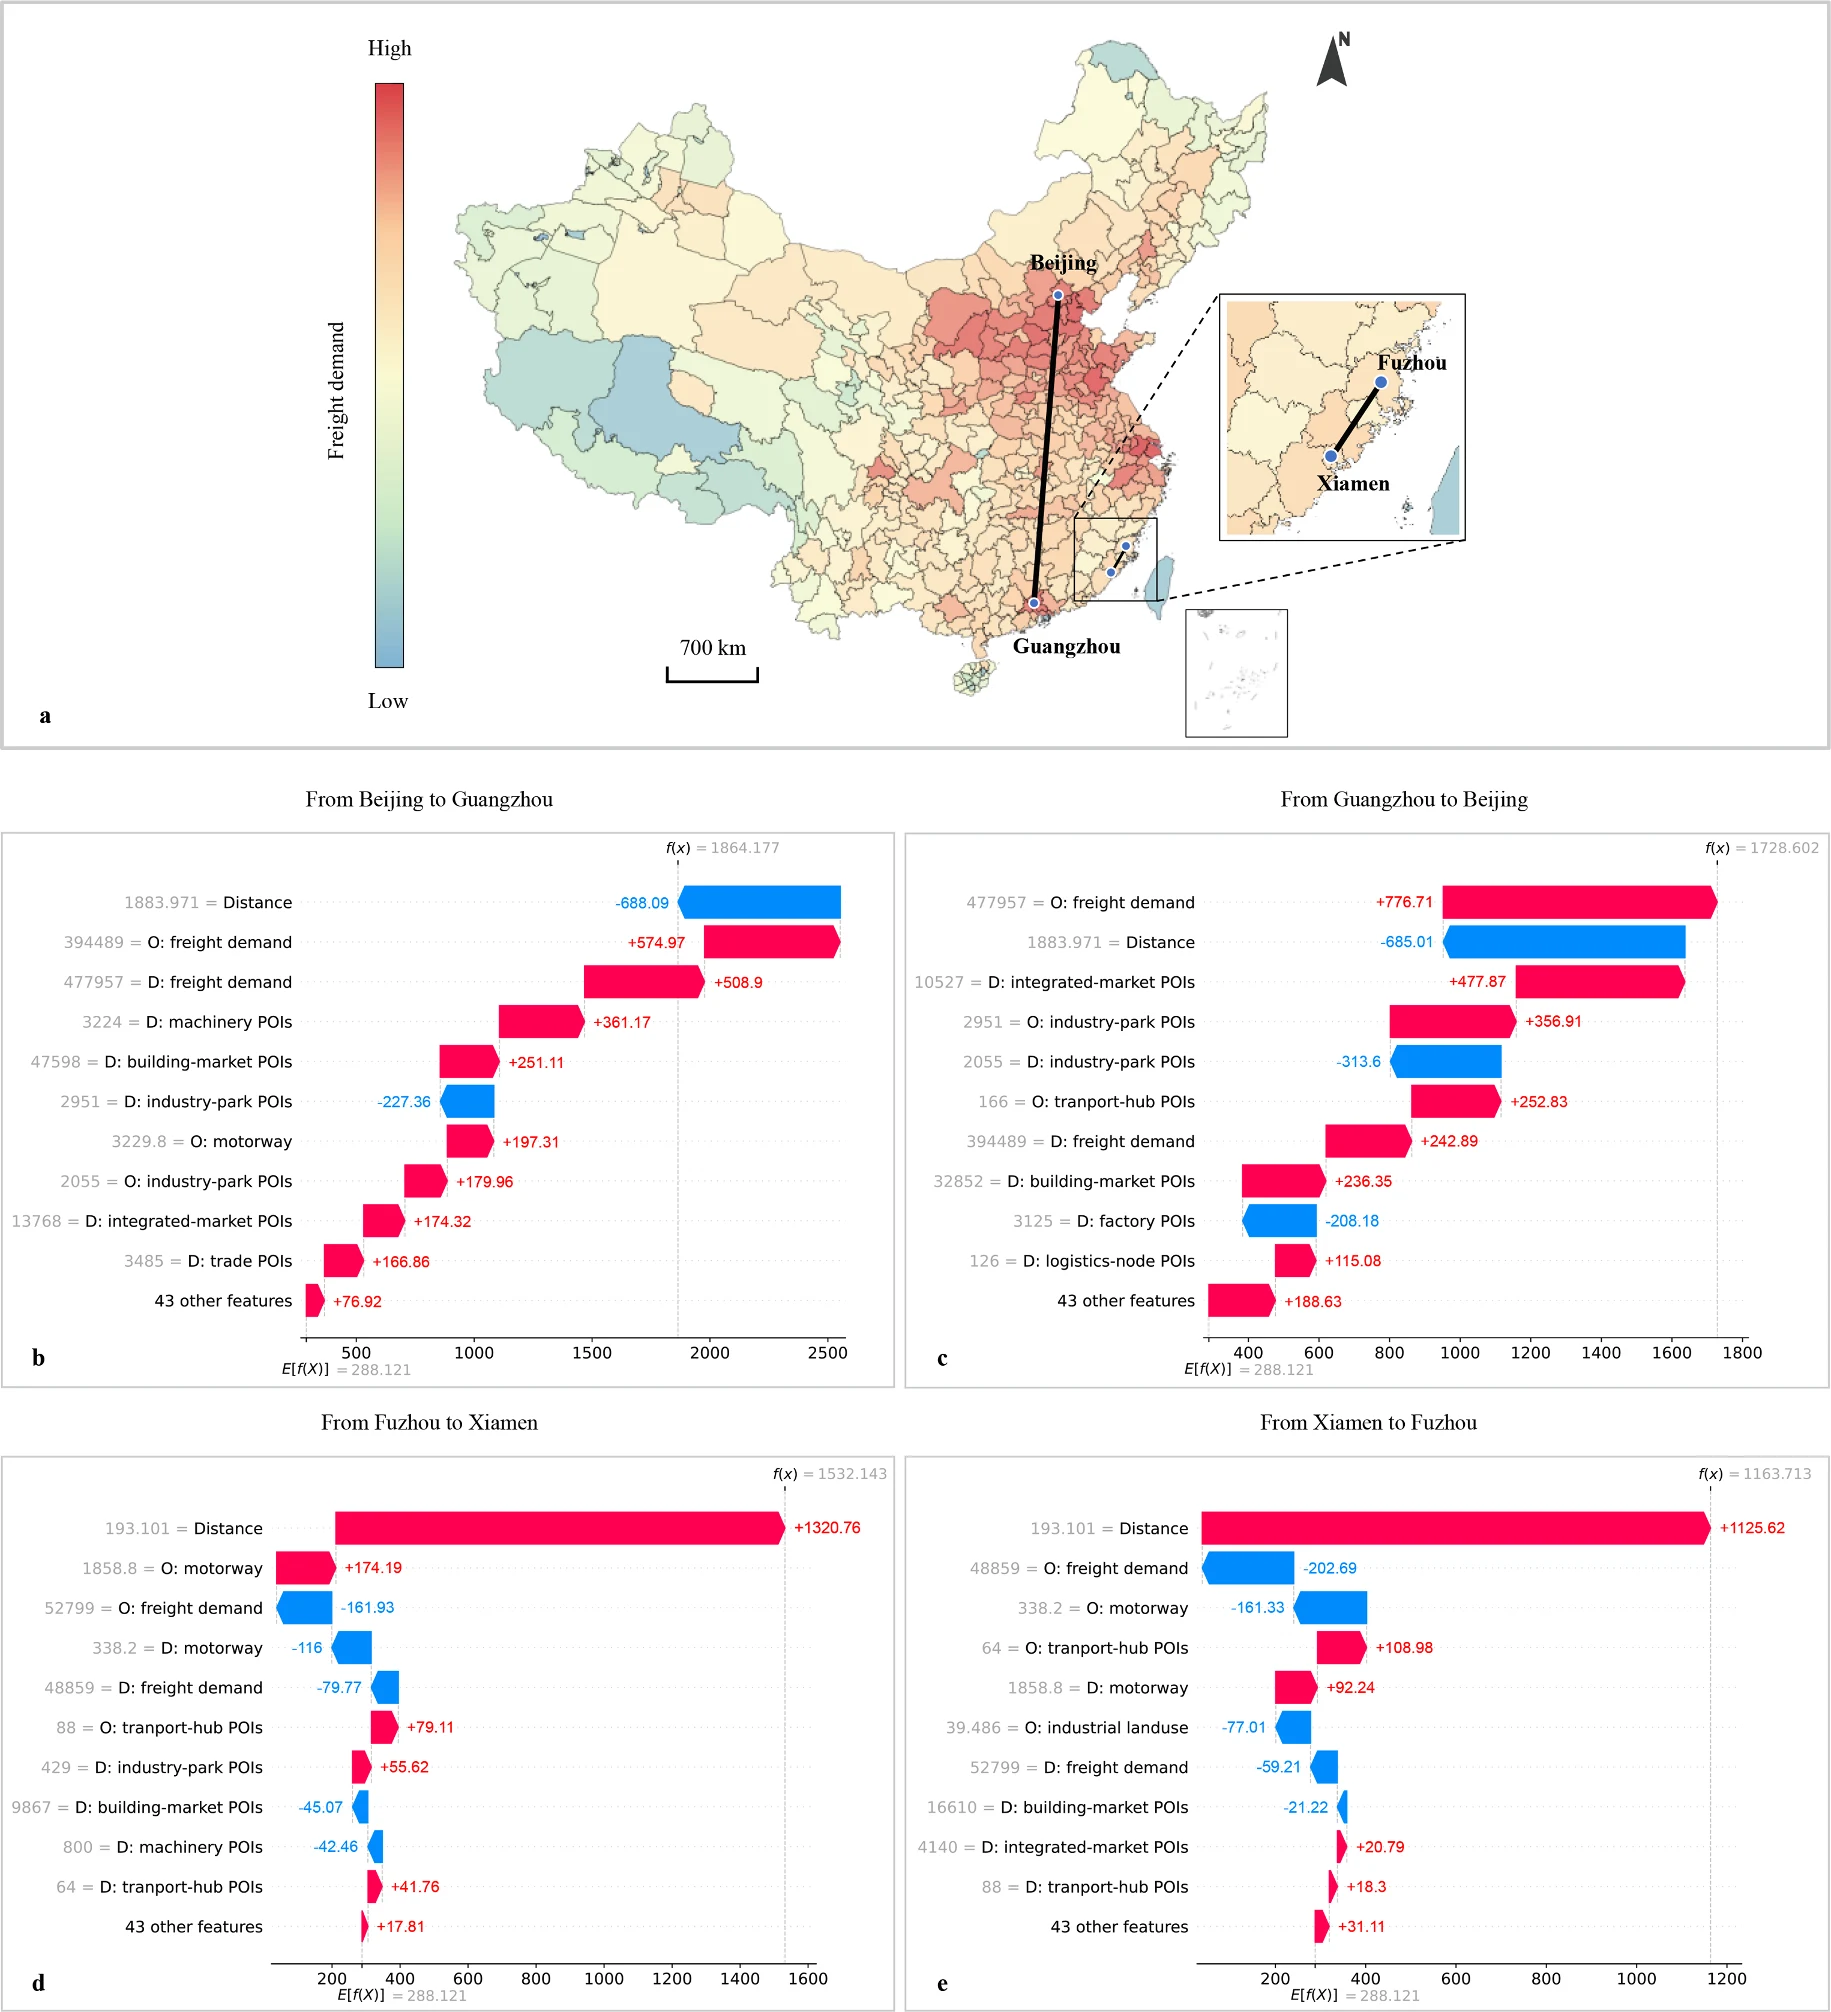
图 5|长距离和短距离城市对上,两个方向的贡献是否对称?
(a)北京—广州与厦门—福州的位置。颜色是各市货运需求,比例尺 700 公里;右下放大图只标出福州和厦门。(b)北京到广州,f(x) = 1,864.177。(c)广州到北京,f(x) = 1,728.602。(d)福州到厦门,f(x) = 1,532.143。(e)厦门到福州,f(x) = 1,163.713。四幅瀑布图的基线都是 E[f(X)] = 288.121。红条为正向贡献,蓝条为负向贡献;左侧数字是该特征取值。距离在(b、c)为负,在(d、e)为正。来源:原论文 Fig. 5。
市场越多,距离的作用会被加强还是抵消?
前一节只看了四条流向。作者进一步计算城市特征与地理距离的 SHAP 交互值,用来描述两个特征一起出现时、相对于各自单独贡献的额外推动。图 6 的纵轴是距离与目的地特征的交互值,不是流量本身。颜色是目的地特征值的对数。横轴是距离,对数坐标;右上角放大图大约从 500 公里画到 3,500 公里。
四张图的目的地特征依次是综合市场数量、工业用地面积、交通枢纽数量和高速公路长度。短距离一侧,特征值较高的红点更多落在正的交互值;放大后的长距离一侧,红点多落到 0 以下,蓝点略高于 0。正文以短于 300 公里和长于 300 公里为例,把前者称为协同、后者称为拮抗:综合市场较多时,短距离上空间效应被加强,长距离上被削弱。工业用地、交通枢纽和高速公路呈现相近的图案。图中没有画出 300 公里的竖线,100 公里附近的散点上下都很宽,不是每个高值城市对都落在同一侧。
交互值为正,表示在这个已训练模型里,两个特征的组合把输出再往上推一截。它不表示新建综合市场就会在 300 公里内增加货车,也不表示长距离市场彼此冲突。货运需求、兴趣点和路网都来自同一研究窗口,SHAP 没有把建设时序分离出来。
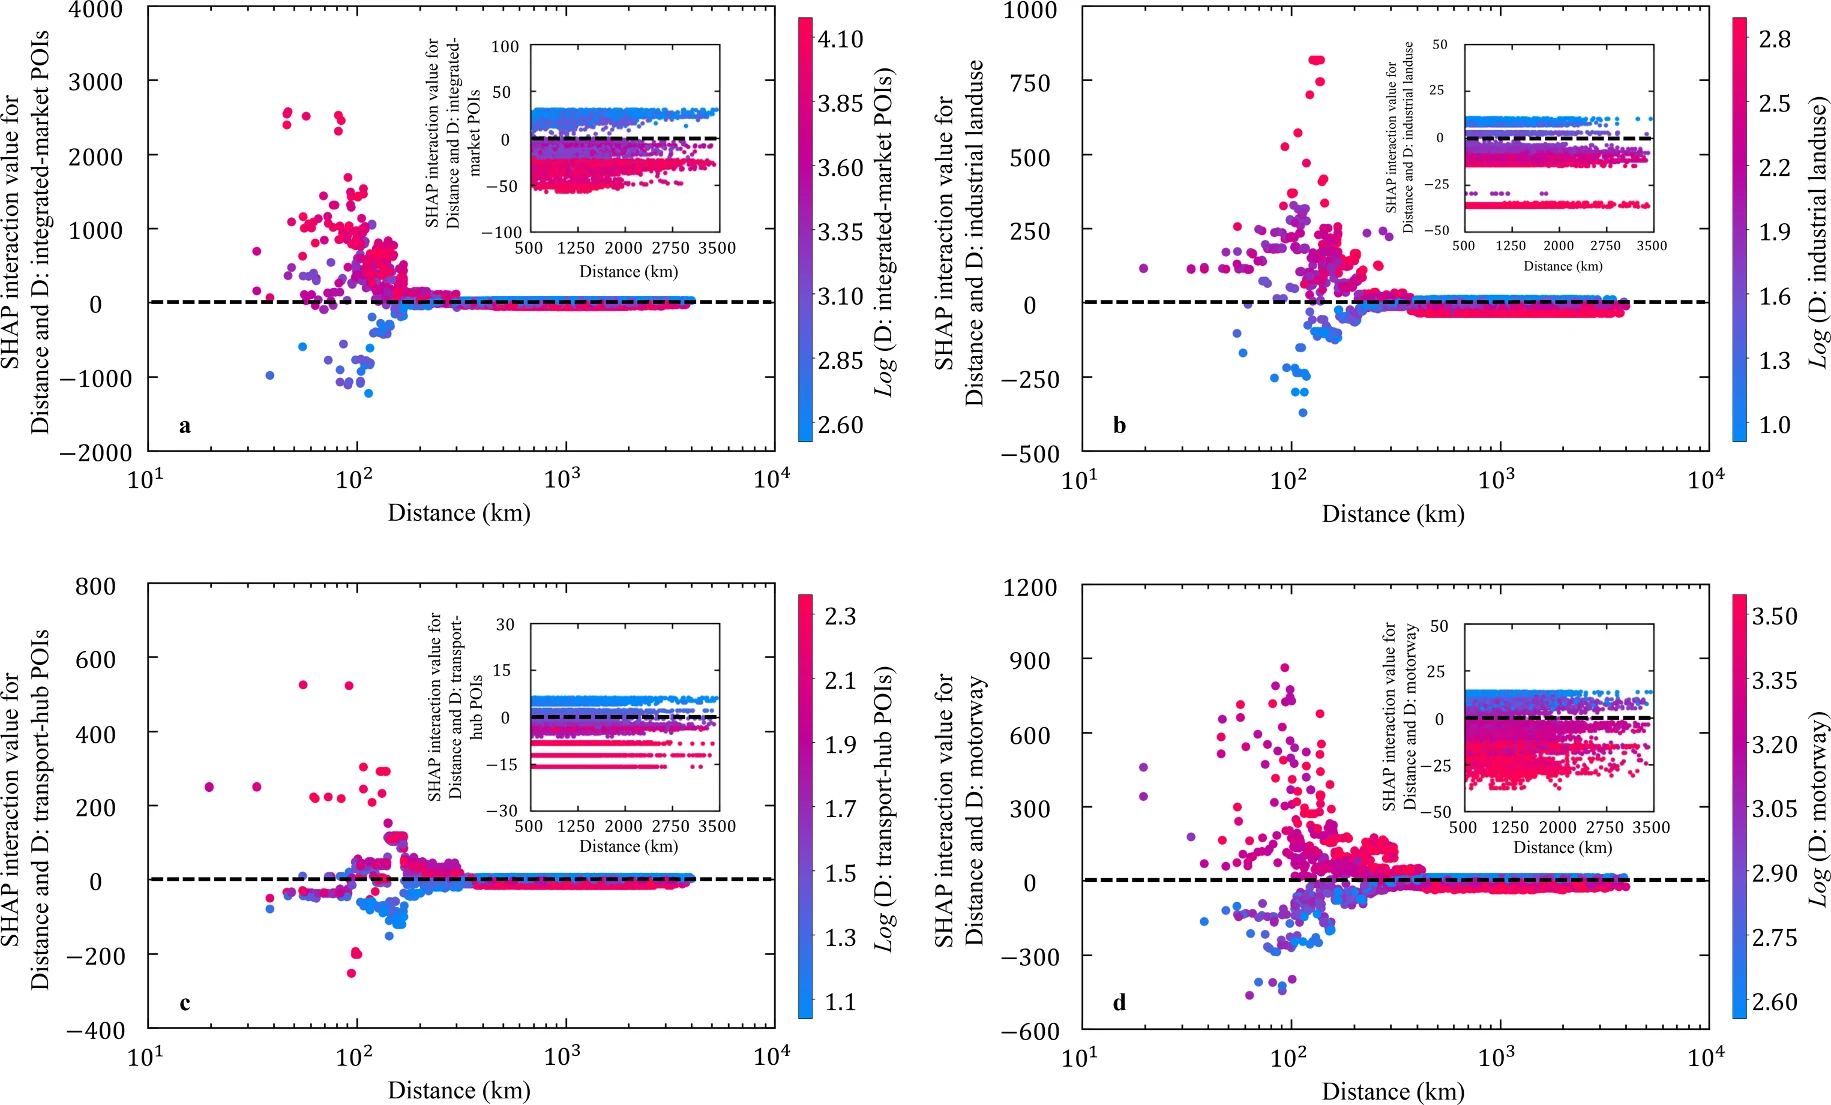
图 6|目的地特征与距离的交互,是否随距离改变符号?
(a)距离与目的地综合市场数量。(b)距离与目的地工业用地。(c)距离与目的地交通枢纽。(d)距离与目的地高速公路长度。每个点是一个城市对。横轴为距离的对数,纵轴为 SHAP 交互值,颜色为目的地特征的对数;虚线是交互值 0。右上角放大长距离段。短距离处高值点偏向正交互,长距离放大图里高值点偏向负交互,散点在 100 公里附近仍然很散。来源:原论文 Fig. 6。
这些比较还留着哪些边界?
模型更接近观测流量,依赖三个已经给定的条件:14 天里识别出的城市对标签、起点总流出,以及由同一张表算出的流出与流入。没有它们,论文没有报告只输入兴趣点和路网时的 CPC。β、γ 和 Npair 也没有公布,重力模型的距离衰减有多陡,无法从正文复核。
时间只是 2018 年 5 月下旬的 14 天。作者说明城际货车常常跑若干天,所以不用客运那种按小时波动的窗口;这也意味着结果不是全年、不是其他季节,更没有纳入灾害或政策冲击。欧氏距离是直线距离,不是路网里程、收费或行程时间。兴趣点分类和 OpenStreetMap 覆盖是否完整,论文没有另做误差评估。停车识别来自先前论文,本文没有重复报告误分临时停车的比例。
SHAP 的全局重要性、四个城市对和交互图,都是对这一网络输出的分解。未出现在前 15 项里的特征,仍可能在个别城市对上重要,图 5 用 43 个其他特征的合计保留了这种可能。政策含义,例如按城市对制定规则、短途和长途分别配置枢纽,是作者从解释结果作出的建议,不是本文实施过的政策实验。
一句话总结
在起点流出已知的这 14 天里,加入货运场所、道路和用地后,深度重力模型比单约束重力模型更接近地级市之间的重型货车流量;距离和货运需求仍占主导,但长短距离上距离的方向相反,而且这还不是脱离当期流量的未来预测。
核心来源
- Transportation Research Part E 正式发表页,核对题目、作者、卷期与 DOI:179 (2023) 103320。正文收到日期为 2023 年 4 月 14 日,修回为 9 月 18 日,接受为 10 月 5 日。
- 本文图表和数值来自该正式版正文 Fig. 1–6。文中没有附录,也没有把补充材料中的表格或图作为证据。
- 数据声明为向作者索取后提供。文中给出的公开入口是全国道路货运车辆公共监管与服务平台、高德开放平台和 OpenStreetMap。平台可访问,不等于本文用到的轨迹、兴趣点切片和模型权重已经公开。
- 深度重力框架来自论文引用的 Simini、Barlacchi、Luca 与 Pappalardo,A Deep Gravity model for mobility flows generation,Nature Communications,2021,12:6576。行程识别来自论文引用的 Yang 等,Transportation Research Part E,2022,157。
作者介绍
以下只采用论文署名机构、通讯作者标注和 CRediT 贡献说明。
- Yitao Yang:署名北京交通大学系统科学学院,以及代尔夫特理工大学土木与地球科学学院交通与规划系。负责概念、形式分析、调查、方法、可视化和初稿。
- Bin Jia:通讯作者,署名北京交通大学系统科学学院,以及西安工业大学经济管理学院。负责概念、指导、基金、项目管理以及审阅修改。
- Xiao-Yong Yan:通讯作者,署名北京交通大学系统科学学院。负责概念、指导、基金、方法和审阅修改。
- Yan Chen:署名北京交通大学交通运输学院。负责方法和审阅修改。
- Dongdong Song:署名北京交通大学系统科学学院。负责方法和审阅修改。
- Danyue Zhi:署名北京交通大学系统科学学院。负责审阅修改。
- Yiyun Wang:署名教育部道路与交通工程重点实验室(上海),以及代尔夫特理工大学交通与规划系。负责审阅修改。
- Ziyou Gao:署名北京交通大学系统科学学院。负责基金和审阅修改。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果物流公司真想用这个框架安排下一月的车和司机,首先要拿开当期流量。现在的货运需求是这 14 天流出与流入之和,预测流量又乘以这 14 天的起点流出,模型实际上在重新分配一张已经数完的表。更有信息量的检验,是用前一段时间的场所、路网和需求训练,再去对上稍后一段时间、且不再喂入该时段流出流入的城市对。若 CPC 从 0.7854 明显跌向重力模型的 0.6723,说明当前提升主要来自同期边际量,而不是地图特征本身。
北京到广州与广州到北京的距离都是 1,883.971,输出却是 1,864.177 和 1,728.602。调度若只保存一条无方向的城市对强度,会把这个差距抹平。值得单独检验的是空驶回程:去程由目的地市场推高、回程由另一套工厂或枢纽推高时,两个方向的车辆需求不会同时出现。图 6 里 300 公里只是正文举例,长距离放大图大约从 500 公里才开始,因此不适合直接写成“300 公里以内鼓励市场聚集、300 公里以外改为多式联运”的规章界限。