同一条定位记录,怎样才算一次停留、一次出行?
论文名片|Henry Martin、Ye Hong、Nina Wiedemann、Dominik Bucher、Martin Raubal,Trackintel: An open-source Python library for human mobility analysis,Computers, Environment and Urban Systems,2023,101:101938,2023年2月7日在线发表。DOI:10.1016/j.compenvurbsys.2023.101938。收稿日期2022年8月4日,修回2023年1月5日,接收2023年1月12日。开放获取(CC BY)。代码见 mie-lab/trackintel。本文依据期刊正式版;这是一篇方法论文,用四份已有追踪数据演示同一套管线。
一个人的手机或 GPS 记录器会留下一串带时间的点。下一地点预测里,Feng 等人的 DeepMove 把每条原始位置记录当作一个地点,不做停留提取。同一类问题上,Urner 等人先从 GPS 点里抽出停留至少一段时间的停留点,再用 k-means 收成地点。Solomon 等人用 mean shift 找停留点,再按距离阈值合并成地点。三套做法都在处理人类移动性(human mobility,人在空间中的日常移动)。模型排名还没开始,地点这个词所指的记录就已经不同。
Trackintel 把交通规划里以活动为中心的层级做成公开的 Python 库,让停留、出行段、出行、地点和巡回的生成规则连同参数一起留下来。四份来源不同的轨迹因此可以放进同一张表。表上的差别同时来自参与者、设备和标签来源;这套管线公开的是处理过程,四组参与者不能代表全体城市居民。
先说结论
- 库把个体移动收成六层:定位点、停留点、出行段、出行、地点和巡回。只有标成活动的停留点才能作为一次出行的起点和终点;等车这类非活动停留留在出行内部。
- 表1按六项文档清单给 Trackintel 打 6 分,并报告单元测试覆盖率 98%。作者的比较结论是:把轨迹汇总到地点、出行和巡回的这整套聚合,在所比较的库里由 Trackintel 提供。98% 衡量的是单元测试覆盖了多少代码。
- 案例里,只有 Geolife 从定位点生成停留:半径 100 米、至少 30 分钟,相邻点相隔超过 24 小时就不能属于同一个停留。另外三份数据由应用事先给出停留点和出行段。四份数据随后共用的地点聚类是 DBSCAN,ε 为 30 米,最少样本数为 1;出行的时间缺口阈值为 25 分钟;巡回的起终点距离阈值为 100 米,允许的空间缺口为 0,默认最长 24 小时。
- 正文给出的合计是 769,957 个停留点和 1,123,931 个出行段。表4的人均每日出行次数,Green Class 1、Green Class 2、yumuv、Geolife 依次为 4.32、3.80、3.13、1.70;人均时间覆盖率均值为 0.85、0.75、0.77 和 0.4。Geolife 的出行段数与出行数相同,每个出行平均 1.00 个出行段,作者说明这是参数使出行段无法合并的结果。
- 按出行段次数和按出行距离,方式构成会变。Green Class 与 yumuv 的工作停留能看出大约 8 时到 17 时以及午休;Geolife 的家可以被标出,工作地的日内曲线则没有同样清楚的白天高峰。yumuv 研究本身分了对照和处理,这篇案例没有比较这两组。
预测下一地点之前,大家说的地点是同一个东西吗?
过去十多年,大样本轨迹被用来描述连续位移的幂律、停留时间、回转半径,以及少数人在少数地点度过大部分时间。这些结果依赖信息与通信技术和位置服务里的数字痕迹。分析时要先把 GPS 点或手机基站记录变成一个人去做某件事的地点,原始点本身还没有这层含义。各研究因此自己做预处理。定义一变,后面的模型就在不同的输入上比较。
已有程序库覆盖了轨迹的一部分工作,很少把人类移动的活动层级一次做完。Joo 等人调查过 58 个 R 的移动分析包,许多面向动物行为,统计轨迹范围、时长和距离。Python 里,MovingPandas 基于 Pandas 和 GeoPandas,侧重轨迹的拆分、合并和可视化;表1给它的文档分是 6、测试覆盖率 96%,停留点检测可用,汇总到地点、出行和巡回则不可用。scikit-mobility 侧重移动性指标、合成轨迹和隐私风险。正文认为这两套库的数据模型分别偏向移动轨迹和流动,活动、出行和巡回这些个体移动概念留在模型外面。Trackintel 要补的是 Axhausen 2007 年那套、后来在地理信息科学和交通规划里常用的活动分析框架。
表1的文档分来自 pyOpenSci 和 ROpenSci 的六项清单:开源许可证、带安装说明的 README、示例、测试、持续集成、以及给函数配示例的文档。Trackintel 六项都有,所以是 6 分。轨迹统计一栏,Trackintel 标的是基础(+),scikit-mobility、MovingPandas 标的是丰富(++)。这张表比较的是功能有没有实现,不是哪一个科学结论更可靠。
活动、停留和出行,在这套管线里各是哪一层?
Trackintel 面向个人或物体的移动,功能都按用户标识分开计算,群体在地点之间的总流量不是它的基本单位。实现靠 Pandas 和 GeoPandas 的 accessor,时间字段必须带时区。六个类都要有规定列名才算合法对象,额外列可以保留。
定位点(positionfix)是最小记录,例如 GNSS 点或呼叫详单(CDR)里的时间位置。它分不出移动和活动,通常是原始数据进入模型的入口,再被切成停留点和出行段。
停留点(staypoint)表示一个人在给定地理半径内停留达到给定时长。它可能是有目的的活动,也可能只是等车。活动停留才是出行的理由;非活动停留只能成为出行的一部分。停留点还可以在空间上收成地点。
出行段(tripleg)在 Axhausen 的用语里对应 stage:不更换交通方式、也不更换车辆的一段连续移动。方式如果已知,记在 mode 里。出行段由定位点生成,再向上收成出行。
出行(trip)概括两次活动停留之间的全部出行段和非活动停留,并继承目的地停留点的活动目的。在这套模型里,出行和活动是交通规划最关心的一层。
地点(location)描述的是地方本身,而不是某一次到访。停留点上的信息绑定这一次停留的时间和活动;地点上的信息可以是土地利用或营业时间。地点有两种几何:中心点,以及表示范围的多边形。
巡回(tour)是从同一地点出发并回到该地点的一串出行。从家出发再回到家的巡回可以标成 journey。巡回可以嵌套:工作地到咖啡馆再回工作地,可以同时属于一个更大的家—工作—咖啡馆—工作—家。因此出行和巡回是多对多:一个巡回含多条出行,一条出行也可以属于多个巡回。
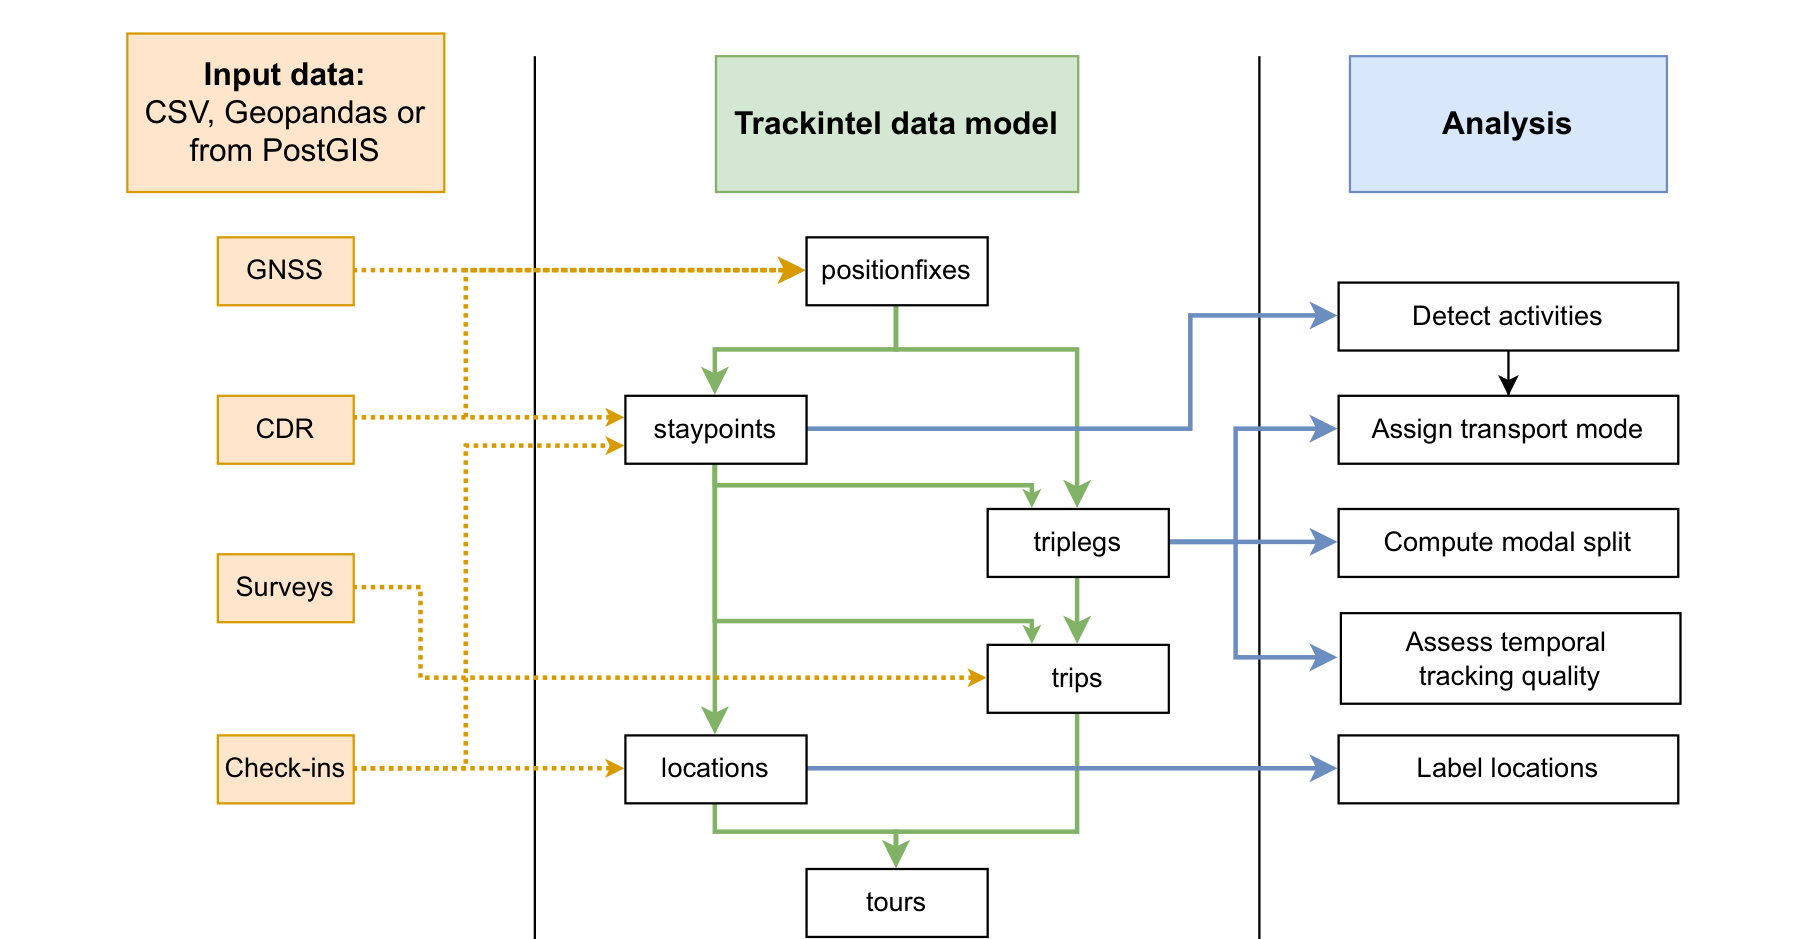
图 1|不同来源的数据从哪一层进入,分析功能接在哪一层后面?
左侧是输入:CSV、GeoPandas 或 PostGIS。GNSS 的箭头进入定位点,CDR 进入停留点,签到的箭头指向地点;调查数据的虚线分叉。中间六层用实线相连,停留点向下到地点,出行段向下到出行,地点再向下到巡回。右侧分析包括识别活动、标注交通方式、计算方式构成、评估时间覆盖和给地点加标签。正文另写过一种入口:基于位置的社交网络签到可以表示没有定位点的停留点。图上签到指向地点,这段文字把签到当作停留点,两处入口不一致;案例没有使用签到数据。来源:原论文 Fig. 1。
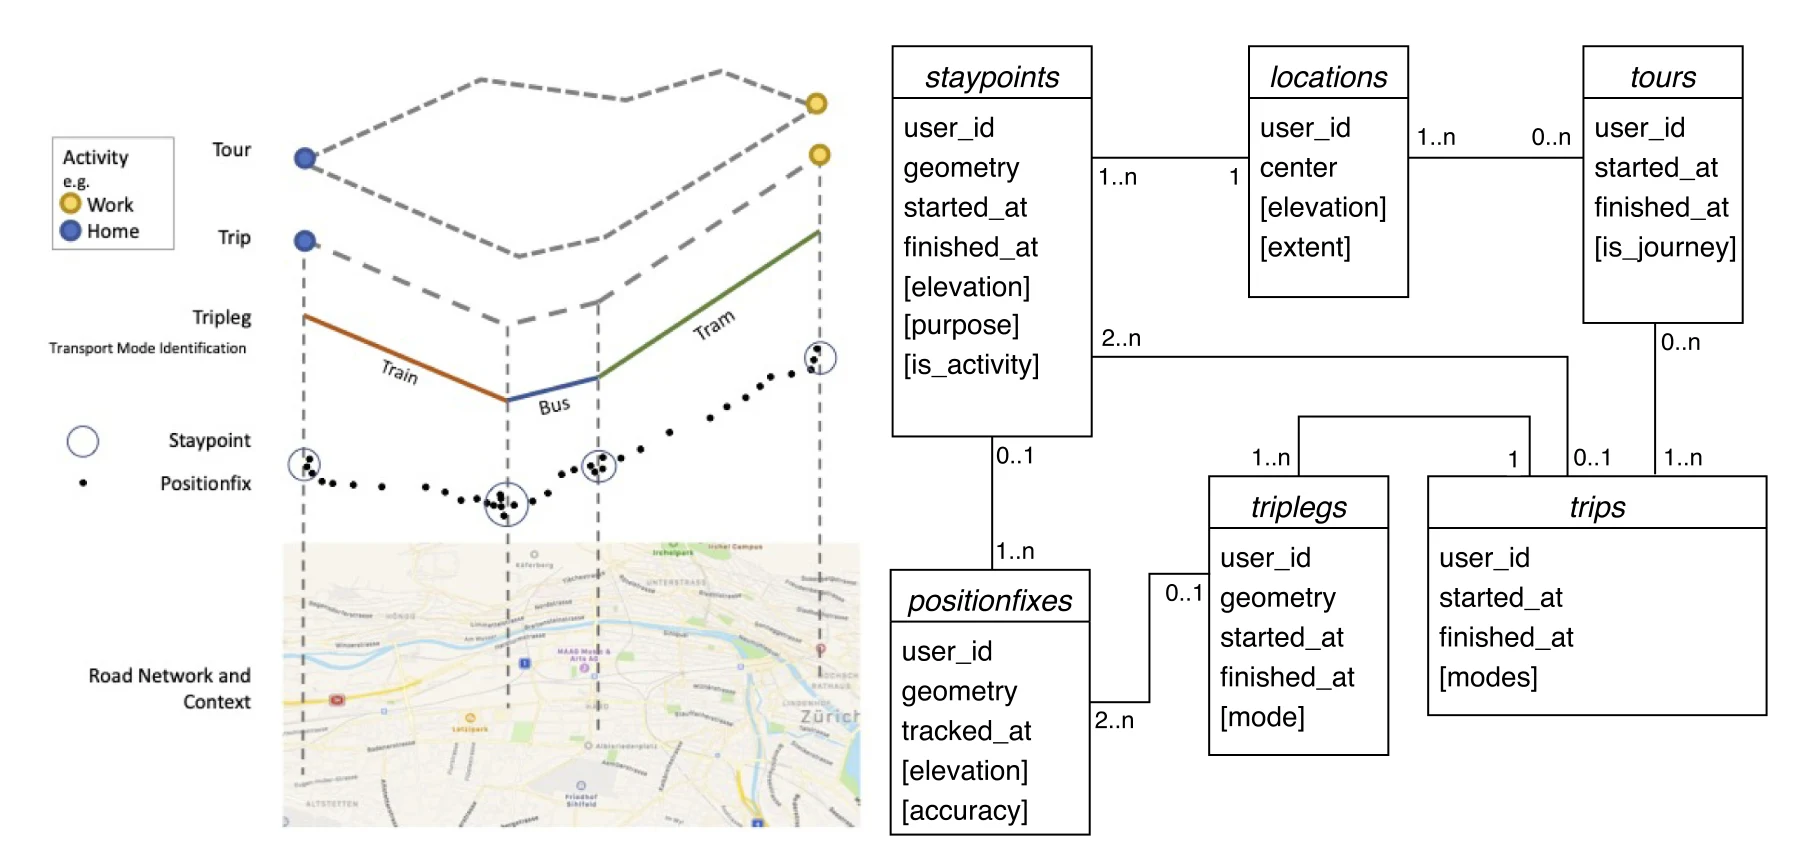
图 2|一次从家到工作和再外出的活动,在空间上分成哪几层,类之间如何连接?
左侧是示意图:黑点是定位点,空心圆是停留点,彩色折线是已标方式的出行段,虚线多边形是巡回,黄点和蓝点示例工作和家。底图是道路。右侧是 UML。方括号里是可选字段。停留点的可选字段包括 purpose 和 is_activity;地点有中心,范围和海拔可选;巡回有起止时间和可选的 is_journey。表2的巡回字段名写成 journey,出行的可选方式写成 primary_mode;图2把这两处画成 is_journey 和 modes。正文叙述停留点时还用过 activity_flag。图表之间的列名不完全相同,论文没有说明哪一个是代码里的最终列名。来源:原论文 Fig. 2,图由 Jonietz 与 Bucher 2018 年的图改绘。
表2把各类的必填列写死了。所有记录要有 id 和 user_id。定位点要有 tracked_at 和点几何;停留点、出行段、出行和巡回要有起止时间;地点要有中心点。出行必须能指回起点和终点停留点的标识。这些列名是后面生成函数的输出合同。
生成停留、地点、出行和巡回时,比较的到底是什么?
停留点沿用 Li 等人 2008 年的滑动窗口,后来被 Zheng 综述为常用做法。对每个人按时间扫定位点,把同时满足距离阈值和时间阈值的一串点收成一个停留点。起止时间来自这串点的第一个和最后一个,几何取这些点的平均坐标。库比原算法多一个参数:相邻定位点相隔超过这个时间,就不再算进同一个停留点,用来切开追踪中断。
地点由停留点聚类得到。文献里用过社区发现、OPTICS、mean shift 和 DBSCAN。这里实现最常用的 DBSCAN。ε 是多近的停留点会并进同一个地点;最少样本数是至少多少次停留才形成一个地点,也就是把一个地方看成值得保留需要几次到访。地点中心是簇内停留点的平均坐标,范围是这些停留点的包围盒。聚类可以按每个用户分开做,避免一个地点被拉得过大;也可以把全体用户的停留点放在一起,得到火车站、商场这类跨用户共用的地点。
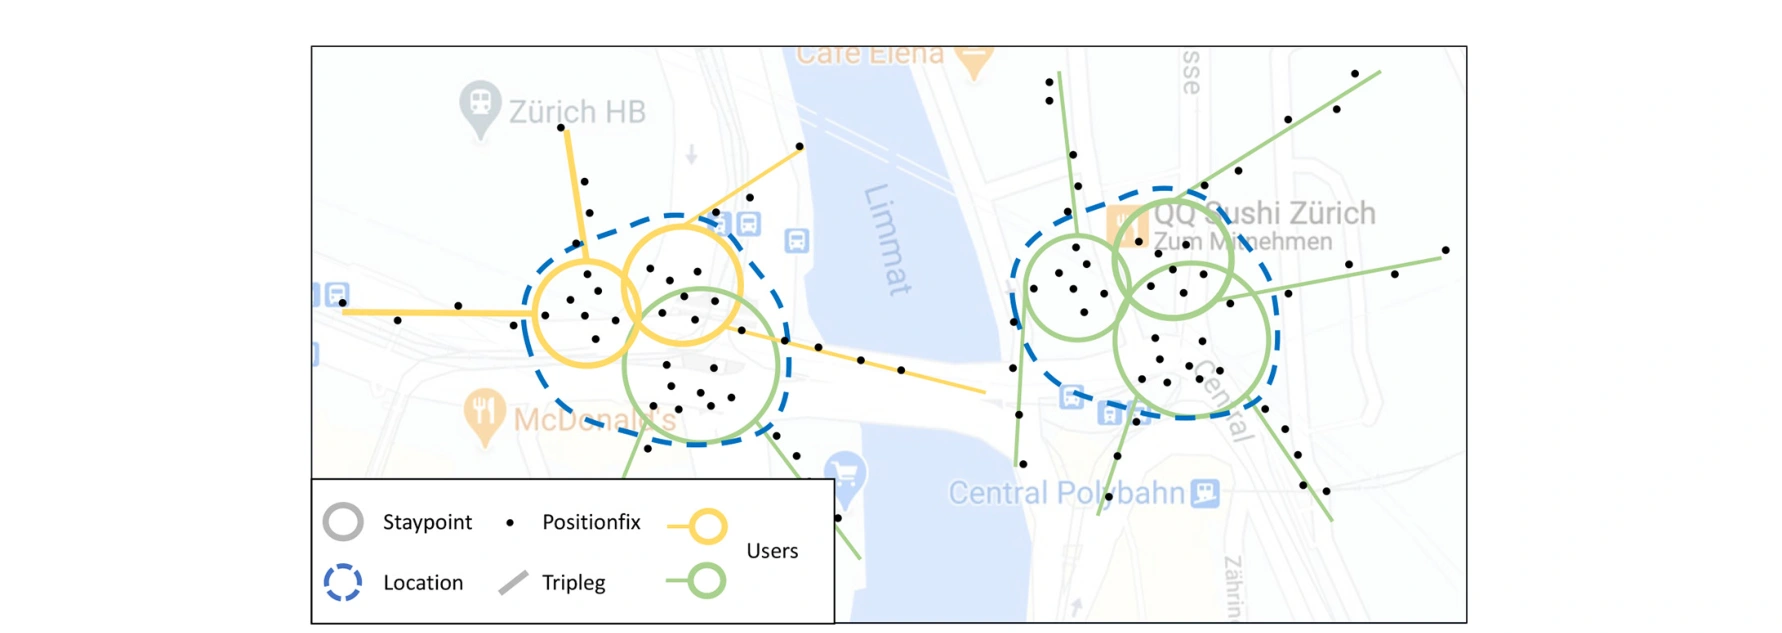
图 3|同一些停留点,按全体用户聚类和按单个用户聚类,地点边界有什么差别?
底图在苏黎世火车总站附近。黑点是定位点,灰线是出行段,空心圆是停留点,彩色实线圆表示用户,蓝色虚线圆是地点。左侧把不同用户的停留放进同一批地点,右侧只使用一个用户的停留,地点跟着这个人的重复到访走。这是关系示意,不是案例四份数据的统计结果。来源:原论文 Fig. 3。
出行段的生成规则很直接:不属于任何停留点的定位点都被视为在移动。已经带有停留点标识的定位点中,相邻两个停留点之间的点按时间连成线,起止时间同样继承第一个和最后一个点。一个人只要不在停留里,这段轨迹就会变成出行段;短时间的定位噪声也会进线。
出行把两次活动停留之间的移动和非活动停留收成一行,并维护出行与停留点、出行段的标识,方便回到原始记录。时间缺口大于阈值 θtrip_gap 时,算法假定中间发生了没被记录到的活动,当前出行的终点和下一出行的起点记为未知。缺口的定义来自 Zhao 等人:追踪信号缺失超过给定时长。出行几何默认由起终点停留点组成;起点未知时改用第一段出行段的第一个点,终点未知时用最后一点。
巡回没有统一的旧算法。Trackintel 采用较宽的定义,保留嵌套,过滤留给使用者。按时间遍历出行,并维护一份可能作为巡回起点的候选。每条出行先检查它和上一条是否在空间上接得上:若有带地点标识的停留点表,就比较上一条的终点地点和这一条的起点地点;否则用距离阈值 θmax_dist。空间上接不上就算一个缺口。θmax_gaps 控制一个巡回内部允许多少个空间缺口,起点和终点本身不允许缺口,因为巡回必须回到同一地点,或起终点停留点落在允许距离内。接着从最近的候选往回找,先发现最短的巡回。候选起点和当前终点的地点或距离相符,并且缺口数不超过阈值、时长不超过 θmax_time(默认 24 小时),这些出行就组成一个巡回。
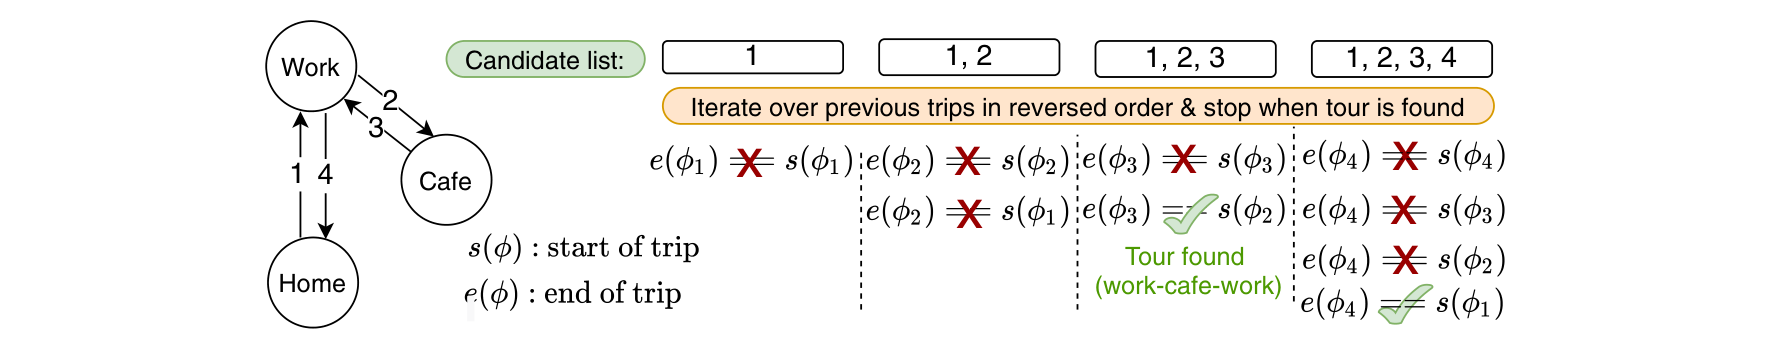
图 4|家、工作和咖啡馆之间的四条出行,怎样找出嵌套的两个巡回?
左侧三个圆是家、工作和咖啡馆,箭头标出四条出行的顺序。右侧候选列表从只有第 1 条,增长到 1–2、1–2–3、1–2–3–4。算法倒序检查当前出行的终点是否回到某个候选的起点。处理到第 3 条时先找到工作—咖啡馆—工作;处理到第 4 条时再找到包含它的更长巡回。一条出行因此可以同时属于两个巡回。来源:原论文 Fig. 4。
读写支持数据框、CSV,以及带 PostGIS 的 PostgreSQL。每种类型在读入时检查字段。Geolife 的原始记录可以直接读成定位点,并有函数把部分参与者单独提供的交通方式贴回去。轨迹可以用 Douglas–Peucker 算法简化。同一人、同一地点、时间上相邻、中间没有出行段、间隔短于阈值的两个停留点可以合并。案例报告的数字没有单独给出简化或合并这两步的效果。
交通方式和家、工作是测出来的,还是标出来的?
库不假定用户填了方式,也不假定有加速度计。出行段的速度用折线长度除以整段时长近似,再按平均速度划分:低于 15 km/h 为慢速,低于 100 km/h 为机动,高于 100 km/h 为快速。正文没有规定恰好等于 15 或 100 km/h 时归入哪一类。堵车、室内断点和没有地图匹配的绕路都会改变这个速度。作者把这叫做简单启发式,并写明以后可以换更细的方法或地图匹配。案例没有报告这套规则相对真实方式的准确率。
家和工作用的是 Efstathiades 等人 OSNA 算法的改写。工作日被分成休息、工作和休闲三段。休息和休闲时段里累计停留最久的地点标为家,工作时段里最主要的地点标为工作。原算法用带地理标签的推文估计停留小时,这里改用停留点的起止时间。另一条更快的规则是:到访更多的两个地点依次标成家和工作。两种做法都可以先丢掉停留次数太少或停留太短的地点。
方式构成可以按出行段条数、按各人出行段时长之和,或按出行距离计算,再按用户或整份数据、按周或按月汇总。时间覆盖率(temporal tracking quality)是此人行迹被记录到的时间比例,可以算到每天、每周或整个研究期,也可以比较一天中的各小时和不同星期几。它衡量的是时间上缺了多少,不是定位在空间上偏了多少米。
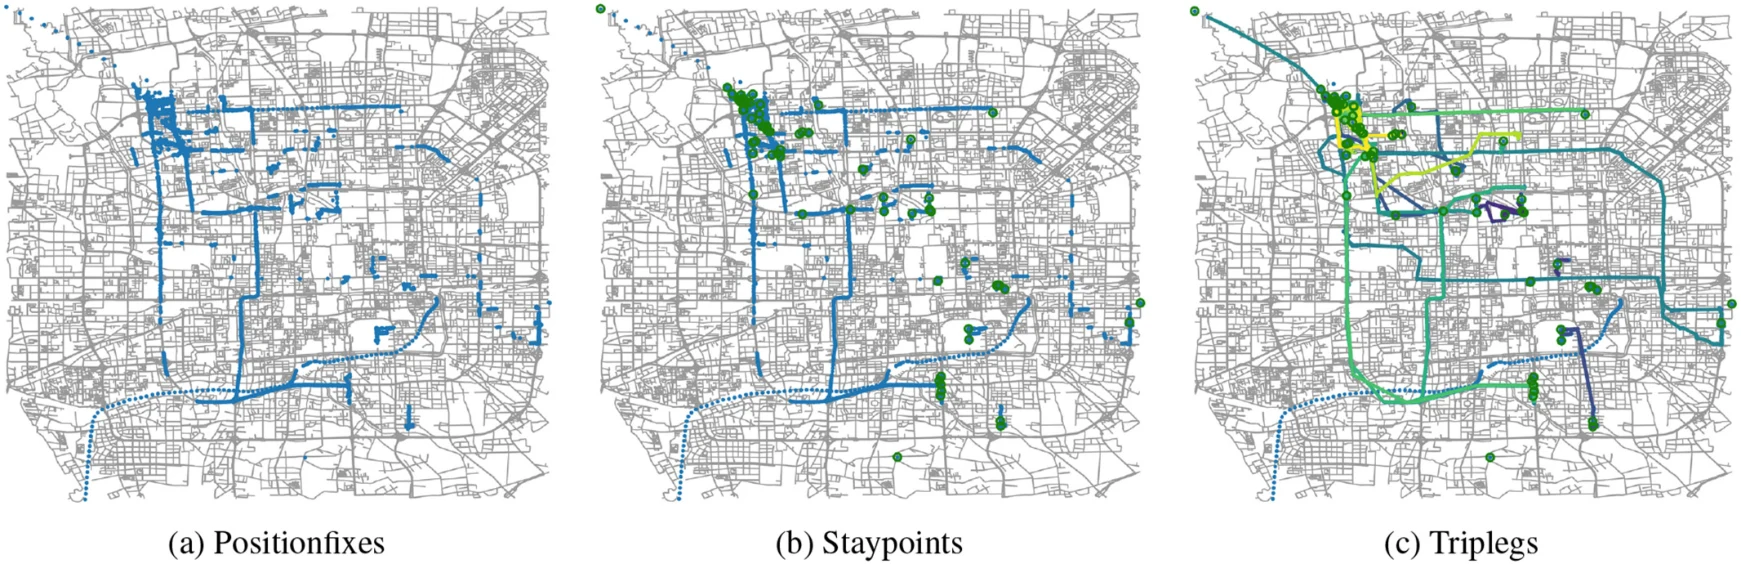
图 5|同一个人的三种几何,叠在同一张路网上有什么差别?
这是 Geolife 中一名参与者,背景来自 OpenStreetMap。(a)蓝色折线是定位点连成的轨迹,跟着路网铺开。(b)在同样的轨迹上用绿点标出停留点,点集中在少数地方。(c)把出行段画成多色折线,图内没有方式图例,颜色对应哪种交通方式没有在图中标明。三幅图展示的是绘图函数,统计对象是这一名参与者。来源:原论文 Fig. 5。
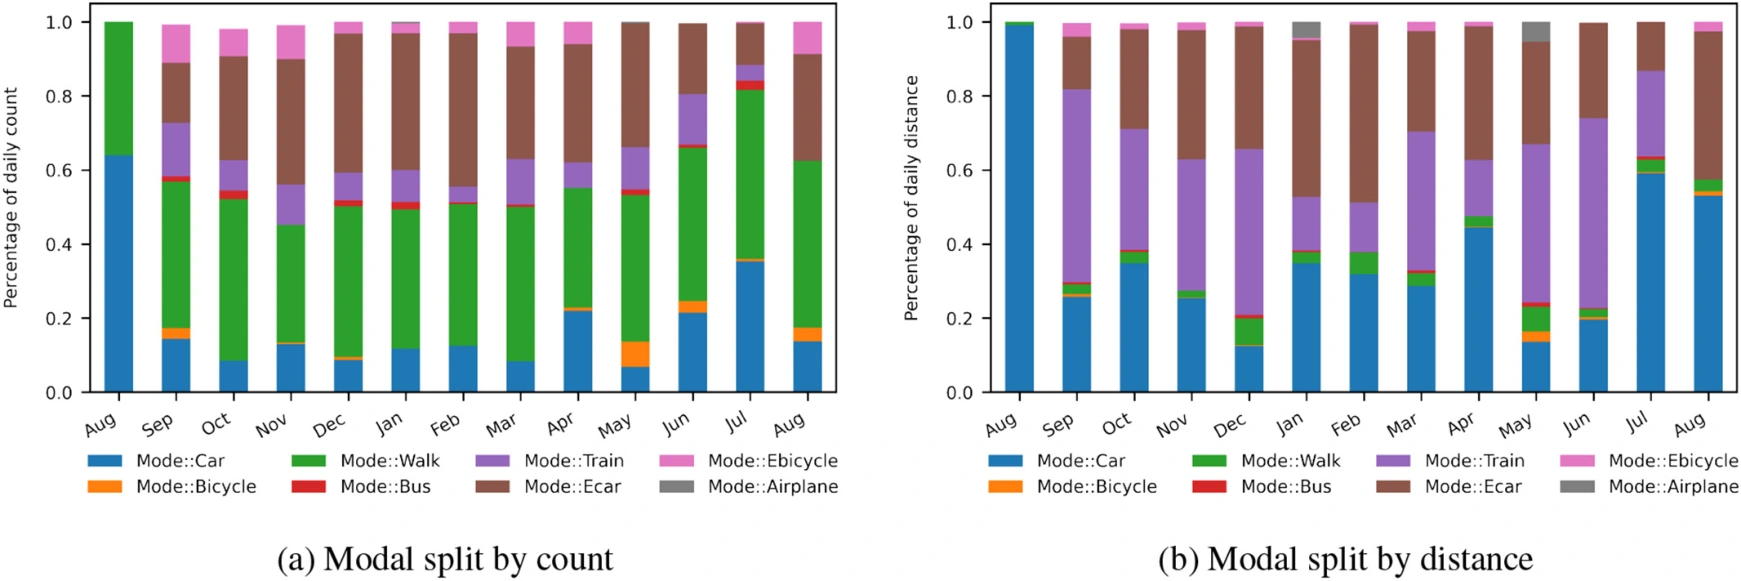
图 6|同一个人的各月出行,按次数和按距离会不会把同一种方式看成主导?
仍是 Geolife 的一名参与者,横轴从第一个 8 月到次年 8 月,图例有小汽车、自行车、步行、公交、火车、电动自行车、电动小汽车和飞机。纵轴印刷为每日次数的百分比和每日距离的百分比,刻度是 0 到 1.0,表示该月份额。(a)第一个 8 月的柱子几乎全是步行。(b)同一个月按距离几乎全是小汽车。后面各月两种算法都混有火车、电动小汽车和步行,但同一颜色在左右两幅图里的高度不同。柱上没有印出精确百分比。这名参与者的细类标签也说明,图6用的是多类方式,不是全库只有慢速、机动、快速的那条速度规则。来源:原论文 Fig. 6。
四份轨迹放进同一套管线,数字差在哪里?
案例从 PostGIS 读入四份数据,再比较时间覆盖、出行特征和方式构成。Geolife 是微软亚洲研究院员工用 GPS 记录器留下的公开数据。Green Class 1 和 Green Class 2 与瑞士联邦铁路合作:参与者都可以使用瑞士全部公共交通;第一项另外得到一辆电动车,第二项得到一辆电动自行车。追踪应用 MyWay 已经给出停留点和出行段。yumuv 研究一项把共享电动滑板车、电动自行车和公共交通包在一起的出行即服务应用,参与者分成对照和处理,追踪三个月。案例没有把 yumuv 的两组拆开比较。
Geolife 用 100 米和 30 分钟生成停留点,间隔超过 24 小时的相邻定位点不属于同一停留。从停留点和出行段往上,四份数据使用同一套参数:地点聚类 ε 为 30 米、最少样本数为 1,所以一次停留就足以形成一个地点;出行缺口阈值为 25 分钟;巡回起终点距离不超过 100 米,空间缺口不允许,最长时间为默认的 24 小时。最少样本数设成 1 之后,案例里的地点数不再表示多次到访才保留的重要地点。
表3的地点、停留点、出行段、出行和巡回都以千为单位。人数和平均追踪天数不是千。
| 数据 | 人数 | 平均追踪天数(标准差) | 输入 | 地点 | 停留点 | 出行段 | 出行 | 巡回 |
|---|---|---|---|---|---|---|---|---|
| Green Class 1 | 139 | 401(59) | 停留点、出行段 | 104.5 | 326.9 | 465.2 | 241.8 | 95.0 |
| Green Class 2 | 50 | 314(76) | 停留点、出行段 | 35.7 | 87.9 | 128.6 | 61.4 | 22.7 |
| yumuv | 806 | 87(38) | 停留点、出行段 | 127.3 | 326.3 | 502.3 | 199.7 | 83.0 |
| Geolife | 177 | 193(443) | 定位点 | 13.6 | 28.9 | 30.2 | 30.2 | 7.2 |
四份研究的人数相加是 1,172,这是四项研究规模之和,不是一份统一抽样。Green Class 1 平均追踪 401 天,正文说超过一年;yumuv 平均 87 天。Geolife 平均 193 天,标准差 443 天,人与人的追踪长度差得很大。
停留点四行相加是 770.0 千。正文的精确总数是 769,957,差额 43。表3精确到 0.1 千,每格舍入误差不超过 50 条,四格合计不超过约 200 条,43 落在这个范围内。出行段四行相加是 1,126.3 千,正文的精确总数是 1,123,931,差额约 2,369,大于约 200 条的舍入上限。分数据集的规模以表3的千位数为准,两份合计以正文的精确整数为准,出行段总数不能由四格相加还原。
表4是出行层面的汇总。括号里是标准差。出行时长这一列的表头没有写单位。
| 数据 | 每日出行 | 每个巡回的出行 | 每个出行的出行段 | 出行距离,公里 | 出行时长 | 时间覆盖率 |
|---|---|---|---|---|---|---|
| Green Class 1 | 4.32 | 2.73 | 1.92 | 27.4(478.7) | 0.52(0.73) | 0.85(0.17) |
| Green Class 2 | 3.80 | 2.66 | 2.09 | 33.7(568.2) | 0.51(0.75) | 0.75(0.24) |
| yumuv | 3.13 | 2.11 | 2.51 | 16.9(100.4) | 0.68(0.91) | 0.77(0.23) |
| Geolife | 1.70 | 2.37 | 1.00 | 36.1(3163.5) | 0.64(0.94) | 0.4(0.32) |
每个出行的出行段数与表3一致:出行段千位数除以出行千位数,四舍五入到两位小数。Green Class 1 是 465.2 / 241.8 = 1.92,yumuv 是 502.3 / 199.7 = 2.51,Geolife 是 30.2 / 30.2 = 1.00。每个巡回的出行数不能这样除。Green Class 1 的 241.8 / 95.0 = 2.55,表4是 2.73;Geolife 的 30.2 / 7.2 = 4.19,表4是 2.37。嵌套巡回允许一条出行进入多个巡回,也有出行不进入任何巡回,所以分子分母都不是表3那两个总数。
每日出行也不能用出行总数除以人数再除以平均追踪天数来还原。yumuv 若这样算是 199.7 千 / (806 × 87) = 2.85,表4是 3.13;Geolife 是 30.2 千 / (177 × 193) = 0.88,表4是 1.70。正文说每日出行由前面的绝对数量导出,但没有列出每人实际追踪天数的总和。表4的 4.32、3.80、3.13 和 1.70 就当作已经汇总的人均每日出行次数。
距离的标准差都远大于均值。Geolife 的均值是 36.1 公里,标准差是 3163.5 公里。这个均值会被很长的右尾拉动,不能当成大多数出行的典型距离。yumuv 的均值距离最短,16.9 公里,标准差仍有 100.4 公里;正文把这联系到参与者偏向城市地区。时长一列里,yumuv 0.68、Geolife 0.64,高于 Green Class 的 0.52 和 0.51。由于表头没有单位,这里保持原数,不换算成分钟或小时。
时间覆盖率是每个用户被记录时间的比例,表4给出用户间的均值和标准差。三份手机 GNSS 研究的均值是 0.85、0.75 和 0.77;正文概括为平均超过 75%。Geolife 的均值是 0.4,正文说大约覆盖 40% 的时间。
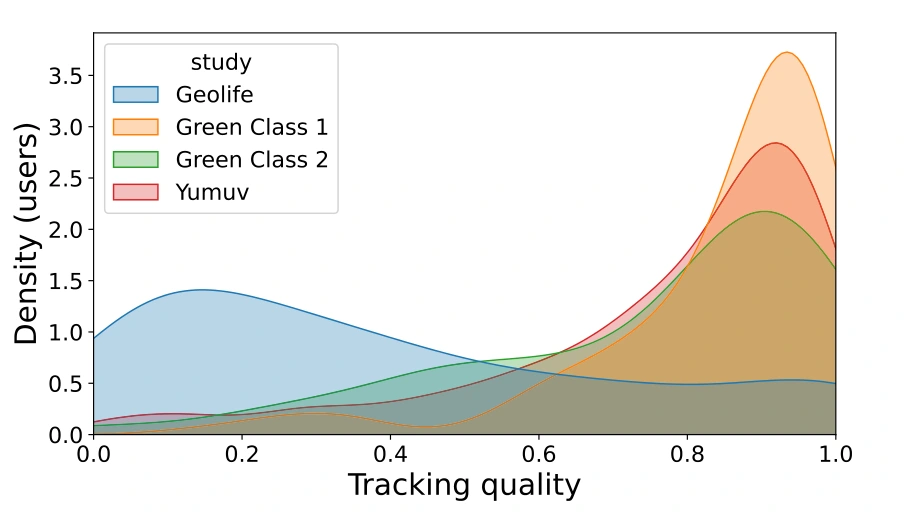
图 7|时间覆盖率在参与者之间是集中在高处,还是铺在整个 0 到 1?
横轴是时间覆盖率,0 到 1。纵轴是用户密度。蓝、橙、绿、红依次为 Geolife、Green Class 1、Green Class 2 和 yumuv。Geolife 的密度在低覆盖一侧铺开;三份手机 GNSS 研究的密度堆向 0.8 以上。正文写明,Green Class 1 的大多数人覆盖率超过 0.7。图上没有印出每条曲线的峰值坐标。作者把差别联系到设备:Geolife 使用只靠 GPS 的记录器,室内和城市峡谷容易丢点;另外三项用手机定位接口,除 GPS 外还能使用其他 GNSS,并在没有卫星时退回 WiFi 或基站定位。这是对设备差异的解释,案例没有单独测量定位误差的米数。来源:原论文 Fig. 7。
方式构成先按出行段条数,再按距离。Geolife 的原始方式并不是所有人、所有时间都有,所以用速度规则预测,再收成三类。另外三份使用数据里已有的方式标签:慢速包括步行、自行车和滑板车,机动包括有轨电车、公交、小汽车和摩托车,快速包括飞机和火车。
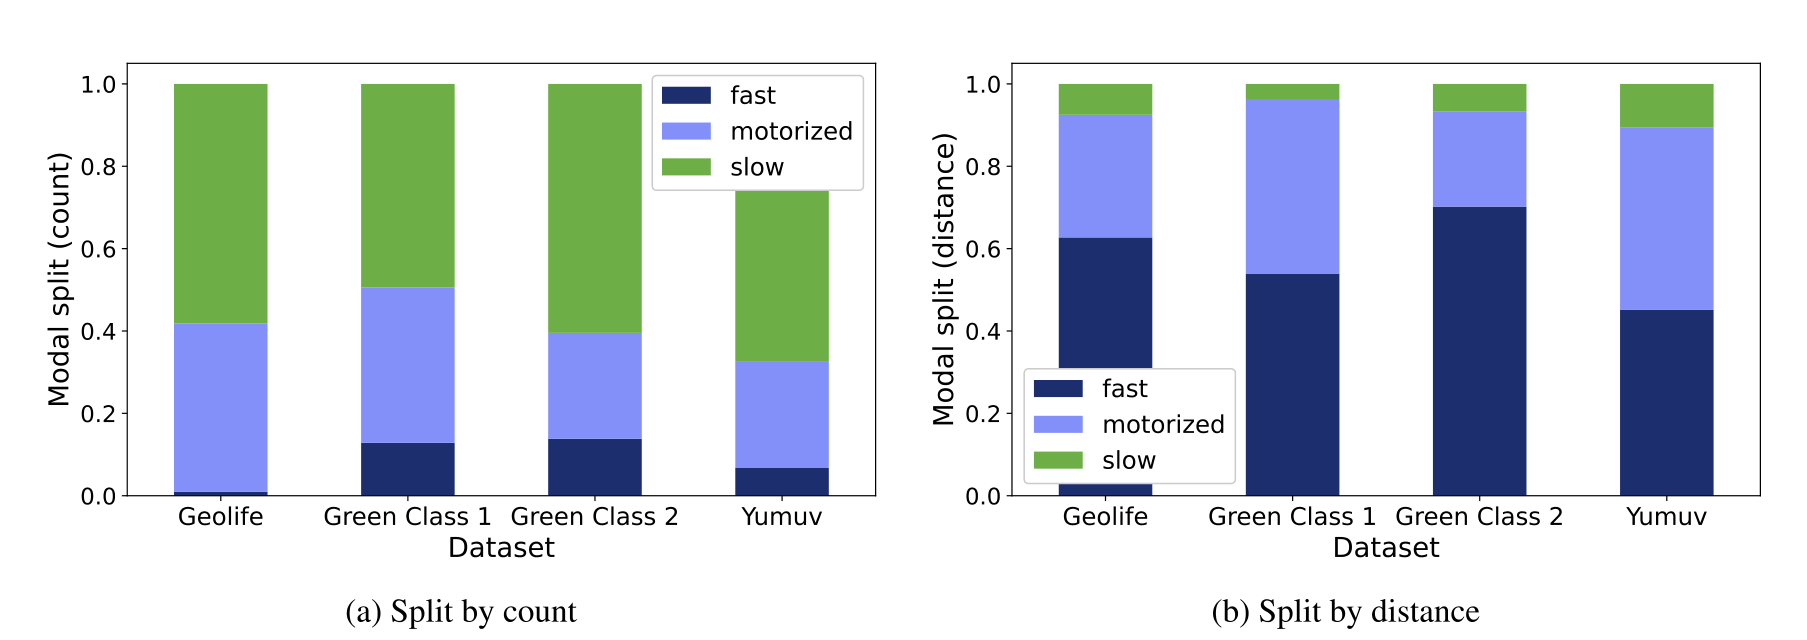
图 8|慢速、机动和快速的高低,按条数和按距离还保持同一顺序吗?
纵轴是 0 到 1 的份额。绿色是慢速,浅蓝是机动,深蓝是快速。(a)按出行段条数,yumuv 的绿色最高;Geolife 几乎看不到深蓝。(b)按距离,四组的深蓝都变高,绿色变矮;Green Class 两组的快速段尤其厚。柱上没有印出百分比。正文的解释是:Green Class 参与者可以使用瑞士全部公共交通,更可能坐火车;yumuv 参与者多为城市居民,并使用共享电动自行车和滑板车,慢速比例更高。Geolife 的三类来自速度阈值,其他三份来自已有标签,柱子高度里同时含有标签程序的差别。来源:原论文 Fig. 8。
家和工作的日内分布也放在一起比。Green Class 1 和 2 的活动标签由参与者提供。Geolife 和 yumuv 用库里的 location_identifier,实现的是 OSNA。图中每一分钟画的是带家或工作标签的平均用户比例。计算写法是:当天的停留点数除以当天活跃用户数;当天至少有一个停留点的用户算活跃。分子是停留点数量。同一个人在同一分钟若有多个停留点,论文没有说明会不会重复计入分子。
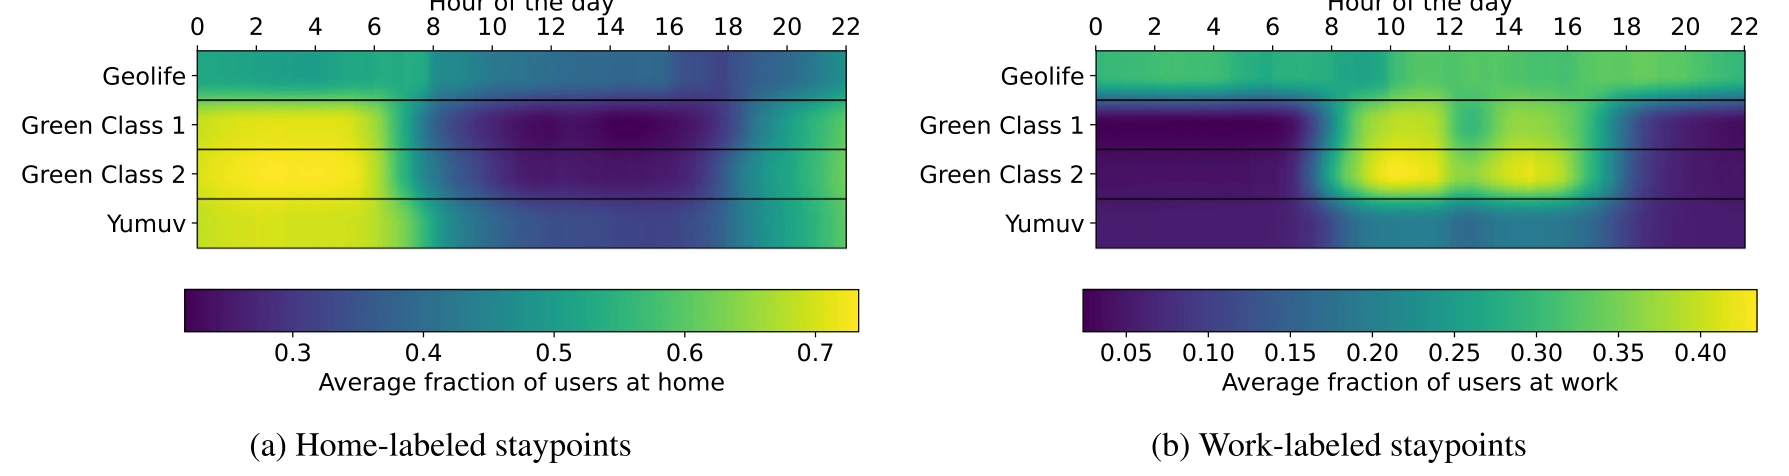
图 9|家和工作的停留在一天的哪些小时更常见?
横轴是一天中的小时,刻度从 0 到 22。每一行是一份数据。(a)家,色标从 0.3 到 0.7。(b)工作,色标从 0.05 到 0.40。色标是图上印刷的范围,单个小时的精确分数没有标在格子里。Green Class 与 yumuv 的家在夜间更亮、白天更暗;工作面板在大约白天的时段更亮,中间有一段变暗。正文指出,8 时到 17 时和午休在 Green Class 1、2 以及 yumuv 的工作面板上能看出来,yumuv 的工作停留更少。Geolife 的家可以被标出,工作面板没有同样清楚的白天高峰。作者把工作地识别变差联系到 Geolife 的低覆盖:当家和工作标签重叠时,所用规则会把到访次数第二多的地点当成工作。Green Class 的标签来自参与者自己,Geolife 和 yumuv 来自算法,四行曲线的差别因此不全是作息差别。来源:原论文 Fig. 9。
这些差别可以解释到哪一步?
案例说明四份数据可以在同一套聚合和标签上并排比较。它可以支持的结论停在这里:处理步骤一旦写进同一套参数,出行次数、时间覆盖、方式构成和日内活动就能放进同一张表,并且表上的差别与设备、参与者任务和标签来源对得上。
它不能支持的结论也很具体。Green Class 的快速出行更高,发生在获得全部公共交通以及电动车或电动自行车的参与者身上,不能写成瑞士居民的方式构成,也不能写成电动车造成了这个差别。yumuv 的慢速更高,同时有城市居住和共享车辆,案例没有分离这两件事,也没有比较对照和处理。Geolife 的每日 1.70 次出行和 0.4 的平均覆盖率,作者认为与 GPS 记录器的低时间覆盖有关;这是设备解释,不是对出行意愿的测量。
速度规则没有在这四份数据上报告正确率。家和工作在两份数据上是自报,在两份数据上是推断。最少样本数为 1 时,地点计数包含只出现一次的停留。出行距离的标准差大于均值,尤其是 Geolife 的 3163.5 公里,均值对长尾敏感。时间覆盖率高,只说明记录到的时间多,不说明坐标更准。
讨论把库的目标限定为高质量的标准聚合和语义标注,而不是包办所有分析。作者计划补充异常点过滤、补小缺口、更丰富的方式识别,以及和路网、兴趣点的衔接。现有版本已经把数据模型里的各层聚合做出来,并在多种数据上做过测试。和 Pandas、GeoPandas 兼容,是为了让这套管线嵌进更大的空间分析流程。单元测试、代码评审和持续集成保证的是软件改动不容易弄坏已有功能。
一句话总结
要把不同轨迹研究放在一起比,先得公开停留、活动、出行和巡回是用哪一套半径、时长和缺口生成的;Trackintel 把这套管线做成了可复用代码,四份数据因此能进入同一张表,表里的差别仍然混有设备、样本和标签来源。
核心来源
Martin, H., Hong, Y., Wiedemann, N., Bucher, D., & Raubal, M. (2023). Trackintel: An open-source Python library for human mobility analysis. Computers, Environment and Urban Systems, 101, 101938. https://doi.org/10.1016/j.compenvurbsys.2023.101938
期刊页标明资助来自 Swiss Data Science Center(C17-14)和 ETH Zurich Foundation(MI-01-19)。层级定义主要依据 Axhausen(2007)以及 Schönfelder 与 Axhausen(2016)。案例数据分别来自 Geolife(Zheng 等人)、SBB Green Class(Martin 等人,2019)和 yumuv(Martin 等人,2021)。
Henry Martin、Ye Hong 和 Nina Wiedemann 为共同第一作者,顺序随机。Dominik Bucher 的大部分工作完成于苏黎世联邦理工学院地理信息工程讲席,论文发表时署名为苏黎世 c.technology。
Henry Martin 的论文署名为苏黎世联邦理工学院制图与地理信息研究所,以及维也纳高等人工智能研究所。他是通讯作者,贡献包括概念、方法、软件、验证和写作。
Ye Hong 的论文署名为同一研究所,贡献与 Martin、Wiedemann 并列。他的个人主页写明,2026 年 5 月起任隆德大学人文地理系(Geo)AI 与区域发展助理教授;此前在苏黎世联邦理工学院移动信息工程实验室做博士后,研究人类移动性、GIS 与地理人工智能,博士导师包括 Martin Raubal。
Nina Wiedemann 的论文署名为同一研究所。实验室介绍她于 2021 年 7 月开始在此读博,2025 年 5 月起继续做博士后,研究方向是面向可持续移动的学习与优化。个人主页还写明目前在 Intel 从事研究,并在该实验室保留部分职位。
Dominik Bucher 在论文中的贡献是概念、方法、软件和验证。苏黎世联邦理工学院的博士论文讨论用时空信息技术支持可持续的个人移动;个人网站写明他是 c.technology 的联合创始人与技术负责人。
Martin Raubal 是苏黎世联邦理工学院制图与地理信息研究所地理信息工程讲席教授,论文中负责指导和获取资助。讲席页面列出的方向包括移动 GIS、基于位置的服务,以及人类移动的时空分析。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
下一地点预测若有的论文把每个 GPS 点当地点,有的先要求 100 米内停留 30 分钟,准确率排名里就混着定义差异。一个可以直接做的复核,是用 Trackintel 的同一套停留参数重做 DeepMove 这类基线,再看排名是否还成立。这篇论文指出了定义分歧,没有重跑那些模型。
最少样本数设为 1 时,只出现一次的停留也会变成地点。引言引用过重要地点数量随时间保持稳定的研究;若用本案例的参数去数重要地点,分母会被一次到访抬高。报告地点数量时,至少要同时给出 ε、最少样本数,以及这是按人聚类还是按全体用户聚类。
Geolife 的平均时间覆盖率是 0.4,工作地曲线又最不清楚。若一个城市比较把自报的家和工作与 OSNA 推断混在同一张日内图里,白天高峰的高低可能来自标签程序。覆盖率本身可以先作为筛选条件:先限定覆盖率相近的人,再比较工作停留的小时分布。
出行距离的均值不适合单独拿来做规划指标。Geolife 的均值是 36.1 公里,标准差是 3163.5 公里,少数极长记录就能移动均值。表4没有给中位数或分位数。同一批出行至少可以同时看均值、中位数,以及超过某个距离阈值的出行占全部出行的比例。
停留点、家和工作标签比原始点更容易读懂,也更容易指向具体的人。库把这些标签做成了批处理函数。复现实验时,公开参数和公开原始轨迹是两件不同的事;前者可以用合成数据或已获授权的数据完成,不必默认四份研究的逐点记录都能重新分发。