出门之后遇上的收入隔离,为什么和住家地图对不上?
论文名片|Esteban Moro、Dan Calacci、Xiaowen Dong、Alex Pentland,Mobility patterns are associated with experienced income segregation in large US cities,Nature Communications,2021,12:4633。2019年10月29日收稿,2021年7月12日接收,2021年7月30日在线发表。DOI:10.1038/s41467-021-24899-8。观察性研究。
波士顿市中心的地图上,两个场所可以只隔一条街,一个的访客时间来自好几个收入组,另一个几乎来自同一个收入组。居住地图在好几个街区甚至好几公里里仍连成一片,场所这一层却已经碎了。
这项研究要量的,是人在日常停留里实际接触到的收入组有多不均匀。收入按居住普查街区组分成四个人数相等的组,再看各组在场所上的停留时间。方向很清楚:场所隔离比居住地图细得多;人要走多远、去哪一类场所,以及是否同时多去新地方、并且去到自己收入组不占多数的地方,都和这种经历有关。这些是相关和生成模型能复现的格局,还不是把一条公交线改了就会改变隔离的因果证明。
先说结论
- 在11个美国大都市区、约100万个场所上,场所隔离的空间相关在大约50米处就已经很低;普查街区组收入中位数的空间相关在超过1公里、正文还写到大于10公里时仍然更高。隔街可以一边混合、一边单一。
- 数据里人到场所的平均距离是9.5公里。遭遇中78%发生在居住于不同公共使用微数据区的人之间,只有3%发生在同一普查街区组的居住者之间。对方住得远,并不等于对方属于另一个收入组。
- 场所类别和吸引范围(从家到场所的平均距离)只解释场所隔离方差的18%和15%。艺术场馆、博物馆、机场往往更混合;礼拜场所和杂货店往往更隔离。同一类场所内部仍然可以很散。
- 人经历到的隔离与居住地收入只有弱相关,ρ = −0.173 ± 0.002。控制访问次数后,去过的不同场所越多,经历隔离越低,ρ = −0.411 ± 0.001。两个参数的社会—探索模型与观察到的经历隔离相关为 ρ = 0.777 ± 0.001,对应11个城市的103万人。
- 地点探索主要与去过的场所类型一起变化。社会探索已解释的方差里,居住地特征占82%,场所类型约14%。对经历隔离本身,场所类型等移动行为因素的相对重要性为55%,居住地普查因素为45%。
一个场所的隔离,是四个收入组的停留时间离“各占四分之一”有多远
数据来自 Cuebiq 在2017年通过 Data for Good 提供的匿名定位,使用者事先选择共享。时间是2016年10月到2017年3月,共6个月,范围是11个核心统计区(core-based statistical area,CBSA),也就是围绕一个城市中心、工作和日常活动连在一起的都市区。原始记录有702亿次定位、1430万部手机。只保留定位超过2000次的设备后,剩下670亿次定位、450万部手机。摘要里的450万用户指的是这一层。
一次停留要超过5分钟、短于1天,并且200米内能对上 Foursquare 在2017年公开检索到的场所。场所总数约110万;进入分析的约100万个,每个至少有20个不同的匿名个体访问过。居住收入用的是2012–2016年美国社区调查五年估计里,居住普查街区组的家庭收入中位数。每个都市区内部再按人数切成四等份。四个组的人数相等,某一组在某个场所的停留时间不必等于四分之一。住所怎样从轨迹里判定,方法里有规则,这里只使用这个群体代理:街区组中位数,不是个人工资单。
最终能稳定对应到居住街区组、并且观测期内在该街区组至少度过10个夜晚的,是360万匿名个体、9.76亿次停留。经历隔离只对其中有场所访问的190万人计算。使用这些定位数据得到了麻省理工学院 IRB 豁免,协议号1812635835及其扩展 E-2962。
表1给出各都市区的人口、手机数和停留次数。合计行是人口8350万、手机360万、停留9.76亿,与上面的最终样本一致。把11行加起来却对不上:人口相加为8368万;手机558+630+411+447+432+212+270+123+504+338+100 = 4025千,即402.5万;停留141+120+123+105+113+55+74+30+129+105+28 = 1023百万,即10.23亿。正文没有解释分列与合计的差额。后文用到人数时,会写明是450万、360万、190万还是103万。
| 都市区(表1原文) | 州 | 人口 | 手机数 | 停留次数 |
|---|---|---|---|---|
| New York-Jersey City | NY-NJ-PA | 19.83 M | 558 k | 141 M |
| Los Angeles-Long Beach-Anaheim | CA | 13.05 M | 630 k | 120 M |
| Chicago-Naperfille-Elgin | IL-IN-WI | 9.52 M | 411 k | 123 M |
| Dallas-Fort Worth-Arlington | TX | 6.70 M | 447 k | 105 M |
| Philadelphia-Camden-Wilmington | PA-NJ-DE-MD | 6.02 M | 432 k | 113 M |
| Washington-Arlington-Alexandria | DC-VA-MD-WV | 5.86 M | 212 k | 55 M |
| Miami-Fort Lauderdale-West Palm Beach | FL | 5.76 M | 270 k | 74 M |
| Boston-Cambridge-Newton | MA-NH | 4.64 M | 123 k | 30 M |
| San Francisco-Oakland-Hayward | CA | 4.46 M | 504 k | 129 M |
| Detroit-Warren-Dearborn | MI | 4.29 M | 338 k | 105 M |
| Seattle-Tacoma-Bellevue | WA | 3.55 M | 100 k | 28 M |
| 合计行 | 83.5 M | 3.6 M | 976 M |
芝加哥在表中印为 Chicago-Naperfille-Elgin。人口、手机和停留都是表上的印刷值,M 为百万,k 为千。
场所 α 的收入隔离记为 Sα。先算四个收入组各自的停留时间比例 τqα,再看它们离开 1/4 的总和:
Sα = (2/3) ×(四个组 |τqα − 1/4| 之和)
四个组各占四分之一时间时,Sα = 0。只有一个组留下全部时间时,绝对偏差之和是1.5,乘以2/3得到1。这个1/4是时间基准。因为四分位在每个都市区内部按人数重切,纽约的高收入组和底特律的高收入组不是同一条美元线。图1a示意图旁印着一组区间:Q4高于11.4万美元,Q3为9.0万到11.4万,Q2为6.7万到9.0万,Q1为1.0万到6.7万。它只标在这张示意上。
人的经历隔离用同一把尺子。人 i 在场所 α 的时间比例是 τiα,接触收入组 q 的比例是各场所 τiα × τqα 的和。再套进上面的2/3公式,得到 Si。两人是否真的说上话,数据里很少能点对点数清,所以这里是按场所时间构成加权之后的接触概率。长停留比擦肩而过权重大。
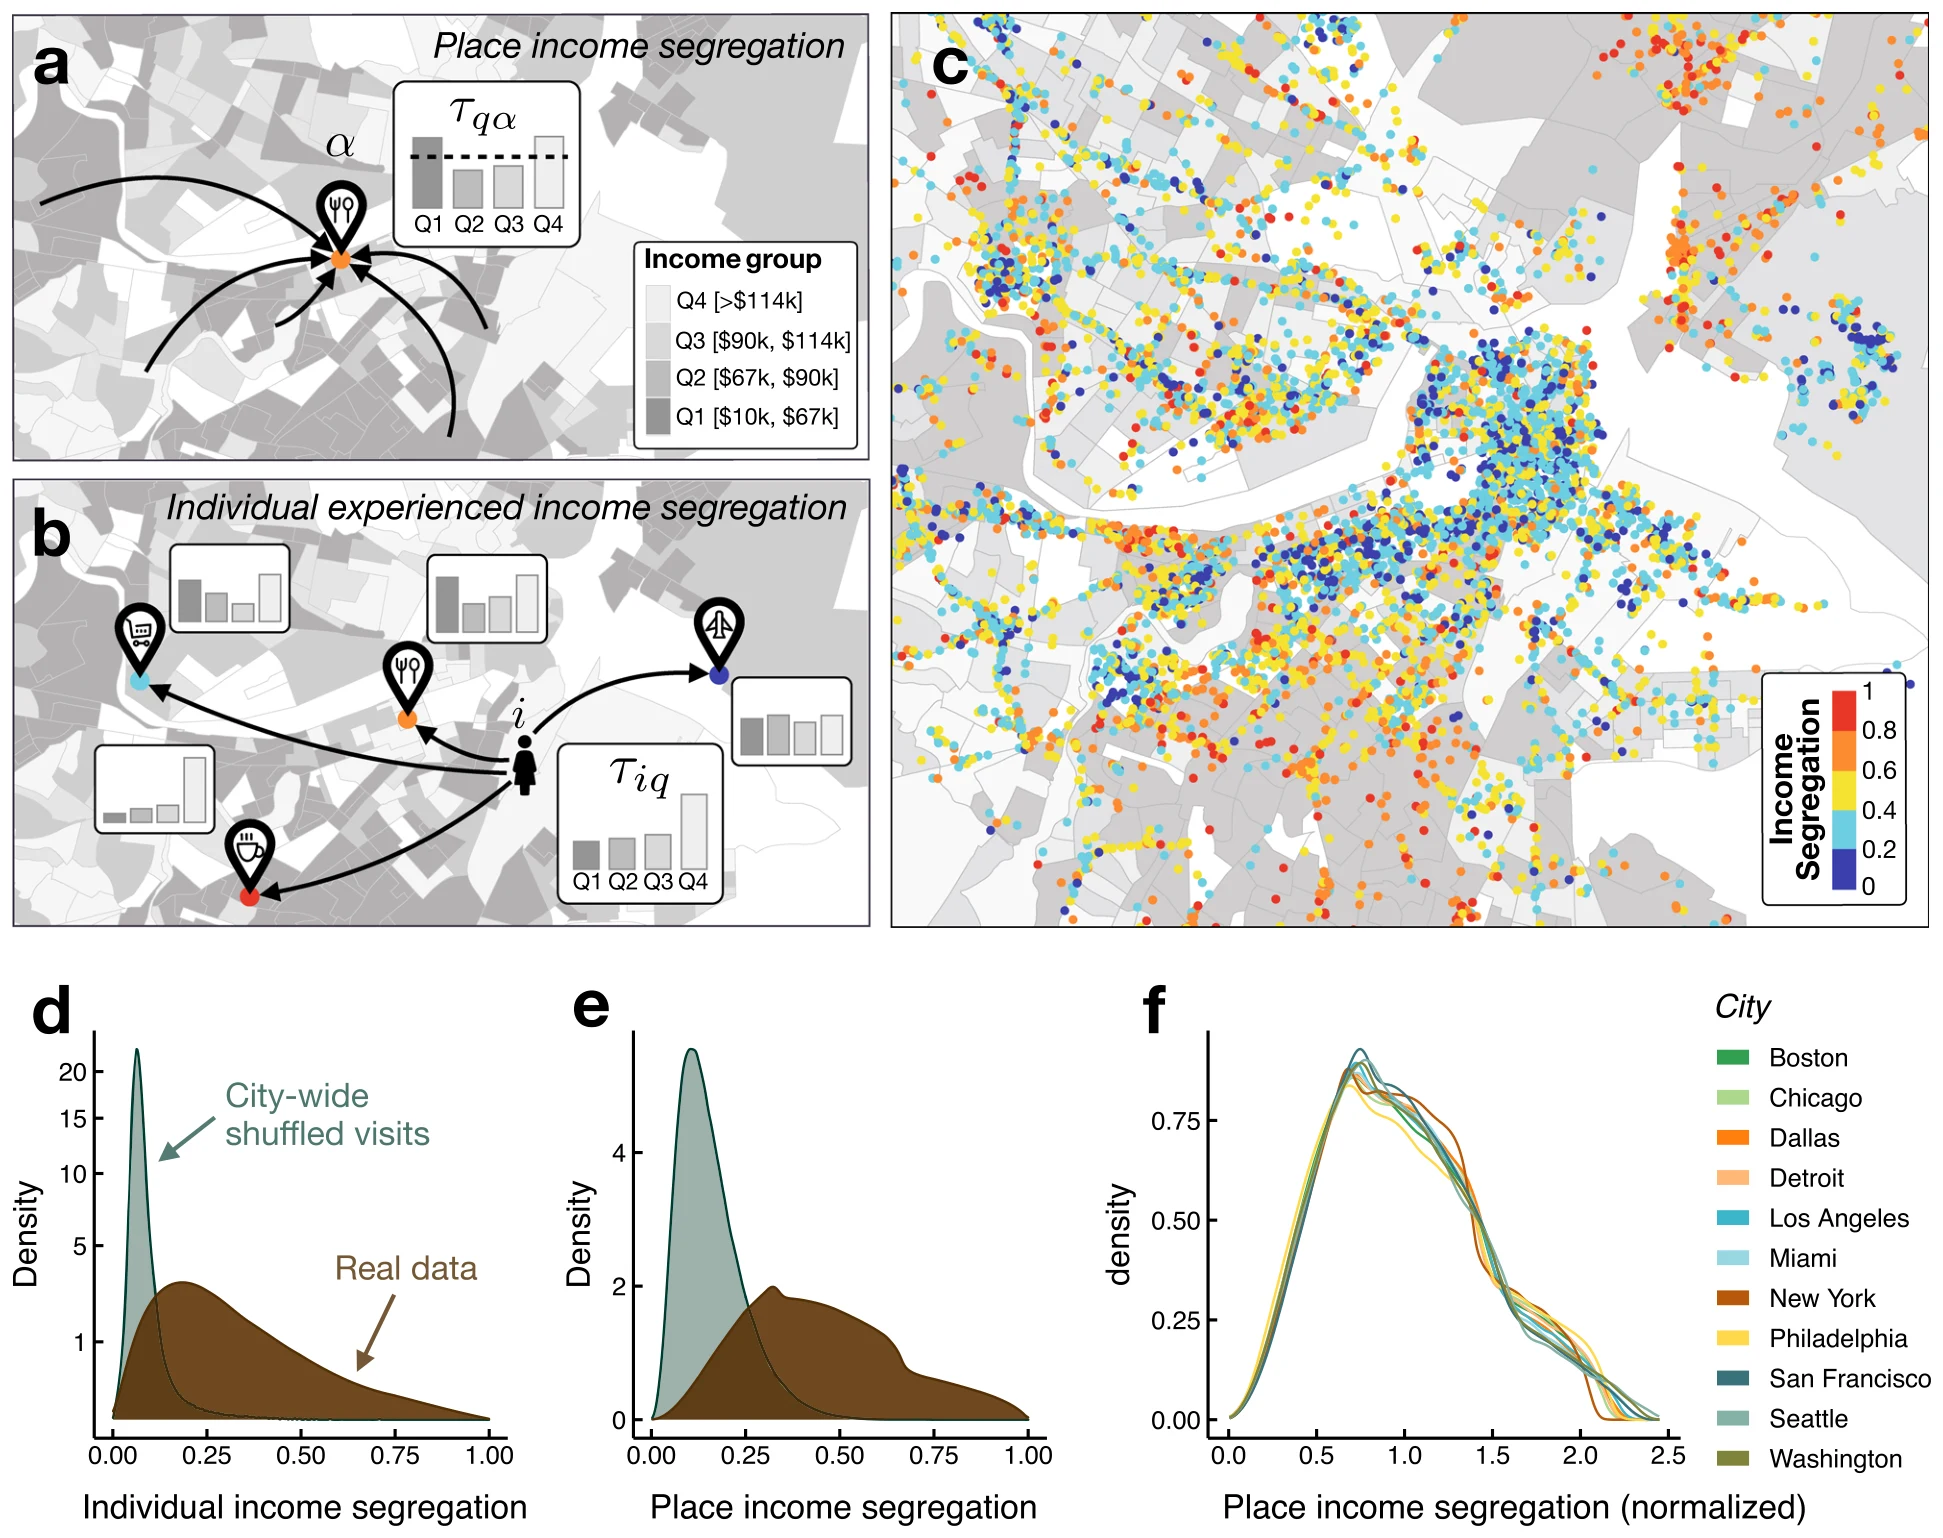
图 1|场所上的收入组混合,和人整天接触到的混合,差在哪里?
(a)不同普查街区组的人来到场所 α。柱是四个收入组的停留时间比例。隔离是这些比例离开各占四分之一的程度。美元区间只印在示意图上。(b)同一个人经过多个场所,按本人停留时间把各场所的组比例加总,得到一天里接触到的组比例。(c)波士顿市中心。颜色是场所隔离,蓝低红高,底图为美国普查局 TIGER。邻近场所可以颜色差很多。(d)11城合并后,人的经历隔离密度。青色是把访问在城市内打乱,棕色是真实访问。打乱后挤在低隔离,真实分布更宽,并延伸到更高的值。(e)场所隔离的同样比较。真实场所比打乱更靠右、更分散。(f)每个城市的场所隔离除以该城市自己的平均场所隔离。横轴是这个比值,11条线形状接近,峰在各自平均值附近。形状接近并不表示各城市的平均隔离相等。来源:原论文 Fig. 1。
打乱访问之后,隔离明显更低。真实的谁去哪个场所,比把访问在同一城市内重新分配更隔离。正文同时说,把各城市按自己的平均值归一之后,场所隔离的分布非常相似。因此跨城可以比较相对形状,还不能把未归一的 Sα 直接排成一座城市比另一座更隔离。
类别和要走的距离,只解释了方差的一小部分
场所隔离在空间上很碎。图2b里,普查街区组收入的空间相关在大约1公里(图上虚线,标为平均街区组尺度)之外,仍然明显高于场所隔离和经历隔离的空间相关;正文还写道,街区组收入在大于10公里时相关仍然相当高。场所隔离的空间相关即使在大约50米也偏低。人的经历隔离的空间相关在超过50米后明显下降。右端另一条虚线标的是个人平均出行距离。图上的相关都随距离下降,所以“10公里外仍然相当高”是相对场所隔离而言,不是相关一直停在短距离的高度。
为了看一个场所的隔离跟着什么一起变化,研究在芝加哥做了一个线性回归,并放入公共使用微数据区(Public Use Microdata Area,PUMA)的固定效应。论文对 PUMA 的一般描述是大约跨20公里、居住人口约15万,用来吸收同一城市内部这一尺度上的差别。其他变量包括:评分、价格等级、场所类别、从居住街区组出发的平均距离(称为吸引范围,catchment range)、附近还有多少场所,以及场所所在街区组的收入中位数。重要性按 Lindeman、Merenda 和 Gold 的方法分解,条的长短是这种重要性,不是回归系数本身。
除 PUMA 之外,类别和吸引范围最重要。正文说二者只解释了场所隔离方差的18%和15%,没有在句中标明哪一个是18%。图2c里吸引范围的条最长,类别次之。图题旁印着 R = 0.60。这是芝加哥模型。全样本的分解在补充表3,正文没有再给一套11城合并的百分比。
平均距离更长的类别,隔离往往更低;主要服务附近、很容易到达的类别,隔离往往更高。艺术场馆、博物馆和机场更混合,礼拜场所和杂货店更隔离。正文把后者读成居住隔离的延伸:人更常去离家近的杂货店。工厂比吸引范围相近的办公室、典当行和超市更隔离。图2a上,支票兑现和典当行位于隔离较高的一侧,科学博物馆、展览和体育场更远、隔离更低。这些是类别平均。工作场所和餐馆在隔离和距离两个方向上都散开,所以同一类招牌下面可以既有混合的店,也有单一的店。
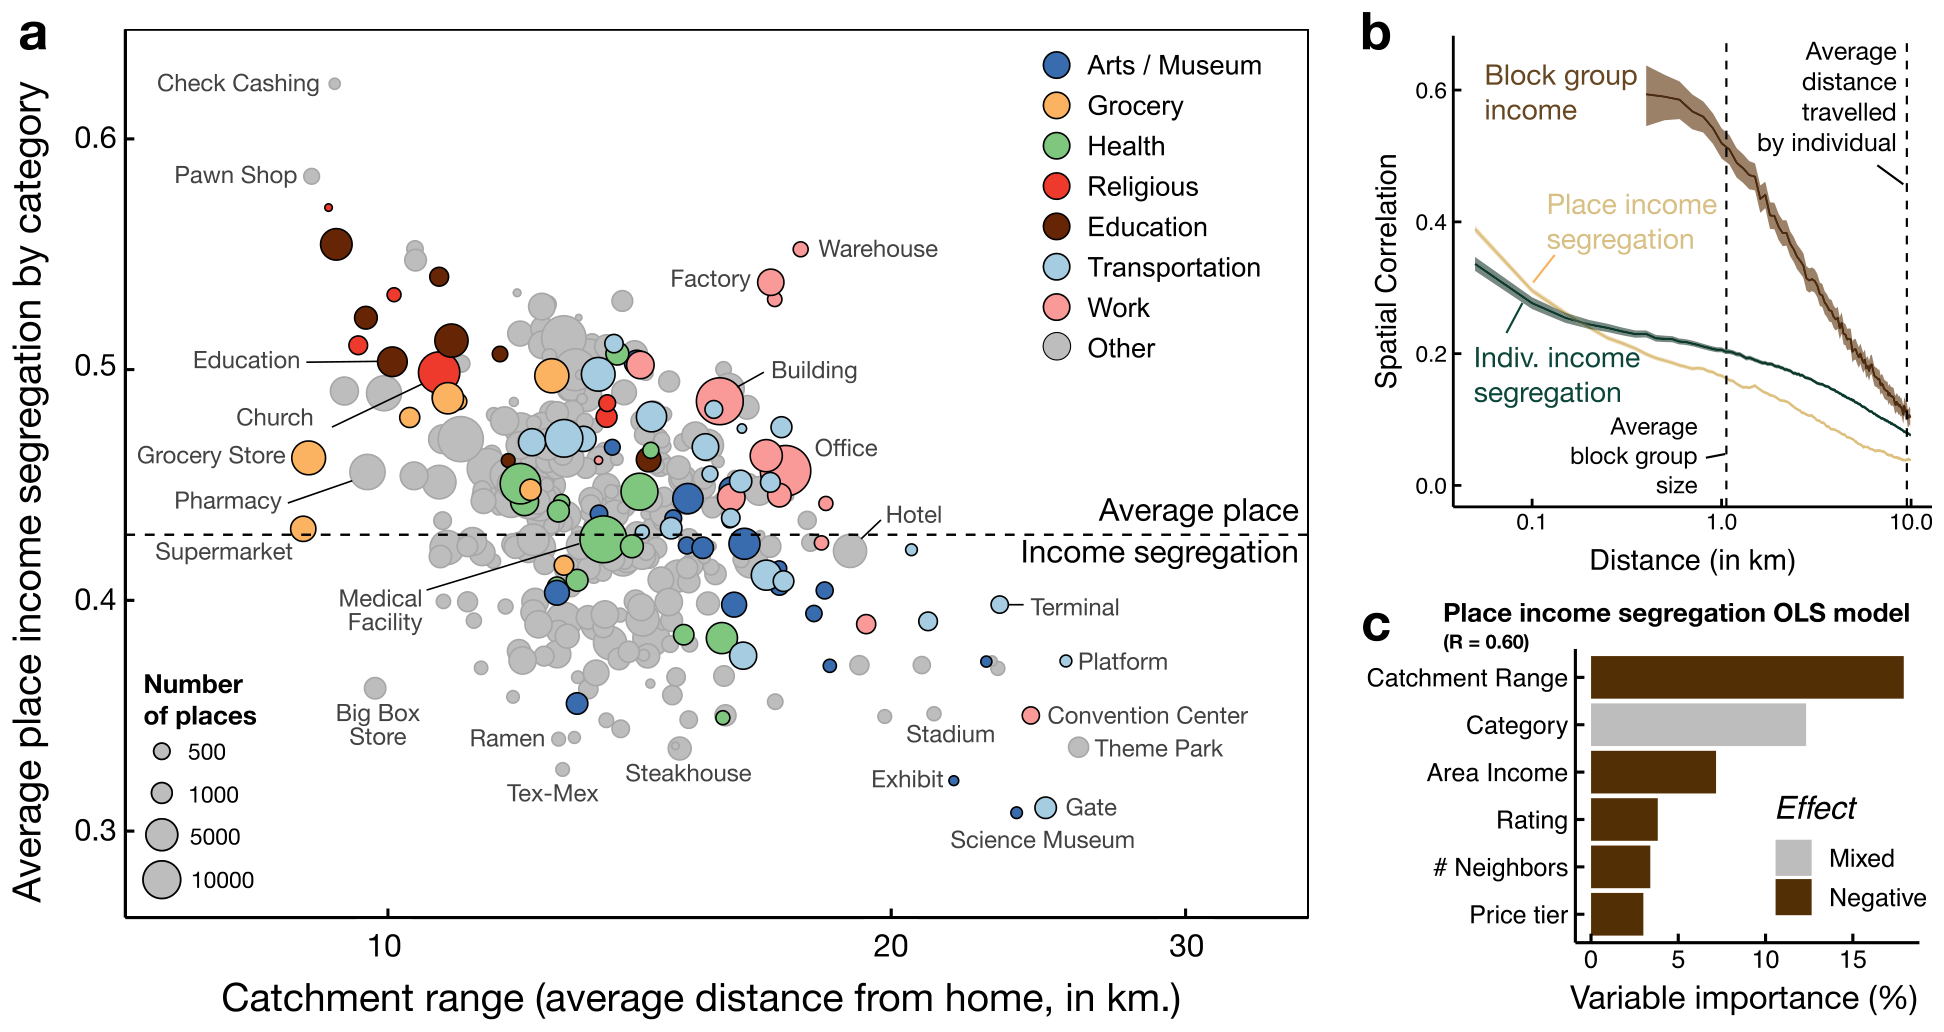
图 2|走得远、店的类型不同,场所隔离会差多少?
(a)每个点是一个场所类别。横轴是从家出发的平均距离,单位公里;纵轴是该类别场所的平均隔离;点的大小是场所数量,从500到10000;颜色是艺术与博物馆、杂货、健康、宗教、教育、交通、工作和其他。虚线是场所隔离的平均水平。近处的教育、教堂、杂货店多在虚线以上,更远的博物馆、展览、场站和体育场多在虚线附近或以下。(b)空间相关对距离,横轴为公里的对数。棕色是街区组收入,黄色是场所隔离,绿色是人的经历隔离。1公里虚线标平均街区组尺度,右端虚线标个人平均出行距离。(c)芝加哥的线性回归,括号内 R = 0.60。横轴是变量重要性的百分比。吸引范围最长;类别为灰色,表示混合效应;地区收入、评分、邻近场所数和价格等级为棕色,表示这些变量更高时,模型中的隔离倾向更低。来源:原论文 Fig. 2。
棕色表示的是模型里的共变方向。地区收入更高、评分更高、邻居场所更多、价格等级更高,在这个芝加哥回归里对应更低的场所隔离。它没有证明把一家店的评分改高,访客的收入组就会变均匀。类别被标成混合效应,因为“类别”是一整组场所,没有单一正负号。
人接触到的收入组,只有一小部分来自同街坊
场所隔离只轻微依赖场所所在街区的收入。访客也常常不住在附近:数据中人到任一场所的平均距离是9.5公里,从居住街区组算起。在这套数据的遭遇里,78%发生在居住于另一个 PUMA 的人之间,3%发生在同一普查街区组的居住者之间。这两个比例的分母是数据中的遭遇。78%回答的是对方住在哪里,不是对方落在哪一个收入四分位。
人经历到的隔离因此不能从住家街区直接读出。它和居住地收入的相关只有 ρ = −0.173 ± 0.002。住得很近的人也可以差很多:这种经历隔离的空间相关在超过50米后就明显掉下去。正文给出的 ± 没有在同一句里定义成标准误或置信区间,这里保持原样。
停留时间是重尾的。少数人在少数场所度过大部分时间,短暂停留改变不了全天的接触比例。只用每人最常去的10个场所来算,与用全部场所来算的经历隔离相关为97%。这97%是两种算法在同一批人上的相关,不是这10个场所占全部时间的97%。
有人会去很多不同的地方,论文沿用既有移动研究的说法,把他们称作探索者;另一些人把大部分时间放回少数地点,称作返回者。不同场所数 ST 较小的返回者,经历隔离更高。控制访问次数之后,经历隔离与不同场所数的相关为 ρ = −0.411 ± 0.001。控制访问次数,是为了把“出门次数更多所以名单更长”从“名单更长则隔离更低”里分开。
另一件容易想错的事是:一个人可以上午待在高收入组的场所、下午待在低收入组的场所,全天加总看起来很混合。数据里这种抵消不强。个人经历隔离与所访场所的平均隔离相关为 ρ = 0.579 ± 0.001。人去的场所,隔离水平和自己全天的经历接近。只拿教育、大学、工作、礼拜、艺术与博物馆、体育或娱乐这些更“社会”的场所来算,和个人整体经历隔离的相关仍有 ρ = 0.754 ± 0.001。隔离格局会跟着人走过城市,而不是只出现在某一类场所。
只按“爱去新地方”生成访问,为什么会把隔离抹平?
探索与优先返回模型(exploration and preferential return,EPR)用两件事描述一个人的访问:以一定概率去一个新场所,否则按过去在旧场所停留的时间返回。去新场所的概率写成 Pnew = ρ / Sₙ 的 γ 次方,Sₙ 是到第 n 次停留为止去过的不同场所数。用这套数据拟合,γ 约等于 0.23 ± 0.02,和以往城市移动研究接近。ρ 里的信息可以改写成地点探索 σp = ST / N:不同场所数除以停留次数。平均值是0.43,也就是平均而言,不同场所数约为停留次数的43%。高于这个均值的是地点探索者,低于均值的是返回者。0.43是这批人的均值,不是另一条绝对门槛。
这个模型能复现停留时间的重尾,探索者在最常去的场所上花的时间比例更低。它解释不了经历隔离的差别,因为它去新场所时不管该场所有多隔离,同一片地区的人会被模拟成几乎同样的经历。图1和图2已经表明,邻近的人、邻近的场所都可以差很多。
社会探索把谢林模型里的一个想法放进“去新场所”这一步。社会探索率 σs 是新去的不同场所中,本人收入组属于少数的比例。少数的分界是50%:论文选择50%,是因为模型与数据的相关在这个值附近最高,那条随阈值变化的曲线在补充说明里。场所隔离看的是四个组的时间是否离开各1/4;社会探索看的是本人那一组在新场所里是否不到一半。两个基准都写在正文里,回答的比较不一样。
σs 小,表示人把时间放在自己收入组占多数、因而也更隔离的场所。研究假定选场所时可以先不管随后待多久。数据里,场所隔离与在该场所停留时间的相关只有 ρ = 0.049 ± 0.001,和这个假定同向;但最常去的场所仍比其余场所大约隔离高14%。这14%是相对其余场所的大约升幅,正文没有给出这些场所的绝对 Sα。
只保留 σp 和 σs 两个参数时,模型生成的经历隔离与观察到的相关为 ρ = 0.777 ± 0.001。正文说这覆盖11个城市的103万人。有场所访问、因而计算了经历隔离的是190万人。正文没有说明103万与190万之间还做了哪一步筛选。0.777是生成结果和观察结果的相关,说明两个参数能排开这批人的差别,不是证明每个人都先掷一枚探索的骰子。
σs 单独也不够。大约80%的人 σs > 0.75,见分布的右堆。对这大多数人,隔离取决于 σp 和 σs 怎样一起发生。σp 小的返回者把时间集中在少数场所,而这些最常去的场所又略更隔离,所以即使 σs 不低,返回者总体上仍更隔离。两个都高的人,接触四个收入组的时间才更接近各占四分之一。经历隔离与 σs 的相关是 ρ = −0.538 ± 0.002,低于两个参数一起的0.777。σp 和 σs 彼此只有 ρ = 0.126 ± 0.002,接近分开的两件事。
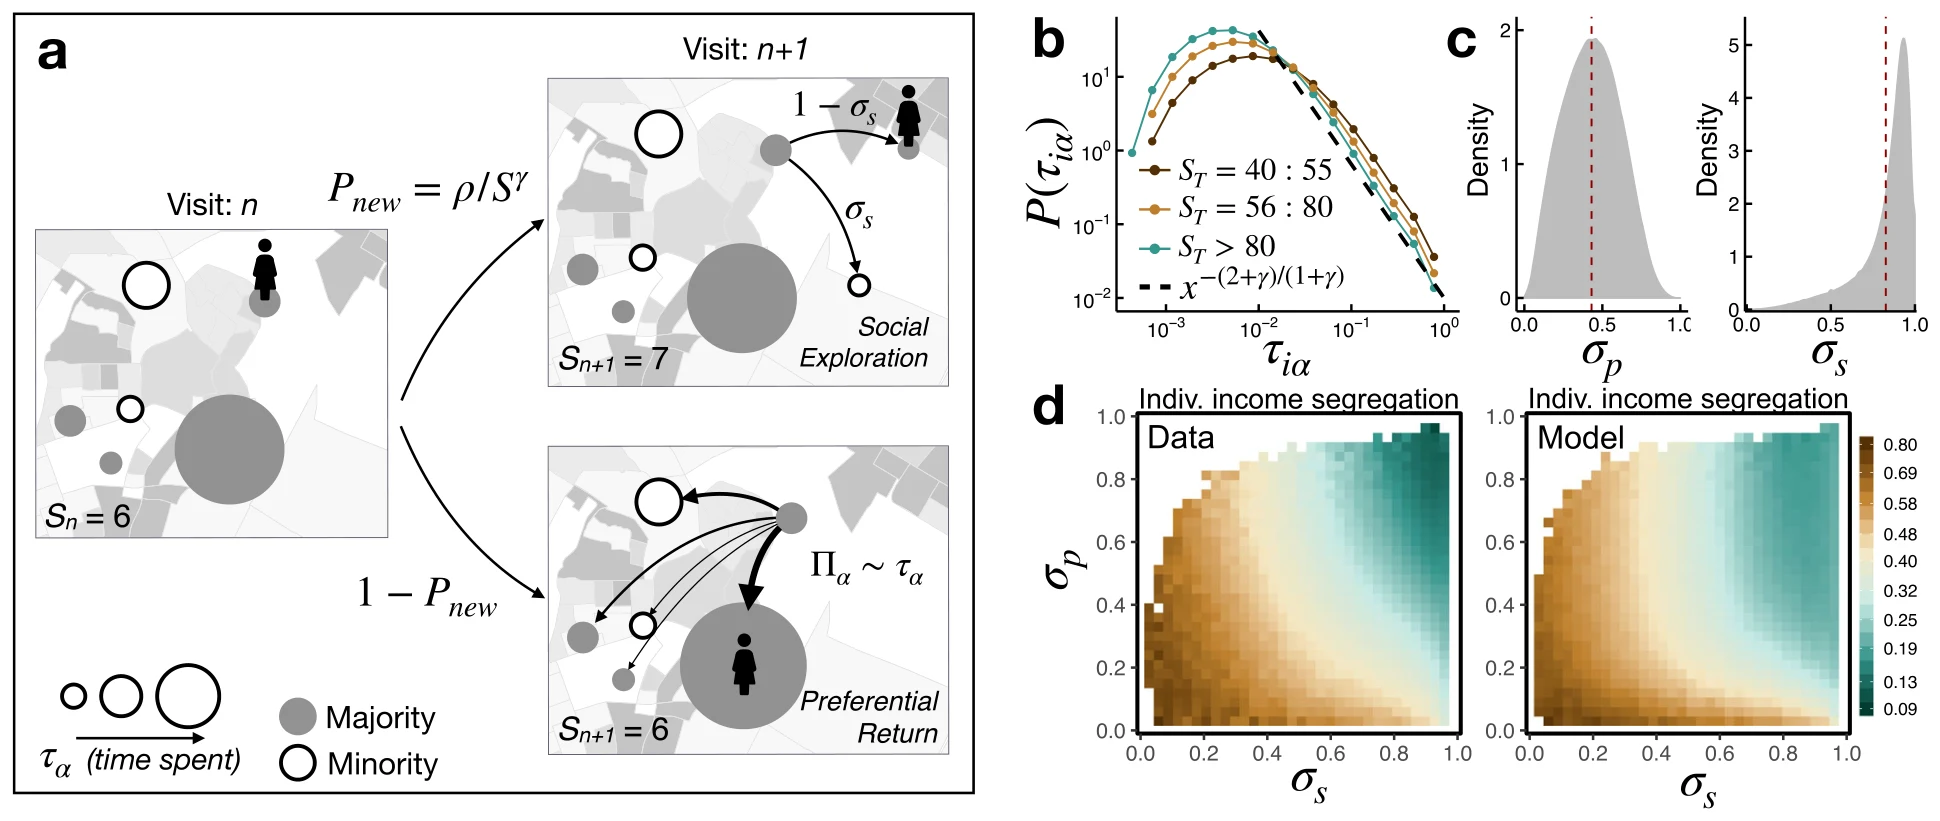
图 3|地点探索和社会探索怎样一起对应经历隔离?
(a)已经去过6个场所时,下一步以 Pnew = ρ / S 的 γ 次方去新场所,否则按过去停留时间返回。去新场所时,σs 走向本人收入组为少数的场所,1−σs 走向本人收入组为多数的场所。圆越大,停留时间越多;实心是多数,空心是少数。(b)停留时间比例 τiα 的分布,按不同场所数分组:40到55、56到80、大于80。纵轴为密度,对数刻度。虚线是模型的解析形状。少数场所占去大部分时间。(c)σp 与 σs 的密度,虚线是均值。σp 分布较宽;σs 堆在高值一端。(d)左为数据,右为模型。横轴 σs,纵轴 σp,颜色是平均经历隔离,棕色高、青色低。两种探索都高的一角更接近低隔离。模型复现这个方向,图上每一格不必相等。来源:原论文 Fig. 3。
去很多新地方,和去“自己这组是少数”的地方,跟着的条件不一样
研究把可能相关的条件分成三组。生活方式是各类场所上的停留时间比例。地理移动是在城市里覆盖多远,包括总出行距离和回转半径。居住地是普查街区组的人口、教育、就业、种族构成、贫困、交通方式等,大约30个变量,完整名单在补充表。回归里仍然放入居住 PUMA,以及地理移动,用来把“身边本来有哪些场所”和“人实际把时间放进哪些类型”分开。这仍是线性回归里的份额,不是实验。
地点探索 σp 主要与场所类型一起变化,地理移动只占很小一部分。电影、展览、咖啡馆,以及某些餐馆(例如 tapas、点心、拉面)出现在访问里,比知道这个人的收入水平更能标出高 σp。这些场所占的时间很少:咖啡馆占全部时间的1.2%,剧院占0.3%。它们并不直接构成经历隔离的大头,更像探索生活方式的标记。高地点探索的时间更多落在娱乐、餐饮和购物,更少落在教育以及工厂、仓库这类工作场所。地点探索在各个居住地区都能出现,和街区组的人口特征几乎分开。
社会探索 σs 相反。居住地特征占它已解释方差的82%,尤其是教育、就业、种族构成、交通方式和贫困率。住在教育水平更高、家庭收入中位数更高、黑人居民比例更低、较少使用公共交通、贫困率更低的街区组里的人,σs 更高,也更常去自己收入组属于少数的新场所。这是街区组构成和社会探索的相关。场所类型只解释 σs 大约14%的方差。教育、附近杂货店、典当行本身更隔离,几乎只待在这些场所的人 σs 会更低,但这批人是少数。大约46%的时间花在工作、餐饮和服务。正文用“大多数人的时间里约占46%”来写,46%本身不到一半。这三类场所里既有隔离的,也有混合的,所以同样的生活方式仍可以对应很不同的 σs。
两套探索因此对应不同的条件。放到经历隔离 Si 上,移动行为因素、尤其是场所类型的相对重要性为55%,居住地普查因素为45%。高收入街区的人往往 σs 更高,地点探索却不一定更高,所以高收入组的人可以和低收入组的人一样隔离。居住在更贫困地区的人,若地点探索高,经历上可以更混合。正文把后一句放在模型结果之后:只有社会探索和地点探索都高,四个收入组的接触才更均匀。这是关联之下的读法,回归没有把收入或探索随机指派给人。
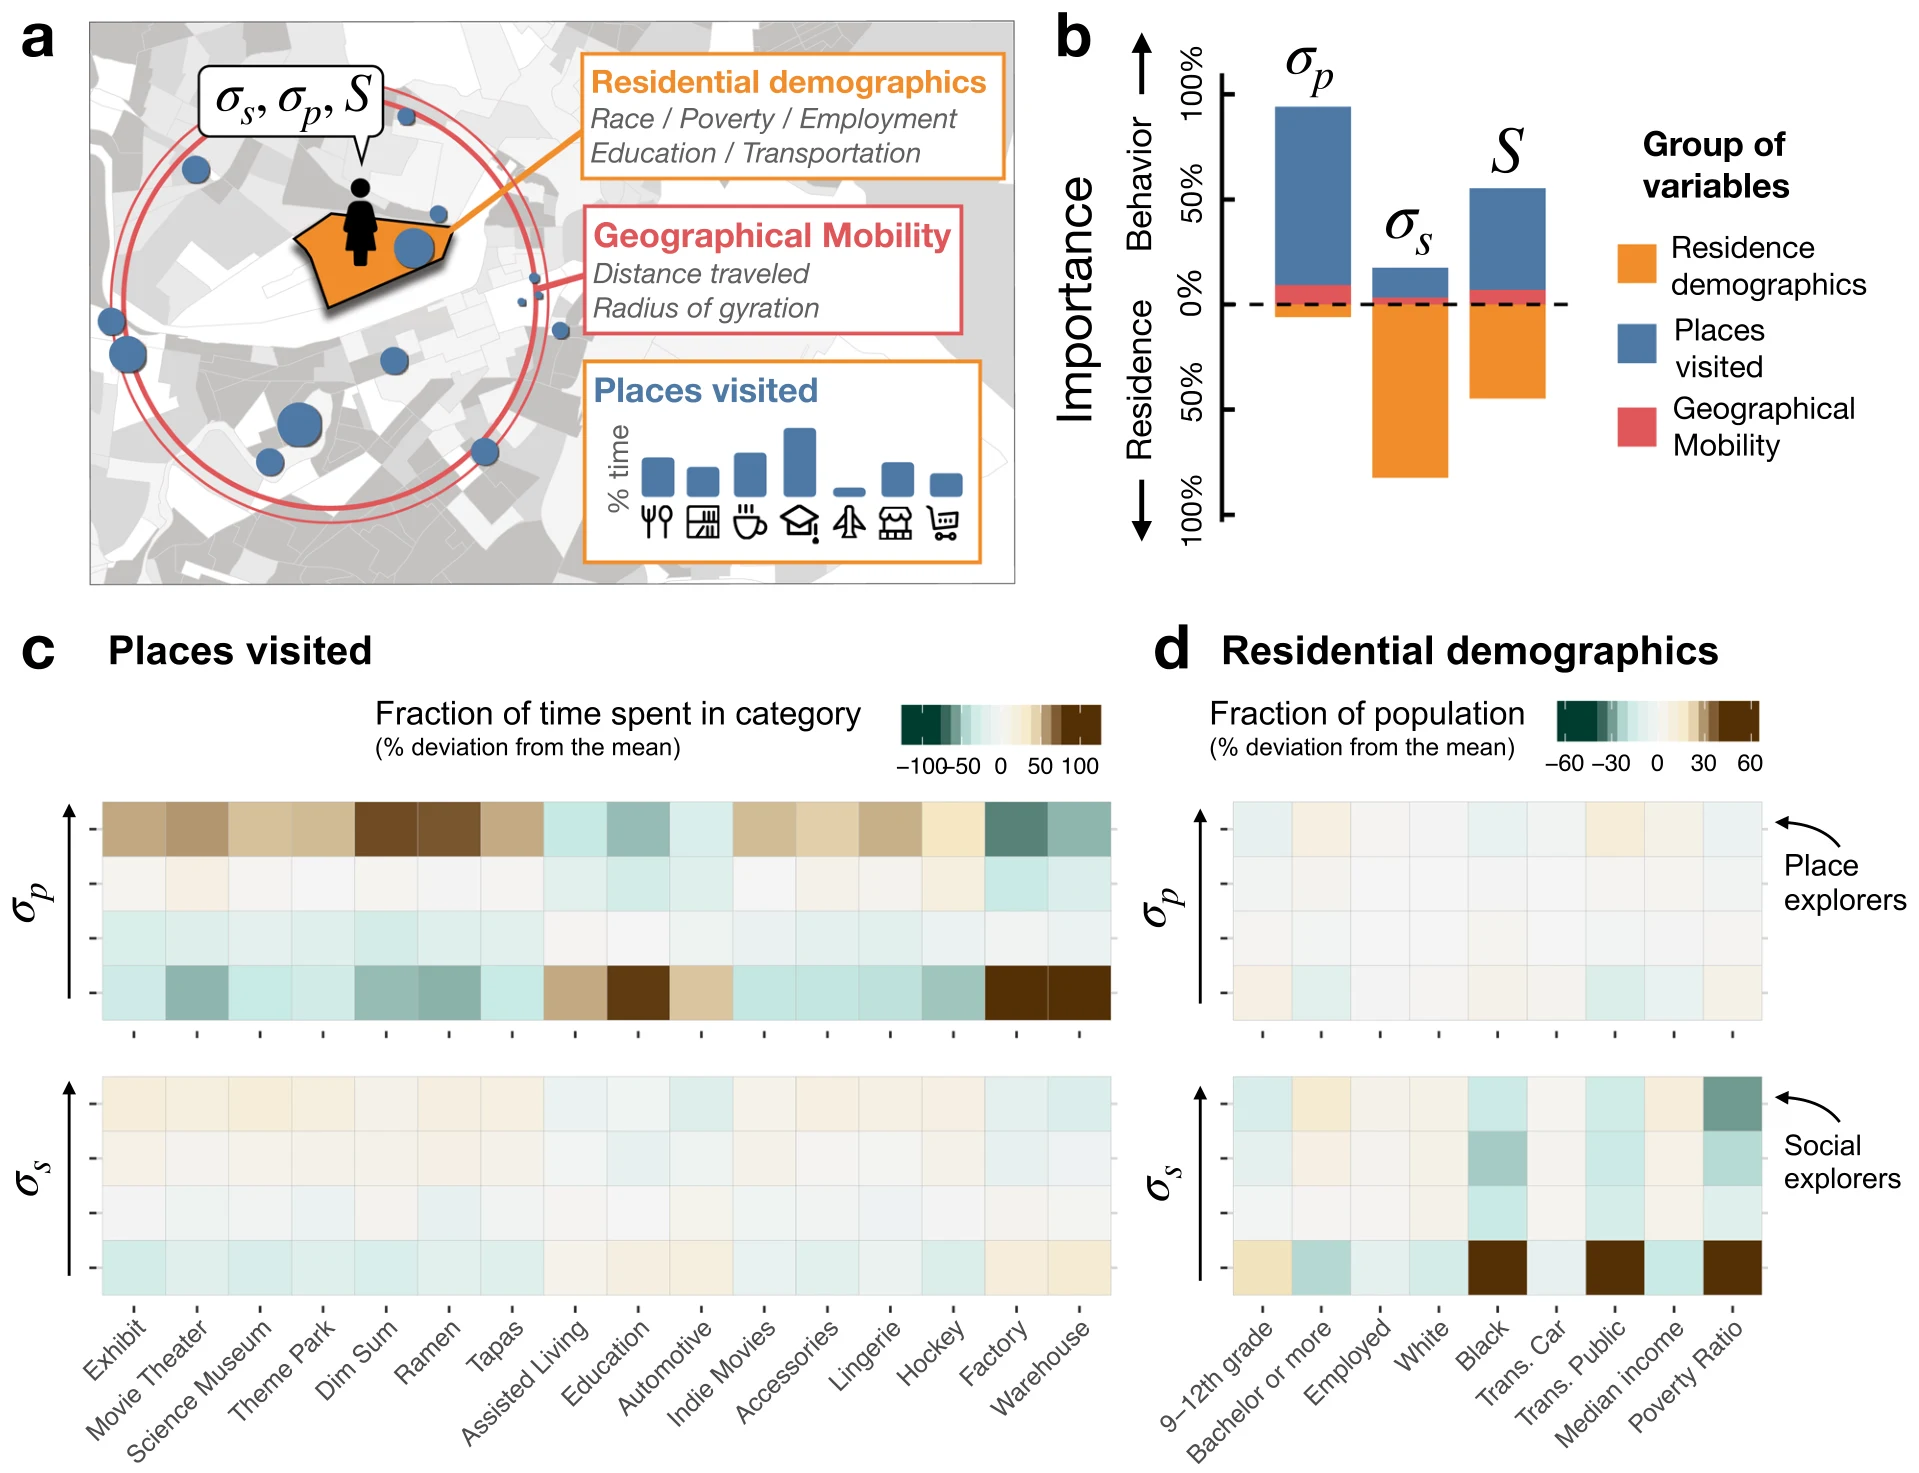
图 4|哪一组条件分别对应两种探索和经历隔离?
(a)居住地人口特征、地理移动(出行距离与回转半径)、各类场所的停留时间。中间是要解释的 σs、σp 和经历隔离 S。(b)三组变量的解释份额。蓝色是去过的场所,橙色是居住地,红色是地理移动。σp 几乎全是蓝色向上;σs 主要是橙色;S 在场所与居住地之间分成上下两截;红色在三列里都很薄。(c)横轴是具体场所类别,纵轴向上是更高的地点探索(上块)或社会探索(下块)。颜色是停留时间相对该类均值的偏离,色标从−100%到100%。地点探索较高的一行在展览、点心、拉面等类别上高于平均,在教育、工厂、仓库上低于平均;社会探索各行接近平均。(d)居住地变量相对人口构成均值的偏离,色标从−60%到60%。地点探索一行接近白色。社会探索的高组与低组在贫困率、公共交通和黑人居民比例上方向相反;教育、收入中位数与此不同向。格子的深浅这里不读成精确百分点。来源:原论文 Fig. 4。
这些相关能说到哪一步
样本留下的人,是6个月内能对应到稳定居住街区组的人。没有稳定住所,以及夜间工作时间不典型(正文写的是晚上8点到凌晨4点这一类班次)的人在样本外。场所来自 Foursquare,某些类型的场所会更多进入名录。咖啡店里的一次闲谈,和柜台前的一次交易,在定位上可以是同一次停留,数据分不开。因此 Sα 和 Si 是潜在接触的范围,给收入隔离一个可计算的上下边界,不是交谈质量。
结果针对收入组。种族、财富和族裔可以与收入相关,但不是这里的隔离指标。种族构成只作为居住街区组的协变量,出现在社会探索的相关里。图1d和1e的打乱、图3的生成模型、图4的回归,都是在观察格局上比较。正文明确写这些结果是描述性的,不表示因果。城市设计、公交线路和分区若要谈到对经历隔离的作用,还需要另外的干预或自然实验。
指标本身也有边界。S 相对于每个都市区自己的四等份。一个场所可以因为本地某一个四分位留下了全部时间而得到 S = 1,即使这个四分位换到另一座城市会落在中间。图1f先除以各城市自己的平均场所隔离,比的是形状。模型相关0.777也只说明两个参数排得开观察值,最常去场所仍比其余场所大约隔离14%,返回者的时间权重就落在略更隔离的场所上。
正文还说,换隔离指标或收入分组后主要结果仍然稳健,并与人口、收入和场所到访做过后分层;最活跃场所与带地理信息的 Twitter、大型活动的官方出席得到相似结果。这些检验的数字在补充说明里,正文没有再列一张对照表。
一句话总结
人出门之后遇上的收入隔离,与住在哪一个街区只有弱对应;它与场所类型、从家出发的距离,以及是否同时多去新地方、并且去到自己收入组不占多数的地方连在一起。
核心来源
- Nature Communications 正式页面,题目、作者、卷期4633与在线发表日期以期刊页面和论文首页为准。
- 论文方法、表1与图1至图4。汇总后的复现数据与图的代码在 https://github.com/emoro/Mobility_income_segregation。原始定位不公开,申请条件见 Cuebiq Data for Good。
- 场所类别来自2017年 Foursquare 公开检索接口。街区组人口与收入来自2012–2016年美国社区调查五年估计。
作者介绍
以下只写论文署名机构和作者贡献说明里能够核对的部分。
- Esteban Moro:署名为麻省理工学院媒体实验室,以及马德里卡洛斯三世大学数学系与 GISC(莱加内斯)。通讯作者。提出问题,设计方法与算法,完成分析、模型和模拟,并处理公司数据。
- Dan Calacci:署名为麻省理工学院媒体实验室。参与部分分析、模型和模拟,并参与处理公司数据。
- Xiaowen Dong:署名为麻省理工学院媒体实验室,以及牛津大学工程科学系。参与部分分析、模型和模拟,并参与指导。致谢中写到牛津—曼定量金融研究所的支持。
- Alex Pentland:署名为麻省理工学院媒体实验室。与 Dong、Moro 共同指导研究。四位作者都参与写作,使用的是汇总后的、非个人层面的处理数据。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果一座城市想改变人白天接触到的收入组,时间预算比地标更要紧。剧院只占全部停留时间的0.3%,咖啡馆占1.2%,而大约46%的时间在工作、餐饮和服务。图2a又显示,后几类在同样的出行距离上已经同时存在很混合和很单一的场所。把一座远处的博物馆做得很混合,会在类别平均里看起来成功,却可能几乎进不了那46%。值得单独检验的是:在人已经会去的工作、餐饮和服务里,把其中更混合的那一家变得同样近,经历隔离是否移动;这和新建一个远距离文化设施不是同一个处理。
图4b里地理移动只是很薄的一层。只把出行距离拉长、却不改变每天能进入的场所类型,对上的是回归里那条很弱的红色,而不是占到55%相对重要性的场所类型。公里数增加和菜单改变,应看成两次不同的干预。论文没有做其中任何一次。
还有一个指标陷阱。S = 1 的意思是本地四个等人数收入组里,有一个组留下了该场所的全部时间。它回答的是相对这座都市区自身的不均匀,不是相对一条全国贫困线。图1f之所以先除以各城市自己的平均值,正是因为绝对水平可以被拿掉,形状仍然相似。若有人把11座城市的平均 S 排成“谁更隔离”,排行榜换的是问题:它不再是这篇论文在归一之后比较的那件事情。