更常留在近处时,一个社区里的热门节点还会那么多吗?
论文名片|Zunnun Narmawala、Sanjay Srivastava,Community Aware Heterogeneous Human Mobility (CAHM): Model and analysis,Pervasive and Mobile Computing,2015,21:119–132。2014年12月29日在线发表,期刊卷期年份为2015;首页标为 Fast track article。DOI:10.1016/j.pmcj.2014.12.008。
一个人可以同时属于实验室、家庭和一个校外小组。手机只在彼此进入几十米时才能直接传文件。若下一站在所有常去地点里均匀抽取,他会频繁从一组人跳到另一组人;若短距离更常被抽中,他会在一组人里来回走一阵,再偶尔离开。谁因此更常被同社区的人遇见,谁又负责把消息带到别的社区,会跟着改变。
这项工作在已有的异质人类行走模型(Heterogeneous Human Walk,HHW)上改移动规则,称为感知社区的异质人类移动模型(Community Aware Heterogeneous Human Mobility,CAHM)。在作者的仿真里,局部流行度的高值尾巴变短,按社区结构排出的枢纽和网关与仿真测量的排序接近单调一致;相对 HHW,传染病路由和 BubbleRap 的投递率更高、平均时延更低。这些是合成移动上的协议比较,不是对某一城市居民出行的直接观测。
先说结论
- 同一个属于 11 个社区的节点,HHW 的单次位移长度不呈幂律;CAHM 按距离的幂律抽取下一站后,该节点的位移长度互补累积分布呈幂律,并在多数时间留在较短位移上。
- 在一个 70 个节点的社区里,局部流行度定义为相遇次数超过该社区平均相遇次数的节点个数。HHW 把社区格子数设成人数,高流行度节点偏多;CAHM 用密度乘数把格子数和人数分开,乘数从 1 增到 3,整体局部流行度下降。
- 用社区间距离的幂律转移估计每个社区的停留时间比例,再据此给节点打局部和全局分数。一次生成的 13 个社区上,这套排序与仿真测量的 Spearman 等级相关平均为 0.9890 和 0.9980(枢纽),以及 0.9770 和 0.9880(网关)。1 表示两条排序完全单调一致,这里的平均是对社区求平均。
- 200 个节点、13 个社区、包到达间隔 1–8 秒的仿真中,相对同一协议在 HHW 下的结果,Epidemic 与 BubbleRap 的投递率提高 23%–26%,平均投递时延降低 40%–50%。同一组仿真里,Epidemic 的每包传输次数大约比 BubbleRap 多 50%。
- 200 个节点、172 个长度为 1000 秒的接触图里,小社区大多不稳定,拐点大约在社区规模 20,即这 200 个节点的 10%。另一次 1000 个节点的结构里,大社区留住枢纽的比例更高、标准差更小;社区里看得到的网关比例明显低于枢纽比例。
均匀抽取下一站,为什么会把人推出当前社区?
口袋交换网络(Pocket Switched Network)或移动社交网络(Mobile Social Network)靠人携带设备时的相遇传数据,没有固定基础设施。随机路点(Random Waypoint,RWP)让节点独立地走向随机目的地,产生不了真实移动里常见的几件事:再次相遇间隔近似幂律并带指数截断、停留时间近似幂律、人更常去近处、对少数地点反复访问,以及走得越远速度越快。
人又不是各自独立的。基于社区的移动模型(Community-based Mobility Model,CMM)和家乡小区模型(HCMM)把社会关系放进移动,但没有同时放进社区重叠、社区内部和全网都不均匀的流行度,以及社区规模、成员所属社区数、社区重叠人数近似幂律这几项。HHW 用合成的 k 团重叠社区补上这些社会结构:一天分成若干时段,同时段在不同天重复同一套社区;成员数大于 2、等于 2、等于 1 的节点被分成三类,用来制造社区之间的重叠。局部度按幂律分配,再把每个社区映射到一块连通格子,节点只在自己被分到的格子之间走直线。
HHW 的下一站在这些格子里均匀抽取,与距离无关。论文用送信人作例子:他要去多栋楼里的多个办公室。若其他楼的办公室总数更多,均匀抽取会让他离开本楼的概率更高。这和“人更常走短距离”相反。Rhee 等报告,人类单次位移(flight,中间不停留的一段移动)的长度服从指数小于 2.5 的幂律。
CAHM 先按节点各关联格子到当前位置的距离排序,再抽一个服从幂律的距离,选距离最接近这个随机数的格子。短距离被抽中的机会更高。社区若各自占一块连通区域,社区内部的格子距离多半短于跨社区距离,节点就会更常留在当前社区。
检验用的是 ONE 仿真器。第一组场景有 200 个节点,平面 5000 米 × 5000 米,分成 62500 个 20 米 × 20 米的格子,传输距离 20 米。社区是 4 团,即 k = 4。成员所属社区数、重叠人数、社区规模和局部度的幂律指数分别设为 3、2、1.2 和 2.5,位移长度指数设为 2。这些指数落在文献给出的范围内,是输入,不是从这次仿真里估计出来的。HHW 与 CAHM 使用同一套社区结构。
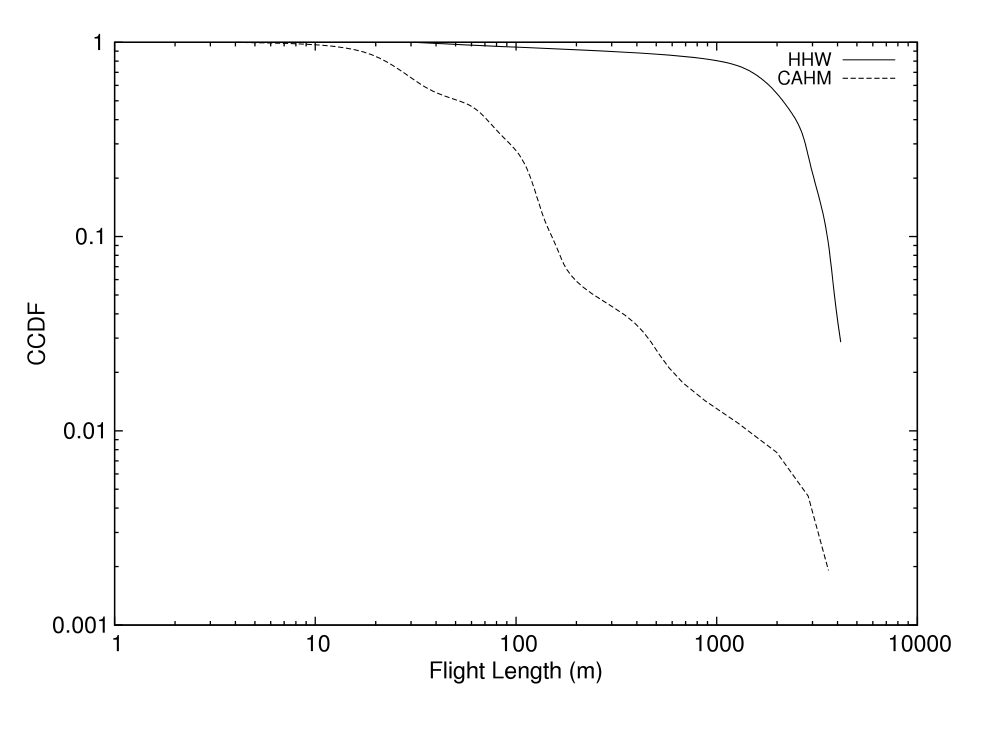
图 3|一个跨很多社区的节点,短距离会不会占多数?
无字母子图。横轴是单次位移长度,单位米;纵轴是互补累积分布(CCDF),表示长度大于横轴数值的位移占该节点全部位移的比例。实线是 HHW,虚线是 CAHM。对象是一个同时属于 11 个社区的节点,不是 200 个节点的平均。HHW 的曲线在 1000 米之前下降很少;CAHM 在 10 米到 100 米之间已经明显下降,长距离所占比例更低。来源:原论文 Fig. 3。
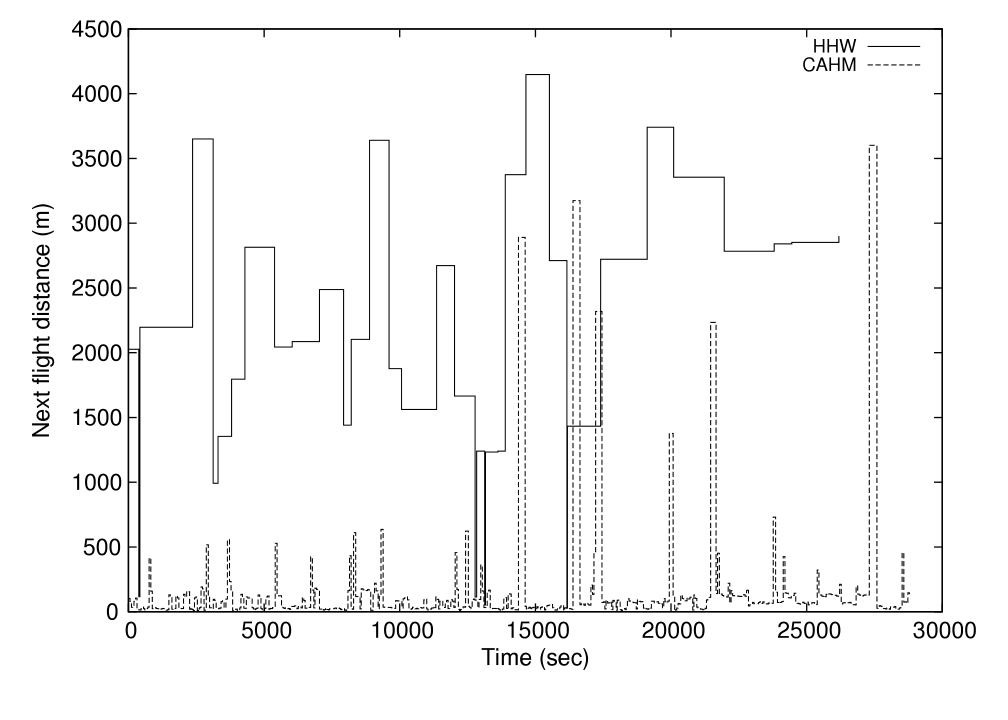
图 4|长距离是零星出现,还是接连出现?
无字母子图。横轴是时间,刻度到 30000 秒;纵轴是下一次位移的距离,刻度到 4500 米。实线 HHW,虚线 CAHM。正文把它接在图 3 的比较之后,用来说明长距离意味着跨社区。HHW 连续停留在纵轴上半部的距离;CAHM 多数时间贴近 0,只间或出现一次高距离。这是单个节点的时间序列,不能读成 200 人的平均行程。来源:原论文 Fig. 4。
改完选点之后,再次相遇间隔的形状还在。作者模拟两天,每天三个相同的 8 小时时段,每个时段用幂律随机数生成一套不同的重叠社区。
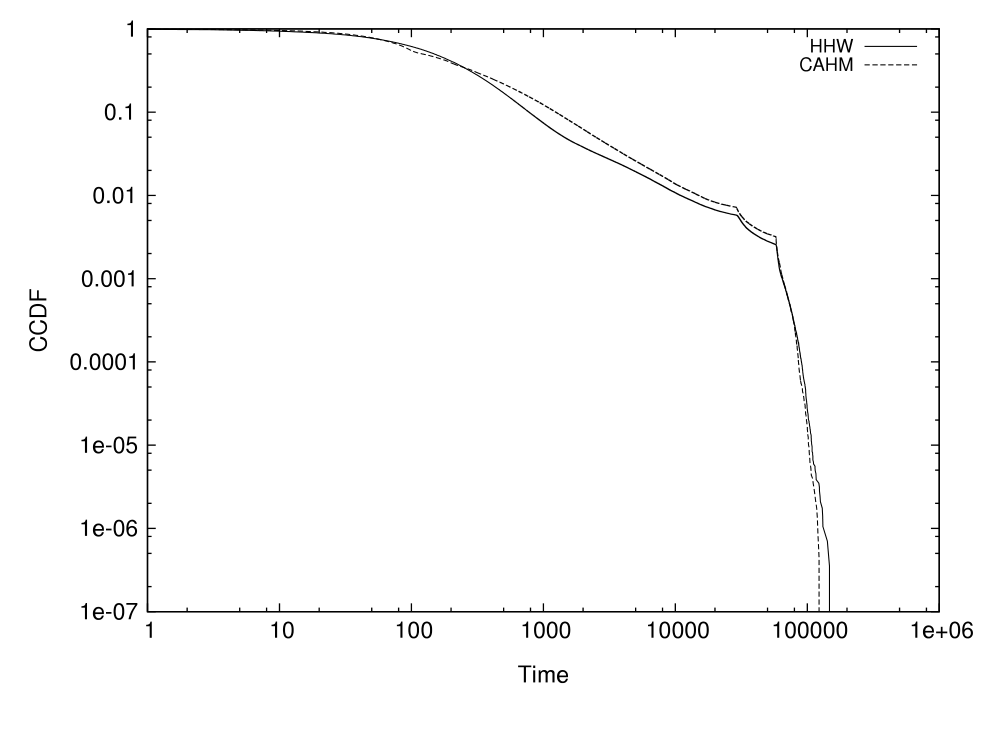
图 2|改了选点规则之后,再次相遇间隔还像原来那样吗?
无字母子图。纵轴是再次相遇间隔的 CCDF,横轴标注为 Time,刻度从 1 到 1e+06;图中没有另注时间单位。实线 HHW,虚线 CAHM,两条曲线接近:先缓慢下降,再在 10000 与 100000 之间迅速掉下去。正文说这与 HHW 一致,而 HHW 与真实轨迹的一致来自被引用的既有论文。本图没有叠上一条点名的真实轨迹。来源:原论文 Fig. 2。
格子数如果等于人数,热门节点为什么变多?
HHW 让社区人数 N 等于格子数 C。平均每个格子上的节点数就等于该社区的平均局部度 μ。节点每到一个格子,平均会遇见大约 μ 个节点,局部流行度随局部度上升的速度被放大。大社区里 μ 的上限又是社区规模,这个问题更重。作者认为,这使高局部流行度的节点比真实轨迹里更多。
CAHM 把格子数和人数分开。社区 x 的连通格子数
Cx = m × μx × Nx。
m 是所有社区共用的密度乘数。m 越大,同样的人数摊到越多格子上,社区越稀疏。
仿真里的局部流行度不是公式里的局部度。它是一个计数:在该社区内,与这个节点的相遇次数超过社区平均相遇次数的节点有多少。分母是该社区的相遇次数平均值;得分是人数,不是概率。
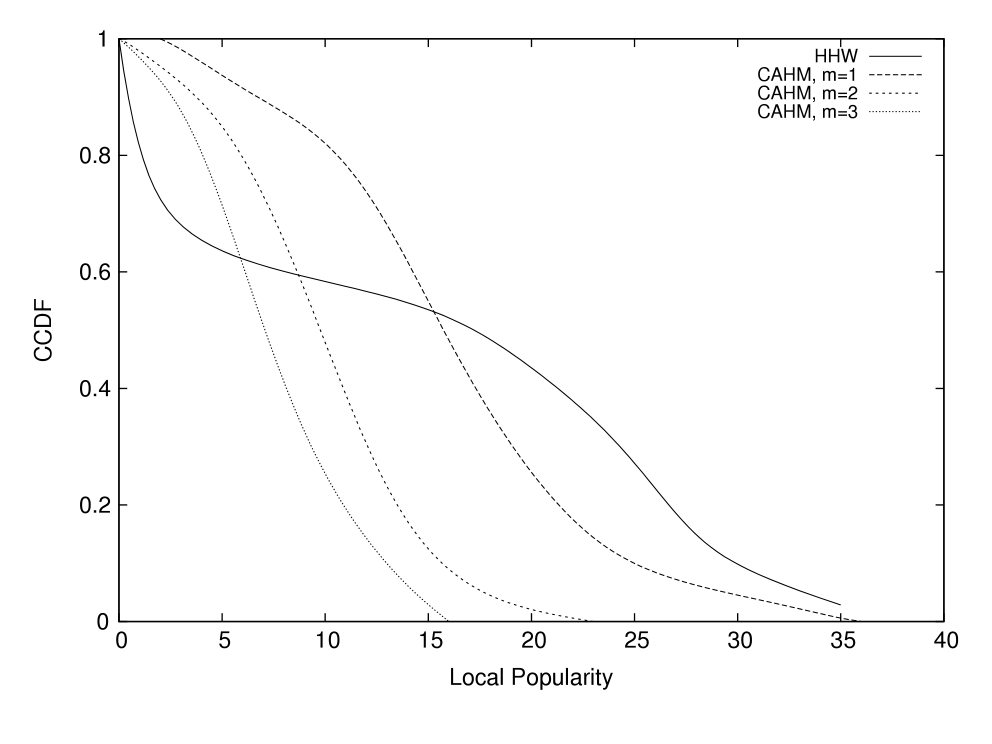
图 5|高局部流行度的节点,在两种模型里各占多少?
无字母子图。横轴是上面定义的局部流行度,刻度到 40;纵轴是 CCDF。曲线分别是 HHW,以及 CAHM 在 m = 1、2、3 时的结果。样本是一个规模为 70 的社区里的节点,不是全部 200 个节点。HHW 的曲线在高流行度一侧留着更长的尾巴;m 增大时,曲线更早降到接近 0。正文据此说,调 m 可以控制社区内的局部流行度。图中没有给出每条曲线的均值表。来源:原论文 Fig. 5。
后面比协议时,速度和停留是怎样配平的?
HHW 在第一组场景里把速度从 1 到 6 米/秒均匀抽取,与距离无关。Rhee 等从轨迹里得到位移时间 t 和位移长度 l 的关系:t = p × l 的 (1−η) 次方,η 在 0 和 1 之间。短于 500 米时 p = 30.55、η = 0.89;达到或超过 500 米时 p = 0.76、η = 0.28。CAHM 用这段时间去除长度,得到随距离变化的速度。长距离更快,对应换成交通工具,而不是把步行速度直接拉长。
协议比较换了一组空间和参数,不能和图 2 至图 5 的 5000 米场景混用。这里有 200 个节点,平面 13000 米 × 13000 米,HHW、CAHM 和 CMM 都是 13 个社区。HHW 与 CAHM 的格子为 250 米 × 250 米,传输距离 40 米,传输速率按正文写作 3 MBps,包大小 8 kB,节点缓冲不受限。包到达间隔从 1 秒变到 8 秒。CMM 用 13 行 13 列,重连概率 0.1,作者选择这个网格是为了让社区内节点密度与 HHW、CAHM 相同。
这一组里,CAHM 的位移长度指数是 1.29,不再是前面的 2。按距离计算后,平均速度为 8.23 米/秒。对照模型把平均飞行速度也设为 8.23 米/秒,但分布是 [0.35, 16.11] 米/秒上的均匀分布。CAHM 的停留时间用幂律,指数 2.39,范围 25 秒到 9500 秒,取自 Rhee 等称为 Campus I 的校园轨迹;这次仿真里的平均停留是 82.32 秒。对照模型把平均停留设为 82.5 秒,均匀分布只取 [25, 140] 秒。平均水平被配平,长尾没有被配平。
第一组属性检验里的停留时间是另一套:指数为 2,范围 0 到 1000 秒。读后面的投递率时,不要把这套停留时间带进去。
不洪泛消息,怎样从社区结构认出枢纽和网关?
要利用流行度不均匀,协议需要知道两类节点。枢纽(hub)是社区内部更常被遇见的节点;网关(gateway)是更常把本社区的消息带到其他社区的节点。直接做法是在社区内和社区之间洪泛消息,开销大。只靠过去相遇的滑动窗口,又会降低协议表现。CAHM 想从已经维护的重叠社区本身计算这两类节点。
节点可以用 AD-SIMPLE 的一个扩展记下自己到过的多个社区:当前社区仍按接触时长加入、按老化退出,退出的成员另存为一个社区,而不是丢掉。各节点还被假定知道自己在这些社区里访问的位置。论文没有报告这套分布式维护本身的字节开销。
局部流行度不能只看局部度。一个局部度很高、但大部分时间待在其他社区的节点,在本社区并不热门。作者把节点所属的社区当成马尔可夫链的状态。下一次位移留在本社区或前往另一社区的概率,由距离上的幂律积分得到:社区按离当前社区由近到远编号,每一段距离区间对应一次转移。稳态概率 w 加起来为 1,表示长期有多少时间比例待在每个社区。
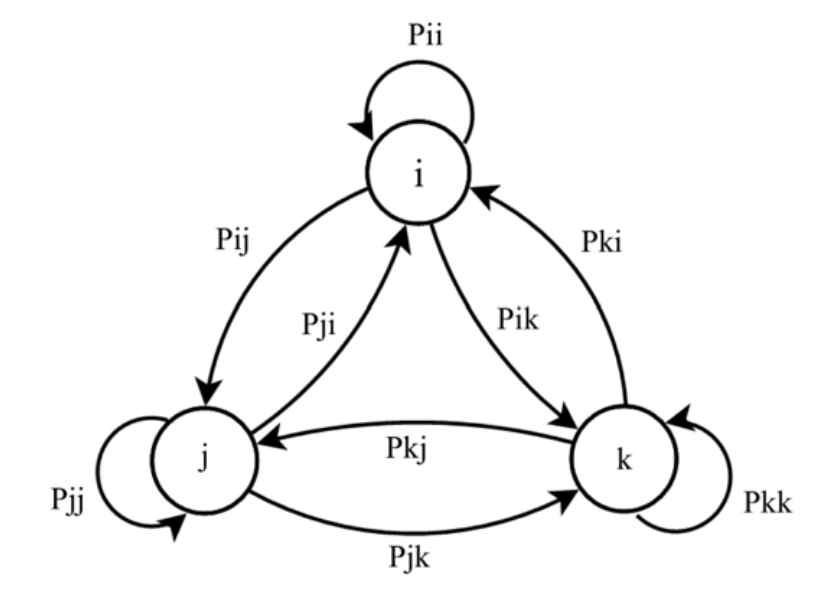
图 1|一个节点在多个社区之间,时间比例从哪里来?
无字母子图。圆圈 i、j、k 是一个节点所属的三个社区,箭头上的 P 是下一次位移的转移概率,自身环表示留在该社区。这是示意图,不是 200 个节点的统计图。稳态概率才是后面公式里的时间比例。来源:原论文 Fig. 1。
社区 i 的局部分数等于时间比例 wi 乘以该节点在社区 i 里访问的地点数 Locali。节点交换这个分数后,各自把局部分数较高的一定比例标成枢纽。全局分数还乘上两项:1 减平均自转移概率,以及该节点所属其他社区的规模之和。自转移越低,社区之间的移动越勤;其他社区越大,作者认为越值得优先当网关。交换全局分数后,再按给定比例标出网关。
验证用的仍是本节开头那套参数生成的结构,某个随机种子得到 13 个社区。公式分数和仿真测量都先排成名次,再用 Spearman 等级相关系数 ρ 比较。ρ 比较的是名次是否单调一致,不是两个分数的原始数值是否相等。ρ = 1 表示估计名次是测量名次的完全单调函数。
枢纽有两个对照。第一是仿真中按相遇次数定义的局部流行度;13 个社区的 ρ 平均为 0.9890。第二是社区内部用 Epidemic 路由送包,统计节点出现在最短路上的次数;平均 ρ 为 0.9980。网关也有两个对照。第一只对同时属于其他社区的节点计算介数,并且只保留起点在本社区、终点在其他社区的最短路;平均 ρ 为 0.9770。第二是跨社区的 Epidemic 最短路,要求节点在路上且下一跳属于其他社区;平均 ρ 为 0.9880。正文还说,公式给出的时间比例与节点实际待在各社区的时间比例非常接近,但没有给出误差数字。
这是一次生成的 13 个社区上的排序相关。它支持“在这套模型和这组参数下,公式名次与仿真名次几乎单调一致”,不能单独证明公式是唯一机制,也不能换成任意城市的接触记录后仍得到同样的 ρ。
同样平均速度下,两种路由差了多少?
Epidemic 路由见到邻居就复制转发,不使用社区或流行度。BubbleRap 使用社区结构和节点的不均匀流行度。作者比较二者在 CAHM、HHW、CMM 和 RWP 下的投递率与平均时延。正文没有单独写出投递率的分子和分母;结论里的百分比是相对 HHW 的变化,不是相对 RWP,也不是各条曲线的逐点读数。
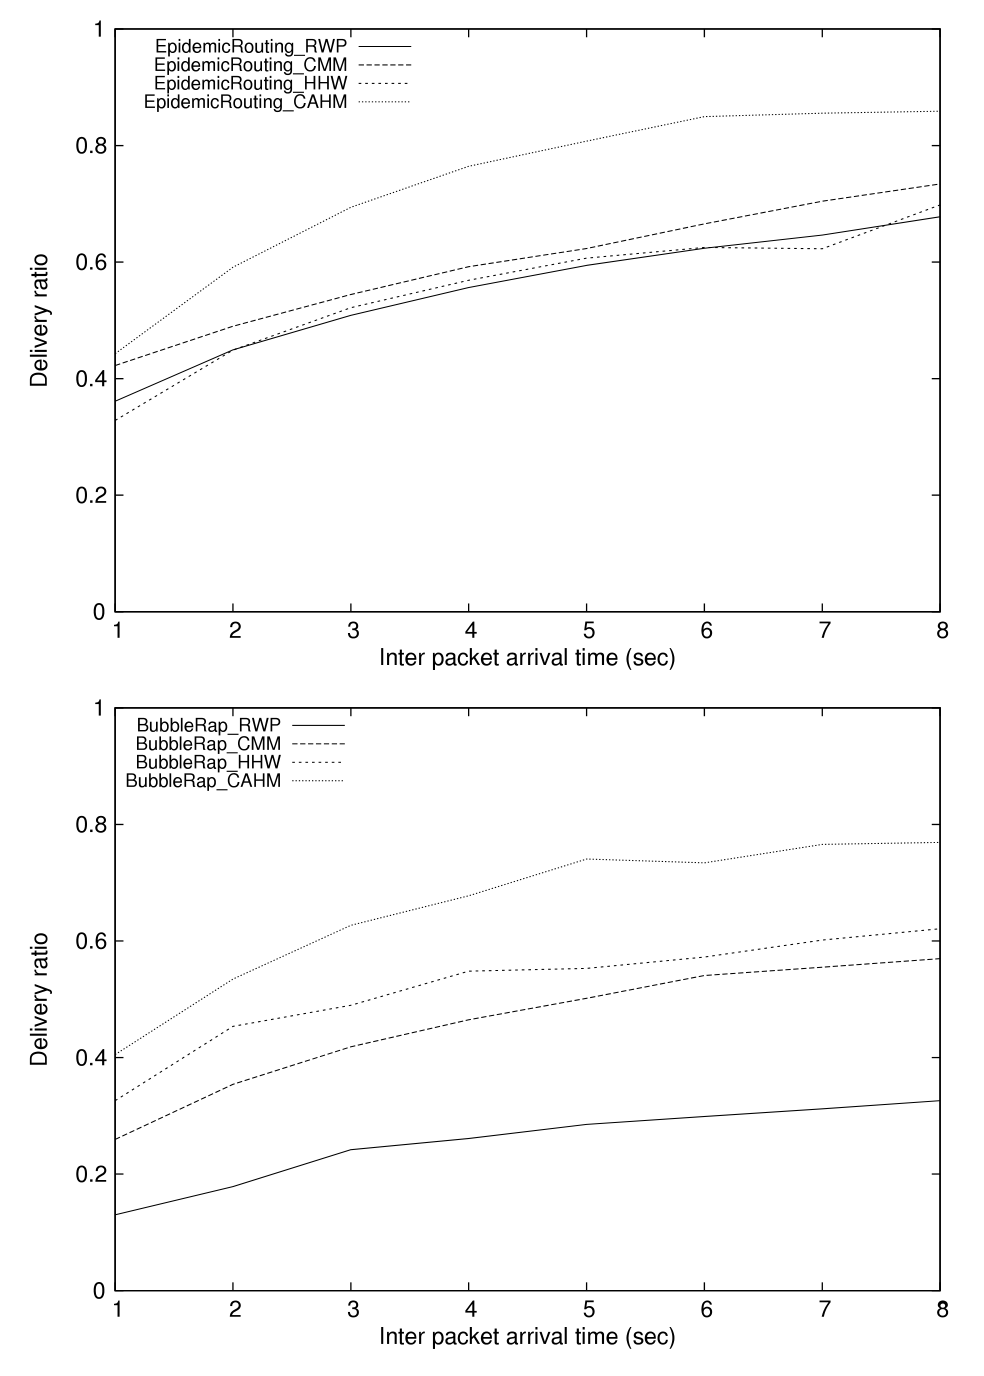
图 6|包来得更稀时,多少包能够送达?
无字母,上下两幅。上图是 Epidemic,下图是 BubbleRap。横轴都是包到达间隔 1–8 秒,纵轴是投递率,刻度 0 到 1。四种线型依次对应 RWP、CMM、HHW、CAHM。两幅图里 CAHM 都在最上方,间隔变长时投递率上升。BubbleRap 在 RWP 下明显低于其他三种移动模型。正文没有附原始投递率表,图上的具体高度不宜再精确到小数点后两位。来源:原论文 Fig. 6。
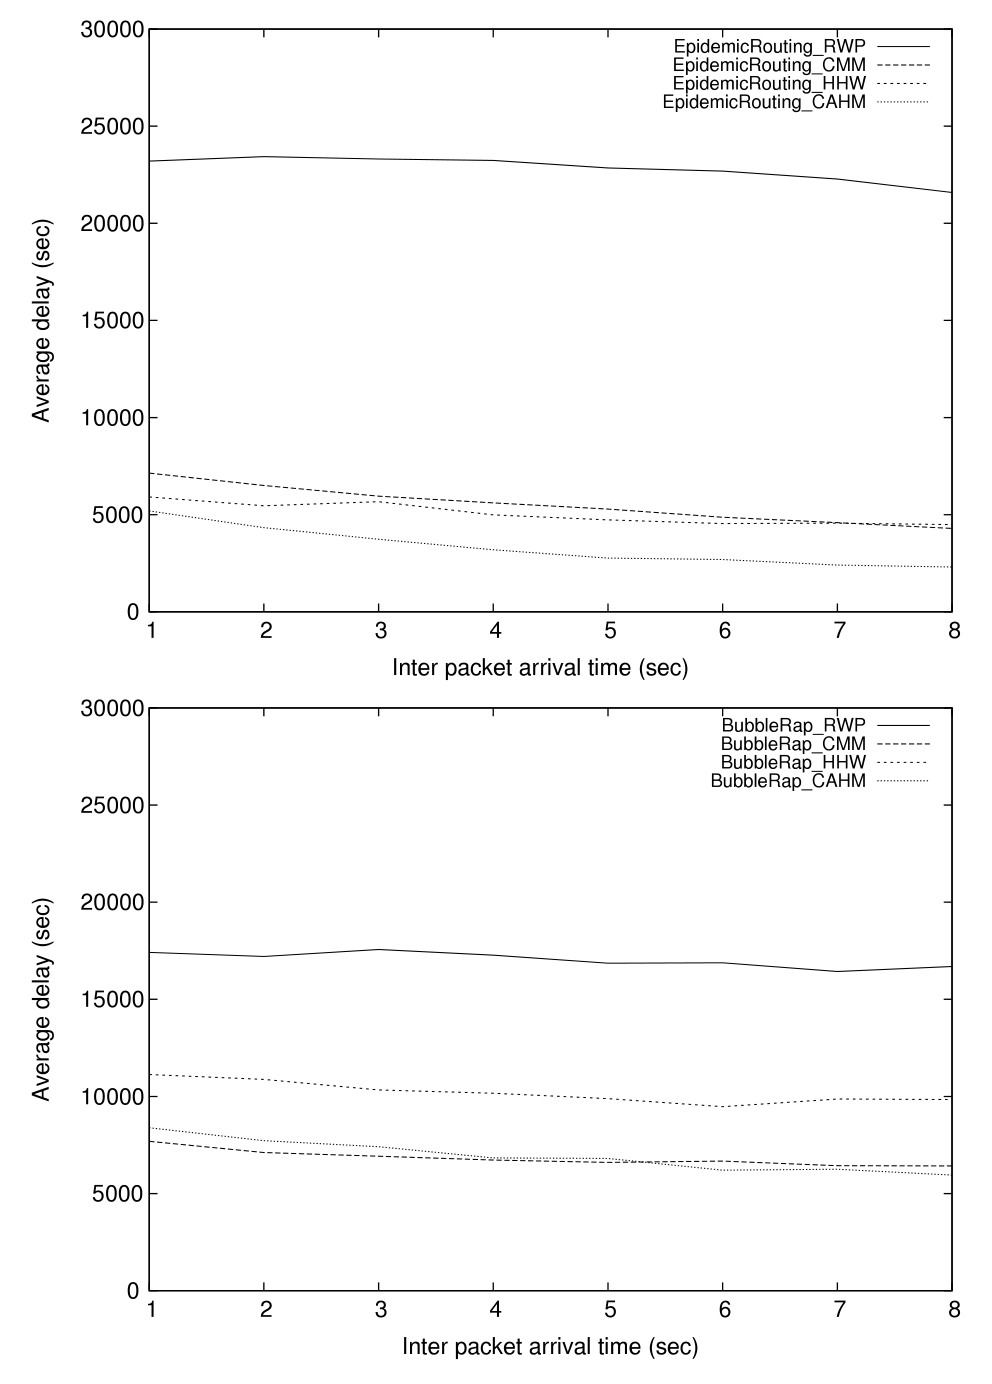
图 7|送达的那些包,平均要等多久?
无字母,上下两幅。上图 Epidemic,下图 BubbleRap。横轴仍是 1–8 秒,纵轴是平均时延,刻度到 30000 秒。RWP 在两幅图里都处于最高的一组,纵轴刻度到 30000 秒;CAHM 处于较低的一组。正文给出的汇总是:相对 HHW,两种协议的平均时延降低 40%–50%。这个范围是两种协议、各个到达间隔放在一起的作者汇总,不是从某一秒上读出的单点。来源:原论文 Fig. 7。
结论写明,在这组设置下,两种协议的投递率相对 HHW 提高 23%–26%。分母是同一协议在 HHW 下的投递率。若把差异理解成百分点,数值会是另一回事,正文没有给出那张表。
图 6 和图 7 还说明另一件事:在 CAHM、HHW 和 CMM 下,Epidemic 与 BubbleRap 的投递率和时延差距,比在 RWP 下更小。与此同时,这组仿真里 Epidemic 的每包传输次数大约比 BubbleRap 多 50%,分母是 BubbleRap 的每包传输次数。作者由此认为,利用社区结构和不均匀流行度能改善转发;移动模型若缺少这些特征,仿真会低估协议表现。这里的“低估”是相对 CAHM 这组合成移动而言,不是相对一份实地测量。
由于 CAHM 相对 HHW 同时改了短距离偏好、格子密度、随距离变化的速度和幂律停留,投递率上升不能单独记到其中任何一项上。对照模型又只配平了平均速度和平均停留,CAHM 的停留可以长到 9500 秒,对照模型的均匀停留停在 140 秒。时延差里仍然可能混有停留分布的影响。
检测出来的小社区,是稳定群体吗?
作者按相遇次数做了 172 个接触图,每个覆盖 1000 秒。相遇次数高于某个阈值才连边,阈值的具体数字正文没有给出。图导入 Gephi,用模块度算法找社区,分辨率设为 1。节点大小与度成比例,同色节点属于算法给出的同一社区。
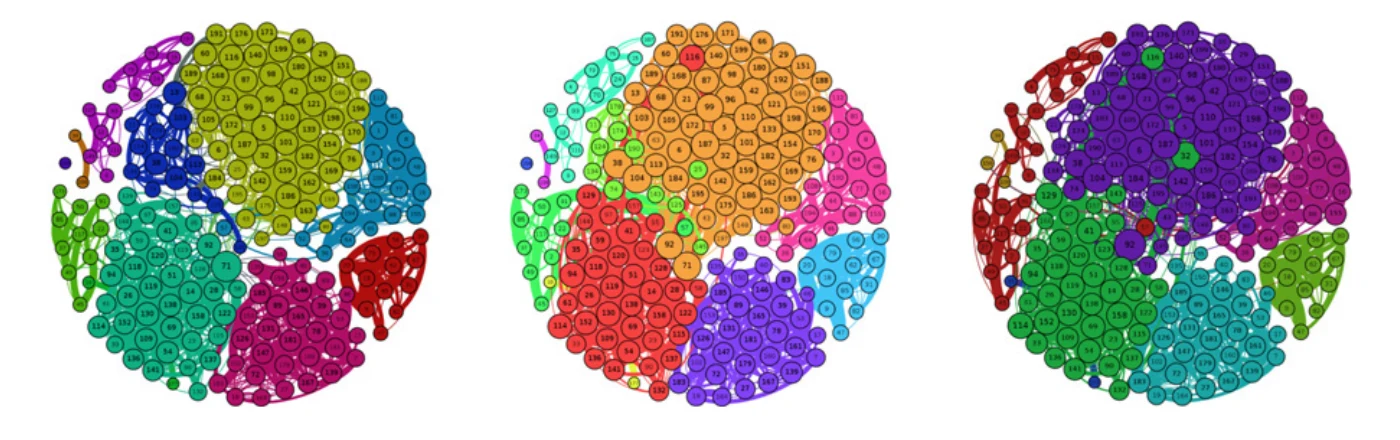
图 8|连续三个短窗口里,社区颜色稳定吗?
无字母,从左到右是最初三个连续的 1000 秒区间。颜色是模块度算法的社区,点的大小表示度。夹在另一种颜色里的节点,表示它的社区归属发生了变化。正文说检测结果与模型预设的社区结构接近,但没有给出节点被分到预设社区的比例。来源:原论文 Fig. 8。
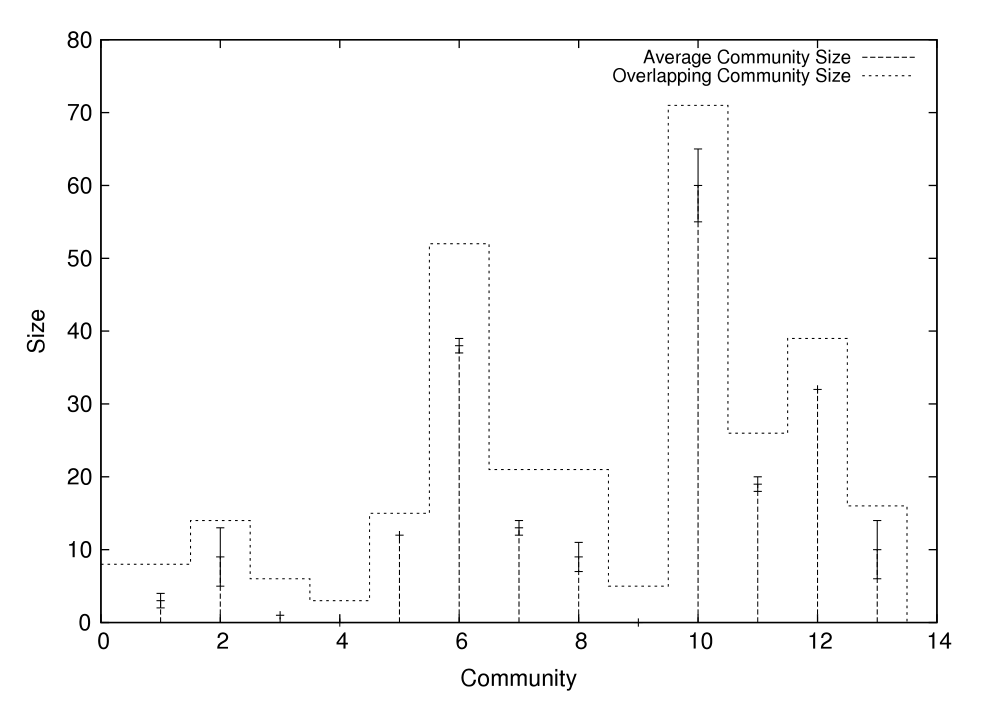
图 9|算法看到的社区,为什么比生成时更小?
无字母子图。横轴是社区编号,纵轴是规模,刻度到 80。图例分为 172 个区间的平均社区规模,以及 CAHM 生成的重叠社区规模。较高的阶梯是生成规模,较低且带误差线的点是检测规模的平均;正文说明后者更小,因为一个节点可以属于多个社区,模块度算法只把它放进一个。误差线是标准差还是标准误,正文没有写。来源:原论文 Fig. 9。
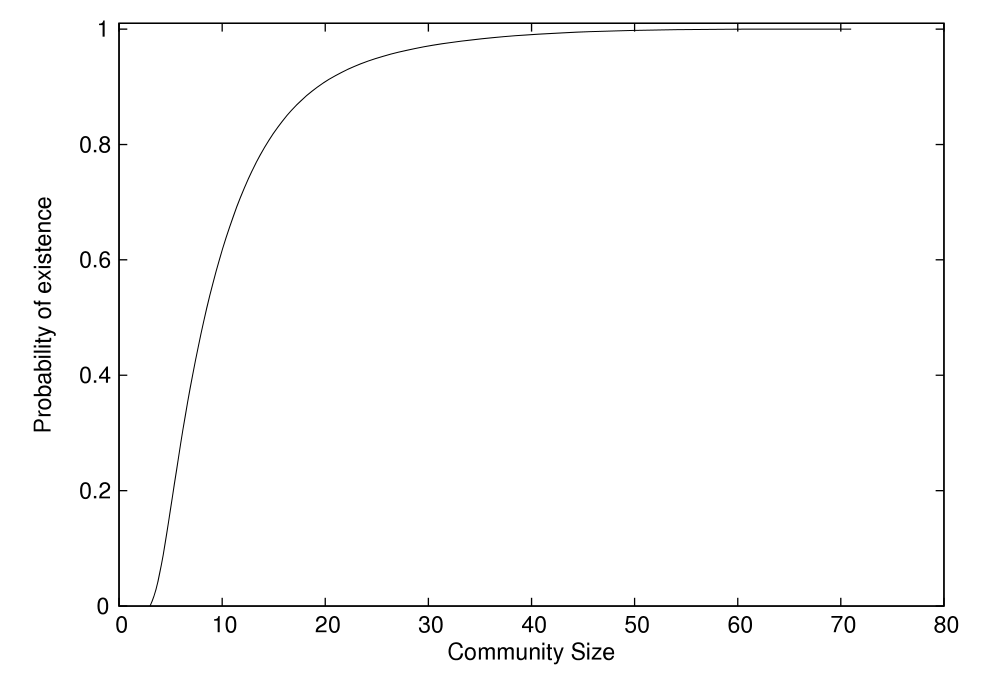
图 10|多小的社区会很快消失?
无字母子图。横轴是社区规模,纵轴是该规模的社区在 172 次检测中出现的比例。曲线在规模 20 之前上升很快,之后接近 1。正文说,13 个幂律规模的社区、一共 200 个节点时,拐点大约在规模 20。结论把这个门槛写成节点总数的大约 10%,200 的 10% 就是 20。它是这组阈值和窗口下的观察,阈值本身没有公布。来源:原论文 Fig. 10。
枢纽是否留在社区里,用的是另一次规模。作者生成 1000 个节点的社区结构,把各社区局部流行度排序后的前 30% 标为枢纽,再看不同区间里这些枢纽出现在社区中的比例。30% 的分母是该社区局部流行度排序后的节点,不是 1000 人里随意抽 30%。纵轴比例的分母,正文没有写成公式。
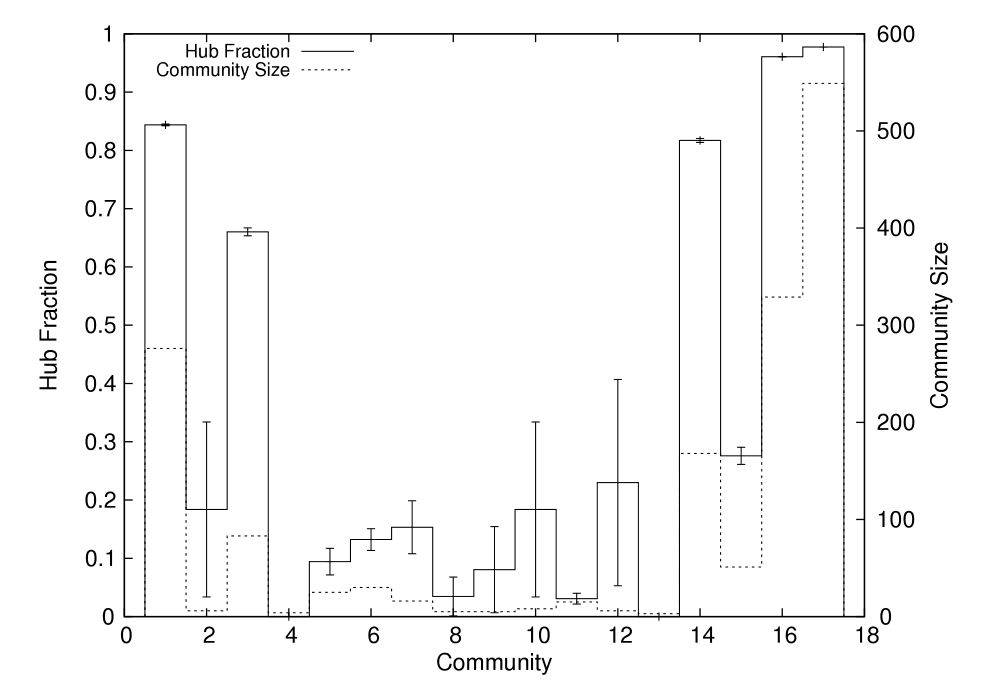
图 11|大社区是不是更能留住枢纽?
无字母子图。横轴是社区编号。左轴是枢纽比例,刻度 0 到 1;右轴是社区规模,刻度到 600。实线柱是枢纽比例,虚线阶梯是社区规模,误差线按正文对应于标准差。规模较大的社区,枢纽比例更高、误差线更短;较小的社区比例更低、波动更大。右轴显示若干社区的规模远超过前面 200 节点实验里的社区,不能把两张图的柱高直接比较。来源:原论文 Fig. 11。
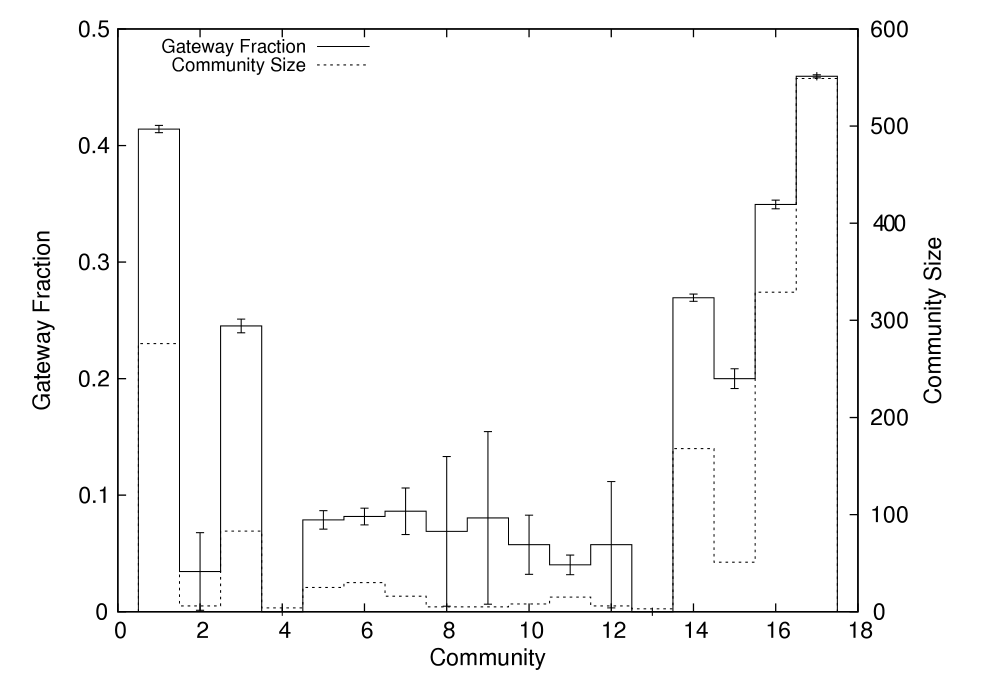
图 12|网关留在社区里的比例,和枢纽一样高吗?
无字母子图。坐标与图 11 相同,只是左轴换成网关比例,刻度只到 0.5。实线柱是网关比例,虚线阶梯是社区规模。大社区的比例仍然较高、波动较小,但同一社区上的网关比例明显低于图 11 的枢纽比例。正文没有在这一段重复枢纽使用的前 30% 阈值,因此不能默认网关也是按 30% 划定的。来源:原论文 Fig. 12。
这些比较能支持到哪一步?
CAHM 是移动模型,输出的是仿真节点的轨迹、相遇和协议统计。局部流行度的计数、枢纽名次和投递率都依赖社区如何生成、格子多大、传输距离多远。第一组实验的平面边长 5000 米、传输距离 20 米;协议实验的边长 13000 米、传输距离 40 米。两边的位移指数和停留时间分布也不相同。
排序相关很高,说明在这次生成的 13 个社区里,公式名次和仿真名次几乎可以互相代替。它没有取消“地点已知、社区成员名单已知”这两个前提,也没有报告多次随机种子的 ρ 分布。模块度检测把重叠成员强制分进一个社区,所以图 9 的检测规模系统性小于生成规模;建边阈值未公布,小社区“不稳定”的拐点会随阈值改变。
协议结果把四项移动改动绑在一起,又只配平了平均速度和平均停留。可以确定的是:在公布的这组 ONE 设置里,CAHM 相对 HHW 带来了作者汇总的 23%–26% 投递率升幅和 40%–50% 时延降幅。不能据此说其中某一项改动单独造成了全部差异,也不能把仿真投递率写成某次会议或校园里的实测送达率。
一句话总结
人更常留在近处、活动格子也不再被人数绑死后,仿真社区里特别热门的节点变少,按社区结构排出的枢纽和网关与相遇名次高度一致;投递率上升仍然是多项移动设定叠在同一次仿真里的结果。
核心来源
- Pervasive and Mobile Computing 论文页面,核对题目、作者、2015 年第 21 卷 119–132 页与 DOI。本文图表和数值按期刊 PDF 正文 Fig. 1–12 核对。
- DOI:10.1016/j.pmcj.2014.12.008。
- 作者公开的 ONE 仿真实现。仓库说明指向本文;正文数值不改用仓库配置代替。
作者介绍
- Zunnun Narmawala:论文署名为印度艾哈迈达巴德 Nirma University 的 Institute of Technology,通讯作者。学院主页介绍其研究兴趣包括无线网络、机会网络和移动社交网络,并写明博士学位于 2016 年在 DA-IICT 获得。
- Sanjay Srivastava:论文署名为甘地讷格尔的 Dhirubhai Ambani Institute of Information and Communication Technology。该校教师页列出其方向包括物联网、协议建模分析与仿真,并收录本文。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果转发协议只用局部度挑选枢纽,一个加入很多社区的人会被反复选中,即使他在每个社区只停留很短时间。CAHM 的分数把局部度换成了时间比例乘访问地点数,并在这次仿真里得到很高的等级相关。还没分开检验的是:把时间比例从公式里拿掉之后,ρ 会下降多少。用同一份接触记录分别按“地点数”和“地点数乘停留比例”排序,才能看出这项修正到底改变了谁。
另一个容易被当成通用规则的数字,是 200 个节点里规模大约 20、也就是 10% 的社区拐点。它来自未公布阈值的 1000 秒接触图和分辨率等于 1 的模块度。阈值提高或窗口加长,小社区会更早并进大社区,10% 这个比例可能移动。把同一轨迹按 500 秒、1000 秒、一小时各做一次,拐点若仍靠近节点总数的一成,这条经验才更值得写进转发策略;若随窗口明显漂移,它就主要反映检测设置。