两个城区算不算有关系,为什么不能只看它们离得有多近?
论文名片|Ya-Jing Xu、Chao Xue、Gong-Fu Li、An-Gen Luo、Yi-Zhe Song,Discovering Social Relationship between City Regions using Human Mobility,11th EAI International Conference on Heterogeneous Networking for Quality, Reliability, Security and Robustness (QSHINE 2015),2015,pp. 104–109。DOI:10.4108/eai.19-8-2015.2260775。
地图上贴在一起的两个基站格子,看起来像邻居。人反复停留、并且从其中一个区域来到另一个区域,却可能隔着几公里。这篇论文要量的是后一种联系:一座中等城市里,区域之间因为停留而形成的有向强度,以及一个区域的人究竟从多少个地方来。
方向已经比较清楚。若只数有非零联系的来源,一个区域平均连着大约 84 个区域;把联系按小时拆开,不确定性大约只相当于 2.64 个区域。用后一个熵算出的潜在可预测性,对全部区域平均是 0.88。这个数是“人从哪些区域来”的准确率上界。
先说结论
- 分析单位是 2440 座基站划出的泰森多边形。邻近基站平均相距 0.83 公里。关系只使用停留区域,距离阈值 0.8 公里,时间阈值 30 分钟。
- 区域激活力同时计入有序共现有多频繁,以及这些共现的平均距离。在 4 个区域、3 条示意轨迹里,关联规则只有 1 和 0.667 两档;激活力可以从 0 到 0.422,而且两个方向的数值可以不同。
- 入链随机熵平均约 6.4 比特,约合 84 个来源区域。按小时计算的区域激活熵平均约 1.4 比特,约合 2.64 个区域。出链的分布相近,后文只用入链。
- 由区域激活熵经 Fano 不等式得到的可预测性,对全部区域平均为 0.88。分布熵对应的可预测性在 0.5 附近最密,而且区域之间差别很大。这里没有另做一套预报实验来报告命中率。
- 四类功能区的激活距离都在约 2 公里形成高峰。平均距离为教育 3.63 公里、居住 3.66 公里、商业/娱乐 2.95 公里、政府机关/公共机构 3.22 公里。万达广场只是一个商业样例。
格子从基站来,关系只保留停留
论文把一座中等城市按基站位置切成泰森多边形(Voronoi diagram):每个格子离自己的基站比离其他基站更近,一个格子里只有一座基站。图 1 标注的范围是 130 公里×70 公里。文中没有写出这座城市的名字,所以后面的公里数不能直接挪到另一座城市。
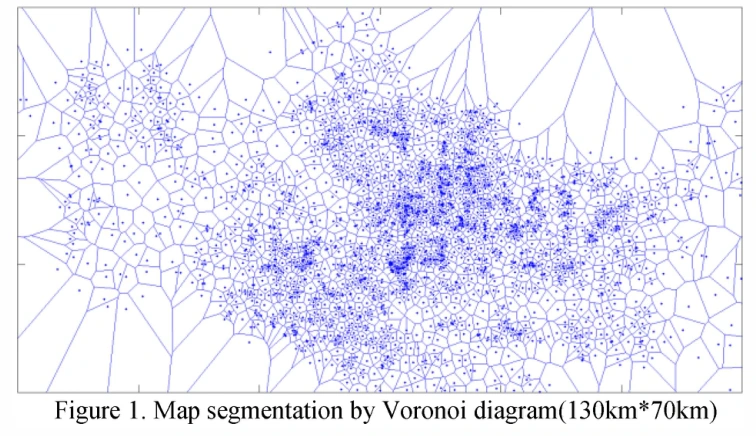
图 1|城市区域是按什么边界切开的?
无字母子图。蓝点为基站,蓝线为泰森多边形,图中范围 130 公里×70 公里。市中心格子小而密,外围格子大。后文每一个区域对应一座基站。来源:原论文 Fig. 1。
人的移动在这里是匿名手机用户连上的基站序列。一次轨迹按天切开:实验里把一天当作一个时段。序列里的区域再分成停留和经过。论文沿用位置历史里的停留判定,距离阈值内持续达到时间阈值时,把这段里靠近中心的区域记为停留,其余记为经过。图 2 是这个判定的示意图。后面的区域关系只接收停留,因为作者要看目标区域的人从哪里来,经过的格子不进入这张表。
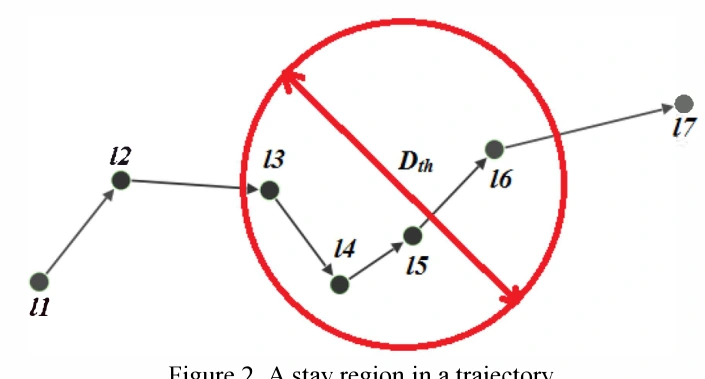
图 2|示意图里,哪一个点会被记成停留?
无字母子图。l1 到 l7 沿箭头排列,红圈直径标为距离阈值 Dth。正文用此图说明:当 l6 的离开与 l3 的到达相差达到时间阈值时,靠近这段中心的 l5 记为停留,其余记为经过。这不是实测地图。来源:原论文 Fig. 2。
两个阈值来自全体数据的分布,分母是 2440 座基站之间的邻近距离,以及全部用户在各区域的停留时长。邻近距离多数小于 1 公里,平均 0.83 公里,所以距离阈值取 0.8 公里。分布在大约 0.3 公里处最高,作者据此认为市中心许多基站的覆盖大约 300 米。停留时长几乎都短于半小时,所以时间阈值取 30 分钟。
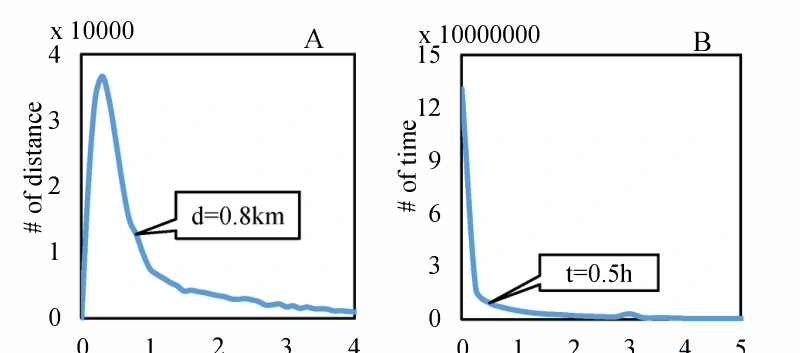
图 3|0.8 公里和 30 分钟是从哪两张分布上选的?
(A)2440 座基站的邻近距离。纵轴计数要乘以 10000,横轴为公里。曲线在约 0.3 公里附近最高,之后迅速下降;箭头标在 0.8 公里。正文给出的平均值是 0.83 公里。(B)全部用户在各区域的停留时长。纵轴计数要乘以 10000000,横轴为小时。曲线在半小时以前已经很低;箭头标在 0.5 小时。两张图的纵轴乘数不同,不能直接比较高度。来源:原论文 Fig. 3。
实验部分说明,这套记录来自移动运营商,大约覆盖 400 万名匿名用户、一个月、同一座有 2440 座基站的中等城市。按上述规则得到 6500 万条停留轨迹,并送进后面的熵模型。6500 万是轨迹条数,约 400 万是用户数,两者不能相除后当成每人每天的出行次数,论文也没有做这个除法。
共现要分方向,还要除以距离的平方
区域激活力(Region Activation Force,RAF)借用了词语网络里的激活力。一条停留轨迹被当成一篇短文,一个停留区域被当成一个词。它要比较的是:区域 i 在 j 之前出现得有多频繁,相对两个区域各自出现的次数有多高,再受到距离惩罚。
rafᵢⱼ = (fᵢⱼ / fᵢ) · (fᵢⱼ / fⱼ) / dᵢⱼ²
fᵢ 是区域 i 在全部停留轨迹中出现的次数,fᵢⱼ 是 i 先于 j、并且落在窗口内的共现次数,dᵢⱼ 是这些共现的平均距离。区域指向自己的激活力被设为 0。矩阵里,第 i 行的非零值是 i 的出链,第 i 列的非零值是 i 的入链。因为分子用的是有序共现,i 到 j 和 j 到 i 可以不相等。
自然语言里,词窗口常常只取前后大约 5 个词。作者认为一条轨迹里的停留区域通常不超过 5 个,于是把窗口放到整条停留序列:排在后面的停留都计入共现。这是计算设定。论文没有另外给出“超过 5 个停留区域的轨迹占全部轨迹的比例”。
他们还用同一份示意样本算了关联规则(association rules)。示意数据只有 4 个区域和 3 条停留序列:第一条是 R1、R2、R3、R4,第二条是 R1、R2、R1,第三条是 R4、R1、R3、R2、R4。四个区域的出现次数是 f1=4,f2=3,f3=2,f4=3。在这 3 条序列里,R1 到 R2 的激活力是 0.422,关联规则值是 1;R3 到 R1 的激活力是 0,因为 R1 没有出现在 R3 之后,关联规则仍是 0.667。整张对照表里,关联规则只有 1 和 0.667 两种数。激活力把次数和距离都放进去,所以这 12 个有向对被拉开了。这些数字的分母是 3 条构造序列,用来说明为什么后文选用激活力,不是那 6500 万条城市轨迹的结果。
84 个来源,和不到 3 个来源,量的不是同一件事
激活力矩阵已经给出每对区域的强度。下一步要问:指向同一个目标的这些强度,到底有多集中。论文定义了三种熵,都用来描述“哪些区域在激活目标区域”。
随机熵只使用来源个数。区域 i 的随机熵是 log nᵢ,nᵢ 是对 i 有非零激活力的区域数。论文把它读成比特。入链随机熵的平均值约 6.4,而 2 的 6.4 次方约等于 84。翻译出来就是:平均而言,大约有 84 个区域以非零激活力指向一个目标。84 是这个平均值换算成的区域数,图上绿色分布从大约 5 伸到 9,并不是每个区域都刚好连着 84 个来源。随机熵低,作者把它理解成这个区域的来源更少、更“私密”。这是多样性的描述。
分布熵进一步看强弱是否悬殊。把指向 i 的激活力归一化成比例,再计算这些比例的熵。来源很多但其中一两个特别强时,分布熵会低于只看个数的随机熵。
区域激活熵(Region Activation Entropy,RAE)再把时间放进来。一个时段可以切成 m 段,本文按小时切。每个小时单独把入链激活力归一化并计算熵,然后对各个小时取平均。平均 RAE 约 1.4 比特,2 的 1.4 次方约等于 2.64,不到 3 个区域。论文写的是按小时平均之后的不确定性。一般而言,RAE 不高于分布熵,分布熵不高于随机熵:小时内的比例比全天混在一起更具体,只知道来源个数最不确定。
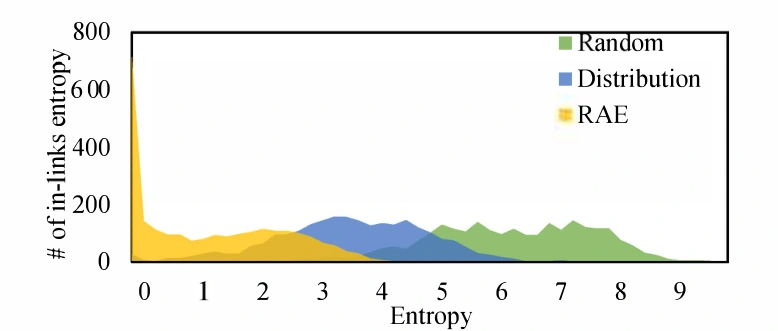
图 4|入链的三种熵,区域都堆在哪里?
无字母子图。横轴为熵,纵轴为区域计数,刻度到 800。绿色是随机熵,蓝色是分布熵,黄色是按小时计算的 RAE。黄色集中在接近 0 的一侧,蓝色居中,绿色更靠右。正文的 6.4 和 1.4 是平均值,不是三条曲线的峰位。黄色柱顶贴到刻度上沿时,不宜读成精确区域数。来源:原论文 Fig. 4。
人从起点去到目的地之后往往会返回,所以一个区域既可以是别人的来源,也可以把人送出去。出链三种熵的形状和入链接近。矩阵本身不对称,作者也写明,仍有一部分区域的入链和出链相差很大,留作后续问题。因为总体上接近,后文只使用入链,也就是“人从哪些区域来到这里”。
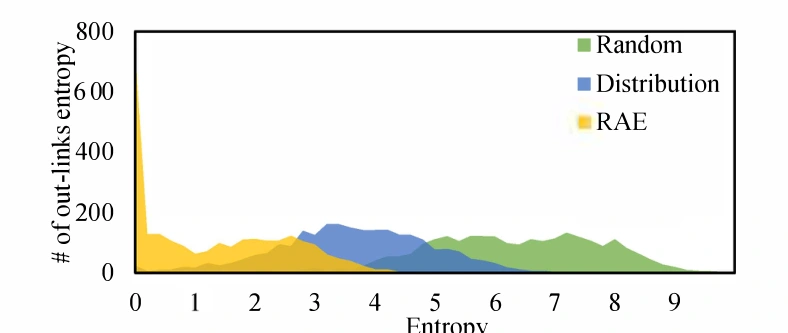
图 5|出链会不会给出另一套不确定性?
无字母子图。颜色与图 4 相同,纵轴改为出链熵的区域计数,刻度到 800。黄色仍偏低,蓝色居中,绿色偏高,整体形状与入链相近。来源:原论文 Fig. 5。
0.88 是准确率上界,分母是区域
熵越高,来源越不确定。论文用 Fano 不等式把每种熵换成一个准确率上界:无论预测方法多好,判断“区域 i 的人从哪个区域来”的准确率也不会超过这个上界。每个区域、每种熵分别得到一个上界。摘要里的 88%,正文写作由 RAE 得到的可预测性平均为 0.88。分母是全部区域,不是用户,也不是停留轨迹。
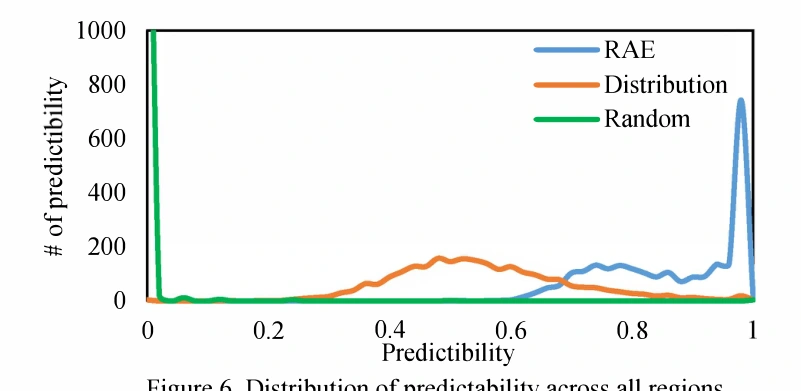
图 6|0.88 是峰的位置,还是全部区域的平均?
无字母子图。横轴为可预测性,图中拼作 Predictibility,范围 0 到 1;纵轴为区域计数,刻度到 1000。蓝色是 RAE,橙色是分布熵,绿色是随机熵。绿色挤在 0 附近并贴到 1000;橙色在 0.5 附近形成宽峰;蓝色在接近 1 处最高。正文的 0.88 是蓝色这组上界对全部区域的平均值,不是尖峰的横坐标。来源:原论文 Fig. 6。
只知道相关区域有多少个时,可预测性最差,图上集中在 0 附近。分布熵的上界分布很宽,峰值在 0.5,区域之间差别很大,不能概括成“所有区域都是一半”。RAE 的上界整体更高,因为小时内的来源比例已经被用上。
这个 0.88 来自熵和不等式,论文没有再训练一个预测器,也没有报告留出日期上的命中率。它也不能当成一个人下一站的可预测性。Song 等人 2010 年讨论的是个人位置序列;本文的问题是区域之间的来源关系。
同样大约 2 公里的高峰,平均距离并不一样
作者在一篇尚未发表的前作里,把这座城市的区域分成 9 类社会功能。本文没有列出 9 类的名称,也没有给出分类步骤,只比较其中 4 类的激活距离:教育、居住、商业/娱乐、政府机关/公共机构。横轴是激活区域到目标区域的平均距离,纵轴是该距离出现的频繁程度。四条曲线的高峰都在大约 2 公里。平均距离分别是教育 3.63 公里、居住 3.66 公里、商业/娱乐 2.95 公里、政府机关/公共机构 3.22 公里。商业/娱乐的平均距离最短。
教育和政府的曲线有多个起伏,居住和商业/娱乐更接近单峰。作者的解释是,学校和政府机构跟着行政区布置,商业区更跟着人口分布。这是对形状的解读。四类用的是同一种激活力,所以类与类之间的形状差别,来自数据里距离如何分布,而不是每一类各用一个公式。激活力本身又把平均距离的平方放在分母里,近距离共现会得到更大的强度。图 7 画的是激活距离的频繁程度,宜和“公式已经惩罚远距离”分开看。
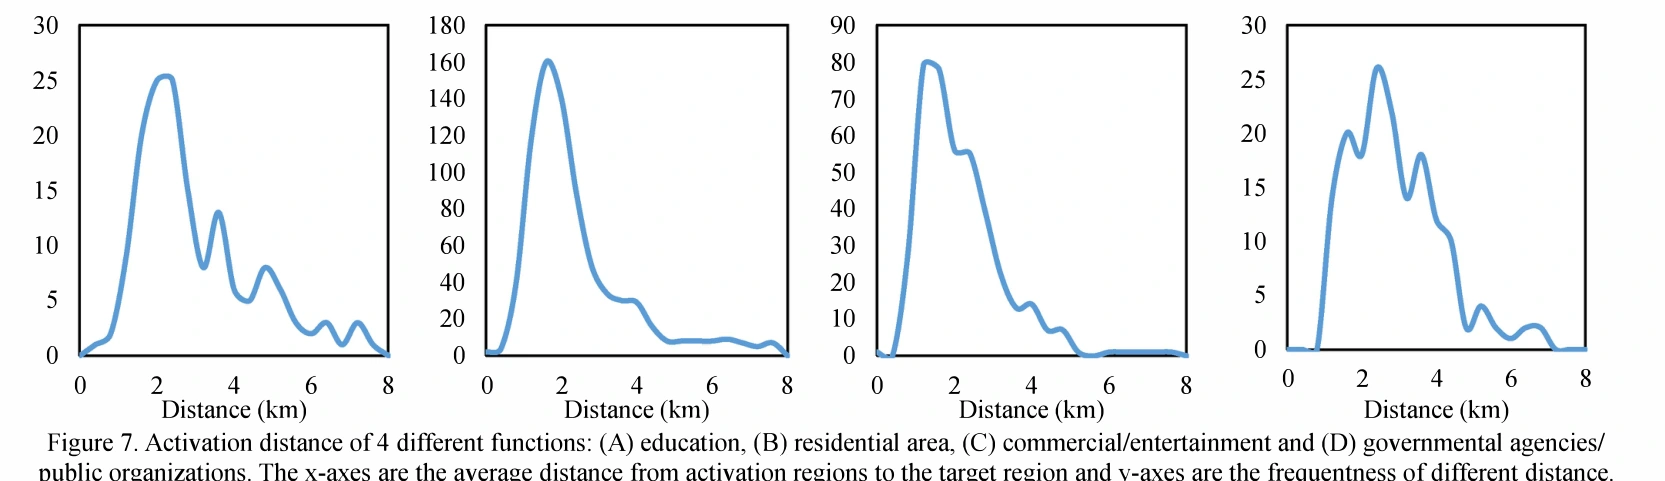
图 7|四类功能的激活距离,高峰和拖尾各是什么样?
(A)教育,纵轴频繁度刻度到 30,约 2 公里处最高,更远处还有较小起伏。(B)居住,纵轴刻度到 180,约 2 公里处单峰,右侧有长尾。(C)商业/娱乐,纵轴刻度到 90,高峰也在约 2 公里,6 公里以后接近底部。(D)政府机关/公共机构,纵轴刻度到 30,2 公里前后有多个起伏。四个横轴都是 0 到 8 公里。纵轴刻度不同,不能跨面板比较高度;频繁度也没有给出可换成百分比的分母。面板上没有另印 A–D,顺序是从左到右。来源:原论文 Fig. 7。
功能差异之后,论文改看一个地点在一天内的变化。样例是万达广场,一个商业地点。每张小图 9 公里×6 公里,中央绿色格子是目标,其他颜色是指向它的非零激活力。8 点以前没有区域激活它;上午着色区域慢慢变多,下午保持,傍晚最多,夜里很快减少。这是一个地点的小时图,不是全部商业区的平均曲线。
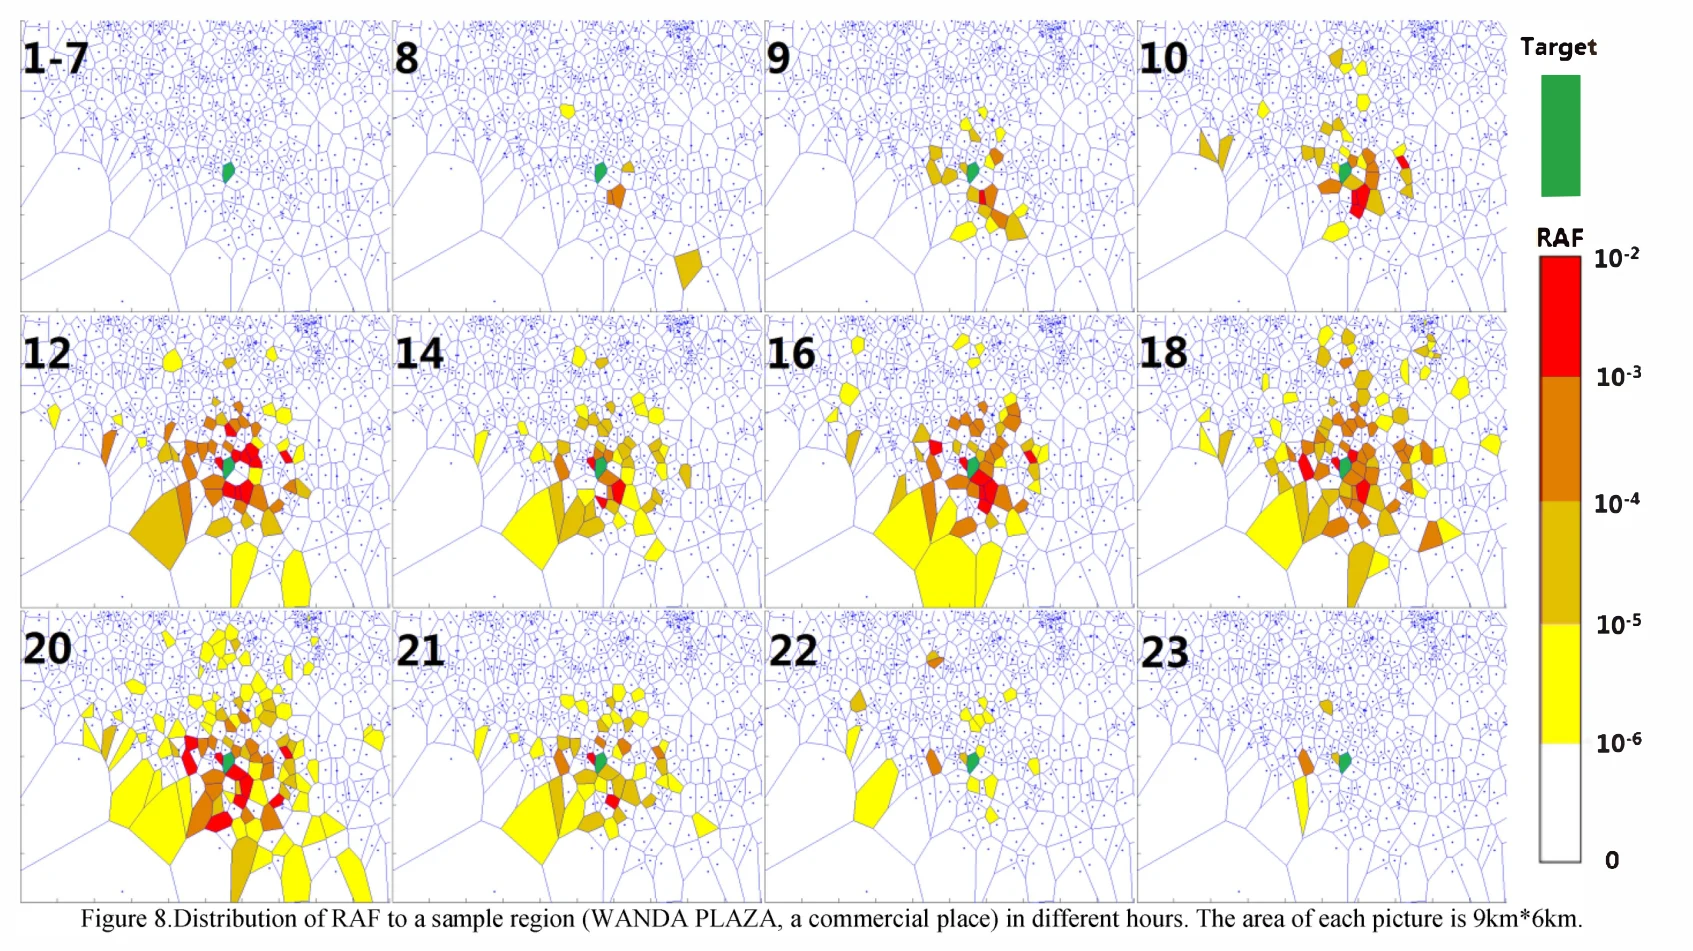
图 8|万达广场这一天,哪些区域在什么时候指向它?
每格 9 公里×6 公里。绿色为目标区域。RAF 图例从 10⁻² 的红到 10⁻⁶ 的黄,白色为 0,颜色越深强度越大。11、13、15、17、19 时没有单独小图,1–7 时合并。(1–7)几乎只有绿色目标格。(8、9、10)着色区域逐渐出现。(12、14、16、18)更密,目标附近能看到红色高值。(20、21)仍然较密。(22、23)明显变少。来源:原论文 Fig. 8。
另外三个功能各取一个样例,小时为 8、12、16、22。教育样例的着色区域更多。居住样例和政府样例更疏。居住行里有的色块很大,那是覆盖范围大的外围基站格子,色块面积不等于区域个数。论文写居住区样例的激活区域最少,并把它联系到更强的私密性;商业样例则相反。图上没有三类区域的个数表,这个“最少”是对样例图的判断。作者认为这些图和实际经验相符,因此激活力能够表现区域关系。相符在这里是定性判断,论文没有给出一张图和现实对照的重合比例。
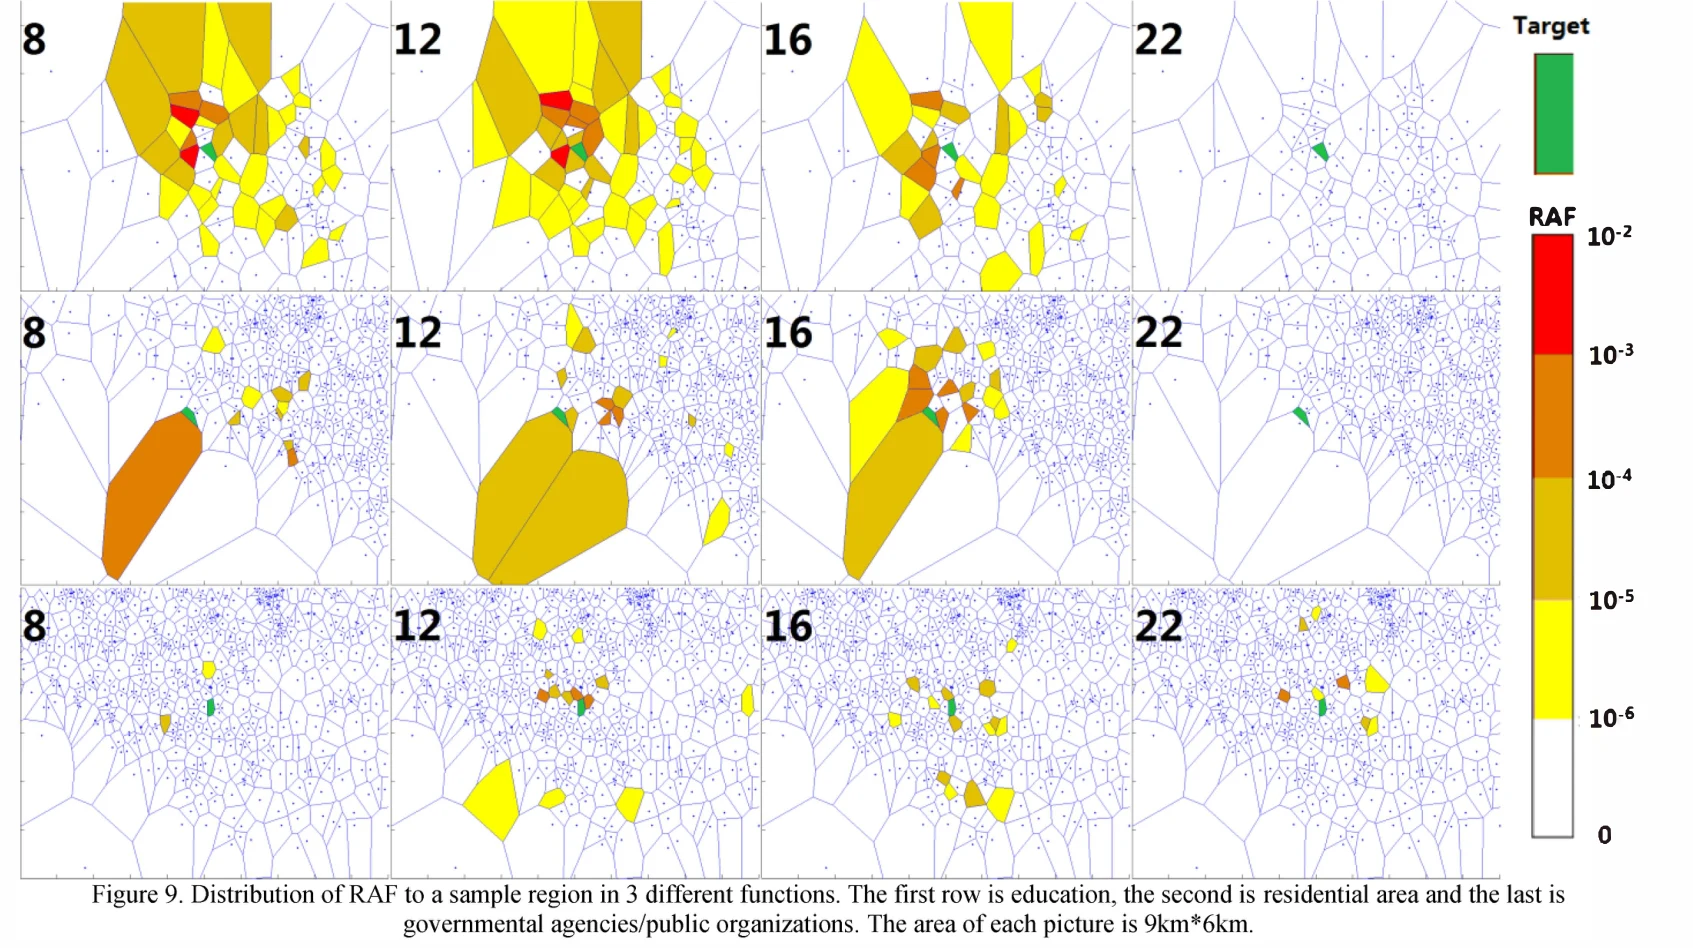
图 9|教育、居住和政府各一个样例,来源区域疏密是否相同?
每格 9 公里×6 公里,颜色含义与图 8 相同。四列是 8、12、16、22 时。第一行教育,第二行居住,第三行政府机关/公共机构。教育行着色区域更多;居住行有大块外围格子;政府行着色很少。来源:原论文 Fig. 9。
这张区域关系表能说到哪里
区域激活力给出的是区域对之间的强度,摘要里的模型名是区域激活熵模型(Region Activation Entropy Model,RAEM)。它适合用来比较来源集中不集中,也给出了每个区域的准确率上界。城市规划、为店铺选址、估计人流会向哪些区域延伸,是作者提到的可能用途。这些用途需要的是稳定的区域名单和可检验的预报;本文直接交出的是共现强度、熵和上界。
有几条边界和结果绑在一起。城市没有具名,基站格子也不是街道或行政区。停留阈值换一套,被送进关系表的“词”就会变。窗口取整条轨迹,是因为作者认为停留区域通常不超过 5 个。0.88 是全部区域的平均上界,分布熵那一组在 0.5 附近很宽,区域之间并不一样。入链和出链整体接近,一部分区域的差距仍然大。功能类来自未发表前作,本文展示了 4 类距离和若干样例地图。关系只衡量强度,没有区分上下班、消费或公务这类不同的来往方式。
一句话总结
城区之间的关系在这里是有向的停留共现,再除以平均距离的平方;平均大约 84 个区域与一个目标有非零来源联系,按小时看不确定性大约只剩不到 3 个区域,由此得到的 0.88 是“人从哪些区域来”的准确率上界。
核心来源
- DOI:10.4108/eai.19-8-2015.2260775。题目大小写、五位作者和 DOI 以 PDF 首页为准;页码为正文所印 104–109。
- 萨里大学机构库记录。该记录写明会议于 2015 年 8 月 19–20 日在台北举行。机构库的作者名单少了 An-Gen Luo,本文作者以 PDF 首页为准。
- 激活力的网络定义来自 Guo、Guo 与 Wang,Scientific Reports,2011。可预测性的参照来自 Song、Qu、Blumm 与 Barabási,Science,2010。区域功能来自 Xu 与 Li 的未发表文稿 Integrating Context with Human Mobility Pattern for Improved Region Function Discovering。
- 论文致谢写明由国家自然科学基金资助,编号 61511130081、61471048、61273217。
作者介绍
- Ya-Jing Xu:论文署名为北京邮电大学信息与通信工程学院(School of ICE)。参考文献中,与 Gong-Fu Li 共同署名上述尚未发表的区域功能识别文稿。
- Chao Xue:论文署名为北京邮电大学信息与通信工程学院(School of ICE)。
- Gong-Fu Li:论文署名为北京邮电大学信息与通信工程学院(School of ICE),并出现在上述未发表文稿的署名中。
- An-Gen Luo:论文首页署名为北京邮电大学信息与通信工程学院(School of ICE)。
- Yi-Zhe Song:论文署名为伦敦玛丽女王大学电子工程与计算机科学学院(School of EECS)。学院 2015 年前后的公开报道显示,他从事素描识别等计算机视觉研究。本文身份以会议论文署名为准。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
四类功能用的是同一个距离平方惩罚,所以教育和商业的曲线形状不同,仍然说明距离的分布不一样。若要判断商业区是不是真的从更近的地方把人带来,需要再画一张不除以距离平方的共现距离图,并且用同一批基站。如果那张图上商业仍然更近,近距离就是停留共现本身的差别;如果几类的原始距离差不多,图 7 的差距就更多来自公式对远处的惩罚。论文没有把这两步拆开。
0.88 说的是小时内来源比例有多集中,而且是全部区域的平均上界。一个区域完全可以上界很高,但周一和周日的高激活力来源换成另一批区域。开一条公交或选一处店铺,需要的是来源名单跨天还在不在。数据覆盖一个月,时段按天切开,论文没有报告工作日和周末的来源是否同一批区域。
居住样例的来源区域少,论文把它理解成这个地方更私密。区域名单很短时,地图上剩下的那几个来源格子也会更显眼,即使图上没有个人身份。来源难猜,和来源名单很短,是两件不同的事。这篇论文没有检验一张区域关系图会不会让少数来源区域变得更容易被认出来。