学会纽约的通勤,为什么未必画得出一座小镇?
论文名片|Can Rong、Jingtao Ding、Yan Liu、Yong Li,A Large-scale Benchmark Dataset for Commuting Origin-destination Matrix Generation,NeurIPS 2024 Datasets and Benchmarks。本文依据arXiv:2407.15823v3,2024年7月24日版本,含附录方法与实验设置。
假设一个模型很会估计大城市的上班人流:它知道密集住宅区与商业中心之间通常有很强的联系。把它拿到小镇或乡村,分散的居住和就业地点却可能完全不符合它熟悉的样子。模型预测错了,问题未必只是神经网络不够复杂,也可能是它从来没有见过足够多不同地方。
这篇论文把数据规模扩展到美国3,233个区域,并把每片区域的整张通勤矩阵作为一个图样本。它提出的核心改变,是让模型从许多不同区域学习通勤网络的整体结构,再为缺乏历史流量的地方生成候选矩阵。
先说结论
- 数据以县级边界定义研究区域,以人口普查区(census tract)作为内部单元,提供2018年通勤OD矩阵、97维人口社会经济特征和36类兴趣点计数。
- 基准中,图扩散模型WeDAN的平均CPC为0.593,对照中较好的DiffODGen为0.532;RMSE由74.6降至68.6。提升针对本文数据和实验设置,不是所有国家、年份或交通需求的通用精度。
- 把流量当作整张有向加权图共同生成,有助于刻画不同流量之间的关系;这比逐个OD独立预测更能保留网络结构,但不自动保证所有规划约束成立。
- 测试地区没有历史OD输入,仍需要人口、设施、距离等条件。生成的是统计上的居住—工作联系,不是逐时通勤、路线、交通方式或拥堵本身。
先把研究对象说清:3,233个区域不是3,233座大城市
每个研究区域对应一张N×N矩阵,N是内部普查区数量。矩阵的第i行、第j列表示住在i区、工作在j区的联系规模。区域边界与内部地理单元均提供坐标与多边形,单元间距离用形心之间的平面欧氏距离计算。
人口、年龄、收入、教育等97维特征来自美国社区调查(ACS);36类设施计数来自OpenStreetMap。通勤标签来自2018年LODES,即美国长期雇主—住户动态项目的居住地与就业地统计。它能提供住宅与工作地点的结构,却不表示观察到了每天实际走了几次、几点出门或走哪条路。
把县当作样本边界,也会截断跨县联系。区域内矩阵适合研究这个边界内的通勤结构,不能自动替代跨县都市圈的完整交通需求。原文所说的都会、城镇与乡村,是样本多样性的描述,不能把每个县都直接改称城市。
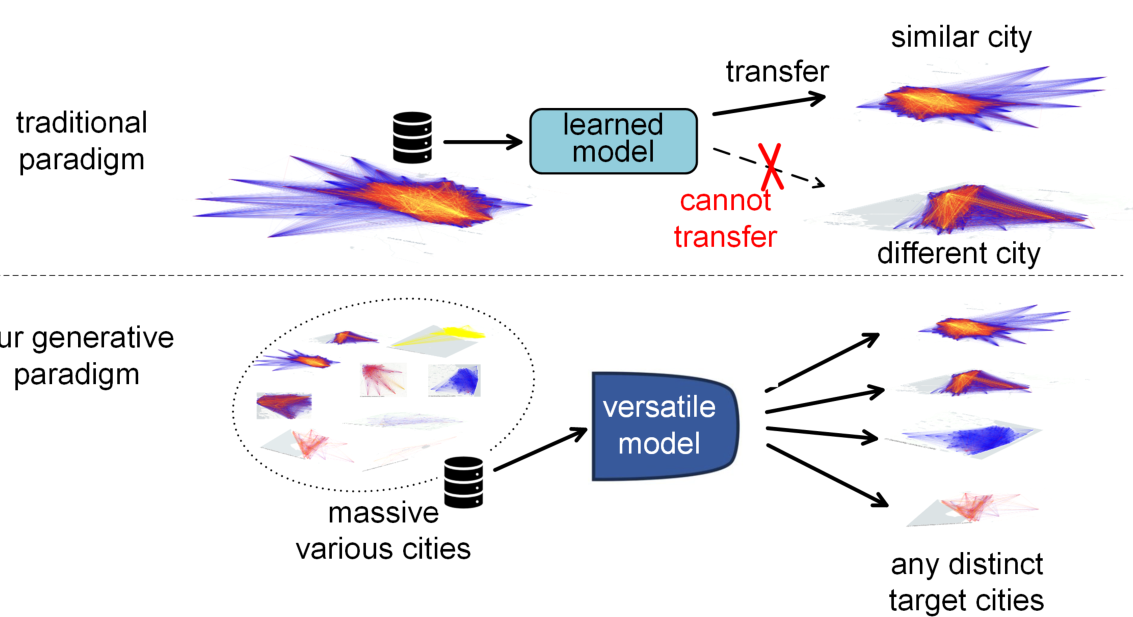
图 1|为什么训练集也需要覆盖不一样的地方?
原图没有字母。上半部表示从一个或少数地区训练模型,再迁移到目标地区,遇到不同结构可能失效;下半部表示用多种区域共同学习,再生成不同目标地的矩阵。图是研究设计示意,不是任意单城训练都不能迁移的证明。来源:原论文 Fig. 1。
论文表1对比既有研究的数据规模、地理覆盖与开放性。新数据报告覆盖3,233个区域、约937万平方公里,较过去集中于少数大城市的数据更广。覆盖更广增加了可以检查的场景,却不等于每种人口或就业类型都已无误差记录。美国人口普查局的方法说明明确指出,LODES采用噪声注入和合成技术保护就业与居住信息。因此,不能把行政统计来源进一步推成零误差真值。
地方之间究竟差在哪些通勤特征?
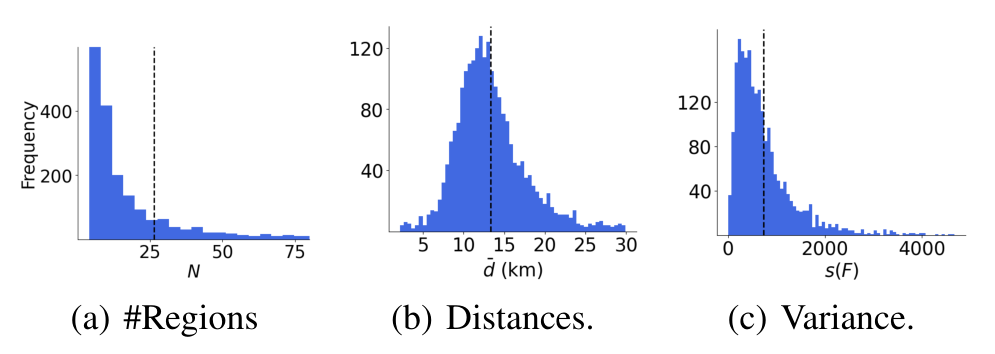
图 2|同一套模型需要面对多大的结构差异?
(a)各研究区域内部普查区数量N的频数分布;(b)各区域平均出行距离d的分布,单位公里;(c)各区域内部流入、流出强度差异的方差分布。三图分别说明单元数量、空间尺度与内部不均衡程度的差异。横轴不是同一种量,不能只按分布形状互相替换解释。来源:原论文 Fig. 2。
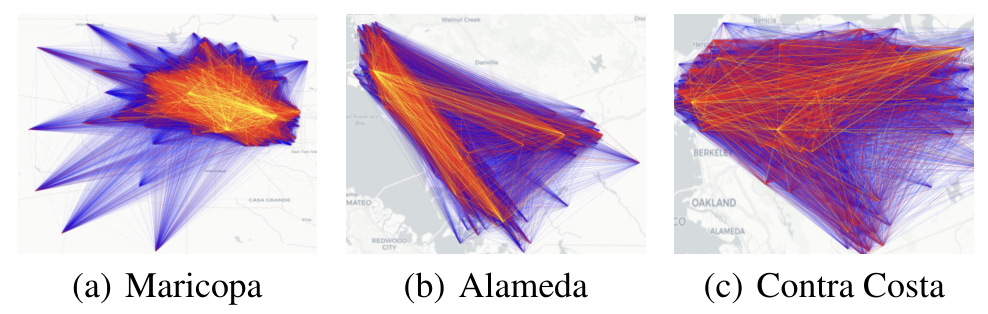
图 3|一张流量矩阵可以对应怎样不同的空间形态?
(a)亚利桑那州Maricopa,用作单中心案例;(b)加利福尼亚州Alameda,用作多中心案例;(c)加利福尼亚州Contra Costa,用作较均匀分布案例。连线表达OD联系的空间分布。这些案例说明矩阵结构的差异,不是在证明三个地方的全部出行都由一种中心形式决定。来源:原论文 Fig. 3。
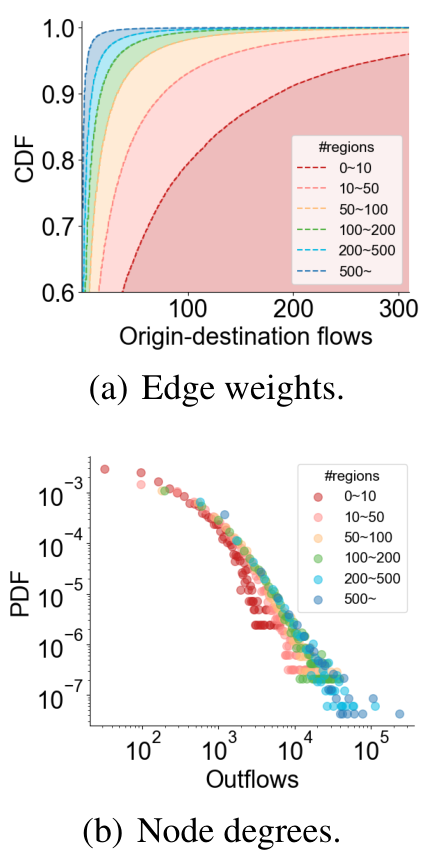
图 4|规模不同,强弱通勤联系的分布是否仍有共性?
(a)OD边权的累积分布,横轴为联系流量,纵轴为累积概率;颜色区分普查区数量不同的区域组。(b)以对数尺度展示区域总流出量的分布,横轴标为Outflows。原图把这一面板称为node degrees,但按轴与正文关注量,应读成流出强度,而不是一个节点有多少条非零连接。曲线既有差别,也表现长尾共性;图形相似不能单独证明完全相同的幂律机制。来源:原论文 Fig. 4。
这些差异解释了为什么只拿一座大城市作训练材料不够。模型不仅要记住高流量通常出现在哪里,也要处理小样本区域、稀疏联系和不同的中心结构。
为什么把整张矩阵一起生成,而非一对地点一对地点地猜?
逐个OD预测,直接问住宅i与就业地j之间有多少联系。整图方法还会考虑这条边与同一网络其他边的关系:多个住宅区可能共享同一就业中心,一个区域的流出也分配到多个目的地。论文用节点表示普查区,节点属性表示人口与设施,边的方向表示居住地到工作地,边权表示流量。
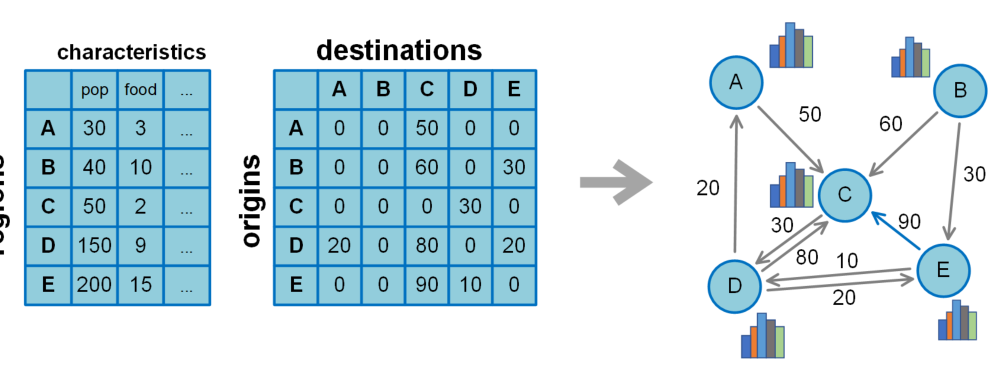
图 5|矩阵中的一个数字,在网络里是什么?
原图没有字母。左侧为五个区域的属性和OD表,右侧为同样五个节点的有向加权图。节点旁柱形表示属性,箭头上的数字对应OD矩阵元素。人口与设施是条件输入,生成目标是边及其权重,不能把节点属性本身当作已观测的通勤量。来源:原论文 Fig. 5。
WeDAN,即Weighted Edges Diffusion condition on Attributed Nodes,在这种图上使用扩散生成。训练时向已知流量逐步加入高斯噪声,再训练网络估计需要移除的噪声;生成时从噪声开始,以目标地区属性为条件,逐步得到一张矩阵。目标地区可以没有历史OD,但模型仍依赖其他地区的OD训练样本。
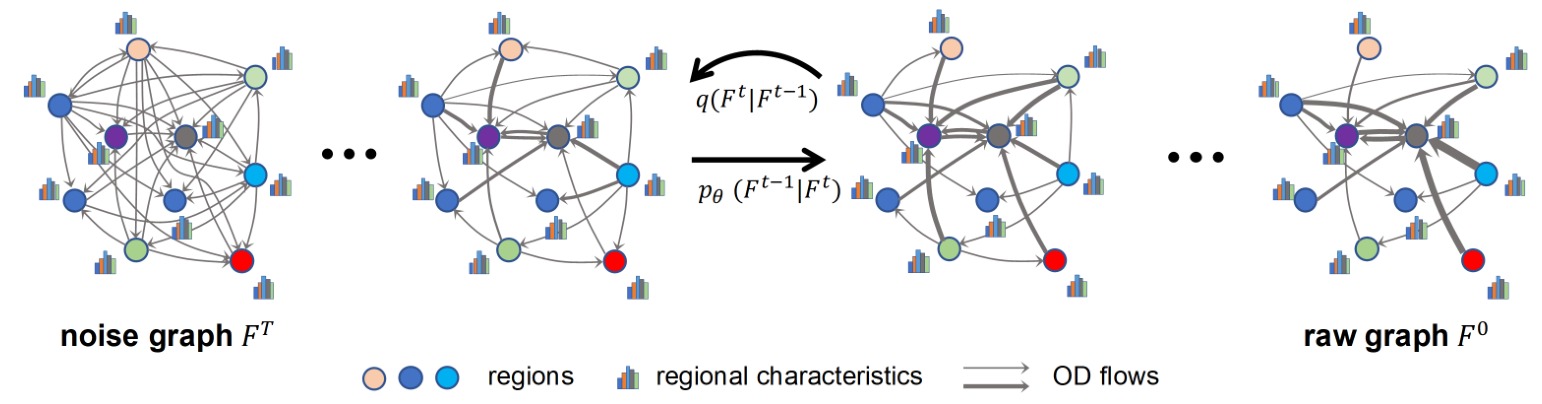
图 6|没有目标地历史流量,怎样从噪声得到OD?
原图没有面板字母,右端是训练中的原始图F⁰,向左逐步加噪直到Fᵀ;生成则向右按学习到的去噪过程恢复。彩色节点及旁边柱形表示区域和属性,连线表示通勤边。图中的多个阶段是同一矩阵的噪声状态,不是未来几天真实通勤的时间演化。来源:原论文 Fig. 6。
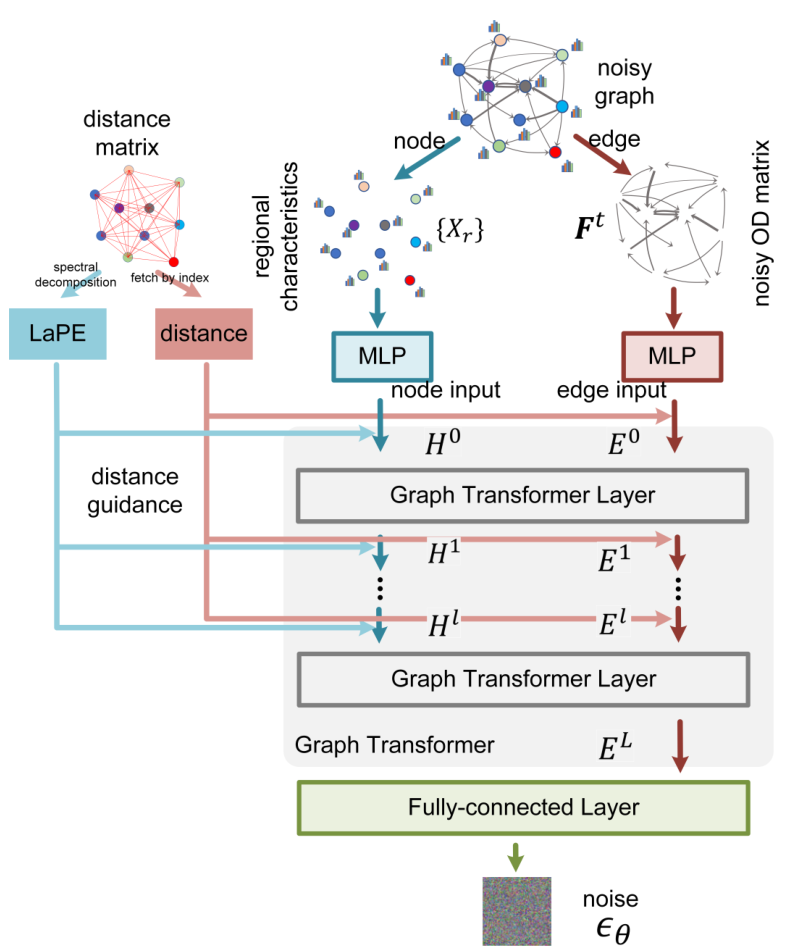
图 9|一次去噪能否同时看见其他地点?
原图没有字母。节点属性与带噪OD分别通过多层感知机进入图Transformer;距离矩阵提供距离与基于拉普拉斯分解的位置编码,多层网络共同更新节点、边,最后输出边级噪声估计。这里的注意力与距离条件帮助建立跨边依赖,不能直接当作识别出的真实通勤决策机制。来源:原论文附录 Fig. 9。
附录还说明,流量先经log(F+1)变换,再在生成后用指数反变换,缓解少数强联系支配数值尺度的问题。网络含4层、每层32维隐藏状态,训练扩散共1,000步;生成使用DDIM采样。WeDAN与DiffODGen均生成10次并取均值作为最终结果,因此表格评价的是平均生成矩阵,不是任意一次随机样本的表现。
0.593的CPC,究竟算什么程度的成功?
数据按8:1:1划分训练、验证、测试,实验重复5次取平均。每个区域先算指标,再对区域取平均:一座包含很多普查区的大区域,和一座小区域,在这个区域平均口径下各贡献一份指标。
共同通勤部分(Common Part of Commuting,CPC)比较生成与真实矩阵中重叠的流量:各OD取两者较小值,求和后乘2,再除以两张矩阵的总量之和。完全一致时为1,无重叠时为0。它不是59.3%的个人通勤目的地被正确预测。
RMSE度量矩阵元素的流量偏差,较小为好;NRMSE再相对真实流量的离散程度归一化。论文另用标为JSD的分布偏差指标比较各单元流入、流出及OD边权分布。这些指标补充流量误差,但分布相近仍可能把强边放在错误的地点。
| 模型 | CPC↑ | RMSE↓ | NRMSE↓ | 流入分布偏差↓ | 流出分布偏差↓ | OD分布偏差↓ |
|---|---|---|---|---|---|---|
| 幂律引力GM-P | 0.321 | 174.0 | 2.222 | 0.668 | 0.656 | 0.409 |
| 随机森林RF | 0.458 | 100.4 | 1.282 | 0.424 | 0.503 | 0.219 |
| 深度引力DGM | 0.431 | 92.9 | 1.186 | 0.469 | 0.561 | 0.230 |
| GMEL | 0.440 | 94.3 | 1.204 | 0.445 | 0.355 | 0.207 |
| NetGAN | 0.487 | 89.1 | 1.138 | 0.429 | 0.354 | 0.191 |
| DiffODGen | 0.532 | 74.6 | 0.953 | 0.324 | 0.270 | 0.149 |
| WeDAN | 0.593 | 68.6 | 0.876 | 0.291 | 0.269 | 0.147 |
来源:原论文表2,表中还比较指数引力、SVR与GBRT。WeDAN相对DiffODGen的CPC提高约11.5%,RMSE降低约8.0%;其中CPC绝对增加0.061,不能写成提高11.5个百分点。流出和OD分布偏差只小幅改善,也不宜笼统称所有指标都有大幅跃升。
数据驱动方法还使用了更丰富特征,而引力模型参数少、形式受限,因此这一比较包含模型表达力与输入利用方式的共同差别。论文提供有用的基准,但并未通过同等信息、同等容量的逐项消融,将每一点收益唯一归因于某种网络结构。
多中心、小地方,以及陌生类型,模型都应付得来吗?
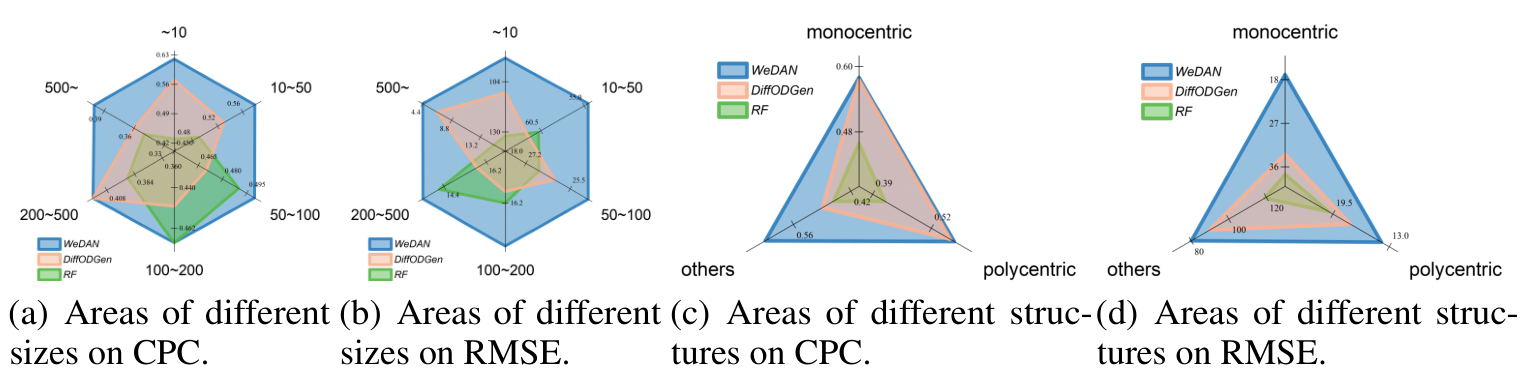
图 7|平均成绩是否掩盖了某些类型的困难?
(a)按普查区数量分六档的CPC;(b)同样分组的RMSE;(c)按单中心、多中心及其他结构分组的CPC;(d)对应RMSE。颜色区分WeDAN、DiffODGen和随机森林。雷达图应结合每种指标的优劣方向阅读,面积大不在所有面板都代表更好。图支持WeDAN在多种组别中保持优势,多中心地区仍有较复杂的模式。来源:原论文 Fig. 7。
按普查区数量分组衡量的是图规模,不是地理面积、GDP或发展水平。小县也可能富裕,普查区少也不自动意味着人口不重要。对模型的外部解释应以实际分组变量为准。
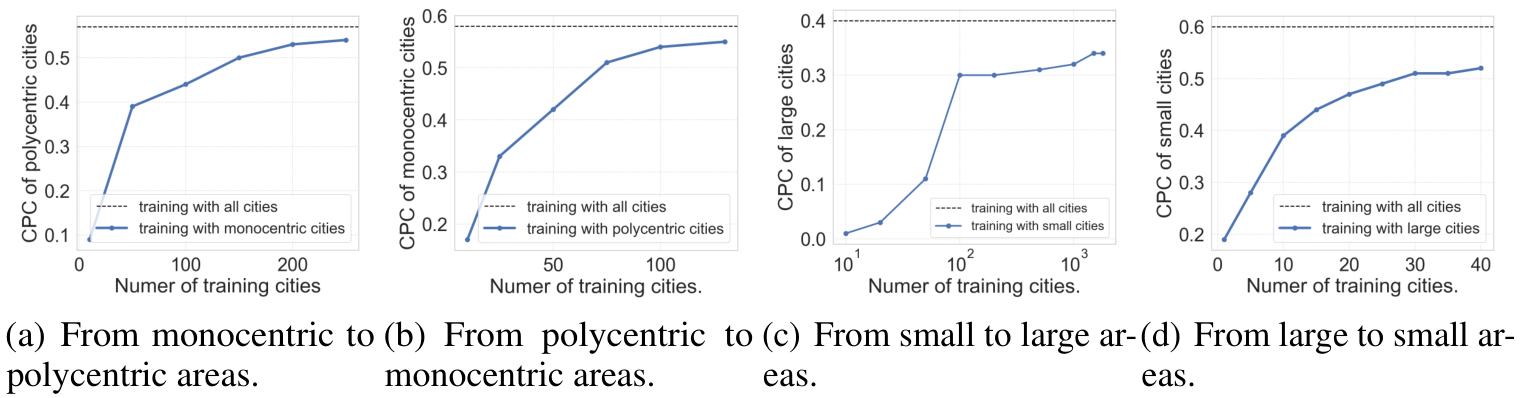
图 8|只看另一类地方,能学到多少可迁移的联系?
(a)用单中心训练、在多中心评价;(b)用多中心训练、在单中心评价;(c)小区域训练、大区域评价;(d)大区域训练、小区域评价。横轴为训练区域数,纵轴为目标组CPC,黑色虚线为全类型训练基准。小区域定义为不足100个普查区,大区域为超过500个。训练样本增加后曲线总体提升,仍与全类型基准有差距;这支持跨类型存在共性,而不是跨国或跨时代的无条件迁移。来源:原论文 Fig. 8。
这套基准还不能替规划者回答什么?
首先,单一2018年标签无法直接检验疫情、混合办公或新基础设施之后的通勤变化。其次,美国县与普查区的边界、设施记录及就业统计条件,未必能原样搬到其他国家。再次,行政和开放地图数据都有覆盖、匹配与保护处理,生成结果继承这些输入条件。
更关键的是任务边界。这里的矩阵是居住—工作联系,不含完整日程、路径、出行方式和所有非通勤活动。即使矩阵误差降低,也不能直接推出道路拥堵预测、公交客流或排放估计同样改善。将其用于交通方案,还需要把需求分配到网络,并验证区域出入总量、跨边界联系与相关约束。
数据划分主要展示同一国家、同一数据体系下留出地区的泛化。若要检验更困难的外推,可以额外留出整片地理区域、另一年份或另一国家;若相邻地区共享背景,随机留出地区的结果与远距离转移可能不同。论文没有给出这些测试的完整答案。
一句话总结
多种地方的整张通勤网络,为模型学习提供了更好的材料,但生成得像统计矩阵,仍需经过具体地点、年份和规划用途的验证。
核心来源
- Rong, C., Ding, J., Liu, Y., & Li, Y.(2024). A Large-scale Benchmark Dataset for Commuting Origin-destination Matrix Generation。论文v3及附录。本文九幅图与基准数值均据该文。
- 作者数据集与代码项目。
- 美国人口普查局关于LODES居住—工作联系及保护处理的方法研究,用于区分公开行政统计与无误差的直接个体观测。
作者介绍
- Can Rong:论文署名清华大学电子工程系,为本文第一作者。
- Jingtao Ding:论文署名清华大学电子工程系,参与本文研究。
- Yan Liu:论文署名南加州大学计算机科学系,参与本文研究。
- Yong Li:论文署名清华大学电子工程系,参与本文研究。以上机构以本论文版本为准。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
一个数据集的重要价值,可能是暴露平均分背后的失败类型。小地方的单条通勤联系人数不多,但若某条边连接唯一的医院或工业雇主,预测错误的实际意义可能很大。区域平均指标避免大城市完全支配评价,却仍没有直接测量公共服务与弱势群体的需求。
可在总体CPC之外,预先定义关键目的地和低流量联系的评价,并检验生成矩阵是否满足可用的居民就业总量与岗位总量。若约束加入后平均指标略降、关键联系却更可靠,这种取舍可能更贴近实际规划;判断依据应来自明确用途,而非单一榜单名次。