能猜中相遇的地点,就能猜中会遇见谁吗?
论文名片|Karim Karamat Jahromi、Matteo Zignani、Sabrina Gaito、Gian Paolo Rossi,Predicting encounter and colocation events,Ad Hoc Networks 62(2017):11—21。论文 DOI。
周一上午,你总在同一栋楼上课。手机或许容易猜中你会在哪里与别人同时出现,却未必知道旁边究竟是谁,更难知道你们会待多久。对机会网络而言,这几种信息各有用处:附近出现设备,才有机会交换消息;遇见合适的人、留出足够时间,转发才可能成功。
这篇论文用校园 Wi-Fi 和城市手机活动记录,把相遇预测拆成地点、持续时间、联系人三个任务。它的结果表明,规律的日程确实能帮助预测,但地点预测的高分不能直接替代对完整相遇事件的判断。
先说结论
- 校园样本中,给出三个候选地点时,超过 90% 的用户地点预测准确率超过 80%;只给一个候选地点,达到这一门槛的用户约占 70%。
- 加权朴素贝叶斯通常优于标准朴素贝叶斯;为每个人单独校准权重,比全体共享权重仅有小幅改善。
- 相遇多久明显更难:按论文设定的容差区间判定,只有约 30% 的用户分类器准确率超过 50%。
- 城市基站数据上的共址预测表现更弱。即使允许三个候选地点,也只有约一半用户的地点准确率超过 50%;联系人预测没有用户超过 70%。
两个人连上同一张网,就算遇见了吗?
论文中的相遇(encounter)与共址(colocation),都由网络记录推断,而非面对面观察。校园 Wi-Fi 中,两台设备连接同一个接入点,连接时段又有重叠,就形成相遇记录。研究处理了设备在接入点间来回切换的乒乓现象,但同一覆盖区仍不保证两个人真正见面。
Dartmouth 数据覆盖 2004 年 1 月 3 日至 4 月 30 日,论文表 1 记为 120 天。原有 17,414 名用户、1,292 个接入点;保留用户停留超过 15 分钟的接入点访问后,剩下 14,082 名用户、907 个地点。这里的兴趣点(point of interest,PoI)是网络接入点标识,不是人工标注的教室或食堂。
另一份数据来自米兰都市区,覆盖 2012 年 3 月 26 日至 5 月 31 日,共 67 天,记录电话、短信和数据活动。表 1 给出的预处理前人数为 734,149,保留每天至少有一次活动的用户后为 17,400,包含 5,398 个基站地点。这些规模是数据预处理口径,后面的分类器还要求个人有足够的事件记录,不能直接当作所有预测实验的分母。
| 数据 | 预处理后用户 | 地点数 | 时长 | 事件的空间口径 |
|---|---|---|---|---|
| Dartmouth Wi-Fi | 14,082 | 907 | 120 天 | 同一接入点下的连接时段重叠 |
| 米兰手机活动记录 | 17,400 | 5,398 | 67 天 | 同一基站覆盖区下的估计停留时段重叠 |
表中汇总原论文 Table 1。手机活动并不连续,因此研究假定用户在一次活动开始前 900 秒至活动结束后 900 秒仍位于该基站覆盖区;短信的活动时长计为零。这是补足观测间隙的规则,也会影响哪些人被认定为同时在场。
基站的空间范围又比 Wi-Fi 接入点更粗。论文报告,米兰距中心 3 公里以内区域的基站覆盖半径中位数约为 120 米;这个数字只描述该中心区域,不能外推为所有基站的精度。因而,后面两个场景的差异同时包含校园与城市人群、观测频率、空间分辨率的差异。
只告诉模型星期几、几点,它能学到什么?
模型按用户分别训练,输入是星期几和一天中的时间窗。默认每窗 2 小时;例如周一上午的某个时间窗,可以对应过去重复出现的地点和联系人。原论文 Table 2 列出的记录还包含用户标识、地点标识、对方标识,以及事件起止时间对应的时间窗。
标准朴素贝叶斯分类器(naïve Bayesian classifier,NBC)把候选地点的历史常见程度,与该地点对应的星期、时段概率相乘,选择得分最高的地点。困难在于,它假定特征在给定类别后条件独立;但同一个上午时段在工作日与周末可能意味着完全不同的安排。
加权版本根据 Kullback–Leibler 散度衡量特征带来的信息,调整星期和时段概率在得分中的权重。可把它理解为:让更有区分力的时间信息承担更多判断,而不是把每个特征等量使用。加权可以缓和原模型的局限,但并没有完整建模所有特征依赖。
地点和联系人任务返回概率最高的前 k 个候选,k 分别取 1、2、3;真实记录落在候选集合内就算命中。允许更多候选本来就更容易命中,所以 top-3 的高分不等于准确猜中唯一答案。持续时间任务另外使用预测地点作为输入,地点误差也可能影响后续判断。
实验采用四折交叉验证。每名用户的准确率是测试记录中命中的比例,再对各折取平均,最后展示不同用户准确率的分布。论文没有把这写成严格按时间前推、留出未来一段时间的验证,因此结果应解释为该交叉验证设置下的能力。
校园的相遇地点为什么最容易预测?
校园实验选择至少有 75 条相遇记录的用户训练分类器。图 1 不是所有记录混在一起的总体准确率:横轴是单个用户的预测准确率,纵轴是互补累积分布(CCDF),表示准确率高于该门槛的用户比例。同一横坐标上,曲线越高,达到该水平的用户越多。
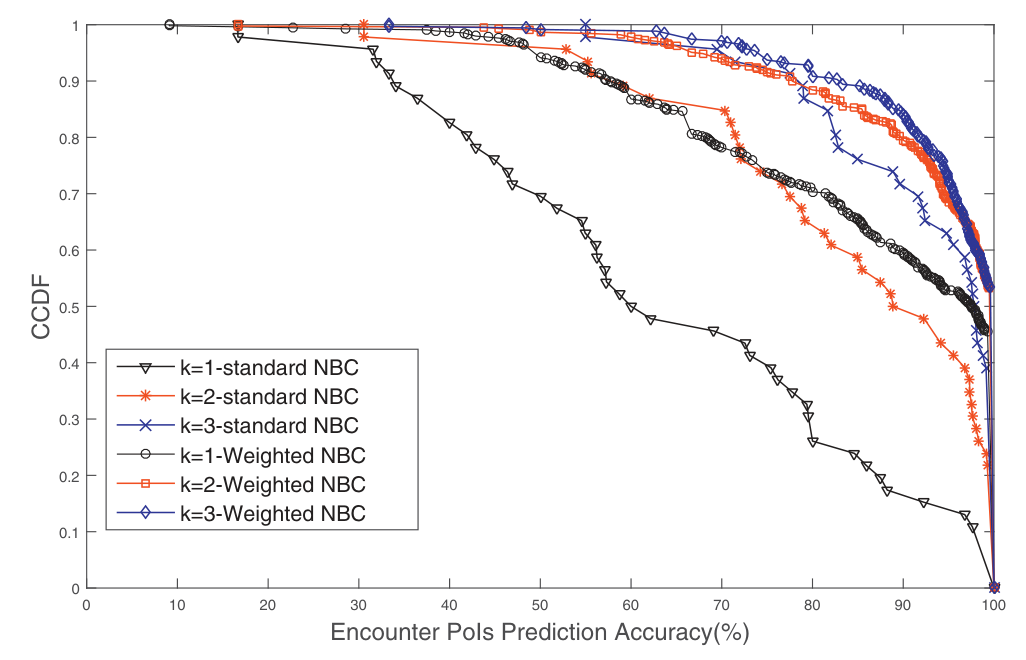
图 1|加入特征权重,能帮助多少用户猜中相遇地点?单幅图中的六条曲线比较标准与加权 NBC,以及各自的前 1、2、3 个候选地点。加权版本在候选较少时改善尤其明显;给出三个候选时,超过 90% 的用户准确率超过 80%。来源:原论文 Fig. 1。
研究还比较了采用高斯时间分布的时空方法、基于高斯过程改写的预测器,以及以支持向量机实现的纠错输出码分类器。这里的高斯过程比较将既有方法改造成同一地点任务,不能当成原方法在所有任务上的全面排名。
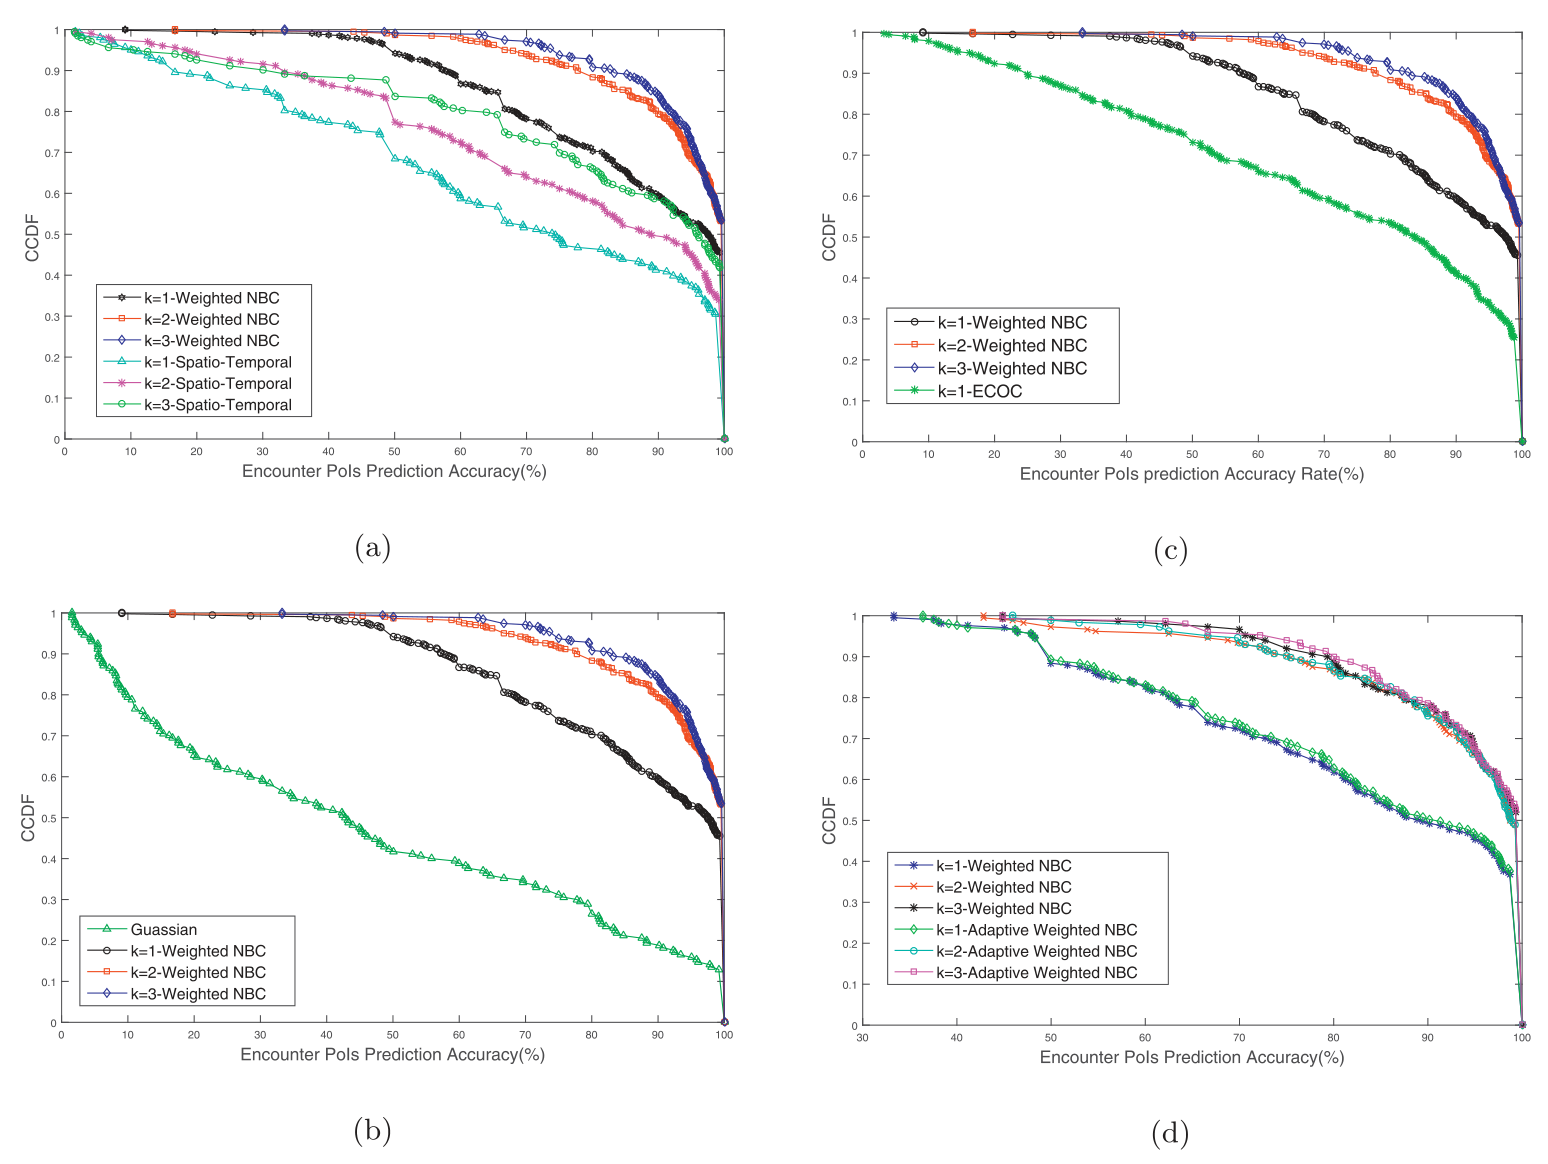
图 2|地点预测优势是否只来自挑选较弱的标准模型?四幅图横轴均为地点准确率,纵轴均为用户比例的 CCDF。(a)加权 NBC 与时空分布方法比较;(b)与用于同一地点任务的高斯过程比较,论文报告高斯过程的准确率中位数约 41%,加权方法约 97%;(c)与纠错输出码分类器比较;(d)比较全体共享特征权重和按个人单独调整的权重,后者只有小幅提升。图中原始排列为左列 a、b,右列 c、d。来源:原论文 Fig. 2。
图 2 支持的是这些数据、任务与实现设置下的相对优势。它没有评估所有可能的现代预测器,也没有直接把结果换算为消息送达率。
日历规律还反映在周末与工作日的差别上。论文文字概括周末预测更好,并解释为周末在家停留等安排可能更简单。但图 3 的图例需要细读:k=1、3 的周末曲线较高,k=2 的工作日曲线反而较高。因此,这张图不能支持所有候选数下周末都更好的概括;关于在家的解释也没有被独立检验。
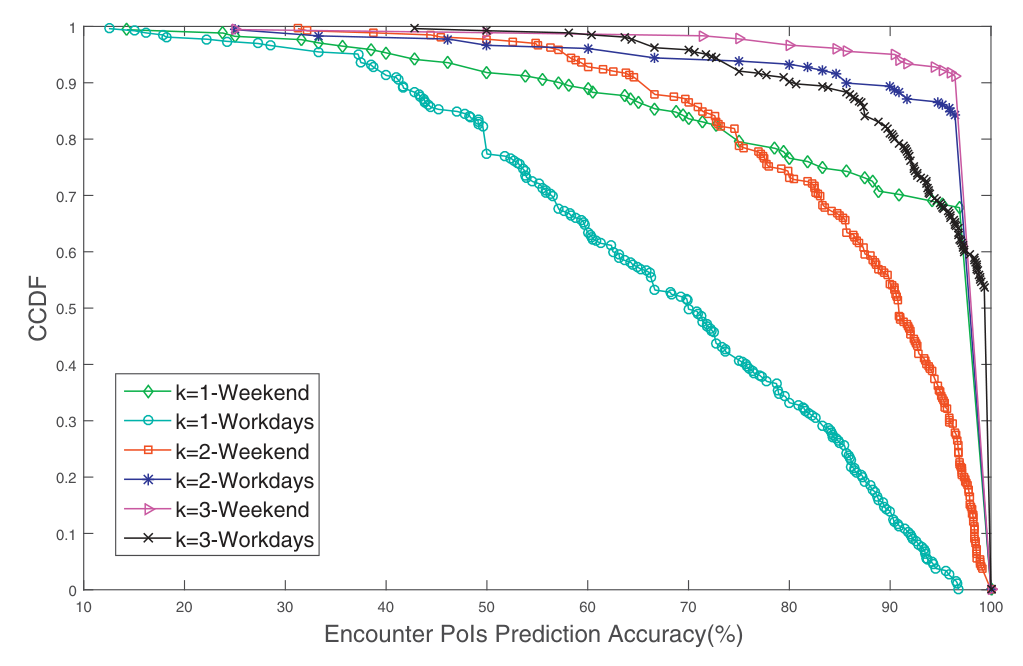
图 3|周末和工作日,哪一种日程更容易预测?单幅图按 k=1、2、3 比较两类日期,横轴为地点准确率,纵轴为 CCDF。按原图图例,k=1、3 时周末表现较好,k=2 时则是工作日表现较好;这与正文概括的方向并不完全一致。来源:原论文 Fig. 3。
把时间窗放宽,会合并原本不同的活动,也可能缓和轻微迟到带来的误差。图 4 显示,这个折中并非时间窗越大越好:从 2 小时改到 4 小时,地点准确率略有下降,k=3 时更明显;继续改到 8 小时,变化不大。
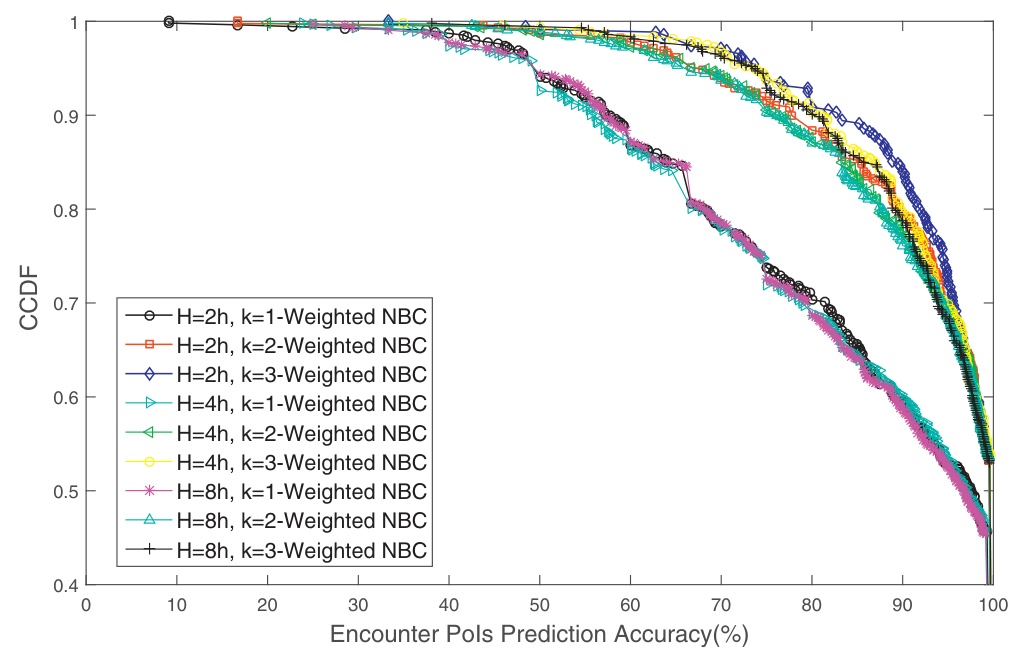
图 4|时间分得更粗,地点预测会改善吗?单幅图比较 H=2、4、8 小时与三个候选数。横轴为地点准确率,纵轴为 CCDF;注意纵轴从 0.4 起,视觉差距不能当作从零开始的比例差距。来源:原论文 Fig. 4。
地点很稳定,为什么停留多久仍难判断?
持续时间并不是要求模型精确猜到某个秒数。研究在测试集中,按地点和时间情境汇总持续时间、去除异常值,再计算均值 μ 与标准差 σ;预测时长落在 μ−σ 至 μ+σ 的范围内,就按论文规则记为正确。这个容差口径与逐条实际时长完全相等不同,也不是模型给出的置信区间。
即使采用这样的判定,约 30% 的分类器准确率超过 50%。同样在一栋楼遇见别人,临时谈话、不同课程长度或离开的时机仍可能让持续时间变化。论文没有逐一验证这些原因,但结果明确说明,固定地点并不能提供同样稳定的时长。
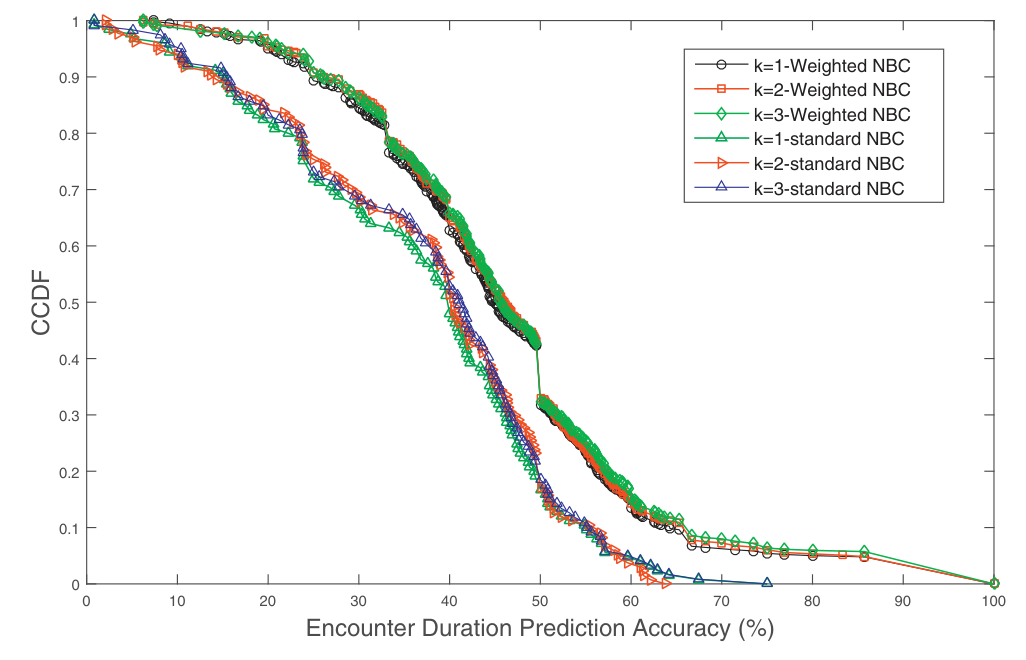
图 5|知道常见地点,能否进一步猜中相遇时长?单幅图横轴为按容差规则计算的持续时间准确率,纵轴为 CCDF;三种候选设置下的加权与标准 NBC 都明显弱于地点任务,加权版本整体有所改善。来源:原论文 Fig. 5。
猜到会遇见谁,还需要更细的重复关系
联系人任务同样采用前 k 个候选:只要其中一个用户标识与测试记录中的对方一致,就计为命中。它评估的是单条事件的联系人候选覆盖,不是一次列出时间窗内所有真实接触者。
校园中,k=1 时约 20% 的用户联系人准确率超过 80%;放宽为 k=3,这一比例约为 30%。地点的固定并不保证周围人员完全相同。加权仍有帮助,尤其是 k=1、2,但联系人预测的分布比地点任务分散得多。
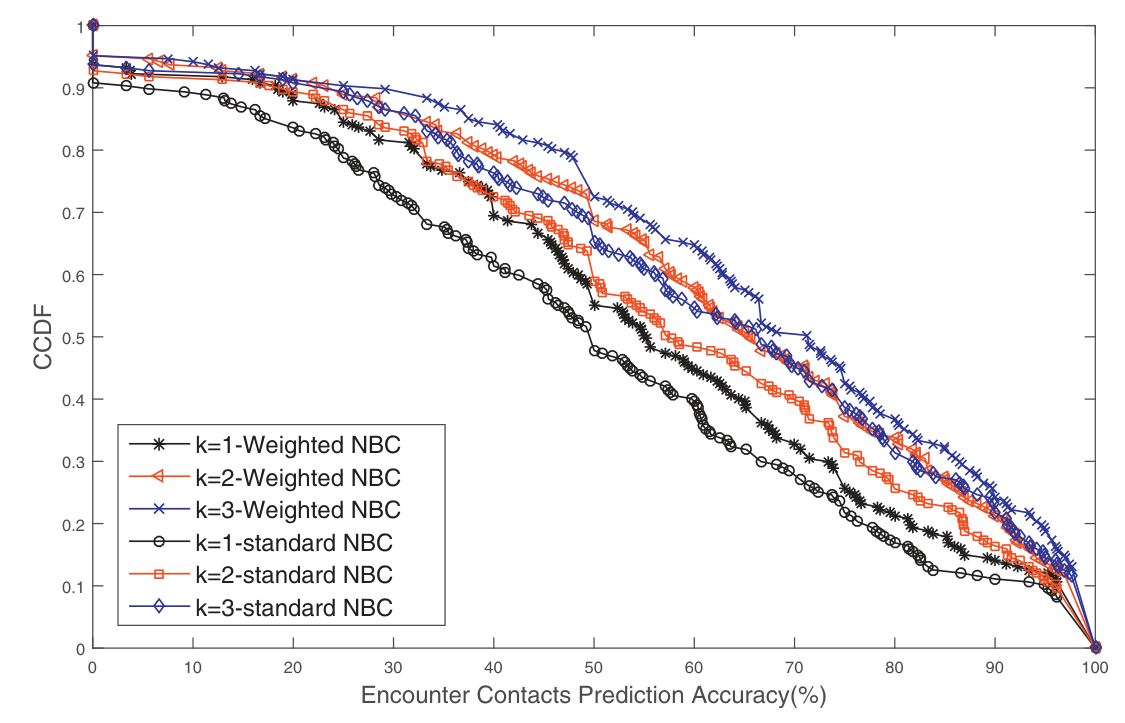
图 6|同一时间、同一校园日程,能否锁定具体的人?单幅图横轴为联系人准确率,纵轴为 CCDF,六条曲线比较候选数及是否加权。随着候选增多,达到高准确率的用户增加;仍不能据此声称所有用户的联系人都可被稳定预测。来源:原论文 Fig. 6。
从校园移到城市,共址预测还剩多少把握?
米兰共址实验进一步选择至少有 350 条记录的用户,避免个人训练数据过少。这比前面的数据清理门槛更严格。城市活动的时空变化、基站覆盖区和记录间隙都可能影响共址标签,不能把两个场景的分数差完全归因于城市居民更不规律。
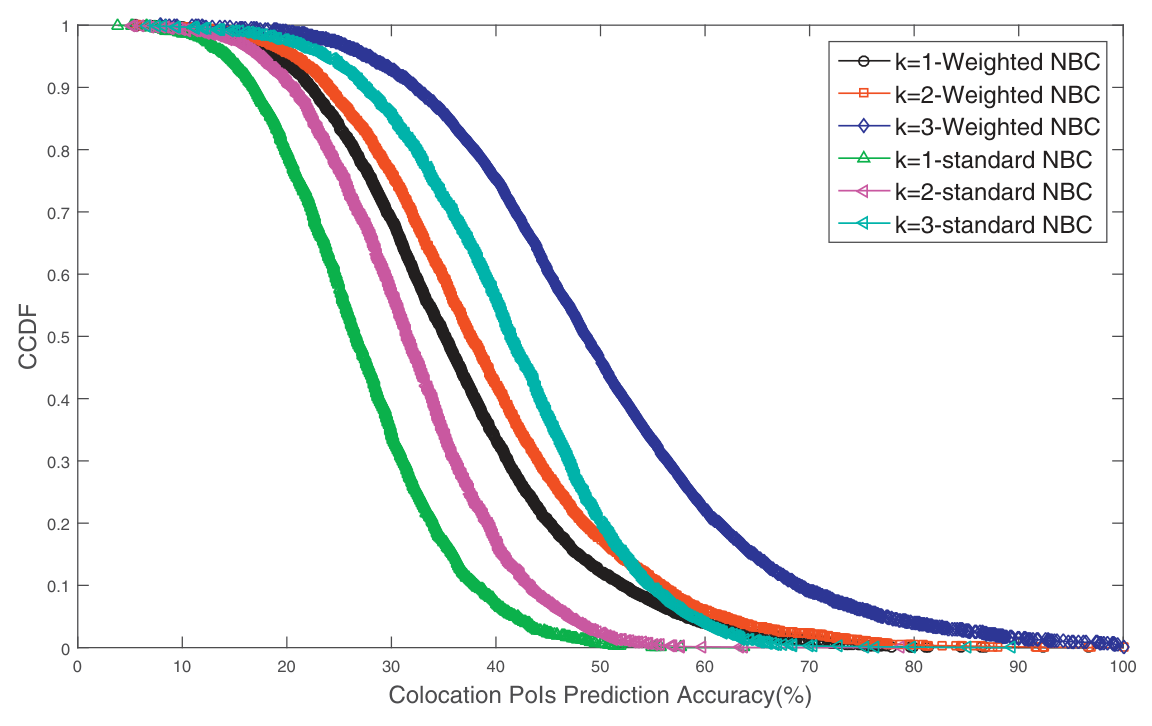
图 7|基站尺度的共址地点还容易预测吗?单幅图横轴为共址地点准确率,纵轴为 CCDF,比较标准与加权模型的三个候选数。加权版本整体更好,但 k=3 时仍只有约一半用户准确率超过 50%;k=1、2 时达到该门槛的用户约占 15%、20%。来源:原论文 Fig. 7。
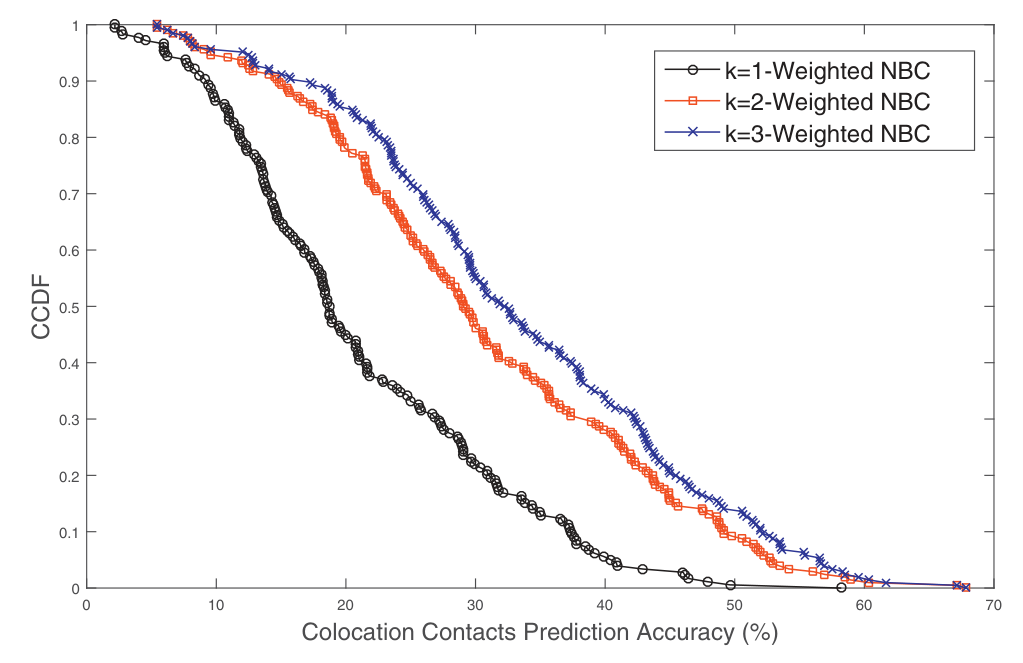
图 8|城市共址数据能否猜中具体联系人?单幅图只比较加权模型的前 1、2、3 个候选,横轴为联系人准确率,纵轴为 CCDF。增加候选可提高命中率,但没有分类器的准确率超过 70%。这里没有标准 NBC 的对照曲线。来源:原论文 Fig. 8。
作者把较弱表现解释为基站记录更稀疏、更粗,以及城市人群日程不如校园规律。这些解释合理,却没有被当前跨数据集比较逐项分离。对实际系统而言,还需要时间前推验证、不同观测规则的敏感性分析,以及在转发协议中直接测试效益。论文把改善内容分发留作未来工作。
一句话总结
日历与历史事件能帮助预测重复相遇的地点,但相遇多久、遇见谁,以及城市粗粒度共址,分别需要更强的证据,不能共用一个高准确率结论。
核心来源
Karim Karamat Jahromi, Matteo Zignani, Sabrina Gaito, Gian Paolo Rossi. Predicting encounter and colocation events. Ad Hoc Networks 62 (2017), 11–21. DOI:10.1016/j.adhoc.2017.04.004。数据、方法、数值及 Fig. 1—8 均来自该论文正文。
作者介绍
- Karim Karamat Jahromi:论文署名机构为意大利米兰大学计算机科学系,也是本文通讯作者。
- Matteo Zignani:论文署名机构为米兰大学计算机科学系。
- Sabrina Gaito:论文署名机构为米兰大学计算机科学系。
- Gian Paolo Rossi:论文署名机构为米兰大学计算机科学系。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果一个转发系统每天都能猜中你会出现在办公室,却经常猜错会遇见哪位同事,地点高分可能对送达消息帮助有限。更贴近应用的评估,可以把“给出三个地点的命中率”换成实际决策:按照预测选择等待或转发,再比较交付时间、耗电和失败率。
另一项值得做的实验,是在同一批人身上同时记录 Wi-Fi、基站活动和近距离探测。固定人群后改变观测尺度,才能更清楚地区分:表现下降来自行为变化,还是来自标签把许多并未相见的人装进了同一个覆盖区。