同一批地铁刷卡,按一天的行程形状拆开,还会是同一张城市网络吗?
论文名片|Shuyang Shi、Lin Wang、Xiaofan Wang,Uncovering the spatiotemporal motif patterns in urban mobility networks by non-negative tensor decomposition,Physica A,2022,606:128142。2022年4月29日收稿,8月9日修回,8月30日在线发表。DOI:10.1016/j.physa.2022.128142。这是一项基于交通卡的观察性研究:用非负张量分解描述不同单日行程形状的时空模式,再比较它们还原出的网络。交通卡没有出行目的字段。
交通卡 101 一天里从站 A 到 B、B 到 C、C 到 D,最后回到 A。交通卡 102 从 E 到 F、F 到 G,傍晚从 H 回到 E。原始记录里没有 G 到 H,作者没有把这条缺失的边补上。两个人都在上海地铁里移动,留下的网络形状却不同:前者绕回起点,后者少一条边。
如果只累计每一次进站和出站,这些形状会在同一张起讫网络里被加总。这篇论文把一个人一天的地铁行程收成一个形状,再问简单行程、复杂行程和只坐一次地铁的行程,会不会还原出结构不同的市内网络。分解得到三类模体模式。作者结合核心张量和网络指标,把它们解释为通勤式的简单行程、更复杂的生活与娱乐活动,以及通往机场或火车站的单次出行。这是对模式的推断,卡数据本身没有目的标签。
先说结论
- 数据是 2017 年 8 月的上海地铁交通卡。当时有 14 条线、289 个站,每日地铁客流约 500 万,约占全市公共交通客流的一半。分析只用 6 时至 23 时,均分为 17 个小时。最常见的 20 种单日模体覆盖超过 97.8% 的乘客;分母是乘客,并假设一张卡在一天里只代表一个人。
- 四维张量的大小是 17×20×289×289。非负 Tucker 分解的核心张量取 4×3×12×12。筛选规则是:每个模式轴上,最小分量与最大分量之比要大于 0.25。去掉模体、只做时间×起点×终点、核心取 4×12×12 时,分解没有把城际枢纽识别成一类独立特征。
- 起点模式与终点模式几乎对称。O12 在地理上不成片:图中红框是浦东国际机场,两个蓝框是上海南站和上海站,紫框里三个站是虹桥火车站与虹桥机场。正文写两个机场和三个火车站,后文又写四个城际枢纽。四个框可以和“四个枢纽”对上;论文没有逐站对照表。
- 还原后的网络再按作者此前研究中的三类功能区汇总。简单模体网络 G1 中,工作区与居住区之间的两格是 1.4×10^7 和 1.3×10^7;九格合计 6.30×10^7,这两格占 42.9%。复杂模体网络 G2 的九格合计 8.43×10^6,最大一格是工作区内部的 1.9×10^6。这些数字是还原边权,不是原始刷卡表的直接计数。
- 站点强度和边权都按无标度累积分布 P(x)=C x^(−γ) 拟合。G1 的 γs=1.6073、γw=1.6542,低于 G2 和 G3;作者把更大的 γ 读成更强的异质性。单次乘车时间的对数正态拟合期望为:G1 2860.7 秒,G2 2898.7 秒,G3 4194.8 秒。G1 里站点强度与熵的 Spearman 相关是 −0.6728(p=1.8934×10^−39),G2 是 −0.0508(p=0.3896)。
一天的地铁行程,留下的是形状
人类移动模体(human mobility motif)在这里不是某一个具体站名的路线,而是去掉站名之后的网络形状。节点是这个人当天到过的地铁站,边是交通卡上实际出现的行程。论文沿用 Schneider 等人把一天的到访序列收成模体的想法,但生成规则以地铁记录为准:其他交通方式造成的缺口不补边。
卡 101 的四条记录围成一个回到起点的环,起点在图中用橙色标出。卡 102 的记录到不了 G 与 H 之间,模体就保持这个缺口。站名 A 到 H 是为了读图,模体本身不保留这些标签。所以两个在不同线路上走了同样形状的人,会落入同一种模体。
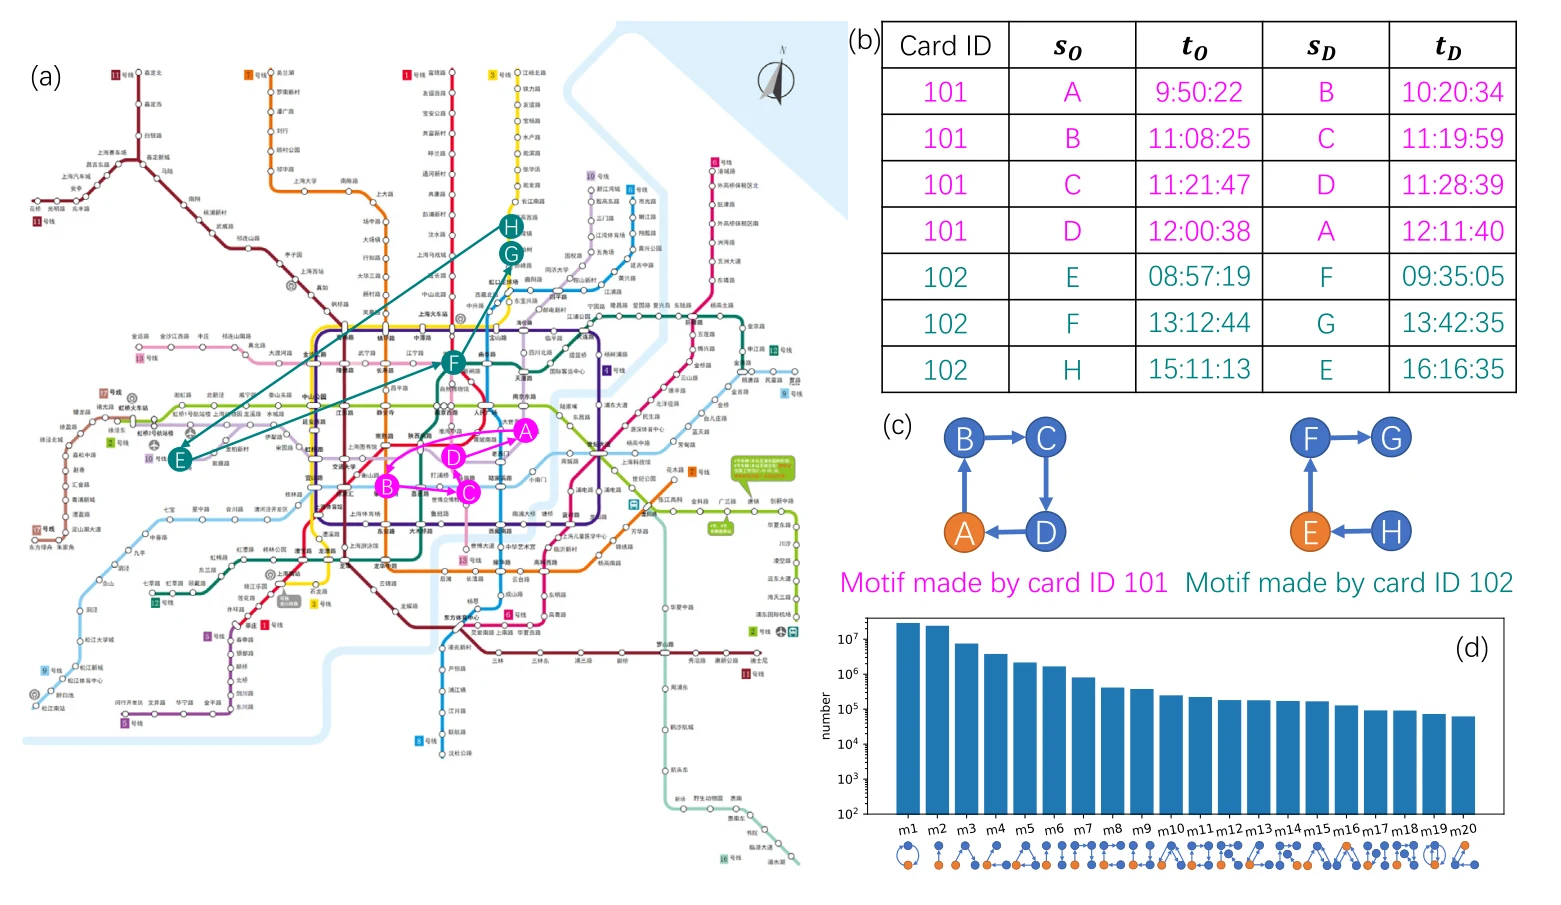
图 1|一张交通卡的一天,怎样收成一个不含站名的形状?
(a)研究年份的上海地铁官方拓扑。这张图为了观看做过地理变形;后文地图改用站点的实际经纬度。粉、青两条轨迹对应下面两张卡。(b)两张真实交通卡的简化记录。列是卡号、起点站、出发时刻、终点站、到达时刻;站名已写成字母。(c)两张卡生成的模体。左为卡 101,右为卡 102;橙色是当天的起始站。卡 102 没有 G 到 H 的边。(d)上海地铁中最常见的 20 种单日模体。横轴 m1 到 m20,纵轴是人数的对数坐标,柱下是对应拓扑。论文给出的合计是这 20 种覆盖超过 97.8% 的乘客,正文没有列出每一柱的精确人数。来源:原论文 Fig. 1。
后续张量只保留这 20 种。按论文的“超过 97.8%”计算,未进入张量的乘客不到 2.2%。这个比例的分母是乘客,不是行程次数,也不是 289 个站。
为什么要把时间、模体和起讫站放进同一个张量?
只看单次起讫,会把不同一天的人加进同一条边。模体种类一多,时间、形状、起点、终点就叠成高维表,直接比较很碎。作者把 2017 年 8 月的记录收成一个非负四维张量:时间 17 段、模体 20 种、起点 289 站、终点 289 站。元素是“在小时段 t、模体 m、从站 o 到站 d 的人数”。人数呈长尾,所以先做 xtmod = ln(1 + 人数)。后面的分解拟合的是这个对数刻度。
非负 Tucker 分解(non-negative Tucker decomposition)把这张表拆成时间、模体、起点、终点四组非负因子,再用一个核心张量记录各组模式如何搭配。非负是为了让分量还能当成“有多少人沿这个模式移动”来读。每一列因子被归一化到长度为 1,这样不同列、以及核心张量里的数可以互相比大小。图 2(b) 用一个三维例子说明拆法;真正进入计算的是上面的四维张量,核心大小也不是图里的示意尺寸。
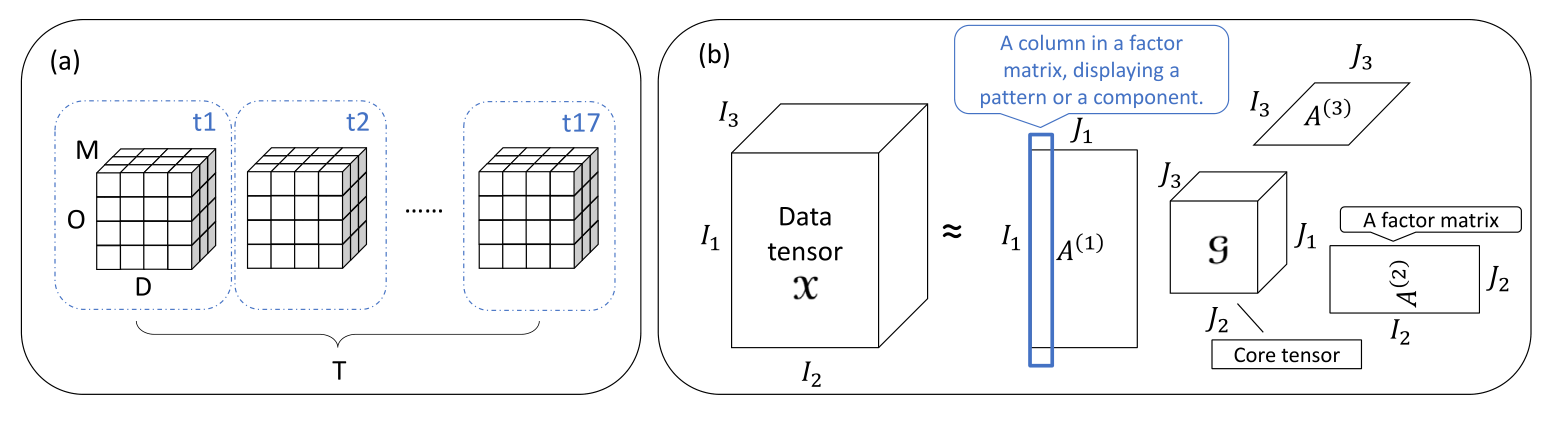
图 2|高维刷卡表要拆成哪些可比较的模式?
(a)数据张量沿时间 T 排开,每一块还有模体 M、起点 O 和终点 D。t1 到 t17 对应 17 个小时。(b)以三维张量为例的分解:数据张量近似写成因子矩阵与核心张量的乘积。一根柱是因子矩阵中的一列,也就是一个模式;小立方是核心张量,用来表示模式之间的搭配强度。来源:原论文 Fig. 2。
核心该取多大,论文当作开放问题来处理。他们在 (2×2×2×2) 到 (9×14×19×19) 里搜索。对每一根轴,把核心张量在其余轴上求和,若最小分量不到最大分量的 0.25,就认为这一档把极少数人拆成了单独模式,予以排除。留下的候选里,时间维和模体维能取到的最大、同时区域数仍便于阅读的结果是 4×3×12×12。起点和终点维还可以再加大,作者认为 12 个空间模式已经够用,并且换用相近大小时主要发现不变。正文没有给出那些相近尺寸的清单,也没有给出重构误差。
要看某一种模体模式的网络,就把模体因子里其他列置零,乘回完整张量,再把 4 个时间模式加总,最后用 w = e^(ŵ) − 1 回到人数刻度。G1、G2、G3 就是这样还原出的三张有向加权网络,节点仍是 289 个站。因此图 5 的核心张量与图 6 以后的网络边权不在同一刻度上。
三种模体,在一天里各占哪一段?
时间因子有 4 列,模体因子有 3 列。作者把 T2 读成早高峰:上班时间较齐,峰短。T4 读成下午到晚上的高峰:下班时间参差,峰更长。T1 铺在全天,T3 落在午前和午后。他们还说明,时间维若只留 3 列,会漏掉有意义的模式;留到 5 列或更多,就会出现对应人数很少、不宜称为全市主要模式的列。
模体这边,简单形状 M1 和复杂形状 M2 在只设 2 列时就已经分开。再增加模体列数,M2 那条曲线基本不动,作者据此认为更复杂的那些模体整体上共用一套模式。M3 几乎全部由一天只坐一次地铁的人组成。
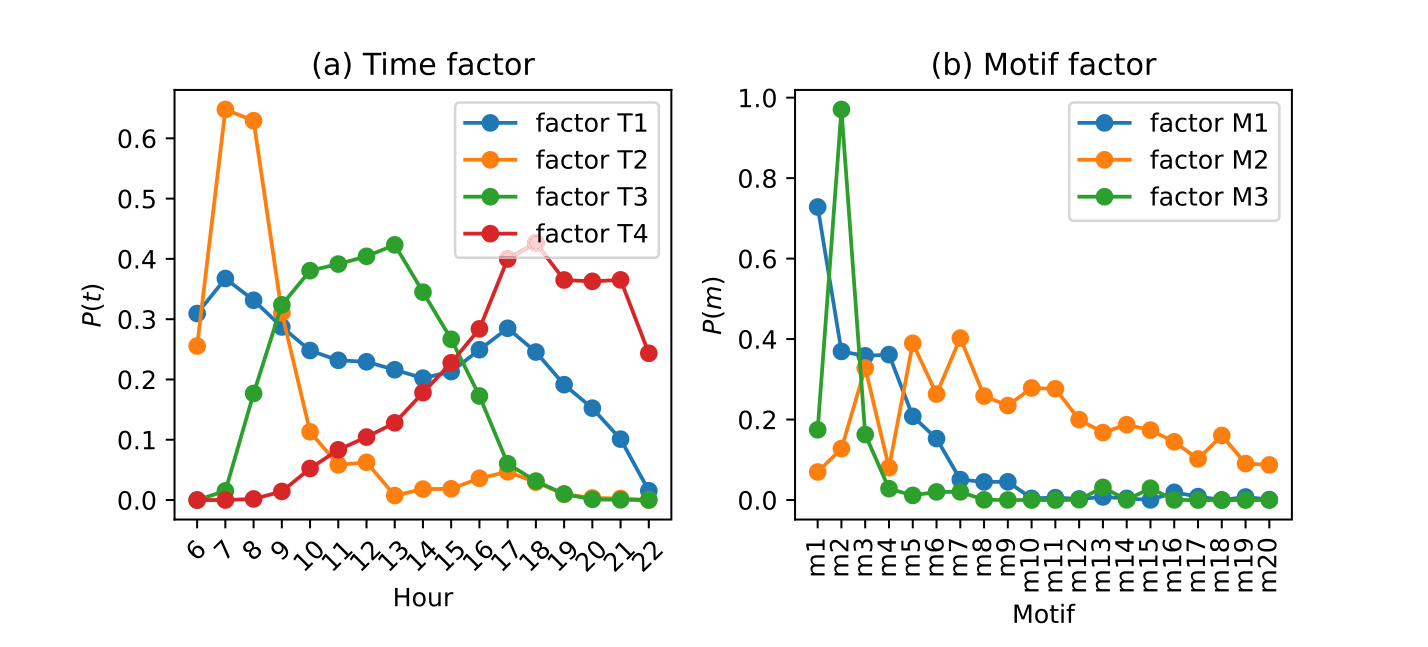
图 3|四个时间模式和三个模体模式各集中在哪里?
(a)时间因子。横轴是小时,图中大约从 6 时标到 22 时;纵轴 P(t) 是因子矩阵对应列的数值。蓝线 T1 全天较平缓,橙线 T2 在 7 时、8 时升到 0.6 以上后迅速下降,绿线 T3 在午前到午后较高,红线 T4 从午后上升并在傍晚到夜间维持一段平台。(b)模体因子。横轴是与图 1(d) 相同顺序的 20 种模体,纵轴 P(m) 同样是列上的数值。蓝线 M1 集中在最常见的简单模体,橙线 M2 分布在更复杂的多个模体上,绿线 M3 几乎只在靠前的一个模体上接近 1。列向量长度被约束为 1,这些数可以互相比,但不是各小时或各模体的人数份额,也不能加总成 100%。来源:原论文 Fig. 3。
M1 被解释成日常通勤,M3 被解释成城际枢纽出行,都要等核心张量和空间因子一起看完才能落定。图 3 单独只能说明:简单形状、复杂形状和单次行程在因子里被拆开了。
空间上分开的,不只有市中心和外围
起点因子和终点因子各 12 列,画在地图上几乎对称,所以作者主要解释起点。输入里没有坐标、线路或行政区,地理结构是分解之后才看出来的。
他们归纳出三类。区域聚集:O2、O7、O9 主要在市中心,论文把市中心说成内环以内或朝向市中心的区段;O1 主要在内环与外环之间,论文称为中城。线路聚集:O4、O5、O6、O8、O10、O11 的高值站基本落在同一条线上。O6 同时含 3 号线和 4 号线,因为两线有很长的共线区段,仍归入线路类。O3 混合了区域和整条线路,高值站多在黄浦江以东的浦东。O12 没有这种地理连片,高值站是机场和火车站。
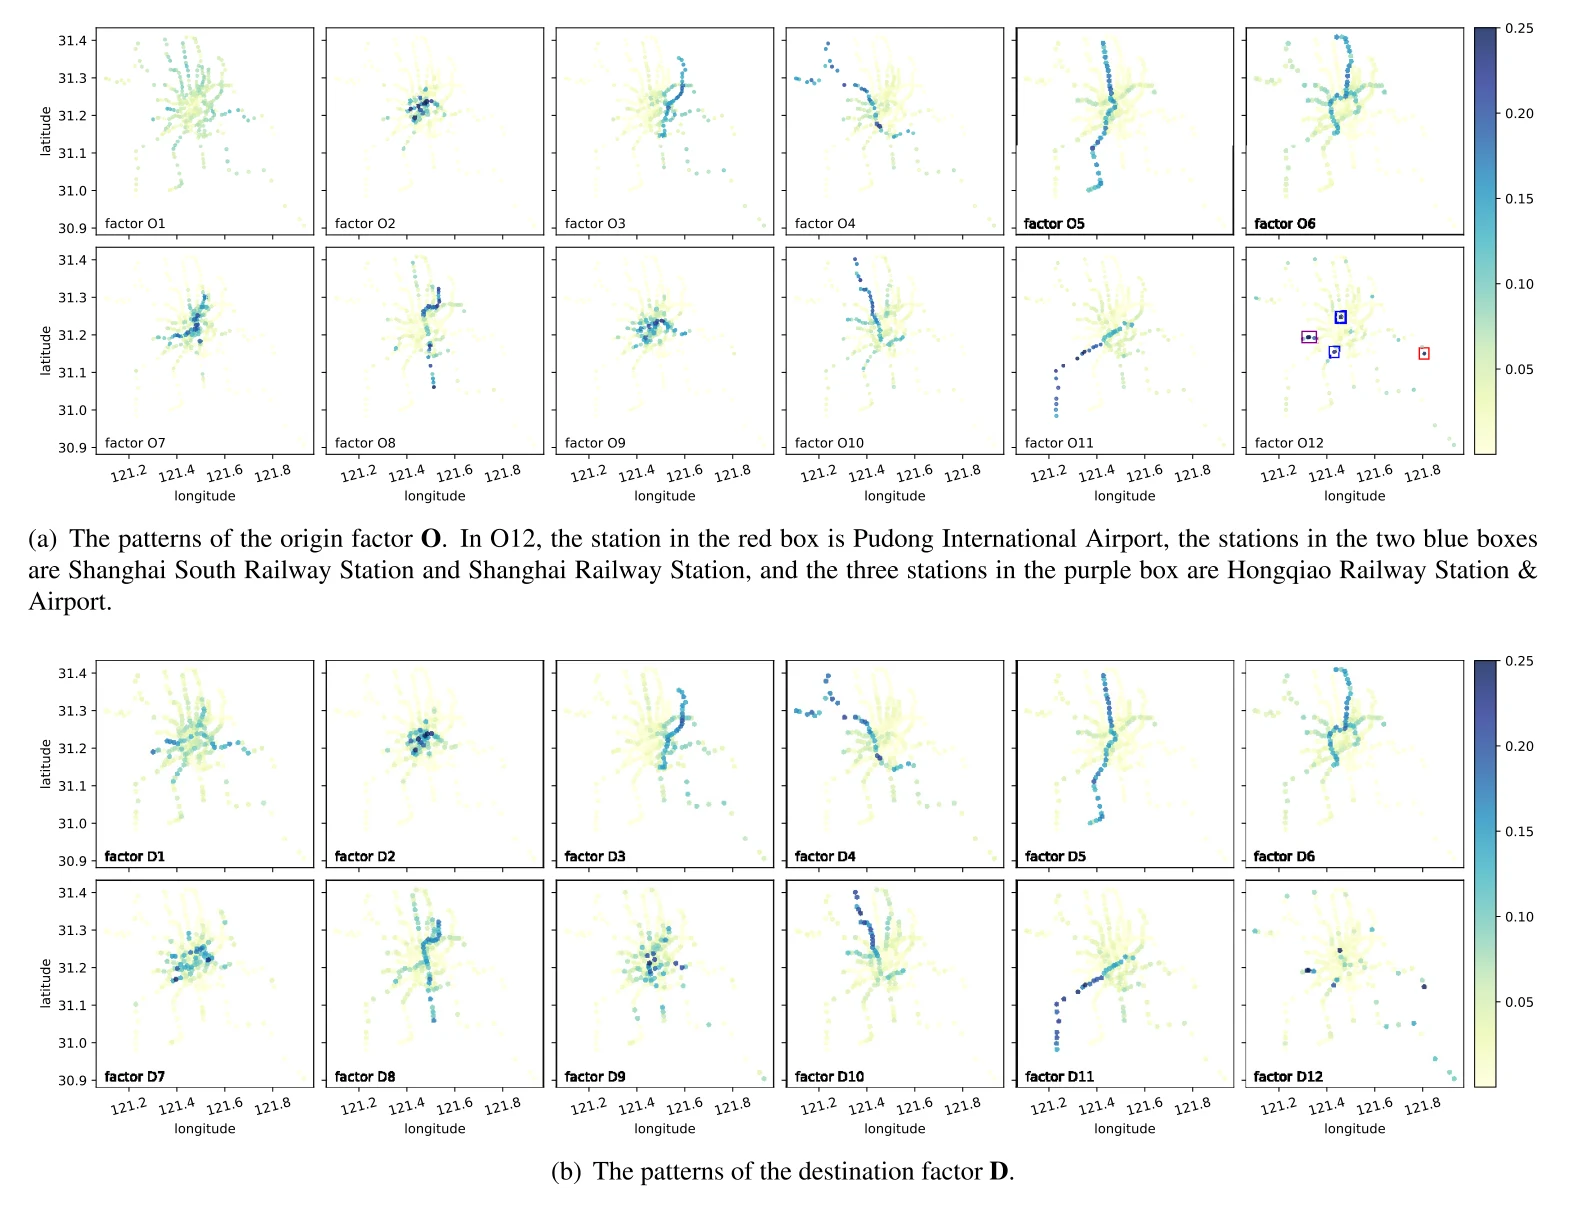
图 4|12 个起点模式和 12 个终点模式在地图上各聚在哪里?
(a)起点因子 O1 到 O12。颜色是该列在各站的数值,色标上限画到 0.25;极少数站超过 0.25,也画成最深色。O12 的红框是浦东国际机场,两个蓝框是上海南站和上海站,紫框中的三个站是虹桥火车站与虹桥机场。(b)终点因子 D1 到 D12,空间分布与起点几乎对称,色标同样把上限画在 0.25。来源:原论文 Fig. 4。
正文说 O12 包含两个机场和三个火车站;讨论 PageRank 时又说四个城际交通枢纽。图上的四个框(浦东、上海南站、上海站、虹桥)和“四个枢纽”一致,虹桥框内还有三个站。论文没有一张表把每个地铁站名和这些框逐一对应,所以这里保持图注的说法,不另编一份站名清单。
这个枢纽模式依赖模体维度。作者用同一个时间与空间规模,做了不含模体的三维张量,核心取 4×12×12,结果无法把城际枢纽识别成关键特征。因此,只按一阶行程分解,会漏掉这一类功能上相似、地理上却分开的站点。
核心张量里,三类人一天的流向并不相同
核心张量 G 的大小是 4×3×12×12。图 5 把它摊成 12 张热图:每一行是一种模体,每一列是一种时间,每一小格是从某个起点模式到某个终点模式的交互强度。颜色越深,交互越强。每张小图有自己的色标,不能拿一块的深浅直接和另一块比人数。这些数还处在对数变换后的分解空间里,不是还原后的乘客人数。
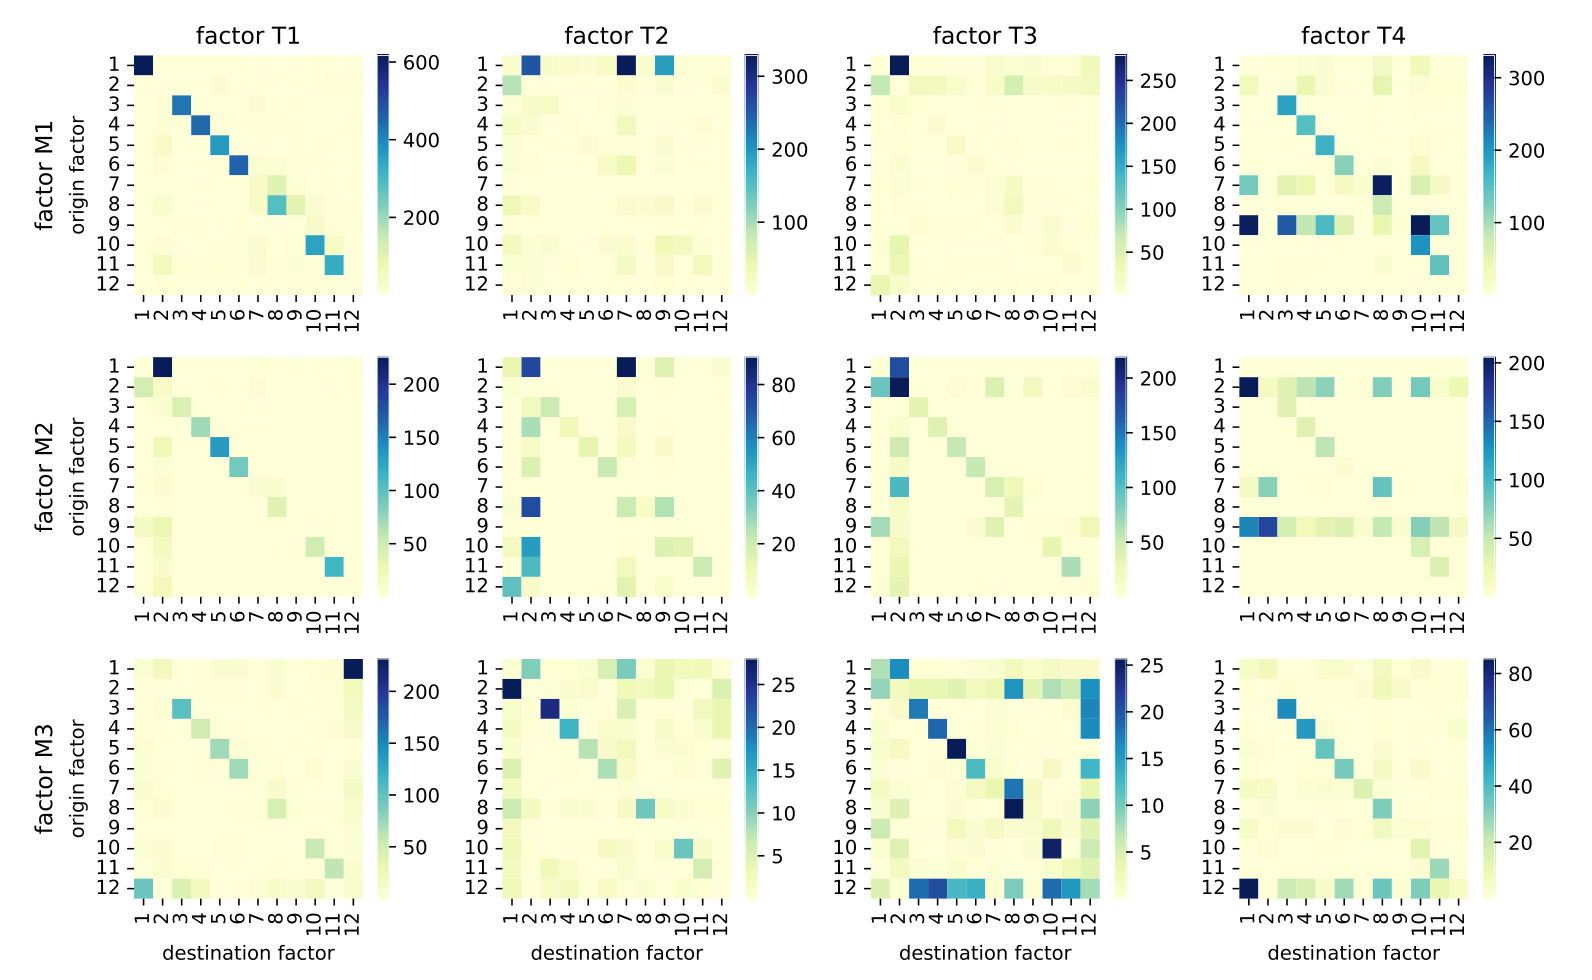
图 5|三种模体在四个时段里,主要从哪一类起点流向哪一类终点?
图中没有子图字母。三行依次是 M1、M2、M3,四列依次是 T1、T2、T3、T4。每张热图的纵轴是 12 个起点模式,横轴是 12 个终点模式,颜色深浅对应该面板自己的色标。M1 在全天的 T1 中对角线较深,早高峰 T2 里能看到从中城一类模式指向市中心几列的深色格。M2 在 T2 的色标上限明显低于它在其他时段的面板。M3 的深色更多出现在第 12 个起点或终点模式与其他模式的交叉处。来源:原论文 Fig. 5。
按论文的阅读:M1 在 T1 多发生在同一空间分量内部;早高峰 T2 以及午前午后的 T3,人从中城 O1 流向市中心 D2、D7、D9;晚高峰则从市中心返回,或在市中心以外的同一分量里活动。无论哪个时段,O2、O7、O9 指向 D2、D7、D9 的流量都很少。作者据此把 M1 解释成两类通勤:从房价相对较低的中城去市中心上班,或在市中心以外的同一片区通勤。房价和“上班”都不是本数据里的测量,而是这个阅读附带的解释。
M2 在全天并不只走对角线,更多从中城到市中心。早高峰面板的色标更低,作者据此说复杂模体的持有者里,早高峰通勤需求较少。午前午后,M2 在市中心内部(O2 到 D2)颜色很深;晚间则既有市中心内部活动,也有从市中心返回其他地区。作者把这套时间空间配上复杂模体,推断为生活和娱乐一类活动。数据里没有娱乐或消费的标签。
M3 主要是 O12、D12 与其他地区之间的交互,模体本身又几乎全是单次行程。时间上,离开上海的行程更多落在 T1 和 T3,而不是早晨 T2 或晚间 T4;到达更集中在午前午后 T3 和晚间 T4。这与“上午下午出发、下午晚上到达”的城际出行习惯相符,仍然是模式对照,不是车票目的地的直接记录。
还原成网络之后,简单行程和复杂行程还像吗?
G3 被确认与城际枢纽有关,所以功能区比较集中在 G1 和 G2。功能区来自作者此前的一项研究:按站点进出站动态聚类,聚成 3 类时得到工作、居住和综合。本图使用的是那三类,不是这次张量新分出来的区。聚类数再增加时,论文说下面的特征保持不变,但没有给出那些聚类数下的数值。
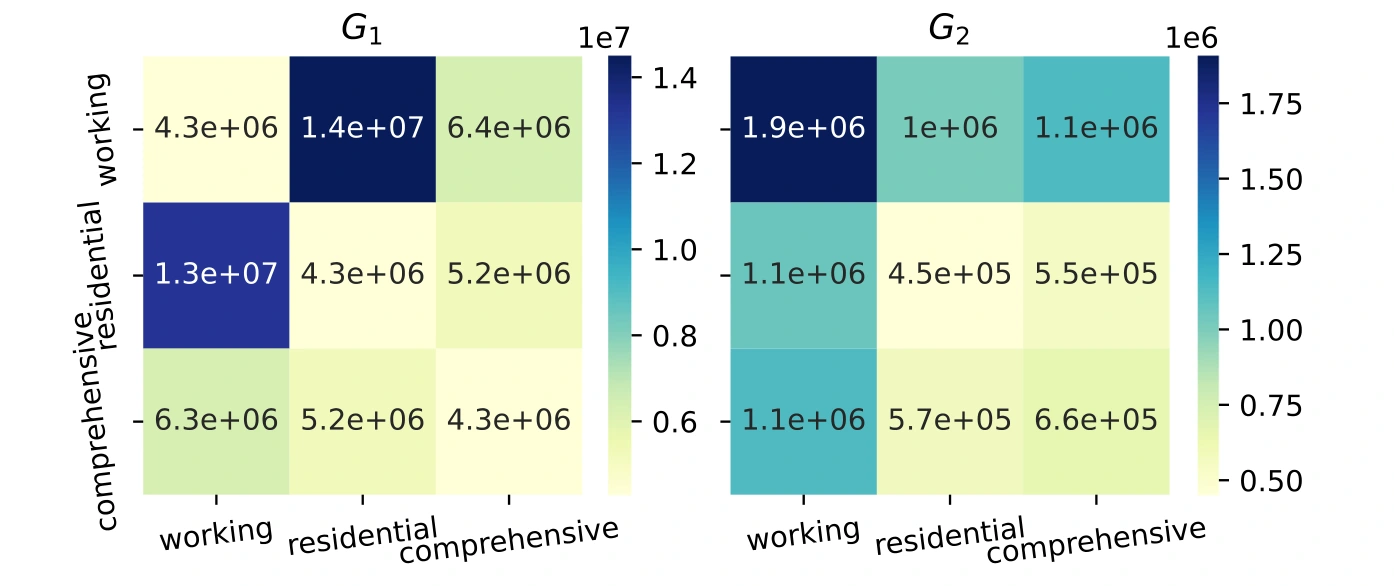
图 6|简单模体和复杂模体的客流,落在工作区、居住区还是综合区?
图中没有子图字母。左为 G1,色标以 10^7 计;右为 G2,色标以 10^6 计。纵轴自上而下、横轴自左而右都是工作区、居住区、综合区。格中数字是还原网络的边权按这三类汇总后的标注。G1 九格为 4.3×10^6、1.4×10^7、6.4×10^6、1.3×10^7、4.3×10^6、5.2×10^6、6.3×10^6、5.2×10^6、4.3×10^6。G2 九格为 1.9×10^6、1.0×10^6、1.1×10^6、1.1×10^6、4.5×10^5、5.5×10^5、1.1×10^6、5.7×10^5、6.6×10^5。来源:原论文 Fig. 6。
把 G1 九个标注相加,合计 6.30×10^7。工作区与居住区之间的两格是 1.4×10^7 和 1.3×10^7,合计 2.7×10^7,占九格总和的 42.9%。三个区域内部的对角格都是 4.3×10^6,合计 1.29×10^7,占 20.5%。标注只有两位有效数字,合计只用来说明份额。最大的流量出现在工作与居住之间,对角格较小,这和支持 G1 以跨区通勤为主的阅读一致;42.9% 是两类区域之间的份额,并没有占到九格总和的一半以上。
G2 九格合计 8.43×10^6,大约是 G1 九格合计的 1/7.5。最大的一格是工作区内部的 1.9×10^6,占 G2 九格的 22.5%。与工作区同行或同列的格子合计 6.2×10^6,占 73.5%。论文据此说复杂模体围绕工作区展开,而这些工作区多在市中心,也是更复杂的娱乐和消费发生的地方。后半句仍是推断。两张图的色标差一个数量级,不能按颜色深浅把 G1 和 G2 放在一起比。
站点有多不均,单次乘车要多久?
节点强度是一个站的进站与出站客流之和,边权是站与站之间的还原人数。三个网络的强度和边权都能用无标度分布的累积形式 P(x)=C x^(−γ) 描述。γ 越大,作者认为异质性越强。表 2 的结果是:G1 的 γs=1.6073、γw=1.6542;G2 为 1.7335 和 1.8446;G3 为 1.7553 和 1.8097。按这个定义,简单模体网络比复杂模体网络和枢纽网络更均匀。作者的解释是,通勤受每日通勤承受度约束,在全城相对匀开;G2 的主要流量集中在市中心,G3 集中在机场和火车站,所以后两者更不均。论文没有报告拟合的 R² 或检验统计量。
单次行程时间用对数正态分布拟合,期望 E(T)=e^(μ+σ²/2),单位是秒。G1:σ=0.5129,μ=7.8273,E(T)=2860.7 秒,约 47.7 分钟。G2:σ=0.5731,μ=7.8078,E(T)=2898.7 秒,约 48.3 分钟。G3:σ=0.5743,μ=8.1767,E(T)=4194.8 秒,约 69.9 分钟。G3 的期望是 G1 的 1.47 倍,多出 1334.1 秒。分母是拟合分布的期望,不是样本中位数,也不是一个人全天所有行程加总的时间。G1 与 G2 只差 38 秒。作者的阅读是:出城时人们较少计较机场或火车站离自己近不近;模体复杂与否,不太改变单次地铁乘车时间。
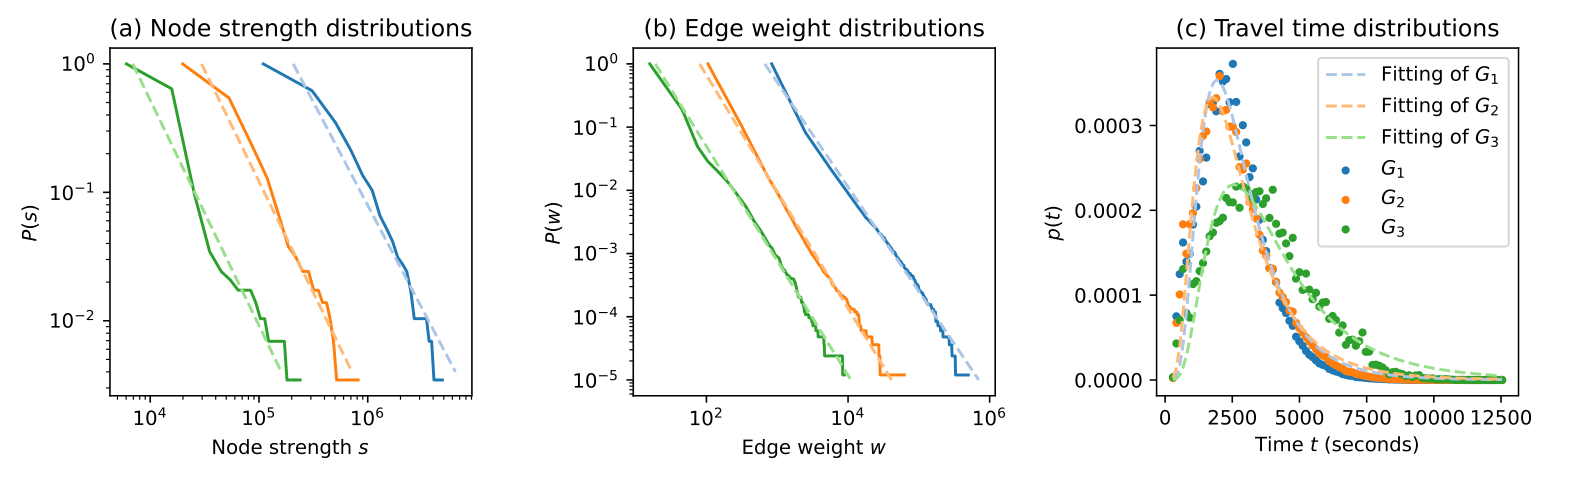
图 7|三个模体网络的客流不均和单次乘车时间差在哪里?
(a)节点强度的累积分布,横轴 s,纵轴 P(s)。(b)边权的累积分布,横轴 w,纵轴 P(w)。两图中实线是数据,浅色点线是无标度拟合;蓝、橙、绿分别对应 G1、G2、G3。G1 的累积曲线伸向更大的强度和边权,拟合指数却更小。(c)单次行程时间的概率密度,横轴是秒,点是数据,浅色点线是对数正态拟合。绿点的峰更靠右,长尾也更长。来源:原论文 Fig. 7。
重要性、熵和聚类,把站点排成三种样子
PageRank 用在有向加权网络上,阻尼系数取 0.85,289 个站的初始值之和为 1。一个站的重要性同时依赖指向它的站有多少、那些站本身重不重。熵衡量一个站的连边是否均匀:pij 是站 i 与站 j 的双向权重占站 i 总强度的比例,熵是这些比例的 −p ln p 之和。若一个站与其余 288 个站完全均匀相连,上限 Hmax = ln 288 ≈ 5.663。聚类系数看邻居之间连得紧不紧;算熵和聚类时,有向网被收成无向加权网,权重再除以全网最大的双向边。作者认为这一简化不改变主要结论,但没有并列给出有向版本的数值。
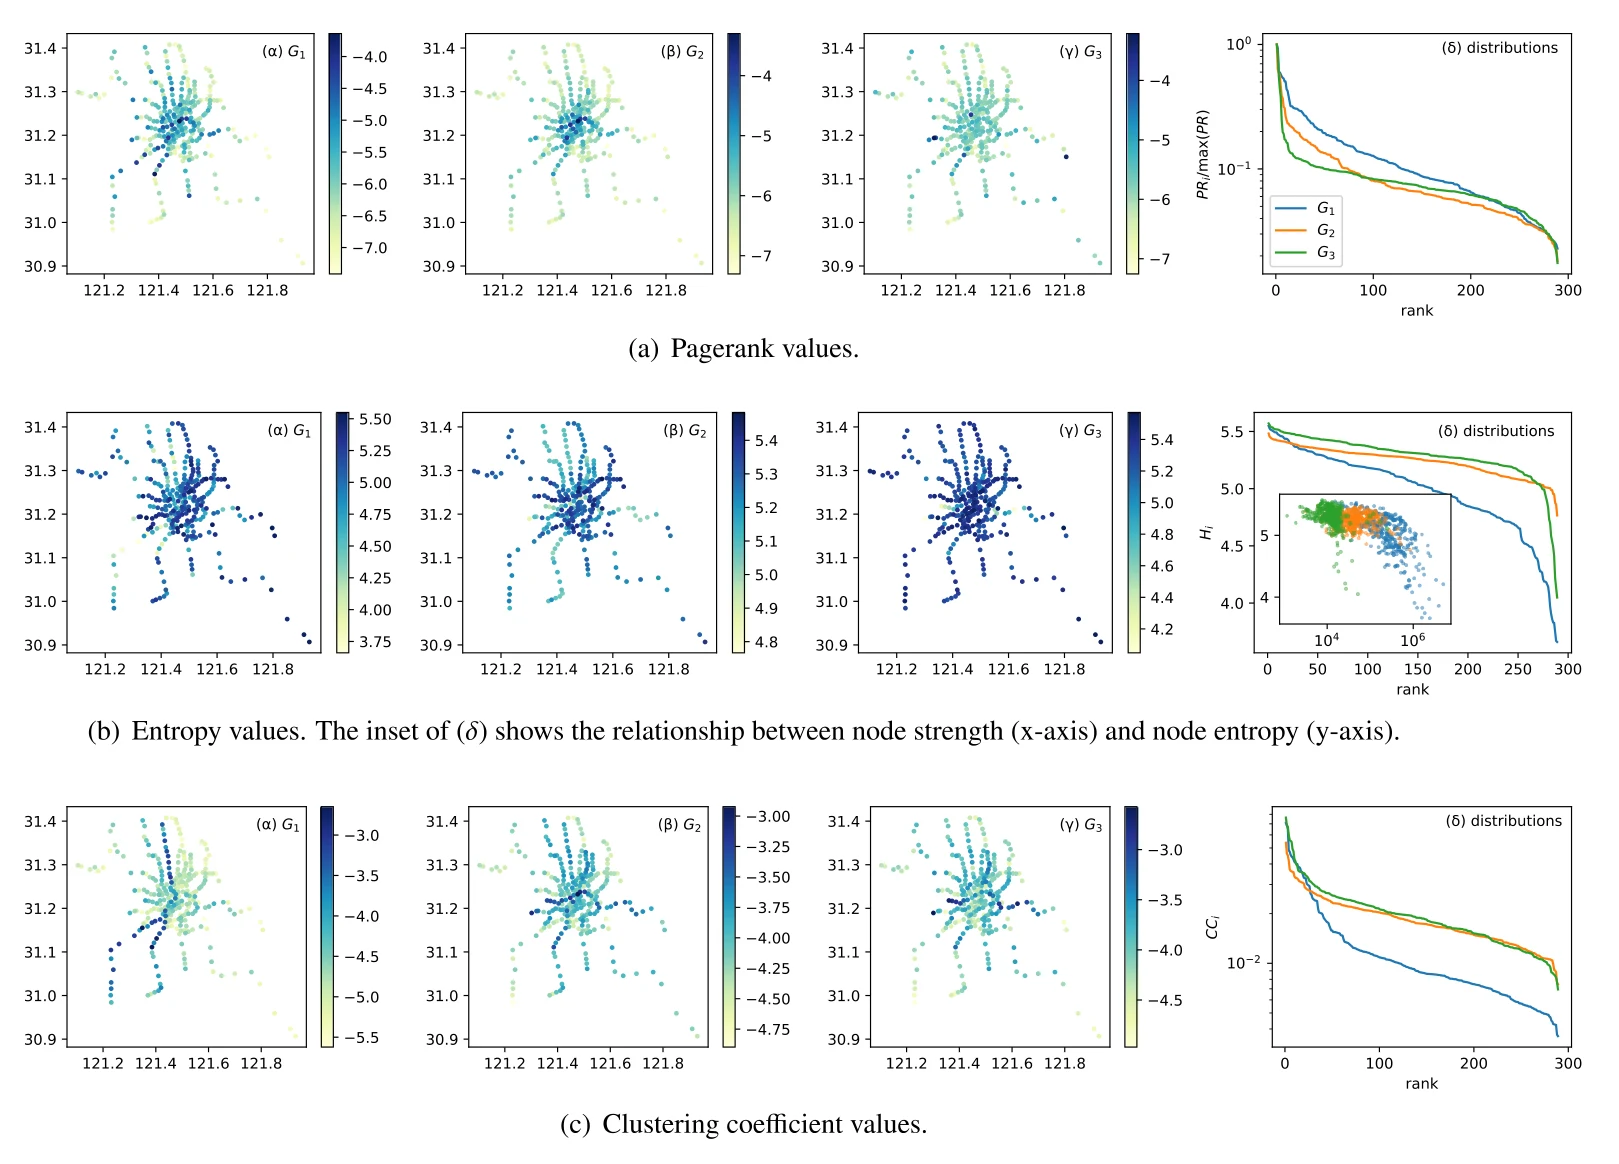
图 8|三张网络里,重要的站、连边均匀的站、邻居互连的站各在哪里?
(a)PageRank。(α)(β)(γ)分别是 G1、G2、G3 的地图,颜色是 PageRank 取自然对数后的值;(δ)按该指标从高到低排序,纵轴是每个站的 PageRank 除以该网络中的最大值,横轴排名延伸到约 300,对应 289 个站。(b)熵。(α)(β)(γ)是熵本身的地图,(δ)是排序曲线;插图的横轴是节点强度、纵轴是熵。(c)聚类系数。(α)(β)(γ)的颜色是聚类系数的自然对数,(δ)是排序曲线,纵轴为 CC。来源:原论文 Fig. 8。
G1 的高 PageRank 同时覆盖市中心和中城,排序曲线下降较缓。G2 的高值集中在市中心,排序曲线前段更高、后段更低。G3 里四个城际枢纽的 PageRank 明显高于其他站。作者还算了电流介数,说它的地理分布和 PageRank 很接近,正文没有另给数值。他们由此建议:复杂活动比通勤更集中在少数市中心地点,职住平衡之外还需要把娱乐、社交和生活类公共空间铺得更开。这是由节点重要性观察到的政策推断,不是一项平衡政策的效果评估。
熵的地图上,只有少数站明显偏低,多数站接近 5.663 的上限。排序曲线显示 G2 大多数站的熵高于 G1。更值得注意的是插图里的关系:G1 中强度越高,熵整体越低,Spearman 相关系数 −0.6728,p=1.8934×10^−39。G2 的相关系数是 −0.0508,p=0.3896,看不出稳定的正负方向。论文没有另写进入相关计算的站点数;全网站点数是 289。作者检查高强站的主要客流后解释:G1 里市中心的大站往往只和少数大型居住区有很重的边,并不是均匀地吸引四面八方。G2 的主要客流发生在市中心内部或流向市中心,单站看起来更均匀,所以熵更高。这与图 7 里 G2 的边权更不均可以同时成立,因为 G2 的站点强度本身也更不均。未给出显著相关,只说明 G2 里没有检测出强度与熵的单调关系,不表示每个站的熵都相同。
聚类系数上,G1 较高的站主要对应 O5 和 O11,也就是 1 号线和 9 号线一带,其余地区较低;G2 和 G3 都是市中心与中城较高、郊区较低,两条排序曲线整体接近,G1 明显更低。作者的机制解释是:通勤网络里居住区的邻居多是工作区,工作区之间很少互相连通,聚类就低;复杂活动会在消费场所之间换乘,场所之间产生连接,聚类就高。这与前面的通勤、娱乐推断是同一套解释,仍然没有目的标签来核对。
这些结论停在哪里
三张网络在幂指数、PageRank 的空间范围、熵和聚类系数上确实不同。简单模体更均匀、熵随强度下降、聚类更低;复杂模体更集中在市中心、熵更高、聚类更高;单次行程把重要性集中到枢纽,单次时间也更长。作者因此说,只按一阶行程构建的市内网络,可能是多类人加总后的平均结果。
这个“可能”有明确边界。通勤和娱乐是核心张量、功能区聚类和网络指标合在一起的解释,卡数据没有目的、职业或土地利用字段。功能区来自作者以前的聚类,聚类数为 3 时才叫工作、居住和综合。对数变换后的核心张量不能直接当成人数;图 6 的边权是指数还原再按区汇总的结果,也不是原始表的一个单元格。
一张卡一天一个人,是建模假设。缺边不补,所以步行、出租或公交接驳不会出现在模体里。时间只包括 6 时至 23 时的地铁,地点只包括 2017 年 8 月的上海 289 个站。工作日和周末没有分开。熵和聚类用了无向化。幂指数的“拟合良好”没有配拟合优度。更大的 γ 被作者定义为更强的异质性,比较只在 G1、G2、G3 之间。这些差异不能写成某种设施或票价政策已经改变了出行,也不能直接外推到其他城市或公交。
论文自己举的管理例子是:复杂模体的乘客可能更需要车站里的洗手间和自动售货,通勤者的饮水可以在办公室解决。这是作者的应用设想。数据没有测量这些设施的使用。
一句话总结
把 2017 年 8 月上海地铁乘客按单日行程形状分开后,简单行程、复杂行程和枢纽单次行程会还原出三张结构不同的网络;只累计单次起讫,看到的是这些差异叠在一起的平均。
核心来源
- Shi S., Wang L., Wang X. Uncovering the spatiotemporal motif patterns in urban mobility networks by non-negative tensor decomposition. Physica A, 2022, 606: 128142。DOI:10.1016/j.physa.2022.128142。正文图 1–8 与表 1、表 2 均出自这一版本。
- 论文数据可用性说明写明,作者无权共享数据。文中引用的模体定义来自 Schneider 等,Journal of the Royal Society Interface,2013,10(84):20130246。功能区三类来自作者此前工作:Shi S., Wang L., Xu S., Wang X. Prediction of intra-urban human mobility by integrating regional functions and trip intentions. IEEE Transactions on Knowledge and Data Engineering, 2020。
作者介绍
三位作者的单位和分工以论文署名及贡献说明为准。
- Shuyang Shi:署名上海交通大学自动化系,以及系统控制与信息处理教育部重点实验室。贡献说明为概念、方法、软件、可视化和初稿。
- Lin Wang:署名同一上海交通大学单位。贡献说明为调查和审阅修改。
- Xiaofan Wang:通讯作者,邮箱 xfwang@sjtu.edu.cn。署名同时包括上述上海交通大学单位,以及上海大学机电工程与自动化学院、上海市电站自动化技术重点实验室。贡献说明为指导和审阅修改。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
卡 102 缺掉的 G 到 H,说明步行或出租一旦插进地铁行程,模体就会变简单。若市中心的娱乐、消费更常在两段地铁之间夹一段步行,复杂行为会有一部分被记进 M1 或 M3。那样的话,G2 已经更高的市中心聚类,还是被这种漏记稀释之后的结果。要检验这一点,需要同一批人的地铁记录和站外轨迹,而不是把现有模体再解释一遍。
G1 里大站熵更低,意味着通勤重边指向少数居住区,而不是均匀铺开。若在中城均匀增加岗位,新岗位仍由原来那几个大型居住站到达,强度与熵的负相关可以继续存在。职住平衡是否改变了这张简单模体网络,要用同样的四维张量比较变化前后,单看某一天的 PageRank 地图不够。
单次行程这个形状本身也分不清远近。虹桥框里有三个站,乘客若只在火车站和航站楼之间坐一次地铁,模体形状与从市区直达机场的单次行程相同。论文能把 M3 读成枢纽出行,靠的是 O12 与其他地区的交互,不是靠模体形状单独完成。若有人只根据 20 种拓扑做聚类,而不把起点终点放进同一个张量,枢纽站和普通站之间的短驳会被当成同一种“只坐一次”的人。