手机最常出现的两个地方,就一定是家和办公室吗?
论文名片|Balázs Cs. Csáji、Arnaud Browet、V.A. Traag、Jean-Charles Delvenne、Etienne Huens、Paul Van Dooren、Zbigniew Smoreda、Vincent D. Blondel,Exploring the mobility of mobile phone users,Physica A,2013,392(6):1459—1473。2012 年 11 月 27 日上线的正式期刊版。DOI:10.1016/j.physa.2012.11.040。研究类型:葡萄牙匿名通信记录的探索性分析、常去地点推断与通勤流量建模。
一个人的手机白天在写字楼附近响,晚上在另一片街区响,我们很容易把两个地方叫作办公室和家。但有人轮班,有人退休,有人把工作手机留在单位;而同一个人在原地不动,也可能接入不同基站。这个日常场景说明了识别难点,并非论文核实过的某位用户经历。
这项研究没有直接把前两名基站等同于家和单位,而是先合并相邻基站,再比较每个常去地点一周内的通信节奏。工作时段与居家时段确实形成了两类突出的模式,但不是每个人都能同时识别出这两个地点,更不是全部常去地点都只有这两种用途。
先说结论
- 研究先在符合基本通信条件的人群中抽取 10 万用户,计算 50 个特征;五个线性组合可以保留约 95% 的标准化数据方差,显示特征冗余,不代表只需五个特征就能理解人的全部行为。
- 常去地点分析另设更严格的活跃度和规律性条件,再抽取 10 万用户。每人平均约 2.14 个常去地点,结论针对经过筛选且能在通信中观测到的地点。
- 一周 168 小时的使用模式支持工作型、居家型与其余型三组。约 60% 的常去地点可归入前两类,但只有约 12% 的分析用户恰好有一个推定家和一个推定办公室。
- 推定居家地点的区域数量与官方人口统计相关系数为 0.92;这是聚合空间分布的对照,不是个人住址识别准确率。
- 通勤引力模型用起点推定家数量、终点推定办公室数量,比只用人口规模拟合稍好;150 km 以上样本的距离系数不显著,不能据此断言长距离出行不受距离影响。
手机记录的是通信时的位置,不是全天的行踪
数据来自葡萄牙一家运营商,覆盖 15 个月。每次通信记录开始、结束时间、涉及用户及通信开始时的基站,并有基站经纬度。本文没有给出连续 GPS 轨迹,也未提供覆盖期的完整起止日历日期。
基站位置与真实位置有偏差,接入还受信号反射、散射与网络情况影响。研究先在每位用户的记录中,用前后 30 分钟内、随时间间隔衰减的权重平滑基站位置,减少频繁换站造成的虚假移动。平滑会影响逐段距离,不能恢复没有通信时的真实路线。
最初的特征分析要求 15 个月内至少发起或接收过 10 次通话,随机抽取 10 万名用户。通话次数、联系人数量、通话时长、通信双方距离、常用基站坐标和移动尺度,共组成 50 个特征。数据在降维和聚类前经过缩放、中心化。
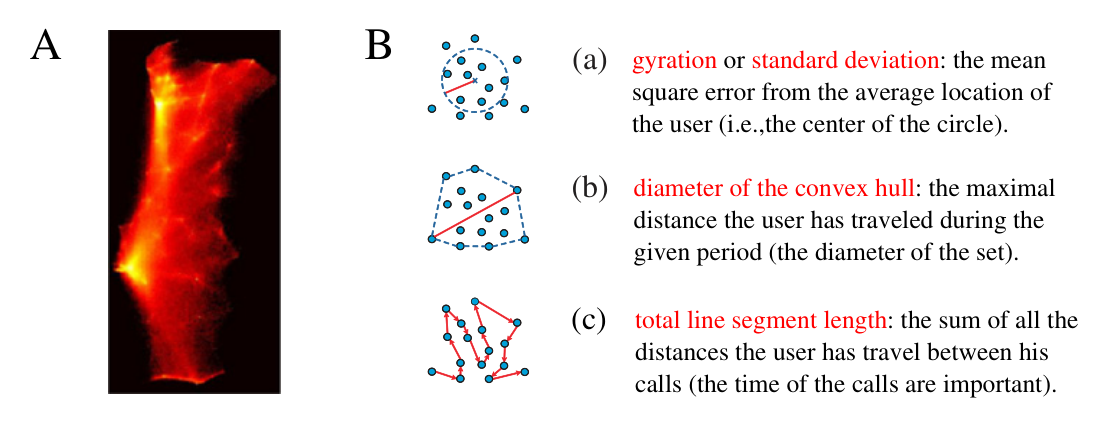
图 1|同样一组位置,为什么能量出不同的移动尺度?
(A)按用户平均位置画出的葡萄牙分布,较亮区域表示更多用户的平均位置集中;它不是常住人口的直接观测。(B)内的(a)gyration 描述位置围绕平均位置的离散程度;(b)凸包直径是任意两个观测位置间的最大距离;(c)总线段长度按通信先后逐段相加,因此受事件顺序和采样频率影响。前两项不依赖访问顺序,三者都不是完整道路里程。来源:原论文 Fig. 1。
五个综合数值,能替代五十个行为特征吗?
部分特征本来就在重复描述相近的事情。原论文表 1 中,通话次数与通话对象数量的相关系数为 0.91;使用基站数与通话次数为 0.60。但凸包直径与平均通话时长只有 0.05。记录更多,可能观测到更多地点;不能把基站数与通信量的相关直接解释成爱打电话导致人走得更远。
主成分分析(principal component analysis,PCA)寻找几个线性组合,尽量保留标准化用户特征之间的总体差异。聚类则寻找彼此接近的用户群。两者回答的问题不同,也不必给出一样的特征排序。
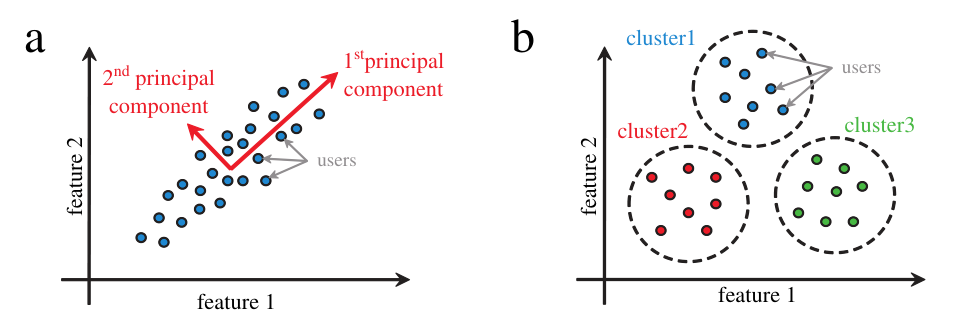
图 2|压缩整体差异和划分人群,有什么不同?
(a)蓝点代表用户,第一主成分沿差异最大的方向,第二主成分与它垂直;图中只有两个示意特征。(b)把相近的点归为不同群体,强调局部相似。这是方法示意,不是葡萄牙用户只有三个真实类别的结果。来源:原论文 Fig. 2。
原论文表 2 的压缩结果如下。允许损失更多方差,需要的综合维度就更少。
| 保留方差 | 方差损失/均方重建误差口径 | 所需主成分 | 相对 50 维压缩比例 |
|---|---|---|---|
| 99% | 1% | 24 | 52% |
| 98% | 2% | 13 | 74% |
| 95% | 5% | 5 | 90% |
这不是说任一用户的任一原始特征都保证误差低于 5%,也不是未见用户的行为预测准确率达到 95%。它描述的是这批经过预处理的数据整体如何被线性重建。
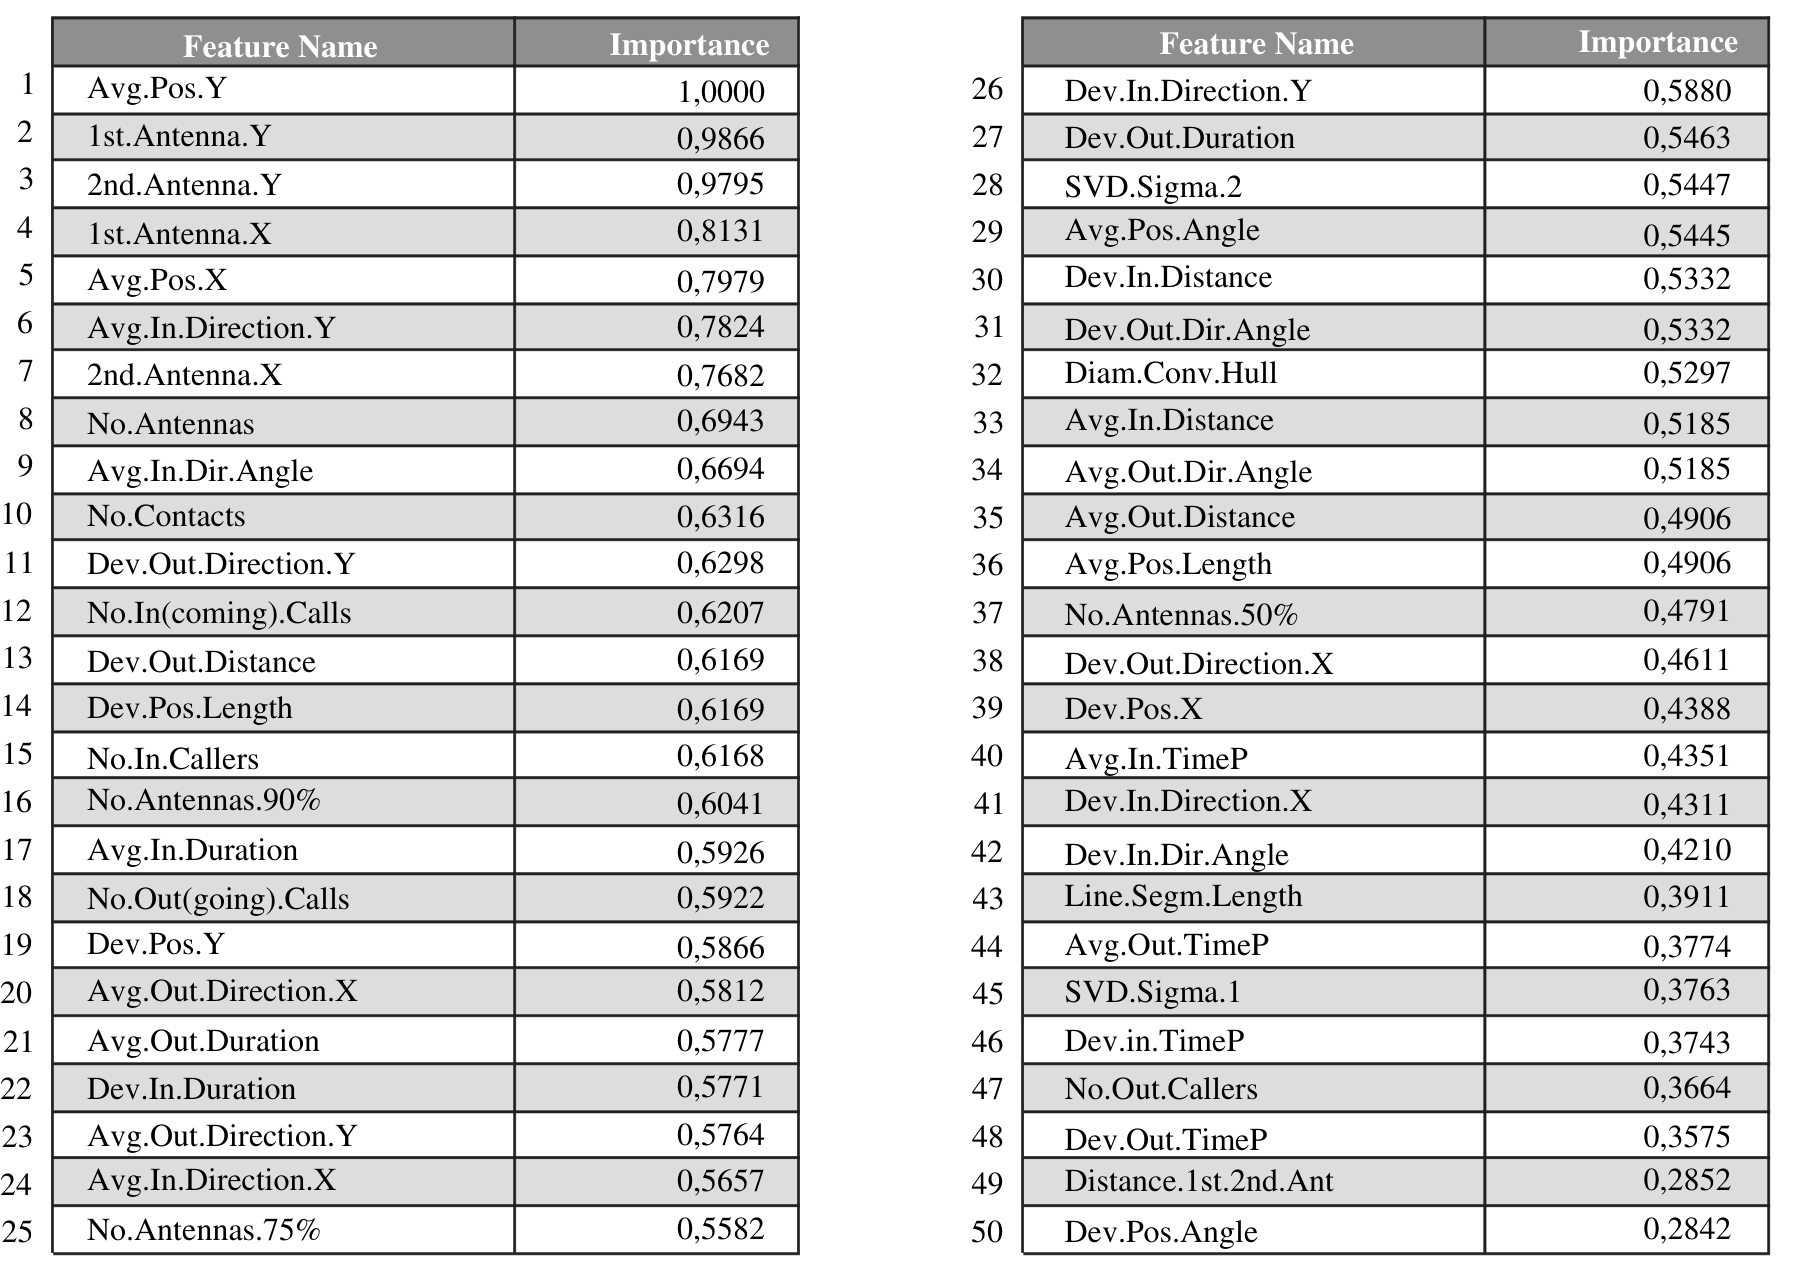
图 3|哪些信息在整体差异中比较突出?
左右两列完整列出 50 个特征及论文定义的相对重要性,最重要项缩放为 1。平均位置 Y、第一与第二常用基站 Y 坐标排在前列;这里的分数不是各特征贡献方差的百分比,更不是地理位置对行为的因果效应。来源:原论文 Fig. 3。
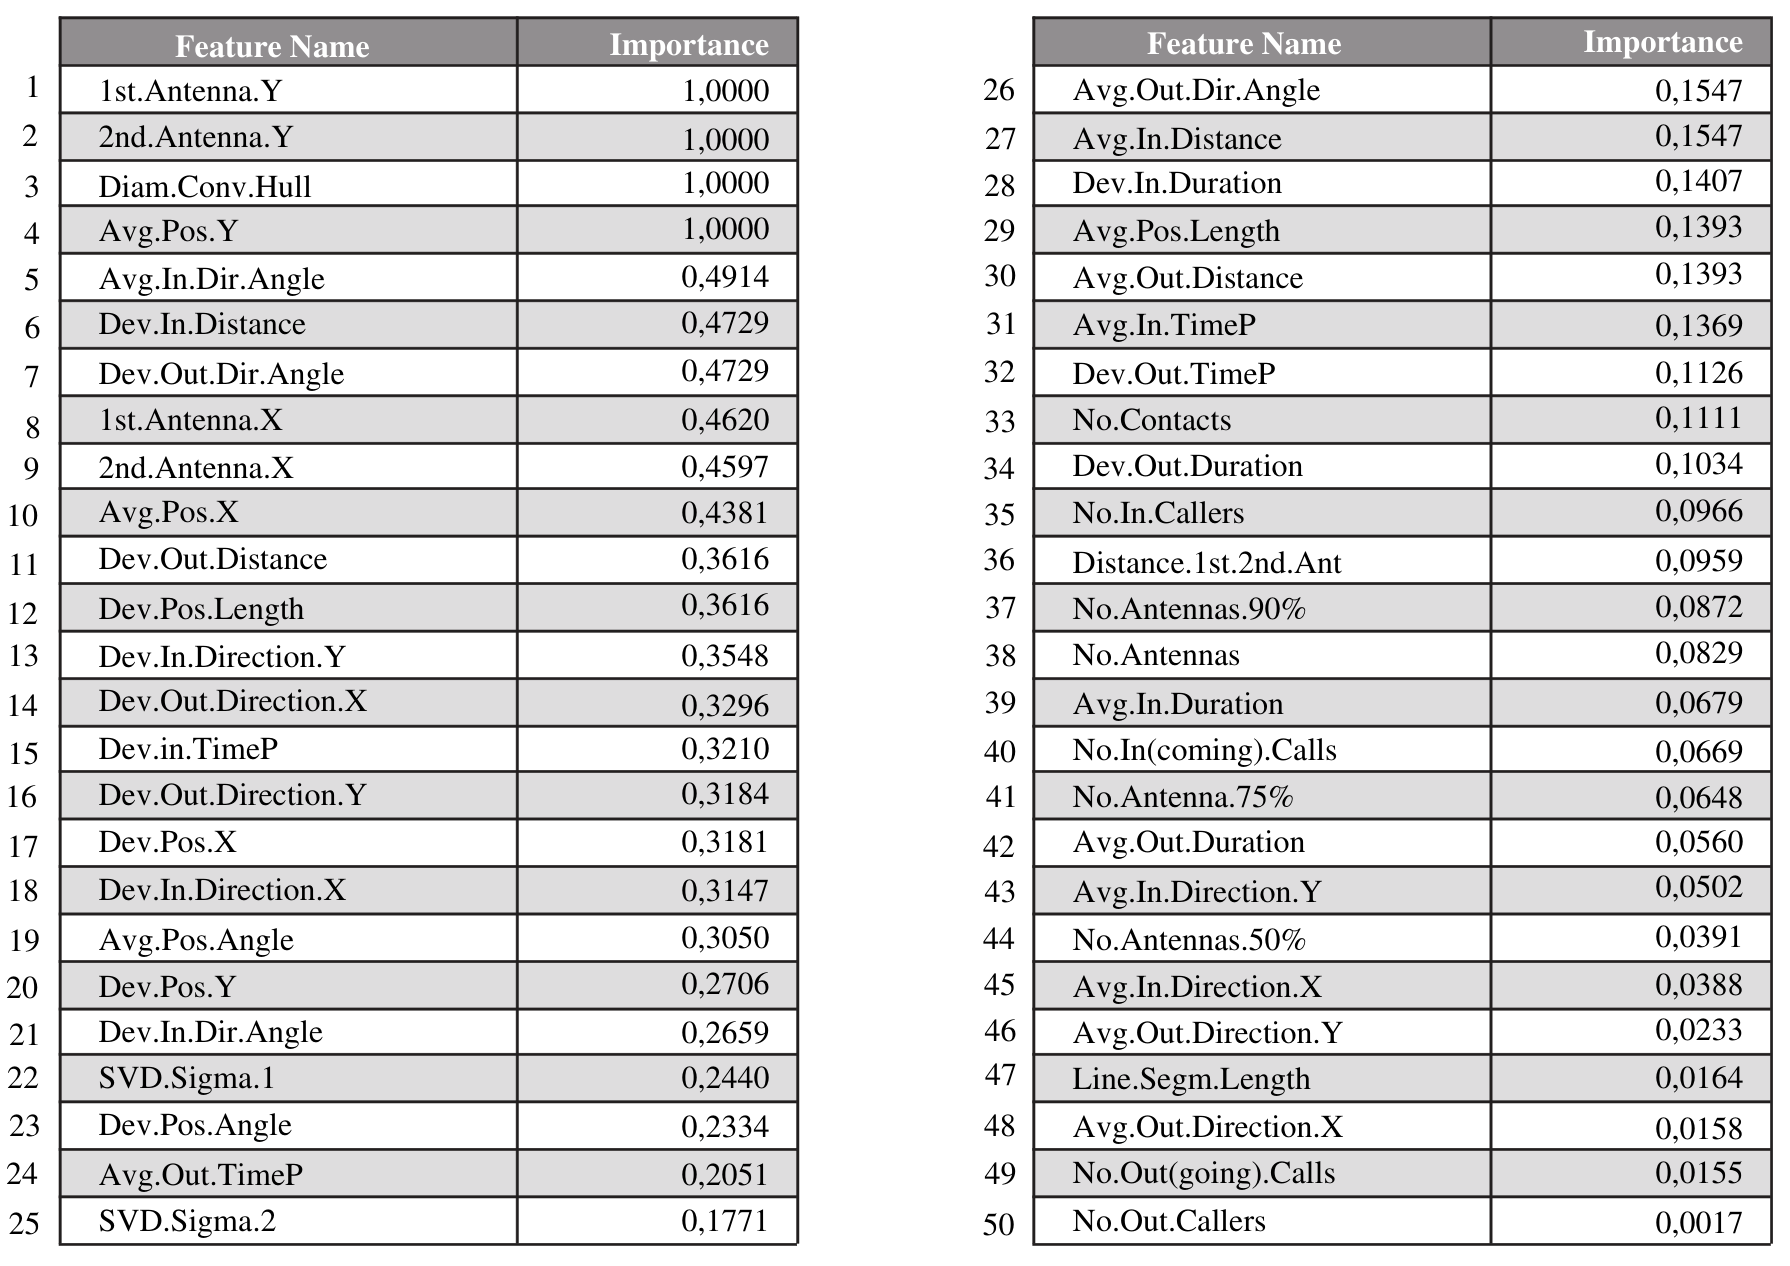
图 4|用于分群的重要信息,与用于压缩的信息相同吗?
左右列分别延续列出第 1—25 与 26—50 项。两处常用基站的 Y 坐标、凸包直径、平均位置 Y 在聚类排序中突出,凸包直径相较图 3 更靠前。研究的减法聚类得到五个用户群,但没有把它们验证成五种社会身份。来源:原论文 Fig. 4。
坐标重要还与葡萄牙狭长、人口沿海分布有关,不能把这个排序直接搬到其他国家。上述结果提供了研究常去地点的理由:位置中有大量信息,下一步需要弄清这些位置到底代表怎样的生活节奏。
一个人站着不动,也可能留下几个基站
识别常去地点需要比计算粗略特征更多的记录。研究在此另选平均每天至少一次通信、且至少 80% 的相邻通信间隔不超过 24 小时的用户,再随机抽取 10 万人。这部分把短信也算入位置事件,正文统称 calls。它偏向活跃、规律的用户,不能与前一阶段的基本筛选混为一谈。
合并基站时,从个人使用频次最高的基站开始,用 Voronoi 分区确定相邻关系,再以该基站到最远 Delaunay 邻站的距离为尺度,将两倍范围内的基站归为一个地点。之后在剩余基站上重复,直到下一组不足个人通信事件的 5%。因此,这里的地点是按基站空间和使用频率推断的区域,不是精确门牌号;其尺度也随当地基站密度变化。
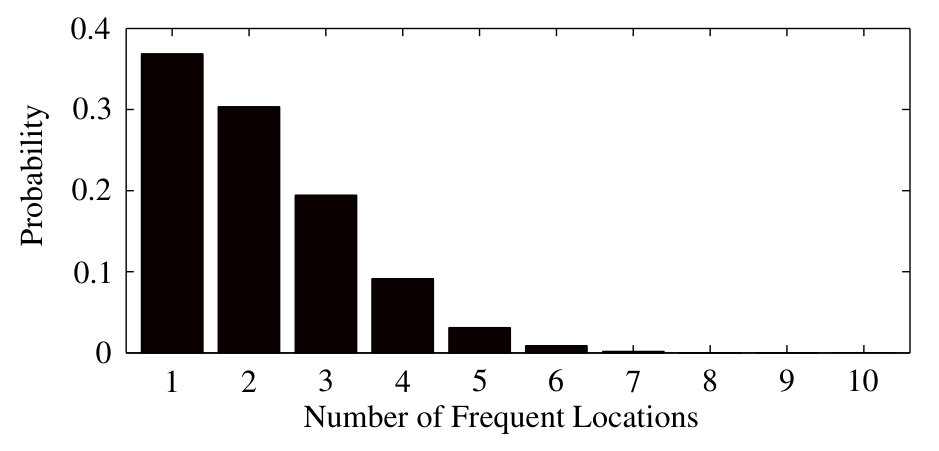
图 5|合并基站后,常去地点到底有多少?
横轴是每位用户的常去地点数,纵轴是相应用户比例;一至三个地点最常见,数量更多时比例迅速下降。论文报告平均约 2.14 个。门槛以通信事件频率定义,这张图不能读成每个人一生只会去两三个地方,也没有测量完整停留时间。来源:原论文 Fig. 5。
要叫作家或办公室,还得看一周何时出现
每个常去地点都被表示成一个 168 维向量:星期一到星期日,每小时有多少通信事件。这样,地理位置本身暂时退到后面,工作日白天活跃还是晚上、周末活跃,成了比较的依据。
研究尝试 k=2 到 10 的 k-means 聚类。三个群体最容易解释:工作型地点在工作日白天活跃,周末明显下降;居家型地点晚间较活跃,周末也有较多通信;其余型没有形成前两类的典型节奏。增加类别没有稳定分出清楚的学生、周末住宅等用途,不能反过来说这些生活方式不存在。
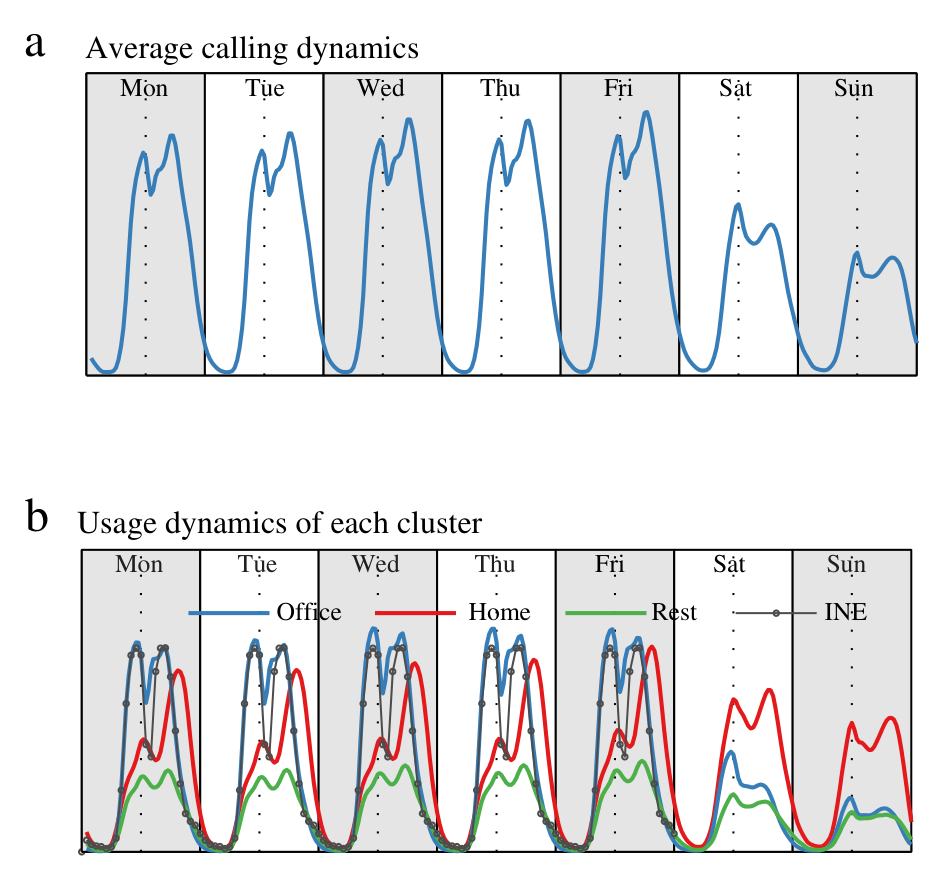
图 6|家和工作的标签,得到哪些时间证据支持?
(a)总体通信节奏在夜间低、白天高,工作日与周末不同。(b)蓝色工作型、红色居家型、绿色其余型的周内使用曲线;灰黑色 INE 独立时间使用统计与工作型节奏较接近。虚线标示每日中午。曲线比较支持群体节奏的解释,并没有逐人核实真实家庭或雇佣地址。来源:原论文 Fig. 6。
原论文表 3 把地点标签组成用户组合。只有一个推定家的占 16.8%,只有一个推定办公室的占 16.5%;恰好一个家、一个办公室且没有其他未识别地点的占 6.6%。若允许同时存在未识别地点,恰好一个家和一个办公室的用户约占 12%。这几个数字分母都是筛选后的分析用户,条件却不同,不能相互替换。
约 60% 的全部常去地点被归入家或办公室。这是地点比例,不是用户比例。没有识别到办公室,不表示用户没有工作;可能是没有在工作时通信,也可能是工作方式不符合这里的典型周节奏。
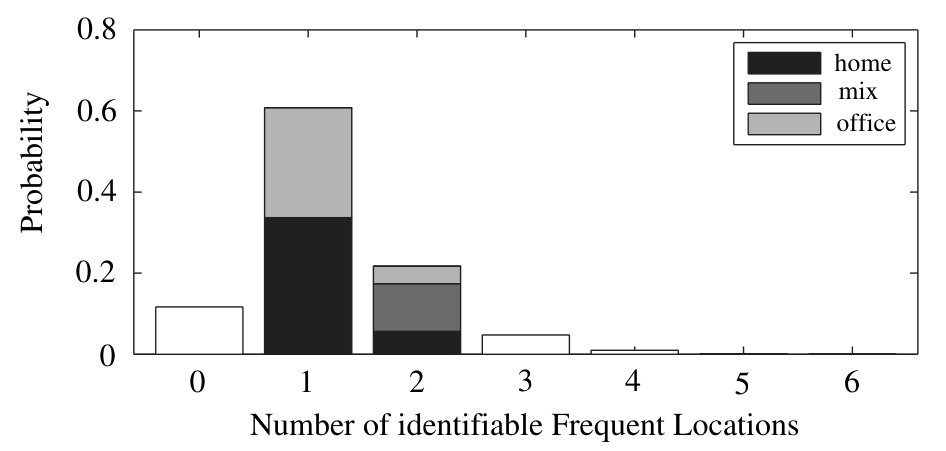
图 7|识别出常去地点,是否就能识别出完整职住关系?
横轴是可识别为家或办公室的地点数量,纵轴是用户比例;黑色为居家型、浅灰为工作型、深灰 mix 为混合组合,0 个可识别地点的空白柱表示未获得家或工作标签,三个及以上地点的柱未继续分类型着色。一个可识别地点最常见,两个可识别地点才可能构成职住配对;这与图 5 的全部常去地点数是不同指标。来源:原论文 Fig. 7。
定位模型更精细,不等于地址误差已经测出来
同一常去地点可能由多座基站服务,用最高频基站的坐标会过于粗略。论文假设基站发射功率相同,信号随距离衰减并叠加独立随机衰落,再用各基站的实际接入次数寻找最符合观测的地点,即最大似然估计(maximum likelihood estimation,MLE)。这是基于简化无线传播模型的估计,不是新增了一次真实 GPS 测量。
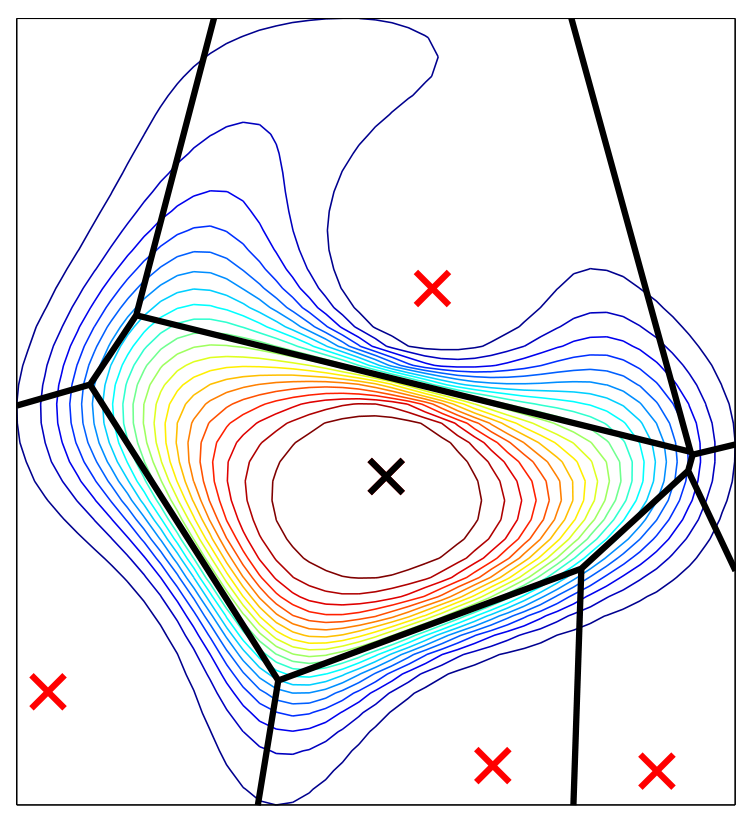
图 8|为何不能总把用户放在最近基站的分区内?
黑色 X 为目标基站,红色 X 为邻站,粗黑线为 Voronoi 边界,彩色等值线表现模型接入目标站的概率。边界外仍有非零接入可能;随机传播使硬分区变得平滑。图是模型概率示意,不是测得的逐位置准确率。来源:原论文 Fig. 8。
为节约计算,只考虑局部基站邻域。以两倍 Delaunay 尺度截断后,论文在 1,000 个随机点比较局部与全基站计算,报告概率计算的平均差异低于 0.1%;这不是 0.1% 的住址误差。最大似然位置与基站加权平均位置相隔平均 1.7 km,极端约 35 km,也只是两种估计的差异,不能拿来当实际定位精度。
一张人口分布图,能验证到哪一层?
将推定家位置按区域汇总后,其数量与葡萄牙官方人口统计的相关系数为 0.92。高人口区通常也有更多推定家,这为宏观空间分布提供了外部对照;即使每个人的位置有偏差,区域总量仍可能高度相关。因此,验证尺度必须与结论尺度一致。
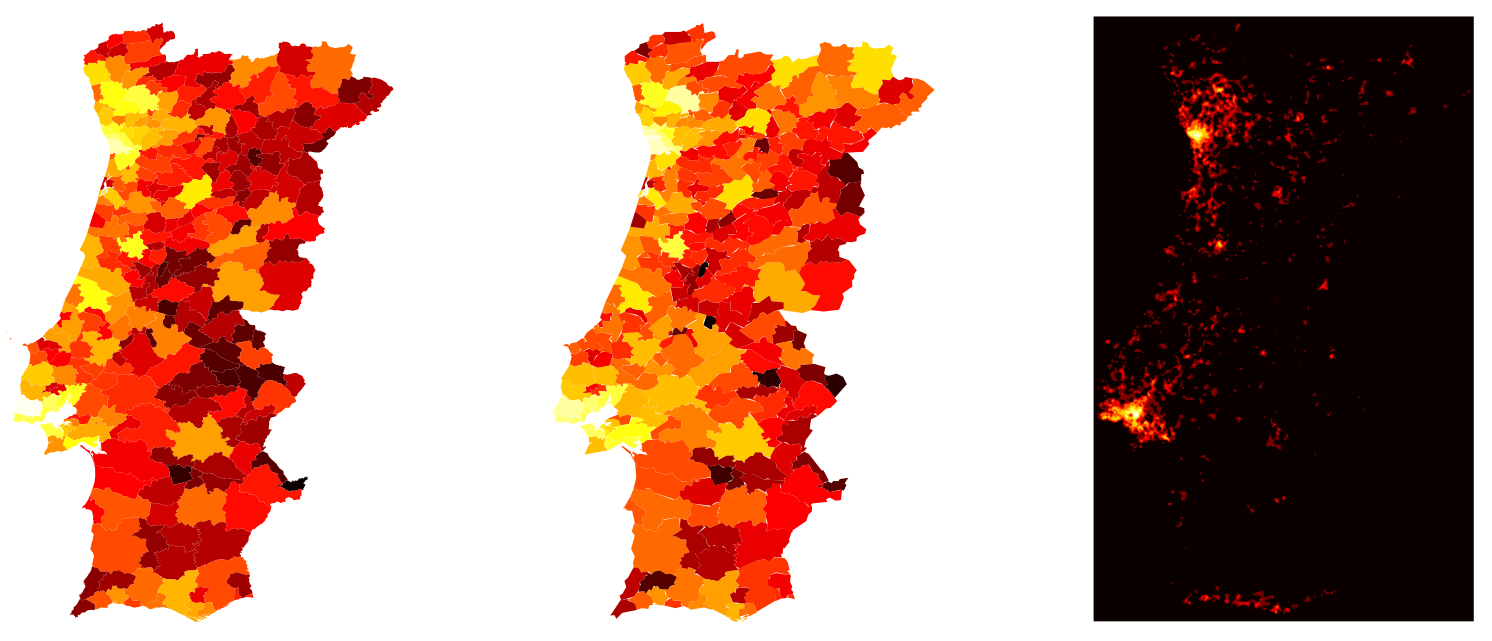
图 9|位置推断是否重现了人口集中的区域?
(a,左)官方区域人口数量;(b,中)对应区域的推定家数量;(c,右)全部常去地点的更细空间分布。颜色越亮表示值越高,城市与沿海集中较突出。常去地点比图 1 的平均位置更集中,因为把家与工作位置简单平均,可能将人放到两者之间。来源:原论文 Fig. 9。
通勤模型只取约 12% 用户,分母为何缩小?
若一个人有两个家或两个工作型地点,哪一对才是通勤关系并不清楚。研究因此只保留恰好一个推定家和一个推定办公室的约 12% 用户,允许另有未识别地点。两处估计位置的地理距离被作为通勤距离;它不是实际沿路里程,也没有逐次验证每天真的发生这段通勤。
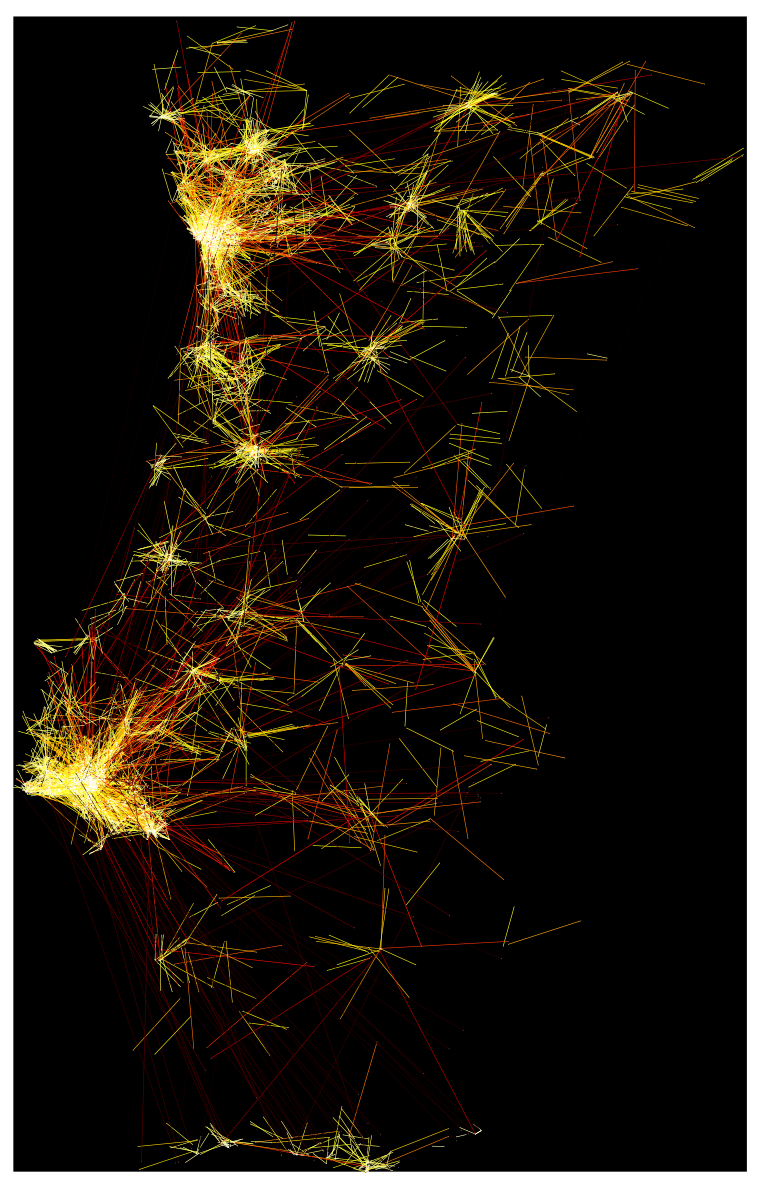
图 10|这批职住配对在地图上形成什么结构?
线连接每位所选用户的推定家与办公室,较亮线表示较短距离。里斯本与波尔图周边形成明显集中,多数城市吸引较近地区,仍有少量很长的连接。图中的长线不能自动认定为每日跨城通勤,长期位置标签也可能混合不同生活安排。来源:原论文 Fig. 10。
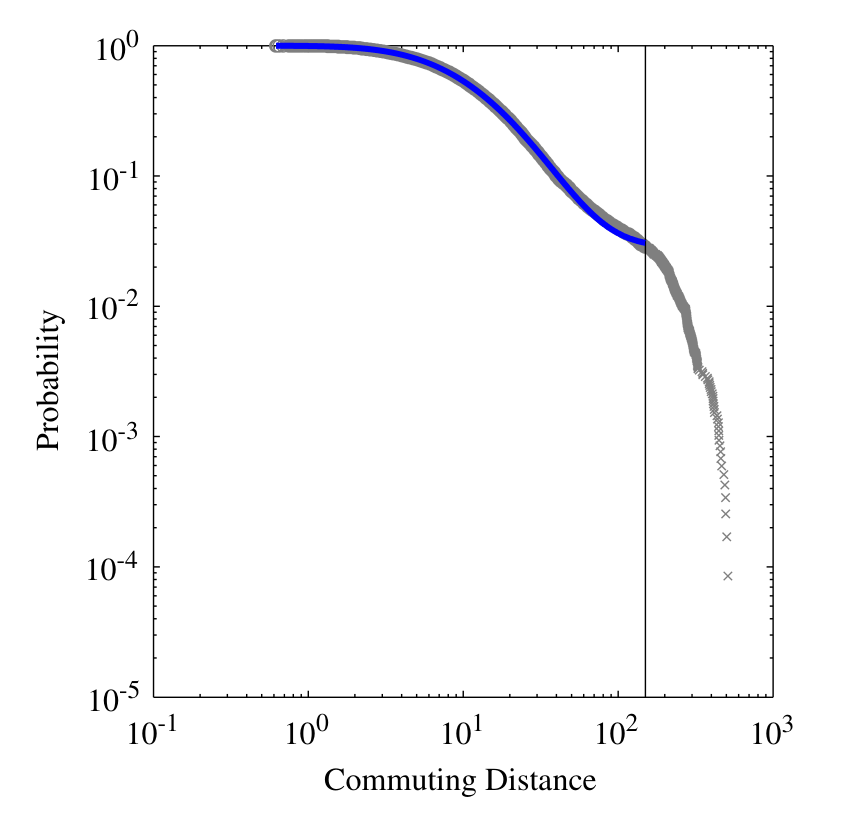
图 11|短距离和长距离适合用同一种分布解释吗?
横轴为推定通勤距离 km,纵轴为随距离阈值增加而下降的尾部概率,均用对数刻度。灰色为数据,蓝色为 150 km 以下的对数正态拟合,竖线标出分界。论文参数 μ=2.35、σ=0.94 是对数尺度拟合参数,不是平均通勤 2.35 km。150 km 与两大城市相距约 300 km 的国土背景相关,不是普遍的人类通勤上限。来源:原论文 Fig. 11。
区域间引力模型(gravity model)进一步问:哪两地之间会有更多这种职住配对?论文用起点的推定家数量 H、终点的推定办公室数量 O 和两地距离 d,拟合“流量 ∝ H 的 α 次方 × O 的 β 次方 ÷ 距离衰减项”。分母分别试用 d 的 γ 次方和指数形式。H、O 是手机推断的地点数量,不是房屋套数、企业数或实际岗位数。
原论文表 4 的幂律距离模型给出以下系数,± 后为标准误。短、长距离分别拟合,不是同一条模型在两边共享全部参数。
| 参数或拟合指标 | 小于 150 km | 至少 150 km |
|---|---|---|
| 起点家数量 α | 0.17 ± 0.013,p<0.001 | 0.018 ± 0.013,未显著 |
| 终点办公室数量 β | 0.21 ± 0.013,p<0.001 | 0.030 ± 0.012,p<0.05 |
| 距离项 γ | 0.37 ± 0.018,p<0.001 | 0.13 ± 0.11,未显著 |
| R²,幂律距离项 | 0.52 | 0.26 |
| R²,指数距离项 | 0.46 | 0.26 |
只用两地人口数量时,R² 分别为 0.43 和 0.24;改用家与办公室数量后分别为 0.52 和 0.26,短距离改进更明显。这是样本内拟合对照,没有给出独立城市或后续时间的预测成绩。
长距离中只有终点办公室数量系数显著,支持的是在该样本与模型下能识别的统计关系。长距离样本较少、地理范围有限,距离项标准误也大;不能把未显著翻译成距离从此没有作用。
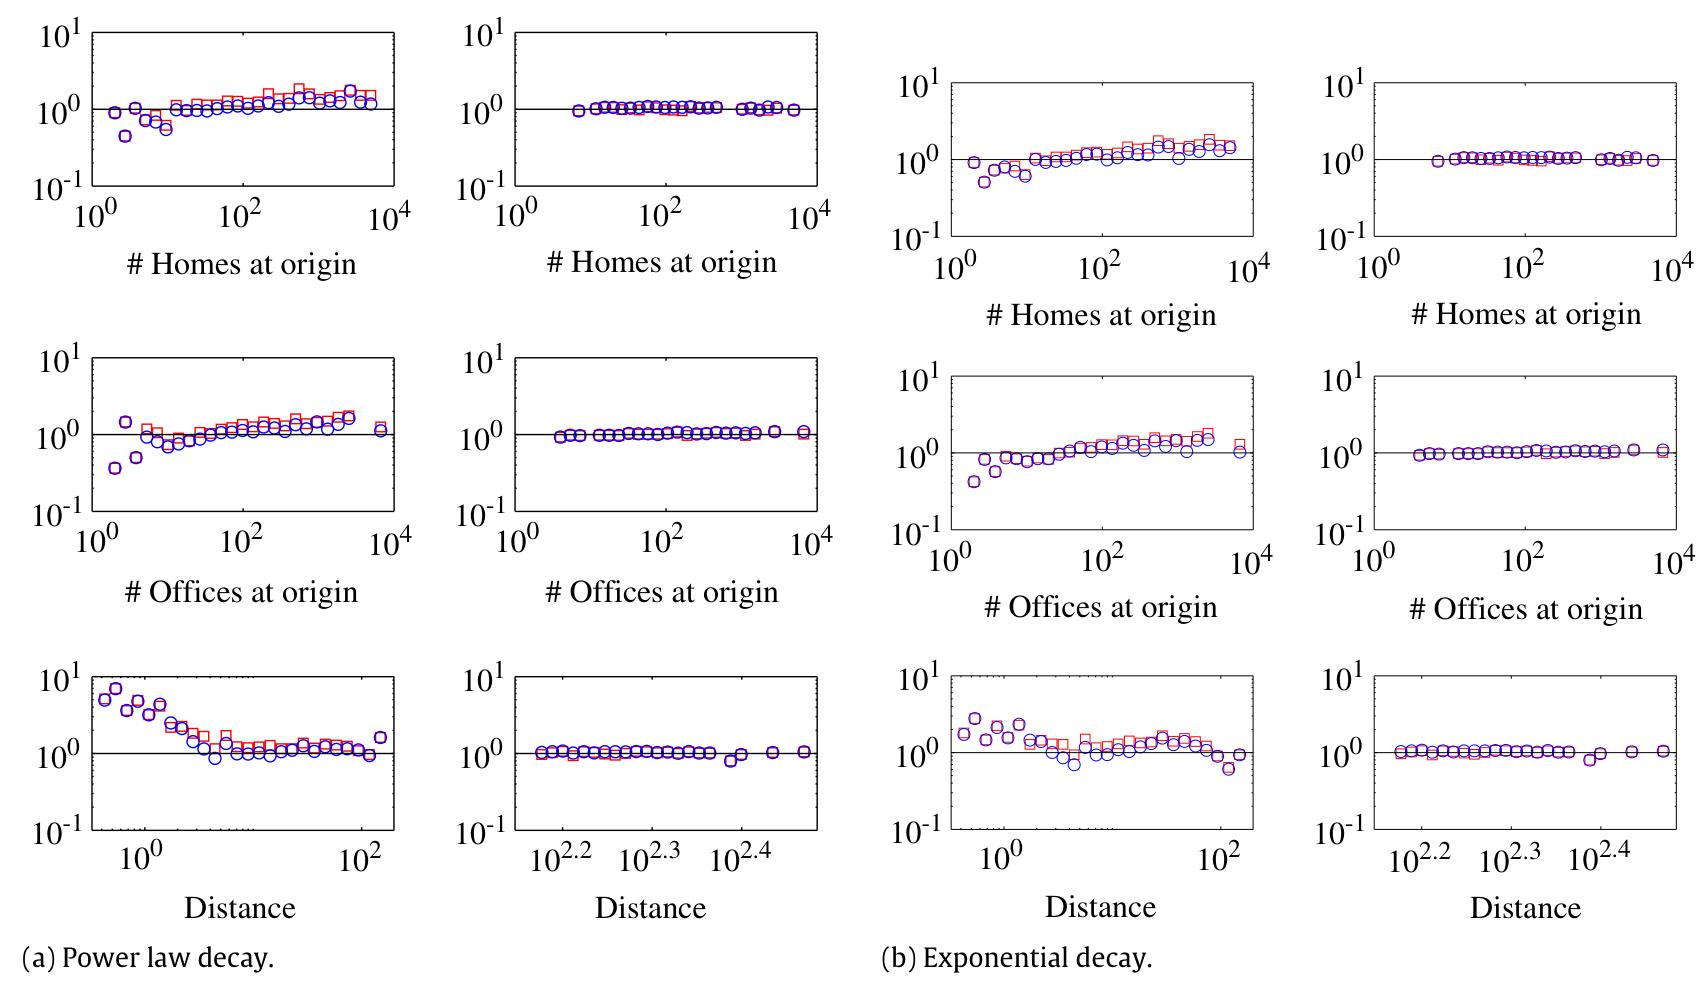
图 12|一个总体拟合优度,会掩盖哪些系统偏差?
(a)幂律距离衰减模型;(b)指数距离衰减模型。每组内左列为小于 150 km、右列为至少 150 km,从上到下按家数量、办公室数量与距离分组;原图保留全部十二个面板。纵轴为模型预测流量/观测流量,接近 1 表示吻合,红方块为均值、蓝圆为中位数。短距离列的最短距离端常高于 1,显示高估;总体 R² 不能代替这种分段检查。来源:原论文 Fig. 12。
能识别的规律,为什么不等于完整生活?
记录只在通信事件出现,活跃度与日程规律性筛选又排除了部分人;推断地点也受基站密度和合并半径影响。工作型与居家型是统计节奏标签,轮班、流动工作或多个住处未必能被同样识别。区域人口对照与职住流量拟合有价值,却不能替代个人位置真值。
这项研究的贡献在于把几道推断分开:先证明特征冗余,再寻找常去地点和使用节奏,最后构造有明确筛选条件的职住关系。每经过一道推断,可说的对象与分母都会变化;守住这些变化,才不会把通信样本变成全体居民的生活画像。
一句话总结
常去地点的周内通信节奏可以帮助辨认居家与工作模式,但从这种群体规律走到个人地址和真实通勤,仍需要更多独立验证。
核心来源
Csáji B Cs, Browet A, Traag V A, Delvenne J-C, Huens E, Van Dooren P, Smoreda Z, Blondel V D. Exploring the mobility of mobile phone users. Physica A, 2013, 392(6):1459—1473。正式论文、作者机构网站期刊全文、2012 年预印本。本文图 1—12 全部对应正式论文 Fig. 1—12;样本、表格和数值以正式版本为准。
作者介绍
- Balázs Cs. Csáji:论文署名墨尔本大学电气与电子工程系,以及匈牙利科学院 SZTAKI。
- Arnaud Browet:论文署名比利时鲁汶天主教大学 ICTEAM 研究所。
- V.A. Traag:论文署名 ICTEAM,为本文通信作者;此处沿用原论文署名。
- Jean-Charles Delvenne:论文署名 ICTEAM、那慕尔 NAXYS,以及鲁汶天主教大学 CORE。
- Etienne Huens:论文署名 ICTEAM,为本研究作者之一。
- Paul Van Dooren:论文署名 ICTEAM,为本研究作者之一。
- Zbigniew Smoreda:论文署名法国 Orange Labs 的网络与服务社会学和经济学部门。
- Vincent D. Blondel:论文署名 ICTEAM,为本研究作者之一。论文未逐人披露贡献分工,不能据署名顺序把某项算法归给特定作者。
延伸思考:没有识别出的生活,也应留在城市画像里
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
一套识别方法越擅长找工作日白天与夜间的规律,越可能让日程不规则的人变得不显眼。如果据此估算公交需求,轮班者或流动工作者的活动可能被放进其余类,随后在分析中被丢掉。不能识别应当是一种需要保留的结果,而不是默认没有需求。
实际应用可以同时报告识别覆盖率、不同用户活跃度下的稳定性,以及未识别地点占比。这样,两个区域即使得到相近的职住流量,也能看出一个区域是大部分用户都留下了清楚证据,另一个只是少数规则用户构成了整张图。两者应有不同的核查优先级。

