充电桩被占着,究竟意味着多少用电需求?
论文名片|Han Li、Haohao Qu、Xiaojun Tan、Linlin You、Rui Zhu、Wenqi Fan,UrbanEV: An Open Benchmark Dataset for Urban Electric Vehicle Charging Demand Prediction,Scientific Data,2025,12:523,2025 年 3 月 28 日发表。论文原文 · 数据 · 代码与说明。
假设你正为下一小时的充电服务做准备。司机想知道哪里有空桩,运营者想知道哪些区域会拥挤,电网则更关心会消耗多少电。三个问题看起来都叫充电需求,却不能用同一个数字回答:一个桩显示忙碌,不代表它始终按额定功率输电。
UrbanEV 把深圳公共充电平台的信息整理成可用于预测的城市数据。它同时提供占用、累计使用时长、估计电量、价格、天气和空间关系。理解这份基准的关键,是分清直接记录的状态、根据状态推算的使用,以及模型可以预测的对象。
先说结论
- 原始范围为 1,682 座公共充电站、24,798 个充电桩;清洗并筛选后,主要预测数据保留 275 个交通小区、1,362 座站和 17,532 个桩。站与桩不能混称。
- 数据覆盖 2022 年 9 月至 2023 年 2 月,共六个月;五分钟状态记录被整理为小时级区域序列,共 4,344 个时间点。
- 电量主要由使用时长乘以桩额定功率估计,并非电表实测。另一个固定 11 kW 的版本也是替代估计,不能当作已验证的真实电量。
- 复杂模型在若干指标上表现较好,但并非所有指标都获胜;加入天气和价格也不必然提高预测,更不能据此证明价格对用户行为的因果效应。
数据里的站、桩和区域,分别是什么?
研究通过供司机查找公共充电设施的移动平台,每五分钟记录可用状态、额定功率、费用与位置。一个站点可以包含多个桩;交通小区则把同一区域的站和桩汇总,便于研究相邻区域之间的联系。
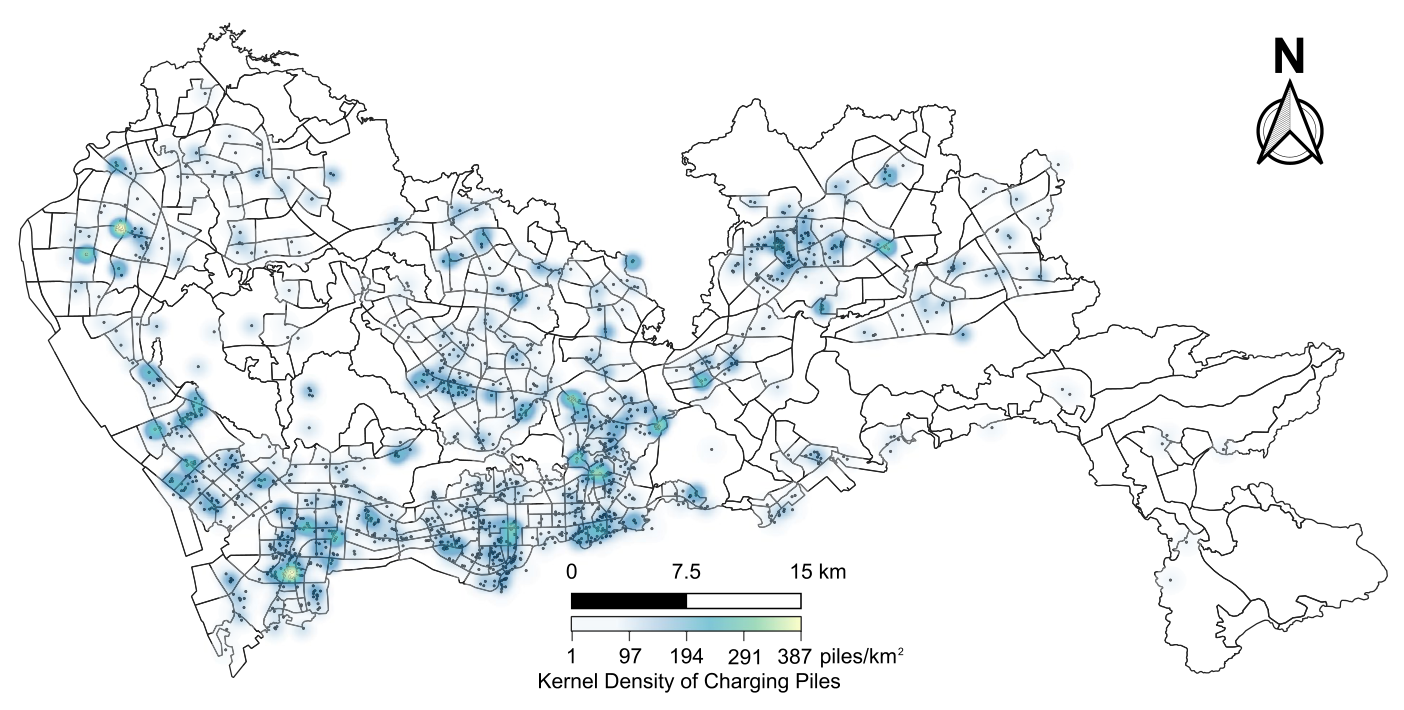
图 1|这些记录来自城市的哪些地方?
这张图没有字母子图。底图呈现深圳空间单元,颜色为初始 24,798 个桩的核密度,单位是每平方公里桩数,颜色更深表示设施更密集。它展示的是采集覆盖与设施密度,不是该时刻的充电负荷,也不是最终 275 个区域的筛选结果。来源:原论文 Fig. 1。
其他资料包括两处气象站的温度、气压和相对湿度,以及兴趣点(point of interest,POI)、区域面积、道路长度、中心点距离和邻接关系。天气序列对所有区域共享,不能据此精确表示每个充电点自己的微气候。
原论文表 1 把 UrbanEV 与其他充电数据比较,突出城市尺度、较多桩位以及价格和空间背景的组合。这个贡献是增加研究条件,不意味着平台覆盖了深圳所有公共与私人充电设施。
一个忙碌状态,怎样变成时长和电量?
论文的规则是,两次相邻记录都为忙碌时,将相应片段视作活跃充电;累加使用桩数与五分钟间隔得到时长,再乘额定功率估计电量。区域内多个桩同时使用,因此一个小时里累计桩时可以超过一小时:十个桩各用半小时就是五桩时,不能读成某一辆车充了五小时。
小时聚合也分两类。时长和电量是累计量,在一小时内相加;占用率和价格则取指定时刻的瞬时值,不是这一小时全部五分钟记录的均值。因此,用占用率直接推算平均利用率时,要先核对采样口径。
作者仓库说明进一步区分:占用从可用性出发,包含不可用或忙碌的桩;时长与电量则从使用角度统计活跃充电。占用、时长、电量相关,却不是可以互换的字段。
电量的边界尤其重要。车辆实际功率可能受电量状态、车型、充电曲线和设施限制影响;平台忙碌状态乘额定功率,可能高估真实供电。volume-11kW.csv 用固定 11 kW 替换部分功率作为另一种估计,它不是逐车测量或对全部直流充电功率的事实描述。
为什么只保留部分区域,又怎样处理错误?
研究删除负收费、忙闲数量与总桩数不一致等异常记录,将其视为缺失;先向前填充,再用向后填充处理序列开端缺口。对部分指标使用四倍四分位距阈值识别离群点,再以相邻有效值均值替换。与常见的 1.5 倍阈值相比,四倍设置保留了更多原始极值,但仍可能改变真实峰值。
初始空间聚合得到 331 个区域,再排除占用率方差低于 0.001,或零值比例超过 30% 的区域,最终保留 275 个。这使预测基准更集中于有明显变化和使用活动的区域,也意味着不能把结果直接推广到低使用率或长期闲置区域。
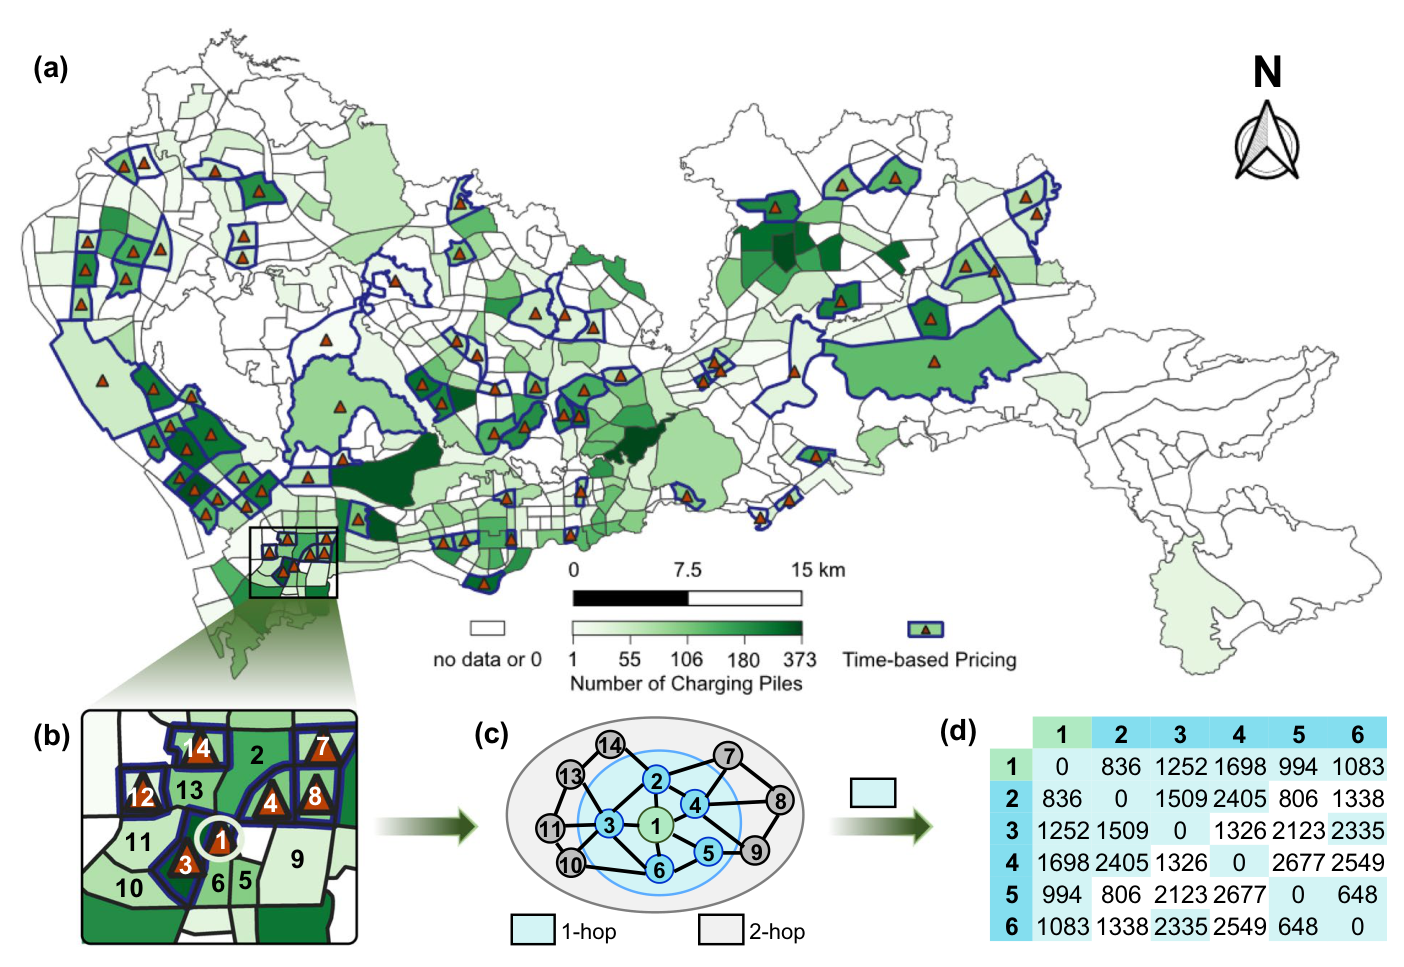
图 2|怎样把一座城市变成可学习的空间网络?
(a)区域级充电桩数量分布,绿色深浅表示桩数,标记指出存在分时定价的区域;这不是预测误差地图。
(b)中心商务区局部放大,显示相邻交通小区及其编号。
(c)把局部区域转成节点图,一跳与两跳表示沿邻接关系跨过一个或两个区域,不是开车一公里或两公里。
(d)部分邻近区域中心点的距离矩阵,单位为米;数值为欧氏距离,不是道路行程时间。全部四个面板共同解释聚合与空间特征,不能把区域编号当作站点编号。来源:原论文 Fig. 2。
原论文表 2 给出区域指标的分布。占用字段的数值在 0–1 范围内,即比例;表中虽用百分号标记,0.24 应先理解为 24%,而不是 0.24%。价格字段也需留意:正文数据说明曾写每小时,作者仓库则明确电价与服务费单位为元/kWh。复用时应以具体文件说明统一单位,不能把时间分辨率误当计价单位。
模型预测得好,证明了哪些事情?
论文以小时数据做预测评测,采用按月份扩展的时间序列交叉验证:逐折增加月份,在各折中以 80% 训练、10% 验证、10% 测试。评估指标包括均方根误差(RMSE)、平均绝对误差(MAE)、平均绝对百分比误差(MAPE)和相对绝对误差(RAE)。不同指标对低值和极值的重视不同,排名可能变化。
区域占用预测比较了直接沿用最近值、AR、ARIMA、全连接网络、LSTM、图模型及两种较新的时间序列模型。原论文表 3 的四个预测长度为 3、6、9、12 小时,下面列出跨长度平均结果;占用比例的误差均还原到 0–1 尺度。
| 模型 | 平均 RMSE | 平均 MAE | 平均 MAPE |
|---|---|---|---|
| 最近值 LO | 0.1309 | 0.0783 | 43.02% |
| LSTM | 0.1028 | 0.0679 | 43.99% |
| GCN-LSTM | 0.0953 | 0.0658 | 43.59% |
| TimesNet | 0.0954 | 0.0599 | 35.20% |
| TimeXer | 0.0924 | 0.0561 | 32.74% |
例如,TimeXer 的平均 MAE 为 0.0561,表示占用比例的绝对误差约 5.61 个百分点,不是总体预测准确率为 94.39%。它相对 LO 改善了表中这些平均指标,但短期 MAPE 上,LO 的 3 小时结果 25.39% 仍低于 TimeXer 的 26.13%。
这些结果支持数据中存在可学习的时间与空间结构,也提供统一比较任务。不过,模型能更好预测由状态规则和功率假设生成的序列,并不反过来证明估计电量已等于电表真值。
单个节点的预测,所有指标都是同一个赢家吗?
原论文表 4 比较单节点上的占用、时长与电量预测。TimeXer 的 RMSE 分别为 0.07、2.73 小时、43.66 kWh,MAE 分别为 0.05、2.04 小时、33.81 kWh,多个指标较好;时长仍应按节点累计使用量理解。
但表内存在明确反例:占用 MAPE 中 AR 为 0.11、TimeXer 为 0.29;电量 MAPE 中 LO 为 0.58、TimeXer 为 0.66。在这些小数比例指标下,值越小越好。因而,不能照搬正文对 TimeXer 在所有指标上都最优的概括。选模型应对照实际任务的误差代价,也应核对零值附近 MAPE 的实现方式。
把天气和费用都加进去,就会预测得更好吗?
表 5 做的是预测特征组合试验:比较气压、温度、湿度、电价和服务费单独或组合加入后的表现。它并没有随机改变价格或天气,因此不是价格弹性或用户行为的因果实验。
在四个模型的平均 RMSE 上,不加外部特征为 0.0899,加入温度与电价的组合为 0.0888;五项全加则为 0.0902。改善幅度不大,也没有因此证明所有模型都受益。具体到 TimeXer,不加特征的 RMSE 为 0.0795,全加为 0.0863,反而变差。
这也提醒我们,表 3 与表 5 的基线数值并不完全相同,不能未经实验设置核对,就拿其中一行拼成新的统一排行榜。没有误差区间与重复运行的完整信息时,细小差别应作为该设置下的结果描述,而不是某种特征永远有用的结论。
作者把价格组合表现较好解释为用户关注总费用,把温度影响解释为出行和充电需求变化。这些解释具有行为直觉,但预测增益本身不足以排除分时价格、日周期、季节和其他共同变化因素。
这份基准适合怎样使用?
UrbanEV 适合检验区域充电序列预测、空间邻接建模与外部特征融合。它同时提供小时和五分钟版本、区域几何、背景变量及代码;读者可以对照研究目标选择占用或使用量,而不是把所有任务统称为电网负荷预测。
有三项边界尤其实际。首先,六个月覆盖的是深圳公共平台的一段时期,并非完整全年或其他城市的分布。其次,前后向填充和相邻均值替换会改变突变,预测评估应核查预处理是否跨过训练测试分界;面向实时预测时不能使用当时尚未发生的数据填补过去。最后,区域筛选移除了大量低变化和高零值单元,因此难点可能与全市新建、低利用率站点不同。
一句话总结
UrbanEV 为城市充电预测提供了丰富且可复用的共同基准,而占用、累计使用与估计电量的区别,决定了预测结果究竟能服务什么问题。
核心来源
- Li, H., Qu, H., Tan, X., You, L., Zhu, R., & Fan, W. (2025). UrbanEV: An Open Benchmark Dataset for Urban Electric Vehicle Charging Demand Prediction. Scientific Data, 12, 523. DOI: 10.1038/s41597-025-04874-4。两张完整主图与表内比较数值均来自该论文。
- Dryad 数据及作者仓库说明:另核对价格单位、占用与使用量区别及替代电量文件。
作者介绍
- Han Li:共同第一作者,署名中山大学智能工程学院;贡献声明列出实验实施与结果分析。
- Haohao Qu:共同第一作者,署名香港理工大学计算学系;参与研究构思与结果分析。
- Xiaojun Tan:署名中山大学智能工程学院,参与论文审阅与编辑。
- Linlin You:通讯作者,署名中山大学智能工程学院,参与研究构思。
- Rui Zhu:署名新加坡科技研究局高性能计算研究所,参与论文审阅与编辑。
- Wenqi Fan:署名香港理工大学计算学系,为本文共同作者;论文未单独列出其具体实验分工。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
同一座充电站可能同时出现两个看似矛盾的情况:司机觉得没有位置,而电网测得的功率并不高。因为不可用的桩不一定都在高功率充电,单纯提高电量预测精度,也未必解决寻找空桩的问题。
后续可以分别验证三个目标:到站时有没有可用位置,接下来会累计多少使用时间,以及电表实际会增加多少电量。再观察同一个模型是否在三个目标上都稳定。如果仅在额定功率推算的序列上表现好,就应把贡献表述为该代理序列的预测改善,而不要提前承诺解决排队或电网峰值。