六辆电车和公交装上传感器,覆盖到的居民就会更像整座城市吗?
论文名片|Petar Koljenšić、Titus Venverloo、Ruben Vrijhoef、Fábio Duarte、Carlo Ratti,Optimizing environmental sensing on public transport to cover broader demographics in Amsterdam,Scientific Reports,2026年11月2日在线发表(Article in Press);收稿日期2026年2月6日,接收日期2026年10月19日。DOI:10.1038/s41598-026-77183-4。
阿姆斯特丹用六台固定仪器监测细颗粒物(PM2.5,直径不超过2.5微米的颗粒物)。人若住在离仪器五十米以外的百米格子里,这台仪器在本文的规则下就没有直接覆盖这户人家。地面上每天还有几百辆有轨电车和公交车在跑。若只给六辆车装上同样规则的移动传感器,被扫到的居住地会不会既更多,人口结构也更接近全市?
会多覆盖很多按居住地计算的居民,按公平挑车也能把结构拉近全市。这里的公平只比较居住人口的年龄、移民背景和房屋估值,不测量污染物,也不追踪人白天待在哪里。
先说结论
- 六台固定PM2.5传感器在50米范围内只碰到13个百米人口格子,覆盖荷兰统计局网格中的870,375人的0.2%。被覆盖人口与全市构成的标准化欧氏距离是0.53。
- 若把观测日全部276辆地面公交都算上,可碰到2,953/6,906个格子、46.6%的居民,距离降到0.28。再观测整整一周,人口覆盖只升到48.5%。
- 同样六辆车,空间挑法一天覆盖28.5%的居民,时间挑法只有2.6%,公平挑法是17.6%。公平挑法的距离是0.06,时间挑法是0.54,且被覆盖人口中非西方移民背景占47.7%,全市这一比例是36.2%。
- 一周内随机抽六辆、重复30次,平均覆盖约29.3%的居民,平均距离0.33,单次可从0.19到0.54。公平挑法更接近全市结构,覆盖的居民少于这次随机平均,也少于空间挑法。
- 格子被碰到一次,还不等于采样够密。公平挑法的六辆车,在某小时至少有一次记录的格子中,41%达到每小时至少12次;5月21日13:00–14:00这一小时是199/360。
六个固定监测点,五十米以外算不算被测到?
比较的起点是同一条空间规则。阿姆斯特丹市界内的人口被放进100米×100米格子,资料来自荷兰统计局(CBS)2021年的网格,含人数、年龄、移民背景,以及每格平均房屋估值。房屋估值用的是荷兰市政房产估值(WOZ-waarde),正文以千欧元计。研究范围不含2022年并入的Weesp。
固定监测点有六台。每台周围画一个50米缓冲区,缓冲区碰到的格子算被直接测到。六台一共只碰到13个格子,其中一台落在没有人口统计的格子上。13个格子里的居民合计占870,375人的0.2%。各年龄组和各移民背景组被覆盖的比例,都只占该组全市人口的0.1%到0.2%。
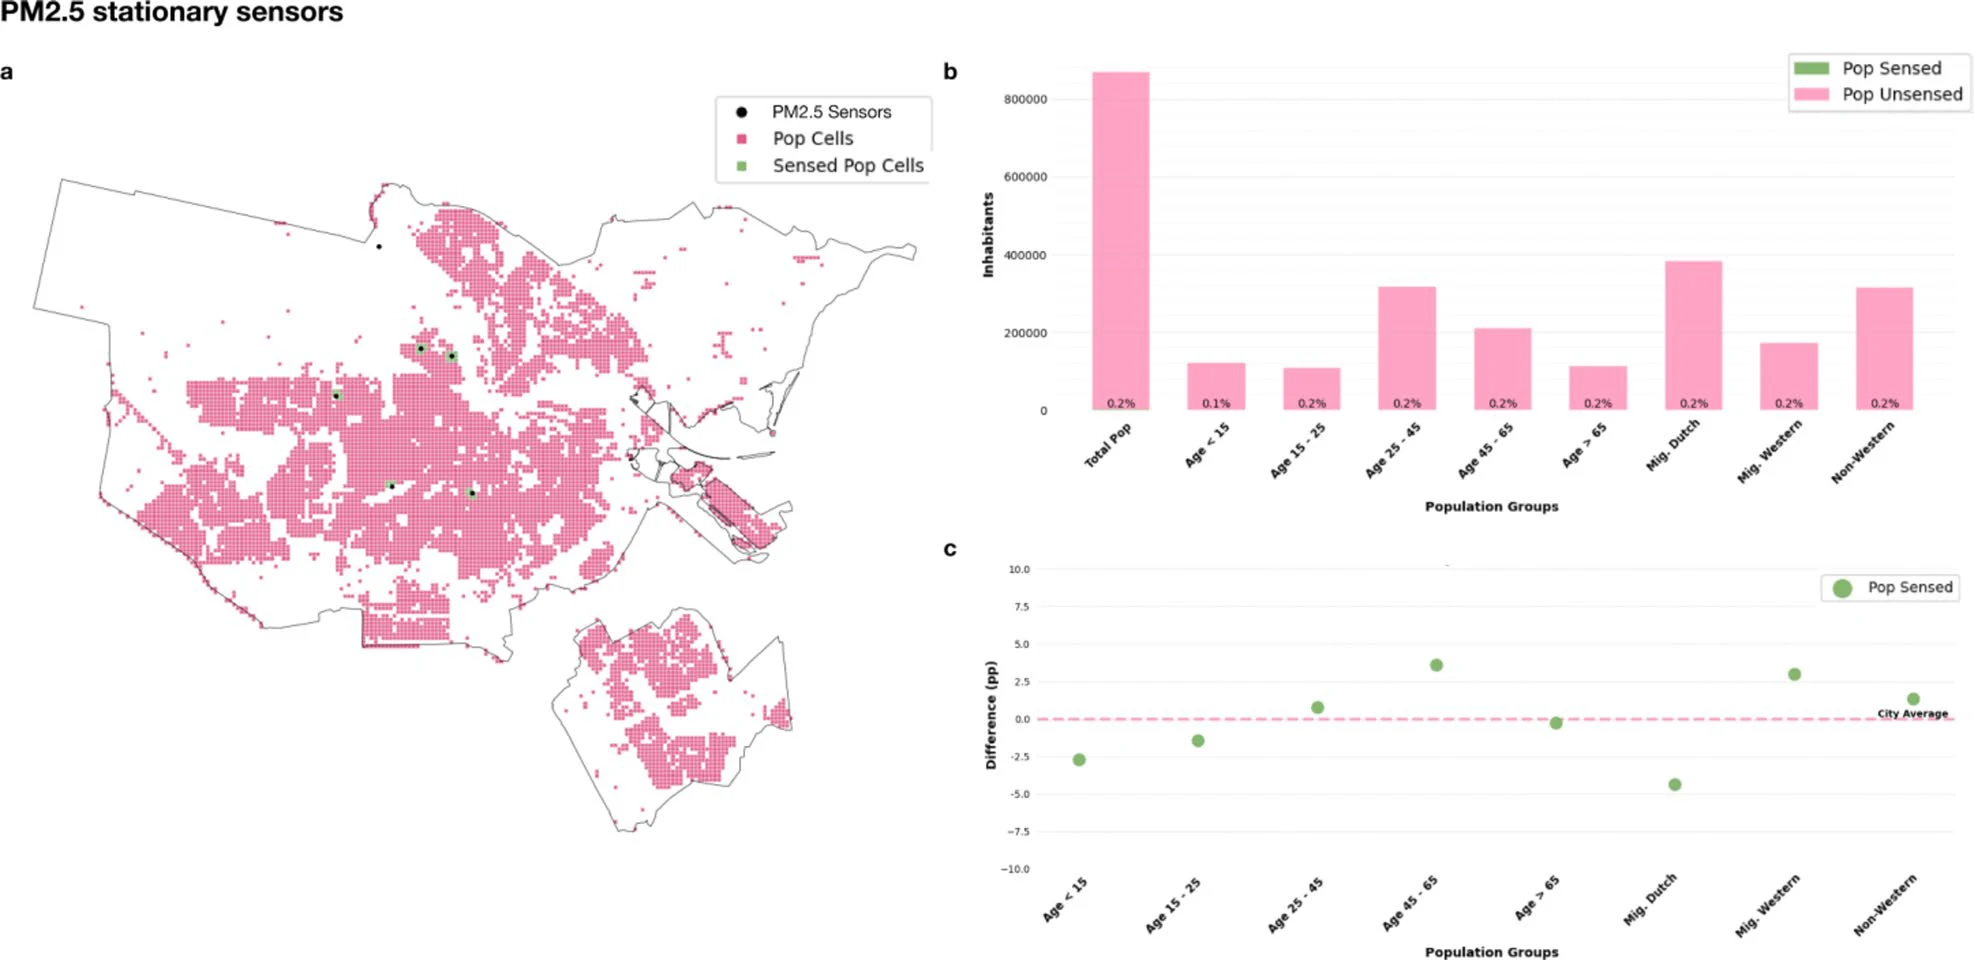
图 1|六台固定细颗粒物传感器,在50米内碰到哪些居住格子?
(a)市界内的100米人口网格。黑点是六台PM2.5传感器,粉色是有人口的格子,绿色是落进任一传感器50米范围的格子。被覆盖的绿色格子只有13个,其中一台传感器落在没有人口统计的位置。(b)各年龄、移民背景组的人数,绿色为被覆盖、粉色为未覆盖。纵轴是人数,各组被覆盖比例都极低;合计为全市人口的0.2%,分母是870,375。(c)被覆盖人口的构成减去全市构成,纵轴是百分点。荷兰背景居民低5个百分点,西方移民背景高2.5个百分点,非西方移民背景高1.5个百分点;45–65岁高3.5个百分点,0–15岁和15–25岁略低,25–45岁与65岁及以上接近全市。被覆盖格子的平均房屋估值是465,全市是469。来源:原论文 Fig. 1。
构成差再用一个综合数概括。标准化欧氏距离把年龄份额、移民背景份额和平均房屋估值放在一起:每一项先除以它在有人口格子上的方差,避免房屋估值的欧元数压过百分比;年龄和移民背景各去掉一个参照类,因为各类加总为100%,参照类选的是65岁及以上和非西方移民背景。距离为0表示与全市完全一致。六台固定传感器的距离是0.53。这个数只说明被50米碰到的居住人口和全市不一样,不能说明这些格子的空气更差,也不能说明某一人群的健康风险更高。论文没有报告任何污染物浓度。
全市电车和公交都装上,能多覆盖多少居住地?
移动传感用的是同一条50米规则,只是圆心换成车辆位置。位置来自荷兰公共交通实时数据(GTFS Realtime),约每60秒一个点,再线性插值到5秒,并吸附到同方式的线路上。研究只保留地面运行、因此适合沿街环境传感的有轨电车和公交车,线路类型分别为0和3;地铁和渡轮不进入分析。运营方只保留阿姆斯特丹主要运营商GVB。有轨电车15条线,公交车44条线,其中日间23条、高峰7条、夜班11条。
案例周是2025年5月19日星期一到5月26日星期一,避开公共假期和学校假期。24小时窗口从5月21日星期三05:30算起,因为多数日间线路在这个时刻前后开始,而且这一天没有特殊时刻表。全周有54条不同线路,这一个昼夜有45条。一周里任一24小时平均有267辆车在运行,最少是5月25日星期日的222辆,最多是5月20日星期二的285辆;5月21日当天是276辆。
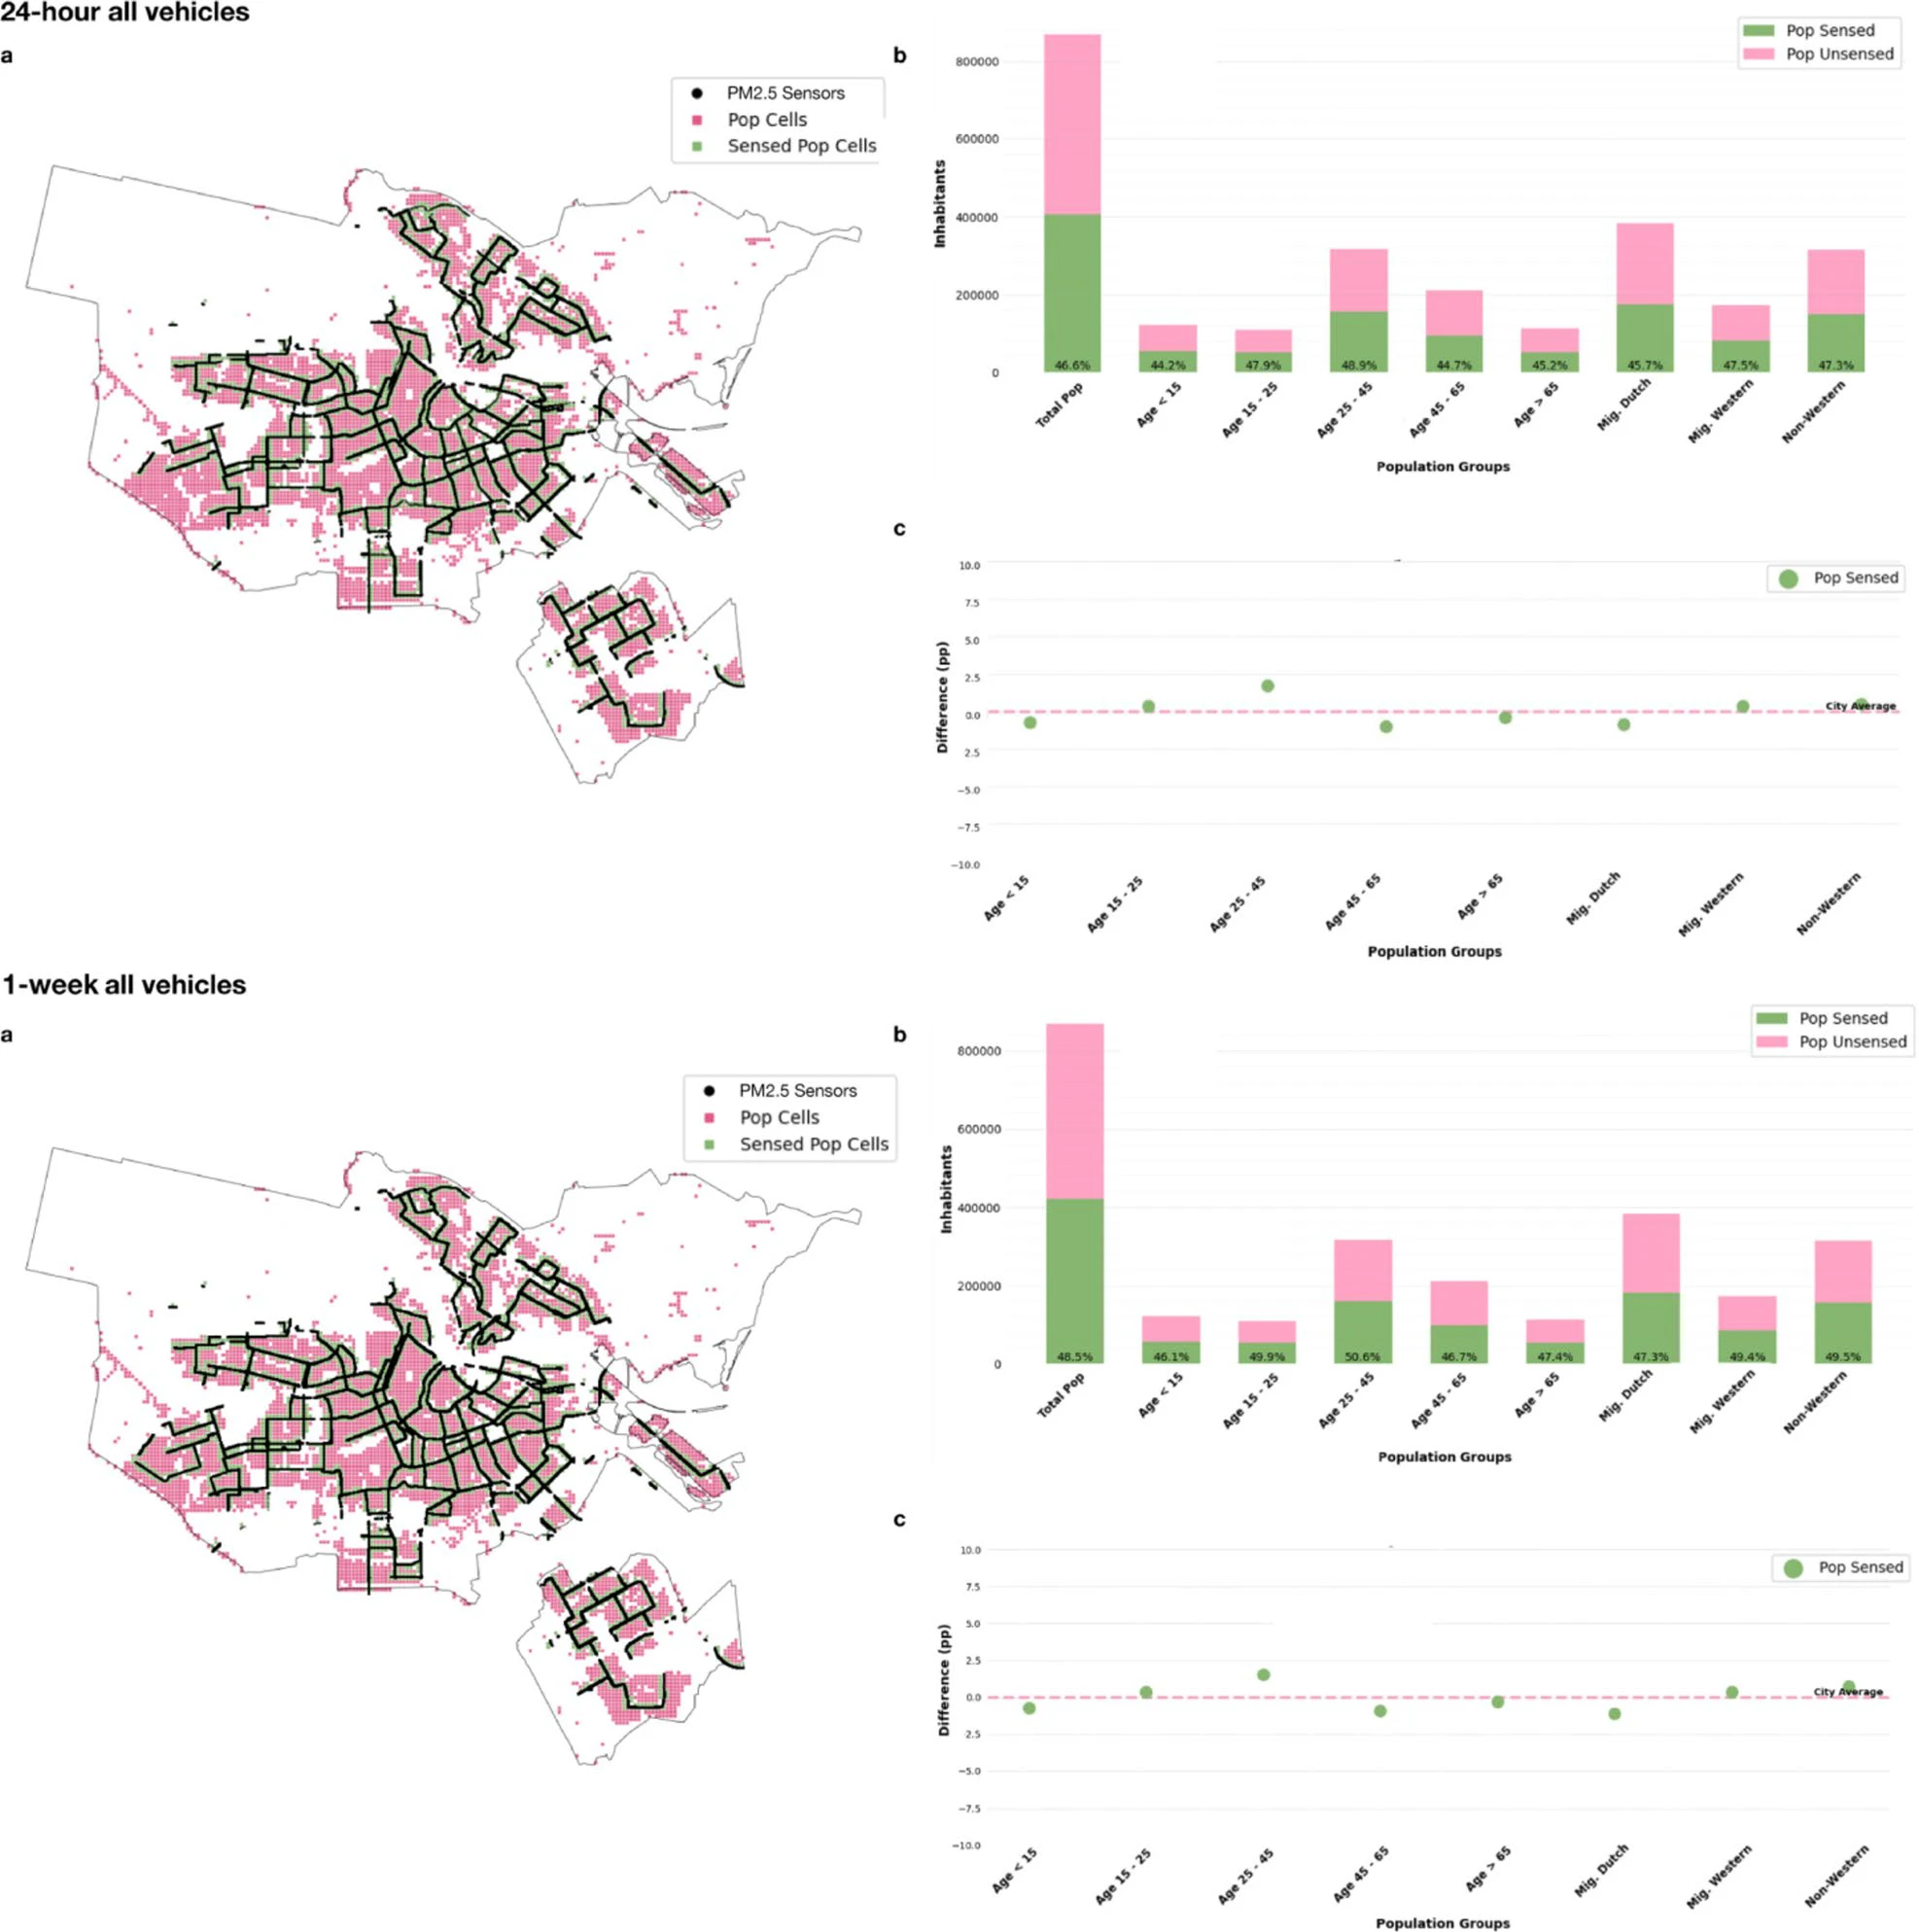
图 2|若全部地面公交都带传感器,24小时和一周分别碰到哪里?
上排是5月21日起的24小时,下排是5月19日起的一周。两排都标有(a)(b)(c)。(a)粉色是有人口的格子,绿色是任一车辆位置50米内被碰到的格子。24小时的绿色格子有2,953个,占6,906个格子的42.7%;一周增到3,083个。绿色贴着线路,走廊之间和部分市中心仍是未被碰到的粉色格子。(b)各组全市人数与被覆盖人数,绿色为被覆盖、粉色为未覆盖。24小时覆盖46.6%的居民;荷兰背景、西方移民背景、非西方移民背景居民中,分别有45.2%、47.5%、47.3%住在被碰到的格子里。一周的人口覆盖是48.5%。(c)被覆盖人口构成与全市的百分点差,24小时大多落在±2个百分点以内,标准化欧氏距离0.28;一周的累计距离升到0.32。房屋估值分别为450和455,全市都是469。来源:原论文 Fig. 2。
一周只比一天多出有限的新格子。人口覆盖从46.6%到48.5%,增加1.9个百分点;格子覆盖从42.7%增到3,083/6,906,约44.6%,也大约多1.9个百分点。多出来的是一周才开行的线路,以及偏离计划轨迹的零星位移。累计距离反而从0.28升到0.32,因为同一格子被反复经过时,公平指标会把那里的居民多次计入。每个格子只计一次时,距离从0.204降到0.196。后文的优化沿用累计口径。
全部车辆装传感器给出的是覆盖上限。地面公交网本身能碰到不到一半的居住人口,多观察几天也留着线路之间的空白。讨论指出,历史中心有一段明显测不到的区域,因为线路主要走主要走廊。25–45岁居民因住得离线路近而略多被覆盖,15岁以下略少;这是方向性描述,一周全部车辆的逐组百分点列在补充表。
只给六辆车时,三种挑法各自牺牲什么?
六这个数量来自固定PM2.5传感器的台数,用来对照,不是算出来的最优车数。候选车在24小时分析中是当天全部276辆。一周的三种优化共用215辆至少运行六天的车,以便每天都有可比的班次;因此36.7%的车辆被排除在这组对照之外。描述性的一周全车队基线仍用至少出现过一次的340辆,和215辆的优化池是两套名单。
空间挑法要让独特格子尽量多。贪心做法是先拿覆盖格子最多的车,之后每一步加入能带来最多新格子的车。频率挑法要让已覆盖格子上的平均测量次数尽量高:先选平均次数最高的车,再优先加同一条线路上的车,使次数堆在原有格子里,而不是去开辟新格子。公平挑法要让累计的人口构成尽量接近全市,也就是让上面的标准化欧氏距离最小。它从距离全市最近的一辆开始,逐辆加入后重算合并后的群体比例。三种方法都是启发式,论文没有用精确求解器证明所选子集是全局最优。
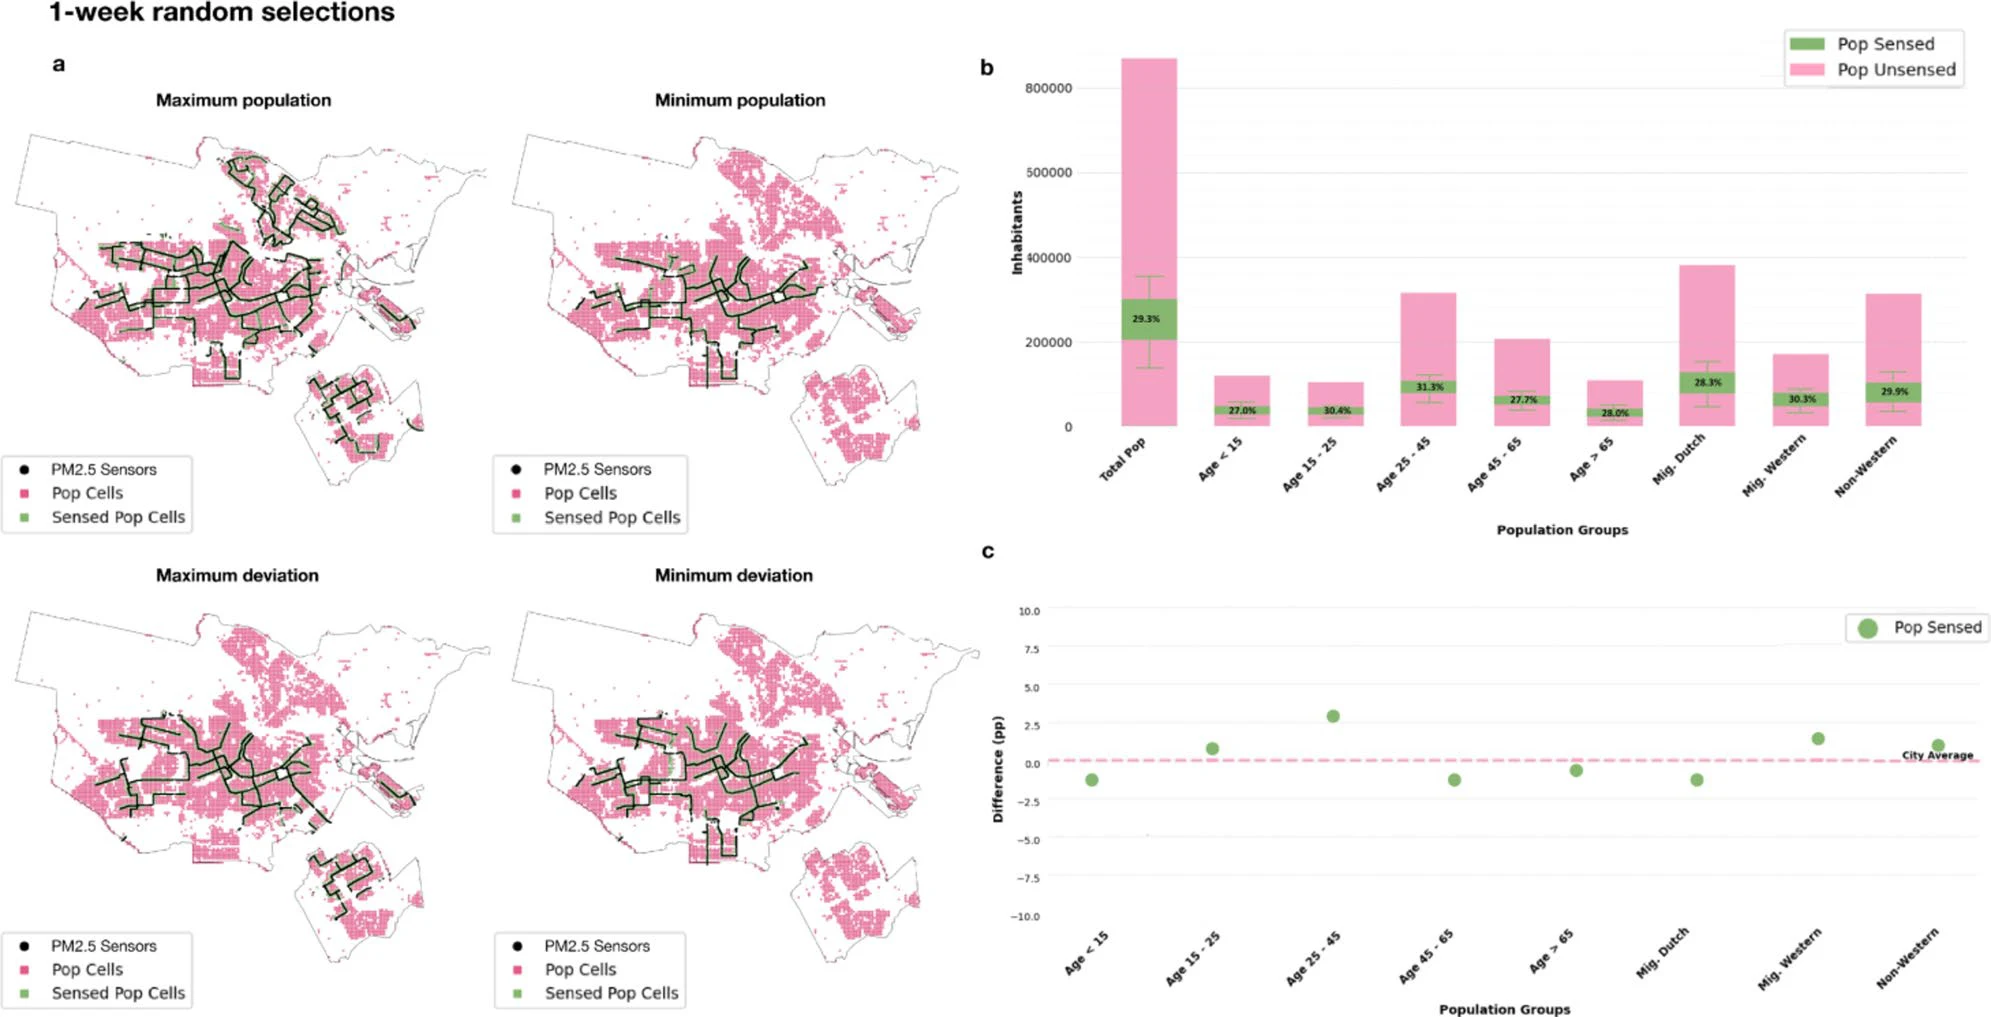
图 3|一周里随机挑六辆,覆盖和结构会散到多宽?
(a)上排是30次随机里人口覆盖最多和最少的两次,下排是欧氏距离最大和最小的两次。粉色是人口格子,绿色是被六辆车碰到的格子。独特格子的全距是1,084到2,388。(b)30次部署的人口覆盖箱线图,包含全体居民和各分组;平均约29.3%的居民、1,797个格子。(c)30次平均后的构成偏差。平均距离0.33,单次从0.19到0.54;平均房屋估值439,全市469。来源:原论文 Fig. 3。
随机结果说明,六辆车本身就有相当大的空间能力,但抽到哪几辆会明显改变代表性。距离0.54已经和六台固定传感器的0.53同级。因此后面优化的意义,是把这种抽签变成按目标挑选。
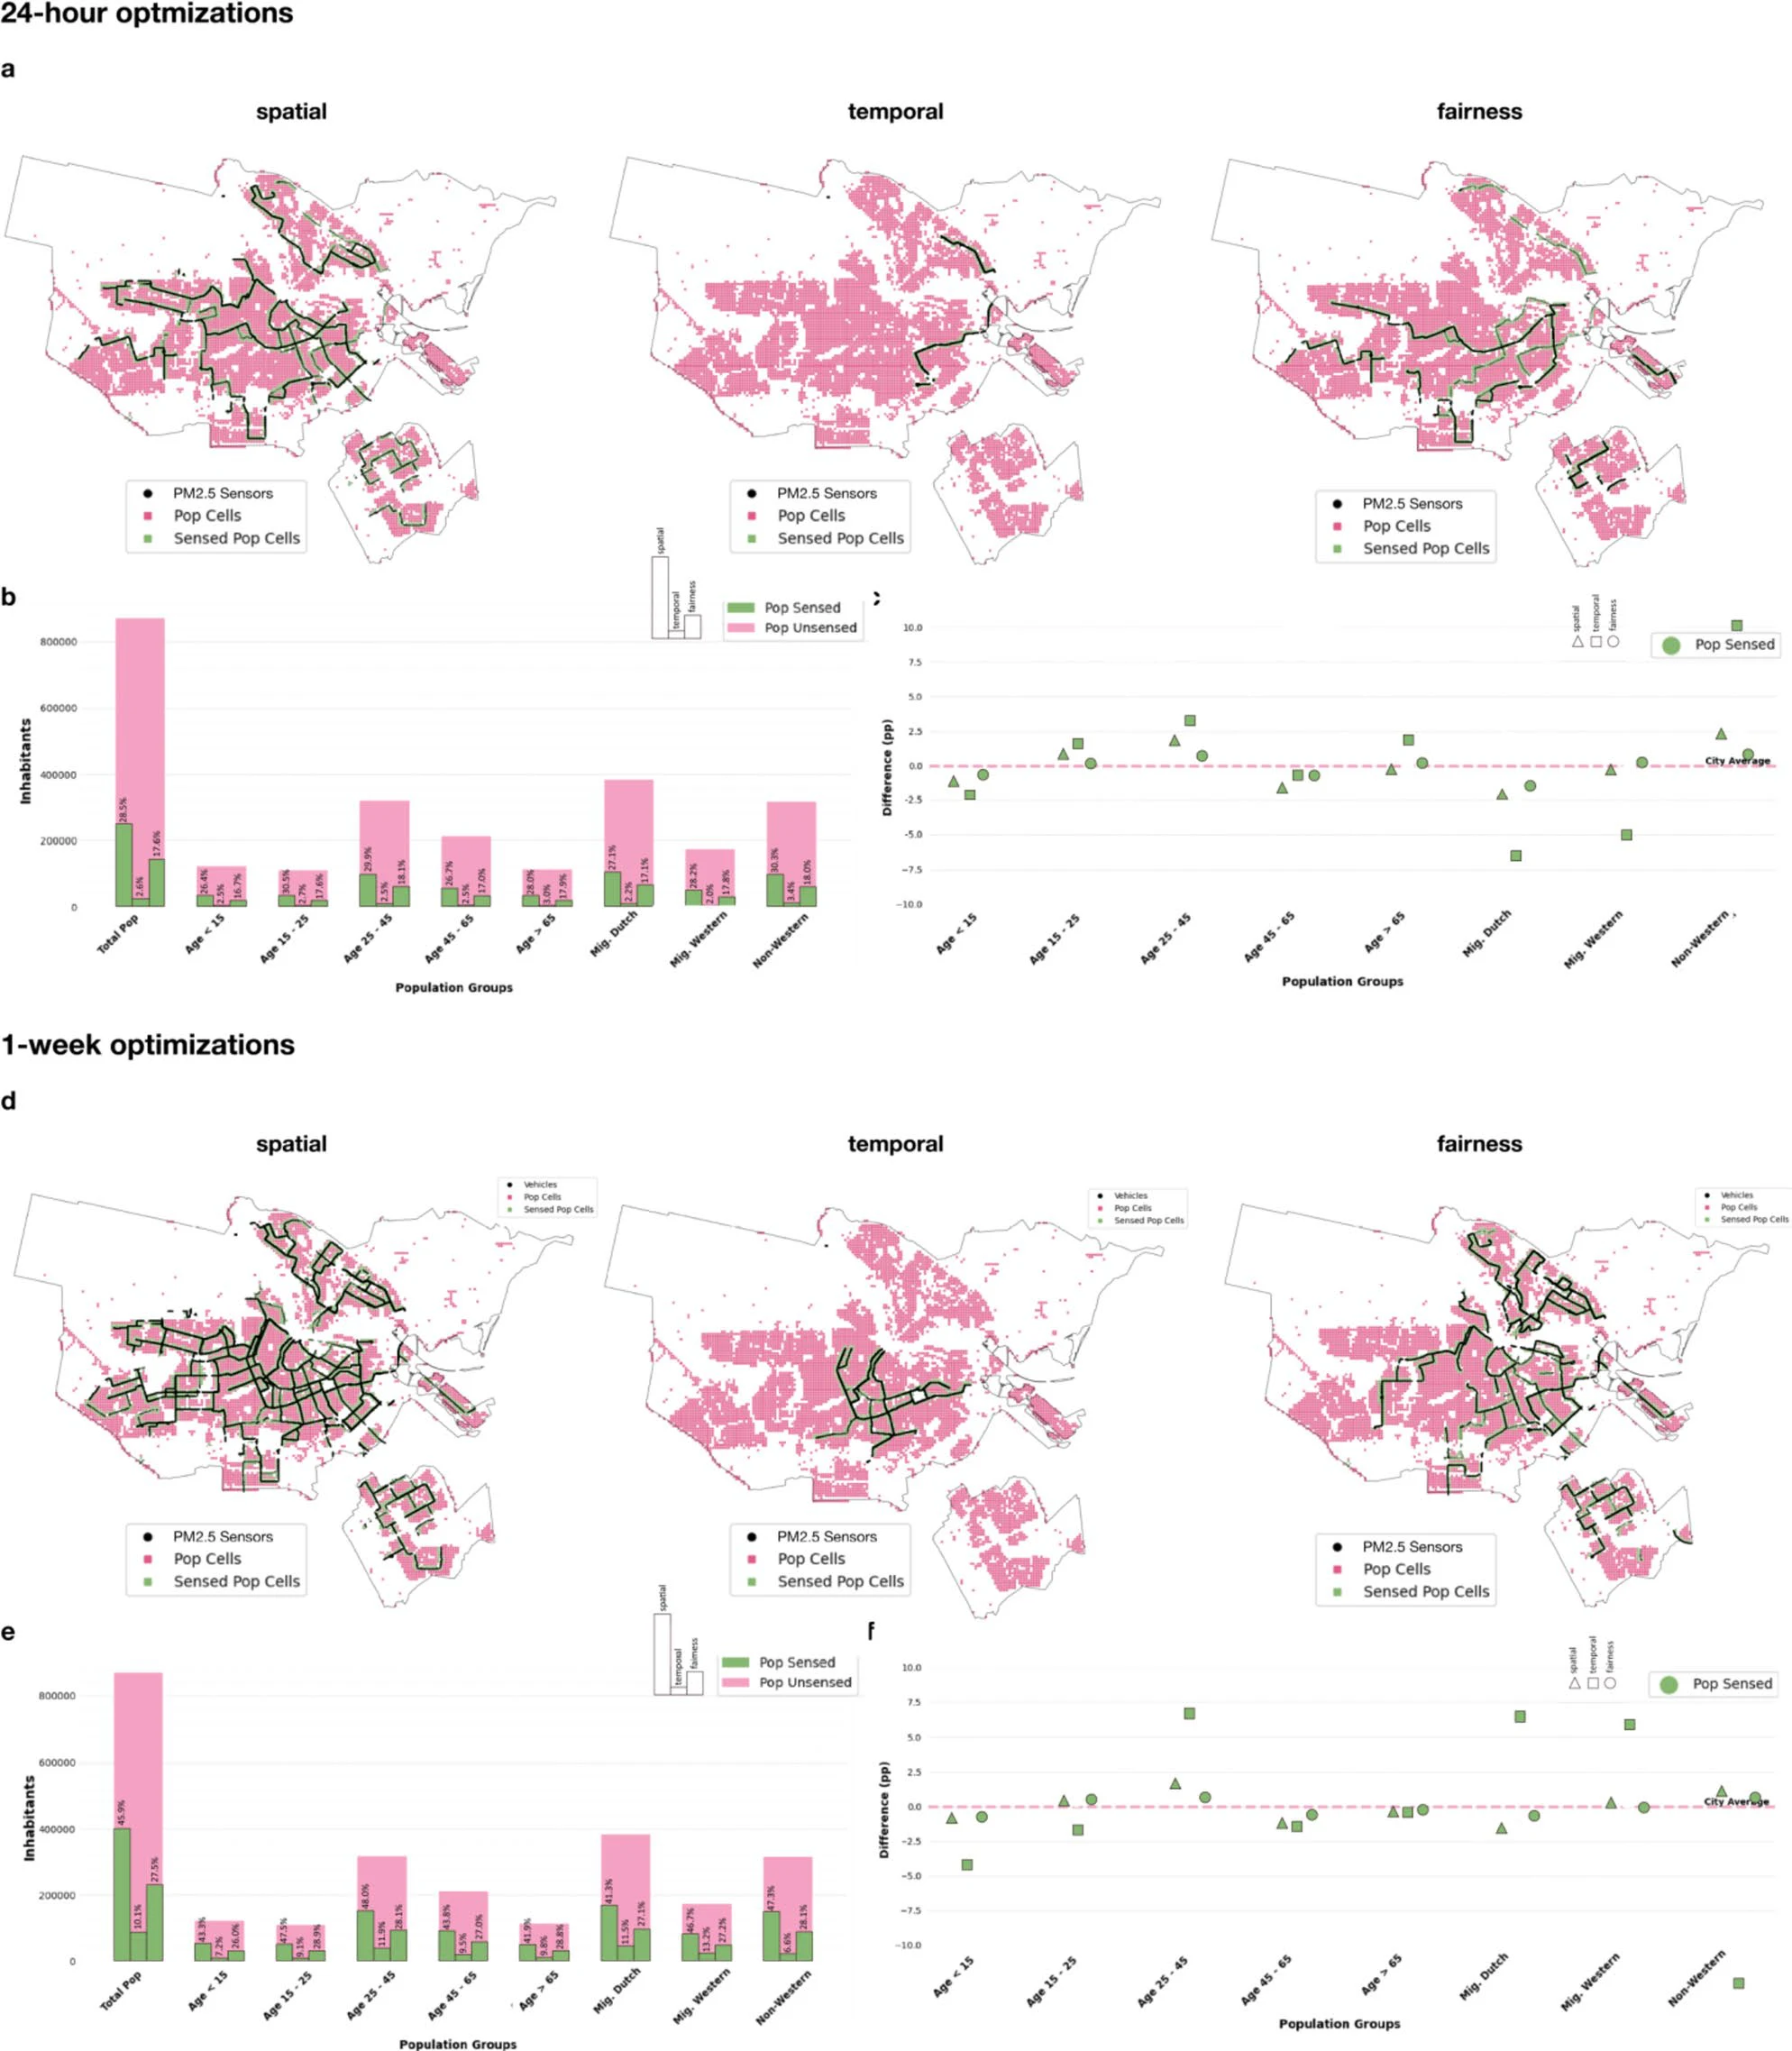
图 4|六辆车按空间、时间、公平三种目标挑,一天和一周分别得到什么?
(a)5月21日05:30起的24小时。粉色是人口格子,绿色是50米内被碰到的格子:空间挑法的绿色铺得最开,时间挑法挤在少数线路,公平挑法介于二者之间。(b)这一天各组的覆盖人数,绿色为被覆盖、粉色为未覆盖。空间挑法1,807格、28.5%的居民;时间挑法150格、2.6%;公平挑法1,062格、17.6%。(c)这一天的构成偏差。公平挑法距离0.06,各组偏差在±2个百分点以内,房屋估值461,全市469。时间挑法距离0.54,被覆盖人口里非西方移民背景占47.7%,全市是36.2%。(d–f)5月19日05:30起的一周,面板顺序与上排对应。空间挑法2,865格、45.8%的居民,距离0.30;时间挑法533格、10.1%,距离0.88,非西方移民背景仍是47.7%对全市36.2%;公平挑法1,812格、26.2%,距离0.08,房屋估值454对469。来源:原论文 Fig. 4。
空间挑法更常选到公交车,因为公交车更可能换线。24小时选中的车跨9条线路,一周跨38条。它在一天里覆盖28.5%的居民,相当于全车队46.6%的约六成;论文称之为大约三分之二。一周则接近全网能碰到的格子。时间挑法在24小时只留在一条公交线路上,一周只留在四条有轨电车线路上,所以次数高、空白大,结构也偏。公平挑法一天跨8条线、一周跨19条线,用低于随机平均值的人口覆盖,换来小得多的结构距离。
表1把六辆车的三种挑法、30次随机平均和全车队放在同一张表里。人口覆盖的分母是相应城市网格中的居民;阿姆斯特丹固定传感器那段明确写出870,375,移动传感的百分比没有再次写出这个整数。
| 方案 | 独特格子(24小时 / 一周) | 人口覆盖 | 表中的平均次数 | 标准化欧氏距离 | 总测量次数 |
|---|---|---|---|---|---|
| 空间,6辆 | 1,807 / 2,865 | 28.5% / 45.8% | 28 / 17 | 0.31 / 0.30 | 51,182 / 341,666 |
| 时间,6辆 | 150 / 533 | 2.6% / 10.1% | 391 / 111 | 0.54 / 0.88 | 58,602 / 414,848 |
| 公平,6辆 | 1,062 / 1,812 | 17.6% / 26.2% | 28 / 18 | 0.06 / 0.08 | 30,210 / 231,552 |
| 随机,6辆,30次平均 | — / 1,797 | — / 29.3% | — / 22 | — / 0.33 | — / 263,882 |
| 全部车辆,276 / 340 | 2,953 / 3,083 | 46.6% / 48.5% | 741 / 723 | 0.28 / 0.32 | 2,187,131 / 15,683,825 |
表头把平均次数写成每格每小时。用总测量次数除以独特格子数,24小时一列正好落到28、391、28和741附近,所以这一列是全天每格次数。一周一列再除以7天,空间、时间和公平三行约为17.0、111.2和18.3,与表中的17、111、18一致,因此更接近每天每格次数。随机的22和全车队的723不能用同一除法精确还原,正文没有给出它们的平均公式。读这张表时,高次数表示反复经过少数格子,不表示每小时都有那么多次。
17.6%和28.5%这类人口覆盖,来自独特格子的并集:一个居民住在被碰到的格子里,就计一次。0.06和0.08的距离则是优化时使用的累计口径,同一格子被多辆车覆盖,里面的居民会重复进入结构比较。两套数字回答两件不同的事。
车再增加,三件事会不会一起变好?
单车差异很大,所以挑选有空间。5月21日的276辆车里,空间覆盖最高的一辆碰到547个格子,最低的只有3个。时间密度最高的一辆全天只跑一条公交线,在54个格子上留下7,178次记录,平均每格133次;最低的一辆每格只有2次。最接近全市的单车距离是0.32,通常是连接城市两侧的长放射线,或一天之内换过线的车。最偏离的一辆超过3.82,覆盖集中在人口结构失衡的地段,例如只在港口区域运行的公交。车队平均是每车1.56条线路、7,924次记录、185个格子、每格50次;50次是各车自身比值的平均,不是7,924除以185。
换线是GVB的日常调度,不是异常。24小时内,20%的车跑两条线,2%跑三条。一周340辆里,79%至少换过一次线;论文接着写63%服务三条线、46%服务四条,另有一辆覆盖十条。后两个比例与79%叠在一起会超过100%,因此不是互斥分组。
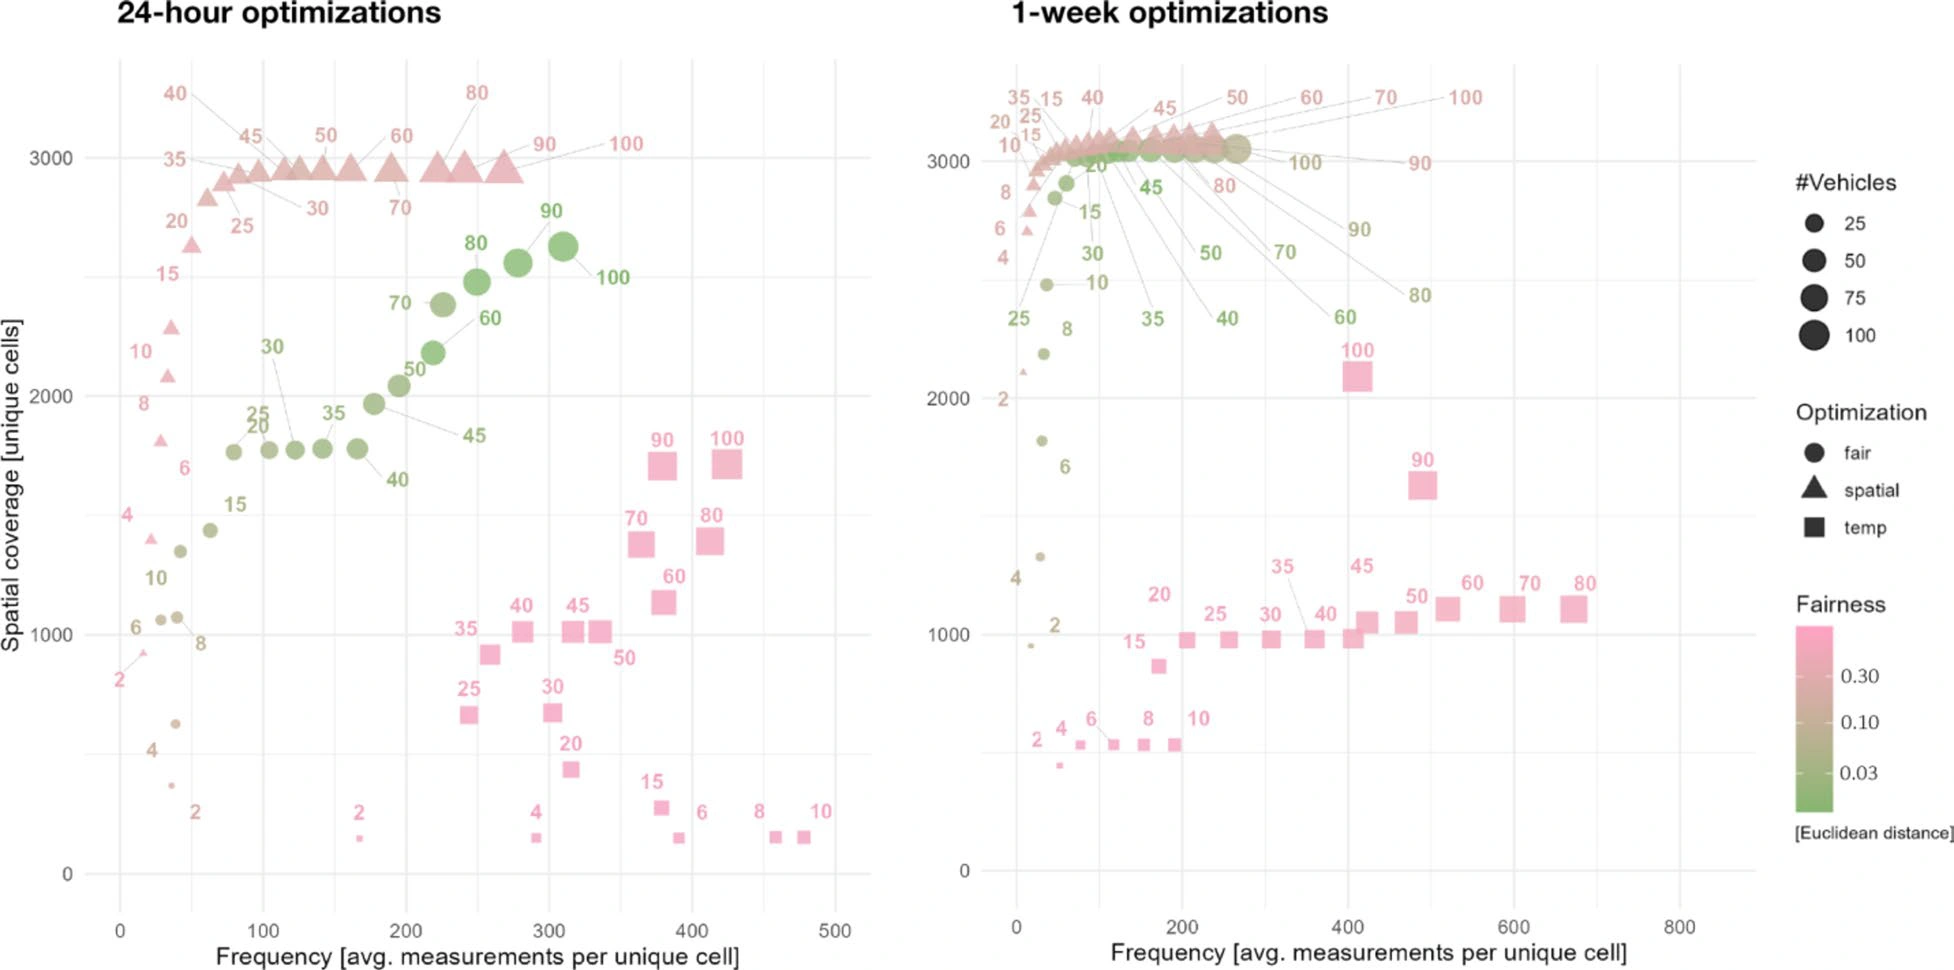
图 5|车辆从2辆加到100辆,覆盖、次数和结构距离怎样一起移动?
左为24小时,右为一周。纵轴是独特格子,横轴是该时段内平均每格测量次数,颜色是欧氏距离,粉色约0.30、绿色约0.03,越绿越接近全市。点的大小表示2到100辆,三角是空间挑法,方块是时间挑法,圆点是公平挑法。24小时的空间挑法在约30辆时就到2,922格,45辆时最高2,943格,之后几乎不再增加格子。时间挑法停在低覆盖、高次数一侧,10辆时每格478次。公平挑法的最低距离出现在80辆,为0.008;90辆和100辆不一定更公平。一周的空间挑法用10辆到达2,958格,50辆以后停在3,076格附近,并与公平挑法逐渐靠近。时间挑法在80辆时每格672次。公平挑法在45辆时距离降到0.03,继续加车后距离回升。来源:原论文 Fig. 5。
全车队没有画进图5。24小时276辆对应每格740.6次、2,953格、距离0.28。一周那215辆至少运行六天的车,对应每格553.6次、3,079格、距离0.27。一周公平挑法在100辆时距离可以到0.11,全部215辆反而更差,因为线路高度重叠,累计口径会反复计入同一批居民。
车数增加以后,一周的公平挑法会越来越像空间挑法。少量车时,三个目标互相让步;车够多、观察够长,把格子铺开本身就会带来比较接近全市的居住结构。这仍然是居住地覆盖,而且趋势并不严格单调。
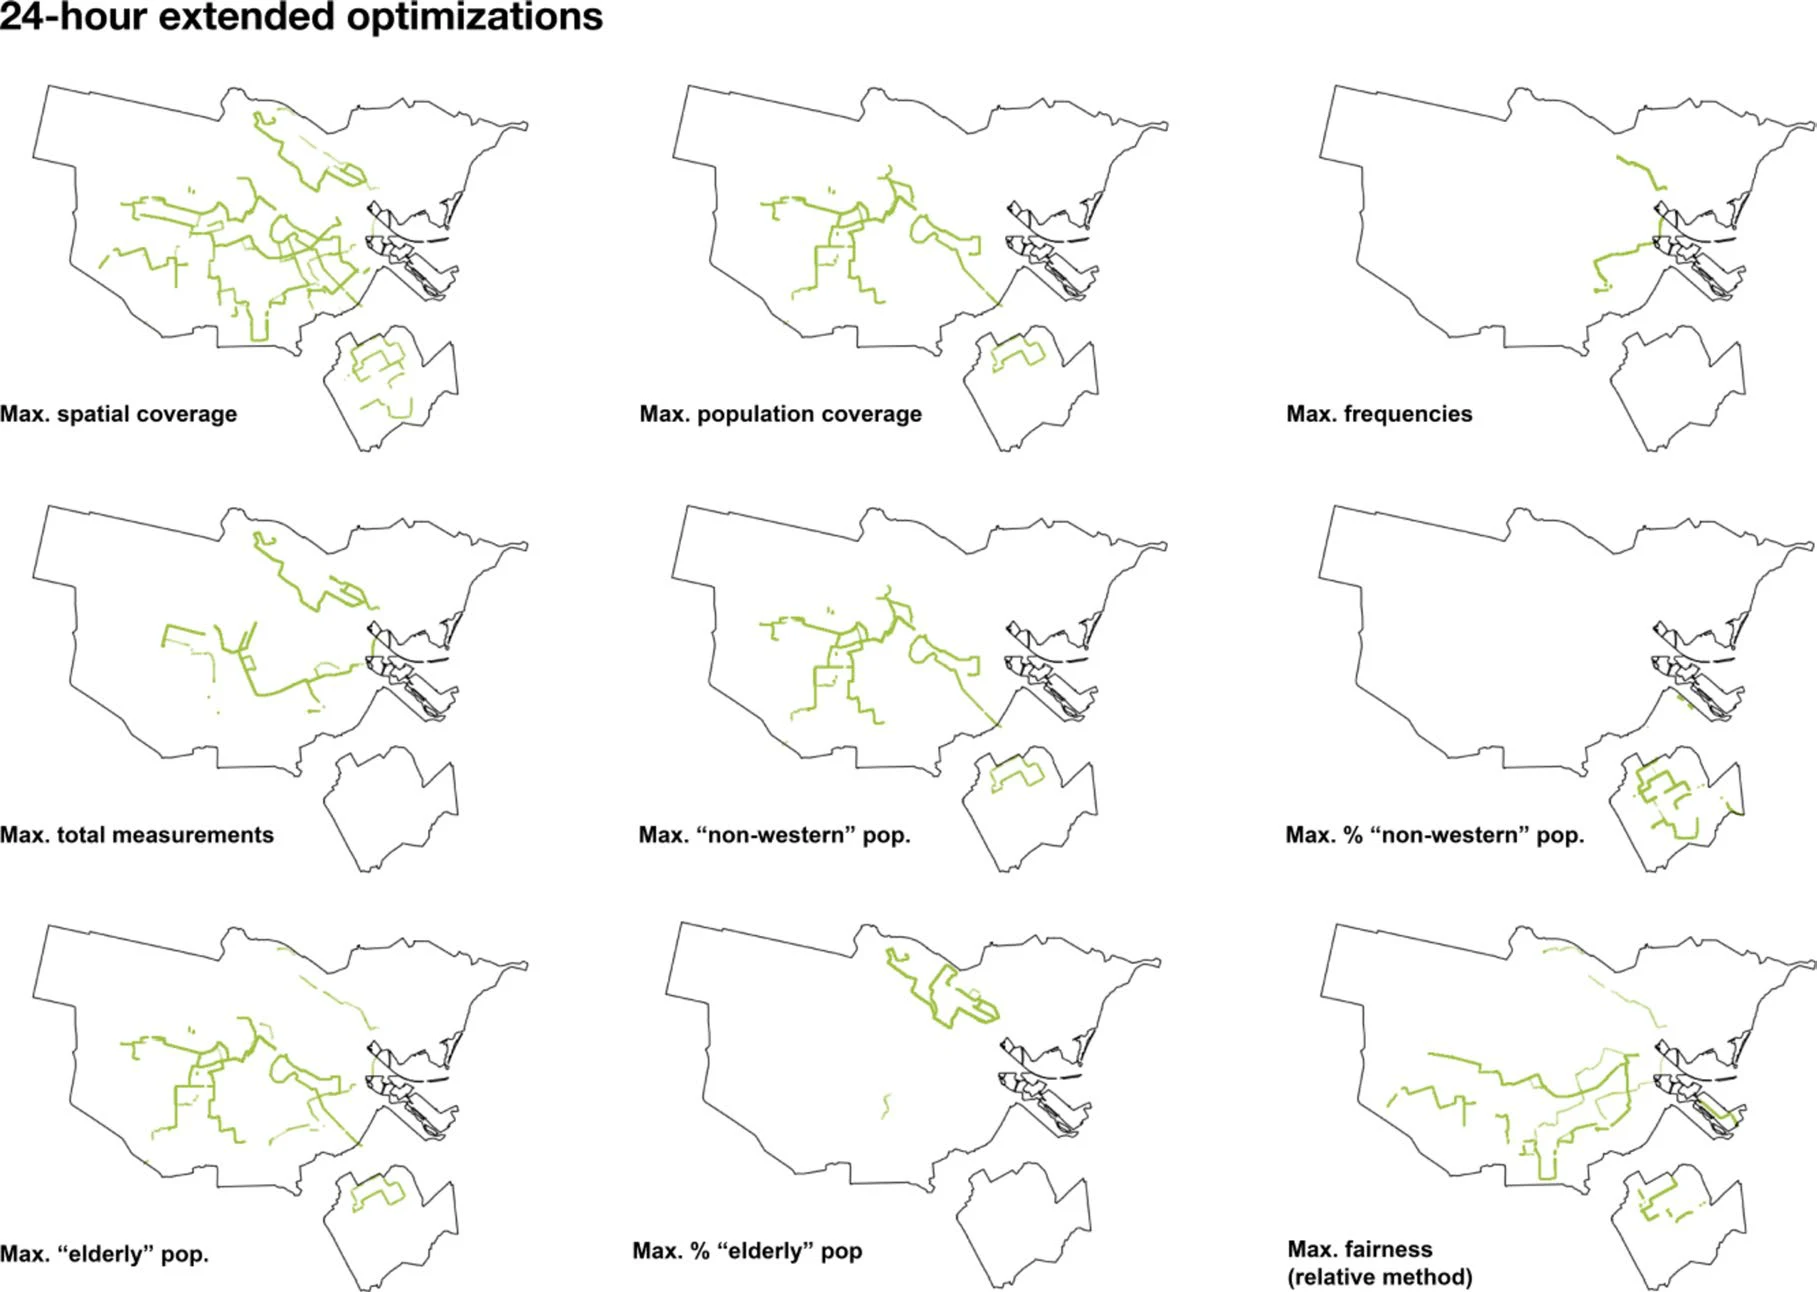
图 6|若改成尽量多覆盖某一类居民,六辆车的轨迹会集中到哪里?
图内没有子图字母。九张图都是5月21日起的24小时,绿点是被选车辆的实时位置,从左到右、从上到下依次为:最大化空间覆盖、最大化人口覆盖、最大化测量频率、最大化总测量次数、最大化非西方移民背景居民人数、最大化该群体占比、最大化老年居民人数、最大化老年居民占比、用相对法最大化公平。人数和空间目标把轨迹铺开;占比目标把非西方移民背景集中到东南,把65岁及以上集中到阿姆斯特丹北。论文给出的最高占比是非西方移民背景65.6%、65岁及以上17.4%。公平选法仍是横贯城市的长线,中心更密。一周的对应图是补充图5。来源:原论文 Fig. 6。
这两张占比地图把社会经济隔离显出来了:想提高某一群体在被测人口中的份额,车辆就会几乎整段开进该群体集中的城区。公平定义若只要求像全市平均,仍可能整片城区落在所选线路之外。作者把接下来的选择留给城市:按需要优先监测某些人群,还是按覆盖尽量碰到更多居民。本文的优化没有替这个选择做价值判断,等权只是为了不预先指定哪一个群体更重要。
格子被碰到一次,和一小时测够十二次,是同一件事吗?
前文的一次覆盖只要求时段内至少有一个50米缓冲区碰到格子。环境量若变化很快,这个定义只表示传感潜力。论文借用世界卫生组织2021年细颗粒物指南中的一条采样参照:每小时至少12次。这里比较的是位置记录的次数,车上并没有真的采气。
全车队在5月21日留下大约220万次记录,表1的精确值是2,187,131。单个格子最多约49,000次,最少1次,中位数1,317次。高值集中在中心走廊和枢纽。
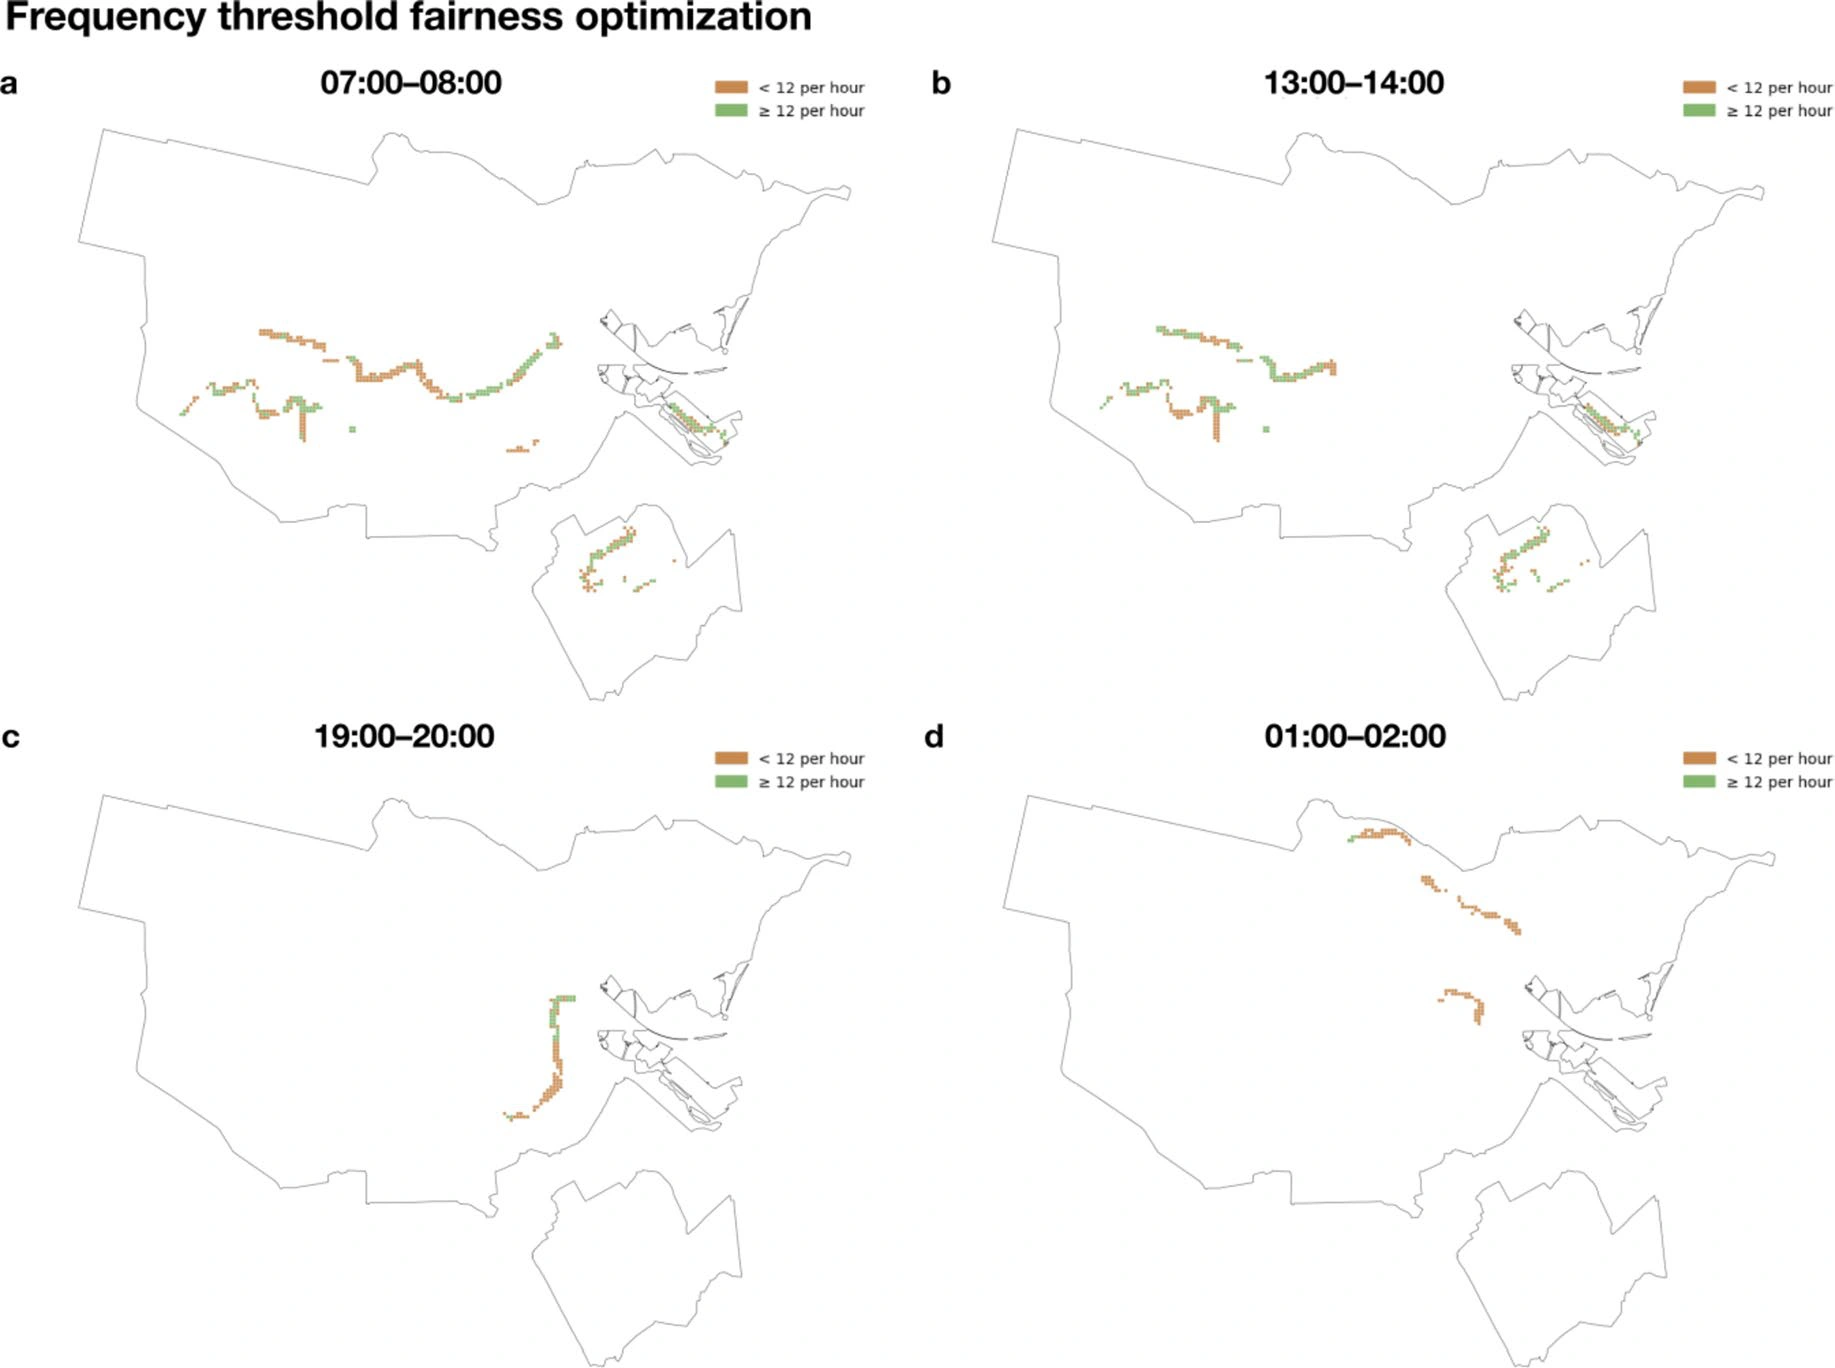
图 7|公平挑出的六辆车,四个小时里有多少格子达到每小时12次?
只画出该小时至少有一次记录的格子。橙色低于每小时12次,绿色达到或超过12次。(a)07:00–08:00,(b)13:00–14:00,(c)19:00–20:00,(d)01:00–02:00。记录高峰在13:00–14:00。凌晨1点到2点仍有夜班公交,但位置换成另一批格子,其中多数达不到12次。把所有至少被记录一次的格子–小时放在一起,41%达到阈值。各小时的格子数列在补充表6和7。来源:原论文 Fig. 7。
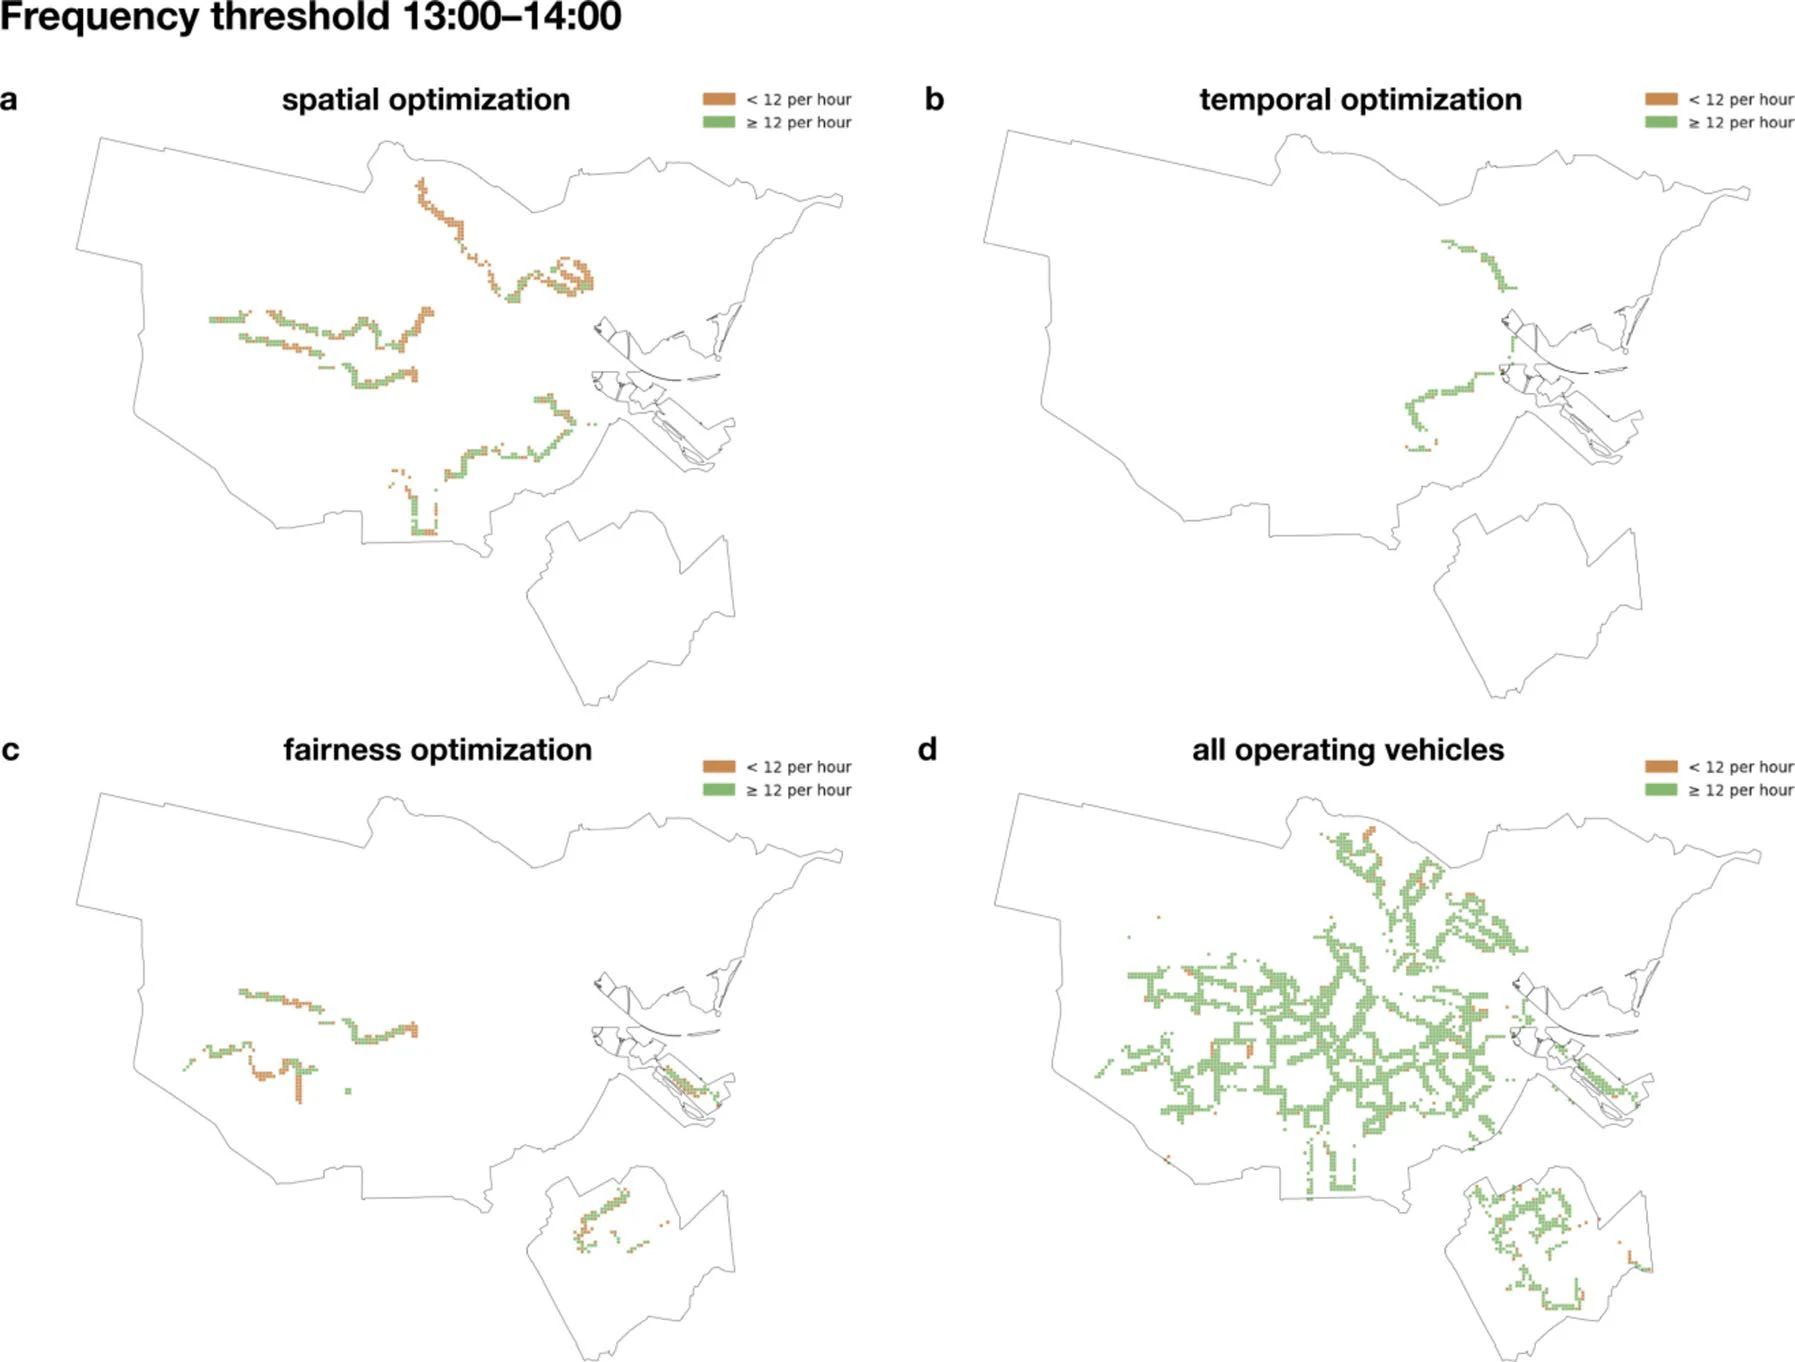
图 8|同一个下午1点到2点,四种部署各有多少格子达到12次?
颜色规则与图7相同,车辆数除(d)外都是六辆。(a)空间挑法铺开后,许多格子低于12次。(b)时间挑法的已覆盖格子几乎都达到阈值。(c)公平挑法居中,360个有记录的格子里有199个达到阈值。(d)当天全部276辆几乎让每个被碰到的格子都达到这一次数。来源:原论文 Fig. 8。
199/360只描述公平挑法在这一个小时、且至少有一次记录的格子。它不能写成全市360个格子中的比例,也不能写成全天24个小时的平均。41%的分母同样是已有记录的格子–小时,空白格子不进入这个比例。
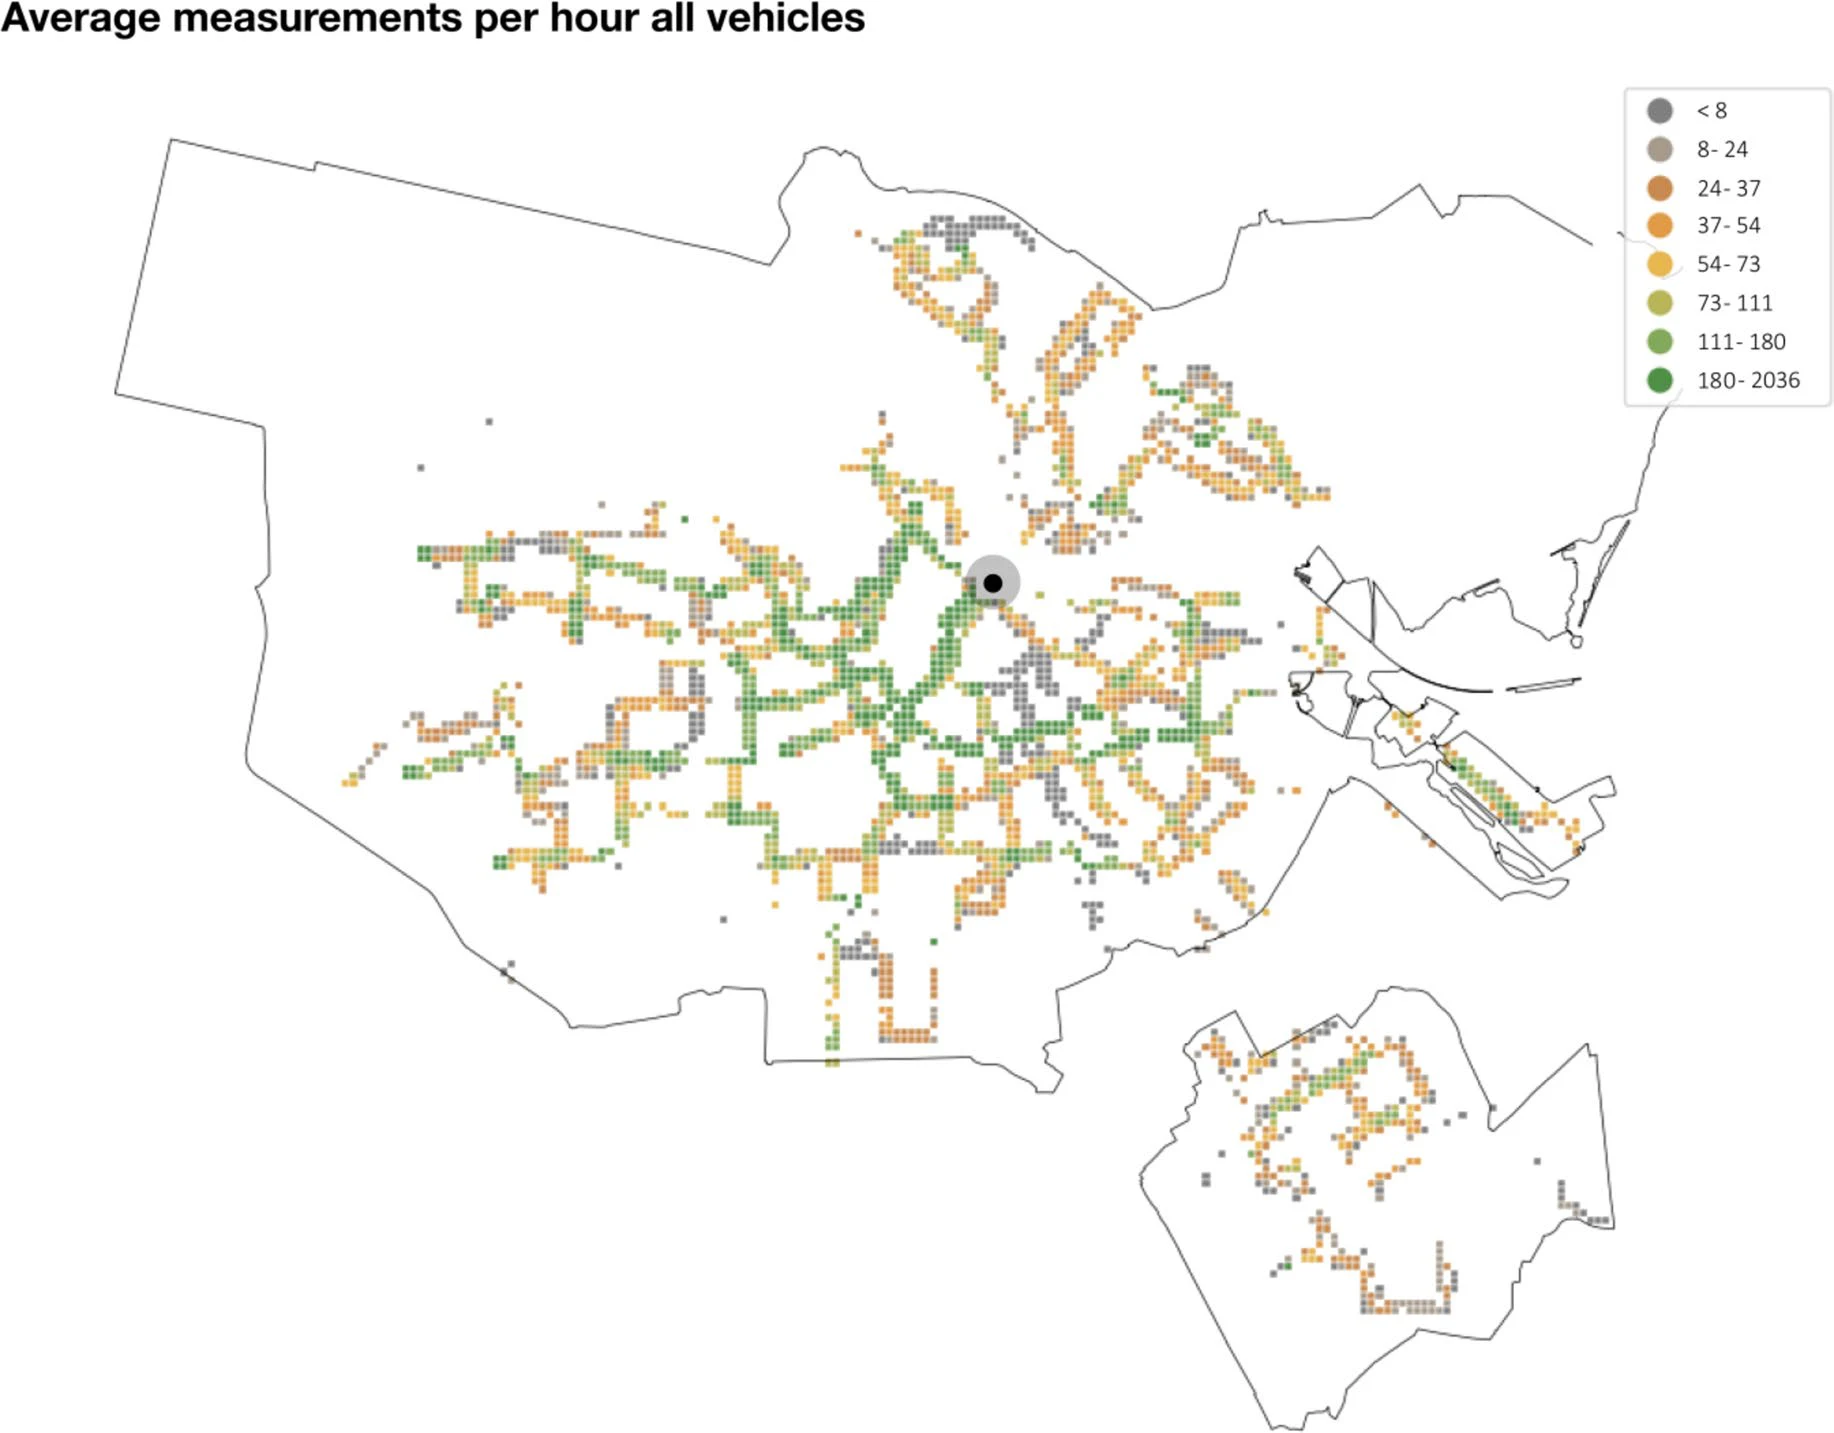
图 9|276辆车全装传感器时,每个格子平均每小时被经过多少次?
颜色是5月21日全天的每小时平均次数:灰色少于8次,然后是8–24、24–37、37–54、54–73、73–111、111–180,最深的一档是180–2036次/小时。黑点标出中央车站及周边,多条线路在此交会。只显示至少有一次记录的格子。中心枢纽最密,外围线路更疏。来源:原论文 Fig. 9。
中央车站这种反复经过的点,可以被当成靠移动车辆堆出来的准固定站。论文建议在这类节点放高质量固定参考仪,让经过的低成本传感器做同点或链式标定。这是部署设想。本文没有实施标定,也没有比较移动传感器和参考仪的读数。
另外三座城市,六辆车还能把结构拉近吗?
同一套GTFS和CBS网格被用到荷兰四座最大城市的一个昼夜。格子数分别是阿姆斯特丹6,906、鹿特丹5,455、海牙5,073、乌得勒支3,819。全部地面公交的车辆数是276、279、274和296。
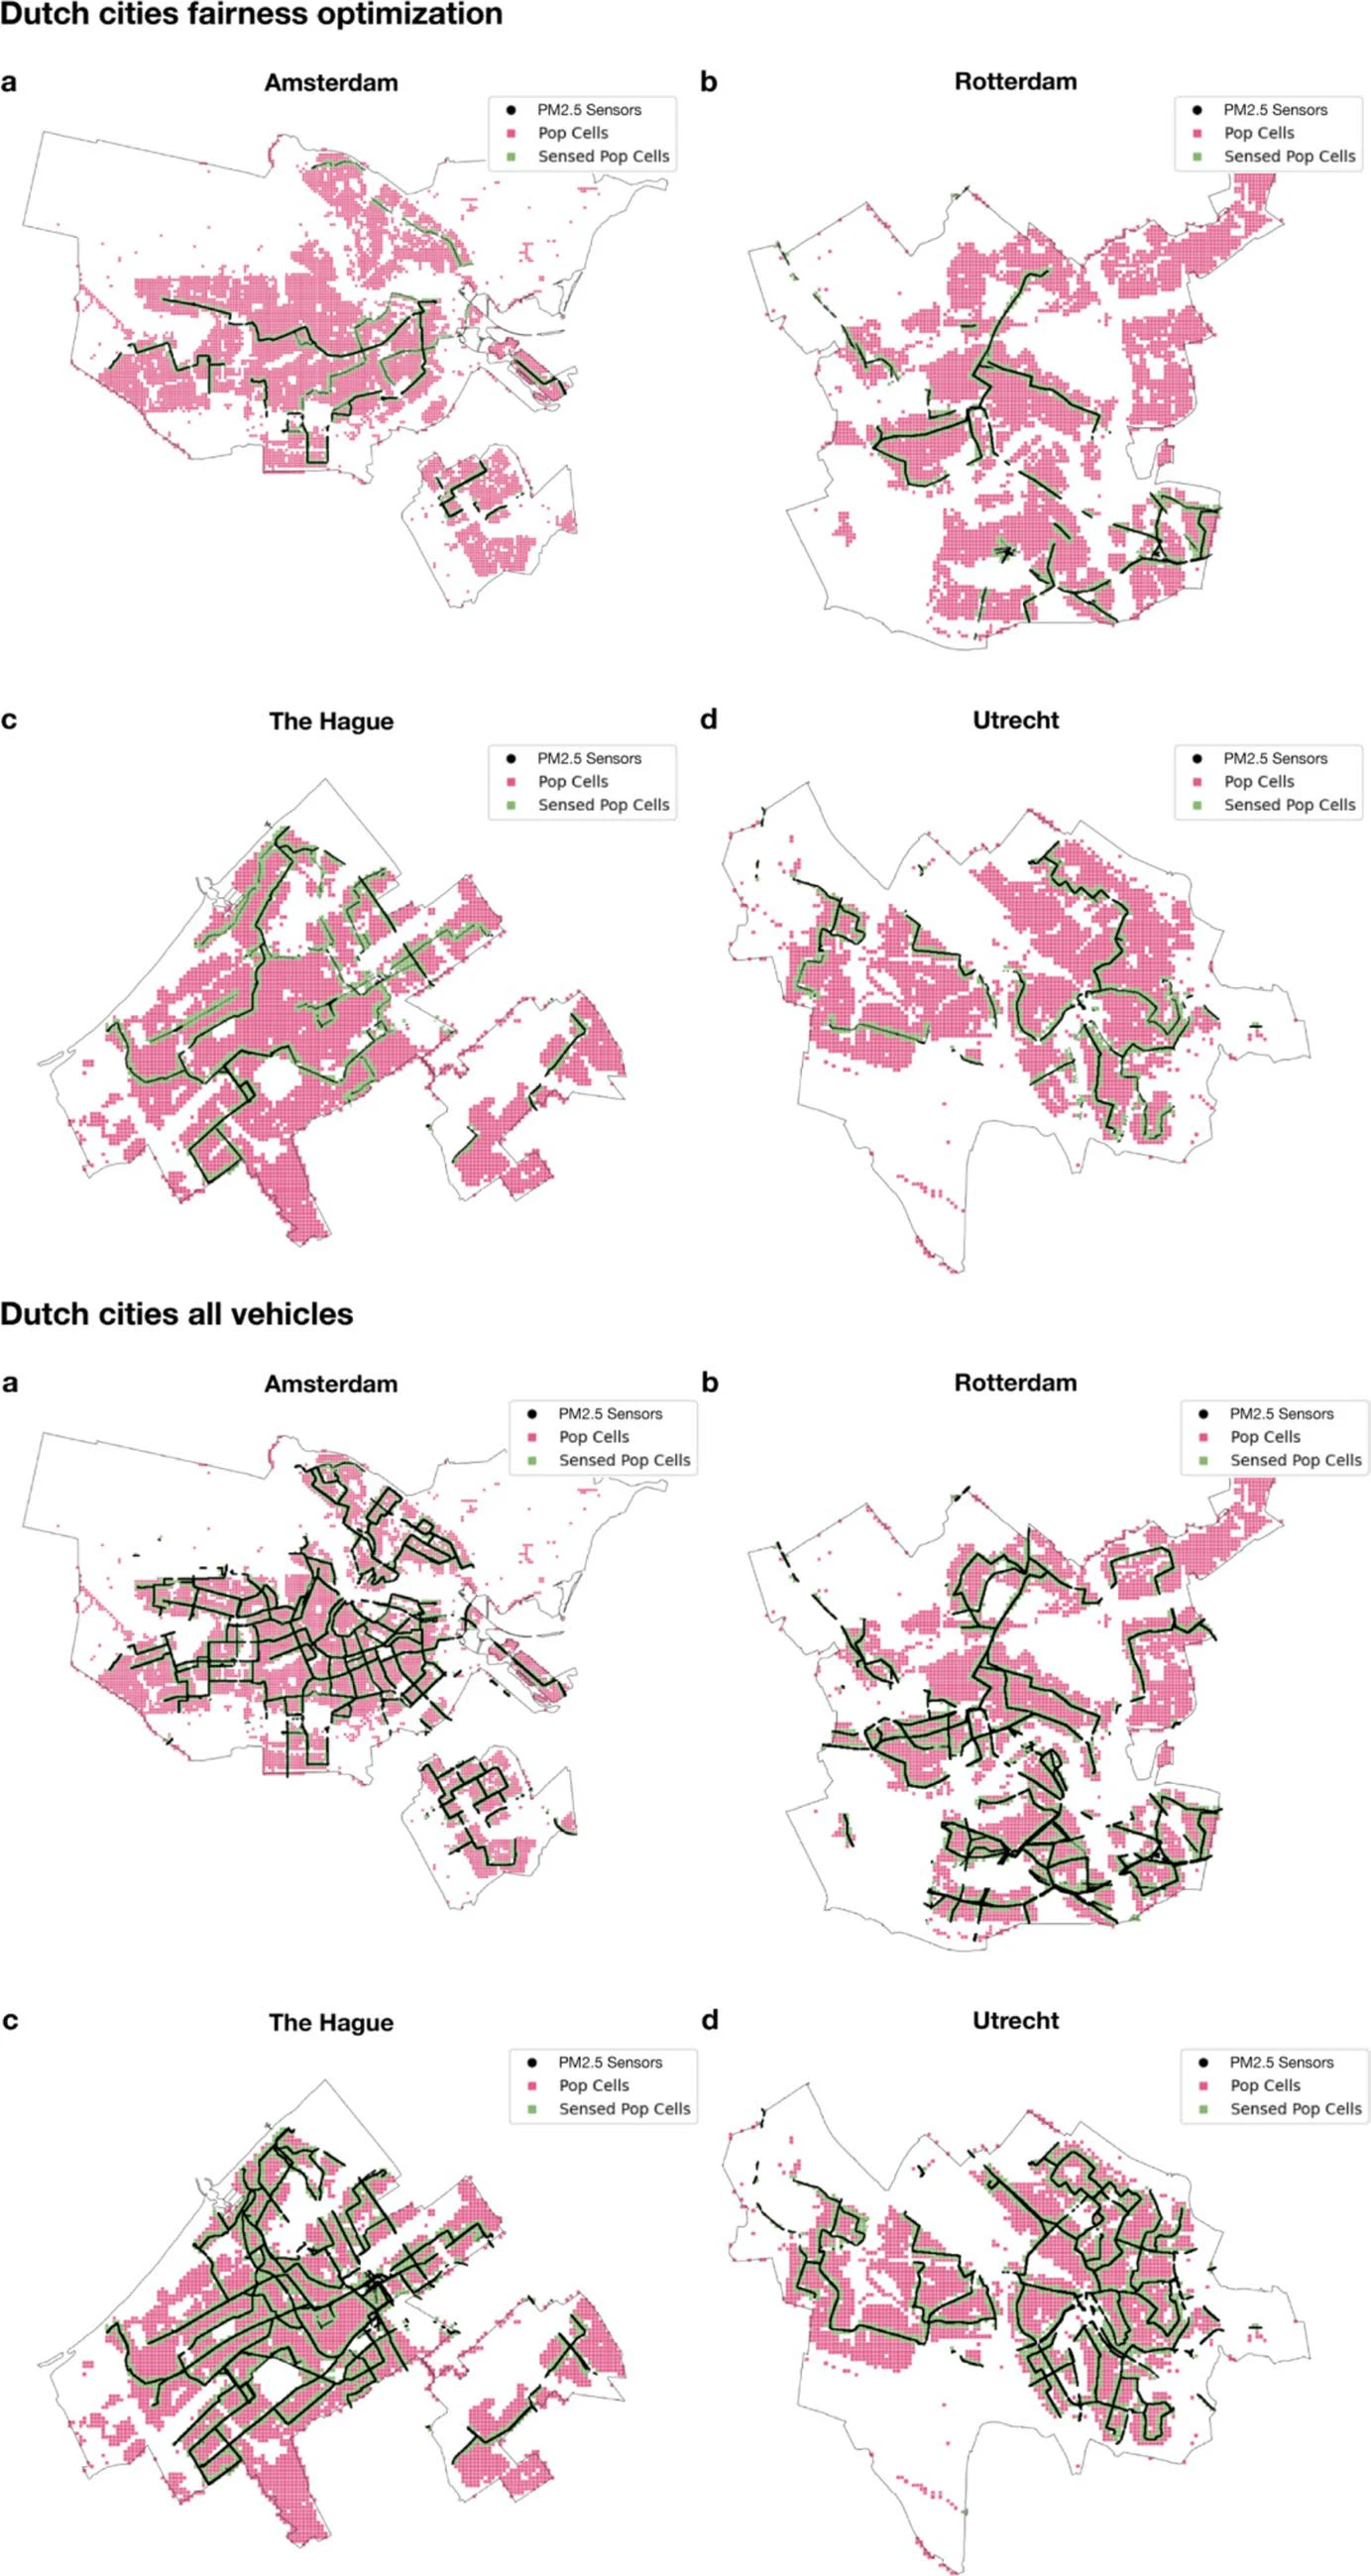
图 10|四座城市在24小时里,六辆公平车和全部车辆各覆盖哪里?
上半是六辆公平优化车,下半是全部运营车辆。两半都是(a)阿姆斯特丹、(b)鹿特丹、(c)海牙、(d)乌得勒支。黑点是PM2.5传感器,粉色是人口格子,绿色是被车辆碰到的人口格子。四座城市都有有轨电车和公交车。来源:原论文 Fig. 10。
六辆公平车的人口覆盖是17.6%、17.0%、26.2%和23.5%,标准化欧氏距离是0.062、0.125、0.126和0.162。海牙用同样六辆车碰到的居民比例高于阿姆斯特丹,乌得勒支的距离最大。正文把全部车辆的覆盖写成这四座城市人口的42.7%、41.1%、46.4%和46.0%。阿姆斯特丹这一项与表1的46.6%人口不一致,却等于2,953/6,906的格子比例。后三座城市的人口数和格子数分列在补充表8–10。这里保留正文写出的四组百分比。
作者据此认为,方法可以接到有GTFS和其他细网格人口资料的城市,并做了页面 fair-sensing.com/dashboard,用来更换城市、车辆数和时间窗。全球网格如WorldPop也能充当人口底图。分辨率和变量一旦变粗,公平距离的含义就会跟着变。
这些比较停在哪一条边界上?
居住地是第一个边界。人被固定在CBS登记的家里,通勤、日间活动和访客都不在数据里。线路旁边的居民被算进覆盖,不表示他们白天在这条街上呼吸。作者引用已有研究说明,用手机位置看暴露,会看见只看家庭住址时看不见的差别;这类个人移动数据通常不公开,所以本文和许多同类工作一样停在居住地。
50米是第二个边界。一个位置点的缓冲区最多叠上四个百米格子,GPS水平误差约±5到10米,60秒插值也会把车放在它并未精确停留的点上。只沿电车线路把缓冲区放到100米和200米,人口覆盖从50米时的26%升到35%和52%。这组26%、35%、52%是电车线路的敏感性结果,不是前面六辆公交加电车的17.6%。噪声、温度和颗粒物的合理距离不同,换缓冲区就可能换掉被选中的车。
公平指标是第三个边界。优化按累计人次比较结构,所以重复经过会改变分数;独特格子上的代表性被另报,但不是挑选时逐步重算的目标。等权、去掉65岁及以上和非西方移民背景这两个参照类,都会影响距离。作者用同样的变量另算马氏距离,与标准化欧氏距离的相关系数在24小时是0.98、在一周是1.00,说明变量之间的相关没有推翻方案排序。距离没有公认的合格线,0.06只是比0.31、0.54和0.33更接近全市。
缺失值会进入房屋估值。少于五人的格子因隐私被隐藏。年龄和移民背景按各格总人口比例补齐;房屋估值用年龄和移民背景做线性回归填补,拟合用6,072行完整记录,R²只有0.192,只用于填补。6,906个格子中有834个、即12.1%的估值是填出来的。六辆公平车的独特格子里,两个时段都大约有9%使用了填补值。若距离只保留原始估值,24小时从0.0625变为0.0615,一周从0.0827变为0.0799。填补对这个主结果影响很小,回归本身解释力弱。
方法文本里还有一处对不上表1的敏感性数字。作者写,六辆车的空间优化若改用全部340辆而不是215辆,只有一辆车不同,独特格子为1,702,人口覆盖26.7%。表1里一周空间优化是2,865格和45.8%。正文没有解释这组1,702和26.7%对应哪一次运行。本文不把它当作六辆车空间挑法的主结果。
实施上,低成本传感器会受日照、气流和车辆自身排气影响,沿公交走廊测到的空气也可能偏脏。论文因此把移动传感器写成固定参考站的补充:参考站负责长期质量和标定,移动传感器负责更密的街道覆盖。短窗口也不利于安装维护,一周比一天更接近可执行的排班。优化按全天和全周累计,不单独加重污染可能堆积的夜间。
分组的完整份额、随机30次的逐次名单,以及人口最大化的补充说明,列在补充表1–11、补充图1–6和补充注记。
一句话总结
在50米和居住地这两条约定下,按结构公平挑出的六辆地面公交,一天可以覆盖17.6%的居民,并把累计结构距离压到0.06;六台固定传感器在同一距离规则下只有0.2%和0.53。更广的覆盖和更高的重访次数仍要分成两次挑选,而且这些百分比还不是空气测量。
核心来源
- Scientific Reports论文页面。所据版本页眉为Article in Press,正文图为Fig. 1–10。
- 代码、流程和输入数据以MIT许可证放在 GitHub的scientific-reports分支,存档为 Zenodo 10.5281/zenodo.22736101。
- 交互部署页面:fair-sensing.com/dashboard。论文致谢Romme te Velde参与落地页和仪表板。
作者介绍
署名以论文末页为准。代尔夫特理工大学的建筑与建成环境学院、土木与地球科学学院写在同一条机构中。
- Petar Koljenšić:署名机构为代尔夫特理工大学、麻省理工学院城市研究与规划系Senseable City Lab,以及阿姆斯特丹先进都市解决方案研究所(AMS Institute)。通讯作者。贡献包括概念、方法、编程、形式分析、调查、可视化和撰写。2024年另获阿姆斯特丹应用科学大学资助。
- Titus Venverloo:署名机构与Koljenšić相同。贡献包括概念、方法、编程、调查、可视化和撰写。
- Ruben Vrijhoef:署名在代尔夫特理工大学上述学院条目。负责获取资助和指导。资金来自代尔夫特理工大学气候行动计划下的气候行动研究与教育种子基金,资助标注为2024年11月。
- Fábio Duarte:署名在麻省理工学院Senseable City Lab。参与概念、方法、指导和文稿修改。
- Carlo Ratti:署名在同一实验室,论文中的贡献是指导。论文所链项目页把他写为该实验室主任。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
城市若把0.06当成监测公平的公开指标,最好同时公布独特格子上的居民比例。累计距离会奖励反复经过的中心走廊。一条已经很像全市的线路若被第二辆车再跑一遍,分数可以更好看,新覆盖的家庭却很少。图5里100辆比215辆更公平,已经露出这种机制。公开报告可以并列两个数:独特居民覆盖,以及按经过次数加权的结构距离。
另一个可以直接检验的选择,是把夜间单独做成一次优化。图7的01:00–02:00已经显示,夜班公交碰到的是另一批格子,而且大多达不到每小时12次。若某类污染或逆温主要发生在夜间,按全天累计挑出的公平六辆车,可能刚好把夜间样本稀释掉。用同一套GTFS,只把目标函数限制在设定的夜间小时,就能看出公平名单会不会从日间长线换成少数夜班线。
第三条是缓冲区随监测对象更换以后,图6的群体集中还会不会留在同一城区。电车线路上50米到200米已经让人口覆盖从26%升到52%。颗粒物、噪声和温度若使用不同半径,东南和阿姆斯特丹北那些为了提高群体占比而选出的线,可能有的还在、有的会被相邻小区稀释。在安装传感器之前,先把半径写成可切换参数,比先选定六辆车更接近这篇论文自己展示的敏感性。