中国游客的伦敦签到挤在市中心,为什么仍然不是同一种行程?
论文名片|Zi Ye、Andy Newing、Graham Clarke,Understanding Chinese tourist mobility and consumption-related behaviours in London using Sina Weibo check-ins,Environment and Planning B: Urban Analytics and City Science,2021,48(8):2436–2452。DOI:10.1177/2399808320980748。观察研究。
官方入境调查可以把中国游客概括成停留更久、花费更高的一群人。一个人在伦敦的一周里,上午可能站在威斯敏斯特看伦敦眼和大本钟,下午可能出现在牛津街或骑士桥的商场。这两件事若落在不同人身上,城市面对的是两股客流;若经常落在同一个人的前后站,商场就是观光行程上的一站。
微博签到把场所按时间连在一起,可以看中国游客在伦敦的移动,以及购物、就餐这类消费相关活动,是不是同一套行程。签到确实挤向少数核心景点和商场,行程组合却分开了:将近一半人的签到以观光和配套场所为主,约五分之一以购物组织停留,餐饮、校园和户外观光各自形成更小的组。购物经常作为顺路活动出现,去的店也不一样。这些差异记录的是签到行为。人均花费来自另一套官方统计。
先说结论
- 2016 年 1 月 1 日至 2018 年 8 月 28 日,大伦敦范围内被判为短停留游客的微博记录有 6,465 人、20,233 次签到,约占原始签到的 20%。观光类场所占这些游客签到的 49%。超过 70% 的游客用户在交通场所签过到,交通签到接近全部游客签到的四分之一。
- 游客签到热点比场所本身的分布更收束。观光集中在威斯敏斯特,以及莱斯特广场和考文特花园一带;购物集中在骑士桥的哈罗德和牛津街。住宿签到分成南岸和绿园两团,住宿场所的供给则更靠近海德公园。
- 个人每日路径叠在一起后,22 个景点成为核心节点,57 条联系成为关键边。伦敦眼和海德公园的网络影响力最高。国王十字火车站的签到少于希思罗机场,在这张本地网络里却更关键。相对既有的伦敦推特研究,大英博物馆、唐人街和福尔摩斯博物馆的联系更强。
- 41 个标准化指标分成 5 类时,组间平方和占全部平方和的 78.3%。传统观光型占 48.4%,购物型占 20.5%,餐饮型占 11.6%,校园相关占 9.8%,户外观光占 9.6%。
- 购物会进入主目的并非购物的行程,场所类型随组别改变。传统观光型很少购物,出现时多是礼品店和纪念品店。2017 年中国游客平均每次访英花费 2,059 英镑,这个数字来自 VisitBritain,分母是访英次数,超过其他国际入境游客平均花费的三倍。微博签到没有进入这个平均数。
这批签到,记的是谁在大伦敦的哪一段停留?
基于位置的社交网络(location-based social network,LBSN)会在用户发帖时带上地点。新浪微博在文中约有 2.1 亿活跃用户,这个数字来自微博 2019 年的投资者资料,口径是全平台活跃用户。用户可以在兴趣点(point of interest,POI)签到(check-in)。一次签到是一次愿意公开的地点记录,带有时间、场所和用户自己写的文字。
研究收集的是 2016 年 1 月 1 日至 2018 年 8 月 28 日、大伦敦范围内的微博签到。起始年份与当时中国公民赴英签证安排的变化放在同一时段,正文没有把签证变化做成前后对照。采集期间,有微博用户签到的兴趣点共 2,665 个。接口按兴趣点返回最近的签到,单个兴趣点最多 1,500 条;其中 31 个兴趣点达到这条上限。31/2,665 约为 1.2%。正文括注写成 0.01%,与这个分数不一致。因此最热地点的签到名单是截断的,其余兴趣点更接近当时接口能返回的全部签到。
微博用户里既有游客,也有本地居民和长期停留者,例如在伦敦学习或工作的人。研究用签到时间跨度把短停留游客分开,分界是连续 20 天。这个天数参照英国国际旅客调查(International Passenger Survey,IPS)和 VisitBritain 的停留情况,不是逐人核对的护照或酒店记录。正文同时说明,会先去掉在很短时间里于多个地点密集签到的社交机器人账号,具体时间阈值没有列出。
由此得到 6,465 名用户的 20,233 次旅游活动签到,大约是原始签到数据集的 20%,其余签到归到居民或长期停留者。20,233÷6,465 约为 3.1,即平均每人约 3.1 次签到;这是两个总数相除,正文没有给中位数,经常打卡的人会把平均值拉高。这些用户的平均停留略多于 6 天。后文把停留长度定义成首次签到和末次签到之间的天数,精确均值没有列出。不少用户的第一次或最后一次签到出现在希思罗。希思罗占中国与英国之间九成以上的航班座位,这是 VisitBritain 2018 年的座位统计,分母是座位供给。
微博上的兴趣点名称和类别不统一。研究用 Foursquare 的场所名录作对照,并把位置邻近、类别相近的兴趣点合成一个场所。经常被游客用户访问的场所有 962 个,门槛是至少 10 名不同的游客用户;同一人的重复签到不另计人数。用户不会给每一个到过的地方签到,热门景点更容易被写进帖子。后面的热点和路线,都是在这层发布选择之上读出来的。
背景里的官方数字用来说明为什么值得单看中国游客,它们和微博样本不是同一口径。VisitBritain 的资料写,2017 年伦敦接待的国际游客超过 1,983 万人。英国国家统计局的资料写,按 2018 年在伦敦的花费计算,中国是国际入境市场里的第八大来源。两句话的年份不同,也不能从中推出这 6,465 名微博用户占中国游客的比例。
签到热点为什么比场所分布更集中?
核密度估计(kernel density estimation,KDE)把散点平滑成一张密度面,用来看某一类活动堆在哪里。图 1 由已经对应到 Foursquare 场所、带有时间的游客签到平滑而成,颜色越深表示这一幅内部的密度越高。每一幅的图例各自缩放,同一种颜色在观光和住宿之间对应的签到次数可以不同。正文没有给出核密度的带宽,色标上的数值只在同一幅内部比较高低。
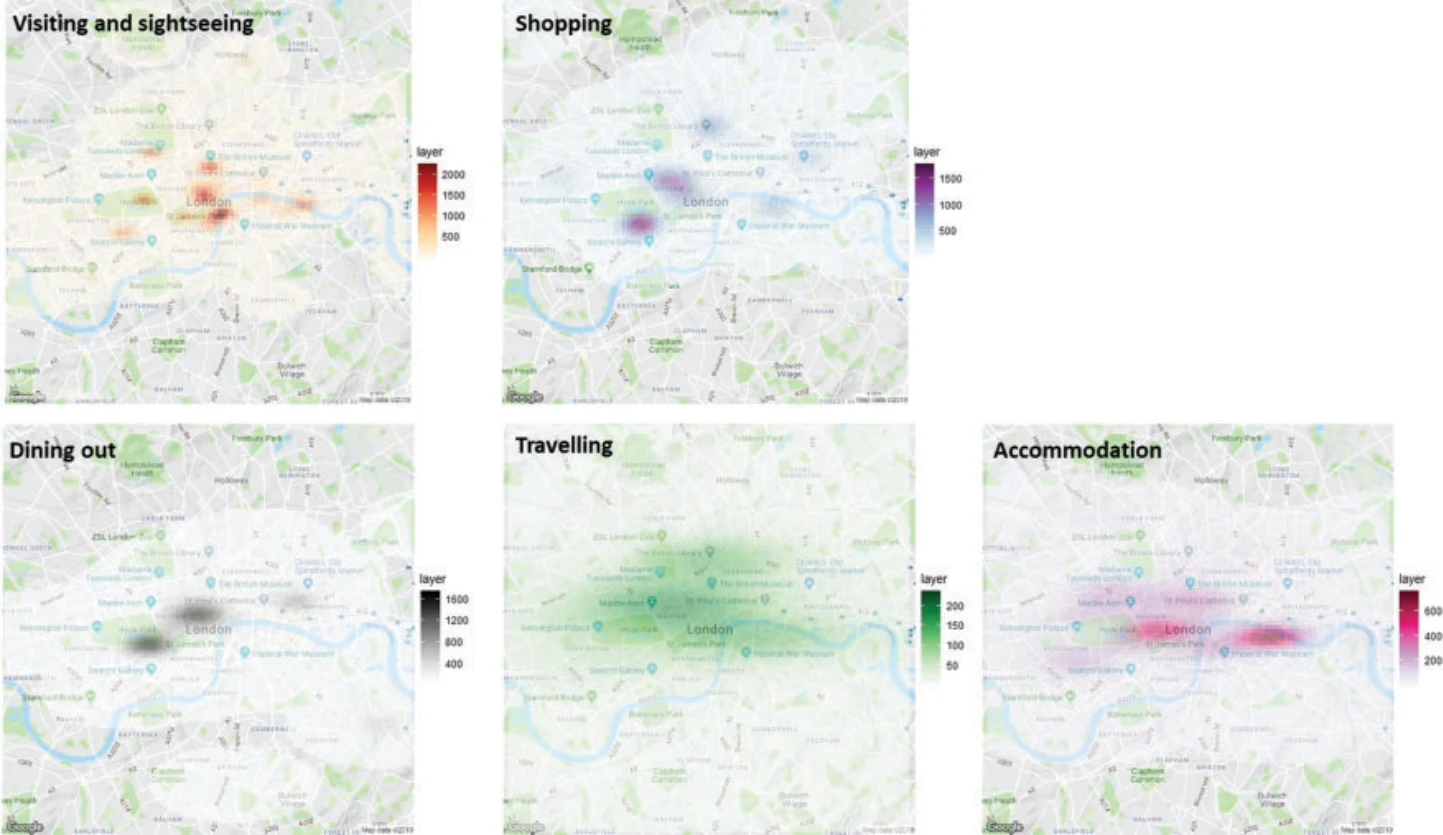
图 1|中国游客的五类签到,分别堆在伦敦的哪些位置?
(a)观光类签到形成两个主要热点,中心在威斯敏斯特的伦敦眼、大本钟一带,以及莱斯特广场和考文特花园;大英博物馆、海德公园、贝克街、展览路和伦敦塔是次一级热点。(b)购物签到集中在骑士桥的哈罗德和牛津街。(c)外出就餐的空间格局与购物相近。(d)交通签到铺得更开,密度面没有收成和观光同等级的单点。(e)住宿签到分成较大的两团,一团在南岸,一团在绿园附近。来源:原论文 Fig. 1。
只看图 1,热点可能只是因为那些地方本来店铺和景点就多。图 2 用同一套五类,画的是 Foursquare 场所在伦敦的分布,也就是供给落在哪里,不按微博签到次数加权。
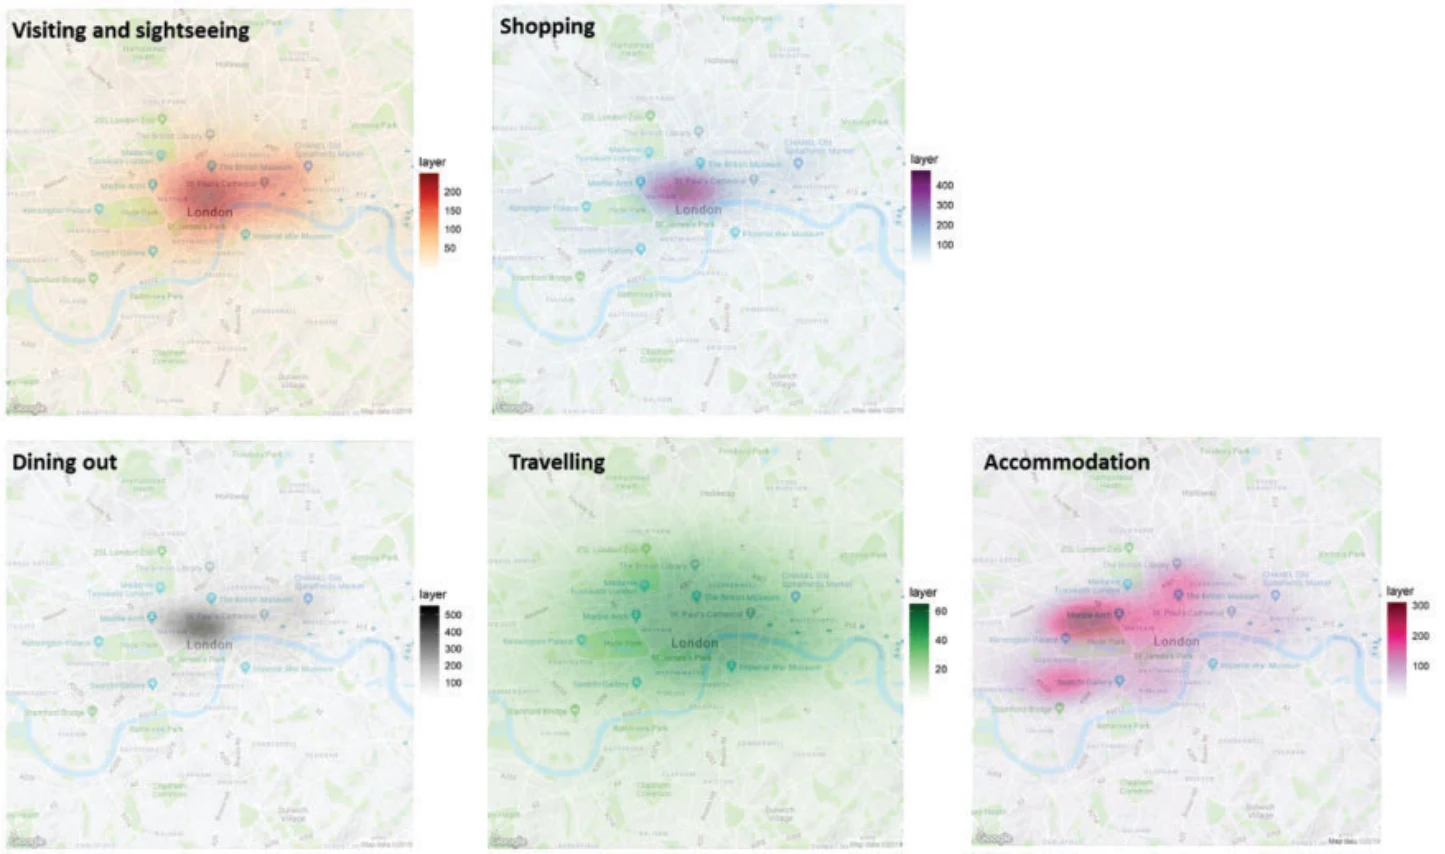
图 2|如果只看场所本身的分布,热点还会这么窄吗?
(a)观光场所在内伦敦铺得更开,对应的游客签到则收成少数热点。(b)购物场所的供给,正文没有另列街道。(c)就餐场所的供给。购物与就餐在图 1 和图 2 中的空间格局都彼此接近。(d)交通场所的分布比签到热点更铺展。(e)住宿场所集中在海德公园一带,图 1 的住宿签到则落在南岸和绿园。来源:原论文 Fig. 2。
观光签到比内伦敦的景点分布更窄,住宿签到的两团也偏离海德公园一带的酒店供给。购物热点则落在已经形成零售聚集的骑士桥和牛津街,并与就餐的空间格局接近。图 1 里不同活动的热点还有空间重叠,重叠的是签到密度。要确认同一个人是否在前后站点完成这些活动,需要按时间排好的路径。
每日路径叠起来,核心景点网络长什么样?
把一名用户的签到按时间排序,再按天切开,就得到这个人在伦敦停留期间的每日路径。图 3 用一名游客的五天说明这种路径里可以同时留下哪些活动。这条线只属于图中这一名用户,代表的是单次停留的场所组合。
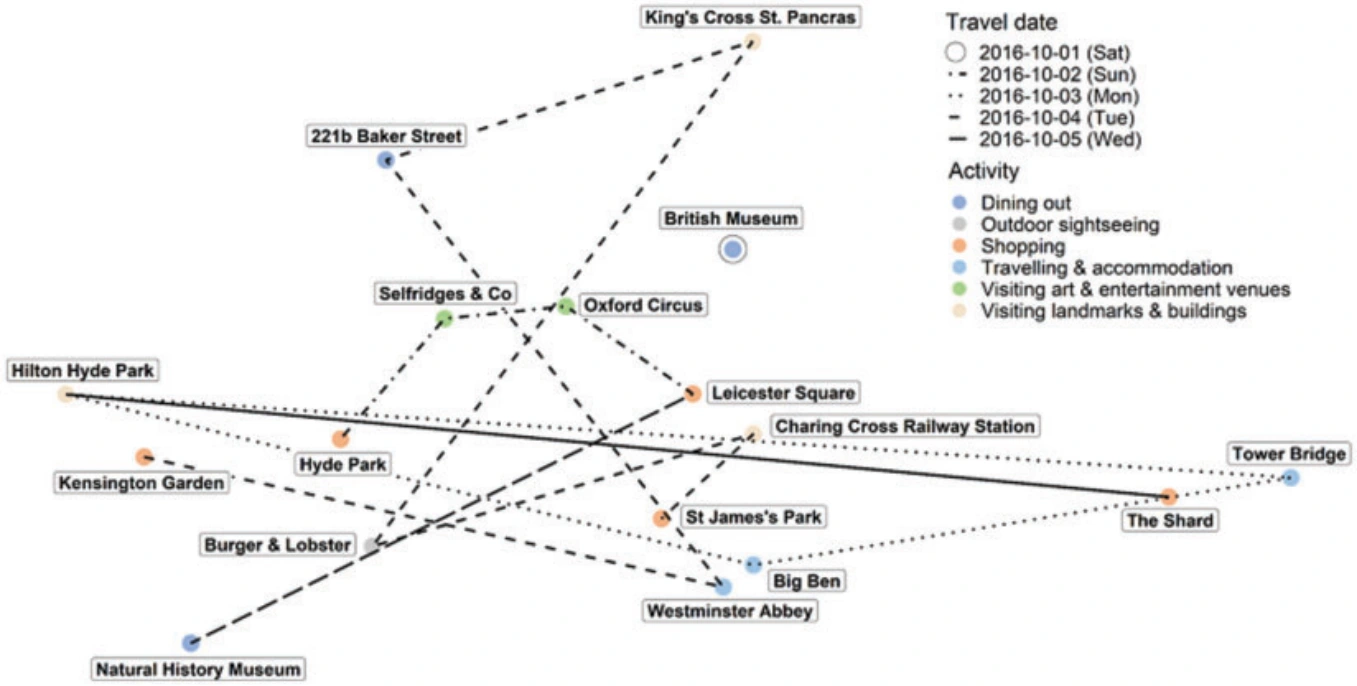
图 3|同一次停留里,不同活动会不会出现在同一名游客的连续几天?
无字母子图。五种线型对应 2016 年 10 月 1 日至 5 日,从周六到周三。颜色区分六类活动:蓝色为外出就餐,灰色为户外观光,橙色为购物,青蓝色为交通与住宿,绿色为艺术与娱乐场所,浅橙色为地标与建筑。同一组连线里同时出现地标、商店、餐饮、公园和车站。用户不会给每一个到过的地方签到,图上的场所是其选择发布的那些。来源:原论文 Fig. 3。
把这样的每日路径从 6,465 名游客用户汇总起来,得到一张中国游客的核心景点网络。节点的重要性用特征向量中心性(eigenvector centrality)衡量:一个景点的中心性来自它与其他重要景点的连接。颜色表示这种中心性,点的大小表示签到次数,线的粗细表示两个景点之间的联系多少。
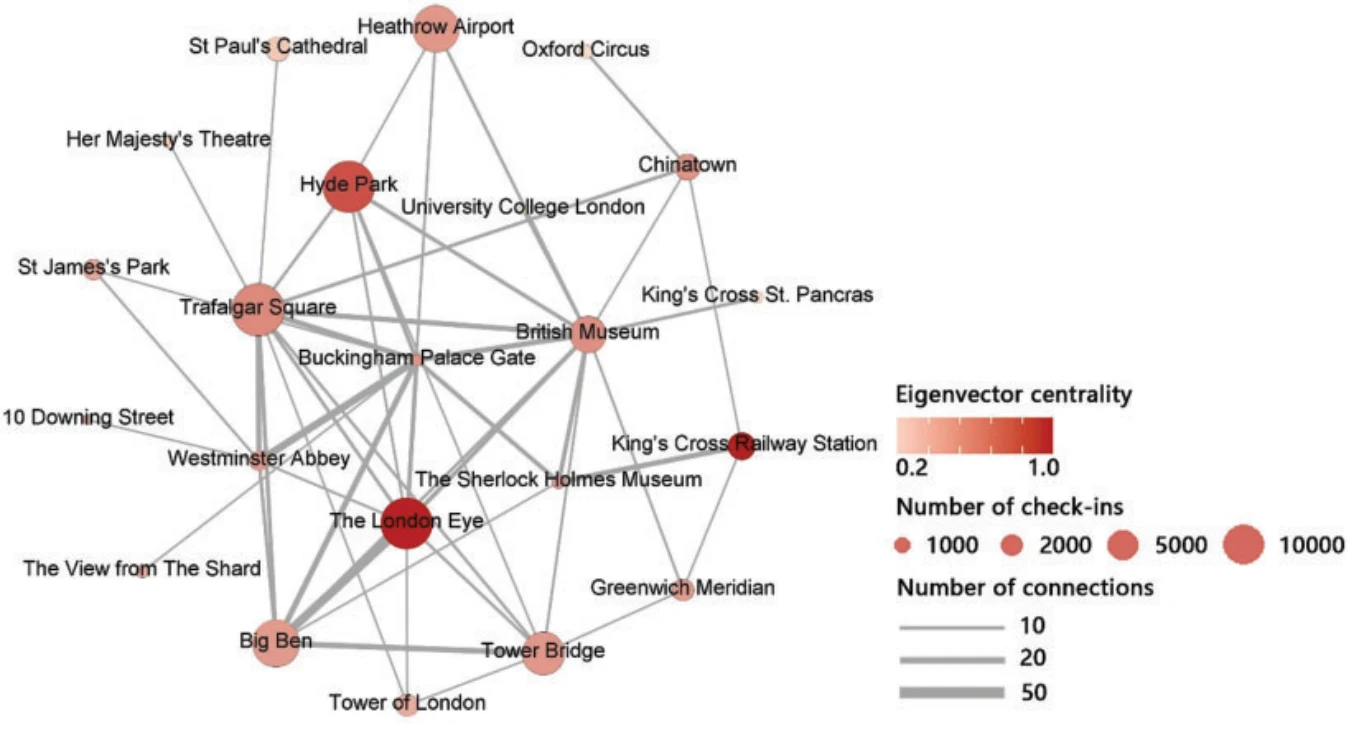
图 4|哪些景点位于中国游客每日路径的核心,哪些只是签到很多?
无字母子图。正文确认 22 个景点为关键节点、57 条联系为关键边。颜色图例的中心性参照从 0.2 到 1.0,点大小的参照为 1,000、2,000、5,000 和 10,000 次签到,线宽参照为 10、20 和 50 条联系;这些是图例刻度,不是每个点的精确读数。伦敦眼和海德公园又大又深,是网络里最有影响力的景点。希思罗的点较大、颜色较浅;国王十字火车站签到少于希思罗,颜色却更深,说明它在本地每日路径里更处于核心。粗线连接的组合包括伦敦眼与大本钟、白金汉宫、威斯敏斯特教堂,以及大英博物馆与特拉法加广场。来源:原论文 Fig. 4。
作者把这张网络和 Comito 等人 2016 年用带地理标签的推特提取的伦敦景点联系作了比较。两边排名靠前的连接有重合;微博上的中国游客与大英博物馆、唐人街、福尔摩斯博物馆之间的流动更强,这些地点在那份推特数据里没有这么突出。比较没有附上一张并列的流量表,强弱是作者对两条研究的判断,不能读成两套数据已经换算到同一套人数口径。
这张网络对目的地管理的用处,是同时看到到访量和核心—边缘位置。签到很多的机场,和每天把市中心景点串起来的火车站,会提出不同的交通与服务问题。网络边是签到路径里的景点对,还不是地铁客流,也不是沿街步行人数。
五类游客,是按哪 41 个签到指标分开的?
热点和核心网络描述的是大家叠在一起的结果。个人的停留长短、活动搭配和路径形状仍然可以差得很远。研究从每名游客用户的签到路径提取 41 个变量,分成三组。
行程特征有 4 个:首次到末次签到的天数、有签到的天数、签到次数、到过的不同景点个数。活动偏好先按 7 类活动各算 4 个数,共 28 个,另加一个平均活动个数(multi degree)。7 类活动在图 5 的图例里是:艺术与娱乐场所、大学相关活动、外出就餐、户外观光、地标与建筑、购物、交通与住宿。4 个数分别是:该类签到占本人全部签到的比例,该类成为当天主要活动的天数比例,该类去过的不同场所个数,以及这些场所的受欢迎程度之和。移动格局有 8 个:每日平均景点数、回到已去场所的概率、每次行程的平均出行距离、停留点之间的平均距离、全部签到点的标准差椭圆面积和偏心率,以及这条路径在全体景点网络里的总权重和总中心性。
标准差椭圆(standard deviation ellipse,SDE)用一组点的中心和两个互相垂直的轴,概括活动范围的大小与拉长程度。总权重和总中心性则用来看这个人走的路,有多贴近图 4 那张全体游客的典型网络。
聚类之前,41 个变量都做成了 z 分数,因此天数和距离不会因为原始单位不同而直接比大小。K 均值聚类(K-means)把用户分成预先指定的 k 组,使组内差异小、组间差异大。k 在 2 到 10 之间用 R 的 NbClust 挑选,结果是 5。k 为 5 时,组间平方和占全部平方和的 78.3%。分母是这些标准化变量的总变异,描述的是五组把变量拉开的程度。
五个组的名称是按聚类后看到的主要活动归纳的,算法本身没有读到这些名字。表 3 的比例之和为 99.9%,差额来自四舍五入。正文写最大一组几乎占这些微博游客用户的一半,但没有单独报告进入聚类的人数,也没有说明签到过少、无法计算椭圆的用户是否被排除。下面只保留表中的百分比,不把它们乘上 6,465 换算成人头。
| 组别 | 占微博游客用户 | 更突出的活动 | 购物出现的方式 |
|---|---|---|---|
| 传统观光型 | 48.4% | 观光 | 少;偶尔是礼品店和纪念品店 |
| 购物型 | 20.5% | 购物 | 百货公司、纪念品店、市场和主要购物中心,场所更多样 |
| 餐饮型 | 11.6% | 外出就餐 | 通常不是当天的主要目的;百货、市场、纪念品店和服装店仍常出现 |
| 校园相关 | 9.8% | 大学场所 | 各类购物场所都有一些签到 |
| 户外观光 | 9.6% | 户外观光 | 购物行程少;一旦出现,包括百货、市场和纪念品店 |
传统观光型和户外观光型的路径比较整齐,多沿着核心景点的常见路线走。购物型、餐饮型和校园相关这几组更分散,对关键节点和共同路线的依赖更低。校园相关的移动主要围绕大学场所,核心景点网络在他们的签到里退到后面。
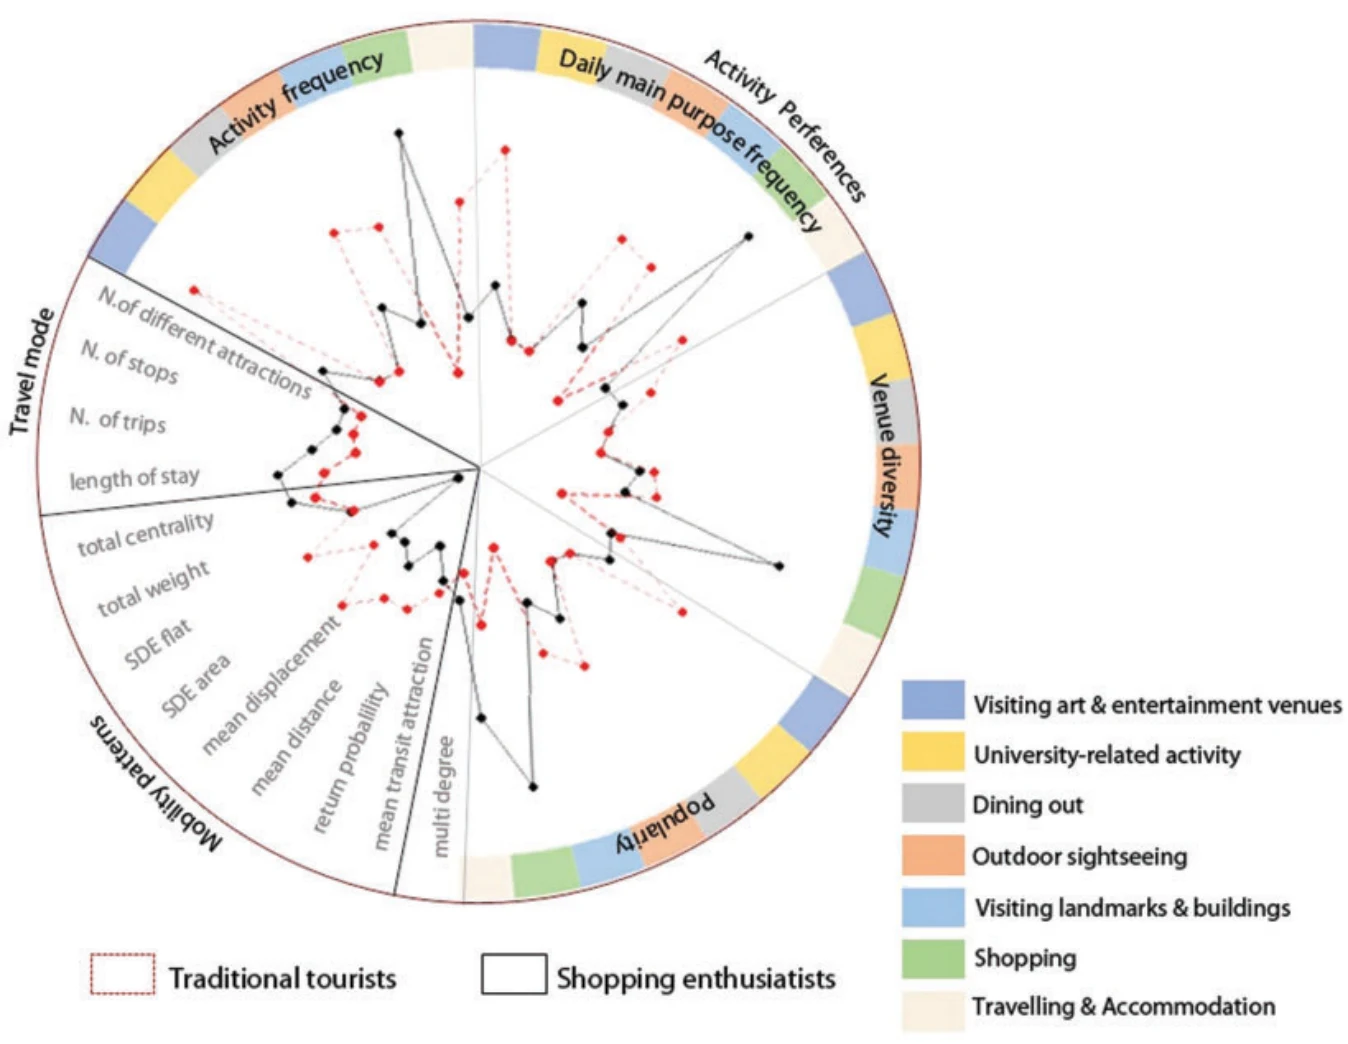
图 5|人数最多的两组,在同一套指标上的轮廓哪里不同?
(a)红色虚线是传统观光型,占微博游客用户的 48.4%,签到多在博物馆、公园、地标、酒店和交通枢纽。(b)黑色实线是购物型,占 20.5%,行程更常由主要百货和零售中心的重复访问组织,并与博物馆、演艺场所和户外观光穿插。两组画在同一张雷达图上,外圈颜色对应七类活动。移动格局一侧与表 2 对应的轴包括椭圆面积(SDE area)、椭圆偏心率(SDE flat)、停留点间距(mean displacement)、平均出行距离和返回概率。图中没有半径刻度,只能看轮廓差异,读不出某一轴相差多少个百分点。另外三组没有画在这张图上。来源:原论文 Fig. 5。
表 3 把购物型的行程特征写成平均出行距离较短。同一节正文又写,他们的停留可能短于传统观光型,个人路径更多样,出行距离高于平均,也更可能回到同一个景点。正文没有给出两组的天数或公里数,两处说法不能收成一个确切差距。雷达图没有刻度,也解决不了这个差额。能够稳住的是方向:购物型用重复的零售场所组织行程,传统观光型把签到放在核心观光和配套场所上。
主目的不是购物时,消费相关活动还留在行程里吗?
中国游客的购物之所以被单独拿出来,是因为已有资料把它和花费连在一起。中国旅游研究院 2014 年的报告被用来说明,中国游客在伦敦更可能把高价值购物当作核心活动。VisitBritain 2018 年的市场快照给出另一个口径:2017 年中国游客平均每次访问英国花费 2,059 英镑,超过其他国际入境游客平均每次访英花费的三倍。正文没有写出那个对照平均值。这里的分母是访英次数,地理范围是英国;微博样本没有进入这个平均数。
签到里没有价格。研究改问:已经被归到非购物主类的人,还会在哪些类型的商店签到。方法是隐含狄利克雷分配(latent Dirichlet allocation,LDA)。它把一组场所子类别看成文档,估计哪些类别倾向一起出现。每个组的场所子类别都被收成 4 个主题,主题个数来自 ldatuning 提供的四个拟合指标。正文没有列出每个主题的概率或词表。表 3 的购物场所一列,是作者根据这些主题对各组作出的归纳。
传统观光型的多目的路径比较整齐,购物少,偶尔出现礼品店和纪念品店。购物型的商店更杂,正文在表 3 之外还写到电器店、书店、购物中心、跳蚤市场和礼品店,并与博物馆或其他观光穿插,场所偏向更受欢迎的那些。餐饮型也会在百货、市场、纪念品店和服装店签到,但很少把购物当成当天的主要目的。户外观光型的每日出行距离较高,购物行程少,一旦出现则包括百货、市场和纪念品店。校园相关一组在各类购物场所都有一些签到,正文没有把某一类商店写成他们的主线。
因此,主活动相近的组,消费场所仍然不同。传统观光型的购物集中在景点旁的礼品和纪念品。餐饮型的购物嵌在核心景点网络里,很少成为当天的主要目的。购物型把更多种类的零售场所放进行程中心。这些都是场所类别的组合,模型里没有金额。
热点、中心性和分组,各自能说到哪一步?
这套结果的分析单位要分开看。图 1 的密度按签到次数累加,重复打卡的人和只签一次的人权重不同。图 4 的颜色是景点在网络里的位置,点的大小是签到次数。表 3 的百分比以进入分组的微博游客用户为分母。2,059 英镑的分母是访英次数。
样本也有明确边界。20 天分界来自官方调查的停留经验,用来把短停留用户和居民、长期停留者分开;它没有逐人验证国籍或入境身份。研究借助微博这个平台观察中国入境游客,正文没有报告护照或户籍核对。平均每人约 3.1 次签到,而平均停留略多于 6 天,路径是行程的稀薄样本。没有签到的地点,数据里没有记录。31 个最热兴趣点在 1,500 条处被截断,市中心最忙场所的签到比这里显示的更不完整。
聚类拟合的是签到指标上的分组。78.3% 说明五个组拉开了标准化变量里的大部分变异,剩下的变异仍在组内。餐饮型和户外观光型被描述为组内的场所偏好更不整齐。LDA 把这种不整齐归纳到商店和景点的子类别,正文没有给出主题概率,也没有检验换一个主题个数后商店名单是否还在。表 3 与正文对购物型出行距离的两处说法并存,在公里数被报告之前,只能同时保留。
和推特研究的比较同样停在定性重合:排名靠前的连接有重叠,三个地点在微博路径里更突出。它支持中国游客的景点组合有自己的侧重,不能推出微博用户与推特用户的人数比例。
一句话总结
中国游客在伦敦的微博签到挤向少数核心景点和商场,将近一半人的签到以观光为主,约五分之一以购物组织行程,其他组里的购物更多是顺路,店的类型也不相同。签到密度、网络位置和分组的分母都还是签到或用户,花费仍来自另一套访英统计。
核心来源
- Environment and Planning B: Urban Analytics and City Science,2021,48(8):2436–2452。正式题目、作者、卷期和 DOI 以期刊页为准。正文图 1–5、表 1–3 都出自这一版。
- 文中作为背景引用、且与花费和客流直接相关的公开资料:VisitBritain 2018 年中国入境市场快照、VisitBritain 2019 年对 2017 年伦敦国际游客规模的说明,以及英国国家统计局关于伦敦国际游客的数据。2,059 英镑、1,983 万国际游客和花费排名第八,分别来自这些资料,不是微博样本的计算结果。
作者介绍
三位作者在论文上的署名单位都是英国利兹大学。下面只采用论文末尾的作者说明、资助声明和页首通讯信息。
- Zi Ye:论文末尾介绍她当时是利兹大学地理学院的研究型研究生,做旅游与零售场景中的地理大数据空间分析,背景是地图学与地理信息工程。资助声明写明,这项工作是她由中国国家留学基金委资助的博士研究的一部分。ORCID:0000-0001-5190-5211。
- Andy Newing:通讯作者,论文末尾介绍他是利兹大学地理学院应用空间分析方向的副教授,研究包括零售选址、地理人口与邻里分析、旅游,以及地方服务供给中的地理可达性。ORCID:0000-0002-3222-6640。
- Graham Clarke:论文末尾介绍他是利兹大学地理学院商业地理方向的教授,研究涵盖地理信息系统、城市服务供给、空间建模,以及零售与商业地理。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若用这五组去估计零售需求,传统观光型偶尔出现的纪念品店,和购物型反复出现的百货公司,会在“是否有过购物签到”这个问题上被算成同一种需求。可以把同一用户在百货、市场和纪念品店的重复次数分开,再问重复签到究竟对应更高花费,还是只对应更愿意发帖。论文没有小票或支付记录,这个区分现在做不到;它决定购物型那 20.5% 能不能被写成高价值顾客。
国王十字火车站签到少于希思罗,在景点网络里却更靠核心。只按签到量给车站排序,会把这种换乘位置排到后面。这张中心性来自微博游客的景点路径。若改用独立的地铁或铁路客流把同一批景点重新连边,国王十字还是否靠前,可以检验签到网络有没有把观光中转站放得过重。住宿也留着一个同类问题:签到落在南岸和绿园,场所供给更靠近海德公园。若这是入住选择,晚间餐饮应跟着这两个签到团走;若只是好拍照的酒店更容易被写进微博,两张图的差别就来自发布意愿。按酒店计算签到次数除以客房规模,才能把这两种读法分开。