普查区之间这一小时的人流,人口和距离还算得出来吗?
论文名片|Chia Wei Hsu、Chao Fan、Ali Mostafavi,Limitations of gravity models in predicting fine-scale spatial-temporal urban mobility networks。公开预印本为 arXiv:2109.03873,2021年9月8日提交,arXiv:2109.03873;Research Square 于2023年2月6日发布同题文本,DOI:10.21203/rs.3.rs-2547382/v1。未见期刊正式版。三位作者署在得克萨斯农工大学 Zachry 土木与环境工程系,通讯作者为 Chia Wei Hsu(chawei0207@tamu.edu)。
2020年2月1日下午6时,Harris 县的普查区质心被出行连成一张密网,同一时刻的 Queens 只画出很少几条黑线。重力模型(gravity model,也称引力模型)的基本算法是:两端地方越大、离得越近,流量越大。粗尺度研究里,国家之间的贸易、城市或邮政编码之间的月流量,常用这个式子,基本形式的决定系数 R² 在一些交通和经济研究里可以到 0.7。
这篇论文把同一个基本式子放到更细的网上:节点是美国人口普查区(census tract),连线是 2020年2月的小时或单日出行次数。问题是,尺度一细,少数枢纽连接绝大多数地点的无标度结构还在不在,人口和距离还能解释多少流量。
方向很明确。小时网络的度指数多数大于 1,但严格落在 2 到 3 之间的无标度标准并不是每个小时都成立。基本重力模型在这些普查区流量上的样本内拟合偏低:小时网络多数时段 R² 低于 0.3,日网络大约在 0.2 到 0.6。18 个县的人口密度和网络结构有差别,这些差别没有把拟合抬回到粗尺度文献常报告的水平。这里的 R² 是同一批流量上对数线性回归解释的方差比例,论文没有做留出样本的预测。
先说结论
- Harris 县 2020年2月的小时网络上,度分布对数线性拟合的 R² 大约 0.7;度指数多数大于 1。若采用更严的标准,指数要落在 2 到 3,无标度就不是每个小时都成立。指数随小时变化的图只画了这一个县。
- 小时流量上,起点人口、终点人口和距离三个自变量都不显著,多数时段 R² 低于 0.3。聚合到一天后,R² 大约升到 0.2 至 0.6,人口变量仍不显著。论文把距离写成方向为负、相对最显著的变量,但没有给出系数、标准误或 p 值,小时与日两段文字对距离是否显著的说法也不一致。
- 表1的 18 个县里,日尺度 R² 在县与县之间分开,同一县各天的箱子很窄。县人口密度越高,平均 R² 倾向于越低。跨县比较时,节点数和边数与 R² 没有显著关联。
- 这些县的聚类系数四舍五入到两位小数后多为 0.00,度同配系数接近 0,平均最短路径在 1.31 到 1.85 步。结构差异可见,基本重力模型在全部县上仍然低于文献里粗尺度约 0.7 的参照。论文没有用同一批手机数据再拟合邮政编码或交通分析区。
这张网记的是普查区之间的停留点移动
人类移动性在这里指设备停留点在普查区之间的移动,不是户籍迁移,也不是一个人全天的连续轨迹。数据来自位置公司 X-Mode 的匿名、用户选择共享的手机定位。论文给出的是公司采集规模:全球约 5000 万台设备,美国超过 3000 万用户,美国每天约 20 亿到 30 亿条位置记录。18 个县最终用了多少设备、多少次停留、占当地人口的比例,正文没有写。
2020年普查区边界用来把停留点归到普查区。一个停留点从甲区到乙区,就在两个区之间记一条移动,再按小时和按日计数。节点是普查区,边权是该时段的移动次数。人口来自美国普查局,论文同时说用各区人口密度作为重力模型的输入。作者把 2020年2月当作新冠疫情扰动之前的对照月。
正文点名的县有 17 个:纽约市的 Bronx、Kings(布鲁克林)、Queens、Richmond(斯塔滕岛);俄勒冈的 Clackamas、Multnomah、Washington;得克萨斯的 Collin、Dallas、Denton、Harris;佐治亚的 DeKalb、Fulton;伊利诺伊的 DuPage;马萨诸塞的 Suffolk;加利福尼亚的 San Francisco;密歇根的 Wayne。表1和图4、图5还包含 New York 县,合计 18 个县。
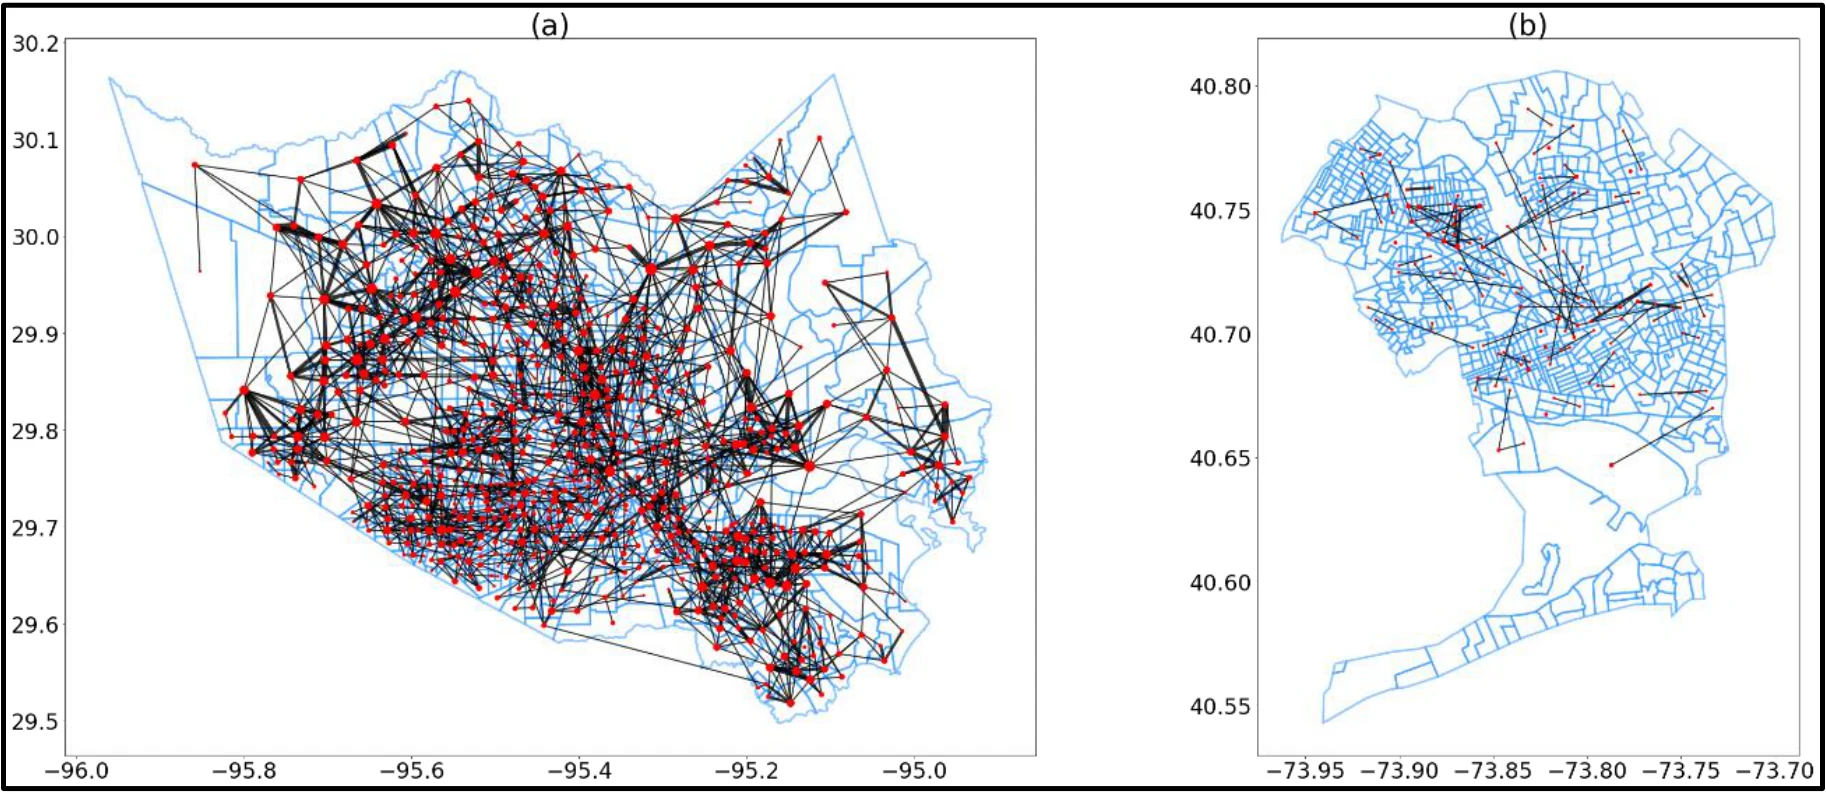
图 1|同一小时里,两个县的普查区出行网看起来有多不一样?
(a)Harris 县,2020年2月1日下午6时。横纵轴是经纬度,红点是普查区质心,点的大小表示以该区为起点或终点的出行总数,黑线粗细表示区与区之间的出行次数,蓝线是县界。(b)同一时刻的 Queens。质心和连线的画法与(a)相同,这一小时画出的黑线少得多,普查区边界更清楚。来源:原论文 Fig. 1。
这是一小时的截面。Queens 在表1里有 668 个节点、52,269 条边,不能从这一张傍晚图读成全月几乎没有跨区出行。Harris 在表1里有 786 个节点、129,486 条边,是边数最多的县。
表1给每个县一行 2020年2月的网络指标,没有拆成 29 天。平均加权度是节点连接权重的平均水平,分母是该县节点数,不是设备数。平均最短路径的单位是网络步数,论文没有说明计算时是否按出行量加权。聚类系数和同配系数都四舍五入到两位小数。
| 县 | 节点数 | 边数 | 平均加权度 | 平均聚类系数 | 平均最短路径 | 平均同配系数 |
|---|---|---|---|---|---|---|
| Bronx | 339 | 22,918 | 198.18 | 0.00 | 1.74 | −0.04 |
| Clackamas | 80 | 3,364 | 696.06 | 0.01 | 1.37 | −0.02 |
| Collin | 152 | 14,099 | 1,961.72 | 0.00 | 1.28 | 0.00 |
| Dallas | 529 | 71,754 | 1,020.37 | 0.00 | 1.65 | −0.04 |
| DeKalb | 145 | 8,529 | 545.41 | 0.00 | 1.44 | −0.03 |
| Denton | 137 | 9,586 | 1,647.03 | 0.00 | 1.38 | 0.01 |
| DuPage | 216 | 15,014 | 697.92 | 0.00 | 1.58 | −0.05 |
| Fulton | 204 | 14,470 | 836.88 | 0.00 | 1.56 | 0.10 |
| Harris | 786 | 129,486 | 1,383.35 | 0.00 | 1.71 | 0.01 |
| Kings | 760 | 64,131 | 230.23 | 0.00 | 1.79 | 0.00 |
| Multnomah | 171 | 11,644 | 528.08 | 0.00 | 1.49 | −0.02 |
| New York | 287 | 29,663 | 353.42 | 0.01 | 1.60 | −0.02 |
| Queens | 668 | 52,269 | 277.52 | 0.00 | 1.82 | −0.04 |
| Richmond | 109 | 7,560 | 657.23 | 0.01 | 1.31 | −0.01 |
| Suffolk | 203 | 11,328 | 283.33 | 0.00 | 1.65 | −0.07 |
| San Francisco | 195 | 12,634 | 269.36 | 0.01 | 1.60 | −0.07 |
| Washington | 104 | 6,281 | 807.59 | 0.00 | 1.31 | −0.04 |
| Wayne | 609 | 41,068 | 393.67 | 0.00 | 1.85 | 0.08 |
节点最少的是 Clackamas,80 个普查区、3,364 条边。平均加权度最高的是 Collin,1,961.72;最低的是 Bronx,198.18。平均最短路径最短的是 Richmond 和 Washington,都是 1.31 步;最长的是 Wayne,1.85 步。同配系数最高是 Fulton 的 0.10,最低是 Suffolk 和 San Francisco 的 −0.07。聚类系数为 0.01 的只有 Clackamas、New York、Richmond 和 San Francisco,其余县在表中为 0.00。路径长度接近 1 到 2 步,说明在这张 2 月汇总网上,多数普查区对只隔一条边或一个中间区。这是网络连通的结果,不能直接换成公里或通勤时间。
重力模型在这里只比较三件事
基本重力模型把 i 到 j 的流量写成两端人口的幂与距离的幂之比:
Fᵢⱼ = G × Pᵢ^β₁ × Pⱼ^β₂ ÷ Dᵢⱼ^β₃
Fᵢⱼ 是移动量,Pᵢ 和 Pⱼ 是起点、终点的人口规模,Dᵢⱼ 是两地距离,G 是比例系数,三个 β 是待估参数。取对数后用普通最小二乘估计:
log Fᵢⱼ = β₀ + β₁ log Pᵢ + β₂ log Pⱼ − β₃ log Dᵢⱼ + εᵢⱼ
β₀ 是截距,εᵢⱼ 同时包含真实误差和测量误差。距离项前面的负号表示:估计出的 β₃ 为正时,距离越远,流量越低。这个式子要比较的是,在已经取对数的流量里,人口和距离各解释多少方差。
方法段写输入是普查区人口密度,公式和结果段写的是起点、终点人口。两套用词没有对照表。图1用质心画点,公式只写 i 与 j 的距离,没有说明是质心直线距离、路网距离还是出行时间。流量为 0 时对数没有定义,论文也没有说明没有出行的区对是删除、保留为 0,还是根本不建边。因此后文的 R² 描述的是进入回归的那些流量,分母是这些观测的方差,不是全县所有可能区对,也不是居民人数。
文献参照是别人的基本重力模型 R² 可以到 0.7,引用包括 Li 等(2020)、Shen(2004)和 Thompson 等(2019)。那是其他数据、其他空间单元上的结果。本文没有把这 18 个县的手机记录再聚合成邮政编码、交通分析区、周或月,然后用同一公式重估一遍。
结果段又把调整后 R² 称作拟合指标,图轴和图例仍标 R²。正文没有并列两套数。下面引用的区间都按作者所写的 R²。
无标度是每个小时的常态,还是只在部分小时靠近?
无标度网络(scale-free network)在这里的操作定义是度分布近似幂律:度为 k 的节点比例 pₖ 约等于 k 的 −γ 次方,γ 是度指数。对数坐标上,log pₖ 对 log k 接近一条直线。论文采用两条宽严不同的习惯:有的研究把 γ 大于 1 就算无标度,更严的要求 γ 在 2 到 3 之间。指数来自度分布在双对数坐标上的回归斜率。总度、入度、出度分开算,所以这张网至少在度分布这一步是按方向看的。
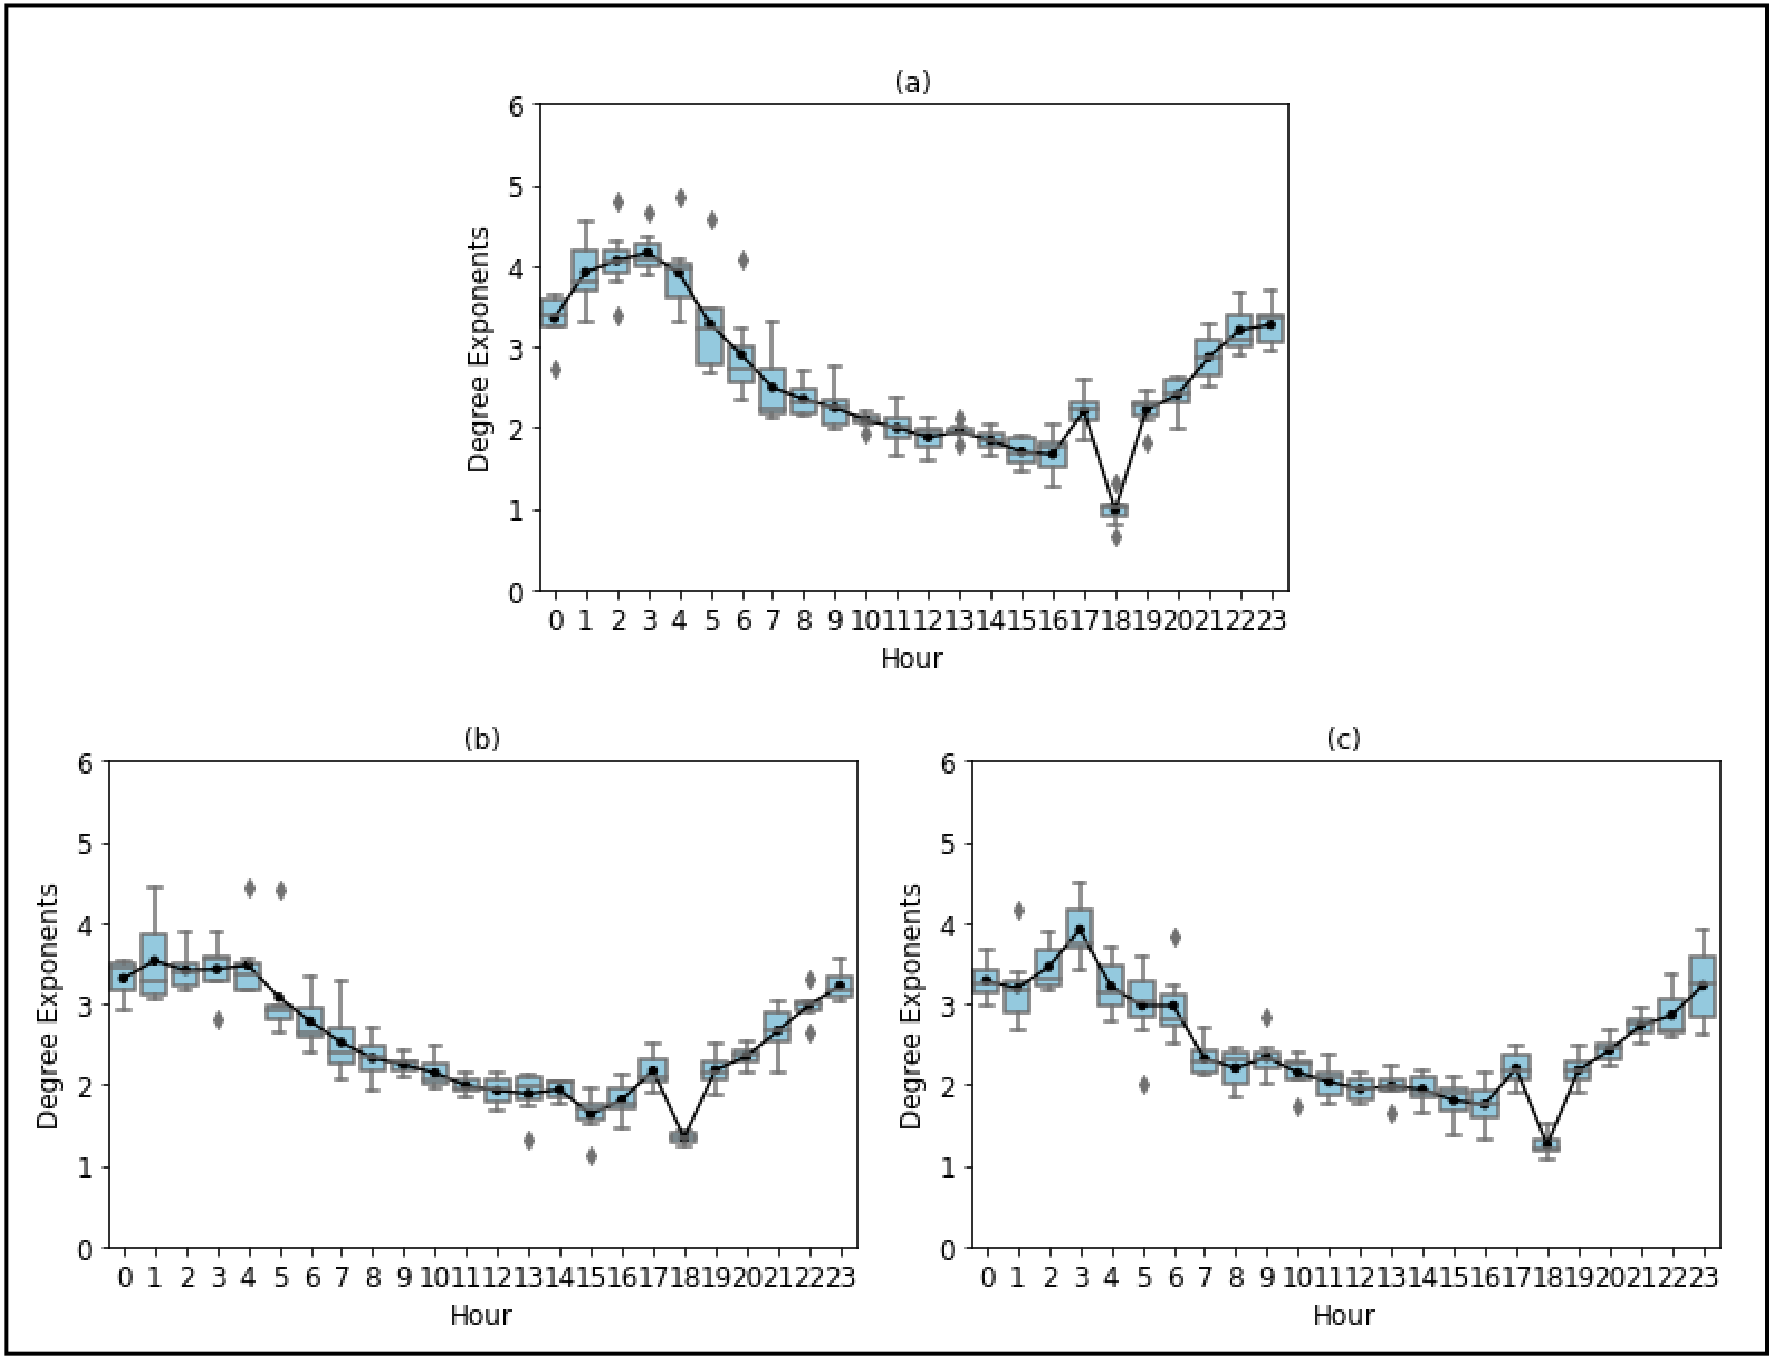
图 2|Harris 县的度指数在一天 24 小时里如何变化?
(a)总度指数。横轴是 0 至 23 时,纵轴是度指数,范围 0 到 6。每个小时一个箱子,概括 2020年2月各天;黑线连接各小时的中心趋势,菱形是箱线外的点。凌晨箱子偏高,午后下降,约 17 时降到靠近 1 的低谷,随后回升。(b)入度指数,起伏与(a)相似,低谷同样在傍晚。(c)出度指数,同样是凌晨较高、午后较低、傍晚有低谷。来源:原论文 Fig. 2。
正文写,小时网络上这条幂律直线的 R² 大约 0.7,指的是 log pₖ 对 log k 的拟合,不是重力模型的 R²。多数度指数大于 1,因此按宽松标准可以说分布像幂律。按 2 到 3 的严格标准,并不是每个小时都算无标度。作者认为高峰时段更接近无标度;图上也能看到午后有一段指数降到 2 附近,而凌晨更高、17 时前后又靠近 1。三种度的形状相似。这张图只覆盖 Harris 县的 2 月小时网。摘要和结尾把“细尺度网络并不总是无标度,强无标度在现实网络里很少见”说成一般结论,其余 17 个县没有对应的指数图。
正文还提到,已有研究里对数正态和拉伸指数往往比幂律更适合描述真实网络。本文没有报告这 18 个县上三种分布的对照拟合。
拟合变差,先出现在小时,再出现在换县之前
重力模型的因变量是每个起讫点对的流量,自变量是两端普查区人口和距离。系数和 p 值用来看方向和是否显著,R² 用来看解释了多少方差。论文没有列出任何一张系数表。
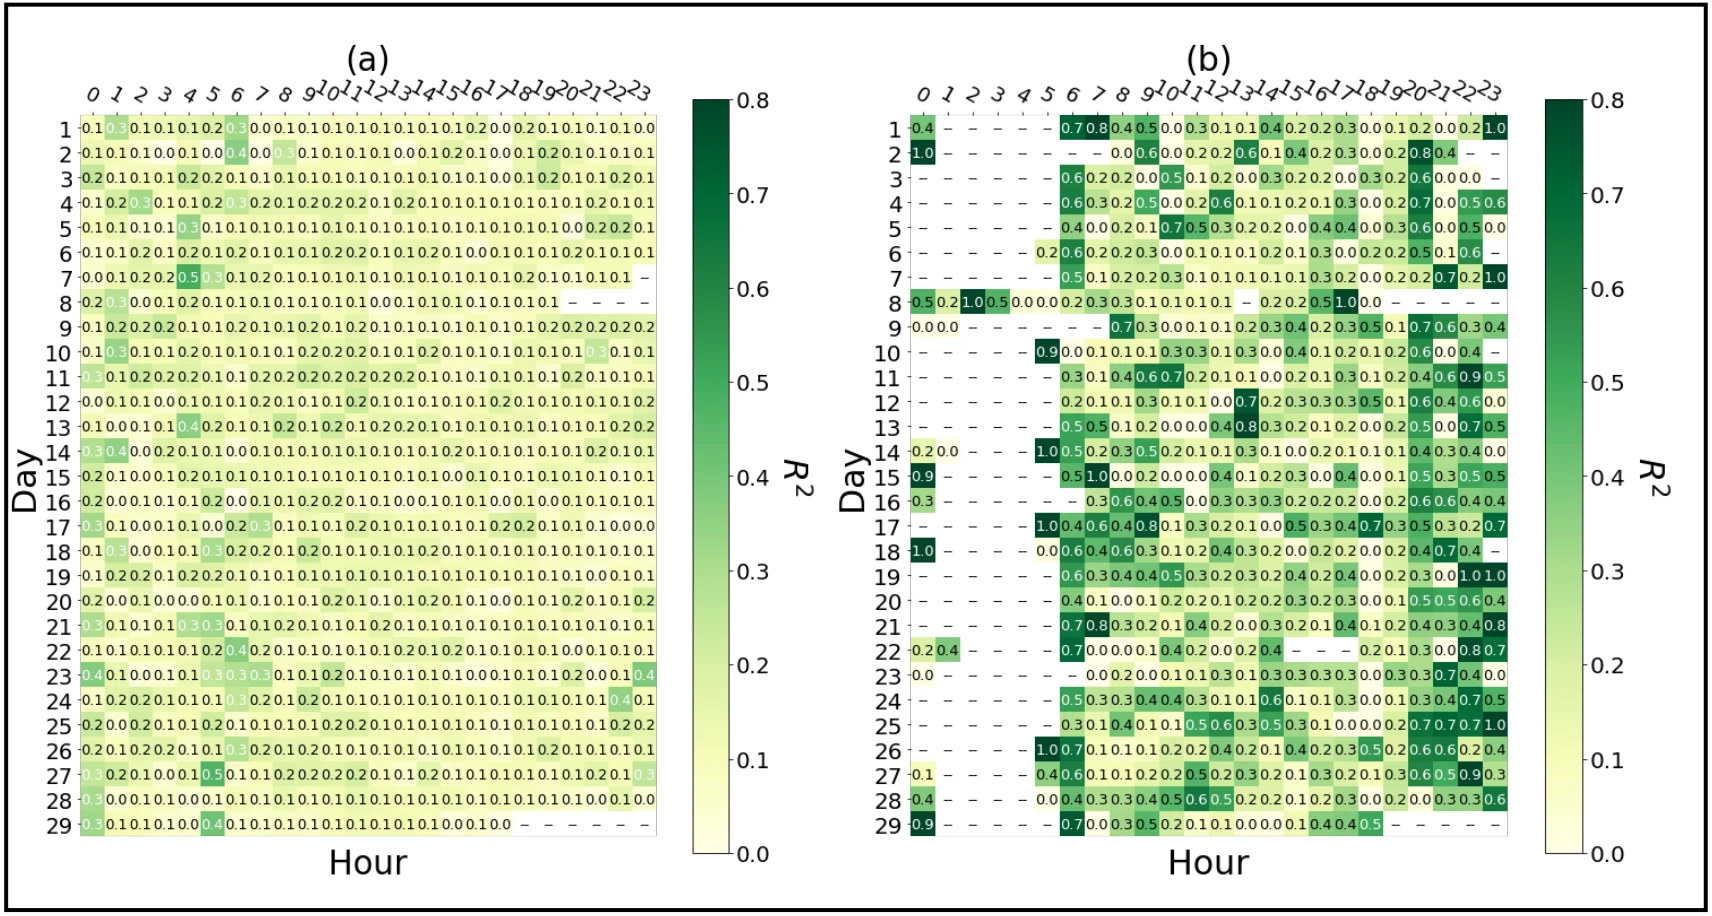
图 3|小时重力模型的 R² 在 2 月的每一天、每一小时有多高?
(a)Harris 县。横轴 0 至 23 时,纵轴是 2 月的第 1 到第 29 天,颜色是该小时网络的 R²,色标从 0 到 0.8,短横线表示数据不足、没有拟合结果。多数格子颜色浅,对应正文所说的多数时段 R² 低于 0.3;个别格子更深。部分日期的深夜或凌晨是短横线。(b)Queens。坐标和色标与(a)相同。夜间短横线更多,颜色深浅的起伏也更大。来源:原论文 Fig. 3。
小时结果只详细画了 Harris 和 Queens。正文说,这一分辨率下三个自变量都不显著,系数波动,对流量大小的说明有限。多数时段 R² 低于 0.3。有些非高峰时段 R² 更高,作者认为可能是因为流量取值很少、变异很小,例如流量几乎都是 1,所以更高的 R² 不能直接读成模型突然变好。县与县之间,有的全天较匀,有的波动更大;图3没有把 18 个县都画出来。
聚合到一天之后,人口变量仍然不显著。紧接着的一句写“当时间聚合是小时移动时,距离变量开始显著”。这句话和小时结果节“三个自变量都不显著”对不上。同一段后面又写:距离对流量是负效应,这与“越近、交互越强”的模型假设一致,日尺度 R² 大约在 0.2 到 0.6。讨论和结尾把距离称为三个变量里最显著的一个,并写距离的显著性在细粒度数据里下降。由于没有系数和 p 值,只能保留这个矛盾:小时节说全不显著,日尺度节的文字把显著算到了小时距离上,后文又把距离当作最显著变量。能够稳妥复述的是作者给出的方向和区间,不是一张隐含的显著性清单。
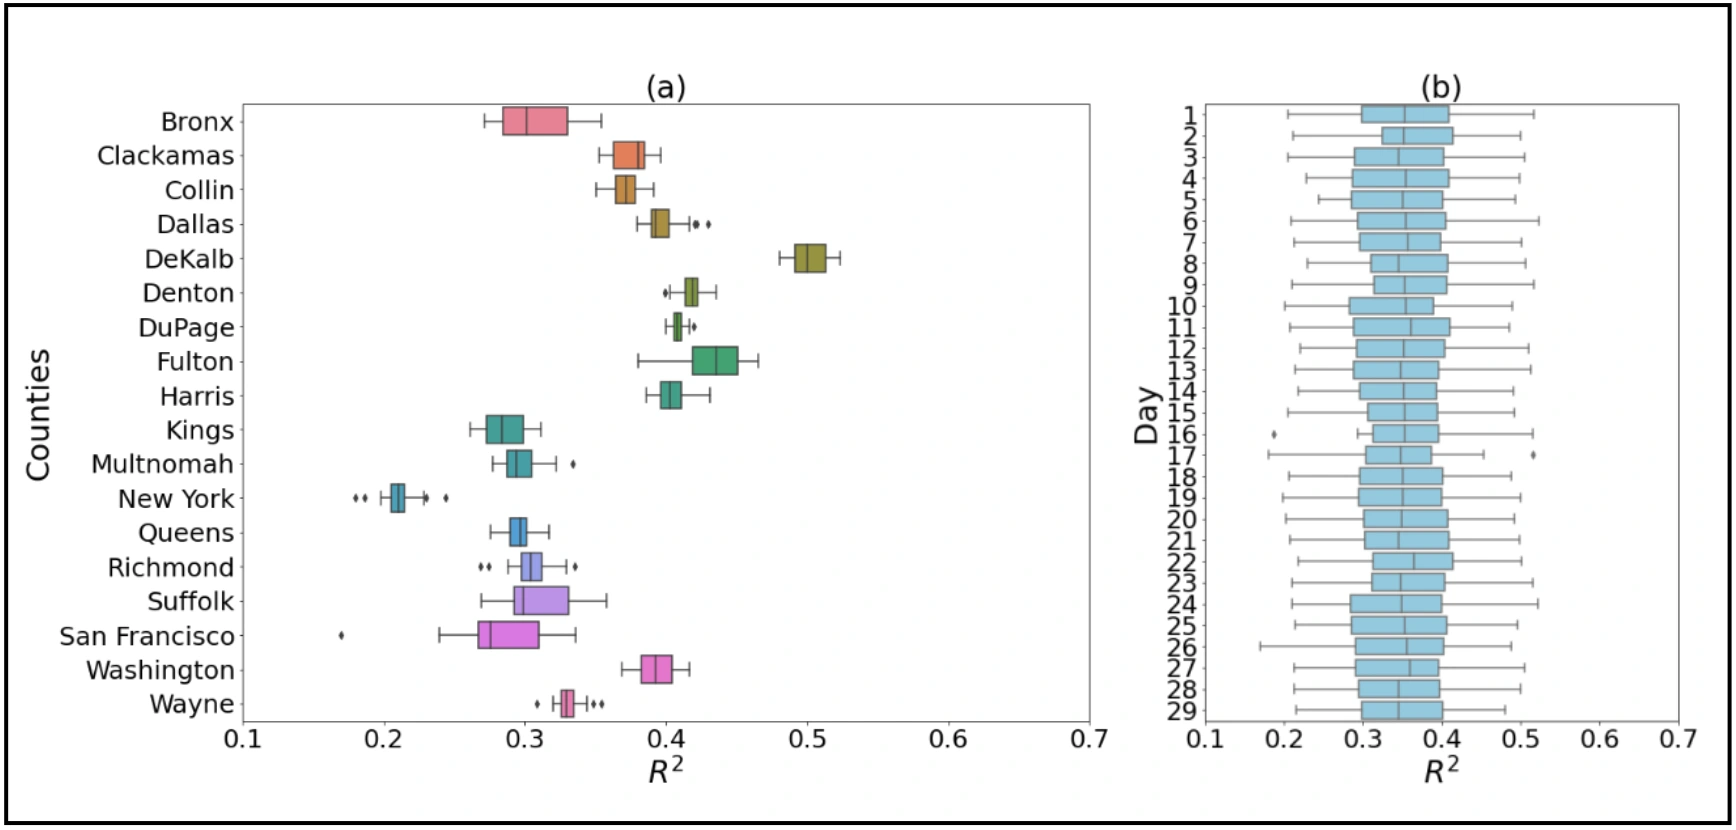
图 4|日尺度 R² 是县与县差得多,还是一天和另一天差得多?
(a)18 个县各自的日 R² 分布。纵轴是县,横轴 R² 大约从 0.1 到 0.7。DeKalb 的箱子最靠右,New York 县最靠左;各县箱子较窄,县与县分开。全部箱子落在正文给出的大约 0.2 到 0.6 这一带,正文没有逐县列出中位数。(b)2 月第 1 到第 29 天。每一天一个箱子,概括当天各县的 R²,各天的位置和宽度相近,少数天有离群点。来源:原论文 Fig. 4。
作者还把数据再收成星期几,例如所有周一相对所有周三。他们写网络结构在相同星期几上大体保持,日聚合之后 R² 的县内方差更小,整体拟合没有因此再提高。工作日的 R² 略高于周末,差异不显著。星期几没有单独的图,也没有给出周一、周日各自的 R²。
所以,从小时收到一天,R² 的区间从“多数低于 0.3”升到“大约 0.2 到 0.6”。这个提升仍然低于别人在更粗时间、更粗空间单元上报告的约 0.7。比较的基线是其他论文的 R²,不是本文自己的粗尺度对照实验。
人口密度和网络大小,没有把偏低的拟合救回来
接下来的散点主要使用日聚合网络。作者要看的是:拟合差,是不是只发生在某几类县。
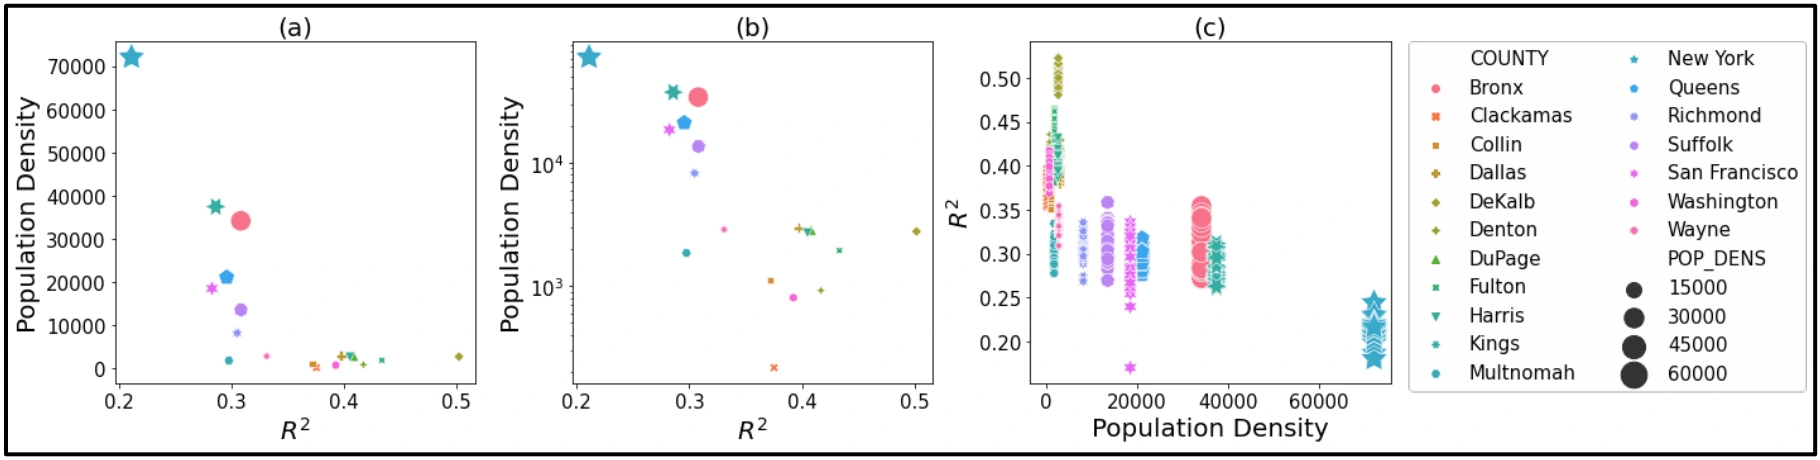
图 5|县的人口密度越高,日尺度 R² 是否越低?
(a)横轴是平均 R²,纵轴是人口密度。一个县一个点,颜色区分县;图例另用点的大小表示人口密度,刻度为 15000、30000、45000、60000,图上没有写单位。高密度的点偏向左侧较低的 R²。(b)纵轴改成人口密度的对数,横轴仍是平均 R²,高低密度县被拉开,低 R² 仍多出现在纵轴上方。(c)横轴是人口密度,纵轴是逐日 R²,同一县的多天叠在相近的密度上。来源:原论文 Fig. 5。
正文的读法是:人口密度较高的县,平均 R² 倾向于更低。作者给出的解释是,高密度县里普查区之间距离更短,人口和距离这两个变量的区分度变弱;同样的聚合水平下,高密度县数据点更多、网络更密、边上的出行变异更大。低密度县看起来拟合更好,也可能只是因为边上流量的方差更小。这是对散点趋势的解释,不是把人口密度随机化之后的因果估计。图5的人口密度是县的量,用来和该县的 R² 对照;它和回归式里那个普查区人口(或人口密度)系数不是同一个数。
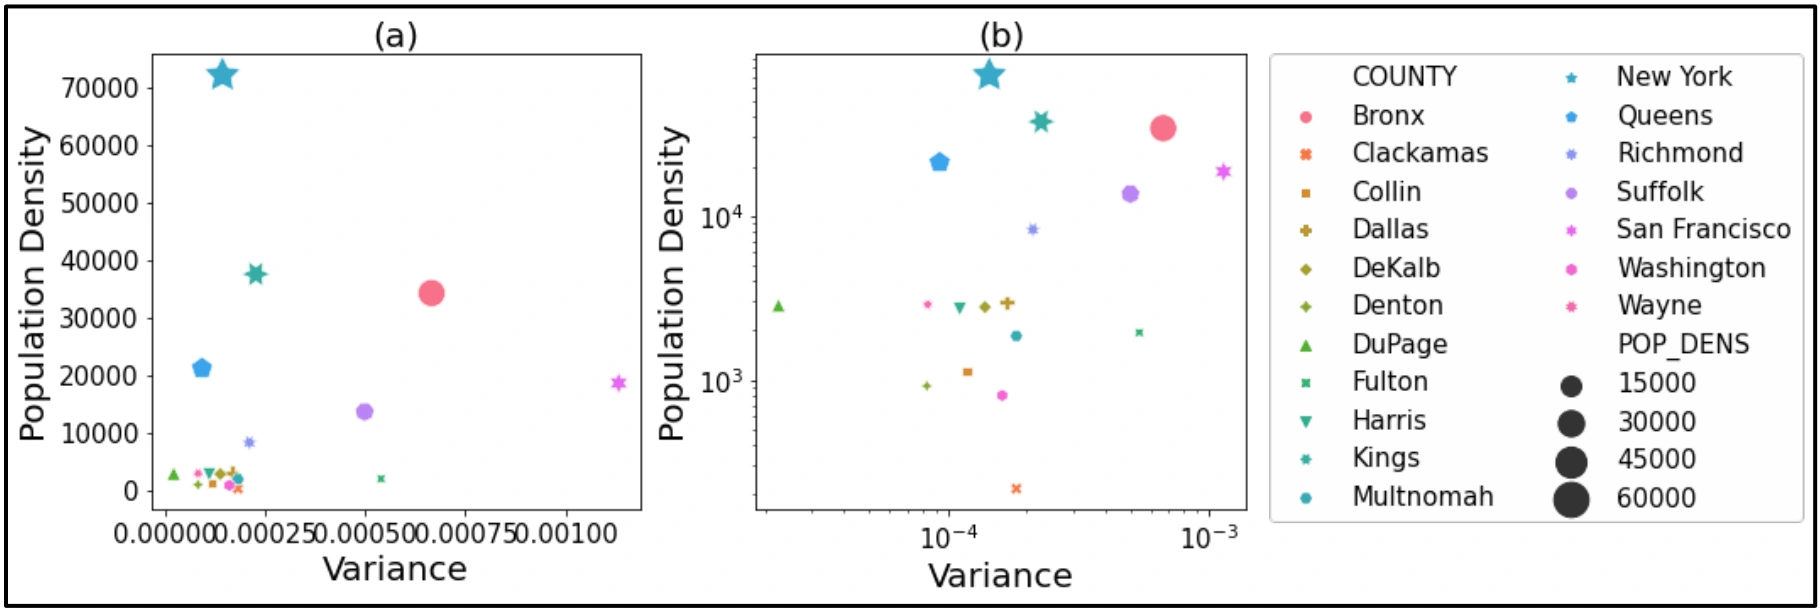
图 6|R² 的日波动是否也跟着人口密度变大?
(a)横轴是各县 R² 的方差,纵轴是人口密度。方差轴的刻度很小,与正文“各县方差都很小”一致;密度较高的县偏向方差更大的一侧。(b)纵横轴都取对数后,这个“密度高、方差高”的倾向更清楚。颜色和图例与图5相同。来源:原论文 Fig. 6。
方差小,说明图4里同一县各天的 R² 确实挤在一起。密度和方差的关系,解释的是拟合稳不稳定,不是流量本身由密度决定。
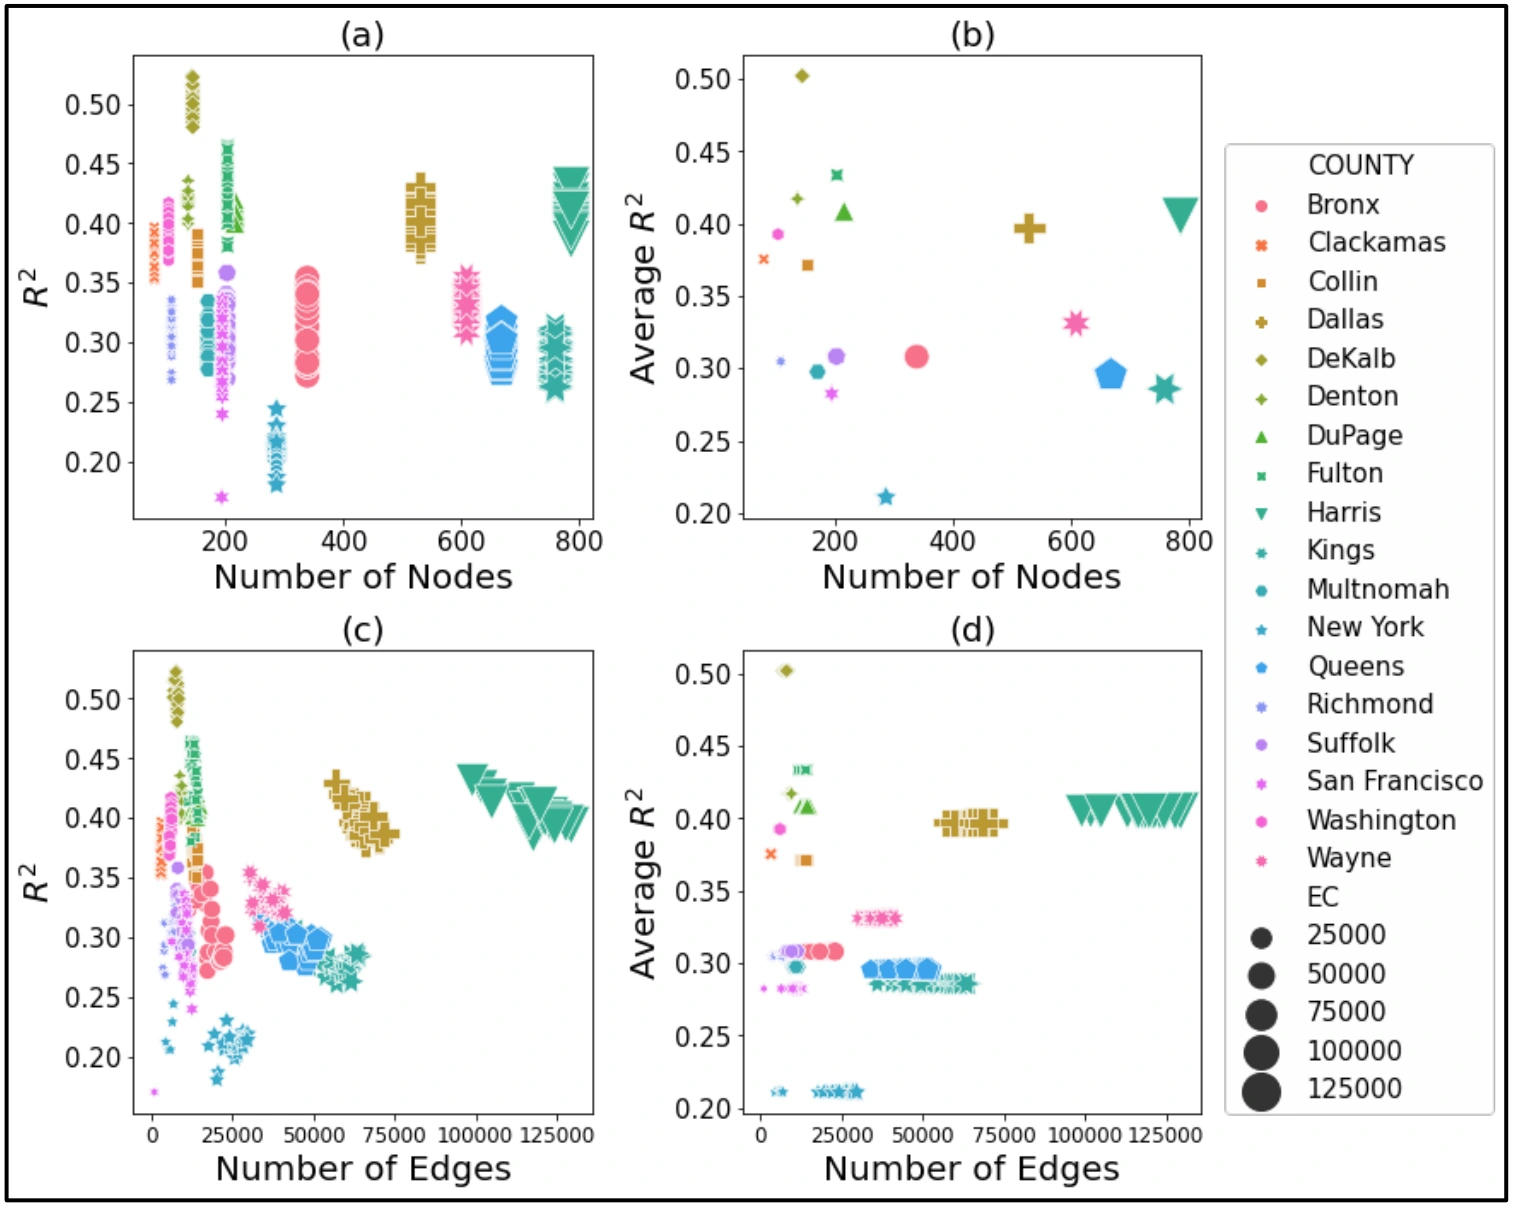
图 7|网络越大,重力模型是否越差?
(a)横轴是节点数,纵轴是逐日 R²。同一县的点聚成一簇,跨县没有形成一条显著的斜线。(b)纵轴改成该县平均 R²,每个县接近一个点,大县和小县都有高有低。(c)横轴改成边数,逐日 R² 仍按县成簇;作者认为县内部可能是边越多、R² 越低。(d)边数对平均 R²,跨县仍然看不出显著关联。图例用颜色区分县,并用点的大小表示边数,图例刻度从 25000 到 125000。来源:原论文 Fig. 7。
日聚合下,一个县的节点数和边数各天几乎不变,所以散点会叠成短簇。作者写,跨县没有显著关联;县内部则可能边越多、R² 越低,并认为这与高人口密度县拟合更差的方向一致。节点数差一截,边数可以差很多。这个几何关系单独画在图8。
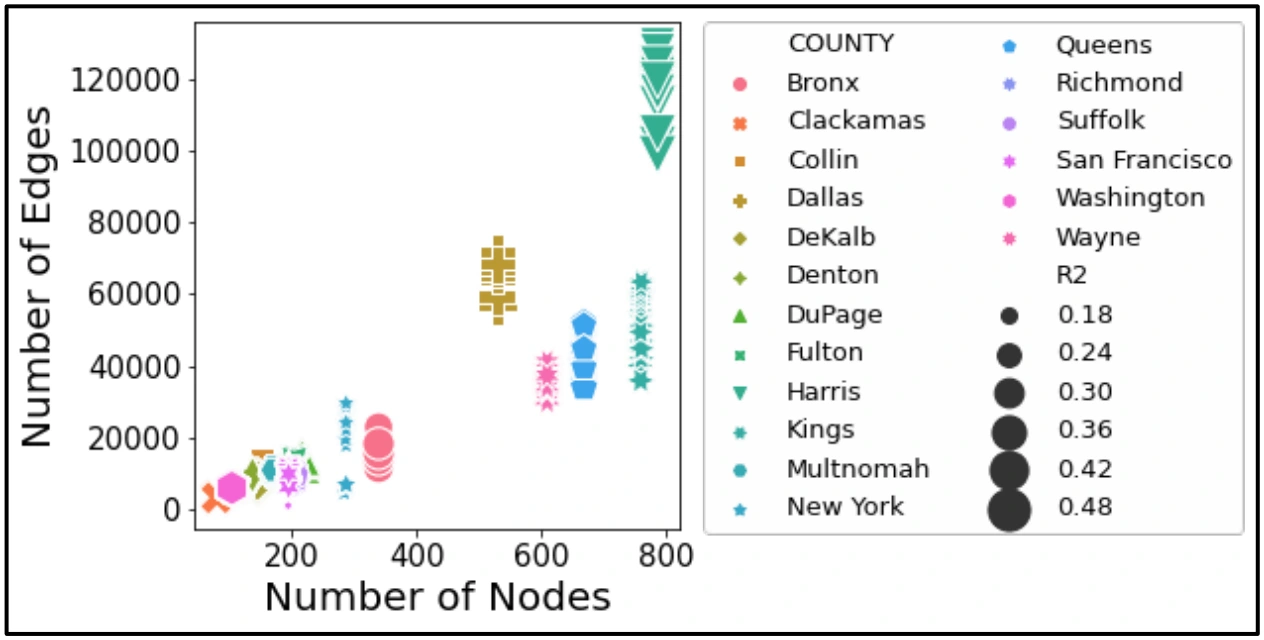
图 8|节点只多一些,边会多出多少?
横轴是节点数,纵轴是边数。Harris 位于最右上,节点接近表1的 786,边数超过 120,000,与表1的 129,486 条边同一量级。节点较少的县挤在左下。点的大小在这张图的图例里表示 R²,刻度从 0.18 到 0.48,颜色仍是县。来源:原论文 Fig. 8。
图8说明网络规模在县与县之间差很大,而且边数比节点数涨得更快。它本身不估计重力模型。和表1合在一起看,2 月汇总的边数与逐日散点的位置大体相符;逐日点数略有上下,正文说这种上下很小。
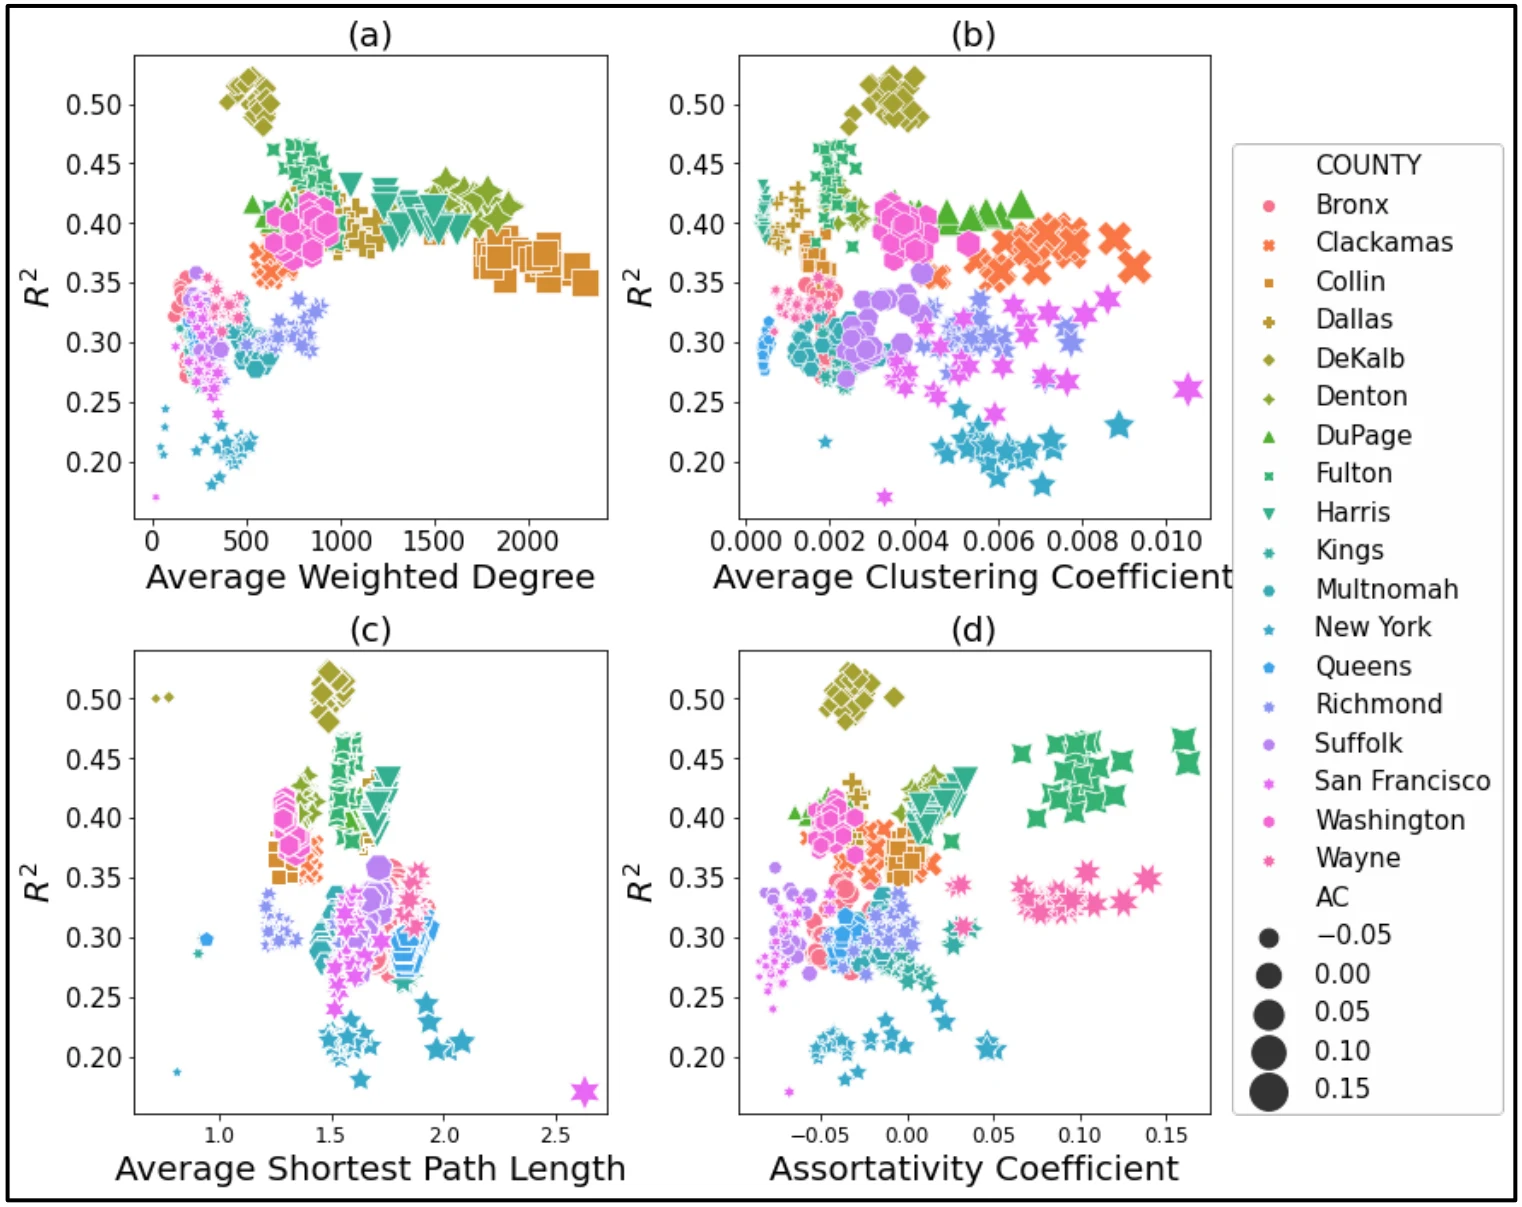
图 9|加权度、聚类、路径长度和同配,有没有哪一个把 R² 拉开?
(a)横轴是平均加权度,纵轴是 R²。加权度处在高低两端的网络,R² 也倾向落在高低两端;中间一大片县混在一起。(b)横轴是平均聚类系数,刻度只到 0.01。所有县都挤在很低的聚类上,R² 仍从大约 0.2 铺到 0.5 以上。(c)横轴是平均最短路径长度。作者认为路径更短可能意味着存在枢纽、结构更像无标度,从而拟合更好;图上短路径并不对应唯一的高 R²。(d)横轴是同配系数。各县逐日的点分布在 0 附近并向两侧散开,没有按度数分成两团。图例用点的大小表示同配系数,刻度从 −0.05 到 0.15。来源:原论文 Fig. 9。
表1的聚类系数多为 0.00 或 0.01,图9把逐日的聚类画在 0 到 0.01 之间,两者口径一致:这些网上三角形很少。同配系数接近 0,表示高度数普查区没有明显只连接其他高度数区,也没有明显只连接低度数区。作者的总结是,规模较小、平均距离较低的部分县拟合略好,但所有县都低于以往粗尺度研究报告的水平。图9没有直接画出平均距离,路径长度是步数。略好仍是样本内 R² 的高低,而且跨县的总体关联作者自己写成不显著。
这些数能支持到哪一步
基本重力模型在这批普查区小时网和日网上的样本内 R²,低于其他研究在更粗聚合上报告的约 0.7。小时到日的改善是真实写出的区间变化:多数小时低于 0.3,日尺度大约 0.2 到 0.6。距离在讨论里被赋予负向、相对最显著的角色;人口变量被写成不显著。因为系数表缺失,小时与日两段文字又互相冲突,距离的显著性不能写成一个已经复核的 p 值。
无标度的直接证据是 Harris 县一张小时指数图,加上大约 0.7 的幂律直线 R²。把它推广成“细尺度城市出行网都不无标度”,靠的是摘要和结尾的概括,不是 18 个县各自的度分布。
县人口密度、节点数、边数和四种网络指标解释的是“哪类县的 R² 更高一点”。跨县的规模关联不显著,密度与平均 R² 的方向是高密度对应更低的 R²。这不能换成“普查区人口密度不推动人流”的回归结论。结尾写“普查区人口密度对跨区人流不起关键作用”,把县密度与 R² 的关系和回归里不显著的人口变量放到了一起。两件事在文中的分析单位不同。
模型没有加入兴趣点、土地利用或社交联系。讨论把这些列为以后可以加入的因素,也提到机器学习是一条可能的路线。正文没有训练这类模型,因此没有它们相对重力模型的误差差。DeepMove 在讨论里被点名,句子没有写完具体能力,不能当成一项已完成的比较。
X-Mode 的 5000 万台设备和每天 20 亿到 30 亿条位置,是公司采集规模。18 个县的设备数、停留定义(停多久才算一个停留点)和样本占人口的比例都没有给出。选择共享位置的手机用户也不是全县居民的随机样本。2020年2月被作者定为扰动前的对照月,结论限于这一个月、这些县、普查区这一级。
一句话总结
在 18 个美国都市县、2020年2月、普查区到普查区的小时和日人流上,基本重力模型用人口和距离做样本内拟合,R² 低于粗尺度文献常报告的水平;县与县的密度和网络结构改变不了这个总的判断。
核心来源
Hsu, C. W., Fan, C., & Mostafavi, A. Limitations of gravity models in predicting fine-scale spatial-temporal urban mobility networks. arXiv:2109.03873,2021年9月8日提交。https://arxiv.org/abs/2109.03873。Research Square 预印本,2023年2月6日,DOI:10.21203/rs.3.rs-2547382/v1。论文致谢美国国家科学基金会 CRISP 计划、得克萨斯农工大学 X-Grants、Microsoft Azure,以及 X-Mode 提供的数据。文中观点不代表资助方和数据方。数据需向 X-Mode 申请,代码向通讯作者索取。正文没有补充材料章节。
Chia Wei Hsu 是论文通讯作者,署名为得克萨斯农工大学 Zachry 土木与环境工程系。2023年交通研究委员会的会议简介写他当时是该校 UrbanResilience.AI 实验室的博士生,关注城市韧性、人类移动性和网络分析。该实验室成员页现列他为成功大学助理教授、实验室前博士生。
Chao Fan 与上述作者共同署在同一系。得克萨斯农工大学图书馆保存的 2020 年博士论文由 Ali Mostafavi 指导,主题是洪水应急中的网络动态。实验室成员页写他曾在该组攻读博士并做博士后,之后在克莱姆森大学任助理教授。
Ali Mostafavi 在得克萨斯农工大学工程学院教师页上是土木与环境工程系教授,头衔为 Zachry Professor in Design & Construction Integration II,并在计算机科学与工程系兼聘,负责 UrbanResilience.AI 实验室。教师页列出的研究方向包括城市韧性、网络与复杂系统、城市计算、灾害信息学和应用人工智能。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果城市规划部门用基本重力模型补全省普查区、逐小时的缺失人流,补出来的矩阵会跟着人口和距离走。Harris 与 Queens 在同一个下午 6 时的连线密度已经差得很远,而小时拟合里这三个变量又不显著。补全结果可以在账面上很完整,同时躲开这一小时真正繁忙的那些区。日尺度 R² 升到 0.2 至 0.6 之后,仍然留下一大半方差。用这张日矩阵去排班或做接触估算,误差的主要来源会是模型没写进的土地使用和出行目的,而不只是县的大小。
用 R² 给城市的模型采购打分也会混进密度。图5里高密度县的平均 R² 更低,图6里它们的日波动方差也倾向更大。New York 县拟合低、DeKalb 拟合高,可能同时反映密度、流量方差和模型失败。把“R² 更高的县”当成重力模型更适用的城市,会偏向低密度、流量变异更小的网络。这个排序需要在相同的流量方差下再比一次,论文没有做。
Harris 县 17 时前后度指数掉到 1 附近。若防疫或交通模型先用全天网络认定存在枢纽,再把枢纽的连接强度用到每一个小时,傍晚这一档的度分布可能已经离开白天的形状。要检验这一点,得把同一套枢纽定义套到每个小时的网上,看被标成枢纽的普查区是否还是那几个。论文只展示了一个县的指数,这项检验仍然空着。