下一站的选项里,包含了这一步根本到不了的地方吗?
论文名片|Gavin Smith、Romain Wieser、James Goulding、Duncan Barrack,A Refined Limit on the Predictability of Human Mobility,2014 IEEE International Conference on Pervasive Computing and Communications (PerCom),布达佩斯,2014年3月24–28日,第88–94页。DOI:10.1109/PerCom.2014.6813948。这是一篇同行评审的会议论文,用信息论上界重新计算 GPS 轨迹的下一步可预测性;文末附录 A、B 是证明。
假如导航在下班时说,五分钟后你还在这栋楼里。它手里只有过去的定位点。2010 年 Song 等人用手机基站记录估计,逐小时位置的理论上限大约是 93%。后来的研究把格子收到大约一栋楼的大小,用相近办法,摘要所转述的上限仍大约是 90%。听上去,下一站几乎已经被历史轨迹决定了。
这篇论文检查的是这个上限的算法。旧公式把一个人出现过的全部地点都留在候选里,再把“不是最可能那一格”的剩余概率,平均铺到其余每一个地点上,其中包含这一步到不了的地点。把剩余概率只分给轨迹里真正出现过的下一格之后,上限会下降,而且格子越细,下降越大。在约 100 米见方的格子上,下降大约是 11 到 24 个百分点。在约 70 米见方、每 5 分钟预测一次时,收紧后的上限是 57.33%,计算用的是筛出的 42 人。这里的百分比是信息论上限:理想预测器在历史轨迹条件下,对下一步猜中的比例最高能到哪里。论文比较的是两种上限公式,没有训练一个已经达到这些百分比的预测器。
先说结论
- Geolife 收录 182 人、长达五年的 GPS 轨迹。熵率估计能够使用的是 42 人。预测任务是一次出行轨迹内部的下一步位置,长时间没有 GPS 的空隙不补成“人还停在原地”。
- 在与 Song 等相近的量化水平上,旧公式给出的上限是 81.45%–85.57%,对照他们报告的 93%。任务里少了大量容易猜中的静止时段。本文的熵估计也与 Song 等略有差别,两条估计只在序列无限长时收敛到同一值。
- 新公式把剩余概率分给 Nr−1 个可达地点。9 种空间格子和 6 种时间间隔组成 54 个组合,平均上限下降 12.9 个百分点。按步行 5 km/h,一个时间步内能够跨出格子的 37 个组合,平均下降 17.69 个百分点。
- 9896 m² 这一行,六格的下降是 11.29 到 24.03 个百分点。2474 m²、5 分钟的收紧上限是 57.33%(42 人)。618 m²、1 小时低至 22.84%,这一格只有 7 人。
93% 量的是人停在哪里,还是下一步挪到哪里?
可预测性在这里有一个操作定义:按固定时间间隔,给出下一步最可能的地点,再对整条轨迹取猜中概率的平均。历史上的全部路径都假定已知。任何算法最多只能每次选择条件概率最大的那个地点,因此存在一个最大可预测性。真实的条件概率分布拿不到,能够计算的是它的上限。
Song 等人的 93% 来自基站记录,采样被调整到大约 1 小时,基站接收范围大约是数平方公里。那个任务把每个小时都放进序列,人连续几小时留在同一基站附近,也算猜中。本文把问题收成轨迹内的移动:只在同一次出行里、固定时间间隔上预测下一地点。轨迹以外、GPS 没有记录的长时间空白,不再填成停留。Geolife 本身就是轨迹数据,这样做也避免用启发式去编造缺失点。
因此,即便先不改公式,本文用旧公式得到的数字也会低于 93%。正文写,在 Song 等使用的同类量化水平上,上限是 81.45%–85.57%。图 4 左图在 1 小时、2.53 km² 与 10.13 km² 两格分别是 81.48% 和 85.57%。0.03 个百分点的差别留在正文与热图之间,不影响“明显低于 93%”这个方向。
和 Lin 等人的 Geolife 分析比,也有同一方向的差距。对方在约 350,000 m²、5 分钟时报告约 98.5%,本文正文写自己的对应范围是 93.05%–94.7%。热图上,158,347 m² 与 633,388 m² 在 5 分钟的旧公式结果是 93.05% 和 94.85%。时间间隔放到 1 小时,对方约 91.7%,本文是 74.23%–78.20%,与这两格在 1 小时的 74.23%、78.20% 一致。正文有一处把这个 1 小时写成 spatial quantization;上下文说的是时间变粗以后不确定性上升。这些对照数字是本文对前人结果的转述。差距符合预期:时间步变长,下一步可以落在更远的地方;再去掉大量“没动”的时刻,上限会进一步下降。
把剩余概率铺满所有格子,上限为什么会偏高?
上限来自熵率。熵率低,表示知道过去之后,下一步新增的不确定性小,可预测性可以高。直接计算真实熵率不现实,因为生成轨迹的随机过程未知。做法是用一个人的历史符号序列估计熵率,再反解出与这个熵率相容的最高猜中概率。
反解时要替未知的下一地点分布找一个熵更高的替身。旧替身保留最可能地点的概率 π,把剩下的 1−π 平均分给其他 N−1 个地点。N 是这个人出现过的不同地点数。平均分配比真实分布更“散”,熵只会升高或持平,所以解出来的 π 是上限。
问题出在那些概率为零的地点。从一个地点出发,下一步到不了的格子,真实概率是 0。旧替身仍给它们分到一份概率,等于把不确定性算大了。熵被抬高之后,反解出来的猜中概率也偏高。格子越细,去过的地点很多,真正能一步到达的地点却增加得慢,这种抬高越明显。
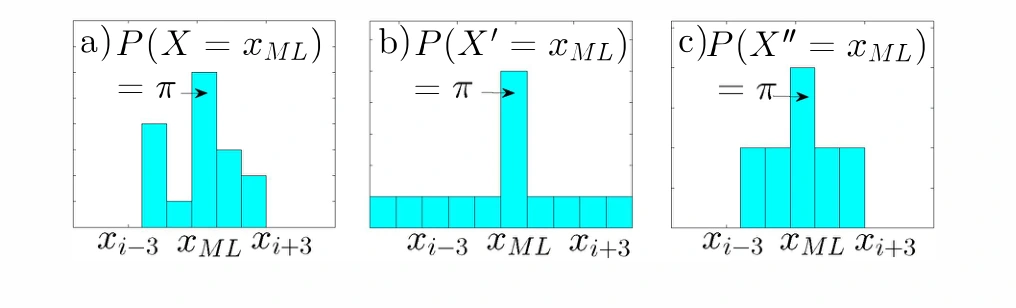
图 1|三种下一地点分布,哪一种把概率分给了到不了的格子?
(a)示意一条未知的真实分布。最高的一根柱是最可能地点,概率为 π;有的地点概率较低,还有的地点因为到不了而是 0。
(b)Song 等的替身。π 保持不变,其余概率平均铺到图上其他每一个地点,包含到不了的地点。这是熵最高的一种画法。
(c)本文的替身。π 仍保留,到不了的地点继续为 0,剩余概率只在能够到达、且不是最可能地点的那些柱之间平均分配。它的熵高于(a),低于(b)。零放在哪几根柱上不影响熵,所以不必知道具体是哪些格子到不了,只需要知道有多少个非零地点。来源:原论文 Fig. 1。
设当前地点下一步最多对应 Nr 个概率不为零的地点,其中已经包含最可能的那一个。新的熵函数是
H′(π) = −π log₂π − (1−π) log₂( (1−π) / (Nr−1) )。
经验熵率等于 H′(Π) 时,用数值方法解出的 Π 就是收紧后的上限。证明沿用 Fano 不等式的思路:猜错的概率是 1−π;在至少有 N−Nr 个地点概率为零的条件下,猜错之后的剩余不确定性不超过 log₂(Nr−1)。只有 Nr 个非零结果的分布,熵本身也不会超过 log₂ Nr。
因为 Nr 小于或等于 N,同一 π 下新函数的熵更低。熵率已经由数据固定,候选变少之后,必须把 π 降下来,分布才会“足够散”,从而凑够原来的熵。所以上限下降。图 2 画的是旧函数随地点数变化的形状,用来说明地点数越多,同一熵率所允许的 Π 越高。
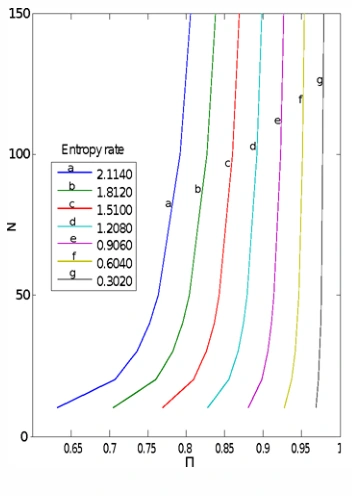
图 2|候选地点变多时,同一熵率允许的猜中概率如何上升?
无字母子图。横轴 Π 是最可能地点的概率,大约从 0.65 到 1;纵轴 N 是候选地点数,从 0 到 150。七条曲线是不同熵率:a 到 g 依次为 2.1140、1.8120、1.5100、1.2080、0.9060、0.6040、0.3020。同一条曲线上,N 越大,对应的 Π 越高。这是公式 H(Π, N) 的单调性,不是 42 个人的实测熵,也不能单独读成某个人的预测准确率。来源:原论文 Fig. 2。
可达地点数,是从轨迹里数出来的
Nr 按每个人自己的符号序列计算。对这个人到过的每一个地点,数他下一步实际去过多少个不同地点,再取其中的最大值。公式里所有地点共用这一个 Nr,取最大是为了不把死胡同的少出口当成全程的出口数,避免把上限压得过低。
这个数来自已经发生的转向。一个人从未走进、但路上其实进得去的商场,不会进入 Nr。论文脚注也写到,人们经常不去自己能够到达的地方。另一方面,它又比“把地图上每一个格子都算作候选”小得多。格网可达、与个人无关的地面覆盖图,或者按这个人一辈子到过的全部地点来设定候选,都会把 Nr 放得过大。
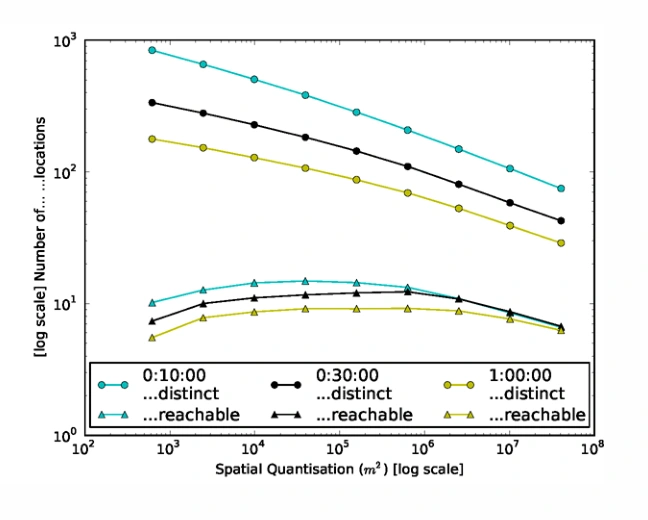
图 3|格子变细以后,去过的地点和可达地点差开了多少?
无字母子图。横轴是空间格子面积,对数坐标,向右格子变大;纵轴是地点个数,同样是对数坐标。圆点是不同地点数,三角点是可达地点数。青、黑、黄三条线对应 10 分钟、30 分钟和 1 小时。圆点整条位于三角点之上;格子变大时,去过的地点下降,可达地点变化小得多,两条曲线在细格子一端分得更开。这张图统计的是 Geolife 的全部轨迹,用来说明 N 与 Nr 的差距,还不是后面 42 人的可预测性上限。来源:原论文 Fig. 3。
空间位置用 HEALPix 收成地球上的等面积格子。正文比较九档面积:618 m²、2474 m²、9896 m²、39586 m²、158347 m²、633388 m²、2.53 km²、10.13 km²、40.54 km²。图上同时标出格子的最大直线跨度,分别约 35 m、70 m、141 m、281 m、563 m、1.1 km、2.3 km、4.5 km、9 km。9896 m² 的边长约 99.5 米,所以摘要说的大约 100 米乘 100 米,和轴上的 141 米对角线指的是同一档格子。时间间隔是 5、10、15、30、45 和 60 分钟。
黑线标的是步行能不能在一步之内离开格子
热图上的黑线用的是另一把尺子:偏好步行速度 5 km/h。线以下的组合,是按这个速度、在一个时间步内能够沿最大直线跨度走出当前格子的那些档。9 km 的格子大约要走 1.8 小时,六个时间步都留在线以上。4.5 km 大约要 54 分钟,只有 1 小时那一格落到线以下。563 米大约 6.8 分钟,5 分钟跨不出,10 分钟及更长可以。281 米和更细的格子,5 分钟也跨得过。按这个规则数,线以下是 37 个组合。
Geolife 里有步行,也有其他交通方式。论文引用的用户指南中,带标签的数据里约 41% 被标成步行。线以上的格子对“下一步还在原格”特别有利:很多人一步之内走不出去,预测“没动”会因为格子太大而经常正确。线以下才是下一步预测更有信息量的区域。黑线不删除开车或坐车的轨迹,它只是给读图时的这种优势划一条参照。
182 人里,熵率估得住的是 42 人
Geolife 是经纬度点,没有 GPS 时该点就缺着,182 人的轨迹长短和采样率差别很大,时间跨度五年。熵率用 Lempel–Ziv 型估计:Λᵢ 是从第 i 步开始、此前没有出现过的最长片段长度;从第 2 步加到序列末尾,计算 Λᵢ / log₂ i 的平均,再取倒数。序列无限长时,估计收敛到真实熵率。这个版本与 Lin 等使用的估计相同,与 Song 等略有不同。作者在合成数据上的初步试验认为它收敛更快。试验细节没有写进正文。
若一个人的估计熵率已经高于 log₂(Nr),也就是高于“Nr 个非零地点”所能具有的最大熵,这个人被排除。剩下的人再看熵率随时间是否收敛,明显不收敛的、通常也是点数太少的,继续排除。最后是 42 人,脚注给出了他们在 Geolife 中的编号。
并不是 54 个格子都有这 42 人。空间越细、时间越长,点数越少,重复模式越稀,熵率越难估。热图括号里的数字就是该格实际人数;没有括号表示 42 人。论文还提醒,格子细到 GPS 误差附近时,位置本身会不可靠;时间间隔过长时,点数又不够。
收紧之后,上限在细格子上掉得最多
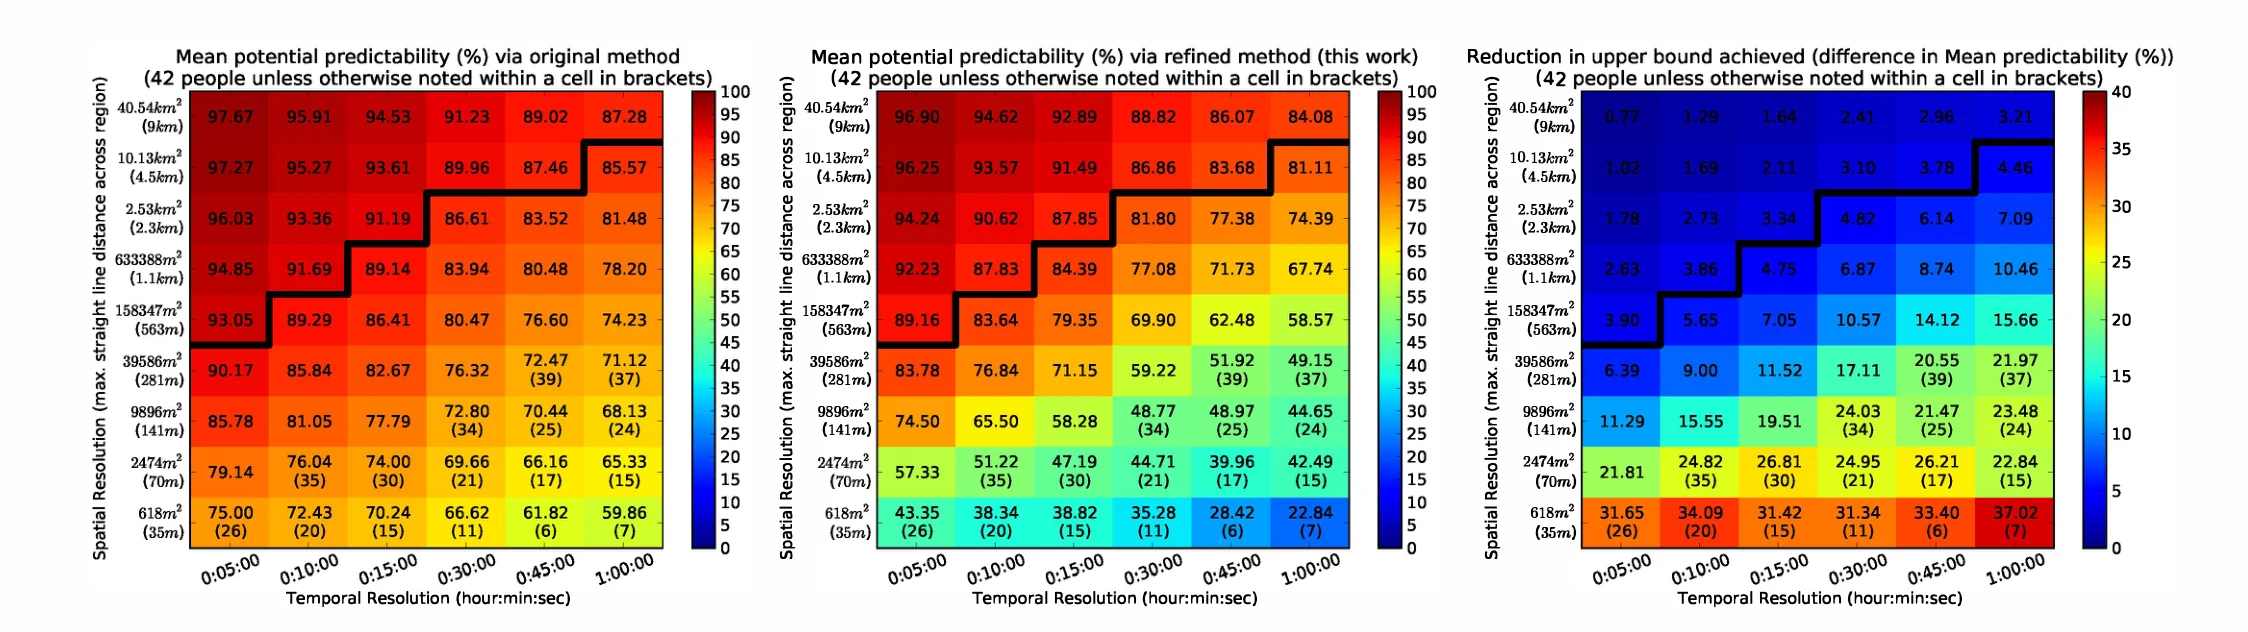
图 4|候选收紧以后,不同时空粒度的上限下降多少?
三块热图没有子图字母,从左到右对应原文的 LEFT、MIDDLE、RIGHT。纵轴是空间格子,上方格子大;横轴是时间间隔,从 5 分钟到 1 小时。括号是不足 42 人时的人数。黑线以下表示按 5 km/h 可以在一个时间步内跨出该格。
(左)旧公式的平均上限,颜色从约 60% 的黄绿到接近 100% 的深红,色标 0–100。粗格子、短时间多为 90% 以上;618 m² 这一行降到 75.00%–59.86%,且六格分别只有 26、20、15、11、6、7 人。
(中)本文公式的平均上限,色标同样是 0–100。同一位置普遍更低。2474 m²、5 分钟是 57.33%,这一格没有括号,即 42 人。618 m²、5 分钟是 43.35%(26 人),1 小时是 22.84%(7 人)。
(右)左减中,单位是百分点,色标 0–40。粗格子多为不到 5 个百分点的深蓝;9896 m² 这一行是 11.29 到 24.03;618 m² 这一行是 31.65 到 37.02,颜色最深。来源:原论文 Fig. 4。
54 个组合的平均下降是 12.9 个百分点,等于右图 54 格的算术平均。线以下 37 个组合的平均下降是 17.69 个百分点。人数不足 42 的格子集中在细格子和长时间隔。按热图括号清点,线以下有 21 个组合仍是 42 人,平均下降 10.4 个百分点;42 人齐全的组合共 38 个,连同线以上的粗格子一起平均,下降 6.86 个百分点。
约 100 米见方的 9896 m²,摘要写上限比以往低 11%–24%,正文写 10%–24%。右图这一行的六格是 11.29、15.55、19.51、24.03、21.47、23.48 个百分点。其中 5、10、15 分钟用满 42 人,5 分钟是从 85.78% 降到 74.50%;30 分钟是从 72.80% 降到 48.77%,人数是括号中的 34。2474 m² 的六格下降 21.81 到 26.81 个百分点,正文概括为 21%–26%,人数从 5 分钟的 42 人减到 1 小时的 15 人。618 m² 的六格下降 31.34 到 37.02 个百分点,正文概括为 31%–37%,人数最少的一格是 45 分钟的 6 人。
中图里,作者特别指出最低的上限是 22.84%,出现在最细格子和最长的 1 小时,但只有 7 人,需要谨慎。更有代表性的读法是看满员格子:2474 m² 在最有利的 5 分钟上也只有 57.33%。论文据此说,大约 70 米乃至 35 米这一档,即使用最好的下一步算法,也只有大约一半或更低的猜中空间,难以单独支撑需要高准确率才触发的服务。618 m² 在全部六个时间间隔上的中图都不超过 43.35%。
正文还写,线以下 37 个组合里,只有 35%(14/37)的上限超过 70%。按中图逐格核对,这 37 格里严格高于 70% 的是 13 格;158,347 m²、30 分钟是 69.90%,没有超过 70%。13/37 约等于 35.1%。这里同时保留正文的 14/37,和热图上的 13 格。
低上限的含义要看方向。上限高,只说明还存在更好算法的空间,并不保证做得到。上限低,则说明只靠位置序列,无法做出超过该百分比的下一步预测。论文把这看成对“仅用定位轨迹”的约束,并写到,若应用目标高于图 4 中的这些值,就需要换一种预测定义、只挑行为极有规律的子人群,或加入轨迹以外的变量。这些是作者对结果用途的判断。热图本身给出的是平均上限,个别人、别的数据集可以更高,文中举了 Jensen 等人的传感器研究作为例子。
这些百分比能说到哪一步
42 人来自熵估计筛剩的子集,占 182 人的一部分,不能当成城市人口的随机样本。细格子上的许多百分比,分母已经不是 42。22.84% 的分母是 7 人,43.35% 的分母是 26 人。
Nr 是观察到的最大转向数。它会漏掉从未走过、但物理上走得到的地点,也会把分支最多的那个地点的出口数用到出口更少的地点上。前者使上限偏紧,后者使上限偏松。它也不是路网长度或通勤时间。
熵率估计依赖有限长度的序列,以及过程在足够长时可以看成平稳的。估计与 Song 等并不完全同一个公式。GPS 在 35 米、70 米附近会有定位误差,论文把更细的格子视为容易失真的区域。
相关的另一层边界是:下降的百分点是两种上限之差,是公式更换带来的计算差异。它不证明人的出行习惯在 2014 年发生了变化,也不证明某个具体预测模型的准确率会下降同样的幅度。
一句话总结
下一步位置并没有被历史轨迹锁在九成附近;一旦候选里去掉这一步到不了的地点,上限会下降,格子细到大约一栋楼时,只靠定位序列留下的猜中空间往往只剩一半上下。
核心来源
- IEEE Xplore 会议论文页面,DOI:10.1109/PerCom.2014.6813948。正文图 1–4;附录 A、B 为定理证明。热图中的全部百分比与括号人数以这版 PDF 为准。
- 文中作为对照转述的 93%、约 98.5% 和约 91.7%,分别来自 Song 等(Science,2010)与 Lin 等(UbiComp,2012)在本文中的引用,不是本文重新计算的成绩。
- Geolife 轨迹来自微软亚洲研究院公开发布的数据集,本文引用其用户指南中的步行标签比例。
作者介绍
四位作者的机构以论文首页为准。诺丁汉大学机构库页面可以核到同一篇论文,并给出其中两位作者在该库中的当前职衔;下面把当前职衔和 2014 年署名分开写。
- Gavin Smith:论文署名为诺丁汉大学 Horizon Digital Economy Research。机构库页面现列其为商业分析副教授。
- Romain Wieser:论文署名为巴黎 Télécom ParisTech,以及马恩河畔瓦莱的 ENSG。机构库只列出姓名。
- James Goulding:论文同署诺丁汉大学 Horizon Digital Economy Research。机构库页面现列其为数据科学教授。
- Duncan Barrack:论文同署该研究所。机构库列出姓名,没有额外职衔。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一个应用要在大约 70 米、每 5 分钟的尺度上触发提醒,57.33% 的上限可以先当成预算,而不是当成模型团队的失误清单。预算之内的误差,才值得继续改算法;预算之外的准确率,需要日程、交通方式或是否已经上车这类轨迹里没有的信息。可以先把同一批人的预测分成两组来检验:一组是 5 分钟内步行能够离开的格子,一组是格子大到几乎必然留在原地的情况。后一组的高准确率,会把前一组的困难盖住。
另一个可以单独检验的量是个人的 Nr。热图上的百分比是多人平均。若某人在最常出发的格子上,下一步只出现过两个地点,那么即使用很细的格子,他的个人上限仍可能很高。服务若先按 Nr 或按轨迹重复程度把人分开,再决定向谁提供下一步提醒,会比用 42 人的平均值向所有人承诺同一个准确率更接近这张热图的结构。这需要新的分层试验,本文没有做。