小区周围的出租车、公交和签到,能拼出一套功能配比吗?
论文名片|Yanjie Fu、Guannan Liu、Yong Ge、Pengyang Wang、Hengshu Zhu、Hui Xiong,Representing Urban Forms: A Collective Learning Model with Heterogeneous Human Mobility Data,IEEE Transactions on Knowledge and Data Engineering,2019,31(3):535–548。DOI:10.1109/TKDE.2018.2837027。本文依据带该 DOI 的录用稿解读;录用稿首页写明尚未完成终校。正式卷期与页码据 DBLP 和密苏里科技大学机构库。正式版署名另有 Chunxiao Li,录用稿的作者名单和文末简介没有列入此人。
北京一个居住小区,工作日清晨有人坐公交离开,傍晚有出租车到达,晚上还有餐馆签到。只看一种记录,这个小区可以被说成住区、办公区或消费区。三种记录落在同一个公里圈里,更常见的情况是几种功能同时存在,而且权重不同。
这篇论文把这种混合叫做城市形态(urban form):一组城市功能,以及每种功能的一个数值权重。作者把签到、出租车和公交放进同一个概率模型,估计每个小区的权重,再用这组权重给房价回报排序、预测餐馆消费频次。
在北京这 2,851 个小区上,学到的权重能把上涨市前 10 名里的高价值小区找全,也让餐馆消费频次的误差低于直接使用交通和兴趣点统计。证据是同一批小区上的拟合和一次随机划分。下跌市的房价月份和出行月份并不重合。
先说结论
- 小区是一个中心点加一块邻域。圆和方、半径 1、1.5、2 公里都试过。下跌市的全名单肯德尔 tau 里,圆形 1 公里是六组中唯一明显高于 0.2 的正值,方形 1 公里和圆形 2 公里接近 −0.6。上涨市六组 tau 都在 0.33 到 0.36 之间。
- 套索回归加卡方检验留下 5 类与小区评分同向的兴趣点:餐饮、购物、生活、景点、科教。功能个数因此取 5。图 7 里困惑度随功能个数增加到 40 仍在下降,K=5 不是困惑度的最低点。
- 上涨市前 10 名中,本文方法 10/10 是评分不低于 3 的高价值小区;随机或 CoordAsc 是 2/10,最好的竞争者是 7/10 到 8/10。全名单 tau 上涨市为 0.377、下跌市为 0.358,分母是全部小区两两比较后的同序对与逆序对。前 10 名命中和 2,851 个小区的整体顺序是两件不同的事。
- 预测餐馆消费频次时,正文写潜在配比、以及显式特征加潜在配比,使线性回归的误差比显式特征下降超过 60%,使弹性网络下降超过 50%。图 12 的纵轴写的是均方误差,正文把同一误差称为 MAE。柱上没有数字,餐馆个数和是否留出测试也没有写明。
- 出租车是 2012 年 4–8 月,签到是 2012 年全年,公交卡是 2012 年 8 月到 2013 年 5 月。房价下跌窗口是 2011 年 7 月到 2012 年 2 月。下跌市结果使用了窗口之外的出行,依据是城市设施变得慢、出行有周期。
一种记录够不够描写一个小区?
论文要分开的两个说法是:小区可以用一种主导功能命名;小区是若干功能的配比。旧的困难在于,出租车、公交和签到来自不同系统,现代小区又很少只有一类设施。
图 1 是这个定义的示意图。饼图中间是问号,两侧列出办公、零售、教育、交通、轻工业、政府机构、居住、娱乐、金融和重工业。它展示“功能可以混合”,没有使用北京数据,也不能读出任一小区的真实份额。
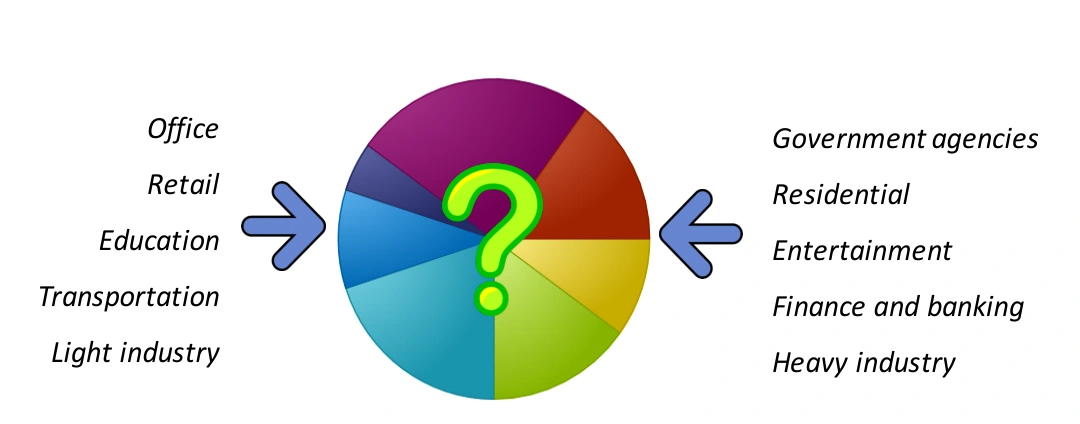
图 1|一个小区的城市形态,指的是哪些功能混在一起?
无字母子图。左右两侧是功能名称,箭头指向中间的彩色圆,圆中心是问号。这是定义用的示意图,各色块没有对应实测比例。来源:原论文 Fig. 1。
后文的可计算定义更窄:一个小区的城市形态是 K 个功能上的一组权重。符号是 ηₘ,第 m 个小区在 K 个功能上的多项分布。全市权重 θ 是这 M 个小区权重的平均。
三种出行怎样进入同一个模型?
数据里的一次记录先被写成一个“词”。签到词是三元组:星期几、钟点、兴趣点类别。出租车词和公交词也是三元组:工作日或周末、钟点、离开或到达。离开对应上车,到达对应下车。
词被归到小区的规则是空间包含:签到点、上车点或下车点落在小区邻域内,这条记录就进入该小区。正文先把邻域写成半径 1 公里的圆。分析单位是“小区 × 时段”里的事件。出租车数据没有乘客编号,模型也没有把同一个人的全天行程串成面板。摘要里的 individual level,对应的是这些单次事件。
模型借用文本的说法,但语料有三套。小区在一个时段里的签到事件是第一套文档,出租车事件是第二套,公交事件是第三套。三种文档共用一个更高层的功能变量 f。给定 f,三种出行在模型里条件独立。这就是论文所说的集体学习(collective learning):一个功能同时生成三种词,而不是三种数据各做一个主题模型再事后拼接。
生成过程可以顺着图 2 读。外层有 M 个小区,每个小区先有自己的功能配比 ηₘ。内层有 N 个时段;实验里 N=7,周一到周日各一段。每个时段从 ηₘ 抽一个功能 f。这个功能再指向三组主题:签到主题、出租车主题、公交主题。每条签到先抽主题 z,再抽具体的签到词;出租车和公交同样,分别经过主题 u、v 抽到词 t、b。K、Q、R、W 是功能个数和三类主题个数。
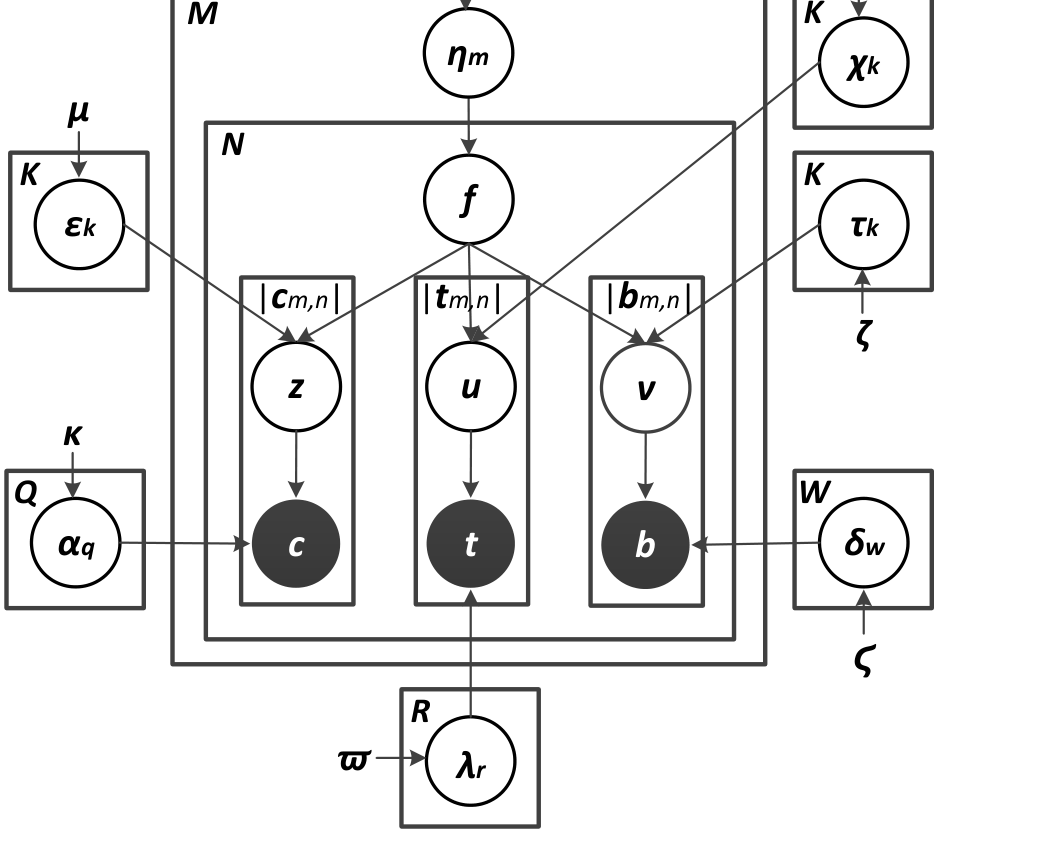
图 2|签到、出租车和公交怎样由同一个功能生成?
无字母子图。外框 M 是小区,其中 ηₘ 是功能配比;内框 N 是时段,f 是该时段抽到的功能。三个内层小框分别重复签到词 c、出租车词 t 和公交词 b。两侧方框是功能与主题的分布,黑底圆是观测到的词。来源:原论文 Fig. 2。
估计使用坍缩吉布斯采样。框架概述里写过用 EM 求解,参数一节给出的是条件后验和计数更新。某个功能的权重,等于该功能被抽中的时段次数加上兴趣点先验,再除以所有功能的次数与先验之和。兴趣点先验怎样来,是下一节的问题。主题模型的结果在 200 次迭代后取出。
功能为什么是 5 种,而不是困惑度最低的那种?
兴趣点被当作小区的显式旁证。作者先用签到给小区打一个分数,再看哪些兴趣点类别和这个分数同向、而且在统计上站得住。
密度是小区内签到总次数。多样性用各类别签到次数的熵来概括。两者分别归一化后,用调和平均合成一个分数:WCS=2×密度×多样性÷(密度+多样性)。论文把 WCS 解释为消费与分享意愿,用来代表小区活跃程度。印刷出来的熵式没有写成带负号、并按概率归一化的常用形式,所以这里只采用这段文字定义。
然后做带 L1 惩罚的线性回归,也就是套索回归(LASSO)。惩罚强度 γ 控制有多少类别系数被压成 0。对留下的类别,再用残差平方和的下降比上评分方差,对照卡方分布看显著性。系数为正且显著的类别,被当作与小区发展相容的功能。
表 7 列出 5 类:类别编号 5 餐饮,6 购物,7 生活,11 景点,14 科教。全量兴趣点有 13 类,编号却写到 14,稿件没有给出编号对照表,也没有给出 γ、系数和 p 值。
每一类在小区 m 里的频率是:该类兴趣点数 ÷ 该小区全部兴趣点数。分母是全部兴趣点,所以这 5 个份额一般加总不到 1。模型把功能个数 K 设成相容类别的个数,也就是 5,并把这组频率当作 ηₘ 的狄利克雷先验。先验把“兴趣点里已经看得到的混合”拉向出行数据估计出来的权重,两者仍然可以不一样。
图 7 用来检查:K=5 落在困惑度曲线的什么位置。
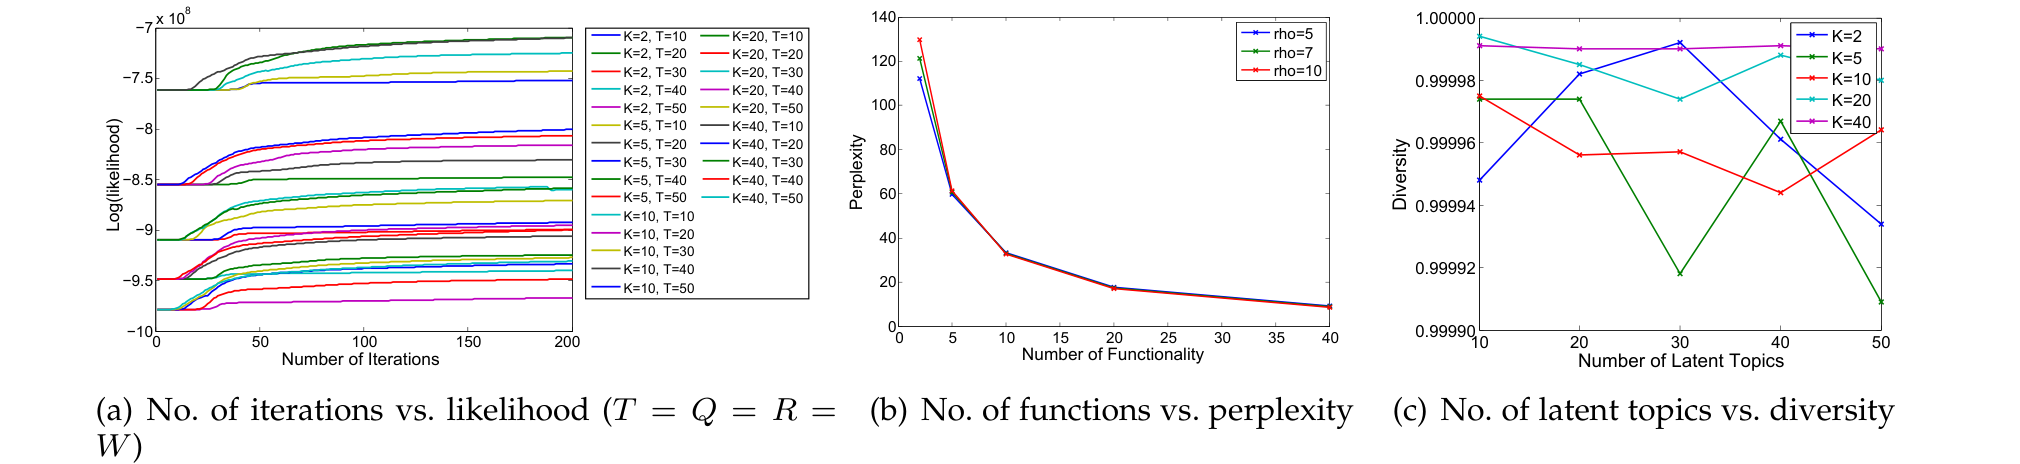
图 7|把功能个数和主题个数调大,拟合还会继续变好吗?
(a)横轴迭代次数到 200,纵轴是对数似然、数量级为 10⁵。不同颜色是功能个数 K 和主题个数 T 的组合,T 在这里等于三类主题个数。各组曲线在约 100 次迭代后变平,K 更大的一组停在更高的位置。(b)横轴功能个数,纵轴困惑度;rho=5、7、10 三条线几乎叠在一起。K=2 时困惑度高于 100,K=40 时降到 20 下方。(c)横轴潜在主题个数,纵轴多样性;五条线都挤在 0.99990 和 1 之间。来源:原论文 Fig. 7。
正文有一句写成功能个数减少时困惑度下降,和曲线方向不同。后文写 K 从 5 增到 20 时困惑度平滑下降,与图 7(b) 一致。
多样性的差距出现在小数点后第五位。作者据此认为主题个数和这个指标关系弱,为避免过拟合,取 K=5、三类主题个数都为 7。7 也等于时段数 N,而且三类词表都不大。似然和困惑度都还允许更大的 K。K=5 的含义是:和兴趣点筛选出来的 5 类对齐。
房价窗口和出行月份是同一段吗?
实验在北京。居住小区 2,851 个,外框 40×40 公里,房价成交从 2011 年 4 月到 2012 年 9 月。
| 数据 | 表 3 中的规模 | 时间 |
|---|---|---|
| 公交站 | 9,810 个站 | 2011 |
| 地铁站 | 215 个站 | 2011 |
| 路网 | 162,246 条路段,总长 20,022 公里;主要道路占比 7.5% | 2011 |
| 兴趣点 | 300,811 个,13 类 | 未单列年份 |
| 出租车 | 13,597 辆,92 个有效日,8,202,012 次行程,总里程 61,269,029 公里;GPS 点数印为 111,602 | 2012 年 4–8 月 |
| 公交卡 | 9,810 个站,持有人一栏印为 car holders 300,250,行程 1,730,000 | 2012 年 8 月–2013 年 5 月 |
| 签到 | 5,874 个兴趣点,2,762,128 次事件,9 个类别 | 2012 年 1–12 月 |
| 商户点评 | 470,846 条评论,159,820 个用户 | 未单列年份 |
| 小区房价 | 2,851 个小区 | 2011 年 4 月–2012 年 9 月 |
主要道路 7.5% 的分母,表里没有写是路段数还是长度。GPS 点数 111,602 远小于 8,202,012 次行程,稿件没有解释,不能把每个行程理解成带有一段完整轨迹。公交卡一栏的英文是 car holders,它和行程数放在同一块智能卡数据里。数据表里有 215 个地铁站和路网。生成模型的三种文档只有签到、出租车和公交。
房价被分成两段市场。支付意愿在本文里不是问卷,而是一段行情内的价格回报率:(期末价 − 期初价)÷ 期初价。下跌市是 2011 年 7 月到 2012 年 2 月,上涨市是 2012 年 2 月到 2012 年 9 月。图 3 的柱从 2011 年 4 月画到 2012 年 9 月,竖线画在 2012 年 2 月和 3 月之间。2 月同时出现在两段文字定义里。纵轴只有 ×10⁴,没有单位;2 月那根柱子贴近 2.4×10⁴,9 月到达 2.8×10⁴。
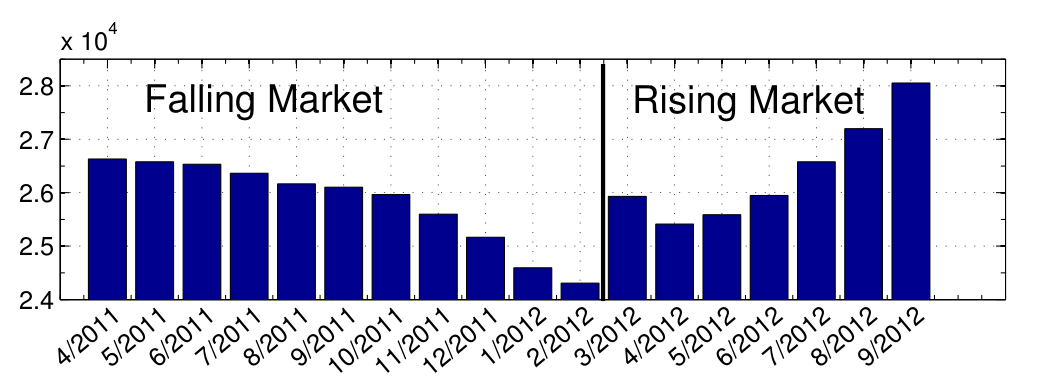
图 3|上涨和下跌,在这 18 个月里各占哪一段?
无字母子图。横轴是 2011 年 4 月到 2012 年 9 月,纵轴为 ×10⁴ 且没有单位。竖线左侧标为下跌市,右侧标为上涨市。柱子先降到 2012 年 2 月,再升到 2012 年 9 月。来源:原论文 Fig. 3。
和这张价格日历对照,出租车完全落在上涨市内部,但没有盖住 2012 年 2–3 月和 9 月。签到从 2012 年 1 月开始,只擦到下跌窗口的末尾。公交卡主要落在 2012 年 9 月之后。作者写明,数据源没有盖住整个上涨和下跌窗口,仍用已有记录近似缺失月份,理由是短时间内城市设施变化慢,出行又有周期性。下跌市的功能权重,因此大量来自窗口之外的出行。
邻域画成圆还是方,谁排在前面会变吗?
半径太大,邻域会盖住别的小区;半径太小,圈里的出行会变稀。作者比较了正方形和圆,边长或半径取 1、1.5、2 公里,评价指标是后面房价排序任务里的 Precision 和肯德尔 tau。
Precision@N 的分母是前 N 名。五档评分从 4 到 0,评分不低于 3 算高价值。Precision@N=前 N 名里高价值小区的个数 ÷ N。稿件没有写明价格回报率怎样切成这五档。tau=(同序对 − 逆序对)÷(同序对 + 逆序对)。同序指真实回报和预测回报的高低方向一致。
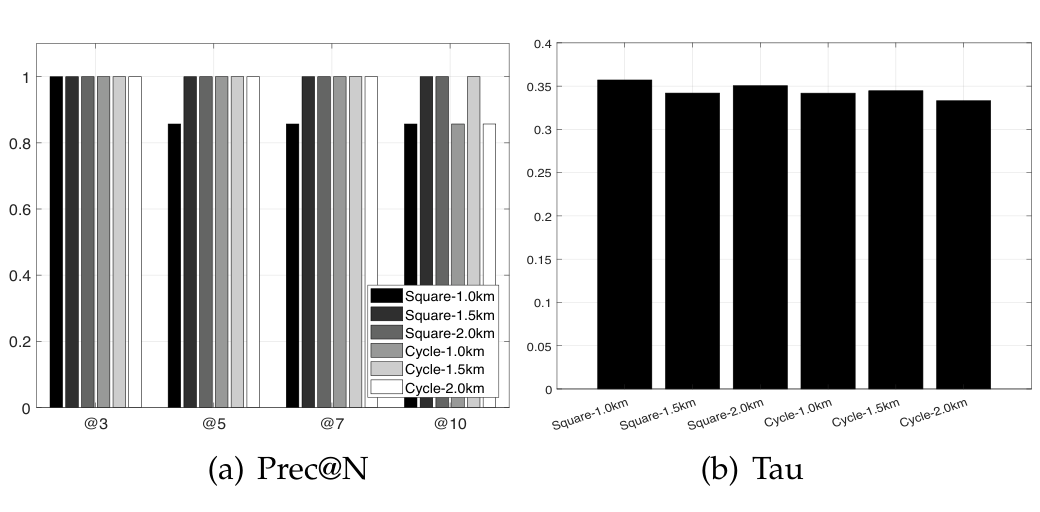
图 4|上涨市里,邻域形状会把前 N 名的精度拉开吗?
(a)横轴是前 3、5、7、10 名,纵轴 Precision,从 0 到 1。六种灰度对应三种半径的方形和圆形。@3 六组都到 1;@5 到 @10,方形 1 公里降到 0.8 与 0.9 之间,其余多数仍贴着 1。(b)横轴是六种邻域,纵轴 tau。六根柱都在 0.33 到 0.36 之间,方形 1 公里略高,圆形 2 公里略低。来源:原论文 Fig. 4。
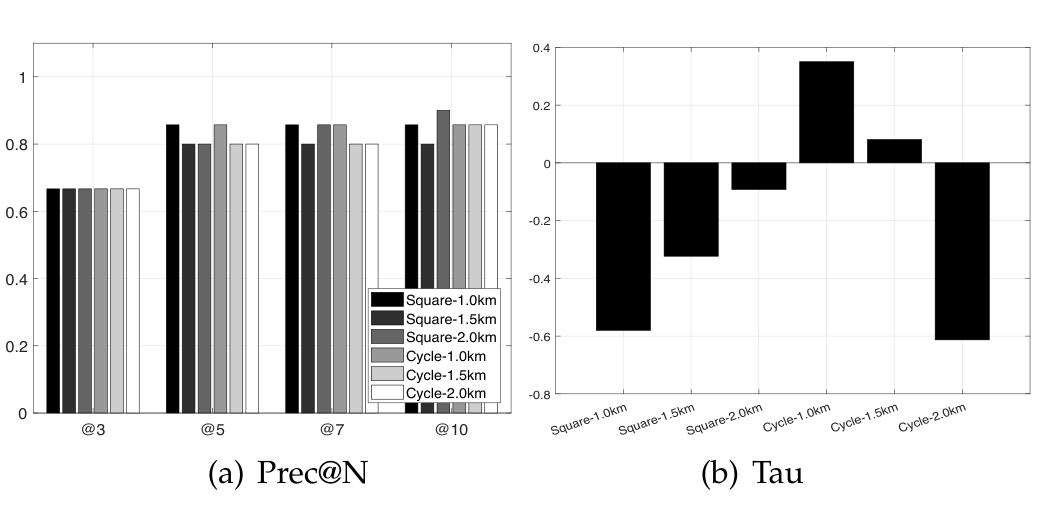
图 5|下跌市里,形状改变的是前几名,还是整张名单的顺序?
(a)纵轴仍是 Precision。@3 六组几乎一样,略高于 0.6;@10 大约落在 0.8 到 0.9。(b)纵轴 tau,刻度从 −0.8 到 0.4。圆形 1 公里是唯一明显高于 0.2 的正柱,圆形 1.5 公里略高于 0,方形 1 公里和圆形 2 公里接近 −0.6。来源:原论文 Fig. 5。
上涨市六组 tau 挤在 0.33 到 0.36,方形 1 公里略高。下跌市里,前 3 名的 Precision 几乎不随形状变化,全名单 tau 从正值落到负值。作者概括为圆形、半径 1 公里在两个市场里都比较稳。图 5(b) 是这个选择最清楚的一张图。
半径 1 公里还会带来重叠。一个圆的面积是 π 平方公里。2,851×π ≈ 8,957 平方公里,外框是 40×40=1,600 平方公里,前者约为后者的 5.6 倍。这是用小区数、半径和外框做的面积比较,论文没有统计一次上车或下车被记入几个小区。图里方形的“半径”没有定义边长怎样量,所以上面的倍数只针对圆。
星期几改变的是主题,还是 1/7 附近的小起伏?
主题个数取 7 之后,可以把每个主题在周一到周日的权重画出来。图 9 的色标很窄:签到约 0.132–0.153,出租车约 0.139–0.147,公交约 0.136–0.150。若 7 个主题的权重相加为 1,均匀时每个主题约为 0.143。整张色标就挤在这个均匀值两侧大约 0.02 的范围里。深色表示比均匀略高,不表示某个主题占了一天里的大部分事件。图题写 weekday,横轴却包括周六和周日。
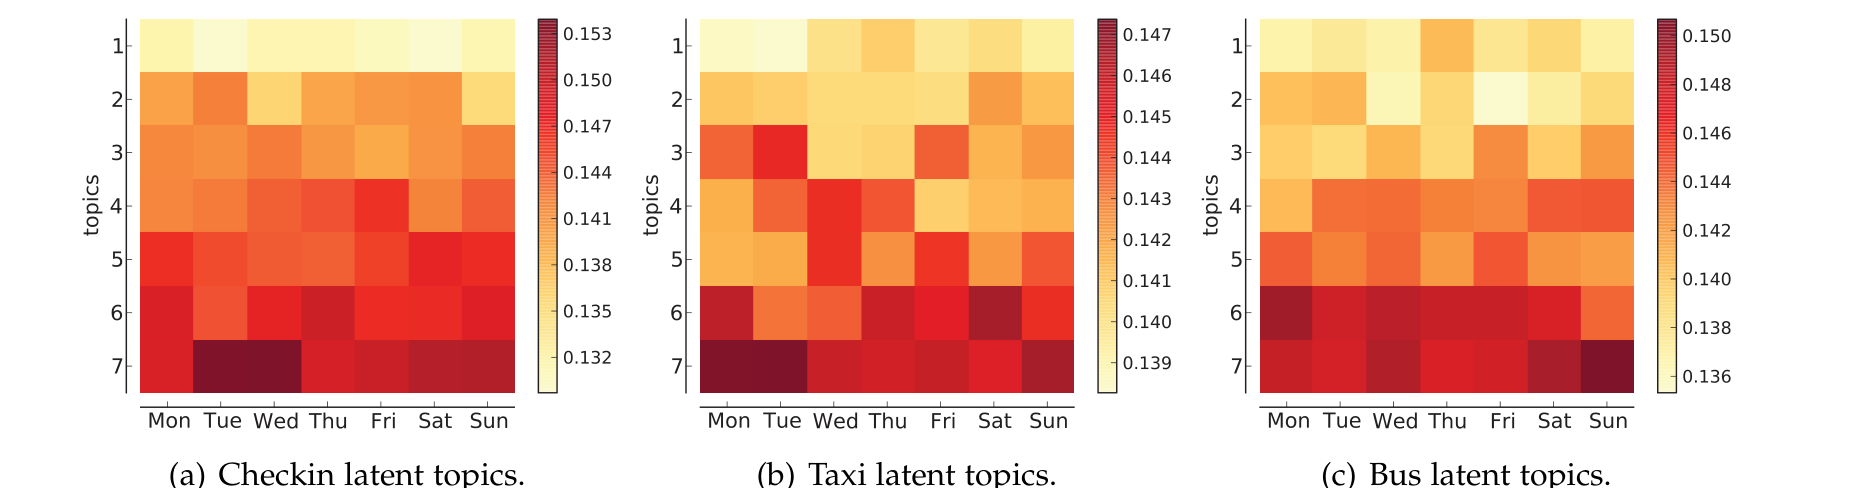
图 9|一周之内,哪些主题只是略高于均匀份额?
(a)签到主题,色标约 0.132–0.153。(b)出租车主题,色标约 0.139–0.147。(c)公交主题,色标约 0.136–0.150。三幅图的横轴都是周一到周日,纵轴是主题 1–7,颜色越深数值越高。主题 5–7 整体深于主题 1–4。来源:原论文 Fig. 9。
表 4 到表 6 给的是部分主题的高频词,不是全部 7 个主题。签到里,主题 5 的例子多是下午和夜间的购物,主题 6 多是娱乐,主题 7 多是餐馆;工作日和周末都列出了这三类。出租车的工作日主题 3 和 4 含有早晨到达、傍晚离开,例如 A@8AM、L@5PM、L@6PM。公交的工作日主题 5 含 A@8AM 和 L@5PM;周末主题 4 含 L@10PM、A@7PM、L@9PM。这些词和通勤、晚间消费的时间对得上。
正文另写签到主题 1、3、4 在工作日和周末都常见。若深色代表更高权重,图 9(a) 里更高的是主题 5–7。表 4 解释的也是 5、6、7。两处对“哪个编号更常见”的说法不一致,稿件又没有逐格概率表。能确定的是:色标跨度只有大约两个百分点,代表词集中在餐饮、娱乐、购物和上下车时点。
用签到给小区打分,出租车和公交同意吗?
选择签到分数作为兴趣点回归的因变量之前,作者比较了三种数据各自的调和平均分数。每个小区得到一个分数,三种数据就得到三条长度为 2,851 的分数向量,图 8 是这三条向量之间的相关。
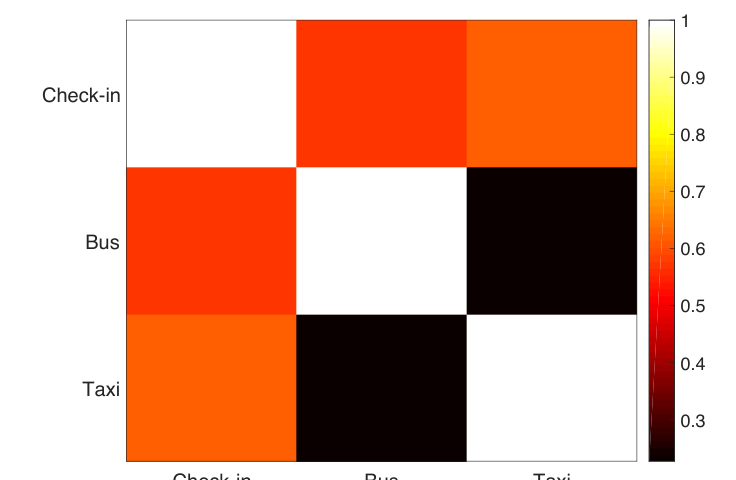
图 8|签到分数、公交分数和出租车分数有多接近?
无字母子图。行列都是签到、公交、出租车,色标从 0.3 到 1,对角格留白。签到与公交的格子颜色深于签到与出租车,公交与出租车落在色标的深色低端。格内没有印出相关系数。来源:原论文 Fig. 8。
正文的读法是:签到和另外两种都是正相关,出租车与公交的相关很弱。由此认为签到分数已经带有另外两种出行的信息,另外两种却带不全签到的信息,所以用签到的调和平均给小区打分。这里的相关是小区分数之间的相关。它不表示同一次出行同时被三种数据记录,也不表示签到可以替代出租车的上下车位置。
名次靠前的小区,五行权重是不是都有颜色?
图 6 把学到的 5 个功能权重按房地产名次排开。上图横轴从 0 到 25,正文称为前 1–25 名;下图是名次 2505–2530。小区共 2,851 个,所以下图靠近名单后部,但不是最后 26 名。五行没有标成餐饮或居住,图上也没有色标数值。
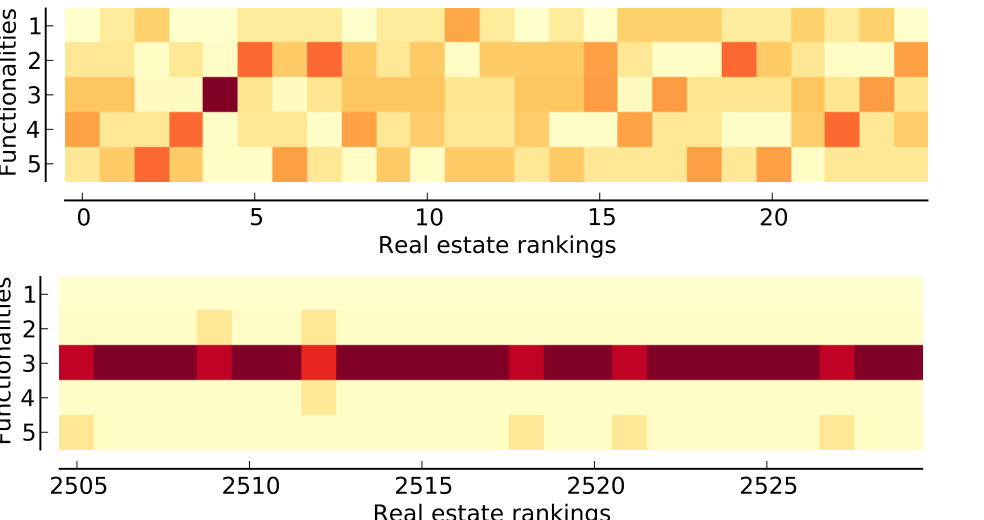
图 6|高名次和低名次小区的五种功能权重,分散程度一样吗?
无字母,上下两个热力面板。颜色由浅黄到深红。上图名次约 0–25,五行都有深浅变化,大约第 4 名的第 3 行有一块深色。下图名次 2505–2530,第 3 行几乎整行深红,其余行很浅。来源:原论文 Fig. 6。
这和“高名次更均衡、低名次更集中”的文字一致。名次和权重来自同一座城市的观测:权重来自出行和兴趣点,名次来自房价一侧的评分。图里没有固定房价、地段或建筑年代。它可以说明两组小区的权重样子不同,不能单独证明把功能调均衡就会提高投资价值。
排序赢在前 10 名,还是赢在全部两两比较?
排序特征是学到的功能配比。训练目标是价格回报率。损失函数把逐点的高斯型和成对的排序项乘在一起。正文写用梯度下降寻找使该损失最大的参数。数据按 70% 训练、30% 测试随机划分,上涨市和下跌市分开评估。稿件没有写重复划分,也没有写置信区间。
对照包括排序学习里的 Coordinate Ascent、LambdaMART、FenchelRank、ListNet,以及面向小区排序的 SEK、ClusRanking、DivRank。DivRank 对应作者 2015 年 KDD 论文里的混合用地排序,那一版还没有把这次的套索显著性检验放进表示学习。传统排序算法用 RankLib 运行,实验也提取了兴趣点、公共交通和路网特征。稿件没有逐一列出每个基线吃进的特征表,所以领先不能单独写成“同一组特征下换了排序器”或“同一个排序器下换了表示”。
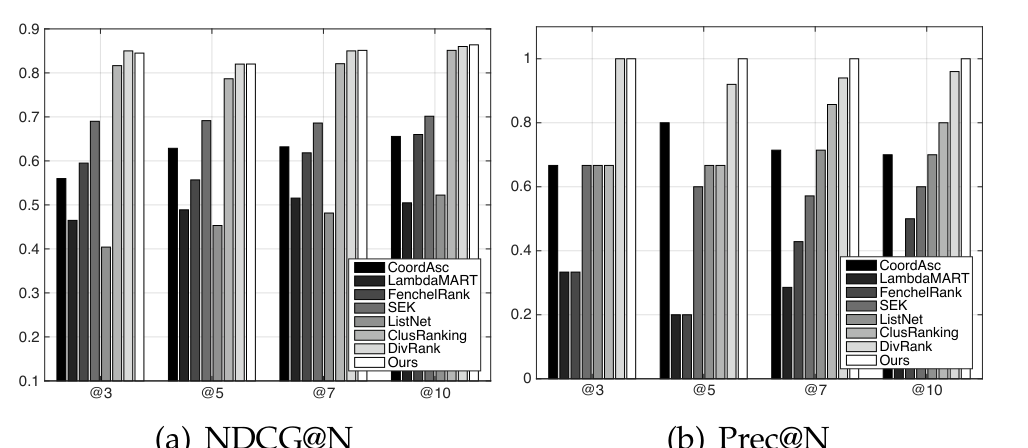
图 10|上涨市的前 N 名里,高价值小区占多少?
(a)纵轴 NDCG,刻度从 0.1 起到 0.9,白柱是本文方法,在 @3 到 @10 都高于其余图例。(b)纵轴 Precision,从 0 到 1。白柱在四个 N 上都贴着 1;@10 的黑柱 CoordAsc 靠近 0.2。来源:原论文 Fig. 10。
NDCG@n=该名次的折损累计增益 ÷ 理想排序的折损累计增益,越大表示高评分小区越靠前。图 10(a) 的纵轴最低刻度是 0.1。
正文给出上涨市 NDCG@3 的相对改进:比 SEK 高 21%,比 FenchelRank 高 32.4%,比 RankBoost 高 47.2%。RankBoost 没有出现在图 10、图 11 和表 8 里,后一个百分比的对照柱无法在这些图表中核对。Precision 的分数有明确分母:前 10 名里,本文方法 10/10 为高价值;随机或 CoordAsc 为 2/10;最好的竞争者是 7/10 到 8/10。
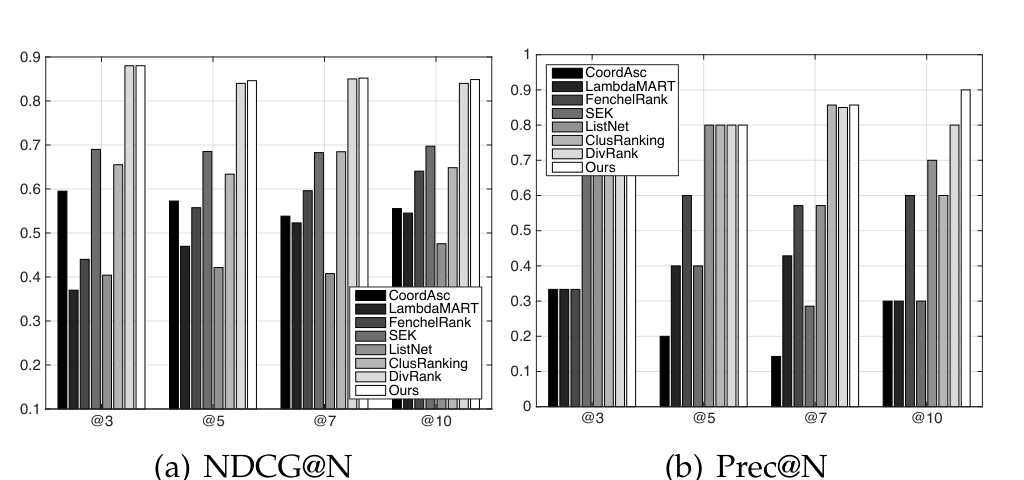
图 11|下跌市的前 N 名,还是 10/10 都命中吗?
(a)纵轴 NDCG 从 0.1 起。白柱在 @3 最高,落在 0.8 与 0.9 之间;@10 仍高于图中其余算法。(b)纵轴 Precision 从 0 到 1。白柱在 @3 贴着 1,@5 靠近 0.8,@10 靠近 0.9。来源:原论文 Fig. 11。
下跌市 NDCG@3 的正文数字是:比 SEK 高 27.5%,比 RankBoost 高 17.3%,比 FenchelRank 高 99%。RankBoost 同样不在图和表里。下跌市的 Precision 没有再写成“前 10 个里有几个”。从图 11(b) 看,本文方法的 @10 靠近 0.9,低于上涨市的 10/10。
全名单 tau 在表 8。上涨市:CoordAsc −0.137,LambdaMART 0.072,FenchelRank 0.122,SEK 0.349,ListNet 0.172,ClusRanking 0.343,DivRank 0.351,本文 0.377。下跌市:0.223,0.231,−0.125,0.335,0.054,0.236,−0.093,0.358。本文在两行都是最大的一个。上涨市只比 DivRank 高 0.026;下跌市 DivRank 为 −0.093,本文为 0.358,差距比上涨市大。0.377 和 0.358 仍表示有相当比例的小区对被排反,和前 10 名里 10/10 同时成立。
作者把下跌市里旧方法 tau 下降,归因于部分出行没有采在下跌窗口内;加入兴趣点先验后的 tau 在两段市场里都保持为正。这个对比支持“先验让全名单相关更稳”,仍然发生在月份错开的特征之上。
餐馆消费频次的误差,相对哪一组特征下降?
第二个应用用餐馆消费频次代表餐馆人气。稿件没有写餐馆个数、频次来自签到还是点评,也没有写这次预测是否使用独立测试集。点评数据本身有 470,846 条评论和 159,820 个用户,不能直接当成这个任务的样本量。
比较的是五组输入:只含显式特征;不含套索先验的潜在配比;含套索先验的潜在配比;显式加前一种潜在配比;显式加后一种潜在配比。显式特征包括出租车平均速度、出租车平均出行距离、公交进出量和公交站密度,以及各类兴趣点频率。不含套索先验的那一版,对应 2015 年的会议论文。五个回归器是线性回归、岭回归、套索回归、弹性网络和贝叶斯岭回归。图 12 的标题是均方误差,正文括号里写成 MAE。MAE 通常指平均绝对误差,这里以图的纵轴名称为准,并把正文的相对降幅当作作者给出的摘要。
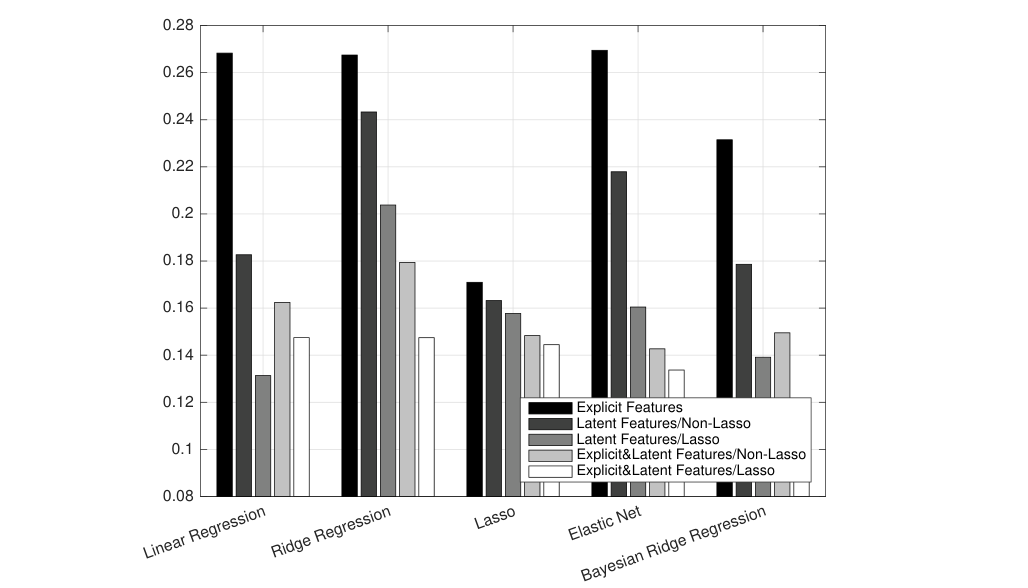
图 12|同样的回归器,换上功能配比以后误差降到哪里?
无字母子图。横轴是五个回归器,纵轴从 0.08 到 0.28。黑色是显式特征,其余灰度依次为不含套索的潜在特征、含套索的潜在特征、显式加不含套索、显式加含套索。黑柱在线性回归、岭回归和弹性网络上最高,大约贴着 0.27;套索回归那一组整体更矮。图例挡住了中间和右侧若干矮柱的下半段。来源:原论文 Fig. 12。
正文的相对数是:潜在表示以及显式加潜在表示,使线性回归的误差下降超过 60%,使弹性网络下降超过 50%。比较对象是同一回归器下的显式特征。柱上没有数字,这个百分比以正文为准。含套索先验的组合,误差低于不含套索先验的组合。误差下降说明这组潜在权重对消费频次有预测上的增量。显式特征里已经有兴趣点频率,潜在权重又用兴趣点频率当先验,两组输入共用了一部分设施信息。
这些结果能够用到哪一步?
模型给出的是小区功能权重的后验估计。它拟合三种事件在时段上的共现,不追踪人从家到工作地的路径,也不估计路段流量。作者在讨论里把这一点说清楚:这套层级模型适合概括地理对象的结构,不适合描述移动过程或地点之间的相互作用。
排序和回归都是预测比较。上涨市前 10 名的 10/10,分母是 10 个小区,而且来自一次 70/30 随机划分。全名单 tau 的分母是小区对。两个数字可以同时为真。随机划分没有按时间切开,1 公里圆又会共享同一批行程,邻近小区的训练和测试并不干净。
下跌市还有月份错位。价格窗口主要在 2011 年 7 月到 2012 年 2 月,公交卡延伸到 2013 年 5 月。作者用设施变化慢和出行有周期来辩护。这个辩护一旦在新开通路段上不成立,下跌市 tau 0.358 对应的就是后来的出行和更早的价格。
兴趣点筛选用的因变量是签到调和平均,房价排序用的因变量是价格回报率。图 6 的均衡图案不能把前一个分数的相关性,当成后一个回报率的因果。图 9 的深色只比 1/7 略高。把主题 7 说成“这个小区晚上主要是餐馆”,超过了色标所能支持的份额。
录用稿首页写明终校前内容还可能改动。正式发表记录比这份署名多一位作者。下面的数值都来自这份录用稿的表、图和正文。
一句话总结
把小区周围的签到、出租车和公交收成五个功能权重后,可以在北京上涨市的前 10 名里找到 10/10 的高价值小区,并让餐馆消费频次的误差低于文中的显式统计;这些权重来自互相重叠的邻域,下跌市还用了价格窗口之外的出行,因此它们是预测用的配比,还不是功能导致涨价或带来客流的证明。
核心来源
- DOI 10.1109/TKDE.2018.2837027,录用稿首页的 DOI。本文的模型、表 3–8 和图 1–12 都按这份录用稿核对。
- DBLP 条目,正式版记录为 IEEE Trans. Knowl. Data Eng. 31(3): 535–548 (2019),作者含 Chunxiao Li。
- 密苏里科技大学机构库,推荐引文为 2019 年 3 月,31 卷 3 期,535–548 页。
- IEEE Xplore 文档 8359195。
作者介绍
以下只根据录用稿首页署名和文末简介。
- Yanjie Fu:密苏里科技大学助理教授。2008 年中国科学技术大学学士,2011 年中国科学院硕士,2016 年罗格斯大学博士。论文所列方向为数据挖掘与大数据分析。
- Guannan Liu:北京航空航天大学信息系统系助理教授,清华大学博士。论文所列方向为数据挖掘、社交网络和商业智能。
- Yong Ge:亚利桑那大学助理教授。论文所列方向为数据挖掘和商业分析。
- Pengyang Wang:撰写时在密苏里科技大学计算机系攻读博士。2014 年西安电子科技大学学士,2017 年北京邮电大学硕士。论文所列方向包括数据挖掘、商业分析、地理经济和表示学习。
- Hengshu Zhu:百度研究院。论文所列方向为面向大规模应用的数据挖掘和机器学习。
- Hui Xiong:罗格斯大学管理科学与信息系统系教授、系副主任,罗格斯信息保障中心主任。中国科学技术大学学士,新加坡国立大学硕士,明尼苏达大学博士。论文所列方向为数据与知识工程。简介中还写明他是 ACM 杰出科学家和 IEEE 高级会员。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
如果一次下车可以同时落入大约五个 1 公里圆,前 10 名的 10/10 可能排序的是一块共享客流,而不只是单个小区的配比。可以把每条上车或下车只分给最近的小区中心,再重算上涨市 Precision@10。若命中数从 10/10 明显下降,现在的功能权重里就有一大截来自邻域重叠;若仍然接近 10/10,权重才更像小区自身的组成。
另一个可以直接算的量,是主题权重减去 1/7。图 9 的全部颜色都在均匀份额两侧大约 0.02 以内。规划上若把最深的那一行当成“晚上以餐馆为主”,应当同时报告:该类词占该小区当天全部签到的比例是多少,以及它比 0.143 高出几个百分点。差额只有一两个百分点时,设施建议的力度应和这个差额相称。
下跌市还可以按基础设施是否变化来分组。选出 2012 年新开通地铁或改道的小区,一组只用价格窗口内的行程,另一组保留文中延伸到 2013 年 5 月的公交卡。若两组 tau 接近,周期近似在这些小区上还站得住;若只用窗口内行程时 tau 掉到 DivRank 那种负值附近,0.358 里就混进了后来的城市。