一座还没有通勤表的城市,能不能靠另一座城市把流量填出来?
论文名片|Can Rong、Jie Feng、Jingtao Ding,GODDAG: Generating Origin-Destination Flow for New Cities Via Domain Adversarial Training,IEEE Transactions on Knowledge and Data Engineering,2023,35(10):10048–10057。2023年4月19日在线发表,当前版本日期为2023年9月15日。DOI:10.1109/TKDE.2023.3268409。本文依据这一正式期刊版;方法论文,比较的是城市之间的通勤起讫流量生成。
规划新城的公交或岗位布局时,手里往往先有各片区的人口、商店和学校,却没有一张“多少人住在这里、到那里上班”的表。直接套用另一座城市里拟合好的引力模型,常常会把就业中心放错位置。这篇论文试的是一条更具体的路:用源城市的真实通勤学习,训练时看目标城市的区域特征、不看它的通勤标签,再生成目标城市每一对区域之间的通勤人数。
在已经建成、并且留有通勤观测可供打分的城市之间,这样做比引力模型、树模型和直接迁移的图模型误差更低。生成结果仍是流量矩阵的拟合。六组美国迁移的平均降幅,也掩盖了各城市对之间很大的差别。
先说结论
- 美国六组、中国两组有向迁移里,GODDAG 的 RMSE 都低于同组全部基线。论文所说平均 RMSE 降低 14.5%、CPC 提高 5.62%,与表 I 六组美国迁移、各自相对该组最强基线的相对变化之算术平均一致;中国两组不在这个平均里。
- 这 14.5% 不均匀。相对各自主表最强基线,纽约到 Chi 的 RMSE 只降约 4.5%,纽约到洛杉矶约降 20.8%。上海到北京约降 30.4%,北京到上海约降 12.4%。
- 在纽约与洛杉矶的消融里,交叉积、距离上限和对抗步骤都降低了误差;显式最大均值差异(MMD)的追加降幅较小。纽约到洛杉矶的 RMSE 从去掉 MMD 的 5.52 到完整模型的 5.48。
- 以洛杉矶为源、纽约为目标的弧线图上,作者认为 GODDAG 的空间格局与观测接近。同一段文字也写明,各方法都把小流量起讫对估得偏大,长尾仍未解决。
要填的表,是居住地到工作地的人数
起讫流量(origin–destination flow,OD 流量)在这里指有向的通勤人数:住在区域 i、工作在区域 j 的人数,记为 Fᵢⱼ。分析单位是区域对上的人数,不包含其他出行目的,也不描述单个人的轨迹。区域可以按普查区或街块划分。每个区域有属性向量,本文使用人口信息和各类兴趣点(point of interest,POI)的数量;两个区域之间还有距离等交互特征。地理上相邻的区域连成无向图,邻接矩阵印成 0-1 矩阵。
任务被写成无监督领域自适应:训练能使用源城市的属性、交互、相邻图和通勤流量,以及目标城市的属性、交互和相邻图。目标城市的通勤流量只在测试时拿来打分。因此模型见过目标城市的用地和人口结构,没见过它的通勤表。
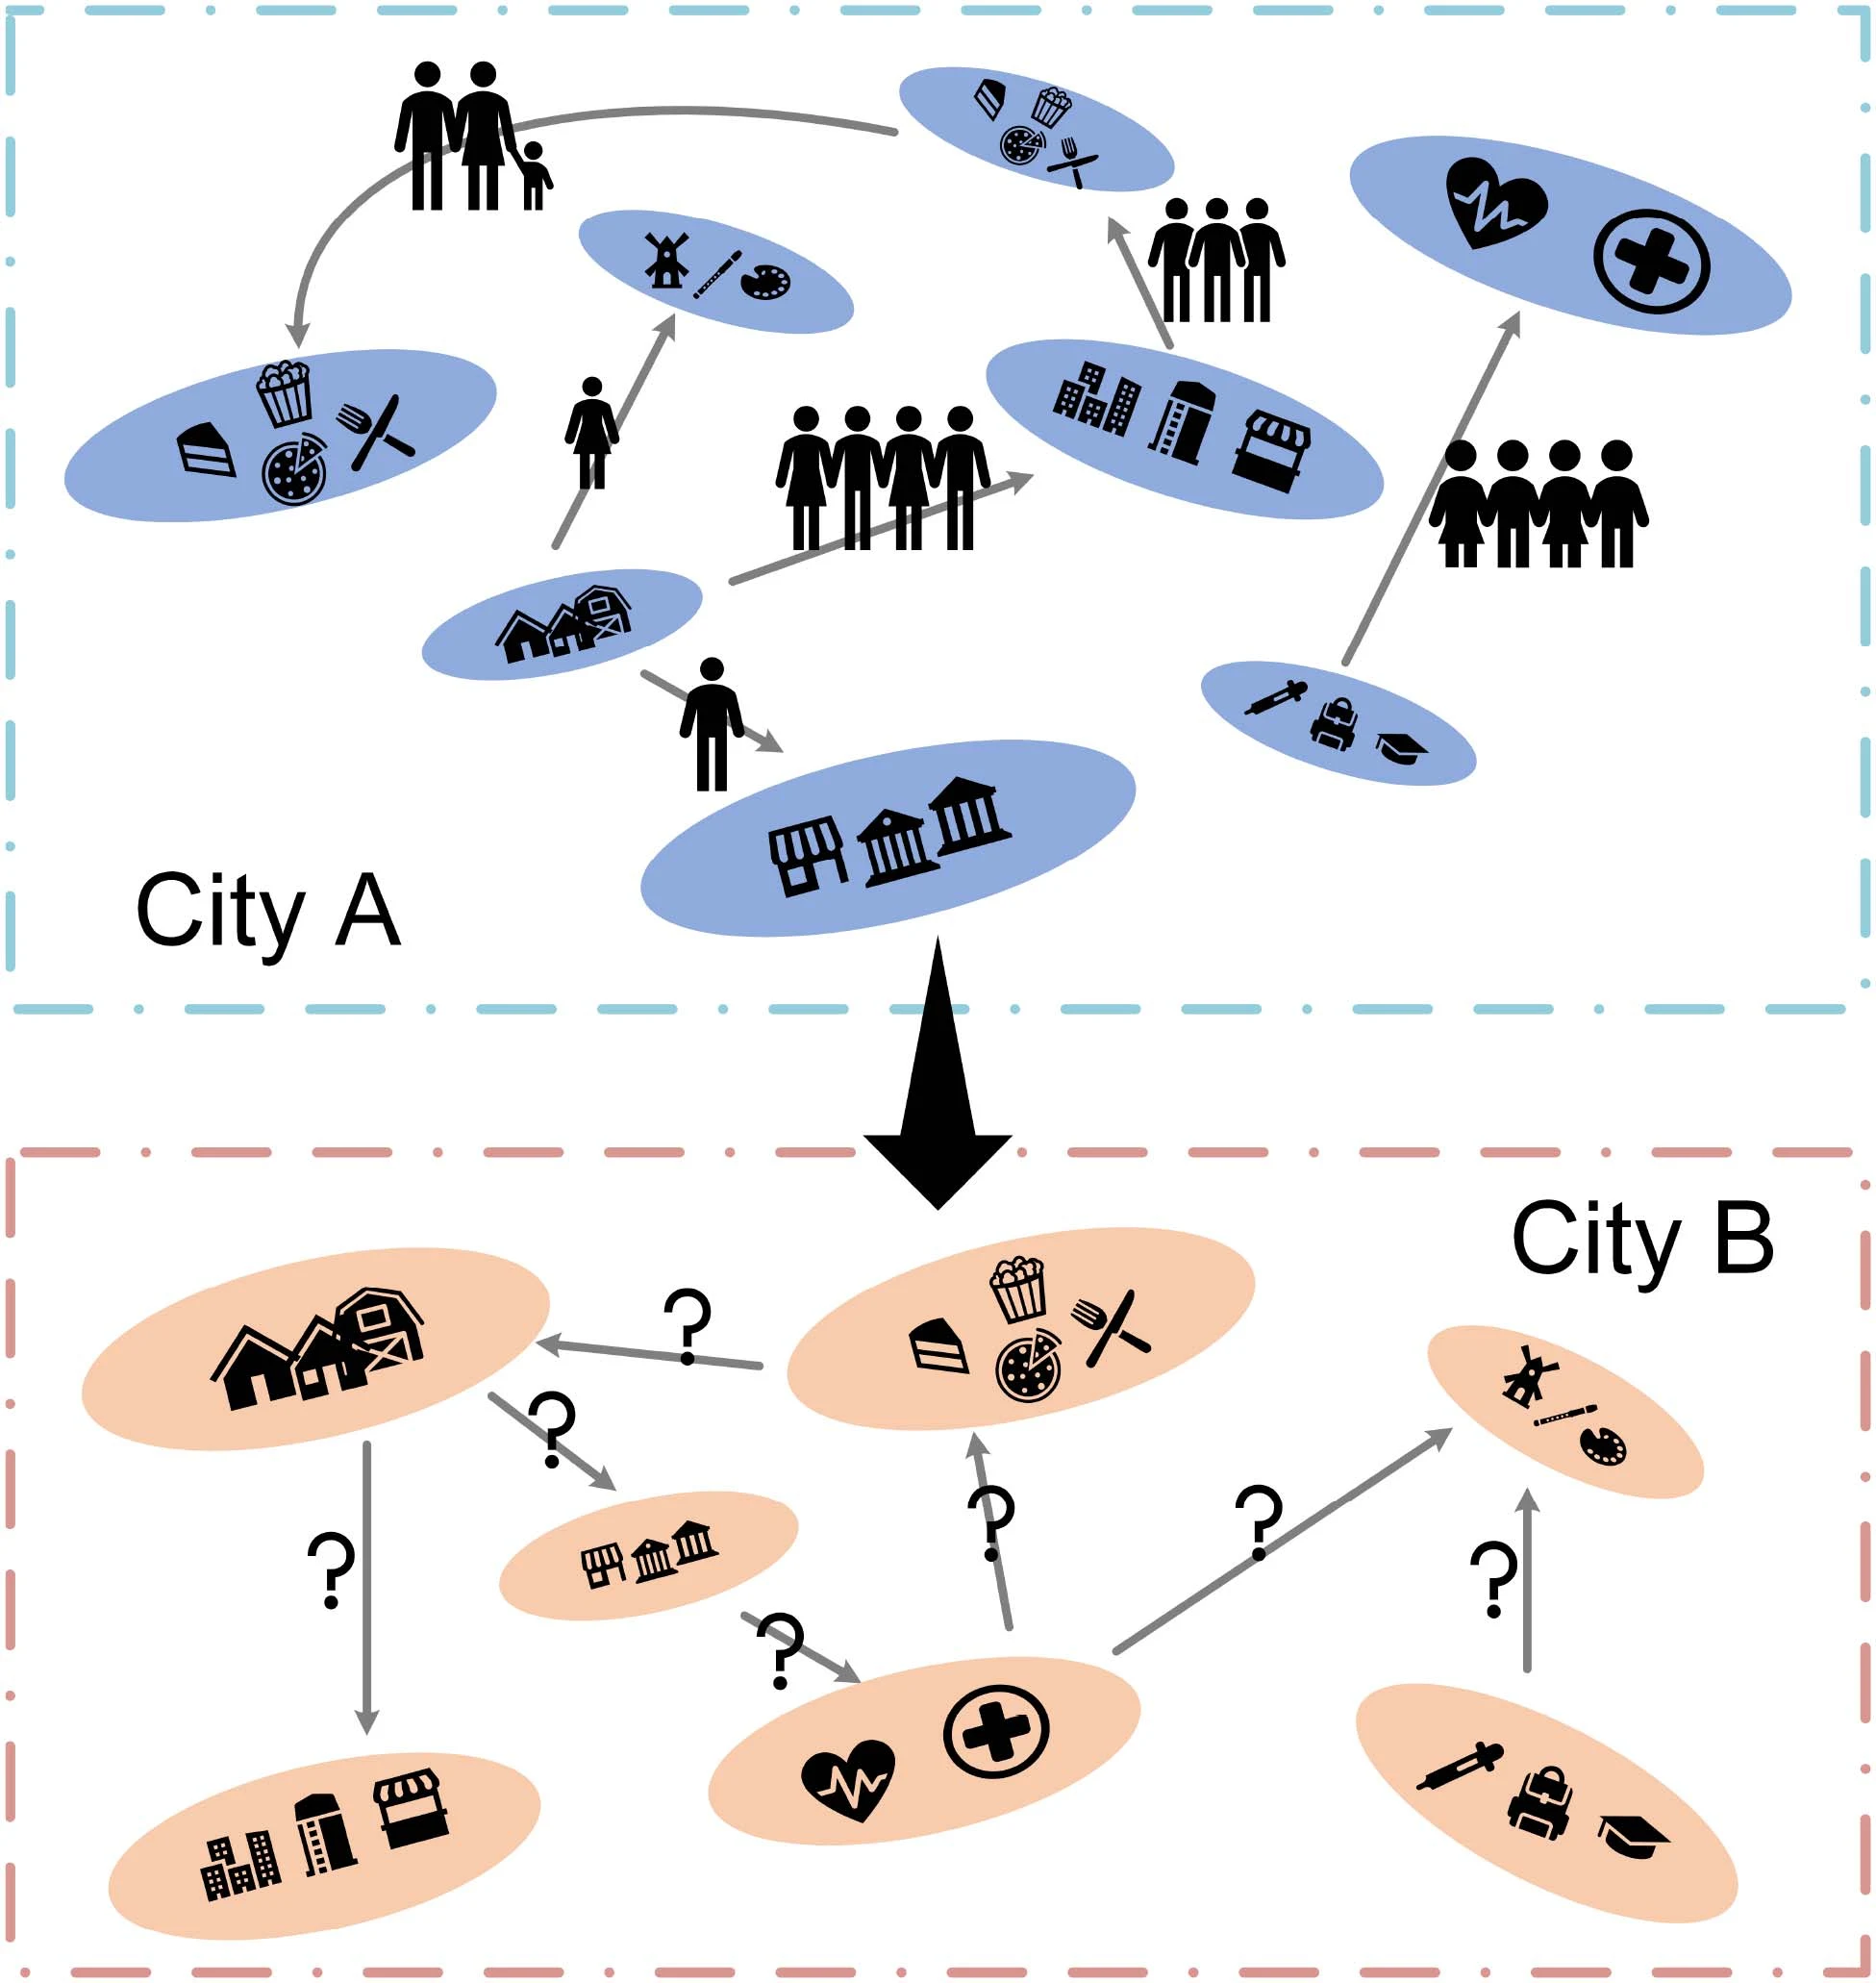
图 1|没有通勤观测的城市,生成任务长什么样?
无字母子图。上半 City A 用人群和设施之间的箭头表示已经观测到的流动;下半 City B 保留同类设施,箭头上换成问号。中间的大箭头表示把源城市中学到的关系用于目标城市。这是任务示意图,没有城市名、流量刻度或误差。来源:原论文 Fig. 1。
数据分成美国和中国两套,正文都没有给出调查年份、区域个数、起讫对个数,也没有给出通勤总量。
美国的人口来自年度美国社区调查(American Community Survey,ACS),兴趣点来自 OpenStreetMap,职住数据和通勤流量都来自就业统计 LODES(Longitudinal Employer-Household Dynamics Origin-Destination Employment Statistics)。城市图由美国普查局的制图边界连接。区域特征因此包含 LODES 的职业与居住数据,而要预测的通勤也来自同一套 LODES。正文没有说明这些特征是不是各区域的居住人数和就业人数,也就是流量矩阵的行和与列和。若模型已经看到每个区域的通勤总量,任务就更接近“已知总量后如何分配方向”。
中国只使用北京和上海。人口来自国家统计局,兴趣点来自一家未点名的地图服务,街块边界从网页爬取,通勤由一家大型移动应用的 GPS 轨迹处理得到。论文把中国更大的 RMSE 归因于街块划分更粗。两边的采集方式也不同:一边是居住—工作统计,一边是应用轨迹整理出的通勤。两国 RMSE 的数值水平不宜直接比谁更准。
同一座城市里训好的模型,为什么换城就会失效?
区域当起点和当终点时,人口、兴趣点、职住状态起的作用不同。流量还受距离和邻居影响:一个区域能送出多少人、吸引多少人,和周围区域连在一起。城市结构不同,源城市里拟合的参数也不能原样套用。
引力模型参数少,把区域特征当作“质量”,再让流量随距离按幂律衰减。随机森林、GBRT 和 XGBoost 能拟合非线性,图注意力网络(graph attention network,GAT)会把邻居信息收进区域表示。GMEL 在图表示之外,用进出流量的多任务学习和 GBRT 做最终预测;正文条目标题印成 GEML,正文随即称该方法为 GMEL。这些模型的共同缺口,是参数主要在单一城市里拟合,换到没有通勤标签的城市就没有迁移机制。已有的跨城工作更多生成个人轨迹或起讫对,不生成区域之间的流量大小。
本文的生成模型因此拆成两截。特征提取要同时处理“区域自身”和“两区域之间”。流量预测再把这两类信息交到一起,并用距离给预测一个上限。
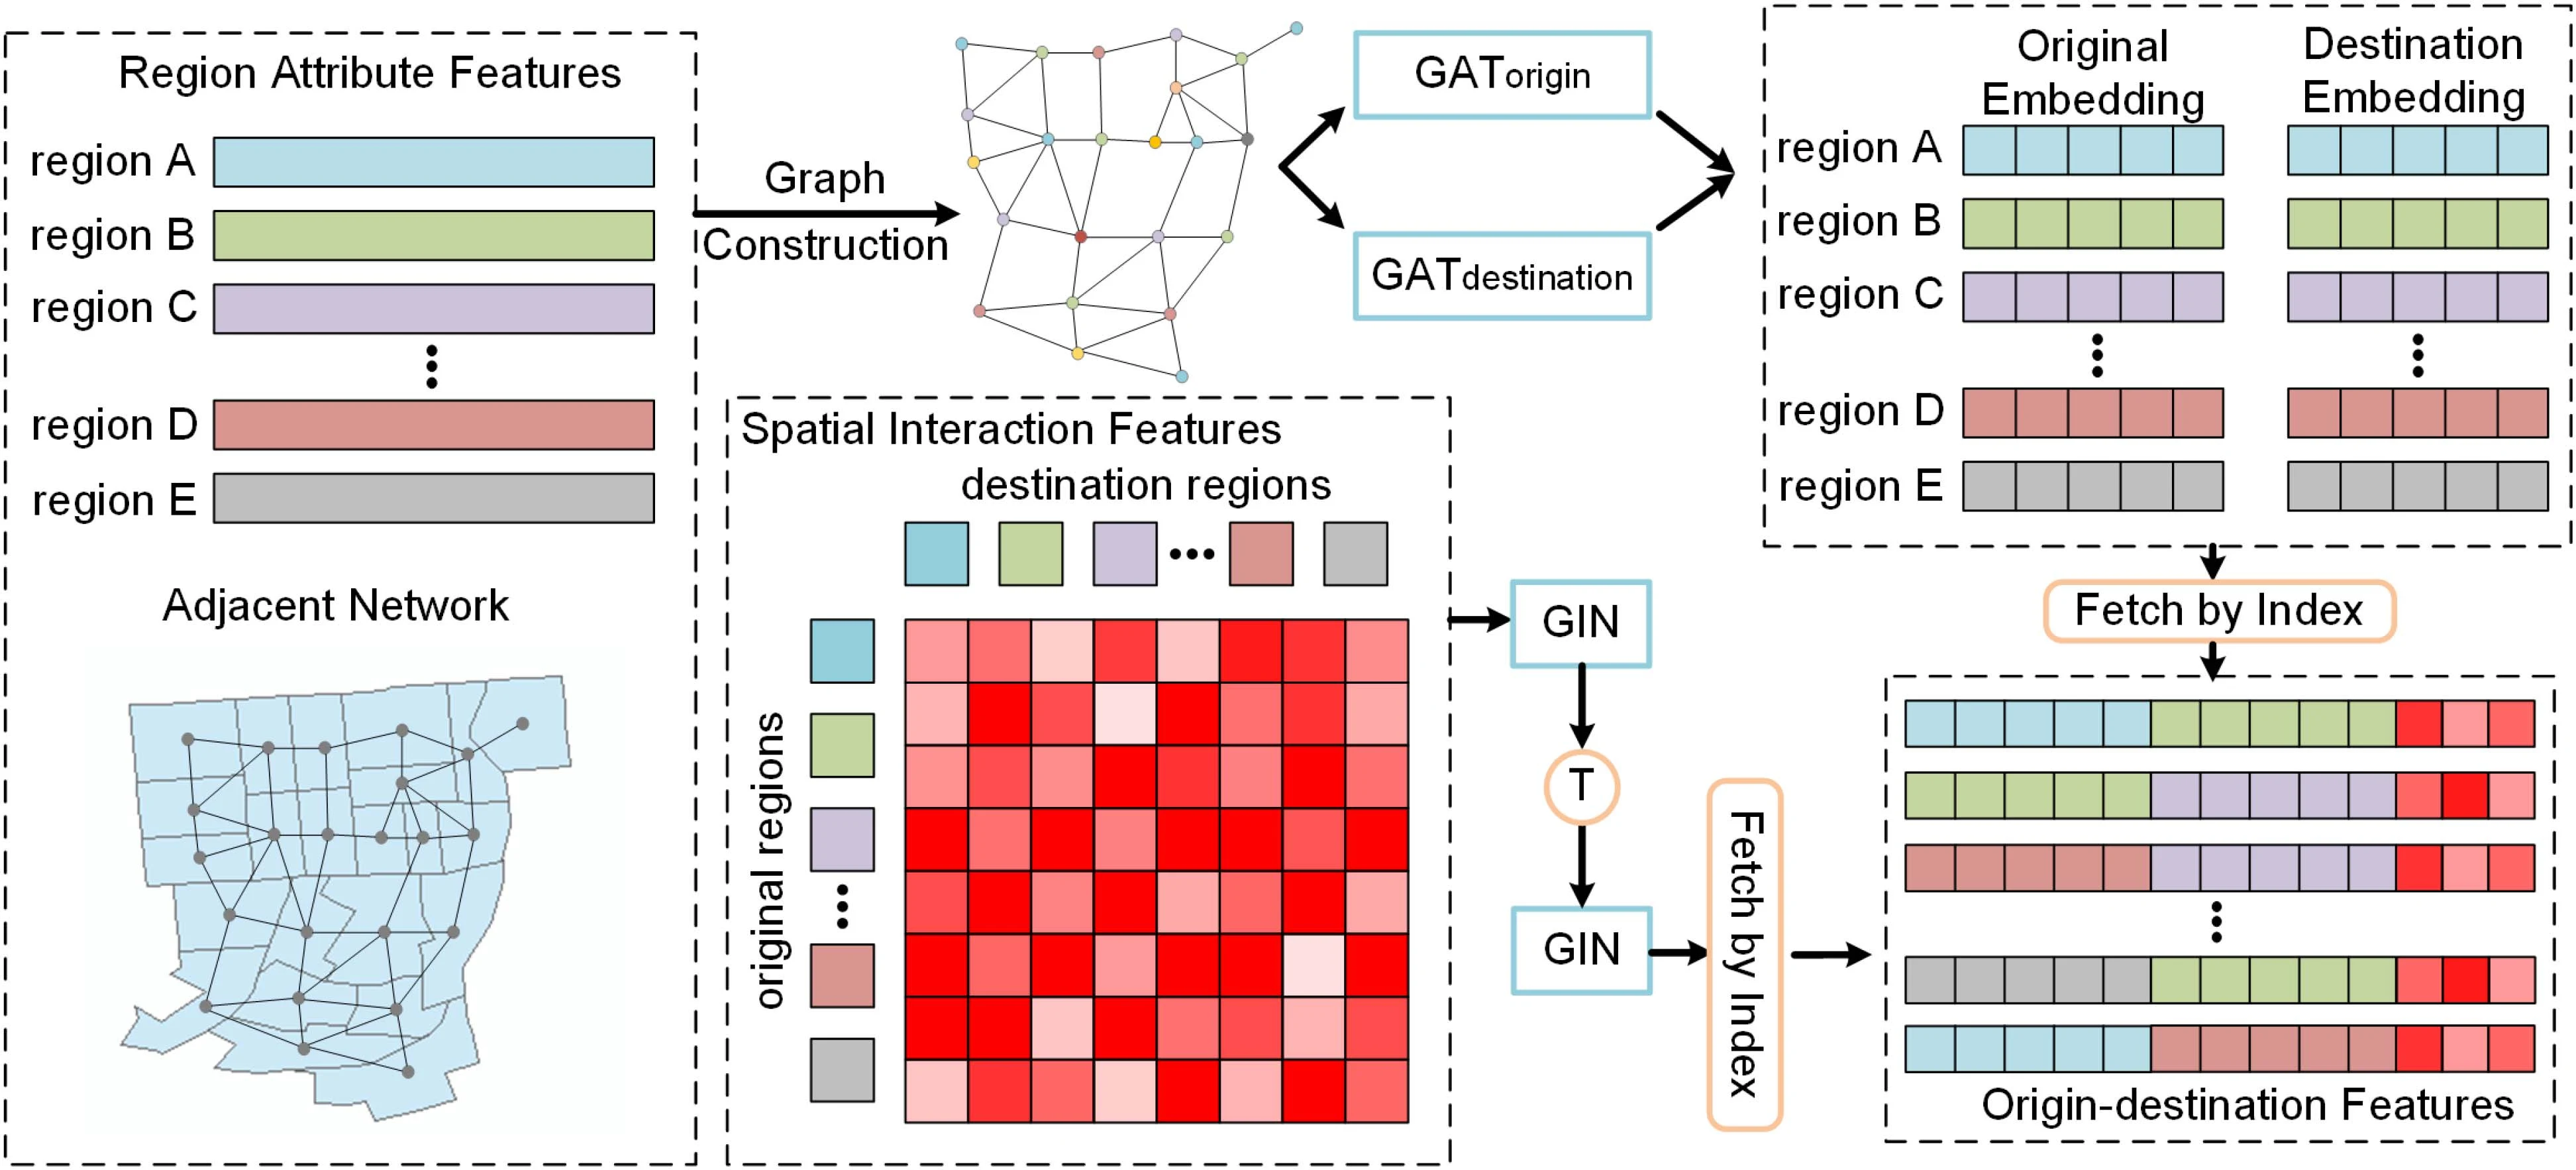
图 2|区域属性和两地距离,怎样变成一对起讫特征?
无字母子图,从左到右是数据流。左侧把区域 A 到 E 的属性条和相邻网络建成图,再分两路 GAT:一路产生区域作为起点的表示,一路产生作为终点的表示。下方的红网格是起点区域乘终点区域的空间交互特征;两个图同构网络(graph isomorphism network,GIN)前后处理这个网格,中间的 T 表示转置,用来调换起点视角和终点视角。右侧按索引取出起点表示、终点表示和边表示,拼成起讫特征。颜色区分区域,网格深浅表示交互强度,图中没有流量数值。来源:原论文 Fig. 2。
GAT 用多头注意力聚合邻居。每一头先按节点特征计算注意力,再加权求和,各头拼接后经过非线性变换。公式(2)下面有一句把其中的 h 说成两区域距离;图 2 则把区域属性交给 GAT,把交互网格交给 GIN。后文按图 2 的数据流理解,注意力权重仍是由节点特征算出来的。
GIN 写成归纳式,以便用到节点数和连边都不同的另一座城市。一层的更新是:把自身特征乘上 (1+ε),加上邻居特征的平均,再送进多层感知机。ε 可学习。两个 GIN 之间的转置,对应矩阵补全里对行图和列图分别处理的想法。
一对区域的最终表示,是起点表示、终点表示和边表示三者拼接。流量头再做两件事。第一,把区域表示和交互表示做外积,得到二阶交叉特征,并与原表示接在一起,送进多层感知机。第二,用传统的距离幂律做上限:
生成流量 = min(a × 距离的 b 次方 + c,多层感知机的输出)。
a、b、c 由流量较大的一部分起讫对拟合。取较小值只会压低高出这条幂律曲线的预测,不会单独修正那些真实流量很小、预测却仍然低于曲线的格子。正文没有报告有多少起讫对真的被截断,也没有写明 a、b、c 是否只在源城市上拟合。训练时的生成损失,是全部 N×N 个区域对上平方误差的平均。评价用的 RMSE 分母写成起讫对集合的大小 |X|。正文没有说明 |X| 是否包含区域内部通勤,以及是否包含流量为零的区域对。
对抗训练对齐的是特征,打分用的是源城市通勤
换城要解决的是特征分布不同。模型用两套特征提取器分别处理源城市和目标城市,再用最大均值差异衡量两侧表示差多远。直观地说,MMD 比较三块:源城市表示彼此的核相似、目标城市表示彼此的核相似,以及跨城市成对的核相似。核是高斯核。MMD 越小,两侧表示的分布越接近。
同时放一个城市分类器,尽量分辨表示来自哪一座城市。特征提取器则尽量让分类器分辨失败。流量预测头只拿源城市的真实通勤计算平方误差。三者交替更新:先按 MMD 更新特征提取器,再按交叉熵更新分类器,最后按源城市的生成误差同时更新特征提取器和流量头。算法写到生成误差收敛为止。正文没有给出学习率、轮数,也没有给出主实验实际使用的批量大小。
图模型的主实验把隐层宽度设为 64、层数设为 3,优化器为 Adam。树模型用 scikit-learn,超参数用其网格搜索。
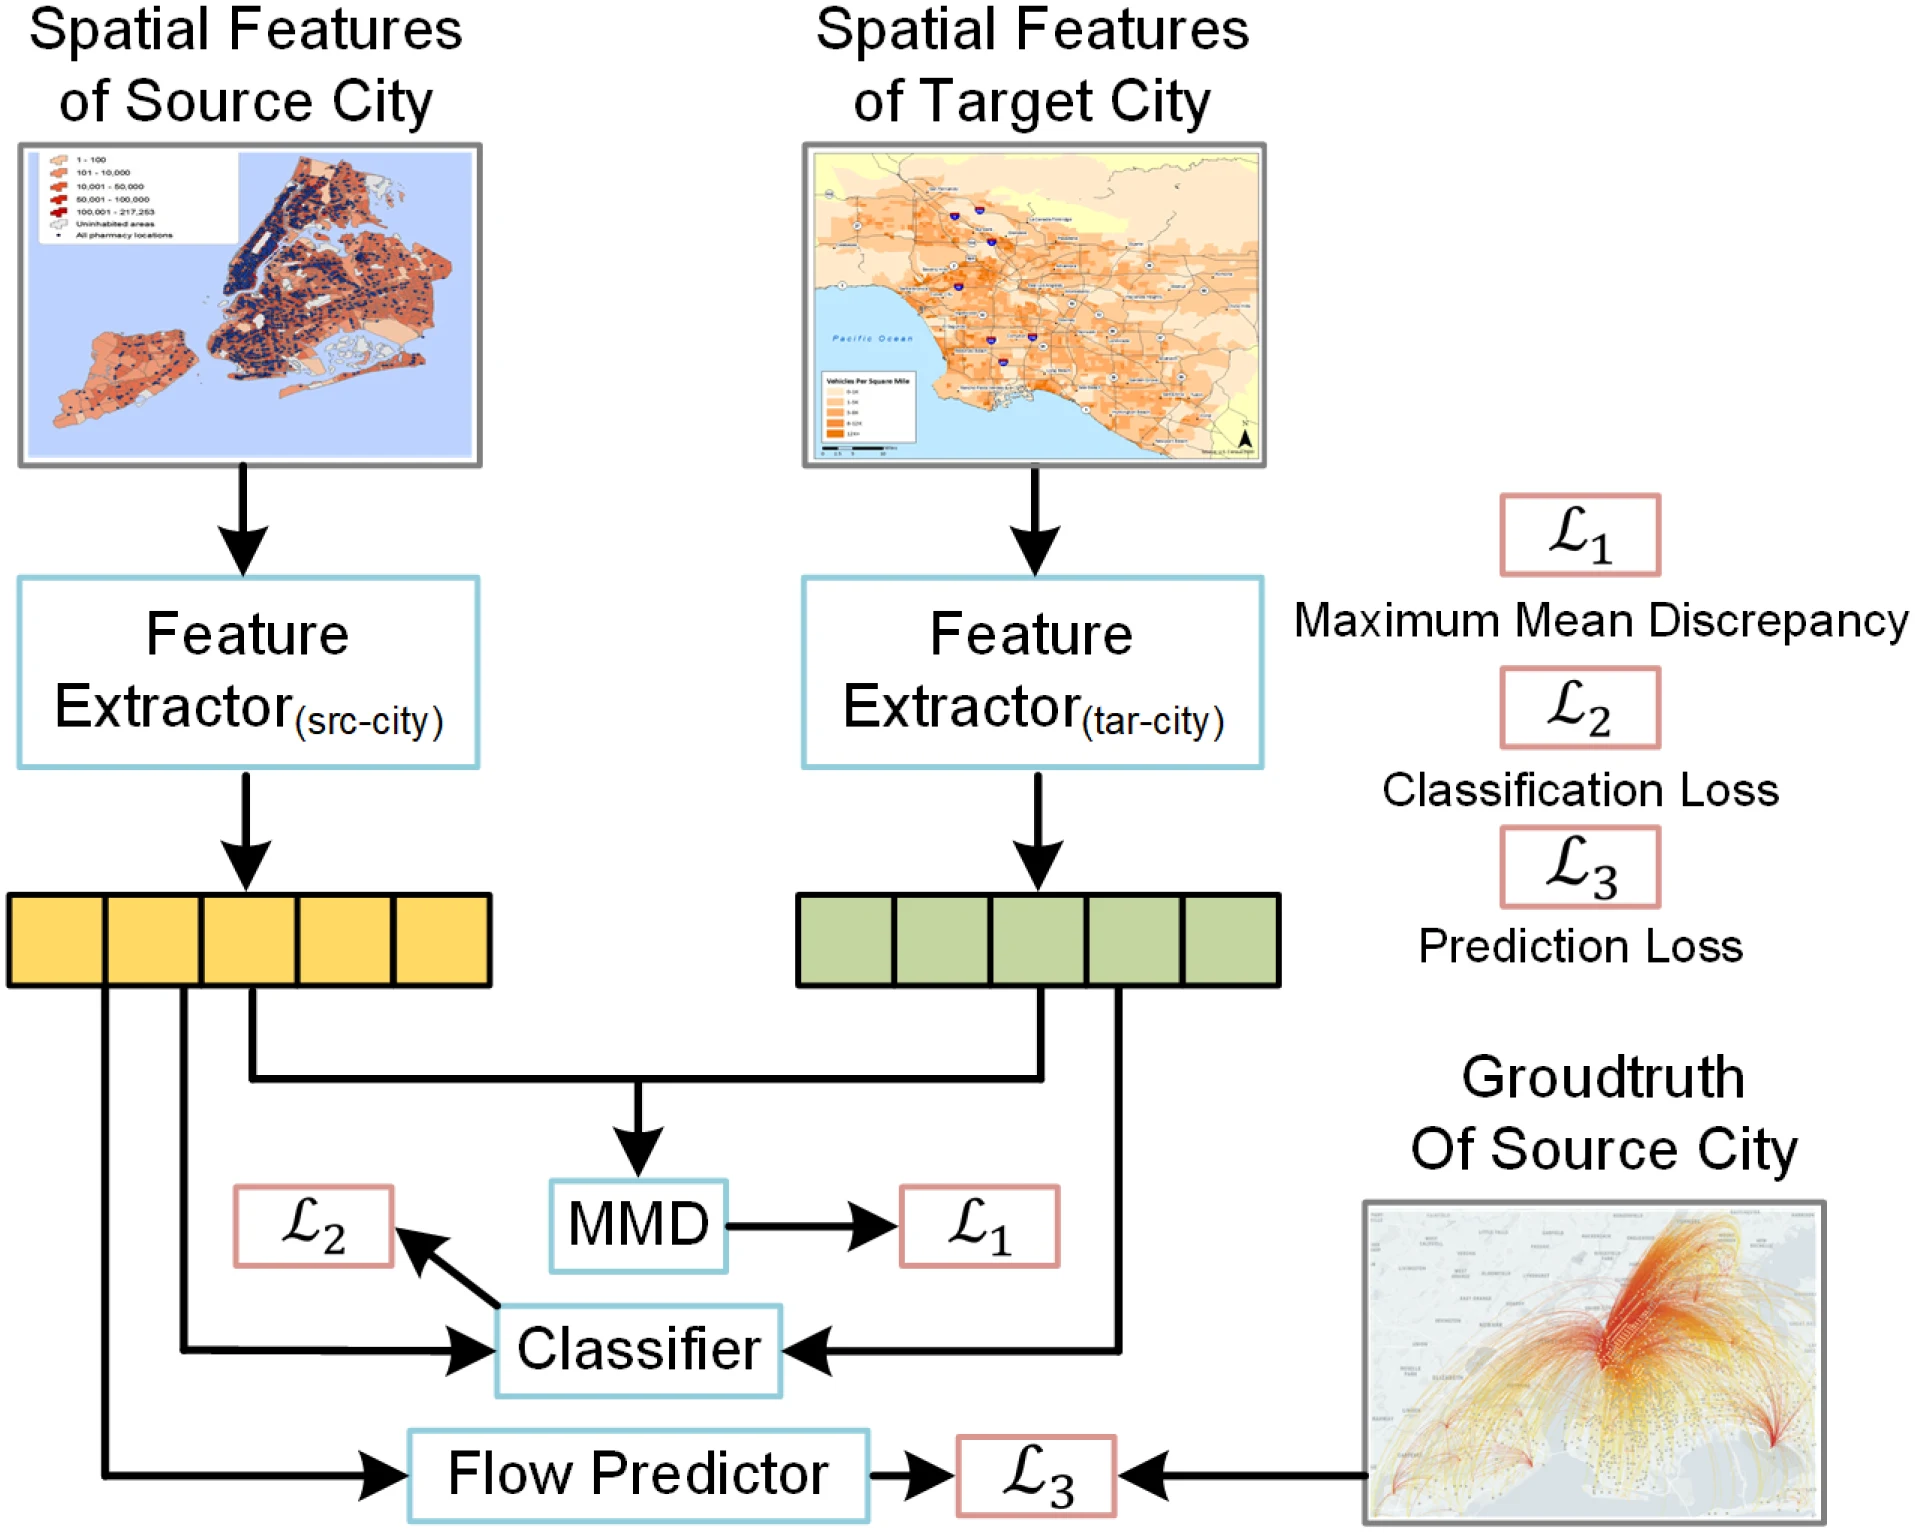
图 3|训练时哪一项损失看过目标城市的通勤?
无字母子图。左右两条支路分别提取源城市和目标城市的空间特征。两侧表示之间的 MMD 标为 L1;城市分类器的损失标为 L2;流量头只与源城市的真实通勤比较,标为 L3,图中真实通勤写成 Groudtruth。右侧图例把三项损失分别称为最大均值差异、分类损失和预测损失。底图没有城市名。来源:原论文 Fig. 3。
读训练步骤时以这张图和公式为准:L1 拉近两城特征,L2 训练分类器,L3 只在源城市上比较生成流量和真实通勤。算法 1 又把源城市上的生成损失写成 L1,与图 3、公式(7)的编号不一致。
图 4(c) 把分类器的反向传播次数设为特征提取器的 10 倍,用来维持双方的拉锯。这个比例是超参数选择,后面和误差曲线一起看。
八组建成城市之间,误差相对谁下降?
测试指标有三个。RMSE 是起讫对上平方误差的均方根,分母是 |X|,越低越好,单位与流量相同。CPC(common part of commuters,通勤流量的公共部分)把观测流量和预测流量看成两堆非负数量:分子是两者逐对取较小值之和的两倍,分母是两堆总量之和。它在 0 到 1 之间,越高表示重叠越多。后文洛杉矶到纽约的 0.65,用的就是这个分母。
SMAPE 是对称相对误差,越低越好。公式(12)的分子印成观测减预测,没有绝对值,式前还有 100%;表中却是 0.52 到 1.05 这样的正小数。若既乘 100% 又不取绝对值,对不上这些表值。下文引用表中的小数,不把 0.73 改写成 73%。
美国六组里,五组以纽约为源城市,只有洛杉矶到纽约是反向。表中的 DC、San、Chi、Sea 只以缩写出现,正文没有写出全称。中国是北京与上海两个方向。箭头左侧是源城市,右侧是目标城市。
| 迁移方向 | 该组最低基线 RMSE | GODDAG 的 RMSE | 相对降幅 | 该组最高基线 CPC | GODDAG 的 CPC |
|---|---|---|---|---|---|
| 纽约 → 洛杉矶 | GBRT 6.92 | 5.48 | 20.8% | 0.54(GBRT、GAT、GMEL 并列) | 0.59 |
| 洛杉矶 → 纽约 | GMEL 6.32 | 5.14 | 18.7% | GMEL 0.63 | 0.65 |
| 纽约 → DC | GMEL 25.17 | 21.33 | 15.3% | RF 0.52 | 0.56 |
| 纽约 → San | GMEL 23.14 | 20.99 | 9.3% | RF 0.57 | 0.58 |
| 纽约 → Chi | GMEL 5.11 | 4.88 | 4.5% | GMEL 0.68 | 0.70 |
| 纽约 → Sea | RF 16.59 | 13.51 | 18.6% | RF 0.56 | 0.61 |
| 北京 → 上海 | GMEL 369.71 | 324.02 | 12.4% | GMEL 0.57 | 0.61 |
| 上海 → 北京 | GMEL 263.94 | 183.74 | 30.4% | GMEL 0.57 | 0.60 |
相对降幅的分母,是同一行最强基线的 RMSE,计算为(基线 − GODDAG)÷ 基线。前六行的算术平均是 14.5%。若对 CPC 做(GODDAG − 最强基线)÷ 最强基线,前六行的算术平均是 5.62%。这两句和论文贡献陈述里的两个百分数一致。贡献陈述没有写明分母;把它理解成“相对引力模型”或“把中国两组也算进去”,都对不上 14.5% 和 5.62%。
表 I 里 GODDAG 的 SMAPE 在六组美国迁移上都是同组最低,例如纽约到洛杉矶为 0.73,同组次低的 XGB 为 0.90;纽约到 Chi 为 0.52,GAT 为 0.53。个别基线会超过 1:纽约到 San 的 XGB 为 1.02,纽约到 Chi 的 GBRT 为 1.05。图网络也不总是强过树模型。纽约到洛杉矶,GBRT 的 RMSE 6.92 低于 GAT 的 7.23 和 GMEL 的 7.21。纽约到 Sea,GMEL 的 RMSE 是 22.42,高于 GAT 的 21.13,也高于随机森林的 16.59。
中国两组的 SMAPE、CPC 与美国的排序大体同向,但上海到北京的 SMAPE 上,GODDAG 是 0.72,与 GAT 相同,低于 GMEL 的 0.74。这一格是并列最低,不是单独最低。
这些比较发生在迁移设定下。正文说明树模型用 scikit-learn 实现,但没有逐一写明每个基线是否也使用了目标城市的无标签特征。GODDAG 的训练明确用到了这些无标签特征。
误差是在哪一步降下来的?
消融只做纽约与洛杉矶两个方向,从 GAT 开始逐项加模块。表 III 的标题印成 Abalation Study。表中洛杉矶到纽约的 GAT 起点是 RMSE 6.79、SMAPE 0.70、CPC 0.61。表 I 同一方向的 GAT 是 6.39、0.70 和 0.62。纽约到洛杉矶的 GAT 两表一致,都是 7.23、0.95、0.54。下面的加减只沿表 III 进行。
| 版本 | 这一行新增的设计 | 纽约 → 洛杉矶:RMSE / SMAPE / CPC | 洛杉矶 → 纽约:RMSE / SMAPE / CPC |
|---|---|---|---|
| GAT | 对照起点 | 7.23 / 0.95 / 0.54 | 6.79 / 0.70 / 0.61 |
| ours-v1 | 用两个 GIN 处理交互特征 | 6.81 / 0.83 / 0.54 | 6.31 / 0.64 / 0.62 |
| ours-v2 | 再加上区域与交互的外积 | 6.60 / 0.79 / 0.57 | 5.74 / 0.64 / 0.62 |
| ours-v3 | 再加上距离幂律上限 | 6.18 / 0.77 / 0.57 | 5.49 / 0.58 / 0.63 |
| ours-v4 | 改为梯度反转,并去掉 MMD | 5.52 / 0.74 / 0.59 | 5.22 / 0.54 / 0.64 |
| ours | 完整模型,保留 MMD | 5.48 / 0.73 / 0.59 | 5.14 / 0.53 / 0.65 |
两个 GIN 先把交互网格纳进来。外积在纽约到洛杉矶把 CPC 从 0.54 提高到 0.57,RMSE 从 6.81 降到 6.60。距离上限再把这一方向的 RMSE 从 6.60 降到 6.18,CPC 仍是 0.57;洛杉矶到纽约的 SMAPE 从 0.64 降到 0.58。上限带来的是一截额外下降,幅度小于后面的对抗步骤。
ours-v4 用梯度反转层替换论文中的对抗更新,并去掉图 3 的 L1,也就是 MMD。相对 v3,纽约到洛杉矶的 RMSE 从 6.18 降到 5.52,降幅为 (6.18−5.52)/6.18,约 10.7%;CPC 从 0.57 到 0.59。洛杉矶到纽约的 RMSE 从 5.49 到 5.22,约降 4.9%,CPC 从 0.63 到 0.64。
完整模型把 MMD 加回后,纽约到洛杉矶的 RMSE 从 5.52 到 5.48,相对再降约 0.7%,CPC 保持 0.59。洛杉矶到纽约从 5.22 到 5.14,约再降 1.5%,CPC 从 0.64 到 0.65。按这两行的数字,对抗式对齐贡献了更大的一段,显式 MMD 是在此之上的小幅继续下降。表 III 没有重复次数或区间,看不出 0.04 的 RMSE 差别是否稳定。
宽度、层数和更新次数,在哪一段比较稳?
主实验固定隐层宽度 64、图网络 3 层。图 4 改这些设置,看 RMSE 怎么变。正文没有写这四条曲线属于哪一对城市,因此不把曲线归到某一次迁移。每条曲线都有竖线,正文没有说明竖线是标准差、多次运行还是别的范围,所以这里不从竖线读出具体误差。
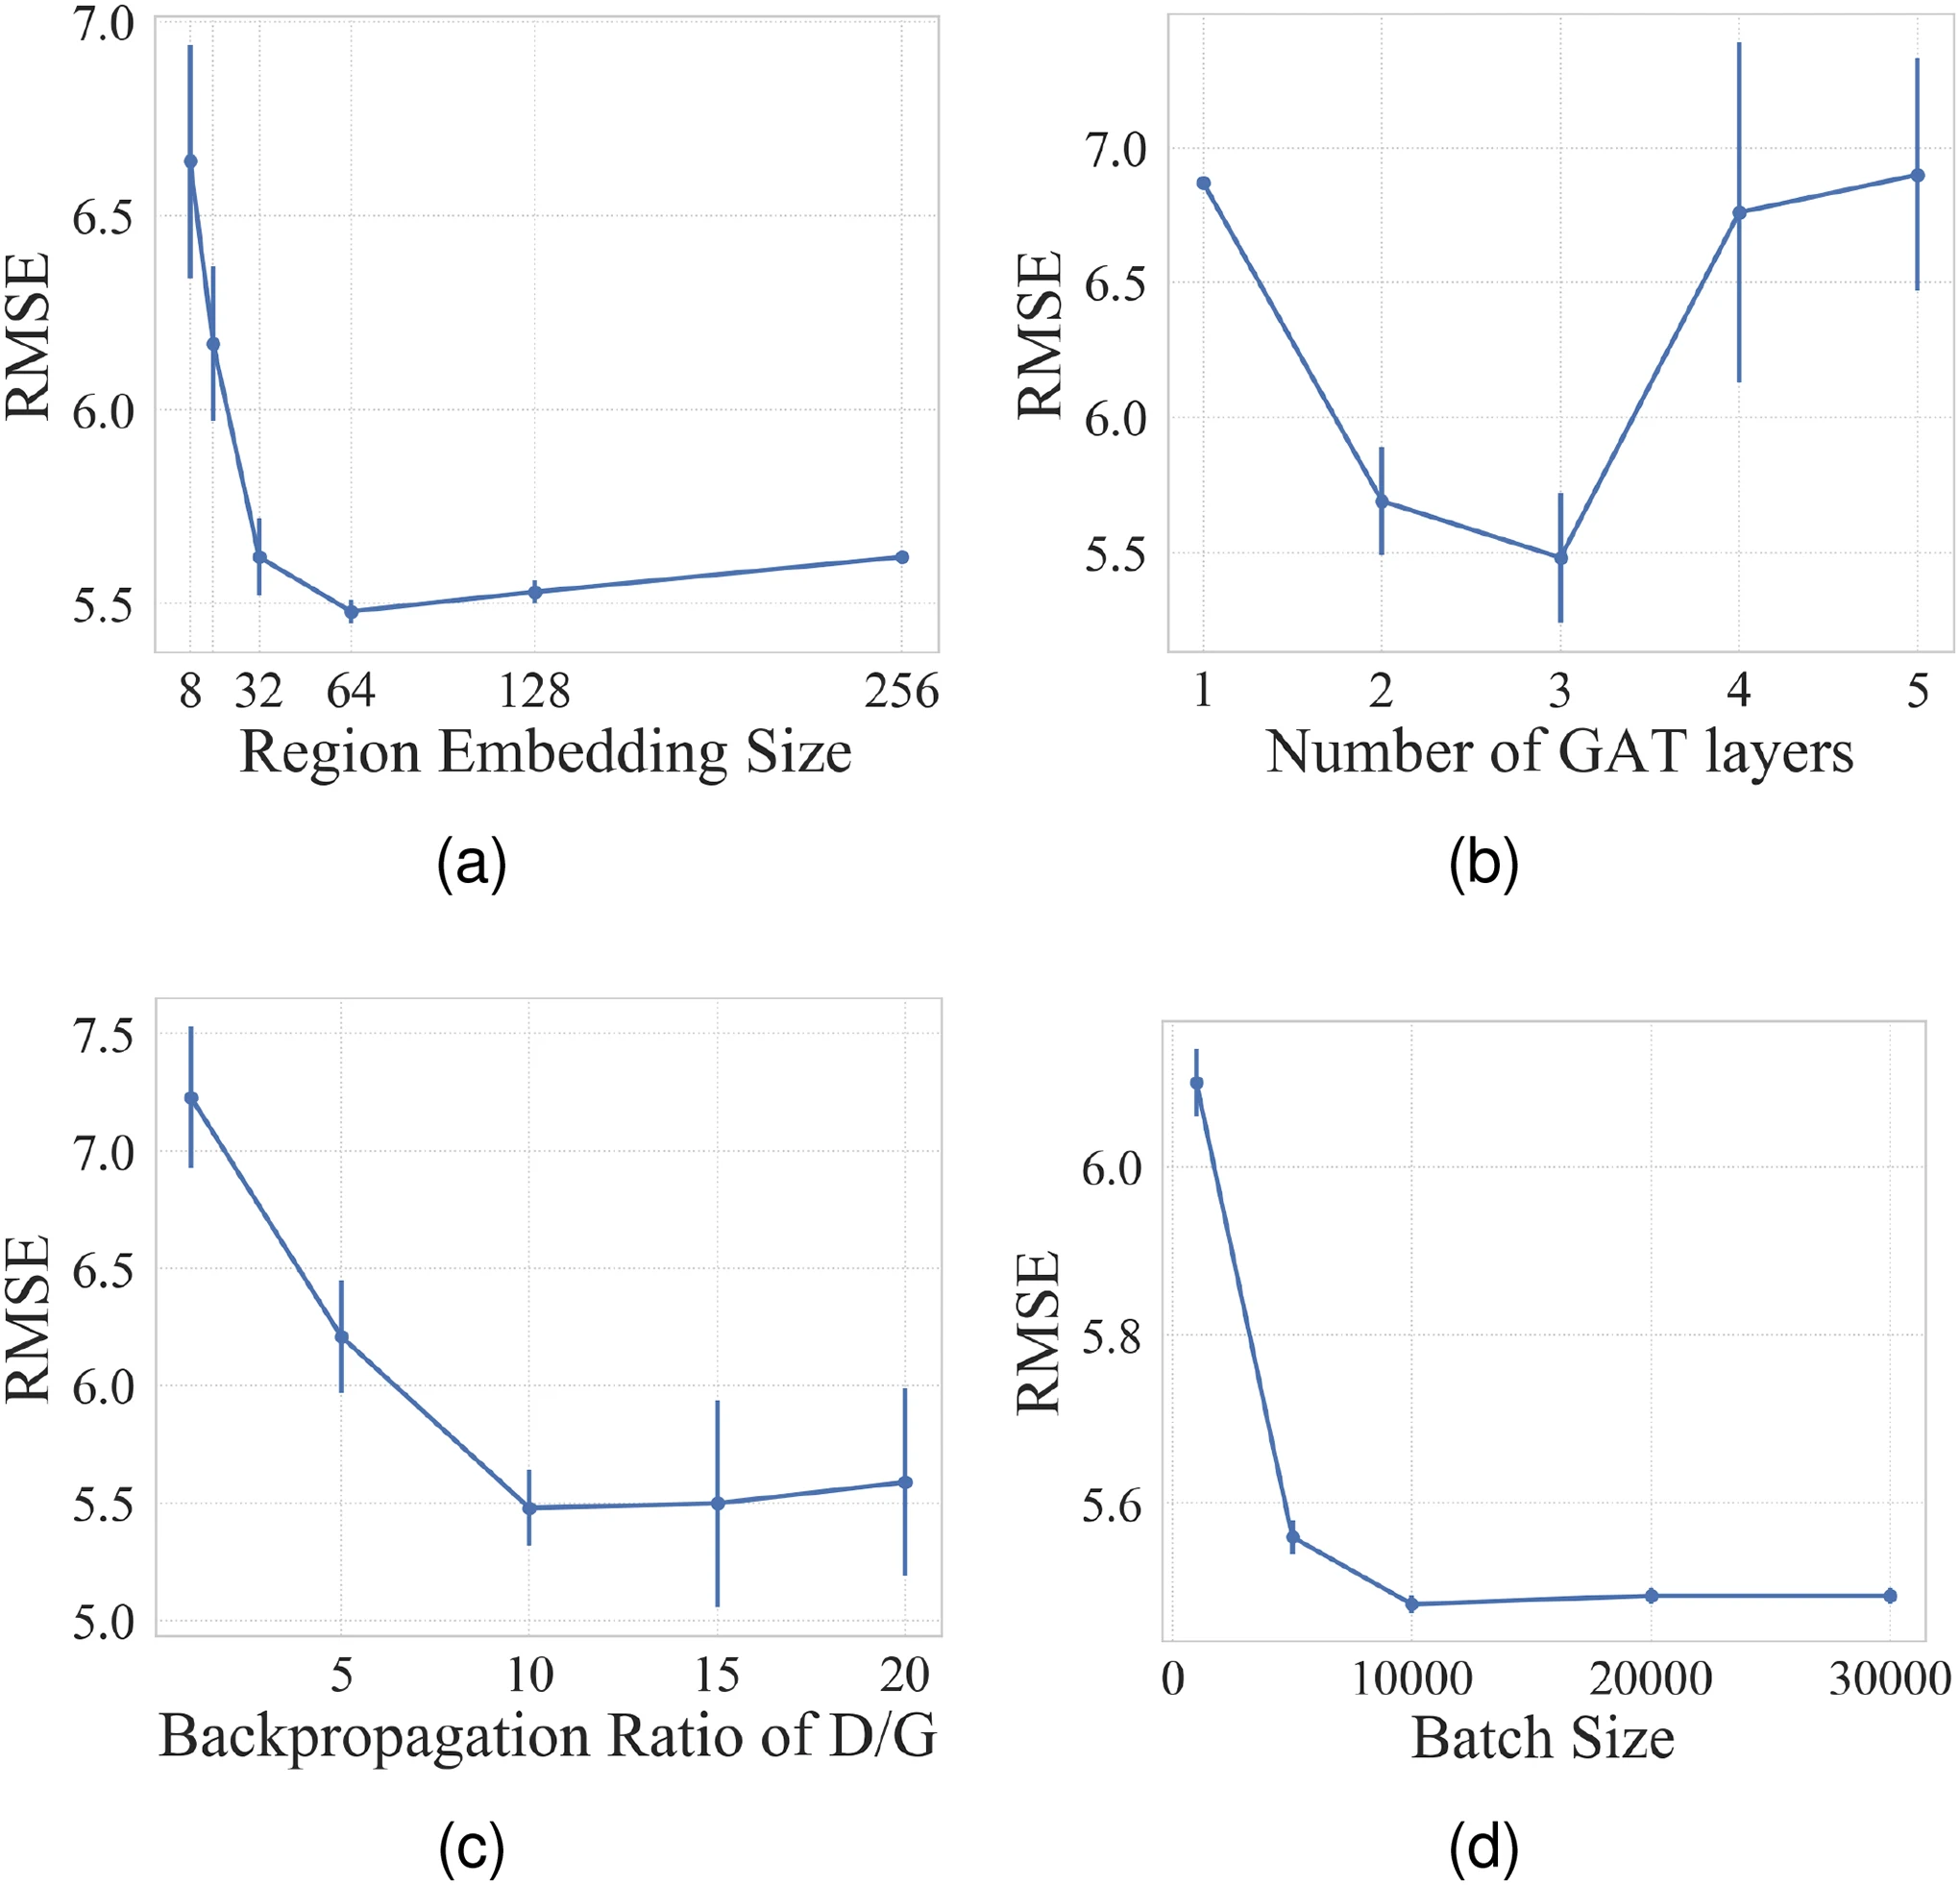
图 4|哪些超参数会让迁移误差明显变高?
(a)横轴是 GAT 之后的区域嵌入维度,标出 8、32、64、128、256;曲线在 64 附近最低,更小维度更高,更大维度略升。(b)横轴是 GAT 层数 1 到 5;3 层最低,4 层和 5 层回升,竖线也更长。正文把 3 层以上的变差归为过度平滑。(c)横轴是分类器与特征提取器的反向传播次数比,标出 5、10、15、20;10 附近进入平台,再增大没有继续明显变好。正文据此把分类器的更新次数设为特征提取器的 10 倍。(d)横轴是批量大小,标出 0、10000、20000、30000;从很小的批量增到约 10000 时下降,之后几乎走平。四个子图的纵轴范围不同,(d)的刻度更窄,斜率不能和(a)(b)直接比较。来源:原论文 Fig. 4。
这张图说明主实验选在曲线的低处附近,也说明层数过多会变差。正文没有给出主实验表格使用的批量大小。
生成的纽约通勤,地图上像不像观测?
定量表之外,论文只展示了一对城市的弧线图:源城市是洛杉矶,目标城市是纽约。一条弧表示两端区域之间有流量。红色一端是起点,蓝色一端是终点,线越亮流量越大。正文没有给亮度对应的人数,也没有计算空间重合指标。
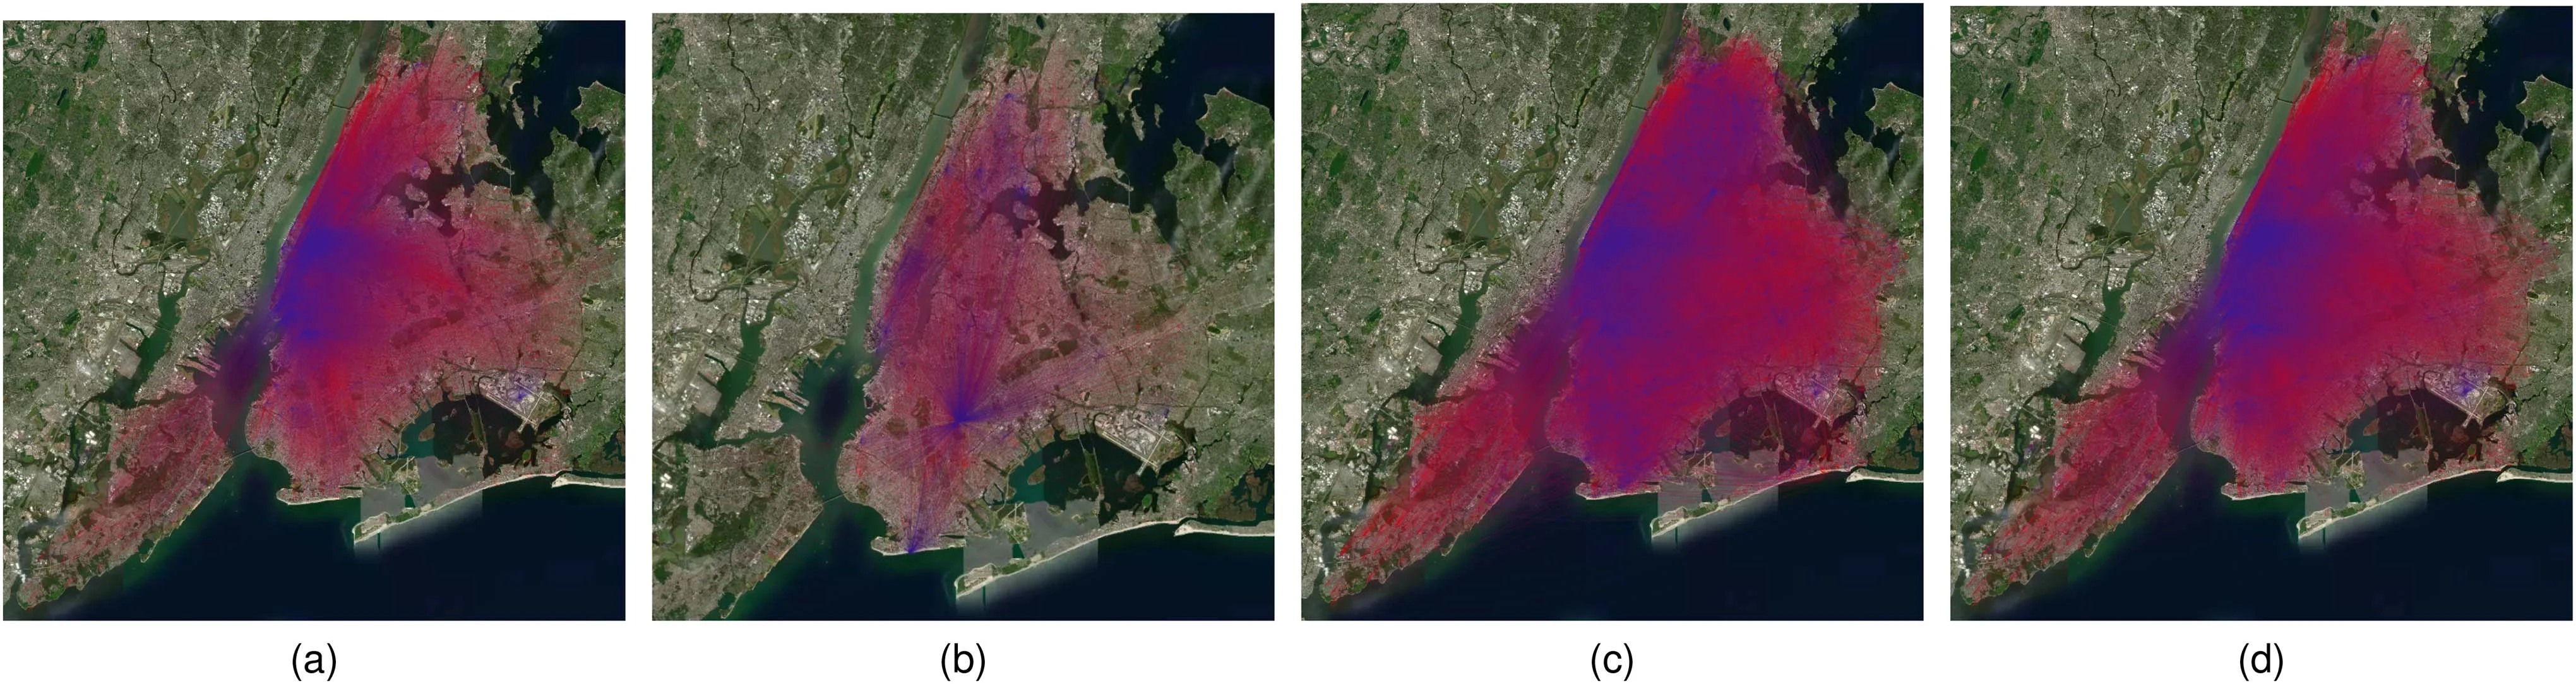
图 5|洛杉矶学到的模型,生成的纽约通勤落在哪里?
(a)纽约通勤的观测。作者读出的格局是:人到市中心工作,住在外围,又倾向于住得离中心近一些,所以离中心更远的居住更少。(b)引力模型。分布相对观测偏移,就业中心被放到偏离曼哈顿的位置。(c)图注意力网络。市中心的就业位置对上了,但不少终点散到北部的布朗克斯和南部的布鲁克林,与观测冲突。(d)GODDAG。作者认为空间分布与观测几乎相同。四幅都是目视比较;正文同时写明,所有方法都把小流量起讫对预测得偏大。来源:原论文 Fig. 5。
(d)与(a)的目视接近,和表 I 中洛杉矶到纽约的 CPC 0.65 可以同时成立:CPC 由大流量主导时,地图上的主骨架会很像,细小连边仍可以系统性偏大。作者把这个长尾列为后续问题。图 5 只覆盖洛杉矶到纽约;纽约到 Sea 的 RMSE 是 13.51,不在这张图里。
这些结果可以停在哪一步?
八组比较支持的判断是:在目标城市已有人口、兴趣点和相邻关系、训练时又看不到它的通勤标签时,这套图表示加上领域对抗,能比表中的基线得到更低的流量误差。误差下降依赖具体的城市对。美国六组有五组把纽约当作源城市。14.5% 是这六组相对降幅的平均,其中五组是从纽约迁出,另一组是洛杉矶迁到纽约。
实验城市都已经建成,测试时使用真实通勤。论文开头讨论的新建城区和规划方案模拟,没有单独的实验。那里的人口和兴趣点会是方案假设,而这八组使用的是已经实现的城市特征。
模型输出是通勤矩阵的拟合值。CPC 高表示两张流量表的体积重叠大;距离和兴趣点进入了特征,实验没有单独证明居民因此选择了工作地。表 I 与表 III 对洛杉矶到纽约的 GAT 起点不一致,消融的绝对水平要按表 III 单独阅读。幂律上限的参数来自有流量标签的起讫对;若拟合时用到目标城市的通勤,所谓目标城市没有标签就会被削弱。正文没有把这件事写清楚。
一句话总结
目标城市拿得出区域特征、拿不出通勤表时,GODDAG 能在八组已建成城市的迁移中降低流量误差;降幅随城市对变化,生成的仍是通勤矩阵的拟合,小流量连边依旧偏大。
核心来源
- Rong C., Feng J., Ding J. GODDAG: Generating Origin-Destination Flow for New Cities Via Domain Adversarial Training. IEEE Transactions on Knowledge and Data Engineering, 2023, 35(10): 10048–10057. DOI:10.1109/TKDE.2023.3268409。正式期刊版,正文图 1–5、表 I–III。
- 参考文献中的引力模型、辐射模型、GMEL、GAT 与领域对抗训练,只用来说明本文相对这些工作改了什么;它们的数值不是本文实验。
- 论文参考文献没有给出本方法的代码仓库或数据下载地址。
作者介绍
三位作者的论文署名单位都是北京信息科学与技术国家研究中心(BNRist,论文英文写为 Beijing National Research Center for Information Science and Technology)和清华大学电子工程系。以下只写论文作者介绍中的身份。
- Can Rong:通讯作者。2017年获北京大学软件工程硕士,论文刊出时在清华大学电子工程系攻读博士,导师为 Yong Li。介绍中的方向是城市计算和时空数据挖掘,当时的工作是用图神经网络刻画城市区域之间的相互作用。
- Jie Feng:2016年获清华大学电子工程学士,论文刊出时在同一系攻读博士,导师为 Yong Li。介绍中的方向是时空数据挖掘,当时把深度学习用于移动预测和流量预测。
- Jingtao Ding:2015年、2020年分别获清华大学电子工程学士和博士,论文刊出时是该系博士后。介绍中的方向包括移动计算、时空数据挖掘和用户行为建模,并称已有三十余篇论文发表于 TKDE、TOIS、KDD、NeurIPS、WWW、ICLR、SIGIR、IJCAI 等场合。这是作者介绍中的自述。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若把模型用于一张规划图,输入的人口和兴趣点是方案假设,而八组实验用的是已经实现的城市。可以做一个与论文指标直接衔接的检验:保持路网和区域边界不变,只按规划常见的误差扰动目标城市的兴趣点数量或人口,再看 CPC 和那些小流量连边朝哪个方向动。洛杉矶到纽约的 CPC 是 0.65,图 5 仍显示小流量被估大。公交线路往往取决于这些细边,而 CPC 主要由大流量重叠决定。规划方案至少应同时报告大流量 CPC,以及低于某个通勤人数的起讫对是被高估还是低估。
另一个尚未在文中出现的比较,是把源城市从纽约换成别人。表 I 的六组美国迁移有五组以纽约为源,纽约到 Sea 的 RMSE 仍有 13.51,相对同组最强基线随机森林的 16.59 下降约 18.6%,绝对误差仍明显高于纽约到 Chi 的 4.88。若一座城市要为多座目标城市提供“通勤模板”,下一步应让每座城市轮流当源城市,看 14.5% 这个平均数还剩多少。这个轮换实验论文没有做。