陌生人的出行记录,为什么也可能透露你的下一站?
论文名片|Zexun Chen、Sean Kelty、Alexandre G. Evsukoff、Brooke Foucault Welles、James Bagrow、Ronaldo Menezes、Gourab Ghoshal,Contrasting social and non-social sources of predictability in human mobility,Nature Communications,2022,13:1922,2022年4月8日发表。DOI:10.1038/s41467-022-29592-y,开放存档。
同一家商店的两位常客可能从未说过话,却有相似的作息和活动范围。一个人不再分享自己的定位,是否就不会被别人的记录透露出活动规律?
这篇研究比较两类来源:已记录的社交关系,以及没有记录到社交联系、却常在相同地点相近时段出现的人。熟人通常提供更多关于目标用户的移动信息;但把多个非社交共处者合起来,也可能达到少数熟人的信息水平。这里测的是由熵估计得到的潜在可预测性,论文并未训练一个已经达到这些数字的实际追踪算法。
先说结论
- 同样数量的联系人中,社交关系通常比非社交共处关系提供更多信息;多个共处者的集合则可弥补单人的不足。
- Weeplaces中常被引用的94%和85%,是外推后可预测性相对于用户自身可预测性的比例,不是94%和85%的实际下一站准确率。
- 共同到访地点越多,信息论可预测性通常越高,但关联强度因数据而异,手机通话记录中的关联明显较弱。
- 即使访问错开数小时,非社交关系中仍存在可预测信息;不过只看共同地点也不够,打乱访问顺序的对照通常会损失信息。
什么样的记录、什么样的人进入了比较?
研究采用BrightKite、Gowalla、Weeplaces三套位置社交网络,以及巴西里约热内卢都会区手机通话详单(CDR)。前三者有平台社交关系,手机数据则以相互拨打电话推断联系。
BrightKite原始数据覆盖2008年4月至2010年10月,Gowalla为2009年2月至2010年10月,Weeplaces为2003年11月至2011年6月;手机记录为2014年1—6月,地点对应基站覆盖区域,而非具体店铺。
清理缺失属性和不活跃用户,并要求至少150条位置记录后,补充表S1给出:
| 数据 | 用户数 | 签到/通话事件数 | 独特地点ID数 |
|---|---|---|---|
| BrightKite | 6,132 | 3,513,895 | 510,308 |
| Gowalla | 9,937 | 3,466,392 | 850,094 |
| Weeplaces | 11,533 | 7,049,037 | 924,666 |
| 手机CDR | 4,415 | 1,382,626 | 1,816 |
主文方法把前三行的独特地点数写成了事件数,与补充表口径不符;这里按表S1区分,不把不同分母混在一起。CDR空间粒度较粗,多个店铺可能归于同一个基站,较高可预测性也可能部分来自这种聚合。
社交网络中的边,只能说明平台记录了关系,不能覆盖现实中的全部熟人。CDR以至少30次互惠通话作为社交边,非社交共处者要求没有通话;没有平台边或没有通话,并不能证明现实生活中绝不认识。
共处主要定义为同一地点ID、同一整点小时箱内到访,例如8:00—9:00;不是必须同时面对面。两类关系都要求不止一次共处,再按共处频次排序。还要求联系人在目标最后一次记录之前至少有150条记录,并在主要分析中去掉不比随机猜测更有信息的联系人。
为公平比较,进一步只保留两类网络中都至少有10名联系人的目标用户,BrightKite、Gowalla、Weeplaces分别只剩33、97、199人。手机数据主文写484人,表S2写483人;这一处不一致不影响研究方向,但不宜把任一数字当作已经无误的统一样本量。结果主要针对这样的活跃且联系较丰富的用户,不能代表所有居民。
不运行预测器,怎样估计可能被预测到多少?
研究先用Lempel–Ziv式序列估计量计算熵率:历史里越容易重复出现相同位置片段,下一地点的不确定性越低。单位为比特;例如3比特可用“相当于在8个等可能选项中选择”帮助理解,但不表示真实下一站只能是某8个固定地点。
随后结合独特地点数量,通过Fano不等式换算潜在可预测性Π,表示理想预测性能的理论限制。它受有限样本熵估计、数据粒度与序列性质影响,不是已部署算法的测试得分。
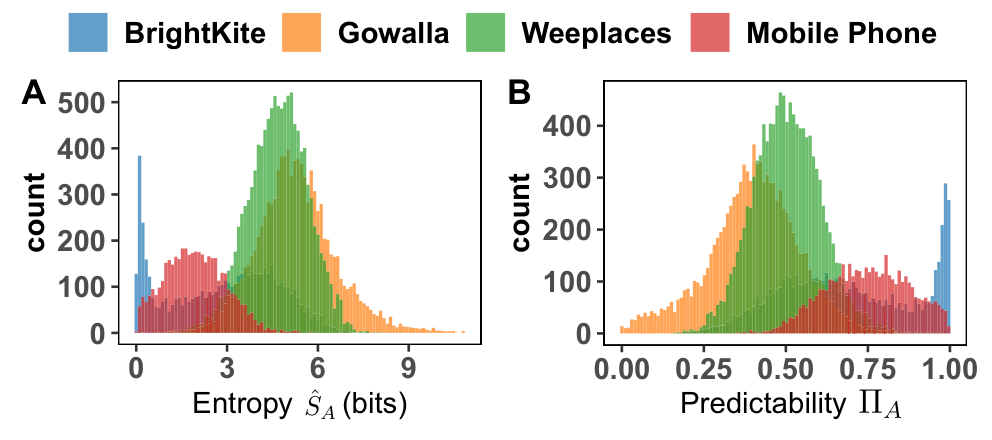
图 1|不同数据本身就有不同的预测基线吗?
(A)横轴熵率、单位比特,纵轴用户计数;(B)横轴潜在可预测性、纵轴计数。蓝、橙、绿、红分别为BrightKite、Gowalla、Weeplaces、手机记录。BrightKite有较多低熵用户,Gowalla较分散,手机数据因覆盖与粒度不同而偏向较高可预测性。不能直接把它们解释为不同城市的人谁更有规律。来源:原论文 Fig. 1。
比较他人记录时,用交叉熵衡量目标序列在另一人的过去序列中有多少可匹配结构;只使用早于目标事件的联系人记录。多个联系人则汇总匹配片段,得到累积交叉熵及相应可预测性。本文的“信息流”是序列统计关系,不能据此认定两个人互相影响或直接传递了信息。
即使计算中不把目标历史当作预测输入,研究者仍要掌握目标序列来定义关系、排名和评估。这不是在完全不知道目标活动的情况下,已经完成了一个可实际复现的定位攻击。
一位熟人和几位非社交共处者,谁的信息更多?
Weeplaces中,第一位社交联系提供的交叉可预测性中位数为17.43%,第一位非社交共处者为12.35%,前三位共处者合起来为19.60%。这比较的是分布中位数,不意味着每个人都能由三位共处者超过一位熟人。
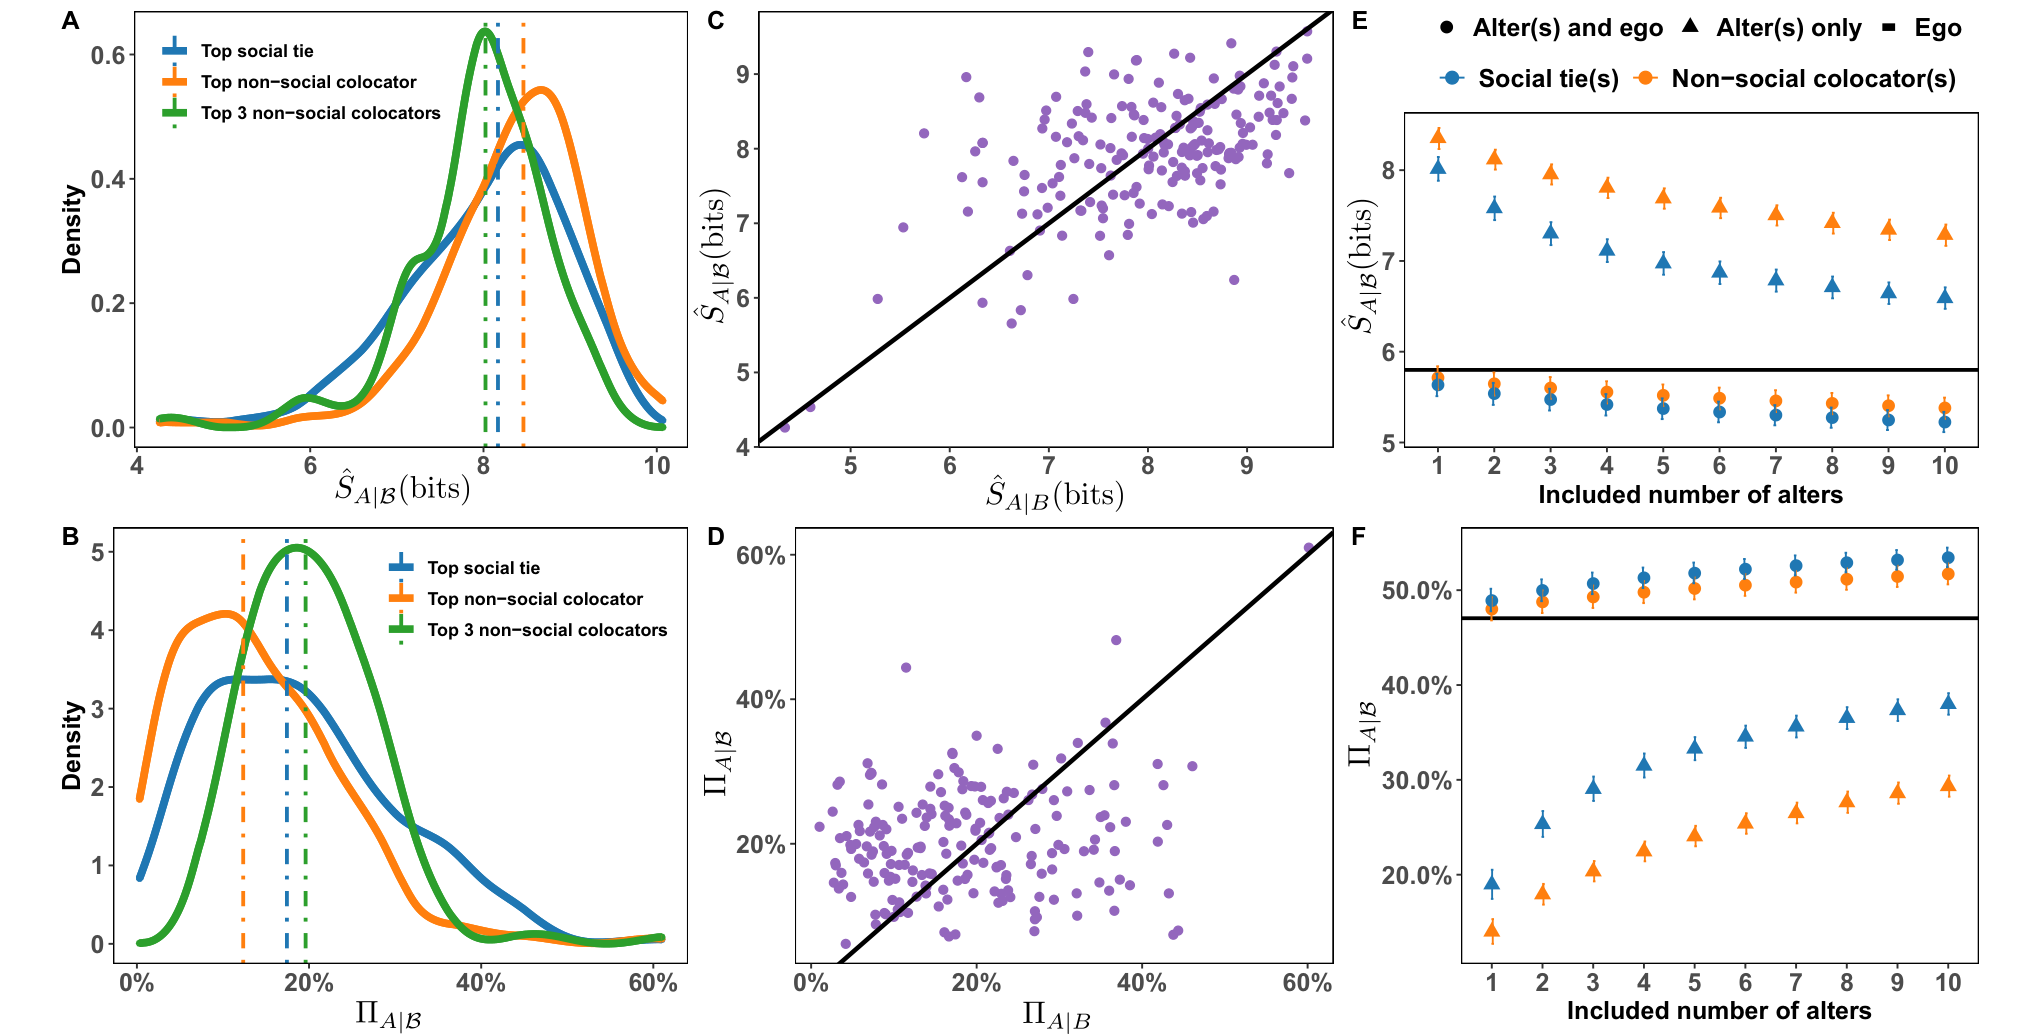
图 2|多名共处者能否补足单人信息较少的劣势?
(A)第一位社交联系、第一位及前三位非社交共处者的交叉熵分布,蓝、橙、绿依次对应三者;熵越低越好。(B)对应可预测性分布,越高越好。(C)横轴前三位共处者的累积交叉熵、纵轴第一位社交联系的交叉熵;(D)相同对象的可预测性散点,黑线均为相等参照。(E)随加入联系人数量变化的熵,(F)对应可预测性;蓝为社交、橙为非社交,三角只含联系人,圆点同时含目标自身历史,黑线为自身基线。误差线为95%置信区间。来源:原论文 Fig. 2。
在相同联系人数下,社交来源平均更强。加入目标自身历史后,两类联系人仍有增量,说明他人记录不完全重复个人历史已有的信息。但个体增益、平均增益与外推到更多联系人的增益应分别阅读。
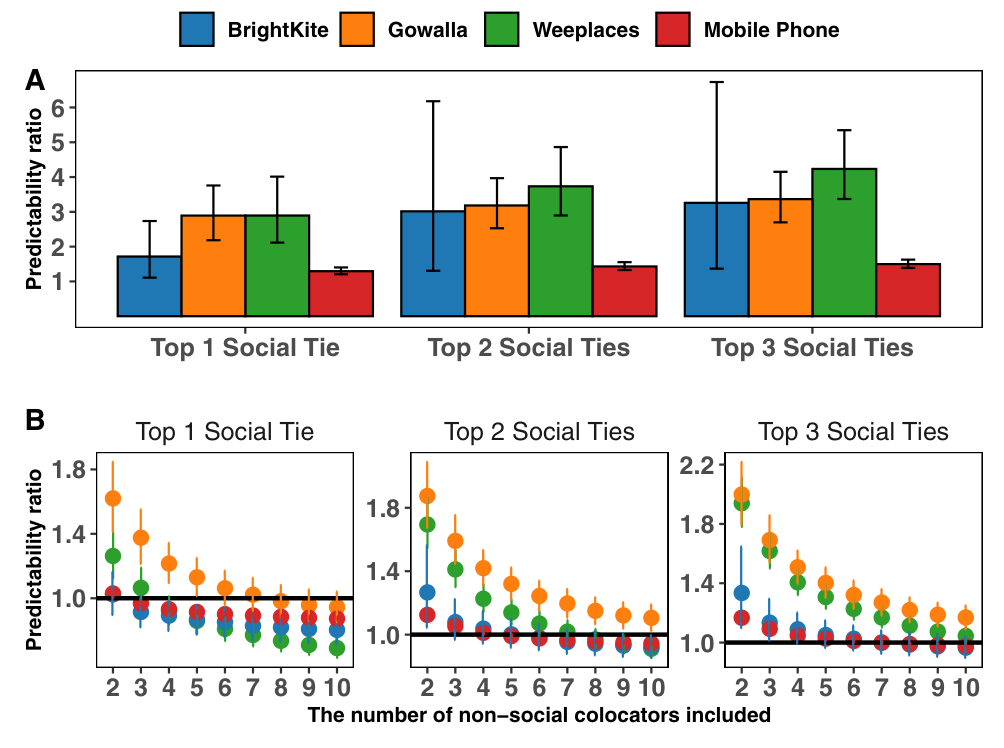
图 3|需要多少共处者才能达到一至三位社交联系的信息量?
(A)以第一位非社交共处者作分母,比较前一、二、三位社交联系的可预测性比值,颜色区分四套数据。(B)横轴增加非社交共处者数量,三列分别以一、二、三位社交联系作参照;纵轴比值达到1表示两类来源相当,误差线为95%置信区间。达到相当水平所需人数依数据不同,不能概括成固定的“三个陌生人”。来源:原论文 Fig. 3。
补图S6—S8在其他数据中重复比较,但数值并不相同。例如Gowalla需要约7—8名非社交共处者才接近一名最高排名社交联系;BrightKite和手机数据约需1—2名。补图S6自己的中位数还显示某些非社交来源并不低于社交来源,不能把平均趋势改成逐用户、逐统计量严格排序。
94%和85%究竟从哪里来?
研究只直接累积前10名联系人,再拟合饱和函数Π(k)=Π∞+β₀÷(β₁+k),外推联系人更多时的极限。Weeplaces中,只有社交联系的外推Π∞约44.31%,非社交共处者约39.79%;目标自身平均基线为47.05%。
44.31÷47.05约为94%,39.79÷47.05约为85%。因此85%不是“陌生人让算法85%的下一站都猜对”,而是一个外推理论量相对另一个理论量的比例。外推基于仅10个联系人点、3个参数,补充材料用7个自由度估计参数区间,不能消除函数形式与外推距离带来的不确定性。
同时纳入自身历史时,Weeplaces外推约为56.70%和56.25%,相对于47.05%是约9.65与9.20个百分点的增加;若说相对提升,则约20.5%与19.6%。百分比和百分点不能互换。
共同去过哪些地方,能解释全部信息吗?
研究把共同访问地点数除以目标访问过的独特地点数,定义重叠比ODLR。累积指标CODLR则把多名联系人的覆盖合并后去重,分母仍是目标的独特地点数,不是全部签到次数。
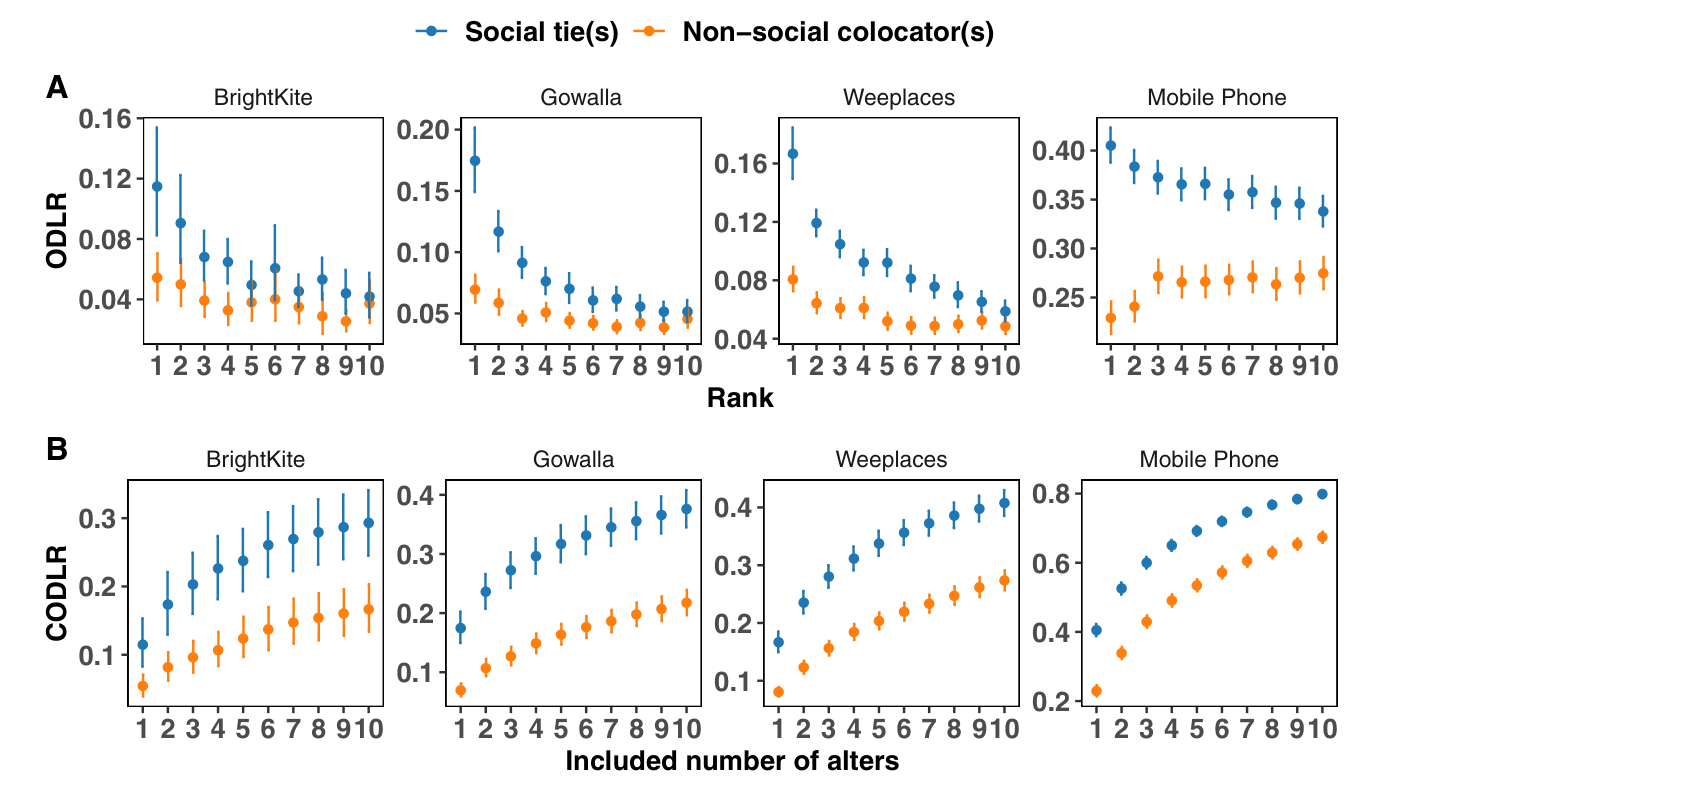
图 4|更多联系人是否覆盖了目标更多的活动地点?
(A)横轴联系人排名、纵轴单人地点重叠比ODLR,四列为四套数据;蓝社交、橙非社交。(B)横轴加入人数、纵轴去重后的累积重叠比CODLR。累积覆盖随人数增加,但新增覆盖逐渐减少;手机数据因基站粒度粗而重叠较高。(A)的下降只是总体趋势,手机非社交曲线还有局部上升,不能逐点说严格单调。误差线为95%置信区间。来源:原论文 Fig. 4。
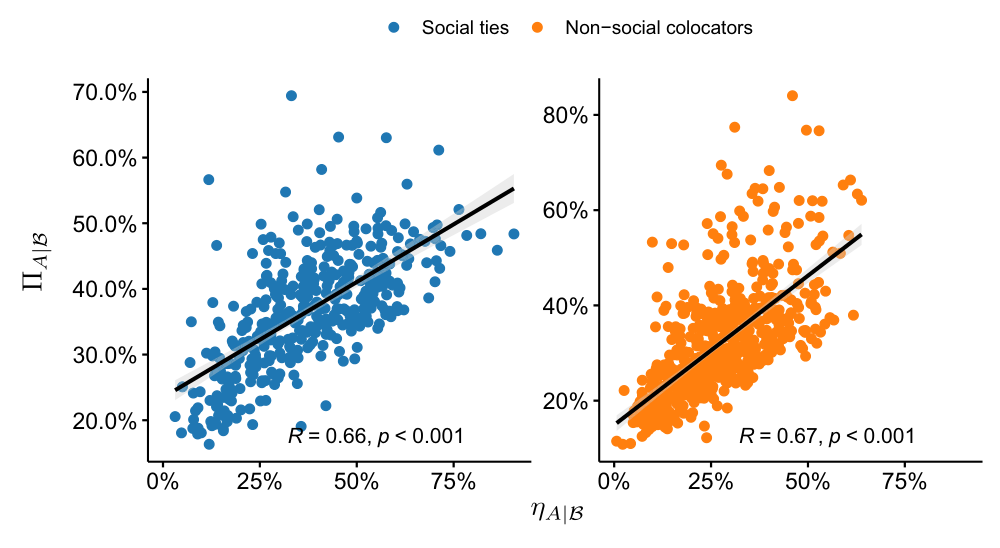
图 5|地点重叠越多,潜在可预测性是否越高?
原图无字母子图,左为Weeplaces社交联系、右为非社交共处者;横轴CODLR、纵轴累积交叉可预测性,黑线为回归。Pearson相关系数约0.66与0.67,均p<0.001;它们不是解释率,也不是因果效应。来源:原论文 Fig. 5。
补充材料也保留了边界:手机记录的对应相关明显弱,补图S16约0.22—0.27,S17多在0.08—0.16,并非主文概括的所有数据都同样强。不同空间分辨率会改变地点重叠的含义。
同一地点错开数小时,也能留下信息吗?
时间错位实验把联系人到访限定在目标前后偏移的半小时窗口。偏移T从0.5到12小时;T=0.5时就是目标前后各半小时。此时是滑动窗口,与主分析的整点小时箱不同。
只保留所有时间偏移网络中都有至少10名联系人的共同目标后,仅Weeplaces和手机数据满足分析条件。不能把这个错位实验说成三套签到数据都验证成功。
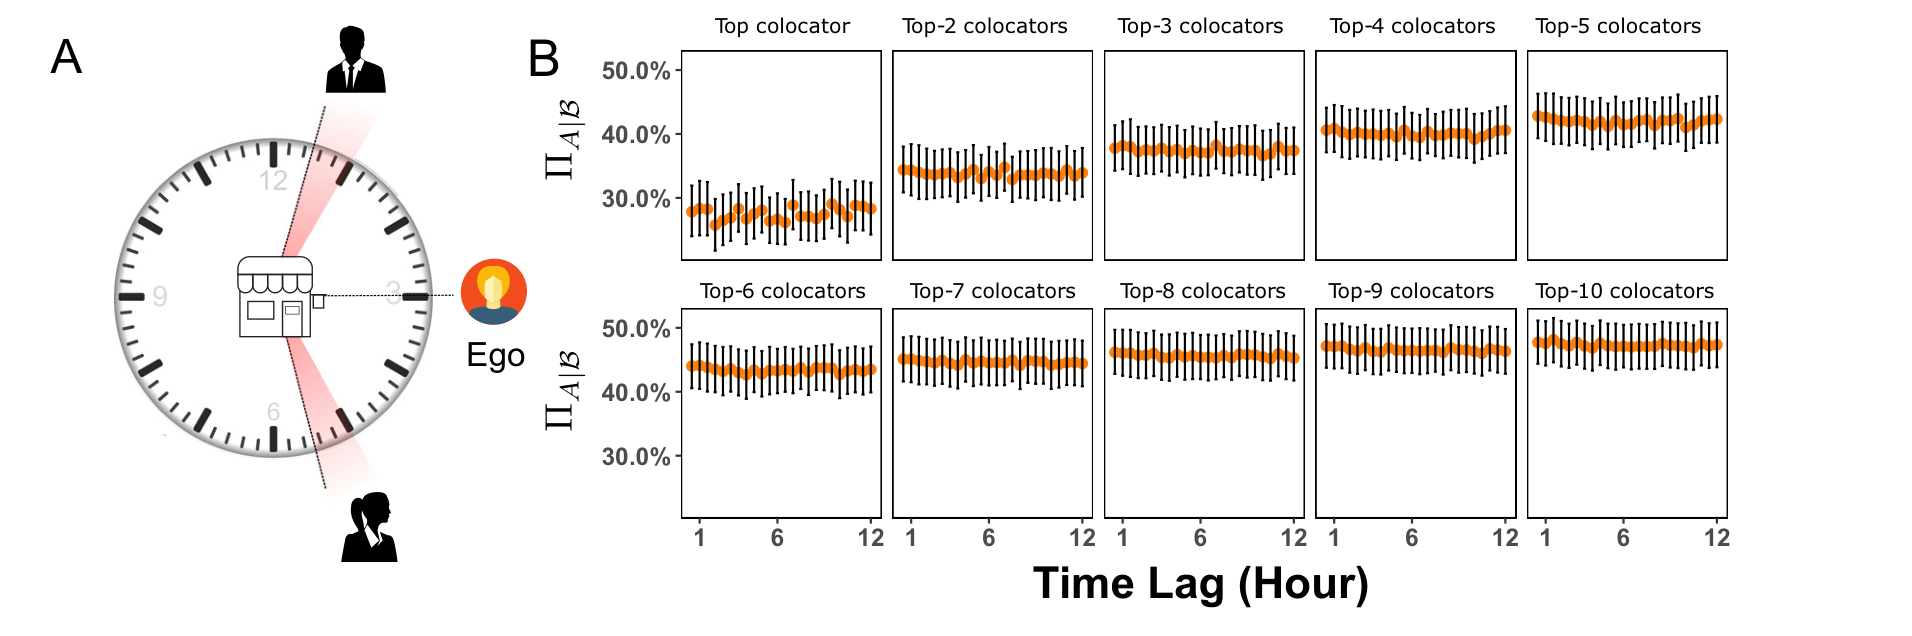
图 6|时间错开后,非社交信息是否迅速消失?
(A)示意在相同地点、与目标错开约2.5小时的到访窗口,不表示实际面对面接触。(B)Weeplaces中前1至前10位共处者的结果,横轴偏移小时数、纵轴潜在可预测性;不同小图累积人数不同,误差线为95%置信区间。固定人数后随偏移变化较小,不能由重叠误差线宣称各时差完全等价。来源:原论文 Fig. 6。
补图S18—S20显示手机数据也有相似趋势;不同时间窗口网络的联系人并不完全相同,Weeplaces若干网络的Jaccard重叠仅约0.31—0.38。结果说明信息不必依赖同时到访,但没有证明共处者一定互不认识,也没有区分共同工作制度、相近社会经济条件等替代解释。
筛选条件是否把信息量抬高了?
补图S21把最低签到数从150降为75,S22比较整点箱与前后半小时滑动窗口,主要趋势保持。但更关键的是,把原先被排除的低信息联系人放回来,绝对预测性会下降。
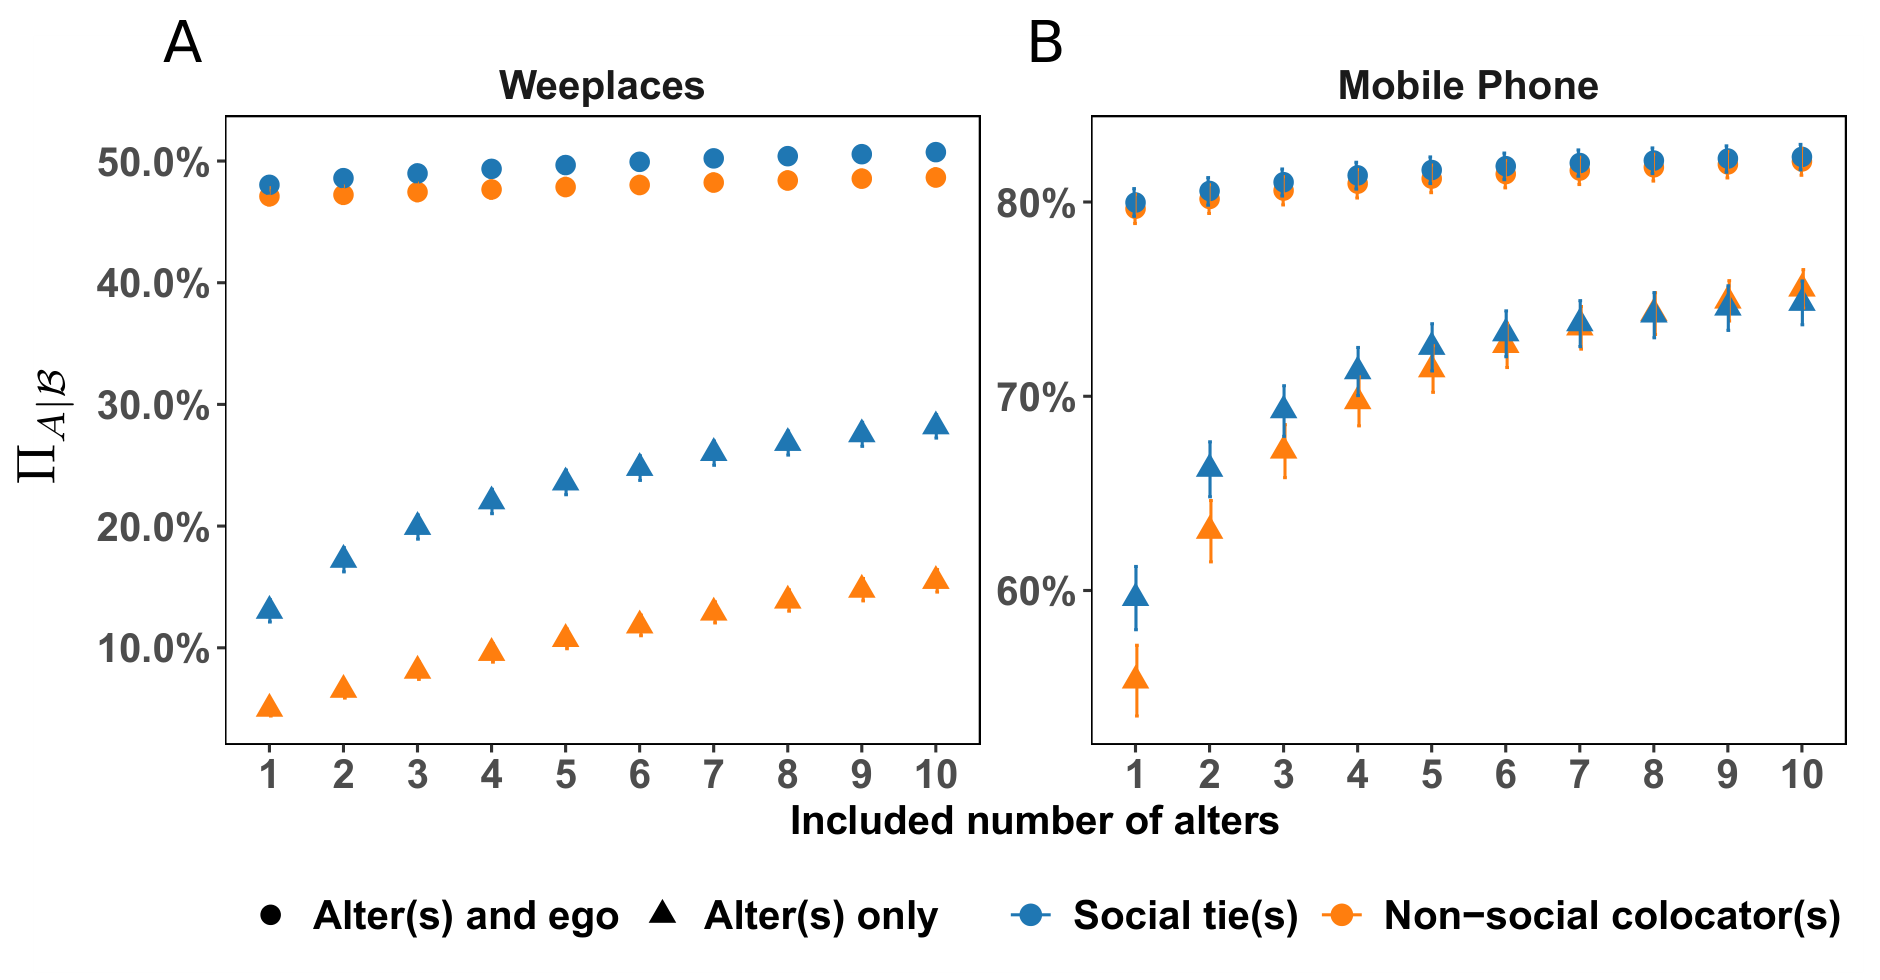
图 S23|不预先排除低信息联系人,还剩下多少信息?
(A)Weeplaces,(B)手机数据,横轴加入人数、纵轴累积可预测性;蓝社交、橙非社交,三角只含联系人,圆点还含目标历史,误差线为95%置信区间。样本分别扩大到827与1,103名目标;相较筛选后的结果,只用联系人时的绝对值下降,累积信息的方向仍在。来源:原论文 Fig. S23。
因此主结果适用于经信息筛选的人际关系集合,不代表随手挑选10名同地点用户都能达到同样数值。扩大样本后仍有信息,也不等于所有活跃度的人都拥有同一风险。
只知道地点集合,不知道访问顺序,是否足够?
补充实验为可预测性最高的20%目标复制一份轨迹作为合成联系人,保留地点重叠但随机打乱访问顺序,再逐步替换部分地点降低重叠。每次打乱重复100遍。
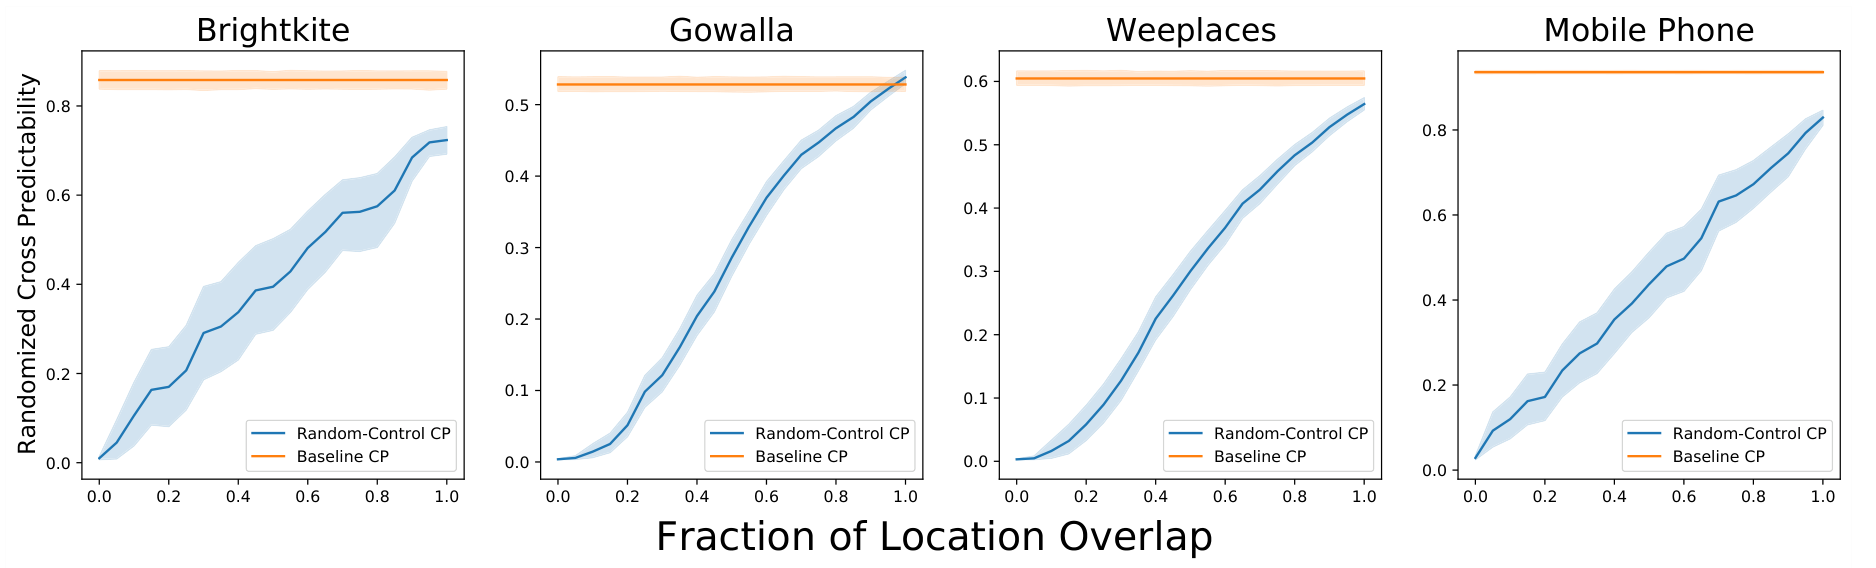
图 S24|完全重叠的地点集合能否替代真实顺序?
原图无字母子图,四列依次为BrightKite、Gowalla、Weeplaces、手机数据。横轴地点重叠比例,纵轴随机序列提供的交叉可预测性;橙线为目标自身基线,蓝线为打乱后结果,阴影95%置信区间。多数数据即使完全重叠仍有损失;Gowalla在完全重叠端已接近基线,不能说每组每个条件都明显低于基线。来源:原论文 Fig. S24。
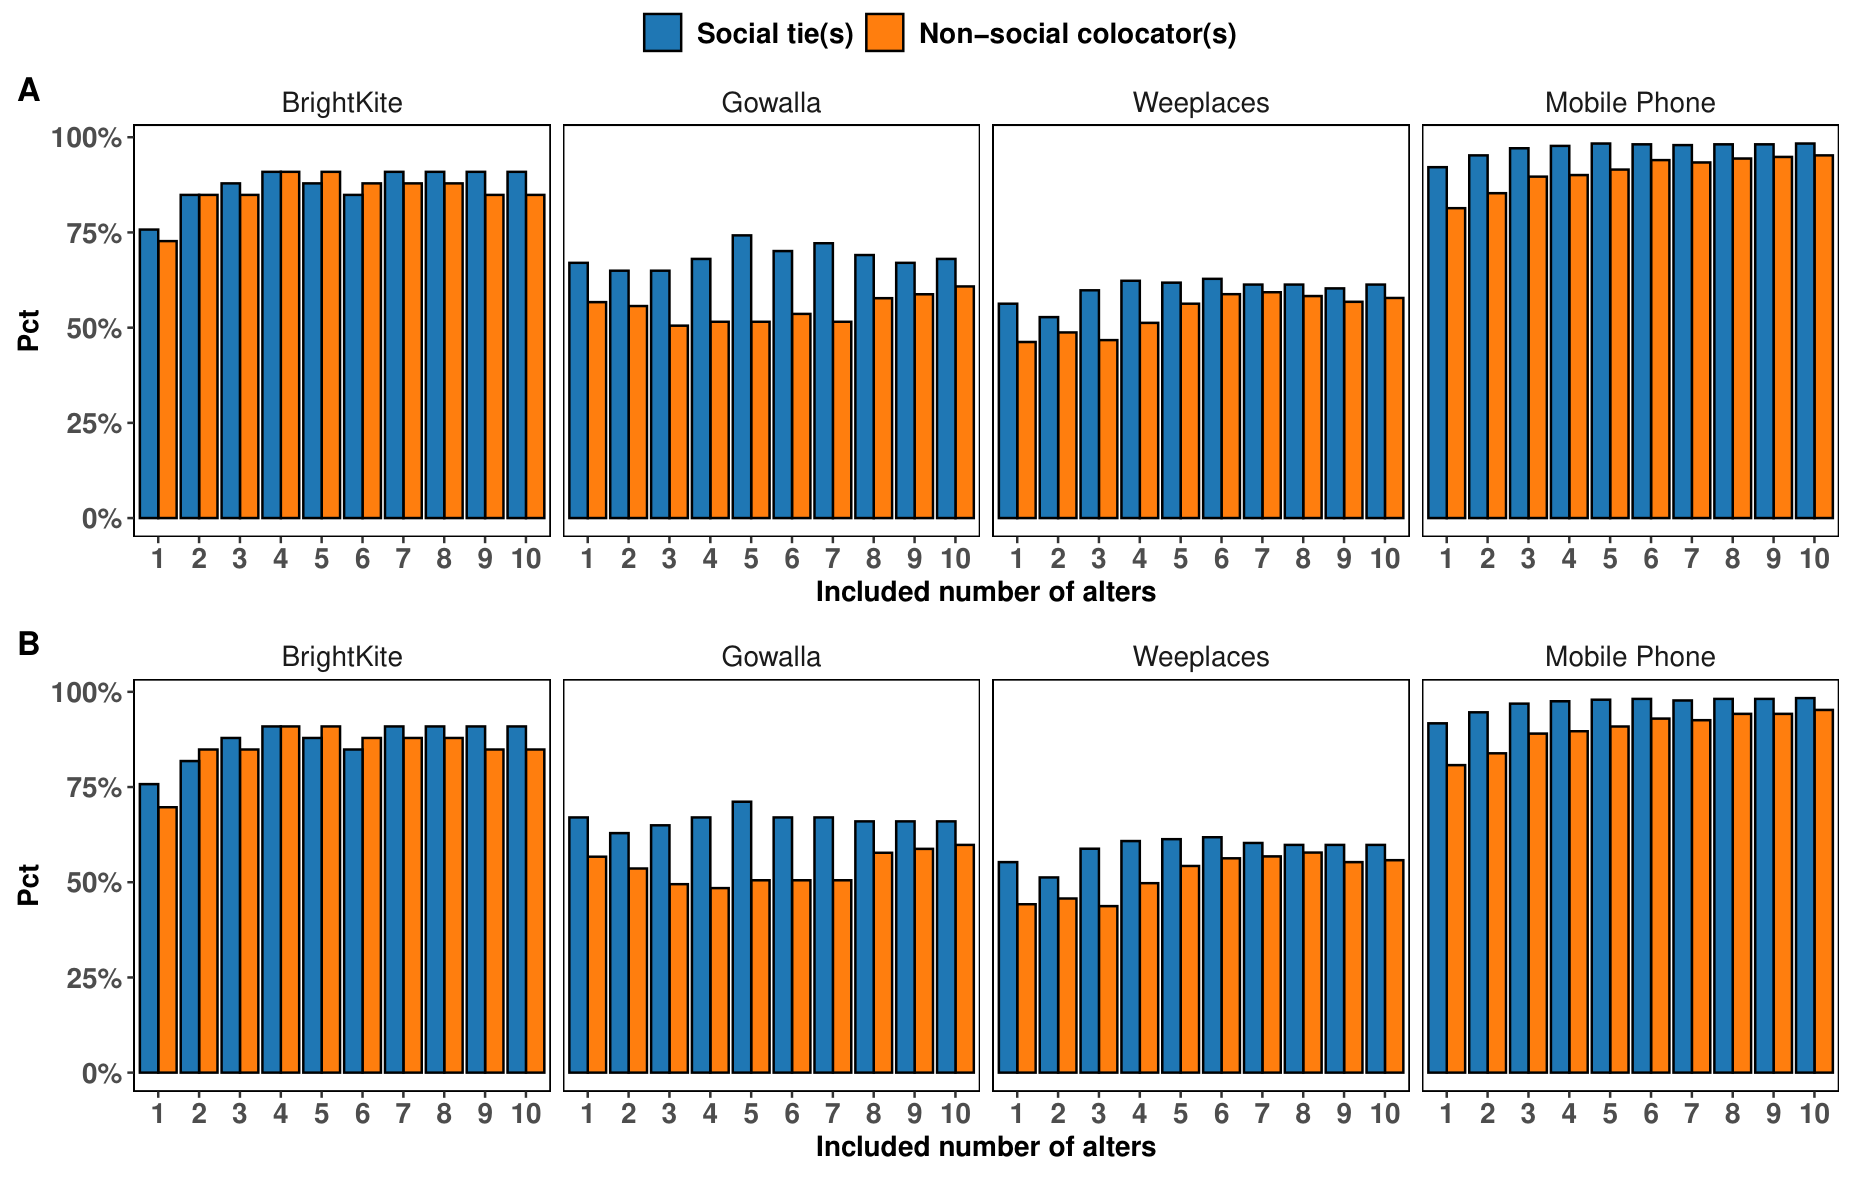
图 S25|真实联系人访问顺序是否比打乱后的更有信息?
(A)以5%显著性阈值,(B)以1%阈值检验;四列为四套数据,横轴累积联系人数,纵轴真实序列显著优于随机顺序的目标比例,蓝社交、橙非社交。多数条件中比例较高,但Weeplaces若干非社交条件低于50%,不能概括为所有条件至少一半。显著性比例也不是预测准确率。来源:原论文 Fig. S25。
这两个对照共同说明,地点集合与时间顺序都可携带信息,不能把结果完全归结为共同去过哪些地点。它们仍属于观察数据的统计检验,没有证明社会关系导致某条移动路径。
一句话总结
一个人的活动规律可能同时映射在熟人和非社交共处者的记录中,但本文揭示的是有筛选、有尺度与外推条件的信息潜力,不能直接写成实际定位算法的高准确率。
核心来源
- 原论文及开放存档,正文、图1—6、公式1—6。
- 官方补充材料,S1—S7、图S1—S25、表S1—S4;全部图像来自原论文及其补材。
- 作者分析代码存档。CDR原始数据受限,不能将代码公开理解为所有原始轨迹均公开。
作者介绍
以下依据论文署名及贡献说明,均为当时身份。
- Zexun Chen:共同第一作者,署名埃克塞特大学BioComplex实验室及爱丁堡大学商学院,参与数据与熵分析。
- Sean Kelty:共同第一作者,署名罗切斯特大学物理与天文学系,参与数据与熵分析。
- Alexandre G. Evsukoff:署名里约热内卢联邦大学COPPE,参与方法并提供手机数据。
- Brooke Foucault Welles:署名美国东北大学,参与研究方法。
- James Bagrow:署名佛蒙特大学数学与统计系、Vermont Complex Systems Center,参与概念与研究设计。
- Ronaldo Menezes:署名埃克塞特大学BioComplex实验室,通讯作者之一,参与研究设计与协调。
- Gourab Ghoshal:署名罗切斯特大学物理与天文学系及计算机科学系,通讯作者之一,参与研究设计与协调。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若位置隐私只按“我是否上传自己的轨迹”衡量,就会漏掉周围人的数据对我的推断能力。一个可检验的保护目标,是在数据发布前评估第三方可预测信息,而不只删除上传者姓名:对不同粒度、时间打散与访问限制,比较自身效用和未上传者信息泄漏是否同时下降。
还应把信息论上限与实际攻击能力接起来检验。在严格时间留出的数据上,只允许使用部署时真正可取得的关系与排名,分别测试熟人、共处者及无关系总体基线。若潜在信息很高而实际性能很低,需要辨明是信息难以学习,还是事后筛选与外推制造了难以部署的优势。