去同一个地方,为什么走得更远和来得更勤,会按同样的比例减少访客?
论文名片|Markus Schläpfer、Lei Dong、Kevin O’Keeffe、Paolo Santi、Michael Szell、Hadrien Salat、Samuel Anklesaria、Mohammad Vazifeh、Carlo Ratti、Geoffrey B. West,The universal visitation law of human mobility,Nature,2021,593:522–527,2021年5月26日在线发表(刊物日期为5月27日)。DOI:10.1038/s41586-021-03480-9。本文依据该正式版的正文、方法与扩展数据图解读。
波士顿后湾是论文拆开一条人流时使用的具体地点。住在附近、隔几天就去的人,和住得很远、整个观测期只去一两天的人,一旦被加成“从某段距离来了多少人”,差别就消失了。引力模型和辐射模型描述的正是这种加总后的空间流量。它们不回答另一件事:到访天数变多时,访客会不会按另一种方式变少。
把居住距离和到访频率拆开以后,两者几乎可以互换。在除掉来源环带面积之后,访客密度主要取决于二者的乘积,并接近这个乘积的平方反比。一个地点更“热闹”,首先表现为访客更多,而不是每位访客都被拉得更远。
先说结论
- 谱流 ρ 是某一距离环带、某一到访频率上的访客数除以环带面积。后湾单个地点拟合得到指数 η = 2.17(标准误 0.055),R² = 0.973。五个地区归一化后叠在一起的拟合是 η = 2.05(标准误 0.018),R² = 0.993。η = 2 时,距离或频率乘以 2,谱流变为 1/4;这是密度,不是原始人数。
- 每位访客在观测期内的有效距离,与地点访客总数几乎没有线性关系。决定系数 R² 在大波士顿为 0.0115,新加坡为 0.0298,达喀尔和阿比让都小于 0.001,里斯本为 0.001。分母是各自图中的地点,不是把五座城市合成一个样本。
- 大波士顿的吸引力在空间上成团。使最大团面积比降到最低的阈值约为 μ* = 10^0.5。此时团块面积的秩–规模指数为 −1.17(标准误 0.013),R² = 0.965,接近齐夫定律常说的 −1,但不是精确等于 −1。
- 个人层面的探索与优先返回,已经能产生接近 2 的指数;扩展数据图 7 的模拟是 η = 2.12(标准误 0.018),R² = 0.992,但吸引力在空间上很均匀。要出现真实城市那种团块,模型还让新探索偏向已经有人去的方向。10 万个代理、50 次模拟得到的面积指数为 −1.14 ± 0.13(标准差)。后一个指数使用了为齐夫形态选出的参数。
- 固定平方反比、再用人口密度估计吸引力之后,可以同时给出出行次数和不同频率的独立访客。以后湾西区为例,总出行的 Sørensen–Dice 相似指数 SSI,到访定律为 0.70,已按出行拟合的引力模型为 0.40,辐射模型为 0.36。独立访客的 SSI 为 0.72,观测期内超过 20 次的访客为 0.63;后两个量,引力模型和辐射模型没有预测。
只数总人数,会把两种完全不同的行程加在一起
一个地点接收的人流至少有两个刻度。空间刻度是居住地离它多远。时间刻度是观测期里有多少天真正到过。购物、上班和偶尔的远行可以落在同一个距离上,频率却差很多。疾病传播、交通设施和公共空间的使用,依赖的是谁会反复相遇,不只是有多少人次经过。
引力模型把两地流量写成人口乘积除以距离的某个函数。辐射模型用起点出行量、目的地机会和中间机会分配流量。两者都在处理加总后的空间流动。个人移动模型则从另一个方向出发:一个人会探索新地点,也会优先回到自己常去的地点。缺的是中间这一层。把所有人的重复到访合在一起之后,一个地点收到的“距离 × 频率”谱,是否还有简单形状。
因此这里要测量的不是迁移,也不是沿路通勤时间。它是日常活动里、被手机记录捕捉到的地点到访。下面的距离是居住格网到目的格网的距离,按 1 公里等宽分箱,不是路网里程,也不是费用。
谱流在数什么?
五套手机数据的地区、年份和采样方式都不同,论文将它们合计为超过 30 亿条带时间戳的位置记录、超过 800 万名匿名用户。这个合计是论文给出的总规模,不是把下面各组用户直接相加,因为部分地区按两周重新抽样。
| 数据 | 记录与用户 | 时间 | 进入统计的空间范围 | 频率所使用的观测期 T |
|---|---|---|---|---|
| 大波士顿 | 约 10 亿条记录,约 200 万用户;通话、短信和上网,基站三角定位,精度约 220 米 | 2009 年 7–10 月 | 大波士顿,500 米格网 | 4 个月 |
| 葡萄牙 | 约 4.4 亿条通话详单,约 200 万用户,6,511 座基站;只有语音通话 | 2006–2007 年中的 8 个月 | 里斯本、波尔图、布拉加的大都市区,1 公里格网 | 8 个月 |
| 塞内加尔 | 2013 年分成 25 个两周;每个两周约 4,400 万条记录、约 30 万名随机用户,1,666 座基站 | 2013 年 | 达喀尔,1 公里格网 | 2 周 |
| 科特迪瓦 | 每个两周 5 万名随机用户,1,231 座基站;论文英文写为 Ivory Coast | 2011 年 12 月 1 日至 2012 年 4 月 28 日 | 阿比让,1 公里格网 | 2 周 |
| 新加坡 | 最大运营商约 400 万用户,5,587 座基站;通话、短信和上网 | 2011 年 3 月中至 5 月中 | 新加坡,500 米格网 | 2 个月 |
家的定义是夜间停留夜数最多的格子,夜间为 20:00 至次日 07:00。常规活跃用户在大波士顿、塞内加尔、科特迪瓦和新加坡至少平均每周有一夜出现在家;葡萄牙因记录更稀,放宽到每两周一夜,即每周 0.5 夜。到访要在格子里停留至少 τ = 1 小时,用来去掉只是路过的人。频率 f 是观测期 T 内、满足这一停留的不同天数,不是一天之内的进出次数。
作者写明,格网尺寸和最短停留的具体取值有过稳健性检验,主要关系仍然成立。检验图放在补充材料,正文没有给出被测试的每一档尺寸和对应指数。
对每个目的地 i,居住距离落在 [r, r + δr) 且频率为 f 的独立访客数为 Nᵢ(r, f),δr = 1 公里。环带面积近似为 A(r) ≈ 2πrδr。谱流定义为
ρᵢ(r, f) = Nᵢ(r, f) / A(r)。
单位是访客每平方公里。除以面积是为了去掉“更远的环带本来就更大”这一几何因素。距离–频率分析使用的目的地,是观测期内至少吸引 10 名来自邻近格子的访客的格子;来源则包括访客数更少的格子。论文说这一关系在数万个地点上成立,正文没有列出五座城市各自纳入的格子总数。
距离加倍和频率加倍,减少的是同一份密度吗?
后湾的谱流在两个方向上都下降。固定频率时,距离越远,每平方公里的访客越少;固定距离时,到访天数越多,访客也越少。两组图使用同一套分箱:[1, 2)、[2, 5)、[5, 10)、[10, 20)、[20, 50)、[50, 100)。在图 1b 里这是频率,横轴是公里;在图 1c 里这是距离,横轴是观测期内的到访天数。
若 ρ(λr, f) 与 ρ(r, λf) 相近,距离和频率就只是同一个乘积 rf 的两种写法。图 1d 把横轴换成 rf 之后,不同分箱落到同一条幂律附近:
ρᵢ(r, f) = μᵢ / (rf)^η。
后湾的最小二乘拟合给出 η = 2.17,标准误 0.055,R² = 0.973。μᵢ 是这个地点自己的比例系数,论文称之为吸引力。它决定谱流的高低,不改变指数。
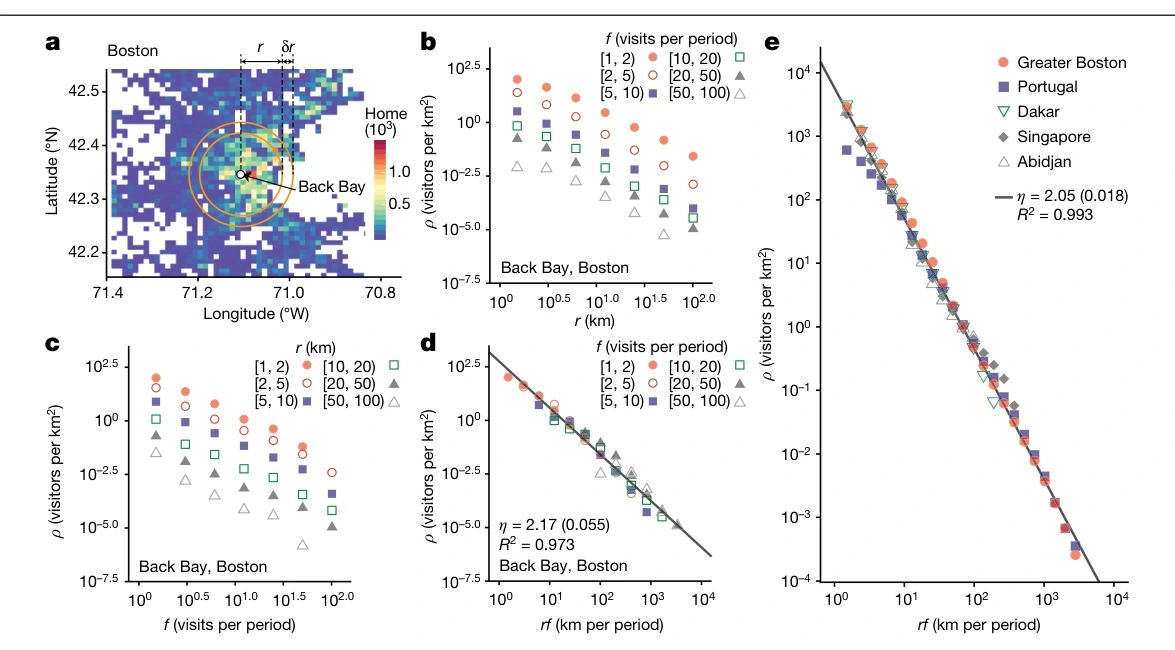
图 1|一个地点收到的访客,是分别随距离和频率下降,还是只随二者的乘积下降?
(a)大波士顿手机用户的居住分布,色标为 Home(10³),图上标出 0.5 和 1.0;橙圈示意后湾周围的距离 r 与环宽 δr。(b)后湾:固定到访频率,谱流随距离下降;图例是观测期内的天数分箱。(c)后湾:固定距离,谱流随频率下降;图例是公里分箱。(d)横轴改为 rf 后,各分箱接近同一条线,η = 2.17(0.055),R² = 0.973。(e)五个地区、先按地点归一化再平均的谱流;叠合后的拟合为 η = 2.05(0.018),R² = 0.993。来源:原论文 Fig. 1。
图 1e 的高 R² 不能读成五个城市的绝对访客密度相同。为了把曲线叠在一起,每个地点的分布先做了归一化,图比较的是形状。观测期也不同:波士顿的 rf 是公里每 4 个月,葡萄牙是每 8 个月,达喀尔和阿比让是每 2 周,新加坡是每 2 个月。指数可以比较,纵轴高低不能跨城市直接当成同一批人。
η = 2 时,只把 r 或只把 f 乘以 2,分母变成原来的 4,谱流变为 1/4。后湾的拟合是 2.17 而不是精确的 2,所以单个地点上这个“恰好四分之一”是近似。更重要的是分母:这里变的是每平方公里访客,不是环带里的原始人数。原始人数还要再乘环带面积,而面积随 r 增大。因此不能把这条定律说成“距离加倍,来的人数减到四分之一”。
扩展数据图 1 用地图把这种互换显示出来。行是频率 f = 3、6、12,列是距离 r = 3、6、12,格子里标出 v = rf。r = 6 且 f = 3 与 r = 3 且 f = 6 都是 v = 18,颜色和空间形态接近;v = 36 和 v = 72 也各自重复。色标是谱流,单位为人每平方公里,从 10^−3.2 到大于 10^−0.6,尺度条为 50 公里。它支持的是同一乘积对应相似的流入形态,不是每一条街道的人数被逐格预测。
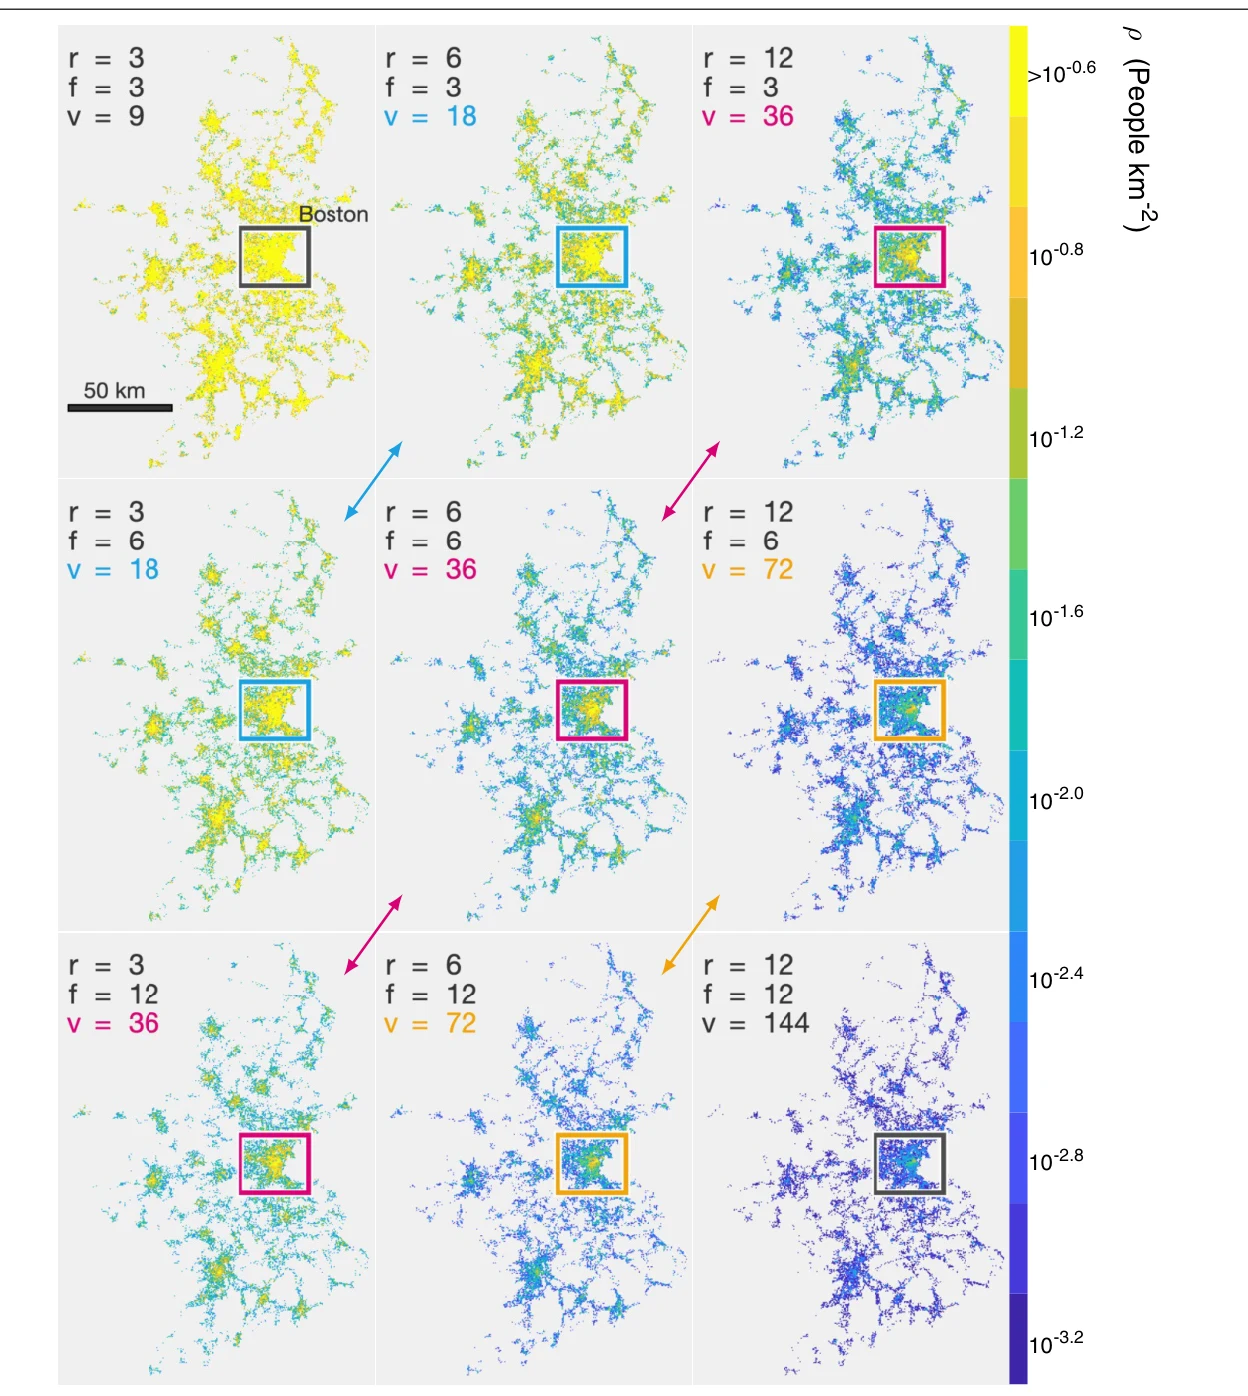
图 E1|把距离加倍,和把频率加倍,地图会不会变成同一张?
无字母面板,三行频率为 3、6、12,三列距离为 3、6、12。格中 v = rf;相同 v 用同色标出,箭头顺着这些对角线。颜色是谱流 ρ,单位为人每平方公里。来源:原论文 Extended Data Fig. 1。
单个地点不会都刚好等于 2。扩展数据图 2 只统计大波士顿,用对数变量的普通最小二乘估计每个地点的 η 和 R²。红线画在 η = 2。最高的柱紧贴这条线,纵轴大约到 1,500 个地点;分布两侧大致延伸到 1.5 和 2.8。R² 大多高于 0.9,最高的柱接近 3,000,位于 0.97 附近。柱宽没有标注,不能把柱高相加当成地点总数,也不能把“集中在 2 附近”写成每个格子的指数都是 2。
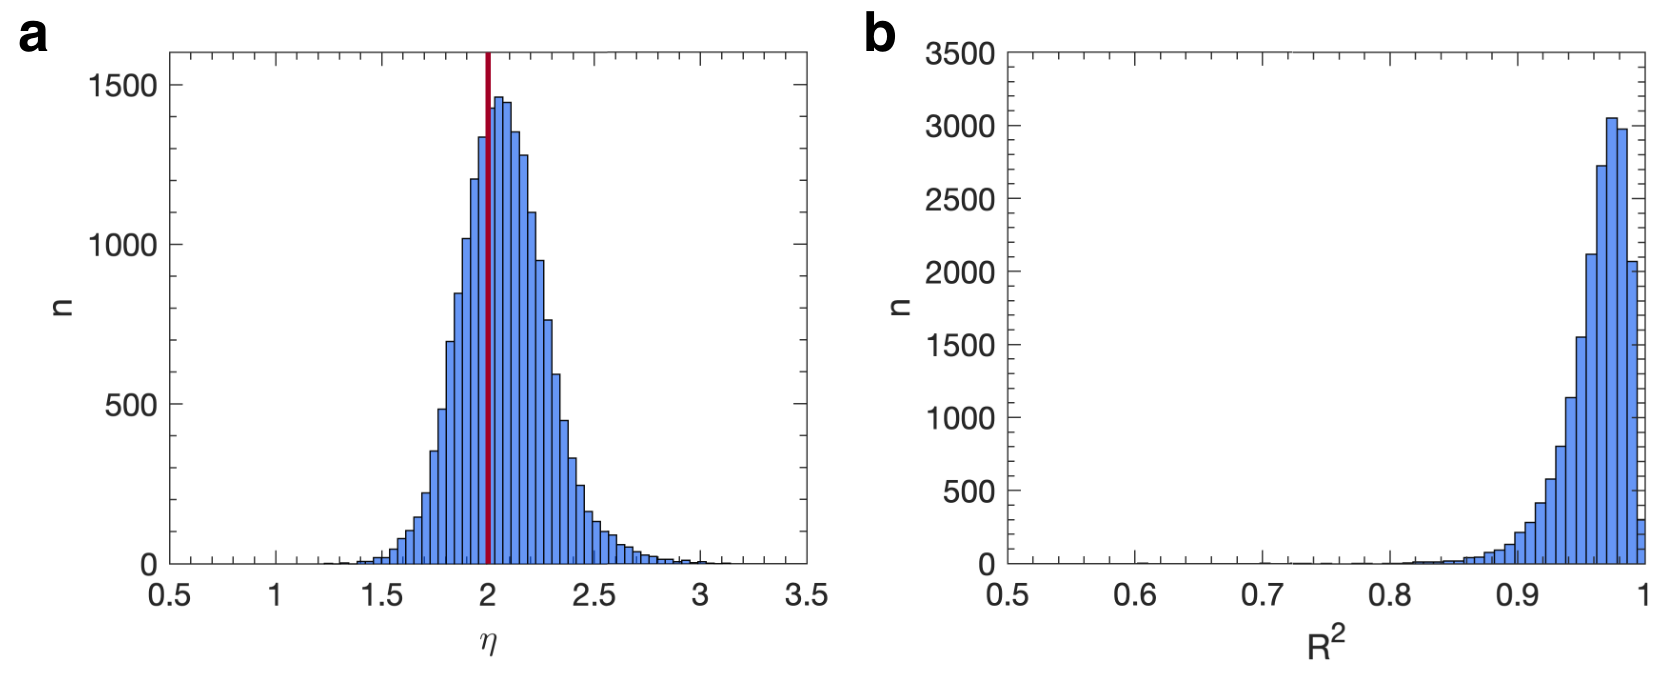
图 E2|平方反比是所有地点共用的精确指数,还是一条分布的中心?
(a)大波士顿各地点的 η,红线为 2。(b)同一批拟合的 R²。纵轴都是地点数。来源:原论文 Extended Data Fig. 2。
扩展数据图 3 至 6 继续检查排名前 30 的地点,参考线斜率都取 −2。扩展数据图 3 是大波士顿 500 米格子,横轴为公里每 4 个月,排名靠前的格子包括波士顿市中心,也包含伍斯特。扩展数据图 4 是葡萄牙 1 公里格子,观测期 8 个月。扩展数据图 5 是达喀尔,观测期只有两周,频率图例只到 [1, 2)、[2, 5)、[5, 10)。扩展数据图 6 是新加坡 500 米格子,频率最高的一档为 [20, 40)。它们重复的是同一条参考线,而不是一批新的指数估计。
作者把 η = 2 解释成一种不变的集体付出。令 v = rf,也就是为到达该地、单位时间所覆盖的有效距离。平方反比等价于 (1/2)ρv² 为常数。这是他们的物理类比,不是在数据里测到了能量;从运动方程出发的推导写在补充材料第三节。数据直接支持的是谱流对 rf 的塌缩,不是这句类比本身。
更热闹的地方,有没有把每个人拉得更远?
若指数接近 2,把谱流按所有访客累加之后,每位访客分到的有效距离不应再随吸引力 μᵢ 变化。论文定义地点 i 的这个量为观测期 T 内全部访客的有效距离之和,除以访客总数。地图用它给格子上色,散点则把它和访客人数做线性回归。
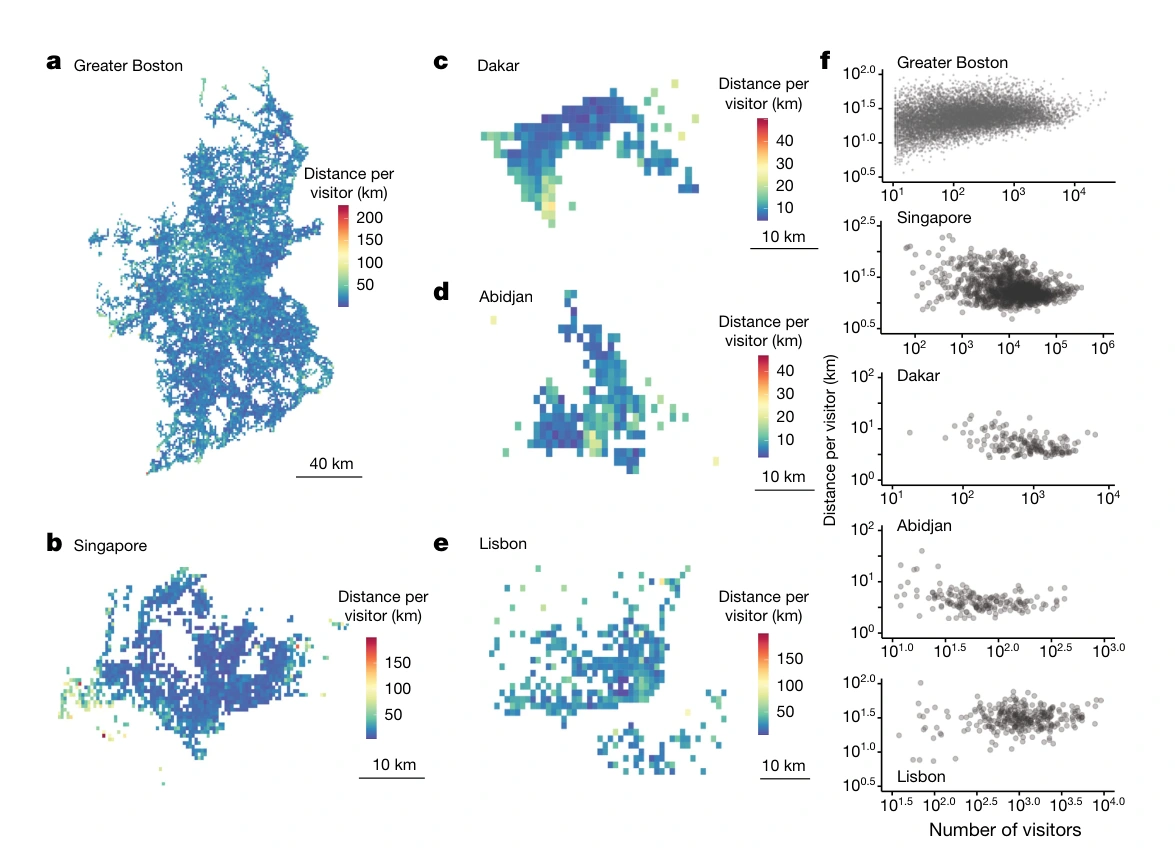
图 2|访客更多的地点,每位访客的有效距离也更大吗?
(a)大波士顿,色标约 50–200 公里,尺度条 40 公里。(b)新加坡,色标约 50–150 公里,尺度条 10 公里。(c)达喀尔,色标约 10–40 公里。(d)阿比让,色标约 10–40 公里。(e)里斯本,色标约 50–150 公里。(c–e)的尺度条都是 10 公里。(f)五个地区各自的散点,横轴为访客数,纵轴为每位访客的距离,均为对数坐标。来源:原论文 Fig. 2。
回归的 R² 很小:大波士顿 0.0115,新加坡 0.0298,达喀尔小于 0.001,阿比让小于 0.001,里斯本 0.001。低 R² 的意思是,访客人数解释不了有效距离的线性差异。地图本身仍有颜色差别,所以“不变”不是每一格的公里数都相同。论文指出,偏高的异常点多数对应港口,例如新加坡和达喀尔,或旅游吸引点,例如里斯本。这些地点有理由接到来自更远居住地的人。
五张地图的色标上限不同,观测期也不同。不能把波士顿色标上的 200 公里和达喀尔色标上的 40 公里读成两个城市的人均距离之比。可比较的是每个城市内部那次回归的 R²。
吸引力会聚成多大的团?
μᵢ 由方程取对数后的线性回归得到。它在大波士顿不是均匀撒开的:高值连成大团,大团周围还有较小的团。这与商业和设施聚集的既有城市研究一致,但这张图本身只显示由到访谱拟合出的系数,没有直接统计商店或就业岗位。
团的大小用城市聚类算法划分。先把低于阈值 μ 的格子清成零,再把空间上相连的非零格子并成团。阈值的选择看一个面积比:最大团的面积,除以所有团的面积之和。μ 极低时,几乎整个地区并成一团,比值接近 1;μ 极高时,只剩下波士顿市中心附近的一团,比值再次接近 1。比值最低的位置被当作临界阈值,约为 10^0.5。图 3b 的虚线就在 log₁₀μ 约为 0.5 处,曲线降到 0.4 刻度以下后再回升。
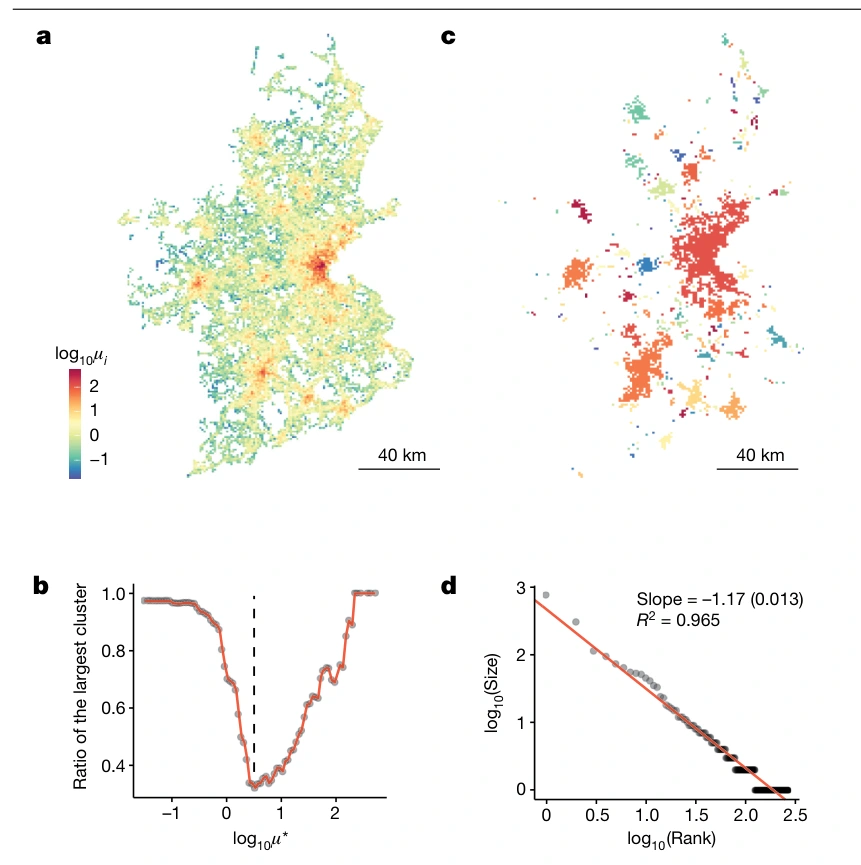
图 3|地点吸引力只是随机高低,还是会形成有面积规律的中心?
(a)大波士顿 log₁₀μᵢ,色标从 −1 到 2,尺度条 40 公里。(b)最大团面积占全部团面积的比例如何随阈值变化;虚线是比值最低的位置。(c)该阈值下的团,颜色区分不同的团,尺度条 40 公里。(d)这些团的面积秩–规模关系,斜率为 −1.17(0.013),R² = 0.965。来源:原论文 Fig. 3。
按面积排名后,面积近似与排名的 −1.17 次方成正比。齐夫定律在城市人口和面积上通常指大约 −1。−1.17 与 −1 接近,标准误只有 0.013,R² 为 0.965,但它仍然是这条临界阈值下的拟合,不是证明任何阈值、任何城市的团块面积都精确服从齐夫定律。图 3 只画了大波士顿。
个人的来回往返,怎样变成全城的平方反比?
模拟从探索与优先返回模型出发。每一步,代理以概率 P_new = σS^−γ 去一个没去过的地点,S 是已经去过的地点数;以 1 − P_new 回到旧地点,回到某处的概率正比于自己以前去过那里的次数。σ = 0.6,γ = 0.21,取自既有的个人移动测量。探索时,跳跃距离服从 P(Δr) ~ |Δr|^−1−α,α = 0.55;若方向完全随机,这就是原来的模型。
10 万个代理放在 300 × 300 的方格上,家均匀随机落在内部 100 × 100 的格子,分析也限制在这块内部,用来减轻边界影响。时间步长取 1,每人走 10³ 步,一个人走完再换下一个人,并且不使用原来模型里的停留时间分布。跳出大网格的轨迹会停止。
只让每个人独立选择时,谱流仍然接近平方反比。扩展数据图 7 给出 η = 2.12,标准误 0.018,R² = 0.992。访问次数在中心略高,但吸引力 log₁₀μᵢ 大体铺在约 0.25 到 1 之间,没有图 3a 那种分明的中心和次中心。个人的探索与返回,足以说明指数,不足以说明城市为什么会形成吸引团。
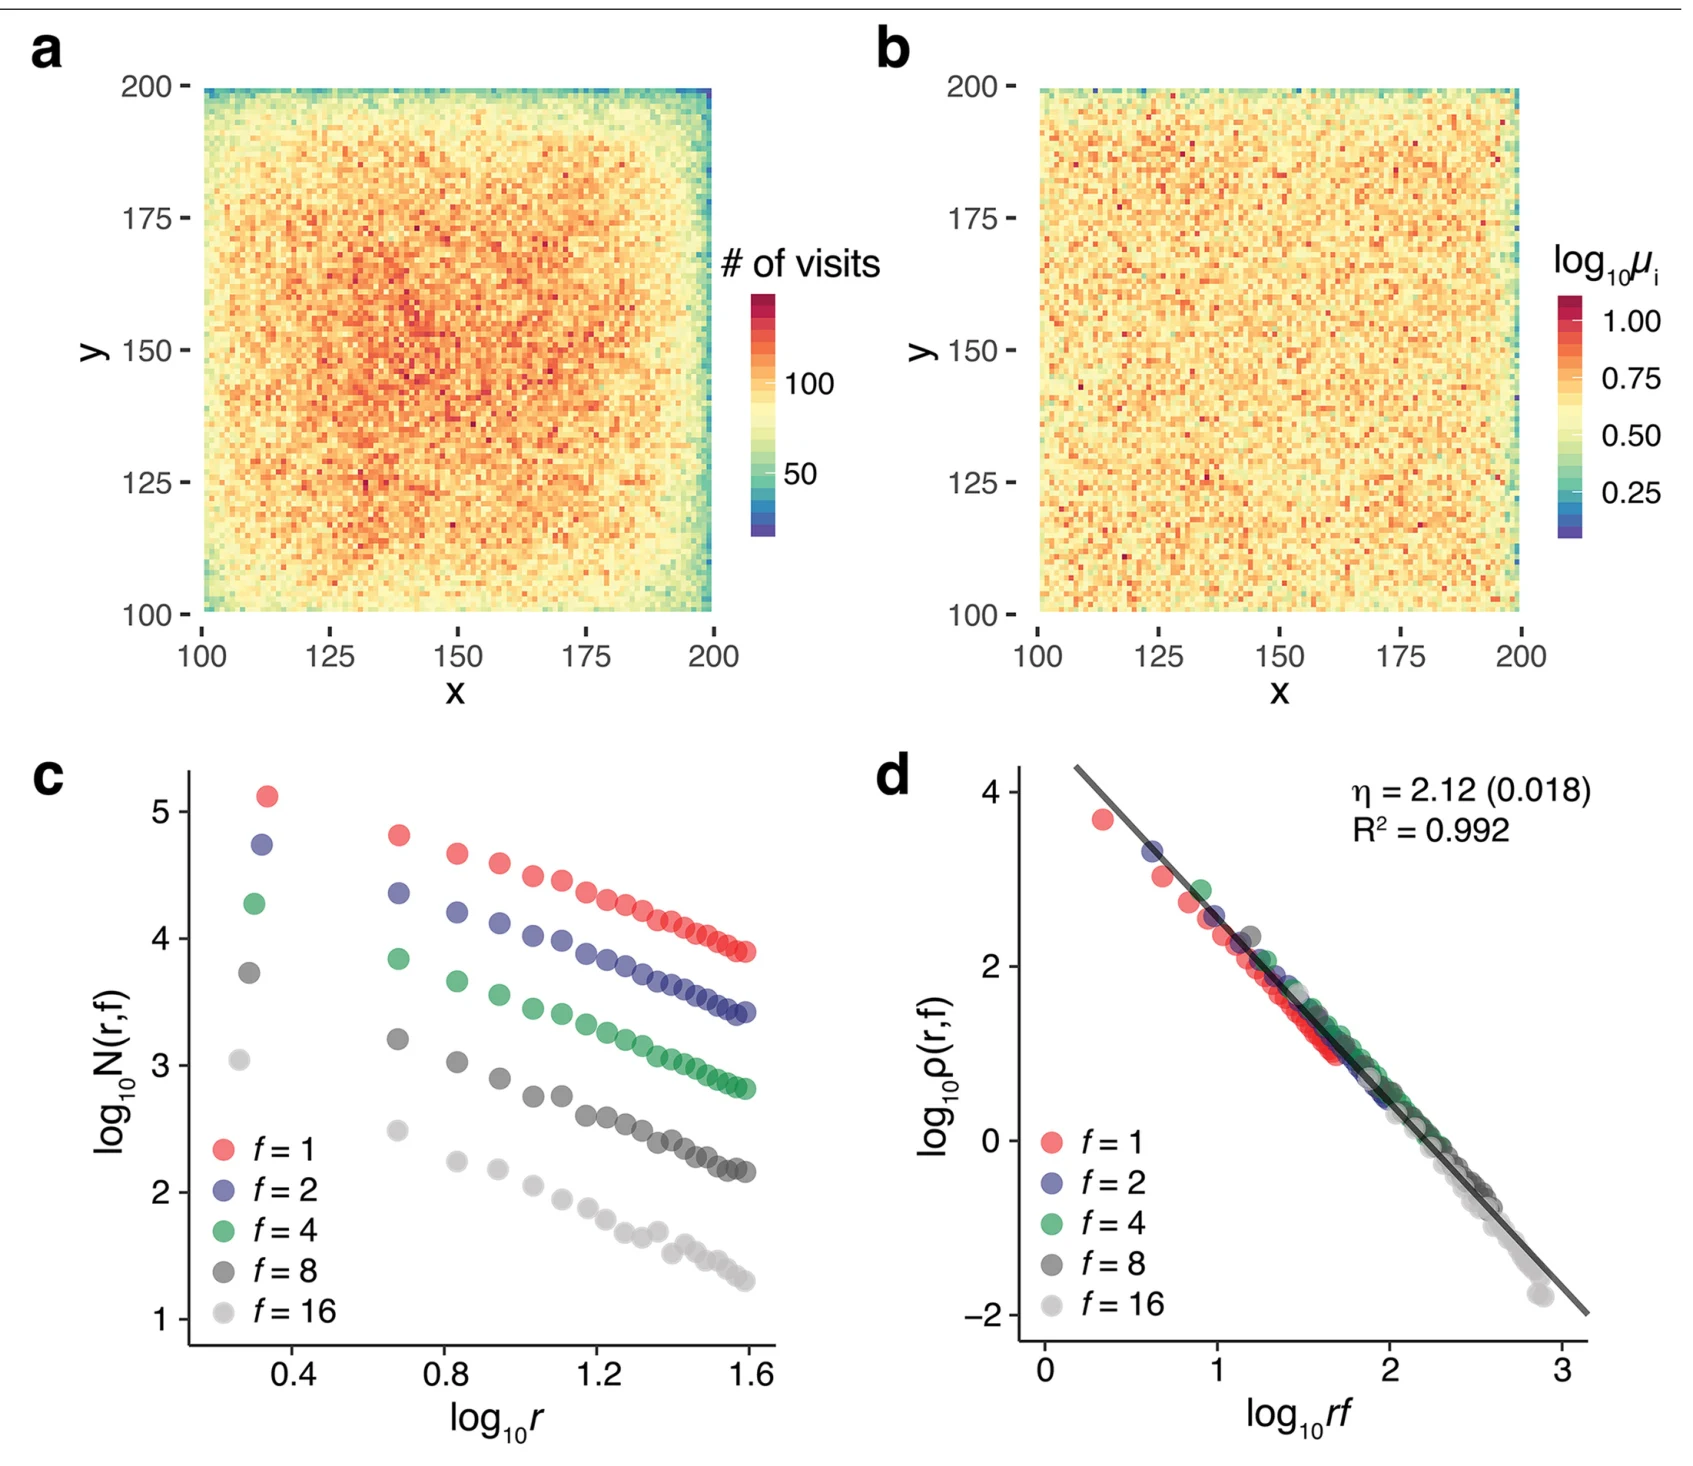
图 E7|不加地点之间的耦合,个人模型能解释到哪一步?
(a)模拟访问次数,颜色大约从几十次到 100 次以上。(b)吸引力,空间上缺少明显团块。(c)不同频率的原始计数随距离下降,彼此分开。(d)换成谱流并按 rf 作图后,η = 2.12(0.018),R² = 0.992。来源:原论文 Extended Data Fig. 7。
优先探索与优先返回模型只改方向。跳跃距离的分布不变;方向不再均匀抽取,而是偏向距离 R 以内、已被众人付出更多行程的扇区,偏向强度由 ν 控制。图中的方向权重正比于该扇区有效距离的 ν 次方。参数选为 R = 10、ν = 4。方法写明,这两个值是在参数网格里挑选出来的,因为它们能让团块面积接近齐夫定律;距离–频率指数对 R 和 ν 的改变并不敏感。所以图 4 里的指数和图 4f 里的面积指数,证据等级不同。前者在不耦合的模型里已经出现,后者依赖这次选择。
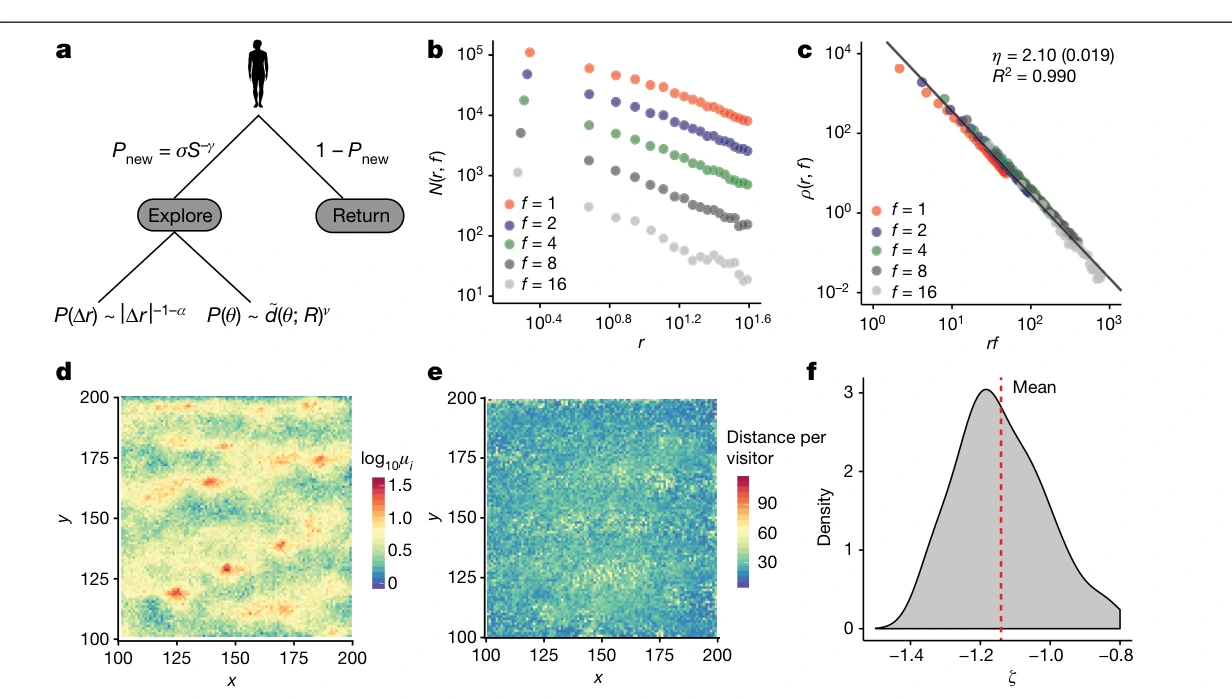
图 4|让新探索偏向热门方向之后,指数和空间团块能否同时出现?
(a)模型示意:探索概率随已访地点数下降,跳跃距离为重尾,方向偏向高到访扇区;否则返回旧地点。(b)原始访客数随距离下降,不同频率分成不同的线。(c)谱流对 rf 塌缩,η = 2.10(0.019),R² = 0.990。(d)吸引力出现局部高值,色标约为 0 至 1.5。(e)每位代理的有效距离没有形成单一中心,色标约为 30 至 90。(f)50 次模拟的面积指数分布,红线为均值;正文给出的指数是 −1.14 ± 0.13(标准差),聚类阈值 μ* = 10。来源:原论文 Fig. 4。
模拟使用规则方格和均匀随机的家,没有河流、地形和资源。论文也写明,模拟团块的具体位置不同于真实城市。它说明一种微观规则可以同时产生这两项统计,不等于还原了波士顿的形成过程。另一个已有模型也会做优先探索,但把引力定律直接放进个人移动;本文的改动是在方向选择里使用众人已经走过的有效距离,而不是先假定加总流量服从引力模型。
只知道人口密度,能同时预测次数和人数吗?
平方反比若成立,整条谱只需要一个高度 μⱼ。估计它的办法是看家。三个假设是:人至少以大约每天 1 次的节奏回家;地点半径 rⱼ 内的人口密度等于边界上的人口密度;住在边界上的人,最低到访频率与住在地点内部、回家的频率同级。于是
μⱼ ≈ ρ_pop(j) × rⱼ² × f_home。
手机记录并没有记下每一次到访。若记录完整,f_home 可取每天 1 次;实际使用的是前面的数据门槛,即多数地区每周 1 夜,葡萄牙每两周 1 夜。扩展数据图 8 把这个边界画成示意:地点内部的流入被人口密度封顶,边界处 f_min ≈ f_home;一旦最低频率低于回家频率,对应的最小距离就向外移。
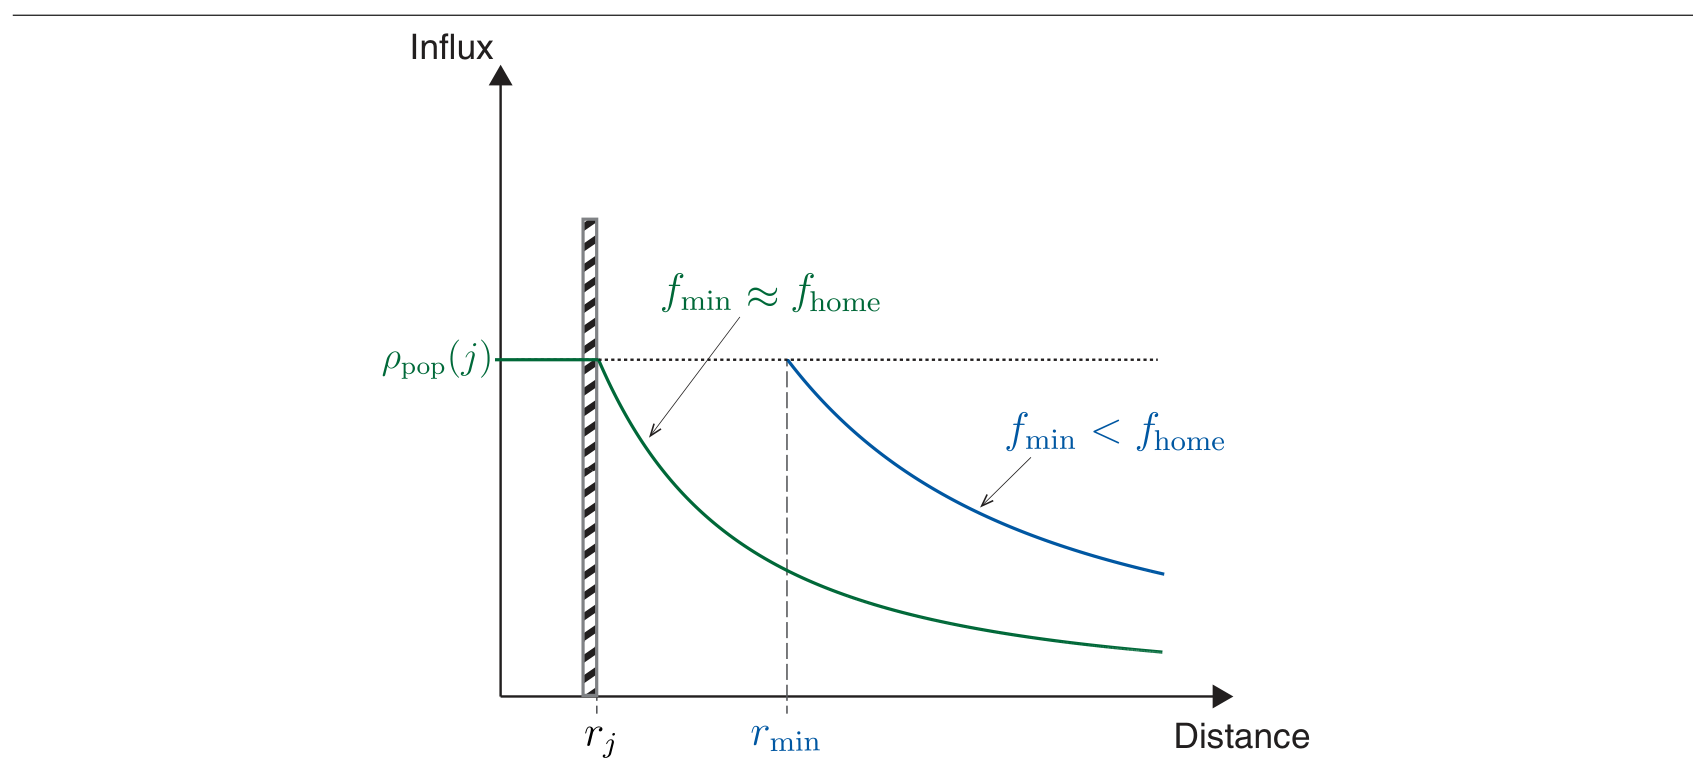
图 E8|为什么可以用居住密度锚定整条到访谱?
无字母示意图。纵轴为流入,横轴为距离。绿色平台是地点 j 的人口密度,阴影带位于半径 rⱼ;绿线在边界上取 f_min ≈ f_home,蓝线表示更低的最低频率以及更远的 r_min。来源:原论文 Extended Data Fig. 8。
从 f_min 积到 f_max,住在起点 i、到访终点 j 的次数约为
Vᵢⱼ ≈ (μⱼ × Aᵢ / rᵢⱼ²) × ln(f_max / f_min)。
Aᵢ 是起点格子的面积,rᵢⱼ 是两格距离。图 5 画的总数还把反向回家算进去:
Vᵢⱼ^tot = (μⱼ Aᵢ + μᵢ Aⱼ) / rᵢⱼ² × ln(f_max / f_min)。
若要包括各类行程,f_min = 1/T,f_max = 每天 1 次,并且用于远大于地点半径的距离。对数使频率界限的误差不会成倍进入总次数。独立访客由谱流对频率积分得到,同一套 μⱼ 因此既能给次数,也能给人数。
对照模型不是无参数的。引力模型采用无约束的幂律形式,流量正比于起点人口的 a 次方、终点人口的 b 次方,再除以距离的 c 次方,四个参数和常数由回归确定。指数形式的距离衰减在所有地区都明显更差,正文没有给出那次比较的 SSI。辐射模型用格子人口代表机会,可以分配出行次数,但每个人只对应一个目的地,所以给不出“同一个人在一段时期访问多个地点”的独立访客。
相似指数把每个起讫对的预测值和观测值拿来比较:两倍的较小值之和,除以预测值之和加观测值之和。1 是完全重合,0 是没有重合。它不是预测对了的人数比例,大流量在求和里更有分量。图 5 只保留起点至少有 25 名用户的流量。
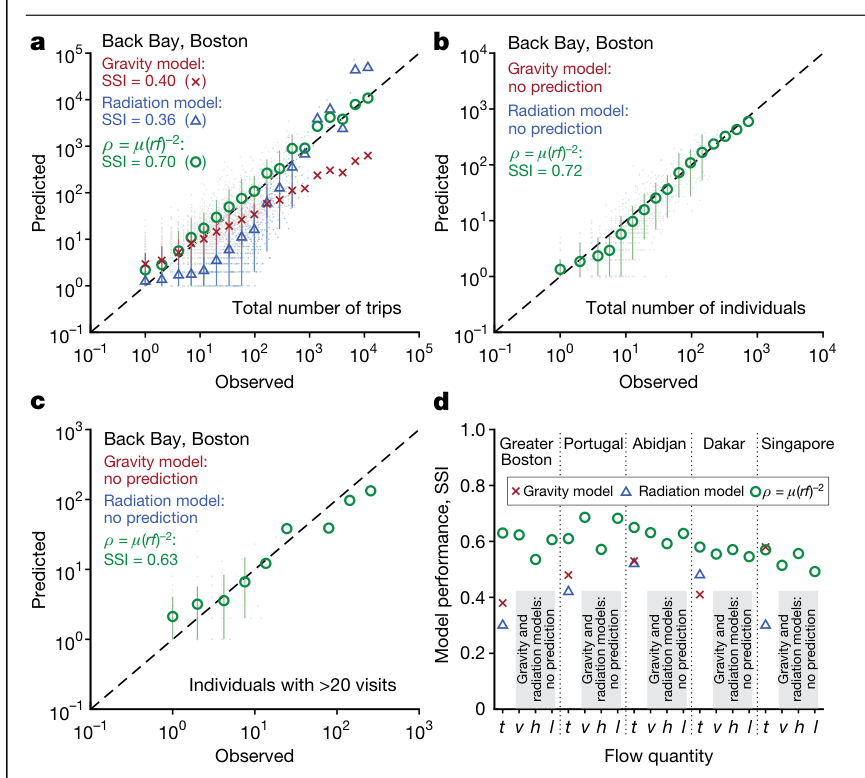
图 5|同一条谱,能否同时预测次数、人数和高频访客?
(a)后湾西区的总出行。点是分箱均值,竖线是 0.1–0.9 分位,虚线是预测等于观测。引力模型 SSI = 0.40,辐射模型 SSI = 0.36,到访定律 SSI = 0.70。(b)独立访客,只有到访定律给出预测,SSI = 0.72。(c)观测期内超过 20 次的访客,SSI = 0.63。(d)五个地区的出行次数 t、访客数 v、高频 h 和低频 l。红叉和蓝三角只出现在 t;v、h、l 被标成两个旧模型无法预测。来源:原论文 Fig. 5。
0.70 高于 0.40 和 0.36,同时远低于 1。图 5a 的大流量一端,引力模型的红叉落到虚线下方,辐射模型的蓝三角偏到虚线上方,绿点更贴近虚线,但分位区间仍然很宽。图 5d 没有逐点标出数值。可以看出的是,多数城市的出行次数上绿点更高;新加坡的次数一格上,红叉与绿点靠得很近,不能概括成每一座城市的每一次比较都有同样的优势。同一城市内,次数的绿点也常常高于高频或低频访客。
高频和低频的分界随采样而定:波士顿每月 5 次,葡萄牙每月 2 次,新加坡每月 4 次,达喀尔和阿比让每周 2 次。图 5c 的“超过 20 次”是后湾在其观测窗口里的计数。波士顿的窗口是 4 个月,每月 5 次在量级上与 20 次相近,但一个是月速率门槛,一个是窗口内次数,二者不是同一个筛选器。
论文还说,人口密度不合适的地点可以改用简单的交通计数。那部分比较在补充信息里,正文没有给出对应的 SSI。
这算不算中心地理论里的高效安排?
中心地理论预期一种嵌套:高等级中心既提供博物馆、大型商业这类较低频率的功能,也包含杂货、餐饮这类较高频率的功能;功能越专门,服务半径越大。本文的数据支持与之相容的距离–频率关系,但没有给格子标注真实的业态。博物馆和杂货店是理论中的例子,不是这套手机数据里的分类结果。
直接量到的是固定频率下、每次到访的平均距离 〈r〉_f,以及它与 1/f 的关系。扩展数据图 9a 是三层中心的示意图。其余面板是五个地区的观测:波士顿 R² = 0.986,频率按 4 个月计,纵轴刻度约从 7 公里到 17 公里;新加坡 R² = 0.944,按 2 个月计;达喀尔 R² = 0.979,阿比让 R² = 0.954,都按 2 周计;里斯本 R² = 0.897,按 8 个月计。曲线总体下降后变平。新加坡和里斯本在高频率一端有点重新上翘,阿比让中段也有偏离,所以“反比”描述的是主要趋势,不是每一个高频点都贴在红线上。葡萄牙面板只标了里斯本,不是波尔图和布拉加的合并曲线。
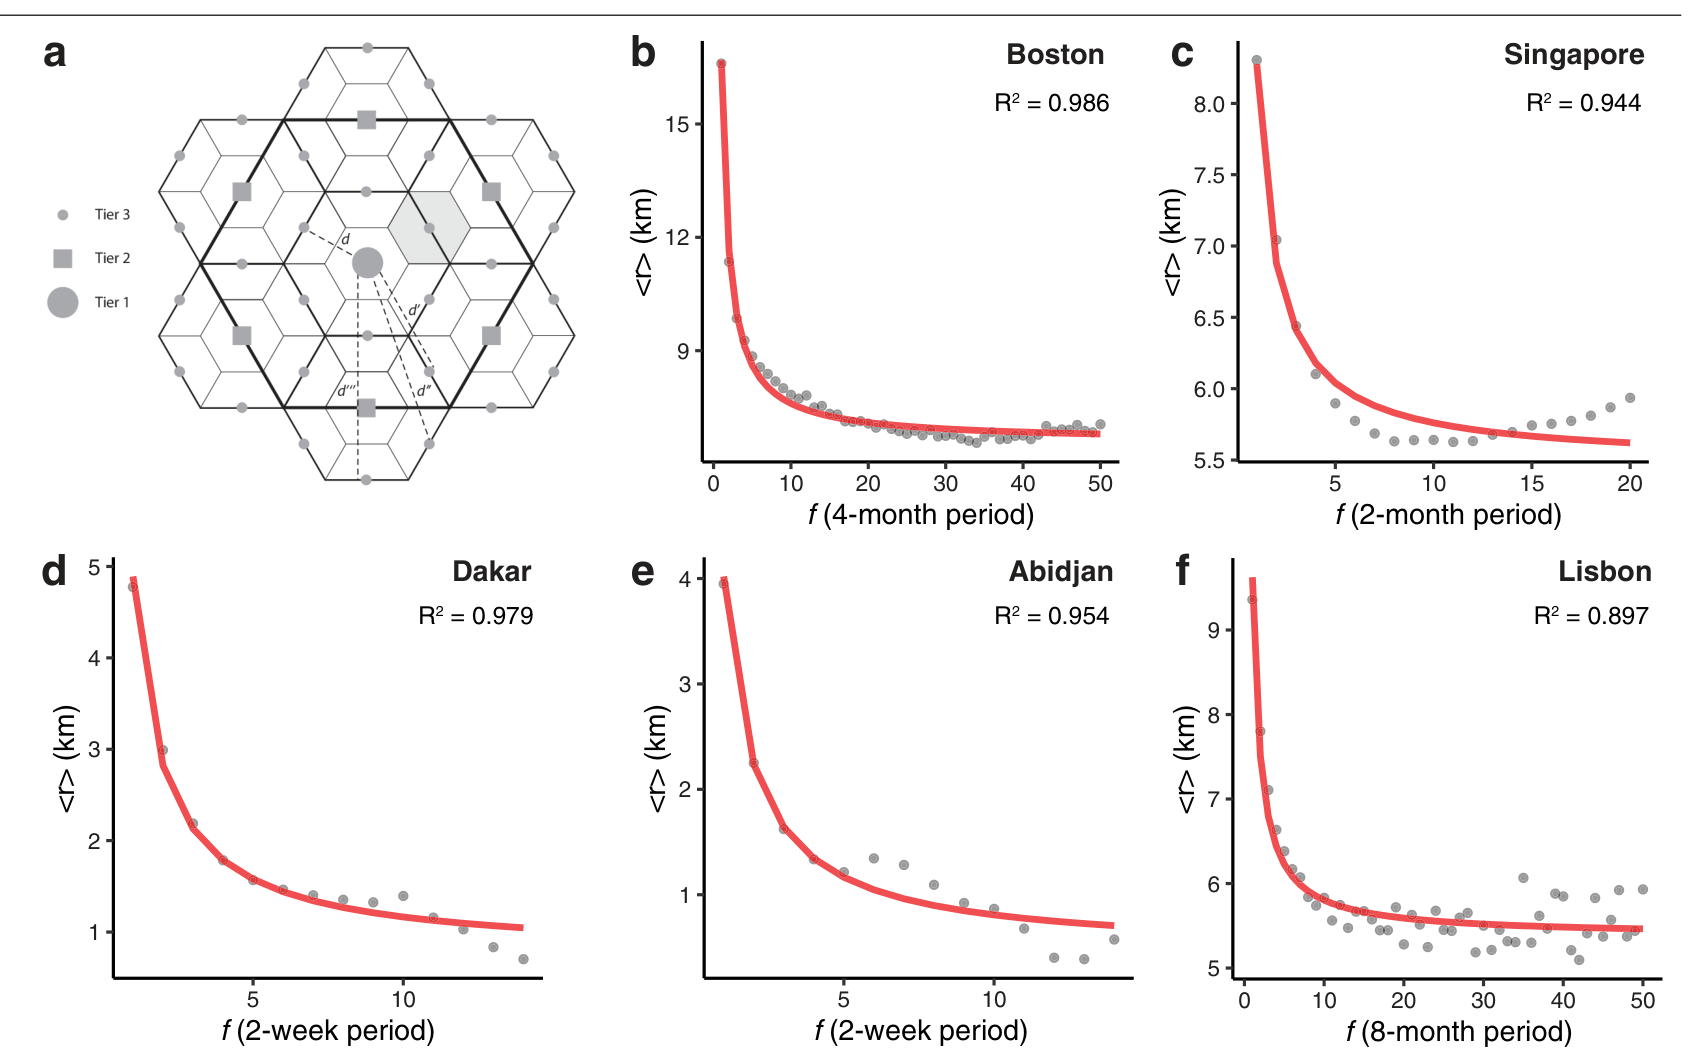
图 E9|到访越勤,单次行程的平均距离是否越短?
(a)中心地理论的三层六边形示意,不是实测地图。(b)波士顿,R² = 0.986。(c)新加坡,R² = 0.944。(d)达喀尔,R² = 0.979。(e)阿比让,R² = 0.954。(f)里斯本,R² = 0.897。红线表示与 1/f 相符的关系。来源:原论文 Extended Data Fig. 9。
另一个问题是,现有地点还能不能通过挪动位置来缩短访客的总有效距离。费马–托里拆利–韦伯点是使加权距离之和最小的位置。设 D 为访客实际付出的有效距离之和,ΔD 是把格子挪到该点后能够减少的部分,图上的纵轴是 ΔD/D。这个比例越小,按交通距离看,当前位置越接近最短总距离。图注把大量格子聚集在很小的 ΔD/D 称为效率很高。
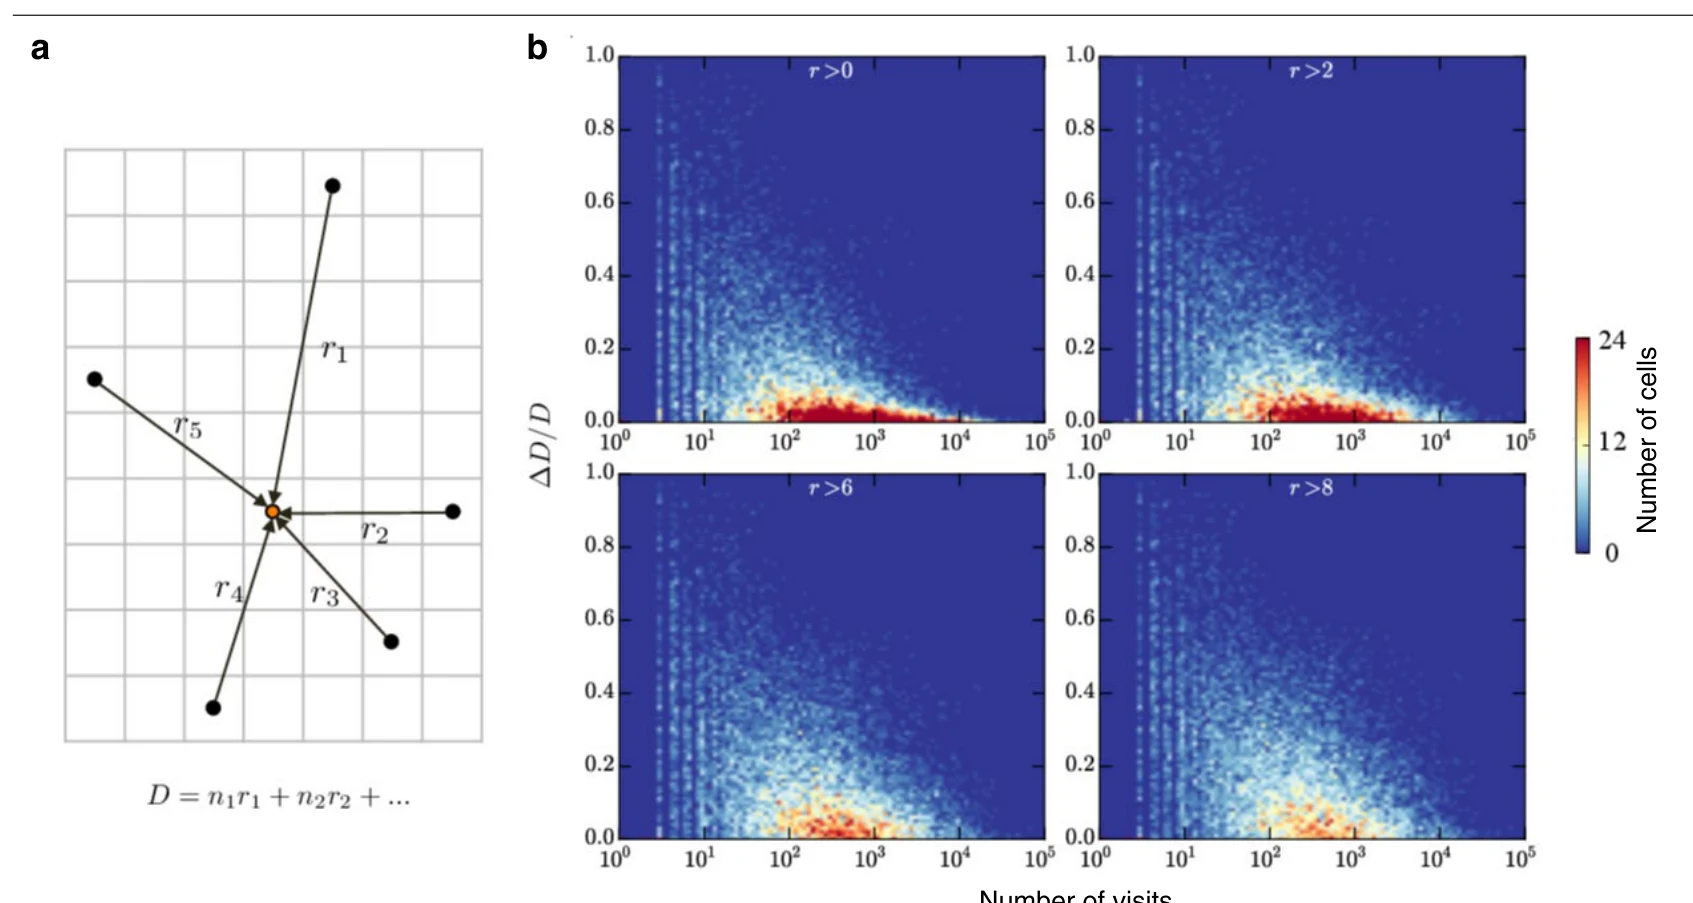
图 E10|把地点挪到几何最优点,访客的总距离还能缩短多少?
(a)示意:黑点为访客来源,橙点为使加权距离之和最小的位置,D 是人数乘距离的和。(b)2009 年 8 月的大波士顿。横轴为访问次数,纵轴为可缩短比例 ΔD/D,颜色是格子数,色标到 24。四格依次为 r > 0、r > 2、r > 6、r > 8;图注将左上角记为阈值 0。来源:原论文 Extended Data Fig. 10。
访问次数增加时,分布更窄,也更靠近 0。距离阈值提高后,这个形态还在,但图注写明它变弱。计算只覆盖大波士顿的 2009 年 8 月,不是五座城市,也没有把河流和地形放进可移动的位置。它表示在“访客居住地不变、只移动目的格子”的指标下,很多格子已经接近最短总距离。这不是居民福利、地租或规划审批意义上的最优,更不是对博弈论里集体非理性的一般反驳。作者用它说明,至少在出行负担这一项上,群体结果可以接近该指标的最优;这个推论依赖上述几何设定。
这条定律能用到哪一步?
谱流的塌缩是多套观测数据上的稳定统计关系。它没有随机改变距离或频率,因此不能把平方反比说成一次干预的因果效应。手机用户不是全体居民,不同运营商、通话详单和上网记录的采样密度不同;不足 1 小时的停留被故意删除。f 是有记录的天数,稀疏通话数据会漏掉真实到访,所以预测里才用数据自身的回家频率,而不是理论中的每天一次。
指数接近 2 是分布的中心,个体地点可以从大约 1.5 延伸到 2.8。港口和旅游点会偏离“每位访客距离不变”。团块的齐夫指数来自大波士顿的一个临界阈值;模拟中的相应指数则是在为这一形态选择 R 和 ν 之后得到的。模型方格也不是真实路网。
预测分数高于两个常用模型,尤其补上了它们给不出的独立访客和频率分层。SSI 为 0.70 仍然留下明显误差,分位区间很宽,而且比较样本限于起点至少 25 名用户的流量。引力模型的出行分数来自对同一批出行的回归,到访定律的指数则固定为平方反比,再用人口密度定高度。这是有利于后者的比较设计,不应写成两种模型都没有接触观测流量。
五个地区的发展水平和数据年份不同,这正是论文声称规律稳固的范围。它仍是一组城市区域在 2006–2013 年的手机记录,不是对所有国家、乡村或疫情期间移动的直接测量。
一句话总结
把环带面积分开之后,一个地点的访客密度大致只跟着居住距离与到访频率的乘积走,并接近这个乘积的平方反比;地点更热闹,主要是因为访客更多,而不是每位访客都走得更远。
核心来源
- Nature 正式论文,核对题目、作者、2021 年 5 月 26 日在线发表与 593 卷 522–527 页。正文图 1–5、扩展数据图 1–10 和方法均来自这一版本。
- 同一 DOI 下的补充材料包含采样、格网与停留门槛的稳健性、集体付出的推导,以及交通计数预测和中心地、韦伯指标的进一步讨论。原始个人轨迹不公开;复现用的网格级数据和代码需向通讯作者申请。
作者介绍
以下只采用论文署名机构和作者贡献说明。三位共同第一作者是 Markus Schläpfer、Lei Dong、Kevin O’Keeffe;Carlo Ratti 与 Geoffrey B. West 共同指导。
- Markus Schläpfer:署名麻省理工学院 Senseable City Laboratory、圣塔菲研究所,以及新加坡 ETH 中心未来城市实验室。参与研究设计、数据处理、发现数据塌缩到单一曲线、理论论证和写作。
- Lei Dong:署名麻省理工学院 Senseable City Laboratory,以及北京大学地球与空间科学学院遥感与地理信息系统研究所。通讯作者,参与研究设计、数据处理、模型构建和写作。
- Kevin O’Keeffe:署名麻省理工学院 Senseable City Laboratory。参与研究设计、数据处理、模型构建和写作。
- Paolo Santi:署名麻省理工学院 Senseable City Laboratory,以及意大利国家研究委员会信息学与远程信息研究所。参与研究设计、模型、韦伯指标检验和写作。
- Michael Szell:署名麻省理工学院 Senseable City Laboratory、哥本哈根信息技术大学和都灵 ISI 基金会。参与写作。
- Hadrien Salat:署名新加坡 ETH 中心未来城市实验室,以及 Orange Labs。参与理论论证。
- Samuel Anklesaria:署名麻省理工学院 Senseable City Laboratory。参与模型构建。
- Mohammad Vazifeh:署名麻省理工学院 Senseable City Laboratory。参与数据处理和韦伯指标检验。
- Carlo Ratti:署名麻省理工学院 Senseable City Laboratory。参与研究设计、写作,并与 West 同为资深作者。
- Geoffrey B. West:署名圣塔菲研究所。参与研究设计、发现数据塌缩、理论论证和写作,并与 Ratti 同为资深作者。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
平方反比把“远但很少来”和“近且经常来”放进同一个乘积。疾病传播若只使用出行次数,会把一名每天到来并停留一小时以上的人,和许多名只出现一天的人混在同一距离衰减里。到访定律能把这两类人拆开,但 f 只计算有记录且停留至少一小时的天数,不计算同一天里的接触时长,也不区分室内外。即便两个来源的 rf 相同、谱流相同,传播风险仍可能不同。要把这条定律用进防疫,还需要把停留时长和接触环境接到频率分层上,而不是只把 SSI 从 0.40 提高到 0.70。
另一个可检验的分界是指数和团块谁更稳。个人探索模型在方向完全随机时已经给出接近 2 的指数,而面积指数依赖专门选出的 R 和 ν。若把在一座城市里选定的 R、ν 原样用到另一座城市,指数可能仍接近 2,面积指数却偏离 −1.14。这种结果会说明:距离与频率的互换是更值得迁移的规律,团块面积接近齐夫定律则还绑在参数选择和当地空间约束上。港口、景区已经在人均距离上偏离内部回归,它们适合作为第一批反例,而不是继续被平均进全城的 R²。