后半天人会待在家、在班,还是在别处?
论文名片|Yapan Liu、Bing Dong,Modeling urban scale human mobility through big data analysis and machine learning,Building Simulation,2024,17(1):3–21。DOI:10.1007/s12273-023-1043-z。这是正式期刊版:PDF 页脚写 BUILD SIMUL (2024) 17: 3–21,页眉为 Vol. 17, No. 1。收稿日期 2023 年 2 月 10 日,修回 2023 年 4 月 28 日,接收 2023 年 5 月 12 日,版权年标为 2023;SciOpen 与 NSF 公共记录中的在线发表日为 2023 年 8 月 14 日。研究类型是手机定位上的停留识别与逐人预测,不是建筑能耗实验。
凤凰城某个工作日的中午,手机还停在办公地点附近。楼宇能耗模拟想知道的是下午这栋楼里还有没有人,电网想知道的是傍晚负荷会不会跟着人回去。一长串经纬度本身答不了这个问题。这项研究先不猜下一栋楼的坐标,而是把每个小时收成家、工作地或其他,再看后 12 小时的类别序列能不能对上。
对这个三分类任务,工作日准确率分布的均值是 85.05%,周末是 85.26%;精确率均值分别是 86.03% 和 86.09%。展示出来的一名用户,2904 个测试小时里有 2654 个小时类别对上。高分主要落在家和工作地,其他地点对得少。这些百分比是类别对上的比例,不是地图误差,也不是本文算出的节电量。
先说结论
- 数据是 2016 年 10 月 1 日至 12 月 31 日亚利桑那州的匿名手机 GPS。全州原始压缩文件约 307 GB;与一个未点名的邮政编码做空间连接后,留下 93,000 个设备、约 19.2 GB。论文把设备称为用户,并假设手机一直在人身边、每人只有一个家。
- 停留点要求落在 250 米、10 分钟以内。DBSCAN 的邻域半径也是 250 米,至少 3 个停留点才成簇。家的钟点是 20:00 到次日 6:00 且停留至少 1.5 小时,工作地是 9:00–18:00 且至少 1.5 小时;对不上的算其他。
- 每人单独训练一个 LSTM。输入是家、工作地、其他的独热编码,不是经纬度。该用户 80% 的数据用于训练,20% 用于测试;检验时用前 12 小时推出后 12 小时。
- 全体测试里,工作日与周末的准确率均值差 0.21 个百分点,精确率均值差 0.06 个百分点。分布在 100% 处抬得很高,论文没有给出那一根柱子的人数。
- 这名典型用户的混淆矩阵合计 2904 小时,对角之和 2654,正文据此写总体准确率 91%、加权平均精确率约 91%。实际为其他的 165 小时里,只有 67 小时仍被预测为其他。
人在不在楼里,为什么要追整座城市的移动?
美国能源部 2015 年的评估写过:建筑部门约占电力使用的 76%,约占一次能源及相关温室气体排放的 40%。这是全国部门口径,不是凤凰城这 93,000 个设备测出来的。人员行为(occupant behavior)在本文里指人是否在空间中、人与建筑系统的互动,以及人对建成环境的适应。单栋楼里的这类行为已经有很多研究,社区和城市尺度仍然少。
城市建筑能耗模型若用错了人的在室日程,可能把区域能源系统选得过大。被本文引用的先前工作给出的是模拟差值,不是本文的结果:Wu 等(2020)按移动数据得到的在室率,冷却、采暖需求最多可比对照低 40% 和 60%;Barbour 等(2019)相对美国能源部标准在室率,居住建筑能耗降幅可达 15%,商业建筑可达 21%;Dong 等(2019)的示例建筑中,大型办公楼差异最高到 50%,沿街商业约 30%。这些“最高到”是各研究自己的模拟对照,分母不是本文的预测误差。本文没有跑城市能耗模型。
人类移动性(human mobility)在这里也不是搬家或户籍迁移,而是一天之中在城市不同地点之间的室外移动。作者认为,知道人在哪些楼之间移动,才能反推人在不在某栋楼里。已有神经网络多半预测下一个地点或下一个兴趣点。本文要的是一整天、固定往前 12 小时的类别序列。
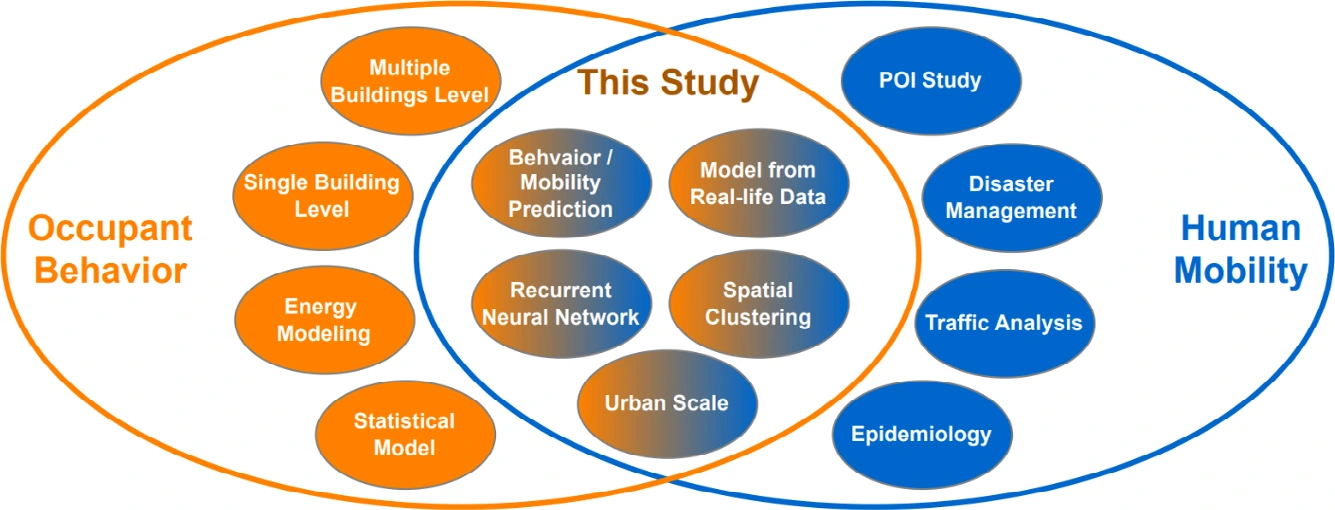
图 1|这篇工作把自己放在人员行为和人类移动性的哪一块?
无字母子图。左圈是人员行为,从多栋楼、单栋楼写到能耗模拟和统计模型;右圈是人类移动性,包含兴趣点、灾害、交通和流行病学。中间一圈标着本研究:由真实数据建模、循环神经网络、空间聚类、城市尺度,以及行为或移动预测。这是文献位置示意图,没有样本量和预测分数。来源:原论文 Fig. 1。
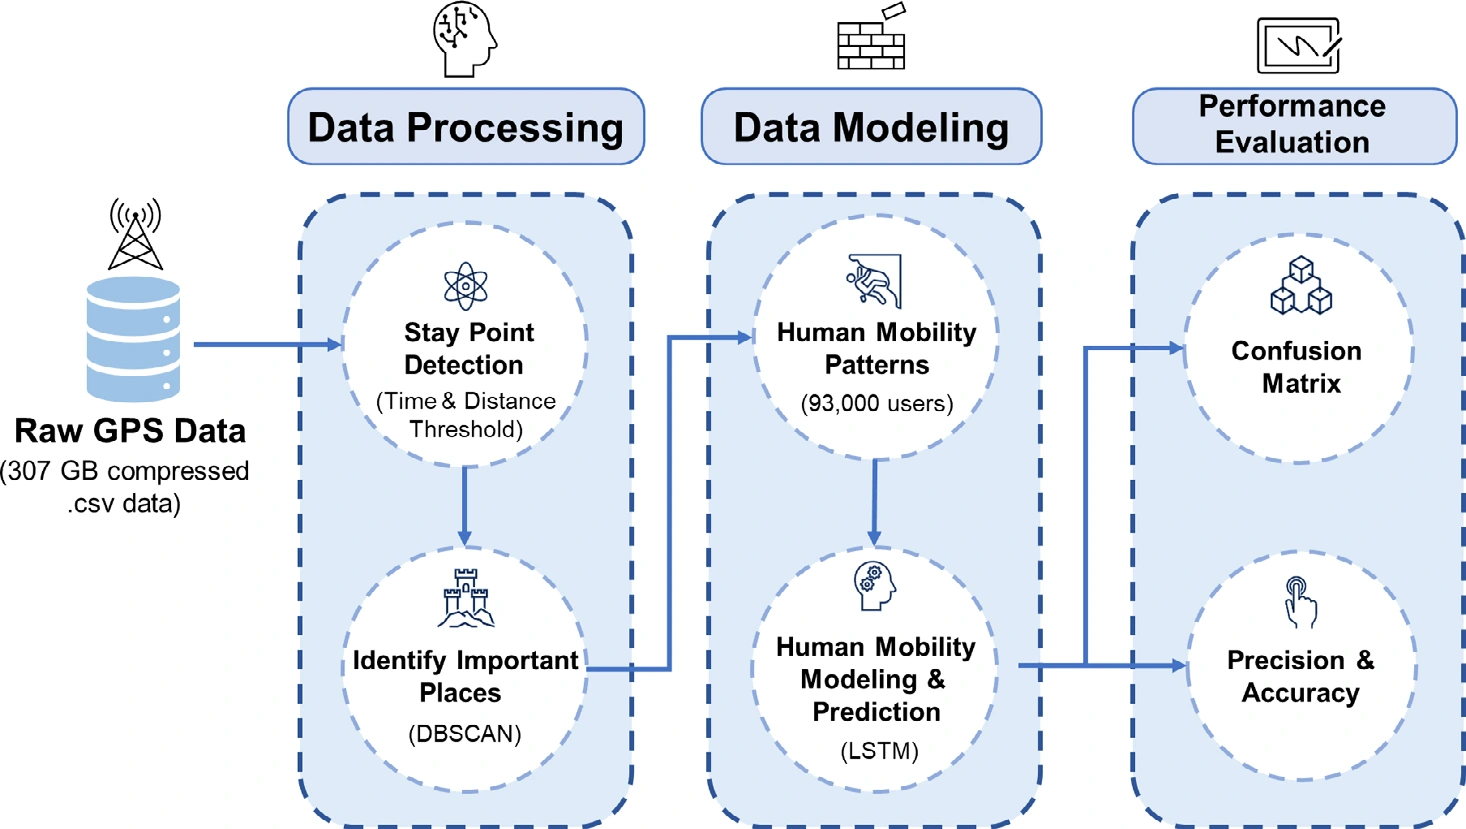
图 2|从原始定位到准确率,中间经过哪三步?
无字母子图。左列处理约 307 GB 压缩 CSV:先按时间与距离阈值提取停留点,再用 DBSCAN 认重要地点。中列把 93,000 名用户的停留收成移动模式,并用 LSTM 做序列预测。右列用混淆矩阵计算精确率与准确率。图中的 93,000 是进入模式构建的用户数,不是测试小时数。来源:原论文 Fig. 2。
这三个月的点,到底是谁的?
原始记录来自 2016 年 10 月 1 日至 12 月 31 日亚利桑那州的匿名手机,时间戳为 UTC 的 Unix 时间,纬度、经度、海拔为十进制,水平精度以米计。时间分辨率到秒,经纬度保留七位小数。水平精度最好可以到大约 10 米,但随设备变化。每一行对应一个匿名设备号。论文声明其中没有由作者实施的人体或动物实验。
| 字段 | 论文给出的含义 |
|---|---|
| Timestamp | GPS 记录的 UTC Unix 时间戳 |
| Unique ID | 代表采集设备的匿名编号 |
| Latitude / Longitude | 十进制纬度、经度 |
| Altitude | 十进制海拔 |
| Horizontal Accuracy | 该条记录的水平精度,单位米 |
作者先看全州点落在哪里,再把范围收进凤凰城都市区。他们预选了光伏和电池储能用户比例最高的一个邮政编码,理由是以后要做建筑与电网研究;那个编码没有写出,这项后续工作也不在本文范围内。原始点与该邮政编码做空间连接后得到 93,000 个用户,选中数据约 19.2 GB,存成 Parquet。正文没有写明连接规则是“家在这个编码里”,还是“三个月中任意一个点落入该区”,因此这 93,000 不能直接当成凤凰城居民的随机样本,也不能换成受访者人数。全量读取用了 Python 的 Dask,按块装入。
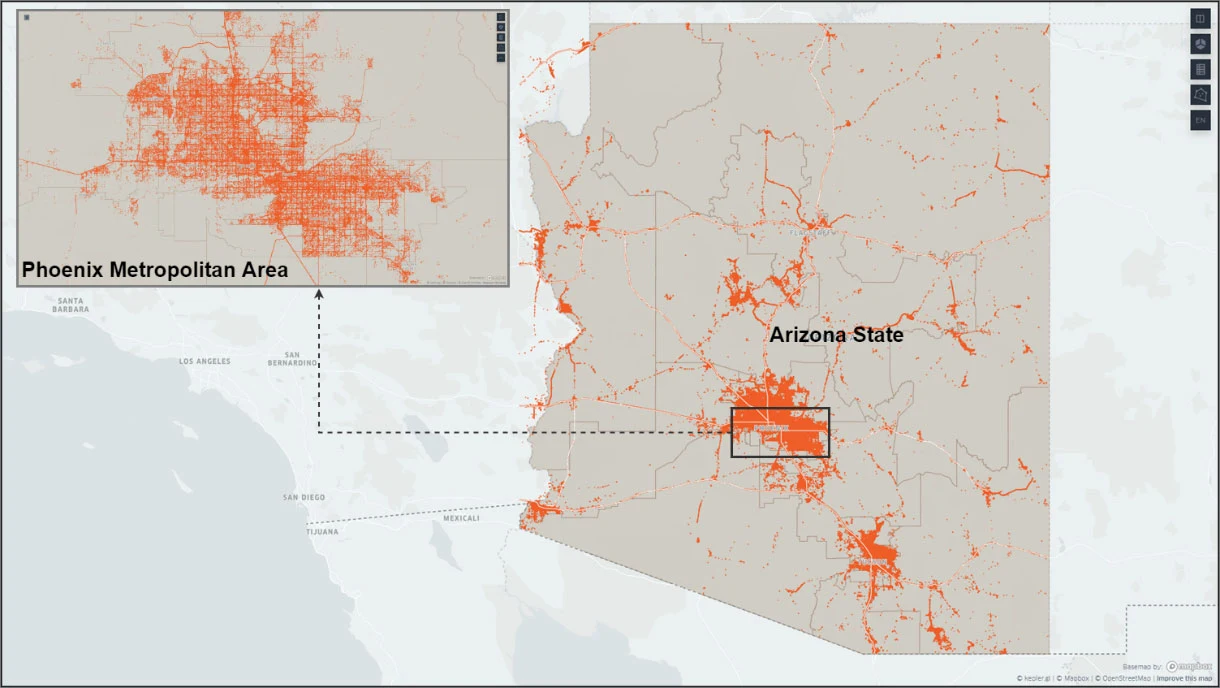
图 3|筛选之前,一小时的原始点集中在哪里?
无字母子图。主图是亚利桑那州,红点为 2016 年 10 月 31 日(星期一)12:00–13:00 的原始 GPS;左上角嵌图框出凤凰城都市区。它只说明这一小时的点大多围着凤凰城,不是三个月全部停留,也不是后来 93,000 个设备的家。来源:原论文 Fig. 3。
四名示例用户的原始轨迹被画进经纬度–时刻空间。正文写竖轴是 0–24 时,并用蓝到红表示时刻。图上能看见清晨停在一处、白天移到另一处、晚上回到清晨附近的折线。这仍是原始点,通勤路段还在里面。
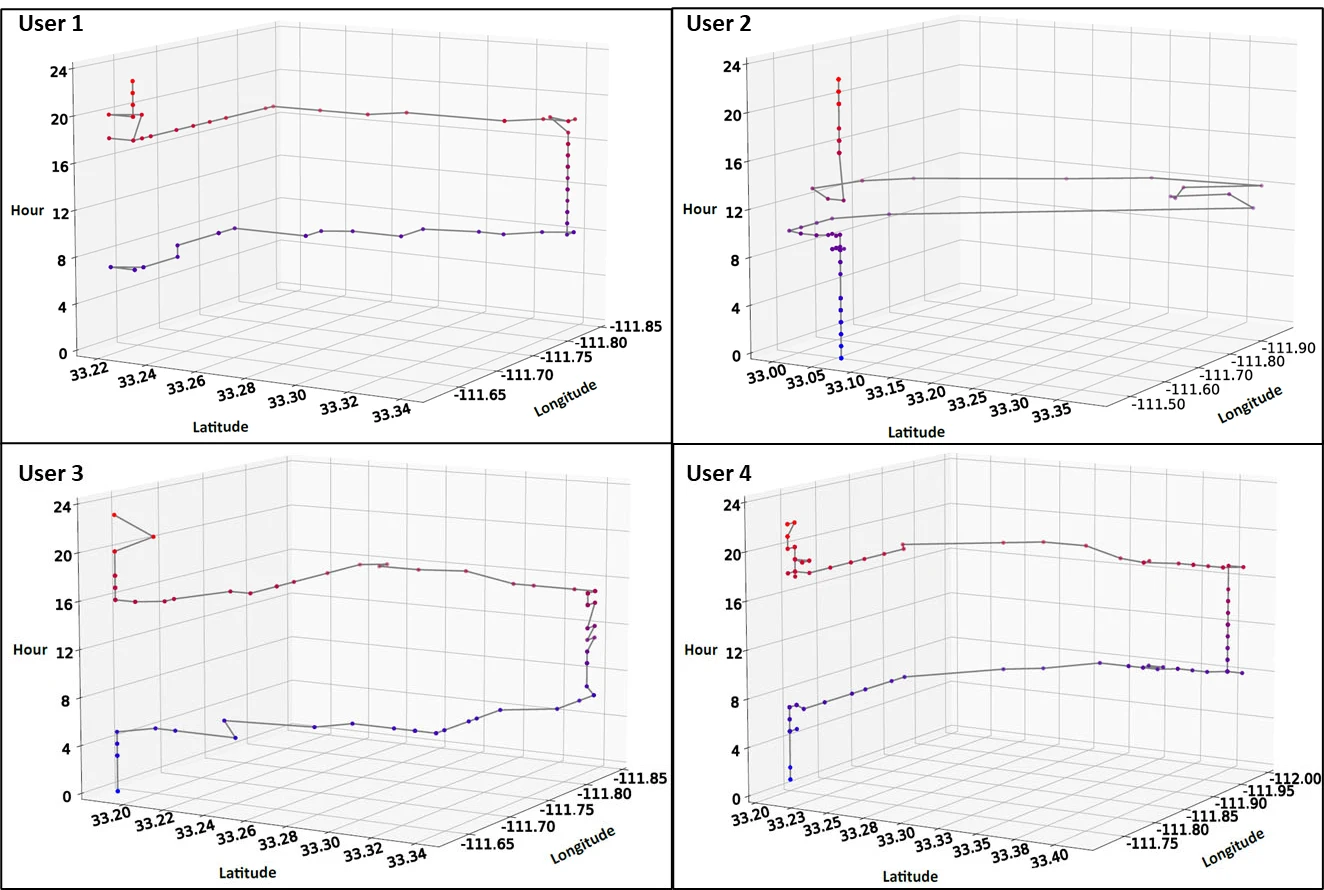
图 4|单看四个人的原始点,一天的折线长什么样?
无字母子图,四格为 User 1 至 User 4。横轴纬度、斜向轴经度,大约落在北纬 33.2°–33.4°、西经 111.6°–112.0°;竖轴是 0–24 时。点色从早间的蓝、紫过渡到晚间的红,折线连接先后点。四人都有成段停留和中途位移,但停留长短、班次形状并不相同。四个人不能代表 93,000 人。来源:原论文 Fig. 4。
通勤途中的点,为什么被当成噪声丢掉?
本文要的是人停在哪里,不是沿路怎么走。高楼和弱信号会让定位乱跳,通勤中的点也会把“停留”冲稀。停留点检测因此把一组点收成一个停留:这些点彼此相距不超过 250 米,并且从第一个点到最后一个点至少跨过 10 分钟。阈值取自 Jiang 等(2016)和 Barbour 等(2019),并在本文数据上使用。250 米也用来压低大约 10 米、但设备之间并不稳定的定位误差。
组内第一个点的时刻是到达,最后一个点的时刻是离开。停留时长等于离开减去到达。停留点的纬度、经度是组内原始点的平均,分母是组内点数。通勤和更短的停留就在这一步被丢掉。后面的家、班、其他,都不再看见这些在路上的点。
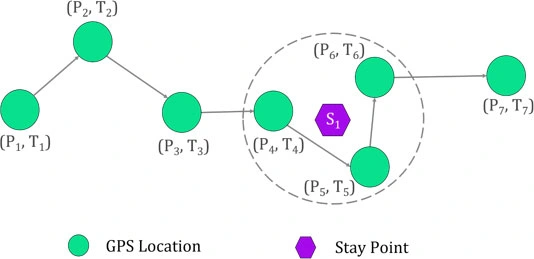
图 5|一组原始点怎样变成一个停留点?
无字母子图。绿点是带时刻的原始 GPS,紫点是提取出的停留点,灰色虚线圈表示 10 分钟与 250 米。圈内若干绿点被收成一个停留,圈外的点仍是另一处或仍在移动。示意图没有标出真实街道。来源:原论文 Fig. 5。
家和工作地,是按哪套钟点判出来的?
停留点还要再聚类,否则同一个人在同一栋楼旁的多次停留会变成许多散点。DBSCAN 不要求事先指定簇的个数。一个点的邻域是与它距离不超过 ε 的停留点;邻域里至少有 Nmin 个点,它才是核心点。本文取 ε = 250 米、Nmin = 3。半径与停留检测的距离阈值相同,最少点数取得较低,是因为每个停留点背后已经有一串原始点。核心点连同其边界点构成一簇,够不着任何核心点的停留进入噪声簇,编号为 −1。
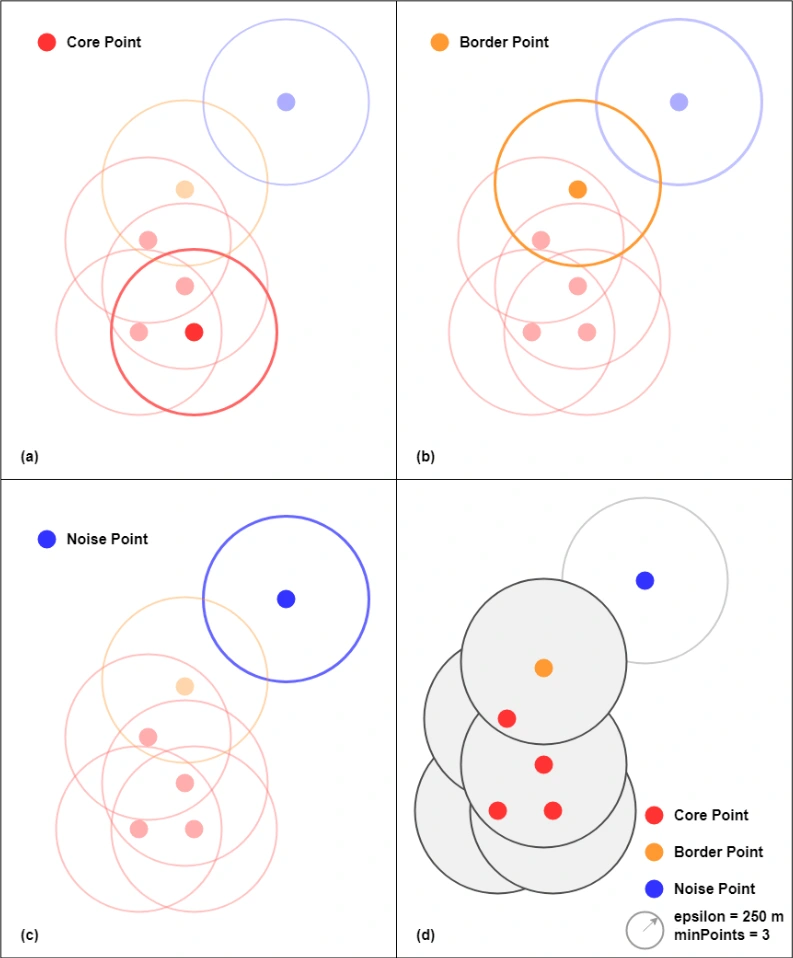
图 6|250 米和最少 3 个点,怎样区分核心、边界和噪声?
(a)红点是核心点,红圈是它的 250 米邻域,邻域内点数达到最少 3 个。(b)橙点落在别人的邻域边缘,自身邻域不够 3 个点,所以是边界点。(c)蓝点在各核心邻域之外,被标成噪声。(d)核心点与边界点合成灰色簇,蓝点留在簇外;图例再次写明 epsilon = 250 m、minPoints = 3。这是算法示意图,不是凤凰城的停留统计。来源:原论文 Fig. 6。
一名用户的示例里,色标从 −1 画到 8。正文说 −1 是噪声,0 到 8 是算法找到的各个簇;图注又写包括噪声簇在内一共九个簇。−1 与 0–8 合起来是十个编号,和图注的“九个”对不上。正文没有再给这名用户的停留点数,所以这里只能确认:噪声被单独放进 −1,其余停留按 250 米密度分成若干地点,各地点的停留数并不一样。
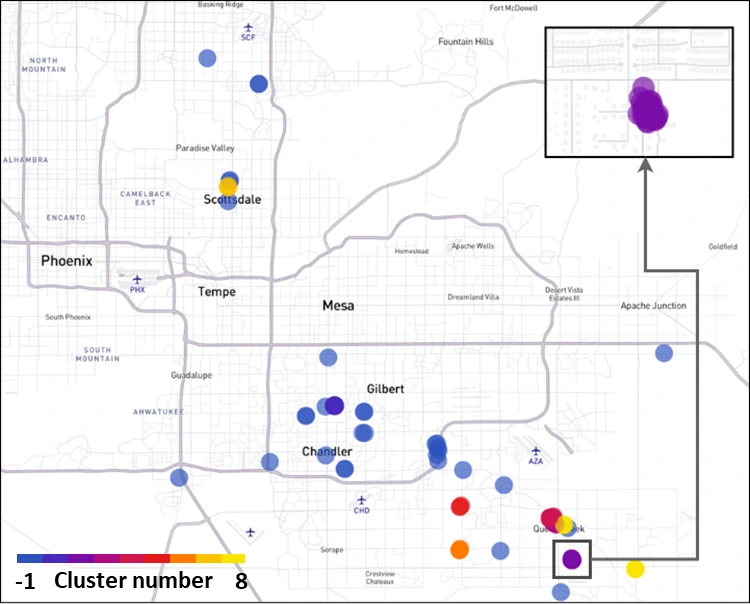
图 7|同一个人的停留点,在凤凰城被分成了哪些簇?
无字母子图。底图从凤凰城、斯科茨代尔、坦佩、梅萨画到吉尔伯特和钱德勒,点色表示簇编号,色标从 −1 到 8。右上角嵌图放大一处高密度簇。它说明停留可以被收成少数地点,但不能据此算出全市有多少个家。来源:原论文 Fig. 7。
簇还要用钟点改写成三类。家的时间窗是 20:00 到次日 6:00,工作地是当天 9:00 到 18:00,其余钟点先算其他。若一个停留点的时刻落在家的时间窗,且停留不少于 1.5 小时,这个点先标成家;停留不少于 24 小时的少见情形也标成家。时刻落在工作时间窗且停留不少于 1.5 小时,则标成工作地。其他情况标成其他。然后,家标签占优的那一簇整体改成家,工作标签占优的簇整体改成工作地,剩下的算其他。讨论部分又补了一句:若检出多个家,访问次数最多的那个当作默认的家。
正文用“停留点的时刻”去对时间窗,没有写明一段停留若跨过 6:00 或 18:00 该算哪一段,也没有单独处理夜班。假设是手机一直在用户身边,每人只有一个家,工作地和其他地点可以有多个。家、各工作地、各地点最后取簇的质心,并按历史出现概率做排序。这个排序被说成以后可以把字母还原成坐标,但后文的评分没有使用坐标误差。
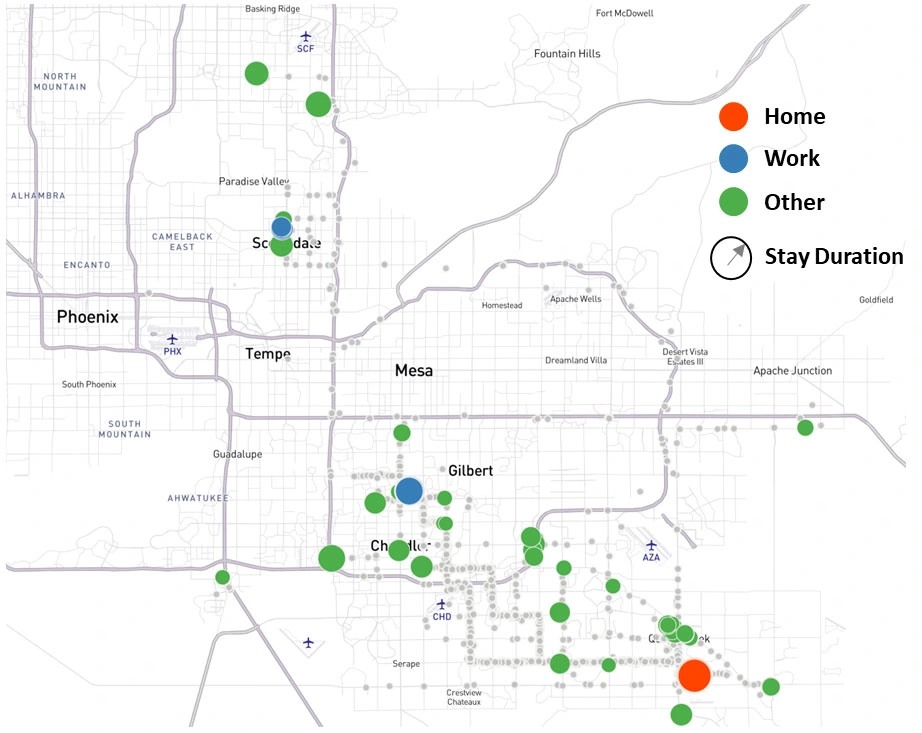
图 8|聚类之后,家、班和其他落在这名用户的哪些位置?
无字母子图。图例中家是暖色圆点,工作地为蓝,其他为绿;圆越大,停留越长。地图范围仍是凤凰城东侧到钱德勒一带。这一例里家和两处工作地是少数大圆,绿色其他地点更多、更散。它是一名用户的标注结果,不是 93,000 人的地点普查。来源:原论文 Fig. 8。
每天再被压成 24 个小时字母:H 是家,W 是工作地,O 是其他。示例的一天在大约 8 点前是 H,白天一段是 W,18 点附近插入很短的 O,晚上回到 H。这些日序列再按星期几归组。预测对象从此只是 H、W、O 的顺序。
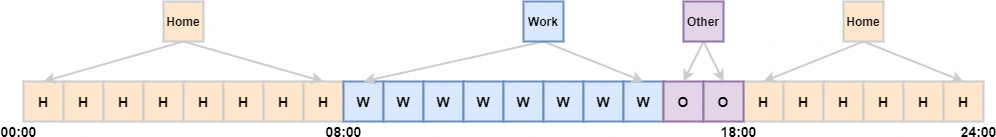
图 9|一天怎样变成 24 个家、班、其他?
无字母子图。横轴 00:00–24:00,每小时一格。示例在早晨长段 H 之后进入 W,18:00 附近只有很短的 O,然后回到 H。它定义了模型要预测的字母,不包含经纬度。来源:原论文 Fig. 9。
模型吃进去的是三个字母,不是经纬度
LSTM 是循环神经网络的一种。本文用它做序列到序列预测:每一步吃入一个停留类别,更新隐藏状态,再吐出下一步。检验时,模型接收 12 小时的字母,逐步生成输出,直到补满后 12 小时,从而凑齐 24 小时。正文没有写明滚出去的那一步,喂回去的是模型刚预测的字母,还是当时的真实字母。
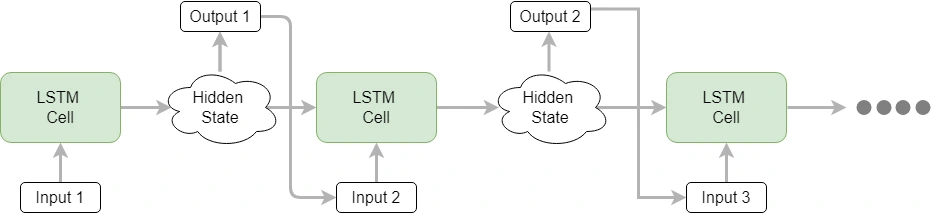
图 10|后一个小时怎样依赖前一个隐藏状态?
无字母子图。三个 LSTM 单元依次接收 Input 1、Input 2、Input 3,各自写出 Hidden State,再给出 Output 1、Output 2,并以省略号表示序列继续。图只说明逐步传递,没有画出 12 小时输入和 12 小时输出的分界。来源:原论文 Fig. 10。
H、W、O 先做独热编码,变成只有一个 1 的三维向量。论文写用 Shadow neural networks 来搭建模型,但没有解释这个名称。能够核对的设置是:隐藏维为 5,训练 1000 轮,学习率调度从 0.1 开始。每人一个模型,结构相同,数据不同;80% 用于训练,20% 用于测试。切分没有写明是按日期、按小时,还是随机打乱。若相邻日期被随机分到训练和测试两侧,分数就不能当成对下一个月的预测。
训练和检验还不是同一个任务。训练时,输入和目标覆盖一天中的 23 小时,目标序列比输入超前一步,也就是用前面的字母预测下一个字母。检验时,才用当天前 12 小时预测后 12 小时。因此,报出来的 85% 和 86% 是 12 小时预测时长上的测试结果,不是训练时的下一步误差。
计算在一台 Linux 机器上完成:AMD Ryzen 9 3950X 16 核,两块各 16 GB 显存的 NVIDIA Quadro RTX 5000,系统内存 115 GB。全文处理大约四天;后文又写每名用户的训练加测试大约 8 秒。按 93,000 人、每人 8 秒、完全串行估算,大约是 8.6 天。两个都是原文的约数,并行方式没有写出,不能把它们收成同一本账。
91% 是 2904 个小时里的多少格?
结果部分回到一名典型用户。原始点沿道路铺开,颜色表示 0–23 时,密的地方被看成可能的停留。停留点检测之后,蓝点明显少于灰点。正文只说停留点远少于原始点,没有给出这名用户的原始点数和停留点数。
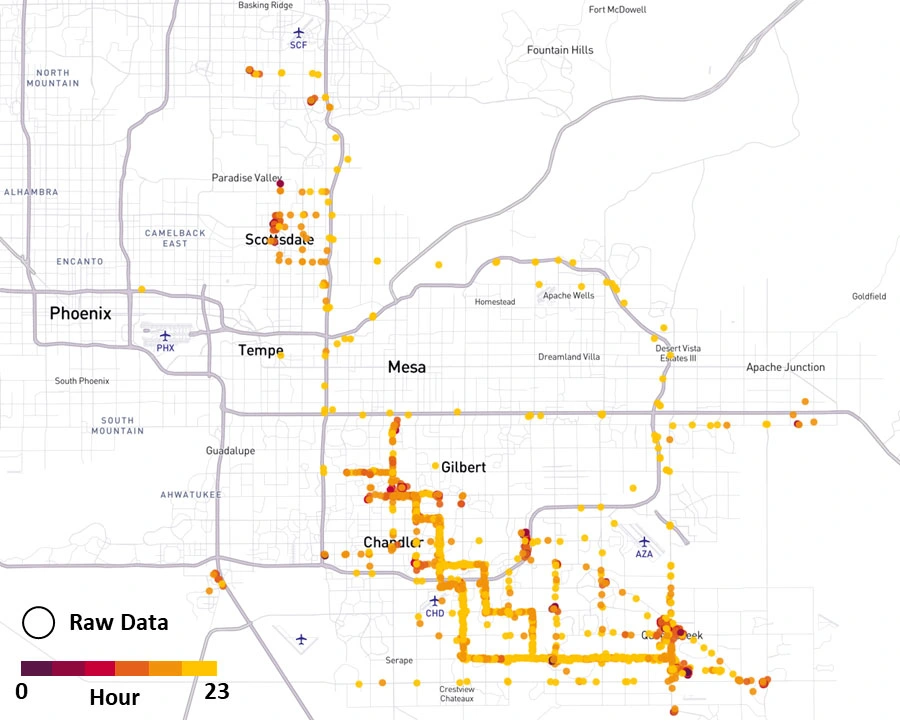
图 11|这名用户的原始点沿哪些路铺开?
无字母子图。白到橙表示 0–23 时,点分布在斯科茨代尔、坦佩、梅萨、吉尔伯特和钱德勒一带,并沿道路连成通勤痕迹。颜色只区分钟点,还没有区分家和班。来源:原论文 Fig. 11。
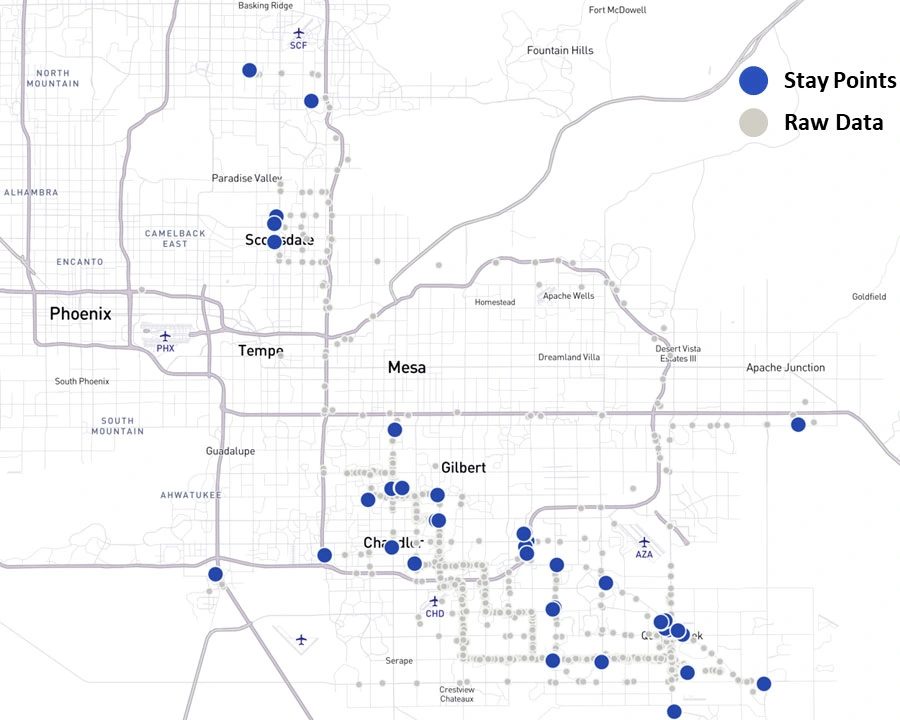
图 12|丢掉通勤之后,还剩下哪些停留?
无字母子图。蓝点是停留点,灰点是原始 GPS。蓝点集中在少数地点,灰点仍铺在路上。图没有标注停留点个数,只能看出停留比原始点稀疏。来源:原论文 Fig. 12。
按小时铺开的三个月里,这名用户大部分时间在家,工作地成段出现,其他地点是偶尔的尖峰。图注写“one month”,日期轴却从 2016-10-01 画到 2017-01-01,与正文“三个月”一致,和英文图注的“一个月”不一致。读图以日期轴为准。
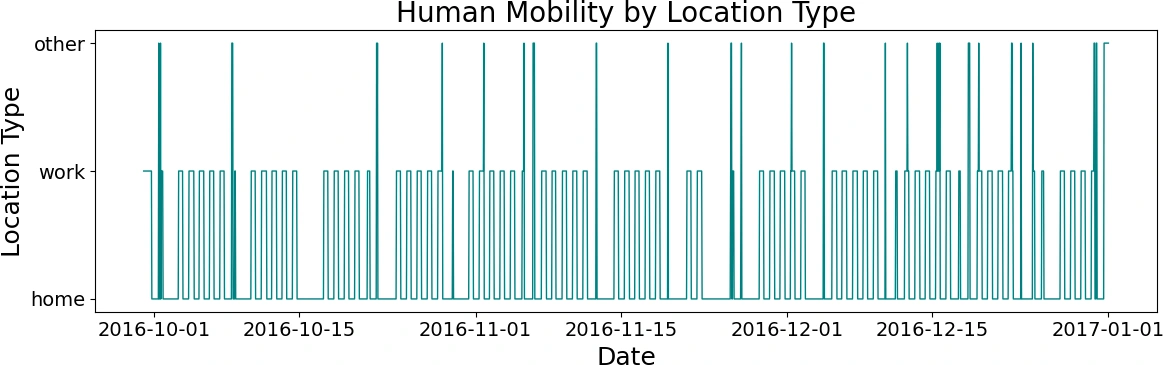
图 13|这三个月里,这名用户多数小时待在哪一类地方?
无字母子图。纵轴从下到上是 home、work、other,横轴为 2016 年 10 月 1 日至 2017 年 1 月 1 日,竖线标出每小时的类别。家占据大部分时间,工作地反复出现,其他地点是稀疏尖峰。它解释了为什么后面家更容易被测对,但不能外推到夜班工人。来源:原论文 Fig. 13。
训练用的 80% 按工作日和周末分开画。工作日多数序列从家开始、在家结束,也有序列在 0 点已经位于工作地;大约 6 点以后,家、班、其他开始分叉。周末更多停在家里,离开得更晚,其他地点主要出现在中午以后。这是这名用户的训练样本,不是全市平均日程。
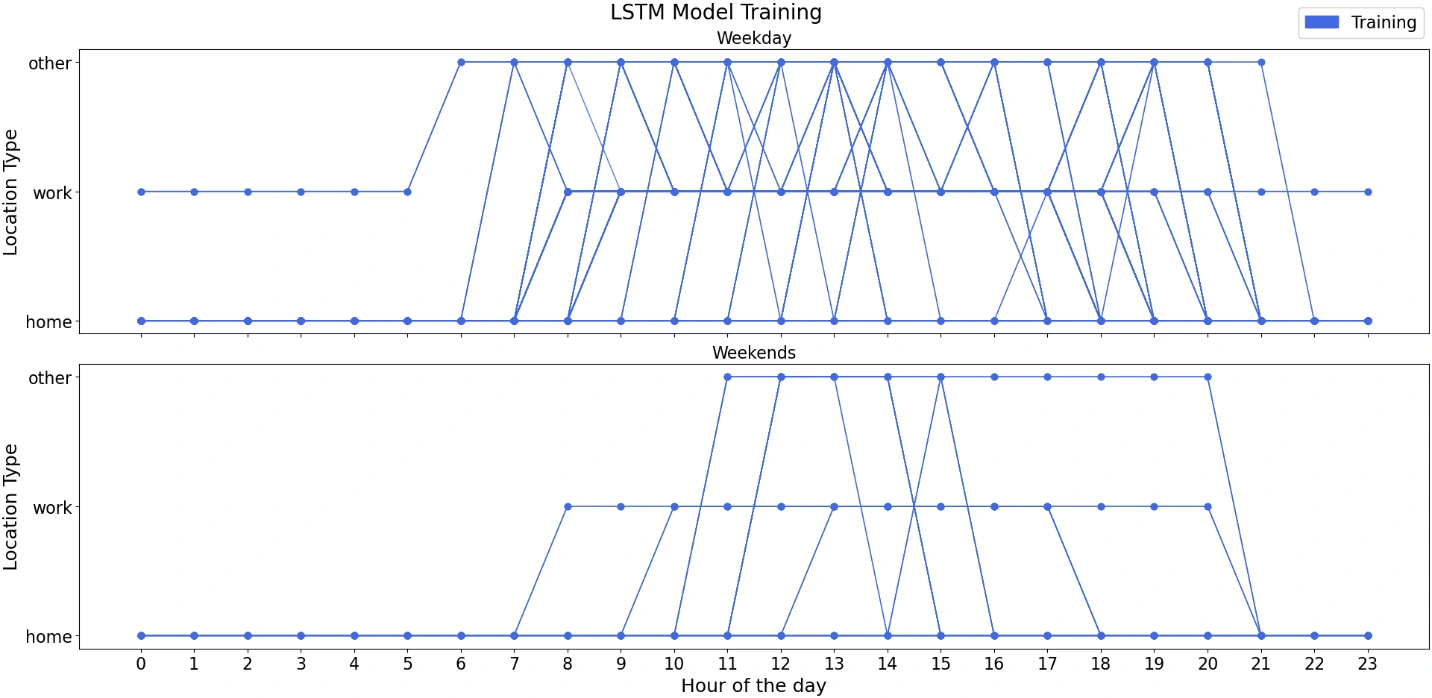
图 14|训练时,工作日和周末的字母序列差在哪里?
无字母子图。上图为 Weekday,下图为 Weekends,蓝色折线是训练序列,横轴 0–23 时,纵轴为 home、work、other。工作日清晨已有停在工作地的序列,6 点后三类来回切换;周末清晨几乎都在家,其他地点集中在日间。图注写明这是 80% 的训练数据。来源:原论文 Fig. 14。
测试用其余 20%。正文写 0 点到 12 点作为输入,预测其后 12 小时。图上的绿色预测区间从大约 12 点盖到 23 点。青色是真实类别,橙色是预测,并被错开以便比较。工作日下午,预测会在班和其他之间跟丢;周末这一例里,真实序列白天去了其他地点,预测在绿色区间里仍停在家。所以“模型学会了日模式”只对一部分测试天成立,图本身就有对不上的天。
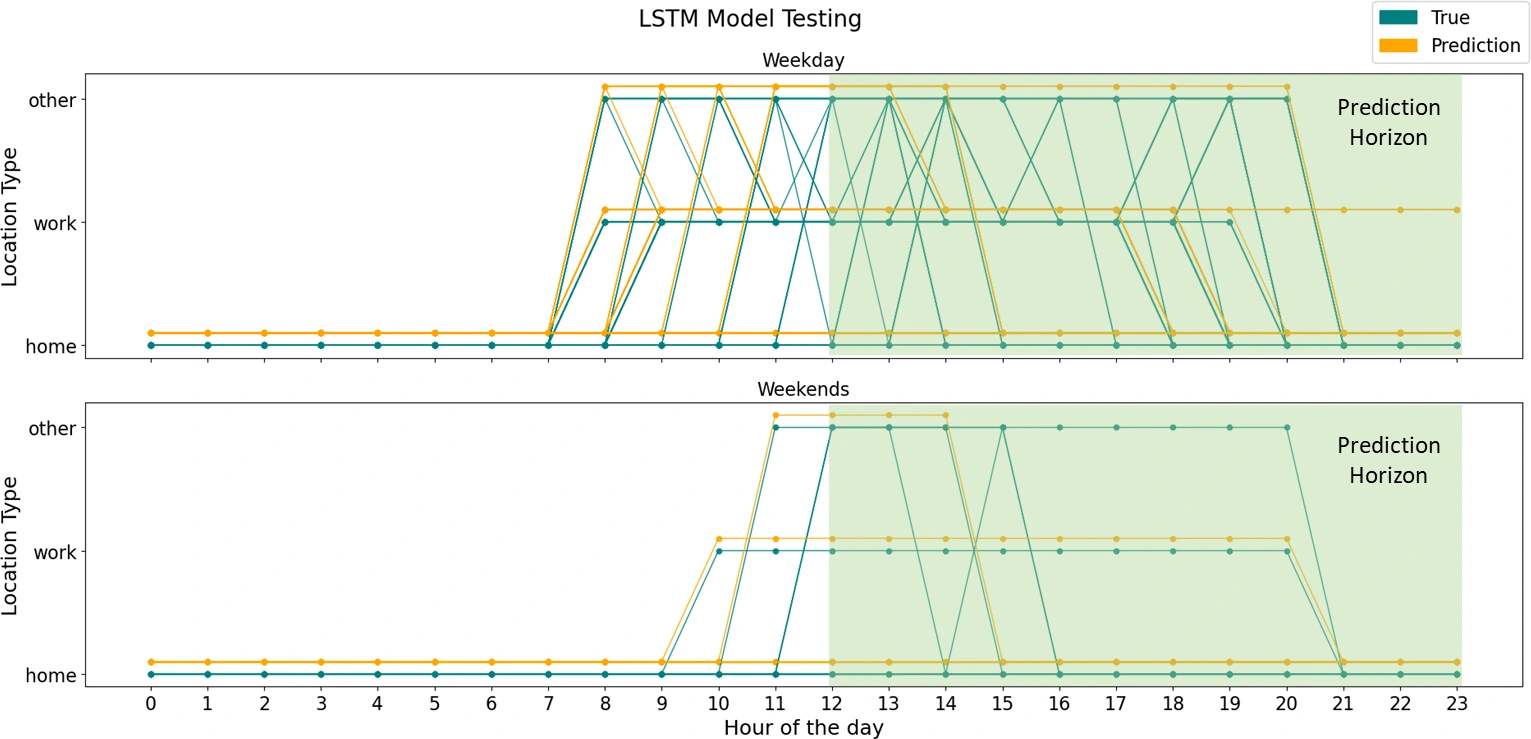
图 15|前 12 小时送进模型后,后 12 小时对上了吗?
无字母子图。上图工作日、下图周末;青色 True 为真实类别,橙色 Prediction 为预测,绿色区域标为 Prediction Horizon,大约覆盖 12–23 时。工作日上午多为家,下午预测与真实在班和其他之间分开;周末的真实序列进入其他地点时,橙色预测仍贴在家。这是 20% 测试数据中的示例,不是全体用户的误差曲线。来源:原论文 Fig. 15。
混淆矩阵把这名用户的测试小时按真实类别和预测类别交叉。九个格子是:
| 真实\预测 | 家 | 工作地 | 其他 | 该行合计 |
|---|---|---|---|---|
| 家 | 1858 | 27 | 26 | 1911 |
| 工作地 | 87 | 729 | 12 | 828 |
| 其他 | 71 | 27 | 67 | 165 |
| 该列合计 | 2016 | 783 | 105 | 2904 |
对角之和是 1858 + 729 + 67 = 2654。2654/2904 = 91.4%,对应正文的总体准确率 91%。家占 1911/2904 = 65.8%。若一个模型永远预测家,在同一批小时上只能对上 65.8%;论文没有把这个常数预测当作对照实验,但格子本身可以这样加。
按行看,真实为家的小时有 1858/1911 = 97.2% 仍被预测为家,工作地是 729/828 = 88.0%,其他只有 67/165 = 40.6%。按列看,预测为家的 2016 小时里 1858 小时为真,精确率 92.2%;工作地是 729/783 = 93.1%;其他是 67/105 = 63.8%。用三类真实小时数 1911、828、165 做加权,平均精确率是 90.8%,对应正文的 around 91% weighted average of precision。正文没有逐类列出这些比率。
图上的绿框只圈出“真实为家且预测为家”的 1858,并标成 TP;橙框把其余格子圈在一起,又标了 FN、FP、TN。工作地对上的 729 也落在橙框里,并不表示这 729 小时被算错。正文另外用测量学的口气说,准确率是预测离真值有多近,精确率是预测彼此有多近。式 (3) 写的却是分类公式:精确率 = TP / (TP + FP),准确率 = (TP + TN) / (TP + TN + FP + FN)。后文的 91% 与对角比例相符,应按分类公式理解,不能按仪器重复性去读。
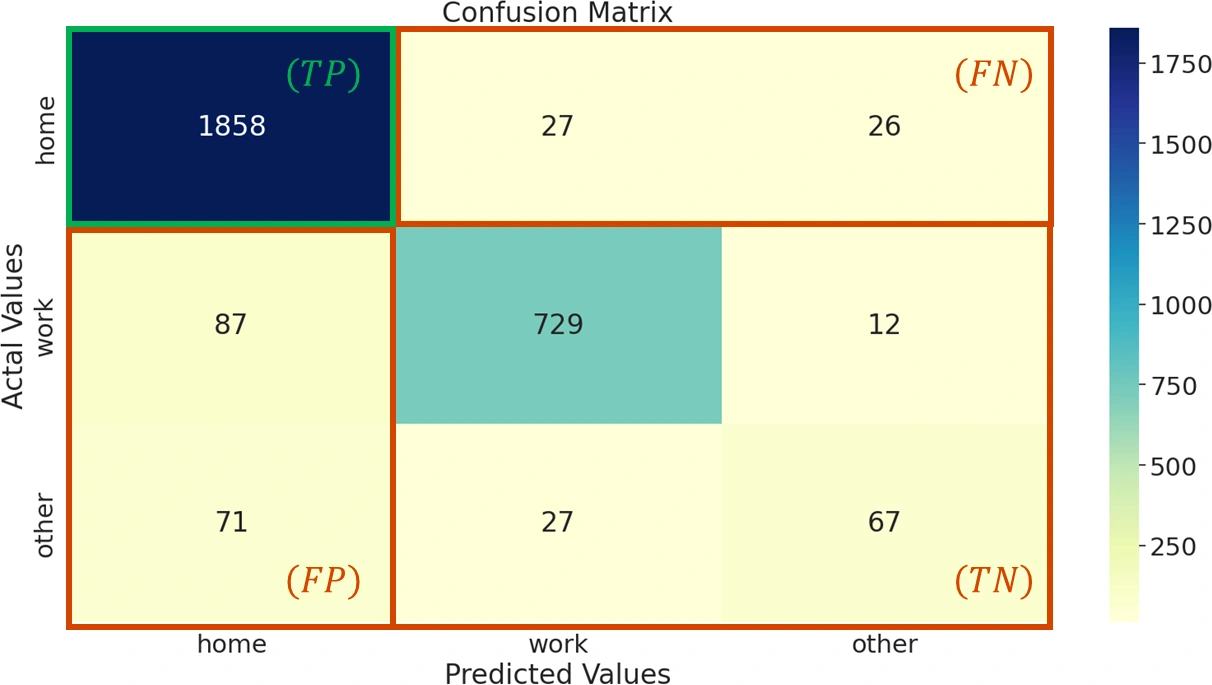
图 16|这名用户的 2904 个测试小时,错在哪一类?
无字母子图。行是真实类别,列是预测类别,颜色越深计数越大,色标大约从 250 到 1750。家—家 1858 最深,工作地—工作地 729 次之,其他—其他只有 67。绿框中的 TP 只指标成家的那一格;橙框是按“是不是家”套上去的,不能把框内的 729 读成错误。来源:原论文 Fig. 16。
85% 是每个人的分数平均,还是所有小时混在一起?
全体测试用户的准确率分布画在一起。图例写工作日均值 85.05%,周末均值 85.26%,与正文一致。质量集中在大约 70% 到 95%,100% 处另有一根很高的工作日柱,升到纵轴所标的 8000 一线。论文说有大量模式被预测到 100% 的准确率和精确率,并把原因归于部分用户的移动非常规律,但没有给出这根柱的频数。纵轴只写 Frequency,没有定义一根柱子是一名用户、一条日序列,还是一小时。周末柱在同一分数段上矮于工作日;假如每人只贡献一个工作日分数和一个周末分数,两组总面积应接近。图上的高矮差别说明不能直接把柱高当成 93,000 里的人数。均值也没有说明是否按每人的测试小时数加权。工作日比周末高 0.21 个百分点,论文没有做显著性检验,不能写成周末和工作日相同,也不能写成周末更难。
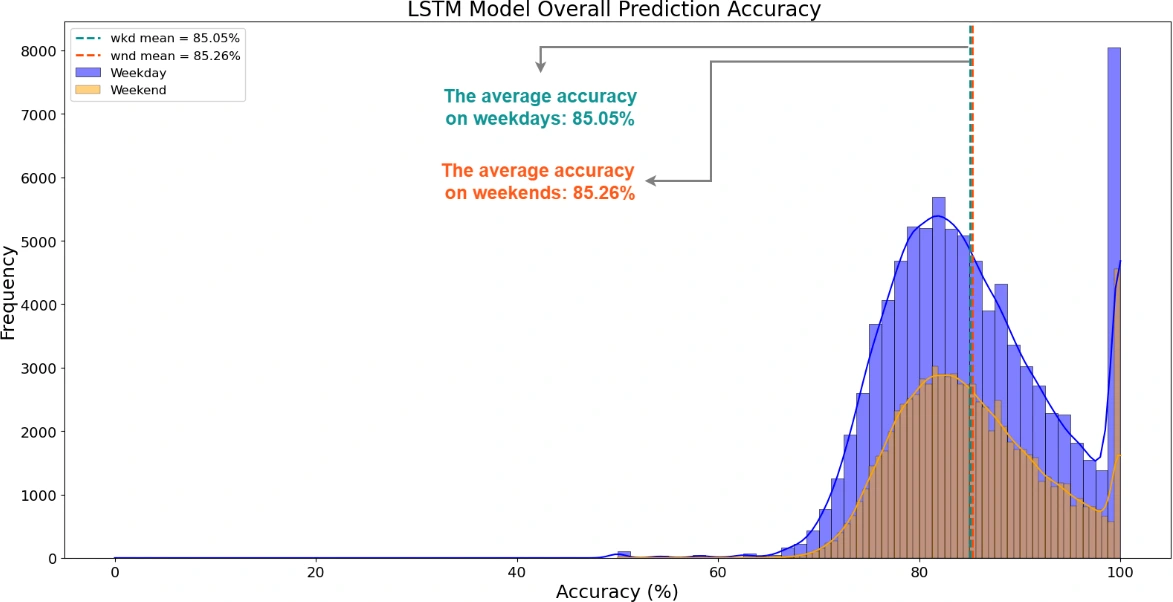
图 17|全体测试的准确率集中在哪一段?
无字母子图。横轴为准确率 0–100%,纵轴为频数,蓝柱和蓝线是工作日,棕柱和橙线是周末。青色虚线标工作日均值 85.05%,橙色虚线标周末均值 85.26%。分布在高分段隆起,并在 100% 处另起一柱;纵轴上限标到 8000,论文没有给出该柱频数,也没有定义频数单位。来源:原论文 Fig. 17。
精确率分布的形状类似。工作日均值 86.03%,周末均值 86.09%,相差 0.06 个百分点。摘要里的 around 85% average accuracy 和 about 86% mean precision,以及结论里的 around 85% 与 close to 86%,就是这两组均值的约数,没有再分工作日和周末。100% 附近同样有高柱。讨论认为,当前结构每一步只看上一步的输出和隐藏状态,所以各步任务难度不变。这是作者对网络结构的判断,不是一张逐步误差图。
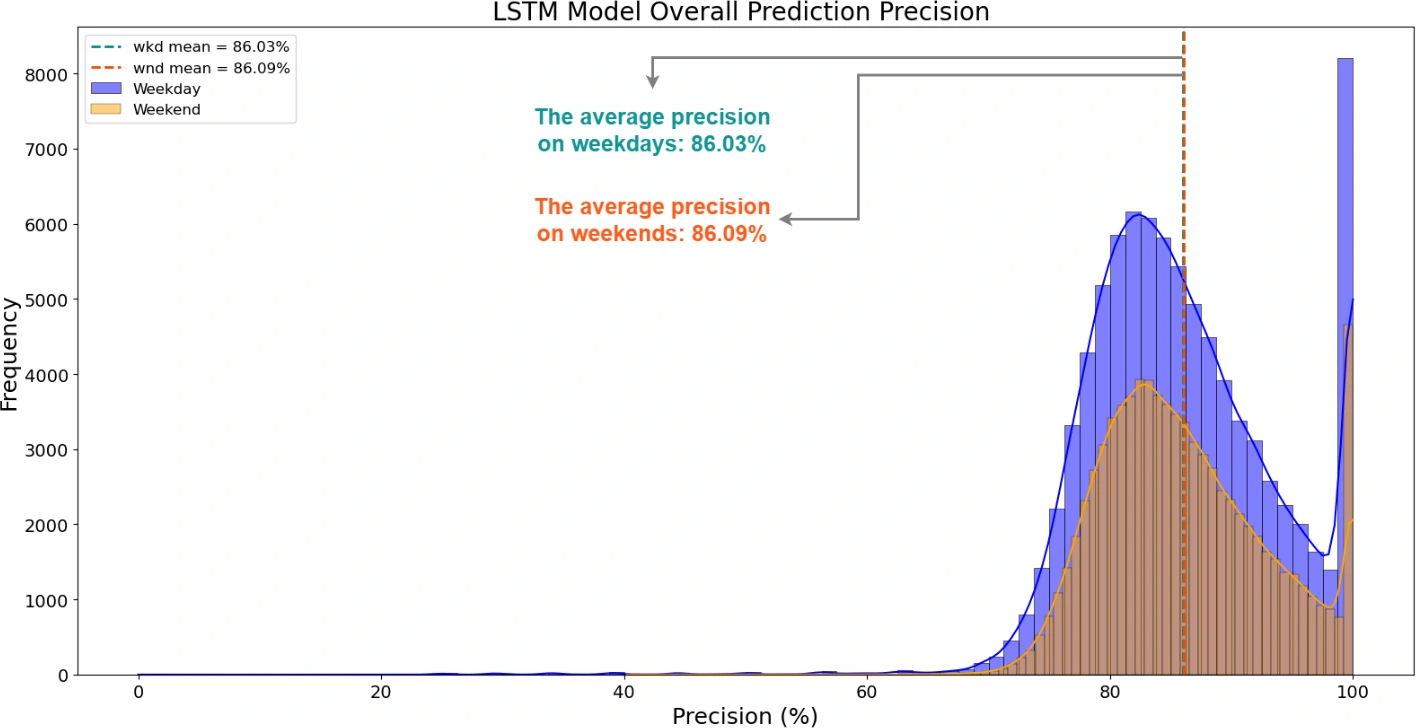
图 18|精确率的分布是否只是准确率换了个名字?
无字母子图。横轴为精确率,纵轴为频数,颜色同样区分工作日与周末。图中标出的均值是工作日 86.03%、周末 86.09%。形状与图 17 相近,并在 100% 处抬高,但精确率使用的是 TP/(TP+FP) 这一类公式,不能与准确率的对角比例互换。频数单位同样没有定义。来源:原论文 Fig. 18。
讨论还指出,其他地点出现少,又带有偶然性,所以其他类别的错分比家和班多。图 16 与这句话一致:其他地点的行合计只有 165/2904。模型没有和“预测下一小时等于当前小时”或者“永远预测家”做过全体比较。家已经占典型用户测试小时的 65.8%,一个较弱的重复规则也可能拿到不低的分数。100% 那一根柱,既可能是模型学会了转移,也可能是有些人几乎全天停在同一类地点。
引用的占用率研究说明,更贴近移动数据的在室日程曾经改变过冷热负荷,最高到 60% 那一档来自 Wu 等(2020)的模拟。本文的模型若要走到那一步,还得把 H、W、O 还原到楼,再放进能耗模型。排序后的工作地和其他地点名单被说成可以做这种还原,本文没有报告还原后的距离误差。
这些结果还不能说成节电或找对了楼
论文自己列出三条限制。第一,通勤和很短的停留在停留点检测时被排除,模型看不见路上的点。第二,每人只有一个家,工作地和其他地点可以有多个。第三,家和班用的是同一套钟点,夜班和白天待在家里的日程没有单独处理。
除此之外,分数还有几道边界。分析单位先是设备,再被当成用户;手机并不保证一直在本人身边。93,000 来自一个未公布邮政编码的空间连接,排除了多少设备没有写出。预测的是三类字母,不是质心坐标,也没有对照模型。80% 与 20% 的切法未说明,训练是超前一步,测试才是后 12 小时。准确率分布的纵轴单位未定义,100% 的人数未给出。式 (3) 的文字解释和公式不是同一种精确率。图 7 的簇个数在正文和图注之间不一致,图 13 的图注把三个月写成一个月。本文没有城市能耗模拟,引言里的 15%、21%、40%、50%、60% 都属于被引用的其他研究。
一句话总结
前 12 小时的家、班、其他,可以把后 12 小时的类别序列预测到工作日 85.05%、周末 85.26% 的平均准确率;这主要说明许多人的三类日程很规律,还不能直接说出一座楼的下午有多少人,本文也没有算出因此能省多少电。
核心来源
- DOI:10.1007/s12273-023-1043-z,正式题名、作者与 Building Simulation 卷期。本文图像与数值均来自该正式版正文 Fig. 1–18 和表 1;正文没有引用补充材料。
- SciOpen 文章页,卷期为 2024 年第 17 卷第 1 期,并记录在线发表日 2023 年 8 月 14 日。
- SyracuseCoE 对学生 Yapan Liu 的介绍,以及雪城大学学位论文库记录。
- 雪城大学对 Bing Dong 与 BEST 实验室的介绍;SyracuseCoE 的人员行为数据库新闻称他为机械工程教授。
作者介绍
- Yapan Liu:论文署名为雪城大学机械与航空航天工程系,负责概念、方法、调查、形式分析、初稿、修改和可视化。雪城大学卓越中心的介绍称,他自 2019 年起在 Bing Dong 课题组做基于大数据的城市尺度人类移动、人员行为建模和建筑—电网控制;机械学士在中国取得,2016 年到雪城大学读硕士,曾在当地一家初创公司工作后再回校读博士。学位论文库记录其博士论文于 2024 年 5 月 12 日获学位,导师为 Bing Dong,题目是 Urban Scale Vehicle-To-Building-To-Grid Integration Leveraging Human Mobility。
- Bing Dong:通讯作者,署名机构相同,邮箱为 bidong@syr.edu。论文中的贡献是概念、方法、调查、资源、审阅、基金和指导,并声明他是 Building Simulation 的副主编。雪城大学的介绍把他和所在的 BEST 实验室放在 SyracuseCoE,研究方向包括建筑控制与人员行为。本文由美国国家科学基金会项目 1949372 和 2125775 资助,部分计算资源来自雪城大学。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
夜班会先被这套钟点写错。9:00–18:00 才叫工作地,20:00 到次日 6:00 且停得够久就倾向叫家。医院夜班若把白天用来睡觉,工作地点可能被标成其他,白天的家也可能挤不进工作标签。图 17 里偏低的那一尾有多少来自这种日程,本文无法分开。若改用每个人自己的高概率时段重新贴标签,再看左尾是否移动,才能知道 85% 描述的是白天通勤,还是也覆盖倒班。
100% 那根柱子也应该先和一条笨规则比。某人若几乎每小时都在家,永远预测家就会得到接近 100% 的准确率;某人若只在固定钟点切换,预测下一小时等于当前小时也会很强。图 16 里永远预测家已经能对上 1911/2904。在把模型用于需求响应之前,需要按人报告 LSTM 相对这两条规则多对了多少小时。多出来的部分才是 12 小时结构带来的,而不是日程本身几乎不变。
字母对了,楼仍可能错。作者已经按出现概率给工作地和其他地点排序,并认为以后能把 H、W、O 译回质心。本文的 85% 没有做这一步。一个直接的后续度量是:预测字母所对应的质心,离该小时真实停留有多远,并以他们已经使用的 250 米作为命中半径。类别准确率很高、250 米命中率却低,说明模型更适合描述在室类型,不适合直接告诉控制系统人进了哪一栋楼。