只留下几次定位,怎样判断一个人会在哪里出现?
论文名片|Moshe Lichman、Padhraic Smyth,Modeling Human Location Data with Mixtures of Kernel Densities,KDD ’14,纽约,2014年8月24—27日,35—44页。DOI:10.1145/2623330.2623681,作者机构公开全文。
一个账号只在两三个地方发过带定位的消息。新消息出现在另一个街区,可能是正常探索,也可能来自另一个人。若模型只相信已有坐标,稍远一点就会被判得异常;若只相信全城热门地点,又会失去个人特征。
这篇论文提出把个人、局部区域与总体的位置密度按权重相加。它在南加州Twitter和Gowalla数据上提高了未来位置记录的密度预测分数,也改善了部分模拟身份切换检测。但它估计的是事件在哪里出现的空间分布,不是按时间顺序推断下一次旅程。
先说结论
- 自适应带宽核密度能适应城市与乡村的点密度差异,但单独用于稀疏个人记录仍可能给新位置极低密度。
- 三层混合核密度在两套数据的测试对数密度指标中都优于对照。总体层给个人历史未覆盖的位置保留支持,个人层则保持个性。
- 模拟盗号实验中,看到10次事件后,排名前20个账号中的阳性精确率为0.816;它不是识别全部50个模拟盗号账号的召回率。
- 仅看到一次事件时,普通高斯模型在一般场景更好;Gowalla的模拟身份切换任务也没有显示模型间显著差别,方法并非处处领先。
地图上的点,究竟代表什么?
Twitter原始收集覆盖2013年7—8月南加州约23万名用户、400多万条公开推文。实验仅用周一至周五的数据,同小时、相距50米以内的重复或突发推文合成一个有效事件。Gowalla使用2010年1—10月南加州工作日签到,共145,558次事件、7,653名用户。
这些点是发帖或签到,不是每个人的全部停留。Twitter在两个月里有60%的用户记录不超过5条,稀疏性使个人模型很容易过拟合。
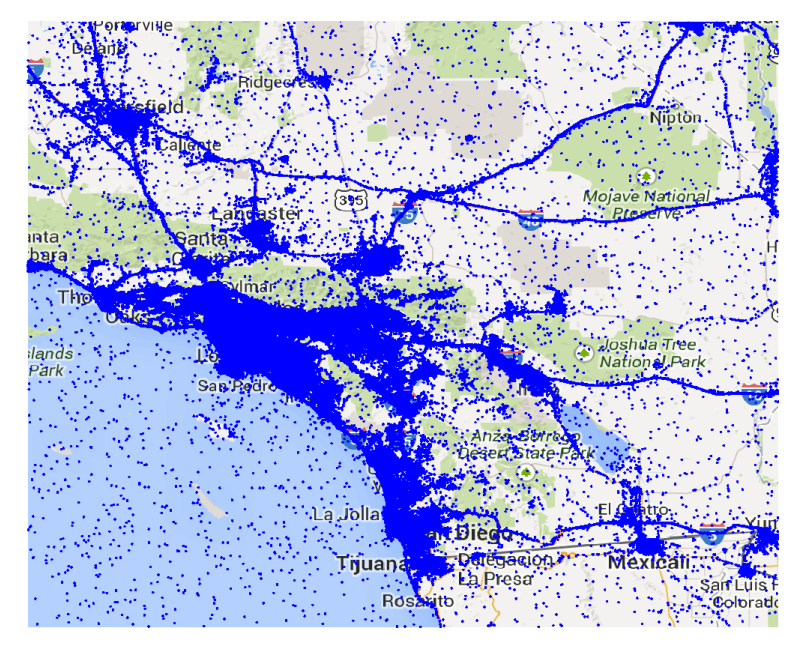
图 1|Twitter定位为何既有结构,也有噪声?
无子图。蓝点是南加州带定位推文,城市与道路附近密集,海面和稀疏地区也出现散点。作者将后者大量归于定位噪声,但没有逐点验证其真实位置。来源:原论文 Fig. 1。
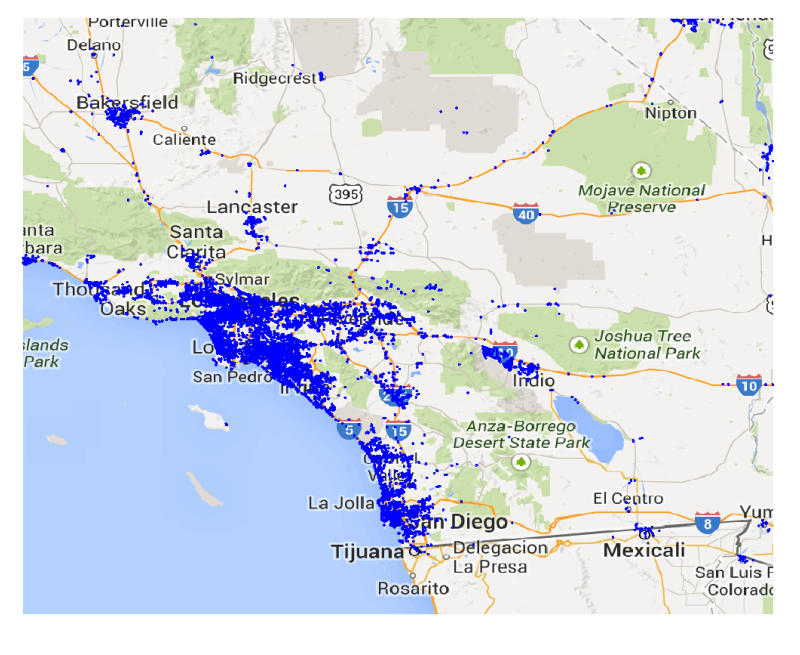
图 2|另一种平台记录是否覆盖同样的活动?
无子图。蓝点为南加州Gowalla签到,更集中于有人活动和提供签到的地点;不能把两张地图的点数差异直接理解成人口差异。来源:原论文 Fig. 2。
模型学习每名用户的二维空间密度fᵢ(x,y)。某区域的概率要把密度在该区域上积分;一个坐标处的密度值不等于概率,因此密度可以大于1、对数密度可以为正。时间只用于排序、划分训练测试及在线更新,模型没有显式学习星期或昼夜规律。
用两个椭圆圈住家和单位,为什么不够?
高斯混合模型(Gaussian mixture model,GMM)可用多个成分表示不同活动中心,但空间结构未必是几个椭圆。道路狭长、海岸有边界、沙漠少活动;稀疏数据又难以决定每个人需要几个成分。
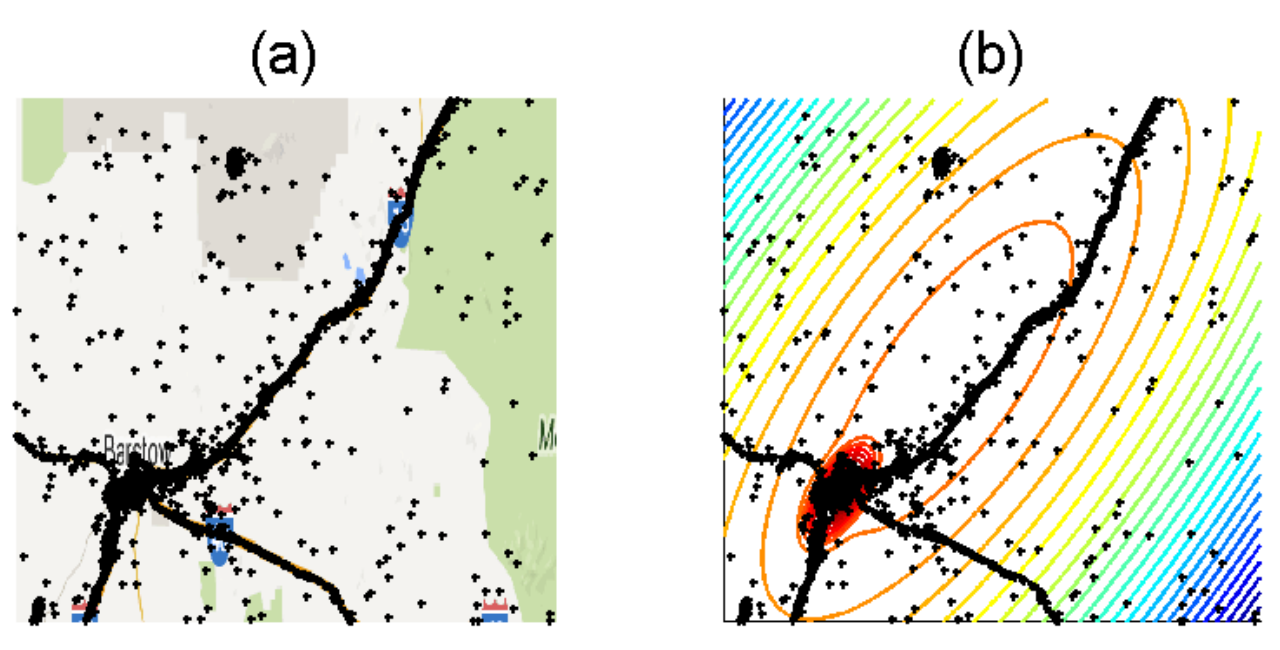
图 3|简单高斯混合会把密度放错在哪里?
(a)Barstow附近的真实记录点,沿道路、城镇与基地集中。(b)两个高斯成分的密度等高线,平滑椭圆覆盖不少少有记录的沙漠,也没贴合道路。颜色表示等高线层次,图中没有给统一数值色标。来源:原论文 Fig. 3。
核密度估计(kernel density estimation,KDE)在每个已有坐标周围放一个平滑核,再相加取平均。关键是带宽:太窄只记住训练点,太宽则抹掉局部结构。
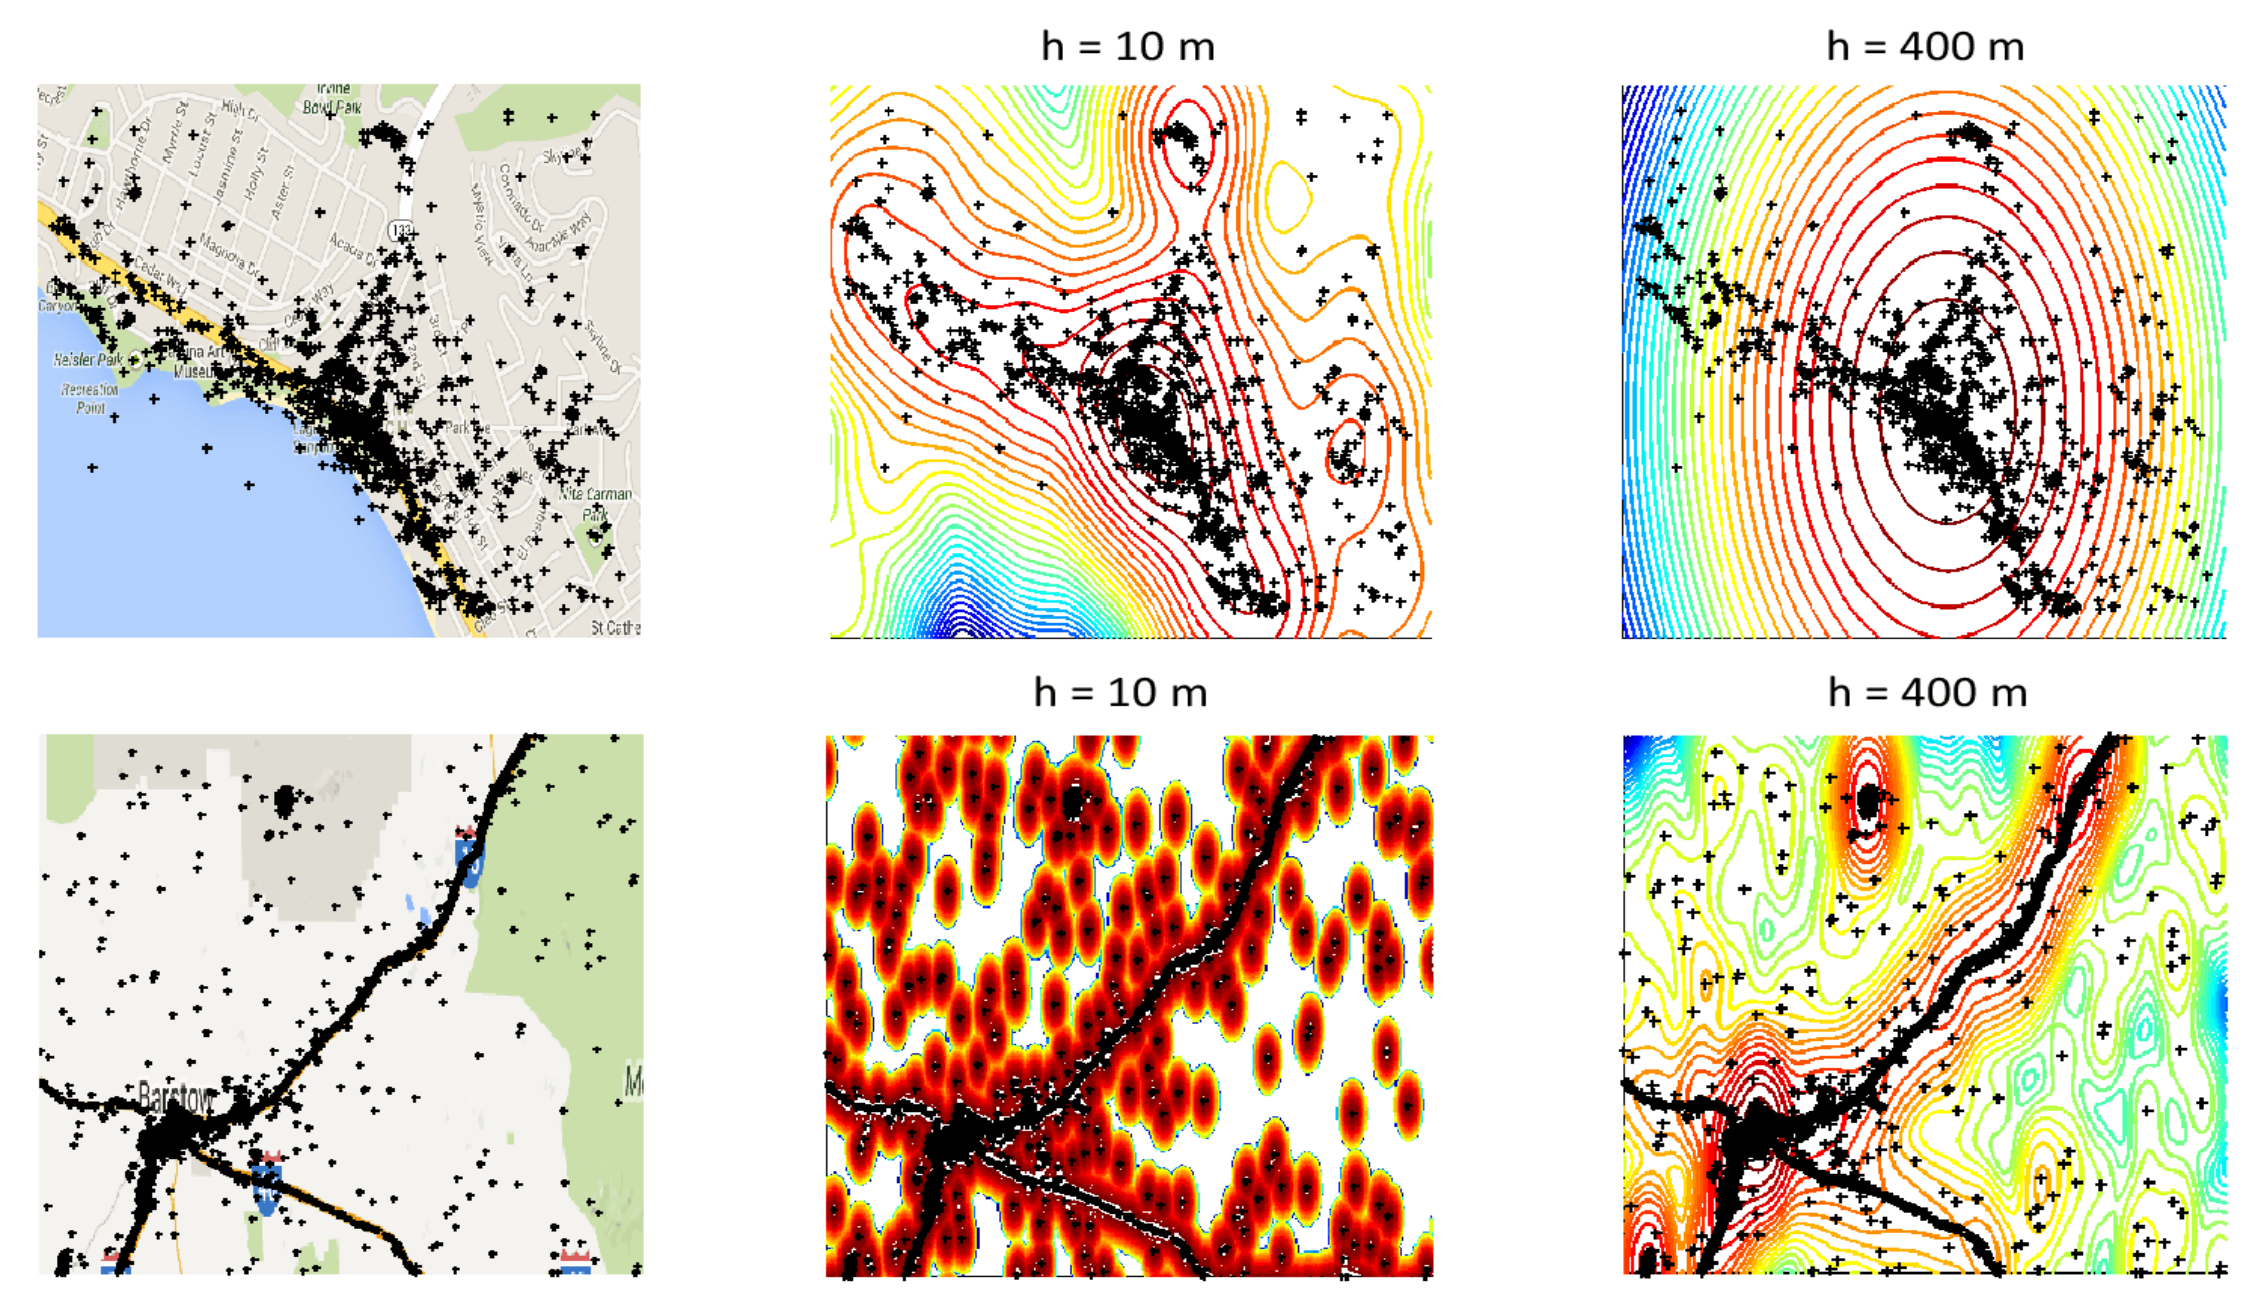
图 4|一个带宽能同时适合密集城市与稀疏区域吗?
原图无字母子图。上排为Laguna Beach,下排为Barstow附近;每排左列是观测点,中列按原图标注带宽10米,右列400米。小带宽保留密集区细节,却在稀疏区产生大量孤峰;大带宽对稀疏区较平滑,却把密集区过度抹平。所有六幅属于同一完整图。来源:原论文 Fig. 4。
自适应KDE用每个训练点到第k近邻的距离决定其局部带宽;稠密处窄、稀疏处宽。表1使用随机抽取的10万训练事件和10万留出事件,最好的固定带宽平均对数密度为0.139,自适应k=5为1.275;k=10为1.196,也说明k并非越大越好。
原文公式把h放在高斯协方差对角线上,图示又以米描述带宽。理解时应保留其实际算法与验证比较,不从这个记号混用自行推导另一套长度换算。
个人点太少,为什么要借用他人的密度?
三层模型的密度为:个人权重α₁×个人KDE+区域权重α₂×区域KDE+总体权重α₃×总体KDE。权重非负且相加为1,各层都用k=5的自适应核。
区域不是根据行政边界或真实住宅划分:研究把南加州分成9×9共81个等面积格子,把个人多数事件所在格子作为其所属区域。一个点可以同时参加个人、区域与总体三层估计。三层分别表示数据尺度,不是三种互不重叠的活动地点。
各层密度先在训练集上确定,再用不重叠验证集通过EM算法学习混合权重。权重在同一数据集内对所有用户共用,没有给每个人单独学习一组。Twitter三层权重为0.85、0.12、0.03,Gowalla为0.5、0.3、0.2;这不是从用户真实生活中测出的三类出行比例。
预测未来月份,分数改善了多少?
Twitter用7月训练,8月测试,测试随机选取7月至少2条记录的2,000名用户;Gowalla用1—6月训练,7—10月测试,随机选取此前至少2条记录的1,000名用户。训练数据中另随机留出约37,000条Twitter、25,000条Gowalla事件作验证。
表2、3既按用户等权汇总,也按事件汇总;后者使记录多的用户贡献更大。对数密度越高,表示模型给未见事件所在位置更高密度,不是“命中位置的百分比”。
| 测试集 | 模型 | 用户等权平均对数密度 | 事件平均对数密度 |
|---|---|---|---|
| 单高斯 | −0.586 | −0.242 | |
| 四成分GMM | −0.474 | −0.015 | |
| 总体KDE | 2.014 | 0.784 | |
| 三层混合KDE | 4.279 | 5.293 | |
| Gowalla | 单高斯 | −1.513 | −1.133 |
| Gowalla | 四成分GMM | −1.522 | −0.958 |
| Gowalla | 总体KDE | 3.388 | 4.021 |
| Gowalla | 三层混合KDE | 6.599 | 6.568 |
混合方法在原表的均值、中位数各项均领先。但单人自适应KDE并不总好:Twitter用户均值为−7.154,一些汇总项还发生数值下溢,不能简单归纳为“自适应KDE必定胜过高斯”。混合人口信息是避免个人稀疏模型失效的关键部分。
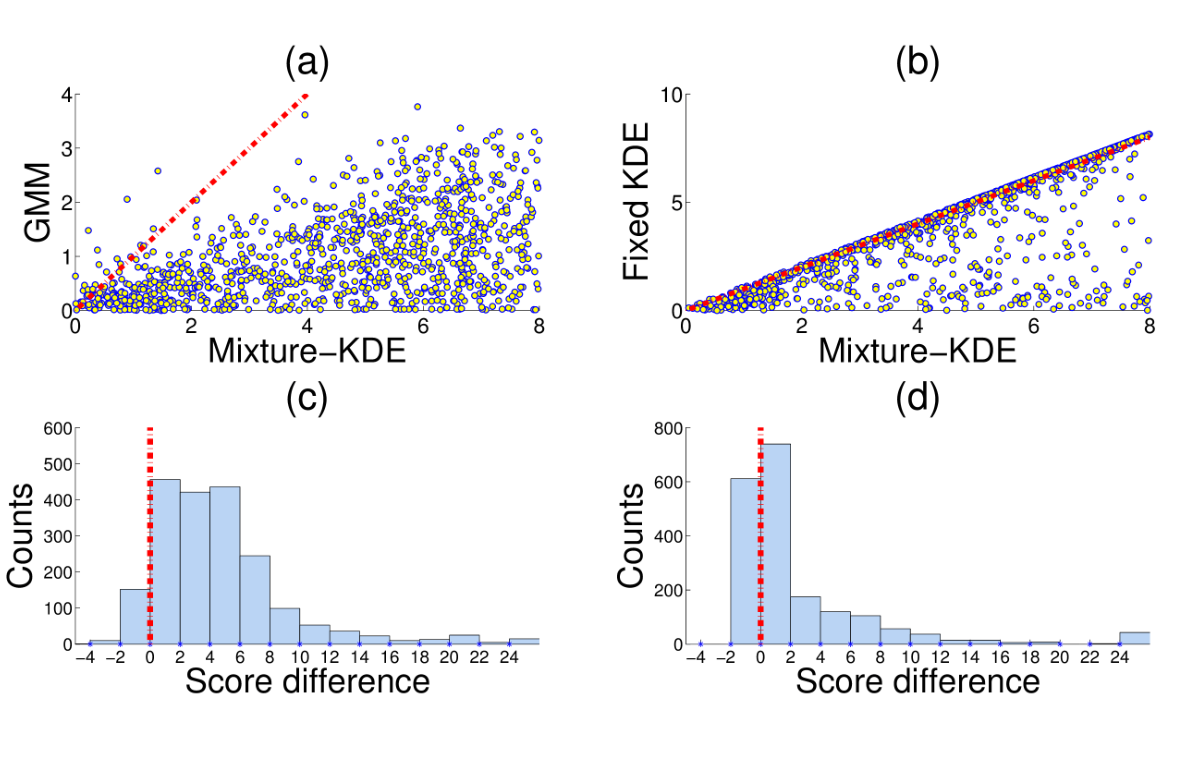
图 5|Twitter的改善是否只由少数用户贡献?
(a)横轴混合KDE、纵轴四成分GMM的用户测试分数;(b)横轴相同、纵轴固定带宽KDE,红线为等分参照,多数点在其下侧。(c)混合KDE减GMM的事件分差直方图;(d)混合KDE减固定KDE的分差,纵轴均为计数,红线标零。分差多数为正,仍有负值,不能称每条记录都改善。来源:原论文 Fig. 5。
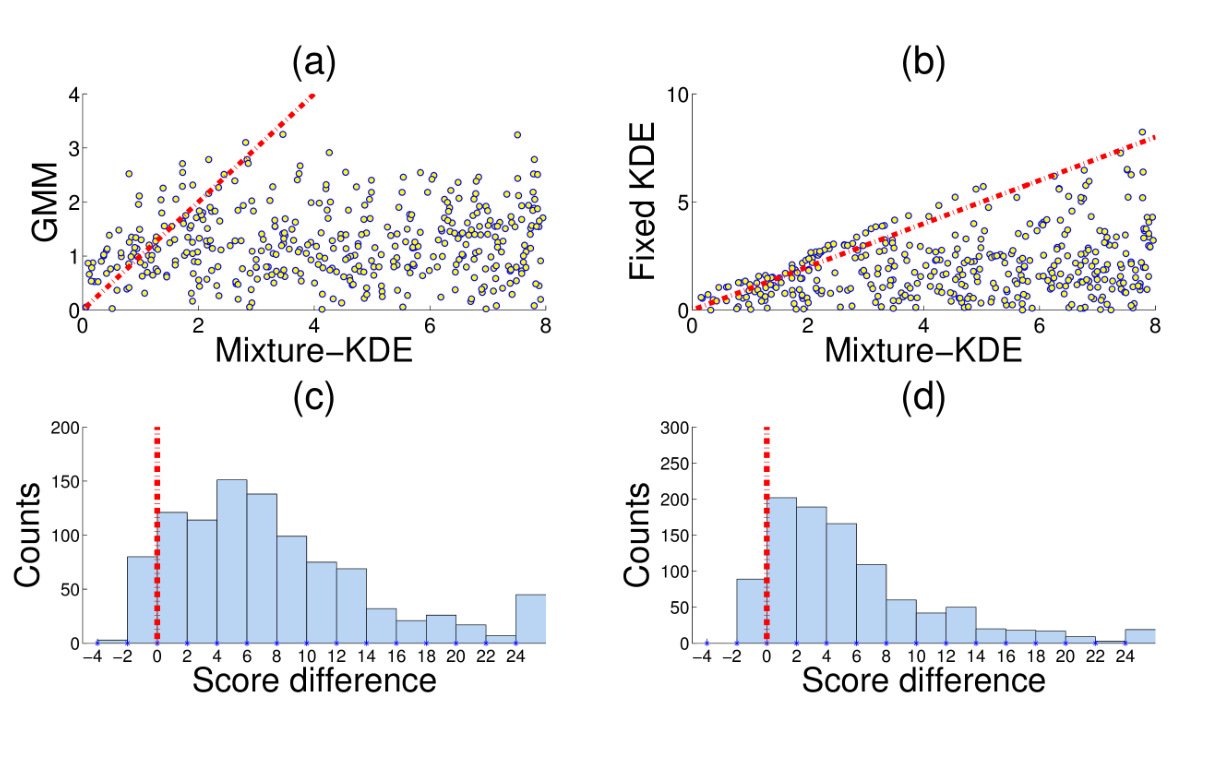
图 6|Gowalla是否也出现相近模式?
(a)混合KDE与四成分GMM的用户分数散点;(b)混合KDE与固定KDE散点,横轴均为混合方法,红线为等分参照。(c)对GMM的事件分差直方图,(d)对固定KDE的事件分差;红零线右侧较多,部分点仍例外。两套数据的整体收益不等于对所有用户和事件统一收益。来源:原论文 Fig. 6。
检出模拟盗号,0.816究竟是什么意思?
实验没有真实盗号标签,而是把50名用户8月的事件替换为另一个人的事件,再加入950名正常用户。训练仍用7月,候选用户至少2条历史记录,正常测试及替换来源需至少10条8月事件;重复生成50套测试集。
每个账号按新事件的平均负对数密度得到惊异度(surprise index),分数越高越像偏离个人历史。按此排序,检查前20个账号有多少属于模拟身份切换:这就是precision@20,分母是20,不是50个异常,也不是全部1,000个账号。
| 场景与模型 | 观察1次事件 | 观察5次 | 观察10次 |
|---|---|---|---|
| 一般场景:高斯 | 0.612 | 0.470 | 0.325 |
| 一般场景:固定KDE | 0.500 | 0.500 | 0.460 |
| 一般场景:混合KDE | 0.531 | 0.747 | 0.816 |
| 冷启动:高斯 | 0.379 | 0.341 | 0.240 |
| 冷启动:固定KDE | 0.330 | 0.370 | 0.320 |
| 冷启动:混合KDE | 0.459 | 0.589 | 0.644 |
冷启动进一步把历史记录限制为2—5条。论文表4、5还比较两种GMM和个人自适应KDE,混合方法在除一般场景1次事件之外的设置中领先,报告Wilcoxon符号秩检验p<0.02。一般场景只看到一次新事件时,高斯的0.612高于混合方法0.531。
这个任务重新按检测精确率调参,混合权重为0.9、0.08、0.02,不能把前面的密度预测权重照搬来解释结果。随着事件增多,混合方法更好;部分其他方法反而因正常用户偶尔远离历史地点而误报。固定KDE从1次到5次在一般场景持平、冷启动还提高,因此原文“其他方法都随事件数下降”的概括也不是逐格成立。
Gowalla在这项任务没有显示方法间显著差异;作者推测其用户较少、共享签到地点较多。这是解释假说,没有被独立的因果检验确认。整个模拟将用户事件整批替换,也不能代表所有真实账号攻击。
新位置不断到来,模型能否更新?
在线版本先给当前事件评分,再将它加入训练数据,用更新后的密度预测后一个事件。表6中,Twitter用户平均分由批量4.279升至4.892,Gowalla由6.599升至6.987;事件平均分分别由5.293升至5.788、6.568升至7.432。这是更丰富历史信息下的顺序预测,不是继续使用完全固定训练集的同条件比较。
原文表2的Twitter用户中位数4.312,表6批量行写4.321,两处略不一致,因此这里不合并使用这个中位数。
计算上,朴素KDE要存储训练点并累计其贡献。作者用k-d树加速,在当时8核2.4GHz Xeon、48GB内存环境中,以100万训练事件估计一个新事件密度平均约8毫秒。这是具体环境的性能报告,不保证所有设备、所有更新规模都如此。
哪些边界需要留在模型旁边?
首先,密度针对平台事件,不直接代表人的完整活动范围。其次,测试区域与训练区域同属南加州,不能据此保证跨地区泛化。第三,模型没有显式时间规律,不能把热力分布解释成几点会去哪里。最后,位置信息能够辅助异常识别,也会形成个人活动画像;论文的检测实验没有提供隐私保护保证。
一句话总结
稀疏个人定位不应只向自己求答案:混合个人、区域与总体的核密度能更稳健地给未来位置评分,但分布预测、模拟异常检测与真实身份确认是三个不同层次的任务。
核心来源
作者介绍
- Moshe Lichman:论文署名加利福尼亚大学尔湾分校计算机科学系。
- Padhraic Smyth:论文署名同为加利福尼亚大学尔湾分校计算机科学系。本文只采用论文当时身份。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
将同一组混合权重用于所有用户简化了训练,但也留下一个可检验的问题:历史只有两条记录的人与历史已有上千条记录的人,是否应该得到相同的总体层权重?可以在独立验证集上比较按历史数量分组的权重,同时要求少量记录用户不被总体热点淹没。
异常提醒还应允许正常行为改变。旅行、搬家或换工作都会造成历史密度低的新事件;若只追求高惊异度,就可能把生活变化当作攻击。让用户可确认正常变化,并观察确认后的在线更新能否减少后续误报,比单独优化模拟身份切换的排名更接近实际使用需要。