附近的亲友,是因为让人更喜欢这条街,才让人不搬家吗?
论文名片|Brian Joseph Gillespie,Family and Friends Living Nearby, Neighborhood Satisfaction, and Residential Mobility,City & Community,2022,21(2):140–155。DOI:10.1177/15356841211060838。格罗宁根大学机构库记为 2022 年 6 月发表。本文依据这一期刊版解读。这是一项观察性研究:用洛杉矶县两波追踪调查做加权 logistic 回归,不是把人随机分到有没有亲友的实验。
设想一个人住在洛杉矶县的某条街上。几个街区之内没有亲属,倒有一两位朋友。这条街他并不喜欢。直觉常把两件事合成一件:附近有人,人就会更喜欢这里,于是留下。短距离搬家最常见的理由确实是住房和地段,但社会关系也会进入去留。问题是,附近的亲属和朋友是同一股拉力,还是要拆开看;他们是改变了人对邻里的评价,还是在评价已经很差时仍把人留住。
方向先说清楚。在这批数据里,一个附近亲属都没有,与跨普查区搬家联系在一起;朋友的直接关联在同时考虑亲属之后并不成立。朋友变得重要,是在亲属很少的时候,以及邻里很不满意的时候。邻里满意本身与较少搬家有关,但这条关联并没有经过亲友数量转一手。下面的优势比都是相关,参照是同一模型里的优势比 1。
先说结论
- 分析样本 1,128 人。加权后,61.9% 在两波之间换了普查区;正文把这个比例说成约 62%。68.7% 的人没有附近亲属,28.5% 没有附近朋友。
- 亲属档位从 0 到 3 逐档增加,并不能支持“人越少越搬家”。改成“一个都没有”之后,搬家优势比是 1.7,参照是至少有一些附近亲属。朋友在控制亲属后没有同样的直接关系。
- 两者要一起看。亲属与朋友的交互优势比是 1.6。论文的读法是:附近亲属越少,朋友越与较低的搬家优势联系在一起。
- 亲友没有充当邻里满意与搬家之间那条可观的间接路径。朋友会改变满意和搬家的斜率:满意处于最低档时,朋友越多,搬家概率的平均边际效应越偏负。亲属的这项调节不显著。
- 同一批控制下,自有住房的搬家优势比约为 0.35,参照非自有住房。年龄每大 1 岁约为 0.96,在现址多住 1 年约为 0.91。
这里的流动,是换没换普查区
居住流动(residential mobility)在这里不是每天的出行,也不是传染病传播。它是人的住址离开了原来的邻里。操作定义更窄:主要受访者在第一波和第二波之间是否换了人口普查区(Census tract)。同一普查区里换公寓、甚至换到街区另一头,都不算这次分析里的搬家者。论文另做了敏感性分析,区内搬家得不到同样的结果,所以结论贴着“跨普查区”这一刀,不能说成任何一次换地址。
数据来自洛杉矶家庭与邻里调查(Los Angeles Family and Neighborhood Survey,LAFANS)。洛杉矶县约 4,083 平方英里,含 88 个独立市和不少未设建制的地区。抽样先在县里抽 65 个普查区,区按 1997 年贫困率分成非贫困、贫困和非常贫困三层,并超抽贫困人口以及家中有孩子的住户。第一波在 2000 年 4 月到 2002 年 1 月访问了 3,085 户、2,620 名主要受访者,对象是当时住在县里、会说英语或西班牙语、未住机构的成年人。第二波在 2006 年 8 月到 2008 年 12 月回访,原始样本中 1,177 人接受了访问。再去掉缺失的 49 人,分析样本是 1,128。两波间隔大约六年到八年,具体年数随每个人的访问日期变化。
搬出洛杉矶县的人不在这批分析里。他们第二波改为电话访问,社区层面的信息更少,而且调查提供的追踪权重只覆盖仍住在县内的人。论文没有单列搬出县的人数。同一普查区里换了住址的人,按跨邻里的定义也不算搬家者。
留下参加第二波的人并不是第一波的随机子集。有工作、女性和教育、收入较高的人更可能两波都在;第一波报告单身的人更可能缺席。模型使用追踪权重,用来处理波次之间的失访,以及按贫困和家中有孩子所做的超抽。因此下面的百分比和优势比是加权结果,不是 1,128 个未加权人数的简单比例,也不能当成全县每一个成年人的搬家概率。
结果变量在第二波回顾,自变量都在第一波测量。两波只比较起点普查区和终点普查区,中间搬走过几次、有没有搬走又搬回,论文没有报告。
附近的人,是几个街区,不是整座城
访问员先说明:接下来问的是住在这个邻里、但没有和你同住的亲属或朋友。为了让每个人口中的邻里不要差得太远,受访者被要求把邻里想成自己住的街区或街道,再加上每个方向的若干街区。题目是:有多少亲属或姻亲住在你的邻里?选项为没有、有一些、很多、大多数,记成 0 到 3。朋友用同一句话、同一组选项再问一次。
这把尺子和搬家那把尺子并不重合。亲友“附近”是几个街区;搬家与否是普查区边界。人觉得的邻里也可以和普查区错位。论文把这当成测量限制,而不是已经解决的问题。
因为“一个都没有”和“至少有一些”在性质上不同,模型除了 0–3 档,还使用了二分变量:有没有附近亲属,有没有附近朋友。
亲属分布很偏。全体加权均值为 0.4(标准差 0.7),偏度 1.6,峰度 5.6。68.7% 的人是 0。朋友均值 0.9(标准差 0.8),偏度 0.8,峰度 3.7,没有附近朋友的人占 28.5%。所以“平均不到 1 档”主要是因为大量的 0,不是因为每个人都只有零点几个朋友。
表 1 的百分比要分清分母。全体列是加权样本中的占比。未搬家、搬家两列把这个占比拆开,两列相加回到全体列。没有附近亲属的 68.7%,被写成未搬家 42.3% 和搬家 26.4%。这两列是全体样本里的份额,不是“搬家者当中有多少人没有亲属”。
这组拆分不能再除回去造组内比率。搬家占加权样本的 61.9%,未搬家就是 38.1%。自有住房的未搬家单元格却是 40.2%,已经大于 38.1%。就业的未搬家单元格是 40.3%,也大于 38.1%。因此后文不把这些单元格换成“业主里有百分之几搬走了”。组间差别改看均值,以及以全体 1,128 人为分析单位的优势比。
均值的分组是清楚的。年龄全体 48.6 岁(标准差 15.6),范围 21–92 岁;未搬家者 52.3 岁(16.5),搬家者 42.4 岁(11.7)。在现址住了多久,全体 7.2 年(5.2),未搬家 8.7 年(4.9),搬家 4.7 年(4.1),这项最长记到 15 年以上。邻里满意从 1(非常不满意)到 5(非常满意),全体 4.0(1.0),未搬家 4.1(0.9),搬家 3.8(1.0)。朋友档位未搬家 1.0(0.8),搬家 0.8(0.7)。亲属档位两边都在 0.4 左右,搬家者的标准差是 0.8,未搬家者是 0.7。
其他全体口径:女性 49.6%;白人 36.7%,黑人 6.1%,西班牙裔或拉美裔 37.5%,亚裔 15.4%,其他 4.4%。已婚 52.8%,同居 6.9%,既非已婚也非同居 40.3%。孩子数均值 1.7(1.6)。在学 10.7%,有工作 69.4%。教育按五档编码,均值 2.8(1.3)。家庭收入取对数后均值 8.6(4.0);论文没有说明对数的底如何处理 0 收入,这里不把 8.6 换算成美元。自评健康 1–5 档,均值 3.6(1.1)。自有住房 49.8%。
街区变量来自与两波链接的洛杉矶邻里服务与特征数据,普查区仍用 1990 年边界。1997 年贫困分层里,非常贫困占加权样本 8.3%,贫困 33.3%,非贫困 58.4%。人口密度是人口除以平方英里再除以 1,000,全体均值 13.2(9.7),也就是约每平方英里 13,200 人。族群多样度按 1 −(白人、黑人、拉美裔、亚太裔、其他五组比例的平方和)计算,均值 0.50(0.2)。住房价格中位数以万美元为单位时,表中均值 24.0(19);回归里进入的是取对数之后的版本。居住稳定是 2000 年仍住在 1995 年同一住房的人口百分比,均值 50.4(9.3)。
还没放进整套控制之前,亲属档位和朋友档位正相关,r = .23(p < .001)。朋友档位和邻里满意正相关,r = .13(p < .001)。亲属档位和邻里满意是负的,r = −.07(p < .05):附近亲属略多的人,满意略低,而不是更高。亲属档位单独预测搬家的优势比是 1.01(p = .49)。朋友档位单独预测搬家的优势比是 0.77(p < .05),参照是优势比 1,也就是朋友每高 1 档、其他什么都不控制时的搬家优势。
没有亲属,和亲属少一档,不是同一次比较
logistic 回归报告的是搬家对不搬家的优势比,样本仍是加权后的 1,128 人。优势比 1 是参照。它不是搬家概率本身:1.7 并不表示搬家概率变成原来的 1.7 倍。
模型同时放入个人、家庭和街区变量:年龄、性别、族群、婚姻或同居、孩子数、是否在学、是否就业、教育、对数收入、自评健康、是否自有住房、在现址的年数、邻里满意、街区贫困层、人口密度、族群多样度、对数住房价格、街区居住稳定比例。多元模型没有严重的多重共线性。正文列出的相关矩阵里,最强的一对是教育与街区住房价格中位数,相关 0.53。那张完整矩阵在补充附录 A,不在这份正文里。
| 比较 | 模型 | 优势比 | 这次比较的参照 |
|---|---|---|---|
| 亲属档位,每高 1 档 | 2.1 | 0.89 | 优势比 1,尚未改成“有没有” |
| 朋友档位,每高 1 档 | 2.1 | 0.84 | 同上,同时控制亲属档位 |
| 没有附近亲属 | 2.2 | 1.7(p < .05) | 至少有一些附近亲属 |
| 没有附近朋友 | 2.2 | 1.2(不显著) | 至少有一些附近朋友 |
| 亲属档位 | 2.3 | 0.64(p < .05) | 与朋友档位、二者乘积同时进入 |
| 朋友档位 | 2.3 | 0.52(p < .01) | 同上 |
| 亲属 × 朋友 | 2.3 | 1.6(p < .01) | 乘积项 |
注:优势比,加权,N = 1,128。不显著指正文没有给该项标出 p < .05。
模型 2.1 不支持“亲属越少、越可能搬家”,也不支持朋友档位在控制亲属之后仍有直接关联。未调整时朋友的优势比 0.77 是显著的;放进整套控制后变成 0.84,星号消失。控制变量吃掉了一部分朋友与搬家的原始关联。
模型 2.2 把问题改成有没有。没有附近亲属的优势比是 1.7(p < .05)。没有附近朋友是 1.2,不显著。假设 1 只在“完全没有”这一刀上得到支持,假设 2 的直接效应没有得到支持。敏感性分析把档位拆成类别后,亲属里“有一些”相对“没有”与更低的搬家可能有关(p < .05)。这为使用二分变量提供了理由,也说明 0–3 的一条直线配不上亲属的分布。
模型 2.3 加入乘积项。论文把它读成:附近亲属会减弱朋友与搬家的关系;亲属较少时,朋友与更少的跨邻里搬家联系在一起。正文另给了一个没有放进表 2 的辅助结果:朋友档位与“没有附近亲属”的交互优势比是 0.52(p < .05)。论文没有写明乘积项里的两个档位有没有先做中心化。若按原始 0–3 分进入,朋友那一格 0.52 对应的是亲属为 0 的情形;这一点文中没有写死,所以这里不把 0.52 再乘 1.6,当成每一档的表内结果。
满意这条街,没有经由亲友再转一手
地点特定资本(location-specific capital)指绑在当地、搬走就带不走的资源。亲属和朋友都可以是这种资源。古典压力模型认为,对环境的不满累积到一定程度,人才搬走;后来的模型把不满看成生命历程变化通向搬家的中间环节。由此会产生两个不同的预期。一个是中介:没有亲友,让人把邻里评得更差,再因此搬走。另一个是调节:人不满意,但因为亲友就在附近而留下。满意和依恋也不是同一个词。人可以给这条街打高分,同时并不觉得自己属于这里。
表 3 用 KHB 分解处理非线性模型里系数不能直接相减的问题。四列分别放入亲属档位、朋友档位、没有亲属、没有朋友,并带上表 2 的控制;朋友模型控制亲属,亲属模型控制朋友。变量经过标准化。完全效应是 −0.31、−0.33、−0.31、−0.34,直接效应是 −0.31、−0.31、−0.33、−0.33,都标了 p < .01。间接效应是 0.01、−0.02、0.02、−0.01,没有显著性标记。
方法段写的是亲友影响搬家、邻里满意作中介;结果段写的是亲友没有中介满意与搬家。两句的箭头方向并不相同。能从数字上确定的是间接效应接近 0,假设 4 没有得到支持。邻里满意在表 1 的标准差是 1.0,表 2 里满意优势比 0.73 取自然对数约为 −0.31,和表 3 的完全效应同一量级。论文已写明表 3 用了标准化变量,所以不能把四列逐格等同于表 2 的优势比,也不能写成“满意通过亲友解释了搬家的百分之几”。用类别而不是连续档位重做中介时,结果相似;唯一差别是亲属的中介在 p = .09,论文自己把它称为非常边缘,不构成对假设 4 的支持。
调节是另一回事,对应假设 5。表 4 仍是加权 logistic,N = 1,128。亲属档位优势比 0.47,满意与亲属的乘积 1.18,都不显著。朋友档位 0.29(p < .05),满意与朋友的乘积 1.31(p < .05)。加入这些乘积后,邻里满意的主效应是 0.54(p < .001)。它和表 2 的 0.73 不是同一次比较,因为表 4 同时放进了满意与亲友的乘积。论文的读法是:朋友减弱了满意与搬家的关系;满意处于最低水平时,朋友增加与更低的搬家可能联系在一起。最高一档朋友(大多数或全部)相对“没有朋友”,也能调节满意与搬家(p < .05)。没有亲友的二分变量与满意的交互放在补充附录 B,正文没有给出那组系数。
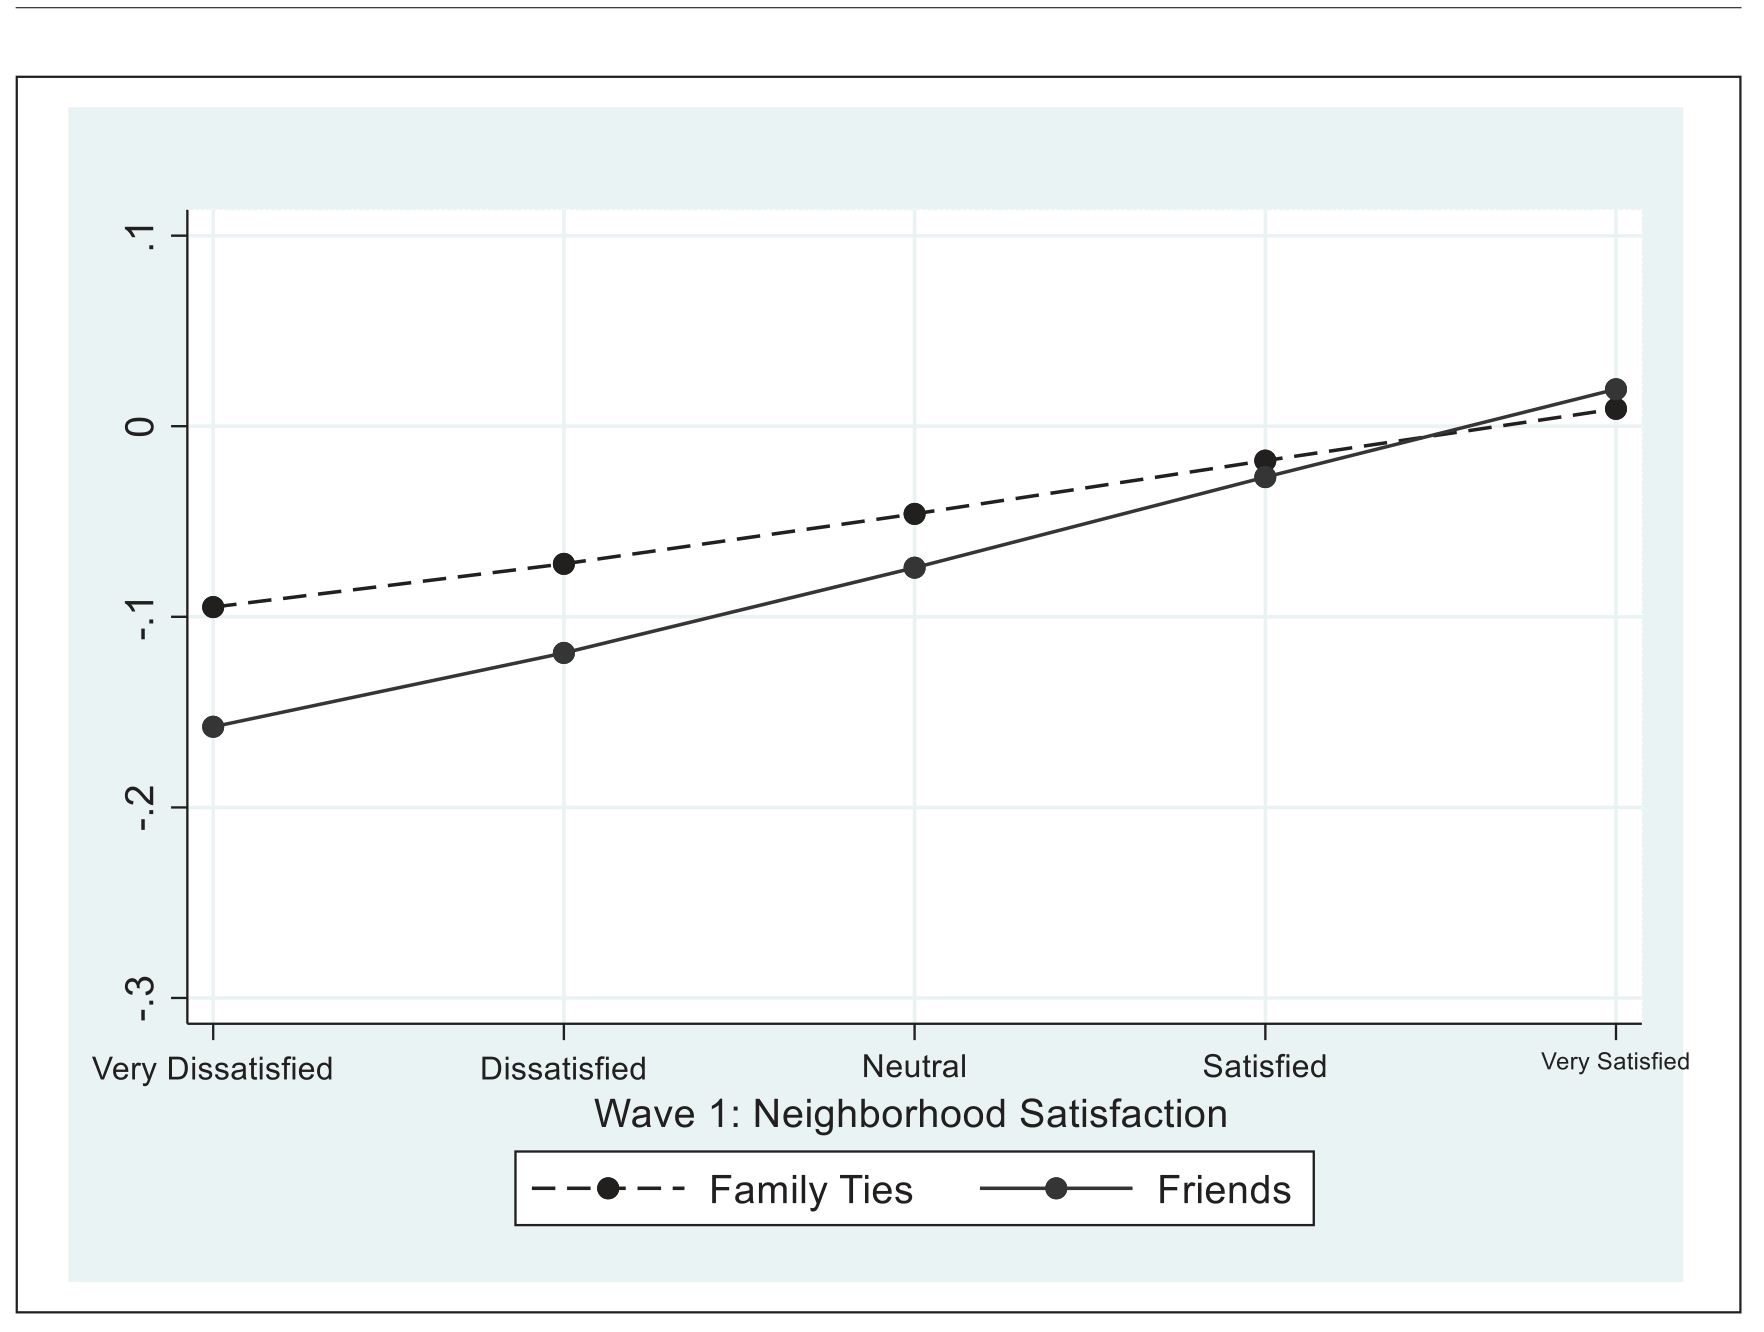
图 1|邻里满意程度不同时,附近亲属和朋友与搬家概率的边际关系有何不同?
无字母子图。横轴是第一波邻里满意的五个等级,从非常不满意到非常满意。纵轴是搬家概率的平均边际效应,刻度标为 −.3、−.2、−.1、0 和 .1;每个点没有印出精确数字。虚线为亲属,实线为朋友。两条线都随满意程度上升。非常不满意时,朋友线低于亲属线,落在 −.2 与 −.1 之间;亲属线靠近 −.1。非常满意时,两条线都略高于 0,朋友线略高于亲属线。图允许的结论是:朋友与搬家概率的边际关系依赖满意等级,低满意时更偏负。它不能单独证明朋友让人不满意的人留下,因为这是模型算出的平均边际效应,不是同一批人在获得或失去朋友前后的观测变化。来源:原论文 Fig. 1。
年龄、房子和住了多久,仍比多数街区指标稳
控制变量的方向和既有研究一致,但证据强度不一样。年龄的优势比在表 2 的三个模型和表 4 里都是 0.96(p < .001),参照是年轻 1 岁的人。自有住房在模型 2.1、2.3 和表 4 是 0.35,在模型 2.2 是 0.34,都是 p < .001,参照是非自有住房。现址年数在模型 2.1 是 0.91(p < .01),在模型 2.2 是 0.90(p < .001)。邻里满意在表 2 三个模型里是 0.73、0.71 和 0.72,均为 p < .01,参照是满意低 1 档。街区居住稳定比例是 0.96(p < .01),参照是该比例低 1 个百分点。
有工作在模型 2.1 是 1.70(p < .05),参照没有工作;模型 2.2 是 1.77,只到 p < .1。就业这项随规格摇动。以白人为参照,西班牙裔或拉美裔在模型 2.1 是 0.46(p < .05),其他模型里降到 p < .1;“其他”族群约是 0.13 到 0.15(p < .01),而这一组只占加权样本的 4.4%。这些是控制项里的系数,不是本文要解释的主要机制。
街区贫困层、人口密度、族群多样度和对数房价都不显著。讨论认为个人特征和感知比人口规模、居住更替这类街区指标更能预测搬家。稳定比例这条街区指标本身是显著的,所以不能把“街区指标都不重要”说成表 2 的全部结果。
年龄与亲友的交互是探索性问题,没有事先指定方向。正文只报告:附近亲属与搬家的关系随年龄减弱(p < .001),朋友没有同样的结果。系数表在补充附录 C,正文没有列出具体优势比。把健康和教育改成类别变量,实质结论不变。
这些结论能用到哪一步
测量是粗的。没有、有一些、很多、大多数,不是名单,也不是可以点数的网络。人能否大致判断附近亲友的比例,和换一种问法会不会得到同一结论,是两件事。关系的质量也没有测。人可能为了躲开紧张的亲属而搬家;作者引用自己此前关于搬家动机的研究,认为这种动机少见,但本调查并不能辨认。强关系与弱关系也没有分开。弱关系未必是值得留下的地点特定资本。
地理范围停在洛杉矶县。作者认为,若在一座城市内部亲友仍然有关,那么在通信更困难的长距离迁移里,这种关系至少不该更弱。这是推断,不是本文已经比较过的第二座城市。准备搬家的人可能少花力气结交附近的朋友;朋友少和爱搬家也可能来自同一种性格。模型没有把这些内生性拆掉。
搬家也不自动等于这条街出了问题。本地关系少的人,可能是搬向别处的亲属或朋友。数据里没有目的地还有谁。集体效能、邻里凝聚力出现在讨论里,作为亲友为何与去留有关的一种理解;这项调查没有单独测量它们。
政策段落认为,高流动街区的项目可以帮助人建立和维持支持,尤其是社会上较孤立的人。同一节同时挑战一个旧想法:促成当地关系就会提高人对地方的满意。本文的相关结构是,对环境的评价可能因附近住着谁而不同。这仍是洛杉矶县、跨普查区、加权回归里的关联。
一句话总结
附近亲友并不是先让人更喜欢这条街、再因此留下;在这 1,128 人里,完全没有附近亲属与跨普查区搬家联系在一起,朋友则主要在亲属很少或邻里很不满意时,才与更低的搬家可能出现在一起。
核心来源
- City & Community 论文页面,核对题目、作者、卷期与 DOI。期刊页为 2022 年 21 卷第 2 期,140–155 页。
- 格罗宁根大学机构库的正式版记录,发表状态为 2022 年 6 月:Family and Friends Living Nearby, Neighborhood Satisfaction, and Residential Mobility。
- 正文指向在线补充附录 A–C。本文写进正文的附录信息,只有论文已经给出的两项:教育与街区房价中位数相关 0.53;附近亲属与搬家的关系随年龄减弱(p < .001),朋友没有同样结果。附录 B 的系数没有出现在正文里。
- 研究资金来自欧洲研究理事会、欧盟 Horizon 2020 计划,资助号 740113。作者感谢 Clara Mulder、Christine Peterson、Megan Thiele 和四位匿名审稿人,这三人不在署名作者里。
作者介绍
本文只有一位署名作者。
- Brian Joseph Gillespie:通讯作者。论文署名为荷兰格罗宁根大学空间科学学院人口研究中心。格罗宁根大学人员页能核到他在空间科学学院;公开出版集中在家庭关系、居住流动,以及人为什么留下不搬。ORCID:0000-0002-2997-7179。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
普查区边界和“几个街区”可以错开。人搬到朋友隔壁、却跨过普查区界,会被记成流动;在很大的普查区里只换一条街,会被记成留下。论文已经发现,区内部的搬家得不到同样的结果。若一座城市用“是否离开原来那几个街区”来评价留人项目,朋友与搬家的关系可能会换一张脸。这要用同一套距离重算,本文没有做。
六年到八年里只比较起点和终点。人可以搬走再搬回同一普查区,表上仍是未流动。若亲属的作用是把人吸回来,而不是让人从未离开,这种来回会被算成稳定。分开这两种稳定,需要中间地址,或者知道新地址附近有没有亲属。论文只指出本地关系少的人可能搬向别处的亲友,数据里没有目的地的人名。
图 1 里,非常不满意时朋友对应更低的搬家概率边际效应,非常满意时两条线都靠近 0。一个只拿搬家率当成绩的街区项目,可能把“人不满意、但因为朋友留下”记成成功。满意和留下在这里不是同一个结果。项目若同时记下满意分档和附近朋友档位,才分得清人是喜欢这条街,还是先忍着。