只记下在哪上车,为什么还看不清一次公交出行?
论文名片|Yunling Chen、Suhong Zhou、Dan Zou、Qiuping Li、Qiumeng Li,Unlocking hidden demand: Reconstructing bus OD flows by integrating mobile trajectories and Map API,Travel Behaviour and Society,2027,46:101358。DOI:10.1016/j.tbs.2026.101358。本文依据该刊正式版解读;2026年8月6日在线发表,收稿日期为2025年11月12日,修回2026年7月12日,接受2026年7月16日。这是一项方法研究:用手机信令轨迹和高德地图路径规划重建公交起讫流,再拿问卷、官方线路客流和一个线路缩短模拟来检验。
早高峰,一条公交线末尾有个站,上车的人很少。按上车人数,它像可以先拿掉的末梢。同一时刻,另一批乘客正在这个站下车,他们的行程要从几站之外算起。只保留上车多的站,线还在,有些人的下车点已经不在了。这是帮助想象的场景,论文的证据来自全网统计。
广州中心区这一天的结果指向同一件事:手机轨迹对照地图给出的公交方案之后,可以补上刷卡常常缺少的下车站,并汇总成站点与线路客流。上车总人数和下车总人数的分布几乎叠在一起,单个站点却经常明显偏向上车或下车。在把线网里程缩短两成的模拟里,按完整起讫删站,比只按上车人数删站,保住更多下车和更多成对行程。模拟用的是重建出来的客流,衡量的是删站规则的差别,尚未变成已经实施的线网调整。
先说结论
- 在3,496条机动化问卷起讫里,加入高德路径规划后,公交这一类的F1从61.92%升到82.42%,Kappa从0.313升到0.610。F1综合的是公交类的查准和查全;3,496条里整体判对的比例,要另外看总体准确率。
- 重建的线路客流与2024年9月官方线路日均客运量的决定系数R²为0.786,皮尔逊相关为0.887;只用静态路网规则时,这两项是0.191和0.437。散点图没有标出参与比较的线路条数。
- 研究区4,812个站点中,出行发生站2,182个、出行吸引站1,308个、相对均衡站1,322个。上车人次的站点均值是12.40、中位数是3,下车是12.32和3。均值接近,站点角色并不接近。
- 线路客流的秩—规模拟合指数,重建结果为−0.99,官方客流为−1.02。论文报告按秩排列后前80%的线路合计占估计总客流的99.99%、官方总客流的99.37%;这说的是排序靠后的线路份额极小,不能换成“最忙的20%线路占80%客流”。
- 里程削减20%时,起讫方案覆盖96.16%的下车和98.29%的成对行程,上车方案覆盖79.55%的下车和93.14%的成对行程,相差16.61和5.15个百分点。上车覆盖则是96.24%对100%。分母都是这条重建网络自己的站点、上下车或起讫。全市常规公交日均289万乘次是另一套全市口径。
上车记录为什么留不下目的地?
许多城市的公交自动收费只要求上车刷卡或扫码。票款数据因此有起点,没有下车站。已有研究用规则或机器学习去猜下车站,精确到站点时准确率大约在60%到80%,放宽到一段距离内或多候选站时可以到90%以上。这些数字来自论文综述的既有工作,随验证标准变化。本文在广州测得的是后面的F1和线路相关。
更靠前的限制是谁会进入刷卡表。持卡的常乘客容易被记到;游客、偶尔付现或移动支付、以及并非每趟都刷卡的优惠乘客,更容易缺席。把下车站补算出来,矩阵仍然主要来自这群会被收费系统看见的人。论文把这称为代表性偏差,并认为它不能靠后面的估计算法消除。
手机信令换了一条记录路径。人是否刷卡,不影响基站是否留下位置。论文同时写明,幼儿和一部分老年人因为较少持有手机,仍可能被低估。在当前中国城市,公交票款大多已经通过手机支付,所以手机数据覆盖的人群大体包住刷卡用户,刷卡用户并不能反过来包住全部手机用户。这是作者对覆盖关系的判断,本文没有拿同一天的刷卡表和信令表做逐人对照。
公交还比地铁更难认。地铁的空间特征比较独,公交和小汽车、网约车共用道路,速度和停靠又不稳定。只看快慢,很容易把几种道路方式混在一起。
一天的信令,怎样变成可分析的样本?
轨迹来自一家电信运营商,估计占广州约30%的市场份额。2024年10月9日是周三,作者选它,是因为这一天没有公共假期和极端天气。当天匿名用户10,154,117人。位置由手机与基站的信令产生,建成区空间分辨率最高到150米。
运营商样本和常住人口的年龄、性别结构不一定一致。作者按第七次全国人口普查的社区人口、性别比和年龄结构做分层重抽样,目标是全市常住人口的1%。实际得到184,400人,相当于常住人口的0.98%。后面的轨迹和客流图都来自这18.44万人。1,015万人只是重抽样之前的运营商池,图上的人次也还没有放大成全市客流。
停留点由运营商上游流程规定:一个人在150米×150米网格里停留至少30分钟。作者没有再改这个阈值。一次行程是相邻两个停留点之间的信令序列。出发时间是起点停留里最后一条信令,到达时间是终点停留的第一条信令,二者之差是观测行程时间。清洗后得到916,212条轨迹。论文没有报告其中有多少条最终被确认为公交。
问卷是另一套人、另一个时段。2024年10月16日至31日,先按人口和经济特征分区,再从中心城区抽21个街道、95个社区,得到3,004份有效答卷。每人报告两个最常去的目的地,以及去那里的主要方式。去掉起终点相同、直线距离短于500米和逻辑不一致的记录后,剩3,987条有效起讫;其中机动化方式3,496条。这里的分母是起讫记录。一个人可以贡献多条,所以3,004份答卷不等于3,987次独立出行者。
官方运营数据是2024年9月的线路长度和线路日均客运量,用来对照重建的线路总量。三个时间窗因此并排:信令是10月9日一天,问卷是10月下半月的惯常目的地,官方客流是9月日均。相关高,说明这些口径在线路总量上同向;它不能单独证明某一天的每一个下车站都被认对。
广州中心区的公交处在什么底图上?
据《2024年广州市交通发展年度报告》,全市常规公交日均289万乘次,占公共交通出行的19.84%。分母是公共交通出行。步行、自行车和小汽车不在这19.84%里面。研究区比全市小。作者限定在白云、天河、越秀、海珠、荔湾、黄埔六个中心区,并纳入部分延伸到番禺的线路,因为中心区公交运营相对统一、客流集中。范围内有4,812个公交站、1,228条线路,方向相反的线路分开计数。
中心城区广州公交集团约占83%的份额,其余由两家较小公司分担。南沙、花都等外围区由另外的地方交通部门管理,票价、服务标准和线网密度不同。作者把范围收在中心区,是为了让票价、服务标准和线网密度停留在同一套运营制度里。下面的站点功能和客流集中,描述的都是这块研究区。
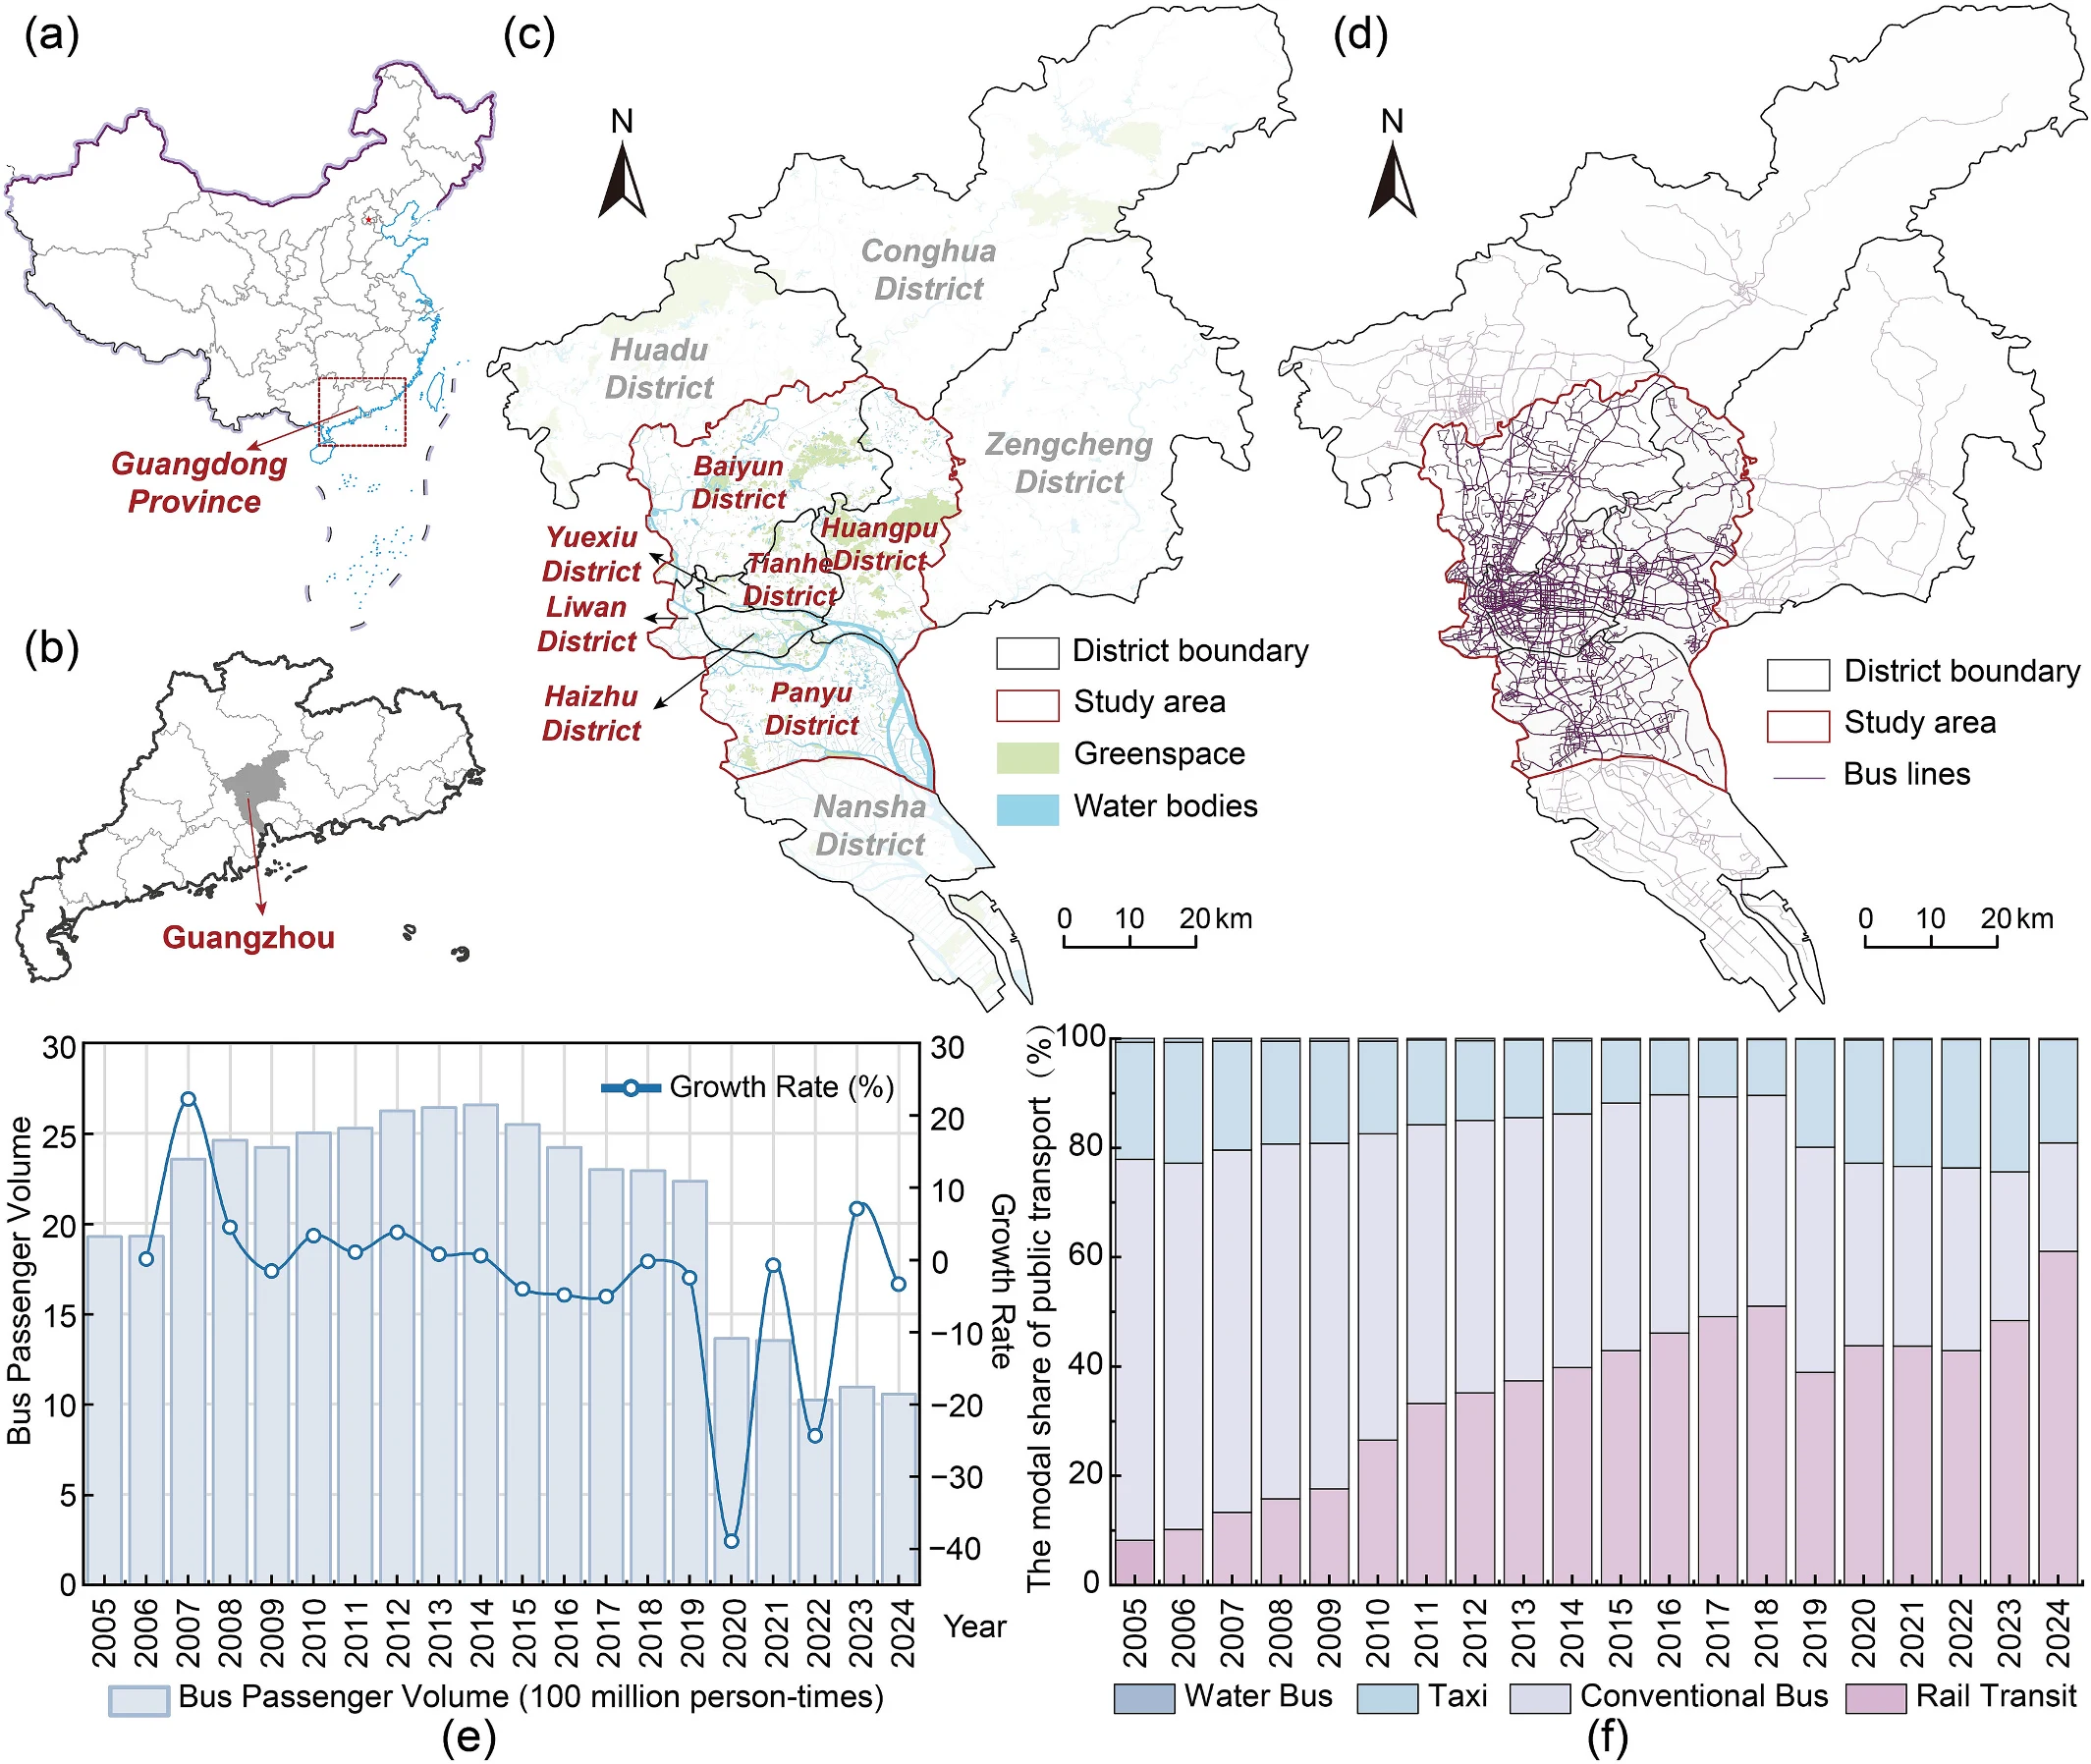
图 1|重建客流之前,公交网络落在广州的哪一块?
(a)广东省在中国的位置。(b)广州市在广东省的位置。(c)市域区界、中心研究区、绿地和水体;红线内是白云、天河、越秀、海珠、荔湾、黄埔及部分番禺线路所覆盖的范围。(d)同一范围的公交线路,线路明显密在中心、疏向外围。(e)2005—2024年全市公交年客运量(亿人次)和增长率;2020年客运量明显下跌,之后没有回到2010年代中段的高位。(f)同期公共交通方式构成,轨道份额上升,常规公交份额下降,图中还单列水上巴士和出租车。来源:原论文 Fig. 1。
(e)(f)给出全市年度背景。(c)(d)对应后文4,812个站和1,228条线路的空间范围。2020年的年客运量下跌,回答不了10月9日每个站的上车变化。
三条对照,怎样把路上的移动认成公交?
916,212条轨迹先过一层不依赖地图的筛选,再过三层依赖高德的核对,最后才汇总成站和线路。
筛选有三条。行程的起终点都在广州市行政范围内。运营商已把方式粗分成道路、地铁、飞机、铁路和其他,这里只留下道路类,当作机动化候选;这个分类器是运营商的,论文无法单独检验它的准确率。速度还要落在12–80千米/小时,时长超过15分钟。这个速度区间偏宽,留在样本里的行程其实更集中:中位数25.0千米/小时,四分位距18.0–37.0千米/小时,95%落在13.0–60.0千米/小时。宽门槛的作用是少误删,后面的地图核对才负责把公交从其他道路方式里分开。
核对使用高德公交路径规划接口。输入是轨迹的起终点和出发时间,默认采用综合推荐方案。这个方案同时平衡行程时间、换乘次数、步行距离和实时班次。一条轨迹要连过三关才记为公交。
第一关看方案是否存在。服务时间以外、规划不出公交的行程,记为非公交。若返回的是公交与地铁的组合行程,只抽出其中的公交段,包括上车站、下车站和线路。这样得到的起讫是站到站,门到门的两端步行留在站外。换乘行程里的公交需求因此还能留下,不必先把整条轨迹切段。
第二关看两端步行。从轨迹起点走到第一个上车站、从最后一个下车站走到轨迹终点,两段都不超过500米。阈值对齐本地规划:到2025年,90%以上的城市人口应能在500米内到达公交站,2035年提到95%。
第三关看时间。行程时间比等于观测行程时间除以接口估计的行程时间。公交时间常常右偏,用标准差剔异常不可靠,作者改用分位数:时间比落在全部候选的第5到第90百分位之间才保留。下界去掉快得不像公交的轨迹,上界去掉极长延误或明显损坏的记录。
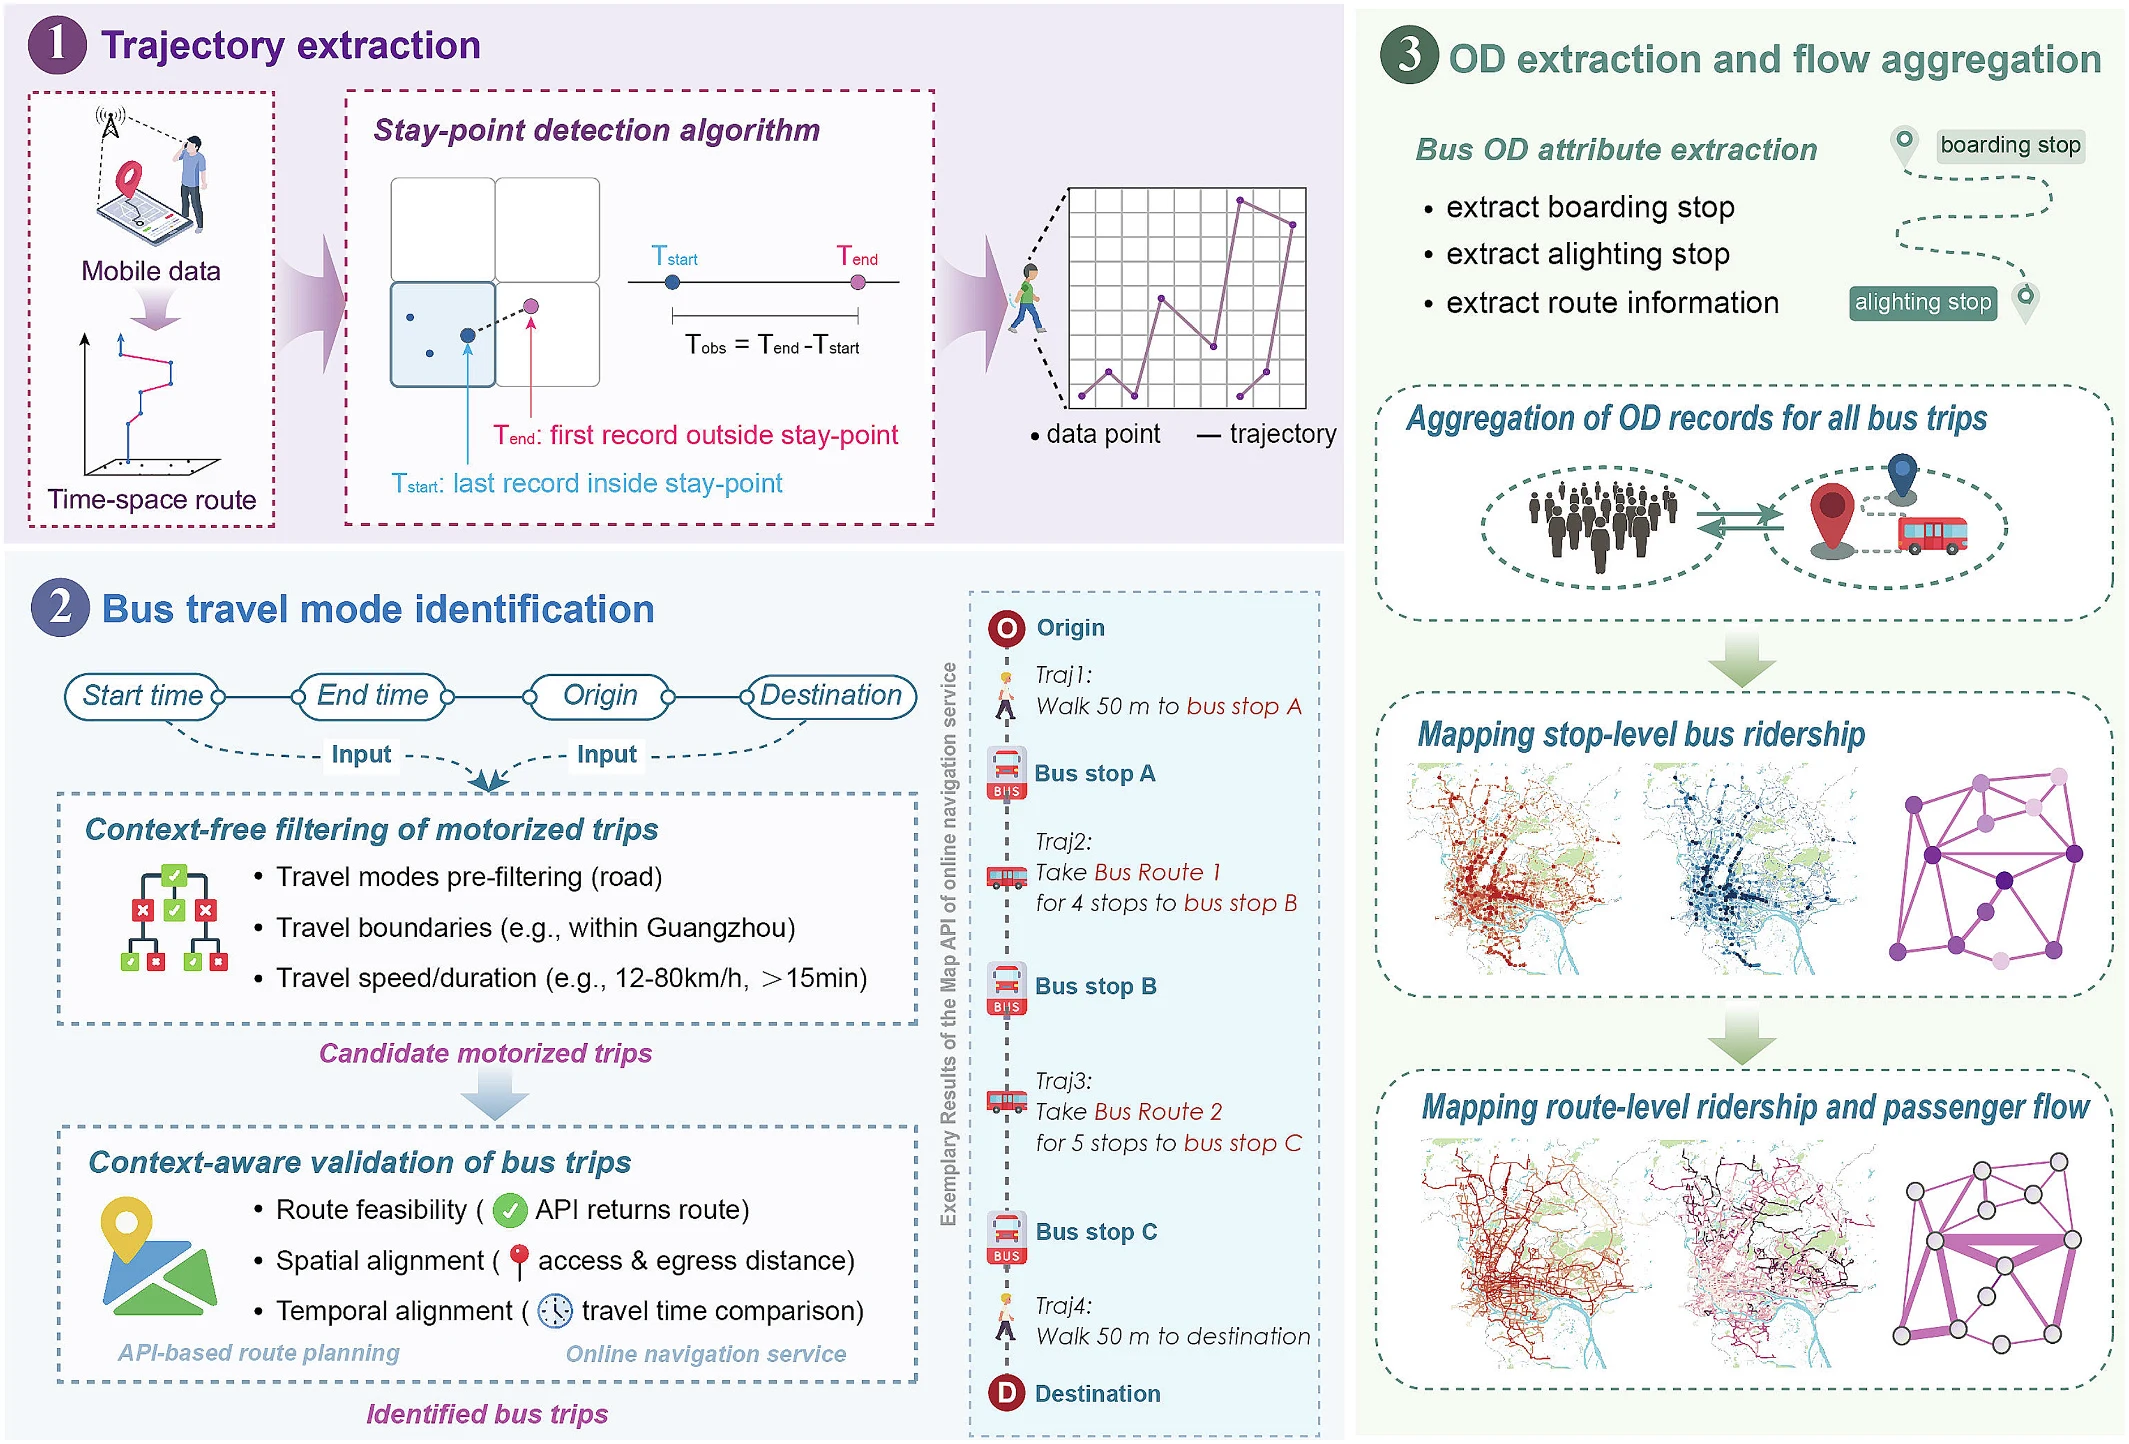
图 2|从基站停留到站点客流,中间哪几步在做核对?
图中没有字母面板,按三个阶段阅读。阶段1在150米网格上检测停留,用起点内最后一条信令和终点停留的第一条信令计算观测时长。阶段2先按道路方式、市域和速度时长筛出机动化候选,再用路径是否存在、两端步行不超过500米、行程时间比是否落在第5到第90百分位确认公交;侧栏示意一次换乘行程被拆成公交段。阶段3抽出上车站、下车站和线路,分别汇总到站点和线路。来源:原论文 Fig. 2。
确认后的公交腿按线路编号、上车站和下车站拆开。换乘的每一段公交各算该线路的一次上车,这个口径和官方客运量统计一致。站点层累加每个站的上车与下车;线路层累加站间起讫。因为前面的筛选会丢掉一部分真公交,作者在讨论里把重建流量看作实际公交需求的下界。它没有被放大成全市客流。
拿掉地图动态规划的对照模型,仍使用500米邻近,再加上静态路网里的最少换乘和绕行比,参数另行调过。两边的差别就是:一边用某一时刻的推荐公交方案核对这条行程,另一边只用站点和线路的固定几何。
上下车总量很像,站点为什么仍然各干各的?
重建客流在中心密、外围疏,和已有的本地需求研究同向。把所有站的上车和下车放在一起看,两组分布也很像。作者因此单独计算每个站的移动功能指数:(该站上车 − 该站下车)÷(上车 + 下车)。指数靠近1,上车远多于下车,站点更像行程的发生端;靠近−1,下车远多于上车,更像吸引端;靠近0,两端比较均衡。
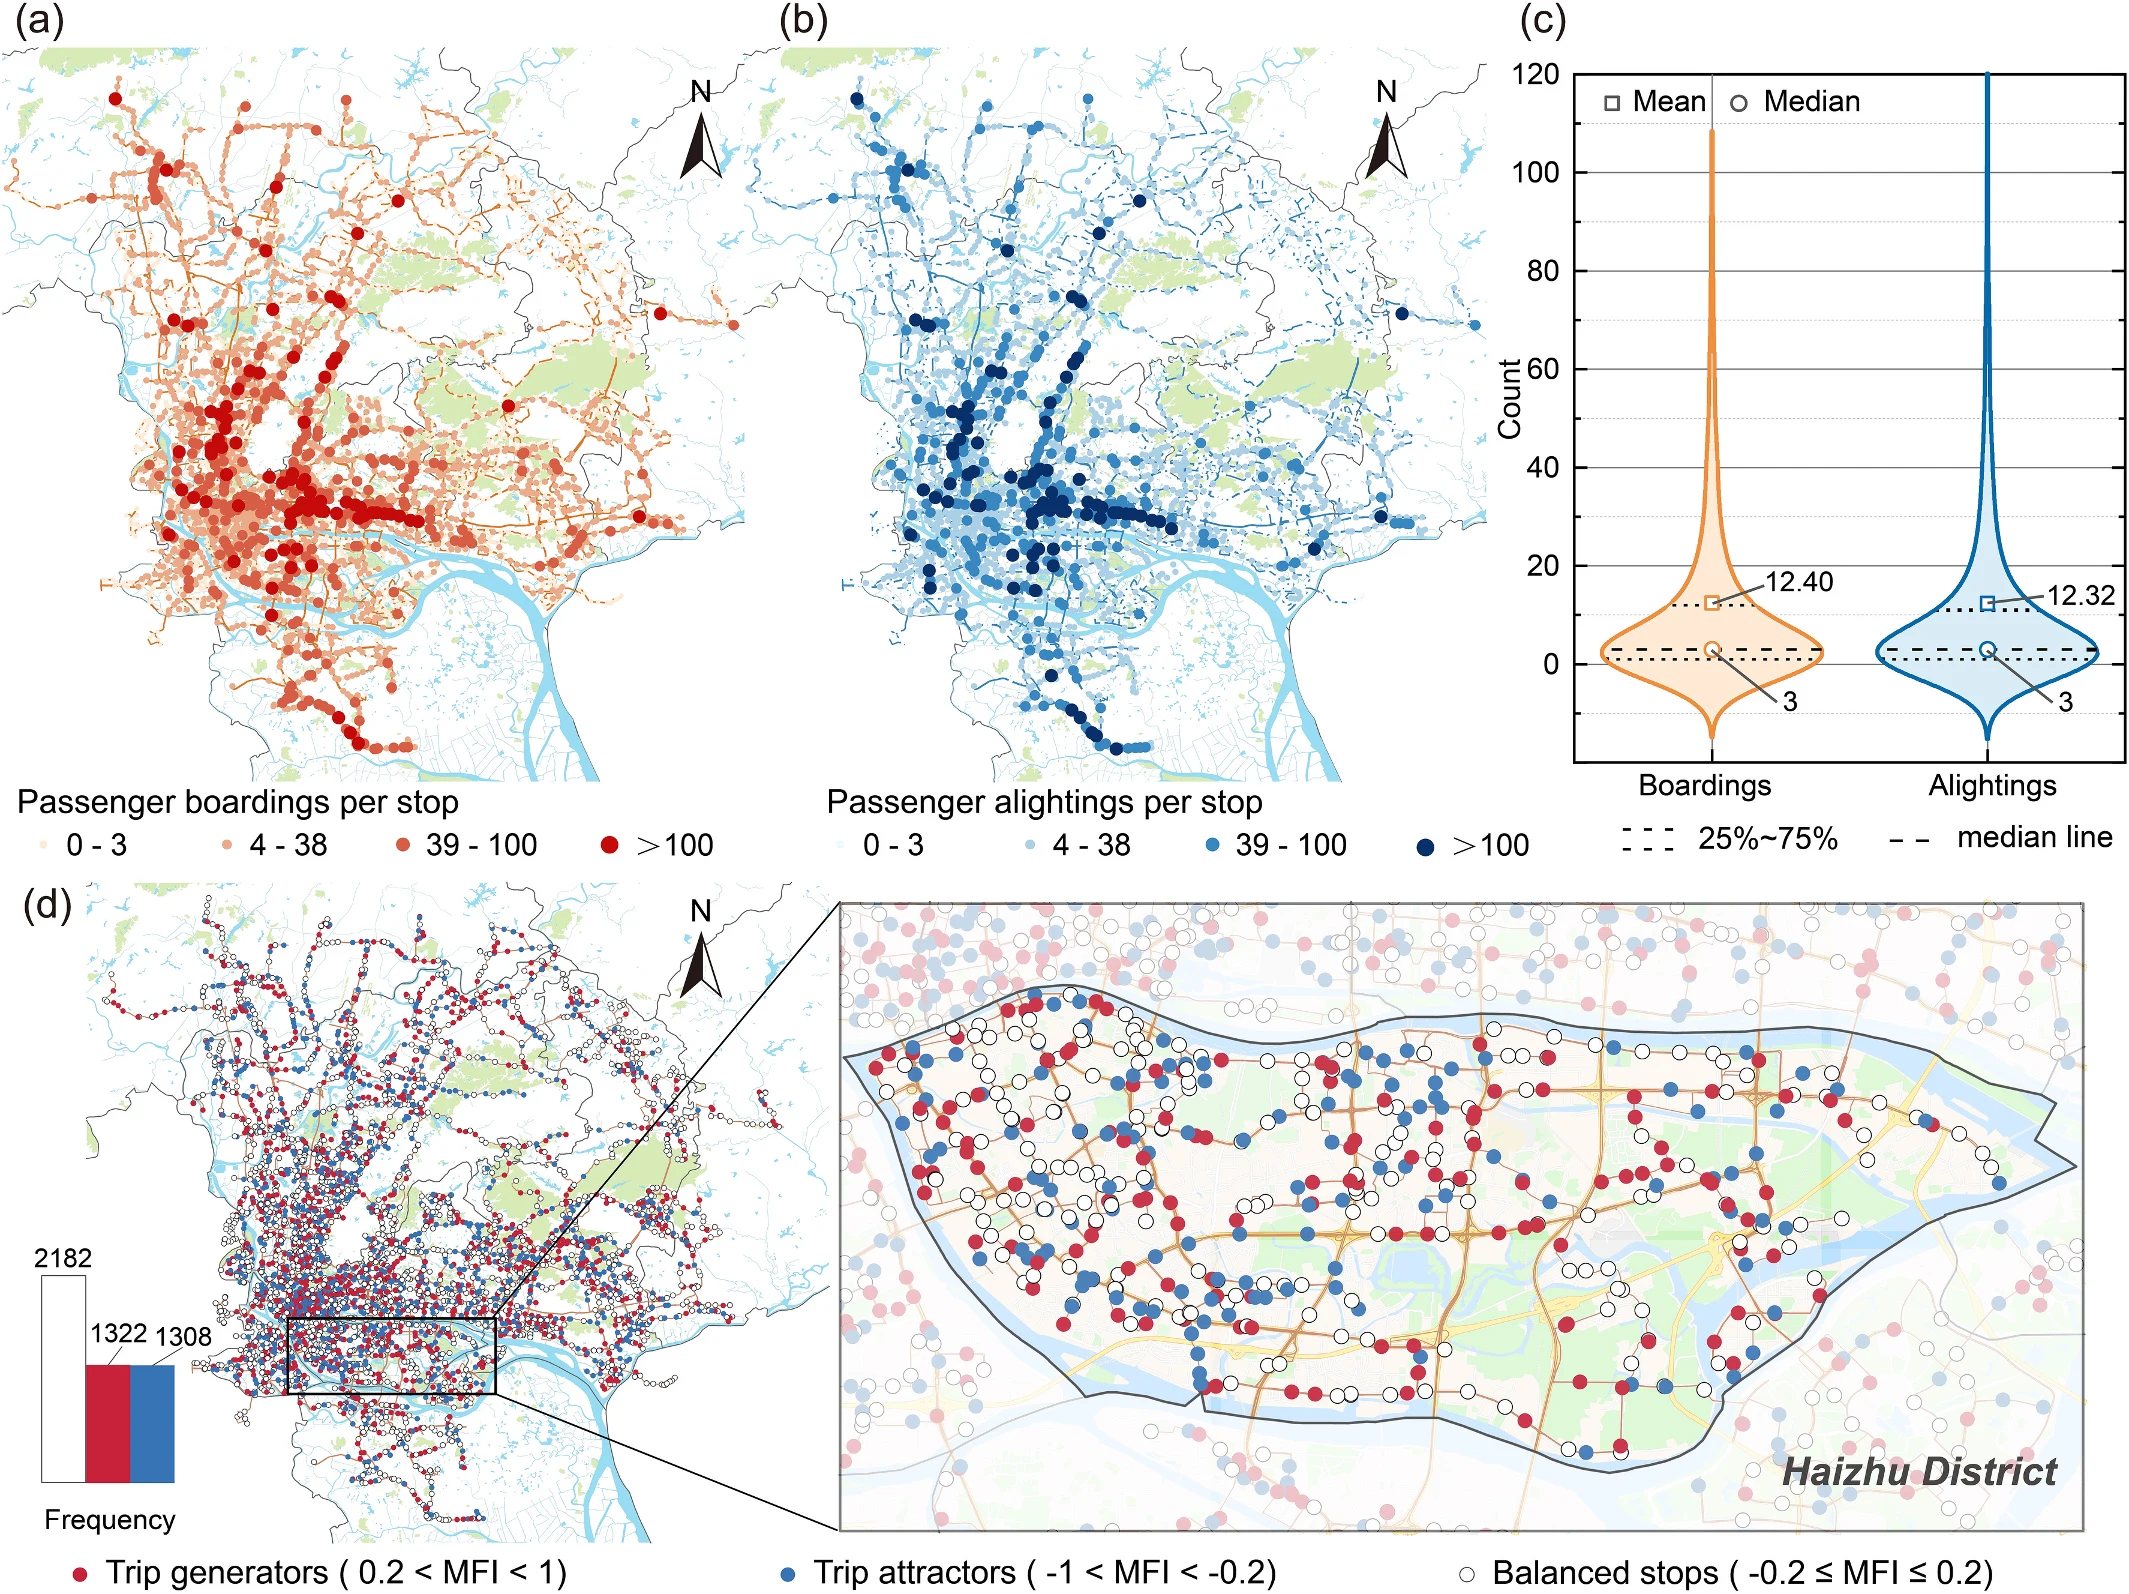
图 3|总上下车相似时,单个站点是否仍有明确角色?
(a)每个站的上车人次,颜色从0–3、4–38、39–100到大于100,深色集中在中心。(b)下车人次使用同一套分级,空间上也是中心密。(c)两个小提琴图的均值分别为上车12.40、下车12.32,中位数都是3;虚线带是25%–75%分位。纵轴是重建样本中的人次,长尾把均值拉到中位数上方。(d)按指数分类:发生站2,182个(0.2 < 指数 < 1),均衡站1,322个(−0.2 ≤ 指数 ≤ 0.2),吸引站1,308个(−1 < 指数 < −0.2)。三者相加为4,812,即研究区全部站点。海珠放大图里红、蓝、白站点彼此穿插。来源:原论文 Fig. 3。
2,182/4,812是发生站,1,308/4,812是吸引站。发生站多于吸引站,但吸引站仍占超过四分之一。只按上车优化,高下车、低上车的站容易被当成需求弱。图3说明的是重建样本里的功能分化。它还没有和土地利用、医院或学校名单对齐,具体设施是否被忽视仍要另做核对。
客流是铺满全网,还是挤在少数路段?
线路总量会把一条线内部的差别抹平。作者按线路跨度和客流量把走廊分成三类:连接就业区和居住区的跨区通勤线、区内连接线,以及汇向主要交通节点的枢纽放射线。这是对重建客流形态的归纳。站间流量再把走廊拆开:东西向如天河商务区—黄埔,南北向如荔湾—白云,高强度汇在广州东站等换乘点附近。少数站间路段承担不成比例的客流。
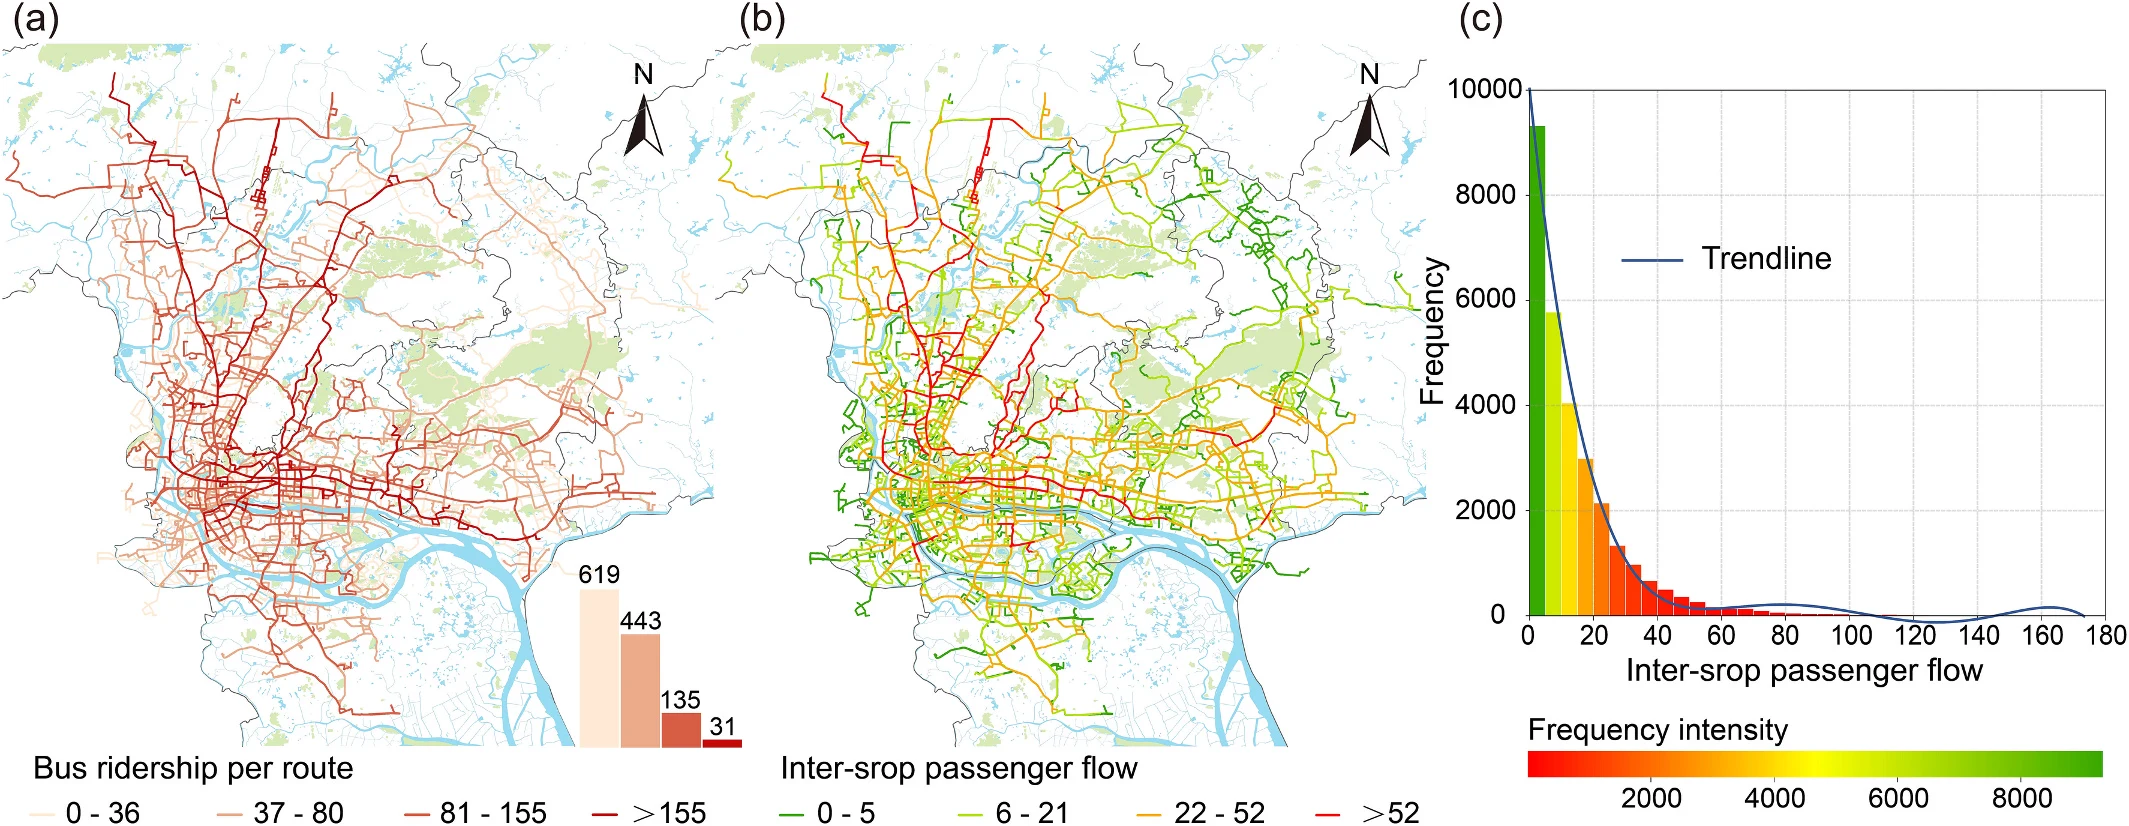
图 4|需求是均匀铺在线上,还是集中在少数路段?
(a)1,228条线路按重建客流着色:0–36有619条,37–80有443条,81–155有135条,大于155有31条。四档相加等于全部研究线路。这些人数是18.44万样本当天的重建计数。官方日均乘次使用另一套数量级,见后文散点的横轴。(b)站间客流分0–5、6–21、22–52和大于52四档,高值沿主要走廊和枢纽分布;图例没有给出每一档的路段条数。(c)站间客流的频数向右长尾延伸,绝大多数路段流量很低。论文据此称分布呈帕累托式集中,正文没有给出“多少比例的路段承担多少比例客流”。来源:原论文 Fig. 4。
31条高客流线路,指的是样本重建值超过155的线路。官方日均远高于这个刻度,下一节的散点把两套数放在同一张图的横轴和纵轴上。
认出来的公交,和问卷、官方客流各差多远?
微观检验把问卷里的起点坐标、终点坐标和出发时间送进同一套规则,让规则预测方式,再和受访者自报方式比较。送进去的是问卷坐标和出发时间。82.42%的F1衡量的是:已知一次起讫和出发时刻时,地图核对能否把自报公交分开。停留点识错、150米定位误差和运营商道路分类错误,留在这项分数之外,要靠后面的线路总量来看整条流程。
机动化子集有3,496条。静态路网模型的公交查准率73.74%,查全率只有53.37%,F1为61.92%,Kappa为0.313,只比偶然一致好一截。地图模型的查准率79.69%,查全率85.35%,F1为82.42%,Kappa为0.610。F1提高20.50个百分点,Kappa提高0.297。查全率上升,同时查准率没有下降,说明多找回来的公交行程,没有靠大量误报换来。
换到全部3,987条,步行和骑行也进入分母。地图模型的公交查全率仍是85.35%,查准率降到66.65%,F1为74.85%,Kappa为0.473。表3记录的总体准确率是73.29%,附录图四舍五入为73.3%。查全率保持不变,是因为新进入的非机动化记录不属于应被找到的公交;查准率下降,是因为一部分步行或骑行被标成了公交。作者因此把主比较放在机动化子集,避免短距离方式把公交识别的难题冲淡。
四种规划偏好也在同一批问卷起讫上比过。机动化3,496条里,综合推荐的公交F1为82.42%,省钱方案79.27%,最少换乘75.76%,最少步行70.51%;对应Kappa为0.610、0.542、0.466、0.348。总体准确率从推荐方案的80.66%降到最少步行的67.65%。推荐方案同时考虑时间、换乘、步行和服务,最接近这些自报行程;最少步行把路线约束得过窄,和观测轨迹最不合。
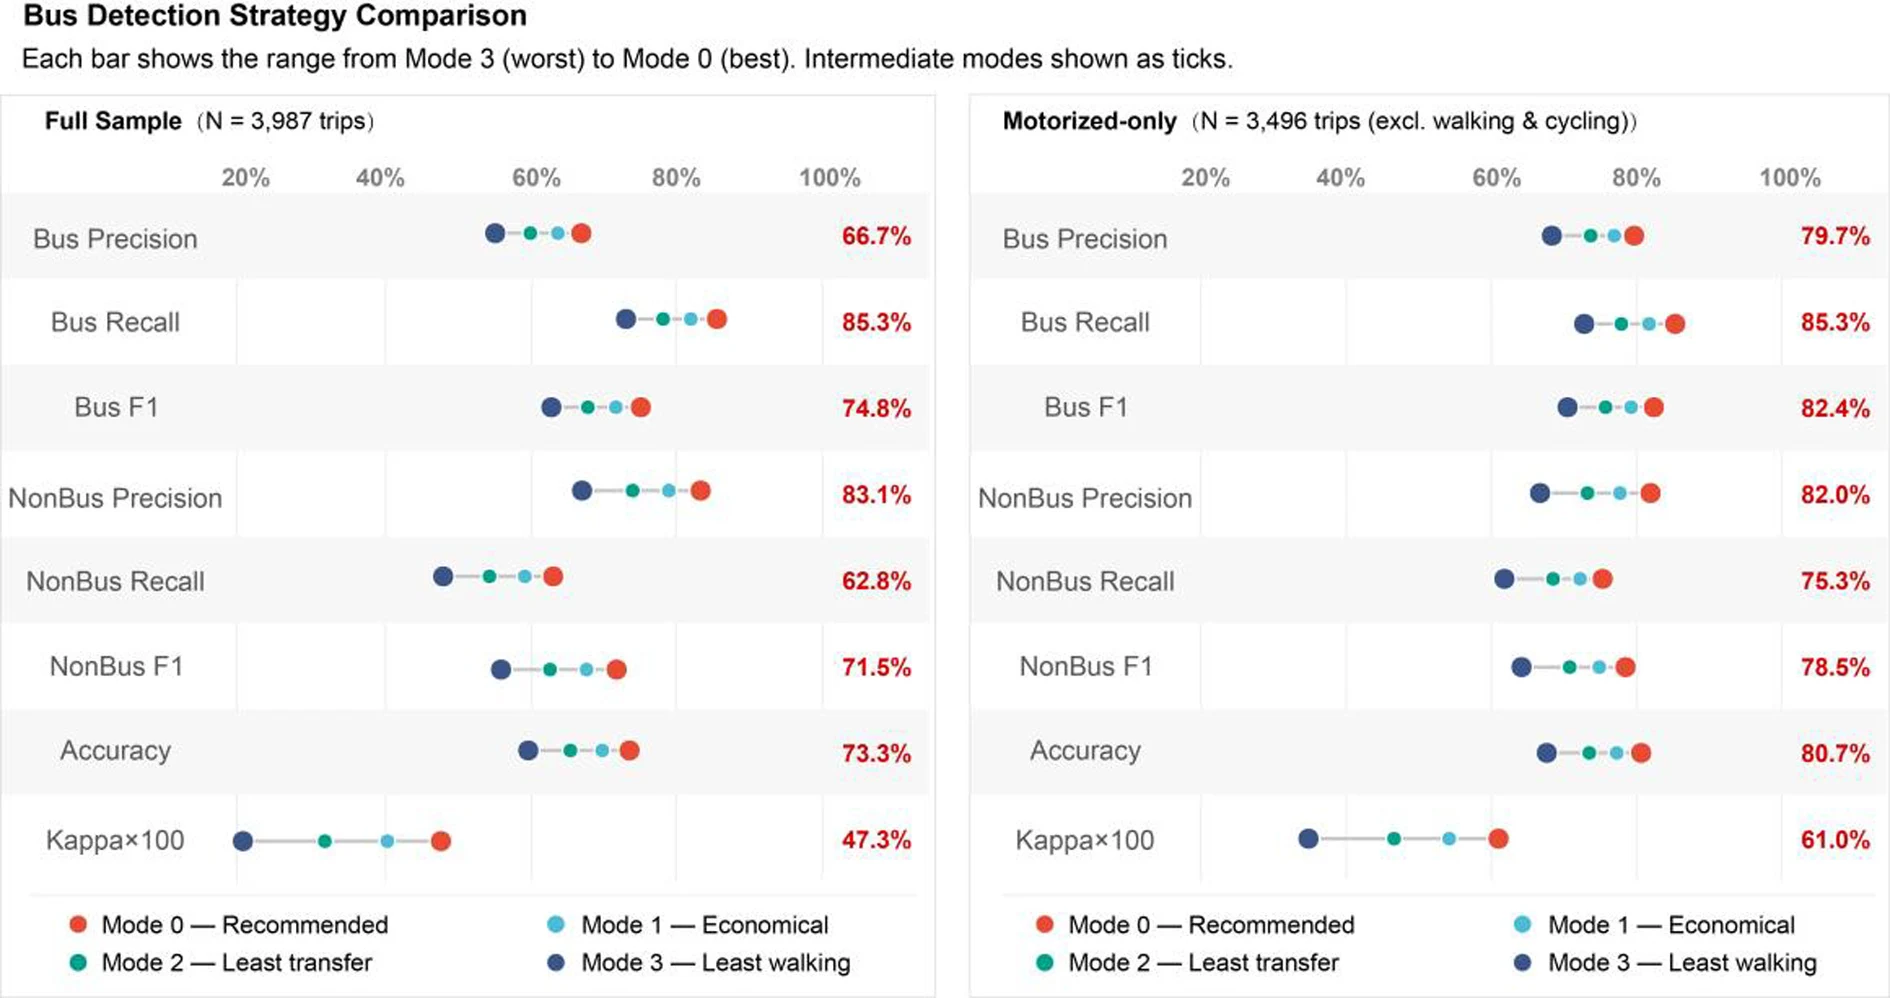
图 5|换一种路径偏好,公交还认得出吗?
图中没有字母面板。左栏是全部3,987条起讫,右栏是不含步行和骑行的3,496条。每个指标上,圆点从少步行到综合推荐排列,红字是推荐方案。右栏公交查准率79.7%、查全率85.3%、F1 82.4%、总体准确率80.7%、Kappa 0.610;左栏公交查准率降到66.7%,查全率仍为85.3%,F1为74.8%。图中红字保留一位小数。来源:原论文 Fig. A1。
宏观检验把重建线路客流和9月官方日均客运量比较。静态模型的R²是0.191,相关0.437;地图模型的R²是0.786,相关0.887。两个相关的p值都小于0.001。p值小表示相关不太像抽样偶然,不表示每个站间起讫都已核实。
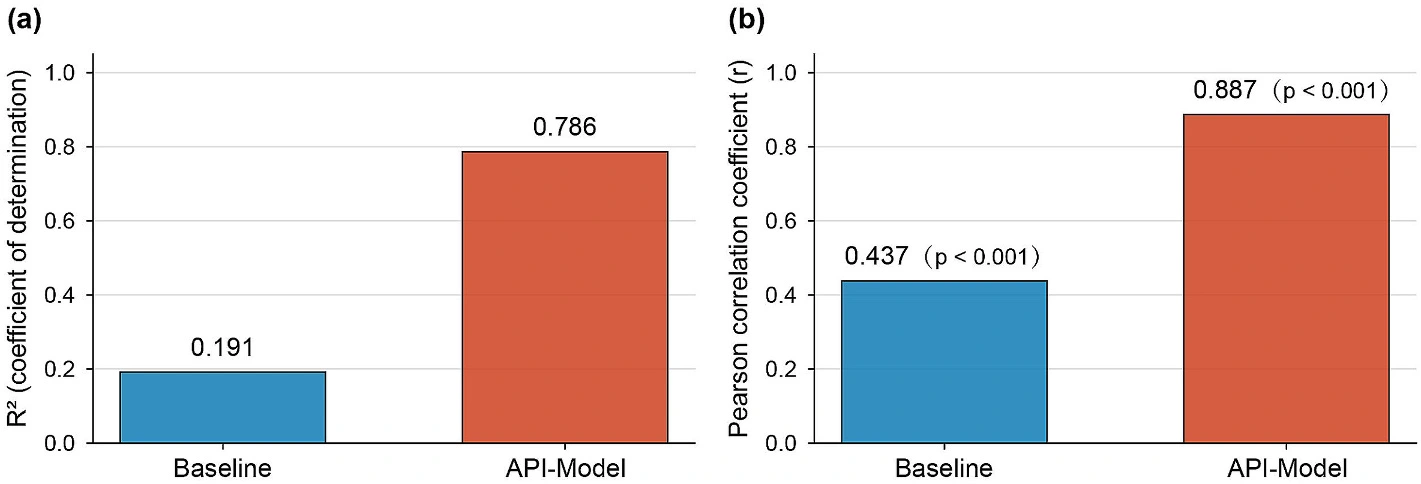
图 6|地图核对有没有改善线路总量,而不只是单条行程?
(a)决定系数:静态模型0.191,地图模型0.786。(b)皮尔逊相关:静态模型0.437,地图模型0.887,两者p均小于0.001。蓝色是静态路网规则,红色是加入路径规划的模型。来源:原论文 Fig. 5。
散点把官方客运量放在横轴,重建估计放在纵轴。拟合直线是估计值 = 0.02 × 官方值 + 0.22。官方轴延伸到一万以上,估计轴主要在几百以内。0.02是这条拟合线的斜率:官方日均约1万人次的线路,对应的估计值大约在200附近。分析样本是常住人口的0.98%,信令只覆盖一天,官方数是9月日均。纵轴因此仍是样本尺度的估计,0.02只是这张图的拟合斜率,论文没有把它用作全市放大系数。
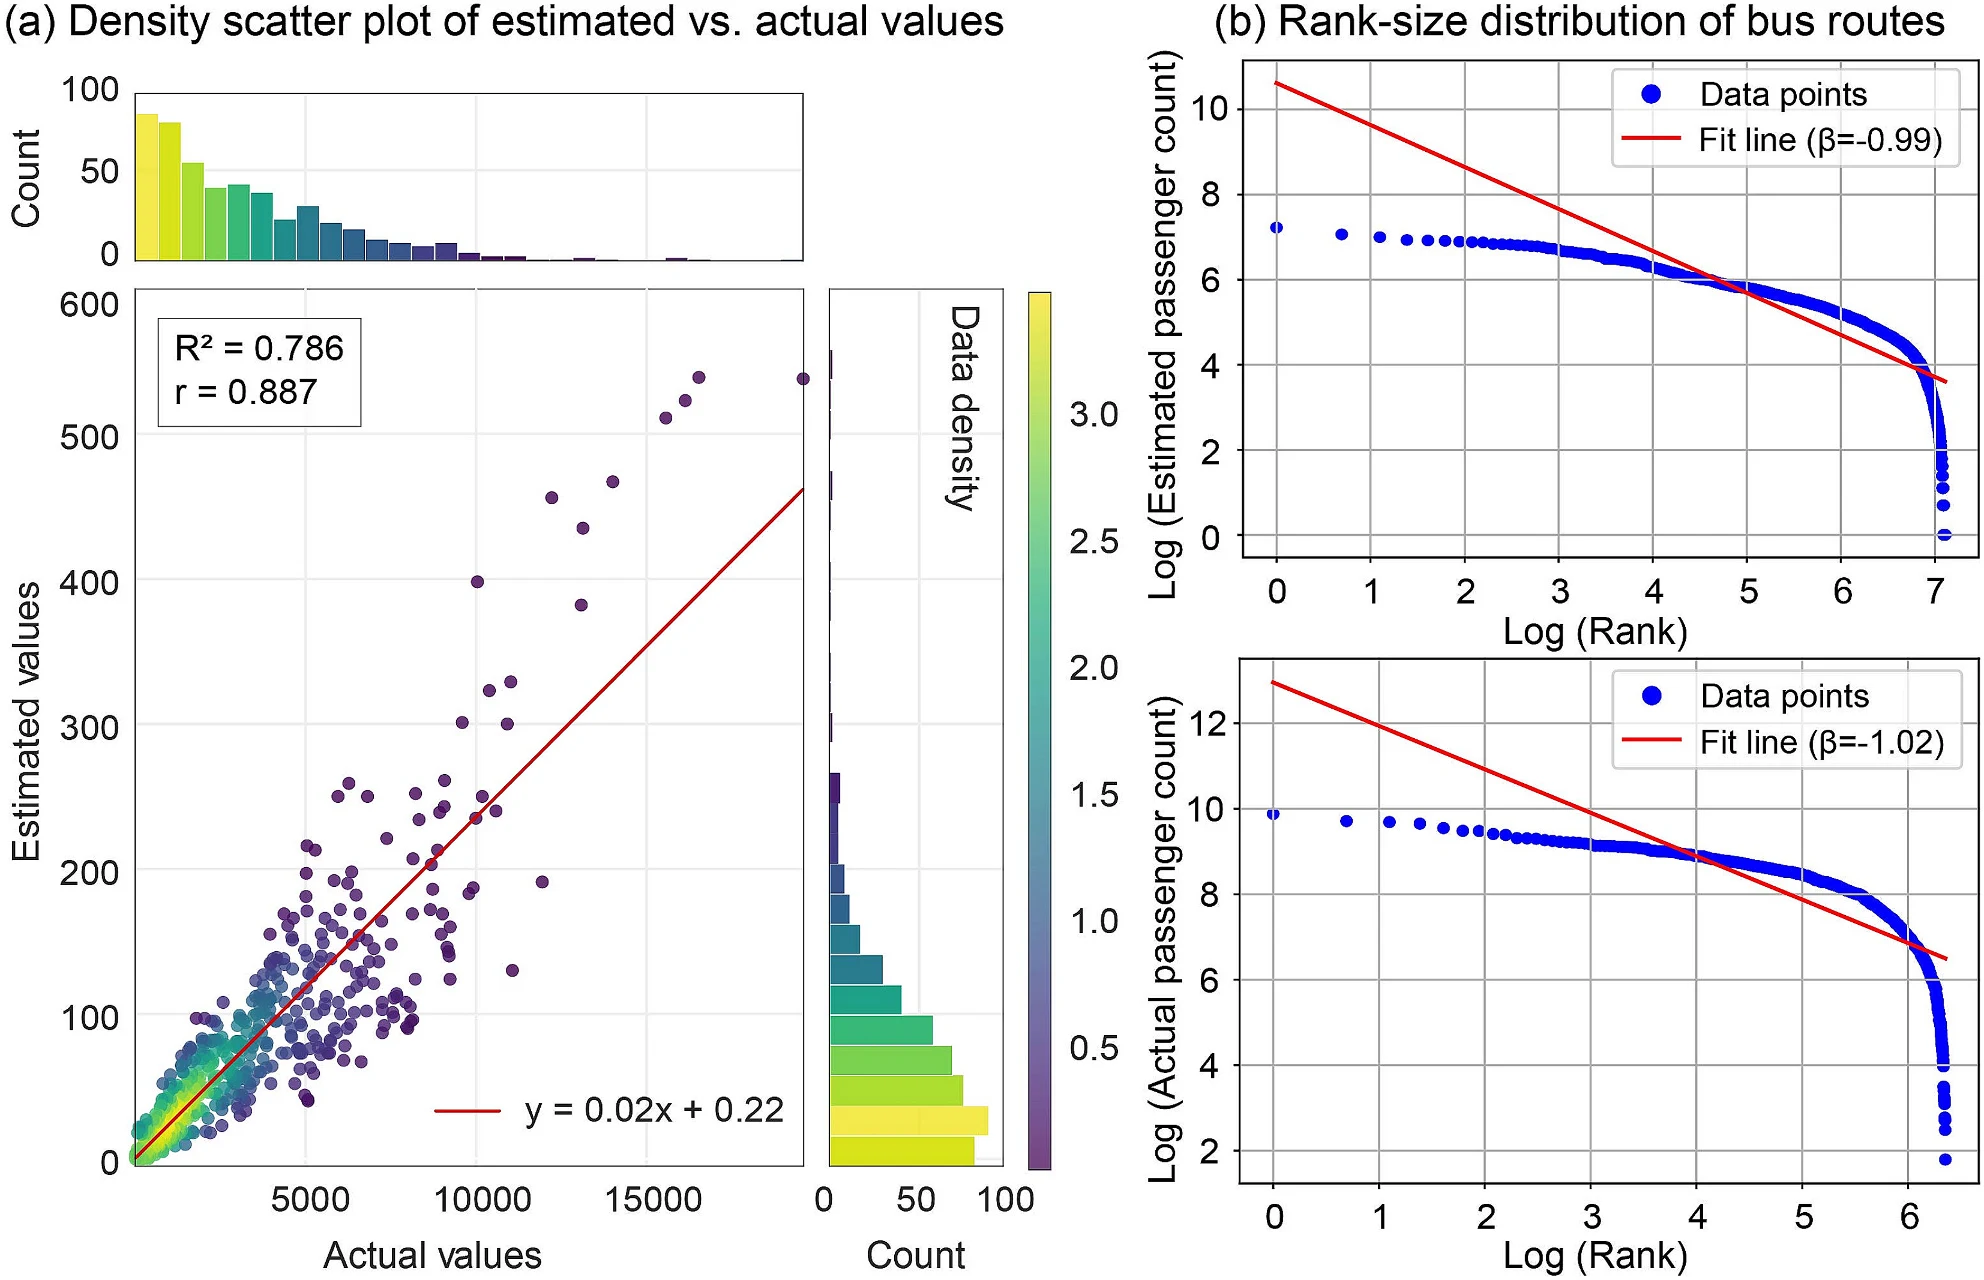
图 7|线路总量对得上时,忙线路和尾部线路各呈什么形状?
(a)颜色表示点的密度,大多数线路挤在低客流一端并靠近红线;红线为 y = 0.02x + 0.22,图内标注R² = 0.786、r = 0.887。高官方客流一端有一批点落在红线上方。(b)双对数秩—规模图,上为重建客流,拟合指数−0.99;下为官方客流,拟合指数−1.02。两端都偏离直线:最大的一批线路低于直线,最小的一批在尾部陡降。来源:原论文 Fig. 6。
论文给出的归一化均方根误差是0.222,归一化平均绝对误差是0.165。正文没有写出归一化的分母,这里只把它们当作作者报告的误差摘要,不换算成平均客流的百分之几。高客流线路偏向上方,作者的解释是中心区站点密,非公交轨迹更容易在空间上碰巧贴近公交站;手机数据覆盖的人群也比刷卡更宽。这是对残差方向的解释。散点本身证明的是线路总量高度同向,以及忙线路有系统性偏高。
秩—规模图上的指数接近−1,论文称之为接近典型帕累托参数。按秩排列后,前80%线路合计占估计总客流99.99%、官方总客流99.37%。分母是相应的线路客流总和。它表明排序末尾的线路份额很小。图上的点在最大和最小两端离开直线,幂律指数概括的是集中程度,头尾名次还各有自己的弯曲。
行程时间提供了另一项行为核对。因为候选行程已被要求长于15分钟,作者用最大似然拟合左截断的对数正态分布。对数均值μ = 2.931,对数标准差σ = 0.675。若按自然对数理解,未截断分布的中位数约为18.7分钟。图上的观测已经去掉短于15分钟的候选,已识别行程的中位数要在这条截断之后的分布里另算。Kolmogorov–Smirnov统计量是0.004,p = 0.985,分位数图大体贴着对角线。时间分布与文献中的公交行程时间一致,可以和线路客流相关并列。历时相近的其他道路方式也会落在这条右偏曲线里,所以时间形状单独还定不了方式。
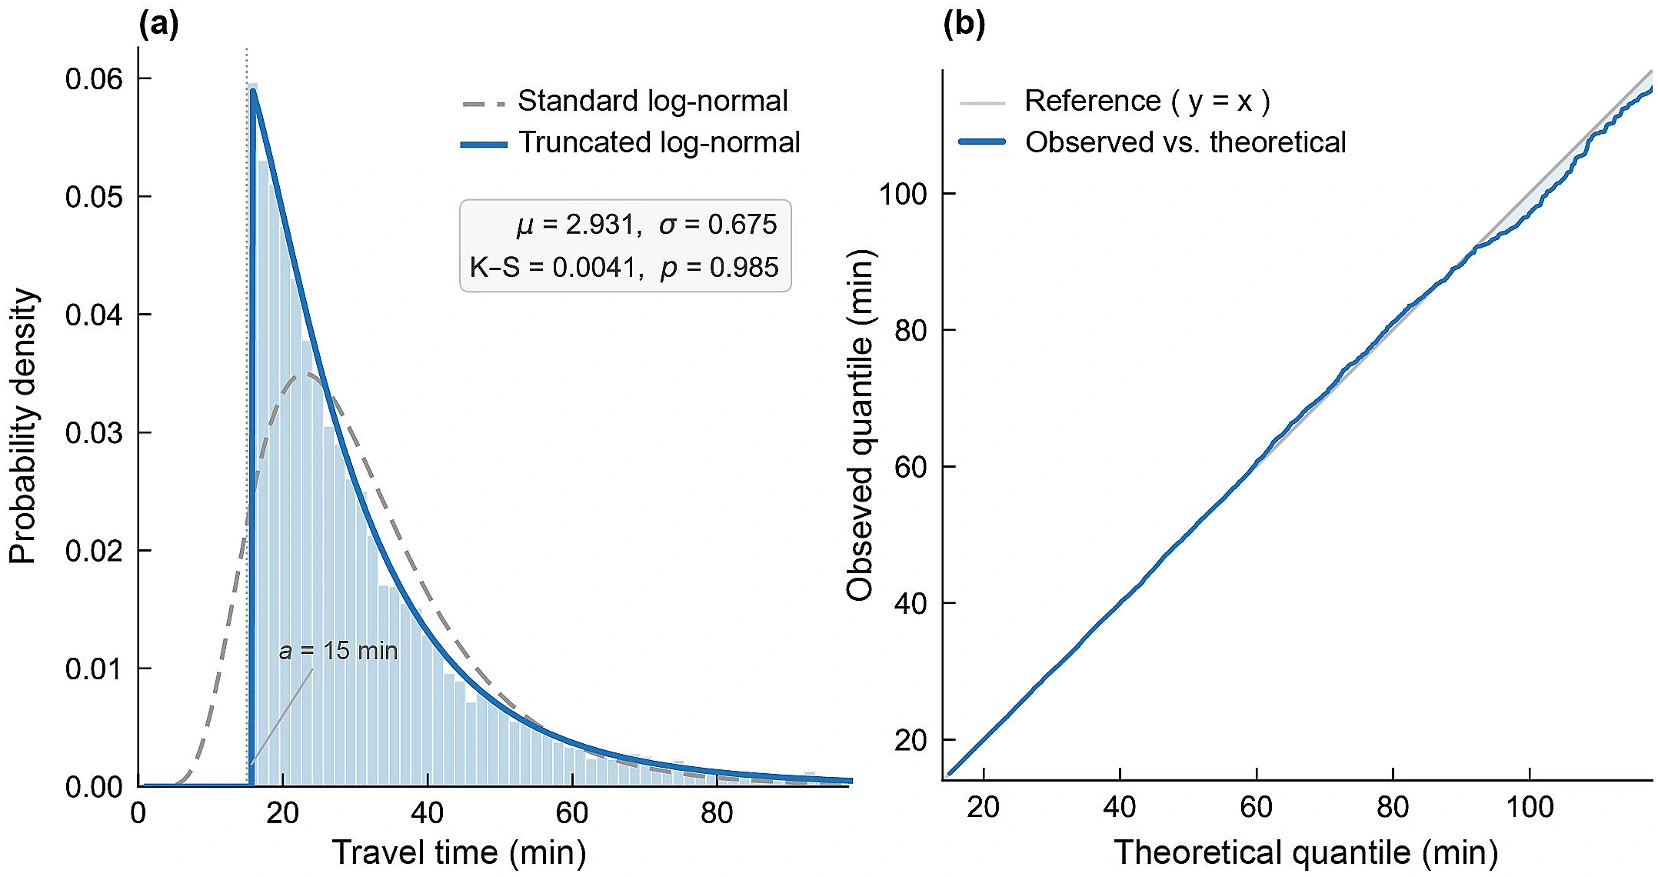
图 8|识别出来的行程,时间上像不像公交?
(a)横轴是分钟,竖线标在15分钟截断处;灰虚线是普通对数正态,蓝实线是左截断对数正态。标注为μ = 2.931、σ = 0.675、K-S = 0.0041、p = 0.985。(b)观测分位数对理论分位数,灰线是完全一致;大部分区间贴近灰线,最长的一端略有分开。来源:原论文 Fig. 7。
500米和分位数窗口也做过网格。步行阈值从200米到3,000米取29档,时间窗口取8档,共232组,每组都把识别结果汇总成线路客流,再和官方数算R²与相关。步行距离的影响远大于时间窗口:从200米放到400米,R²大约从0.20升到0.77。最高点在600米、第20到第80百分位,R² = 0.812,相关0.901。本文采用的500米、第5到第90百分位得到R² = 0.786,相关0.887,比最高点低0.026。作者保留500米,因为它落在高分区里,又和本地500米服务标准一致。超过700–800米后成绩明显下降。作者提示,稍远距离上被纳入的行程里,有些可能是骑行接驳。单一步行门槛盖不住多种到站方式。
同样砍掉两成里程,保住的是上车还是整段行程?
客流若集中在少数路段,缩短线网就有了可计算的对象。作者强调,这一节不提出新的优化算法。两条方案使用同一类迭代贪心程序,差别只在删什么。上车方案只知道每个站的上车人数,优先从线路两端删掉“线路长度除以上车人数”最高的站,也就是用较长路段换掉较少上车。起讫方案按站间客流从低到高分层,同样只删线路两端的段,先删低客流段,直到里程降到目标以下。只动两端,是为了不把一条线从中间剪断。
目标是把总里程减少20%,同时尽量保住需求。四个指标的分母都写在重建网络上:删掉的站数除以原站数;优化后仍保留的上车除以原上车;下车同样计算;起讫覆盖则要求这一对行程的上车站和下车站都被留下,再除以全部起讫行程。
| 指标 | 上车方案 | 起讫方案 | 差值 |
|---|---|---|---|
| 删掉的站点占比 | 20.05% | 22.37% | +2.32个百分点 |
| 上车覆盖 | 100% | 96.24% | −3.76个百分点 |
| 下车覆盖 | 79.55% | 96.16% | +16.61个百分点 |
| 成对起讫覆盖 | 93.14% | 98.29% | +5.15个百分点 |
里程少两成时,上车方案仍覆盖100%的重建上车,同时只保住79.55%的下车。起讫方案多删一些站,上车覆盖降到96.24%,下车和成对行程都留在96%以上。下车相差16.61个百分点,成对行程相差5.15个百分点。上车方案的100%来自它的删除规则尽量不损失上车,而且只在这个削减幅度下成立。
把目标改成削减10%、30%、40%和50%,起讫方案的下车覆盖和成对覆盖仍然更高。削减10%时,成对覆盖是99.77%对97.57%,下车是99.32%对89.45%,上车只差0.77个百分点。削减50%时,成对覆盖的优势收到3.20个百分点(77.57%对74.37%),下车优势仍有13.76个百分点(68.89%对55.13%),上车覆盖则变成69.07%对89.65%,起讫方案少覆盖20.58个百分点。旅程保得更完整,是以放弃更多上车覆盖为代价的;削减越深,这个代价越大。
这些百分比是同一套重建需求上、两种删站规则的覆盖差。等候时间、车辆容量、发车频率和道路拥堵都留在规则之外,也还没有改线之后的实测留存。
证据各自停在哪一层?
重建流量是下界。速度、时长、步行距离和时间比会在进入地图核对之前丢掉一部分真公交,后面补不回来。微观F1使用的是问卷坐标,宏观相关使用的是线路总客运量。论文写明,目前缺少站点级的真实上下车,每一对起讫还没有直接核对。线路总量接近时,甲站到乙站的客流仍可能被配到邻近的另一对站点。
推荐路径是单一的综合方案。习惯走另一条线、或愿意多换乘以换便宜票价的人,会因为和推荐方案对不上而被漏掉。共享单车让500米步行假设更不稳。样本来自一家约占30%份额的运营商,并且只有一个周三;周末、高峰与平峰、季节差异都还没测。社区层面的年龄和性别重抽样,仍然留着儿童和部分老年人缺少手机这一层偏差。
优化示例还把里程和覆盖当成仅有的目标。一个站若上车不多、下车很多,起讫规则更可能留下它;若规划目标是枢纽换乘能力或车厢拥挤,结论里的最优删站会换一套。
一句话总结
上车人数说明行程从哪一站开始。把10月9日的手机轨迹和高德公交方案核对之后,广州中心区要保住的是成对的上下车站;上车最多的站只覆盖这些行程的起点。
核心来源
- Travel Behaviour and Society正式版,题目、作者、卷期、在线日期和正文图表均按该版核对。全文15页,附录A至D含在同一PDF中,未见单独的补充材料文件。
- 广州市规划和自然资源局,2025,《2024年广州市交通发展年度报告》。论文用它给出全市常规公交日均289万乘次,以及占公共交通出行19.84%。
- 高德路径规划接口用于生成某一出发时刻的公交方案。论文比较了综合推荐、省钱、最少换乘和最少步行四种策略。
作者介绍
- Yunling Chen:署名中山大学地理科学与规划学院。贡献说明列出写作、可视化、验证、程序、方法、调查、形式分析和数据整理。公开页面不足以再写职称,这里只保留论文中的身份。
- Suhong Zhou(周素红):通讯作者,中山大学地理科学与规划学院教授,同时署名广东省公共安全与灾害工程技术研究中心;学院介绍写明该中心主任一职,研究方向为城市地理、社会交通地理和时空行为。本文中负责概念、方法、经费、资源与统筹。
- Dan Zou:署名同一学院和工程中心,参与方法与文稿修订。未见可核对的独立职衔页面,不另写头衔。
- Qiuping Li(李秋萍):中山大学地理科学与规划学院副教授,研究城市交通流、人类移动和交通大数据,并署名上述工程中心。本文中参与概念和文稿修订。
- Qiumeng Li:香港科技大学(广州)城市治理与设计学域、智能交通学域助理教授,研究城市计算与移动性分析。本文中参与概念和文稿修订。
延伸思考
以下是 AI 基于论文结果所作的延伸,不属于原论文结论。
若一个城市只能拿到上车人数,线路两端先被拿掉的,会是下车多、上车少的末梢站。20%里程削减里,上车规则仍保住全部重建上车,下车只剩79.55%。医院、学校或铁路接驳站若恰好位于线尾,又主要承接下车,会先进入删除名单。要确认这一点,还得把吸引站和图3没有包含的设施名单叠在一起。仅凭红蓝站点穿插,还指不出哪一类设施被删。
82.42%也不该被写成“信令公交识别已经达到这个准确率”。这个F1的输入是问卷里的坐标和出发时间,分母是3,496条机动化起讫。一座只有粗糙基站轨迹、没有这份问卷的城市,能直接参考的是另一项:线路总量与官方日均的R² = 0.786。而这项相关仍然不检验甲站到乙站是否配对比邻的丙站到丁站。
削减加深以后,完整行程的优势还在,上车覆盖的代价迅速变大。50%里程目标下,起讫方案的成对覆盖只多3.20个百分点,上车覆盖却少20.58个百分点。若管理部门同时考核票款、车厢拥挤和换乘枢纽的上车量,只把成对覆盖设成唯一目标,会在深度缩线时先放弃一大批上车。周三的帕累托走廊也不自动等于周日集市或雨天的关键路段;单日下界流量若被写成时刻表,被漏掉的真公交不会在优化结果里自己出现。